阅读中
Fine-Tuning AI
The Internals of PostgreSQL
ch1: 数据库集簇、数据库与数据表
数据库集簇(database cluster)是一组数据库(database) 的集合,由一个PostgreSQL服务器管理。第一次听到这个定义也许会令人疑惑,PostgreSQL中的术语“数据库集簇”,并非 意味着“一组数据库服务器”。 一个PostgreSQL服务器只会在单机上运行并管理单个数据库集簇。
在 PostgreSQL 内部,所有的数据库对象都通过相应的 对象标识符(Object Identifiers, OID) 进行管理,这些标识符是无符号的4字节整型
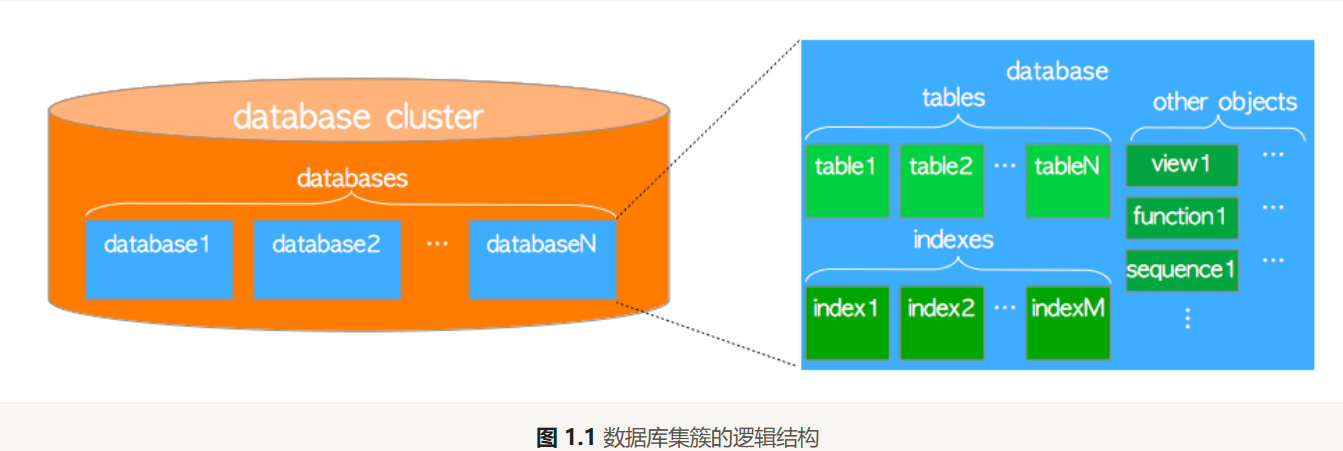
database cluster本质上是一个文件夹,数据库中每个表和索引都会在相应的子目录下存储为至少一个文件(超过1GiB后会创建第二个文件,以此类推).base文件夹中的每一个子文件夹都对应了一个数据库.
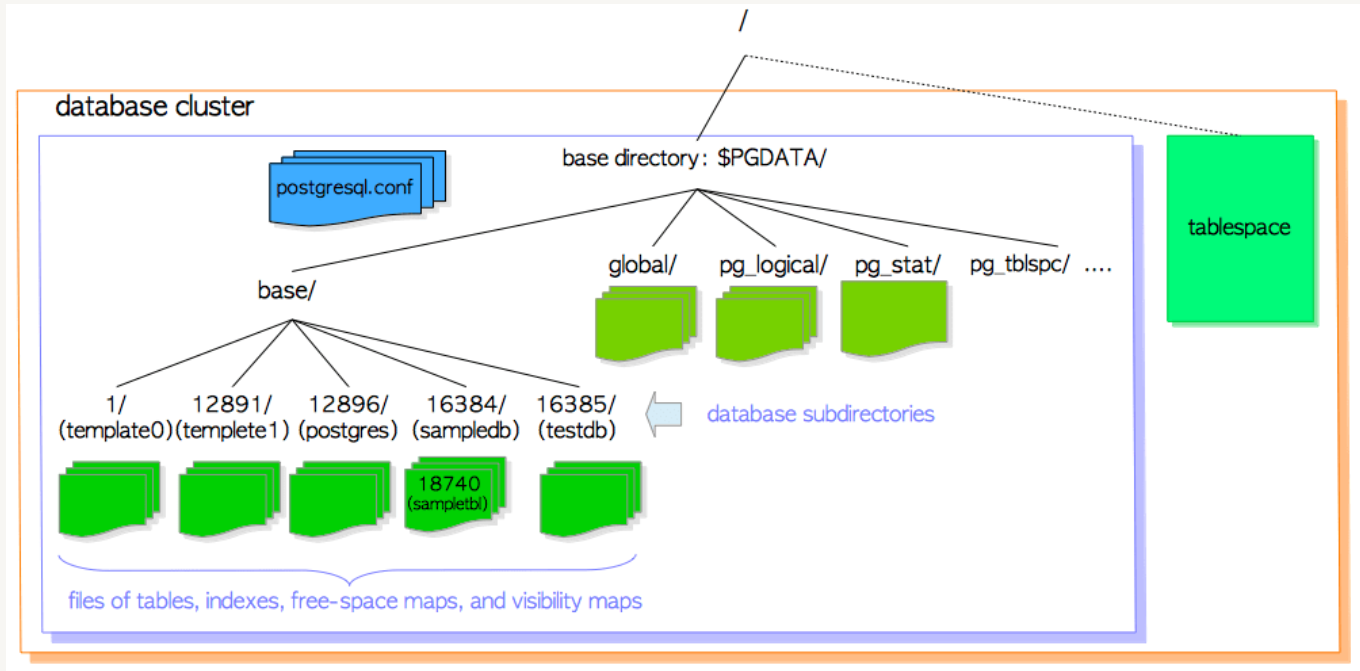
数据文件(如索引和表)被划分为固定长度的pages(也叫blocks),默认大小为8KiB,每个文件中的页从0开始顺序编号,这被称为block number.
表文件的页面布局如下:
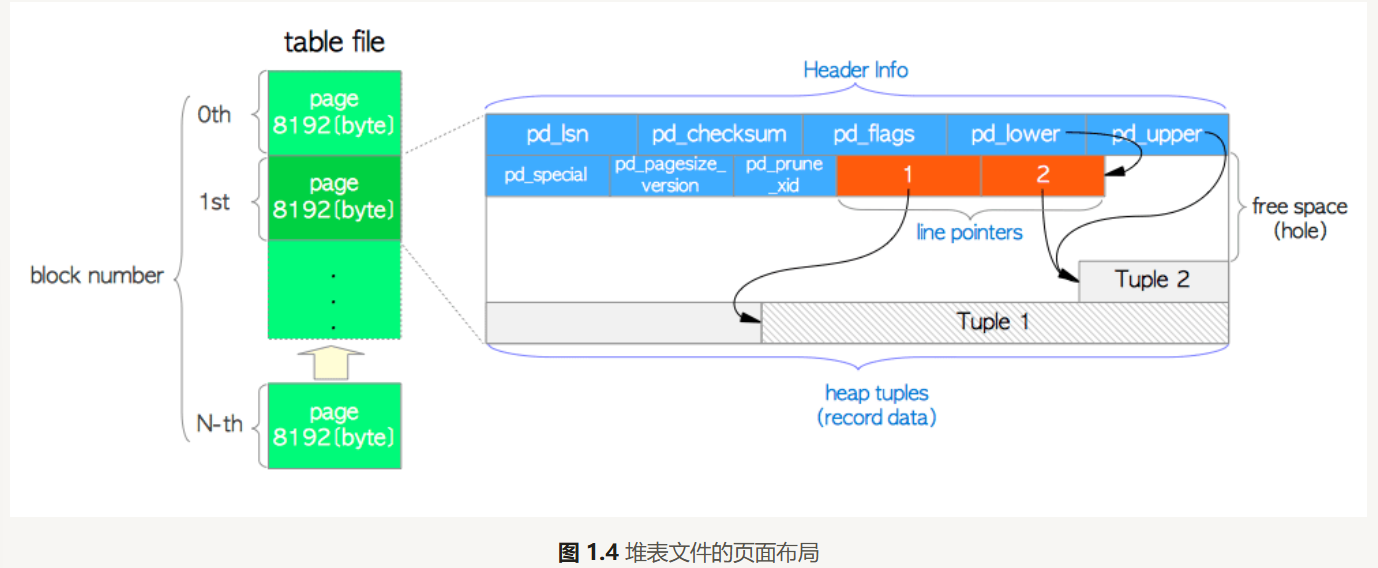
表的页面包含了三种类型的数据:
堆元组(heap tuples) —— 堆元组就是数据记录本身。它们从页面底部开始依序堆叠。第5.2节与第9章会描述元组的内部结构,这一知识对于理解PostgreSQL并发控制与WAL机制是必须的。
行指针(line pointer) —— 每个行指针占4个字节,保存着指向堆元组的指针。它们也被称为项目指针(item pointer)。行指针简单地组织为一个数组,扮演了元组索引的角色。每个索引项从1开始依次编号,称为偏移号(offset number)。当向页面中添加新元组时,一个相应的新行指针也会被放入数组中,并指向新添加的元组。
首部数据(header data) —— 页面的起始位置分配了由结构
PageHeaderData定义的首部数据。它的大小为24个字节,包含关于页面的元数据。该结构的主要成员变量为:pd_lsn—— 本页面最近一次变更所写入XLOG记录对应的LSN。它是一个8字节无符号整数,与WAL机制相关,第9章将详细展开。pd_checksum—— 本页面的校验和值。(注意只有在9.3或更高版本才有此变量,早期版中该字段用于存储页面的时间线标识)pd_lower,pd_upper——pd_lower指向行指针的末尾,pd_upper指向最新堆元组的起始位置。pd_special—— 在索引页中会用到该字段。在堆表页中它指向页尾。(在索引页中它指向特殊空间的起始位置,特殊空间是仅由索引使用的特殊数据区域,包含特定的数据,具体内容依索引的类型而定,如B树,GiST,GiN等。
访问heap tuples有两种方法:
- 顺序扫描: 用行指针依次读取所有页面中的所有元组
- B树索引扫描: 索引文件中的元组存储的是索引元组,索引元组由一个键值对组成,键为被索引的列值,值为目标堆元组的TID(即页号加offset)
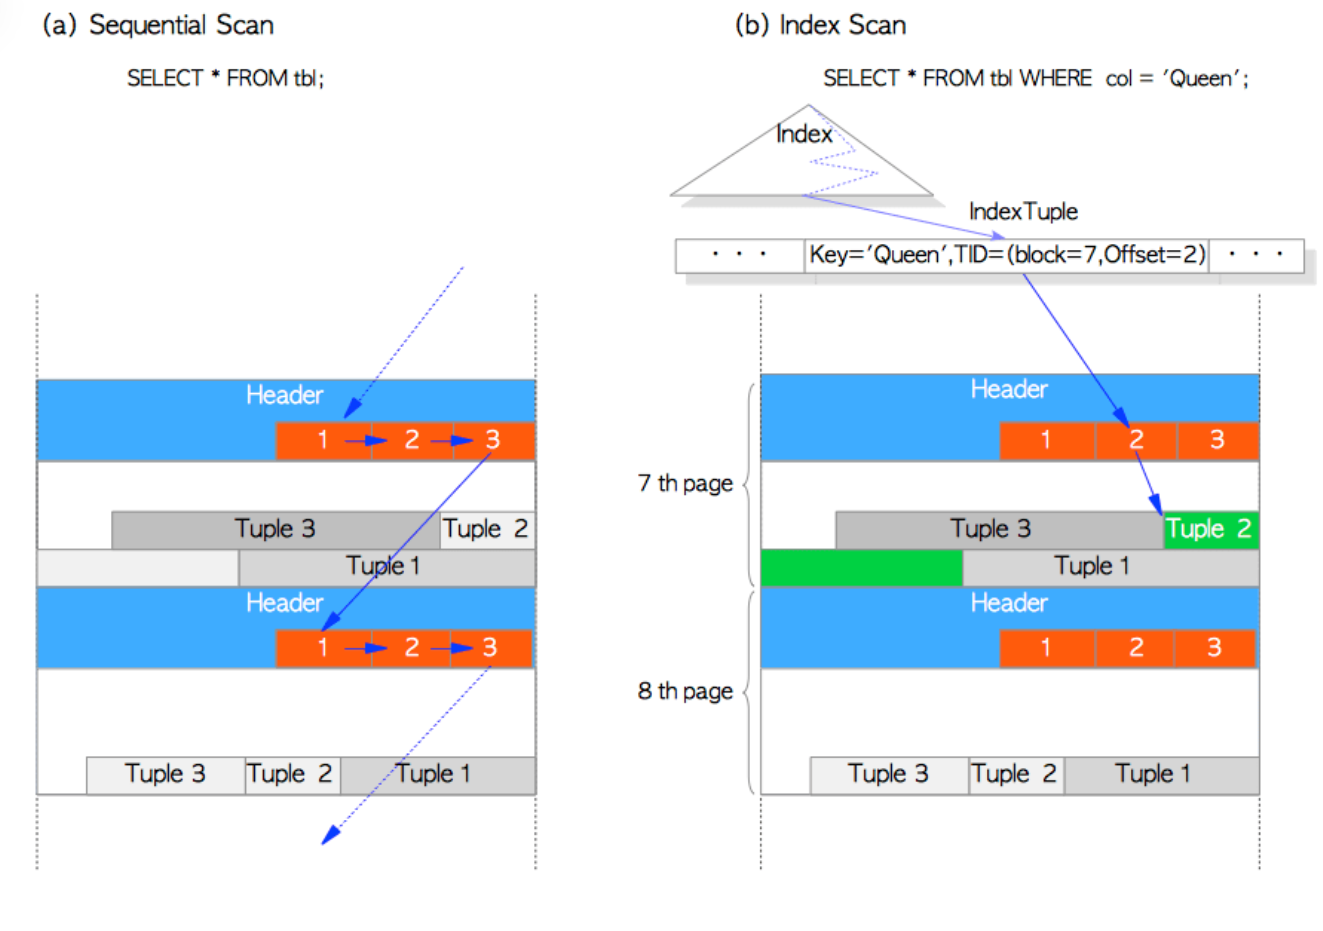
ch2: 进程和内存架构
比较粗犷,可跳过
ch3: 查询处理
Reinforcement Learning from Human Feedback
前言
人工智能领域存在一个几乎无人公开讨论的鸿沟:那就是那些领先的封闭实验室所掌握的知识与公开记录的知识之间的差距。某种技术在少数营利性机构中成为标准做法,并在论文的“方法”部分获得一个段落的描述。实施该技术的实践者们随后便转向其他领域。一年后,其他地方的团队花费四个月的时间重复了原本只需一个下午就能解释清楚的内容。没有人记录下来,因为这并非任何人的职责。
ch1: 介绍
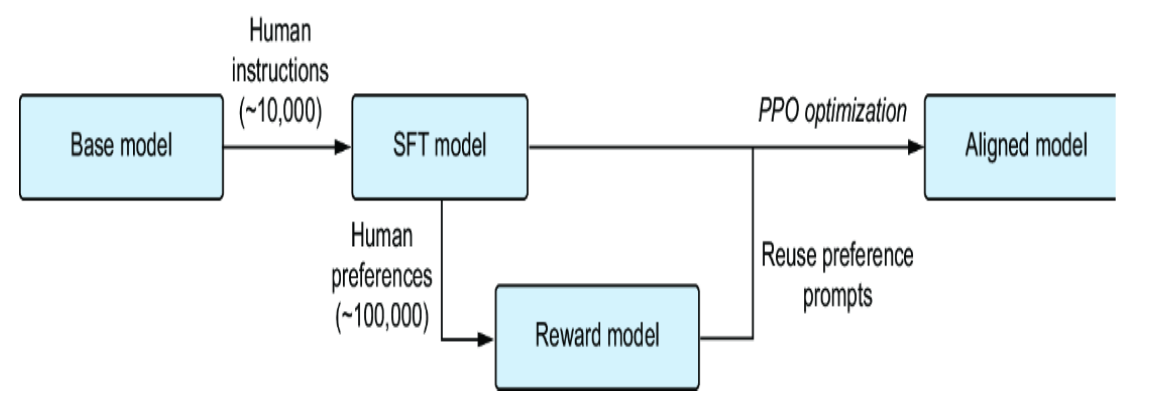
post-training可以总结为三个阶段:
- SFT/IFT(Instruction fine-tuning / supervised fine-tuning): 教授格式规范
- PreFT(Preference fine-tuning): 如RLHF等方法可以让LLM更加贴近某些偏好和语言风格
- RLVR(Reinforcement learning with verifiable rewards): 通过进一步的强化学习训练来提高在某个垂直领域的性能
RLHF分为三步:
- 展示高质量的问答格式数据,让训练模型学习
- 建立一个独立于训练模型的奖励模型,该模型能够捕捉特定的人类偏好,对输入的文本质量进行评分,用于给训练模型提供奖励信号
- 输入一组问题,让训练模型输出多个答案,奖励模型对这些答案进行排序,从而反馈到训练模型的参数上
ch2: RLHF历史
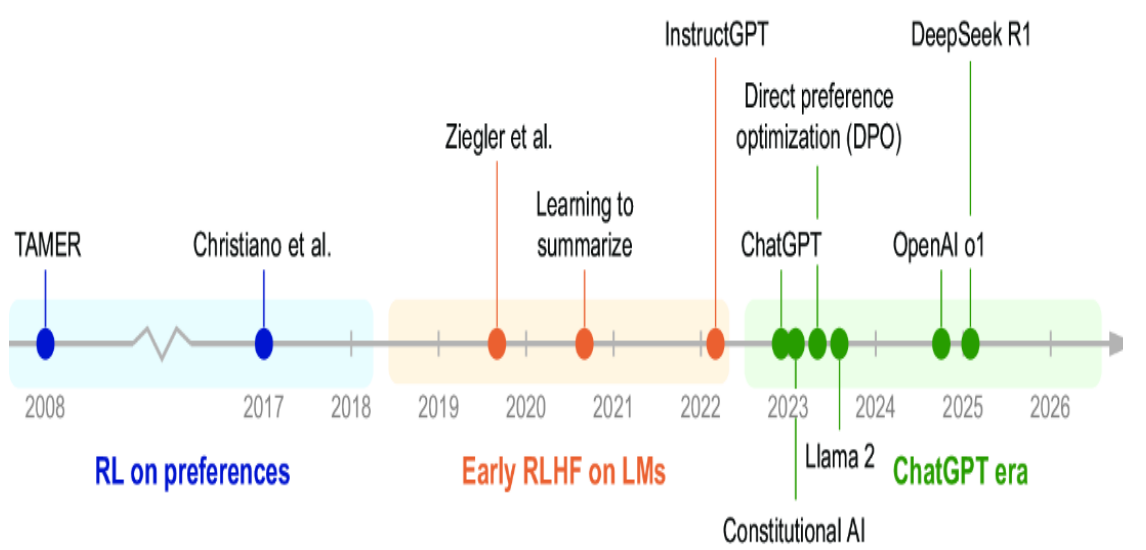
ch3: Training overview
本章将对基于人类反馈的强化学习(RLHF)训练进行简要概述,本书后续章节将深入探讨其具体细节。RLHF虽然优化的是一个简单的损失函数,但它涉及按顺序训练多个不同的AI模型,然后将它们连接起来进行复杂的在线优化。
核心的RL公式:
\[ p_\pi(\tau)= \rho_0(s_0) \prod_{t=0}^{T-1} \pi(a_t\mid s_t) p(s_{t+1}\mid s_t,a_t) \]- \[\pi(a_t\mid s_t)\]
- 策略概率,表示在当前状态s_t下,agent选择动作a_t的概率
- \[p(s_{t+1}\mid s_t,a_t)\]
- 状态转移概率,表示在状态s_t下执行动作a_t后,环境转移到状态s_t+1的概率
- \(\rho_0(s_0)\)
- 初始状态为s_0的概率
- \(\tau\)
- 表示一条完整的轨迹,即从状态s_0一直到状态s_99这样的
- T
- 该轨迹长度所需要的时间步数
连起来看就很好理解了,这条公式是在计算,我们从初始状态s_0开始,不断执行动作a_0,a_1,将状态转换为s_1,s_2,并最终达到最终目标状态的概率,因此才要逐状态计算概率乘积.
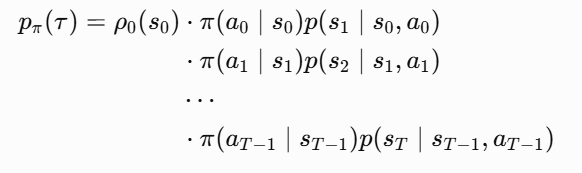
那么假设经过了T个时间步长,我们需要用以下公式来训练Agent:
\[ \max_{\pi} \mathbb{E}_{\tau\sim p_{\pi}} \left[ \sum_{t=0}^{T-1}\gamma^t r(s_t,a_t) \right] \]- \(r(s_t,a_t)\)
- 当前状态采取当前动作获得的奖励
- \[\mathbb E_{\tau\sim p_\pi}[\cdots]\]
- 由于相同的策略未必会产生相同的轨迹(通常是因为环境的随机性),所以我们需要计算按照当前策略能够获得的平均奖励
- \[\sum_{t=0}^{T-1}r(s_t,a_t)\]
- 我们需要考量每一个时间步带来的影响,所以需要累加奖励
- \(\gamma\)
- 折扣因子(通常设置为0-1之间),用于调整不同时间步奖励的权重,当时间步越长,对奖励的折扣就越大,从而让Agent能够重视近期奖励,并且保证任务的收益一定能够收敛而不发散
因此,我们需要寻找一个最优的策略pi,能够让这个奖励和的期望最大,从而让Agent能够遵循特定的轨迹移动.
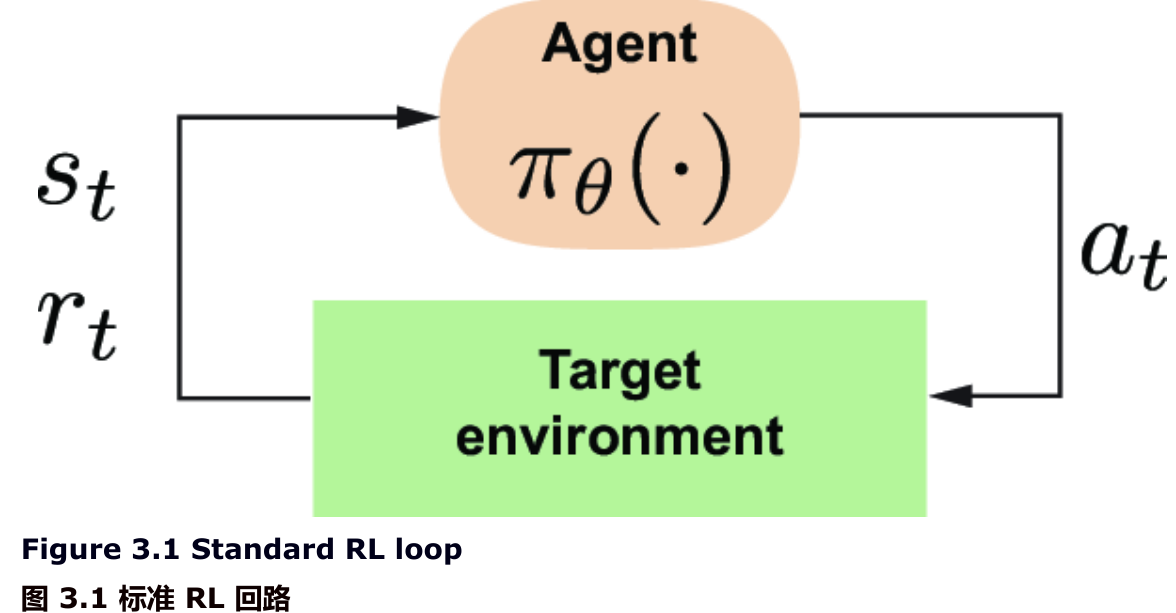
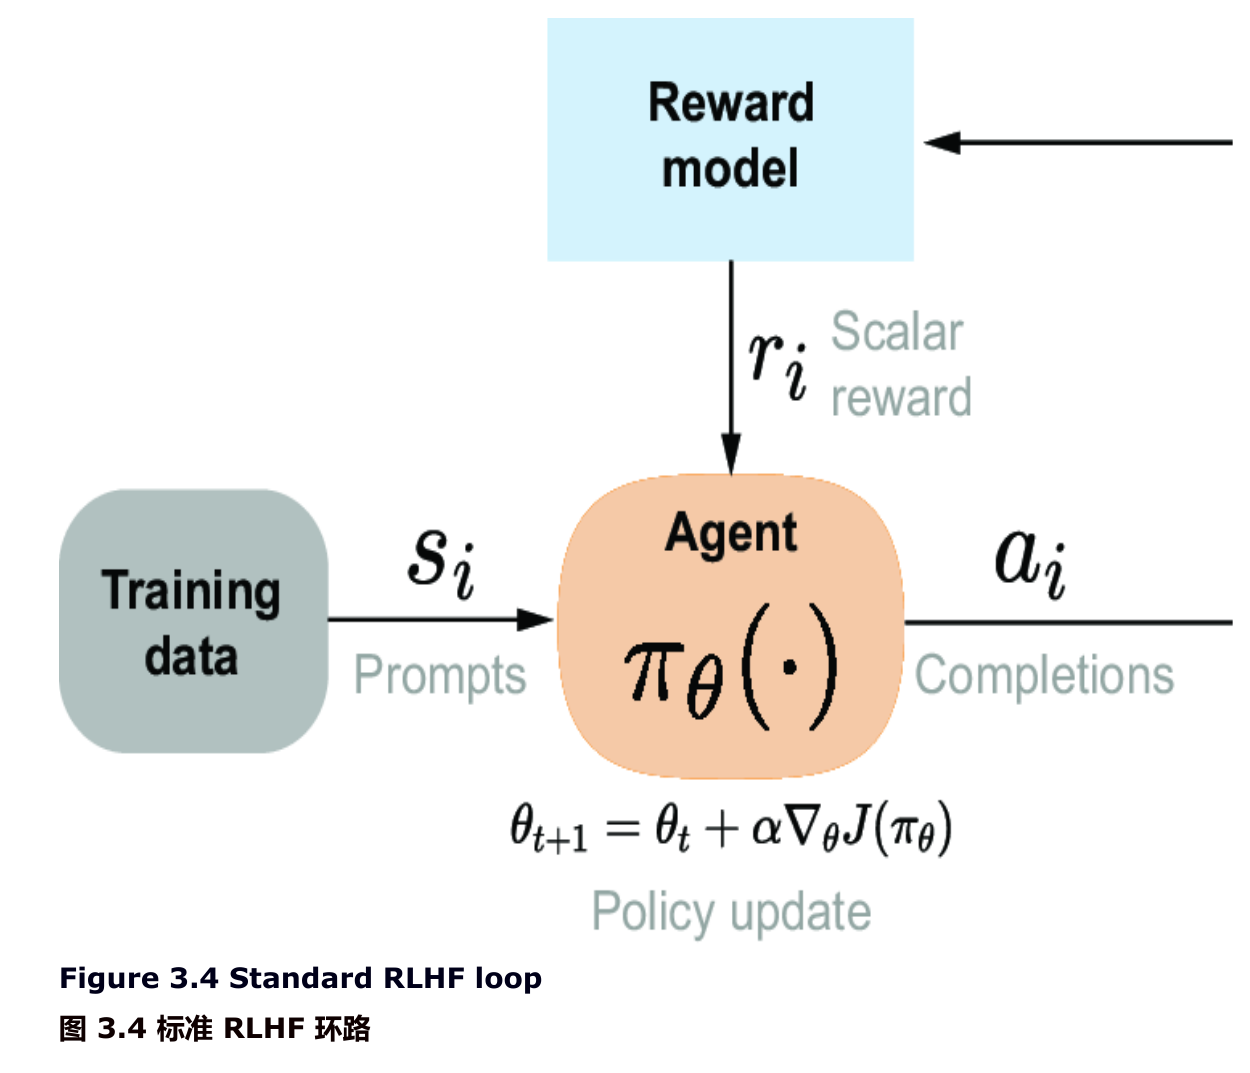
而RLHF与标准的RL有许多不太一样的地方:
- 奖励函数变成了奖励模型,从而增加了实现的复杂性,因为在标准RL中,奖励被视为环境中的静态元素,训练时无法更改
- 没有折扣因子,即设置为1,因为时间步长不应该影响各个位置token的重要性.
ch4: IFT
介绍了Chat Template和IFT的一些基本原理,可跳过.
ch5: 奖励模型(Reward Model)
最常见的奖励模型(RM),被称为Bradley–Terry奖励模型,也是本章的主要讨论对象
Training a Bradley–Terry reward model
BT RM假设每个item都有一个大于零的强度p_i,在比较两个item时,使用该公式进行计算:
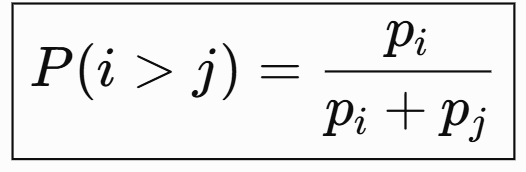
通常,该公式会用指数形式改写:
\[ P(i>j)=\frac{e^{r_i}}{e^{r_i}+e^{r_j}}=\sigma(r_i-r_j). \]- 其中,σ表示sigmoid函数.
如果我们同时给p_i和p_j加一个倍数,并不会影响p(i>j)的值
在给定一个提示词x下,我们得到两个LLM的输出y_1和y_2,那么评分模型就变成了这样:
\[ P(y_1>y_2\mid x)=\frac{\exp(r_\theta(y_1\mid x))}{\exp(r_\theta(y_1\mid x))+\exp(r_\theta(y_2\mid x))}. \]实现
The Healthy Programmer, Second Edition
ch2:
ch6: Preventing Wrist Pain
您可能意想不到的是,每天使用键盘超过7小时的人患腕管综合征的几率并不比普通人群高。然而,键盘使用者更容易出现腕部疼痛和手部麻木。这些症状不如腕管综合征严重,但您可以使用相同的方法来缓解。
ch7: 预防头痛和眼疲劳
CVS(Computer Vision Syndrome,计算机视觉综合征)是一种暂时性疾病,由长时间盯着电脑屏幕引起。其症状包括头痛、眼睛干涩、眼睛发痒、眼睛发红、视力模糊、颈部疼痛、疲劳、复视以及难以重新聚焦。因此,对于大多数程序员来说,CVS 就是他们生活中的常态。
眨眼可以湿润眼睛,并补充覆盖在角膜上的保护膜。使用电脑时,您眨眼的频率往往会降低——大约比平时少五倍。这会导致眼睛更快干涩。因此,你需要强迫自己眨眼——理想情况下,每隔20分钟有意识地眨一下眼。慢慢闭上眼睛,就像要睡着了一样,重复10次。
眼睛疲劳的主要原因是长时间聚焦于同一深度。想想拿着一个重物——过一段时间后,你需要调整它的位置。这就是为什么锻炼眼睛很重要。遵循“20-20-20”法则——即每隔20分钟将视线从电脑上移开,看向20英尺(6米)外的物体,并注视20秒。
The Software Engineer’s Guidebook
ch1: CAREER PATHS
公司种类
- Big Tech(大型科技公司)
- 特点:规模大、上市、雇佣数万名工程师、市值数十亿。
- 代表:Apple, Google, Microsoft, Amazon。
- 优势:顶级薪酬、晋升空间大(超越 Staff Engineer)、影响数亿客户、与顶尖人才共事。
- Medium to large tech companies(中大型科技公司)
- 特点:技术优先,软件工程是核心业务,规模略小于大厂(数百至数千名工程师)。
- 代表:Atlassian, Dropbox, Shopify, Snap, Uber。
- 优势:薪酬和晋升空间接近大厂、工作仍具大规模影响力。
- Scaleups(规模化企业)
- 特点:风投支持的后期公司,已实现产品-市场契合(PMF),正投资于增长(可能故意亏损以抢占市场)。
- 代表:Airtable, Klarna, Notion。子集为“独角兽”(估值≥10亿美元的私营企业)。
- 特征:高压快速扩张、为下一轮融资或上市做准备。
- Startups(创业公司)
- 特点:风投支持、早期融资阶段,正在寻找产品-市场契合(PMF)。
- 代表:早期 Airbnb(成功蜕变为 Scaleup),Secret(失败倒闭)。
- 特征:高风险(往往无实质收入)、最大自由度、最不稳定、工作生活平衡需求高、创始人文化影响大。提供股权的公司属于高风险高回报。
- Traditional, non-tech companies with tech divisions(拥有技术部门的传统非科技公司)
- 特点:核心业务非技术,技术仅为支撑部门(成本中心),部分公司历史悠久。
- 代表:IKEA(家居), JPMorgan Chase(金融), Pfizer(制药), Toyota(汽车), Walmart(零售)。
- 特征:薪酬低于大厂、晋升路径少(Staff Engineer 以上罕见)、工作相对稳定、工作生活平衡较好。
- Traditional but technology-heavy companies(传统但技术密集型公司)
- 特点:技术(硬件/软件)是核心业务,公司发展成熟、可靠、盈利,但组织结构相对僵化。
- 代表:Broadcom, Cisco, Intel, Nokia, Ericsson, Mercedes-Benz, Saab。
- 特征:薪酬低于大厂、不轻易采用新工作方式。但工程挑战复杂、工作影响规模大、极度稳定、工程师任期长、工作生活平衡可预测。
Typical Paths
| Level | Individual contributor | Manager |
|---|---|---|
| 1 | Software Engineer | |
| 2 | Senior Engineer | |
| 3 | Staff/Principal Engineer | Manager |
| 4 | Director | |
| 5 | VP of Engineering | |
| 6 | CTO |
典型的单一职业发展路径。薪酬随级别提升而增长,期望值也随之提高。
规模稍大的公司会采用双轨制:
| Level | Individual contributor ladder | Manager ladder |
|---|---|---|
| 1 | Software engineer | |
| 2 | Senior engineer | |
| 3 | Staff engineer | Manager |
| 4 | Senior staff engineer | Director |
| 5 | Principal engineer | Senior director |
| 6 | Distinguished engineer | VP of engineering |
| 7 | Fellow | Senior VP of engineering |
| 8 | CTO |
典型的双轨制职业发展路径:薪酬和期望值都会随着级别提升而增长。
成本中心和利润中心
成本中心流动性更大,挑战更多,晋升更难,裁员的首要目标,利润中心奖金更多,更加平稳,晋升更容易
先放着
Databse Internals
ch1: 介绍
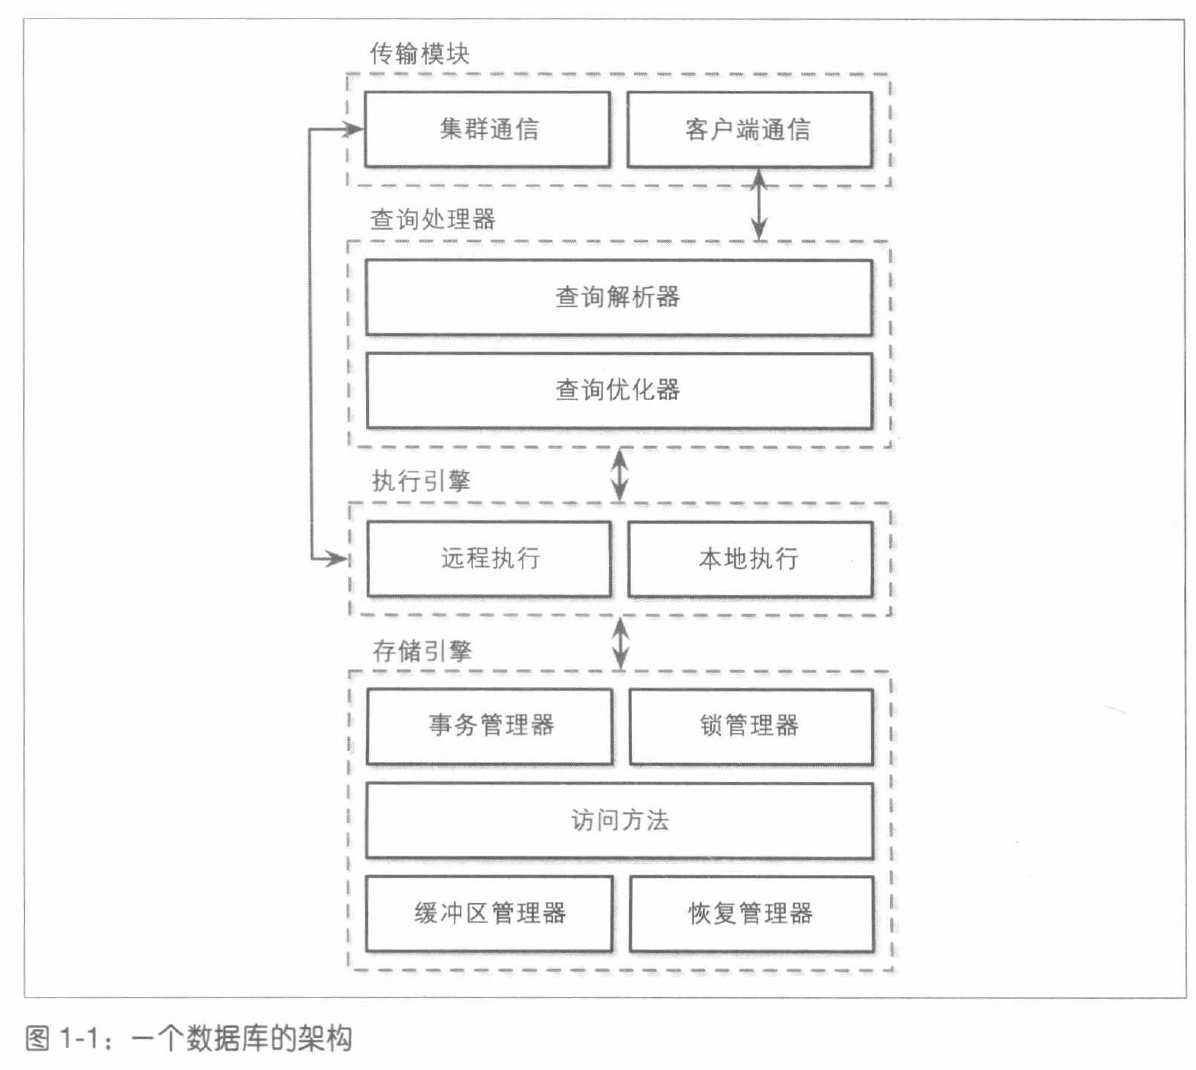
大部分DBMS都是基于硬盘的,而内存数据库如Redis之所以选择Main Memory,是因为内存的访问成本相对较低,并且容易编程,因为操作系统抽象了内存管理,使我们能够以分配和释放任意大小内存块的方式来思考问题.
而在磁盘中,我们需要手动管理数据引用、序列化格式、已释放的内存以及碎片等问题。
不过,鉴于内存缺乏持久性,而且成本高昂,不如更容易维护且价格更低的硬盘,所以内存数据库的发展依然受到了不少限制.
数据库系统可以分为传统的行式存储(将相邻行存储在连续磁盘块中)和新兴的列式存储(将相同列存储在连续磁盘块中),前者即为MySQL,Postgre等关系型数据库,后者的代表有ClickHouse,以及文件格式Apache Parquet.
行存储的优点在于单个用户的数据会存储一起,不需要跨越多个磁盘块就能定位到所有数据,缺点在于执行针对非主键的条件查询时,如果不使用索引,效率极低.
列存储的优点在于能够进行大规模的聚合运算,但缺点就是无法轻松定位到单个用户的所有信息.
大多数现代存储系统不会显式地从页面中删除数据。相反,它们使用删除标记(也称为墓碑标记),其中包含删除元数据,例如键和时间戳。被更新或删除标记覆盖的记录所占用的空间会在垃圾回收过程中被回收。垃圾回收会读取页面,将存活的(即未被覆盖的)记录写入新位置,并丢弃被覆盖的记录。
索引
主(数据)文件上的索引称为主索引。然而,在大多数情况下,我们也可以假设主索引是基于一个主键或一组被标识为主键的键构建的。所有其他索引都称为辅助索引。
二级索引可以直接指向数据记录,也可以只存储其主键。指向数据记录的指针可以保存指向堆文件或索引组织表的偏移量。多个二级索引可以指向同一条记录,从而允许通过不同的字段标识同一条数据记录,并通过不同的索引定位该记录。
两种方法各有优缺点,最好在完整的实现框架下进行讨论。直接引用数据可以减少磁盘寻道次数,但每次记录更新或维护过程中发生重定位时,都需要更新指针,这会带来一定的开销。使用主索引形式的间接引用可以降低指针更新的开销,但会增加读取路径的开销。
ch2: B树
Ch3: 文件格式
Just Use Postgres!
ch1: 介绍Postgres
介绍了用Docker运行Postgres,以及使用psql与Postgres进行连接的方法
| |
请注意,我们在 psql 连接字符串中没有指定密码,连接时也不会提示您输入密码。这是因为,一旦进入容器(docker exec -it postgres),psql 就会通过本地 Unix 套接字进行连接。Postgres Docker 镜像配置为将此类本地连接视为可信连接,因此无需输入密码。
ch2: Standard RDBMS capabilities
多用户
在Postgres中实现多租户有多种方法:
- Table-Level: 用一个共享表记录用户,使用类似tenant_id 的列来区分一个租户的数据与其他租户的数据。粒度很细
- Schema-level: 每个用户有一个专用的Schema,每个Schema有自己的Table,粒度适中
- Database-level: 每个用户有自己的数据库,粒度最大
一个Postgres实例,可以内含多个数据库.
创建表
Postgres 默认创建 postgres 数据库和 public schema,因此数据库和模式的创建步骤是可选的。但是,表的设计和创建完全由您负责——没有捷径可走。
| |
此语句将 catalog 表置于 products 模式下。模式名称在 CREATE TABLE语句中是可选的,仅当需要将表添加到特定模式时才使用,如果不指定则默认添加到当前Schema下,而这一般是Public Schema.
约束添加
| |
可以看到这里的Constraint是对整个表添加的,而不需要特别指明是应用到price字段.
但是NOT NULL这样的约束就需要特别指定列了:
| |
Transactions
当您需要原子地执行多个 SQL 语句时,显式事务非常有用。它将这些语句视为一个单一操作,要么成功完成,要么优雅地回滚,不留下任何痕迹。显式事务以 BEGIN 语句开始,并且必须使用 COMMIT 操作显式提交.
| |
成功应用但随后被 Postgres 回滚的更改不会立即从数据库中消失。The Postgres multiversion concurrency control (MVCC)引擎确保这些更改对后续的应用程序请求和事务不再可见。然而,即使回滚的更改不再可见,它们仍会在数据库中保留一段时间,直到 Postgres 执行垃圾回收(称为vacuum)。
Postgres的默认隔离级别是Read Committed,即一个事务只能读取其他事务已经提交的数据。它很好地平衡了数据一致性和并发性,使您能够在不牺牲数据一致性的前提下构建高性能的事务型应用程序。然而,除了读已提交隔离级别可以防止的脏读现象之外,SQL 标准还定义了其他现象,例如幻读和不可重复读。PostgreSQL 提供了更强的隔离级别——可重复读和可序列化——来解决这些额外的读取异常问题。
Join
基本的join操作
函数和触发器(待补充)
何时以及为何需要使用数据库函数呢?至少可以想到以下两种情况:
- 当复杂的业务逻辑与数据紧密耦合,且需要每个客户端应用程序或微服务独立实现和维护时,您可以创建一个所有客户端和微服务都能利用的单一数据库函数。这种方法使得数据库函数能够直接在数据库中高效地实现业务逻辑。
- 当您需要处理复杂的、多步骤的业务逻辑,并且需要在应用层和数据库层之间进行多次往返时,将逻辑实现为数据库函数会更加高效,尤其是在网络延迟较高且需要在应用层和数据库层之间传输大量数据的情况下。
ch3: Modern SQL
自 1999 年以来,SQL 不再局限于关系模型。当时,ISO/IEC 9075(“SQL 标准”)加入了数组、对象和递归查询。如今,SQL 标准的规模已是 SQL-92 的五倍。换句话说:关系型 SQL 仅占现代 SQL 的约 20%。
Common table expressions
CTE的标准格式如下:
| |
辅助语句(auxiliary_statement)是一个常规的SQL查询,执行结果可供接下来执行的(主语句)primary_statement使用
- 总的来说,您可以将 CTE视为仅由给定查询生成和使用的临时表或视图
一个例子如下:
| |
事实上就是with语句而已,属于SQL-99标准
递归查询(待补充)
Window Function
最简单的窗口函数形式如下:
| |
一个示例是,如果我们需要计算一个云端播放器中每首歌曲的总播放时长,可以这么写:
| |
但如果我们不仅需要计算歌曲的总播放时长,还需要在输出中包含所有收听过该歌曲的用户,该怎么办?本质上,我们需要为每个收听过歌曲的用户创建一个单独的行,同时还要显示所有用户的总播放时长。
一个错误的方法是:
| |
如果这么写,那么就无法获取每首歌的总播放时长,而是得到单个用户对每一首歌的总播放时长.
如果不用窗口函数,我们就需要用join连接两次查询结果:
| |
而用窗口函数,是这样写的:
| |
窗口函数和Group By很像,都是分组聚合,但是窗口函数会保留原行,将新算出来的数据插入到原行的新列中.
ch4: 索引
大模型原理与架构
ch1: Transformer诞生
序列建模(Sequence Modeling)
在深入 Transformer 的技术细节之前,有必要先理解它试图解决的根本问题:如何对序列数据进行有效建模。
序列建模(Sequence Modeling)是指让计算机理解和处理有序数据的任务。自然语言是最典型的序列数据——一句话中词语的排列顺序直接决定了语义。“猫追狗”和“狗追猫”使用了完全相同的词汇,但含义截然不同。
序列建模有三大难题:
- 变长输入: 句子的长度可以从一个词到数千个词不等,但传统的全连接网络需要输入维度固定,无法直接处理变长序列
- 长距离依赖: 两个词语在一段话中可能相隔很远,但却是强相关的,模型必须具有捕捉这种依赖的能力.
- 计算效率问题: 如果模型严格按照顺序逐个处理每个元素,那么长序列的计算时间线性增长,无法并行计算,计算效率低
围绕这三大根本难题,序列建模领域展开了长达几十年的探索与发展。在这段漫长的技术演进中,循环神经网络(RNN)较好地解决了变长输入问题,随后的长短期记忆网络(LSTM)在长距离依赖问题上取得了显著改善。然而,直到 Transformer 横空出世,计算效率问题才真正迎来了突破——不仅如此,它在前两个问题上也给出了更为优雅的答案。
RNN与CNN
RNN的训练依赖时间反向传播(Backpropagation Through Time,BPTT): 将 RNN 沿时间展开为一个很深的前馈网络,然后用标准的反向传播算法计算梯度,但反向传播中每次都需要乘以一个权重矩阵,这有可能导致梯度的指数级衰减,即梯度消失问题.
智能体 Harness 工程指南
Learning LangChain
ch1: 基础知识
Software Design for Python Programmers
Site Reliability Engineering, 2nd ed
- 超级新鲜,还没出我就在期盼了
ch1: 引言
乍一看,这个名字可能有点奇怪,但每个词都有更深层的含义——它们合在一起,很好地概括了 SRE 的本质:
- Site: The why
- 2003 年,谷歌设立 SRE 部门时,其使命非常明确:“确保网站 (google.com) 正常运行”。
- Reliability: The what
- 可靠性是 SRE 的最终目标。
- Engineering: The how
- 工程是SRE为业务提供可靠性的方法。它并非英雄壮举、超能力或神秘魔法,而是运用软件工程的思维方式来解决可靠性问题
ch2: The Value of Reliability
简单的头脑风暴,可以跳过
ch3: Trends in Production
如果管理不当,企业往往会发现,他们只是用波动性极大的运营支出(OpEx)取代了可预测的资本支出(CapEx)。这催生了金融运营(FinOps)这一学科,它将站点可靠性工程(SRE)的概念(例如自动化和以客户为中心的监控)应用于可靠性、容量和成本的交汇点。
介绍了一些SRE领域相关的新变化,如今的生产环境与短短十年前相比已截然不同.面对各有特色却又大同小异的挑战,许多组织最终都趋同于采用共同的模式来应对规模化、复杂性和持续变化的需求
ch4: SRE的文化背景
实际上在讲管理…
ch5: SRE Hiring, Training,and Career Management
- 一次面试表现不佳并不一定意味着候选人不合适,也可能反映出面试官的水平
- 太直白了
讲培训SRE的
ch6: SRE 的组织结构
依旧讲管理
ch8: Service Level Objectives
Service level indicator (SLI)是衡量服务绩效的量化指标,如p99响应时间等数据,SLO由SLI和对应的目标值结合起来,如: 我们需要p99响应时间少于20ms,这就是一个SLO.
而Service level agreement (SLA)则是在SLO未达成时的必要措施,是服务提供商和消费者之间达成的某些协议.
ch9: 可观测性和监控
面向模式的软件架构
介绍
这书总共有5卷:
| 卷数 | 英文书名 | 中文书名 | 出版年份 | 主要内容 |
|---|---|---|---|---|
| 卷 1 | A System of Patterns | 模式系统 | 1996 | 分层架构、MVC、Broker、Pipes and Filters 等架构模式 |
| 卷 2 | Patterns for Concurrent and Networked Objects | 用于并发和网络化对象的模式 | 2000 | Reactor、Proactor、Acceptor-Connector、线程并发与网络通信模式 |
| 卷 3 | Patterns for Resource Management | 资源管理模式 | 2004 | 资源获取、资源生命周期、资源共享与释放 |
| 卷 4 | A Pattern Language for Distributed Computing | 分布式计算的模式语言 | 2007 | 分布式系统架构与多种设计模式的组合 |
| 卷 5 | On Patterns and Pattern Languages | 模式与模式语言 | 2007 | 模式的理论基础、模式语言及模式之间的关系 |
volume 1
模式
每个模式都包含三部分:
- 背景(Context):问题出现的背景;
- 问题(Problem):该背景下反复出现的问题;
- 解决方案(Solution):经过实践检验的解决之道。
模式类型有三种: 架构模式(如MVC,DDD),设计模式(如Observer模式),成例(针对特定编程语言的某种经验如引用计数),三者的关系是自顶向下,逐渐深入细节.
模式的标准描述模板如下:
- 背景
- 模式可能适用的情形。
- 问题
- 模式解决的问题,包括涉及的作用力。
- 解决方案
- 模式背后的基本解决原则。
- 结构
- 详细说明模式的结构方面,包括每个参与组件的 CRC 卡 [BeCu89](参见本书后面的“表示法”)以及一个 OMT 类图 [RBPEL91]。
- 动态
- 通常是一些情景,描述了模式的运行阶段行为。
- 我们还使用对象消息序列图(参见本书后面的“表示法”)对情景做进一步说明。
- 实现
- 模式实现指南。
- 这些指南只是建议,并非永恒的规则。你应根据需求调整实现:添加不同、额外或更详细的步骤,或调整步骤的顺序。我们使用 C++、Smalltalk、Java 或 pSather 示例代码来演示可能的实现,它们通常描述了示例问题的细节。
- 示例解答
- 对“解决方案”、“结构”、“动态”和“实现”等部分未涉及,但对解决示例问题至关重要的各个方面进行讨论。
- 变种
- 简要地描述当前模式的变种或具体化(specialization)。
- 已知应用
- 模式在既有系统中的应用。
- 效果
- 模式提供的优点及潜在的缺点。
- 参见
- 列举其他一些模式,它们要么解决了类似问题,要么有助于改进当前模式。
ch2: 架构模式
本章介绍如下8个架构模式:Layers(分层)、Pipes and Filters(管道和过滤器)、Blackboard(黑板)、Broker(中间人)、Model-View-Controller(模型—视图—控制器)、Presentation-Abstraction-Control(表示—抽象—控制)、Microkernel(微核)和Reflection(反射)。
每个架构模式都有助于获得特定的系统整体特征,如用户界面的可适应性。可根据模式有助于实现的特征对它们进行分类,本章将架构模式分为四类。
- 从混乱到有序。这类模式有助于避免组件(对象)过多。具体地说,它们有助于以可控的方式将整个系统面临的任务分解成相互协作的子任务。这类模式包括Layers、Pipes and Filters和Blackboard。
- 分布式系统。这个类别只包含一个模式——Broker,但涉及其他类别中的两个模式:Microkernel和Pipes and Filters。Broker给分布式应用程序提供了完备的基础设施,对象管理组织(Object Management Group,OMG)不久后将对其底层架构标准化[OMG92]。Microkernel和Pipes and Filters模式将分布性视为次要考虑因素,因此根据它们考虑的主要因素将它们划归到了其他类别,但2.3节将详细讨论这两个模式的分布性方面。
- 交互式系统。这个类别包含两个模式:Smalltalk领域大名鼎鼎的Model-View-Controller模式以及Presentation-Abstraction-Control模式。这两个模式都有助于组织支持人机交互的软件系统。
- 可适应系统。如果应用程序需要扩展,以适应不断发展的技术及不断变化的功能性需求,使用模式Reflection和Microkernel将大有裨益。
从混乱到有序
- Layers:
- 应用: OSI七层协议,虚拟机,API,操作系统
- 优点: 各层可重用和轻易更换
- 缺点: 引入大量的适配代码和不必要的抽象,效率低下,而且底层代码的行为变化可能引发高层的剧烈崩溃
Pipes and Filters:
Architecture Patterns with Python
前言
按照知名度,我们有三种常用的开发架构: 1. 测试驱动开发(TDD)的效能优化
测试驱动开发(TDD)能辅助我们编写正确的代码,并支持我们在无回归风险的前提下重构或新增功能。然而,要充分发挥测试的效用并非易事:
- 如何确保测试运行速度足够快?
- 如何通过快速、无依赖的单元测试获得尽可能高的代码覆盖率和反馈?
- 如何将运行较慢且不稳定的端到端测试数量降至最低?
2. 领域驱动设计(DDD)的模型解耦
领域驱动设计(DDD)要求我们将精力聚焦于构建优质的业务领域模型。但关键在于,我们该如何确保模型免受基础设施问题的干扰,从而避免其变得难以修改?
3. Event-Driven Architecture
通过消息集成的松耦合(微)服务(有时称为响应式微服务)是管理跨应用或业务领域复杂性的成熟方案。然而,如何让这些服务与 Python 世界现有的工具(如 Flask、Django、Celery 等)无缝兼容,往往并非显而易见。
Part one前言
我们发现,很多开发人员在被要求设计新系统时,会立即着手构建数据库模式,而将对象模型视为次要考虑因素。这正是问题开始出现的地方。正确的做法是,先考虑行为,并以此来驱动存储需求。毕竟,我们的客户并不关心数据模型,他们关心的是系统能做什么;否则,他们直接使用电子表格就好了。
ch1: Domain Modeling
The domain is a fancy way of saying the problem you’re trying to solve.
简而言之,领域驱动设计(DDD)认为软件最重要的功能是提供一个有用的问题模型。如果我们能正确地构建这个模型,我们的软件就能创造价值,并催生新的事物。
ch2: Repository Pattern
原理图
Before:
After:
SQLAlchmy中的DIP(依赖倒置原则)
声明式映射:
| |
OrderLine 本来代表一个领域实体(订单明细),但是现在它:
- 必须继承 SQLAlchemy 的
Base。 - 必须使用
Column定义属性。 - 必须知道
Integer、String等数据库类型。 - 必须使用
ForeignKey和relationship描述 ORM 映射关系。
DIP写法:
| |
可以注意到这里,我们用一个外部model文件中的Order类映射到了内部的orders中,从而避免了直接依赖于SQLAlchemy.
Introducing the Repository Pattern
The Repository pattern is an abstraction over persistent storage.它通过假装所有数据都存储在内存中,来隐藏数据访问的繁琐细节
模拟仓库:
| |
使用仓库:
| |
其实就是对SQLAlchemy的session访问做了一层封装,所以的数据库访问都是通过Repository来间接实现的.
ch3: Coupling and Abstractions
当我们因为担心会影响组件 B 而无法更改组件 A 时,我们就说这些组件之间产生了耦合。从局部来看,耦合是件好事:它表明我们的代码协同工作,每个组件都支持其他组件,所有组件都像手表齿轮一样完美契合。用专业术语来说,当耦合的元素之间具有高内聚性时,我们就说这种协同工作状态良好。
从全局来看,耦合是相当糟糕的问题,它会增加代码修改的风险和成本,有时甚至会让我们感觉根本无法进行任何修改.
唯一的方法就是抽象掉细节,通过中间件来剥离组件之间的依赖:
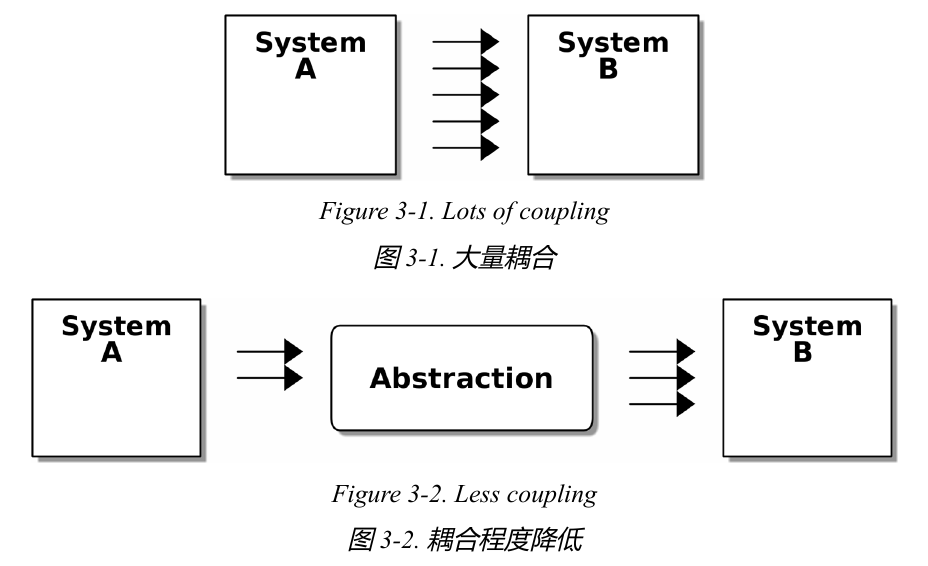
当我们需要从根本上解决问题时,通常会先编写一个简单的实现,然后再进行重构,使其设计得更好。本书将始终采用这种方法,因为这正是我们在现实世界中编写代码的方式:从解决问题的最小部分入手,然后迭代地完善解决方案,使其更加完善和设计得更好。
ch4: 实战,引入服务层
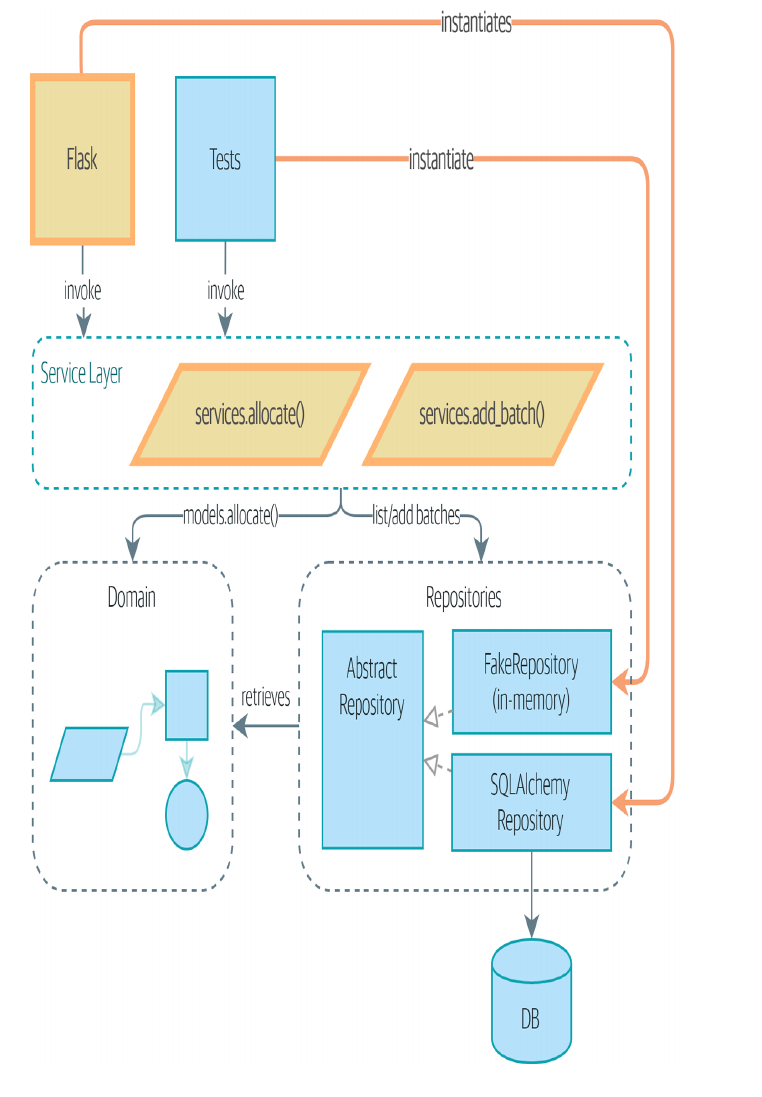
ch5: TDD in High Gear and Low Gear
尽管用了TDD,但我觉得相当的牵强.
ch6: Unit of Work
UoW用于将仓库和服务连接起来,使其完全解耦,如果不用uow,我们的API请求要除了Service之外,还要同时接触数据库层(启动会话,引入sessiondep依赖),仓库层(引入Domain模型).
用了uow后,我们的架构如下:
先实现一个抽象基类:
| |
再来一个具体实现:
| |
写测试:
| |
一个很好的想法是,显式写明commit,默认使用rollback,如:
| |
使用uow的另一个好处就是,我们现在可以轻松地将一系列操作包装为原子的:
| |
所以uow其实就是对数据库操作做了一层封装,并且通过抽象基类可以保证能随时替换数据库.
ch7: Aggregates
当我们开始考虑扩展应用程序时,我们意识到,将订单行分配到所有可用批次的模型可能无法扩展。如果我们每小时处理数万个订单,以及数十万条订单行,我们不可能对每一条订单行都持有整个 batches 表的锁——至少会遇到死锁或性能问题。
因此我们需要将原子操作封装到一个更大的单元里:
| |
Part Two前言
恕我直言——我们一直强调,每种模式都有其代价。每一层间接性都会增加代码的复杂性和重复性,并且会让从未见过这些模式的程序员感到困惑。如果你的应用本质上只是一个简单的数据库CRUD封装,并且在可预见的未来不太可能发展成其他功能,那么你就不需要这些模式。直接使用Django,省去很多麻烦吧。
ch8: Events and the Message Bus
如果我们需要在库存不足时向管理员发送邮件提醒,一个显而易见的想法就是在路由里直接写,相关异常被抛出时就发送邮件.
如果我们希望保持简洁,也可以把它放在domain或者service里面:
| |
无论如何,这都破坏了single responsibility principle (SRP),即每个函数只应该有一个职责.
如此一来,我们就有必要引入Events,它是一个简单的dataclass:
| |
因此,当出现异常时,我们就在发生异常的地方记录事件,由Message Bus来处理这些事件:
| |
至于具体怎么用,可以在service中处理,也可以在uow中处理
ch9: Message Bus深入
之前的消息总线是一个附加组件,现在我们试图将所有消息都通过消息总线来传输:
一个很好的想法是,如果我们把API调用也看作是事件,那么所有的服务和业务就都可以通过消息总线传输了,不再需要区分内部事件还是外部事件.
Vision Language Models
- 出版于2026年,出版商:O’Reilly,作者:Merve Noyan。
导论
Brief Introduction to Computer Vision
Coding Video,A Practical Guide to HEVC and Beyond(待补充)
- 出版于2024年,作者:Iain E. Richardson。
介绍
一秒标准的未压缩SD(576p)视频,每秒25帧,大约占用15.5 MB存储空间。这意味着,通过网络或广播频道实时传输这段视频,即每秒发送一秒可播放的视频内容,需要124 Mbit/s的带宽。而一秒未压缩的UHD/4K视频、每秒50帧捕捉,则大约占用620 MB存储空间,实时传输将需要高达5 Gbit/s的传输带宽。
- 由此可知,我们在电子产品中存储的视频都是压缩形式的,只在播放时进行实时的解码.
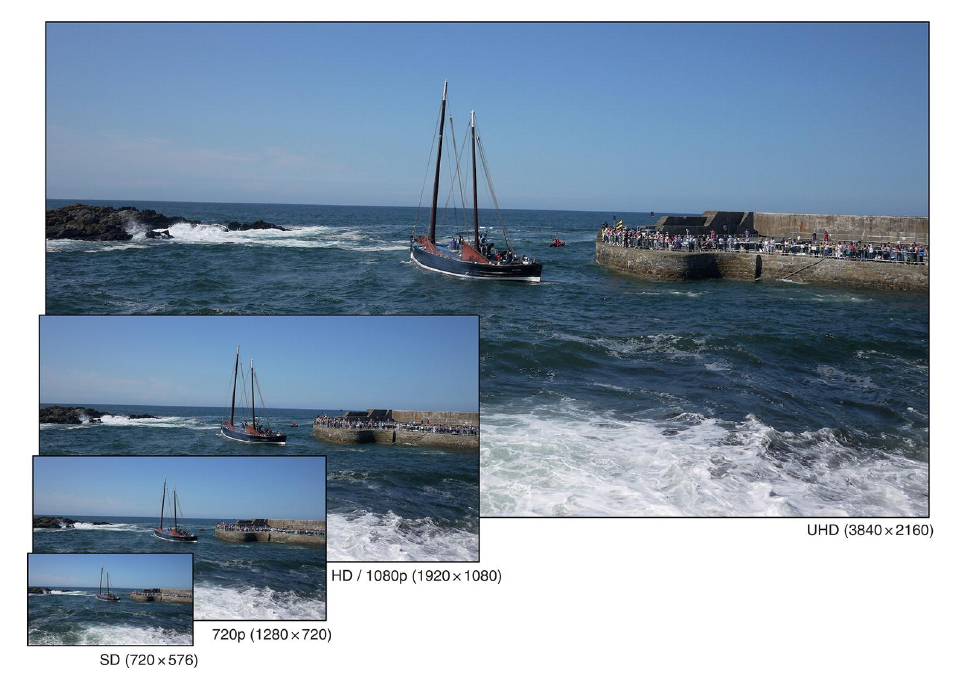
尽管我们拥有的存储容量和网络带宽比以往任何时候都要多,但存储和传输视频的需求仍在不断超出可用容量。到2023年,约三分之二的消费级电视机已达到4K分辨率或更高。将高性能视频编解码器集成到智能手机和电视等消费设备中,以及对高分辨率视频的期望,使得在存储或传输前压缩或编码视频,并在显示前解码视频成为常态
Elasticsearch in Action, Second Edition(待补充)
- 出版于2023年(第2版),出版商:Manning,作者:Madhusudhan Konda。
- 为什么不用Solr
概述
传统的数据库仅能返回普通的查询结果,而若是要实现智能提示和多样化搜索,就需要搜索引擎这些经过了优化处理的数据库来解决了.
Es的底层引擎为使用Java编写的Lucene,再在外面套了一层符合Rest规范的API,然后还有一个配套的前端管理程序Kibana.
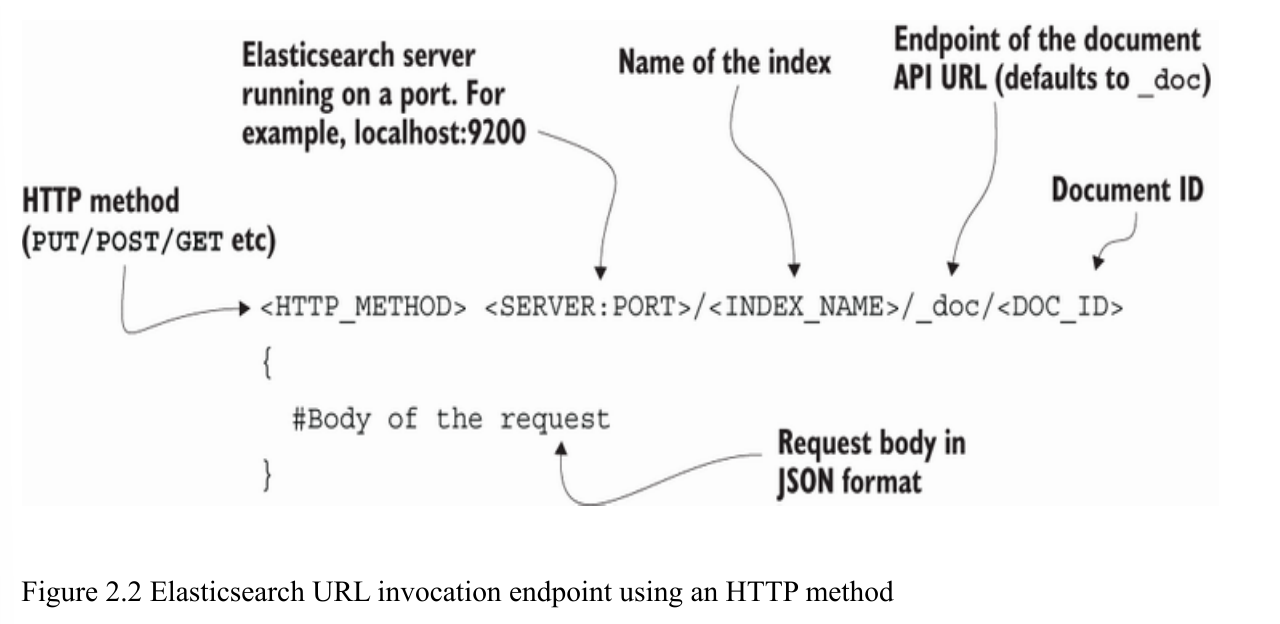
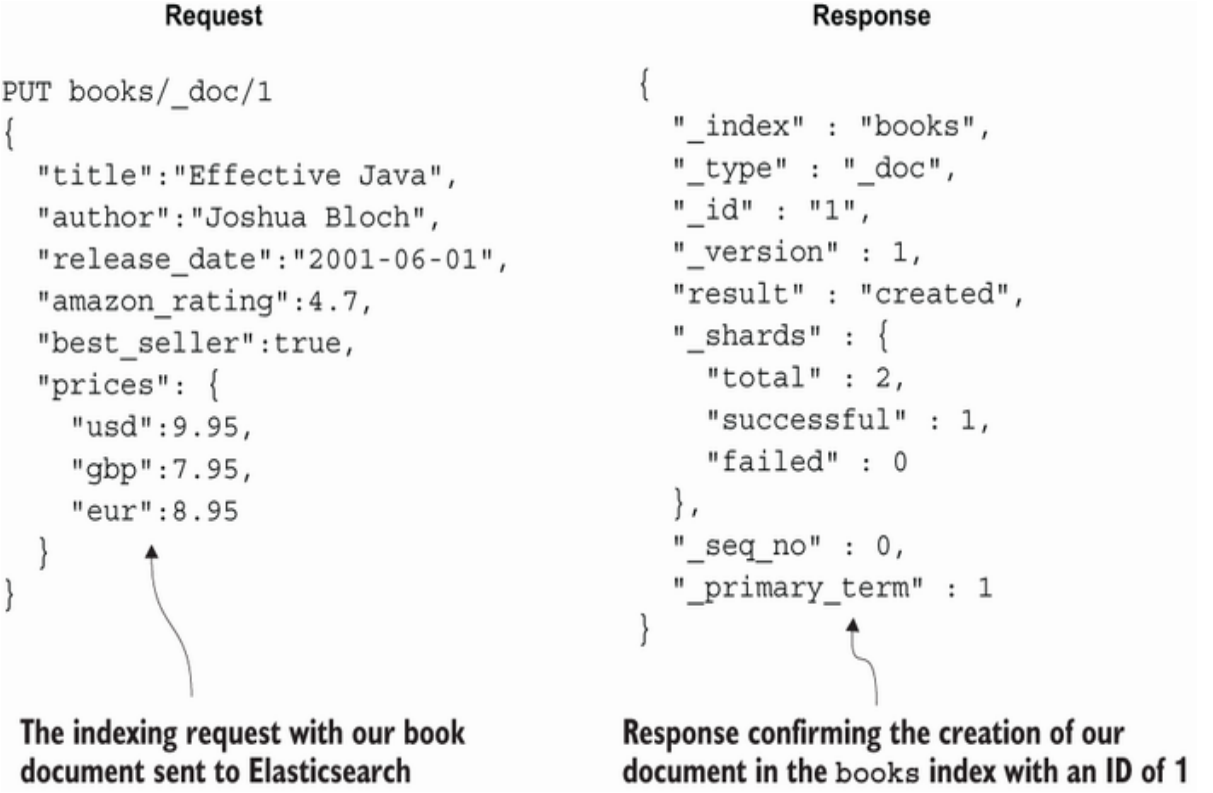
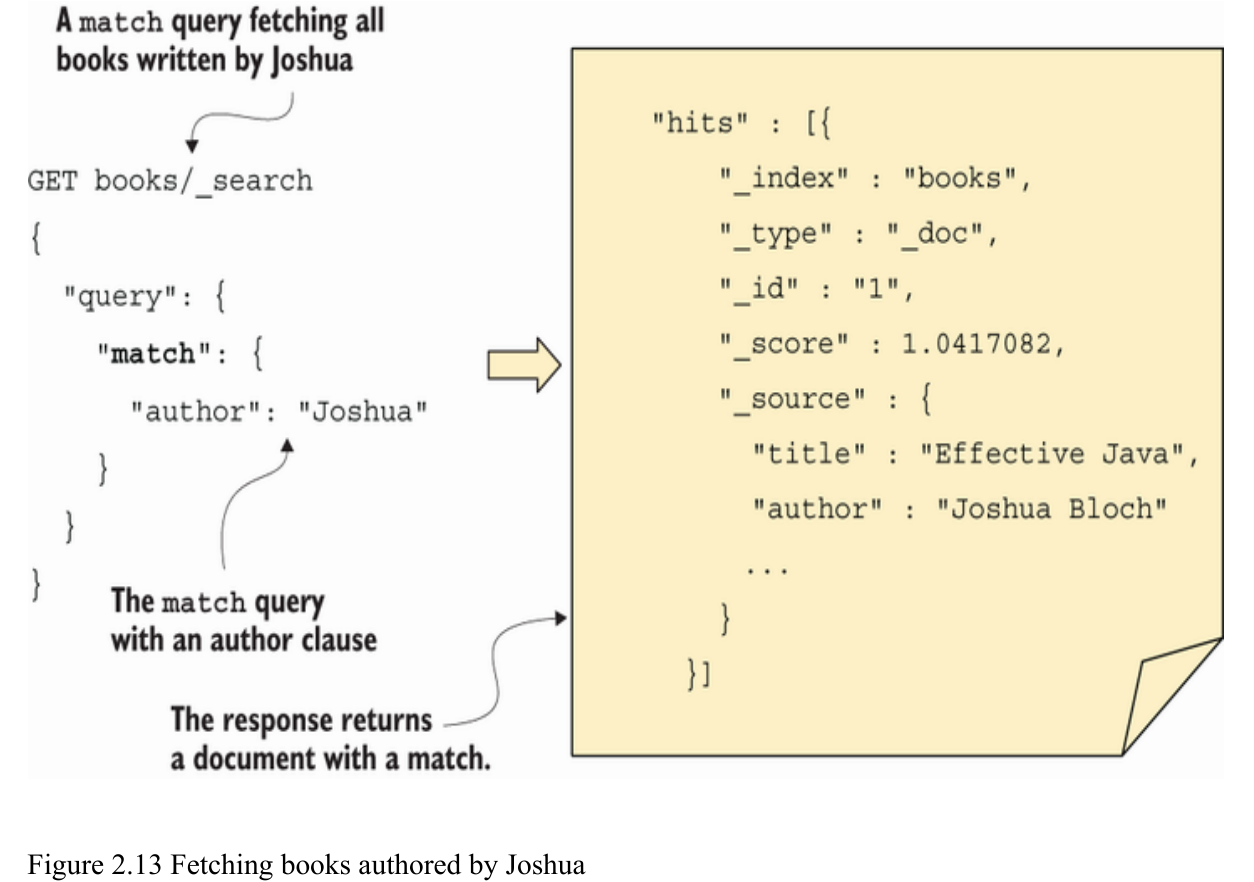
到这里我们也看明白了,Es的使用方法就是通过Restful API来传输Json文档而已,这种方法非常高效,而且掩盖了背后的复杂优化过程.
- 不过,也只有搜索引擎才能这么干,毕竟搜索请求都是幂等的,所以不会受到并发的困扰.而对于普通的数据库来说,只好老老实实地通过底层驱动连接了,如果有人能够想到更美妙的解决方法,诺奖不说,图灵奖是绝对有的.
Elasticsearch has an algorithm called Okapi Best Match 25 (BM25), which is an enhanced term frequency/inverse document frequency (TF/IDF) similarity algorithm that calculates the relevancy scores for the results and sorts them in that order when presenting them to the client.
而在执行搜索时,我们也可以手动给关键字分配对应的权重,来返回自己想要的搜索结果,而在我们平常的搜索时,这一过程都是自动进行的.
架构
Elasticsearch按节点和数据类型对数据进行分类。每个节点都有一个专用文件夹,其中包含若干存储相关数据的桶。Elasticsearch会根据每种数据类型创建一组桶(在Elasticsearch术语中称为索引)
分片是 Apache Lucene 的物理实例,是幕后将数据存入和取出存储的关键载体。换言之,分片负责数据的物理存储与检索工作。从 7.x 版本起,默认情况下新创建的每个索引仅配备一个主分片和一个副本
主分片负责存储文档,而副本分片(简称副本)顾名思义是主分片的副本。每个分片可以有多个副本,也可不设置副本,但这种方式不推荐用于生产环境——在实际生产环境中,通常会为每个分片创建多个副本。副本存储着数据副本,既能提升系统冗余度,又能帮助加速搜索查询。
Systems Performance,2nd edition(待补充)
- 出版于2020年(第2版),作者:Brendan Gregg。
ch1: 介绍
讲的特别好,很适合运维来看
ch2: 方法论
术语和模型
Head First Design Patterns, 2nd Edition
ch1: 策略模式(STRATEGY)
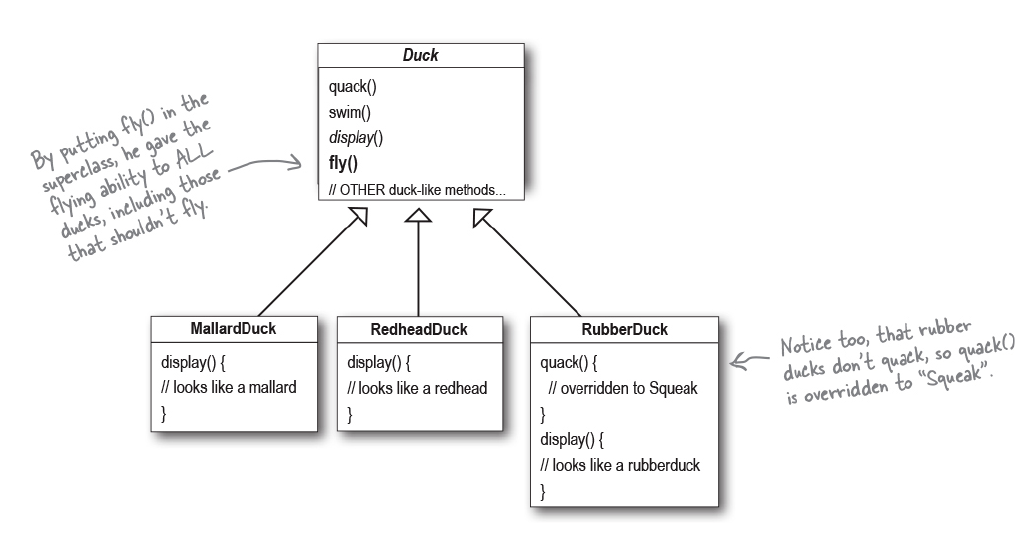
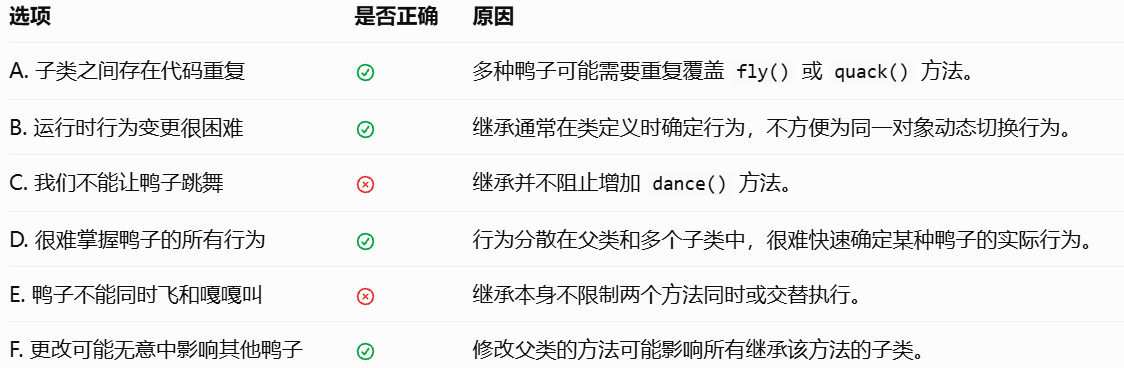
使用继承(Inheritance)实现鸭子行为时存在的问题如下:
一个简单的方法是拆分接口:
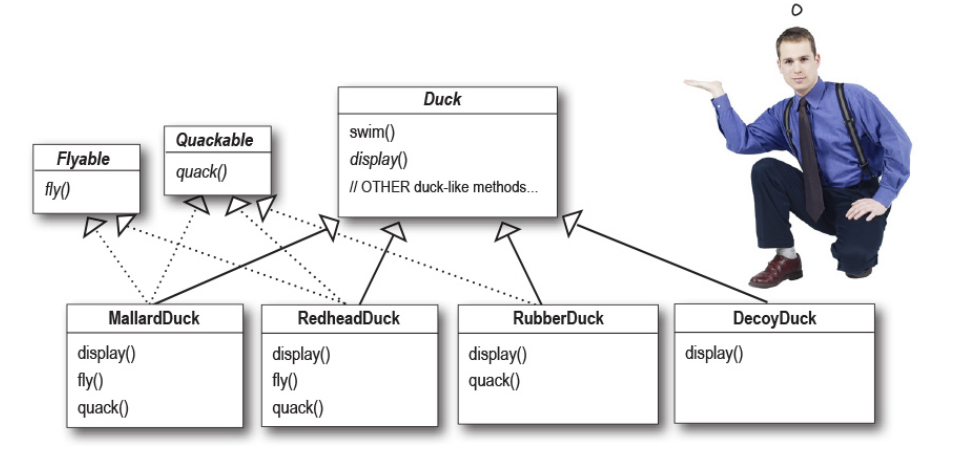
原则1
所以我们知道使用继承并不理想,因为鸭子的行为在子类之间不断变化,而并非所有子类都适合拥有相同的行为。Flyable 和 Quackable 接口起初听起来很有前景——只有真正会飞的鸭子才会是 Flyable 等等——但 Java 接口通常没有实现代码,因此无法重用代码。无论哪种情况,每当需要修改某个行为时,通常都不得不去查找并修改所有定义了该行为的子类,这很可能还会引入新的 bug!
如果你的代码中某些部分会随着每个新需求而改变,那么你就知道你需要将这种行为提取出来,并与所有不变的部分分离
这个概念虽然简单,却是几乎所有设计模式的基础。所有模式都提供了一种方法,允许系统中的某些部分独立于其他所有部分而变化
原则2
我们将fly这个行为单独作为接口,并由实类继承,而非特定的Duck子类继承:
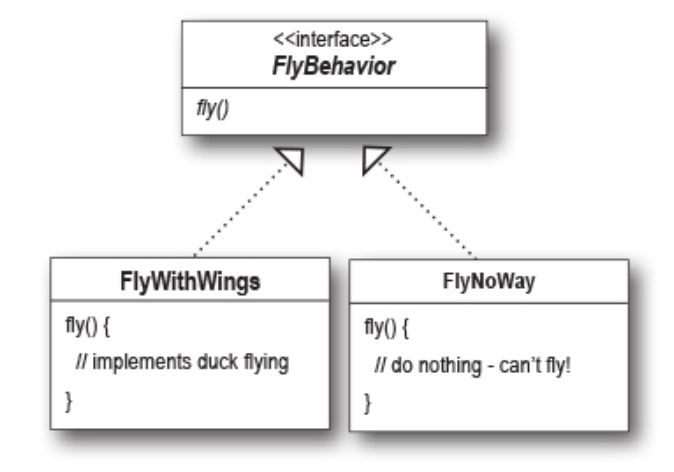
如此一来,我们的接口实现就与某个具体的子类无关了,从而避免代码被特定的对象绑定.
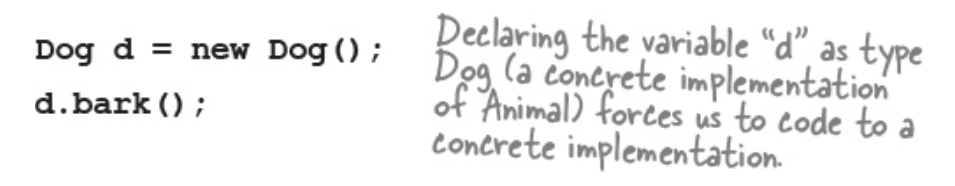
Programming to an implementation would be:
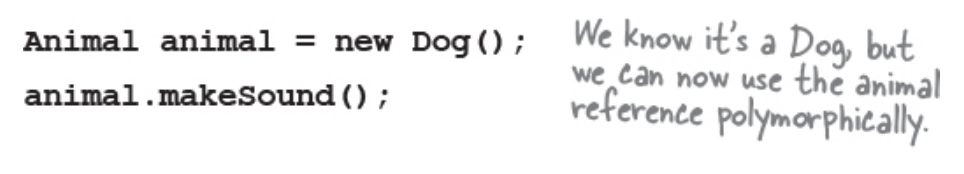
programming to an interface/supertype would be:
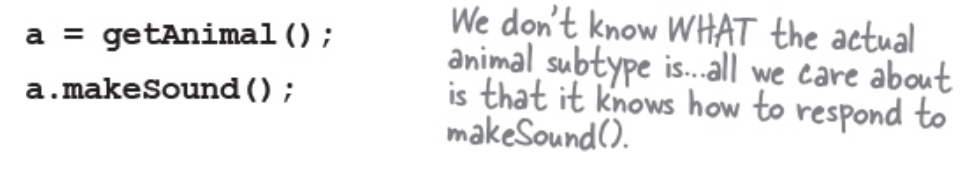
一个更好的方法是将实例封装起来,只在使用时传入:
ch2: 观察者模式(Observer Pattern)
Readings in Database Systems,5th edition(待补充)
前言
我们既选择了数据库早期文献中的经典传统论文,也选择了近年来对事务处理、查询处理、高级分析、Web 数据和语言设计等领域产生重大影响的论文。每章都附有简短导读,介绍相关论文并说明选取它们的原因。
ch1: background
介绍了HDFS,data lake,列式存储等新领域
ch2: 传统的RDBMS
介绍了数据库原型System R,数据库新秀Postgres和分区数据库Gamma,都是相当重要的论文.
很值得看,但现在看还是有点早了
Apache Kafka in Action(待补充)
ch1: 介绍
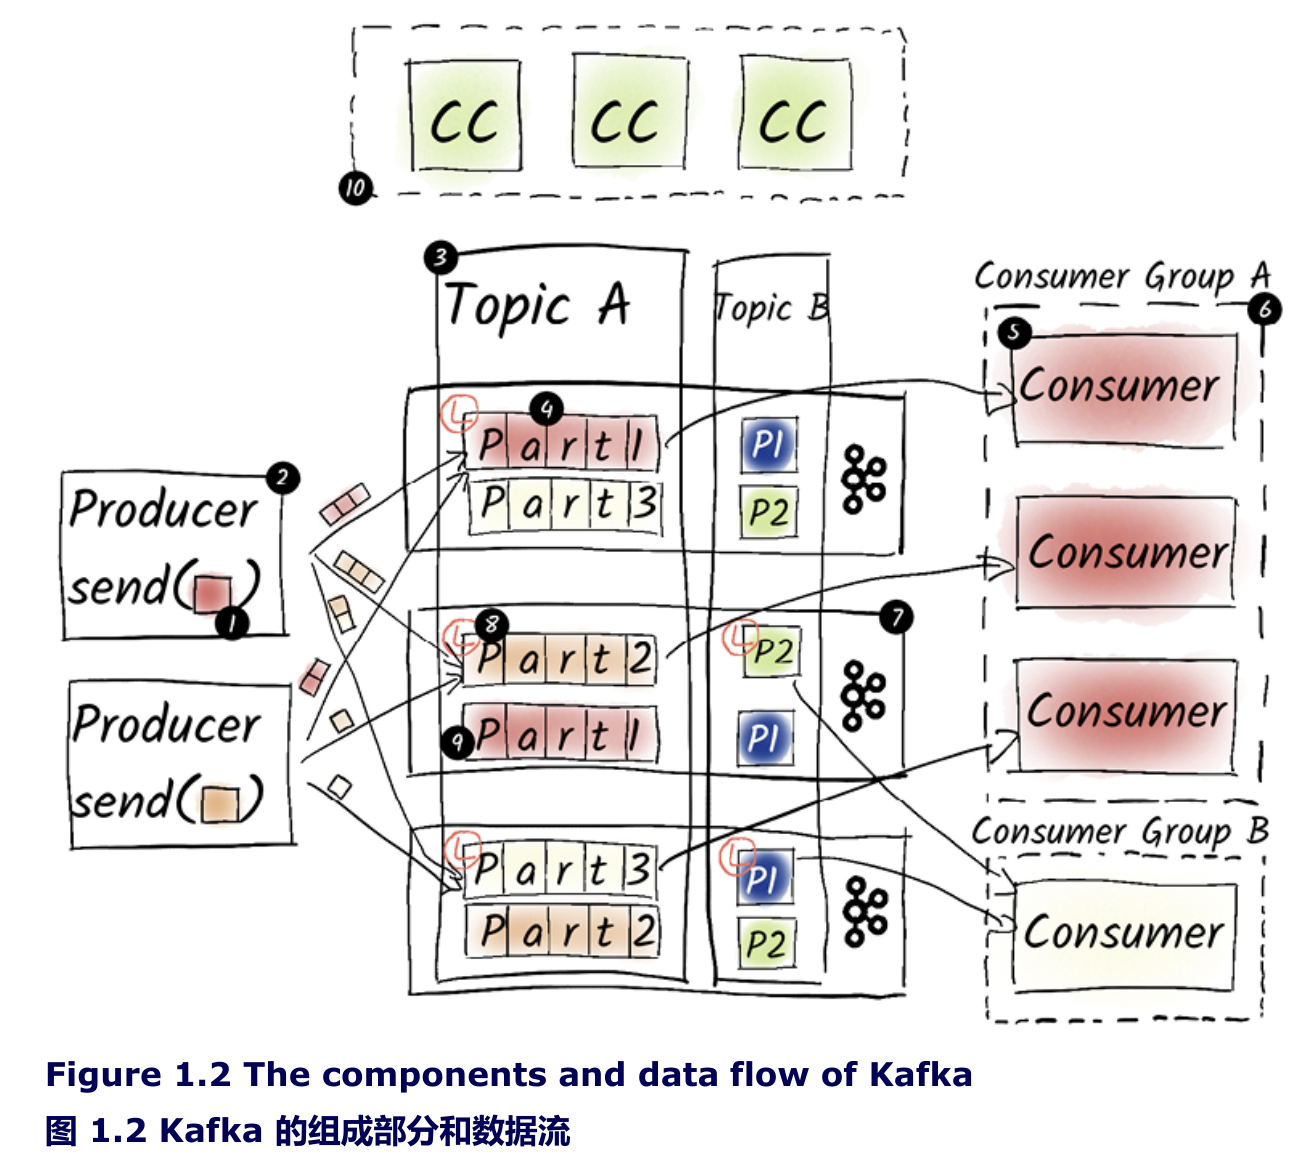
Kafka 是一个强大、开源、分布式的流式处理平台,它从根本上改变了组织处理数据流的方式。Kafka 的核心功能是持久化、分布式地记录组织的所有数据事件。
ch2: 入门
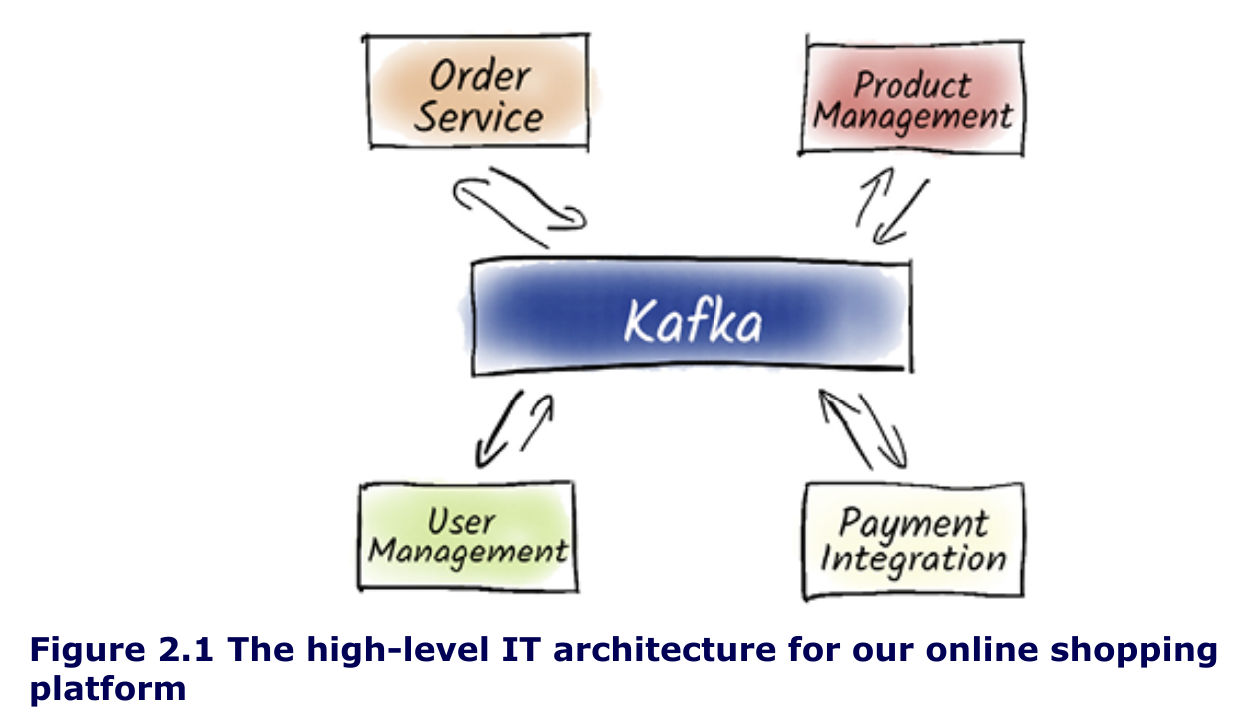
Kafka 默认保留数据七天,但我们也可以设置不删除数据,与go中的channel还是不一样的.
我们已成功完成第一个 Kafka 用例,该用例涉及 Kafka 的数据读写操作。首先,我们使用 kafka-topics.sh 命令行工具创建了一个名为 products.prices.changelog 的主题,用于存储所有产品的价格变动。接下来,我们使用 kafka-console-producer.sh 命令将数据写入该主题,捕获价格更新。随后,我们使用 kafka-console-consumer.sh 命令读取并显示这些数据。此外,我们还通过使用多个生产者并行生产数据并使用多个消费者同时读取数据,进一步探索了 Kafka 的用法。通过在 kafka-console-consumer.sh 中使用 –from-beginning 标志,我们访问了历史数据。通过这个过程,我们熟悉了如何使用 Kafka 的命令行工具进行数据读写操作。
补充: compose部署+ui管理
| |
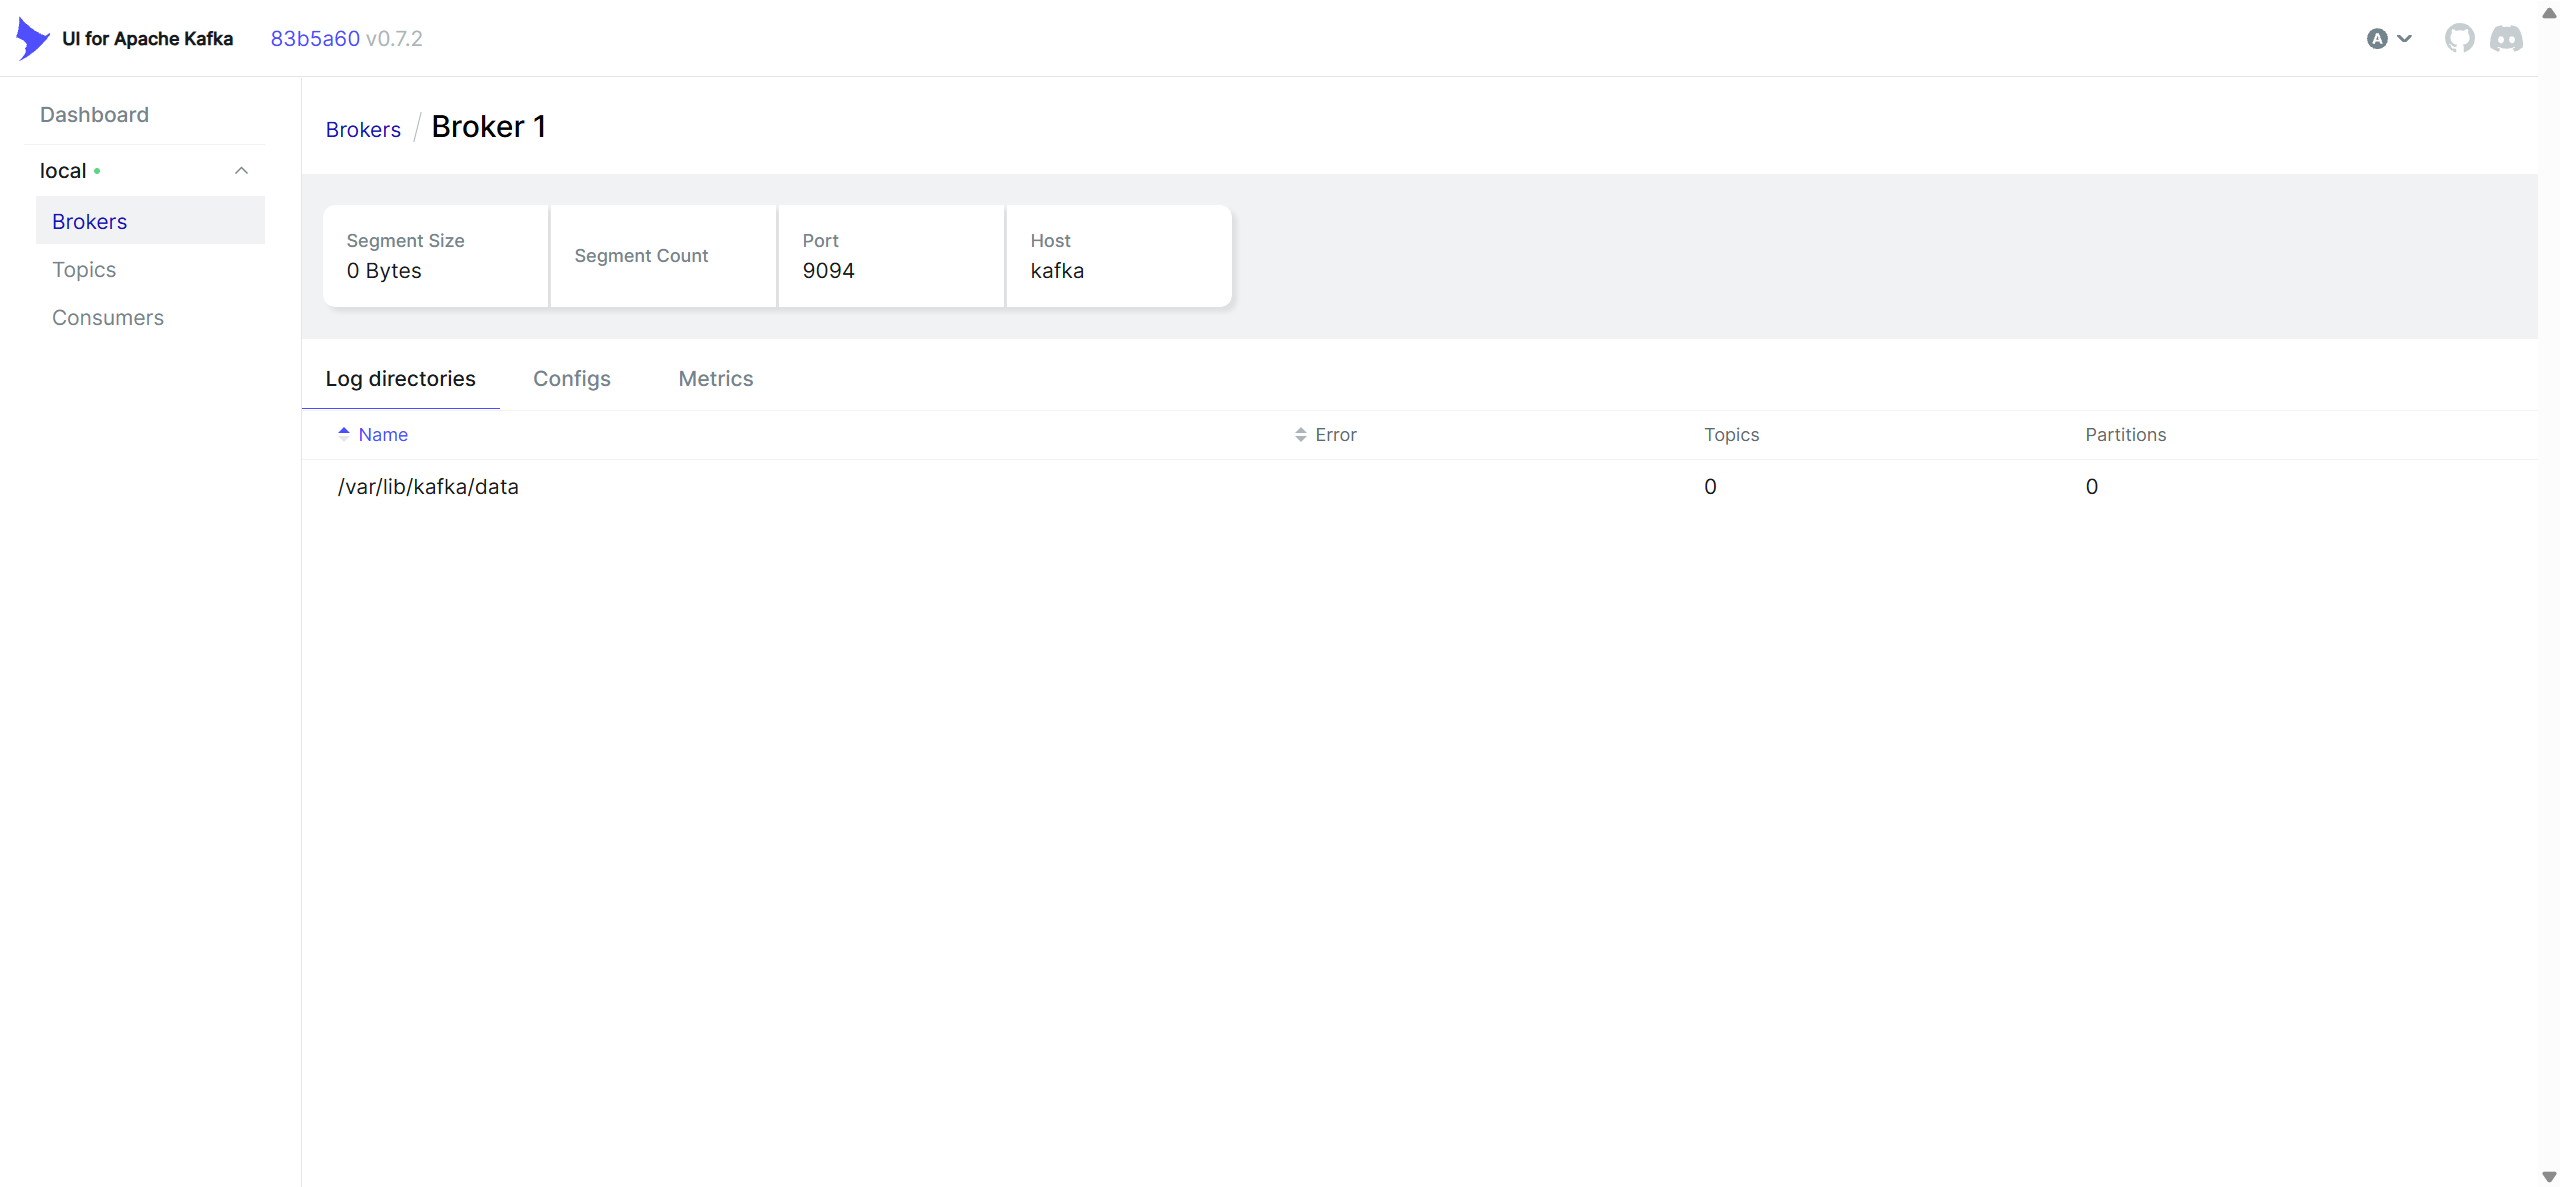
看了ui图就能明白,kafka集群只负责创建broker,topic和partition.而producer和consumer通过broker进行信息传输.
ch3: Kafka topic and messages
Kafka topics就像是数据库中的表,可以有多个Partition,类似于数据库的备份
比如我创建了3个broker,然后只创建了一个topic,这个topic有两个partition,每个partition有两个副本,那么这总共有4个partition,需要有两个Leader:
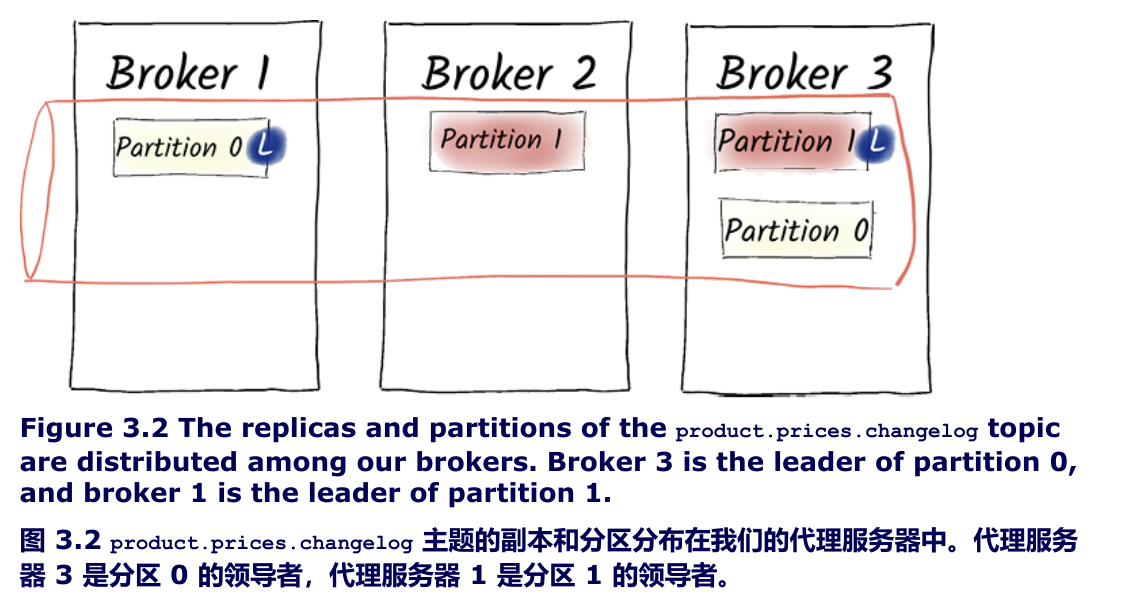
Broker1是Partition0的Leader,Broker2是Partition1的Follower,而Broker3是Partition1的Leader,是Partition0的Follower.
- 当 Producer 向 Partition 1 发送新消息时,消息首先写入 Broker 1 上的 Leader 副本。
- Broker 3 随后从 Leader 拉取新消息,复制到自己的本地日志中。
换句话说:
- 一个 Partition 在同一时刻只能有一个 Leader。
- 一个 Broker 可以是多个 Partition 的 Leader,也可以同时是其他 Partition 的 Follower。
- 不同 Topic 的 Partition 也可以由同一个 Broker 担任 Leader。
一般来说,partition的分布是由kafka来将负载均匀分配的.例如,我们再加一个partition的话,结构就会变成这样:
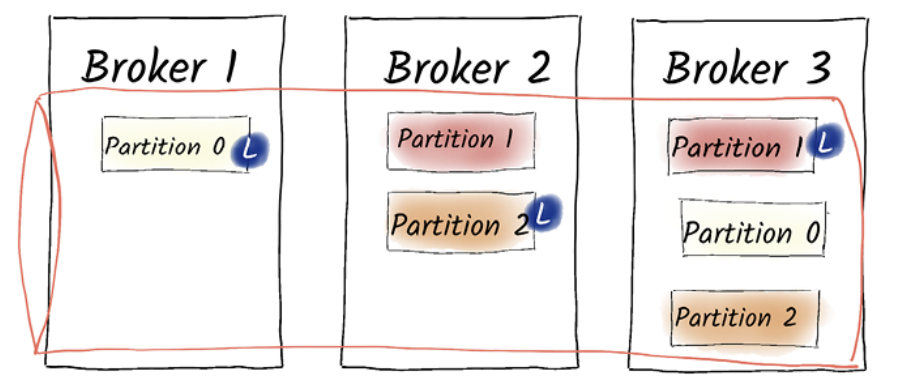
Leader负责接收和发送消息,而Follower负责实现数据冗余,在Leader故障后接管.
messages
Kafka 对数据类型没有限制,这意味着它内部只处理byte序列,具有高度的灵活性.
唯一需要记住的是,Kafka 针对处理大量小消息进行了优化。消息的最大大小被限制为 1 MB。虽然我们可以调整这个值,但应该避免这样做,因为过大的消息会严重影响性能和资源使用。那么,大量小消息究竟意味着什么呢?极端情况下,这意味着像 LinkedIn 这样的公司在 2019 年每天使用 Kafka 处理大约 7 万亿条消息(不是 70 亿条)。需要注意的是,LinkedIn 当时并非只有一个 Kafka 集群,而是大约 100 个 Kafka 集群。即使是规模较小的部署也能让我们快速处理大量消息。
ch4: Kafka 作为分布式日志
logs
日志是一个事件列表,支持两个操作:
- 写入: 新条目被添加到列表末尾
- 读取: 可以从某个特定条目开始读取,通常会一直读到末尾.
而kafka会根据消息传入顺序自动编号,非常适合存取无穷无尽的日志条目
分布式原理
当我们对系统进行垂直扩展时,我们会得到更强大的系统。例如,我们不再使用配备 8 个 CPU 核心和 16 GB 内存的数据库服务器,而是使用配备 64 个 CPU 核心和 256 GB 内存的服务器,希望获得更好的性能。这是一种提升系统性能的简便方法,并且在短期内效果显著。然而,可靠性却并未得到改善。大多数情况下,当我们用更强大的服务器替换旧服务器时,故障概率并不会显著降低。
如果我们对一个topic设置多个partition,那么kafka就会自动将传输到topic的消息负载均衡到各个partition上,如此一来,读取的时候就可能出现顺序问题.
一个顺序机制是key,我们可以显式设置让consumer传输消息时带上key,同时还可以自定义采用的key分隔符,挑选partition的方式是通过hash(key)的方式实现的:
| |
由此一来,有相同key的消息就会被传输到相同的partition,从而保证相同partition中的消息是有序的:
| |
这特别适用于用户个人消息的传输,也就是说每个用户的消息都对应了一个独特的key,并能够存储在一个partition中,保证时间顺序.
现在我们可以将这些分区分发给不同的代理,从而平衡代理之间的负载。生产者独立决定哪些数据应该分发到哪些分区。如果不使用键,生产者会以轮询的方式将数据分发到各个分区,即先分发到分区 0,然后是分区 1,依此类推。如果使用键,则会将消息分发到各个分区,使得具有相同键的消息最终位于同一个分区。
消费者组: 消费者的水平扩展
在一个消费者组中,一个partition只能被最多一个消费者读取,但一个消费者能够读取多个分区.
消费者组通过内置的分配器来决定哪个分区由哪个消费者消费,我们可以设定不同的策略:
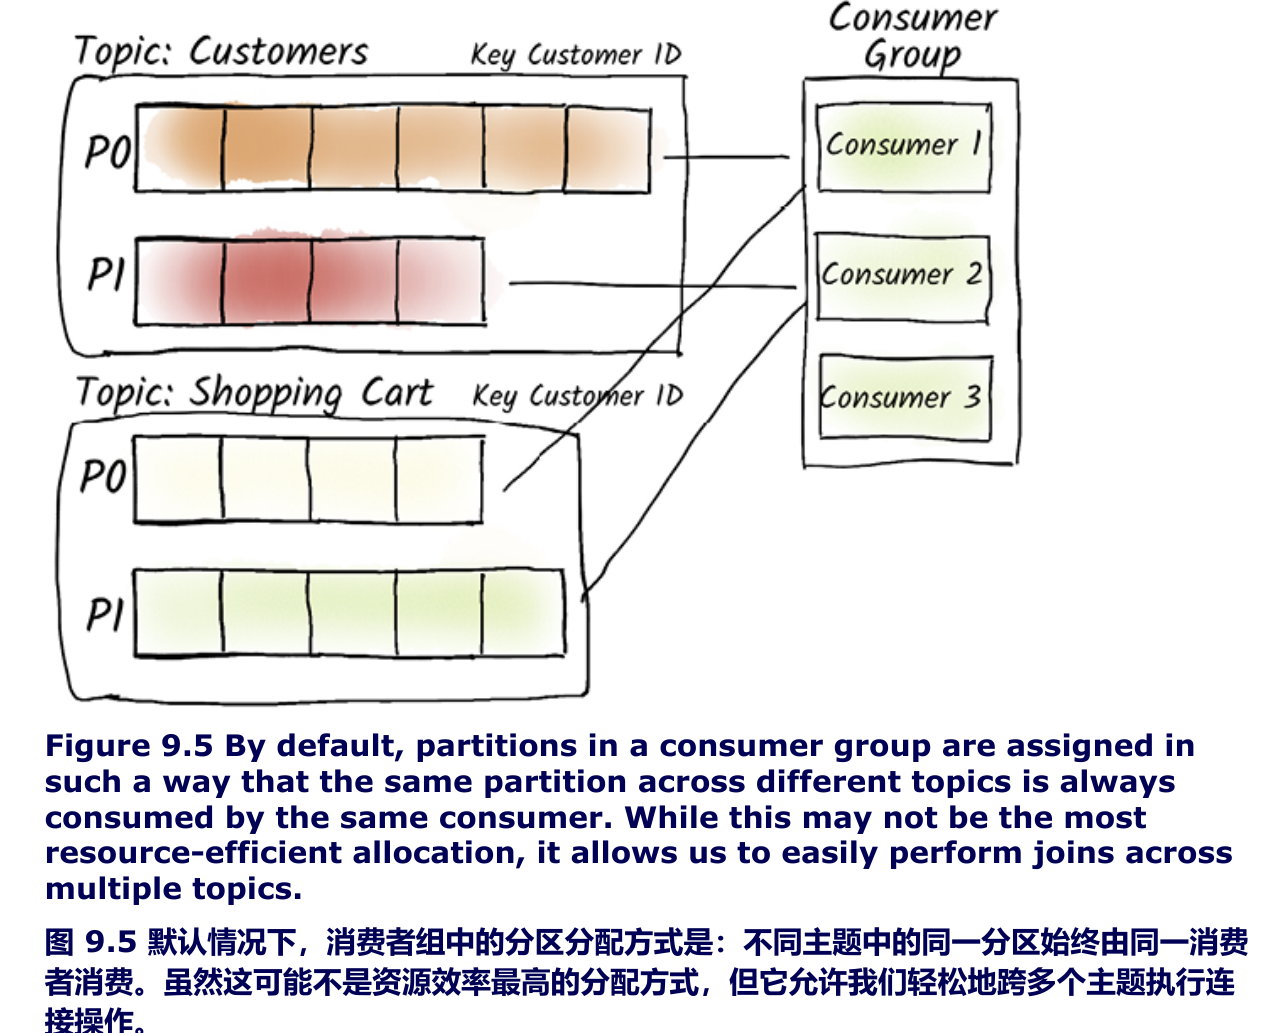
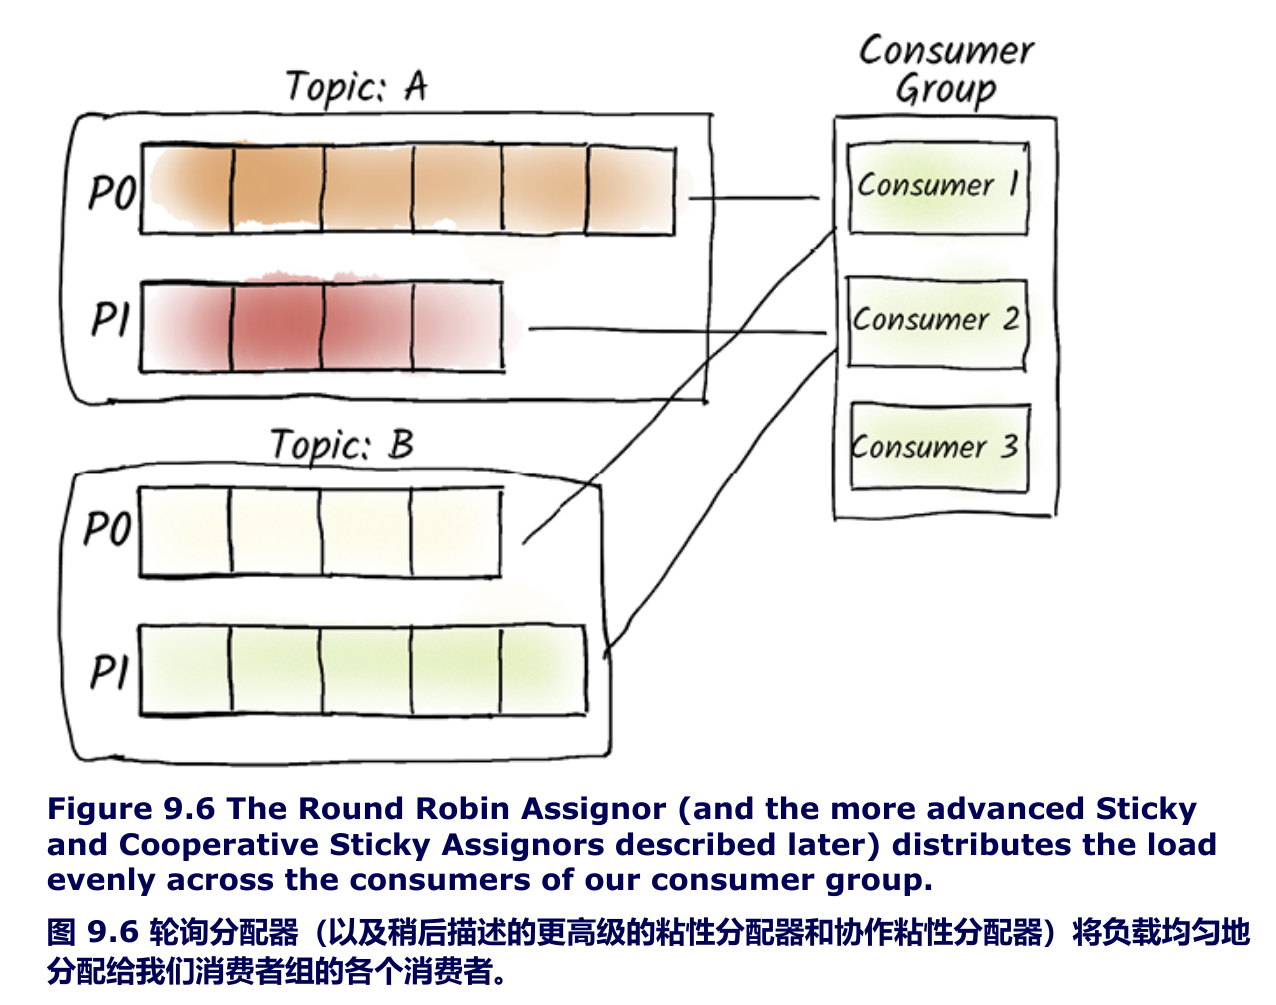
kafka的组成部分
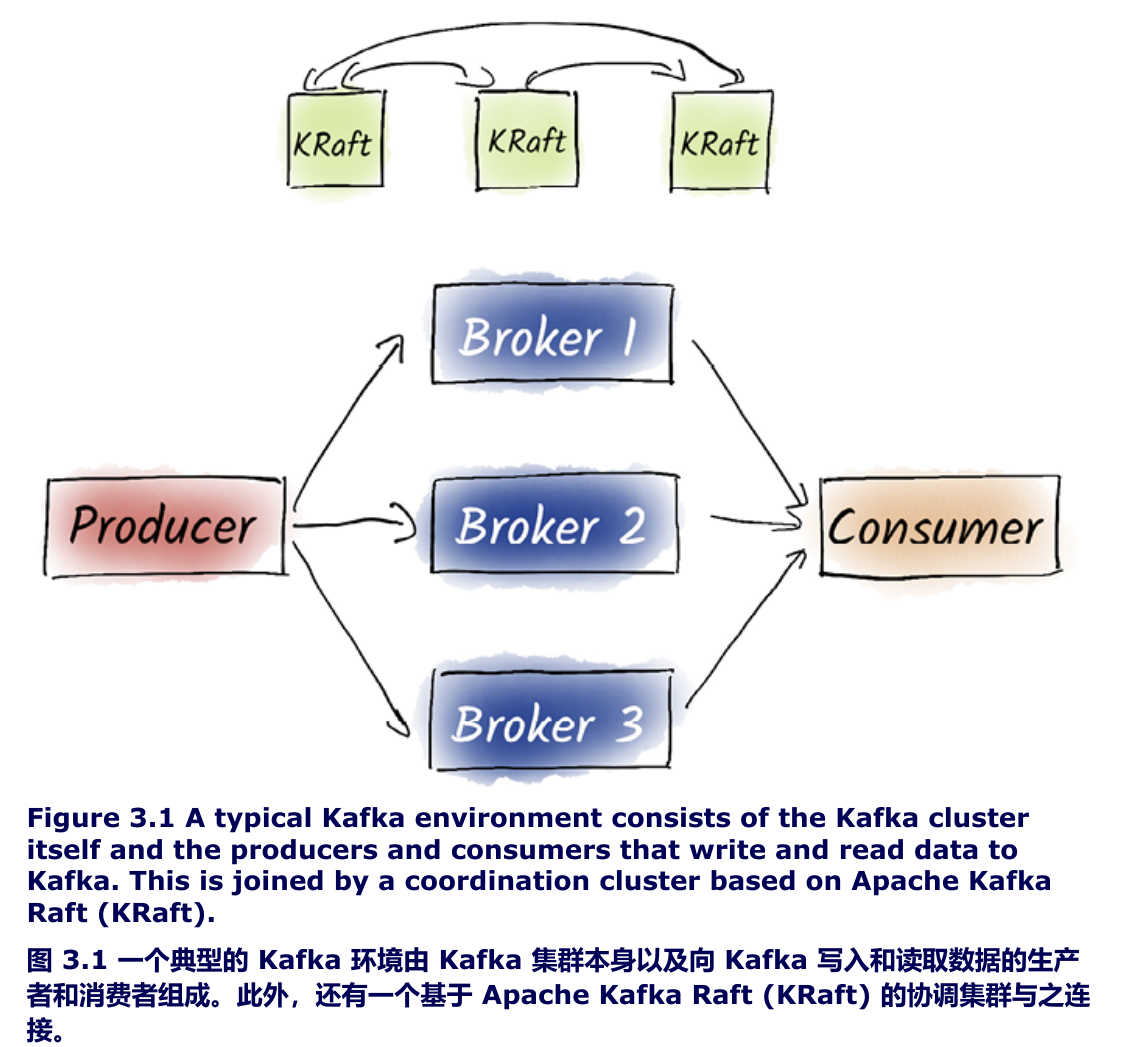
- 协调集群(Coordination cluster): 持续监控集群的当前状态,并检查所有代理是否仍然可达且运行正常。作为这项任务的一部分,它还管理所有活动代理的列表,并负责向集群添加新代理和从中移除现有代理。
- 使用Raft或者Paxos共识算法,目前kafka使用的协调集群为KRaft
- Broker: 负责接收,存储和发送消息
- Clients: 包括生产者和消费者,指的是连接到集群的任何外部应用程序
ch5: Reliability
Acknowledgments(ACK)
鉴于网络协议不能确保数据传输或者解析成功,所以Kafka使用了自己的ACK机制,确保Broker收到了Producer发送的数据.
kafka有三种ACK配置:
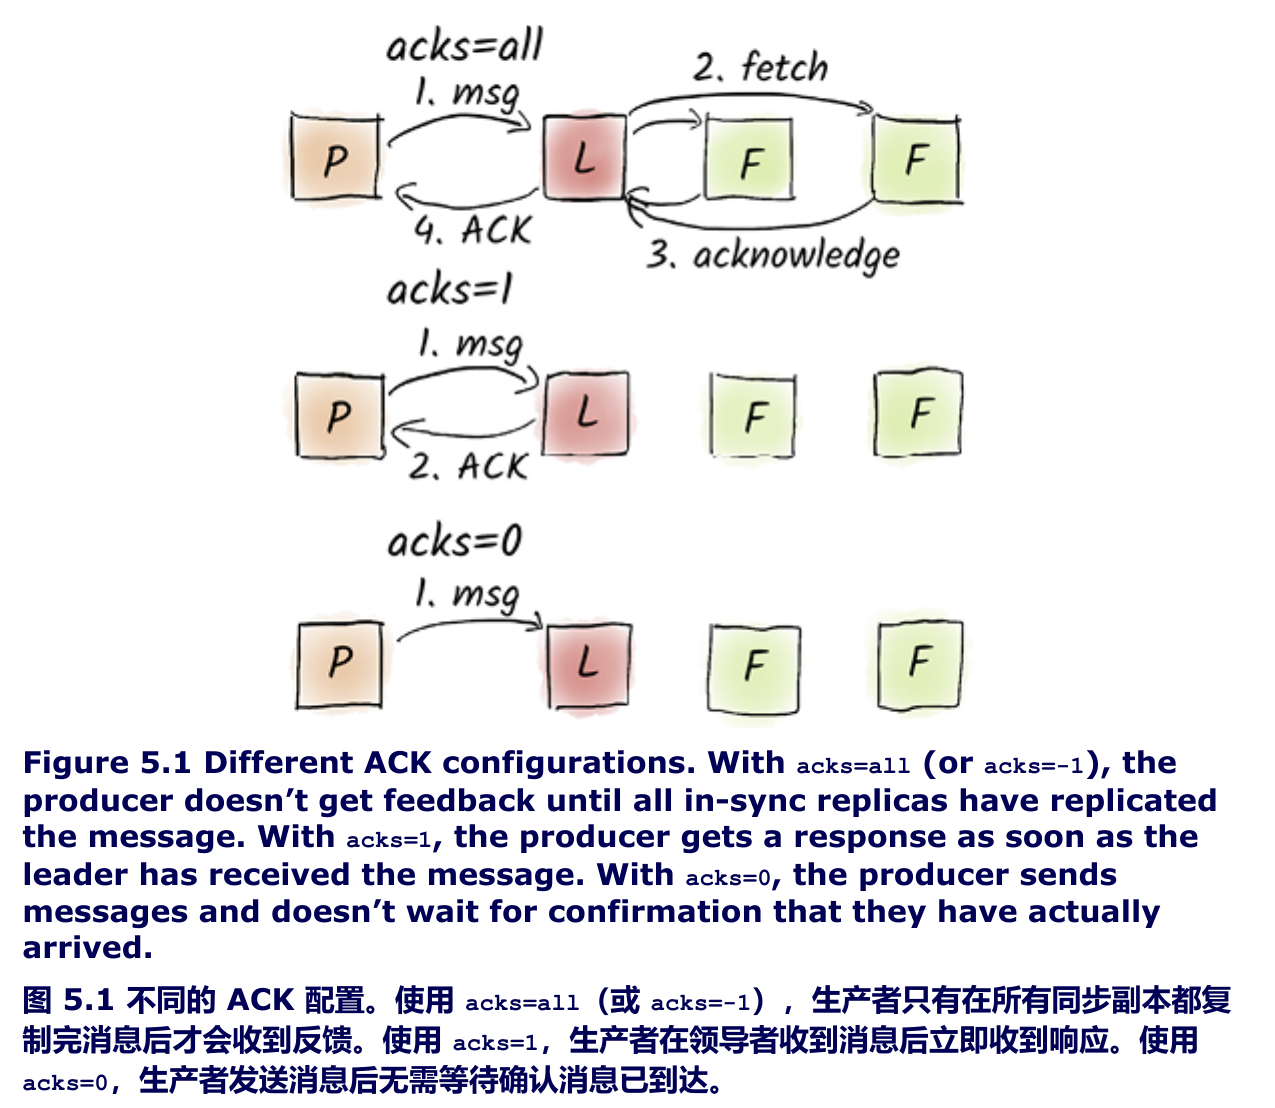
- 注意:设置 acks=-1 等同于 acks=all。
一个权衡在于,如果设置acks=0,那么消息只会被发送一次,至多持久化一次,但如果设置acks=-1,那么如果消息成功持久化,但由于网络问题,ACK未返回到Producer的话,就会触发retry机制,导致消息重复发送,这是一个非常严重的问题.
好在Kafka支持给Producer加上幂等性参数: enable.idempotence=true,如果重复发送消息,那么Broker就会检查到消息冲突,并只重发ACK而不实际存储.
Transactions
kafka支持在传输中开启事务:
| |
ch6: 性能
一些配置上的细节
ch7: 集群管理
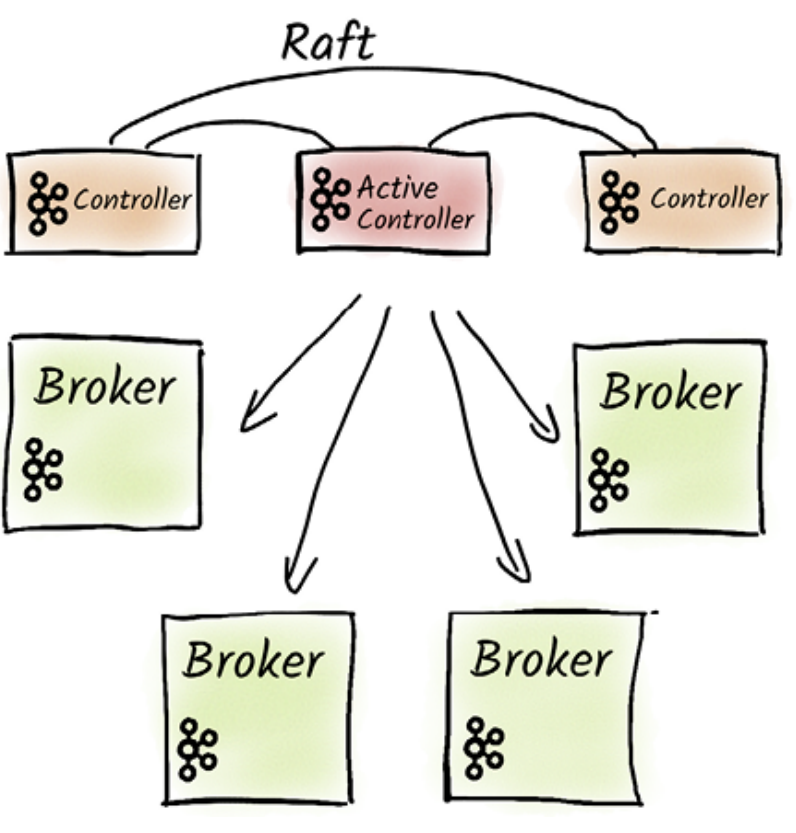
我们建议使用三到五个 controller 节点以提高可靠性,并至少配备三个broker。(四个 controller 与三个 controller 相比并无优势,因为我们仍然只能弥补一个 controller 的故障。)
KRaft和Zookeeper负责从Broker中选举唯一的Active Controller,Controller负责管理Partition和Broker.
ch8: 生成和保存消息
Producer
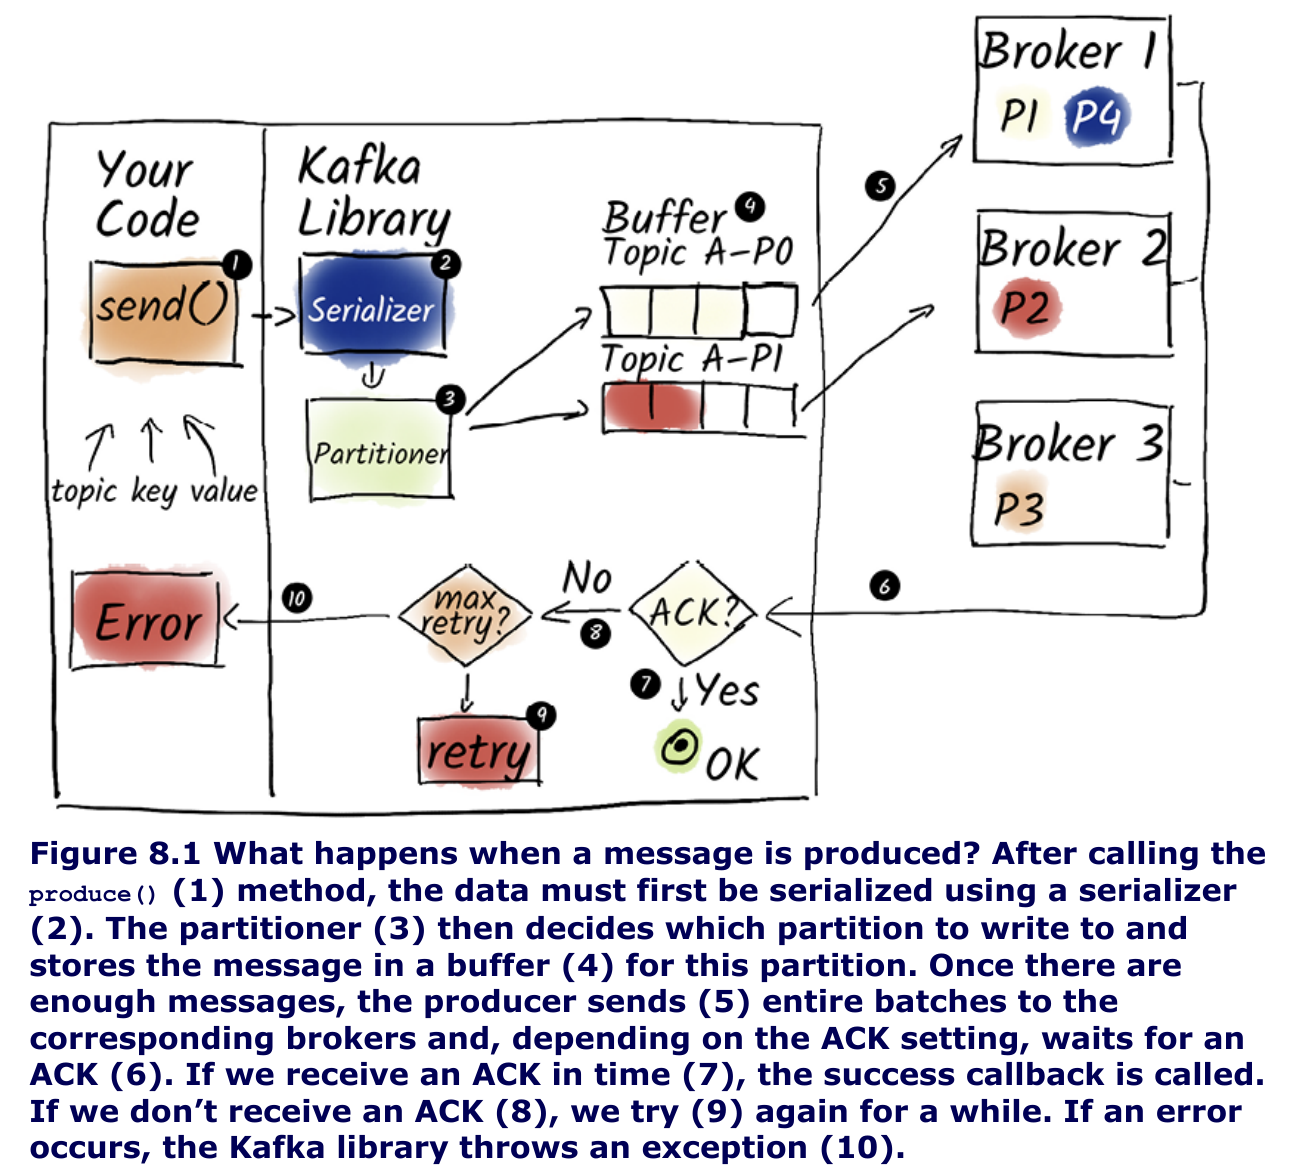
当设置ack=0时,由于不需要重发消息,所以消息进入buffer后即可批量发送,占用时间短,当设置ack=1或者-1时,由于需要确认ack到达后才能判断是否要重发消息,所以消息会一直占据缓冲区,有导致缓冲区耗尽的风险.
Broker
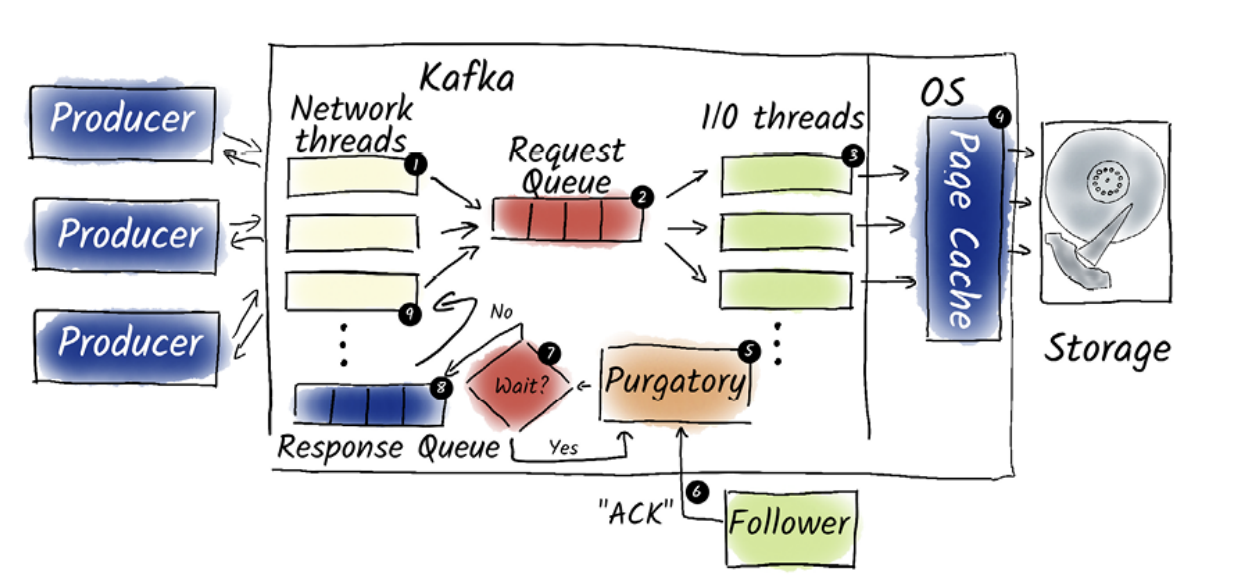
- broker接收producer的消息,放入请求队列中
- 将消息写入到文件系统中,由操作系统确保持久化
- 确认满足ack条件后,发送ack给producer
数据和文件结构
kafka在创建新主题时,首先会在元数据文件中注册该主题,然后会为topic的每个分区单独创建一个子目录,而消息则存在扩展名为.log的文件中.
分区本身又可以划分为多个segment(当分区存放的消息长度超过阈值时或者达到一定时间时自动创建新段,阈值默认为1GiB和7天),segment是存放日志文件和索引文件的最小单元:
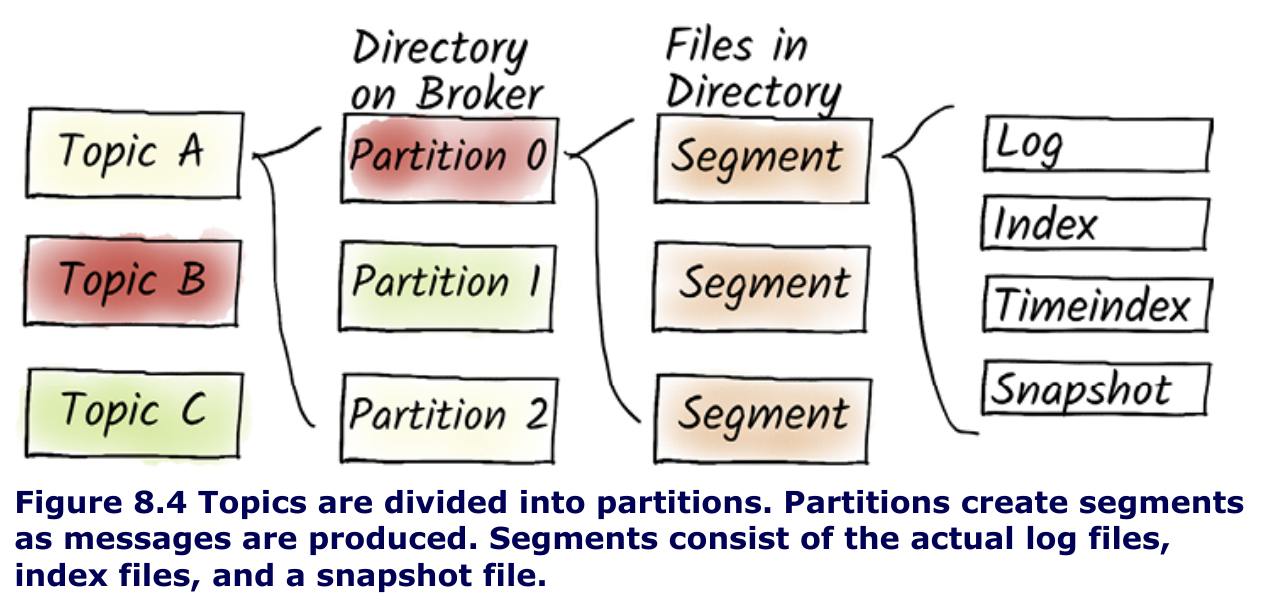
如果要删除topic,kafka会先将topic所在的文件夹标记为待删除,并在1分钟后永久删除.
Replication(待补充)
为了避免某些特别慢的副本拖累acks=all时的ack返回,kafka定义了一个In-Sync Replicas(ISR),表示能够跟上Leader Partition的对应Partition集合,如果Follower在最大延迟时间内(如30s)未能处理掉Leader的在某个阈值前的所有消息,那么就将该Partition从ISR中移除.
如果某个Partition不再响应heartbeat信号,那么也立即将它从ISR中移除.
- 只有ISR中的Partition才有资格被选为Leader
高水位线(High Watermark,HWM)是ISR中所有副本已经消费消息的位置,
- 比较繁琐,日后用到再看
ch9: Consuming messages
默认情况下,kafka-console-consumer.sh 从分区末尾开始读取,而 –from-beginning 标志则从分区开头读取。Kafka 库使用相同的默认设置。当我们启动一个消费者时,它会从读取最新的消息开始。要从分区开头开始读取,我们需要将配置选项 auto.offset.reset 设置为 earliest(默认值为 latest)。
到目前为止,我们一直认为消费者会从分区领导者那里获取消息。这种说法并不完全正确,因为自 Kafka Improvement Proposal 392 起,消费者可以从最近的副本中消费消息。
kafka通过rack参数获知哪个副本距离consumer最近,rack指的是服务器的物理或者逻辑分组,从而能够更加精细的调控consumer的消费.
在传统的消息传递系统中,系统本身会管理哪些消息发送给哪些消费者。然而,在 Kafka 中,消费者需要负责跟踪来自各个分区的消息。这意味着消费者必须记录哪些消息已经读取,哪些消息尚未读取。在 Kafka 中,这是通过offset来实现的。
生成一条消息时,它会被分配唯一的offset,第一条为0,第二条为1,以此类推,即便某些消息被删除,其他消息的offset也保持不变.
但对于消费者来说,我们希望保持服务的无状态性,而不需要主动存储消息的offset,否则一旦服务重启,就需要迁移offset数据.我们可以通过创建一个额外的offset表存在数据库里面,但终归比较麻烦.
好在消费者组记录了每个分区还有多少未读消息,称为lag(延迟),这被存储在topic之中,所以我们可以借此获知offset.
ch10: 清理消息
删除策略
Kafka有两种删除策略:
- log retention: 基于时间或者空间删除,删除所有达到一定年龄(即在特定时间之前生成)的消息
- log compaction: 基于key清理旧数据,即删除过时的key-value对,只保留最新的有效记录
我们的删除都是以segment作为最小单位的,因此只要我们定期向某个segment中写入消息,该segment就无法被log retention策略删除,因此我们呢可以针对segment中最旧的消息也做出限制.
压缩时,日志清理器的工作原理如下:
- 首先检查未压缩的段,并记录每个键的最新偏移量
- 从最早的消息开始读取。日志清理器会跳过过时的键或消息(即已被更新条目覆盖的键),并将保留的消息写入新的段。
- 一旦新段写满,旧段便会被这个干净的新段替换。
- 这也解释了为什么日志清理器最多只需要一个段大小的额外存储空间。
总结
还有很多实战内容,以后来看
博文
深入理解 AI Infra
- 姊妹书,大佬为了我们这些菜鸟真的是操碎了心.
前言
这部分非常值得一看,前沿的科研人物早就站在浪潮之上,而我们只是跟在后面拾取牙慧罢了.
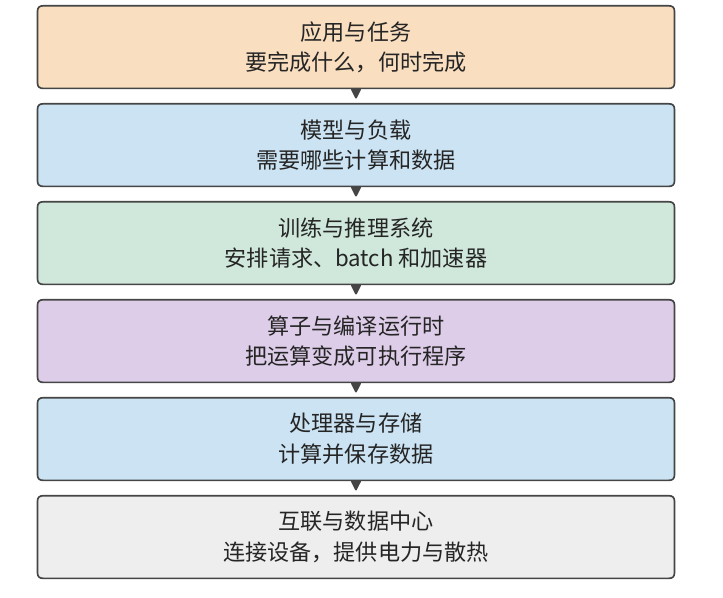
不必等到熟悉所有层次才开始阅读。做系统研究和工程实践时,我一直需要围绕具体问题,学习相邻层次的知识。遇到陌生的概念,可以先抓住它要解决的问题,再回来看实现细节。
- 看似很简单的一句话,实际上我却是深有体会.
ch1: AI Infra介绍
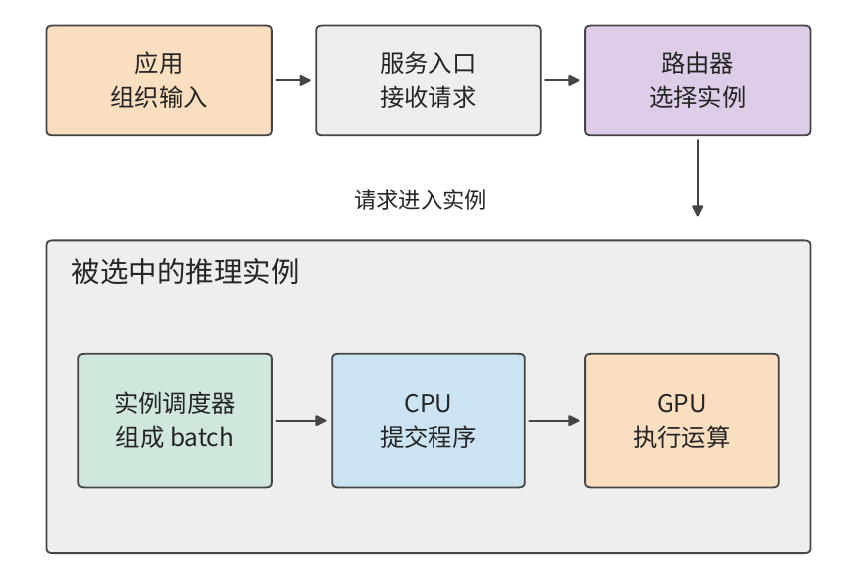
- 应用通过API传入上下文给模型服务入口
- 入口核验访问权限和请求内容后,将请求交给某个模型实例(可以是一张卡,也可以分布在多张卡上)
- 文本先被转换为token,实例调度器将传入该实例的请求编入队列中,并等待模型处理
- CPU负责向GPU提交这一次的计算任务,GPU执行正式的推理
- 模型先处理用户输入(这被称为prefill),然后逐步生成新token(这被称为decode),其中生成的KV cache可供后续位置的注意力计算使用.
- 产生的token经输出处理转换为文字,流式返回应用.
模型权重是计算中需要反复使用的数据,需要在实例启动时或者模型切换时从存储中加载,并持续存放在显存中(称为驻留),可供多次请求使用.生成时,GPU计算单元从显存中读取当前层的权重和上下文状态,完成运算后再交给下一层,在多卡实例中,我们还需要把一张卡算出的中间结果交给其他卡
先介绍一组贯穿全书的真实模型。DeepSeek V4 和 V4.1 Flash 提供了一条可以持续追踪的线索。V4 已经通过上下文压缩与稀疏访问改变存储和读取需求,V4.1 Flash 则进一步重新划分模型内部的职责。传统的 decoder-only(仅解码器)模型通常让输入 token 经过完整主干,逐层建立生成所需的状态;V4.1 Flash 采用因果编码器—解码器(Causal Encoder-Decoder,CED)架构,由编码器形成上下文表示,解码器从这些表示取得全局信息。大量输入 token 因此无需经过解码器主体的计算;生成新 token 时,模型仍依次经过编码器与解码器。输入与输出的执行路径并不对称,模型因此能针对 Agent 输入多、输出相对少的负载重新安排计算投入。
ch2: 模型架构
计算图
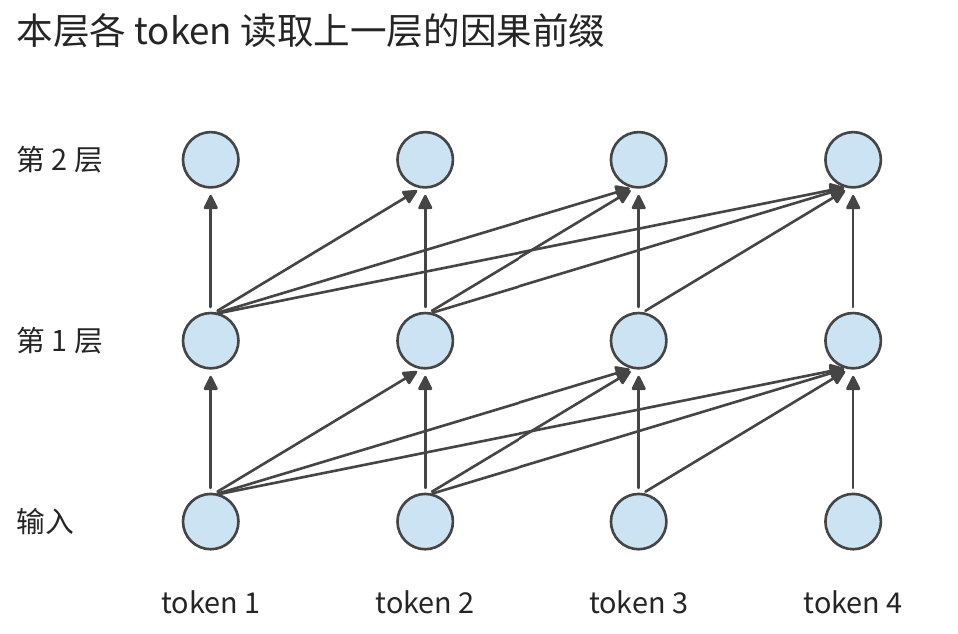
在prefill阶段,由于上一层的所有状态已知(指的是所有的输入都已经确定了),所以可以并行计算同一层中的所有token;而在decode阶段,由于每一个token都需要注意前面的所有token,所以只能串行执行.
换句话说,堆叠层之间必须串行,同一层之间在输入阶段可以并行处理.
先把一个计算节点展开。设本次对 \(m\) 个输入 token 执行投影,每个 token 用包含 \(k\) 个特征的向量表示。把这些向量逐行排成输入矩阵 \(X\),就得到 \(m\) 行、\(k\) 列的矩阵。设输出宽度为 \(n\),则有:
\[ X \in \mathbb{R}^{m \times k}, \qquad W \in \mathbb{R}^{k \times n}, \qquad Y = XW \in \mathbb{R}^{m \times n}. \]输入的token数量翻倍,运算量翻倍,但权重矩阵保持不变;输出的矩阵宽度翻倍,权重数量和运算量都翻倍.
即时消息技术剖析与实战
ch0
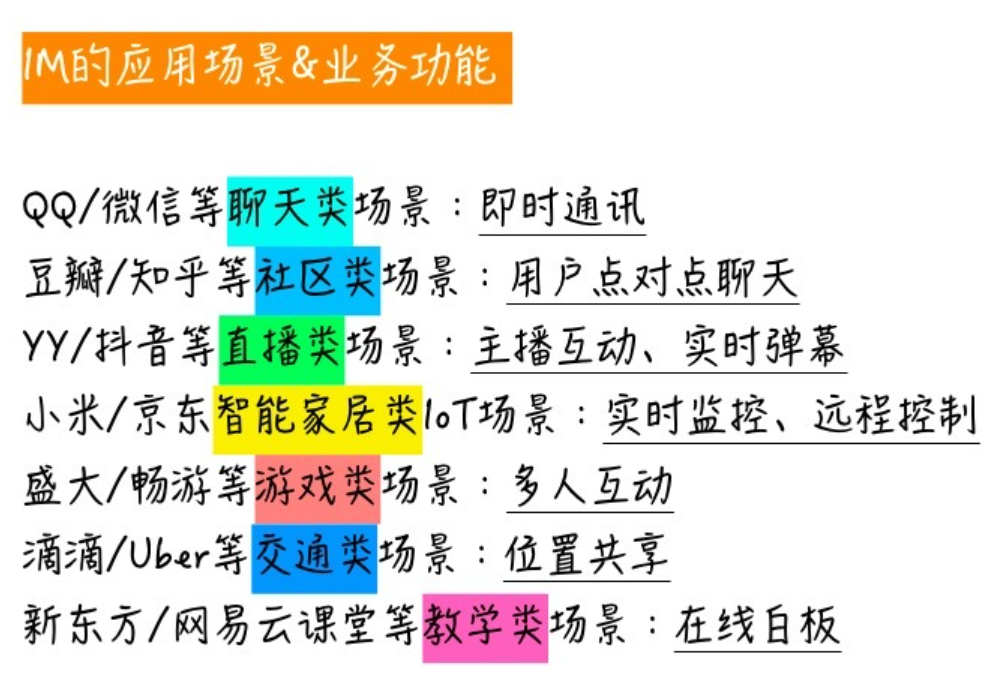
其实,除了QQ和微信外,陌陌、抖音等直播业务为主的App也都深度用到了IM相关的技术。
比如在线学习软件中的“实时在线白板”,导航打车软件中的“实时位置共享”,以及和我们生活密切相关的智能家居的“远程控制”,也都会通过IM技术来提升人和人、人和物的实时互动性。
我觉得可以这么理解:包括聊天、直播、在线客服、物联网等这些业务领域在内,所有需要“实时互动”“高实时性”的场景,都需要、也应该用到IM技术。
ch1: 架构
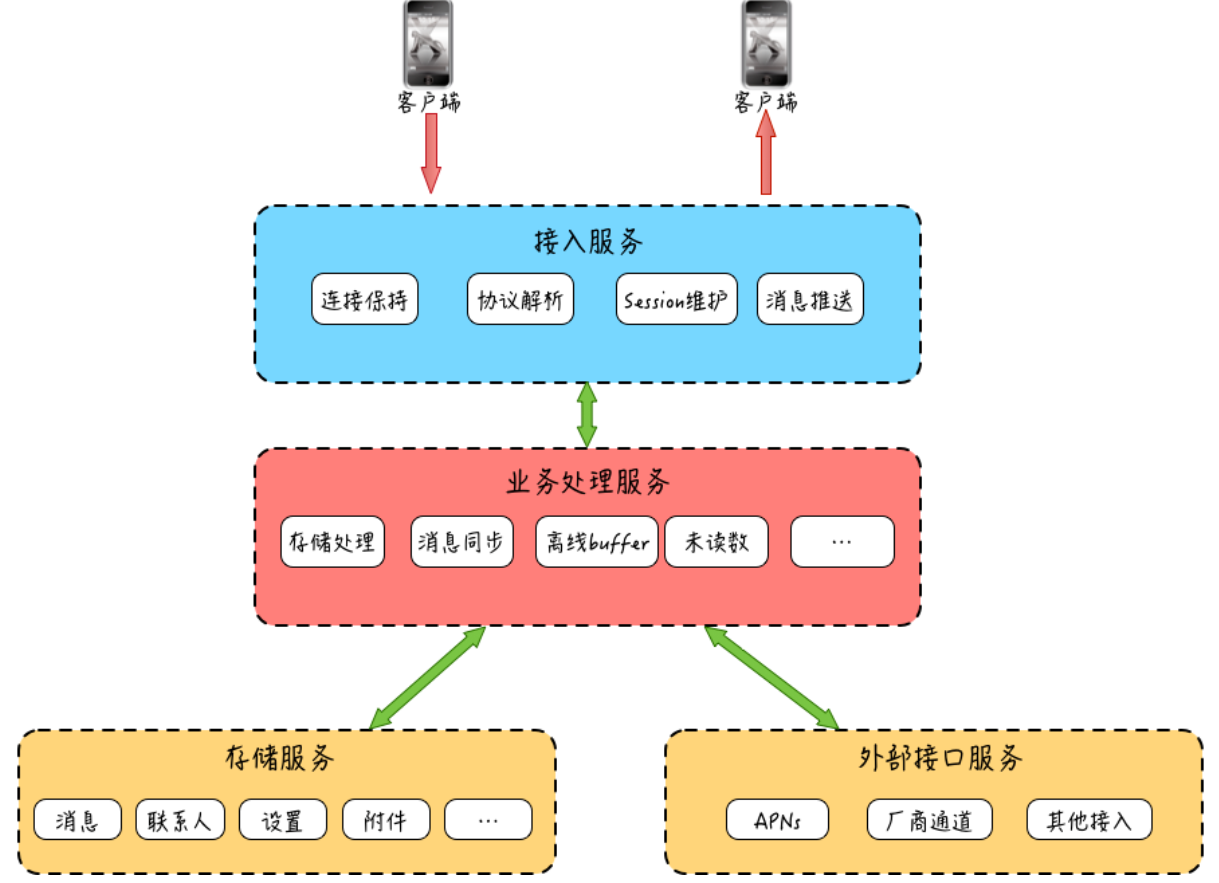
了让用户在App未打开时,或者在后台运行时,也能接收到新消息,我们会将消息给到第三方外部接口服务,来通过手机操作系统自身的公共连接服务来进行操作系统级的“消息推送”,通过这种方式下发的消息一般会在手机的“通知栏”对用户进行提醒和展示。
这种最常用的第三方系统推送服务有苹果手机自带的APNs(Apple Push Notification service)服务、安卓手机内置的谷歌公司的GCM(Google Cloud Messaging)服务等。
但GCM服务在国内无法使用,为此很多国内手机厂商在各自手机系统中,也提供类似的公共系统推送服务,如小米、华为、OPPO、vivo等手机厂商都有相应的SDK提供支持。
ch2: 收发架构
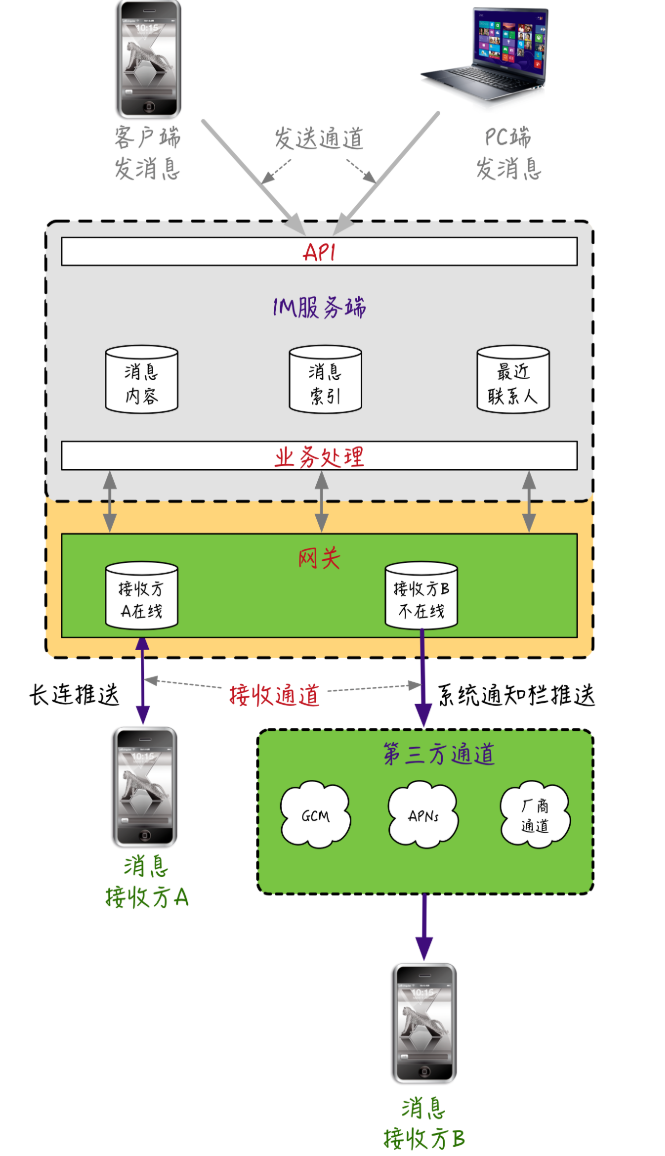
ch3: 轮询与长连接
聊天类应用的技术有一个发展历程:
- 一问一答
- 短轮询: 不断发送消息请求
- 太耗资源,负载也高
- 长轮询: 当本次请求没有新消息时,会在服务端等待(hang)一段时间,如果有新消息,就马上响应返回
- 用户量上来之后,负载还是很高
- 服务端推送: 由服务器触发消息推送,而非客户端主动触发
- WebSocket: 双方创建持久的长连接,进行随时的双向数据传输
- 同时基于TCP长连接衍生的各种有状态的通信协议,也能够实现服务端主动推送,从而更好解决“消息收发实时性”的问题。
总结
存个档,以后看
深入理解 AI Agent
- 都说了是深入理解了,所以必须要在实际用过一段时间的Agent之后再来看,才会有很多收获.
ch1: 入门
现代 Agent 系统的本质可以用一个简洁的公式来表达: Agent = LLM (大语言模型, Large Language Model)+ 上下文 + 工具
工具是 Agent 与外部世界交互的桥梁,就像人类的手脚一样,让 Agent 能够从被动的观察者变成主动的执行者。没有工具,Agent 只能“纸上谈兵”;有了工具,它才能真正改变世界。
现在的一个疑问是Harness会不会被模型内化,工具调用和任务安排曾经都需要靠外部编排,而如今都被模型内化.而原书认为,只要Harness此刻还能用,那么就一直用,模型每内化一层,Harness 就卸下一层,转而兜底新的能力前沿.
而每次调用 LLM 时的上下文由以下五个部分构成:
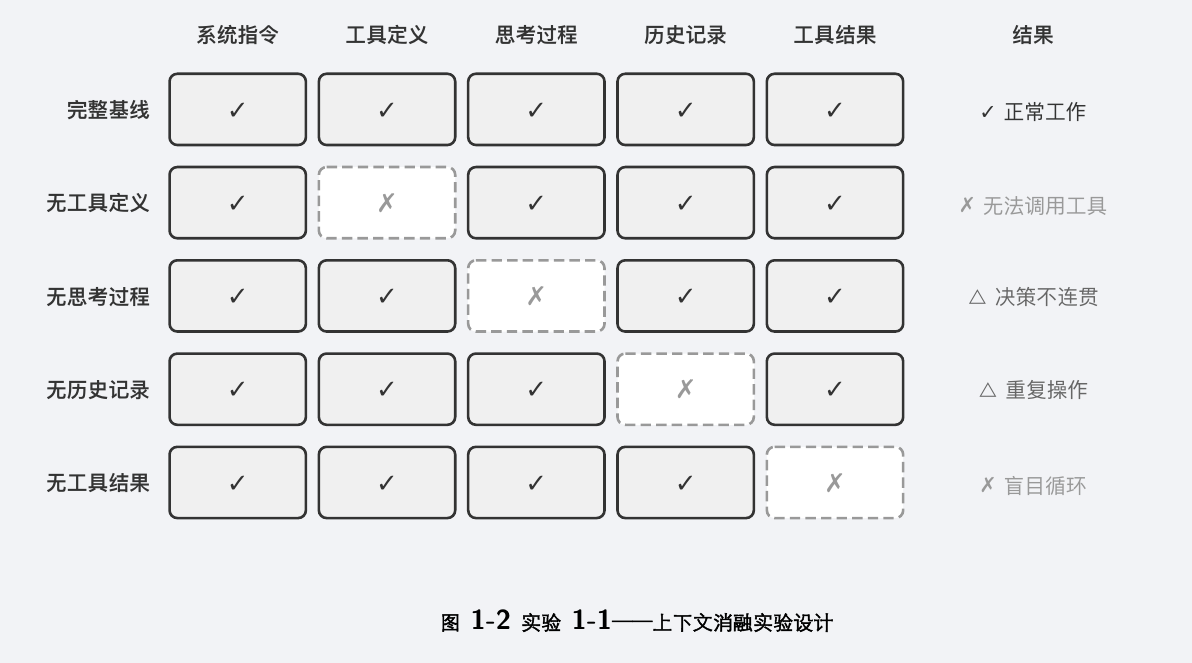
系统提示词(System Prompt):与用户每次输入的提示词不同,系统提示词由开发者编写,在整个对话过程中保持不变,相当于 Agent 的“岗位说明书”——定义它的身份、权限和行为准则。通过提示工程(Prompt Engineering)精心设计系统提示词,我们可以塑造 Agent 的工作方式。系统提示词中还会包含跨会话保存的用户记忆(用户偏好、历史行为、背景设定等个性化信息,详见第三章)和动态注入的环境状态。
工具定义(Tool Definitions):声明 Agent 可用工具的名称、功能描述和参数格式。没有工具定义,Agent 就无法识别和调用任何工具——消融实验(实验 1-1)将验证这一点。工具定义与系统提示词一起构成对话中保持不变的静态前缀(这是基础模式;2026 年以来,生产框架中工具的完整 schema 也可以按需动态加载到上下文末尾而不破坏前缀,详见第二章工具定义一节和第四章)。
用户消息(User Messages):来自用户的输入。用户消息中还可能包含通过 RAG(检索增强生成,Retrieval-Augmented Generation,详见第三章)动态检索引入的外部知识——覆盖训练数据截止后的信息或私有领域知识。
模型回复(Assistant Messages):模型之前生成的回复,最多包含三个部分——思考过程(reasoning,即内部思考链,保持思维连贯性和决策可解释性)、文本内容(content,即对用户的回复)和工具调用请求(tool_calls,即 Agent 采取行动的方式)。在一次具体的回复中,三者不一定同时出现:例如 Agent 决定调用工具时通常只有 reasoning + tool_calls,给出最终回答时通常只有 reasoning + content。
工具执行结果(Tool Results):Agent 框架执行工具后返回的结果。这些结果是 Agent 下一步思考的直接依据,也让它能够从执行结果中学习、避免重复犯错。
Harness 的核心就是原公式中的“上下文 + 工具”,再加上三层保障机制:约束(限定 Agent 能做什么、不能做什么)、验证(检查 Agent 做得对不对)和纠正(做错了怎么补救)
ch2: 上下文工程
KV Cache
KV Cache 的做法是:把前文的中间计算结果缓存下来,下一轮只需要计算新增 token 的部分。前提是前缀完全不变——只要前缀里有一个字符被改写,缓存就全部作废,模型不得不从被修改的位置重算。
使用 KV Cache 时,A、B、C、D 的 K、V 向量算过一次后就缓存起来。生成 E 时,只需要计算 E 自身的 K、V,然后与缓存中的 4 组一起完成注意力计算。需要注意的是,KV Cache 省去的是历史 token 的 K、V 投影重算,使每步解码不必重算整个前缀;但每个新 token 的注意力计算仍要遍历全部缓存的 K、V,计算量随上下文长度线性增长——这正是长上下文解码越来越慢、KV Cache 的显存与带宽成为推理瓶颈的原因。
Chat Template
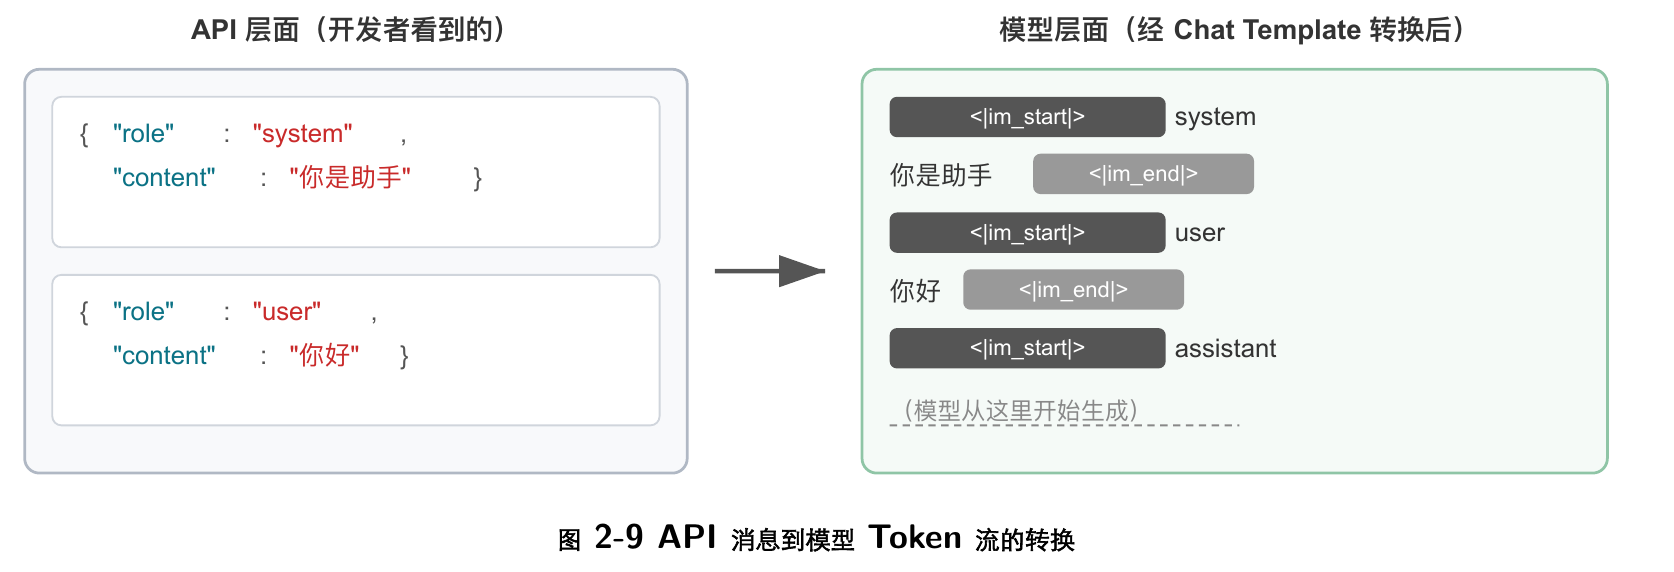
API格式的结构化消息会被模型的Chat Template自动转换为LLM可使用的标准格式.
Prompt Cache
在API服务层,我们也可以缓存相同前缀的计算结果,这被称为Prompt Cache,工作原理是: API 服务商对请求的前缀进行匹配,如果多次请求的前缀相同(比如系统提示词和工具定义不变),就直接复用之前计算好的 KV Cache。 而不需要重新计算这部分 token 的键值对。缓存读取的成本远低于首次计算——以 Anthropic、DeepSeek 为例约为十分之一.
提示工程
语气和风格的设计是提示工程中最容易被忽视,却又深刻影响用户体验的部分。例如“You MUST answer concisely with fewer than 4 lines”(你必须简洁地回答,不超过 4 行)。在无法完成任务时要求“keep your response to 1-2 sentences”(把回复控制在 1-2 句话),并且“不要解释为什么不能做某事”——这种设计避免了 Agent 陷入冗长的自我辩护。大写字母(如“NEVER do X”)比“Please avoid doing X”更能引起模型的“注意”,但过度使用会导致效果被稀释,应保留给真正关键的约束。
Skill设置
Skill内容的插入位置在哪里?有三种方案:
- 注入系统提示词: 由于每次加载/切换Skill都会该笔那系统提示词,就会影响KV Cache
- 作为普通文件读取,置于用户消息中,由于出现在上下文的中间位置,需要模型针对这种情况进行特调,不同模型的效果差别很大,Claude对这一点做的较好.
- 生产实现中,metadata作为system/user角色注入上下文(不同模型设置不同),而完整内容则由Skill工具加载并注入到上下文中
Agent状态栏
Agent 状态栏之所以有效,源于注意力机制的一个本质特性:上下文学习更像检索而非推理——模型擅长从已有内容中查找信息,但不擅长主动归纳和总结
一个更形象的说法是:上下文窗口是一台只有一半的检索引擎。它“检索”的这一半非常强——你问什么,注意力就能从成千上万个 token 里把相关的原始记录捞出来,相当于把检索增强生成(RAG)内置进了每一次前向传播。但它缺了另一半:没有“提炼层”。上下文里的东西从来不会被自动数一遍、建个索引、或就地总结成一条结论;任何“关于这些内容的结论”——一共多少条、有没有超标、进展到哪一步——模型每次要用,都得从原始记录里现算一遍。而“现算一遍”的代价,会随上下文里堆积的内容量(记作 N)一起往上涨。
使用状态栏可以把分散在上下文各处的隐式状态提炼为可直接使用的显式知识。原始轨迹中的信息是高度冗余的——大量的 token 中只包含少量关键的状态信息。Agent 状态栏主动提取这些关键状态,以极低的额外 token成本,呈现出原本需要扫描数千个 token 才能获得的信息。
Agent 状态栏正是通过显式地操纵注意力分配来解决这一问题。当我们将关键的元信息以结构化的形式放置在上下文末尾时,这些信息在空间上更接近模型即将生成的新 token,因而能获得更高的注意力权重——这是一种“强制性的注意力引导”。
状态栏有以下三条要点:
- 用代码提取统计状态栏,而不要用LLM去维护,尤其是不能一次性批量统计,因为这等于把“扫描整段上下文”这个原始难题原封不动搬了个家,问题一点没解.
例如,我们可以写一个函数,让LLM在需要时执行即可:
| |
- 删除原始上下文之前,需要保证状态栏覆盖了所有会被问到的问题
- 如果状态栏够用(计数、状态跟踪这类任务就是如此),你完全可以把原始记录整段删掉、只留状态栏,省下大把 token;可只要有一个问题落到了状态栏没算过的维度上,事情就会急转直下。论文做过一个极端测试:状态栏里只存了“两两组合”的计数,却去问“三者交叉”的问题——这时只留状态栏的准确率会断崖式崩塌,连 Claude 都从 100% 掉到 7.6%。
- 确保状态栏的准确率,模型几乎无条件相信状态栏,而不会去核对或者重算
状态栏包含什么
基于上述的理论基础,Agent 状态栏包括以下几种类型的信息:
任务规划:当 Agent 处理复杂的多步骤任务时,轨迹会变得很长。Agent 容易过分关注当前的局部子任务,而忘记用户的原始诉求、核心约束以及后续工作。通过引入 TODO 列表将任务分解为清晰的步骤,放在轨迹末尾不断提醒模型当前的进展和未来的目标,确保行动与总体规划保持一致。
事件的侧信道信息(Side-channel Information):为每个事件附加元数据——精确的时间、地理位置、距上次 Agent 回复的时间间隔等。侧信道信息是指不在主要数据通道中传递、但对理解事件很有帮助的辅助信息。这些信息帮助模型理解事件的时序关系和环境背景,从而做出更符合情境的决策。
环境的当前状态:包括动态的环境信息(系统时间、工作目录等)、异常操作提醒(“该工具已被重复调用 N 次”)、以及从隐式状态到显式状态的转换。这一设计原则同样适用于人类界面——命令行(CLI)和图形界面(GUI)都致力于让用户清晰地感知系统的当前状态。
可用能力清单:当 Agent 框架支持插件化的能力扩展(如上一节的 Skills 系统)时,所有已安装 Skill 的元数据列表也走这条同一的末尾注入通道,相当于告诉模型“你现在拥有哪些可调用的专业能力”。它变化频率最低(仅在用户安装/卸载 Skill 时才变),其增量发送机制已在上一节 Skills 中详述,此处不再重复。
侧信道信息和可用能力清单一经添加就不再改变,对 KV Cache 很友好(因为不会破坏已缓存的前缀)。而任务规划和环境状态是动态变化的,需要以特殊的用户消息追加到上下文末尾,并随任务推进不断更新——更新方式的选择直接关系到 KV Cache 的代价,下面结合具体的消息结构展开讨论。
多轮目标中,每完成一次任务,就需要更新状态栏,有两种方法: 每轮替换(每次对话时移除上一轮的状态栏,缺点是破坏KV Cache),持久追加(保留历史状态栏,缺点是在上下文中会累积失效的状态栏).
取舍的经验法则是:状态更新频繁且轨迹很长时,选择持久追加——每轮替换带来的缓存失效会在长轨迹上反复累积,代价远超陈旧状态占用的 token;轨迹较短或单条状态消息很大(如完整的 TODO 列表加环境快照)时,选择每轮替换——末尾几轮的缓存失效本来就便宜,换来的是上下文的整洁和无歧义。
上下文压缩策略
压缩上下文有两个截然不同的动机,理解这一点对设计压缩策略至关重要。
- 解决上下文窗口问题和成本约束,毕竟几轮交互下来,1M的窗口也会被塞满,而且Token越多,API成本越高,也会提升推理延迟
- 提高思考质量: 总结后的知识比原始形式更利于模型使用
假设上下文中包含一段宠物店的巡查记录:
笼子 1:黑猫。笼子 2:白猫。笼子 3:黑猫。笼子 4:黑猫。笼子 5:白猫。⋯⋯(共 100 个笼子,其中 90 只黑猫、10 只白猫)
如果不启用思维链(Thinking),模型很难直接给出正确答案——因为注意力机制擅长的是查找(“笼子 37 里是什么猫?”),而不是统计归纳(“总共有多少只黑猫?”)。后者需要遍历所有记录并维护计数状态,这本质上是思考而非检索。
如果启用思维链,模型可以通过逐个数数来得到正确答案——但代价是每一次被问到这个问题,都需要重新从头数一遍,产生大量的思考 token
而如果我们提前做一次总结,在上下文中直接写入“当前统计:黑猫 90 只,白猫 10 只”,模型就能立即检索到这个结论,无需重新思考。这就是压缩的第二个价值:把需要思考才能得到的结论变成可以直接检索的知识。
与其期望模型从冗长的上下文中自动学习,不如主动地、显式地进行知识提炼。虽然需要额外的计算投入(用专门的 LLM 调用来做总结),但产生的是经过压缩的高密度知识表示——不要让模型被动地在海量信息中检索,而要主动为模型提供经过提炼的结构化知识。
KV Cache与压缩
压缩不是在单次 API 调用的过程中修改上下文,而是在两次 API 调用之间,由 Agent 框架对消息列表进行预处理:
- System Prompt 和 Tool Definitions 永远不动——这是上下文最前面的“静态前缀”,KV Cache 持续缓存。
- 压缩的对象是对话历史中的 tool results——当 Agent 框架用压缩后的摘要替换原始的工具输出时,替换位置之后的缓存会失效,但之前的缓存仍然有效。
- 这是一个有意识的权衡:不压缩,上下文膨胀到超出窗口限制,任务直接失败;压缩后,虽然损失了部分缓存,但上下文长度可控且信息密度更高。因此压缩的频次需要权衡——频繁压缩会频繁破坏缓存,最好在上下文接近阈值时批量压缩,而不是每轮都压。
压缩策略
常见的策略是上下文感知压缩(根据当前的任务目标有选择地压缩不同轮次的对话信息)和结构化摘要(保留每轮对话的独立记录和逻辑脉络).
隔离优于压缩
子Agent上下文隔离: 主 Agent 把“读取大量文件”“在代码库中大范围搜索”这类会产生海量中间内容的任务,委派给一个独立的子 Agent;子Agent 在自己的上下文中完成探索,只把几百 token 的结论性摘要回传给主Agent。
ch3: 用户记忆和知识库
持久化的记忆体系可以从两个尺度来理解。用户记忆是针对单个用户的个性化记忆——Agent 在与每位用户的交互中逐渐了解其偏好、习惯和需求,构建专属于该用户的知识模型。知识库则是面向所有用户共享的集体知识——比如一个行业的法规体系、一家公司内部的操作流程、一个技术领域的专业文档。前者让 Agent 成为“懂你的助手”,后者让 Agent 成为“领域专家”。
用户记忆
用户记忆能力可归纳为以下八项:
- 个人信息保留:记住用户身份等长期个人信息
- 偏好追踪:跟踪并记住用户的长期偏好
- 上下文切换:在多个话题之间切换时保持连贯
- 记忆更新:当用户提供与旧信息矛盾的新信息时能正确处理
- 多会话连续性:跨会话保持知识
- 复杂思考:基于多个记忆片段联合思考,例如当用户对花生过敏时推荐泰国菜应主动提醒注意花生成分
- 时间感知:记住日期、理解相对时间、进行时间计算
- 冲突解决:识别并处理记忆之间的不一致
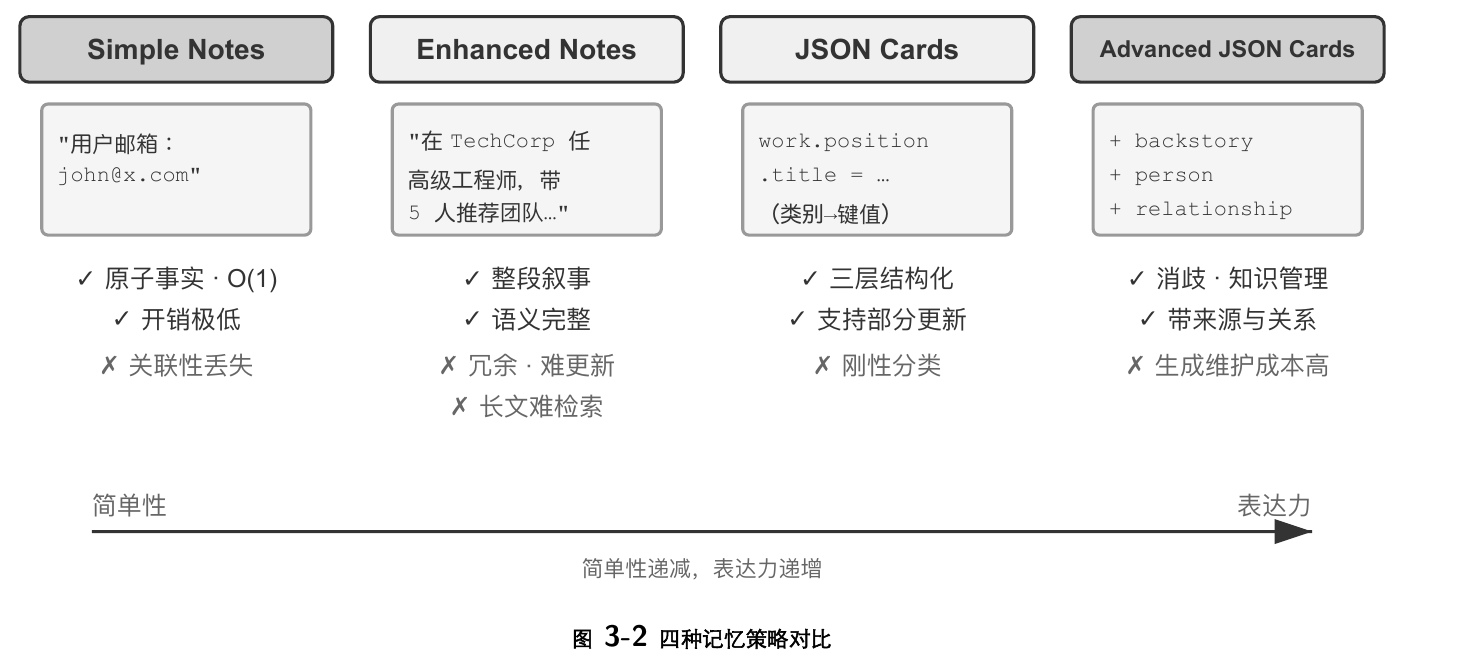
实践中的选择标准是:关键且少量的数据(如用户偏好、关键人物关系)用 Advanced JSON Cards 以保证可检索性;大量且非关键的对话事实用 Simple Notes 以降低成本;多数生产系统采用混合模式——同一 Agent 内不同类信息走不同路径。
事实上,我觉得用户记忆才是最适合用向量检索处理的,毕竟数据量不大,检索速度很快,缺点自然就是延迟了,额外引入了不必要的检索时间.
RAG
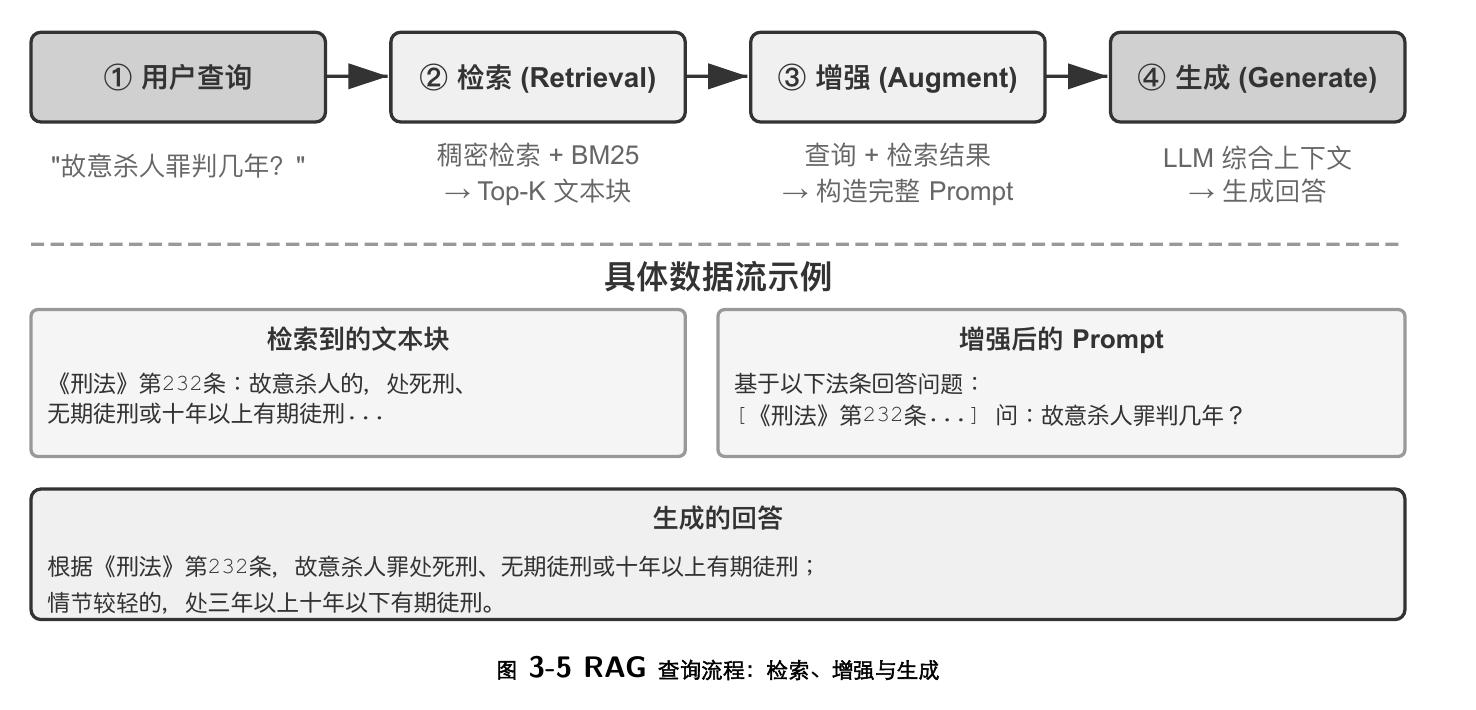 嵌入有两种方式:
- 稠密嵌入: 向量的每个维度都有数值,用余弦相似度度量语义相似性,常用策略有HNSW和ANNOY
- 稀疏嵌入: 将文档表示为极高维度的向量,只有在文档中出现的词汇对应的维度才具有非零值,只关心有哪些词出现了,以及出现了几次,忽略词序,常用策略有TF-IDF和BM25(TF-IDF的优化版)
两种方法各有盲区:稠密检索懂语义但可能漏掉关键词(搜“HTTP-403”可能返回“服务器错误”的泛泛讨论),稀疏检索精确匹配但读不懂同义词(搜“kitty”找不到只写了“cat”的文档)。混合检索的思路很简单——两个引擎都跑,结果合并——难点在于如何把分布迥异的两组得分整合成一个有意义的排序。
混合检索步骤如下:
- 并行检索: 向两类引擎同时发送查询,各自获得一部分候选文档
- 结果融合: 难点在于两类结果不具备可比较性,只能做归一化后加权融合,至于怎么归一化就看你用什么公式了
- 重排序: 对排名靠前的N个候选逐一精细打分,产生最终排序,基本原理是,把查询和候选文档拼接成一段完整的文字送入模型,让模型逐词比对、输出一个综合的相关性得分
多模态处理
对于语音,图表来说,简单的方法是直接提取为文本,复杂一点可以先提取为文本,但保留原始文件,供Agent在激活对应文本时去深入分析原文件.
- 但说实话,谁闲着没事会传一大堆语音和图片进去嘛,传视频就更是匪夷所思.除非是考虑到图库,音乐库和视频库,但这种直接在本地整理好了文件夹归类,或者传到支持MCP的云盘上,然后大模型再调用工具直接访问具体文件,那还有点说法.
超越扁平文本
简单的RAG有以下弊病:
- top-k截断: 检索的本质是找最相关的几个,而统计类问题需要找到所有文档,二者天然就是矛盾的
- 非结构化: 无法将语义相似的向量组织在一起,而只能根据单次查询来返回非结构化的内容.
结构化索引
结构化索引有两种思路: 树状层次(RAPTOR)和(实体关系图)GraphRAG.
RAPTOR (Recursive Abstractive Processing for Tree-Organized Retrieval)采用自下而上的递归抽象方式。它首先将长文档切分为小的文本块作为“叶子节点”,然后通过聚类算法将语义相近的叶子节点分组——聚类类似于把图书馆的书按主题自动分堆:算法计算每本书(每个文本块)之间的相似度,把最相似的归为一类,每一类就代表一个主题。
GraphRAG将文档建模为实体与关系的知识图谱:
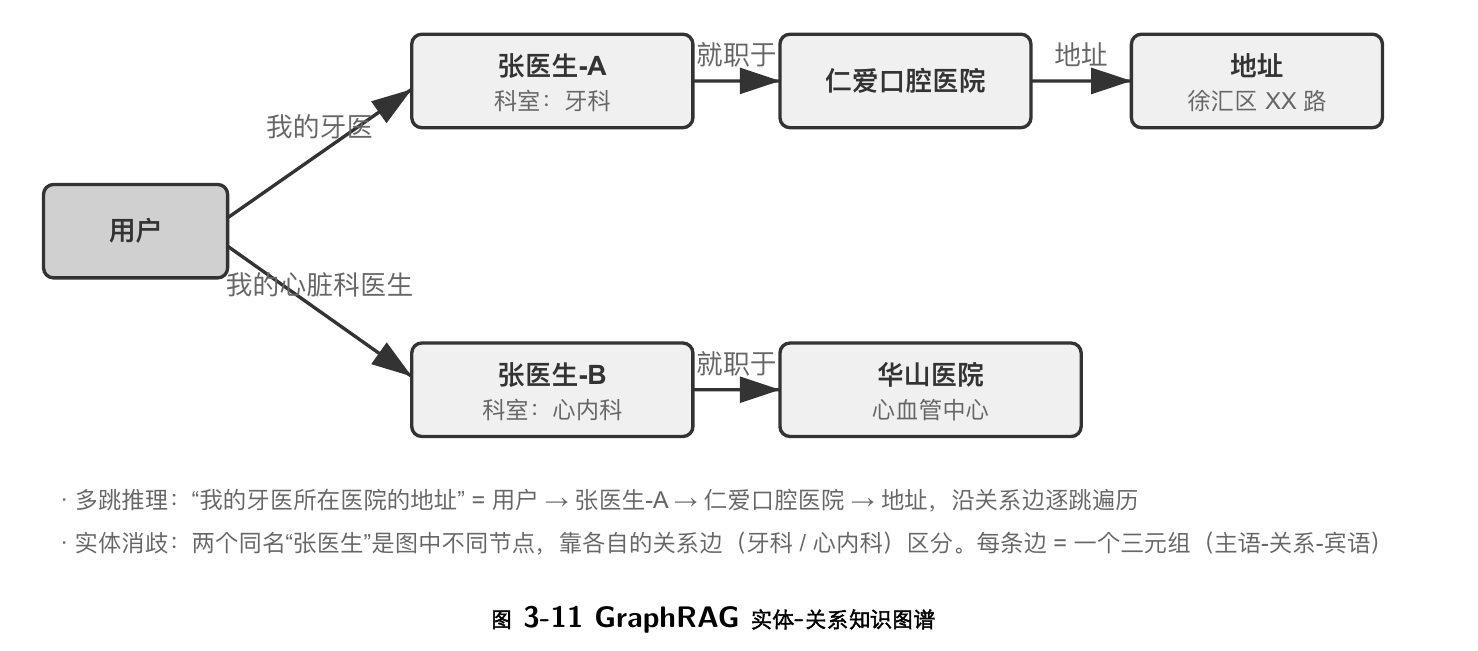
知识图谱通过实体-关系-实体三元组(Triple)构建信息网络。三元组用“主语-关系-宾语”的形式表达一条知识,例如(北京,是首都,中国)、(张三,就职于,腾讯)。大量三元组交织在一起,就形成了一张知识之网。知识图谱的核心优势体现在两个方面。
多跳关系推理是知识图谱最不可替代的能力。当用户问“我的医生所在医院的地址”时,系统需要依次解析“用户 → 医生 → 医院 → 地址”这条关系链。在扁平化的记忆存储中,这类多跳查询要么需要多次独立检索再由 LLM 拼接(效率低且容易断链),要么根本无法表达。知识图谱的图结构天然支持沿关系边遍历,使得这类查询既高效又可靠。
**实体消歧(Entity Disambiguation)**同样是知识图谱的强项。注意它与前文稠密嵌入部分讨论的“一词多义”不同:判断“bank”在句中指河岸还是银行,是词义消歧(Word Sense Disambiguation)的任务,靠上下文感知的嵌入即可解决;而区分现实世界中两个同名的“张医生”,是实体消歧——需要维护关于实体本身的知识。还记得“四种存储格式”一节中 Advanced JSON Cards 靠 person、relationship 等人工设计的字段来区分用户的多位“张医生”吗?在知识图谱中,这种消歧成为图结构的原生能力:(张医生-A,科室,牙科)与(张医生-B,科室,心脏科)是图中的不同节点,通过各自的关系边连接到不同的人和机构,消歧过程无需额外推理。
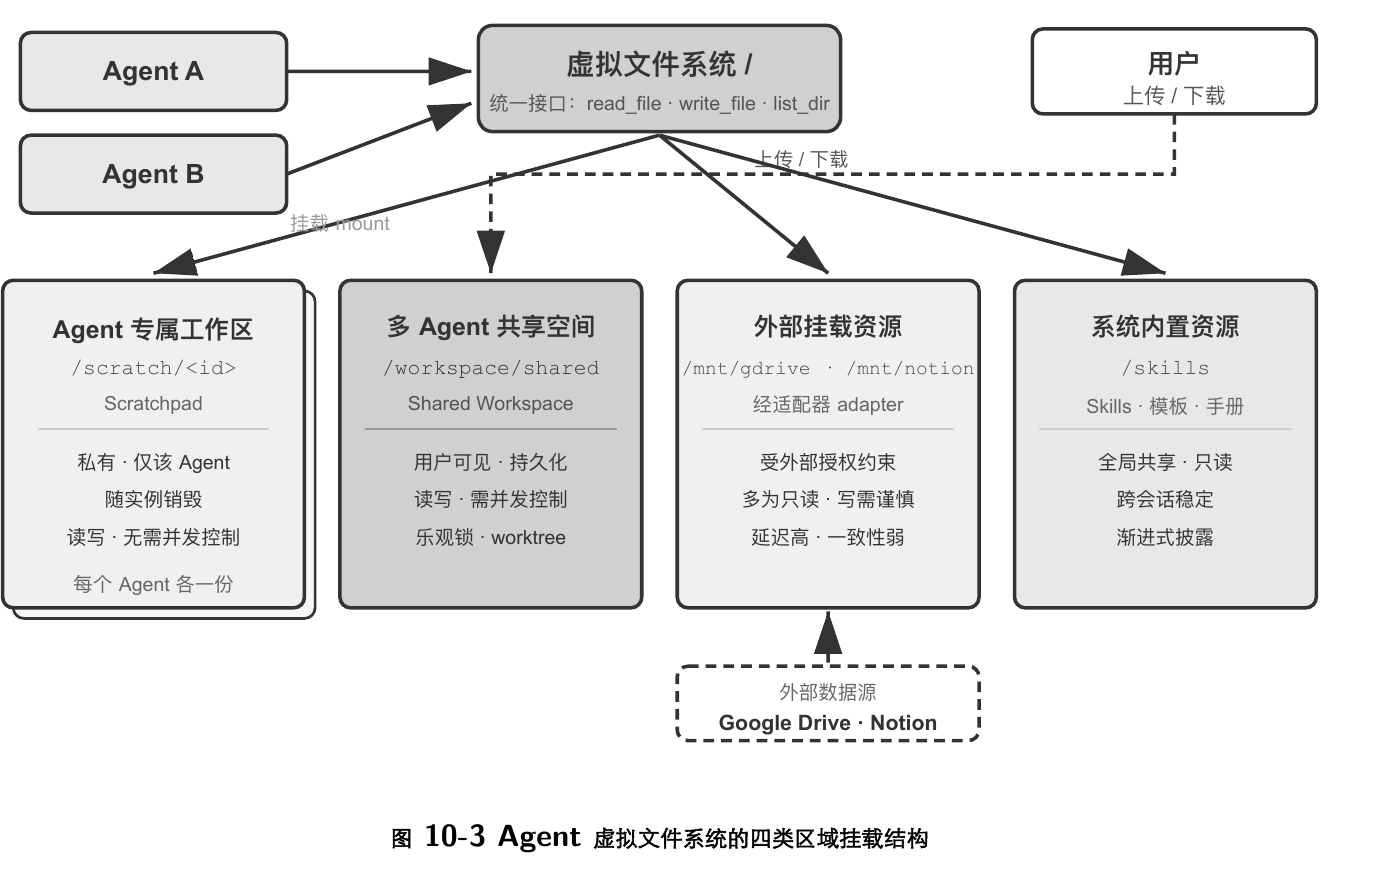
字节跳动火山引擎开源的 OpenViking提出了第三条道路: 文件系统范式,它不将上下文视为扁平的向量碎片或图谱节点,而是将所有上下文——记忆、资源、技能——映射为虚拟文件系统中的目录和文件,每个条目拥有唯一 URI:
| |
这种渐进式披露需要文件之间彼此建立索引和链接,否则Agent无法进行导航.
Agentic RAG
为 Agent 构建了强大的知识库之后,下一个核心问题是:Agent 如何才能智能地、自主地利用这个知识库?传统的 RAG 流程通常是一个简单直接的单向数据流:用户的查询直接用于检索,检索结果直接注入模型上下文,模型直接生成最终答案。这种“非智能体化(Non-Agentic)”的模式虽然高效,但其能力上限很低,因为它本质上只是一个被动的“检索-生成”管道,缺乏对问题进行深度理解、分解和迭代探索的能力。
为了突破这一限制,我们必须将 RAG 从一个固定的数据处理流程,升级为一个由 Agent 主导的、动态、迭代的探索过程。这便是“智能体化 RAG(Agentic RAG)”的核心思想。
打个比方,传统 RAG 就像在图书馆里只能做一次搜索然后立刻写报告,而智能体化 RAG 则像一位研究员,可以反复查阅不同书架、调整搜索策略、交叉验证信息,直到掌握足够的材料再动笔。
面对复杂问题时,Agent 首先“思考”分析核心需求,自主决定应该使用什么查询关键词才能最有效地获取信息;然后“行动”调用 knowledge_base_search 工具;在“观察”到初步结果后不会立即生成答案,而是评估信息是否充分——若不够则进入下一轮循环,提炼更精确的查询再次搜索,甚至调用其他工具辅助。只有判断收集到充分信息后才综合所有上下文生成最终的、有理有据的答案。
Contextual Retrieval
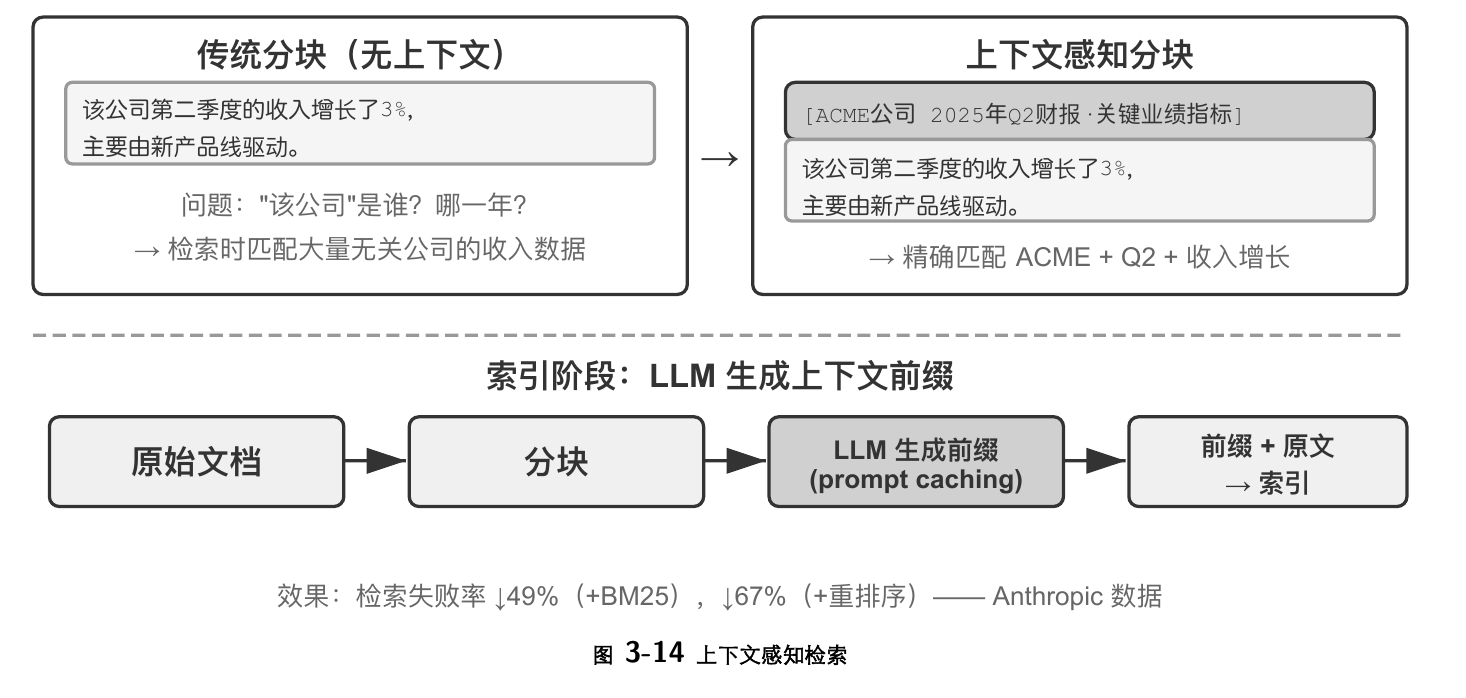
上下文感知检索用LLM给文本块生成所需的上下文,从而极大地增强了RAG的效果和威力.
核心思想非常直观:在对文本块进行向量化索引之前,先利用 LLM 为其生成一段简短的、包含核心上下文的“前缀摘要”,然后将前缀与原始文本块拼接后再索引。例如系统可能生成前缀:“[本段内容节选自 ACME 公司 2025 年 Q2 财务报告的‘关键业绩指标’章节]”。通过这种方式,原本模糊不清的文本块被重新“锚定”在了其原始的语义环境中。
思考题
RAG到底何去何从,Agent有没有可能不再需要RAG,看一下这一章的思考题:
- ★★ 在用户记忆系统中,当同一用户在不同会话中提供了矛盾信息(比如两次提到不同的家庭住址),记忆系统应该如何处理这种冲突?
- ★★ 上下文感知检索将原始文档的上下文附加到每个分块。但如果原始文档本身结构混乱或存在矛盾信息,这种方法可能传播甚至放大错误。你会如何在检索阶段引入“信息质量”信号?
- ★★★ 智能体化 RAG 让 Agent 主动决定何时搜索、搜索什么、以及是否需要继续搜索。但如果模型不知道自己不知道什么,就无法正确触发搜索。这个“元认知”问题如何解决?
- ★★ 多模态信息提取将图表转为文本描述后再进行检索。这个“翻译”过程可能丢失视觉信息中的空间关系。举一个具体例子,说明纯文本描述无法完整传达的图表信息,并设计一种保留该信息的方案。
- ★★★ Rich Sutton 的“苦涩的教训”认为通用方法(搜索和学习)最终会胜过手工设计的特征。本章构建的整个知识系统(分块策略、索引结构、检索管道)是否本身就是一种“手工设计”?如果模型能力足够强,这些设计是否会被简单的“全量输入”所替代?
- ★★★ 随着模型能力的提升,你认为领域知识库还重要吗?未来强大的基座模型是否有可能包含领域知识库中所有的信息,从而不再需要领域知识库?
- ★ RAPTOR 通过自底向上的层次摘要构建树形索引,GraphRAG 通过实体关系构建图结构索引。这两种结构化索引分别擅长回答什么类型的查询?
- ★★ 文件系统范式将知识组织为类似文件系统的层次结构。这种方式和传统的向量数据库 RAG 相比,在什么场景下更有优势?
- ★★★ 从结构化数据(如司法判决数据库)中自动发现“裁判因素”和“因素重要性层级”,本质上是让 Agent 从数据中归纳规则。这种数据驱动的知识提取是否能达到人类专家手工编写规则的质量?
ch4: 工具
工具分类
Agent一共有5类工具:
| 工具类型 | 调用方向 | 作用对象 |
|---|---|---|
| 感知工具 | Agent 主动调用 | 获取信息 |
| 执行工具 | Agent 主动调用 | 改变世界 |
| 协作工具 | Agent 主动调用 | 驱动其他 Agent 或人类 |
| 用户沟通工具 | Agent 主动调用 | 向用户传递信息 |
| 事件触发工具 | Agent 注册、外部触发 | 驱动 Agent 开始执行 |
工具设计
Agent的能力应该用什么形式来表达?目前有两种形态:
- 专用代码工具: 结构化的函数调用,确定性高,缺点是工具过多会挤占上下文
- Skill+通用执行器: 用Skill描述操作流程,Agent用少量工具就可以覆盖大量场景
举个例子:一个“部署应用”的 Skill 文档可能写成 1. 运行 npm run build 构建项目;2. 运行 docker build -t app:latest . 打包镜像;3. 运行 kubectl apply -f deploy.yaml 部署到集群——Agent 通过 bash 工具逐步执行这些指令,无需为每个步骤创建专用工具。
一般来说,通用工具优于专用工具,除非存在明确的安全、权限或性能理由.这条原则背后的逻辑是: LLM 本身具有强大的思考和代码生成能力,我们应该利用这种能力而不是限制它.
边界同样重要。文件搜索工具应该明确说明它只能基于文件名进行匹配,不能搜索文件内容——如果缺少这样的反例说明,LLM 就会去猜测。清晰列出工具的边界条件——做不到什么、不接受什么输入——往往比描述能力本身更重要,因为大多数工具调用失败的根因不是模型不知道工具能做什么,而是不知道工具不能做什么。
MCP
MCP工具如今都是通过插件提供的,除了用户自己可勾选之外,Agent也可以按照MCP的描述按需读取.
感知工具
感知工具常常面临返回信息量远超 Agent 处理能力的挑战:一次搜索可能返回数万个字符,一份 PDF 可能多达上百页,直接塞入上下文既会耗尽窗口空间,又会让关键内容淹没在噪声中。通用的应对是在工具层面集成第二章介绍的上下文感知压缩——当输出超过阈值(如 10000 个字符)时,基于 Agent 当前的查询意图自动压缩。
搜索类工具应该具有结构化的结果列表,方便Agent进行浏览候选,而不是一次性倾倒所有结果;读取类工具应该支持offset/limit参数,当内容超过阈值必须截断时,截断必须是显式的,说明读取了多少内容,如何读取剩余部分,千万不能设置静默截断.
而多模态感知则有一个权衡: 是直接将图像交给有视觉能力的模型,还是先用OCR转成文本?前者保留布局和视觉细节但消耗更多 token,后者精简高效但可能丢失关键的空间结构.践中常按内容类型选择:纯文字内容用文本提取,布局敏感的内容(UI 界面、复杂表格、设计稿)保留图像。
执行工具
感知工具是只读的,所以可以适当放宽安全边界,但执行工具的错误代价可能极高,所以需要极其精巧的设计.
执行工具的安全需要采用多层防护:
- 输入验证: 检查操作的合法性,是否存在路径遍历攻击(如../../etc/passwd——攻击者通过在路径中加入 ../ 使工具跳出指定目录,访问本不应触及的系统文件).关键是快速失败——发现异常输入时立即拒绝,不尝试“智能”修正。
- 权限控制: 维护一个禁止命令的黑名单,强制文件操作只能访问特定的工作目录
- 审查机制: 引入独立模型审核现有模型的提议是否合规,理想配对是能力相近但训练偏好不同的两个模型,例如 Claude Opus 与 GPT-5 互审。
- 隔离和沙盒: 利用操作系统的安全机制(轻量级),利用容器隔离(隔离程度适中),利用虚拟机(级别最高),都可以限制Agent的权限边界
协作工具
当任务超出单个 Agent 的能力边界时,协作工具可以让它把子任务委托给其他 Agent 或人类,再整合各方的结果。
协作工具的接口可以归纳为三组原语。其一,启动与取消:spawn_subagent 创建子 Agent 并分配任务;cancel_subagent 在任务失去意义时(如用户改变了主意、另一个子 Agent 已经找到答案)及时终止,避免继续浪费 token。其二,消息传递:send_message_to_subagent 在子 Agent 运行期间向它发送补充指令或追问,子 Agent 也可以反向给主 Agent 发消息汇报进展或请求澄清。其三,发现:在一个同时运行着多个 Agent 的系统中,list_agents 列出当前可用的 Agent 及其职责描述和运行状态,让 Agent 找到潜在的协作者——这与 MCP 用 tools/list 列出可用工具是同一思路,只不过列出的是 Agent。
而协作形态则可以分为三种: 阻塞调用(主Agent等待subagent执行完成),异步调用(主Agent继续执行),流式协作(subagent持续发送增量消息,适合过程本身有价值的场景)和多轮交互(子 Agent 主动询问、主 Agent 应答的对话式协作)
事件驱动的异步 Agent(待补充)
- 相当精彩,之后重温一下
要实现事件驱动,首先就是要让系统避免轮询,而是根据新消息的到达自动触发处理链条,所有的输入/输出/思考/外部交互统一建模为事件流:
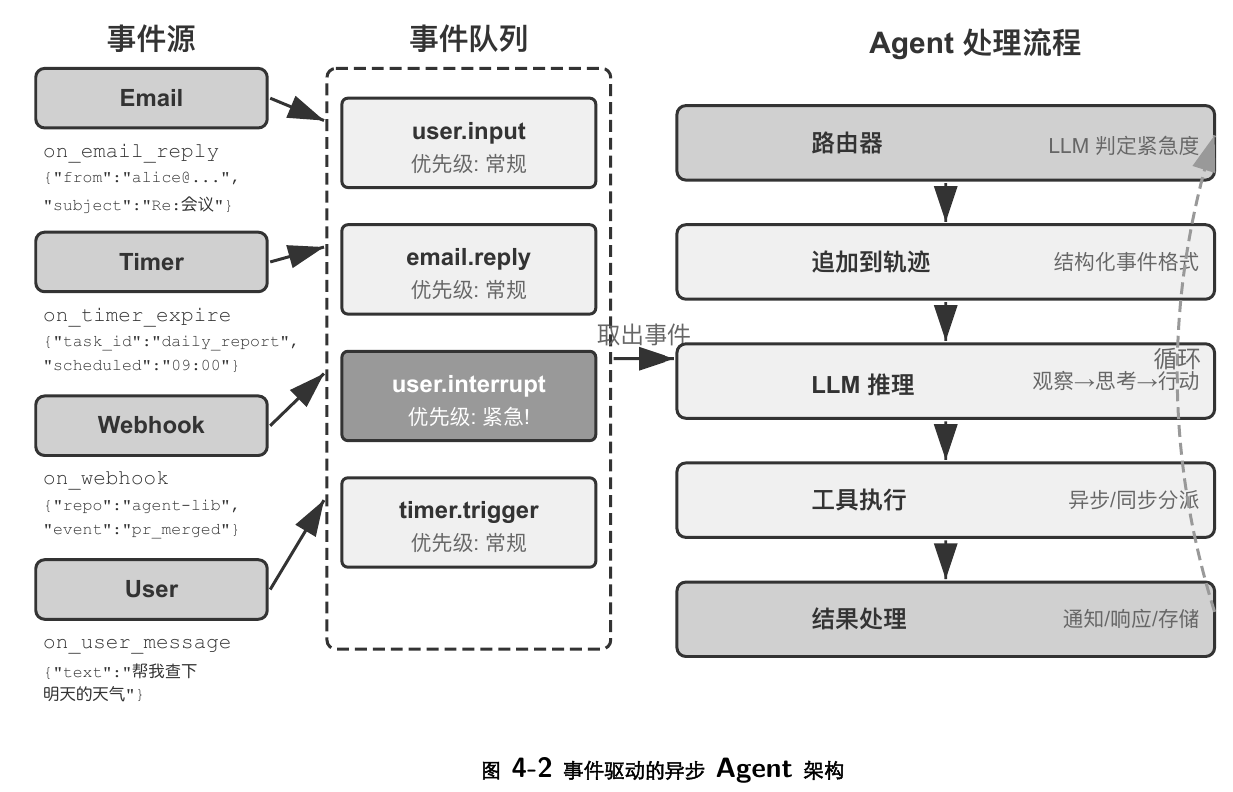
以OpenClaw为例,其触发方式都是时间驱动的,如周期任务和定时检查的Heartbeat机制,无法在事件发生的瞬间做出响应.PineClaw(Pine AI 的 OpenClaw 插件)引入了Channel机制,建立了实时通道,从而极大降低了响应延迟.
通用Agent面对的输入有着极其丰富的的语义空间,所以需要我们为其精心建模:
- 来源(谁):用户本人、联系人、陌生人、系统通知
- 渠道(方式):电话语音、短信、即时消息、邮件、社交媒体、定时器触发、异步工具调用结果、命令行监控状态更新
- 内容(什么):消息文本、情感色彩、紧急程度、是否需要回复
- 上下文(背景):是对之前某个对话的回复还是新发起的沟通,与当前任务的关联
以客户退款邮件为例:
| |
对于用户打断等异常情况,我们可以将占位符写入到tool result,如“工具正在后台执行,请优先处理新事件”,并将用户的请求置于事件队列最前方,此时LLM看到的历史消息轨迹完全合法,可以继续执行最紧急的事件.
当然这只是权宜之计,因为LLM还没有在异步环境下训练过,以为每次工具调用都必然会返回结果(至少会返回异常),所以异步环境也是LLM的未来发展方向.
主动工具发现
传统做法是把所有工具的 schema 一次性注入系统提示词,但当工具数量上千时它迅速失效:上下文被“工具说明书”塞满,模型的选择精度随之下降.
有一个不错的解决方案:
- Agent在执行过程中主动声明需要什么工具,并由工具搜索工具(tool search tool)或者带有embedding/LLM匹配的工具路由来加载需要的工具
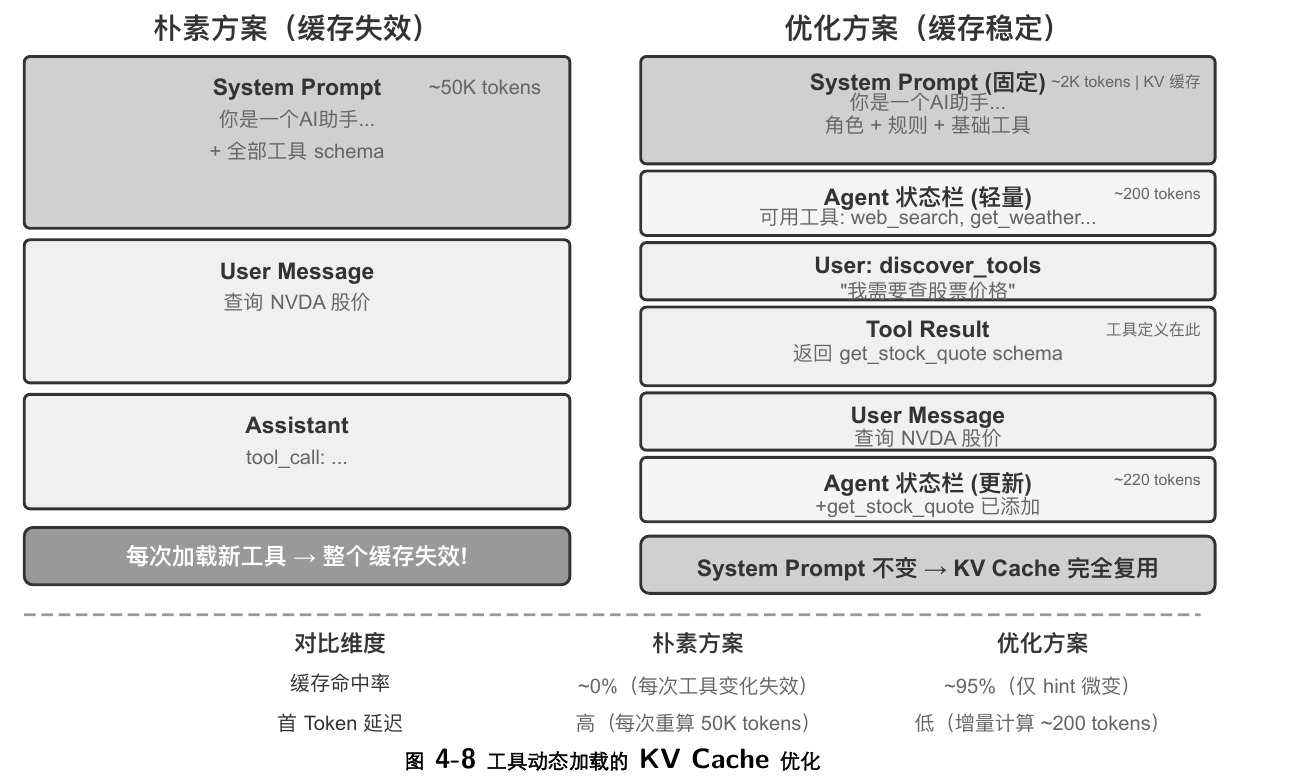
但是这个方案需要我们维护自己的工具索引,还是比较繁琐.更流行的思路是通过Skills的渐进式披露,即由Skill.md告诉Agent工具分别放在哪些文件夹下面.
ch5: Coding Agent
以 Manus 为代表的通用 Agent 产品,将 Deep Research(深度调研)、Computer Use(电脑操控)和 Coding(代码生成)三大能力融合在一个系统中,凸显了一个已经被多类实践反复验证的洞察:Coding Agent 加上文件系统,是开放任务型通用 Agent 最核心的技术基础。
为什么 Coding Agent 是核心而非其他两种?因为几乎所有高效的内容生成最终都要落到代码上。PPT 本质上是 OOXML(Office Open XML,微软推出的办公文档开放标准)格式的代码,Word 文档和 PDF 报告可通过代码生成,数据分析和可视化由 Python 脚本完成,甚至 GUI 操作中成功的浏览器操作序列也可以被固化为可复用的 RPA(机器人流程自动化,Robotic Process Automation)代码。
Coding Agent 的 Harness 实践为所有 Agent 系统提供了可迁移的设计原则:
- 约束优先于指导:能用代码强制的规则就不要用文档建议。Linter 规则、类型约束、CI 检查的价值远超系统提示词中“请遵循…”式的指导——前者是“做不了”,后者只是“建议别做”。
- 验证要自动化:人工审查是不可扩展的瓶颈。测试套件、代码质量检查、行为监控——这些基础设施的投入回报远高于增加人力。
- 反馈越快越好,越结构化越好:错误信息越详细、越接近错误发生的时刻,Agent 的纠正效率越高。第二章的 Agent 状态栏技术(详细错误信息、工具调用计数器)正是这一原则的体现。
- 回退要可靠:Agent 在安全网内操作才能大胆试错。Git 分支、沙盒环境、快照机制确保任何错误都可逆。
文件编辑方案
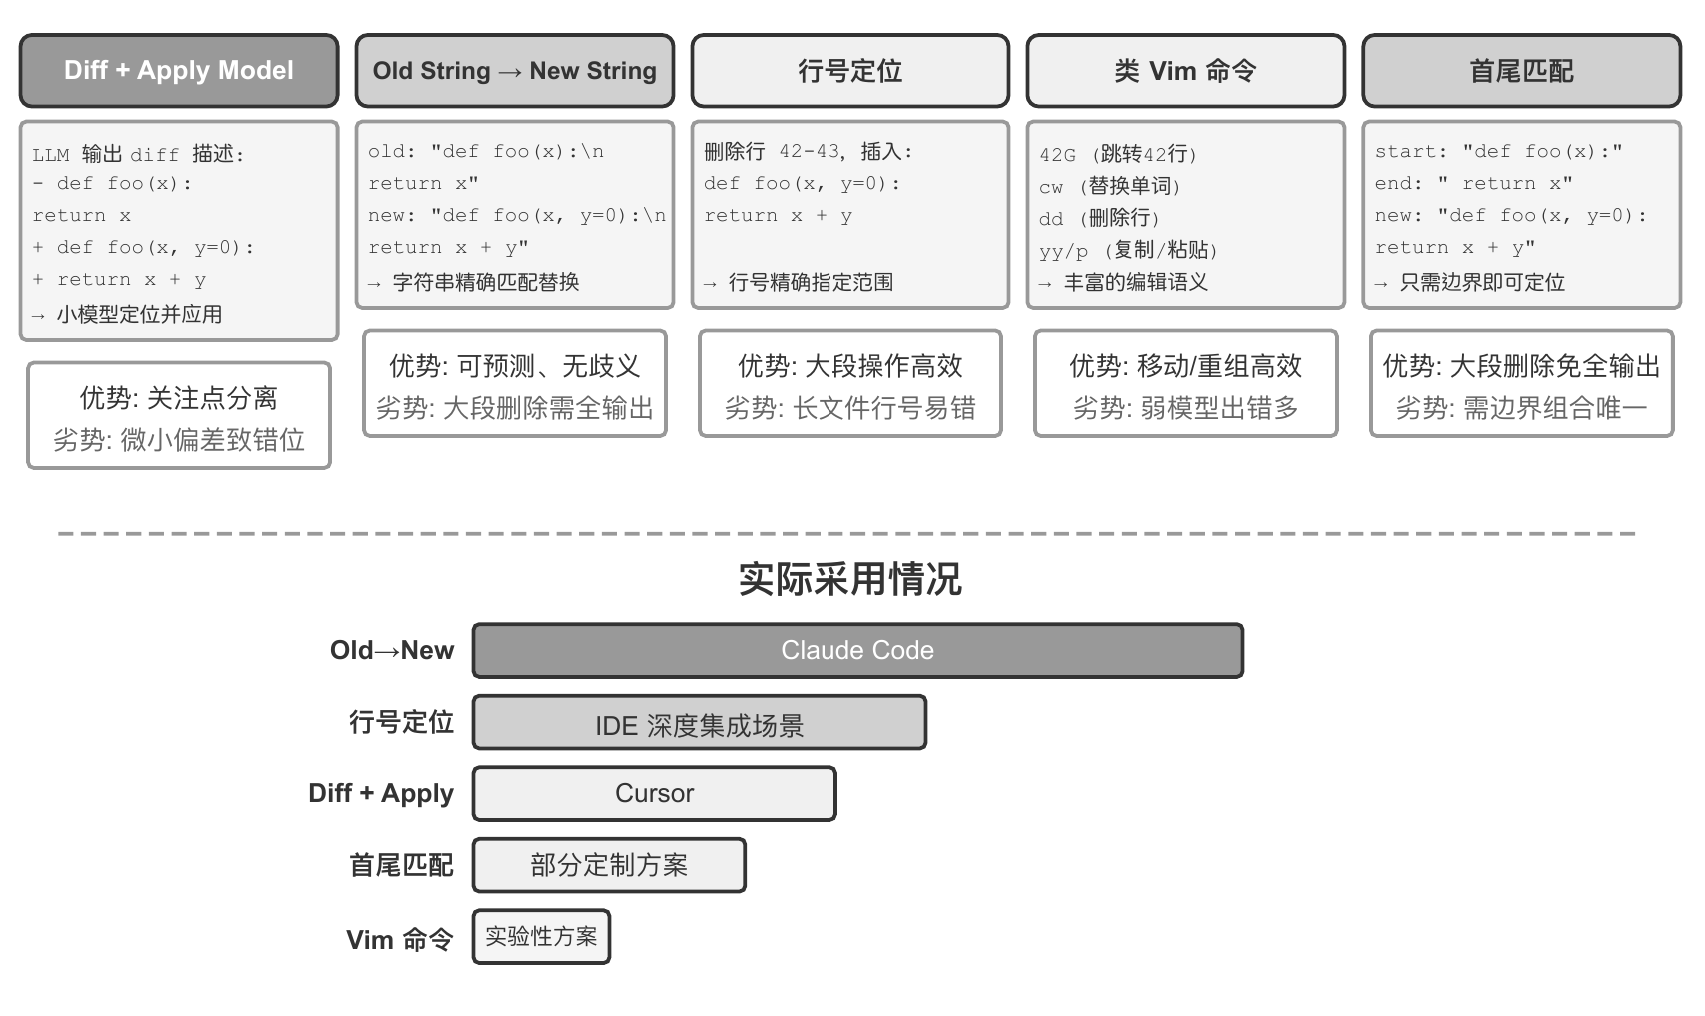
差异描述 + Apply Model:模型不是直接指定如何编辑文件,而是生成一份变更描述——可以是类似 git diff(即 git diff 命令输出的那种“删了哪几行、加了哪几行”的格式)的差异文本,也可以是带省略标记的代码骨架(用“此处保持不变”之类的注释跳过未修改部分)。这份描述随后交给专门的“应用模型”(Apply Model)——通常是另一个更小、更快的 LLM——负责与原文件合并、产出完整的新文件。这种分离关注点的设计让主模型专注高层代码逻辑、应用模型专注底层文本操作。
旧字符串到新字符串(Old String → New String):Claude Code 采用的方案。模型提供 old string(要被替换的原文)和 new string(替换后的新文本),框架执行简单的字符串查找替换。优势是可预测性和透明性——old string 在文件中存在且唯一则成功,否则失败,不存在模棱两可。代价是删除大段代码时需完整输出所有原始内容,一个字符的偏差就会匹配失败;同一代码出现多次时需提供更长的上下文来消除歧义。
代码的威力
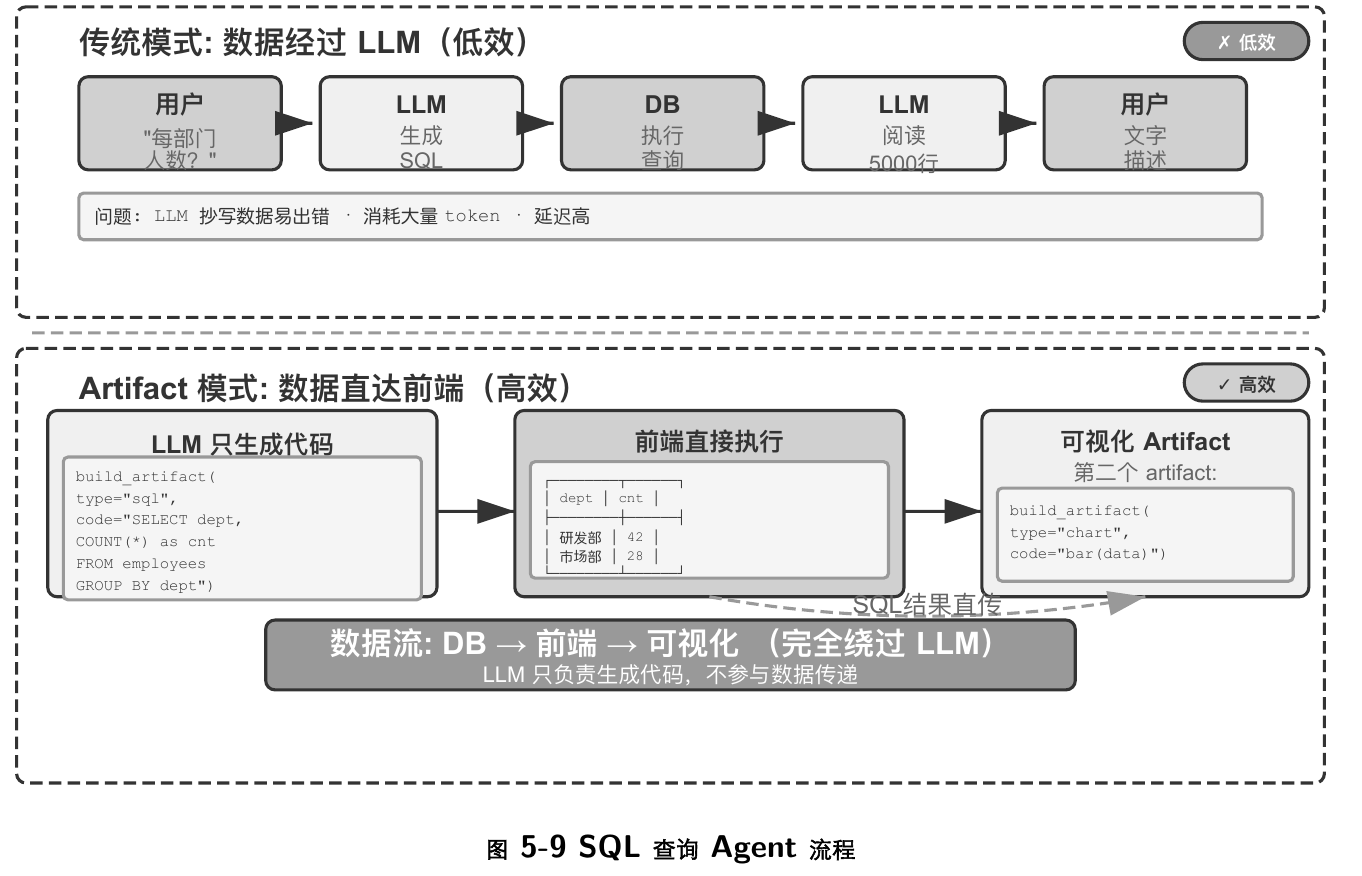
如果Agent只负责阅读和利用代码,而无需处理复杂的自然语言,那么无论是运行效率还是使用体验上都会大大提升.
ch6: Agent评估
评估环境
评估环境包含五个要素: 数据集(Dataset) 定义任务集合,包含初始状态、目标描述和可选的参考解决方案。
环境状态(Environment State) 维护任务执行中的可变信息,需在真实性和可控性之间取得平衡。例如,在客服评估中,环境状态包括数据库中的订单记录和用户账户余额。Agent 调用 process_refund 后,订单状态从 “delivered” 变为 “refunded”、余额增加——这些就是“可变信息”。“真实性”要求状态变化符合业务逻辑(退款不超过订单金额),“可控性”要求每次测试可重置到相同初始状态。
工具接口(Tools) 定义 Agent 可执行的操作集合——工具不应提供过高层的抽象(如“解决用户问题”),而应提供原子操作(如查询订单、修改预订、发送邮件),迫使 Agent 通过规划和思考来组合这些操作。
评分标准(Rubric,评分准则) 量化 Agent 的表现,可以是二元的(通过/不通过)、连续的(0 到 100 分)或多维的(分别给准确性、效率、安全性打分)。
执行协议(Interaction Protocol) 规定交互模式和终止条件。
假设你的 Agent 系统当前基于 Claude 构建,在工具调用和复杂编排上表现优异。某天 Gemini 发布了一个新模型,公开基准显示它在多项指标上超越 Claude,而且定价更低。此时你面临的问题不是“Gemini 是否比 Claude 强”,而是“在我的特定任务上,Gemini 是否比 Claude 好?好多少?切换成本是什么?”
ch7: 后训练
一个现代模型的能力,是分三个阶段炼成的:
- 预训练(pre-training): 在海量互联网文本上做“预测下一个词”的训练,就像一个人读完了图书馆里的所有书——博学,但还不会好好回答问题。这是最贵的一步(动辄数千万美元),也是能力的地基。
- 监督微调(SFT, Supervised Fine-Tuning): 用标注好的“输入—输出”对来训练模型,用几千到几万条“问题—标准回答”的示范数据,教会模型“该用什么格式、什么风格、什么流程来回答”。
- 强化学习(RL): 让模型反复尝试、根据结果好坏给奖惩来改进行为,不再给模型看标准答案,而是让它自己去试,把做得好的行为的概率调高、做得差的调低。这一步让模型学会在没见过的情况下也能做出合理决策
本章有两个要点:
- SFT 记忆, RL 泛化。在相同任务、相同预算下, SFT 倾向于记住训练数据里的答案,一旦部署环境和训练时不一样就容易失效;RL 则倾向于学会一套能迁移的策略,面对没见过的情况也更稳
- 数据和环境,比算法更重要。 这是工业界最反直觉、也最值钱的一条经验。现成的 RL 算法(PPO、GRPO 等)你知道怎么用就够了,真正决定成败的是两件事:仿真环境(模型练习的场地够不够真实)和训练数据(示范和奖励信号的质量够不够高)。很多场景下,只要 SFT 的数据质量到位,你甚至根本不需要做 RL。本章会不断把你的注意力从“调哪个算法”拉回到“数据和环境做对了没有”。
一个重要边界:“必须先 SFT”是在“较小基础模型 + 严格结构化输出”的设定下成立的(实验 7-11 会看到,Llama-3.2-Vision-11B 这个量级不经 SFT 直接 RL 会完全失败)。但若基础模型足够强,它可能一上来就能产出够格的输出,从而跳过 SFT,DeepSeek-R1-Zero 就证明了强基模可以直接 RL 成功,自行涌现出反思与长链思考。代价是输出可读性差、中英文混杂,所以 DeepSeek 最终仍在 R1 里加回“冷启动 SFT”,把“形”重新立稳。R1 从 Zero 到冷启动的往返,正是“先形后神”的最好注脚。
为什么需要RL:
- 其一,离线的天花板是数据,在线的天花板是任务。 SFT 的最优结果是把示范“完美复现”——所以它的上限就是示范者的水平,最多逼近、几乎不可能超过;一份由 60 分老师标注的数据,训不出 90 分的学生。RL 不看示范、只看结果奖励:任何能拿到更高奖励的行为都会被强化,哪怕没有任何人演示过。于是 RL 能自己发现示范里根本不存在的更优策略——本章后面实验 7-13 的 SimpleVLA 里,模型自创的“推切”动作从未在人类演示中出现,正是“超越示范”的直接证据。RL 的上限由任务本身(奖励能认可什么)决定,而不是由数据里恰好有什么决定。
- 其二,“验证”比“生成”容易,这是 RL 能摸高的根本原因。 SFT 需要有人先把好答案写出来当示范;RL 只需要能判断一个答案好不好(给个奖励)。很多任务里“判断对错”远比“写出正确答案”容易——数学题答案能对照、代码能跑测试、定理证明器能校验。只要“认出好”比“做出好”容易,RL 就能训出比任何现成示范者都强的模型:模型自己乱试,环境负责挑出好的加以强化。这条“验证—生成不对称”,正是 RLVR 这类可验证奖励方法威力的来源。
- 其三,在线让模型练在自己会走的路上,学会从自己的错误里爬出来。 离线模仿有个经典毛病叫协变量漂移(covariate shift):学生自己走时会偏离示范、进入数据里没有的状态,而它从没学过怎么从这些状态回正轨,于是误差沿轨迹越滚越大(理论上,纯模仿的误差随轨迹长度 T 大致按 \(T^2\) 增长,而用在线数据训练能把它压到约 \(T\))。在线方法恰好相反——模型训练时走的就是它部署时会走的分布,每一步反馈都精确打在它当前的真实弱点上;数据永远“新鲜”,不像离线数据那样描述的是别人(教师)的行为、随模型进步越来越不相关。本章后面的 On-Policy Distillation (7.12 节) 之所以强,本质就是把这个“在线”的好处,和 SFT“稠密监督”的好处合到了一起。
SFT
SFT数据的来历:
- 人工专家编写: 质量最高,但又贵又慢
- 教师模型生成: 让已有模型批量生成输入-输出对,过滤后喂给学生
- 模型自举: 对同一问题生成多种候选,用验证器筛选出正确版本后反过来训练自己,这就是拒绝采样微调.
无论走哪条路,构造流程都大同小异:先定义任务分布与输出 schema,再批量生成候选,然后用规则校验、格式检查加人工抽检做质量过滤,最后去重、平衡配比、保证多样性。量级上不必贪多——数千到数万条高质量样本通常就足以固化协议,与其堆十万条脏数据,不如精修一万条干净数据:数据里的每一处噪声,SFT 都会忠实地写进参数。
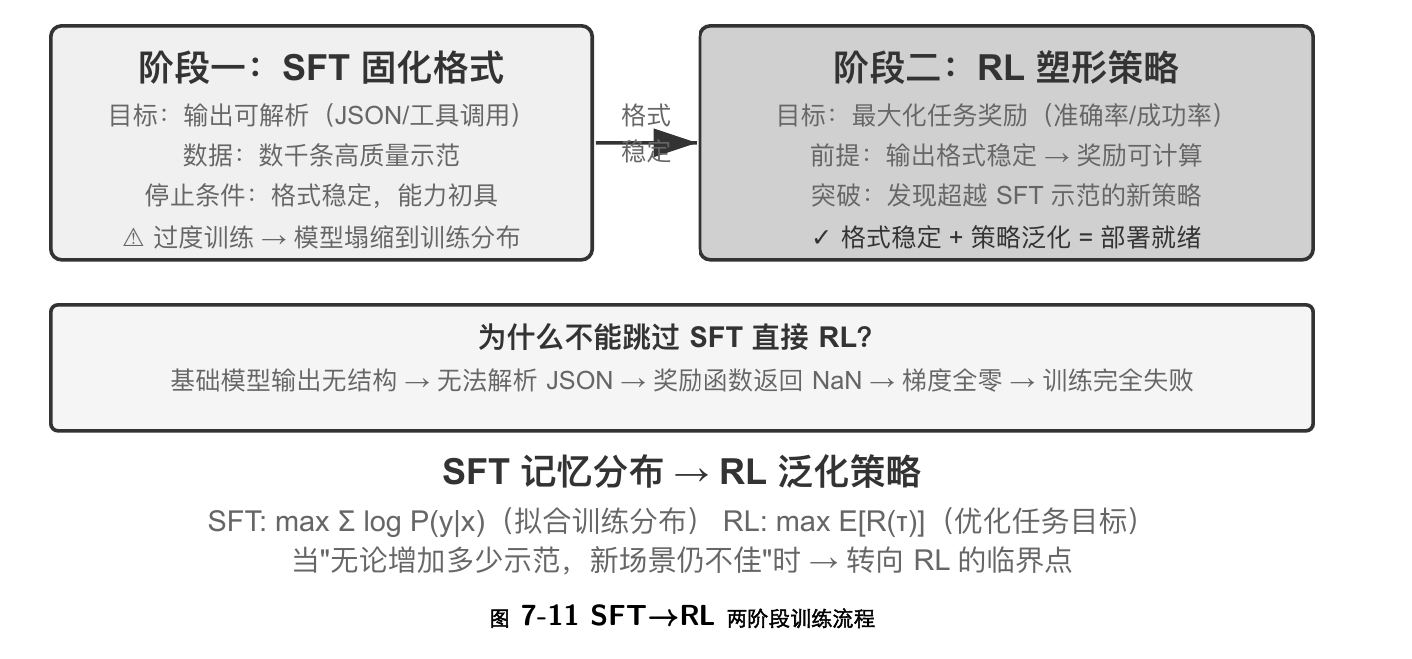
针对不同的任务目标,我们完全可以使用不同的SFT和RL策略,从而将通用模型转化成专业模型.
数据与环境
这是全章我最想让你记住的一节,也是本章主线二的正面陈述。前面花了不少篇幅讲算法,但工业界一线的经 验恰恰相反:算法的重要性,远不及三个更基础的要素——仿真环境的保真度、训练数据的质量、基础模型的能力。
单轮到多轮
从单轮到多轮,复杂性发生了质的跃迁。策略不仅要选择当前最优动作,还要考虑未来的状态价值;不仅要处理即时反馈,还要在延迟奖励下进行信用分配(Credit Assignment)——判断多步序列中到底哪一步对最终结果贡献最大。比如一个客服 Agent 用了 10 轮对话解决了用户问题,最终获得好评——但这个好评该归功于第 2 轮的精准提问,还是第 7 轮的耐心解释?多轮还引入了另一个难题:部分可观测性(Agent 无法获得完整状态,必须通过历史观测构建隐含的状态表征)。
因此,我们需要打磨如何给出奖励,针对哪些过程给出奖励,奖励的密度如何:
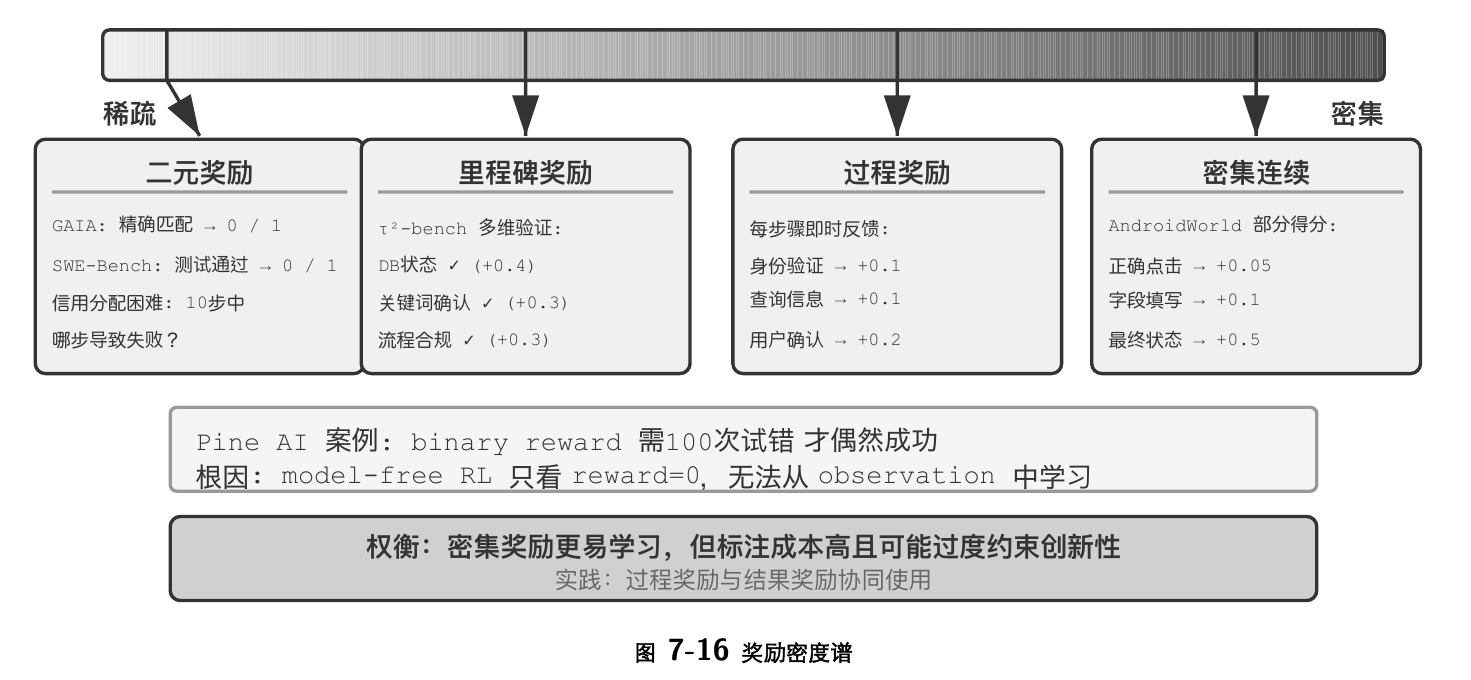
学习工具调用
工具 RL 还有一个绕不开的工程细节:对环境反馈的 token 做损失屏蔽(loss masking)。一条工具调用轨迹里既有模型自己生成的 token(思考、工具调用参数),也有环境返回的 token(代码解释器的输出、搜索结果、客服的回话)。后者不是策略生成的、而是环境给定的——如果把它们也计入策略梯度,模型就会被训练去“预测沙盒会输出什么”,这既偏离了优化目标,又会让训练变得不稳定。标准做法是在计算损失时把环境反馈 token 屏蔽掉,只对模型自己生成的 token 回传梯度。这正是 ReTool 的核心技术点之一(对 <interpreter> 标签内的反馈 token 屏蔽梯度),也是 Search-R1 所说的“对检索到的 token 做屏蔽以稳定训练”,veRL、AWorld 等主流训练框架都内置了这一机制。
ch8: Agent的持续进化
今天的 Agent 面临一个鲜明的能力悖论:它可以零样本解决从未见过的复杂任务,却可能在处理了一万次相似任务之后,第二天仍然犯下第一天的错误。能否自主从经验中学习,正在成为 Agent 从“会完成任务”走向“能够可靠工作”的关键能力,也是下一代模型的核心研究课题。 然而,目前模型本身的持续学习能力仍远远不够。
原因在于,部署后的模型并不会因为一次推理自动改变参数。第二章讨论的上下文学习、状态维护和压缩,能让 Agent 在当前任务内适应;但上下文结束后,这种变化不会自然进入下一次任务。把对话存进记忆也不等于学会了新的行为:原始轨迹可能很长,其中既有有效策略,也有偶然成功、错误归因和不可信输入。
然而,我们不可能为单个用户定制模型,也不能用每次API调用的数据来学习,所以需要将该能力内置于Harness中.
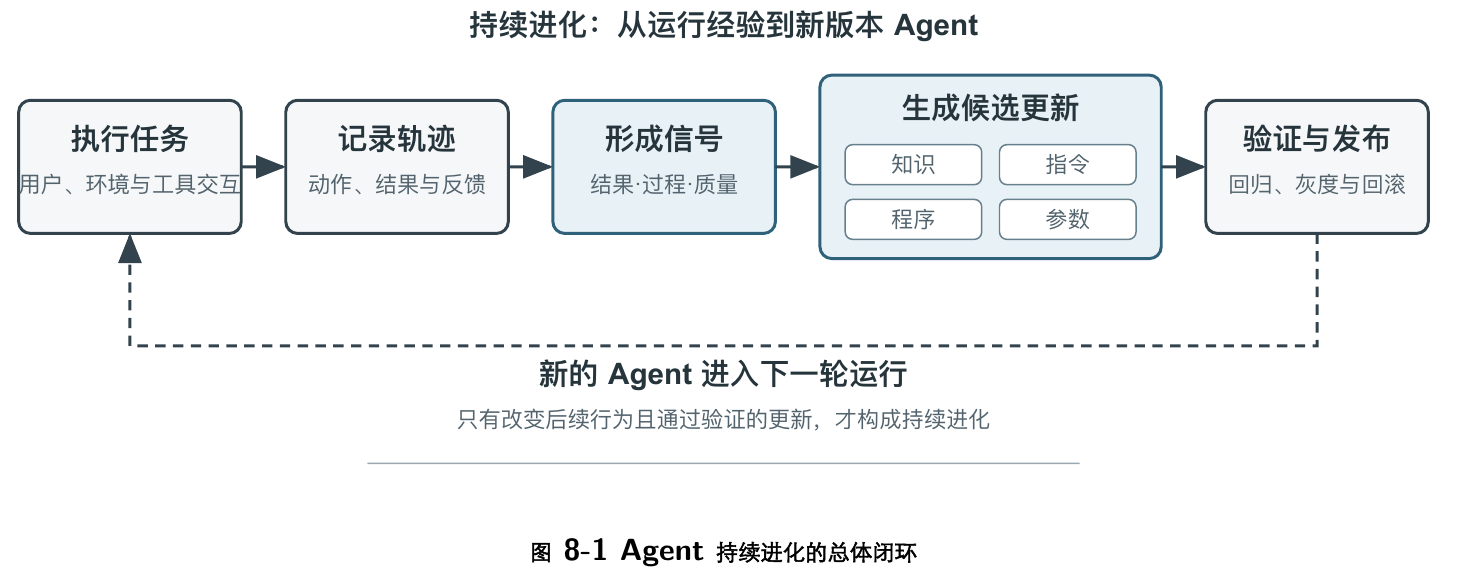
就我来看,只要LLM训练还是无状态的,记忆能力就不可能内化,那么光靠Harness还是独木难支的,不具备生产价值.
ch9: 多模态
先划定本章的边界。静态的图像与文档理解——看一张截图、读一幅图表、解析一份 PDF——已经作为感知工具自然融入了前面各章的 Agent 实践:对今天的多模态大模型来说,这类“一次输入、一次理解”的任务已相对成熟,不需要专门的架构设计。本章聚焦的是另一类问题:实时性把多模态问题变难的三个场景——语音对话、GUI 操作、机器人控制。
要理清语音 Agent 的技术演进,一个清晰的坐标系是 OpenAI 在 2026 年发布 GPT-Live 时给出的三分法——它恰好对应了 ChatGPT 语音自身走过的三代架构:
- 级联(Cascaded):把语音识别(ASR)、大语言模型(LLM)、语音合成(TTS)三个模型串成一条流水线,一棒接一棒。最早的 ChatGPT Voice 就是这样,它第一次让人能“对话”前沿模型,但信息在模型间传递时会丢失,回应缓慢而生硬。
- 端到端全模态(Omni):用单一模型直接“听音频、想回复、说出来”,把三段合一,延迟更低、韵律与情感等非文字信息得以保留。但它仍然假设“轮流说话”——模型要等用户停顿才开口,而轮次切换靠静音来判断,稍一停顿或有背景噪音就可能被误判为“说完了”,在不该插话时插话。ChatGPT 的高级语音模式(Advanced Voice Mode)就属于这一代;OpenAI 把它称作“轮次式语音模型(turn-based)”,工业界更常按模型能力称之为“全模态(Omni)”模型(如 Qwen3-Omni),两个名字指的是同一类东西。
- 全双工 / 交互式(Full-Duplex / Interactive):模型边听边说,同时处理输入与输出,每秒做许多次“该说、该听、该停、该打断、还是该调用工具”的决策,彻底取消了“轮流”这个假设。2024 年 Kyutai 的 Moshi 是研究先声,2026 年 OpenAI 的 GPT-Live 把它带到了 1.5 亿用户的规模。
非常值得看的一章,多模态的探索路程十分有趣,而且是真的有工程意义的.
本章的三个场景(语音、Computer Use、机器人)都面临“感知-思考-行动”循环的延迟问题,都朝着快慢思考并行化的方向演进。在语音场景中,这表现为“说错了再纠正”;在 Computer Use 场景中,这表现为“先点再看”;在机器人场景中,这表现为“走一步看一步”。如何保证这些基于快思考的行动不会导致无法挽回的后果?
- 无法保证!
ch10: 多Agent
多agent的决策
- 上下文是否共享
- 共享意味着信息不丢失,但上下文可能快速膨胀
- 不共享意味着彼此界限分明,但需要定义好消息和参数传递,还可能需要一个消息总线,设计上会比较复杂
- 考虑到真实环境中的开发,不共享是必然的趋势,这样可以确保彼此之间的责任是解耦的
- 协作方式: 如管理者模式,对话模式,去中心化模式
要不要引入多Agent,关键在于,协作过程是否引入了单个 Agent 在生成时无法获得的新信息?
而在实际操作中,多Agent的token消耗是远远超过单Agent执行的,这也不奇怪,毕竟大多数新Agent的token不仅没有缓存命中,还需要重新积累上下文,可能还要承担繁重的工具调用解析任务.
不共享上下文的协作
为什么不能让一个 Agent 自己生成再自己审查?这正是前面“多 Agent 何时真正优于单 Agent”一节那条判据的具体落点——审查若不引入新信息,就只是“让模型再想一遍”。相关研究对此给出了明确的答案。Huang 等人在 ICLR 2024 论文《Large Language Models Cannot Self-Correct Reasoning Yet》中发现:让 GPT-4 在没有外部反馈的情况下审查并修正自己的回答,准确率反而下降——模型把正确答案改错的次数比把错误答案改对的次数更多。
总结
Agent 技术仍在飞速演进,一本书追不上所有变化。但如果这本书让你带走的不是某个 API 的具体用法,而是一套能在技术浪潮里保持清醒的判断力,那它就完成了使命。本书全部正文、配图与配套实验代码都是开源的,欢迎你去仓库里把实验亲手跑一遍、提 issue 和 PR——读懂和做出来之间,隔着一条只能靠双手跨过的河。而 Agent 最迷人的地方,正在于它能通过写代码创造新的能力,甚至改进自己;读到这里,你已经握住了“创造”的原则。接下来,去造点什么吧。
我说这是近几年最优秀的中文技术书籍应该不过分吧,时效性高,专业性强,又有配套实验,至少国外目前还是没有这么清晰的书籍的.
基础
Test-Driven Development with Python
ch1: 使用Django
通常,Web 开发的第一步是安装和配置 Web 框架。下载这个,安装那个,配置其他的,运行脚本……但 TDD 需要不同的思维方式。当你进行 TDD 时,你的脑子里总会有一只“测试山羊”——就像山羊一样,一心只想着测试——不停地叫着:“先测试,先测试!”
在测试驱动开发(TDD)中,第一步始终相同:编写测试。
首先,我们编写测试;然后运行测试,并检查它是否如预期般失败。只有这样,我们才能继续构建应用程序的部分功能。用山羊般的声音重复一遍。
ch2&&ch3: 单元测试与功能测试
功能测试(Functional test,也称End to End test,或者Acceptance test)从高层的用户体验指导我们进行开发,而单元测试(unittest)从代码层面指导开发.
TDD的工作流程如下:
- 编写功能测试
- 一旦功能测试失败,就开始编写单元测试来定义代码的具体行为,目标是每一行代码至少要经过一个单元测试的验证
- 一旦单元测试失败,就编写尽可能少的代码来让单元测试通过
- 重新运行功能测试,通过后就可以继续编写一些新的测试来循环开发.
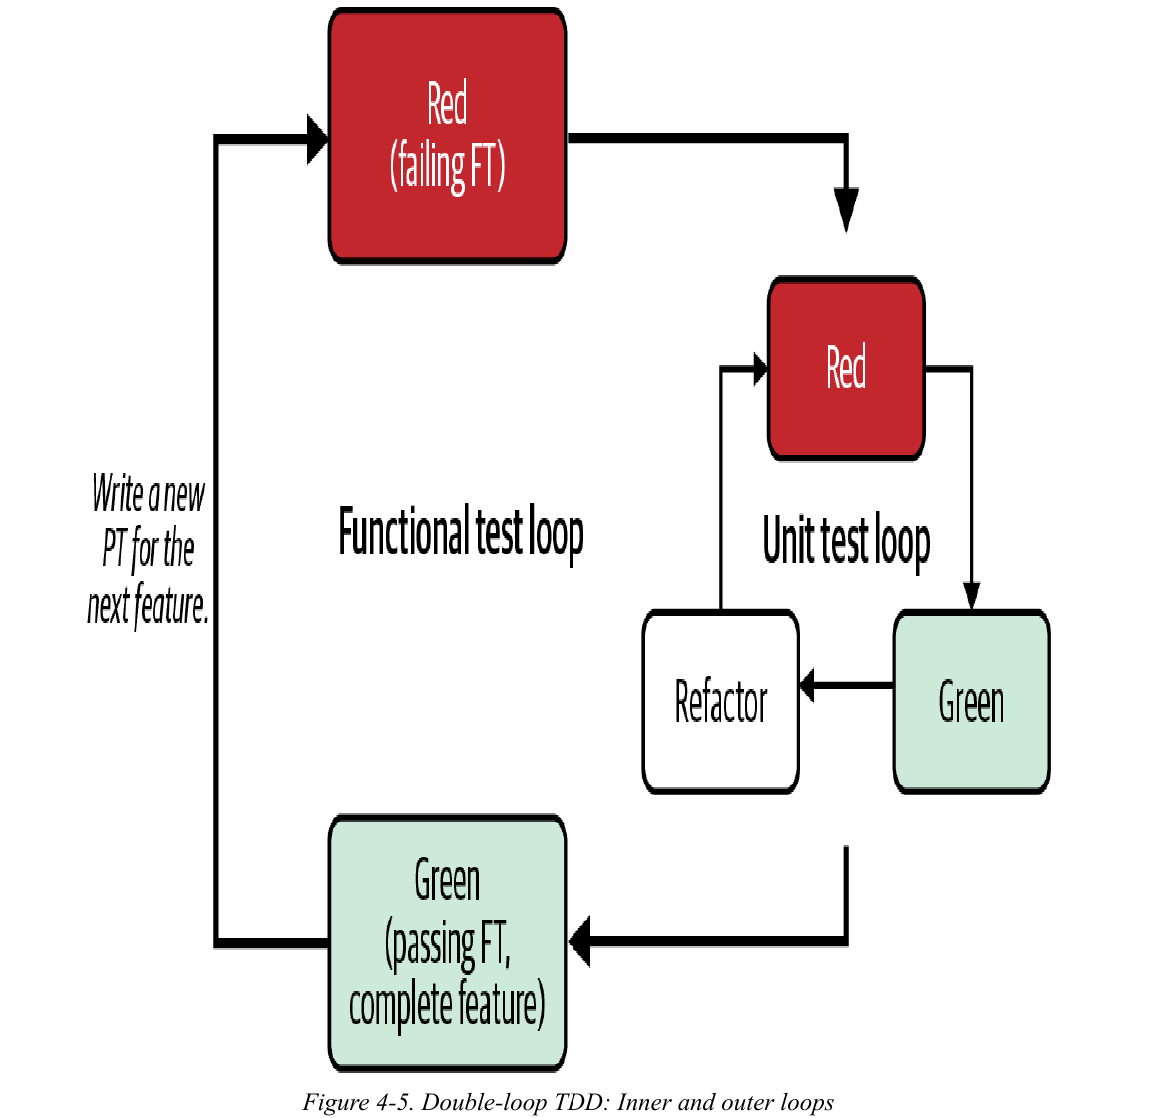
ch5: 测试数据库
总结
偷工减料、跳过一些测试总是更容易。而且,这种做法在心理上尤其难以接受,因为回报与你投入的时间点完全脱节。你现在花时间编写的测试不会立即见效;它只有在很久以后才会发挥作用——也许是几个月后,当你重构代码时,它能避免引入 bug;或者,当你升级依赖项时,它能发现回归问题。又或许,它会以难以衡量的方式回报你,比如鼓励你编写设计更完善的代码,但你却会说服自己,即使没有测试,你也能写出同样优雅的代码。
不过,有一点需要记住:拖得越久,就越难。另一点是,就像温水煮青蛙的故事一样,痛苦只会逐渐显现,你可能要等到错过了最佳的转换时机才会察觉。而且,转换的时机永远不会很方便。就像技术债务一样,面对更紧迫的优先事项,转换总是难以找到合理的理由。
或许以后我会再来看,但不是现在.
Kafka: The Definitive Guide,2nd edition
- 出版于2021年(第2版),出版商:O’Reilly,作者:Gwen Shapira。
总结
不如Apache Kafka in Action远甚
Python Concurrency with asyncio
ch1: 认识asyncio
虽然asyncio的名称可能让我们认为这个库仅适用于I/O操作,但它通过支持多线程和多进程的互操作功能,也能处理其他类型的操作。借助这种互操作性,我们可以将async和await语法用于线程和进程,使这些工作流程更易于理解。这意味着这个库不仅适用于基于I/O的并发操作,还可以用于CPU密集型代码。
在Python编程领域,CPU密集型操作通常指代计算与代码处理过程,例如计算圆周率数字或遍历字典内容并应用业务逻辑。而I/O密集型操作则多见于等待网络传输或其他输入输出设备响应的场景,比如向网络服务器发送请求,或读取本地硬盘中的文件。
并发与并行
并发(concurrency)指的是两个任务可以交错/并排执行,即具有顺序无关性,或者说,彼此独立.如: 我们不必等到完成第一个蛋糕才开始为第二个蛋糕进行准备工作。我们可以先做好一份蛋糕糊放进立式搅拌机,趁它搅拌完成前开始准备第二份蛋糕糊。在这种模式下,我们正在同时切换处理不同的任务。这种任务间的切换行为——比如在烤箱预热时做其他事、穿梭于两种蛋糕的制作之间——正是并发行为的体现。
并行(parallelism)指的是两个任务正在同时发生,即并排执行这件事已经发生了.以烘焙蛋糕为例,假设我们有一位助手的帮助:在此场景下,我将制作第一块蛋糕,而第二位烘焙师则同时制作第二块蛋糕。两人同时搅拌面糊就是典型的并行计算,因为我们实现了两个独立任务的并发执行。
multitask
- preemptive multitasking(抢占式多任务): 通过时间切片机制,由操作系统在后台主动切换任务
- cooperative multitasking:(协作性多任务): 在应用程序中显式编排任务,在某些时间点允许其他任务插入进来执行.
asyncio用协作性多任务来实现并发,即用async/await显式标记某些任务是可以被中断的.
进程、线程、多线程以及多进程
- 进程是一个应用程序运行实例,拥有其他应用程序无法访问的独立内存空间
- 线程是轻量级进程,**不像进程那样拥有独立内存,而是共享创建它们的进程的内存空间。**线程与创建它们的进程相关联。每个进程至少会有一个关联线程,通常称为主线程。进程还可以创建其他线程,它们常被称为工作线程或后台线程。这些线程能与主线程并发执行其他任务。与进程类似,线程可以在多核CPU上并行运行,操作系统也能通过时间片轮转在它们之间进行切换。当运行普通Python应用程序时,我们会创建一个进程以及用于运行该Python应用的主线程。
多线程并非实现并发的唯一方式;我们还可以创建多个进程来同时完成工作,这被称为多进程。在多进程中,父进程会创建一个或多个由其管理的子进程,随后可以将任务分配给这些子进程处理。
GIL
全局解释器锁(简称GIL,发音为"gill")是Python社区中备受争议的话题。简而言之,GIL阻止单个Python进程在任意时刻执行超过一条Python字节码指令。这意味着即使机器拥有多核心并开启多线程,一个Python进程同时也只能有一个线程在运行Python代码。在当前多核CPU普及的时代,这给希望利用多线程提升应用程序性能的Python开发者带来了重大挑战。
asyncio利用I/O操作会释放全局解释器锁(GIL)这一特性,即使仅靠单线程也能实现并发.
使用asyncio时,我们会创建名为协程的对象。可以将协程理解为轻量级线程的执行体。就像多线程环境下每个线程可同时进行独立的I/O操作一样,多个协程也能协同并行运行。在等待I/O型协程完成任务的同时,我们仍可执行其他Python代码,从而实现并发。需要特别注意的是,asyncio并未绕过GIL的限制,我们依然受其制约。若遇到CPU密集型任务,仍需借助多进程方案来实现并发执行(可通过asyncio自身实现),否则将导致应用程序性能问题。
How single-threaded concurrency works
通信的底层都是通过socket实现的,默认情况下,socket是阻塞的,这意味着我们在发送请求之后,只要数据尚未传输完成,我们的应用就会停止运行其他任务.
但我们可以将socket配置为非阻塞的,那么就能实现并行处理多项事务,而不用再空等数据传输回来,只需要由操作系统主动通知我们传输完成即可.
在后台,这一功能由几个不同的事件通知系统执行,具体取决于我们运行的操作系统。asyncio的抽象程度足够高,以至于它能够根据我们操作系统所支持的不同通知系统进行切换。以下是一些特定操作系统使用的事件通知系统:
- linux: epoll
- MacOS: kqueue
- Windows: IOCP
How an event loop works
事件循环是所有asyncio应用程序的核心。事件循环是许多系统中相当常见的设计模式,且已存在相当长的时间。如果你曾在浏览器中使用JavaScript发起异步网络请求,实际上就已经在事件循环上创建了一个任务。Windows图形用户界面应用在底层使用所谓的消息循环,作为处理键盘输入等事件的主要机制,同时仍允许UI进行绘制。
在asyncio中,事件循环维护的是一个任务队列而非消息队列。任务是对协程的封装。当协程在执行时遇到I/O密集型操作,它会暂停执行,允许事件循环运行其他无需等待I/O操作完成的任务。
ch2: asyncio basics
Coroutines
将协程想象成一个普通的Python函数,但它具备一个超能力:当遇到可能需要较长时间才能完成的操作时,可以暂停自身的执行。待那个耗时操作完成后,我们就能“唤醒”暂停的协程,继续执行该协程中的剩余代码。在等待暂停操作完成期间,我们可以运行其它代码。这种在等待过程中并行执行其它代码的能力,便是应用程序实现并发的体现。
async关键字让我们定义协程;而await关键字则允许我们在执行耗时操作时暂停协程。
| |
当我们调用常规的 add_one 函数时,它会立即执行并返回预期的整数值。然而,当调用 coroutine_add_one 时,我们的协程代码完全没有被执行,而是返回了一个协程对象。
也就是说协程不会在直接调用时执行,而是创建了一个需要事件循环主动激活的协程对象,比如我们可以引入asyncio.run执行器:
| |
asyncio.run在此场景中执行了几项关键操作。首先,它创建了一个全新事件。成功创建事件后,它会接收我们传入的任何协程并运行至完成,随后返回执行结果。该函数还会在主协程运行结束后清理残存运行状态。待所有任务完成,它将关闭并终止事件循环。
要暂停执行,我们使用 await 关键字。await 关键字后面通常跟随着对一个协程的调用(更具体地说,是一个被称为可等待对象的对象,它并不总是协程;我们将在本章后面了解关于可等待对象的更多内容)。
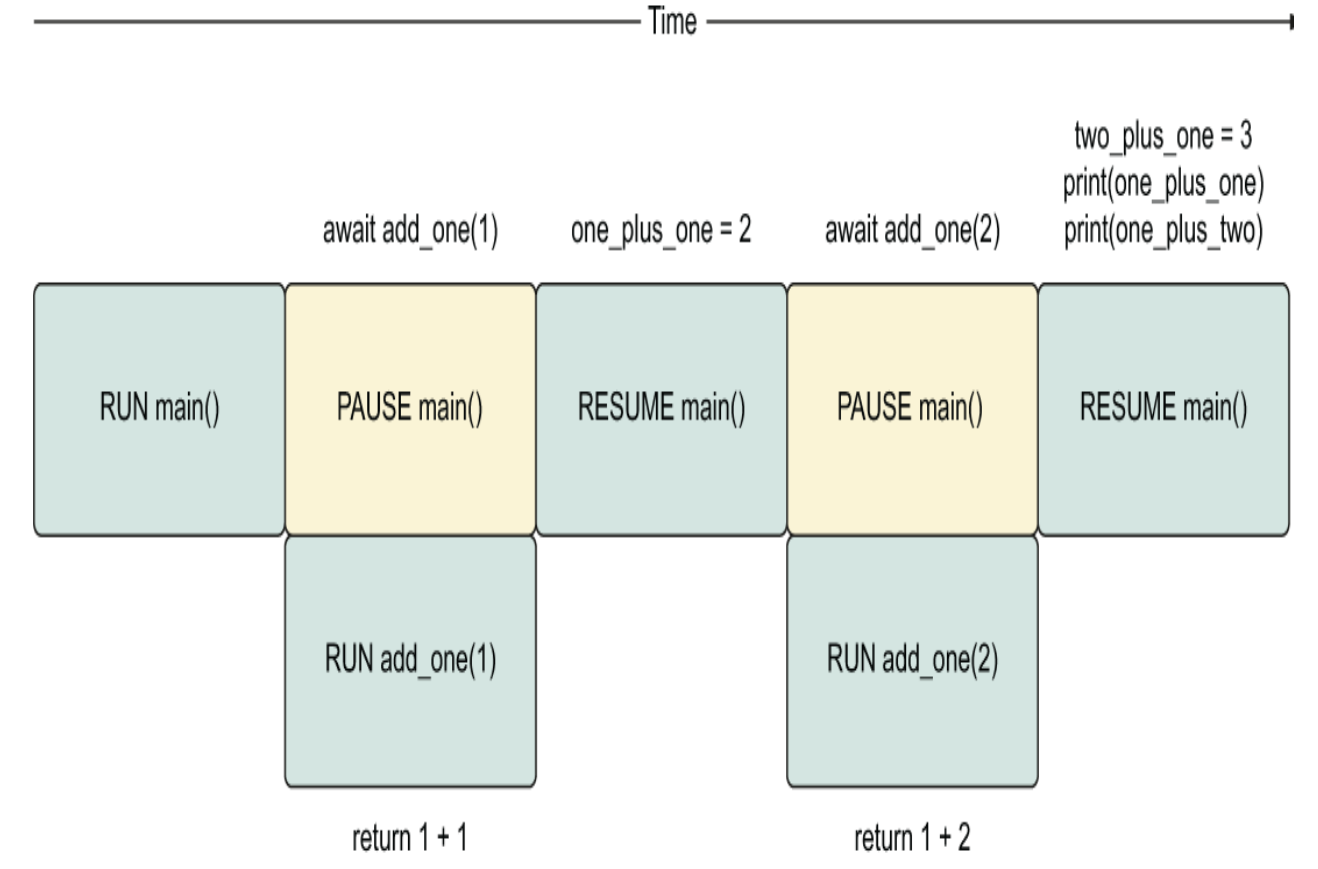
asyncio.sleep
我们可以使用 asyncio.sleep 使协程在指定秒数内"休眠"——这会暂停协程一段给定的时间,模拟调用数据库或Web API时可能出现的长时间运行状态。
asyncio.sleep 本身是一个协程,因此必须使用 await 关键字与其搭配使用。若直接单独调用,则会返回一个协程对象。
| |
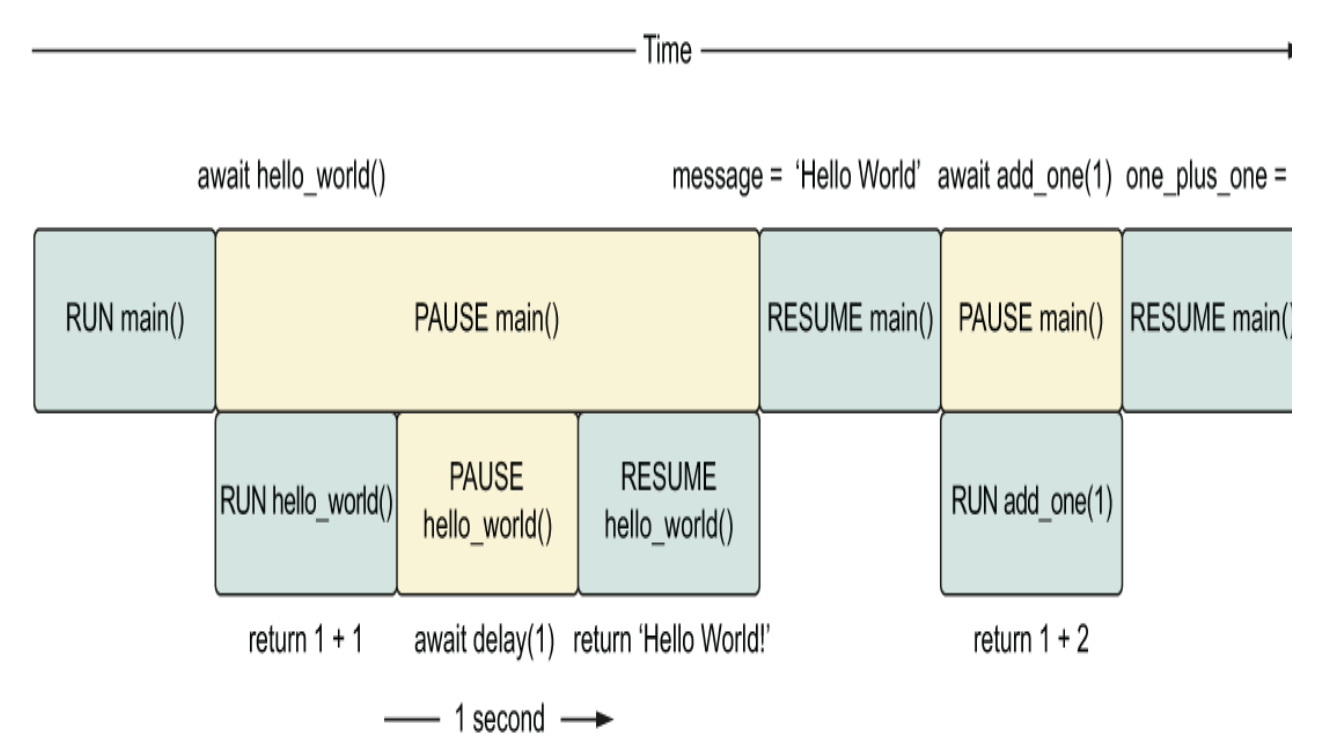
tasks
Task是对协程的封装,提供一个尽可能早地在事件循环中运行的机会,以非阻塞方式进行,意味着一旦我们创建了一个任务,就可以在任务运行的同时立即执行其他代码.这与await的阻塞调用正好相反:
| |
上述程序的总用时为3s,因为task是一个非阻塞协程
任务可以随时取消,在await被取消的任务时会引入CancelledError异常,写法如下:
| |
还可以用wait_for方法来显式标明timeout时间,并在超时后抛出TimeoutException:
| |
Tasks, coroutines, futures, and awaitables
协程和任务都可以在await表达式中使用。那么它们之间的共同点是什么?要理解这一点,我们需要了解future和awaitable。通常你不需要直接使用future,但理解它们是掌握asyncio内部机制的关键。
future是一个Python对象,包含一个你期望在未来得到,但目前可能暂未获取的一个值:
| |
输出结果:
| |
当我们await一个future时,意味着这样一件事: 暂停,直到future拥有一个我可以处理的值,一旦获得值,就唤醒我让我处理它
实际上,task直接继承自future。可将future理解为代表一个暂时无法获取的数值,而task则可被视为协程与future的结合体。当我们创建task时,实际是在创建一个空future并运行协程。随后,当协程以异常或结果的方式完成时,我们会设置该future的结果或异常。
二者之间的共同联系是Awaitable抽象基类,这个基类定义了一个__await__方法,任何实现了该方法的对象都可以用于await表达式中,因此,所有可在await表达式中使用的对象统称为可等待对象.
pitfalls和要点
需要注意的是,如果await的对象本身是阻塞的,那么就不会带来任何并发执行的效果,最典型的就是使用requests库进行网络请求:
| |
由于requests的阻塞问题,所以上述代码的用时就是三个请求的累加用时,所以最好换用aiohttp这样的非阻塞库.
手动创建事件循环
我们可以通过使用asyncio.new_event_loop方法来创建一个事件循环,该方法将返回一个事件循环实例。通过这个实例,我们可以访问事件循环提供的所有低级方法。借助事件循环,我们可以使用一个名为run_until_complete的方法,它接收一个协程并运行至其完成。完成事件循环的使用后,我们需要将其关闭以释放其占用的资源。这通常应放在finally代码块中,以确保任何抛出的异常不会阻止我们关闭循环。利用这些概念,我们可以创建循环并运行一个asyncio应用。
| |
开启调试模式
默认情况下debug选项是关闭的,我们需要显式设置:
| |
在出现一些异常情况时,该选项会很有用.
ch4: Concurrent web requests
如果要启用async with,需要在类中定义__aenter__和__aexit__块,从而可以支持异步代码的自动清理
asyncio.gather 返回一个可等待对象。在 await 表达式中使用它,会暂停直至传入的所有可等待对象均完成。当所有传入对象完成后,asyncio.gather 将返回包含已完成结果的列表。
| |
值得注意的是,返回结果是[3,1]而非我们认为根据完成速度达成的[1,3],原因在于gather有一种特殊的future实现方式.
虽然 asyncio.gather 适用于许多情况,但它有一个缺点:在所有可等待对象完成之前,不允许访问任何结果。如果我们希望结果一产生就进行处理,这就是个问题。如果有一些可等待对象能快速完成,而另一些则需要较长时间,这个问题也会凸显,因为 gather 会等待所有操作结束。这可能导致应用程序响应变慢。
一个方法就是使用as_completed方法来取代gather:
| |
as_completed方法还可以用timeout参数设置超时时间,一旦任务的执行时间达到timeout值,就会抛出TimeoutException异常,但是已经创建的任务会继续在后台执行,无法关闭.
为了实现更精细的掌控,asyncio提供了wait方法:
| |
没有任何额外参数的wait与gather的作用相同,要想有点不同,需要加上return_when=asyncio.FIRST_EXCEPTION,或者修改一下结构:
| |
ch5: Non-blocking database drivers
假设我们有一个包含两个连接的连接池。再假设我们有三个协程,每个都执行一个查询任务。我们将这三个协程作为任务并发运行。按照这种连接池设置,前两个尝试执行查询的协程会获取两个可用连接并开始运行查询。在此期间,第三个协程将等待连接变为可用状态。当前两个协程中任意一个完成查询后,它会释放连接并返还给连接池。这使第三个协程能够获取该连接并开始执行查询。
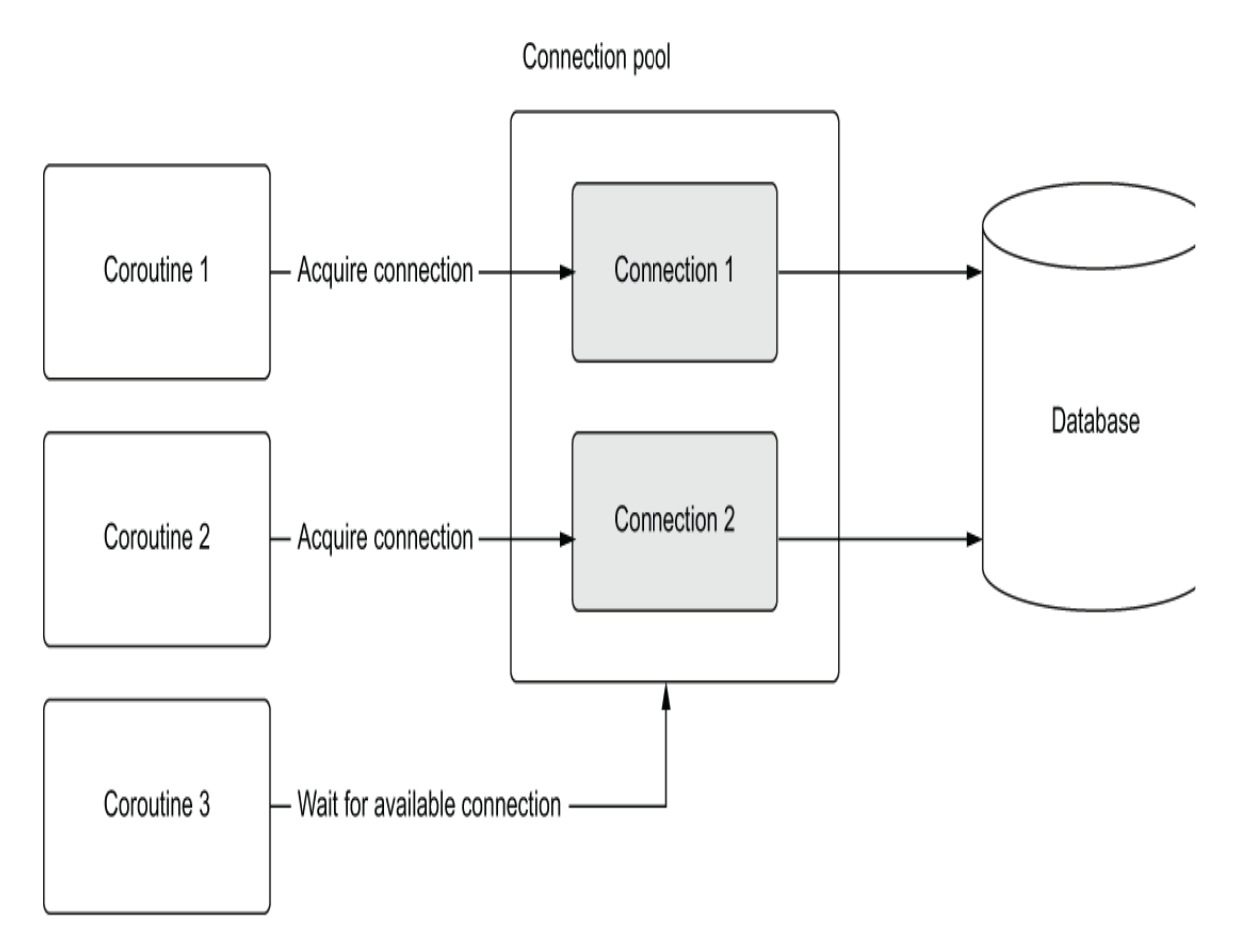
ch6: CPU密集型任务(待补充)
asyncio 提供了与 Python 多进程库交互的 API。这使我们能够使用 async await 语法以及多进程下的 asyncio API。通过这种方式,即使在处理 CPU 密集型代码时,也能享受 asyncio 库的优势。
单纯的多进程调度比较麻烦:
| |
- start():启动子进程,让子进程开始执行任务。
- join():等待指定子进程结束,再继续执行当前进程后面的代码。
也就是说,start负责启动,而join不会阻塞已经启动的子进程,只会阻塞主进程,直到子进程执行完毕.
进程池
进程池不需要我们显式join进程,而是通过apply方法启动:
| |
apply的问题在于它是同步调用,要想异步执行,就要换成apply_async方法,但它的问题在于,即便某个任务完成了,但如果用时更长的任务置于该任务上方串行调用,那么也会发生阻塞,不能做到随去随用.解决方法就是用ProcessPoolExecutor
ProcessPoolExecutor
| |
ProcessPoolExecutor的问题在于,它对任务是按照numbers列表的顺序调用的,如果100000是第一个数字,那么就必须等到该数字打印完成后才能打印其他早就完成的数字,这显然不如asyncio.as_completed
ch8: Streams(待补充)
使用Socket编程太烧心了,所以asyncio构建了网络流的抽象层,封装了Socket的复杂细节.
ch9: Web应用程序
Websocket开发
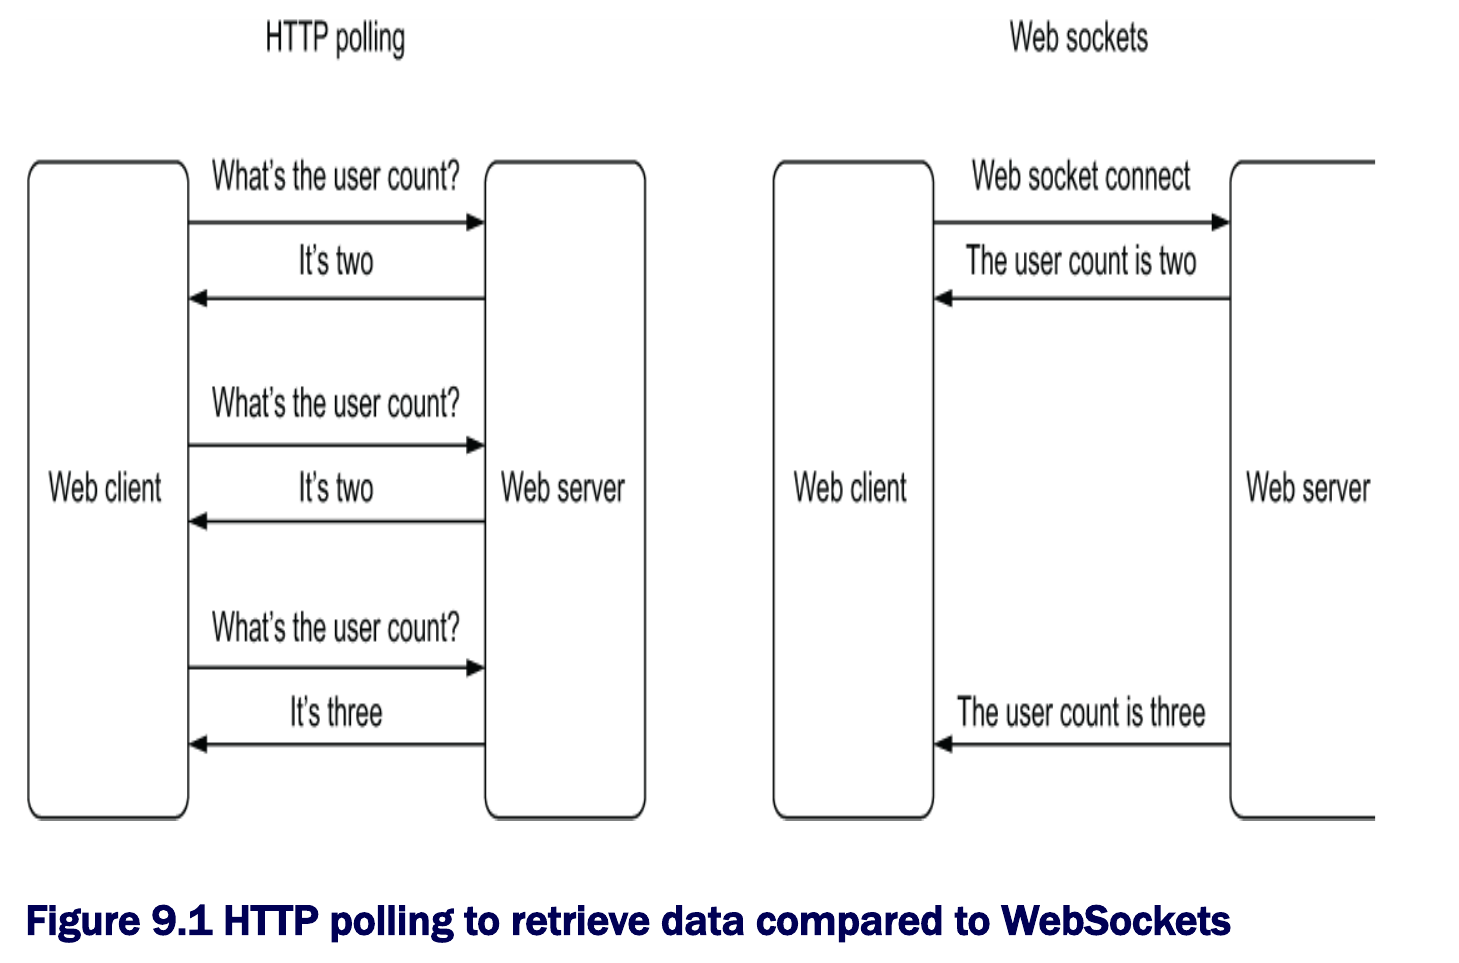
我们的计划是在内存中维护所有已连接的客户端 WebSocket 的列表。当新客户端连接时,将其添加到列表中,并向列表中的所有客户端发送更新后的用户数量。当客户端断开连接时,将其从列表中移除,并通知其他客户端用户数的变更。同时增加基本错误处理:若发送消息时发生异常,则将该客户端从列表中移除。
ch10: Microservices
用aiohttp搭后端服务,相当烧心.
总结
前面两章相当不错,后面就按需读吧
Python Testing with pytest, 2nd Edition
ch1: 介绍
以下是命名规则的简要概述,用于确保你的测试代码能被pytest识别:
- 测试文件的命名应为
test_<something>.py或<something>_test.py。 - 测试方法和函数的命名应为
test_<something>。 - 测试类的命名应为
Test<Something>。
pytest测试有以下几种结果:
- PASSED (.) — 测试运行成功。
- FAILED (F) — 测试未能成功运行。
- SKIPPED (s) — 测试被跳过。可通过使用
@pytest.mark.skip()或@pytest.mark.skipif()装饰器指示 pytest 跳过测试。 - XFAIL (x) — 测试预期会失败,实际运行也确实失败了。可通过
@pytest.mark.xfail()装饰器告知 pytest 某个测试预期会失败。 - XPASS (X) — 测试被标记为预期失败(xfail),但实际运行并通过。
- ERROR (E) — 异常发生在装置(fixture)或钩子(hook)函数的执行过程中,而非测试函数的执行过程中。
ch3: Fixtures
只要我们将fixture修饰的函数名字作为测试函数的参数,就会在测试运行时自动解析并注入到测试函数中.
如果定义在conftest.py中,就会作用于所在目录及子目录中,而不需要额外import声明,如果定义在普通测试文件中,则需要额外import声明才能生效.
对于数据库这种需要在函数关闭后再显式清理的依赖,我们需要在fixture里设置yield:
| |
yield之前的代码被称为setup,在测试开始前执行,yield之后的代码被称为teardown,在测试完成后强制执行.
用法也很简单:
| |
作用域
fixture的默认作呕功能与是函数级,这意味着每一个需要该fixture运行的测试用例都会先执行其设置部分。同样地,每个测试结束后都会执行拆卸部分。
而如果我们将scope切换为module级的话,那么该fixture只会在该模块中被启动和销毁一次.从而避免反复建立连接又销毁的问题.
除此之外,还有package级别和session级别,作用域是不断扩大的.
autouse
如果我们希望fixture不需要在参数中显式声明,默认在作用域中执行的话,则可以声明autouse=True,.
| |
ch4: 内置fixtures
pytest 的内置 Fixture 不需要显式 import,直接在测试函数的参数中声明即可:
| |
ch5: Parametrization
参数化测试指的是为测试函数添加参数,并向测试传入多组参数,从而生成新的测试用例。
比较高级,直接跳过
ch9: 覆盖率
Coverage.py 是首选的 Python 代码覆盖率测量工具。而 pytest-cov 是一个常用的 pytest 插件,常与 coverage.py 配合使用,可简化为命令行操作。还可以生成HTML报告
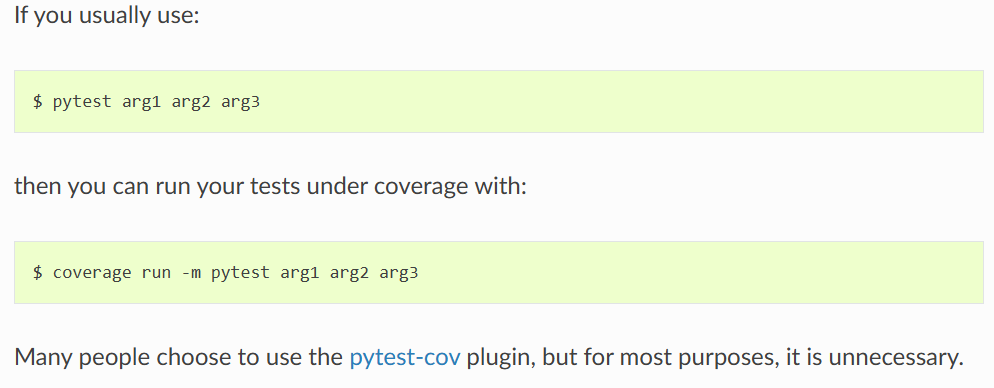
总结
讲的很不错,但日常用只看前三章就足够了
A Philosophy of Software Design, 2nd Edition
总结
不值一看
Docker Deep Dive
ch1-4: 介绍
尽管开发 Windows 容器投入了大量精力,但几乎所有容器都是Linux 容器。这是因为 Linux 容器体积更小、速度更快,而且 Linux 拥有更丰富的工具。
由于容器共享运行所在主机的内核。这意味着容器化的Windows应用需要运行Windows内核的主机,而容器化的Linux应用则需要运行Linux内核的主机。但是,如前所述,您可以在安装了WSL 2后端的Windows系统上运行Linux容器
OCI
生态系统中的主要参与者齐聚一堂,成立了 OCI,这是一个厂商中立的轻量级委员会,负责管理容器标准:
- The image-spec
- The runtime-spec
- The distribution-spec
OCI规范对容器生态系统起到了同样的作用,此后容器生态系统蓬勃发展。Docker自OCI成立以来也发生了巨大变化,所有现代版本的Docker都实现了全部三项OCI规范。例如:
- Docker 构建器 (BuildKit) 创建符合 OCI 标准的镜像
- Docker 使用符合 OCI 标准的运行时来创建符合 OCI 标准的容器
- Docker Hub 实现了 OCI 发行版规范,并且是一个符合 OCI 标准的镜像仓库。
ch5: Docker Engine
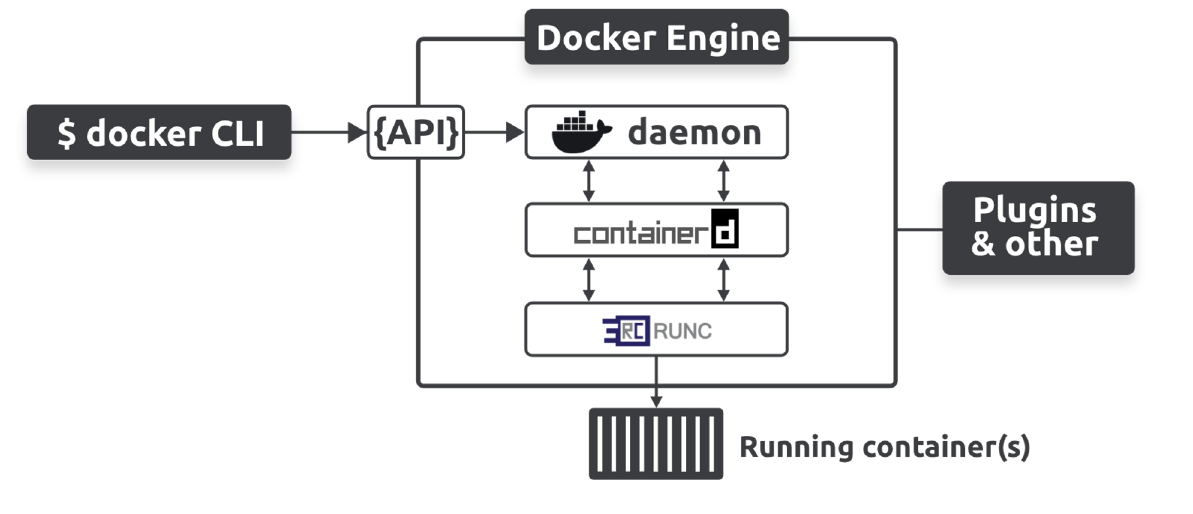
最初的Docker将所有功能都放入了daemon中,是在后面才逐渐拆分得到runc和containerd等独立工具的.
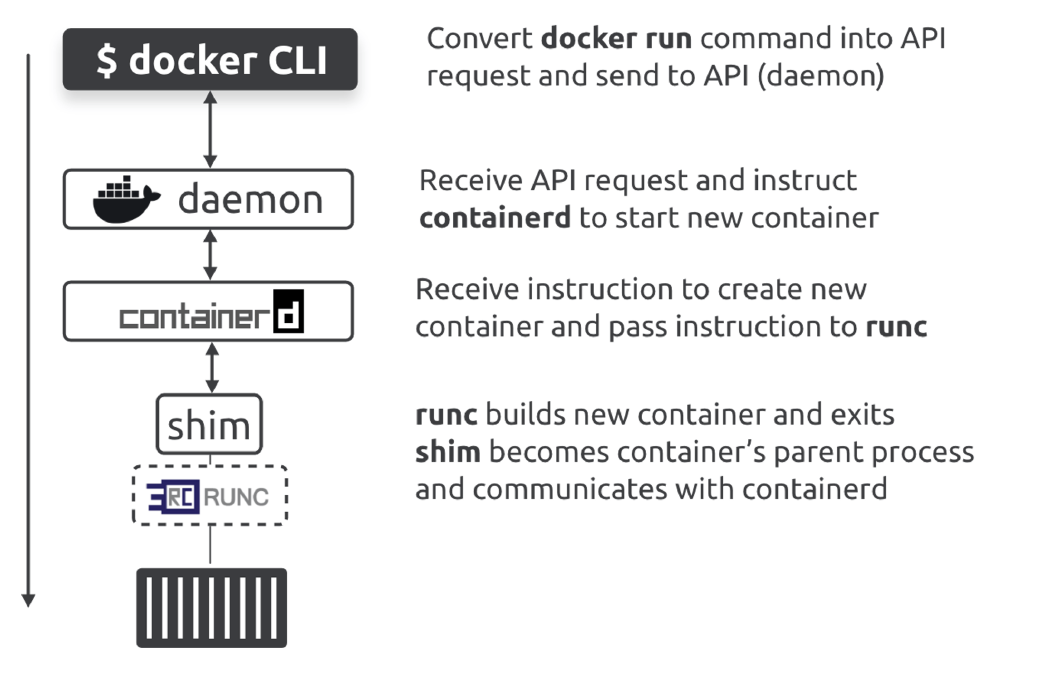
- shim可以让我们很轻松的将runc替换为其他runtime
ch6: images
例如,官方的 Alpine Linux 镜像目前只有大约 3MB。这是因为它没有预装六个不同的 shell、三个不同的包管理器,以及一大堆你可能十年才用一次的工具。事实上,现在越来越多的镜像都不包含 shell 或包管理器——如果应用程序在运行时不需要它们,镜像就不会包含。我们称这些为精简镜像
Docker在pull镜像时默认从Docker Hub拉取latest的镜像,除非特地指明,因此我们可以省略这两个字段:
| |
有两点值得注意。
- 如前所述,如果您未在仓库名称后指定镜像标签,Docker 会默认将镜像标记为
latest。如果仓库中没有标记为latest的镜像,则该命令将失败。 - 标记为
latest的image不保证是存储库中最新的image
ch7: 容器
介绍rm,exec,ps,run等常见容器命令.
ch8: 构建容器
介绍了多阶段构建,多架构构建,构建的基本原理
任何时候,如果指令导致缓存未命中,缓存就会失效,并且在后续构建过程中不再进行检查。这意味着你应该编写 Dockerfile,将最有可能导致缓存失效的指令放在 Dockerfile 的末尾附近。这样可以确保构建过程尽可能长时间地利用缓存。
ch9: compose
介绍构建一个简单的网页对话大模型
ch10: Docker and Wasm(WebAssembly)
介绍了与Linux容器相比性能更好的Wasm.
ch11: Docker Swarm
Swarm 是 Docker 的原生技术,用于管理 Docker 节点集群和编排微服务应用程序。它类似于 Kubernetes,但功能相对简单,使用起来也更方便。
介绍了Swarm的基本运作机制: 节点通过Token认证来决定作为Manager还是Worker加入swarm,Manager采用Raft算法,所以最好选用奇数个Manager节点.节点间自动通过TLS通信,无需手动配置连接细节.
docker swarm init用于创建一个新的集群。运行该命令的节点将成为第一个管理器,并且该节点的 Docker Engine 会切换到集群模式。
ch12: Deploying apps to Swarm
Docker Swarm通过于Compose文件极其相同的Stack文件定义:
| |
在使用前,我们需要先初始化管理节点,并在管理节点中用stack文件创建Stack.
Docker Swarm 默认会在所有可用节点之间自动调度Replicas,包括 Worker 和 Manager 节点,并倾向于分散部署,这和Kubernetes就不太一样了.
ch13: Docker网络
从最高层面来看,Docker 网络基于以下三个组件:
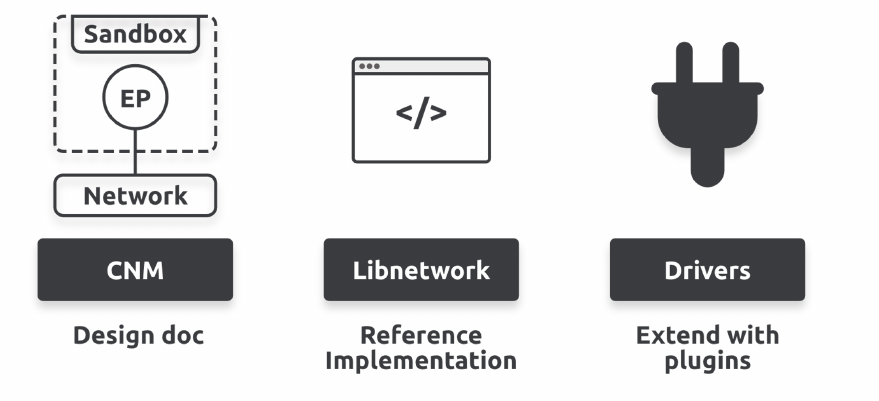
- The Container Network Model (CNM)
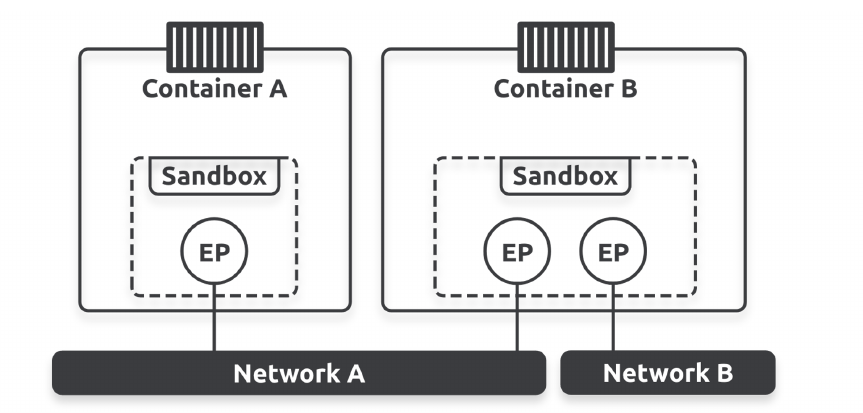
- 设计规范,概述了Docker网络的基本模块,定义了Sandbox(包括以太网接口,Ports,DNS配置等网络组件),Endpoint(虚拟网络接口,将Sandbox连接到Network),Network(虚拟的交换机)
具体的通信过程如下:
- Libnetwork
- 隶属于Moby项目,是CNM的具体实现.原来也是放在Daemon中的,后来被移除出来作为外部库配置,实现了网络控制平面(即API managements,服务发现,负载均衡等功能)
- Drivers
- 作为数据平面,负责创建网络并确保隔离和连通性
我们创建的每个network都属于一个driver,该driver负责创建和管理network的所有相关内容
Single-host bridge networks
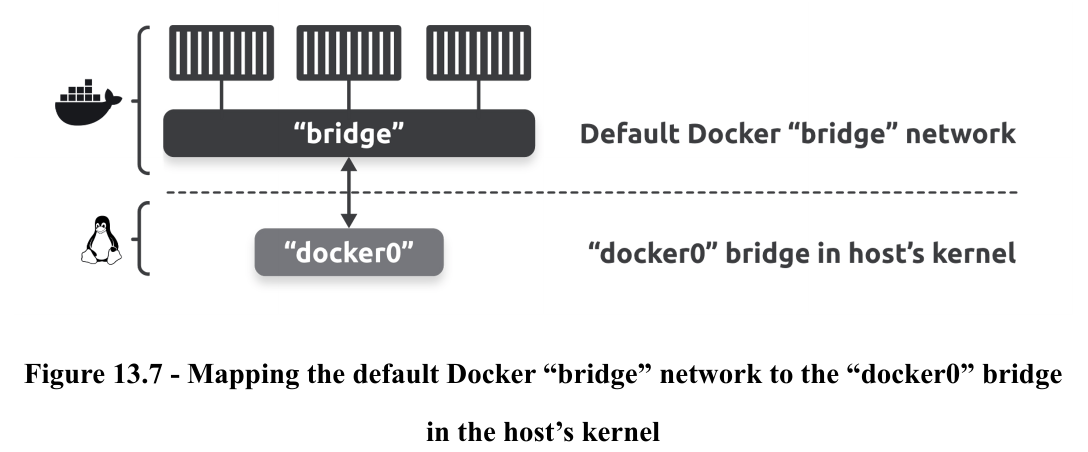
这是最简单的network类型,只运行在一个host中.每个host都会自动创建一个名为Bridge的默认Network,Docker 会将新容器连接到该网络,除非您使用 –network 标志覆盖它。
所有基于 Linux 的 Docker 主机上的默认桥接网络名为 bridge,它映射到主机内核中名为 docker0 的底层 Linux 桥接网络:
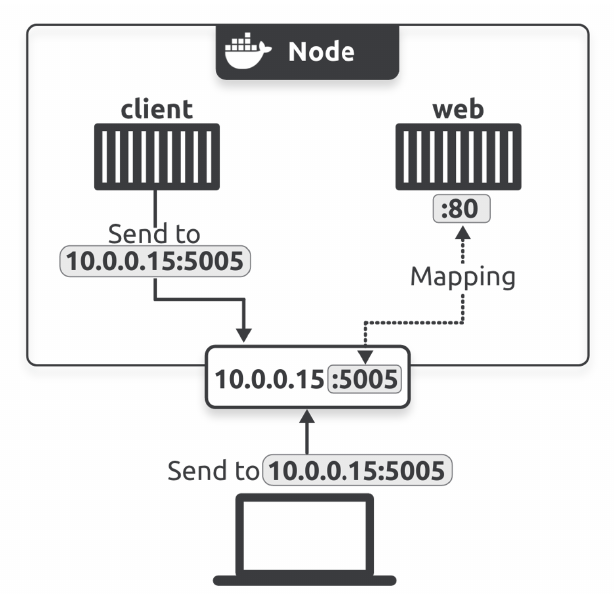
端口映射
ch14: Docker overlay networking
很专业,可跳过
ch15: 持久化存储
对于无状态应用程序,Docker 会为每个容器创建一个与容器生命周期绑定的非持久性本地存储区域。该存储区域适用于存放临时数据和临时文件,但当您删除容器或容器终止时,该存储区域内的数据将会丢失。
连绑定挂载和volume的区别都没讲,不够深入
ch16: Docker安全
在Docker中,命名空间提供了轻量级的隔离,每个Docker容器都有一下独立的namespace:
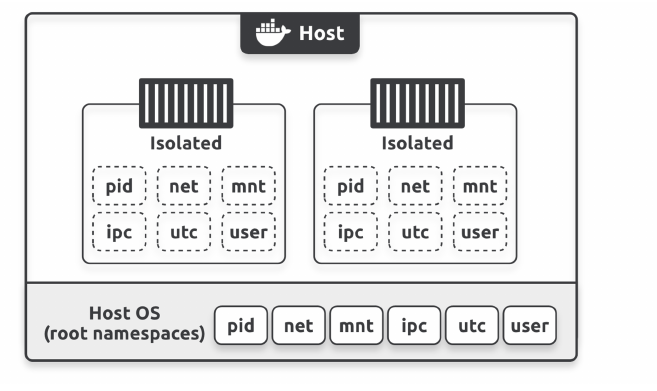
- PID: 每个容器都有自己的PID 1,无法查看或者访问其他容器或者主机中的进程,
- network: 每个容器都有自己的IP地址和网络接口,所有内部端口都不会冲突
- mount: 每个容器都有自己的文件系统,可以有自己的
/根文件系统和/etc等文件夹 - Inter-process Communication: 容器内的进程都可以进行共享的内存访问
- User: 每个容器都有自己的用户,我们可以将容器中的用户如root映射到主机上的非root用户
- UTS: 为每个容器提供自己的hostname
Control Groups
如果命名空间是关于隔离的,那么控制组(cgroups)就是关于限制的。
可以将容器想象成酒店里的客房。虽然每个房间看起来都是独立的,但实际上它们共享很多东西,例如供水、供电、空调、游泳池、健身房、电梯、早餐吧等等。容器也是如此——即使它们是独立的,它们也共享很多公共资源,例如主机的 CPU、内存、网络 I/O 和磁盘 I/O。
Docker 使用 cgroups 来限制容器对这些共享资源的使用,防止任何容器消耗掉所有资源,从而导致拒绝服务 (DoS) 攻击。
Linux root 用户底层拥有众多权限。这些权限包括:
- CAP_CHOWN:允许您更改文件所有权
- CAP_NET_BIND_SERVICE:允许您将套接字绑定到编号较低的网络端口
- CAP_SETUID:允许您提升进程的权限级别。
- CAP_SYS_BOOT:允许您重新启动系统。
Docker 利用权限控制功能,允许您以 root 用户身份运行容器,同时移除所有不需要的权限。例如,假设您的容器只需要绑定到低编号网络端口的权限。在这种情况下,Docker 可以以 root 用户身份启动容器,移除所有 root 权限,然后再添加 CAP_NET_BIND_SERVICE 权限。
总结
阅读体验很好,基本的要点都有了,非常优秀的Docker书籍
Kubernetes in Action, Second Edition(待补充)
- 出版于2026年(第2版),出版商:Manning,作者:Marko Lukša。
入门
ch1: Introducing Kubernetes
Kubernetes 一词源自希腊语,意为“领航员”或“舵手”,最初由Google开发.
Kubernetes集群包含两组nodes:
- control plane nodes: 控制整个集群
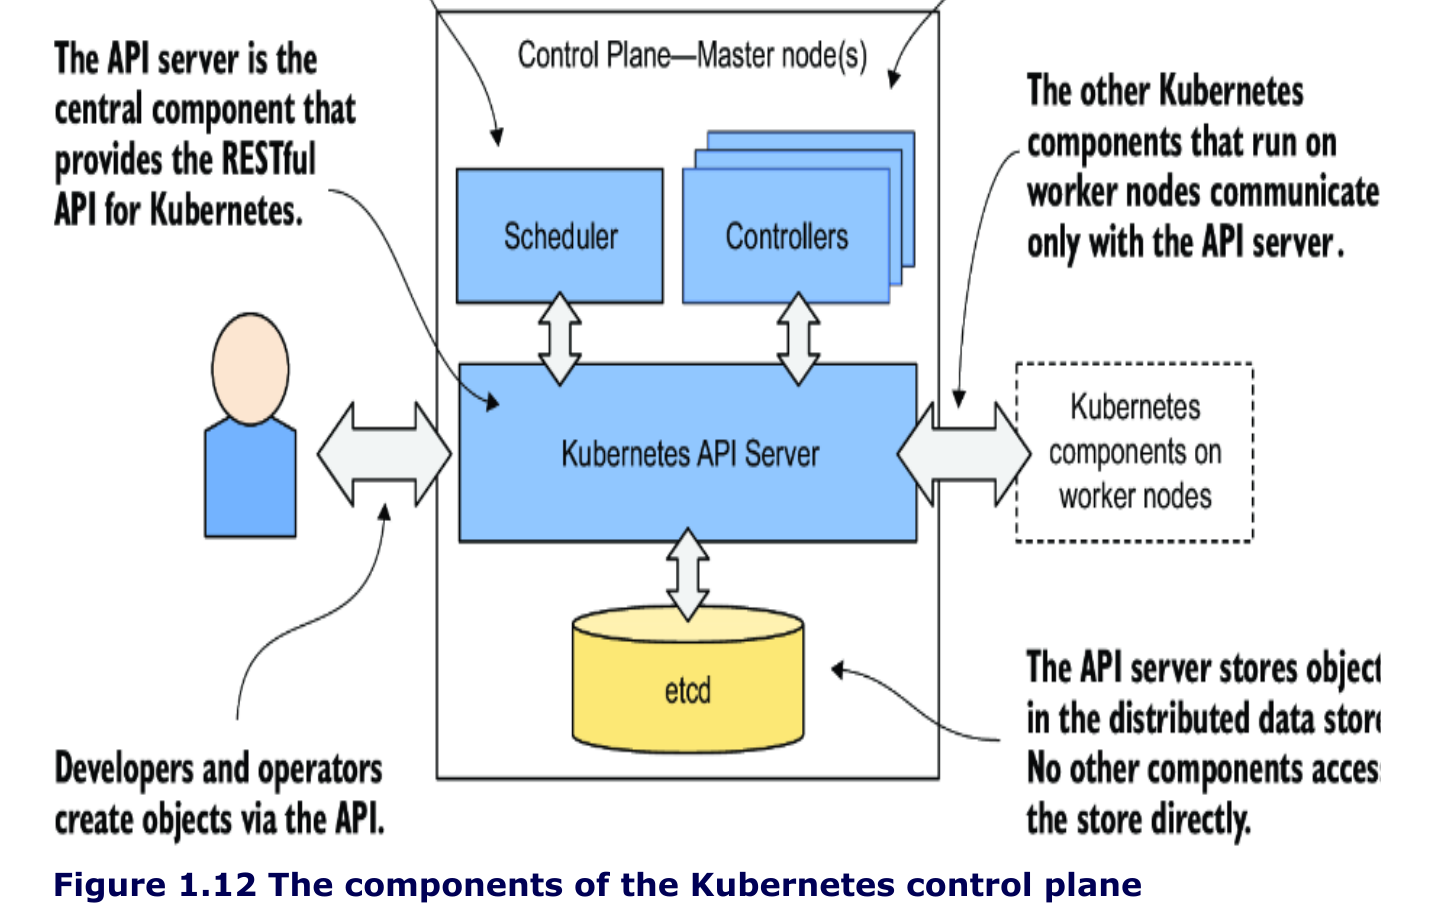
- worker nodes: 实际工作的节点.
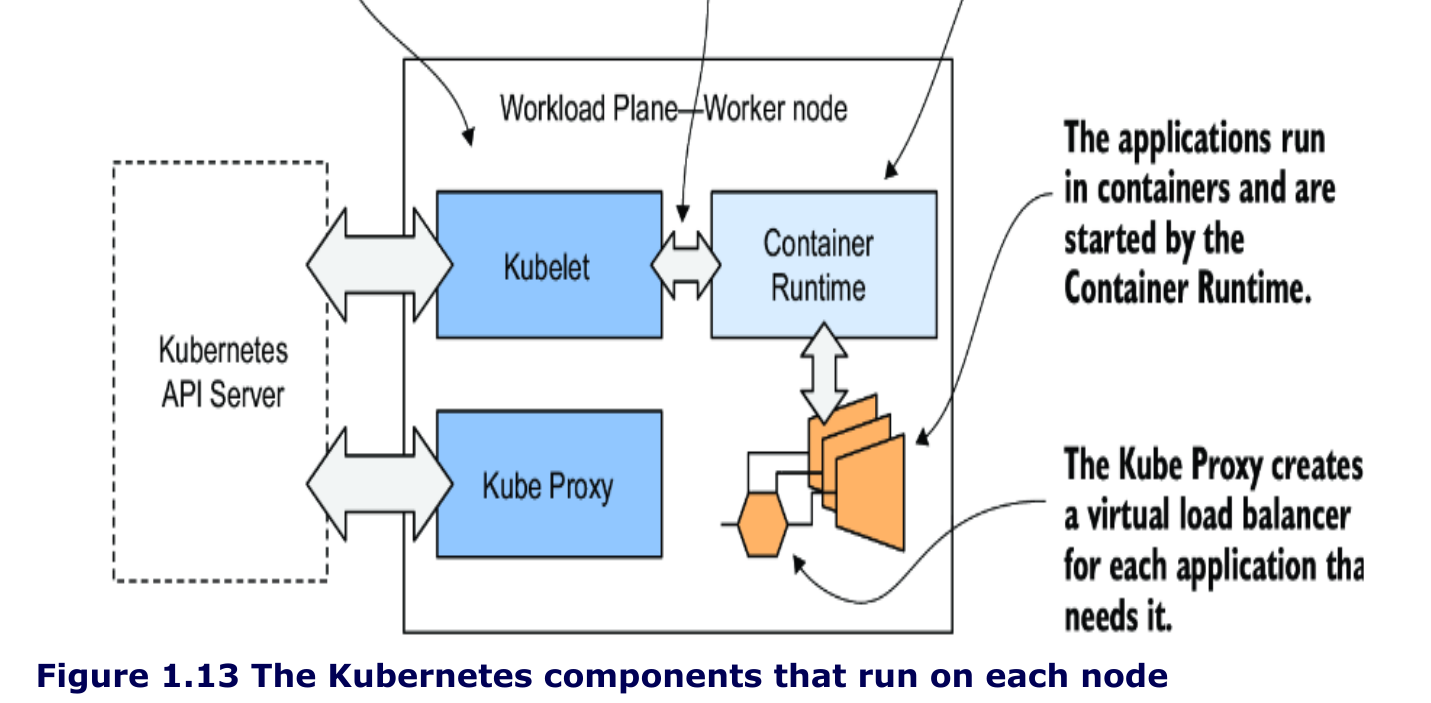
你将应用清单提交至 Kubernetes API。API 服务器随后将清单中定义的对象写入 etcd。
控制器察觉到这些新建对象,随之创建若干新对象——每个应用实例对应一个。
调度器为每个实例分配一个节点。
Kubelet 察觉到有实例被调度至其所在节点,便通过容器运行时启动该应用实例。
kube-proxy 检测到应用实例已准备好接收客户端连接,随即为它们配置负载均衡器。
Kubelet 与控制器持续监控系统状态,确保应用程序保持运行。
ch2: 容器介绍
每个容器都有着独立的文件系统和进程ID,如果是有Shell的Linux镜像的话,还可以使用bash命令.
ch3: 部署kubernetes
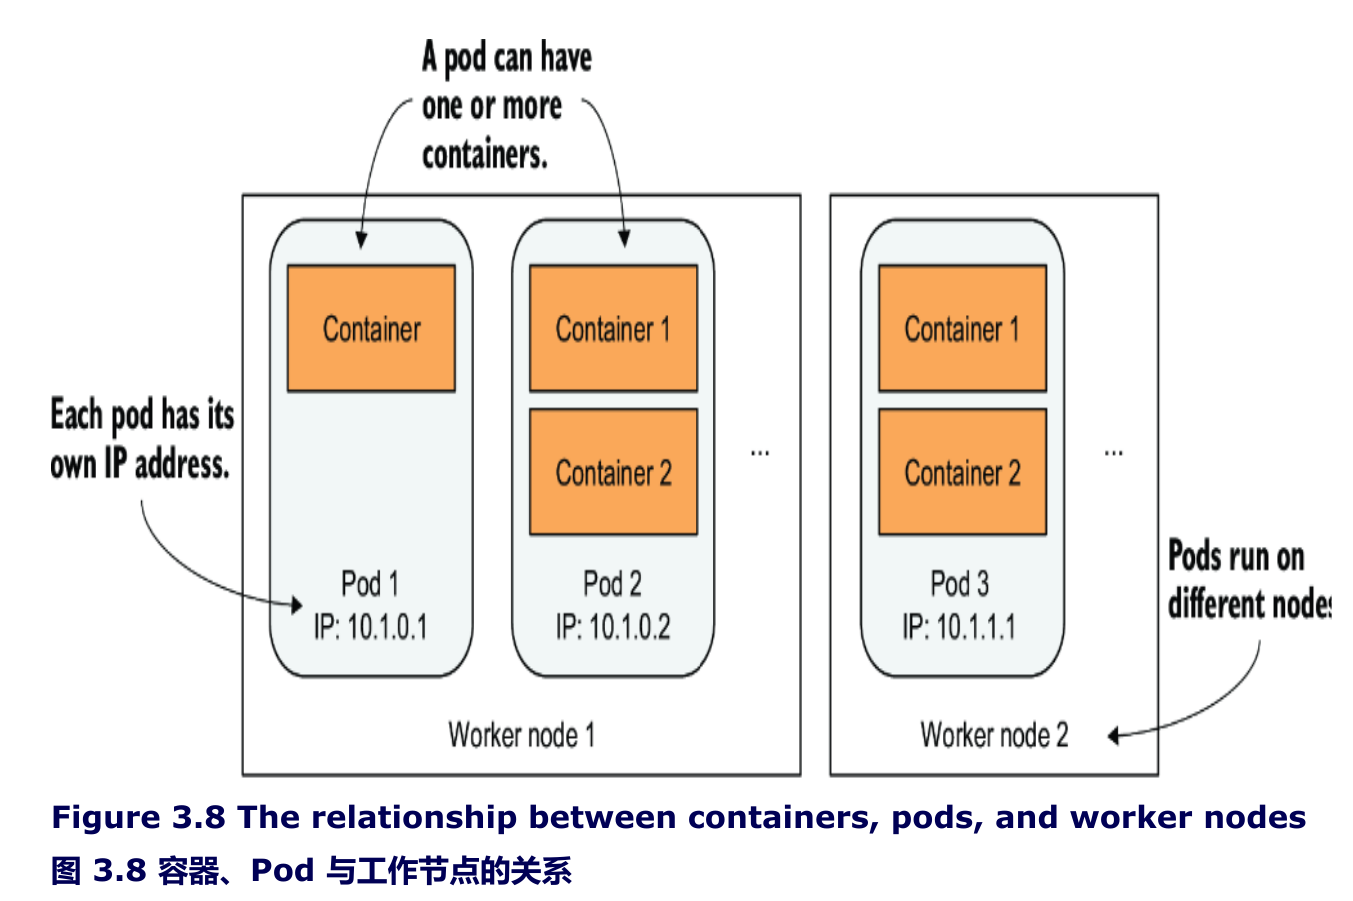
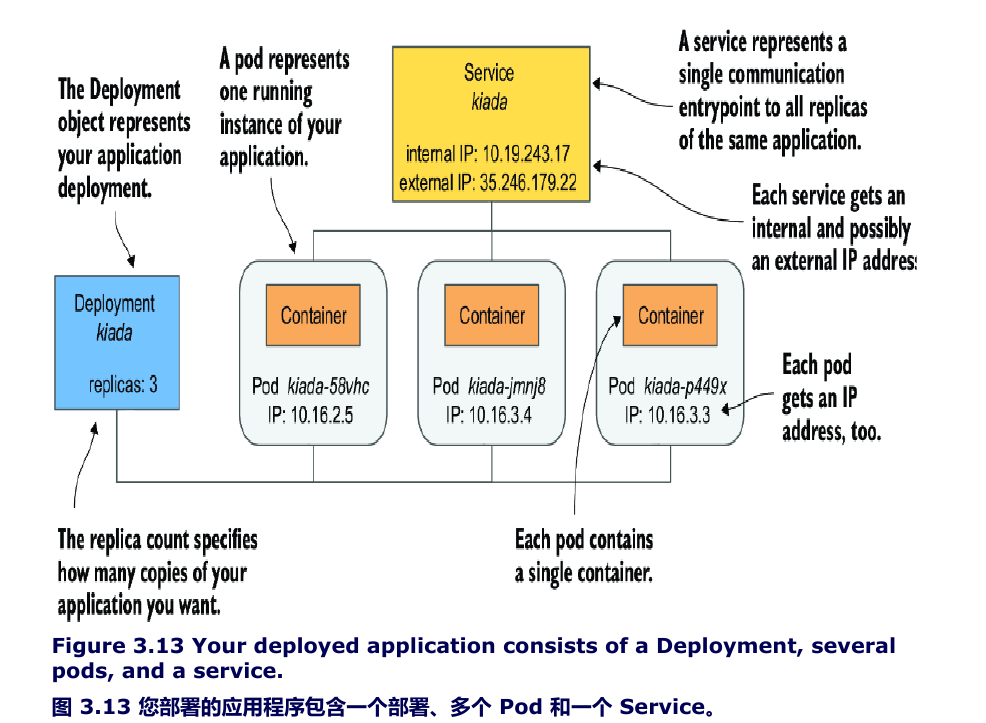
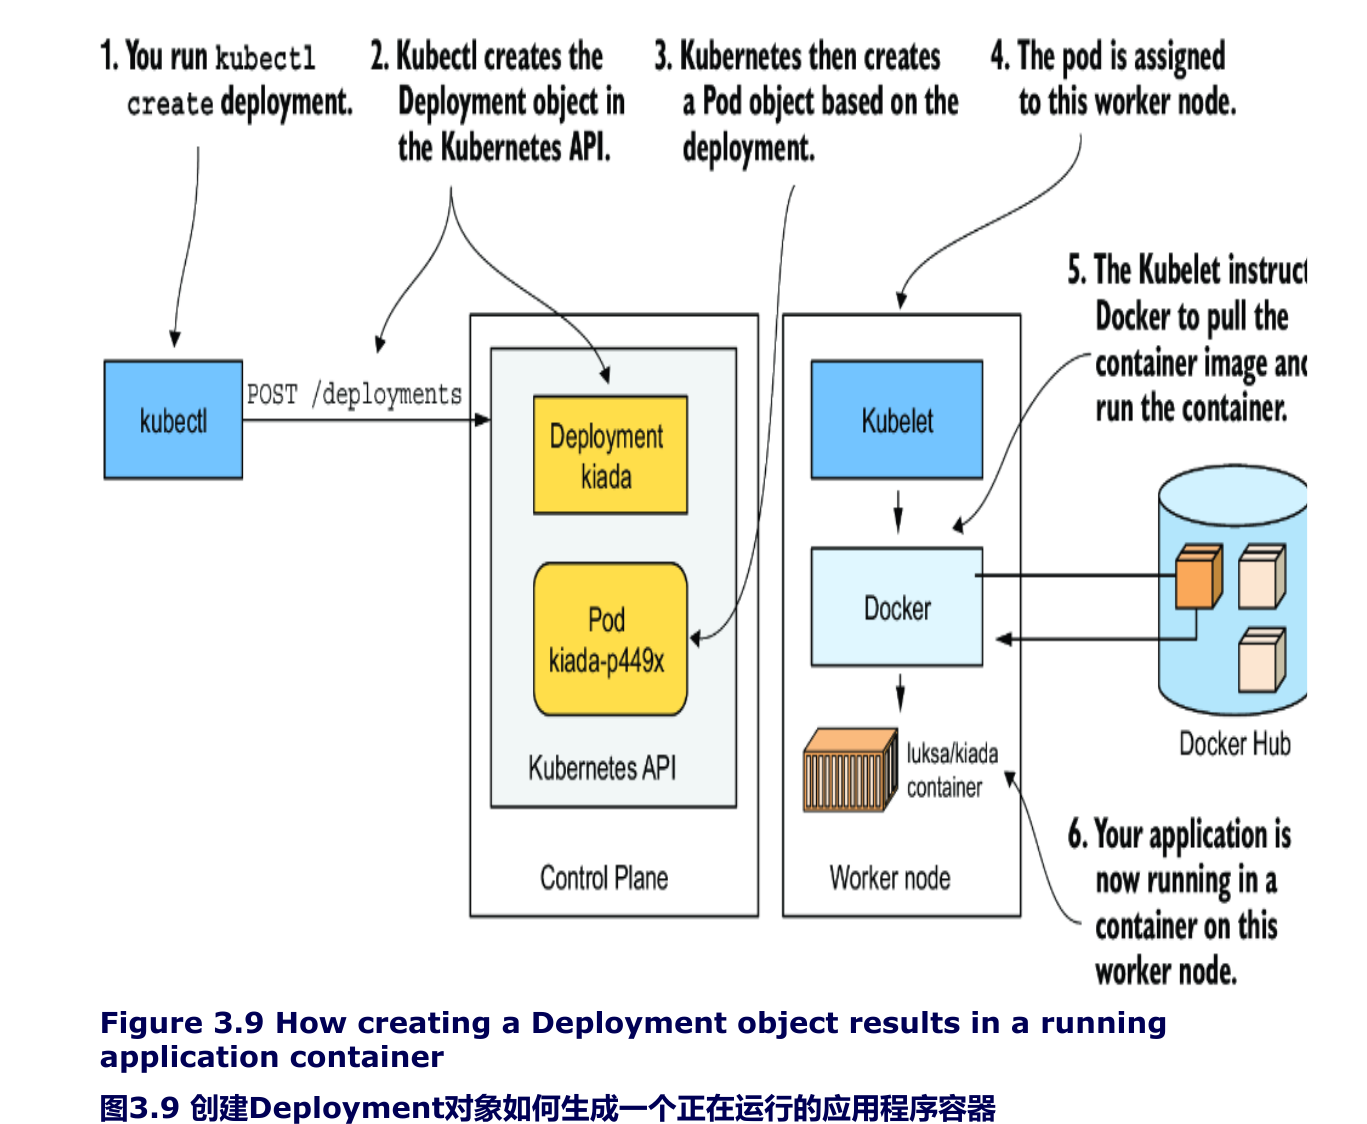 每个Pod都有自己的IP地址,但这个地址仅在Cluster内部可见,通过expose命令即可将Pod部署为Service对外暴露
你不应该关心Pod被调度到哪里。这也是为什么默认的kubectl get pods命令不会显示列表中Pod所属的工作节点信息。在Kubernetes的世界里,这点并不那么重要。
Kube-proxy会自动提供负载均衡,所以不用担心多个Pod的流量访问:
ch4: Kubernetes API and Model(待补充)
使用Kubernetes
ch5: Running applications with pods
容器的设计初衷是只运行单个进程,不计算它创建的任何子进程。容器工具和Kubernetes都是围绕这个事实开发的。例如,容器中运行的进程应该将其日志写入标准输出。用于显示日志的Docker和Kubernetes命令仅显示从该输出捕获的内容。如果只有一个进程在容器中运行,它就是唯一的写入者,但如果你在容器中运行多个进程,它们都会写入相同的输出。因此,它们的日志会相互交织,难以判断每一行属于哪个进程。
因此,为了组合相关的独立进程,我们需要引入Pod,为他们提供几乎相同的环境——仿佛它们都在同一个容器中运行。这些进程会存在一定程度的隔离,但并非完全隔离——它们共享部分资源。这让我们兼得了两者的优势:既能使用容器提供的全部特性,又能让进程协同工作。Pod使得这些相互关联的容器可以作为一个统一单元进行管理。
在第2章中,你已经了解到容器使用自己的Linux命名空间集合,但同时也能够与其他容器共享部分命名空间。正是这种命名空间共享机制,使得Kubernetes与容器运行时能够将多个容器组合成一个Pod。Pod中的所有容器共享同一个网络命名空间,因此也就共享属于该命名空间的网络接口、IP地址以及端口空间。
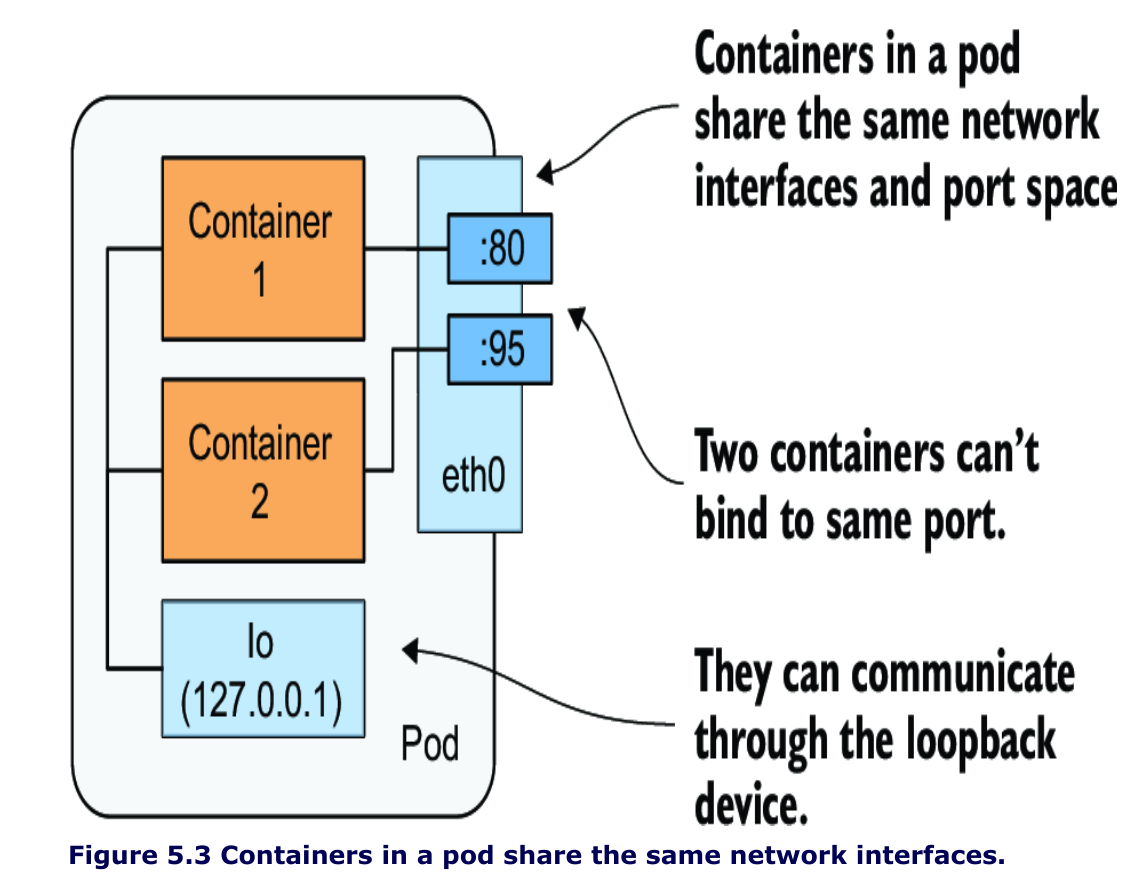
而一般来说,只有两个容器有必要放在同一个pod中相互交流时我们才会这么做,前端和后端则一般放在不同pod中:
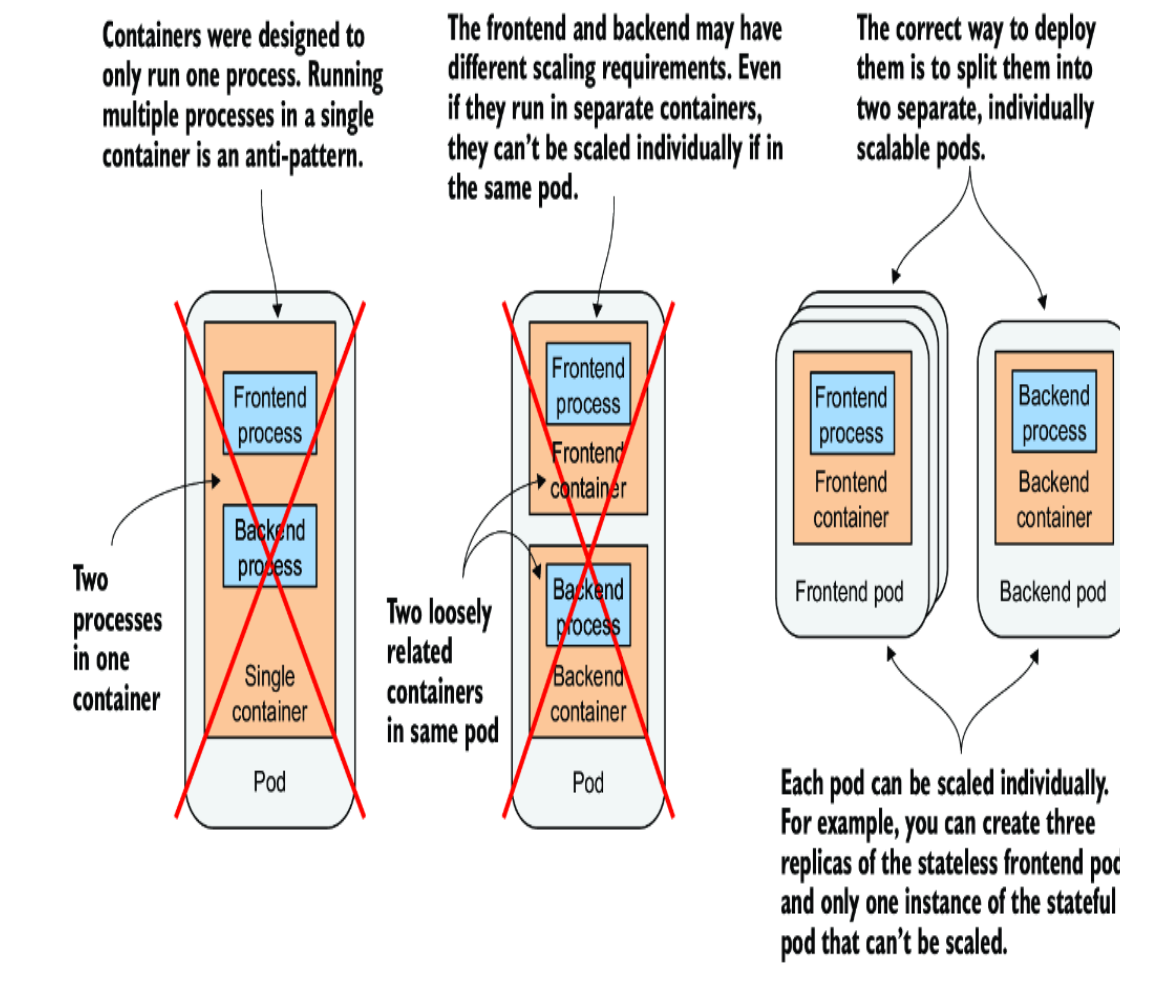
仅当应用程序由一个主进程和一个或多个补充主进程运行的辅助进程组成时,才适合将多个容器放入同一个Pod中。容纳补充进程的容器被称为Sidecar Containers,Sidecar就是给摩托车加装一个轮子变成三轮,但不同于摩托车的是,一个Pod可以拥有多个边车:
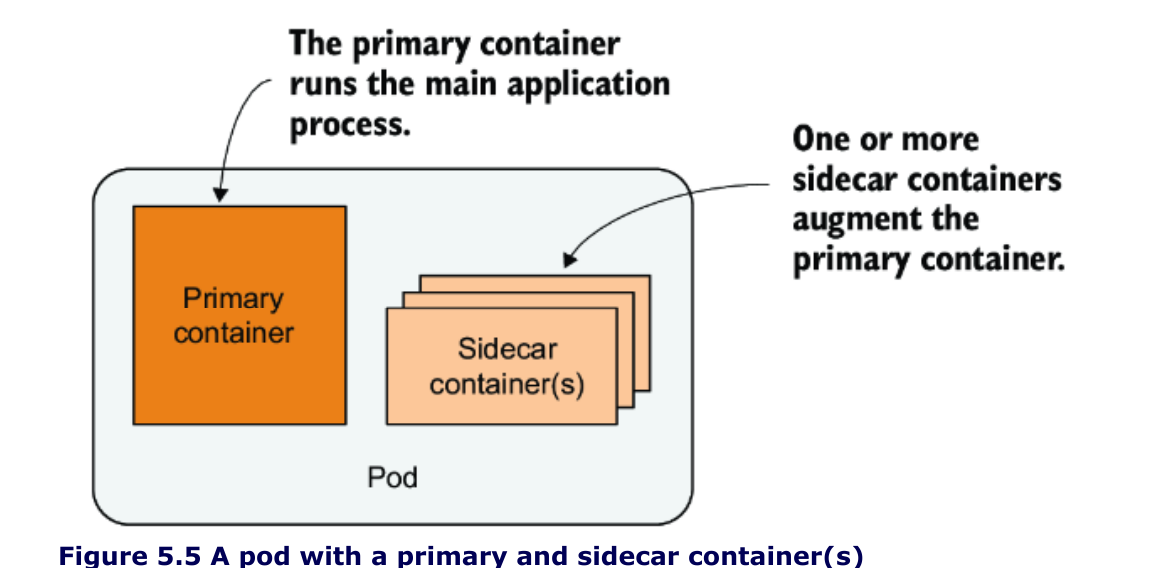
pod中运行多个容器
| |
当一个Pod包含多个容器时,所有容器会并行启动。Kubernetes未提供指定容器间依赖关系的机制,因此无法确保某个容器在其他容器之前启动。但Kubernetes允许在主容器启动前,通过运行一系列容器来初始化Pod。
| |
ch6: 管理Pod
总结
日后来看,又臭又长.
深入剖析Nginx
- 出版于2013年,作者:高群凯。
ch1: 准备工作
由于Nginx本身就不是一个特别复杂的软件,所以目录也很清晰:
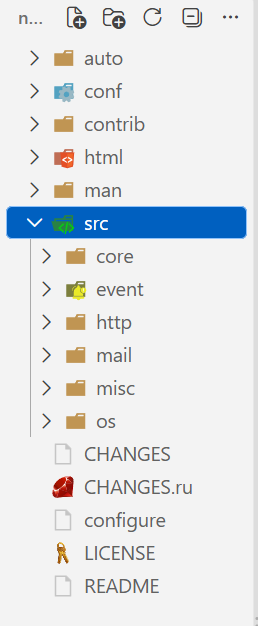
其中src文件夹是放源码的,conf文件夹放默认的配置文件,auto文件夹用于编译时的检查.实际上只看源码文件夹就够了.
ch3: 进程模型
启动Nginx后会运行多个Nginx进程,有用于监控的Master(主进程),有Worker(工作进程),还有Cache相关的进程,进程之间彼此通信:
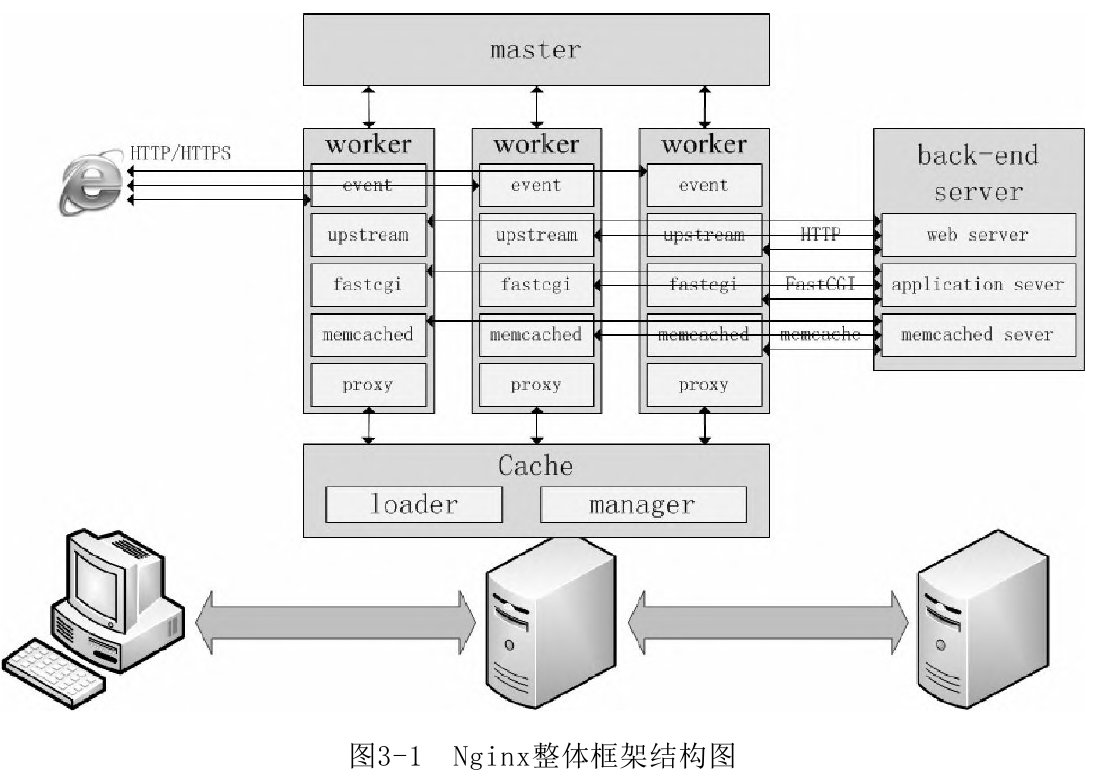
自然,Worker和Master内部都是通过无限循环实现持续不断处理客户端请求的,Master大部分时间都是Pending状态,直到接收到信号(如子进程退出,或者用户发送SIGKILL)才会开始处理.
如果启动了缓存,那么Master还会创建两个进程,Cache Loader用于缓存与和Cache Manager用于清除缓存,
ch4: 数据结构
讲了内存分配,Nginx hash,Radix tree(前缀树Trie的改进版,用于IP前缀匹配)
ch5: 配置解析
Nginx配置文件是由多个配置项组成的,每一个配置项都有一个项目名和对应的项目值,项目名又称为指令(Directive),而项目值可能是简单的字符串(以分号结尾),也可能是由简单字符串和多个配置项组合而成配置块的复合结构(以大括号结尾),我们可以将配置项归纳为两种:简单配置项和复杂配置项:
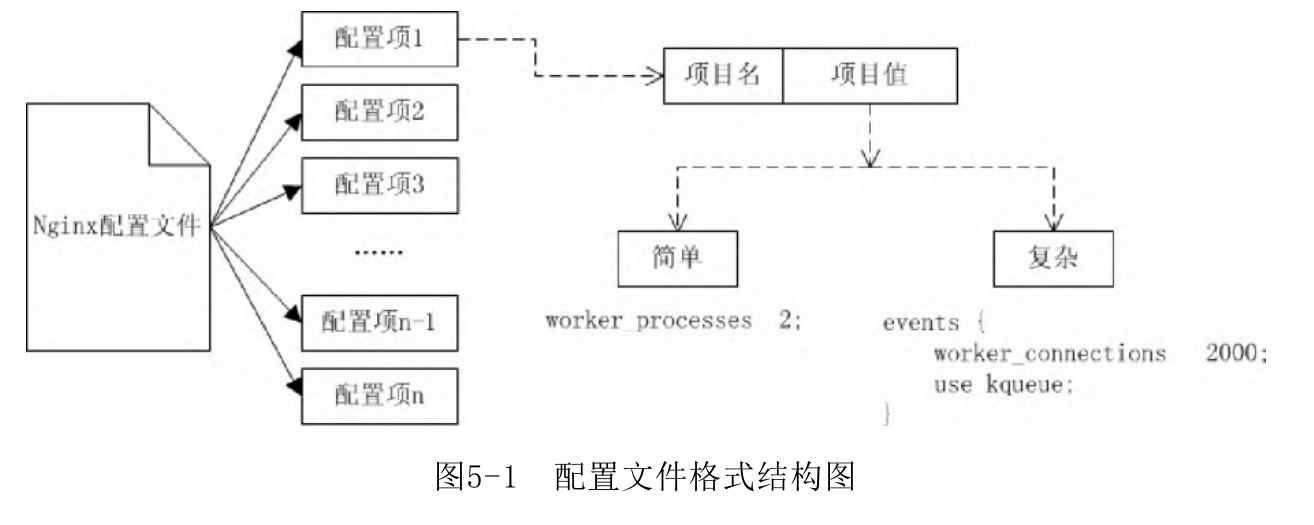
某些字段如error_log可以多次出现:
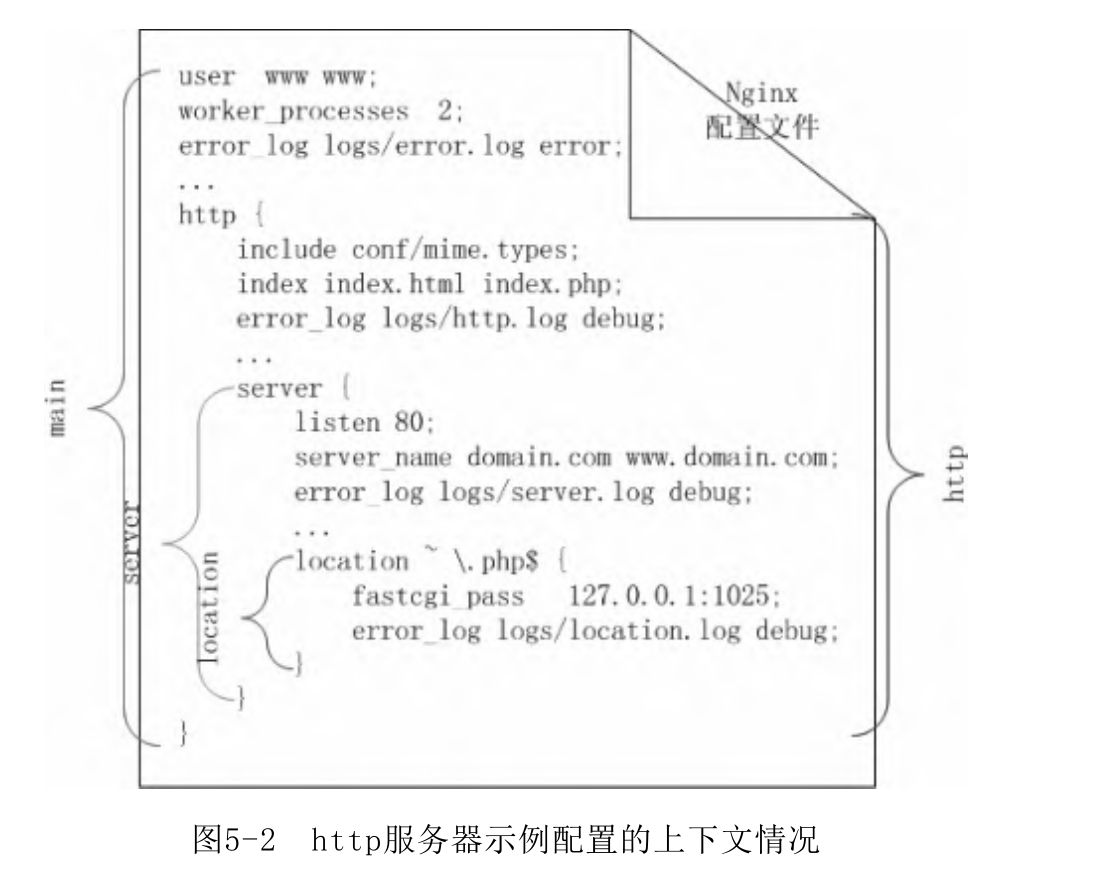
ch6: 模块
Nginx不会像Apache或Lighttpd那样在编译时生成so动态库,然后在程序执行时再进行动态加载,Nginx模块源文件会在生成Nginx时就直接被编译到其二进制执行文件中,所以,如果要选用不同的功能模块,必须对Nginx做重新配置和编译。
ch7: 事件管理
各种操作系统平台下支持的各种I/O事件处理机制在Nginx内部都被进行了统一封装,这样不论Nginx被用在何种平台都能以最高效的方式运行,涉及的I/O多路复用接口如下:
| 名称 | 特点 |
|---|---|
| select | 标准的 I/O 复用模型,几乎所有的类 UNIX 系统上都有提供,但性能相对较差。如果在当前系统平台上找不到更优的 I/O 事件处理机制,那么 Nginx 默认编译并使用 select 复用模型,我们也可以通过使用 --with-select_module 或 --without-select_module 配置选项来启用或禁用 select 复用模型模块的编译 |
| poll | 标准的 I/O 复用模型,理论上比 select 复用模型要优。同 select 复用模型类似,可以通过使用 --with-poll_module 或 --without-poll_module 配置选项来启用或禁用 poll 复用模型模块的编译 |
| epoll | 系统 Linux 2.6+ 上正式提供的性能更为优秀的 I/O 复用模型 |
| kqueue | 在系统 FreeBSD 4.1+,OpenBSD 2.9+,NetBSD 2.0 和 MacOS X 上特有的性能更优秀的 I/O 复用模型 |
| eventport | 在系统 Solaris 10 上可用的高性能 I/O 复用模型 |
| /dev/poll | 在系统 Solaris 7 11/99+,HP/UX 11.22+ (eventport),IRIX 6.5.15+ 和 Tru64 UNIX 5.1A+ 上可用的高性能 I/O 复用模型 |
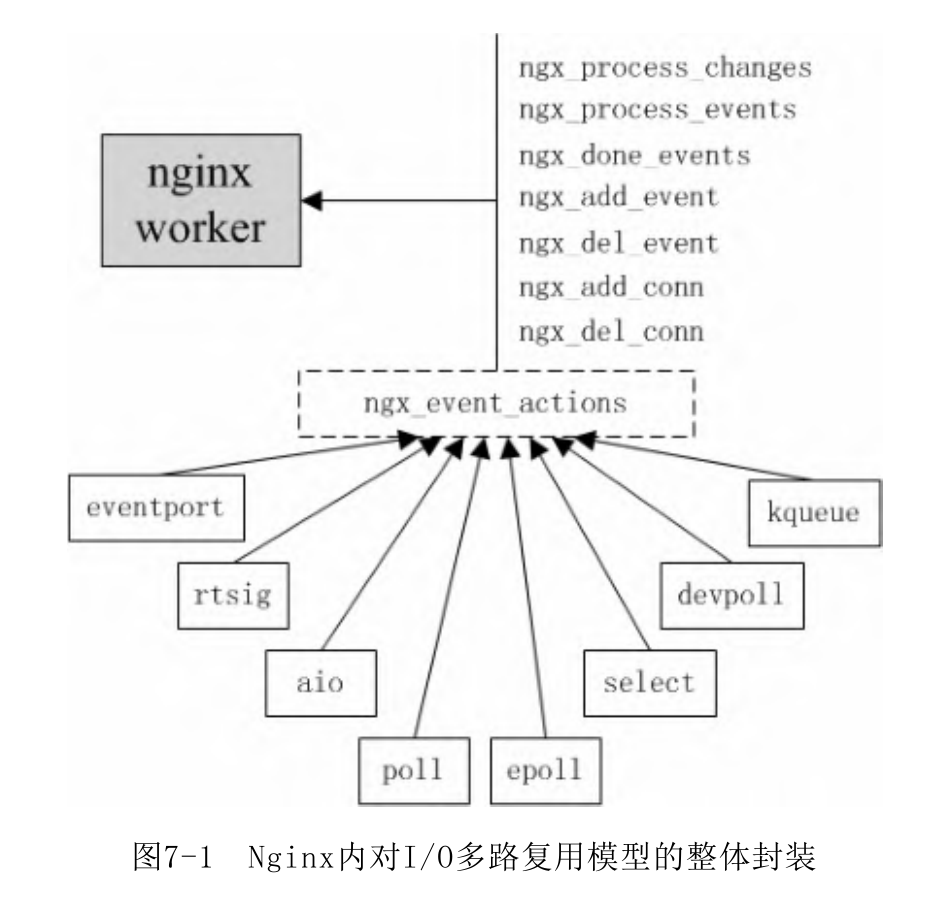
ch9: 请求处理与响应
介绍了Nginx解析Request Header,根据监听IP/端口创建socket,派生子请求来并发处理某次请求涉及的多个资源
ch10: location解析
标准的location指令配置语法为
| |
官方示例如下:
| |
nginx会自动对用户配置的location进行整理,将各自server下的location放在一起形成树.
ch13: 负载均衡
Nginx默认采用加权轮询策略(通过weight,backup,down等字段配置),或者显式写明采用IP哈希策略.
加权轮询:
| |
由于加权轮询无法保留会话,所以只能用根据用户IP分派服务器的IP哈希策略了;但同时,IP哈希有负载不均衡等缺点(比如来自某个IP地址的请求特别多),所以需要进行斟酌一下来选择哪个策略.
ch14: 访问控制
可以配置deny字段来禁止某个IP来访问服务器
总结
阅读起来相当累,因为作者是真的在一行行剖析源码的,似乎也觉得读者都是愿意和他一样一行行看源码的.
Redis设计与实现
- 出版于2014年,作者:黄健宏。
- 本书基于Redis 2.9(Redis 3.0开发版)编写,而现在已经更新到8.10版本了,不过仍然值得一读
数据结构与对象
simple dynamic string,SDS
Redis没有直接使用C语言传统的字符串表示(以空字符结尾的字符数组,以下简称C字符串),而是自己构建了一种名为简单动态字符串(simple dynamic string,SDS)的抽象类型,并将SDS用作Redis的默认字符串表示。
主要原因自然是C字符串本身的问题,如字符串拼接函数strcat不会自动扩容,C字符串默认以./0结尾,并不会记录自身的长度,而是需要程序员自己控制.
格式如下:
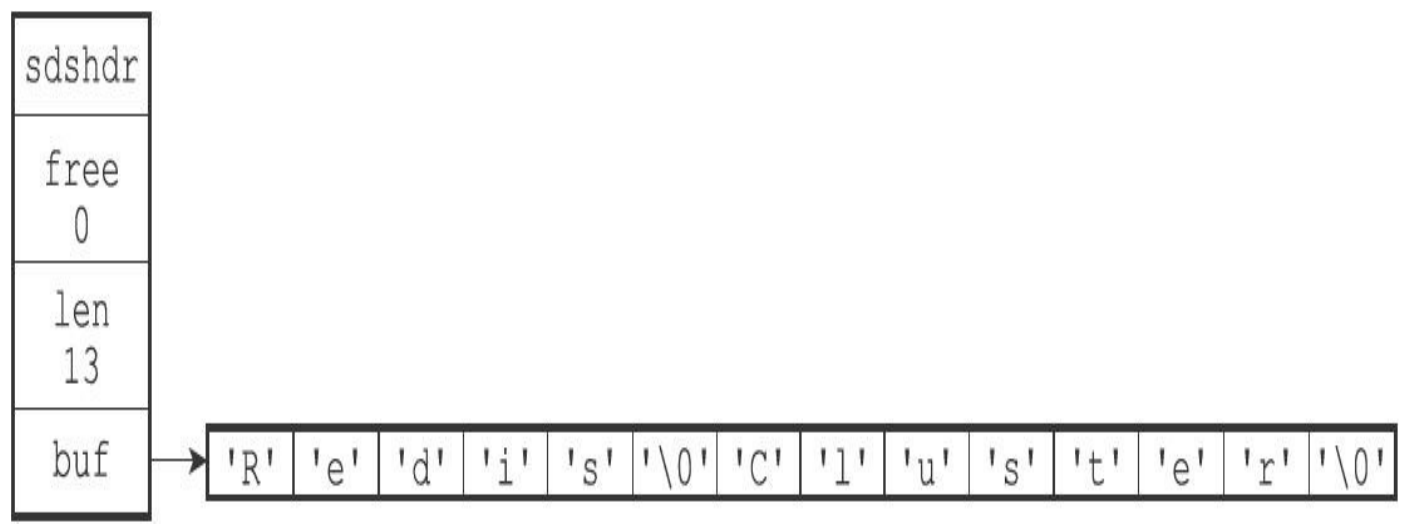
- len记载占用空间,free记载剩余空间,通过结构体实现
链表
Redis中的链表设计如下:
- 双端:链表节点带有
prev和next指针,获取某个节点的前置节点和后置节点的复杂度都是 O(1)。 - 无环:表头节点的
prev指针和表尾节点的next指针都指向NULL,对链表的访问以NULL为终点。 - 带表头指针和表尾指针:通过
list结构的head指针和tail指针,程序获取链表的表头节点和表尾节点的复杂度为 O(1)。 - 带链表长度计数器:程序使用
list结构的len属性来对list持有的链表节点进行计数,程序获取链表中节点数量的复杂度为 O(1)。 - 多态:链表节点使用
void*指针来保存节点值,并且可以通过list结构的dup、free、match三个属性为节点值设置类型特定函数,所以链表可以用于保存各种不同类型的值。
字典
字典在Redis中的应用相当广泛,比如Redis的数据库就是使用字典来作为底层实现的,对数据库的增、删、查、改操作也是构建在对字典的操作之上的。
哈希表
Redis的字典使用哈希表实现:
| |
具体的单节点结构如下:
| |
- 这里的union非常有意思,完美解决了节点的替换问题.
哈希算法
Redis计算哈希值和索引值的方法如下:
| |
hashFunction用的算法是MurmurHash2算法,而现在用的则是SipHash算法
哈希冲突
发生哈希冲突时,由于没有指向尾部的指针,所以Redis会将新节点放在链表的头部
rehash
当哈希冲突过多/加入节点过多时,Redis会自动执行Rehash来渐进式地扩展哈希表,详细步骤如下:
- 为
ht[1]分配空间,让字典同时持有ht[0]和ht[1]两个哈希表。 - 在字典中维持一个索引计数器变量
rehashidx,并将它的值设置为0,表示 rehash 工作正式开始。 - 在 rehash 进行期间,每次对字典执行添加、删除、查找或者更新操作时,程序除了执行指定的操作以外,还会顺带将
ht[0]哈希表在rehashidx索引上的所有键值对 rehash 到ht[1]。当 rehash 工作完成之后,程序将rehashidx属性的值增一。 - 随着字典操作的不断执行,最终在某个时间点上,
ht[0]的所有键值对都会被 rehash 至ht[1]。这时程序将rehashidx属性的值设为-1,表示 rehash 操作已完成。
设计上确实很简单,但不是那么容易想得到的.
跳表
和链表、字典等数据结构被广泛地应用在Redis内部不同,Redis只在两个地方用到了跳跃表,一个是实现有序集合键,另一个是在集群节点中用作内部数据结构,除此之外,跳跃表在Redis里面没有其他用途
- 我以前还以为Redis主要靠跳表呢,结果并没有我想的那么简单
整数集合
整数集合(intset)是集合键的底层实现之一,当一个集合只包含整数值元素,并且这个集合的元素数量不多时,Redis就会使用整数集合作为集合键的底层实现。
基本原理就是把整数按照顺序放进一块连续内存中,所有元素的类型统一,有三种类型:
| |
压缩列表
压缩列表(ziplist)是列表键和哈希键的底层实现之一。当一个列表键只包含少量列表项,并且每个列表项要么就是小整数值,要么就是长度比较短的字符串,那么Redis就会使用压缩列表来做列表键的底层实现。
可以说只是一个优化过的链表而已.
对象
在前面的数个章节里,我们陆续介绍了Redis用到的所有主要数据结构,比如简单动态字符串(SDS)、双端链表、字典、压缩列表、整数集合等等。
Redis并没有直接使用这些数据结构来实现键值对数据库,而是基于这些数据结构创建了一个对象系统,这个系统包含字符串对象、列表对象、哈希对象、集合对象和有序集合对象这五种类型的对象,每种对象都用到了至少一种我们前面所介绍的数据结构。
对象类型
Redis使用对象来表示数据库中的键和值,每次当我们在Redis的数据库中新创建一个键值对时,我们至少会创建两个对象,一个对象用作键值对的键(键对象),另一个对象用作键值对的值(值对象)。
经典的5个对象类型如下:
| 类型常量 | 对象的名称 |
|---|---|
REDIS_STRING | 字符串对象 |
REDIS_LIST | 列表对象 |
REDIS_HASH | 哈希对象 |
REDIS_SET | 集合对象 |
REDIS_ZSET | 有序集合对象 |
对于Redis数据库保存的键值对来说,键总是一个字符串对象,而值则可以是字符串对象、列表对象、哈希对象、集合对象或者有序集合对象的其中一种,
字符串对象
字符串对象的编码可以是int、raw或者embstr,分别对应整数,长字符串,短于32字节的字符串
列表对象
列表对象的编码可以是ziplist或者linkedlist,当列表中所有字符串元素的长度都小于64字节,且保存元素少于512个时,使用zpilist,否则就用linkedlist,二者的实现方式上有一点不同:
linkedlist是一个真正的双端列表,而ziplist中所有元素紧凑排列在一段连续内存中.
| 命令 | ziplist 编码的实现方法 | linkedlist 编码的实现方法 |
|---|---|---|
LPUSH | 调用 ziplistPush 函数,将新元素推入到压缩列表的表头 | 调用 listAddNodeHead 函数,将新元素推入到双端链表的表头 |
RPUSH | 调用 ziplistPush 函数,将新元素推入到压缩列表的表尾 | 调用 listAddNodeTail 函数,将新元素推入到双端链表的表尾 |
LPOP | 调用 ziplistIndex 函数定位压缩列表的表头节点,在向用户返回节点所保存的元素之后,调用 ziplistDelete 函数删除表头节点 | 调用 listFirst 函数定位双端链表的表头节点,在向用户返回节点所保存的元素之后,调用 listDelNode 函数删除表头节点 |
RPOP | 调用 ziplistIndex 函数定位压缩列表的表尾节点,在向用户返回节点所保存的元素之后,调用 ziplistDelete 函数删除表尾节点 | 调用 listLast 函数定位双端链表的表尾节点,在向用户返回节点所保存的元素之后,调用 listDelNode 函数删除表尾节点 |
LINDEX | 调用 ziplistIndex 函数定位压缩列表中的指定节点,然后返回节点所保存的元素 | 调用 listIndex 函数定位双端链表中的指定节点,然后返回节点所保存的元素 |
LLEN | 调用 ziplistLen 函数返回压缩列表的长度 | 调用 listLength 函数返回双端链表的长度 |
LINSERT | 插入新节点到压缩列表的表头或者表尾时,使用 ziplistPush 函数;插入新节点到压缩列表的其他位置时,使用 ziplistInsert 函数 | 调用 listInsertNode 函数,将新节点插入到双端链表的指定位置 |
问了一下AI,现在list的主要实现变成了quicklist,是一个由多个ziplist组成的链表,这个设计确实很不错
哈希对象
哈希对象的编码可以是ziplist或者hashtable。
如果使用ziplist,那么就满足以下性质:
- 保存了同一键值对的两个节点总是紧挨在一起,保存键的节点在前,保存值的节点在后;
- 先添加到哈希对象中的键值对会被放在压缩列表的表头方向,而后来添加到哈希对象中的键值对会被放在压缩列表的表尾方向。
这与列表其实没有任何区别,只不过存储的量多了一倍而已,同样,当所有元素的字符串长度小于64字节,键值对数量小于512时才会启用ziplist,否则使用hashtable.
hashtable使用前面所说的字典实现.
集合对象
集合对象的编码可以是intset或者hashtable。同样也是根据元素数量来进行转换的.
有序集合对象
有序集合的编码可以是ziplist或者skiplist。
如果是ziplist,每次插入都要重新排序,显然很地狱,所以只在元素数量小于128个,且所有成员长度小于64字节时才启用.
而skiplist编码的zset结构同时包含了一个字典和一个跳表,跳表负责将元素从小到大排列,用于存放数据,而哈希字典用于记录元素和分值(score)的映射,从而实现O(1)的查找.二者通过指针共享地址,所以不会浪费内存.
内存回收
由于C没有垃圾回收,所以Redis构建了一个引用计数的垃圾回收机制
单机数据库
数据库
Redis Server负责创建和管理Redis数据库,初始化Server时,默认会创建16个数据库.
Redis是一个键值对(key-value pair)数据库服务器,服务器中的每个数据库都由一个redis.h/redisDb结构表示,其中,redisDb结构的dict字典保存了数据库中的所有键值对,我们将这个字典称为键空间(key space):
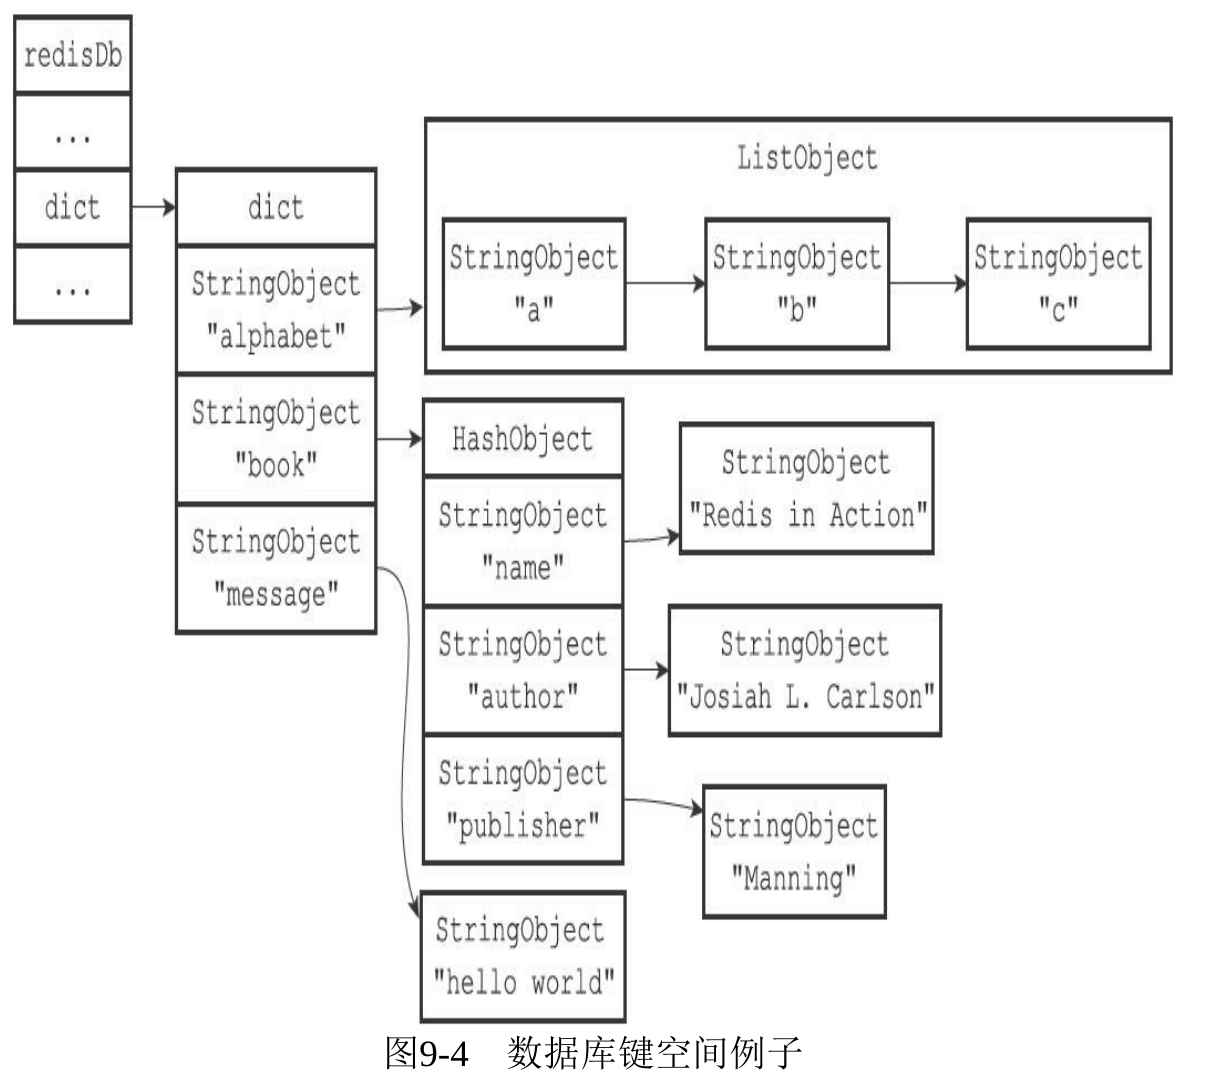
我们还可以对key设置过期时间,如下方结构所示:
| |
删除机制
现在剩下的问题是:如果一个键过期了,那么它什么时候会被删除呢?
- 定时删除:在设置键的过期时间的同时,创建一个定时器(timer),让定时器在键的过期时间来临时,立即执行对键的删除操作。
- 惰性删除:放任键过期不管,但是每次从键空间中获取键时,都检查取得的键是否过期,如果过期的话,就删除该键;如果没有过期,就返回该键。
- 定期删除:每隔一段时间,程序就对数据库进行一次检查,删除里面的过期键。至于要删除多少过期键,以及要检查多少个数据库,则由算法决定。
在这三种策略中,第一种和第三种为主动删除策略,而第二种则为被动删除策略。
而Redis服务器实际使用的是惰性删除和定期删除两种策略
当服务器运行在复制模式下时,从服务器的过期键删除动作由主服务器控制:
- 主服务器在删除一个过期键之后,会显式地向所有从服务器发送一个DEL命令,告知从服务器删除这个过期键。
- 从服务器在执行客户端发送的读命令时,即使碰到过期键也不会将过期键删除,而是继续像处理未过期的键一样来处理过期键。
- 从服务器只有在接到主服务器发来的DEL命令之后,才会删除过期键。
通过由主服务器来控制从服务器统一地删除过期键,可以保证主从服务器数据的一致性,也正是因为这个原因,当一个过期键仍然存在于主服务器的数据库时,这个过期键在从服务器里的复制品也会继续存在。
RDB(Redis DataBase)持久化
因为Redis是内存数据库,它将自己的数据库状态储存在内存里面,所以如果不想办法将储存在内存中的数据库状态保存到磁盘里面,那么一旦服务器进程退出,服务器中的数据库状态也会消失不见。
为了解决这个问题,Redis提供了RDB持久化功能,这个功能可以将Redis在内存中的数据库状态保存到磁盘里面,避免数据意外丢失,RDB持久化既可以手动执行,也可以根据服务器配置选项定期执行,该功能可以将某个时间点上的数据库状态保存到一个RDB文件中,这是一个经过压缩的二进制文件,可以还原生成RDB文件时的数据库状态
创建与载入RDB文件
有两个Redis命令可以用于生成RDB文件,一个是SAVE,另一个是BGSAVE。
SAVE命令会阻塞Redis服务器进程,直到RDB文件创建完毕为止,在服务器进程阻塞期间,服务器不能处理任何命令请求,即便是主从服务器部署,这么做也是不太合理的.
而BGSAVE命令会派生出一个子进程,由子进程负责创建RDB文件,服务器进程继续处理请求.
而RDB文件的载入是在服务器启动时自动执行的,不需要我们额外输入命令:
| |
另外值得一提的是,因为AOF文件的更新频率通常比RDB文件的更新频率高,所以:
- 如果服务器开启了AOF持久化功能,那么服务器会优先使用AOF文件来还原数据库状态。
- 只有在AOF持久化功能处于关闭状态时,服务器才会使用RDB文件来还原数据库状态。
因为BGSAVE命令可以在不阻塞服务器进程的情况下执行,所以Redis允许用户通过设置服务器配置的save选项,让服务器每隔一段时间自动执行一次BGSAVE命令。
举个例子,如果我们向服务器提供以下配置:
| |
那么只要满足以下三个条件中的任意一个,BGSAVE命令就会被执行:
- 服务器在900秒之内,对数据库进行了至少1次修改。
- 服务器在300秒之内,对数据库进行了至少10次修改。
- 服务器在60秒之内,对数据库进行了至少10000次修改。
RDB文件结构
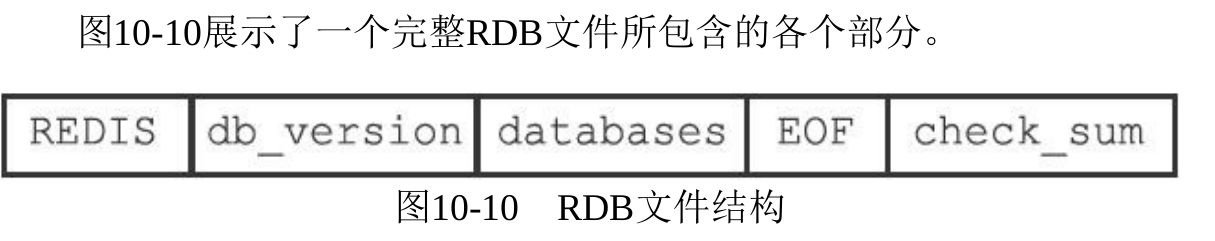
databases 部分包含着零个或任意多个数据库,以及各个数据库中的键值对数据:
- 如果服务器的数据库状态为空(所有数据库都是空的),那么这个部分也为空,长度为 0 字节。
- 如果服务器的数据库状态为非空(有至少一个数据库非空),那么这个部分也为非空,根据数据库所保存键值对的数量、类型和内容不同,这个部分的长度也会有所不同。
EOF 常量的长度为 1 字节,这个常量标志着 RDB 文件正文内容的结束,当读入程序遇到这个值的时候,它知道所有数据库的所有键值对都已经载入完毕了。
check_sum 是一个 8 字节长的无符号整数,保存着一个校验和,这个校验和是程序通过对 REDIS、db_version、databases、EOF 四个部分的内容进行计算得出的。服务器在载入 RDB 文件时,会将载入数据所计算出的校验和与 check_sum 所记录的校验和进行对比,以此来检查 RDB 文件是否有出错或者损坏的情况出现。
每个非空数据库在RDB文件中都可以保存为SELECTDB、db_number、key_value_pairs三个部分:
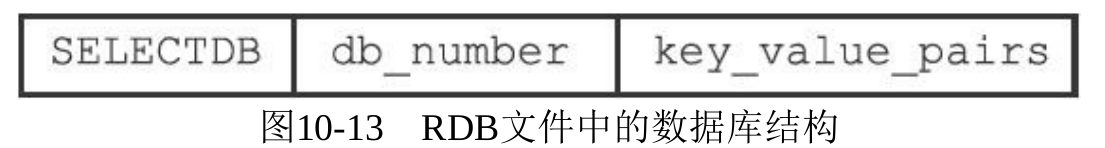
SELECTDB 常量的长度为 1 字节,当读入程序遇到这个值的时候,它知道接下来要读入的将是一个数据库号码。
db_number 保存着一个数据库号码,根据号码的大小不同,这个部分的长度可以是 1 字节、2 字节或者 5 字节。当程序读入 db_number 部分之后,服务器会调用 SELECT 命令,根据读入的数据库号码进行数据库切换,使得之后读入的键值对可以载入到正确的数据库中。
key_value_pairs 部分保存了数据库中的所有键值对数据,如果键值对带有过期时间,那么过期时间也会和键值对保存在一起。根据键值对的数量、类型、内容以及是否有过期时间等条件的不同,key_value_pairs 部分的长度也会有所不同。
由此来看,Redis只适合存放那种比较小和短的数据,否则RDB文件的大小会非常惊人.而且在现代生产环境里,只使用 DB 0 是非常常见、也通常更推荐的做法,所以不用担心多个数据库的RDB叠加起来的超大内存占用.
AOF(Append Only File)持久化
与RDB持久化通过保存数据库中的键值对来记录数据库状态不同,AOF持久化是通过保存Redis服务器所执行的写命令来记录数据库状态的:
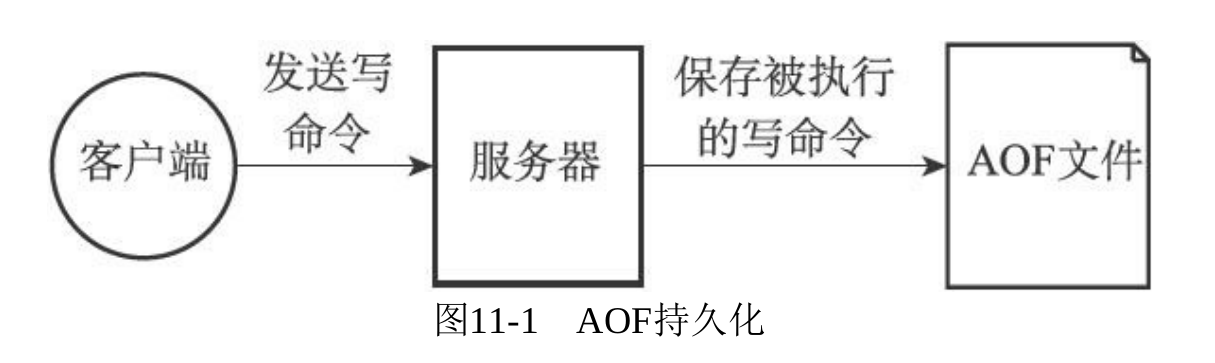
因为Redis的命令请求协议是纯文本格式,所以我们可以直接打开一个AOF文件,观察里面的内容,例如先执行这三个命令:
| |
然后查看AOF:
| |
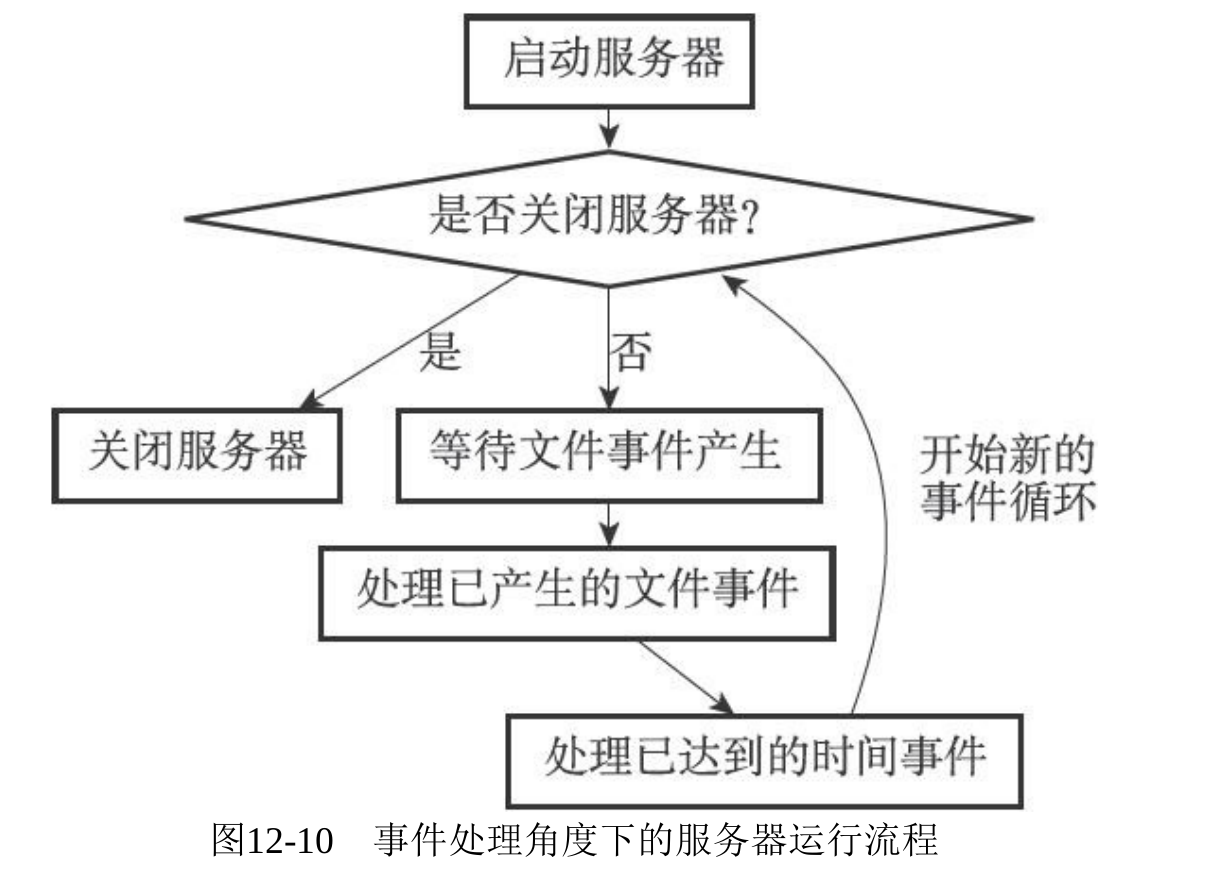
Redis的服务器进程就是一个事件循环(loop),这个循环中的文件事件负责接收客户端的命令请求,以及向客户端发送命令回复,而时间事件则负责执行像serverCron函数这样需要定时运行的函数,如此一来,每次loop结束后,都需要调用AOF相关的函数,考虑是否将缓冲区中的命令写入和保存到AOF文件中
事件
Redis服务器是一个事件驱动程序,服务器需要处理以下两类事件:
- 文件事件(file event):Redis服务器通过套接字与客户端(或者其他Redis服务器)进行连接,而文件事件就是服务器对套接字操作的抽象。服务器与客户端(或者其他服务器)的通信会产生相应的文件事件,而服务器则通过监听并处理这些事件来完成一系列网络通信操作
- 时间事件(time event):Redis服务器中的一些操作(比如serverCron函数)需要在给定的时间点执行,而时间事件就是服务器对这类定时操作的抽象。
文件事件
Redis基于Reactor模式开发了自己的网络事件处理器:这个处理器被称为文件事件处理器(file event handler):
文件事件处理器使用I/O多路复用(multiplexing)程序来同时监听多个套接字,并根据套接字目前执行的任务来为套接字关联不同的事件处理器。
当被监听的套接字准备好执行连接应答(accept)、读取(read)、写入(write)、关闭(close)等操作时,与操作相对应的文件事件就会产生,这时文件事件处理器就会调用套接字之前关联好的事件处理器来处理这些事件。
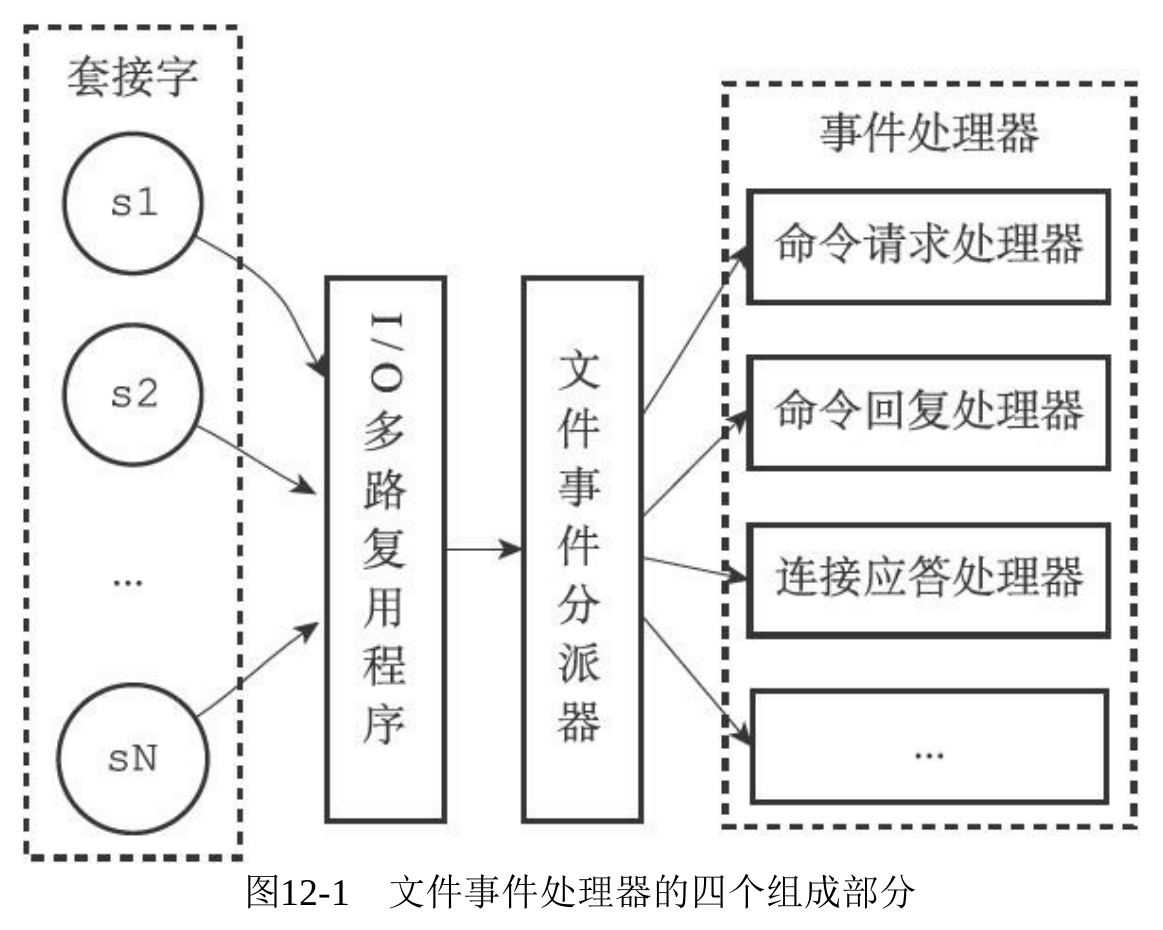
尽管多个文件事件可能会并发地出现,但I/O多路复用程序总是会将所有产生事件的套接字都放到一个队列里面,然后顺序处理,但由于处理速度很快(毕竟全都在内存中实现),所以不会影响高并发.
I/O多路复用程序可以监听多个套接字的ae.h/AE_READABLE事件和ae.h/AE_WRITABLE事件,这两类事件和套接字操作之间的对应关系如下:
当套接字变得可读时(客户端对套接字执行write操作,或者执行close操作),或者有新的可应答(acceptable)套接字出现时(客户端对服务器的监听套接字执行connect操作),套接字产生
AE_READABLE事件。当套接字变得可写时(客户端对套接字执行read操作),套接字产生
AE_WRITABLE事件。
I/O多路复用程序允许服务器同时监听套接字的AE_READABLE事件和AE_WRITABLE事件,如果一个套接字同时产生了这两种事件,那么文件事件分派器会优先处理AE_READABLE事件,等到AE_READABLE事件处理完之后,才处理AE_WRITABLE事件。
这也就是说,如果一个套接字又可读又可写的话,那么服务器将先读套接字,后写套接字。
时间事件
Redis的时间事件分为以下两类:
- 定时事件:让一段程序在指定的时间之后执行一次。比如说,让程序X在当前时间的30毫秒之后执行一次。
- 周期性事件:让一段程序每隔指定时间就执行一次。比如说,让程序Y每隔30毫秒就执行一次。
一个时间事件主要由以下三个属性组成:
- id:服务器为时间事件创建的全局唯一ID(标识号)。ID号按从小到大的顺序递增,新事件的ID号比旧事件的ID号要大。
- when:毫秒精度的UNIX时间戳,记录了时间事件的到达(arrive)时间。
- timeProc:时间事件处理器,一个函数。当时间事件到达时,服务器就会调用相应的处理器来处理事件。一个时间事件是定时事件还是周期性事件取决于时间事件处理器的返回值
Redis将所有时间事件都放在一个无序链表中,当执行器运行时会遍历整个链表,查找所有已经就绪的时间事件
处理流程
客户端
Redis服务器是典型的一对多服务器程序:一个服务器可以与多个客户端建立网络连接,每个客户端可以向服务器发送命令请求,而服务器则接收并处理客户端发送的命令请求,并向客户端返回命令回复
对于每个与服务器进行连接的客户端,服务器都为这些客户端建立了相应的 redis.h/redisClient 结构(客户端状态),这个结构保存了客户端当前的状态信息,以及执行相关功能时需要用到的数据结构,其中包括:
- 客户端的套接字描述符。
- 客户端的名字。
- 客户端的标志值(flag)。
- 指向客户端正在使用的数据库的指针,以及该数据库的号码。
- 客户端当前要执行的命令、命令的参数、命令参数的个数,以及指向命令实现函数的指针。
- 客户端的输入缓冲区和输出缓冲区。
- 客户端的复制状态信息,以及进行复制所需的数据结构。
- 客户端执行 BRPOP、BLPOP 等列表阻塞命令时使用的数据结构。
- 客户端的事务状态,以及执行 WATCH 命令时用到的数据结构。
- 客户端执行发布与订阅功能时用到的数据结构。
- 客户端的身份验证标志。
- 客户端的创建时间,客户端和服务器最后一次通信的时间,以及客户端的输出缓冲区大小超出软性限制(soft limit)的时间。
服务器
从客户端发送 SET KEY VALUE 命令到获得回复 OK 期间,客户端和服务器共需要执行以下操作:
- 客户端向服务器发送命令请求 SET KEY VALUE
- 服务器接收并处理客户端发来的命令请求 SET KEY VALUE,在数据库中进行设置操作,并产生命令回复 OK
- 服务器将命令回复 OK 发送给客户端
- 客户端接收服务器返回的命令回复 OK,并将这个回复打印给用户观看
多机数据库
不用一次是不可能学会的,待我先实战一段时间再来
Python网络编程攻略
ch1: socket编程
| |
总结
一看出版时间就不对劲了,书太老了,写的也很烂.
Hugo in Action(待补充)
- 出版于2022年,出版商:Manning,作者:Atishay Jain。
引言
2013 年 7 月,我将博客迁移到 Hugo,并向世界发布了我的第一个Go 项目。当时,我完全没有想到,这个最初只是为了个人博客而编写的项目,竟会彻底改变我的人生,乃至整个世界
基础
Jamstack
Jamstack 一词由 Netlify 的联合创始人兼首席执行官 Matt Biilmann 于 2016 年提出,是一种架构思想,最初来自:
| |
Jamstack 摒弃了数据库,将所有内容存储在部署期间编译的文件中,然后通过**内容分发网络(CDN)**进行分发。应用程序编程接口(API) 提供动态的、基于服务器的内容,这些内容由第三方维护或由云服务提供商托管,网站所有者只需极少的日常参与。这样,开发人员就无需处理安全更新、**拒绝服务(DoS)**攻击以及持续监控以抵御黑客攻击等任务。
Hugo 是目前最流行的 Jamstack 框架之一,拥有最快的构建速度。它让我们摆脱了设置、维护和日常维护的烦恼
总结
仔细一想,我目前根本用不到里面的任何知识好不好…
Prometheus: Up & Running(待补充)
介绍
- Prometheus是一个开源的、基于指标的监控系统.
监控(monitor)可以定义如下:
- 告警(Alerting):知道事情何时出错,通常是监控最重要的用途。监控系统应能够在出现异常时通知人工介入检查。
- 调试(Debugging):当人工介入后,需要进一步调查问题,确定根本原因,并最终解决已经出现的故障。
- 热门趋势(Trending):告警和调试通常发生在几分钟到几小时的时间尺度上。虽然趋势分析没有那么紧急,但了解系统如何被使用、如何随时间变化同样重要。趋势信息可以为设计决策、容量规划等工作提供依据。
- 水管工程(Plumbing):监控系统本质上也是一套数据处理管道。在实践中,有时可以复用监控系统的部分能力去完成其他任务,而不必重新构建专门的解决方案。严格来说这不完全属于监控,但实际工程中很常见。
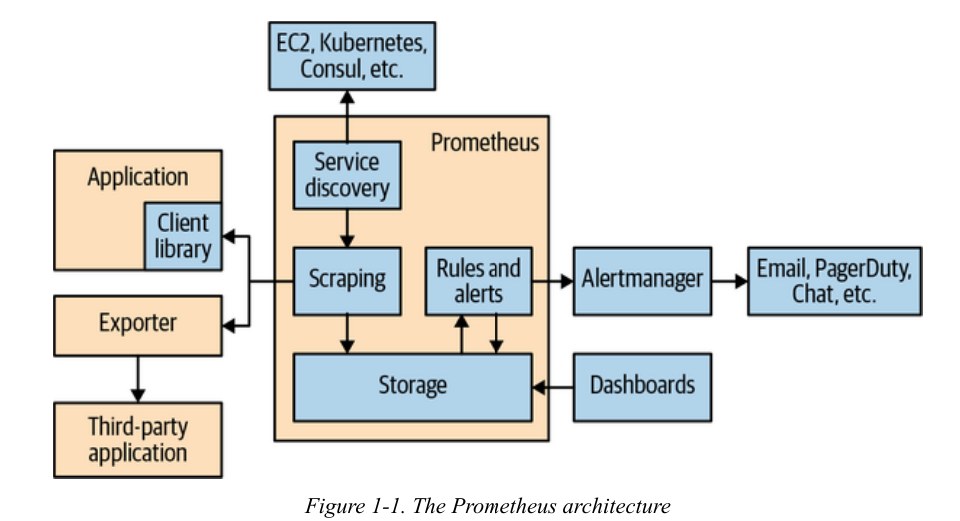
入门
补充: 使用docker运行Prometheus
新建一个文件夹,放三个文件:
prometheus.yml
| |
dockerfile
| |
compose.yml
| |
然后用docker compose up -d运行,成功打开页面:
表达式浏览器(Expression Browser)
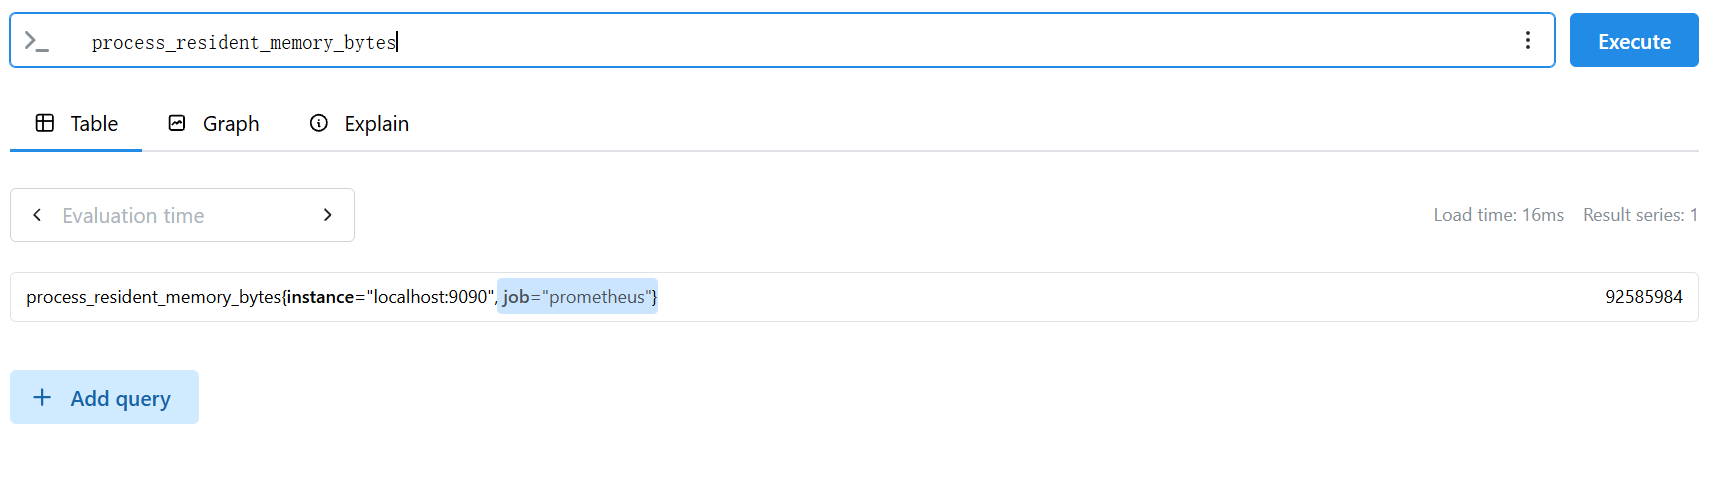
我们的Prometheus大约使用了73 MB内存。你可能会好奇,为什么这个指标用字节而非兆字节或千兆字节来展示,那样可能更易读。答案是,可读性很大程度上取决于上下文,即使在不同环境中使用同一二进制,其数值也可能相差多个数量级:一个内部RPC可能只需微秒级完成,而轮询一个长期运行的进程则可能耗时数小时甚至数天。因此,Prometheus的惯例是采用基础单位,如字节和秒,并将美化显示的职责交给像Grafana这样的前端工具。
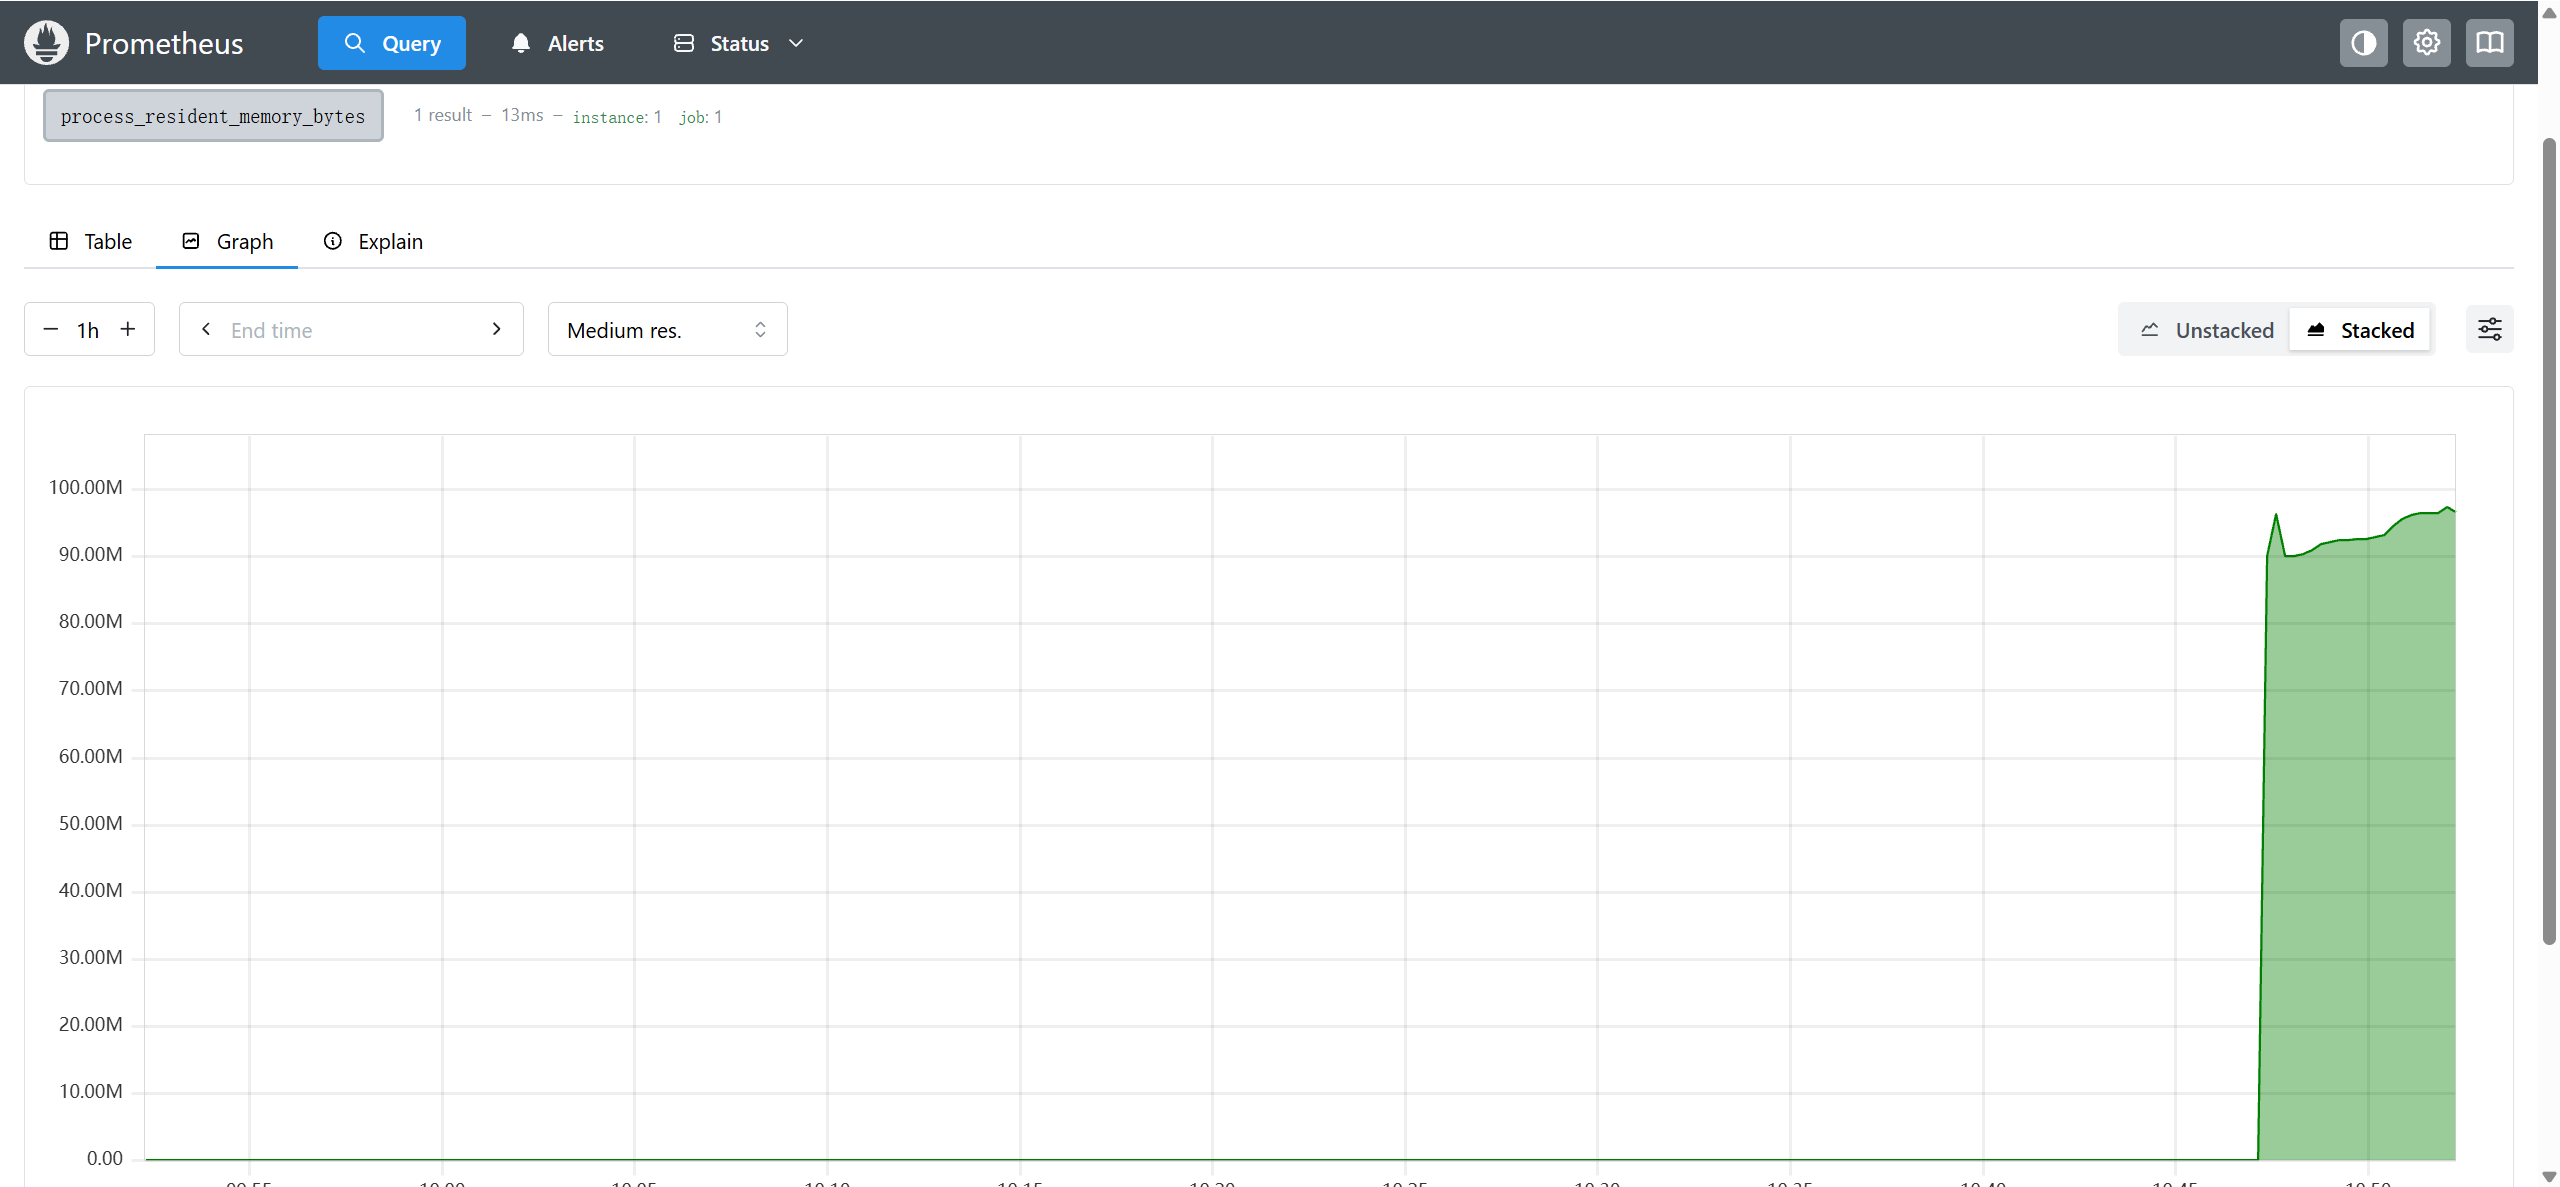
Alert(告警)
运行目标:
| |
要想设定报警规则,就要写一个rules.yml出来:
| |
除此之外,我们还需要将alert发送到我们指定的alertmanager上,所以还需要编写一个alertmanager.yml:
| |
Application Monitoring
Instrumentation
简单程序
| |
访问http://localhost:8000/会看到如下界面:
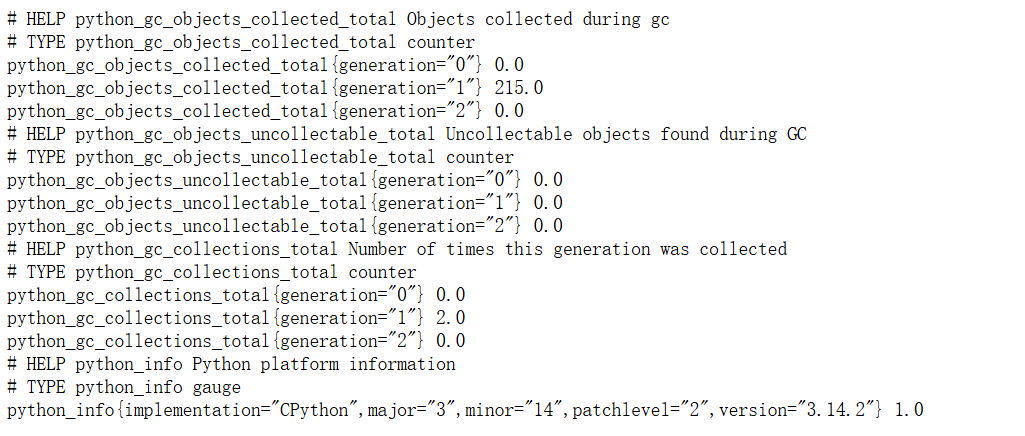
再访问 http://localhost:8001/ 即可看到`Hello,World!"
修改之前的Prometheus.yml:
| |
然后运行Prometheus来监听:
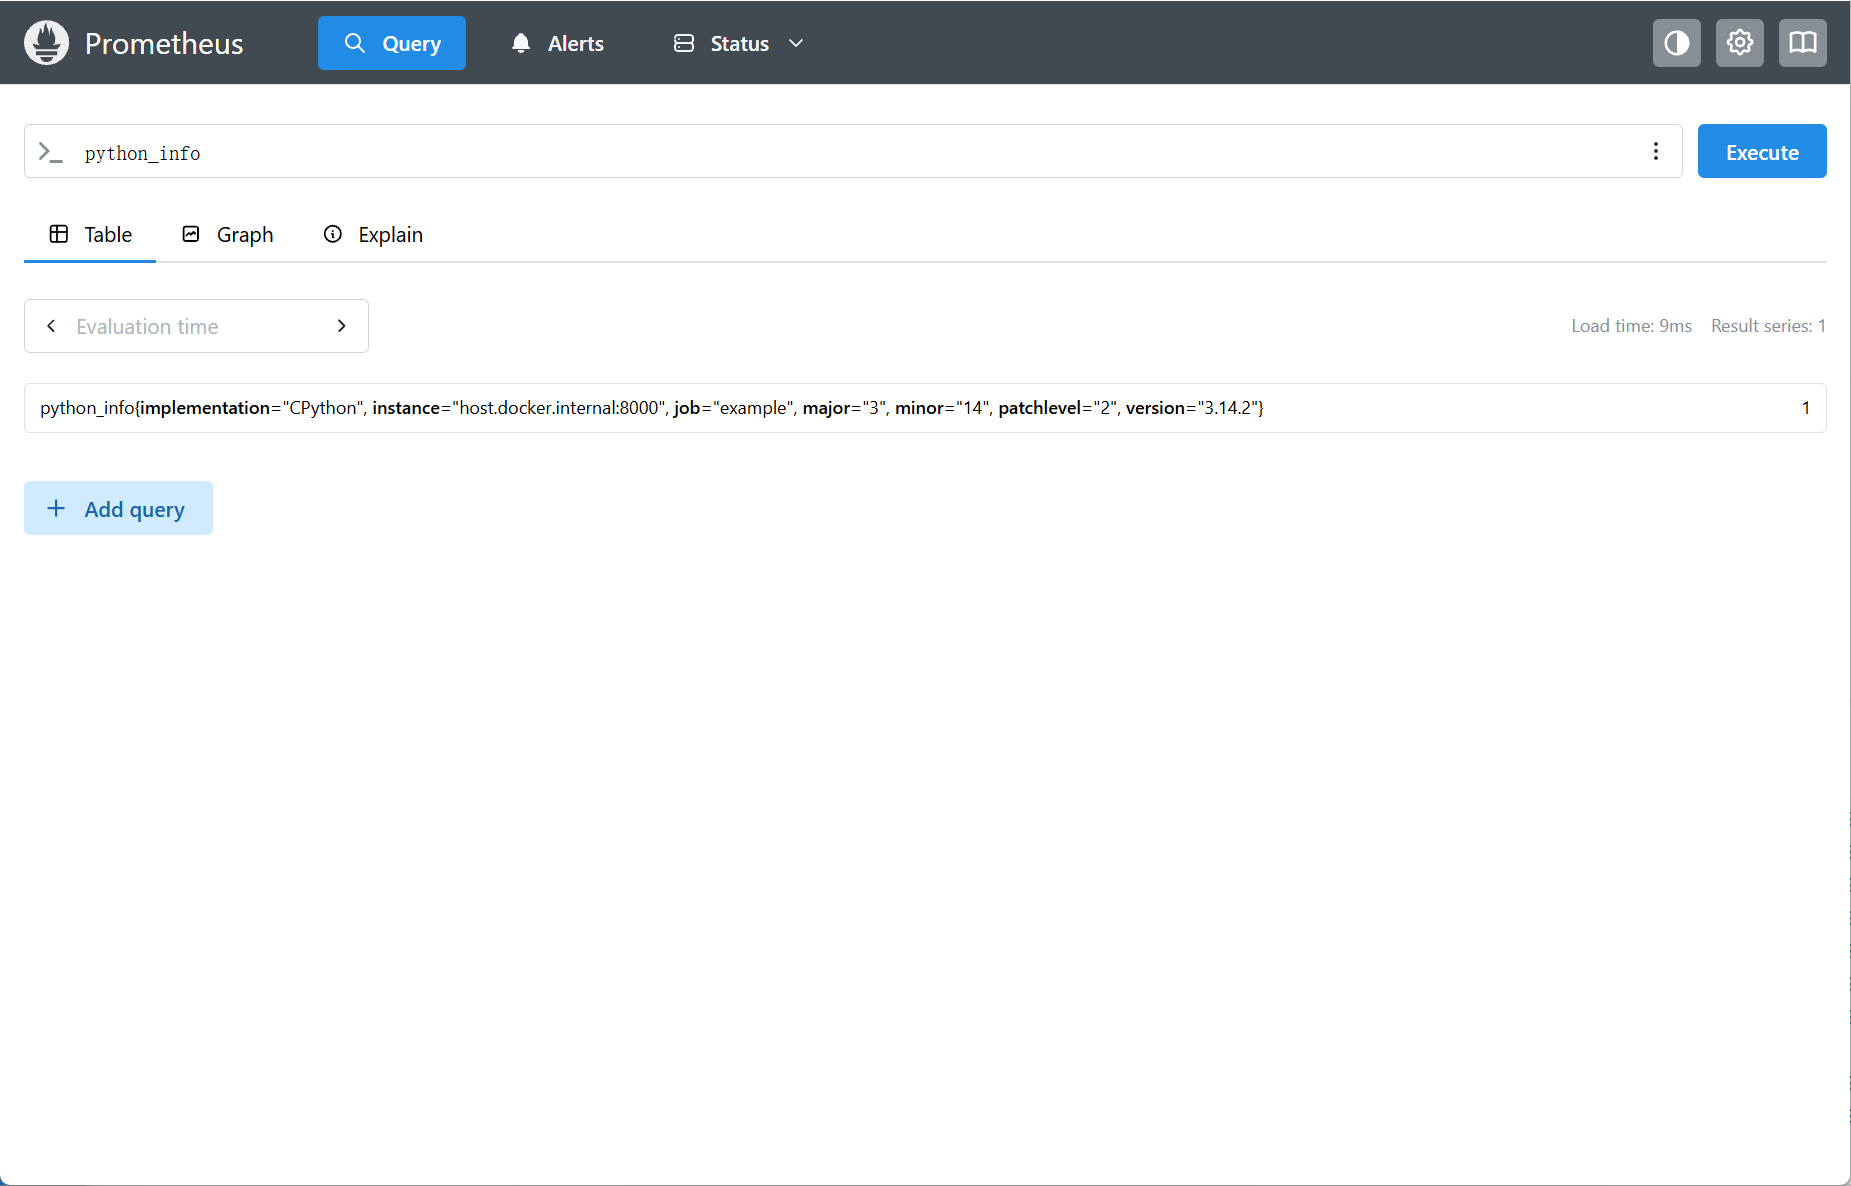
Counter
| |
Count用于统计程序的各种自定义指标
总结
暂时弃坑,毕竟目前根本用不到好吧
Rootkit和Bootkit:现代恶意软件逆向分析和下一代威胁(待补充)
- 出版于2019年(英文原版),作者:Alex Matrosov。
- Rootkit: 针对操作系统内核
- Bootkit: 针对MBR等引导扇区
Rootkit
TDL3
为了在系统重新启动时幸存下来,TDL3通过在驱动程序的二进制文件中注入恶意代码来感染加载操作系统所必需的一个引导启动驱动程序.
一旦选择了一个目标驱动程序,TDL3感染程序就会用一个恶意加载程序覆盖它的资源部分.rsrc的前几百个字节,从而修改驱动程序在内存中的映像。这个加载程序非常简单:它只是在启动时从硬盘上加载它需要的其余恶意软件代码。
这种方式只能针对x32位系统起作用,因为x64位系统需要对内核代码进行完整性的检查,通过数字签名即可阻止TDL3的运行.
TDL3是第一个将配置文件和有效负载存储在目标系统隐藏的加密存储区域的恶意软件系统,不依赖于操作系统提供的文件系统服务。
Festi
本章专门讨论发现的最先进的垃圾邮件和分布式拒绝服务 (DDoS)僵尸网络之一—Win32/Festi僵尸网络,我们将其简称为Festi。Festi拥有强大的垃圾邮件发送和DDoS功能,以及有趣的Rootkit功能,这使得它可以连接到文件系统和系统注册表而不被人发现。Festi还通过使用调试器和沙箱规避技术来对抗动态分析,以隐藏自己的存在。
Festi的Dropper(植入程序)有一个相当简单的功能—在系统中安装一个内核模式驱动程序,该驱动程序实现了恶意软件的主要逻辑。内核模式组件注册为“系统启动”内核模式驱动程序,并随机生成名称,这意味着在初始化期间,恶意驱动程序将在系统启动时加载和执行。
内核模式驱动程序有两个主要职责:从命令和控制(C&C)服务器请求配置信 息,以及以插件的形式下载和执行恶意模块(见图2-2)。每个插件专用于特定的任 务,例如对指定的网络资源执行DDoS攻击,或向C&C服务器提供的电子邮件列表发送 垃圾邮件。
有趣的是,插件并不存储在系统硬盘驱动器上,而是存储在易失性内存中,这意 味着当受感染的计算机被关闭或重新启动时,插件就会从系统内存中消失。这使得恶 意软件的取证分析变得非常困难,因为存储在硬盘上的唯一文件是主内核模式驱动程 序,它既不包含有效负载,也不包含攻击目标的任何信息。
Bootkit
可以看到,由于操作系统的安全性能不断提高,Rootkit已经式微,随之而来的是更加深入底层的Bootkit类型软件.
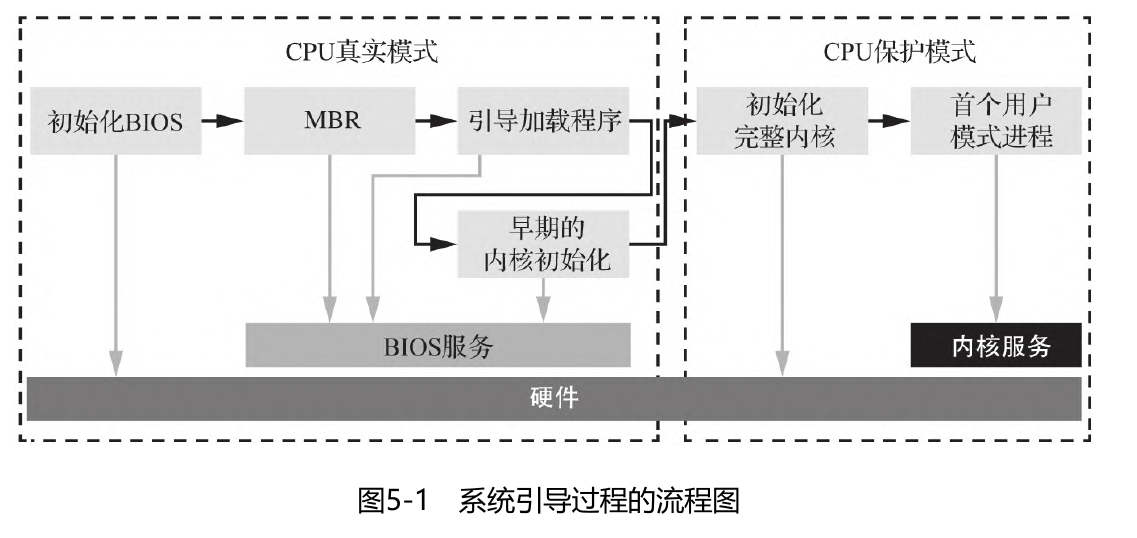
ch5
这一章很有看头,讲述了从BIOS启动操作系统的一般过程
总结
在可预见的几年内是不需要用到这本书的.
gRPC: Up and Running
- 出版于2020年,出版商:O’Reilly,作者:Kasun Indrasiri。
ch1: 介绍
在构建现代云原生应用和微服务的同步请求-响应式通信时,最常用且传统的方法是将其构建为RESTful服务,即将应用或服务建模为可通过HTTP协议上的网络调用访问和更改状态的资源集合。然而,对于大多数用例而言,RESTful服务在构建进程间通信时往往较为笨重、效率低下且易出错。通常需要一种高度可扩展、松散耦合且比RESTful服务更高效的进程间通信技术。这正是gRPC——一种用于构建分布式应用和微服务的现代进程间通信方式——发挥作用的地方
gRPC(“g”在每个gRPC版本中代表不同的含义)是一种进程间通信技术,它使您能够像进行本地函数调用一样轻松地连接、调用、操作和调试分布式异构应用程序。
作为有线传输协议,gRPC使用HTTP/2,这是一种高性能的二进制消息协议,支持双向消息传递。
背景
RPC是构建客户端-服务应用程序的一种流行的进程间通信技术。通过RPC,客户端可以像调用本地方法一样远程调用某个函数或方法。早期有几种流行的RPC实现,如公共对象请求代理架构(CORBA)和Java远程方法调用(RMI),它们用于构建和连接服务或应用程序。然而,这类传统RPC实现大多极其复杂,因为它们构建在像TCP这样的通信协议之上,这阻碍了互操作性,并且基于臃肿的规范。
由于传统RPC实现(如CORBA)的局限性,Simple Object Access Protocol(SOAP)被设计并由微软、IBM等大型企业大力推广。SOAP是 service-oriented architecture(SOA)中的标准通信技术,用于在服务(在SOA上下文中通常称为Web服务)之间交换基于XML的结构化数据,并通过任何底层通信协议(如HTTP,最常用)进行通信。
SOAP曾是一种相当流行的技术,但消息格式的复杂性以及围绕SOAP构建的规范复杂性,阻碍了分布式应用开发的敏捷性。因此,在现代分布式应用开发的背景下,SOAP web服务被视为一种遗留技术。相较于使用SOAP,当前大多数现有的分布式应用正采用REST架构风格进行开发。
REST的事实标准实现是HTTP,而在HTTP中,你可以将RESTful Web应用建模为一系列资源,这些资源通过唯一标识符(URL)进行访问。状态变更操作以HTTP动词(如GET、POST、PUT、DELETE、PATCH等)的形式应用于这些资源之上。资源的状态以文本格式(如JSON、XML、HTML、YAML等)表示。
使用REST架构风格配合HTTP和JSON构建应用程序已成为构建微服务的事实标准方法。然而,随着微服务数量及其网络交互的激增,RESTful服务已无法满足预期的现代需求。RESTful服务存在几个关键限制,阻碍了其作为基于微服务的现代应用程序的消息传递协议的能力。
本质上,RESTful服务建立在基于文本的传输协议(如HTTP 1.x)之上,并利用可读的文本格式(如JSON)。在服务到服务的通信中,使用JSON这类文本格式效率并不高,因为通信双方无需采用这种面向人类的可读文本格式。
作为一种架构风格,REST 包含许多“良好实践”,遵循这些实践才能构建出真正的 RESTful 服务。然而,这些实践并未作为实现协议(如HTTP)的强制部分,使得在实现阶段难以强制执行。因此,在实践中,大多数自称为 RESTful 的服务并未 properly 遵循 REST 风格的基础。由此,所谓的 RESTful 服务大多仅仅是通过网络暴露的 HTTP 服务。因此,开发团队不得不花费大量时间维护 RESTful 服务的一致性和纯粹性。
Google一直使用一个名为Stubby的通用RPC框架,来连接数千个运行在多个数据中心、采用不同技术构建的微服务。其核心RPC层旨在处理每秒数百亿次请求的互联网规模。Stubby拥有众多优秀特性,但它并未被标准化为通用框架,因为它与Google的内部基础设施耦合过紧。2015年,谷歌发布了gRPC作为开源RPC框架;它是一种标准化、通用且跨平台的RPC基础设施。gRPC旨在向广大社区提供与Stubby相同的可扩展性、性能和功能。
gRPC并非使用JSON或XML这类文本格式,而是采用基于协议缓冲区的二进制协议来与gRPC服务和客户端进行通信。此外,gRPC在HTTP/2之上实现了协议缓冲区,这使得它在进程间通信中更加高效。
| |
可以看到,protobuf的格式相当清晰,比起OpenAPI规范的可读性要高了许多,不再需要强调路由,方法这些让人心累的无关参数.
ch3: gRPC Communication Patterns
总共有四种gRPC模式:
| 通信模式 | 英文名称 | 客户端发送 | 服务端返回 | 典型应用场景 |
|---|---|---|---|---|
| 一元 RPC | Unary RPC | 单个请求 | 单个响应 | 用户登录、查询用户信息、普通 API 调用 |
| 服务端流式 RPC | Server Streaming RPC | 单个请求 | 多个响应(流式) | AI 文本流式输出、实时日志推送 |
| 客户端流式 RPC | Client Streaming RPC | 多个请求(流式) | 单个响应 | 文件分块上传、批量数据采集 |
| 双向流式 RPC | Bidirectional Streaming RPC | 多个请求(流式) | 多个响应(流式) | 实时聊天、双向语音通信、实时协作 |
protobuf中用stream关键字来标记是否流式输出:
| |
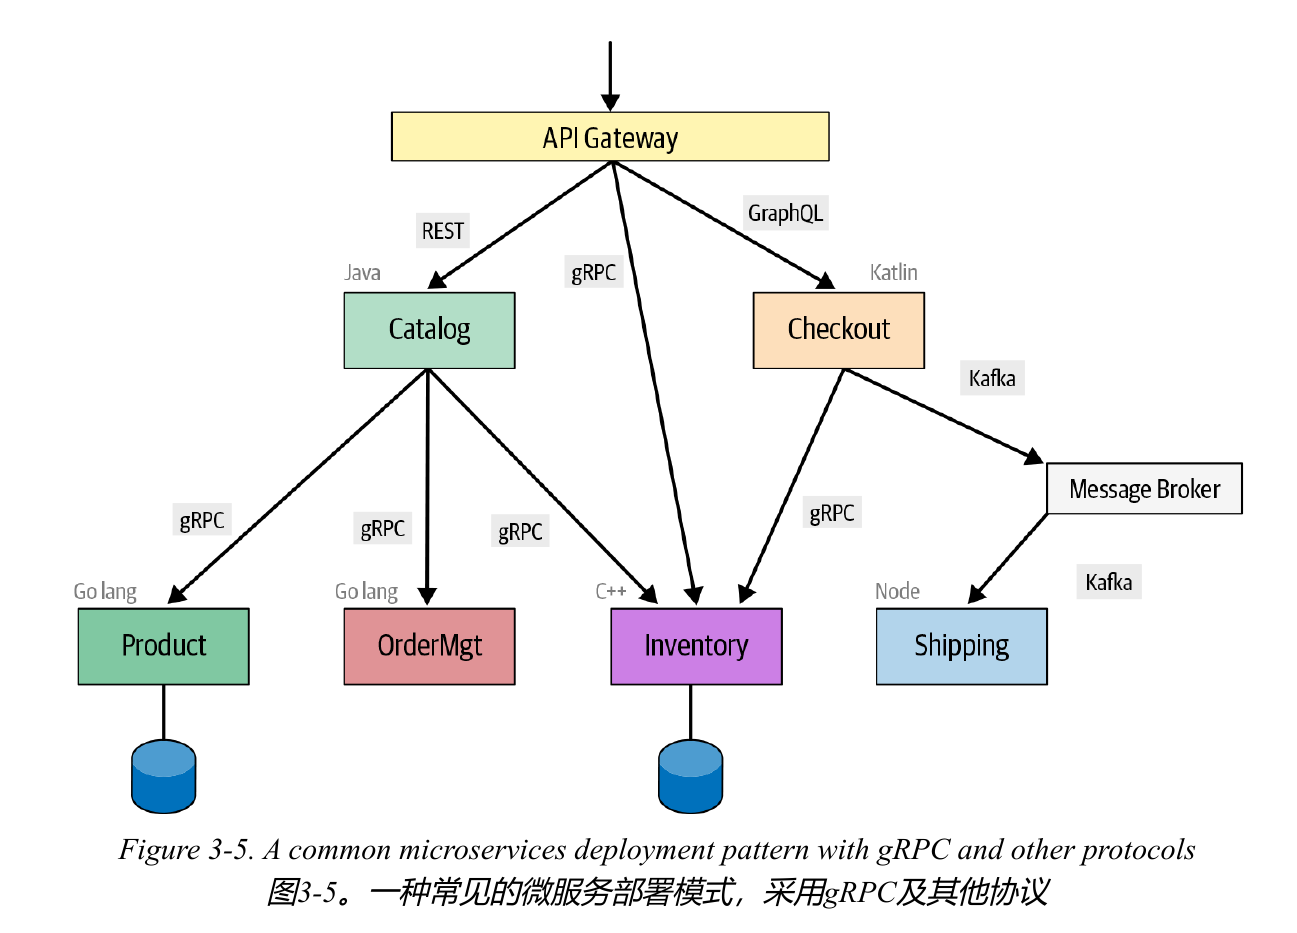
ch4: gRPC原理
gRPC的通信过程很简单,以客户端调用getProduct函数为例:
- Client会生成一个stub,用于调用Server中的函数
- Client的stub负责创建一个携带编码后消息的 HTTP POST 请求。在 gRPC 中,所有请求都是 HTTP POST 请求,其
content-type以application/grpc为前缀。所调用的远程函数(/ProductInfo/getProduct)作为单独的 HTTP header发送。 - HTTP 请求消息通过网络发送到Server。
- 当消息到达Server时,Server会检查消息头以确定需要调用哪个服务功能,并将消息交给Server的stub处理。
- stub将消息解析为特定于语言的数据结构。
- 然后,服务使用解析后的消息,对
getProduct函数进行本地调用。 - 服务函数的返回被编码后发送回Client。响应消息遵循我们在客户端观察到的相同流程(响应→编码→线上的 HTTP 响应);消息被解包,其值返回给等待的客户端进程。
这些步骤与大多数RPC系统(如CORBA、Java RMI等)非常相似。这里gRPC的主要区别在于它对消息的编码方式.
- 尽管原文有对编码进行分析,但对我们平常用grpc确实没有任何帮助,所以暂时不学
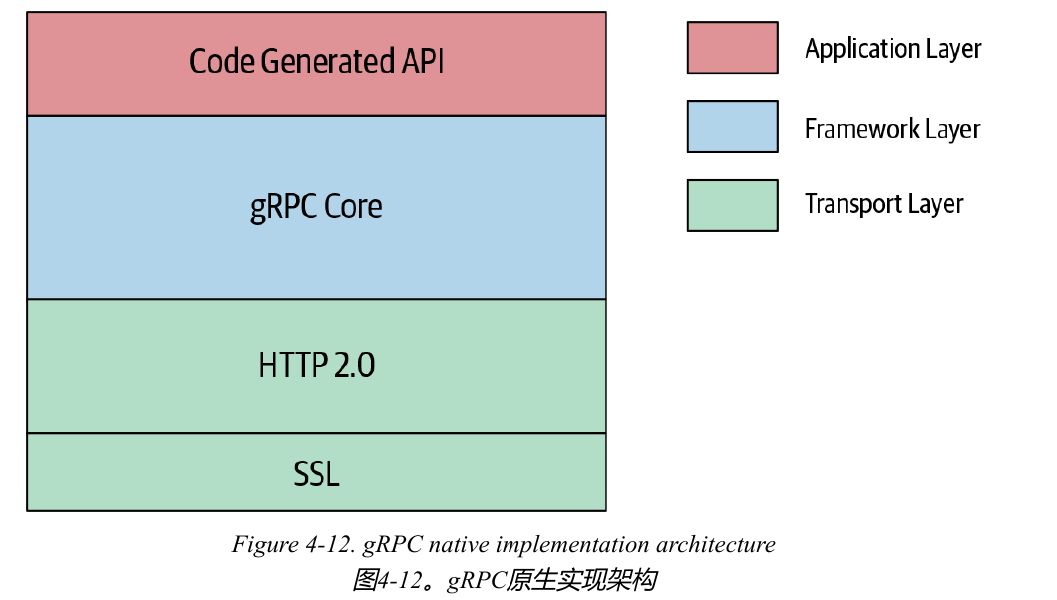
ch5: gRPC高级
鉴于还没开始用,所以先放着.
Hadoop: The Definitive Guide(4th)
- 出版于2015年(第4版),出版商:O’Reilly,作者:Tom White。
基础
起源
Hadoop这个名字并不是一个首字母缩略词;它是一个杜撰出来的名字。该项目的创建者Doug Cutting解释了这个名字的由来:
The name my kid gave a stuffed yellow elephant. Short, relatively easy to spell and pronounce, meaningless, and not used elsewhere
Hadoop起源于Lucene的研发过程,结合了04年Google公开的MapReduce算法,并在08年成为Apache的顶级项目,在之后被主流企业广泛使用
MapReduce
简单例子
- 首先我们有一个数据集,想要从中找出每一年的最大数
| |
- 设置一个Map函数,从中过滤后并提取出标准格式的信息:
| |
整理得到:
| |
- 设置一个Reduce函数,遍历Map函数的结果得到最终值:
| |
流程图如下:
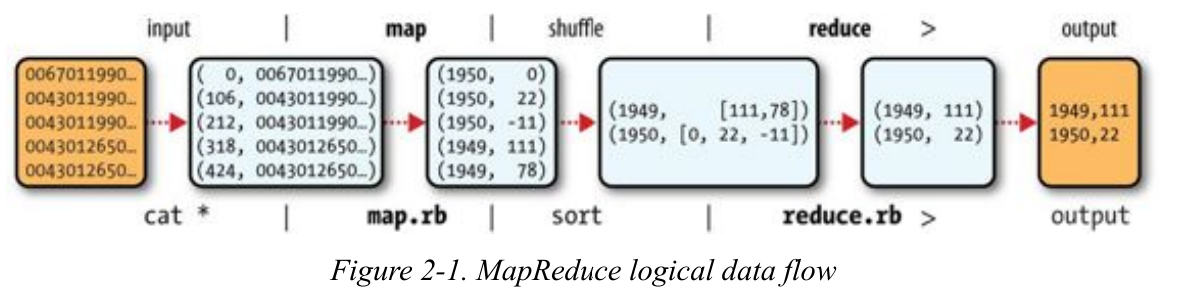
Map函数:
| |
Reduce函数:
| |
在实现了Map和Reduce方法后,调用方法如下:
| |
总结
至少在可见的未来我没必要学吧…
推荐系统:前沿与实践
比我想的要好很多,以前看的那几本相关书简直是垃圾
概述和历史
1987年,麻省理工学院与密歇根州立大学的研究人员提出了一个颇具前瞻性的构想:设计一种新型的信息共享系统,只将相关信息分发给那些认为其有价值的人,而不去干扰那些认为其无价值的人。这一构想,正是推荐系统的萌芽。
此后,推荐系统的研究逐步深入,并展现出越来越高的商业价值。2001年,亚马逊首次将推荐系统引入电商平台,带来了销售额的大幅提升。2006年,网飞举办“Netflix Prize”竞赛,吸引了大批研究人员投身该领域,也推动了矩阵分解等重要方法在推荐算法中的快速发展。2007年,图灵奖得主 Geoffrey Hinton 与合作者 Ruslan Salakhutdinov、Andriy Mnih 共同提出用受限玻尔兹曼机解决推荐问题的方法,开启了深度学习时代推荐算法研究与应用的新篇章。
此后,推荐系统研究蓬勃发展,其价值也在越来越多的场景中得到验证。
三种形式
推荐算法有几种形式:
- 基于内容: 先收集用户的兴趣并建模,再推荐相关内容给用户
- 协同过滤: 由于内容推荐有很大的局限性,准确率较低,为了解决这些问题,1992年,美国施乐公司的 Goldberg 等人创新性地提出了协同过滤思想,即一位用户可能与部分其他用户(也称为“邻居”)具有相似的兴趣,因此他(她)很可能会喜欢这些邻居感兴趣的物品。协同过滤可以认为是推荐算法领域最重要的概念之一,从出现至今一直影响着推荐算法的研究与应用。
- 相关的主流算法有最近邻算法(对相似度做加权平均)和矩阵降维/分解(高维的用户向量彼此交集很少,但降维之后可以让数据密集起来)
- 深度学习: 最早的应用在于07年,但直到ImageNet比赛之后,深度学习才开始真正应用在推荐算法上
基本原理
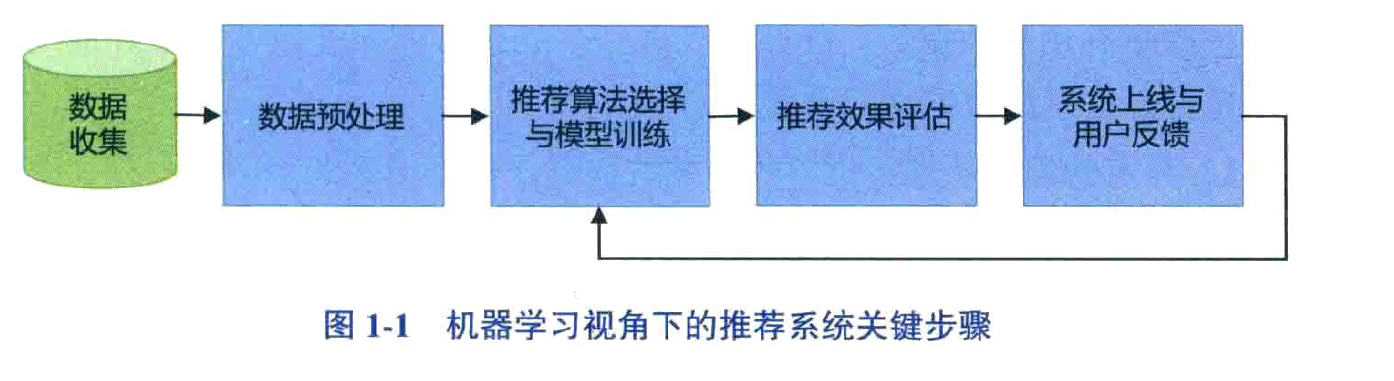
个性化推荐固然很重要,但是我觉得这种比较玄乎看心情的东西,98%和99%的差别基本没有吧,所以也没必要专门去频繁换算法,除非有了大杀器出现,才值得更换一次,这也就意味着相关的岗位肯定比较少,但都是比较核心的.
推荐、搜索与广告被很多人称作互联网技术的三驾马车,是互联网平台中最受重视的三种技术,也是互联网平台盈利的关键。从应用本身来看,三者之间存在着较大的差异,但是三种应用在技术上有许多共同之处,如表 1-1 所示。
表 1-1 推荐、搜索与广告的比较
| 比较项目 | 推荐 | 搜索 | 广告 |
|---|---|---|---|
| 用户交互方式 | 用户主动请求与被动接受 | 用户主动请求 | 用户被动接受 |
| 个性化程度 | 强 | 弱 | 中等 |
| 用户接受度 | 强 | 强 | 弱 |
三者在如今越来越相似,普遍使用“召回 + 排序”这一经典架构作为算法引擎.
基本算法
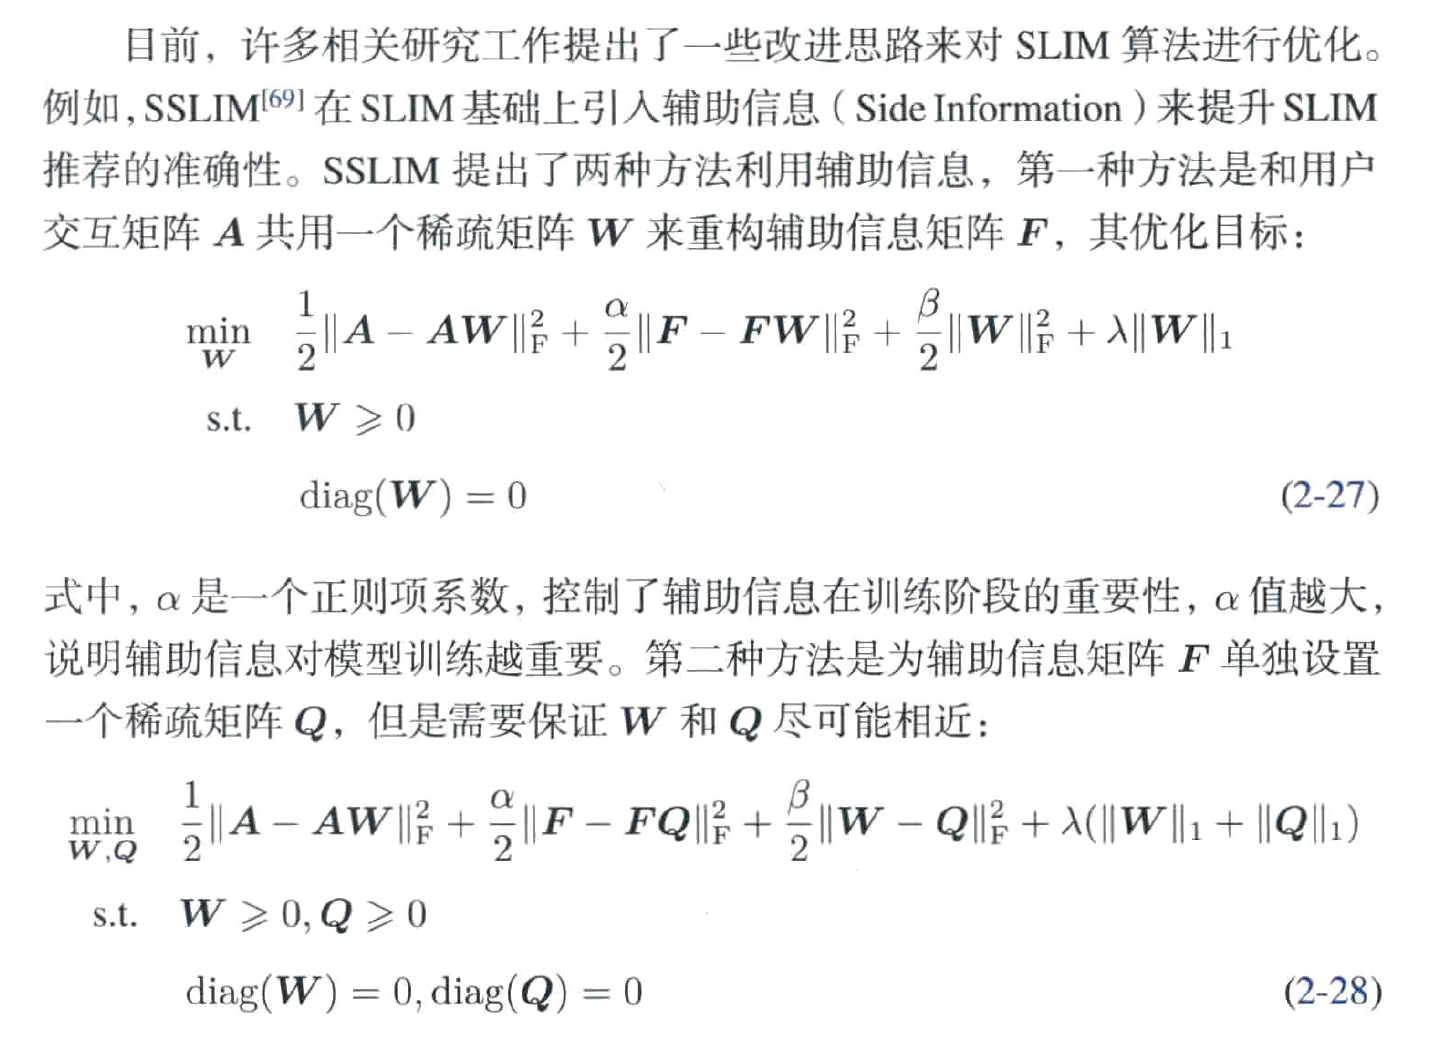
看到这个我就知道自己完全不是这块料呢.
总结
明明知道这书写的不错,但就是看不进去公式啊.
Learning Go
ch1: 搭建环境
| |
使用make
| |
在终端敲上make这个单词就可以自动运行build命令了.
ch2: 类型和声明
字符串
Go 语言中的字符串是不可变的;你可以重新赋值给一个字符串变量,但你不能改变赋值给它的字符串的值。
变量声明
如果有初始化值,Go中的var声明都可以省略类型:
| |
另一个则是只能写在函数中作为局部变量声明的:=,同样不用指定类型:
| |
Go中的const声明如下:
| |
其中第二种声明方式显然比较有特色
ch3: 复合类型
数组
| |
Go 语言中的数组很少被显式使用。这是因为它们有一个特殊的限制:Go 将数组的大小视为数组类型的一部分。这使得声明为[3]int 的数组与声明为 [4]int 的数组类型不同
切片
切片的用法与数组类似,但声明时不用指定数组大小:
| |
make内置函数
指定切片类型,零值数量,总容量.
| |
从数组/切片中创建切片
| |
依然遵循前闭后开的准则.
切片彼此之间是相互引用的,修改一个切片会影响到其他相同位置的切片.
| |
数组转换成切片.
| |
切片转换成数组.
copy内置函数
| |
copy函数可以创建一个独立于原始切片的切片.
Maps
声明与创建
普通的声明方式如下,[]中写key,后面跟着任何可映射的value类型:
| |
通用的make函数声明:
| |
访问Map
| |
可以看到,Map访问内置了异常处理,还是很方便的.
Structs
声明
| |
Go中的结构体不支持默认值,只有零值.
对于结构体来说,赋值一个空结构体字面量和完全不赋值之间没有区别,都会将所有字段初始化为零值:
| |
和python一样,go支持指名赋值或者按照成员声明的顺序来进行不指名赋值.
匿名结构体
| |
pet还比较好理解,是一个经典的匿名结构体,在声明后立即使用.但person就比较神奇了,原来的type person struct变成了var person struct,然后就同时完成了类型声明和初始化变量两件事情.
匿名结构体显然是那种只会用到一两次的数据仓库.
ch4: 逻辑结构
if
| |
Go中的if语句可以定义存活到else语句结束时的变量,很容易用在那些当属性名称太长时的简写.
for
Go中的for有四种形式:
- A complete, C-style
for - A condition-only
for - An infinite
for for-range
| |
需要注意的是,每次
for-range循环遍历复合类型时,它都会将复合类型的值复制到 value 变量中。修改 value 变量不会修改复合类型的值
如果要修改原复合类型,就必须要通过下标来处理:
| |
ch5: 函数
基本形式
在Go中,你必须为函数提供所有参数,并不存在命名参数和可选参数,如果参数过多,可以包裹在一个结构体里面再传入:
| |
但Go支持可变参数,也就是说可以传入任意数量的参数:
| |
Go的另一个独特之处就是支持多个返回值:
| |
接受变量需要与返回值的数量一一对应,如果有不需要的值,则用_表示,如 result, _, err := divAndRemainder(5, 2)
Go还支持对返回值命名:
| |
命名的返回值在创建时会被初始化为零。这意味着你可以在任何显式使用或赋值之前直接返回它们。
函数也是值
我们可以声明一个函数变量:
| |
| |
我们还可以声明函数的类型:
| |
Go还支持匿名函数:
| |
甚至还能在声明时直接调用:
| |
- 非常不推荐好吧,太不清晰了
闭包
在函数内部声明的函数被称为闭包:
| |
甚至还能将函数作为返回值:
| |
defer
| |
defer的函数直到作用域结束时才开始执行,是按照栈的顺序推入的,遵循先进先出的规则.
尽管可以用在方法调用中,但defer最常用的方式是写成匿名函数的形式:
| |
按值传递
Go中的函数参数在一般情况下都是复制进去的,也就是说不会改变原变量的值,除非是指针类型.如Map和Slice.
ch6: 指针
介绍
| |
虽然不同类型的变量占用的内存空间数量可能不同,但每个指针,无论指向什么类型,始终占用相同数量的内存空间。
指针的零值是 nil 。你之前已经见过 nil 几次了,它代表切片、映射和函数的零值。所有这些类型都是用指针实现的
内置函数 new 创建一个指针变量。它返回指向所提供类型的零值实例的指针:
| |
在 Java、Python、JavaScript 和 Ruby 中,int,string等普通的变量类型在使用y=x复制时是直接拷贝的,二者互不相关,而类的传参是通过指针进行的,在函数内部写student.score=100是真的会影响到原student类的,当你重新给这个类初始化,只会改变函数内部的参数变量,外部的类不受影响.
| |
问题在于,当你直接传入指针时,是直接复制地址进去的,想要修改该地址对应的变量,就要通过解引用符明确指向它,否则就只是在函数内部修改而已.
糟糕的设计
| |
由于Go会自动解引用,上述代码等价于:
| |
要我说,不如把->还回来算了,自动解引用反而让我看的很难受.
slice和map
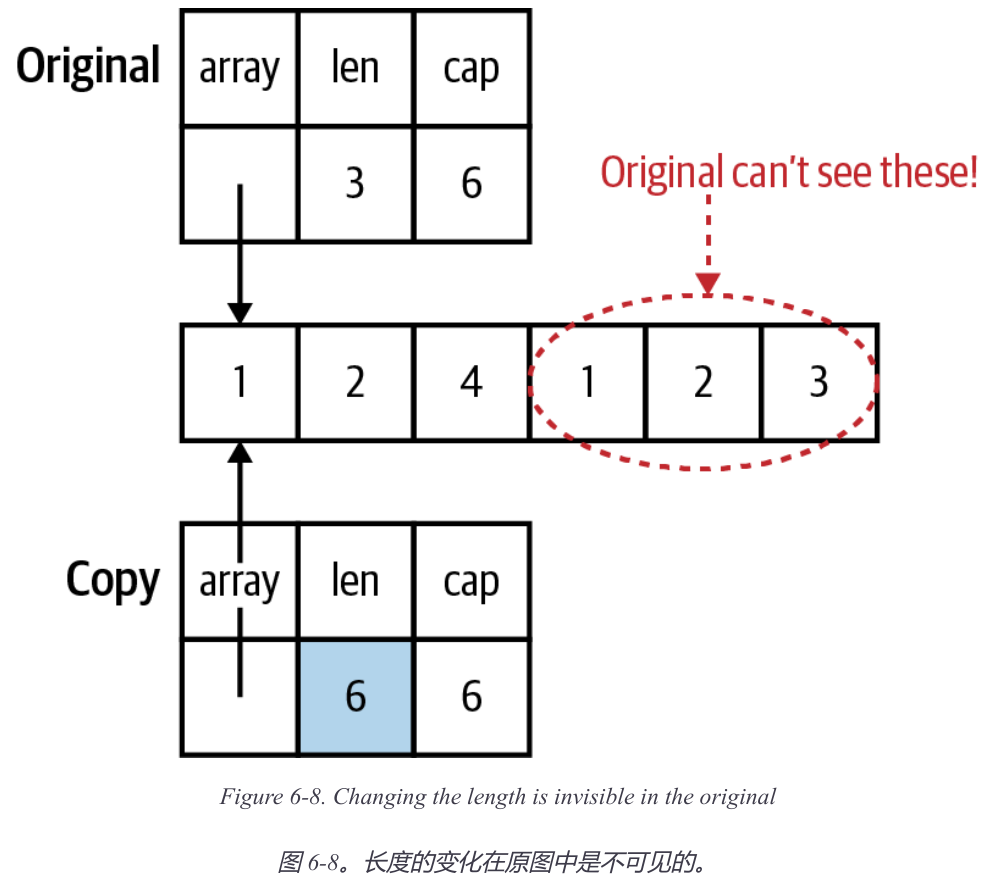
切片同样是指针传值,但对副本所做以下操作不会对原切片造成更改:
- append追加数据
- append追加数据导致副本扩容,此时副本的指针将会与原切片分离:
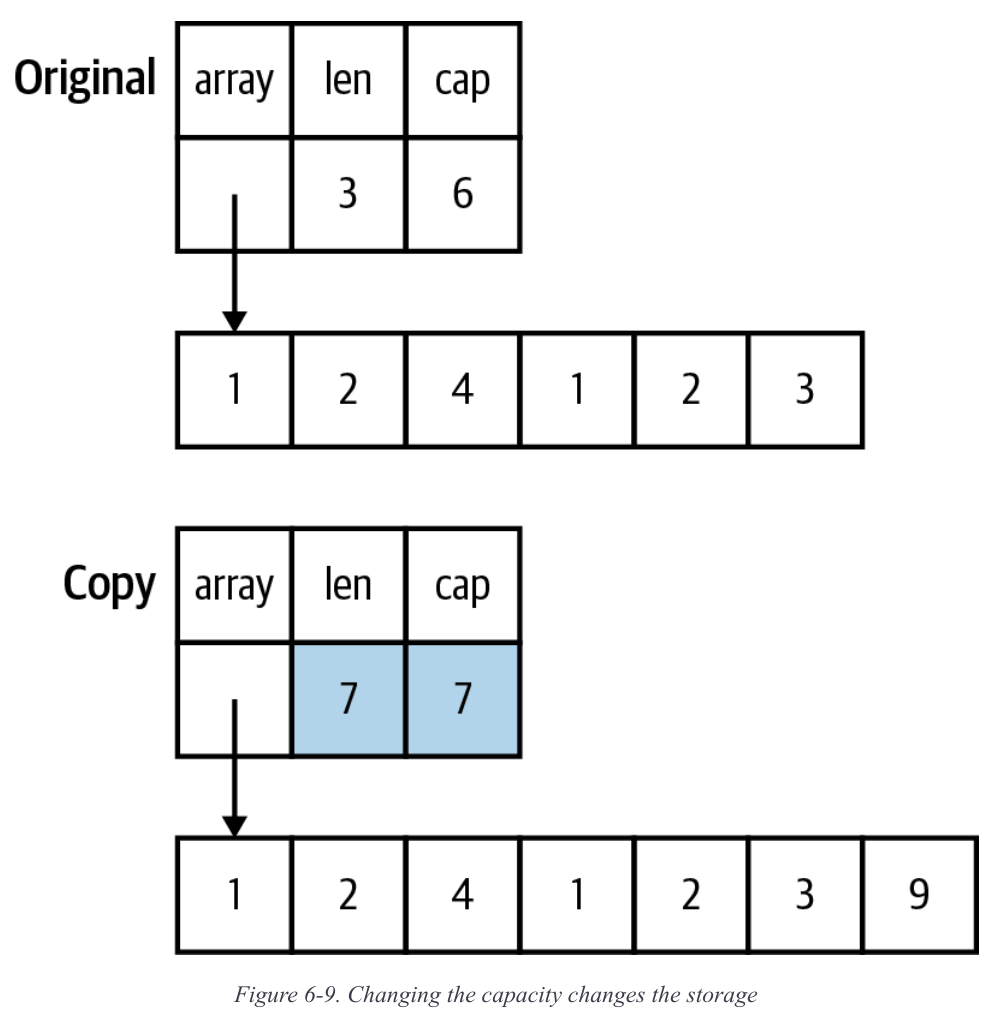
而将map传递给函数实际上就是复制一个指针,但由于我们不知道map的具体key有哪些,所以唯一了解键值的方法就是追踪代码,这样来看,远不如直接传入一个结构体.
Go的设计
要在栈上存储数据,必须在编译时精确知道它的大小。Go 语言中的值类型(基本类型、数组和结构体)都有一个共同点:它们在编译时占用的内存大小是已知的。这就是为什么数组的大小被视为类型的一部分。由于数组的大小已知,因此可以将其分配到栈上而不是堆上。指针类型的大小也是已知的,并且也存储在栈上。
而对于指针指向的堆类型数据,必须要经过垃圾回收处理,所以会降低不少性能.
在 Java 中,局部变量和参数都存储在栈上,就像 Go 一样。然而,正如前面讨论的,Java 中的对象是以指针的形式实现的。对于每个对象变量实例,只有指向它的指针会被分配到栈上;对象内部的数据则被分配到堆上。只有基本类型(数字、布尔值和字符)才会完全存储在栈上。这意味着 Java 中的垃圾回收器需要执行大量的工作
ch7: 类型,方法与接口
Type
Go支持在任何代码块级别声明自定义的类型:
| |
Methods
方法声明在函数名之前多了一个receiver specification,用于标明这是该类型的方法:
| |
声明方法和声明函数之间有一个关键区别:方法只能在包块级别定义,而函数可以在任何块内定义。
如果要修改结构体内部,就必须通过指针传值:
| |
在本例中, c.Increment() 被转换为 (&c).Increment() 。
而在下面这个例子中, c.String() 被静默地转换为 (*c).String() 。:
| |
也就是说不用像Cpp那样总要显式写明了,但对于习惯Cpp写法的人来说终归是比较别扭的.
方法也是值
| |
还可以从类型本身创建函数,这被称为方法表达式:
| |
iota Is for Enumerations—Sometimes
许多编程语言都有枚举的概念,允许你指定某种类型只能拥有有限的值。Go 语言没有枚举类型,而是使用了 iota ,允许你为一组常量赋值,且值递增。
| |
iota 的值会随着 const 代码块中定义的每个常量递增,从0 开始。这意味着 0 被赋值给第一个常量 (Uncategorized ),1 被赋值给第二个常量 (Personal),依此类推
Embedding(嵌入)
Go中没有继承机制,只能通过嵌入(将要"继承"的结构体直接放进内部字段)来间接实现:
| |
Interfaces
接口可以在任何代码块处声明:
| |
Go中不需要类似Java中implements这样的关键字,只要某个类型实现了该接口中的所有方法,那么该类型就实现了该接口.
| |
代码提供了一个接口,但只有调用者 ( Client ) 知道它的存在;LogicProvider 上没有任何声明表明它符合该接口
类型断言
| |
明明MyInt就是int类型,但上述代码依然会Panic,原因是类型断言必须字面上完全一样,想要不panic只能这样写:
| |
依赖注入
| |
简单来说就是,通过接口,我们可以让所有满足接口的类型都能直接注入到目标代码中,从而减少代码所需的更改.
ch8: Generics(待补充)
介绍
| |
Go的泛型与Cpp不同的地方在于,有诸如any这样的类型约束,而这与Rust中的约束非常相似,也更好理解.
而由于T的类型不一定,所以不能直接返回nil,因为int等类型的零值为0,而字符串的类型零值为"",所以必须要借助var的自动初始化的机制来赋值.
ch9: Errors(待补充)
| |
ch10: 模块和包
遗憾的是,不同的编程语言使用这些术语来表示不同的概念。虽然 Java 和 Go 中的包很相似,但 Java 仓库是一个集中存储多个工件的地方(相当于 Go 模块)。Node.js 和 Go 则互换了这些术语的含义:Node.js 中的包类似于 Go 中的模块,而 Go 中的包则类似于 Node.js 中的模块。
go mod
命令 go mod init MODULE_PATH 会创建 go.mod 文件,并将当前目录设置为模块的根目录。MODULE_PATH 是全局唯一标识模块的名称。模块路径区分大小写。为避免混淆,请勿在路径中使用大写字母。
从编译器版本看Go
| |
如果将mod文件里的go版本改为1.21及以下,那么每次打印出来的是相同的地址,代表每次循环时,Go 只是把切片 x 中的下一个值,拷贝到同一个变量 v 的内存空间里,但如果改成1.22及以上,那么每次打印的是不同地址,代表每
包的介绍
在Go中一个目录就是一个包,不能包含多个包,包也不能包含多个目录.
Go 语言并没有使用特殊的关键字,而是通过大小写来判断包级标识符是否在其声明的包之外可见。名称以大写字母开头的标识符会被导出。相反,名称以小写字母或下划线开头的标识符只能在其声明的包内部访问
| |
导入一个包但未使用该包导出的任何标识符,会导致编译时错误。这确保 Go 编译器生成的二进制文件仅包含程序实际使用的代码。
Go模块系统采用最小版本选择原则:在所有依赖项的go.mod文件中,你总是会获取到声明为可正常工作的最低依赖版本。假设你的模块直接依赖于模块A、B和C,这三个模块都依赖于模块D。模块A的go.mod声明它依赖于v1.1.0,模块B声明它依赖于v1.2.0,模块C声明它依赖于v1.2.3。Go只会导入模块D一次,并会选择v1.2.3版本,因为正如Go模块参考文档中所述,这是满足所有要求的最低版本。
ch11: tooling(待补充)
go install和go get
| |
| |
go get用于更新当前mod的依赖,而go install用于编译并安装包,并在环境变量中注册对应的可执行文件.
ch12: 并发
Goroutine
可以将 goroutine 理解为由 Go 运行时管理的轻量级线程。当 Go 程序启动时,Go 运行时会创建若干线程,并启动一个 goroutine 来运行你的程序
创建 Goroutine 比创建线程更快,因为你不需要创建操作系统级别的资源。
Goroutine 的初始栈大小小于线程栈大小,并且可以根据需要增长。这使得 goroutine 更节省内存。
在 goroutine 之间切换比在线程之间切换更快,因为它完全在进程内进行,避免了(相对)缓慢的操作系统调用。
由于 goroutine 调度器是 Go 进程的一部分,因此它能够优化其决策。该调度器与网络轮询器协同工作,检测何时 goroutine 因 I/O 阻塞而可以取消调度。它还与垃圾回收器集成,确保分配给 Go 进程的所有操作系统线程之间的工作负载得到适当的均衡。
这些优势使得 Go 程序能够同时生成成百上千甚至数万个 goroutine。如果你尝试用一种本身就支持线程的语言启动数千个线程,你的程序运行速度将会变得极其缓慢。
- 说真的,光看了这些我还是不知道Goroutine是什么,唯一的方法就是去看源码了.
Channels
Channel是一种内置类型,同样使用make函数创建:
| |
与映射(Map)类似,通道(Channel)也是引用类型,因此通道的零值是 nil .
Channel的写法非常神奇:
| |
- 其实我觉得
->和<-来标记更好,但估计设计的时候考虑到这样写更麻烦了吧
写入通道的每个值只能被读取一次。如果多个 goroutine 从同一个通道读取数据,则写入通道的值只会被其中一个 goroutine 读取。
单个 goroutine 很少会同时读取和写入同一个通道。当将通道赋值给变量或字段,或将其传递给函数时,请在
chan关键字前使用箭头(例如ch <-chan int),以表明 goroutine 仅从该通道读取数据。在chan关键字后使用箭头(例如ch chan<- int),以表明 goroutine 仅向该通道写入数据。这样做可以让 Go 编译器确保通道仅由函数读取或写入。
- 设计思想上确实很有意思,这天然就解决了通信并发的问题还不用加锁
Go 也支持缓冲通道。这些通道可以缓冲有限数量的写入操作,而不会阻塞。如果通道在读取操作发生之前缓冲区已满,则后续的写入操作会暂停写入 goroutine,直到通道中的数据被读取完毕。正如向缓冲区已满的通道写入数据会阻塞一样,从缓冲区为空的通道读取数据也会阻塞。
创建方法如下,指定缓冲区的容量:
| |
完成向频道写入数据后,可以使用内置的 close 函数将其关闭:
| |
通道一旦关闭,任何写入或再次关闭通道的尝试都会导致程序崩溃。有趣的是,尝试从已关闭的通道读取数据总是会成功。如果通道已缓冲且仍有一些值尚未读取,则会按顺序返回这些值。如果通道未缓冲或已缓冲的通道中没有更多值,则返回该通道类型的零值。
因此,为了区分写入的零值和通道关闭返回的零值,我们读取通道时最好这么写:
| |
如果 ok 设置为 true ,则通道已打开;如果设置为 false ,则通道已关闭。
| 操作 | 无缓冲,开放 | 无缓冲,已关闭 | 缓冲,开放 | 缓冲,已关闭 |
|---|---|---|---|---|
| 读 (Read) | 暂停,直到有内容写入。 | 返回零值(使用逗号可判断是否已关闭)。 | 如果缓冲区为空,则暂停。 | 返回缓冲区中剩余的值;若缓冲区为空,则返回零值(可用逗号判断是否已关闭)。 |
| 写 (Write) | 暂停,直到有内容被读取。 | 恐慌 (PANIC) | 如果缓冲区已满,则暂停。 | 恐慌 (PANIC) |
| 关闭 (Close) | 正常生效。 | 恐慌 (PANIC) | 正常生效;缓冲区中剩余的值依然存在。 | 恐慌 (PANIC) |
select
select 关键字允许 goroutine 从一组多个通道中的一个读取数据或向其中一个通道写入数据。它看起来很像一个空白的 switch 语句:
| |
如果多个 case 都具有可读写的通道会发生什么?select 算法很简单:它从所有可以继续执行的 case 中随机选择一个;顺序无关紧要。这与 switch 语句截然不同,后者总是选择第一个解析为 true 的 case。它也完美地解决了饥饿问题,因为没有哪个 case 比其他的更有优势,所有 case 都会同时被检查。
补充: go关键字
我寻思我也没跳内容啊,怎么突然就看不懂代码了.
go关键字把一个函数调用放到一个新的 goroutine 中并发执行,而当前 goroutine 不等待它执行完就继续执行:
| |
go不关心函数的返回值,只起到开启goroutine的作用.
继续
如果两个 goroutine 都访问相同的两个通道,则这两个 goroutine 必须以相同的顺序访问它们,否则就会发生死锁:
| |
由于上述的ch1和ch2都是没有缓冲区的,如果没有接收者,发送方就会被阻塞.无论是哪个Goroutine先运行,由于另一边缺少接收者,那么就会被阻塞,转而执行另一个Goroutine,从而形成死锁.
但这可以用select来解决:
| |
与 switch 语句类似, select 语句也可以包含 default 子句
| |
goroutine回收
每次启动 goroutine 函数时,必须确保它最终会退出。与变量不同,Go 运行时无法检测到 goroutine 是否会被再次使用。如果 goroutine 没有退出,其栈上分配给变量的所有内存都会一直保留,并且堆上任何以 goroutine 栈变量为根的内存都无法被垃圾回收。这被称为 goroutine 内存泄漏。
解决方法是使用context:
| |
mutex(待补充)
ch13&&ch14(待补充)
等真的用到了再来看
ch15: 测试
Go中普遍使用官方库来写测试,适用go test命令来运行测试:
| |
其中,测试文件名必须以_test.go结尾,测试函数必须以Test打头,后面的第一个字母必须大写,而且不能是某个类型的方法,而是单纯的函数,不能有返回值,而是通过Error,Fatal等方法来打印调试信息.
| |
Docker Up & Running,3rd edtion
ch1: 引言
Docker 最初是由 dotCloud 公司的创始人兼首席执行官 Solomon Hykes 于 2013 年 3 月 15 日在加利福尼亚州圣克拉拉举行的 Python 开发者大会上,以五分钟的闪电演讲向世界推出的——事先没有任何预告,也没有大张旗鼓的宣传。在这次发布时,除了 dotCloud 之外,只有大约 40 人有机会体验 Docker。
最初,许多不熟悉 Docker 的人将其视为某种虚拟化平台,但实际上,它是第一个广泛应用的工具,它基于一种名为容器化的新兴技术。Docker 和 Linux 容器对众多行业领域产生了重大影响,其中包括 Vagrant、KVM、OpenStack、Mesos、Capistrano、Ansible、Chef、Puppet 等工具和技术。
在部署过程中,旧应用程序的整个运行环境都会被抛弃。应用程序环境中的任何东西都不会比应用程序本身存在更长时间,这是一个看似简单却意义深远的理念。这意味着应用程序不太可能意外地依赖于先前版本遗留的工件。这意味着从本地文件系统中获取的短暂调试更改不太可能在后续版本中继续存在。
ch2: 概览
服务提供商和商业供应商尤其不愿构建可能受制于与其利益重叠的公司意志的平台。因此,Docker 公司在那段时间面临着一些公开的挑战。为了赢得公众好感并支持其产品在市场上的更广泛应用,Docker 公司于 2015 年 6 月决定赞助开放容器倡议(OCI)。该倡议的首个完整规范于 2017 年 7 月发布,其很大程度上基于 Docker 镜像格式的版本 2。现在,容器镜像和容器运行时都可以申请 OCI 认证。
最主要的运行时就是containerd了,他是现代版本的 Docker 和 Kubernetes 中的默认高级运行时,底层运行时则可以是runc和crun等.
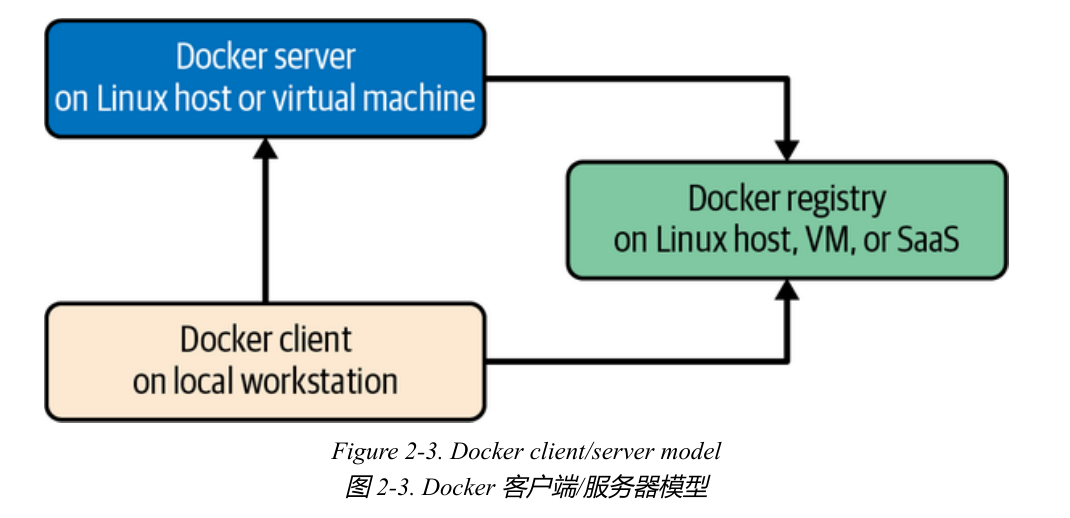
服务器负责构建和管理容器,而客户端负责向服务器发出指令.
每个 Docker 主机通常运行一个 Docker 服务器,该服务器可以管理任意数量的容器。然后,您可以使用命令行工具(docker)与服务器通信,既可以从服务器本身通信,也可以在安全措施到位的情况下从远程客户端通信
尽管 Docker 在生产环境编排领域的光芒很大程度上被 Google 的 Kubernetes 所掩盖,但值得注意的是,在 2022 年初发布 1.24 版本之前,Kubernetes 也高度依赖 Docker。不过,Docker 的编排工具仍然非常实用,尤其是 Compose,对于本地开发来说非常方便。
首先,Docker 的架构主要面向无状态应用,或者将状态外部化到数据库或缓存等数据存储中的应用。这类应用最容易容器化。Docker 为这类应用强制执行了一些优秀的开发原则,但这也就意味着,像把数据库引擎放在 Docker 容器里这样的操作有点像逆流而上。这并不是说你不能这样做,甚至也不是说你不应该这样做;只是这并非 Docker 最常见的用例。
ch4: 镜像
镜像构建的一个特殊之处在于,尽管构建时会尽可能地利用缓存,但是每一层构建之间是完全不相关的,也就是说如果要清除build时的缓存,就必须将构建和清除放在同一行,如RUN dnf install -y httpd && \ dnf clean all
一般来说,你应该始终尝试对 Dockerfile 进行排序,以便构建过程中最稳定和最耗时的部分首先执行,而你的代码则尽可能在过程的最后添加。
ch5: 容器
容器的定义:
A container is a self-contained execution environment that shares the kernel of the host system and is (optionally) isolated from other containers in the system.
对于绑定挂载,您可以使用 -v 参数来缩短命令。使用 -v 参数时,您会注意到源文件/目录和目标文件/目录之间用冒号 (:) 分隔。另需注意的是,卷默认以读写模式挂载。您可以通过在 –mount 参数末尾添加,readonly,或在 -v 参数末尾添加 :ro,轻松地将 docker 文件或目录挂载为只读模式:
| |
windows image
在Docker Desktop中可以在Windows镜像和Linux镜像之间切换:
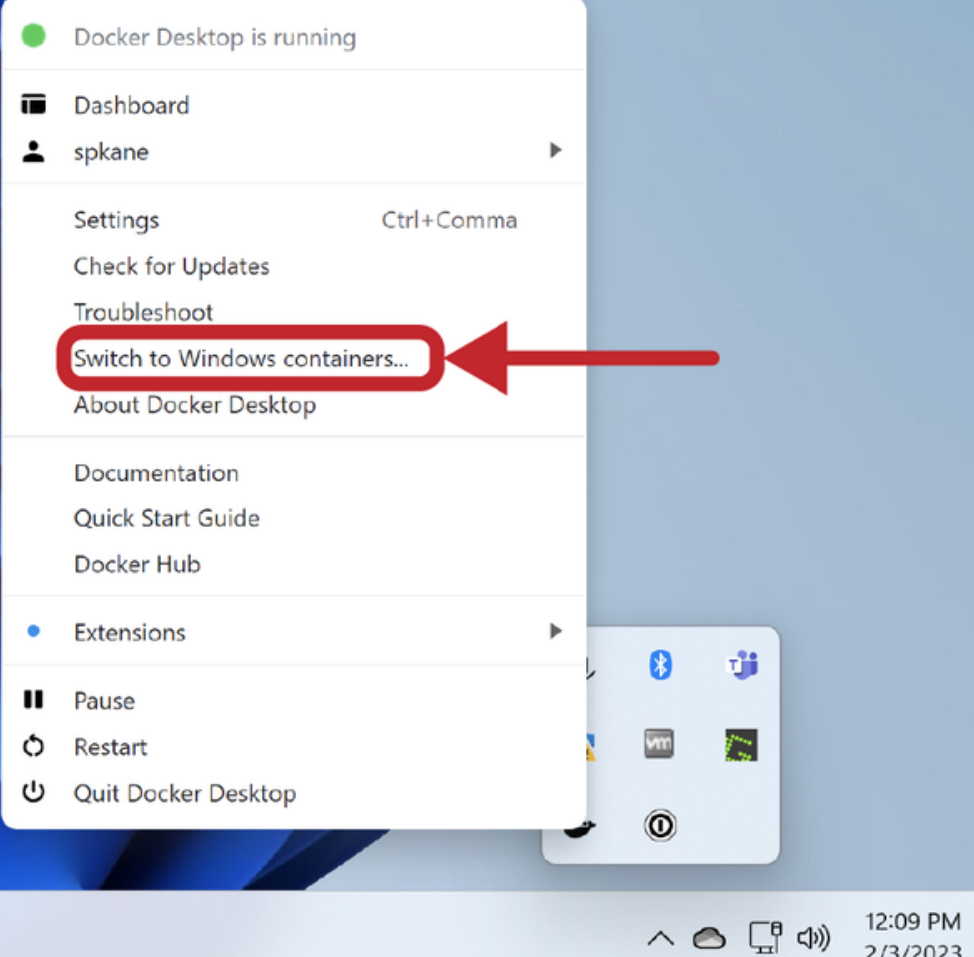
Docker Desktop 在 Windows 系统上支持两种容器运行模式:
- Linux Containers(Linux 容器):运行基于 Linux 内核的容器,例如 Ubuntu、Alpine、Redis、MySQL、Nginx。
- Windows Containers(Windows 容器):运行基于 Windows 内核的容器,例如 Windows Server Core、Nano Server,以及依赖 Windows 环境的 .NET Framework 应用。
二者最本质的区别是:容器依赖的操作系统内核不同,而不仅仅是镜像里的文件不同。
| 对比维度 | Linux 容器 | Windows 容器 |
|---|---|---|
| 内核 | Linux Kernel | Windows NT Kernel |
| Windows 上的运行方式 | 主要通过 WSL 2 虚拟化环境 | Windows 容器功能,通常采用进程隔离 |
| 常见基础镜像 | Ubuntu、Debian、Alpine | Nano Server、Server Core |
| 镜像大小 | 通常较小 | 通常较大 |
| 资源消耗 | 一般较低 | 一般较高 |
| 启动速度 | 通常较快 | 相对较慢 |
| 常见开发语言 | Python、Go、Java、Node.js、C++ | C#、.NET Framework、PowerShell |
| 常见应用 | FastAPI、Redis、PostgreSQL、Nginx | 传统 ASP.NET、IIS、Windows 服务 |
| 主要部署环境 | Linux 云服务器、Kubernetes | Windows Server |
| 推荐场景 | 绝大多数现代后端开发 | 依赖 Windows 的特定业务系统 |
| |
ch10: Containers at Scale
minikube
Minikube 是一个适用于单实例的完整 Kubernetes 发行版。它管理您计算机上的一个容器或虚拟机,提供一个可运行的 Kubernetes 环境,并允许您使用与生产系统完全相同的所有工具。从功能上看,它有点像 Docker Compose:可以让您在本地搭建完整的技术栈。不过,它比 Compose 更进一步,因为它拥有生产环境的全部 API。因此,如果您在生产环境中运行 Kubernetes,您就可以在桌面上拥有一个功能与生产环境非常接近(即使规模可能有所不同)的环境。
安装:
| |
启动:
| |
可以用minikube status来检查kube状态.
尽管minikube自带了kubectl,但还是推荐单独安装:
| |
使用minikube dashboard访问控制面板:
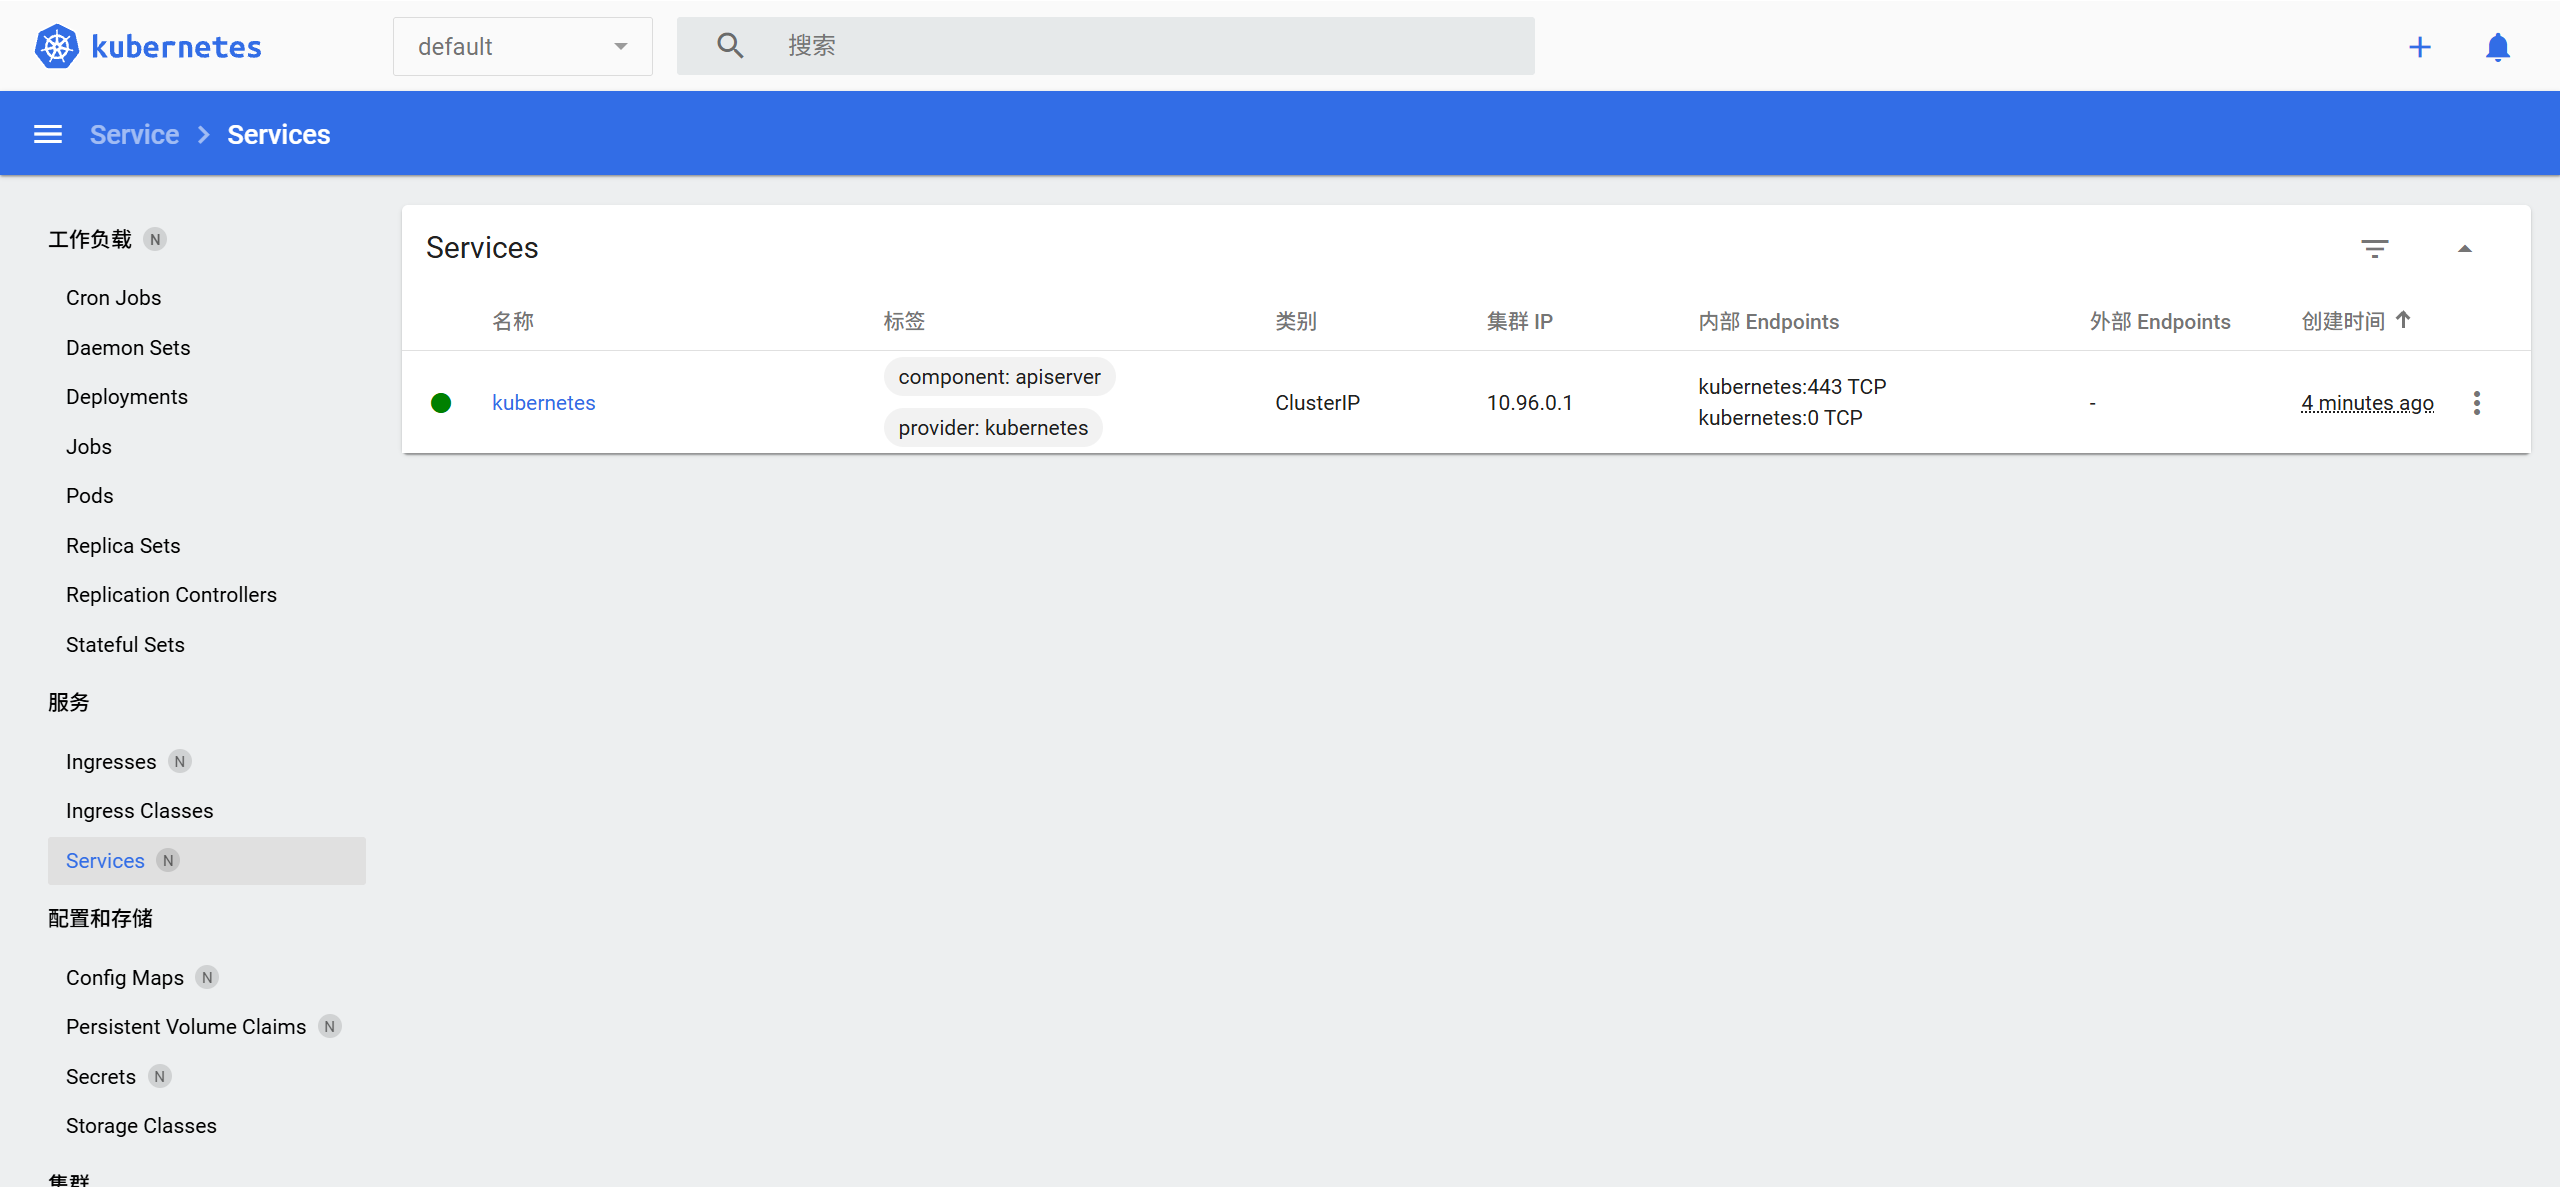
Pod
The term pod came about because the Docker mascot is Moby, the whale, and a group of whales is called a pod.
在 Kubernetes 术语中,Pod 指的是一个或多个共享相同 cgroups 和命名空间的容器。您还可以使用 cgroups 和命名空间将同一个 Pod 内的各个容器彼此隔离。Pod 的目的是封装所有需要一起部署以创建一个功能单元的进程或应用程序,然后由调度器进行管理。Pod 中的所有容器都可以通过 localhost 相互通信,从而无需相互发现。那么,为什么不直接部署一个包含所有应用程序的大型容器呢?Pod 相对于大型容器的优势在于,您仍然可以单独限制每个应用程序的资源,并利用庞大的公共 Linux 容器库来构建您的应用程序。
Deployment
| |
运行kubectl get all:
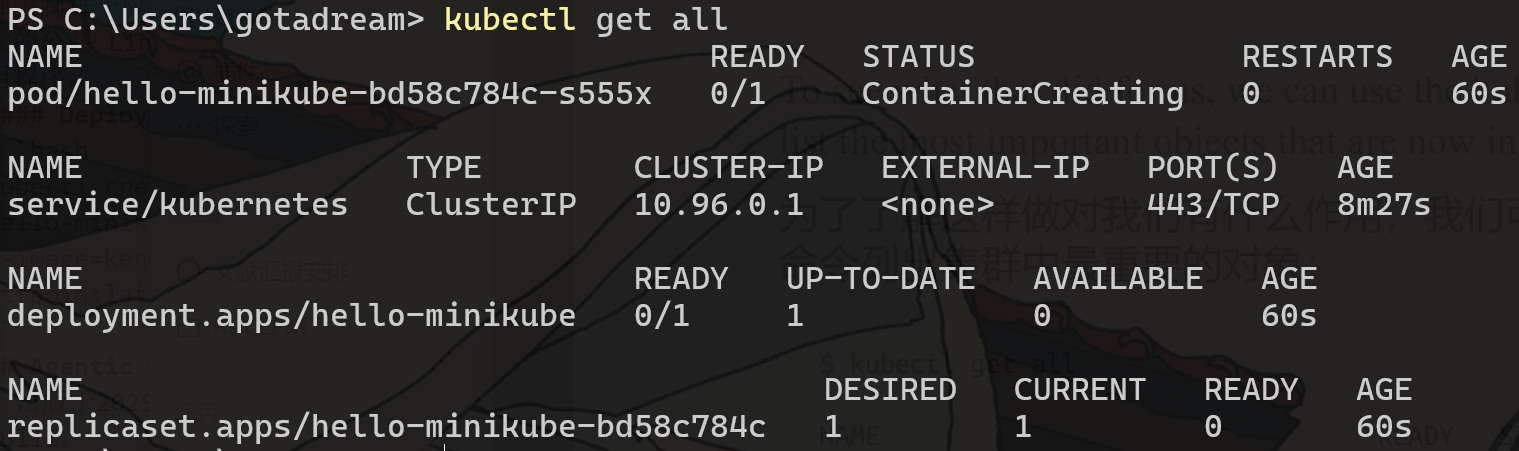
为了让我们的deployment能够作为service被外界发现,我们需要暴露它的端口:
| |
查看services:
| |
查看services的url:
| |
可以发现二者的url是完全不同的,这是因为集群内部的网络我们不能直接访问,要通过kubernetes的映射处理,每次映射到随机端口.
不过更快的方法则是直接运行minikube service hello-minikube,这会自动打开映射的URL.
运行完后删除service和deployment:
| |
yml部署
Kubernetes 与 Docker Compose 非常相似,它允许我们使用一个或多个YAML 文件来定义堆栈,这些文件将所有我们需要关注的定义集中在一个地方:
| |
apiVersion字段是强制的,而不是像compose的version字段一样可以随便填版本号:
| API 版本 | 常见资源 |
|---|---|
v1 | Pod、Service、ConfigMap、Secret |
apps/v1 | Deployment、StatefulSet、DaemonSet |
batch/v1 | Job、CronJob |
networking.k8s.io/v1 | Ingress、NetworkPolicy |
metadata用于定义某个资源的名称,标签.
先部署一下看看:
| |
| |
ReplicaSet 是 Kubernetes 的一个组件,负责确保我们的应用程序始终运行正确数量的实例,并且这些实例都处于健康状态。通常情况下,我们无需担心 ReplicaSet 内部的运行情况,因为我们创建的部署会自动管理它。如有需要,您可以自行管理 ReplicaSet,但大多数情况下您既不需要也不想这样做。
而persistent volume claim需要单独查询:
| |
如果要扩展Deployment的话,需要使用scale命令:
| |
效果如下:
| |
事实上,这几个写法的作用完全一样:
| |
从上面可以看到,一个Deployment可以启动多个Pod,deshboard界面如下:
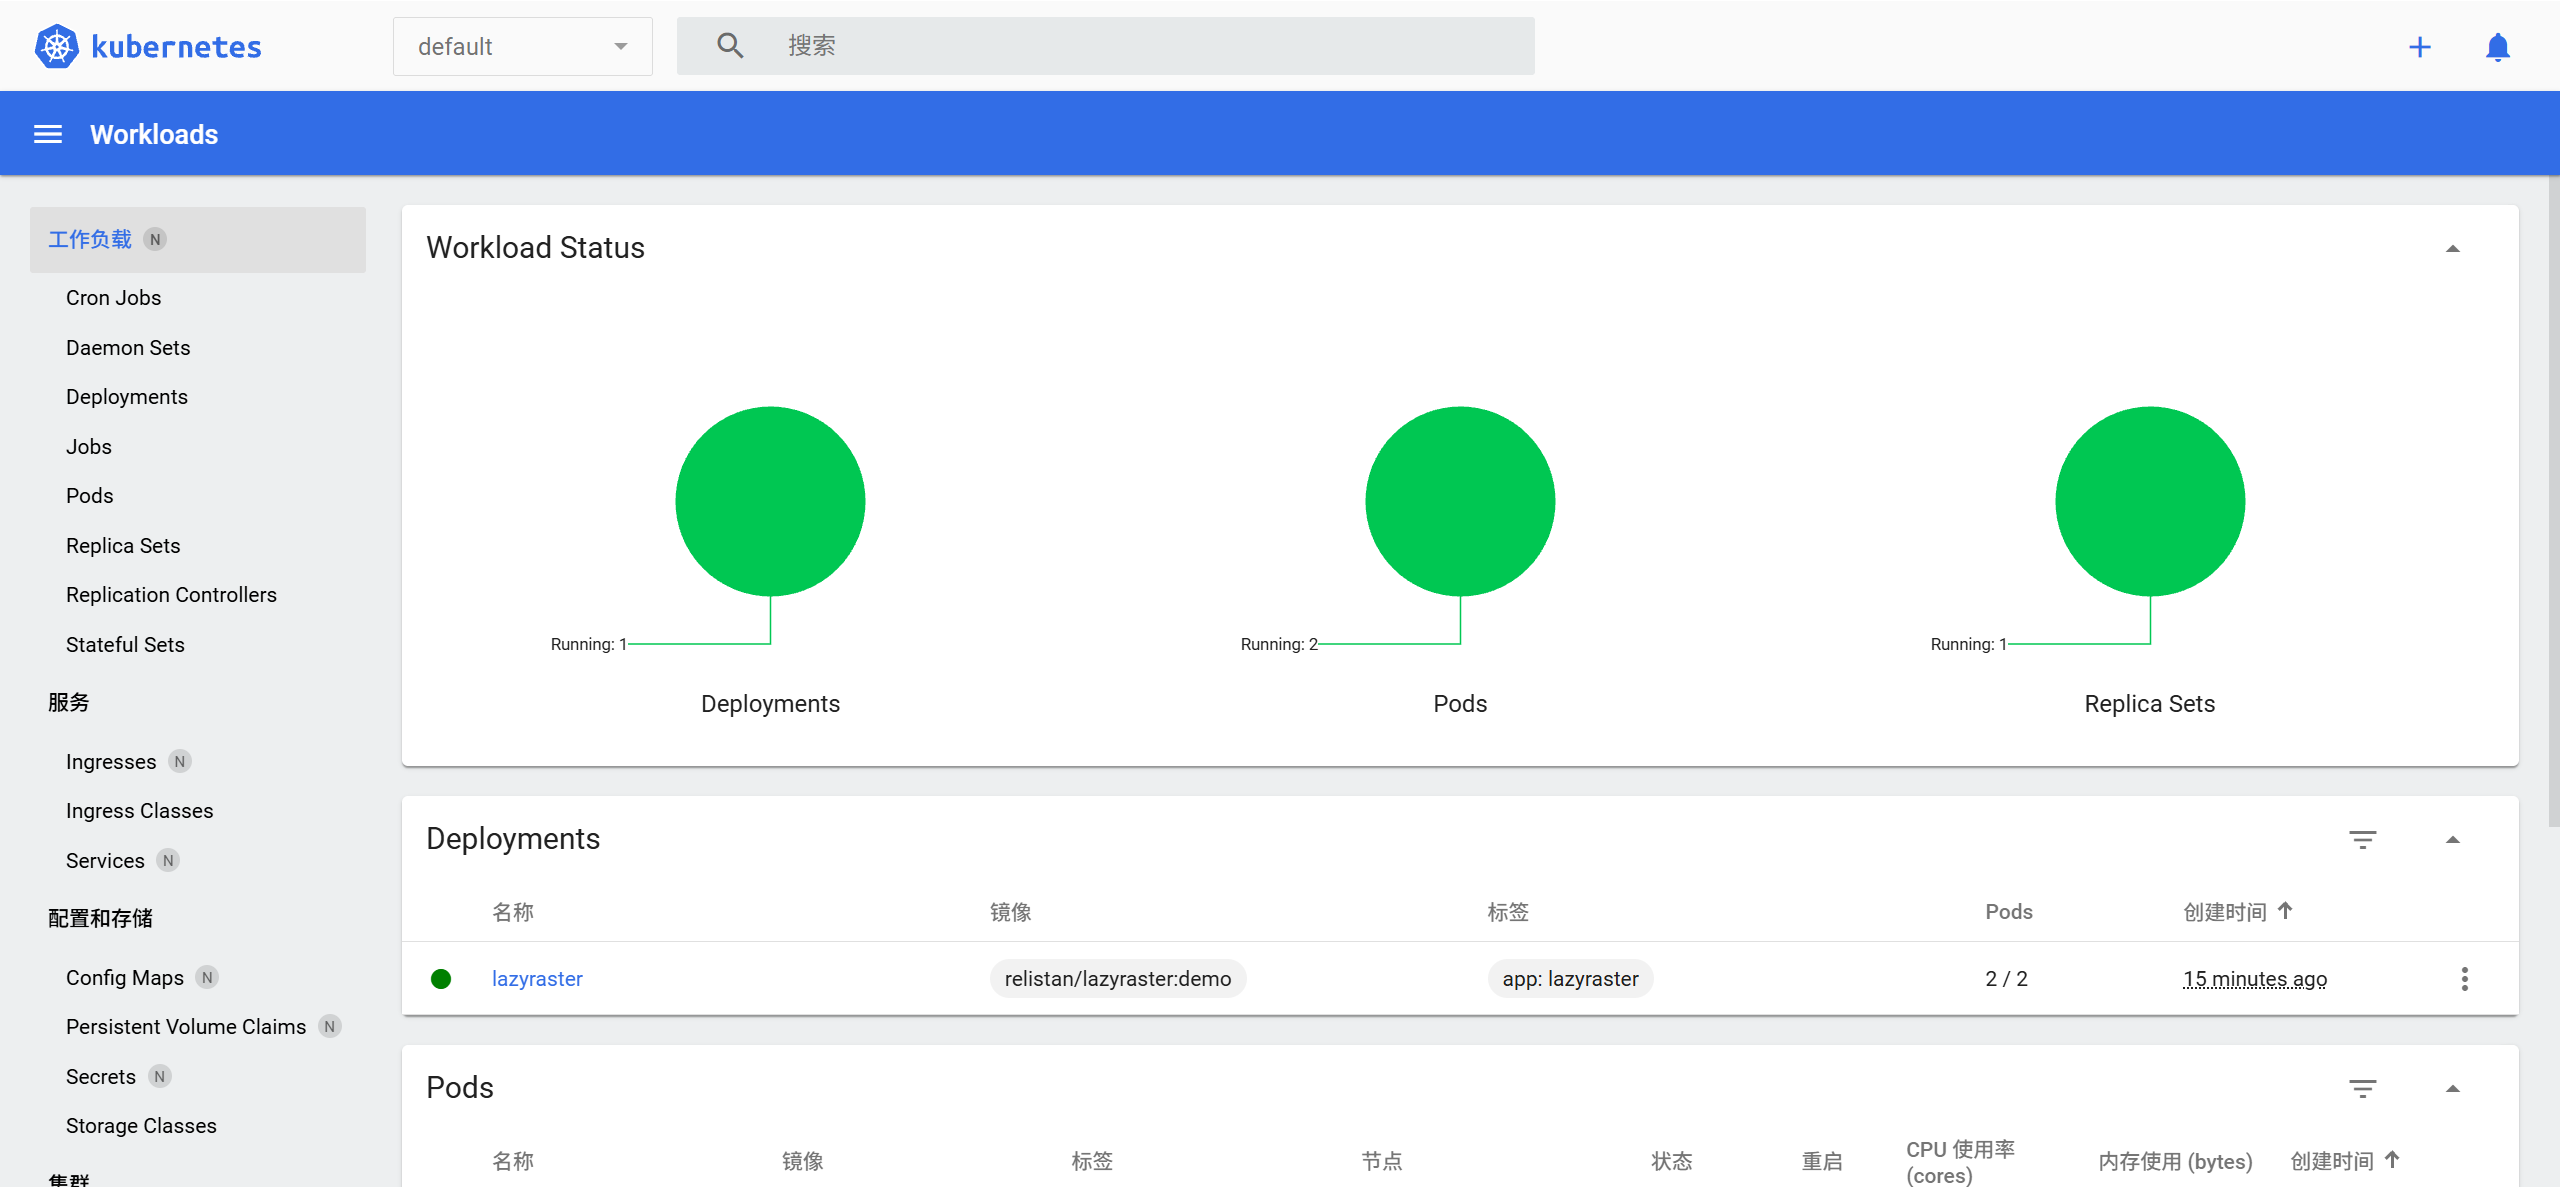
很明显,一个个删除还是太累了,好在kubectl支持根据部署的yaml来一键删除.
用完后删除minikube即可:
| |
ch11: 高级知识
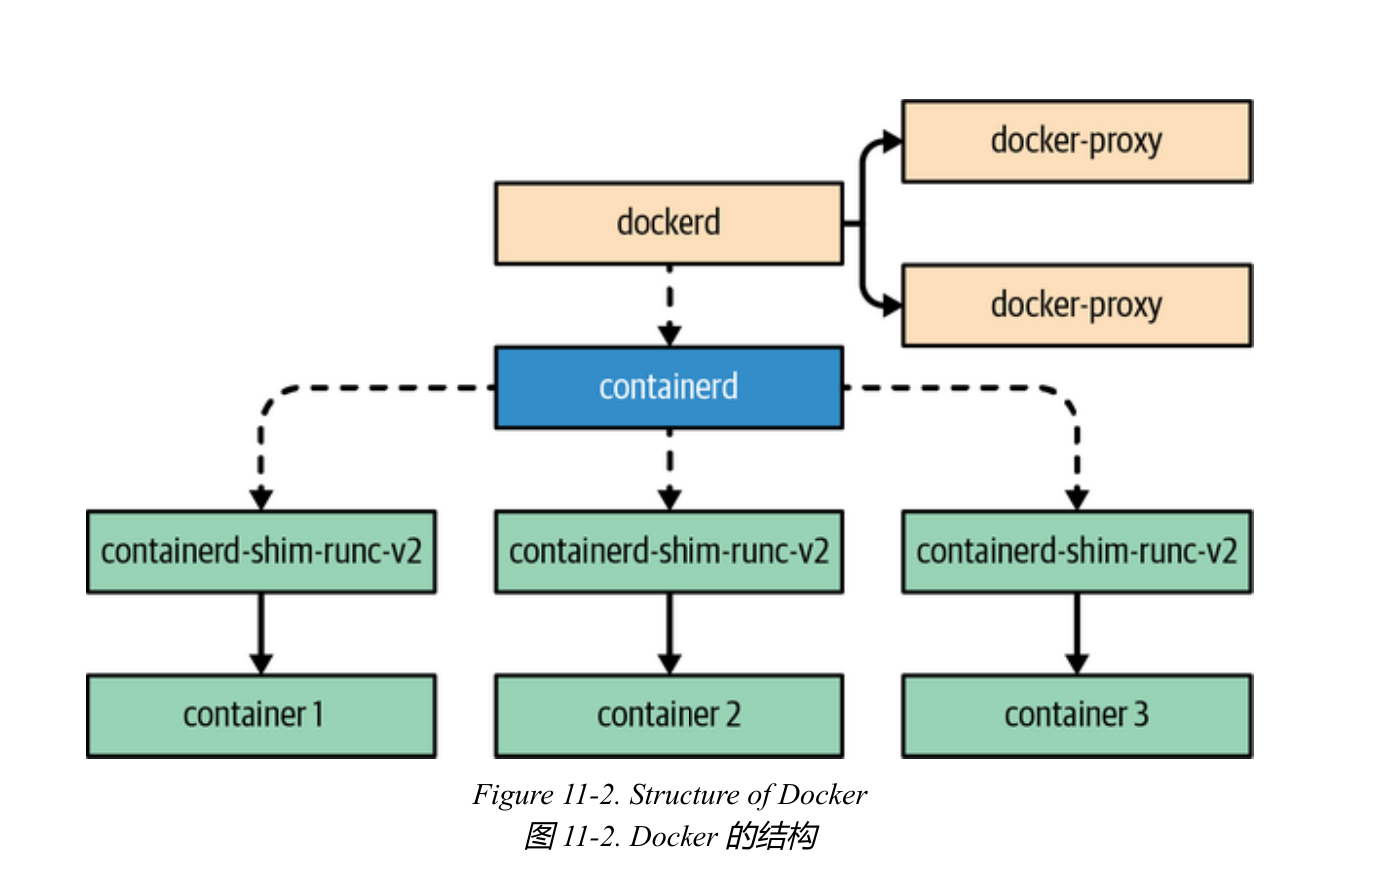
dockerd即为docker daemon,containerd则是Container Daemon,daemon一词表示后台进程.
docker运行的完整流程如下:
这一章对命名空间和网络的探析不够清晰,所以我还得去接着找资料.
总结
其实讲的还不错,但刚入门不适合读,只适合用过一段时间后有疑问的时候来读.
Architecting ASP.NET Core Applications&&# Mastering ASP.NET Core 10
- 两本书翻了好几章全都讲的很烂,确实不应该随便找别人没推荐过的书来看…
ASP.NET Core in Action(第三版)
- 出版于2023年(第3版),出版商:Manning,作者:Andrew Lock。
- 之前看了老版本的,直接被劝退了,现在这个版本是2023年出版的.
入门
ASP.NET Core是一个C#框架,用于构建Web应用程序,可实现的应用程序如下:
- 后端API
- MVC控制器
- Blazor WebAssembly用来做前端
总的来说,就是一个后端的网页框架而已.
ASP.NET Core的默认Web服务器是Kestrel,其地位基本等于python中的uvicorn,在接受请求时会传给应用程序一个HttpContext对象,它是一个用来存储单个请求的容器,这等价于fastapi中的app=Fastapi().
补充: 使用VSCode创建项目
书中使用Visual Studio 中的 ASP.NET Core Empty 项目模板来初始化项目,这等价于在VSCode终端输入dotnet new web.
运行dotnet run即可在给定端口看到欢迎界面:
项目介绍
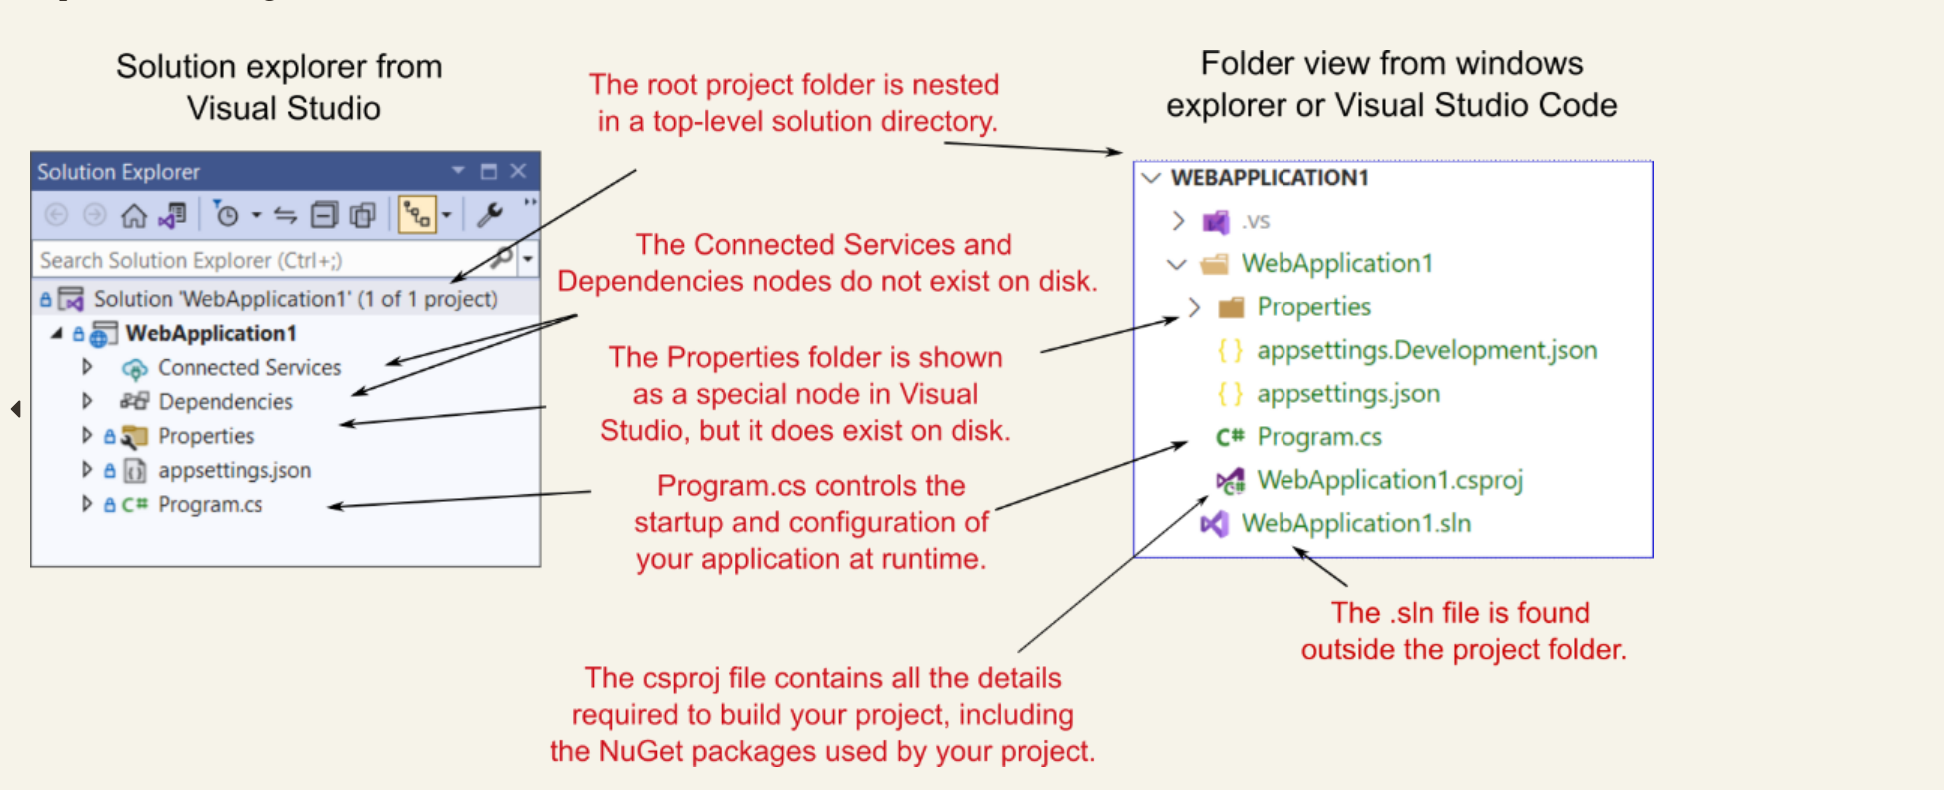
- 文件夹Properties中存放了launchSettings.json文件,只用于本地开发和调试,在部署时不生效.
- 核心的配置文件是
appsettings.json和appsettings.Development.json,用来在运行时调控应用. .csproj后缀的文件是.NET应用程序的项目文件,定义了.NET的版本和项目用到的依赖,为xml风格,内容如下:
| |
要导入新的包可以使用dotnet add package <包名>命令,这会同步更新.csproj文件,反过来也可以,导入其他项目的.csproj文件就可以实现一键导入.
Program.cs: .NET项目的默认入口文件,可以不叫这个名字,但容易引起混淆,而且根目录下一般只有这一个cs文件
从.NET 6开始,Program.cs文件不需要再显式写static void Main以标明主函数,如:
| |
而现在可以直接这么写:
| |
看起来确实清晰多了,建议Java也学习一下.
然后我们的初始Program.cs文件是这样的:
| |
这已经可以比得上fastapi的简洁语法了,开发效率这不就一下子上来了.
builder会按顺序加载 appsettings.json、appsettings.Development.json、系统环境变量,并注入builder中,然后再通过app来锁定这个配置并创建Web服务器.
MapGet函数用来定义如何处理一个使用GET方法的请求。还有其他Map*函数用于其他HTTP方法,例如MapPost。
- 说真的,那就没必要加上Map这个前缀啊,估计是有命名冲突吧.
进阶项目
| |
上述代码中往builder内额外注册了两个配置,用于在生产环境下向控制台输出日志.
中间件
中间件以Use开头的方法来调用.
这些中间件与通常意义上能够均衡负载,处理路由的middleware不同,只是用来调试和作为模板页面而已,很难想象有必要把这种东西加入到核心库中而不是作为扩展包.
状态码
| |
- ConcurrentDictionary是一个线程安全的字典,支持
TryAdd,TryGetValue等方法 - Results和TypedResults用起来没有区别,但在生成OpenAPI文档时TypedResults可以提供更好的具体类型说明,所以推荐无脑使用TypedResults
两种路由
在 ASP.NET Core 中,路由写法主要分为 Minimal APIs(极简 API / 终结点路由) 和 Controllers(控制器路由 / 传统 MVC)。
Minimal API 路由写法
| 写法 | 示例 | 匹配 URL | 含义 |
|---|---|---|---|
| 根路径 | app.MapGet("/", () => "Hello"); | / | 访问网站根地址 |
| 固定路径 | app.MapGet("/fruit", () => ...); | /fruit | 路径必须完全匹配 /fruit |
| 路径参数 | app.MapGet("/fruit/{id}", (string id) => ...); | /fruit/apple | {id} 会绑定为 "apple" |
| 多个路径参数 | app.MapGet("/users/{userId}/orders/{orderId}", ...) | /users/1/orders/99 | 同时接收多个参数 |
| 指定参数类型 | app.MapGet("/fruit/{id:int}", (int id) => ...); | /fruit/123 | 只匹配整数 id |
| 可选参数 | app.MapGet("/fruit/{id?}", (string? id) => ...); | /fruit 或 /fruit/apple | id 可以没有 |
| 默认值参数 | app.MapGet("/page/{num=1}", (int num) => ...); | /page | 没传时 num = 1 |
| catch-all 路由 | app.MapGet("/files/{*path}", (string path) => ...); | /files/a/b/c.txt | 捕获 /files/ 后面的剩余路径 |
| 双星 catch-all | app.MapGet("/files/{**path}", (string path) => ...); | /files/a/b/c.txt | 和 * 类似,但生成 URL 时保留 / |
| 正则约束 | app.MapGet("/posts/{slug:regex(^[a-z0-9_-]+$)}", ...) | /posts/hello-1 | 只匹配符合正则的 slug |
| 路由分组 | app.MapGroup("/api").MapGet("/fruit", ...) | /api/fruit | 给一组接口统一加前缀 |
Controller 路由写法
| 类型 | 写法 | 示例 URL | 说明 |
|---|---|---|---|
| Controller 统一前缀 | [Route("api/[controller]")] | /api/fruit | [controller] 会替换成控制器名 |
| GET Action | [HttpGet] | /api/fruit | 匹配 GET /api/fruit |
| GET 带参数 | [HttpGet("{id}")] | /api/fruit/apple | 匹配 GET /api/fruit/{id} |
| POST | [HttpPost] | /api/fruit | 新增资源 |
| PUT | [HttpPut("{id}")] | /api/fruit/apple | 更新资源 |
| DELETE | [HttpDelete("{id}")] | /api/fruit/apple | 删除资源 |
| 指定完整路由 | [HttpGet("/health")] | /health | 以 / 开头时通常表示绝对路径 |
由于Controller路由比较古老,写法也比较复杂,所以现在都推荐使用Minimal API写法了.
使用EF Core
| |
这些类遵循EF Core用来构建其所映射数据库视图的某些默认约定。例如,Recipe类具有RecipeId属性,而Ingredient类包含IngredientId属性。EF Core将这种Id后缀模式识别为表的主键指示符。
- 表的主键是一个能够在该表的所有行中唯一标识某行的值。它通常为int或Guid。
| |
创建数据库连接要继承DbContext类,并使用DbSet方法逐个创建表格.之后要访问这些表格也只要新建一个AppDbContext示例就可以了.
| |
而这个构造函数是用来继承父类的构造函数的,接受数据库配置的依赖注入.
| |
例如,上面这个普通的DbContext类,可以改写成功能区分的两个文件:
| |
| |
总结
剩下的内容基本都是垃圾了,谁会用C#写前端啊…
总的来说这本书讲的不是很清晰,但也只有这本书能看了
A Tour of C++,Third Edition
- 出版于2022年(第3版),作者:Bjarne Stroustrup。
事实证明,任何由Bjarne Stroustrup亲自动笔的C++书都不具备任何的可读性.
白帽子讲Web安全
- 作者介绍
- 非常有传奇色彩的hacker,可惜了解他的人不多
浏览器安全
- 同源策略: 禁止不同源的网站访问该网站的内容,否则恶意网站就可以监控你的交易信息.
- Sandbox: 浏览器引擎由Sandbox隔离起来,从而防止网页中的恶意代码注入和执行
- 恶意网址拦截: 浏览器内置了一份关于恶意网站的黑名单,当用户遇到这些网站时提出警告
跨站脚本攻击(XSS)
跨站脚本攻击,英文全称是 Cross Site Script,本来缩写是 CSS,但是为了和层叠样式表(Cascading Style Sheet,CSS)有所区别,所以在安全领域叫做“XSS”
文章中讲的XSS攻击方案在如今的现代前端框架下已经不太可能出现了,所以我们现在没有听过像零几年Samy Worm那样的大规模攻击事件了.
跨站点请求伪造(CSRF)
CSRF的全名为Cross Site Request Forgery,通过恶意网站向正常网站发送带有Cookie或者Token的请求,从而引发破坏性的影响,现在这种攻击基本绝迹了.
点击劫持(ClickJacking)
这种方法将恶意的透明图片或者按钮覆盖在原网页上方,当用户浏览网页时,会不经意地被导向另外一个伪装的恶意网站,这种攻击现在也绝迹了.
注入攻击
通过ORM和数据库的内置防御,SQL等注入攻击现在也绝迹了
应用层拒绝服务攻击
分布式拒绝服务(Distributed Denial of Service,DDOS)通过大量的合理请求造成资源过载,服务器不得不停止运行,拒绝新的请求.
总结
尽管文章谈到的Web安全原理很多,但可惜的是在当今这个时代下都不太适用了,唯独DDOS还有着些微的活跃度.
纵览全文,可以发现的是,大多数Web安全方案都是被各种网络攻击逼出来的,如果没有这些网络攻击,或许人们永远不会意识到存在这些漏洞.
或许,网络安全这个行业将会逐渐式微下去吧,毕竟在现代的前后端框架下,传统的网络攻击方案都不太管作用了,cracker想要发起攻击只有两条道路,从内部突破,例如诱导下载恶意软件或者U盘攻击,或者付出高昂的代价从外部侵入,例如DDOS或者攻击防火墙.也就是说,SRE这类岗位做的才是传统的网络安全的活儿,而我如今看到的网络安全行业,更多的是去挖漏洞和找病毒,也就是和网络本身关系并不大了,叫做软件安全反而更为恰当
Beginning C,From Beginner to Pro
- 出版于2020年,作者:Ivor Horton。
确实很适合入门,可惜的是当初没看到这本书
指针与内存分配
当你使用malloc()函数时,你需要在程序中包含stdlib.h头文件。,你将希望分配的内存字节数作为参数指定。该函数返回它根据你的请求分配的内存中第一个字节的地址。因为你得到一个返回的地址,所以指针是唯一能存放它的地方。
| |
由于malloc返回的是void*,会自动转换,所以右边那个强制转换可以不用写,而在cpp中,我们推荐直接用new,从而避开万恶的空指针问题:
| |
更多的还有calloc,realloc等方法,但我真切的希望这些函数我之后再也碰不到比较好.
属性语法
很惊讶的是这本书引入了不少C23的内容,其中属性语法是我觉得很不错的一个功能,该语法于C++11引入,而C语言直到C23才开始使用.
一个最简单的属性写法如下:
| |
属性使用两个[]来标识,里面的属性名用于告诉编译器这是什么类型的函数,我们还可以额外提供调试输出语句,用()包裹:
| |
可以发现,这和Java5中的注解极其相似,而实现难度其实并不大,但仍旧过了这么久才正式推出,足以说明C的陈旧.
基本输入与输出
Each serial input source and output destination in C is called a stream.
流独立于所涉及的物理设备,如显示器或键盘。程序使用的每个设备都可以关联一个或多个流,这取决于它是单向设备(如键盘)还是能代表多个数据源或目标的设备(如磁盘驱动器)。
结构体
| |
Union
| |
Union与结构体的不同之处在于,所有成员都共享最长变量的内存空间,赋值时会覆盖之前的变量值,同一时刻只有最后一次被赋值的成员是有效的,总的来说我们不会这么缺内存,所以Struct几乎永远是Union的上位替代.
处理文件
简单涉及了几个文件操作函数的使用方法
The Preprocessor and Debugging
直到这里才开始讲头文件和static关键字,完美诠释了真正的循序渐进是怎样的.
避免头文件被包含多次:
| |
预处理中的选择语句:
| |
C# 12 in a Nutshell
- 出版于2023年,出版商:O’Reilly,作者:Joseph Albahari。
- 2024年出版,还是非常新鲜的
高级C#
Lambda Expressions
Lambda表达式具有以下形式:
| |
Anonymous Types
匿名类型是由编译器动态创建的一种简单类,用于存储一组值。要创建匿名类型,请使用new关键字,后跟对象初始化器,指定该类型将要包含的属性和值:
| |
编译器将此(大致)转换为以下内容:
| |
record
By default, the underlying type of a record is a class:
| |
- record class 也是合法的,且与 record 具有相同含义。
总结
又臭又长,主要原因却不在这本书上面,而是C#的语法实在太多了,多的离谱,从每个主流语言中都扒拉了不少特性过来,导致整个语法体系臃肿的可怕.
如此看来,我是不看好C#的,只不过是有着微软的大力支持,它才勉强发展到现在的,而不会成为主流的开发语言,毕竟用C#开发确实很麻烦.
操作系统导论
- 出版于2018年(英文原版),作者:Remzi H. Arpaci-Dusseau。
概览
本书围绕操作系统的三个特征展开:
- 虚拟化(virtualization): 这与程序装载相关
- 并发(concurrency): 这与程序调度相关
- 持久性(persistence): 这与硬盘/文件系统相关
系统调用
谁能想到这本书竟然帮我解决了关于系统调用的许多疑问
- fork(): 复制当前进程创建一个子进程,子进程拥有独立的地址空间,寄存器和程序计数器
- fork()系统调用实质上是在执行到当前代码时再新建一个进程,两个进程同时运行,因此,下面这段条件语句能够返回两个值,一个是父进程返回的子进程pid,一个是子进程返回的0
| |
- wait(): 让父进程等待子进程执行完毕再继续执行,这显然是I/O,网络请求等让我们深恶痛绝的阻塞的源头.
- exec(): 因为
fork()只是创建了一个近乎完全相同的进程,所以我们需要exec()来真正的创建一个不同的进程.该调用会从指定的可执行程序中加载代码和静态数据,并覆盖当前子进程的内存区域.
要执行系统调用,程序必须执行特殊的陷阱(trap)指令。该指令同时跳入内核并将特 权级别提升到内核模式。一旦进入内核,系统就可以执行任何需要的特权操作(如果允许), 从而为调用进程执行所需的工作。完成后,操作系统调用一个特殊的从陷阱返回 (return-from-trap)指令,如你期望的那样,该指令返回到发起调用的用户程序中,同时将 特权级别降低,回到用户模式。
进程调度
进程切换问题
如果一个进程在 CPU 上运行,这就意味着操作系统没有运行。如果操作系统没有运行,它怎么能做事情?
- 这一问题直接打入了操作系统的核心,非常的透彻.
早期的操作系统由进程来决定何时将CPU的控制权交给内核,内核只能在进程执行时被动地等待.
后来,我们引入了时钟中断(timer interrupt),当中断发生时,当前运行的进程被停止,CPU的控制权会重新交给内核
进程调度方法
简单粗暴的几个调度方法有:
- FIFO: First In First Out,先进先出
- SJF: Shortest Job First,最短任务优先
- STCF: Shortest Time-to-Completion First,最短完成时间优先
- 从这一算法开始就引入了抢占的思想,后来的进程有可能会被内核优先调度
后来,我们将时钟中断和调度联系起来,引入了轮转(Round-Robin,RR)算法,每个进程被划分成多个时间片(time slices),时间片长度是时钟中断周期的整数倍,出于公平起见,所有进程在用完一个时间片后就要将CPU让给下一个进程执行.尽管如此,这会大大拖延进程的实际执行完成时间,所以还是不够理想.
多级反馈队列
1962年,多级反馈队列(Multi-level Feedback,MLFQ)算法由Corbato提出,大致思想如下:
- 建立多个不同优先级(priority level)的独立队列,一个进程只能存在于一个队列中
- 优先级高的队列中的进程优先执行,而同一个队列中的进程采用轮转算法调度
- 通过观察进程的行为动态调整它的优先级,例如用户交互类进程被划为高优先级,计算密集型进程被划为低优先级
实现MLFQ
我们可以先对该算法进行一个简单的实现:
- 进程刚开始运行时,放在最高优先级
- 进程用完一个时间片后,降低其优先级
- 进程在时间片中主动释放CPU,则优先级不变
显然,这种方法会导致计算密集型进程永远处于饥饿(starvation)状态,也会让恶意程序(如挖矿病毒)伪装成I/O类程序,从而一直保持高优先级.
为了解决恶意程序,我们需要将规则2和规则3修改成一条: 2. 记录一个进程在某一个队列中消耗的总时间,只要它用完了该层中的时间配额,就降低其优先级.
为了让计算密集型进程也能运行一段时间,我们可以这么做: 3. 经过一段时间S,就将所有进程重新加入最高优先级队列
总结一下MLFQ的思想就是:
- 进程刚开始运行时,放在最高优先级
- 记录一个进程在某一个队列中消耗的总时间,只要它用完了该层中的时间配额,就降低其优先级.
- 经过一段时间S,就将所有进程重新加入最高优先级队列
Windows和MacOS现在仍然在使用MLFQ的变体
比例份额调度
比例份额(proportional-share)调度类算法的代表性算法就是彩票调度(lottery scheduling),基本思想如下:
- 每个进程分得一定比例的彩票数,对应了一些彩票编号,接下来反复抽取彩票,每次抽中的彩票编号对应的进程开始运行.
- 父进程可以给子进程分出自己的彩票,再由内核换算出实际的彩票比例
- 不同的进程之间可以转让彩票,同一个进程的彩票数量可以动态变化,这被称为彩票通胀(ticket inflation)
可以看出来,彩票调度算法具有相当大的随机性,但当执行次数达到一定量级时,每个进程运行的比例也慢慢趋于一个稳定值,所以该类算法适合有大量进程同时执行的情景
尽管设计很巧妙,但该类算法并没有用在主流的操作系统中.
多处理器调度
多处理器有以下问题:
- 缓存一致性: 多个处理器缓存同时访问内存会带来数据上的不一致
- 数据加锁: 某一处理器在临界区执行时需要给这部分内存加锁,其他处理器此时不能访问该临界区,这会导致性能下降
- 缓存亲和度: 需要保证一个进程尽可能地在一个CPU上运行,减少切换CPU带来的缓存迁移损耗
文中介绍了两种多处理器调度方法:
- 单队列多处理器调度(Single Queue Multiprocessor Scheduling,SQMS): 将所有需要调度的进程放入一个单独队列中,每个进程依次被多个处理器调用
- 当然,我们可以对SQMS做一点改进,比如说尽可能让一个进程在同一个处理器上执行
- 多队列多处理器调度(Multi-Queue Multiprocessor Scheduling,MQMS): 一个处理器控制一个进程队列,尽管这可以解决缓存亲和度的问题,但可能导致一些处理器满负荷运行,而另一些处理器一直空置,这被称为负载不均.
- 为了解决这个问题,我们可以不断在处理器队列之中平衡进程的负载
虚拟内存
- 由于虚拟地址到物理地址的映射是通过硬件实现的,我们在电脑软件中看到的所有地址都是虚拟地址.
简单实现
早期的映射方式是这样实现的:
每个CPU都有一对基址和界限寄存器(base and bounds register),由一个**内存管理单元(Memory Management Unit,MMU)**来管理这两个寄存器,base寄存器用来确定进程虚拟地址映射到的实际物理地址的偏移,bound寄存器用来限制该进程能够访问的最大地址.
尽管如此,实际还是要由操作系统来调用这些硬件,所以操作系统是可以直接访问物理内存的,它需要标记当前的空闲物理内存区间,在进程切换时保存和恢复寄存器,在进程终止和创建时分配和回收物理内存
分段
上述的映射方式不太灵活,需要将整个进程的地址空间全部装载到内存中,就会有相当大部分的地址被浪费:
如果我们将进程的地址空间分成多个段(segment),比如说代码内容,堆,栈三个段,每个段都有独立的基址和界限寄存器,分别装载这三个段,就不会占用过多的地址空间了.
为了区分当前进程正在执行的是哪个段,我们使用段寄存器来存储关于段的信息,比如前两位是 00,硬件就知道这是属于代码段的地址.
为了进一步压缩空间,我们可以用硬件将代码段标记为只读,确保多个进程可以共享代码段,却不会更改代码段的内容,只独立的更改自己的栈和堆.
我们还需要建立一个空闲地址列表来追踪所有可用的地址块,每次要用堆分配新的内存时,通过算法匹配到最合适的空闲地址交付给堆,并分割对应大小的地址空间出来.
- 至于用的算法是什么我们就没必要知道了,如书中所说,有几千种备选算法.
尽管如此,这种方法会引入大量的地址碎片,没有足够的连续地址可以装载之后的进程.所以我们需要找到新的解决方法.
分页
- 分页: 将地址空间分割成固定长度的块
我们通过页表来管理单个进程中各个虚拟页到物理页的映射:
x86架构中的页表结构如下:
- PFN指的是对应的物理页,其余的符号均为标志位
分页方法有一个非常大的问题,如果每次访问内存时都要通过页表转换,这会引入巨大的内存访问开销.
为了加速内存访问,我们可以使用地址转换旁路缓冲存储器(translation-lookaside buffer,TLB),更好的称呼是地址转换缓存(address-translation cache),每次内存访问时,硬件先检查TLB,如果有对应映射的话就不用再访问页表,从而大幅度提高转换速度.如果TLB未命中,那么就需要硬件去访问页表,并将查找到的映射存储在TLB中.
鉴于内存很宝贵,所以我们需要进一步压缩TLB的大小,将TLB改装成多级的缓存,每一级相对于上一级,只保留真正有效的映射,无效的地址映射则不保留,这样就可以大幅度减小空间占用,但增加了TLB未命中的处理时间,因为需要同时更新多个缓存级:
存放在内存中的页数终归是有限的,所以我们需要时不时地将一些页交换到硬盘中,当某个记录在TLB中的页映射被用到时,如果该页不在内存而是被交换到了硬盘,就被称为页错误(page default),需要我们花费更长的时间从硬盘中调用该页.
由于磁盘访问的成本很高,我们需要确定一个比较好的算法来替换不需要的页,以尽可能减少页错误的发生.
- 实际来说,我们使用的是LRU或者类似LRU的算法
这本书忽略了cache的存在,而是认为CPU可以直接与硬盘交互,而对于实际的操作系统编写来说,这也是正确的,我们无需关注CPU调用硬盘的中途发生了什么
并发
前置概念
- 临界区(critical section): 访问共享资源的一段代码,资源通常是一个变量或者数据结构.
- 竞争(race condition): 多个线程同时进入临界区,导致一些异常的结果
- 不确定性(indeterminate): 程序中存在一个或多个竞争,导致不确定的输出.
锁
我们可以使用锁(lock)来确保只有一个线程在临界区执行,POSIX库中锁被称为互斥量(mutex),用法如下:
| |
锁的具体实现是在处理器层面上,经过了一段比较长的演进历史.
最早的锁方案就是在临界区关闭中断:
| |
这种方法会让恶意程序一直运行,也无法支持多处理器的情况,效率很低.
一段时间以来,出于某种原因,大家都热衷于研究不依赖硬件支持的锁机制。 后来这些工作都没有太多意义,因为只需要很少的硬件支持,实现锁就会容易很多(实际在多处理器的早期,就有这些硬件支持)。
而且上面提到的方法无法运行在现代硬件(应为松散内存一致性模型),导致它们更加没有用处。
一个稍微复杂一点的方案叫做test-and-set instruction,也称为原子交换(atomic exchange),该指令是原子地执行的,所以不会被中断所影响:
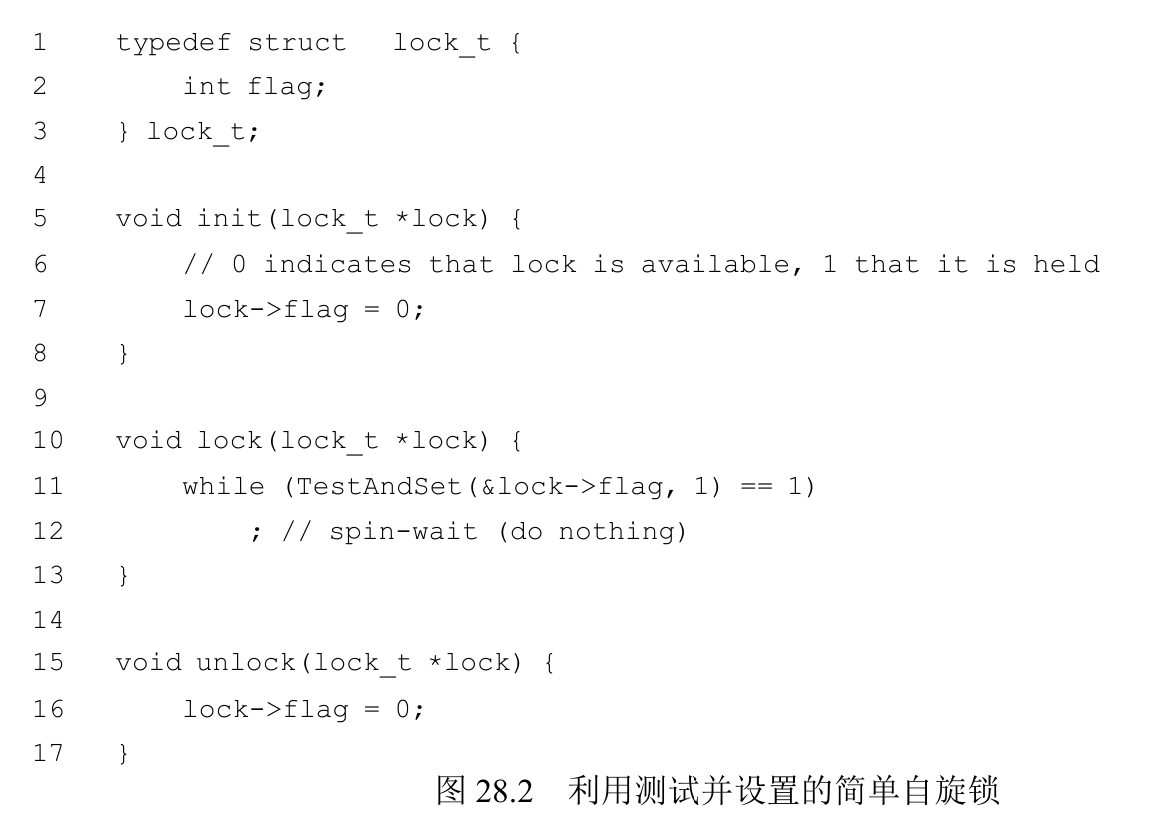
代码中展示的锁被称为自旋锁(spin lock),会一直自旋等到锁最终可用.这种锁不能保证公平性,在单处理器系统上的开销也相当大.
如果多个线程竞争同一个自旋锁,那么当轮到没能持有锁的线程执行时,由于锁仍然被占用,CPU只会空转一个周期,这样就会大幅度降低线程的执行速度,这需要我们从操作系统的层面来解决这个问题.
一个简单的想法是如果该线程没能持有锁,就直接让出CPU,跳过执行阶段,但这很容易引发饥饿问题.
实际上,不同的操作系统对于这个问题有着不同的解决方案,但大致的思想是这样的: 将没能持有锁的线程/进程从执行队列放入准备队列中,直到锁被释放时才唤醒该线程.
条件变量
假设有一个或多个生产者线程和一个或多个消费者线程。生产者把生成的数据项放入缓冲区;消费者从缓冲区取走数据项,以某种方式消费。这就是生产者/消费者问题.
为了解决这一问题,文中提出可以引入条件变量来让生产者与消费者的调用互不冲突.
但我的意见是,你把生产者和消费者放到两个队列中不就可以了吗?很难理解这种脱裤子放屁的事情,所以直接略过吧.
信号量
信号量(semaphore)可以作为锁也可以作为条件变量,是一种比较复杂的并发实现方式.
在POSIX标准中,信号量是一个有整数值的对象,通过sem_wait()和sem_post()函数来操作它.
| |
其中申明了一个信号量 s,通过第三个参数,将它的值初始化为 1。sem_init()的第二个参数,在我们看到的所有例子中都设置为 0,表示信号量是在同一进程的多个线程共享的。
两个函数的定义
| |
死
死锁(deadlock)是一种在许多复杂并发系统中出现的经典问题,死锁的产生需要如下 4 个条件:
- 互斥:线程对于需要的资源进行互斥的访问(例如一个线程抢到锁)。
- 持有并等待:线程持有了资源(例如已将持有的锁),同时又在等待其他资源(例如,需要获得的锁)。
- 非抢占:线程获得的资源(例如锁),不能被抢占。
- 循环等待:线程之间存在一个环路,环路上每个线程都额外持有一个资源,而这个资源又是下一个线程要申请的。
因此,解决死锁问题可以从这四个角度下手,从而预防或者避免死锁.
持久性
I/O设备
有趣的是,因为所有需要插入系统的设备都需要安装对应的驱动程序,所以久而久之,驱动程序的代码在整个内核代码中的占比越来越大。查看 Linux 内核代码会发现,超过 70%的代码都是各种驱动程序。在 Windows 系统中,这样的比例同样很高。因此,如果有人跟你说操作系统包含上百万行代码,实际的意思是包含上百万行驱动程序代码。
磁盘驱动器
- 这一部分讲的是磁盘类的机械硬盘,可以适当的了解一下
RAID
前置概念
廉价冗余磁盘阵列(Redundant Array of Inexpensive Disks,RAID)使用多个磁盘构建一个更大,更快,更可靠的存储系统.
RAID 0
RAID 0没有冗余的磁盘,它以轮转方式将数据块分布在磁盘上,从而保证可以并行读取数据.
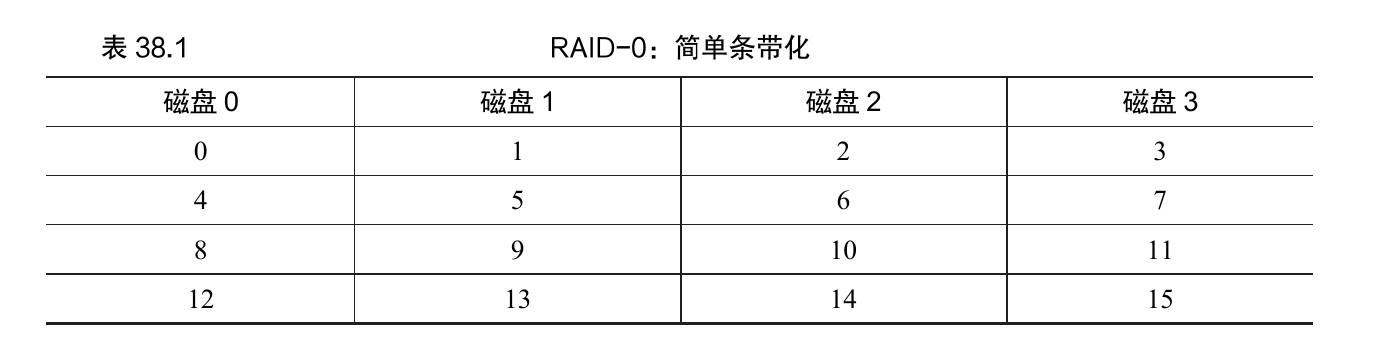
这个方案无法缓解任何磁盘故障问题.
RAID 1
RAID 1仅仅是在RAID的基础上,将每个数据块都存储了多个备份而已,常见的备份数量为1:
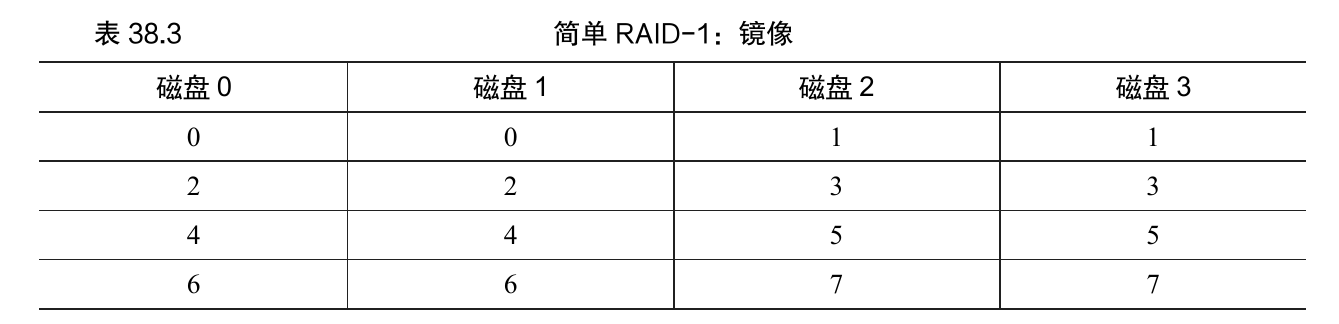
RAID 4
RAID 4用一个专门的磁盘来存储其他磁盘中数据块的奇偶校验块,例如图中的P1具有从4,5,6,7计算出的冗余信息.
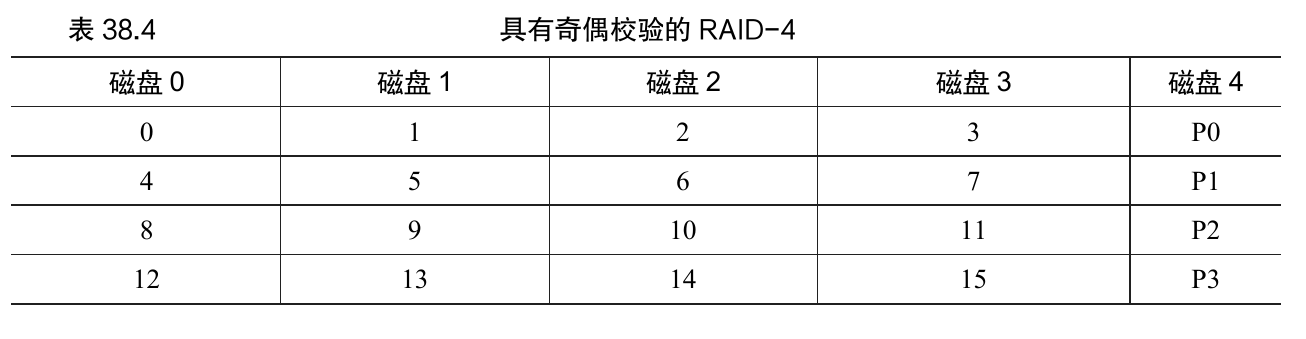
由于只有一个磁盘负责存储冗余数据,当多行的数据同时更新时,冗余磁盘无法并行处理数据,会降低RAID的性能,这被称为小写入问题:
RAID 5
RAID 5在RAID 4的基础上,将奇偶校验块跨驱动器旋转,从而解决小写入问题:
文件系统
文件系统是一个纯软件的实现,不需要硬件提供额外的支持,我们需要做的就是使用汇编语言创建open,close等系统调用的接口,使用特殊的数据结构来存储文件和目录,按照精心设计的硬盘调度方式来存放文件系统
简单的文件系统
我们可以将磁盘简单地分成以下几个部分:
- 数据块(D): 存放真正的文件数据
- inode table(I): 存放文件的元数据
- inode bitmap(i): 管理inode table
- data bitmap(d): 管理数据块
- superblock(S): 记录inode和数据块的个数和其他有用的全局信息.
几乎所有的文件系统都有类似inode的结构,inode是index node的缩写,因为这些节点早期使用数组存储的,通过index访问特定的节点.
例如ext2的inode内容如下:
如果要支持更大的文件,那么我们就可以在inode中存放指向下一级索引存储块的指针,以4KB为分页的话,那就有1024个指针,文件大小可以增长到1024x4KB,也就是4MB的大小,要想继续增加的话就多来几次指针跳转就行了.
设计 inode 有另一个更简单的方法,即使用链表(linked list)。这样,在一个 inode 中,不是有多个指针,只需要一个,指向文件的第一个块。要处理较大的文件,就在该数据块的末尾添加另一个指针等,这样就可以支持大文件。
这样的表听起来很熟悉吗?我们描述的是所谓的文件分配表(File Allocation Table,FAT)—文件系统的基本结构。是的,在 NTFS [C94]之前,这款经典的旧 Windows 文件系统基于简单的基于链接的分配方案
文件系统将目录视为特殊类型的文件,目录中可以存放一个inode列表,标识在目录中存放的文件.
如此一来,我们就可以随意拖拽文件了,因为目录实际上存放的只是具体数据块的链接而已,这也是为什么在同一个磁盘分区中移动文件非常快的原因.
文件系统通过缓存来存储临时的块数据,从而避免大量的重复存取操作引发的灾难性影响,然而,数据库这种应用程序不适合使用缓存,需要所有的更改能够立刻执行,早期的数据库会绕过文件系统使用原始的磁盘接口,而现在,而现在由于文件系统的升级,可以直接选择无缓存的系统调用了,所以就不需要额外搞动作了.
更快的文件系统
老式的UNIX文件系统比上述的简单文件系统还要简单,只有三个模块:
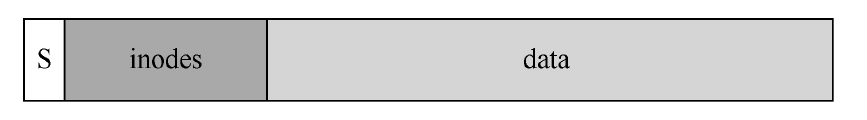
由于数据块由inode进行分配,而inode并不了解具体的磁盘情况,可能会让属于同一个文件的数据块散落到各个角落,从而引入非常高的I/O调用成本,大大降低了文件存取的性能.
伯克利的一个小组决定建立一个更好、更快的文件系统,他们聪明地称之为快速文件系统(Fast File System,FFS)。
FFS 将磁盘划分为一些分组,称为柱面组(cylinder group,而一些现代文件系统,如 Linux ext2 和 ext3,就称它们为块组,即 block group)
因此,FFS可以在每一个组中都分配文件和目录,一个组的结构是这样的,这已经与我们之前的简单文件系统基本相同了:
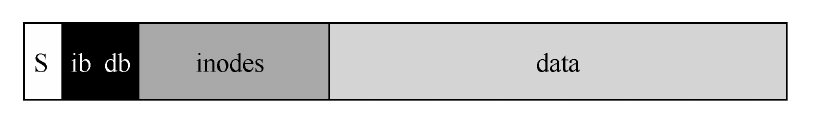
对于文件,FFS 做两件事。首先,它确保(在一般情况下)将文件的数据块分配到与其inode 相同的组中,从而防止 inode 和数据之间的长时间寻道(如在老文件系统中)。其次,它将位于同一目录中的所有文件,放在它们所在目录的柱面组中
FFS 也引入了一些其他创新。特别是,设计人员非常担心容纳小文件。事实证明,当时许多文件大小为 2KB 左右,使用 4KB 块虽然有利于传输数据,但空间效率却不太好。因此,在典型的文件系统上,这种内部碎片(internal fragmentation)可能导致大约一半的磁盘浪费。
FFS 设计人员采用很简单的解决方案解决了这个问题。他们决定引入子块(sub-block),这些子块有 512 字节,文件系统可以将它们分配给文件。因此,如果你创建了一个小文件(比如大小为 1KB),它将占用两个子块,因此不会浪费整个 4KB 块
更稳定的文件系统
每次在原有的文件上新加内容时,我们需要更新三个结构: 文件对应的inode,新数据块对应的bitmap,磁盘上的新数据块内容.如果在更新过程中系统崩溃了,我们有可能只完成了其中的一两项更新,导致系统内部不再保持一致性.
早期的文件系统使用文件系统检查程序(file system checker, fsck)来解决这个问题,它通过扫描整个磁盘和检查各种有可能出错的地方来发现潜在的不一致问题,这种做法非常低效和费时.
后来,我们提出了**日志记录(journaling)**这一从数据库管理系统种借鉴来的方法,在执行事务前先将要执行的操作记入日志,这样就可以在系统恢复时检查哪些操作没能成功执行了,如今的Linux ext3,ext4和Windows的NTFS都采用了这种方法.
假如我们直接往日志中记录我们要提交的所有更改,如果在记录过程中发生了故障,这又会导致系统的不一致,所以我们需要将日志记录分成两步,再加上更改时的记录,总共就是三步了:
- 日志写入: 写入这次事务的时间,涉及的块等信息
- 日志提交: 写入这次事务要执行的具体操作
- 事务执行: 执行最终的磁盘写入,每次写入时提交一个报告或者加上一个检查点
如果崩溃发生在第二步完成之前,我们直接放弃这次更新即可,如果在第二步完成之后,那么就可以从日志中恢复之前的更改了.
总结
整体来说是相当精彩的,每个部分都能谈及对应技术的历史背景和发展历程,让人对操作系统有了一个非常好的全局视野,可以说是程序员的必读书籍了.
操作系统: 设计与实现(第三版)
- 出版于2006年(英文第3版),作者:Andrew S. Tanenbaum。
- MINIX配套教材,也是一切开始的地方.
- 一开始我在想这本书的中文版为什么要分成上下两册,后来发现下册只有300多页,里面是接近3w行的MINIX源码,说实话真没必要😅
引言

大多数操作系统书也确实是这样的,这也是这本书与众不同的地方,从头设计了一个全新的操作系统.
操作系统的发展历史
- 这一部分很值得看.
与Linux的关系
有些读者可能对 MINIX 和 Linux 之间的关系比较感兴趣。在 MINIX 发布后不久,便出现了一个相应的 USENET 新闻组 comp.os.minix,在数周内便有多达 40 000 个用户订阅。其中多数人都想往 MINIX 中加入一些新的特性以使它更大、更好(嗯,至少是更大吧)。每天都有数百人提出自己的建议、想法甚至是代码。而 MINIX 的作者在几年内始终坚持不采纳这些建议,目的是使 MINIX 保持足够的简洁,以便于学生理解;同时保持规模的小巧,使它能运行在一些低档的、学生可以买得起的计算机上。事实上,对于一些看不上 MS-DOS 的人来说,MINIX 系统及其源代码的存在,甚至是促使他们去购买一台 PC 机的动因。 在这些提建议的人中,有一个芬兰学生 Linus Torvalds。Torvalds 在他的 PC 机上安装了 MINIX 系统,并且认真钻研了它的源代码。后来,Torvalds 想在他自己的 PC 机上阅读 USENET 新闻组(如 comp.os.minix ),免得每次都得跑到学校去。但是他需要的一些特性在 MINIX 中没有,于是他就写了一个程序来完成这些功能。但不久他又需要一个不同的终端驱动程序,于是他又写了一个相应的程序。接下来,他想要下载和保存新闻组中的文章,于是又写了一个磁盘驱动程序和一个文件系统。到 1991 年 8 月,他已经完成了一个基本的内核。在 1991 年 8 月 25 日,他把这个消息公布在 comp.os.minix 上。这个公告吸引了其他人来帮助他,在 1994 年 3 月 13 日,Linux 1.0 正式发布了,这标志着 Linux 的诞生。
总结
由于我看这本书是想学MINIX,奈何大部分内容都是在抛开MINIX谈论操作系统的共性,尽管讲的不错,但这些内容我都还比较熟悉,等待以后要背八股时或许会再来看一遍吧.
程序设计语言原理(第12版)
- 出版于2018年(英文第12版),作者:Robert W. Sebesta。
这本书应该放在所有程序员的必读书单中,原因就在于它的第二章详细描述了整个编程语言的发展历史,至于其他部分说实话都讲的不太行.
编程语言历史
- 非常的详实,非常的有趣,可以说这才是这整本书的精华,所有对编程语言历史感兴趣的人都应该看看这一章.
程序员自我修养
- 出版于2009年,作者:俞甲子。
- (4/5): 讲的很深,可惜的是逻辑比较混乱,如果能再版后重构一下就真的是神书了
- (6/16): 回来鞭尸了,这本书的遗毒太深了,导致我对编译器产生了很多乱七八糟的误解,尽管这能够让我从错误中更好地学习,但还是不希望其他人拿这本书入门编译原理,不太推荐.
OUTLINE
- 简介
- 编译和链接
- 目标文件里有什么
- 静态链接
- windows PE/COFF
- exe的装载与进程
- 动态链接
- Linux的共享库
- Windows中的动态链接
- 内存
- 运行库
- 系统调用与API
- 运行库的实现
可以很明显的看出来,这本书主要涉及的是C语言程序经过编译与链接后装载的过程.
编译和链接
程序运行的过程
当我们使用GCC编译Hello World程序时,只需要这样写:
| |
上述过程可以分解为4个步骤:
- 预处理(Preprocessing)
- 编译(Compilation)
- 汇编(Assembly)
- 链接(Linking)
预处理
c文件和h文件会被预处理成.i文件,cpp文件和hpp文件会被预处理为.ii文件.
- 对应的命令为
gcc -E hello.c -o a.i该阶段主要处理源代码中以"#“打头的预编译指令,如’#include’,’#define’等,主要运行过程如下:
- 将所有的”#define"删除,并展开所有的宏定义,比如,将含有"#define PI 3.14"的文件中的所有PI替换为3.14
- 处理所有的条件预编译指令,如"#if",“endif"等
- 处理”#include",将被包含的文件插入到文件中该预编译指令所在的行,该过程是递归执行的
- 删除所有的注释"//“和”/* */"
- 添加行号和文件名标识,如 " #2 “hello.c” 2 “,这就是我们在程序报错的时候看到的那些行号和文件名的来历,至于行尾的2,是一个给编译器看的标志位
- 保留所有的”#pragma"指令
因此,经过预处理后的.i文件不包含任何宏定义,包含的文件也被插入到.i文件中
编译
对.i文件进行一系列词法分析,语法分析,语义分析和优化,生成相应的汇编代码文件.
- 对应的命令为
gcc -S hello.i -o hello.s
汇编
根据汇编代码构建目标文件
- 对应的命令为
gcc -c hello.s -o hello.o- 或者一步完成:
gcc -c hello.c -o hello.o
- 或者一步完成:
链接
| |
可以看到需要链接一堆文件才可以得到最终的可执行文件
编译的详细原理
下面我们来以一段简单的c语言代码为例来分析编译的全过程:
| |
词法分析
源代码被输入到扫描器(Scanner),产生一系列记号:关键字,标识符,数字,字符串和特殊符号(加号,等号)等.
语法分析
语法分析器(Grammar Parser)对扫描器产生的记号进行语法分析,产生由表达式组成的语法树(Syntax Tree)
语义分析
语义分析器(Semantic Analyzer)对表达式进行静态的语义分析,标识各个表达式的类型;动态语义则只能在运行期确定.
中间代码的生成
现代编译器会对源代码进行优化,将整个语法树转换成中间代码,尽管非常接近目标代码,但它与运行的操作系统无关,不包含数据尺寸,变量地址和寄存器名字等信息.
根据中间代码可以把编译器分为前端和后端.前端负责产生于操作系统无关的中间代码,后端负责将中间代码转换成目标文件 Java 编译体系 (Bytecode)
前端:javac。它将 .java 源码编译成与平台无关的 Java Bytecode (.class 文件)。这就是所谓的中间代码。
后端:JVM (Java Virtual Machine) 中的 JIT 编译器 (如 C1、C2)。当程序运行时,JIT 将字节码转换为当前运行机器(Windows x64、Linux ARM 等)的具体指令集。
目标代码的生成与优化
编译器后端主要包括代码生成器和目标代码优化器二者.
代码生成器将中间代码转换成目标机器代码,例如:
| |
然后由目标代码优化器对上述目标代码进行优化,比如选择合适的寻址方式,使用位移来代替乘法运算,删除冗余指令等
总结
经过这么多步骤后,源代码被编译成了目标代码,但有一个问题,变量的存储地址还没有确定,而且如果这个变量是来自其他模块的话又该怎么办?这就是链接派上用场的地方了
链接概览
链接有以下几个步骤:
- 地址和空间分配(Address and Storage Allocation)
- 符号决议(Symbol Resolution)
- 重定位(Relocation)
补充: 编译全过程;编译器的前端和后端
由于书上对这些概念没有做一个很清晰的介绍,因此我再在这里做一点辨析方便后续的阅读: 流水线解释
- 预处理: 转换宏定义,删除注释
- 编译(狭义): 将cpp源码翻译成汇编代码(人类可读)
- 汇编:
- 将汇编代码翻译成机器指令(二进制码)
- 根据机器指令,地址位置等信息构造目标文件
- 链接: 将目标文件与系统库,用户库关联起来,得到可执行文件
- 编译(广义): 由于大多数人对cpp的装载过程没有一个清晰的认识,故通常使用编译代指从
.cpp到.exe的全过程,也就是说我们一般都用广义的编译概念,很少特指"真正的编译"
但是,我们所用的编译器如gcc,clang等都是广义上的编译器,也就是说不仅仅做的是编译,而是包揽了从.cpp到目标文件的全构建过程.
如果用前端和后端的概念来划分的话,是这样的:
前端(Frontend)
范畴: 仅包含“编译”这一步的前半部分。
- 输入: 预处理后的源码。
- 任务: 词法分析(Lexical Analysis)、语法分析(Syntax Analysis)、语义分析(Semantic Analysis)、生成中间表示(IR, Intermediate Representation)。
- 特性: 与具体的硬件架构(如 x86、ARM)无关,只与 C++ 语言本身的规则有关。
后端(Backend)
范畴: 包含“编译”这一步的后半部分,以及“汇编”的全部。
- 任务: * 中端优化(Optimizer):对 IR 进行架构无关的优化。
- 代码生成(Code Generator):将 IR 转换为特定硬件的汇编代码。
- 汇编器(Assembler):将汇编代码转换为机器指令,产出目标文件。
- 特性: 强依赖于硬件架构。
其他项
- 预处理(Preprocessing):通常被视为编译前的“文本清洁工作”,不属于狭义编译器(Compiler Core)的前后端逻辑。
- 链接(Linking):属于编译链的下游,是一个独立的二进制处理过程,不属于编译器(Compiler)的范畴。
目标文件: 汇编的产物
目标文件的格式
可执行文件的格式主要有Windows中的PE(Portable Executable,不是那个重装windows用的Preinstallation Environment)和Linux中的ELF(Executable Linkable Format),两者都是COFF(Common file format)的变种.从广义上看,可执行文件的格式与目标文件基本相同,故这里将它们看作一种类型的文件,在Windows中称为PE-COFF文件格式,在Linux中称为ELF文件格式.(也就是说我们这里把目标文件就看成是ELF文件)
- 事实上,动态链接库(DLL,Dynamic Linking Library)(Windows.dll和Linux的.so)和静态链接库(Static Linking Library)(Windows的.lib和Linux的.a)的存储方式也是可执行文件.
更为标准的分类方法如下:
| ELF 文件类型 | 说明 | 实例 |
|---|---|---|
| 可重定向文件 (Relocatable File) | 包含代码和数据,可被用来链接成可执行文件或共享目标文件,静态链接库也归为此类。 | Linux 的 .oWindows 的 .obj |
| 可执行文件 (Executable File) | 包含可以直接执行的程序。 | Linux 的 /bin/bashWindows 的 .exe |
| 共享目标文件 (Shared Object File) | 包含代码和数据。可由链接器与其他可重定向/共享目标文件链接产生新目标文件;或由动态链接器与可执行文件结合,作为进程映像的一部分运行。 | Linux 的 .soWindows 的 DLL |
| 核心转储文件 (Core Dump File) | 当进程意外终止时,系统将该进程的地址空间内容及终止时的其他信息转储到该文件。 | Linux 下的 core dump |
ELF文件的内容
目标文件将不同类型的信息用段(section)的形式存储:
- File Header: 描述了整个文件的文件属性,包括文件是否可执行,目标硬件,目标操作系统等信息;还包括一个段表(section table),描述目标文件中各段的属性
- 使用C语言的结构体来定义
- .text section: 保存汇编得到的及其代码
- .data section: 保存已经初始化的全局变量和局部静态变量
- .bss section: 保存未初始化的全局变量和局部静态变量,由于它们都是0,故没有必要放入.data段中,同时,由于程序运行时需要记录这两类变量,因此需要用.bss段来额外预留位置.该段并没有内容,故在目标文件中也不占据空间.
bss的来历 BSS(Block Started by Symbol)来源于1950年代IBM大型机的汇编器中的一个伪指令,后来被引入标准汇编器FAP中,用于定义符号并且为该符号预留给定数量的未初始化空间
整体来说,源代码被编译后分成两段:程序指令(代码段),程序数据(数据段和.bss段).
事实上,ELF文件的内部结构比上述所说的四段式结构要复杂的多:
- [ 0] (NULL):索引为 0 的段物理上必须存在且全为空,用于标识无效引用。
- [ 1] .text:代码段。存放程序经过编译后的物理机器指令。
- [ 2] .rel.text:代码重定位段。记录
.text段中哪些物理地址需要在链接时进行修正。 - [ 3] .data:已初始化数据段。存放程序中已初始化的全局变量和局部静态变量。
- [ 4] .bss:未初始化数据段。为未初始化的全局变量预留的物理占位符,在文件中不占实际磁盘空间。
- [ 5] .rodata:只读数据段。存放常量(如字符串常量、
const修饰的变量)。 - [ 6] .comment:注释段。物理记录编译器版本信息(如 “GCC: (GNU) …")。
- [ 7] .note.GNU-stack:堆栈属性段。物理标识堆栈是否可执行,用于系统安全防御(NX 位)。
- [ 8] .shstrtab:段表字符串表。存储所有段名(如 “.text”, “.data”)的物理字符串池。
- [ 9] .symtab:符号表。记录程序中定义和引用的所有函数名、变量名及其物理偏移。
- [10] .strtab:字符串表。存储符号表中所使用的所有名称字符串。
下面我们来一个个解析:
文件头,段表,重定位表
文件头
本书使用的示例c程序分析得到的文件头内容如下:
- Magic (魔数):
7f 45 4c 46 01 01 01 00 ...- 物理意义:文件开头的 16 个字节,用于标识该文件是一个 ELF 格式的可执行或目标文件。
- Class (类别):
ELF32- 物理意义:该文件是为 32 位 架构设计的。
- Data (数据存储方式):
2's complement, little endian- 物理意义:采用二补码形式,且为 小端序(低位字节存储在低地址)。
- Version (版本):
1 (current)- 物理意义:当前 ELF 格式的版本号。
- OS/ABI (操作系统/接口):
UNIX - System V- 物理意义:该文件遵循的物理调用约定标准。
- Type (文件类型):
REL (Relocatable file)- 物理意义:这是一个可重定位文件(通常为
.o文件),尚未经过链接。
- 物理意义:这是一个可重定位文件(通常为
- Machine (硬件平台):
Intel 80386- 物理意义:物理运行的目标指令集架构。
- Entry point address (入口地址):
0x0- 物理意义:由于是可重定位文件,尚未装载,因此物理入口地址为 0。
- Start of program headers (程序头起点):
0 (bytes into file)- 物理意义:目标文件中通常不包含程序头表(Program Header Table),该表仅在可执行文件中存在。
- Start of section headers (段表起点):
280 (bytes into file)- 物理意义:**段表(Section Header Table)**在文件内部的物理偏移地址。
- Size of this header (ELF 头大小):
52 (bytes)- 物理意义:ELF Header 本身物理占据的字节长度。
- Size of section headers (单段描述符大小):
40 (bytes)- 物理意义:段表中每个条目物理占据的空间。
- Number of section headers (段的数量):
11- 物理意义:该文件物理包含 11 个段(如
.text,.data,.bss等)。
- 物理意义:该文件物理包含 11 个段(如
- Section header string table index (段表字符串表索引):
8- 物理意义:存储段名字符串的表在段表中的物理下标。
事实上,这些信息是以C语言的结构体存储的:
| |
在 ELF 文件格式定义中,为了屏蔽不同平台下
int或long长度不一带来的物理对齐问题,官方定义了一套标准数据类型:
| 自定义类型 | 描述 | 原始类型 | 长度(字节) |
|---|---|---|---|
| Elf32_Addr | 32 位版本程序地址 | uint32_t | 4 |
| Elf32_Half | 32 位版本无符号短整型 | uint16_t | 2 |
| Elf32_Off | 32 位版本偏移地址 | uint32_t | 4 |
| Elf32_Sword | 32 位版本有符号整型 | int32_t | 4 |
| Elf32_Word | 32 位版本无符号整型 | uint32_t | 4 |
| Elf64_Addr | 64 位版本程序地址 | uint64_t | 8 |
| Elf64_Half | 64 位版本无符号短整型 | uint16_t | 2 |
| Elf64_Off | 64 位版本偏移地址 | uint64_t | 8 |
| Elf64_Sword | 64 位版本有符号整型 | int32_t | 4 |
| Elf64_Word | 64 位版本无符号整型 | uint32_t | 4 |
带上示例来解释:
| 成员 | 内容 | 物理/逻辑解释 |
|---|---|---|
| e_ident | Magic: 7f 45 4c 46 01 01 01 00… | ELF 魔数。包含文件机器字节长度、数据存储方式、版本、运行平台及 ABI 版本。 |
| e_type | Type: REL (Relocatable file) | ELF 文件类型。标识是可重定位文件、可执行文件还是共享对象文件。 |
| e_machine | Machine: Intel 80386 | CPU 平台属性。相关常量以 EM_ 开头(如 EM_386)。 |
| e_version | Version: 0x1 | ELF 版本号。通常为常数 1。 |
| e_entry | Entry point address: 0x0 | 入口地址。规定程序开始执行的虚拟地址。可重定位文件(.o)通常为 0。 |
| e_phoff | Start of program headers: 0 | 程序头(Program Header)偏移。在链接视图中暂不关心,执行视图的核心。 |
| e_shoff | Start of section headers: 280 | 段表(Section Header)偏移。即段表在文件内的起始物理位置。 |
| e_word | Flags: 0x0 | ELF 标志位。标识特定平台相关的属性,格式通常为 EF_machine_flag。 |
| e_ehsize | Size of this header: 52 (bytes) | ELF 文件头本身的大小。在本例中物理占据 52 字节。 |
| e_phentsize | Size of program headers: 0 | 程序头描述符的大小。 |
| e_phnum | Number of program headers: 0 | 程序头描述符的数量。 |
| e_shentsize | Size of section headers: 40 (bytes) | 段表描述符的大小。物理上等于 sizeof(Elf32_Shdr)。 |
| e_shnum | Number of section headers: 11 | 段的数量。物理记录了 ELF 文件中拥有的段表描述符总数。 |
| e_shstrndx | Section header string table index: 8 | 段表字符串表下标。存储段名字符串的表在段表中的物理索引位置。 |
魔数详解
e_ident成员的前四个字节7f 45 4c 46中,第一个字节对应的是ASCII中的DEL控制符,后三个字节刚好是ELF这三个字母的ASCII码,从而唯一标识了ELF文件,故被称为ELF文件的魔数.
接下来的一个字节用来标识ELF的文件类,
01表示是32位的,02表示是64位的;第六个字节是字节序,规定该文件是大端存储还是小端存储;第七个字节为该文件的主版本号,一般是1,因为ELF标准从1.2版后就没有更新过.后面的9个字节ELF标准没有定义,一般填0. 至于为什么要多出来这9个字节,主要是为了兼容老编译器的考量.
自然,所有的可执行文件都有一个魔数用来标识自己,比如PE/COFF文件的最开始两个字节为4d,5a,即ASCII字符MZ.
段表
段表用于保存ELF文件中各个section(段)的基本信息,比如段的名字,长度,存储位置,读写权限等属性.编译器,链接器和装载器都是依靠段表来定位和访问各个段的属性的,至于段表的位置则是由文件头中的
e_shoff字段来定义的.
- 尽管书上讲的很详细,但我想只需要大概知道段表的作用即可
重定位表
链接器在处理目标文件的时候,需要对目标文件中的某些部分进行重定位,即.text段和.data段中对绝对地址引用的位置.
对于每个要重定位的.text段和.data段,都会有一个相应的重定位表.
链接的接口: symbol
如果目标文件B用到了目标文件A中的函数foo,那么就称A定义(define)了foo,B引用(reference)了A中的函数foo.
在链接中,函数和变量统称为符号(symbol),函数名和变量名则为符号名(symbol name).
链接中很关键的一部分就是符号的管理,每一个目标文件都有一个相应的符号表,记录该目标文件中用到的所有符号,每个定义的符号有一个对应的符号值,对于变量和函数来说,符号值就是它们的地址.
除了函数和变量之外,还存在其他几种不常用到的符号。我们将符号表中所有的符号进行分类,它们可能是下面这些类型中的一种:
- 定义在本目标文件的全局符号,可以被其他目标文件引用。比如 SimpleSection.o 里面的 “func1”、“main” 和 “global_init_var”。
- 在本目标文件中引用的全局符号,却没有定义在本目标文件,这一般叫做外部符号(External Symbol),也就是我们前面所讲的符号引用。比如 SimpleSection.o 里面的 “printf”。
- 段名,这种符号往往由编译器产生,它的值就是该段的起始地址。比如 SimpleSection.o 里面的 “.text”、“.data” 等。
- 局部符号,这类符号只在编译单元内部可见。比如 SimpleSection.o 里面的 “static_var” 和 “static_var2”。调试器可以使用这些符号来分析程序或崩溃时的核心转储文件。这些局部符号对于链接过程没有作用,链接器往往也忽略它们。
- 行号信息,即目标文件指令与源代码中代码行的对应关系,它也是可选的。
符号修饰与函数签名
在cpp中我们可以通过命名空间(namespace)和函数重载定义多个同名函数,那么编译器和链接器就需要在链接过程中区分这两个函数.
首先,我们可以使用函数签名(function signature)来区分不同的函数,它包含了函数的名字,参数类型,命名空间,所在的类及其他信息.这样可以保证每一个函数都有一个独特的函数签名.
其次,我们可以根据函数签名在编译过程中修饰这些函数,例如:
| 函数签名 | 修饰后名称(符号名) |
|---|---|
| int func(int) | _Z4funci |
| float func(float) | _Z4funcf |
| int C::func(int) | _ZN1C4funcEi |
| int C::C2::func(int) | _ZN1C2C24funcEi |
| int N::func(int) | _ZN1N4funcEi |
| int N::C::func(int) | _ZN1N1C4funcEi |
自然,cpp中的全局变量和静态变量也有同样的签名和修饰机制,而C语言由于不存在重名机制,故不需要对涉及的符号进行任何修改.
强弱符号
在C/CPP中,函数和初始化的全局变量为强符号(strong symbol),未初始化的全局变量为弱符号(weak symbol).
编译器按照以下三个规则来处理强弱符号:
- 不允许强符号被多次定义,否则链接器会报出符号重复定义的错误
- 如果一个符号在某个目标文件中是强符号,在其他目标文件中是弱符号,则将它看作为强符号
- 如果一个符号在所有目标文件中都是弱符号,那么选择占用空间最大的一个作为它的定义,如int和double中选择double.
强弱引用
当目标文件中引用外部符号时,如果在链接时,没有找到该符号的定义,那么就会报出未定义错误,这类引用被称为强引用(strong reference).
但是还有一类特殊的引用即使在链接时没找到该符号的定义也不报错,被称为弱引用(weak reference).这允许了冗余代码和缺失功能模块的设计.
调试信息
目标文件里还会保存调试信息,如果我们用GCC编译时加上 “-g” 参数,编译器就会在产生的目标文件里面加上调试信息,我们通过 readelf 等工具可以看到,目标文件里多了很多 “debug” 相关的段:
| [Nr] | Name | Type | Addr | Off | Size | ES | Flg | Lk | Inf | Al |
|---|---|---|---|---|---|---|---|---|---|---|
| … | ||||||||||
| [ 4] | .debug_abbrev | PROGBITS | 00000000 | 000040 | 000034 | 00 | 0 | 0 | 1 | |
| [ 5] | .debug_info | PROGBITS | 00000000 | 000074 | 0000af | 00 | 0 | 0 | 1 | |
| [ 6] | .rel.debug_info | REL | 00000000 | 000738 | 000038 | 08 | 9 | 5 | 4 | |
| [ 7] | .debug_line | PROGBITS | 00000000 | 000123 | 000037 | 00 | 0 | 0 | 1 | |
| [ 8] | .rel.debug_line | REL | 00000000 | 000770 | 000008 | 08 | 19 | 7 | 4 | |
| [ 9] | .debug_frame | PROGBITS | 00000000 | 00015c | 000034 | 00 | 0 | 0 | 4 | |
| [10] | .rel.debug_frame | REL | 00000000 | 000778 | 000010 | 08 | 19 | 9 | 4 | |
| [11] | .debug_loc | PROGBITS | 00000000 | 000190 | 00002c | 00 | 0 | 0 | 1 |
- 调试信息在目标文件和可执行文件中占用了很大的空间,往往比程序的代码和数据本身大好几倍,因此,发布程序时,我们需要去除这些对于用户没有用的调试信息,从而节省大量的空间
- 例如可以在VS中选用Release模式而非Debug模式,从而将大部分调试信息排除在打包的可执行文件以外.
静态链接(4/15)
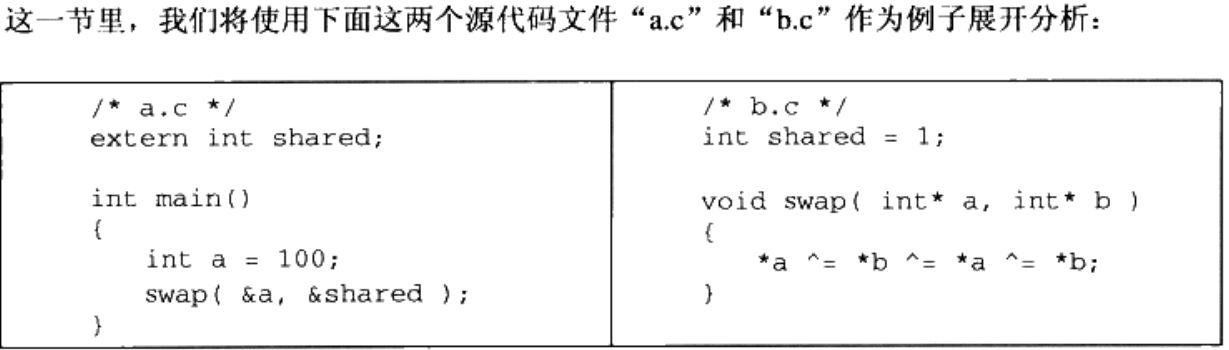
当我们运行gcc -c a.c b.c后,得到两个目标文件a.o和b.o,如何将他们链接起来,形成一个可执行文件?这个过程中发生了什么?
链接方法
对于多个目标文件,链接器有以下两种方法,将他们的各个段(section)合并到一个可执行文件中:
- 按序叠加
- 相似段合并
按序叠加
这种方法将输入的目标文件按照次序叠加起来:
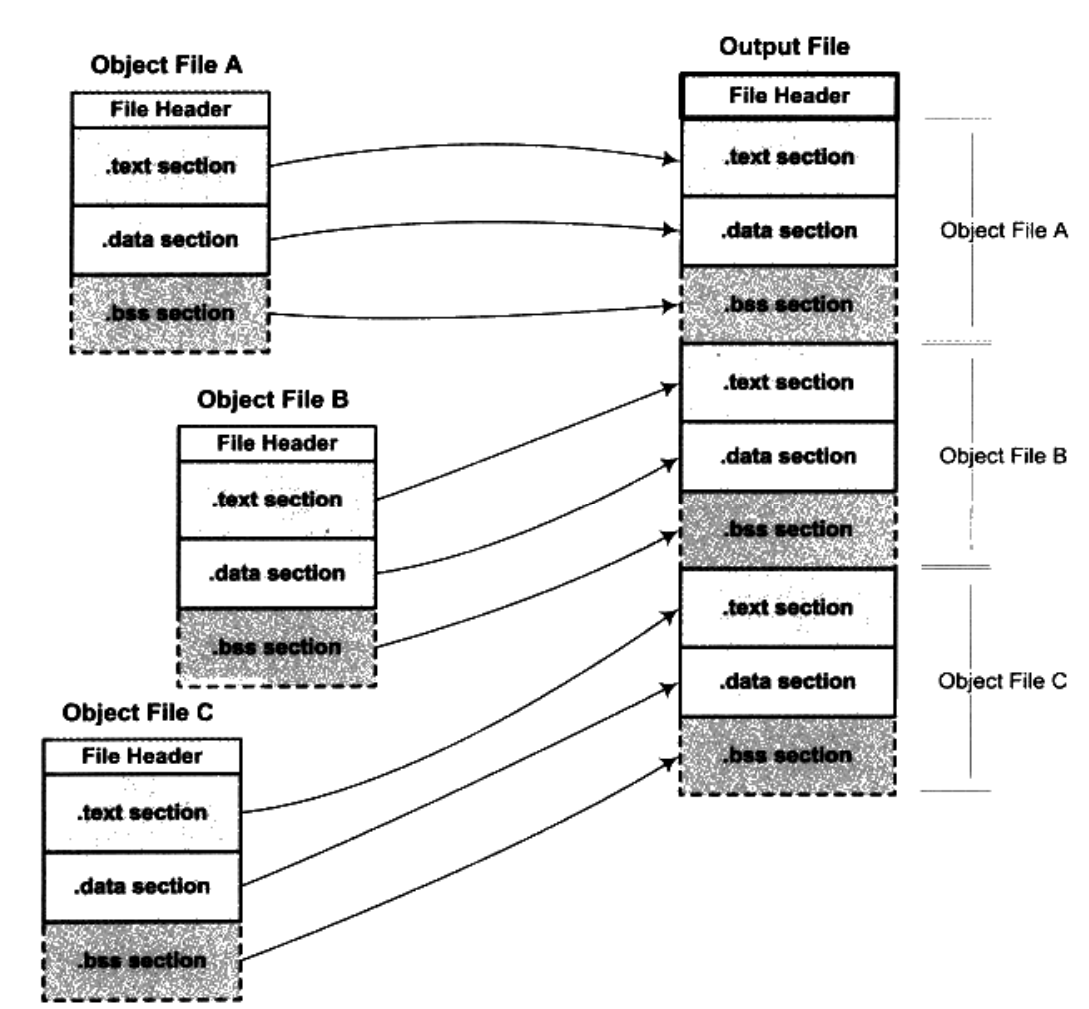
显然,这种做法非常浪费空间,会堆积一大堆冗余数据
相似段合并
将相同性质的段合并到一起是一个更为实际的方法,也是主流的链接器空间分配策略:
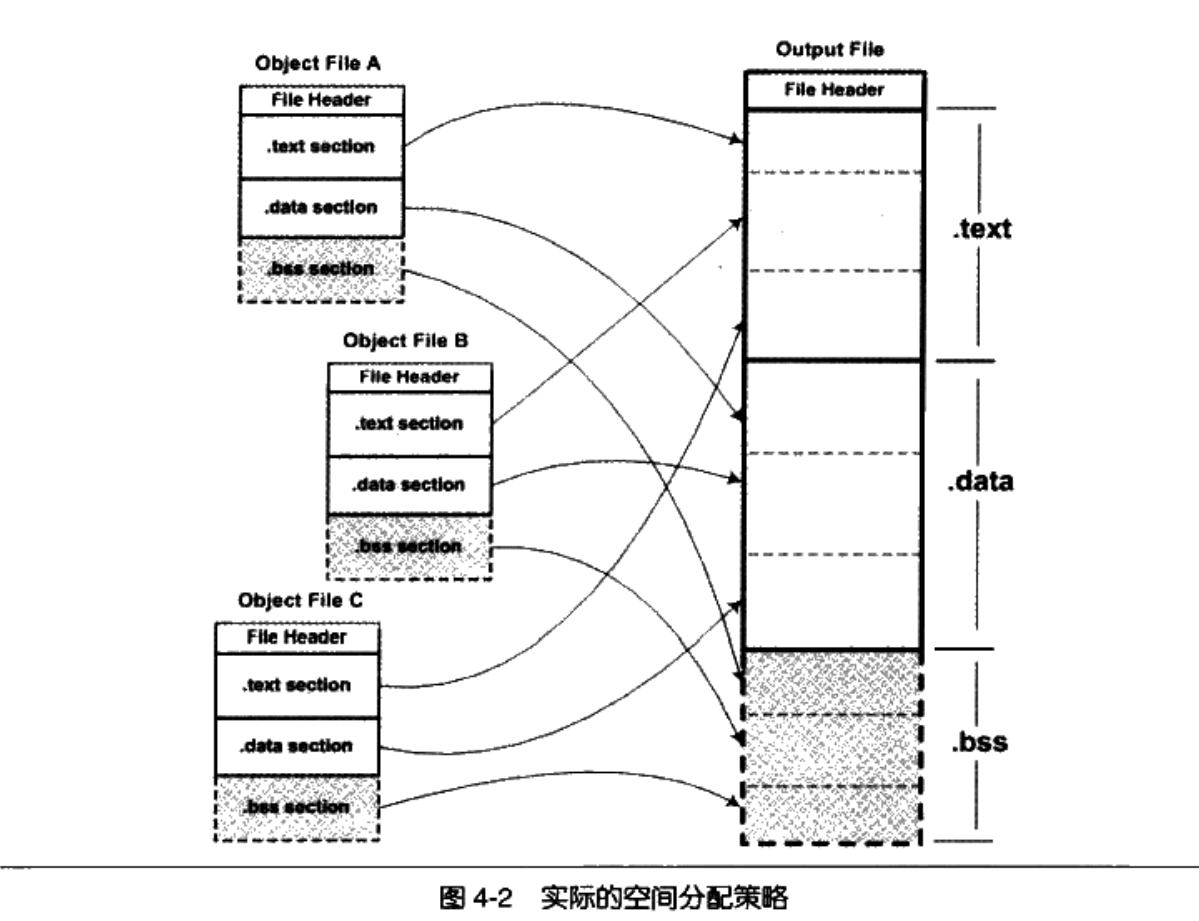
这种链接方式分为两步:
- 空间和地址分配: 扫描所有的目标文件,将符号表中的所有信息统一放到一个全局符号表
- 符号解析和重定位: 根据上一步的信息,进行符号解析和重定位,调整代码中的地址
空间与地址分配
通过 objdump -h 命令观察目标文件 a.o、b.o 以及链接后的可执行文件 ab 的段分配情况:
a.o (目标文件)
| Idx | Name | Size | VMA | LMA | File off | Algn | Flags |
|---|---|---|---|---|---|---|---|
| 0 | .text | 00000034 | 00000000 | 00000000 | 00000034 | 2**2 | CONTENTS, ALLOC, LOAD, RELOC, READONLY, CODE |
| 1 | .data | 00000000 | 00000000 | 00000000 | 00000068 | 2**2 | CONTENTS, ALLOC, LOAD, DATA |
| 2 | .bss | 00000000 | 00000000 | 00000000 | 00000068 | 2**2 | ALLOC |
b.o (目标文件)
| Idx | Name | Size | VMA | LMA | File off | Algn | Flags |
|---|---|---|---|---|---|---|---|
| 0 | .text | 0000003e | 00000000 | 00000000 | 00000034 | 2**2 | CONTENTS, ALLOC, LOAD, RELOC, READONLY, CODE |
| 1 | .data | 00000004 | 00000000 | 00000000 | 00000074 | 2**2 | CONTENTS, ALLOC, LOAD, DATA |
| 2 | .bss | 00000000 | 00000000 | 00000000 | 00000078 | 2**2 | ALLOC |
ab (链接后的可执行文件)
| Idx | Name | Size | VMA | LMA | File off | Algn | Flags |
|---|---|---|---|---|---|---|---|
| 0 | .text | 00000072 | 08048094 | 08048094 | 00000094 | 2**2 | CONTENTS, ALLOC, LOAD, READONLY, CODE |
| 1 | .data | 00000004 | 08049108 | 08049108 | 00000108 | 2**2 | CONTENTS, ALLOC, LOAD, DATA |
- VMA (Virtual Memory Address):链接前目标文件的 VMA 均为
0,因为尚未物理分配虚拟地址;链接后ab中的段被物理分配到了以0804xxxx开头的地址空间。- LMA(Load Memory Address): 装载地址,正常情况下该值与VMA相同,但在部分嵌入式系统中,两个值是不同的.
- Size 合并:
ab的.text段大小(0x72)约等于a.o(0x34)与b.o(0x3e)之和,体现了链接器的段合并策略。 - Flags 变化:链接后的
ab移除了RELOC标志,说明物理重定位已完成。
可执行文件里没有物理地址,在执行时才由操作系统将虚拟地址映射到物理地址
符号解析与重定位(4/22)
- 重定位: 修正编译器产生的符号(函数与变量)地址
- 符号解析: 根据全局符号表查找所需符号的地址,用于重定位
C++相关的链接问题(待补充)
Windows PE/COFF
之所以叫PE/COFF,是因为windows32位的可执行文件格式PE与ELF一样,都是从古老的COFF格式发展来的.换句话说,PE(Portable Executable)是COFF的一种扩展,结构上大致相同,与ELF格式也基本相同,都采用了段的格式
- windows64位中,对原本的PE格式做了一点修改,叫做PE32+,它没有增加新的字段,只是把原来的32位字段变成了64位,因此我们也可以把它看作是一般的PE文件.
总的来说的话,在Windows中目标文件为COFF格式,为.obj后缀;可执行文件/动态链接库为PE格式,为.exe/dll后缀
COFF文件结构
COFF 目标文件格式 (COFF Object File Format) 的常见结构如下:
- Image Header (
IMAGE_FILE_HEADER) - Section Table (
IMAGE_SECTION_HEADER[]) - .text(代码节)
- .data(数据节)
- .drectve(指示节)
- .debug$S(调试符号节)
- other sections(其他节)
- Symbol Table(符号表)
- 与ELF文件格式确实很像
前两个部分是COFF文件的文件头,分别是描述文件总体结构和属性的映像头和描述各段属性的段表
- 映像(image): PE文件在装载时会被直接映射到进程的虚拟空间中,是进程虚拟空间的映像.
PE文件结构
PE 文件格式 (PE File Format) 的常见结构如下:
- Image DOS Header (
IMAGE_DOS_HEADER) - Image DOS Stub
- PE File Header (
IMAGE_NT_HEADERS)- Image Header (
IMAGE_FILE_HEADER) - Image Optional Header (
IMAGE_OPTIONAL_HEADER32)
- Image Header (
- Section Table (
IMAGE_SECTION_HEADER[]) - .text
- .data
- .drectve
- .debug$S
- other sections
- Symbol Table
第一段和第二段中DOS部分的来历:
在Windows发展的早期,古老的DOS系统还十分盛行,而此时的Windows甚至不能脱离DOS环境独立运行,所以为Windows1编写的程序必须加入这两个DOS段来兼容DOS系统. 为了兼容古老的程序,直到现在的Windows可执行文件都包含了这两个段
Image DOS Header详解
“IMAGE_DOS_HEADER”结构也被定义在 WinNT.h 里面,该结构的大多数成员我们都不关心,唯一值得关心的是“e_lfanew”成员,这个成员表明了 PE 文件头(IMAGE_NT_HEADERS)在 PE 文件中的偏移,我们需要使用这个值来定位 PE 文件头。
这个成员在 DOS 的“MZ”文件格式中的值永远为 0,所以当 Windows 开始执行一个后缀名为“.exe”的文件时,它会判断“e_lfanew”成员是否为 0。如果为 0,则该“.exe”文件是一个 DOS“MZ”可执行文件,Windows 会启动 DOS 子系统来执行它;如果不为 0,那么它就是一个 Windows 的 PE 可执行文件,“e_lfanew”的值表示“IMAGE_NT_HEADERS”在文件中的偏移。
Image DOS Stub详解
当 PE 可执行映像在 DOS 下被加载的时候,DOS 系统检测该文件,发现最开始两个字节是“MZ”,于是认为它是一个“MZ”可执行文件。然后 DOS 系统就将 PE 文件当作正常的“MZ”文件开始执行。
DOS 系统会读取 “e_cs” 和 “e_ip” 这两个成员的值,以跳转到程序的入口地址。然而 PE 文件中,“e_cs”和“e_ip”这两个成员并不指向程序真正的入口地址,而是指向文件中的 “DOS Stub”。
“DOS Stub” 是一段可以在 DOS 下运行的一小段代码,这段代码的唯一作用是向终端输出一行字:
“This program cannot be run in DOS”
然后退出程序,表示该程序不能在 DOS 下运行。所以我们如果在 DOS 系统下运行 Windows 的程序就可以看到上面这句话,这是因为 PE 文件结构兼容 DOS “MZ” 可执行文件结构的缘故。
可执行文件的装载
可执行文件只有装载到内存以后才能被 CPU 执行。早期的程序装载十分简陋,装载的基本过程就是把程序从外部存储器中读取到内存中的某个位置。随着硬件 MMU 的诞生,多进程、多用户、虚拟存储的操作系统出现以后,可执行文件的装载过程变得非常复杂。
进程虚拟地址空间
如前所说,可执行文件里的地址都是虚拟地址,在运行时拥有自己独立的虚拟空间地址,并被操作系统映射到实际的硬件地址上.
在32位平台下,我们有4GB(2^32-1)的虚拟空间地址可以分配.
默认情况下,Linux会将这4GB分成两部分:
- 1GB的操作系统空间
- 3GB的用户进程运行空间,换句话说,所有的代码,数据申请的虚拟空间之和不可以超过3GB
而在Windows中,默认情况下会分给操作系统2GB空间(因为系统比Linux更为臃肿庞大),进程只有2GB空间,尽管我们可以通过修改启动参数来将操作系统的空间减少到1GB.
装载的方式
程序执行时所需要的指令和数据必须在内存中才能够正常运行,但我们永远不会也不需要在内存里装载所有程序的指令.只需要将程序最常用的部分驻留在内存中,将不太常用的数据存放在磁盘里,这被称为动态装载,即只装载当前所需的数据,不需要的数据就放在磁盘中.
动态装载有两种具体的实现方法:
- 覆盖装载(Overlay): 已经被完全淘汰
- 页映射(Paging): 现代操作系统都使用该方法
覆盖装载
尽管该方法被淘汰了,但体现的一些思想还是很有意义的,并且在内存受限的环境下还可能用得到.
程序员在编写程序的时候必须手工将程序分割成若干块,还需要编写一个辅助代码(被称为覆盖管理器(overlay manager)),用于管理模块何时驻留内存以及何时被替换,这个覆盖管理器需要常驻内存指挥内存调用.
之所以叫覆盖装载,是因为我们可以在程序的某个部分不再被用到时,把一个被用到的程序部分装载到它的内存空间,从而节省内存.
- 显然,当程序复杂起来时,我们需要考虑程序之间的依赖关系,保证覆盖时不会影响其他正在使用的进程.不管怎样,确实非常麻烦.
页映射
页映射将内存和所有磁盘中的数据和指令按照页(Page)为单位划分并进行操作和装载.
- Intel IA32处理器使用4096字节的页,那么512MB的物理内存就有
512*1024*1024/4096=131072个页
当内存中的剩余空间不足以容纳新进程时,我们就需要抛弃旧的进程来腾出空间,有两种简单的算法来选择被抛弃的进程:
- 先进先出(FIFO): 将第一个被分配的内存页抛弃
- 最少使用(LUR): 将最不常用的内存页抛弃
不管使用的什么算法,我们都由操作系统的存储管理器来进行内存页的分配和抛弃,所以接下来让我们从操作系统的角度看看可执行文件的装载过程
实际的装载过程
创建进程
创建进程需要做以下三件事:
- 创建一个独立的虚拟地址空间
- 读取可执行文件头,建立虚拟空间和可执行文件的映射关系
- 将cpu的指令寄存器设置成可执行文件的入口地址,运行可执行文件
页错误
上述的步骤执行完后,可执行文件的真正指令和数据都没有被装入内存,仅仅是在内存开辟一个存放虚拟地址映射关系的数据结构而已.
当CPU开始在入口地址执行可执行文件时,发现往后的页面都是空的,不存在任何数据,这被称为页错误(Page Fault),于是CPU将控制权交给操作系统,让操作系统根据数据结构找到空页面对应的VMA(Virtual Memory Area,虚拟内存区域),这个VMA就是进程中代码所对应的执行空间.
操作系统在物理内存中分配该VMA对应的物理页,并将控制权还给CPU,让进程从刚才的页错误位置重新开始执行.
随着进程的执行,页错误不断产生,新的VMA也不断地被分配,直到所有的页面都被读取完,这时进程也被执行完了.
VMA区域分类
VMA(虚拟内存区域)除了用来映射要执行的代码段/数据段等section外,还可以用来存储栈(stack)和堆(heap),整体上我们可以将进程分为以下几种VMA:
| VMA 类型 | 权限特征 | 映射源 (Backing Store) | 内存性质 | 扩展方向 |
|---|---|---|---|---|
| 代码 VMA | 只读、可执行 | 可执行映像文件 (.text) | 文件映射 (File-backed) | 固定 |
| 数据 VMA | 可读写、可执行 | 可执行映像文件 (.data) | 文件映射 (File-backed) | 固定 |
| 堆 VMA | 可读写、可执行 | 无 (由内核分配物理页) | 匿名内存 (Anonymous) | 向上扩展 (高地址) |
| 栈 VMA | 可读写、不可执行 | 无 (由内核分配物理页) | 匿名内存 (Anonymous) | 向下扩展 (低地址) |
一个完整的映射关系如下所示:
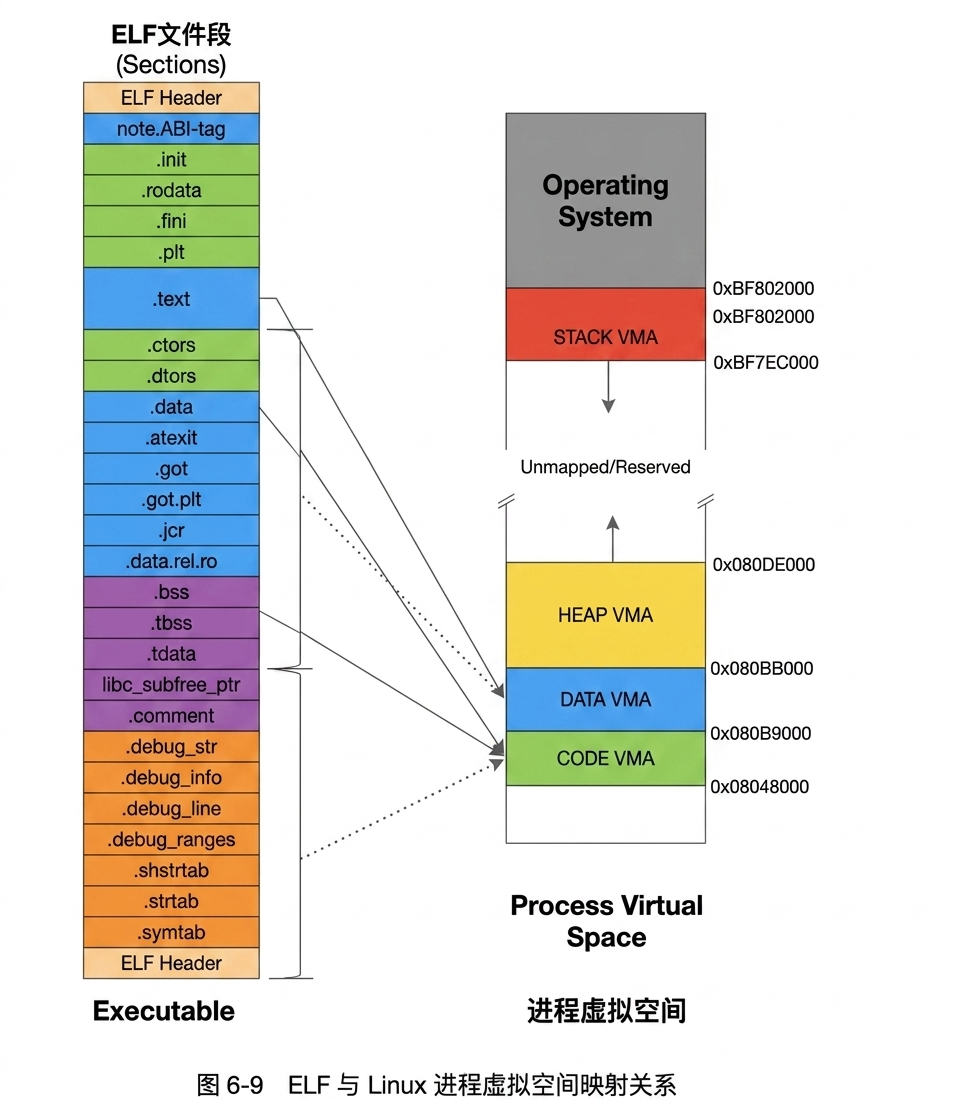
Linux装载ELF
当我们在Linux的bash中执行某个ELF文件时,bash进程调用fork()函数创建一个新的进程,新的进程调用execve()函数来执行该ELF文件,原先的bash进程等待该新进程结束后用户重新输入的命令.
执行可执行文件的具体过程如下:
execve()函数会调用do_execve()函数,读取被执行的文件的前128个字节来确定文件格式为什么要这么做呢?因为我们知道,
Linux支持的可执行文件不止ELF一种,还有a.out、Java程序和以“#!”开始的脚本程序。Linux还可以支持更多的可执行文件格式,如果某一天Linux须支持Windows PE的可执行文件格式,那么我们可以编写一个支持PE装载的内核模块来实现Linux对PE文件的支持。这里do_execve()读取文件的前 128 个字节的目的是判断文件的格式,每种可执行文件的格式的开头几个字节都是很特殊的,特别是开头 4 个字节,常常被称作魔数(Magic Number),通过对魔数的判断可以确定文件的格式和类型。比如ELF的可执行文件格式的头 4 个字节为0x7F、'e'、'l'、'f';而Java的可执行文件格式的头 4 个字节为'c'、'a'、'f'、'e';如果被执行的是Shell脚本或perl、python等这种解释型语言的脚本,那么它的第一行往往是“#!/bin/sh”或“#!/usr/bin/perl”或“#!/usr/bin/python”,这时候前两个字节'#'和'!'就构成了魔数,系统一旦判断到这两个字节,就对后面的字符串进行解析,以确定具体的解释程序的路径。
- 之后Linux根据文件格式调用对应的装载函数,比如ELF的装载函数叫做
load_elf_binary() - 以
load_elf_binary()为例,它会执行以下步骤:- 检查 ELF 可执行文件格式的有效性,比如魔数、程序头表中段(Segment)的数量。
- 设置动态链接器路径
- 根据 ELF 可执行文件的程序头表的描述,对 ELF 文件进行映射,比如代码、数据、只读数据。
- 初始化 ELF 进程环境,比如进程启动时 EDX 寄存器的地址应该是 DT_FINI 的地址(参照动态链接)。
- 将系统调用的返回地址修改成 ELF 可执行文件的入口点,这个入口点取决于程序的链接方式,对于静态链接的 ELF 可执行文件,这个程序入口就是 ELF 文件的文件头中 e_entry 所指的地址;对于动态链接的 ELF 可执行文件,程序入口点是动态链接器。
- 当装载函数执行完毕时,上述的第五步已经将寄存器的地址改成了ELF程序的入口地址了,于是开始真正执行该程序,完成装载
Windows装载PE
- RVA: Relative Virtual Address,相对虚拟地址,相对于PE文件的装载基地址的偏移地址
装载一个 PE(Portable Executable)文件并执行是一个比 ELF 相对简单的过程:
一、 头部读取与校验
- 读取首页:首先读取文件的第一个页,其中包含了
DOS 头、PE 文件头和段表。
二、 地址空间分配
- 检查目标地址:检查进程地址空间中,目标地址是否可用。
- 地址占用处理:如果不可用,则另外选择一个装载地址。对于可执行文件(
.exe)来说,这通常不是问题,因为它是进程第一个装入的模块。该步骤主要针对DLL文件的装载。
三、 内存映射与重定位
- 段映射:使用段表提供的信息,将
PE文件中所有的段一一映射到地址空间中相应的起始位置。 - 进行 Rebasing:如果实际装载地址不是预设的目标地址,则进行
Rebasing(重定向)。
四、 符号解析与依赖处理
- 装载 DLL:装载所有
PE文件运行所需的DLL动态链接库文件。 - 解析导入符号:对
PE文件中的所有导入符号进行解析与绑定。
五、 环境初始化与启动
- 建立栈和堆:根据
PE头中指定的参数,建立初始化的栈(Stack)和堆(Heap)。 - 启动进程:建立主线程并且启动进程。
动态链接
动态链接的引入
空间浪费
尽管静态链接很简单,但是会浪费大量的内存和磁盘空间,想象一下每个程序内部除了都保留着 printf()函数、scanf()函数、strlen()等这样的公用库函数,还有数量相当可观的其他库函数及它们所需要的辅助数据结构。在现在的 Linux 系统中,一个普通程序会使用到的 C 语言静态库至少在 1 MB 以上,那么,如果我们的机器中运行着 100 个这样的程序,就要浪费近 100 MB 的内存;如果磁盘中有 2 000 个这样的程序,就要浪费近 2 GB 的磁盘空间,很多 Linux 的机器中,/usr/bin 下就有数千个可执行文件。
更新困难
静态链接对程序的更新、部署和发布也会带来很多麻烦。比如程序 Program1 所使用的 Lib.o 是由一个第三方厂商提供的,当该厂商更新了 Lib.o 的时候(比如修正了 lib.o 里面包含的一个 Bug),那么 Program1 的厂商就需要拿到最新版的 Lib.o,然后将其与 Program1.o 链接后,将新的 Program1 整个发布给用户。这样做的缺点很明显,即一旦程序中有任何模块更新,整个程序就要重新链接、发布给用户。比如一个程序有 20 个模块,每个模块 1 MB,那么每次更新任何一个模块,用户就得重新获取这个 20 MB 的程序。如果程序都使用静态链接,那么通过网络来更新程序将会非常不便,因为一旦程序任何位置的一个小改动,都会导致整个程序重新下载。
动态链接是什么
要解决上述两个问题,有一个很简单的方法: 把程序划分成多个独立的文件,而不是静态地拼接在一起,直到程序要运行时再进行链接.换句话说,动态链接把链接这个过程推迟到了程序运行时再执行.
比如说,当我们拆分出p1.o,p2.o,lib.o这三个目标文件,当p1.o被系统加载到内存时,发现还需要导入lib.o,那么系统接着加载lib.o到内存,如果它们还依赖其他的目标文件,则一并导入,等到所有的依赖关系都满足时,系统开始将这些文件链接在一起后开始运行.
如果还需要运行p2.o,我们不需要重新加载lib.o,因为它已经被载入内存里了,系统只需要将p2.o与lib.o链接在一起即可.
动态链接的基本实现
实际的动态链接过程中,我们无法直接把目标文件拿来链接,而是要把目标文件稍加改动.
在Linux中,ELF动态链接文件被称为动态共享对象(DSO,Dynamic Shared Objects),文件扩展名为.so;在Windows中,动态链接文件被称为动态链接库(Dynamical Linking Library),文件扩展名为.dll.
由于动态链接在程序每次装载时都要重新进行链接,会导致程序的一些性能损失,经过优化之后的性能损失大约在5%以下,影响并不大,这样看来还是很值得的.
地址无关代码
在动态链接的情况下,由于共享文件是一个个装载的,我们无法确定后来的文件会不会占用先前的文件的虚拟地址,如果通过硬编码的形式来一一指定文件的虚拟地址,那么就极易出现错误和混淆.因此,我们有两种可能的方法来解决这个问题:
- 装载时重定位
- 地址无关代码
可执行文件往往是第一个被加载的文件,因此它可以硬编码自己的虚拟空间地址,无需程序员担忧.
装载时重定位
该想法的思路是: 在链接时不重定位所有绝对地址的引用,而是推迟到装载时进行重定位,这又被称为基址重置(Rebasing).
该方法并不适合解决上述问题,由于装载时重定位后还需要按照可执行文件的地址对指令修改,**那么同一个共享文件的指令部分是无法被多个进程共享的.**比如说可执行文件A的物理地址是100,那么指令就要修改成jmp 100,但如果可执行文件B的物理地址是500的话,修改后的共享文件就无法识别了.
地址无关代码
地址无关代码(PIC,Position-independent Code),基本想法是将共享文件中需要修改的指令部分分离出来,和数据部分放在一起,这样共享文件的指令部分就可以保持不变,而数据部分可以在每个进程中拥有一个副本.
我们先分析一下代码中各种类型的地址引用方式,从而确定哪些指令部分需要重定位:
类型一: 模块内部调用或跳转 由于被调用的函数与调用者位于同一个文件中,相对位置是固定的,所以不需要重定位.
类型二: 模块内部数据访问 由于文件被分页之后的相对位置是固定的,数据部分和指令部分往往是在相邻的页中,因此我们可以通过相对寻址来访问内部数据,通常也不需要重定位.
类型三: 模块间数据访问 不同模块间的访问地址需要到装载时才能确定,为了保证代码是地址无关的,我们需要建立一个指向这些外部全局变量的指针数组,也被称为全局偏移表(Global Offset Table),当代码需要引用外部全局变量时,可以根据GOT来查找并间接引用该变量.
详细过程如下:
- 动态链接器在装载时会查找每个变量所在的地址来填充GOT,将其存放在数据段
- 需要访问外部变量时,程序根据GOT查找到该变量的目标地址

类型四: 模块间调用和跳转 显然,我们可以把函数的地址也放入GOT中实现简单的调用和跳转,但ELF采用了一种更加复杂和精巧的方法,会在之后涉及.
延迟绑定
**延迟绑定(Lazy Binding)**的基本思想是,只有当函数第一次被用到时才进行绑定(符号查找,重定位等),如果没有用到则不进行绑定,这样就可以大幅加快程序的启动速度.
- 具体原理非常无聊,就不展开了
Linux中的动态链接
在可执行文件被映射到虚拟空间后,操作系统会启动动态链接器(Dynamic Linker)来进行动态链接,在Linux中动态链接器就是ld.so文件,可以看得到它本身也是一个共享对象.
Linux在加载完ld后,会进入ld的入口地址开始执行初始化和动态链接操作.
实际的动态链接
动态链接的步骤可以分为以下三步:
- 启动动态链接器
- 加载所有需要的共享对象(.so或者.dll文件)
- 重定位和初始化
启动动态链接器
其他共享文件的重定位可以依靠动态链接器来执行,但动态链接器本身是不可以依靠其他文件的,也就是说它不可以用到其他库,也不可以在启动的时候用到全局变量和静态变量.这被称为自举(Bootstrap).
- 在某些情况下,动态链接器启动的时候也不可以调用函数,可想而知动态链接器代码的编写有多么困难
装载共享对象
根据可执行文件依赖的所有共享对象进行递归导入,一般来说采用广度优先算法,即bfs.
重定位和初始化
重新遍历可执行文件和所有共享对象的重定位表,修正需要再次重定位的地址
Windows中的动态链接
DLL简介
Windows中的DLL文件与EXE文件均是PE格式的二进制文件,稍微不同的地方在于PE文件头中有符号位表明该文件是EXE还是DLL,同时DLL文件的扩展名未必是.dll,还可以是.ocx和.cpl.
ELF中默认所有的全局符号(全局函数和变量)都可以被导出,但在DLL中默认所有符号都不导出,我们需要显式告诉编译器我们需要导出某个符号.一种方法是在符号名字前加上__declspec关键字修饰,但也可以通过CMake进行自动添加.
符号导出导入表
导出表
当一个PE需要将一些函数或者变量提供给其他PE使用时,我们称之为符号导出.在PE中,所有需要导出的符号都集中存放在了文件头的导出表*中,它的结构如下:
| |
导入表
如果在某个程序中用到了来自dll的函数或者变量,我们称为符号导入,所有被导入的dll地址存放在文件头的导入表中
后续部分待补充
内存
内存空间中有一部分是要保留给操作系统使用的,剩下的空间被称为用户空间,有如下区域:
- 栈: 维护函数调用的上下文,一般位于用户空间的最高地址处,通常有几个MB大小
- 堆: 容纳应用程序动态分配的内存区域,位于栈的下方,比栈的容量大,可至数百兆字节
- 可执行文件映像: 可执行文件装载时的位置.
- 保留区: 不是一个单一的内存区域,而是对内存中受到保护而禁止访问的内存区域的总称.
- 例如,大多数操作系统里,极小的地址都是不允许访问的
Linux的内存分配如图所示:
可以看到,栈向低地址增长,而堆向高地址增长,但在Windows系统中,就不是这样了:
可以看到堆和栈都是散乱分布的,而Windows中的堆也不存在向上增长的规律.
栈
栈保存了函数调用所需要的维护信息:
- 函数的返回地址和参数
- 临时变量
- 保存的上下文: 在函数调用前后需要保持不变的寄存器
在i386中,一个函数的活动记录使用ebp和esp两个寄存器划定范围:
- esp(Extended Stack Pointer): 始终指向当前函数栈帧的顶部,故随着函数运行会有所变动
- ebp (Extended Base Pointer): 固定指向函数调用前ebp的值,通过偏移量可以定位函数调用时的各个参数,还可以在函数返回时,帮助恢复到调用前的值.
i386中的函数调用过程:
- 把所有或者一部分参数压入栈中
- 把当前指令的下一条指令地址压入栈中
- 跳转到函数体执行
- 后面是一大段逆向分析,就直接跳过了
堆与内存管理
栈上的数据在函数返回时就会被释放掉,无法将数据传递到函数外部,而程序运行时又无法产生新的全局变量,只能在编译的时候就确定,所以堆就成了唯一的选择.
堆的占用空间巨大,往往占据了用户空间的绝大部分,程序可以在堆中申请一块连续内存并自由使用,直到程序主动放弃前都一直可用.
例如在C语言中可以这样申请堆内存:
| |
malloc的实现有两种可能的方法:
- 每次申请空间时都进行系统调用,让系统来管理内存,由于系统调用的开销很大,要经过多层API,所以会严重影响性能
- 程序向操作系统申请一块空间后,由程序自己管理内存,这种做法也是实际的内存分配过程.
malloc本身是对Linux的系统函数和Windows系统函数的封装,我们无需知道它的具体分配原理,放心使用即可.
堆分配算法
这里介绍三种比较简单实用的堆分配算法:
- 空闲链表:把堆中各个空闲的块按照链表的方式连接起来,当用户请求堆时,可以遍历整个列表,直到找到合适大小的块后再将它拆分分给用户

- 显然这种方法容易将堆空间拆成一个非常破碎的结构,一旦链表被越界的读写操作破坏就无法正常工作.
- 位图(Bitmap): 将整个堆划分成大量大小相同的块,每次分配时都分配数个整块空间给用户,第一个块被称为头(head),其余的块被称为主体(body),我们可以使用一个整数数组来记录块的使用情况,由于一个块只有 头/主体/空闲 三种状态,故只用两位就可以表示一个块,所以叫做位图.
- 具体实现就不附上了,比较琐碎
- 对象池: 假定用户每次申请的空间大小都不变,按照这个大小把整个堆空间划分成大量的小块,每次请求的时候只需分给用户一个小块即可,无须反复遍历查找.
在实际使用时,常常是针对不同的空间大小申请采用不同的堆分配算法.
运行库
入口函数与程序初始化
“main创论”
操作系统装载程序后,首先运行的代码并不是main的第一行,而是某些别的代码,这些代码负责初始化main函数执行所需的环境并调用main函数,在main函数返回之后也会记录main函数的返回值,调用收尾函数后结束进程.
运行这些代码的函数被称为入口函数,它往往是运行库的一部分,一个典型的程序运行步骤如下:
- 操作系统创建进程后,跳转到程序入口执行,这个入口即运行库中的某个入口函数
- 入口函数初始化运行环境,包括堆,I/O,线程,全局变量构造,等等
- 入口函数初始化之后,调用main函数,正式执行程序主体部分
- main函数执行完毕后,返回到入口函数,进行清理工作,包括全局变量析构,堆销毁,关闭I/O等,然后结束进程.
C/C++运行库
C语言运行库
一个C语言运行库(C Runtime Library,CRT)包含以下功能:
- 启动与退出: 入口函数和入口函数依赖的其他函数
- 标准函数: C语言标准库中的库函数,如math.h,stdio.h等
- I/O: I/O功能的封装和实现
- 堆: 堆的封装和实现
- 语言实现: 语言中特殊功能的实现
- 调试: 实现调试功能的代码
初生的 C 语言在功能上非常不完善,例如不提供 I/O 相关的函数。因此在 C 语言的发展过程中,C 语言社区共同意识到建立一个基础函数库的必要性。与此同时,在 20 世纪 70 年代 C 语言变得非常流行时,许多大学、公司和组织都自发地编写自己的 C 语言变种和基础函数库,因此当到了 80 年代时,C 语言已经出现了大量的变种和多种不同的基础函数库,这对代码迁移等方面造成了巨大的障碍,许多大学、公司和组织在共享代码时为了将代码在不同的 C 语言变种之间移植搞得焦头烂额。于是对此惨状忍无可忍的美国国家标准协会(American National Standards Institute, ANSI)在 1983 年成立了一个委员会,旨在对 C 语言进行标准化,此委员会所建立的 C 语言标准被称为 ANSI C。第一个完整的 C 语言标准建立于 1989 年,此版本的 C 语言标准称为 C89。在 C89 标准中,包含了 C 语言基础函数库,由 C89 指定的 C 语言基础函数库就称为 ANSI C 标准运行库(简称标准库)。其后在 1995 年 C 语言标准委员会对 C89 标准进行了一次修订,在此次修订中,ANSI C 标准库得到了第一次扩充,头文件 iso646.h、wchar.h 和 wctype.h 加入了标准库的大家庭。在 1999 年,C99 标准诞生,C 语言标准库得到了进一步的扩充,头文件 complex.h、fenv.h、inttypes.h、stdbool.h、stdint.h 和 tgmath.h 进入标准库。自此,C 语言标准库的面貌一直延续至今。
总结
花了一段时间,总算把这本书读完了,可以说收获满满,透彻了解一个C/C++程序从编译到运行的整个过程,但是这本书有一些不足之处,列举如下:
- 结构安排混乱,部分内容前后重复或者顺序不合理
- 汇编代码分析多,很多地方举的汇编例子并不具有代表性,而且分析的也不够深入,不了解汇编代码的我只好直接跳过
C和指针
- 出版于2008年(中文版;英文原版1997年),作者:Kenneth A. Reek。
不推荐阅读,甚至没找到有必要做笔记的地方,你就说写的有多烂吧.
可是这种书却能拿到这么高的分数,反而说明了C系语言的教材有多么匮乏和枯燥.
重构 改善既有代码的设计
- 出版于2019年(中文版第2版),作者:Martin Fowler。
ch1: Intro
如果你要给程序添加一个特性,但发现代码因缺乏良好的结构而不易于进行更改,那就先重构那个程序,使其比较容易添加该特性,然后再添加该特性。
无论每次重构多么简单,养成重构后即运行测试的习惯非常重要。 犯错误是很容易的——至少我知道我是很容易犯错的。做完一次修改就运行测试,这样在我真的犯了错时,只需要考虑一个很小的改动范围,这使得查错与修复问题易如反掌。
这就是重构过程的精髓所在:小步修改,每次修改后就运行测试。如果我改动了太多东西,犯错时就可能陷入麻烦的调试,并为此耗费大把时间。小步修改,以及它带来的频繁反馈,正是防止混乱的关键。
- 这章用了巨量的篇幅来修改一个几十行的js代码,从而说明了一个良好的早期架构是有多么的重要,一旦那些架构混乱的项目开始变得复杂,就算是神仙来了也未必能够轻易看懂并重构
关键点: 尽可能多的使用OOP,通过多态,继承,接口来实现代码复用和类型统一;通过将复杂表达式拆分为工具函数并选择合适的名字来增强代码的可读性
ch2: 重构的原则
重构有两种词性,一种是动词,一种是名词:
- 重构(名词):对软件内部结构的一种调整,目的是在不改变软件可观察行为的前提下,提高其可理解性,降低其修改成本。
- 重构(动词):使用一系列重构手法,在不改变软件可观察行为的前提下,调整其结构。
如果我看见一块凌乱的代码,但并不需要修改它,那么我就不需要重构它。如果丑陋的代码能被隐藏在一个 API 之下,我就可以容忍它继续保持丑陋。只有当我需要理解其工作原理时,对其进行重构才有价值。 另一种情况是,如果重写比重构还容易,就别重构了。这是个困难的决定。如果不花一点儿时间尝试,往往很难真实了解重构一块代码的难度。决定到底应该重构还是重写,需要良好的判断力与丰富的经验,我无法给出一条简单的建议。
如果一支团队想要重构,那么每个团队成员都需要掌握重构技能,能在需要时开展重构,而不会干扰其他人的工作。这也是我鼓励持续集成的原因:有了 CI,每个成员的重构都能快速分享给其他同事,不会发生这边在调用一个接口那边却已把这个接口删掉的情况;如果一次重构会影响别人的工作,我们很快就会知道。自测试的代码也是持续集成的关键环节,所以这三大实践——自测试代码、持续集成、重构——彼此之间有着很强的协同效应。
ch3: 代码的坏味道
需要重构的特征有以下几个:
- 难以捉摸的命名
- 重复的代码段
- 函数太长: 将值得用注释说明的部分拆分成函数
- 过长参数列表: 使用类来传入参数
- 全局数据: 用函数或者类来封装这个全局数据,尽量控制其作用域
- 可变数据: 如果一个数据有不同的用途,最好将它按照用途分成不同的类
- 模块边界不清晰
- 修改一次需要在多个地方更改
ch4: 构筑测试体系
确保所有测试都完全自动化,让它们检查自己的测试结果。
频繁地运行测试。对于你正在处理的代码,与其对应的测试至少每隔几分钟就要运行一次,每天至少运行一次所有的测试。
考虑可能出错的边界条件,把测试火力集中在那儿。
每当你收到 bug 报告,请先写一个单元测试来暴露这个 bug。
ch6: 第一组
提炼函数(Extract Function)
用例
| |
对于“何时应该把代码放进独立的函数”这个问题,我曾经听过多种不同的意见。有的观点从代码的长度考虑,认为一个函数应该能在一屏中显示。有的观点从复用的角度考虑,认为只要被用过不止一次的代码,就应该单独放进一个函数;只用过一次的代码则保持内联(inline)的状态。但我认为最合理的观点是“将意图与实现分开”:如果你需要花时间浏览一段代码才能弄清它到底在干什么,那么就应该将其提炼到一个函数中,并根据它所做的事为其命名。以后再读到这段代码时,你一眼就能看到函数的用途,大多数时候根本不需要关心函数如何达成其用途(这是函数体内干的事)。
如果想要提炼的代码非常简单,例如只是一个函数调用,只要新函数的名称能够以更好的方式昭示代码意图,我还是会提炼它;但如果想不出一个更有意义的名称,这就是一个信号,可能我不应该提炼这块代码。不过,我不一定非得马上想出最好的名字,有时在提炼的过程中好的名字才会出现。有时我会提炼一个函数,尝试使用它,然后发现不太合适,再把它内联回去,这完全没问题。只要在这个过程中学到了东西,我的时间就没有白费。
- “如果需要返回的变量不止一个,又该怎么办呢?”
有几种选择。最好的选择通常是:挑选另一块代码来提炼。我比较喜欢让每个函数都只返回一个值,所以我会安排多个函数,用以返回多个值。如果真的有必要提炼一个函数并返回多个值,可以构造并返回一个记录对象—不过通常更好的办法还是回过头来重新处理局部变量
内联函数(Inline Function)
这里的内联指的是将不必要的中间层删除,从而让函数更加清晰
| |
- 这显然与前面说的提炼函数正好相反,从而说明重构并不是一个简单的活儿,你不好判断加入函数和删除函数这两种做法哪一种会让代码更清晰
break&总结
后面的部分都是一些具体用例了,大部分内容都需要真正去实践才能体会,所以就不建议去看了.
提炼一下本书的精华:
- 软件的初步架构需要是合理的,工程化的,否则后期的重构难度甚至超过推翻重写
- 重构一般是一次一小步进行的,如果你的重构会让项目暂时无法运行,说明你做的不是重构
- 重构的方法有以下几种:
- 提炼/删除 函数
- 用类来存放函数和变量
- 去除不必要的全局变量
- 改一个好的名字
- 重构与添加新功能可以是同时进行的
CPython Internals
- 出版于2021年,作者:Anthony Shaw。
- 很烂,烂到无以复加…
C++ CRASH COURSE
- 出版于2019年,作者:Josh Lospinoso。
本书面向已经熟悉基本编程概念的中级到高级程序员。若您没有特定的系统编程经验也没关系,欢迎有经验的应用程序程序员阅读。
C++基础
过于Crash了,讲的不够详细.只好摘抄重点了.
异常处理
先在try代码中抛出异常,再在catch代码中处理异常:
| |
我们可以给那些不可能抛出异常的函数加上noexcept标记,但如果发生了异常,程序会被强行终止:
| |
构造与析构
构造和析构的顺序和栈相同,遵循后构造先析构的顺序.
成员的构造顺序由声明顺序决定:
| |
上述代码中,会先构造A,再构造B.
Copy Semantics
Copy semantics is “the meaning of copy.”
也就是说,x被复制到y后,二者是相互独立的,对x的修改不会影响到y.
Move Semantics
移动语义是拷贝语义在移动操作上的对应概念,它要求将对象 y 移入对象x后,x等价于 y原先的值。移动完成后,y 处于一种特殊状态,称为 “ 已移动状态 ” 。对于已移动状态的对象,你只能执行两种操作:(重新)赋值或销毁它们
总结
学不下去了,太繁琐了😁日后有需要再来
Crafting Interpreters
- 出版于2021年,作者:Robert Nystrom。
概览
自举
- 自举: 使用语言C编写语言C的编译器.最开始,我们需要用其他语言实现的编译器来编写语言C的编译器,再用这个编译器来编译得到全部使用语言C编写的编译器,然后就可以把以前那个编译器扔掉了.
至于最开始的编译器是怎么实现的?那自然是用汇编语言写的了,而将符号汇编语言转成二进制机器码也需要一个编译器,这个编译器自然就是用二进制机器码写的了,至于是如何实现的,我简直不敢想象
完整的编译器实现
程序编译分成多步:
- 扫描/语法分析: 扫描器将高级语言的代码分割成不同的词法单元
- 解析: 根据词法单元序列构建出语法树(abstract syntax tree,AST)
- 静态分析: 分析语法树中各个变量的关系,如数据类型和是否为全局变量
上述三步称为编译器的前端. 4. 中间表示: intermediate representation(IR),将代码以一种中间语言存储,只需要针对中间语言来开发不同处理器架构的后端即可,而不需要改动前端.尽管很方便,但很多语言并不会在这一步生成中间代码,而是留待代码生成阶段再生成类似的形式 5. 优化: 使用各种编译处理来优化代码的运行速度,如循环展开和变量提取.
这两步称为编译器的中端. 6. 代码生成: 将中间代码/抽象语法树根据不同的处理器架构生成对应的汇编代码,或者,为一个虚拟机生成虚拟的指令集代码,如今称为字节码(bytecode),这是因为这类代码通常用单个字节构建而成 7. 虚拟机: 如果编译器生成了字节码,就可以用C语言编写一个虚拟机,那么任何支持C编译器的平台都可以运行该虚拟机,执行该语言的字节码,这也是为什么Java能够"一次编译,处处运行”. 8. 运行时(runtime): 如果之前已经编译成机器码,那么我们只需要用操作系统加载可执行文件即可,如果编译成了字节码,那么就启动虚拟机并装载程序.程序执行过程中,我们需要能够支持垃圾回收,对象追踪等功能,这些被统称为运行时.
上述过程就是编译器的后端.
其他类型的编译器
- single-pass compiler: 不生成语法树或者中间代码,需要源代码提供足够的信息,用于压缩编译占用的内存,如Pascal和C语言的编译器,这也解释了为何Pascal的语法规定类型声明必须位于代码块的开头;以及为何在C语言中,除非使用显式的前向声明告知编译器生成后续函数调用所需的信息,否则无法在函数定义代码上方调用该函数。
- tree-walk interpreter: 生成语法树后就立刻开始执行,也是这本书要制作的第一个解释器
- transpiler: 转译器,例如Typescript转译成Javascript,Javascript XML转译成Javascript.
- Just-in-time compilation(即时编译): 对于使用虚拟机和字节码的语言例如Java和C#来说,执行字节码还是太慢了,即时编译会将字节码编译成所在平台的汇编代码,从而加速代码的执行,如Java的HotSpot虚拟机.
编译器与解释器
- 编译器: 将源代码转换成另一种形式,但不会执行该代码,用户需要自己额外用命令运行它
- 解释器: 接收源代码并立即执行
例如CPython,它在内部将python代码转换成字节码,并用虚拟机立即执行它,因此它既是解释器也包含了编译器.
总结
具体实现的内容真的不太有耐心看下去呢,因为太过割裂了,以后有机会我或许会再来阅读一次吧.
Data Storage Architectures and Technologies
- 出版于2024年(英文版),作者:舒继武。
简介
一开始是从Zlib上看到了英文版,觉得可能很适合我,随意地翻阅了一下,发现果然是本比较优秀的教材,后来发现原来这书是先出的中文版嘛,叫做数据存储架构与技术 (第2版)
简要介绍
数据存储性能通常以吞吐量和延迟来衡量。吞吐量指单位时间内存储系统能处理的操作数量,而延迟则是完成单次操作所需的时间
数据存储的另一个目标是高可用性(high usability),这能提升上层应用与存储系统之间的交互效率,包括更快速的数据写入和更高效的读取操作,也就是说要能设计出一个良好的接口供其他人使用
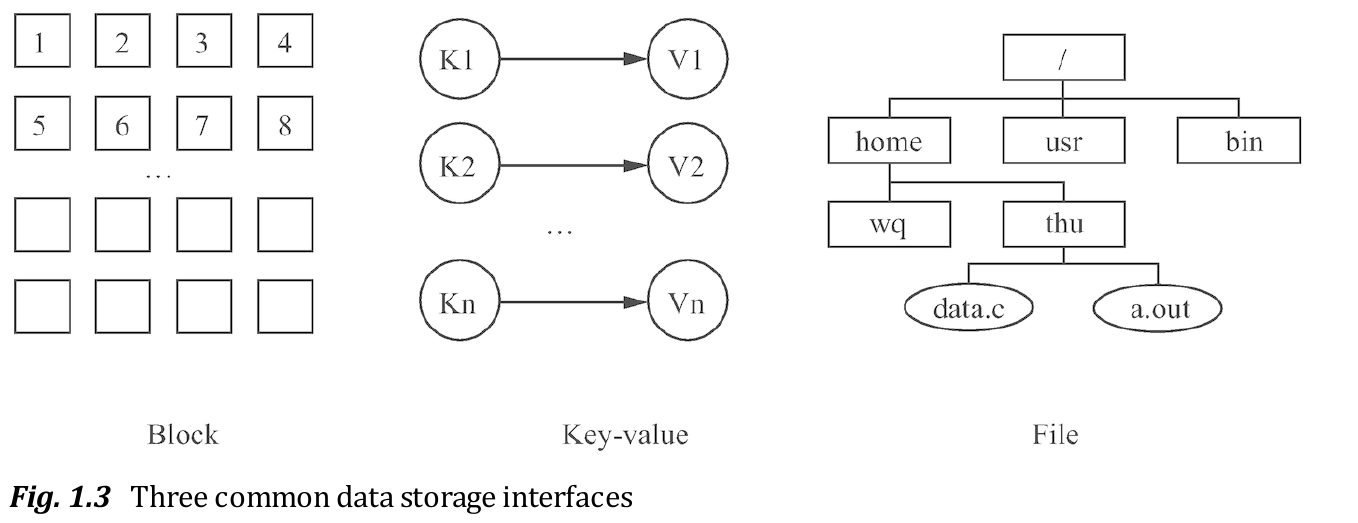
高可靠性(High Reliability)存储能够在系统异常(包括磁盘、服务器和网络故障以及人为错误)时防止数据丢失和服务中断,实现高可靠性最基础的方法之一是利用数据冗余,最著名的就是RAID了,通过多副本和纠错码,能够大幅度降低出错的概率.
存储介质
磁存储介质利用磁性粒子的磁极来记录数据,两种磁化方向分别代表数据“0”和“1”。采用磁存储介质的常见存储盘有磁盘和磁带。电存储介质利用存储单元中存储的电子数量来记录数据,电子数量影响位线的电平,表示数据“0”或“1”。采用电存储介质的常见存储盘包括闪存和动态随机存取存储器。对于光存储介质,使用激光照射介质,使介质发生物理或化学变化来表示“0”和“1”。采用光存储介质的常见存储盘有CD光盘、DVD光盘、蓝光光盘和归档光盘。
HDD(hard disk drives)-硬盘驱动器,也被称为机械硬盘
机械硬盘由于需要等待盘片的旋转和磁头的定位时间,所以在性能上并没有多好,但由于价格便宜,所以仍然在不断发展和改进中.
SSD(solid-state drives)-固态硬盘
目前,固态硬盘主要使用闪存或其他非易失性内存芯片,如相变存储器。
- 可以发现SSD的结构比起HDD来相当复杂.
由于闪存是一种electrically erasable programmable read-only memory,所以每次写入新数据时都要进行擦写,而一个存储单元的擦写次数是有上限的,一旦达到这个上限,SSD也就等于失效了.为延长SSD寿命,闪存转换层采用磨损均衡策略,尽可能将擦写次数均匀分配给所有页面
Main Memory
目前,主存储器普遍使用DRAM介质,如名字所说,是Random Access的,所以存取速度极快.
剩余部分
介绍了PCM,RRAM,MRAM等新型结构,不太需要关注.
Storage Arrays
简单介绍了一下RAID等阵列结构
存储协议
目前,计算机存储架构主要采用存储块协议,按照固定数据块大小的倍数对存储设备进行数据访问。典型的存储块协议包括SCSI(Small Computer System Interface)协议和专门为SSD设计的NVMe(non-volatile memory express)协议
而具体原理可以说是相当的复杂,所以不深入了.
键-值存储
简单介绍了B+树,LSM树
文件系统
有一个非常好的引入!
网络存储架构
DAS: direct-attached storage
DAS这一概念是在网络存储技术出现后才被提出的。与网络存储不同,DAS不涉及网络或网络设备。任何将硬盘驱动器(HDD)或固态硬盘(SSD)直接连接至计算机的存储架构,均可称为DAS。
NAS: network-attached storage
客户可以通过各种基于网络的文件访问协议(如NFS和CIFS)在NAS系统上操作文件
NFS协议由SUN公司于1984年提出,允许用户如同访问本地文件一样访问远程服务器上的文件。该协议采用基于远程过程调用(RPC)机制的客户端/服务器模型。由于具有高性能和高灵活性,NFS已成为UNIX和Linux系统中最流行的网络文件访问协议。
CIFS 由微软提出,通常用于 Windows 主机之间的网络文件共享。与 NFS 协议不同,CIFS 协议是面向网络连接的,要求网络可靠性较高。此外,CIFS 是一种有状态协议,对故障非常敏感。
SAN: storage area network
广义而言,任何能够实现计算机、专用存储网络与存储设备互联的存储形式均可称为SAN。不过,由于光纤通道(FC)协议在商业上的成功,SAN这一术语已逐渐成为基于FC的网络存储架构的代名词。
总结
总的来说还是比较全面详细的.值得一读
Designing APIs with Swagger and OpenAPI
- 出版于2022年,出版商:Manning,作者:Joshua S. Ponelat。
Describing APIs
Introducing APIs and OpenAPI
OpenAPI 是一种基于HTTP协议的API,采用Yaml或者Json形式来描述API的输入输出.
- Yaml是Json的完全超集,所以可以自由地在Yaml中使用Json的
{}和[]语法,分别对应map和list的写法.
一开始我们使用Swagger UI来大致描述API的写法,后来越来越多的工具附着在Swagger UI上,最终被称为Swagger,由Linux基金会管理,更名为OpenAPI规范,而Swagger则用来称呼将OpenAPI文档转变成可视化网页的工具.
使用OpenAPI
核心部件
| |
上述yaml包含了路由,请求方法和对请求方法的响应,一定的描述.
加上请求参数
| |
Describing API responses
| |
- content: 必须声明一个Media types (aka MIME),常用的有
text/html,image/png,application/json等类型. - properties: 存放所有的查询参数
创建资源
部分http方法(如POST,PATCH)可以声明请求体:
| |
身份验证
| |
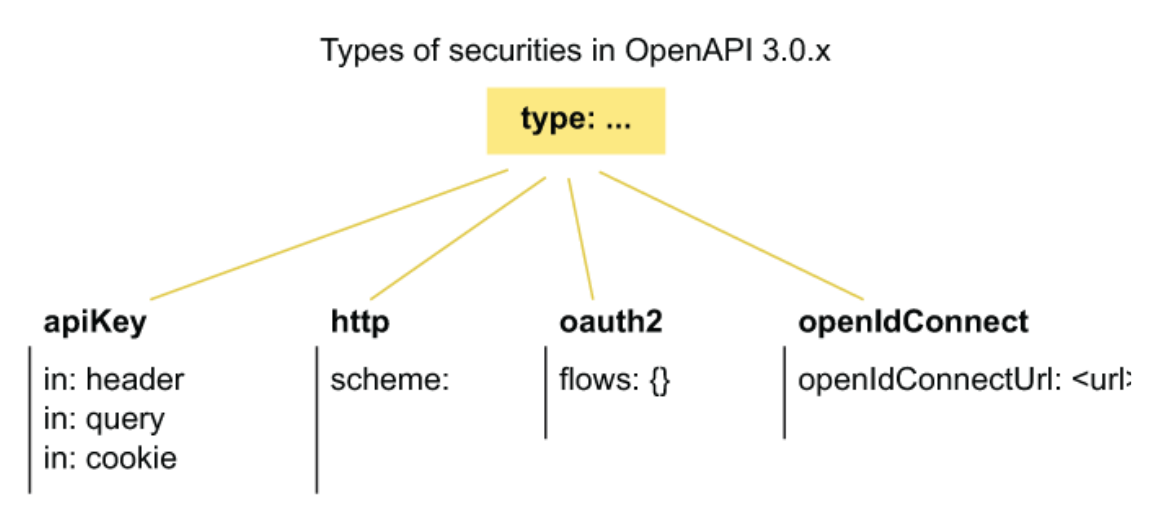
设计
ch9
这一章很有意思,详细描述了设计数据库的完整过程.
总结
这本书还是很不错的,完美体现了OpenAPI在前后端开发中的必要性.
第一行代码(待补充)
- 谁能想到我连Android Studio的模拟器都打不开呢,直接就折戟沉沙了,过会时候再来吧.
Docker 从入门到实践
比官方文档要简洁清晰的多
Docker简介
无论你的应用是用 Python、Java、Node.js 还是其他语言写的,无论它需要什么样的依赖库和环境,一旦被打包成 Docker 镜像,就可以用同样的方式在任何支持 Docker 的机器上运行.
- 也就是说,通过将依赖和软件打包在一起,我们成功实现了无缝的跨环境运行
Docker不是虚拟机
传统虚拟机技术是虚拟出一套完整的硬件,在其上运行一个完整的操作系统,再在该系统上运行应用
而 Docker 容器内的应用直接运行于宿主的内核,容器内没有自己的内核,也没有进行硬件虚拟
Docker历史
Docker 最初是 dotCloud 公司创始人 Solomon Hykes 在法国期间发起的一个公司内部项目,于 2013 年 3 月以 Apache 2.0 授权协议开源
- 很难想象这么优秀的技术竟然只有十年多一点的历史
Docker的核心优势
环境一致性
Docker 镜像包含了应用运行所需的 一切:代码、运行时、系统工具、库、配置。这意味着:
- 开发环境和生产环境完全一致
- 不会再有 “在我机器上能跑” 的问题
快速启动
传统虚拟机启动需要几分钟 (引导操作系统),而 Docker 容器启动通常只需要 几秒甚至几百毫秒
- 当然这得要你先构建好了镜像和容器
Docker 的核心价值可以用一句话概括:让应用的开发、测试、部署保持一致,同时极大提高资源利用效率。 笔者认为,对于现代软件开发者来说,Docker 已经不是 “要不要学” 的问题,而是 必备技能。无论你是前端、后端、运维还是全栈开发者,掌握 Docker 都能让你的工作更高效。
基本概念
Docker里有三个基本概念:
- 镜像(Image): Docker 镜像是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数 (如匿名卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。
- 容器 (Container):镜像 (Image) 和容器 (Container) 的关系,就像是面向对象程序设计中的 类 和 实例 一样,镜像是静态的定义,容器是镜像运行时的实体。容器可以被创建、启动、停止、删除、暂停等。
- 仓库 (Repository):镜像构建完成后,可以很容易的在当前宿主机上运行,但是,如果需要在其它服务器上使用这个镜像,我们就需要一个集中的存储、分发镜像的服务,Docker Registry 就是这样的服务。
镜像
Docker 镜像是一个只读的模板,包含了运行应用所需的一切:代码、运行时、库、环境变量和配置文件。 如果用一个类比:镜像就像是一张光盘或 ISO 文件。你可以用同一张光盘在不同电脑上安装系统,而光盘本身不会被修改。同样,一个镜像可以创建多个容器,而镜像本身保持不变。
镜像的组成部分
| 类别 | 示例 |
|---|---|
| 程序文件 | 应用二进制文件、Python/Node 解释器 |
| 库文件 | libc、OpenSSL、各种依赖库 |
| 配置文件 | nginx.conf、my.cnf 等 |
| 环境变量 | PATH、LANG 等预设值 |
| 元数据 | 启动命令、暴露端口、数据卷定义 |
- 镜像是只读的
- 镜像不包含动态数据
- 镜像构建后内容不会改变
镜像的分层存储
| |
换句话说,只要某一行命令对镜像做了修改,就被docker视为单独的一个构建层,不可以被其他构建层修改,但可以与其他镜像共享
镜像标识
镜像名称和标签
| |
镜像ID
| |
镜像摘要 镜像摘要是基于镜像内容生成的哈希码
| |
容器
容器是镜像的运行实例。如果把镜像比作程序,那么容器就是进程。 用面向对象编程的术语来说:镜像是类 (Class),容器是对象 (Instance)。
容器的本质
笔者认为,理解这一点是理解 Docker 的关键:容器的本质是一个特殊的进程
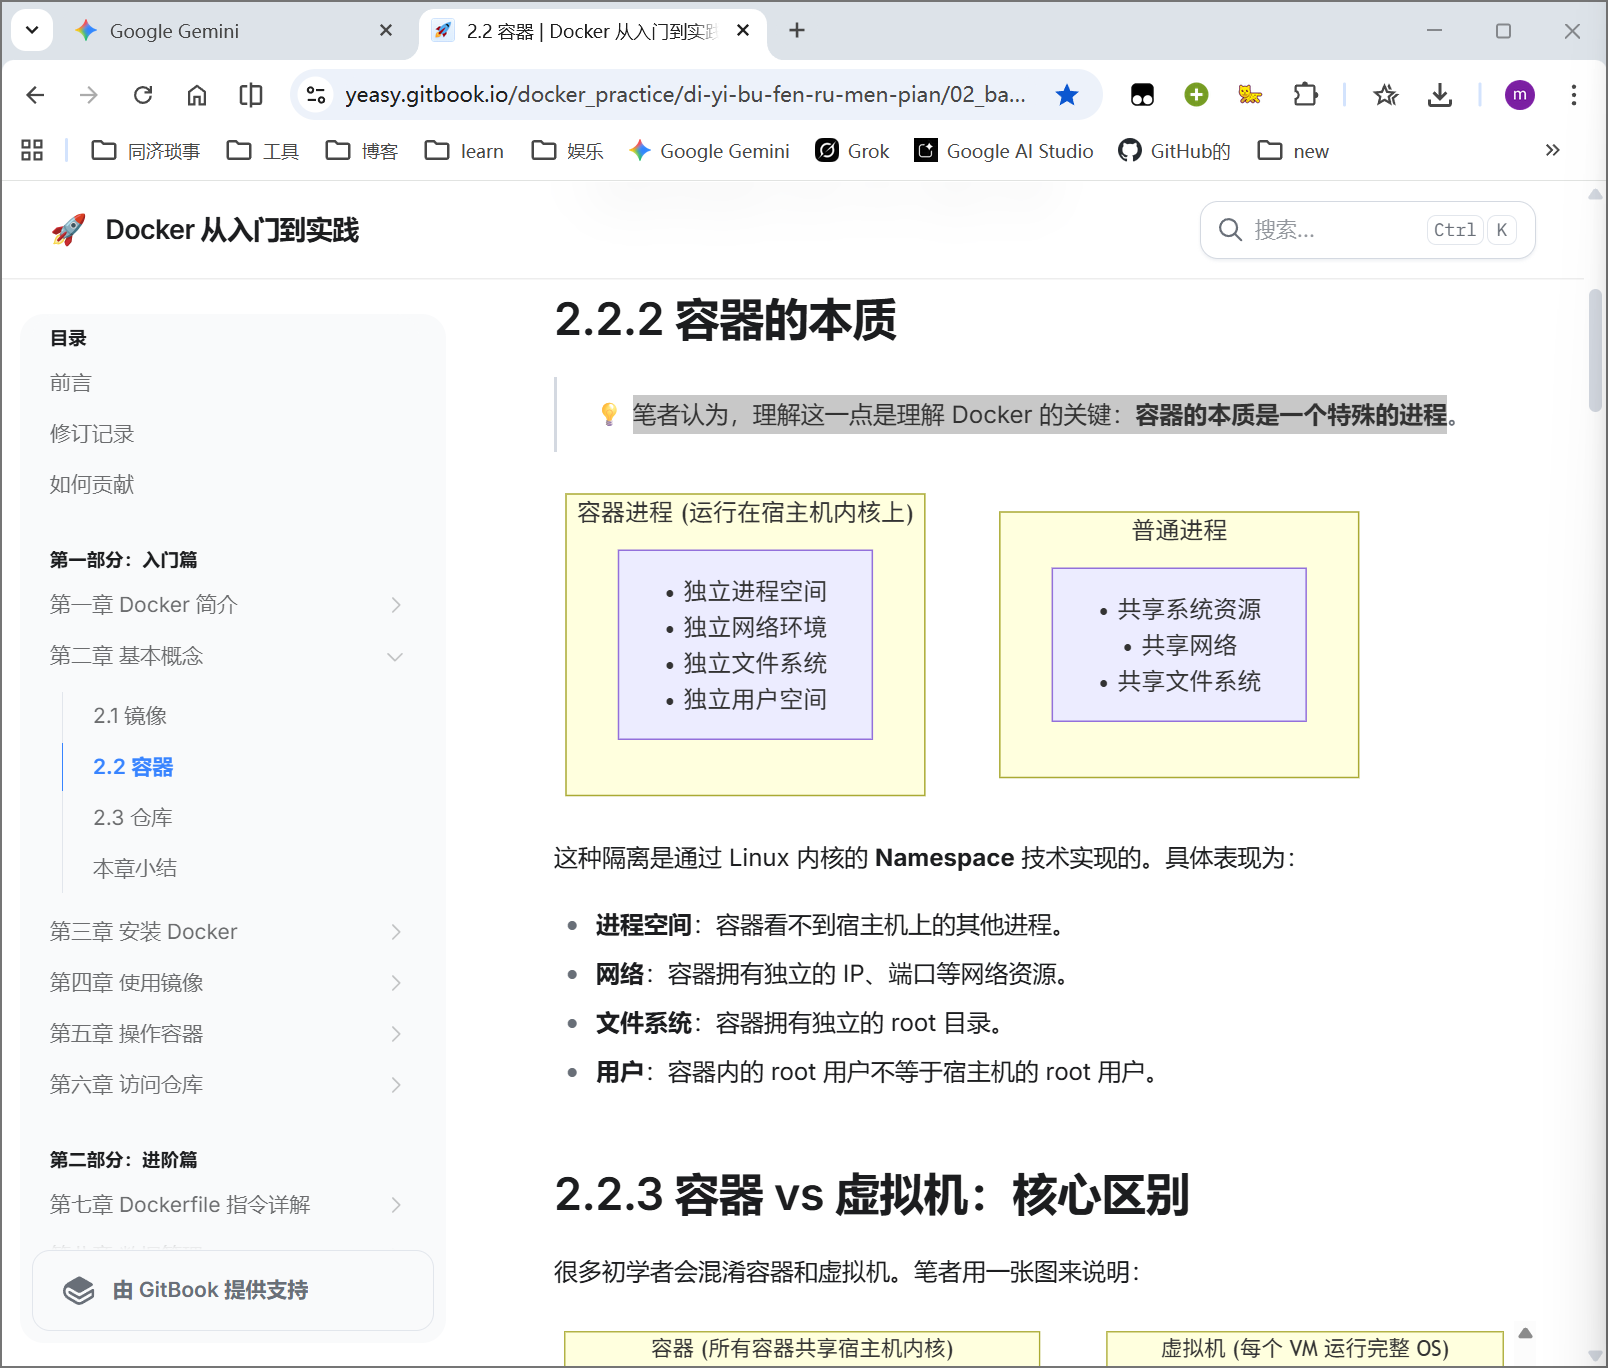
这种隔离是通过 Linux 内核的 Namespace 技术实现的。具体表现为:
- 进程空间:容器看不到宿主机上的其他进程。
- 网络:容器拥有独立的 IP、端口等网络资源
- 文件系统:容器拥有独立的 root 目录。
- 用户:容器内的 root 用户不等于宿主机的 root 用户。
容器的存储层机制
当容器运行时,Docker 会在镜像的只读层之上创建一个可写层(容器存储层);
而当容器需要修改镜像层中的文件时:
- Docker将该文件复制到容器存储层
- 在容器存储层中进行修改
- 原始镜像层保持不变
| |
既然当容器被删除后数据就全部丢失,那么容器存储层就不应该保留任何重要的信息,而是只保留运行时数据.
- 如果我们想要存储数据,可以使用数据卷(Volume)来存储数据库和应用数据,或者使用绑定到宿主机的目录.
| |
容器的生命周期
| |
仓库
Docker Registry 是存储和分发 Docker 镜像的服务,类似于代码的 GitHub 或包管理的 npm。
Docker Registry 中可以包含多个 Repository,每个 Repository 可以包含多个 Tag:
| 概念 | 说明 | 示例 |
|---|---|---|
| Registry | 存储镜像的服务 | Docker Hub、ghcr.io |
| Repository (仓库) | 同一软件的镜像集合 | nginx、mysql、mycompany/myapp |
| Tag (标签) | 仓库内的版本标识 | latest、1.25、alpine |
一个完整的 Docker 镜像名称由 Registry 地址、用户名/组织名、仓库名和标签组成。了解其结构有助于我们更准确地定位镜像。基本格式如下:
[registry 地址/][用户名/]仓库名[:标签]
完整示例如下:
| |
公共 Registry
Docker Hub 是最大的公共 Registry,也是 Docker 的默认 Registry,有以下特点:
- 拥有大量官方镜像(nginx、mysql、redis)
- 免费账户可以创建公开仓库
- 付费账户支持私有仓库
除了 Docker Hub,还有以下几个常见的公共 Registry:
| Registry | 地址 | 说明 |
|---|---|---|
| GitHub Container Registry | ghcr.io | GitHub 提供,与 GitHub Actions 集成好 |
| Google Container Registry | gcr.io | Google Cloud 提供,Kubernetes 镜像常用 |
| Quay.io | quay.io | Red Hat 提供 |
| 阿里云容器镜像服务 | registry.cn-*.aliyuncs.com | 国内访问快 |
| 腾讯云容器镜像服务 | ccr.ccs.tencentyun.com | 国内访问快 |
安装docker
如果是Windows端,开启WSL2后下载官方软件即可运行 如果是Linux端,尽管文章里给了一堆命令,但现在有Dokploy了.如果是部署在国外服务器上或者自己学习使用的话,使用Dokploy就没必要操心那么多了.
Dokploy
支持Dokploy的目前有以下服务器厂商:
- Hostinger
- AmericanCloud
- Teramont
- Hetzner
- DigitalOcean
- Vultr
- Linode
- Scaleway
- Google Cloud
- AWS 而Dokploy目前可以在以下系统里部署:
- Ubuntu 24.04 LTS
- Ubuntu 23.10
- Ubuntu 22.04 LTS
- Ubuntu 20.04 LTS
- Ubuntu 18.04 LTS
- Debian 12
- Debian 11
- Debian 10
- Fedora 40
- Centos 9
- Centos 8
换句话说,主流的Linux操作系统现在都支持Dokploy了
Dokploy is a stable, easy-to-use deployment solution designed to simplify the application management process. Think of Dokploy as your free self hostable alternative to platforms like Heroku, Vercel, and Netlify, leveraging the robustness of Docker and the flexibility of Traefik.
- Dokploy本身就是为了简化在Linux服务器部署Docker而产生的
Dokploy utilizes Docker, so it is essential to have Docker installed on your server. If Docker is not already installed, Dokploy’s installation script will install it automatically.
- 甚至都不用提前安装docker,易用性可见一斑
部署
前置要求
To ensure a smooth experience with Dokploy, your server should have at least 2GB of RAM and 30GB of disk space. This specification helps to handle the resources consumed by Docker during builds and prevents system freezes.
- 官方推荐使用Hetzner的服务器来省钱
避免以下端口被占用:
- Port 80: HTTP traffic (used by Traefik)
- Port 443: HTTPS traffic (used by Traefik)
- Port 3000: Dokploy web interface
我们只需要运行以下命令便可以在服务器的3000端口访问dokploy界面:
| |
第一次进入dokploy界面时需要我们注册管理员账户,然后就可以在面板里部署自己的docker项目了,要进一步了解的话还是去看官方文档吧.
使用镜像
获取镜像
docker pull用于从镜像仓库获取镜像:
| |
镜像名称的标准格式如下:
| |
| 组成部分 | 说明 | 默认值 |
|---|---|---|
| Registry 地址 | 镜像仓库服务的域名或 IP 地址 | docker.io (Docker Hub) |
| 用户名 | 镜像所属的用户、组织或命名空间 | library (官方镜像默认路径) |
| 仓库名 | 镜像的具体名称 | 必须指定 |
| 标签 (Tag) | 镜像的版本标识或分类标签 | latest |
示例
| |
- 镜像是分层下载的,如果本地已经有相同的层(这可以通过ID来识别),那么就会跳过该层继续下载
docker pull常用参数
| 选项 | 说明 | 示例 |
|---|---|---|
| –all-tags, -a | 下载仓库中该镜像的所有版本标签 | docker pull -a ubuntu |
| –platform | 在多架构镜像中指定运行平台(如 arm64, amd64) | docker pull --platform linux/arm64 nginx |
| –quiet, -q | 静默模式,只输出镜像 ID,不显示拉取进度详情 | docker pull -q nginx |
管理镜像
docker image ls
基本用法
| |
| 字段 | 说明 |
|---|---|
| REPOSITORY | 镜像仓库名称 |
| TAG | 镜像的标签(通常代表版本号) |
| IMAGE ID | 镜像的唯一标识符(取 SHA-256 哈希值的前 12 位) |
| CREATED | 镜像在构建服务器上被创建的时间 |
| SIZE | 镜像解压后在本地磁盘占用的实际空间 |
- 上面的 ubuntu:24.04 和 ubuntu:noble 拥有相同的 IMAGE ID——它们是同一个镜像的不同标签,只占用一份存储空间。
查找镜像
可以根据名字来找镜像:
| |
镜像删除
docker rmi/docker image rm
这两个命令等价,用于删除单个镜像:
使用ID删除
| |
使用镜像名删除
| |
- Untagged:移除镜像标签
- Deleted: 删除镜像的存储层
docker image prune
| |
- 虚悬镜像 (dangling):没有标签且未被容器引用的镜像,通常是旧版本被新版本覆盖后产生的
操作容器
启动容器
由于 Docker 容器非常轻量,实际使用中常常是随时删除和新建容器,而不是反复重启同一个容器。
基本语法
| |
基本例子
| |
基础选项
| 选项 | 说明 | 示例 |
|---|---|---|
-d | 后台运行容器(detach) | docker run -d nginx |
-it | 分配交互式终端 | docker run -it ubuntu bash |
--name | 为容器指定自定义名称 | docker run --name myapp nginx |
--rm | 容器退出后自动删除 | docker run --rm ubuntu echo hi |
端口映射
| |
运行容器
当你在终端运行一个程序时,有两种模式:
前台运行:程序占用当前终端,输出直接显示,关闭终端程序就停止 后台运行:程序在后台执行,不占用终端,终端关闭也不影响程序 Docker 容器默认是 前台运行 的。使用 -d (detach) 参数可以让容器在后台运行
前台运行
| |
容器会把输出的结果 (STDOUT) 打印到宿主机上面。此时:
- 终端被占用,无法执行其他命令
- 按 Ctrl+C 会终止容器
- 关闭终端窗口,容器也会停止
后台运行
| |
使用 -d 参数后:
- 容器在后台运行
- 返回容器的完整 ID
- 终端立即释放,可以继续执行其他命令
- 输出不会直接显示 (需要用 docker logs 查看)
终止容器
终止容器有三种方式:
| 方式 | 命令 | 说明 |
|---|---|---|
| 优雅停止 | docker stop | 先发 SIGTERM,超时后发 SIGKILL |
| 强制停止 | docker kill | 直接发送 SIGKILL 信号 |
| 自动终止 | - | 容器主进程退出时自动停止 |
我们还可以在镜像被修改后重启容器
| |
删除容器
随着容器的创建和停止,系统中会积累大量的容器。
使用 docker rm 删除已停止的容器:
| |
- 该命令与docker container rm等效
使用 docker container prune 批量删除:
| |
补充部分: 镜像的文件结构
非常离谱的是,这么详细的文档偏偏没有提到这一点: 镜像内部是怎么存放文件的?
自然,镜像是分层构建存储的,但是这些构建层显然要有个地方放吧.
镜像的默认工作目录是根目录,类似于Linux的根目录,当我们需要切换存储目录或者启动某个目录下的脚本时,,可以显式指明,比如说以下的几个命令:
| |
- 如此一来,我们成功的将本地文件复制到了app文件夹中.
因此,镜像不仅仅是一个iso,我们可以把它抽象成一个文件系统,存储层堆叠在不同的目录中,可以来回切换访问.
dockerfile编写
概览
Dockerfile 是一个文本文件,其内包含了一条条的 指令 (Instruction),每一条指令构建一层,因此每一条指令的内容,就是描述该层应当如何构建。
Dockerfile不是脚本,而是镜像的"设计图"。这个区别决定了你如何思考每条指令的作用:
- 合并命令:应将
RUN apt-get update && apt-get install -y ...写入同一个RUN指令中,因为它们是同一层的逻辑 - 优化镜像大小:最后才清理缓存、删除临时文件,让这些"瘦身"操作在同一层完成
(补充)FROM: 基础镜像
很多时候我们都需要在官方镜像的基础上进行构建,这个时候我们可以这么写:
| |
这个AS与python中的as一样,都是为导入的镜像重新设一个名字.
- 事实上,如果你不写任何FROM,根本无法运行任何Linux命令
而FROM命令最厉害的地方在于,每一个FROM指令都会重新开辟一个新的文件系统,取代之前的所有内容.
因此,我们可以这么写:
| |
这样既可以利用上一个阶段的构建内容,又不会将多余的内容打包进镜像
RUN: 执行命令
RUN 是 Dockerfile 中最常用的指令,主要用于在镜像构建阶段执行命令来修改镜像,有以下几个应用场景:
- 安装依赖:
RUN apt-get install nginx - 编译程序:
RUN gcc -o app main.c - 下载文件:
RUN curl -O https://example.com/file.tar.gz - 配置系统:
RUN mkdir -p /app/data
理解 RUN 的核心是理解镜像分层:每一个 RUN 都会在当前层之上创建新的一层,这会影响镜像大小。因此,合理使用 RUN(特别是合并多个 RUN)是构建轻量级镜像的关键。
基本语法
有两种格式:
| |
shell格式
| |
- 默认通过 /bin/sh -c 执行。
- 可以使用环境变量、管道、重定向等 Shell 特性。
exec格式
| |
- 直接调用可执行文件,不经过 Shell。
- 无法使用 $VAR 环境变量替换 (除非显式调用 shell)
实战
由于每一个 RUN 指令都会新建一层镜像。为了减少镜像体积和层数,应使用 && 连接命令:
| |
- 可以看到dockerfile将\用于换行,这与makefile的写法一致
COPY: 复制文件
COPY 是在构建镜像时,将构建上下文(Dockerfile 所在目录及其子目录)中的文件或目录复制到镜像内的指令。它是处理应用代码、配置文件最常用的方式,应用场景如下:
COPY . /app(应用源码)COPY nginx.conf /etc/nginx/nginx.conf(配置文件)COPY public /app/public(静态资源)
基本语法
| |
复制文件
| |
复制目录
| |
指定路径
| |
dockerignore
排除不需要复制的文件,精简镜像体积
| |
实战
| |
详细解释一下,docker构建镜像是线性操作的,只有COPY,RUN,ADD三种命令会创建新的存储层,而每次构建时docker都会在本地存储缓存,如果下一次构建镜像时对应的命令没有变化,则会直接复用原来的缓存,不会重新构建;当docker发现COPY的文件内容有改动时,该行之后的所有命令被视为与原缓存不同,需要重新构建.
因此,如果直接写COPY . .的话,修改任何一个文件后构建镜像都要重新运行npm install;但如果把COPY . .放在后面,只会在package.json变化时重新构建.
ADD: 更高级的COPY
实践中的建议:除非你明确需要自动解压功能(比如官方基础镜像构建根文件系统),否则始终使用 COPY。原因很简单——显式优于隐式。你的 Dockerfile 在 6 个月后被接手维护时,清晰的意图会让团队少走很多弯路。
基本用法
| |
ADD 在 COPY 基础上增加了两个功能:
- 自动解压 tar 压缩包
- 支持从 URL 下载文件 (不推荐)
CMD: 容器启动命令(4/10)
在深入 CMD 的细节之前,我们需要理解一个关键问题:CMD 和 ENTRYPOINT 应该在什么时候使用?
这是 Dockerfile 使用中最常见的困惑之一。简单的答案是:
- CMD:定义容器的”默认命令”。如果用户在 docker run 时提供命令,CMD 会被覆盖
- ENTRYPOINT:定义容器的”入口脚本”。通常用于启动应用的某个特定部分
基本用法
CMD指令用于指定容器启动时默认执行的命令。它定义了容器的 “主进程”。
| 格式类型 | 语法示例 | 推荐程度 | 核心机制 |
|---|---|---|---|
| Exec 格式 | CMD ["executable", "param1", "param2"] | ✅ 推荐 | 直接由内核执行,PID 为 1,可接收 SIGTERM 信号。 |
| Shell 格式 | CMD command param1 param2 | ⚠️ 简单场景 | 通过 /bin/sh -c 调用,无法直接接收信号,环境变量会被解析。 |
| 参数格式 | CMD ["param1", "param2"] | ⚓ 配合使用 | 仅作为 ENTRYPOINT 的默认参数传递。 |
exec 格式
| |
shell格式
| |
实际执行:会被包装为 sh -c
| |
- 换句话说shell写法实际上是使用了sh的exec简写格式.
CMD命令只能写一个
多个CMD只有最后一个生效.
因为CMD的PID为1,意思是在Linux内核中它作为根进程,是独一无二的.因此CMD一旦停止,容器就关闭了.
ENTRYPOINT: 入口点(4/11)
如果说 CMD 是"容器中的默认程序",那么 ENTRYPOINT 就是"把容器变成一个命令"。这个思维转变决定了你何时使用 ENTRYPOINT。
是什么,怎么用
ENTRYPOINT 指定容器启动时运行的入口程序。与 CMD 不同,ENTRYPOINT 定义的命令不会被 docker run 的参数覆盖,而是 接收这些参数。
基本语法
| |
ENV: 设置环境变量
- 很好理解,就是设置了一个dockerfile中的变量而已.
| |
例子
| |
用法
使用 -e 或 –env 覆盖 Dockerfile 中定义的环境变量:
| |
运行时传入密码:
| |
使用docker compose的话就没必要考虑这么多了
ARG: 构建参数
ARG仅在构建时生效,用于传递版本号之类的信息,可以出现在FROM指令之前,也能在docker build阶段传入对应的参数.换句话说,我们可以更改构建初始镜像所用的版本号.
而ENV则会被打包进入镜像,在容器运行期间永久生效,也不能出现在FROM指令之前.
基本语法
| |
用法
| |
VOLUME: 定义匿名卷
是什么,怎么用
容器存储层应该保持无状态,任何运行时数据都应该存储在volume中。
| |
volume的行为
自动创建匿名卷 如果运行时未指定挂载,Docker 会自动创建匿名卷:
| |
会被命名卷覆盖
| |
VOLUME 之后对该目录的修改会被丢弃!
| |
原因:在构建过程中,VOLUME 指令会为该目录创建一个临时的匿名卷。后续 RUN 指令对该目录的写入实际发生在这个临时卷中,而非镜像层。当该 RUN 指令结束后,临时卷被丢弃,因此写入的内容不会保存到最终镜像中。注意:这与容器运行时创建的匿名卷是不同的——运行时创建的卷会在容器生命周期内持续存在。
正确做法
| |
在compose中使用
| |
EXPOSE: 暴露端口(4/12)
是什么,怎么用
EXPOSE 声明容器运行时提供服务的端口。这是一个文档性质的声明,告诉使用者容器会监听哪些端口。
- 换句话说只起一个约定作用,不通过-p的话不会起作用
基本用法
| |
使用 docker run -P 时,Docker 会自动映射 EXPOSE 的端口到宿主机随机端口:
| |
实战
| |
| |
compose中的编写
| |
WORKDIR: 指定工作目录
WORKDIR 指定后续指令的工作目录。如果目录不存在,Docker 会自动创建。
基本用法
| |
| |
实战
使用绝对命令
| |
USER: 指定当前用户
是什么,怎么用
USER 指令切换后续指令 (RUN、CMD、ENTRYPOINT) 的执行用户
| |
- 一般是用不上这个的
HEALTHCHECK: 健康检查
是什么,怎么用
HEALTHCHECK 指令告诉 Docker 如何判断容器状态是否正常。这是保障服务高可用的重要机制。
| |
基本用法
| |
| 选项 | 说明 | 默认值 |
|---|---|---|
--interval | 两次检查的间隔 | 30s |
--timeout | 检查命令的超时时间 | 30s |
--start-period | 启动缓冲期 (期间失败不计入次数) | 0s |
--retries | 连续失败多少次标记为 unhealthy | 3 |
应用启动可能需要时间 (如 Java 应用)。设置 –start-period 可以防止在启动阶段因检查失败而误判
| |
LABEL: 为镜像添加元数据
是什么,怎么用
LABEL 指令以键值对的形式给镜像添加元数据。这些数据不会影响镜像的功能,但可以帮助用户理解镜像,或被自动化工具使用。
- 版本管理:记录版本号、构建时间、Git Commit ID
- 联系信息:维护者邮箱、文档地址、支持渠道
- 自动化工具:CI/CD 工具可以读取标签触发操作
- 许可证信息:声明开源协议
| |
| |
数据管理
这一章介绍如何在 Docker 内部以及容器之间管理数据,在容器中管理数据主要有以下几种方式:
- 数据卷
- 挂载主机目录
- tmpfs 挂载
数据卷
容器的存储层有一个关键问题:容器删除后,数据就没了。数据卷 (Volume) 解决了这个问题,它的生命周期独立于容器。
创建和查看数据卷
| |
关键字段:
- Mountpoint:数据卷在宿主机上的实际存储位置
- Driver:存储驱动 (默认 local,也可以用第三方驱动)
挂载数据卷
方式一:–mount:推荐
| |
| 参数 | 说明 |
|---|---|
source | 数据卷名称 (不存在会自动创建) |
target | 容器内挂载路径 |
readonly | 可选,只读挂载 |
| 方式二:-v:简写 |
| |
提示:官方更推荐使用 –mount。除了语法格式可读性更好之外,最重要的行为差异发生在 绑定挂载 (Bind Mount) 时:如果挂载的宿主机源路径尚未存在,-v 会擅自将其自动创建为一个空目录;而 –mount 则会严格检查并直接报错。这能有效避免因路径拼写错误而在宿主机上留下垃圾目录(以及导致的容器访问空目录问题)。而对于本节的 数据卷 (Volume) 挂载而言,两者在目标指定的卷不存在时皆会自动创建卷,产生的结果是 完全一致 的。
实战
数据库持久化
| |
多容器共享数据
| |
配置文件持久化
| |
挂载主机目录
绑定挂载
Bind Mount (绑定挂载) 将 Docker daemon 所在主机 上的目录或文件直接挂载到容器中。容器可以读写这台主机上的文件系统。 Bind Mount vs Volume
| 特性 | Bind Mount (绑定挂载) | Volume (数据卷) |
|---|---|---|
| 数据位置 | 宿主机任意路径 | Docker 管理的特定目录 (/var/lib/docker/volumes/) |
| 路径指定 | 必须是绝对路径 (如 /opt/app/data) | 卷名 (如 my-vol),隐式管理物理路径 |
| 可移植性 | 低。依赖宿主机特定的文件目录结构 | 高。不依赖物理路径,易于在不同环境迁移 |
| 性能 | 依赖宿主机文件系统原生性能 | 绕过 Storage Driver 层,具备原生 I/O 性能 |
| 适用场景 | 开发环境同步代码、挂载宿主机配置文件 | 生产环境数据库持久化、日志存储、多容器共享 |
| 备份与管理 | 手动定位宿主机路径进行备份 | 使用 docker volume 命令管理,备份需挂载容器操作 |
| 隔离性 | 宿主机进程可轻易修改,安全性较低 | 由 Docker 隔离,减少了被宿主机其他进程误删的风险 |
基本语法
方案 A:使用 --mount(推荐方式)
| |
方案 B:使用 -v(简写方式)
| |
可以看到,这里的语法与之前的volume挂载基本相同
网络配置
配置DNS
Docker 容器的 DNS 配置有两种情况:
- 默认 Bridge 网络:继承宿主机的 DNS 配置 (/etc/resolv.conf)。
- 自定义网络(推荐):使用 Docker 嵌入式 DNS 服务器 (Embedded DNS),支持通过 容器名 进行服务发现。
使用自定义网络
| |
端口映射
容器的网络访问规则如下:
- 容器之间:可以通过 IP 或容器名 (自定义网络) 互通。
- 宿主机访问容器:可以通过容器 IP 访问。
- 外部网络访问容器:❌ 默认无法直接访问。
为了让外部 (如你的浏览器、其他局域网机器) 访问容器内的服务,我们需要将容器的端口 映射 到宿主机的端口。
基本用法
| |
- 此时访问 http://localhost:8080 即可看到 Nginx 页面。
| 格式 | 含义 | 示例 |
|---|---|---|
| ip:hostPort:containerPort | 绑定指定 IP 的特定端口 | -p 127.0.0.1:8080:80 (仅允许本机访问) |
| ip::containerPort | 绑定指定 IP 的随机端口 | -p 127.0.0.1::80 |
| hostPort:containerPort | 绑定所有网卡 IP (0.0.0.0) 的特定端口 | -p 8080:80 (最常用格式) |
| containerPort | 绑定所有网卡 IP 的随机端口 | -p 80 |
随机映射
如果不关心宿主机使用哪个端口,可以使用随机映射。使用 -P (大写) 参数,Docker 会把 Dockerfile 中 EXPOSE 指令暴露的所有端口发布到宿主机的随机高位端口。具体落在哪个端口,取决于宿主机当前可用的临时端口范围。
| |
实战
默认情况下,-p 8080:80 会监听 0.0.0.0:8080,这意味着任何人只要能连接你的宿主机 IP,就能访问该服务。如果不希望对外暴露 (例如数据库服务),应绑定到 127.0.0.1:
| |
网络隔离
不同网络之间默认隔离,容器只能与同一网络中的容器直接通信:
| |
Docker Compose
概览
在学习 Compose 之前,笔者想强调它的真正价值。假设你正在开发一个微服务应用——前端、后端、数据库三个服务。如果你用 Docker 容器分别运行它们,你会遇到这些问题:
- 启动顺序:需要先启数据库,再启后端,最后启前端
- 网络连接:三个容器需要能彼此通信
- 卷挂载:本地代码需要映射到容器内
- 环境变量:每个服务的配置需要逐个设置
使用
docker run逐个启动的话,需要记住 3 条复杂的命令。而Docker Compose的核心价值就是用一个 YAML 文件来定义整个应用,然后一条命令docker compose up启动所有服务。这是 Compose 被广泛采用的原因——它极大地简化了本地开发和测试的复杂性。
Compose 项目早期由 Python 编写,称为 Docker Compose V1,现在的 Docker Compose V2 是一个 Go 语言编写的 Docker CLI 插件。Docker Desktop 默认包含它
关键定义
- 服务 (service):一个应用容器,实际上可以运行多个相同镜像的实例。
- 项目 (project):由一组关联的应用容器组成的一个完整业务单元。
可见,一个项目可以由多个服务 (容器) 关联而成,Compose 面向项目进行管理。
补充: compose命令行
基本使用格式
| |
参数说明
-f, --file FILE: 指定使用的 Compose 模板文件。默认会自动识别 compose.yaml (也兼容 docker-compose.yml 等),并且可以多次指定。-p, --project-name NAME: 指定项目名称,默认将使用所在目录名称作为项目名。--verbose: 输出更多调试信息。-v, --version: 打印版本并退出。
事实上,想要更好的理解docker compose命令,需要和没有compose的docker命令进行比较:
构建项目
docker compose build: 根据当前目录的compose.yml文件进行构建,如果没有用-f指定文件名字的话,会在当前目录中按以下顺序检索,匹配到第一个即停止查找- compose.yaml(官方推荐的首选名称)
- compose.yml
- docker-compose.yaml
- docker-compose.yml(历史最常用的名称,现降级为备选)
docker build: 根据当前目录的dockerfile构建镜像 更多的相同点
- 都会在目标文件变更时才重新构建镜像
自然,它完全可以被且已经被docker compose up取代
启动项目
docker run: 根据镜像名字启动容器,若依赖的镜像尚未构建且可以从远端拉取时,则先拉取该镜像后再启动容器,docker compose up: 根据compose.yml启动项目,若依赖的services(服务)有一些或者全部没有对应的镜像则会先构建再启动项目.
更多的相同点
- 都支持使用-d参数来后台运行
事实上,docker compose up的特性比上面所说的要复杂得多,我们可以compose.yml中预先在build关键字中指定了对应的构建目录和dockerfile,则每次运行docker compose up时可以加上--build参数,来实现在对应的构建目录有更改时自动构建镜像后运行.
因此,如果容器不报错的话我们可以只使用docker compose up命令完成实时的构建和项目运行.
停止和删除容器
docker compose stop: 停止所有服务,保留容器和网络,当然也保留数据卷docker compose down: 停止所有服务后删除容器和网络,默认保留数据卷,除非加上-v参数,这会删除所有匿名卷和命名卷,但保留绑定挂载文件docker stop: 正常停止容器,不会删除容器docker kill: 强制停止容器,不会删除容器docker rm 容器名: 删除某个容器docker rmi 镜像名:docker remove image的缩写,删除某个镜像docker container prune: 删除虚悬容器docker image prune: 删除虚悬镜像
docker compose logs: 日志查看
基本格式
| |
参数
--tail=50: 指定对应的最新日志行数 tail参数的默认值为all,输出所有服务或者在指定服务名字时输出该服务的所有日志.
如果构建报错,都需要使用该命令来查看具体的构建问题.
进阶用法: 多compose文件编排
- 官方文档
前面所说的
docker compose up还可以通过使用多个-f参数,实现多文件的覆盖,从而将生产环境和部署环境彻底隔离开来,具体用法如下:
执行命令
| |
compose.yml
| |
compose.prod.yml
| |
补充: compose编写
build: 指定dockerfile路径
指定 Dockerfile 所在文件夹的路径 (可以是绝对路径,或者相对 Compose 文件的路径)。Compose 将会利用它自动构建这个镜像,然后使用这个镜像.
- Dockerfile 中设置的选项 (例如:CMD、EXPOSE、VOLUME、ENV 等) 将会自动被获取,无需在 Compose 文件中重复设置。
| |
进阶用法
使用arg参数指定构建镜像时的变量:
| |
image: 指定镜像
指定该服务使用的镜像名称或ID,如果该镜像本地不存在,则会去远程仓库拉取该镜像
进阶用法
image可以与build进行配合,指定build生成的镜像名字:
| |
${DOCKER_IMAGE_FRONTEND?Variable not set}: compose语法${VAR?ErrorMessage},若VAR为定义或为空,则compose会报错并停止运行,在终端输出该调试信息TAG-latest: compose语法${VAR-DefaultValue},VAR变量未定义时提供默认值
如果compose.yml所在目录的.env文件中有如下定义:
DOCKER_IMAGE_FRONTEND = frontendTAG = 1.0
而该项目的名字为web,则这个镜像在docker中的最终名字为web-frontend:1.0.
volumes: 指定挂载的数据卷
数据卷所挂载路径设置。可以设置为宿主机路径 (HOST:CONTAINER)(即绑定挂载) 或者数据卷名称 (VOLUME:CONTAINER),并且可以设置访问模式 (HOST:CONTAINER:ro)。
用法
| |
env_file与environment: 环境变量
env_file: 指定环境变量文件路径。- 如果通过 docker compose -f FILE 方式来指定 Compose 模板文件,则 env_file 中变量的路径会基于模板文件路径。
- 如果有变量名称与 environment 指令冲突,则按照惯例,以后者为准。
该环境文件需要严格符合.env格式:
| |
即使没有使用env_file关键字,compose依然会自动读取对应目录的.env文件.
environment: 设置服务的环境变量,如果只给定名称,会自动读取环境变量,可以用来防止泄露不必要的数据.
示例
| |
command: 覆盖容器启动后默认执行的命令
command: bash scripts/prestart.sh
healthcheck: 健康检查
通过命令检查容器是否健康运行。
| |
test: 检查时执行的命令interval: 执行间隔timeout: 超过该时间限制仍未收到响应则视为这次检查失败retries: 第一次检查失败后的总尝试次数,若5次都失败则将该服务标记未不健康(unhealthy).
该关键字通常与depends_on关键字搭配使用.
depends_on
先看这个例子:
| |
- web需要在redis和db两个服务都启动后才可以启动.
也就是说depends_on规定了容器启动的先后顺序,保证需要其他服务作为依赖的容器滞后启动.
进阶用法: 搭配healthcheck
| |
关键字解析
condition: 要求相关依赖服务必须达到的具体状态restart: 对应服务重启时backend也必须重启service_healthy: 要求对应服务通过了健康检查,状态变为healthyservice_completed_successfully: 用于一次性服务中,要求对应服务运行后正常退出
labels
设置服务标签,供第三方工具识别
例如我们可以给后端加上traefik标签:
| |
networks
配置容器连接的网络,若不声明,所有服务都加入默认的桥接网络,彼此可见
写法如下:
| |
expose: 暴露端口
暴露端口,但不映射到宿主机仅可以指定docker内部端口为参数:
| |
docker中装载操作系统
EFFECTIVE C
- 出版于2020年,作者:Robert C. Seacord。
非常一般,实际上就是讲一遍C语言基础,远不如上面那本书
Effective Python,3rd edition
- 出版于2024年(第3版),作者:Brett Slatkin。
尽管东西很多,但不到真正要用的时候也根本记不住呢
Entity Framework Core in Action Second Edition
- 出版于2021年(第2版),出版商:Manning,作者:Jon P Smith。
概览
EF core原理
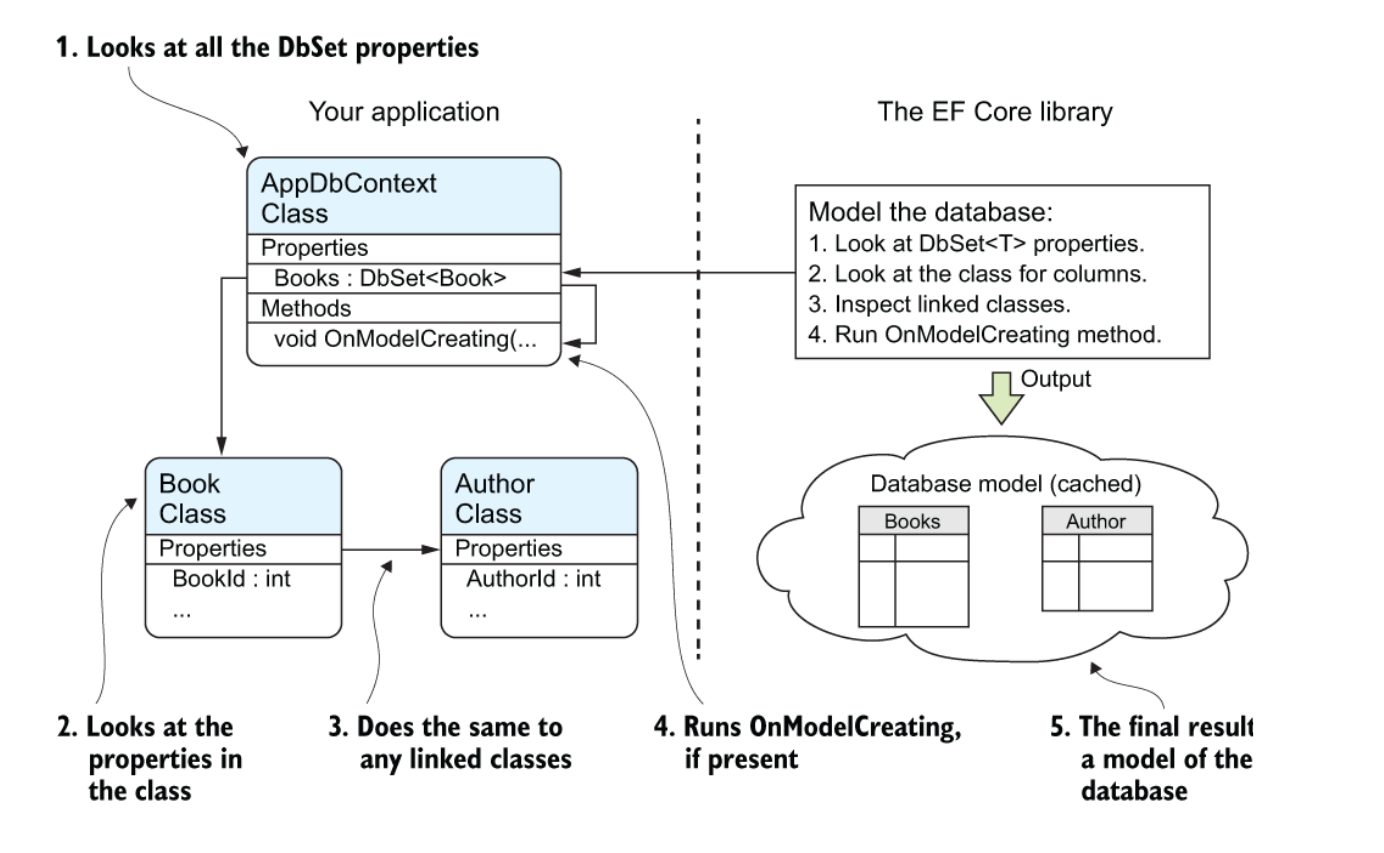
该图展示了 EF Core 如何依据你映射的类构建数据库模型。首先它通过
DbSet<T>属性检查你定义的类,随后会扫描这些类所引用的其他类。借助这些类,EF Core 能够推导出数据库的默认模型。接着它会执行应用程序中 DbContext 的OnModelCreating方法,你可以重写该方法并添加具体指令,以按你的需求配置数据库。
总结
不推荐,又臭又长,讲的也不清楚.
Effective Software Testing
- 出版于2022年,出版商:Manning,作者:Maurício Aniche。
软件测试介绍
软件工程中的实证研究一再表明,简洁无味的代码比复杂代码更不易出现缺陷(参见 Shatnawi 和 Li 2006年的论文)。 然而,仅有简洁远远不够。
认为测试可以完全被简洁取代是天真的看法。“通过设计保证正确性"同样如此:设计好代码并不意味着能避免所有可能的错误。
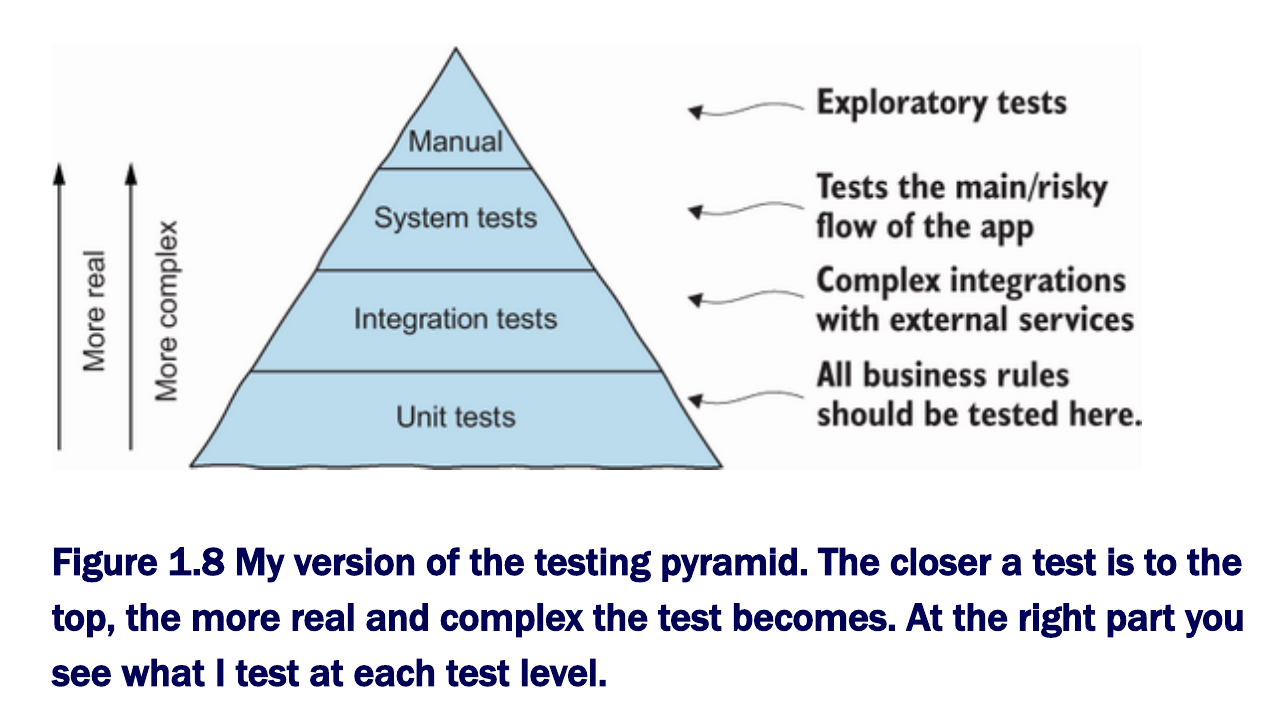
总结
用的是Java,很多框架都不适合其他的语言.
恶意代码分析实战
- 出版于2012年(英文原版),作者:Michael Sikorski。
- 基本都是泛泛而谈,没真东西
Fluent C
- 出版于2022年,出版商:O’Reilly,作者:Christopher Preschern。
结构比较清晰,先给一个上下文(context),再指出其中的问题(problem),最后给出推荐的解决方案(Solution),重复个几十遍.
也正因为如此,不是精通C的程序员看了也记不住,精通C的程序员遇到了问题来看才差不多.
Fluent Python ,second edition
- 出版于2022年(第2版),出版商:O’Reilly,作者:Luciano Ramalho。
比较一般,讲的不够深入,尽管名气很大,但不推荐阅读.
Flutter实战 第二版
- 出版于2023年(第2版),作者:杜文。
入门
起步
| 技术类型 | UI渲染方式 | 性能 | 开发效率 | 动态化 | 框架代表 |
|---|---|---|---|---|---|
| H5 + 原生 | WebView渲染 | 一般 | 高 | 支持 | Cordova、Ionic |
| JavaScript + 原生渲染 | 原生控件渲染 | 好 | 中 | 支持 | RN、Weex |
| 自绘UI + 原生 | 调用系统API渲染 | 好 | Flutter高, Qt低 | 默认不支持 | Qt、Flutter |
Dart基础
Dart 在静态语法方面和 Java 非常相似,如类型定义、函数声明、泛型等,而在动态特性方面又和 JavaScript 很像,如函数式特性、异步支持等
- 变量声明
| |
- 常量声明
| |
final变量在第一次使用时才会被初始化,而const是一个编译时的常量,会被直接替换成常量值.
- 函数声明
Dart中的函数也是对象,有一个类型Function,但可以不指定返回类型(你要么全都指定,要么全都默认推断,这样在中间卡着也太不利索了)
Dart函数声明如果没有显式声明返回值类型时会默认当做dynamic处理,注意,函数返回值没有类型推断:
| |
- 我受不了了,直接跳过吧,太乱了
官方示例
看一下官方给的代码样例来速通一下:
| |
对于学过Java和Js的人来说,Dart语法确实很容易掌握,但这种乱糟糟的写法开发效率显然弗如JSX远甚.
总结
越看越头痛呢,虽然知道这种跨平台框架到头来还是写前端样式,但是静态类型和杂糅的语法让Dart的样式函数变得面目可憎:
| |
如果以后有机会的话,我会再来学习的…
Fundamentals of DevOps and Software Delivery
- 出版于2025年,出版商:O’Reilly,作者:Yevgeniy Brikman。
Preface
DevOps 诞生于 2000 年代末,最初是为了解决企业软件交付效率低下的问题。 传统上,大多数公司设有两个独立团队:开发团队(Dev)负责编写软件,运维团队(Ops)负责管理硬件。
许多公司的这两个团队目标相冲突,各自为政。
运维团队的核心目标通常是安全性和可靠性,因此只有他们有权访问生产系统,需负责部署和应对系统故障。
而开发团队的核心目标通常是交付新功能并尽可能加快交付速度。这种架构模式往往导致各种问题。
- The goal of DevOps is to make software delivery vastly more efficient.
Nordstrom发现,应用DevOps实践后,其每月交付的功能数量增加了100%,缺陷减少了50%,交付周期缩短了60%,生产事故数量减少了60%到90%。 惠普LaserJet固件部门采用DevOps实践后,开发人员花在开发新功能上的时间从5%增加到了40%,并整体减少了40%的开发成本。
ch1
即使你是大型企业,也不应同时采纳所有DevOps实践。我职业生涯中最重要的教训之一就是,大多数大型软件项目都以失败告终。小型IT项目(低于100万美元)中约有四分之三能成功完成,而大型项目(超过1000万美元)中仅有十分之一能按时、按预算交付,甚至有超过三分之一的大型项目永远无法完工。
ch5
最重要的是理解这一点:当多个开发者同时在同一个代码库中工作时,合并冲突是不可避免的,所以问题不在于如何避免合并冲突,而是如何让这些合并冲突的处理尽可能轻松
CI
CI的当前风范是让所有成员都在主分支上工作,每天进行多次合并以确保不会落后主分支太多.
使用Github Actions等工具确保每次提交都能通过测试,之后就可以进行pull request的合并,减少一点人工运行测试的麻烦.
CD
CD主要的目标是在应用更新时不会导致网络震荡,应用停机等问题.
尽管话是这么说,安卓app不都是要退出应用再下载更新安装包的吗,至于网站的更新,崩溃的次数还少吗…
总结
该说是大道至简还是内有乾坤呢,DevOp的活儿看上去确实很简单,做好部署,监控,处理异常三件事就行了,但这需要对计算机领域的几乎所有知识都有一个比较全面的了解,这也是为什么SRE的地位相对较高的原因吧.
不过这本书讲的内容稀稀拉拉的,看头并不大.
GAME ENGINE ARCHITECTURE
- 内容太老了,而且很多概念都是宽泛的讲一下就结束了,没有深入.不推荐阅读.
导论
典型游戏团队的结构
- 工程师: 设计引擎,制作游戏
- 艺术家: 有很多分类
- 概念艺术家: 制作整个游戏的蓝图
- 三维建模师: 制作物体,角色,地形,建筑物
- 灯光师: 布置光源,调整场景的美感
- 动画师: 为角色,物体设计动作
- 音效设计师
- 作曲家
- 配音演员
- 游戏设计师: 有的在宏观上设定故事主线,整体的章节安排,有的在具体关卡中设定角色/道具的位置,设计游戏谜题和战斗场景
- 制作人: 管理开发进度,联系其他公司.
- 发行商: 负责游戏的市场策划,制造和分销.有些游戏工作室隶属于某些发行商,但也有很多独立工作室,他们会将游戏委托给条件最好的发行商.有时候还需要给跨越国际的游戏设置代理商.
游戏类型概览
第一人称射击游戏(FPS)
该类游戏的开发难度很高,需要能够实现以下功能:
- 高效地渲染大型三维虚拟世界。
- 快速反应的摄像机控制及瞄准机制。
- 玩家的虚拟手臂和武器的逼真动画。
- 各式各样的手持武器。
- 宽容的玩家角色运动及碰撞模型,通常使游戏有种“漂浮”的感觉。
- 非玩家角色(NPC,如玩家的敌人及同盟)有逼真的动画及智能。
- 小规模在线多人游戏的能力(通常支持多至同时 64 位玩家在线),以及无处不在的死亡竞赛(death match)游戏模式。
第三人称游戏
第三人称游戏的种类比较多,比如森林冰火人这种平台游戏,比如生化危机这种第三人称动作游戏,一般需要以下技术:
- 移动平台、梯子、绳子、棚架及其他有趣的运动模式。
- 用来解谜的环境元素。
- 第三人称的“跟踪摄像机”会一直注视玩家角色,也通常会让玩家用手柄右摇杆(在游戏主机上)或鼠标(在 PC 上)旋转摄像机(虽然在 PC 上有很多流行的第三人称射击游戏,但平台游戏类型几乎是游戏主机上独有的)。
- 复杂的摄像机碰撞系统,以保证视点不会穿过背景几何物体或动态的前景物体。
其他类型
- 格斗游戏: 拳皇
- 竞速游戏: 卡丁车
- 实时策略游戏(real-time strategy,RTS): 魔兽称霸,星际争霸
- 大型多人在线游戏(massively multiplayer online game,MMO): 魔兽世界
- 体育游戏: 足球经理
- 角色扮演游戏(role playing game,RPG)
游戏开发全貌

游戏支持系统
子系统的启动和终止
游戏引擎由多个互相合作的子系统结合组成,当引擎启动/终止时,需要按照一定的顺序启动/终止子系统.
如果使用C++原生的构造函数和析构函数,尽管同一文件中的构造/析构顺序是一定的,但不同文件中的构造/析构顺序是未知的,那么这就会导致子系统的构造/析构顺序发生紊乱,导致程序崩溃.
书中提出的解决方法是:不使用原生的构造函数和析构函数,改成自定义的启动管理器函数和终止管理器函数,在调用某个子系统时,直接调用其启动函数,并在终止子系统时,调用终止函数.如此一来,就可以避免原生语法带来的混乱.
内存管理
由于new/malloc操作符需要操作系统从用户模式切换至内核模式来进行堆分配,存在一个上下文切换的时间开销,一旦这类动态内存分配多了,就会极大的影响游戏的运行速度.c++类游戏引擎为了解决这个问题,通常会定制分配器来是实现内存分配
总结
不推荐阅读…
GitHub Actions in Action
- 出版于2024年,出版商:Manning,作者:Michael Kaufmann。
补充: 官网文档阅读
基本概念
workflow由以下基本组件组成:
- 一个或多个触发该工作流的事件,如push和pull
- 一个或者多个Job,每个Job都独立地在一个Runner上执行
- 每个Job由多个Step组成,这些一般都是脚本命令
不得不承认,官网的文档写的很烂…
yaml基础
yaml的变量写法都是如同key: value的形式,即便是带空格的字符串也不需要单独用引号包裹,如果要写成多行字符串,则如下所示:
| |
yaml中使用两种集合类型: map和list,map的写法就是用多级缩进:
| |
list的写法则用-标明:
| |
workflow语法
- 习惯上我们会在第一行给这个workflow命名:
| |
触发器
触发器(trigger)有三种:
- Webhook triggers
- Scheduled triggers
- Manual triggers
All triggers follow the key on: in the workflow file.
Webhook triggers 根据某个Github事件被触发,可以是对仓库的推送或者拉取:
| |
有时候我们希望只在特定分支下的某个特定文件夹中触发workflow,就可以这么写:
| |
有许多可用的Webhook触发器——例如,您可以在issues事件上运行工作流。支持的活动类型筛选器包括opened、edited、deleted、 transferred、pinned、unpinned、closed、reopened、assigned
Schedule triggers会在特定时间段执行,使用的语法包含五个字段,分别代表分钟(0 –59)、小时(0–23)、月份中的日期(1–31)、月份(1–12或JAN–DEC)以及星期几(0–6或SUN–SAT).
可以使用*,',-,/四种操作符,分别表示任何值,分隔符,范围,step value(每多长时间执行一次).
| |
manual triggers用于手动触发workflow,workflow_dispatch和repository_dispatch是其中的代表.
jobs和steps
Jobs默认可以并行运行,但可以使用needs关键字让某些job在特定的任务完成后再运行.
| |
总结
剩下的内容就都是扯淡了,不过前面的内容讲的还算详细,配合第一章的实战来看就能基本搞懂Github Actions是什么了.
Grokking Concurrency(待补充)
- 出版于2023年,出版商:Manning,作者:Kirill Bobrov。
介绍
并发与并行
- An application can be concurrent but not parallel. It processes more than one task over a given period (i.e., juggling more than one task even if no two tasks are executing at the same instant—this is described in more detail in Chapter 6).
单核多任务。系统通过时间片轮转交替执行多个任务。一段时间内多个任务都有进展,但同一时刻只有一个任务在占用 CPU 执行。
- An application can be parallel but not concurrent, which means it processes multiple subtasks of a single task simultaneously.
多核加速同一任务。将单个大任务拆分成多个子任务,在多核 CPU 上同时执行。
- An application can be neither parallel nor concurrent, which means it processes one task at a time sequentially, and the task is never broken into subtasks.
纯串行。单线程,按顺序从头到尾执行一个任务,不拆分任务。
- An application can be both parallel and concurrent, which means it processes multiple tasks or subtasks of a single task concurrently at the same time (executing them in parallel).
最理想状态。系统既能同时调度多个独立任务,又能把这些任务或单个大任务的子任务分配给多个 CPU 核心同时执行。
总结
其实讲的还不错,当我想复习的时候可以来看看,但还是不如专业的书籍
Go语言圣经
- 出版于2015年(英文原版),作者:Alan A. A. Donovan。
- 中文版网站
- (5/7): 看多了Java总觉得有些烦躁,就想着先学习一下Go来看看它的神奇之处
- (5/29): 不推荐拿这本书入门Go,建议先学习了Go的基础语法后再来看,不然会看的很难受
- (6/8): 一直以为是翻译很烂,换了英文版后才发现原来是原文就很烂,很难想象一本语言教科书能够同时实现超过论文程度的诘屈聱牙和垃圾博客的"咬字不清”,突然想起类似这种风格的还有C++ Programming Language.
前言
就事后诸葛的角度来看,Go语言的这些地方都做的还不错:拥有自动垃圾回收、一个包系统、函数作为一等公民、词法作用域、系统调用接口、只读的UTF8字符串等。但是Go语言本身只有很少的特性,也不太可能添加太多的特性。例如,它没有隐式的数值转换,没有构造函数和析构函数,没有运算符重载,没有默认参数,也没有继承,没有泛型,没有异常,没有宏,没有函数修饰,更没有线程局部存储。但是,语言本身是成熟和稳定的,而且承诺保证向后兼容:用之前的Go语言编写程序可以用新版本的Go语言编译器和标准库直接构建而不需要修改代码。
- 尽管Go现在支持泛型了,但是没有异常,也没有继承,重载,宏,隐式数值转换等一切让cpp变得面目可憎的东西.还是很不错的.
Go语言有足够的类型系统以避免动态语言中那些粗心的类型错误,但是,Go语言的类型系统相比传统的强类型语言又要简洁很多。虽然,有时候这会导致一个“无类型”的抽象类型概念,但是Go语言程序员并不需要像C++或Haskell程序员那样纠结于具体类型的安全属性。在实践中,Go语言简洁的类型系统给程序员带来了更多的安全性和更好的运行时性能
入门
入门代码
| |
- fmt: format,格式化输入与输出
Go 语言不需要在语句或者声明的末尾添加分号,除非一行上有多条语句。实际上,编译器会主动把特定符号后的换行符转换为分号,因此换行符添加的位置会影响 Go 代码的正确解析
循环语句
Go 语言只有 for 循环这一种循环语句。for 循环有多种形式,其中一种如下所示:
| |
for 循环三个部分不需括号包围。大括号强制要求,左大括号必须和 post 语句在同一行。
- 格式很严格,但也很符合一般的编程习惯
| |
for的另一种写法类似python中的enumerate遍历:
| |
- 与python一样,用不到的变量可以直接用下划线
_代替.事实上Go中只能这么写,因为Go不允许使用无用的局部变量.
该for ... range ...循环用于遍历某一种数据结构,每次迭代都会返回一对值,第一个是索引,第二个是索引处的元素值.
总结
看到这就可以了,后面只是对Go的基础功能的一些展示.
程序结构
变量
变量声明
基本语法如下:
| |
其中“类型”或“= 表达式”两个部分可以省略其中的一个。如果省略的是类型信息,那么将根据初始化表达式来推导变量的类型信息。如果初始化表达式被省略,那么将用零值初始化该变量。 数值类型变量对应的零值是0,布尔类型变量对应的零值是false,字符串类型对应的零值是空字符串,接口或引用类型(包括slice、指针、map、chan和函数)变量对应的零值是nil。数组或结构体等聚合类型对应的零值是每个元素或字段都是对应该类型的零值。
| |
也可以用两种方法同时声明多个变量:
| |
Go还有一种非常简短的方式来声明和初始化局部变量,这被称为简短变量声明:
| |
- 我们不需要写前置的var关键字,也不需要写后置的变量类型,而是由编译器自动推导
我们同样可以一次声明一组变量:
| |
需要注意的是,:=必须要至少声明一个新的变量,否则会报错:
| |
指针
由于Go的底层不是和Java,Python一样的引用传值,而是和Cpp,Rust一样的值拷贝,所以还是需要引入指针,来避免大规模的复制拷贝.
- 任何类型指针的零值都是nil,对应于cpp中的nullptr.
- 非常遗憾的是,Go仍旧没有把解引用符号和指针声明符号区分开,看来设计者真的非常喜欢
*这个符号
| |
- 上述代码并不会报错,因为Go底层的垃圾收集器会智能地把依旧要使用的局部变量分配到堆上,不会被回收.这很大程度上解决了C++的指针问题.
补充:整合得到的Go特性
- 完全无法理解这本书的组织架构,想必作者也是想到哪写到哪
const声明
const有两种声明方式:
- 常规写法:
| |
- 分组声明:
| |
字符串
Go中的字符串用双引号括起来,唯一一处会用到单引号的地方是用来表示单个字符,这与cpp的用法一致.
但是,Go中的字符串是不可修改的,不能用类似s[0]=1的方式进行修改.
尽管如此,我们可以对字符串进行拼接,在底层实际上是创建了一个更长的字符串,把原来的字符串丢弃掉:
| |
Goroutines
go中的多线程可能是所有语言中最好实现的了,毕竟我们只要在函数前加上两个单词: go:
| |
示例代码
| |
实际来说,goroutine和多线程有细微的区别,而在主函数返回时,所有的goroutine会被直接打断.
总结
暂时弃坑,如果有缘的话会再回来补充.
Go Web Scraping Quick Start Guide
- 出版于2019年,出版商:Packt,作者:Vincent Smith。
A simple request example
| |
不得不承认,Go的语法确实很简洁,但远不如Python形象
总结
一开始以为Go与Python的爬虫实现会有什么太大的不同,后来发现并没有什么区别,只不过Go的语法上要相对简洁一些.
GraphQL in Action
- 出版于2021年,出版商:Manning,作者:Samer Buna。
介绍
REST API最大的相关问题是客户端需要与多个数据API端点通信。因此,当客户端需要多个资源的数据时,它必须向该REST API发起多个网络请求,然后通过组合接收到的多个响应来整合数据。REST API客户端可用的语言极其有限。例如,
READREST API端点要么是GET /ResourceName以获取该资源的所有记录列表,要么是GET /ResourceName/ ResourceID以获取由ID标识的单一记录。
补充: strawberry库
strawberry库是python的GraphQL实现,在22年就有issue提出要整合Pydantic进去,可惜直到现在都还是实验性的,等到真正整合进去之后,我想才有必要去学这个库.
总结
尽管GraphQL很不错,但可惜这本书讲的太烂了,不如直接看文档.
Hello算法
前言
说来也好笑,尽管我一开始学算法时觉得这本书写的不太好,转而去看其他的算法书了,但现在回头重学算法的时候却发现,这本书的目录编排恰恰是我想要学习的内容:
缘分就是这么妙不可言.
数据结构
基本数据结构
链表
| |
列表
| |
- 之所以不叫push是因为vector还可以从前端插入,但实际上并没有
push_front方法,因为开销太大了
栈
| |
队列
| |
双向队列(double-ended queue)
| |
哈希表
| |
进阶数据结构
二叉树
| |
层序遍历,本质上是广度优先遍历
| |
三种深度优先遍历:
| |
尽管上述代码很简单,但在简单算法题中的用法确实就有这么简单.
二叉搜索树
查找
| |
插入
| |
删除
| |
堆
- 堆是一种完全二叉树,可以使用优先队列实现.分为根节点最大的大顶堆和根节点最小的小顶堆
| |
cpp的优先队列默认的底层容器是vector,默认采用大顶堆:
| |
| |
图
实际的图有两种表示方法:
- 邻接矩阵: 有n个节点就要用nxn大小的矩阵来表示
- 邻接表: 存储实际存在的边,空间复杂度更小,但时间复杂度更高.
算法
搜索
二分查找(过)
排序
选择排序(selection sort)
每轮从未排序的区间选择最小的元素,将其放到已排序区间的末尾
| |
这显然是O(n^2)的时间复杂度,对于相同大小的元素,有可能发生相对顺序的改变,因此是非稳定的:
冒泡排序(bubble sort)
连续地与相邻元素交换,每一轮将当前最大的元素交换至正确位置
| |
由于相等元素之间不交换,所以,前后顺序能够保持不变,是稳定的.
插入排序(insertion sort)
从第一个元素开始保证局部有序,不断将后面的元素插入到前面已经排序好的队列中
| |
由于需要遍历读取和遍历查找,所以还是n^2的时间复杂度.如果如上述示例中所写,相等的值将会被插入到右侧,因此是稳定的.
快速排序(quick sort)
- 逻辑比较复杂,所以我以前学算法的时候都没彻底搞懂快排…
首先锚定一个基准数,将左侧比基准数大的放到右侧,右侧比基准数小的放到左侧,处理完后的两边对于基准数来说是有序的,之后再递归处理即可.
| |
归并排序(merge sort)
大致想法其实和快速排序差不多,都是将大数组不断拆分成小数组后进行排序,不同的是快速排序在拆分前就排序,而归并排序是在拆分后进行排序
| |
- 实际上我并没有听说过有什么程序使用归并排序来处理数据结构的.
堆排序(heap sort)
| |
动态规划(dynamic programming)
要点:
- 明确初始状态
- 找到状态转移方程
- 开始递归
无后效性是动态规划能够有效解决问题的重要特性之一,其定义为:给定一个确定的状态,它的未来发展只与当前状态有关,而与过去经历的所有状态无关。
如果待求解问题的"有后效性"特别显著,那么就不能用动态规划,而是换成其他的算法.
背包问题
在一定的背包容量下,尽可能让装入物品的总价值最大.
之所以背包问题能够用动态规划来解决,也是因为我们可以将背包问题拆分成逐个放入物品的过程,当前的最大价值只与当前放入的物品有关.
0-1背包问题
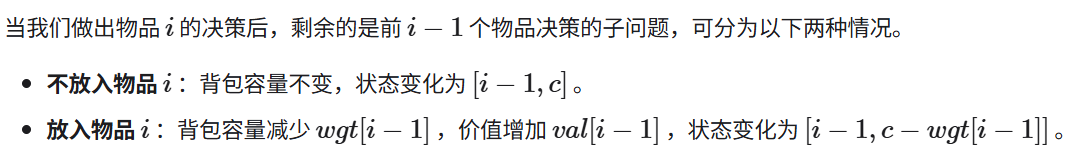
完全背包问题
之所以叫完全背包,是因为每个物品都可以重复选取
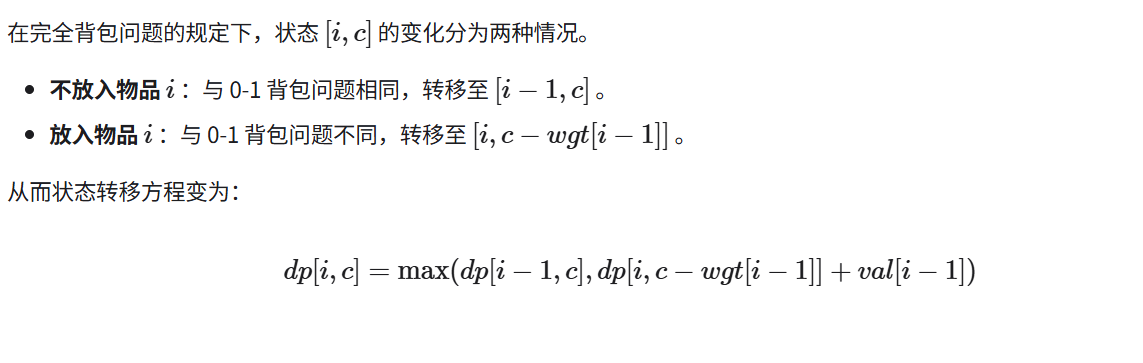
High Performance Python 3rd edition
- 出版于2025年(第3版),出版商:O’Reilly,作者:Micha Gorelick。
- 25年5月出版的,新鲜的很
讲的一般般,大多数内容我都已经学过了.
HTML5 WebSocket权威指南
- 出版于2013年(英文原版),作者:Vanessa Wang。
前置知识
在HTTP/1.0和HTTP/1.1中,低效的根源主要是:
- HTTP用于文档共享,而不是丰富的交互性应用程序,我们在桌面上习以为常的这种应用程序现在已经进入Web
- 随着客户端和服务器之间交互的增加,HTTP协议在客户端和服务器之间通信所需要的信息量快速增加。
而WebSocket是基于HTTP1.1的框架,能够将HTTP请求变成全双工的.
总结
内容太老了,所以没什么可读性.不过WebSocket也逐渐式微了,在可预见的未来我想不是很需要学习这方面的知识.
HTTP权威指南
- 出版于2002年,出版商:O’Reilly,作者:David Gourley。
不推荐阅读.
- 这本书于2002年出版,所以大多数概念可以直接跳过
本书分成以下五个部分:
- 第一部分 HTTP:Web 的基础
- 第二部分 HTTP 结构
- 第三部分 识别、认证与安全
- 第四部分 实体、编码和国际化
- 第五部分 内容发布与分发
ch2: URL
一个URL由以下部分组成,其中方案(如http:,ftp:),主机(域名或者ip地址)和路径是必须的,其他的是可选项:
| 组件 | 描述 | 默认值 |
|---|---|---|
| 方案 | 访问服务器以获取资源时要使用哪种协议 | 无 |
| 用户 | 某些方案访问资源时需要的用户名 | 匿名 |
| 密码 | 用户名后面可能包含的密码,中间由冒号 (:) 分隔 | <E-mail 地址 > |
| 主机 | 资源宿主服务器的主机名或点分 IP 地址 | 无 |
| 端口 | 资源宿主服务器正在监听的端口号。很多方案都有默认端口号(HTTP 的默认端口号为 80) | 每个方案特有 |
| 路径 | 服务器上资源的本地名,由一个斜杠 (/) 将其与前面的 URL 组件分隔开来。路径组件的语法是与服务器和方案有关的(本章稍后会讲到 URL 路径可以分为若干段,每段都可以有其特有的组件。) | 无 |
| 参数 | 某些方案会用这个组件来指定输入参数。参数为名 / 值对。URL 中可以包含多个参数字段,它们相互之间以及与路径的其余部分之间用分号 (;) 分隔 | 无 |
| 查询 | 某些方案会用这个组件传递参数以激活应用程序(比如数据库、公告板、搜索引擎以及其他因特网网关)。查询组件的内容没有通用格式。用字符 “?” 将其与 URL 的其余部分分隔开来 | 无 |
| 片段 | 一小片或一部分资源的名字。引用对象时,不会将 frag 字段传送给服务器;这个字段是在客户端内部使用的。通过字符 “#” 将其与 URL 的其余部分分隔开来 | 无 |
端口
我们平常使用http和https时都省略了端口,比如说https://github.com/实际上是https://github.com/:443,但浏览器会自动帮我们处理,如图所示:
- 事实上访问
https://github.com/:443也可以实现一样的效果,如果这么考量的话,我们看到localhost:3000等URL的时候就不会太迷糊
查询字符串
诸如下方这样的以?打头的查询参数非常常见,一般来说会用于搜索窗口上.
| |
片段
有时候我们会遇到以#打头的字符串,它表示该文档或者资源的一个片段,可以理解成某一章节或者某个特定图片:
| |
ch6: 代理
代理与网关的对比
代理连接的是多个使用相同协议的应用程序,而网关连接多个使用不同协议的断点,更像是协议转换器.
ch8: 网关
网关进行协议间的转换,如"ftp转http",“https转http”
总结
由于内容太老,讲的也不深入,所以收获很少.
Java核心技术·卷 I&&Ⅱ
- 实际观感不太行,第一部只不过涉及了一些常见的Java基础知识,而第二部涉及的各种框架和库也没什么必要去特地了解
计算机组成与设计: 硬件/软件接口
教材介绍和错误澄清
- 这本书的作者是John L. Hennessy 与 David A. Patterson,都是硬件领域中极其杰出的人物
这本书有三个指令集版本: RISC-V 版、MIPS 版和 ARM 版。当然推荐看新兴的RISC-V版本,如果出于国内应试的考量,就只能看MIPS版本了.
“There are two textbooks for the course: Computer Organization and Design by Patterson and Hennessy… The expectation is that the same text will also be useful to you in a later architecture course (CS 152). Do not get ‘Computer Architecture, a Quantitative Approach’ by mistake; it’s a similar-looking graduate text by the same authors.”
千万不要错买成《计算机体系结构:量化研究方法》(CAQA),那是一本看起来很像、但由同作者撰写的研究生阶段教材
- 没错,我就是那个不小心先看了CAQA的人,在没有前置基础的情况下确实看的有点难受.
引言
计算机体系结构的7个伟大设计思想:
- 使用抽象来隐藏底层实现细节,简化设计
- 加速大概率事件,这比优化小概率事件更能提高性能
- 通过并行来提高性能
- 通过流水线提高性能
- 通过预测来提高性能
- 设计分层的存储器
- 通过冗余提高系统的可靠性
指令
前置概念
- MIPS的寄存器有32个,大小均为32位,由于对32位数据进行整体操作的情况经常出现,所以将32位的数据称为字(word).
- 也有64位的MIPS,但没必要了解.
- MIPS约定书写指令时用一个
$后面跟两个字符来表示寄存器,比如说用$s0,$s1表示常规寄存器,用$t0表示临时寄存器.
由于MIPS是按字节编址的,但指令都是32位的,所以加上偏移量比如说8时,实际上是加上了4x8个字节,这样才能正确读到A[8]处存储的指令,而不会错读到A[8/4].
| 硬件概念 | 数学表示 (十六进制) | 物理对应关系 |
|---|---|---|
| PC = 0x0000 | 基准地址 | 指向物理内存中的 第 0 个字节(里面包含 8 个 bit) |
| PC = 0x0001 | 地址加 1 | 指向物理内存中的 第 1 个字节(里面包含另外 8 个 bit) |
| PC = 0x0004 | 地址加 4 | 指向物理内存中的 第 4 个字节(跨过了 1 个 32 位的字/指令) |
基本操作数
- add(加法)/sub(减法)指令后一般跟三个寄存器,第一个寄存器存储计算结果,后两个为要参与运算的寄存器
- load指令用来装载从存储器复制到寄存器的数据,使用
lw和lb符号,表示load word和load byte - store指令用来将数据从寄存器复制到寄存器中,使用
sw和sb符号,表示store word和store byte. - MIPS中经常会用到常数运算,因此专门设计了立即数的加减法,记为
addi,即add immediate,如addi $s3,$s3,4.
MIPS还支持对半字和无符号半字的存取
基本指令格式
MIPS为了保证所有的指令长度均为32位,针对不同的需求,将不同类型的指令拆分成了不同的指令格式,最常用的格式为R型和I型.
R型,用于普通的寄存器运算指令:
I型,用于立即数和数据传送指令:
- op: 操作码(opcode)
- rs: 第一个寄存器
- rt: 第二个寄存器
- rd: 存放操作结果的寄存器
- shamt: 移位量(shift amount),若用不到则置为0
- funct: 功能码,用于操作码的扩展.
可以看到,例题中的写法是把rd放在最前面了,但操作码格式中rd是放在最后面的,这个真心搞不太懂.
进阶操作数
逻辑指令:
- 移位(shift): 分为左移(shift left logical,sll)和右移(srl)
- 按位操作:按位与(AND)和按位或(OR),会逐个比较位数得出结果.
- 或非指令(NOT OR,NOR): 为了保持三操作数的格式,MIPS用NOR来代替普通的NOT指令,只需要将一个辅助寄存器的值设定为0,结果就等价于NOT.
决策指令:
- 分支指令: beq(branch if equal)和bne(branch if not equal),例子如下:
| |
如果r1与r2中的数值相等,则跳转到标签l1
| |
如果r1与r2中的数值不相等,则跳转到标签l1
- 无条件分支指令: 即跳转指令
jr,表示jump register,如jr r1 - 跳转并链接指令: jump-and-link,jal,会在跳转地址的同时,将下一条指令的地址保存在特定的返回地址寄存器中.
算术运算
加法和减法
在加法和减法运算中,可能发生溢出,MIPS使用两种类型的算术指令来解决溢出:
- add,addi,sub在溢出时抛出异常
- addu,addiu,subu,在溢出时不产生异常
由于C语言忽略溢出,所以MIPS C编译器只是用第二种算术指令.
乘法
如果我们将乘数的32位全部拆开,每一位分别用到一个加法器的话,就可以大幅度加速运算:
上面讨论的是正数乘法,如果是有符号乘法的话,符号位不参与运算即可.
MIPS提供了两条乘法指令: 乘法(mult)和无符号乘法(multu)
除法
解释一下流程:
- 之所以除数寄存器和余数寄存器是商寄存器的双倍长度,是因为要保证除数能从最高位慢慢向右移动,才知道够不够除被除数
- 一开始余数寄存器初始化为被除数,发现余数比除数大时,将商寄存器左移,最低位记为1,否则记为0
- 除数寄存器右移1位,继续相除,如果余数比除数小,则说明计算完成,可以退出循环,余数寄存器中的值则为最终的余数
这个设计还是很精妙的,不是那么容易看懂的.
MIPS中提供了两条除法指令: 除法(div)和无符号除法(divu)
浮点运算
浮点数的基本运算法则与整数计算没有区别,只是要考虑一下指数的转换.
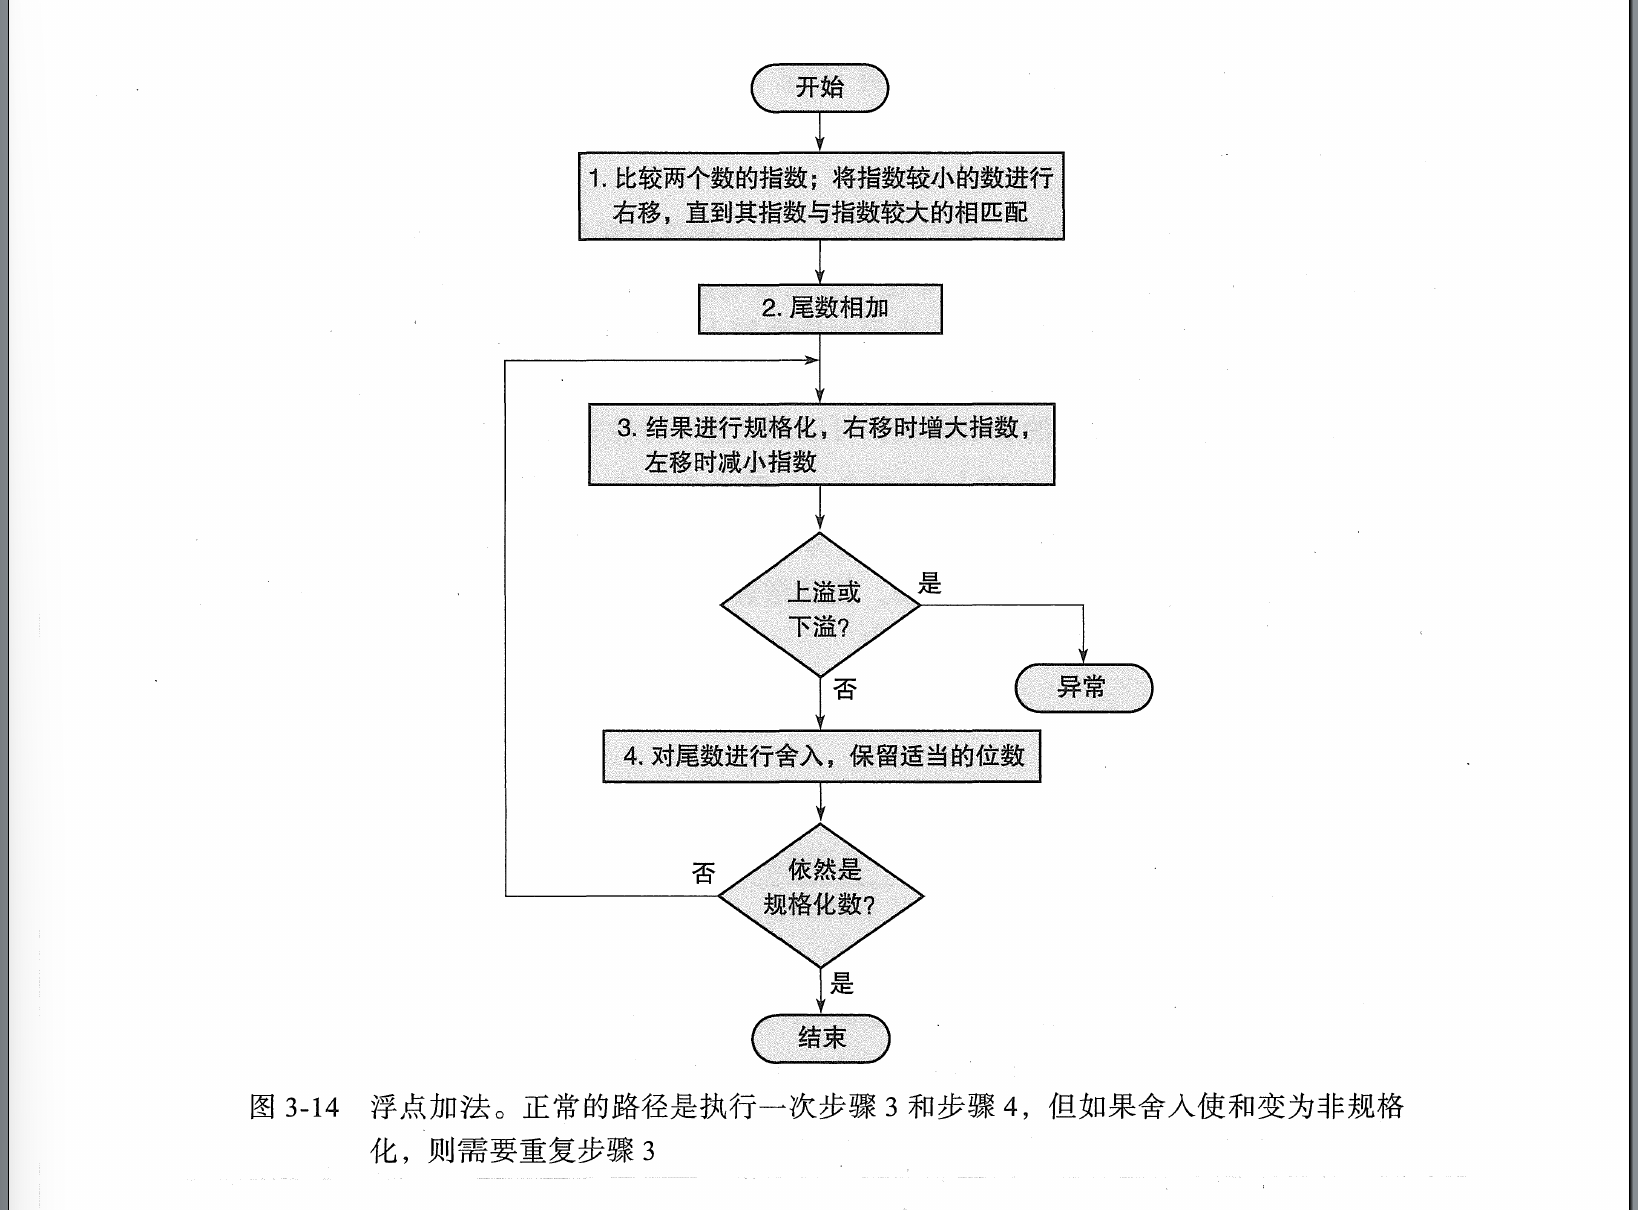
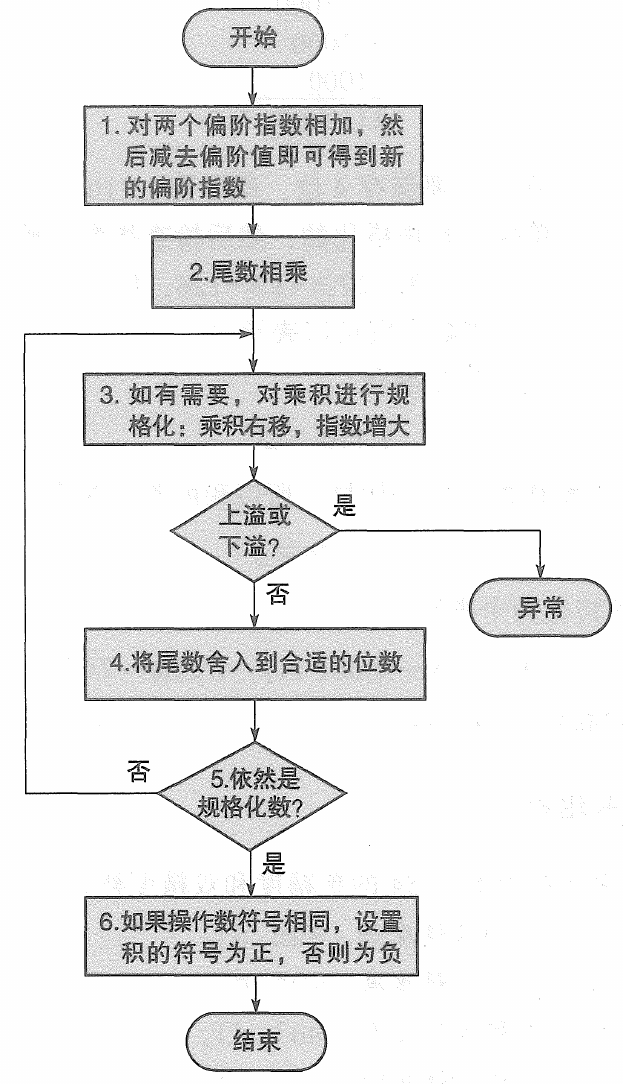
MIPS中有以下浮点计算指令:
- 浮点单精度加 (add.s) 和双精度加 (add.d) 。
- 浮点单精度减 (sub.s) 和双精度减 (sub.d) 。
- 浮点单精度乘 (mul.s) 和双精度乘 (mul.d) 。
- 浮点单精度除 (div.s) 和双精度除 (div.d) 。
附录B: 逻辑设计基础(过)
- 书上讲的太烂了,只好另外找书恶补基础了
现代计算机的内部电路为数字电路,只工作在两个电压: 高电压和低电压,与二进制的0和1相匹配.
数字电路按照是否包含存储器件(电容,电感)可以分成两种逻辑电路:
- 组合逻辑(combinational logic): 当前的输出只取决于当前的输入
- 时序逻辑(sequential logic): 当前的输出不仅于当前的输入相关,还和存储器件中存储的值有关.
组合逻辑
仅仅使用与门,或门,非门,我们可以得到所有的逻辑器件,常用的组合逻辑器件如下:
- 译码器: 有n个输入和2^n个输出,对于每一种输入组合,都只有一个输出信号为1
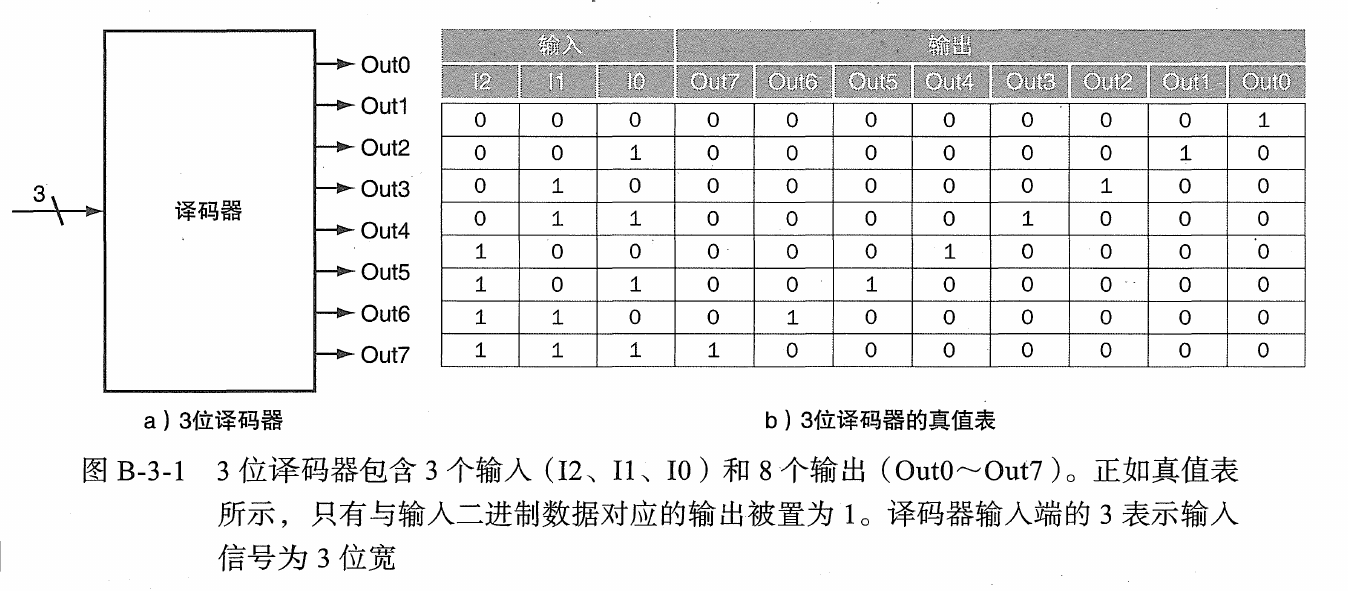
- 多路选择器: 输出由控制信号从多个输入中选择一个产生
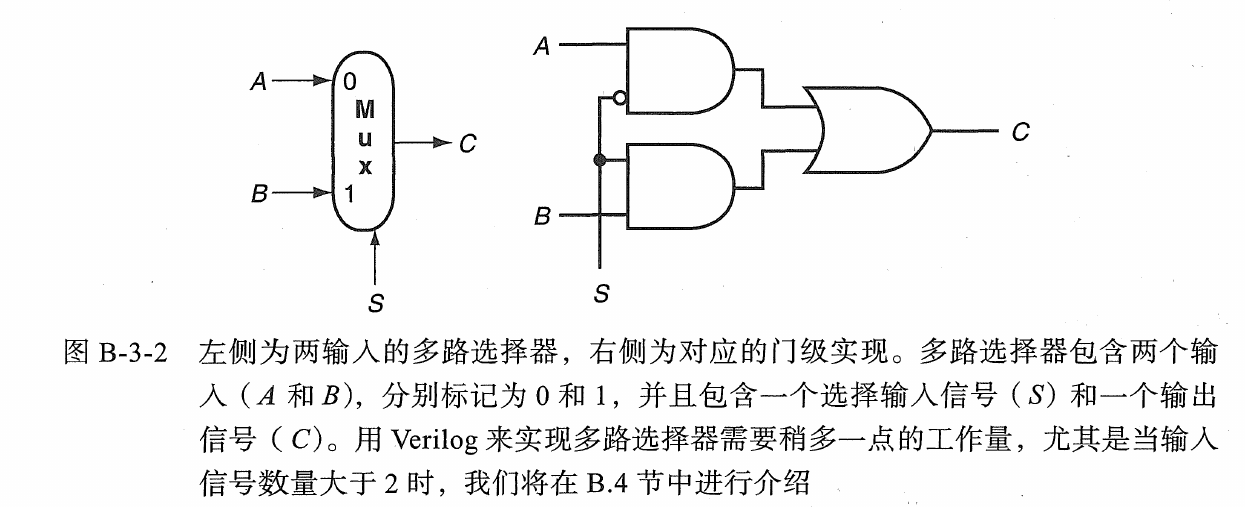
- 只读存储器(Read-Only Memory,ROM): 包含一组地址输入线和一组输出
- 算术逻辑单元(Arithmetic Logic Unit,ALU): 执行算术运算和逻辑运算
时序逻辑
时钟
在时序电路中,时钟非常重要,决定了包含状态的存储元件何时更新,它只有两种状态: 高电平和低电平.
MIPS中采用边沿触发时钟(edge-triggered clocking),所有的状态改变都发生在时钟边沿(即高低电平切换的时间点)
处理器
流水线
- 跳过了一大堆可怕的逻辑设计电路分析
流水线可以最大限度的利用硬件,对于特定的硬件来说,每个周期都可以执行新指令的该阶段操作.
- 流水线的级数:指令中涉及的总操作个数,例如某个指令涉及了6个操作,它的级数就是6
对于MIPS来说,由于所有指令的长度都是相同的,而且指令格式的种类很少,每一条指令中源寄存器字段的位置也相同,所有的操作都可以通过流水线完成.
流水线冒险,意为在下一个时钟周期中无法执行下一条指令,可以分为三种类型:
- 结构冒险: 硬件不支持多条指令在同一时钟周期执行,例如存储器在同一周期被两条指令的特定阶段都同时访问
- 数据冒险: 一个流水级必须等待另一个流水级完成,导致流水线暂停.这是由于一条指令依赖于另一条还在流水线中的指令造成的.
一种解决方法是: 我们可以让需要等待来自其他指令结果x的流水线先进行到需要x的地方,再由特定的硬件直接将计算好的x送给该流水线,这被称为旁路(bypassing).
| 符号 | 全称 | 中文含义 | 主要功能 |
|---|---|---|---|
| IF | Instruction Fetch | 取指令 | 从指令存储器中取出当前 PC 指向的指令 |
| ID | Instruction Decode | 指令译码 | 解析指令,读取寄存器,生成控制信号 |
| EX | Execute | 执行 / 地址计算 | ALU 运算、分支判断、计算访存地址 |
| MEM | Memory Access | 访存 | 访问数据存储器,完成 load / store |
| WB | Write Back | 写回 | 将运算结果或访存结果写回寄存器 |
上述的示例是理想的情况,由于ALU运算的结果刚好在下一个周期前回流到了减法的流水线,所以流水线不会中断.但实际上很多时候我们需要停留一两个周期才能获取上一个流水线的结果,停留的周期被称为阻塞(stall).
我们可以通过重排指令来避免阻塞:
- 控制冒险: 接下来的决策依赖于某一条正在执行的指令结果,这类指令通常都是条件分支指令(beq,ben),有可能产生不同的指令结果.
指令集采用**预测(predict)**的方法来处理条件分支问题,在预测正确的时候不停止流水线的运行,在预测失败的时候需要重新执行流水线.
一种简单的设想是,认为所有的分支都不会生效,那么当预测正确的时候(分支生效),流水线可以全速执行,当分支生效时才会阻塞流水线.
更为成熟的做法是,预测一些分支生效而另一些分支不生效,对于分支生效的指令,会提前跳转到对应的分支地址进行执行.
控制冒险实际上就是我们在程序编写中常见的while和for循环操作.
存储器
前置概念
- 局部性原理:
- 时间局部性(temporal locality): 如果某个数据项被访问,那么在不久的将来它可能再次被访问
- 空间局部性(spatial locality): 如果某个数据项被访问,与它地址相邻的数据项可能很快也将被访问
根据局部性原理,我们可以将存储器设计成分层的结构:
cache的设计
cache的基本原理可以这样表述:
将主存中的内存块映射到cache中的每一行中,如果cache有8行,那么就对主存地址取模8,将余数相同的地址全部对应到cache的一行中
当然,我们需要对cache中某一行存储的内存块设置标签(tag),否则无法区分这到底是哪个内存块,如果cache有8行,那么我们可以直接将内存地址的低三位设置为余数,其他位数设置为标签,例如(10111)对应的是cache第8行,标签为10.
总结
总体看下来的感受还是可以的,大多数内容都讲的比较详细,解决了我关于MIPS指令集的不少疑问.
计算机网络:自顶向下方法(第八版)
- 出版于2021年(英文第8版),作者:James F. Kurose。
- 很早的阅读笔记,现在看来质量堪忧,待日后解决
应用层
应用层协议
http协议(2026/1/28)
事实上我把之前博客里写的内容直接搬过来了,比书上还是要详细不少的
概览
HTTP 是一个客户端—服务器协议:请求由一个实体,即用户代理(user agent),或是一个可以代表它的代理方(proxy)发出。大多数情况下,这个用户代理都是一个 Web 浏览器,不过它也可能是任何东西,比如一个爬取网页来充实、维护搜索引擎索引的机器爬虫。
每个请求都会被发送到一个服务器,它会处理这个请求并提供一个称作响应的回复。在客户端与服务器之间,还有许许多多的被称为代理的实体,履行不同的作用,例如充当网关或缓存。
客户端发送的请求
| |
- POST: 客户端发起的请求所用方法
/api/v1/user/update?id=1024:服务器对应资源的路径和Query参数- Host: 目标服务器域名
- Content-Type: 传输数据格式声明
- User-Agent: 使用的浏览器代理
- Authorization: cookie或token等身份识别头
- Content-Length: 请求体字节长度
{"nickname": "Apollo","gender": "male"}: 传输的数据
服务端返回的报文
| |
METHOD
HTTP/1.1 协议中共定义了八种方法来以不同方式操作指定的资源,下面我列举常用的几种 GET The request is for a representation of a resource.The server should only retrieve data; not modify state.
HEAD The request is like a GET except that the response should not include the representation data in the body.
HEAD = GET − Response Body
POST The request is to process a resource in some way.
PUT The request is to create or update a resource with the state in the request.
DELETE The request is to delete a resource.
status code
In HTTP, you send a numeric status code of 3 digits as part of the response. These status codes have a name associated to recognize them, but the important part is the number.
In short: 100 - 199 are for “Information”. You rarely use them directly. Responses with these status codes cannot have a body.
200 - 299 are for “Successful” responses. These are the ones you would use the most.
200 is the default status code, which means everything was “OK”.
Another example would be 201, “Created”. It is commonly used after creating a new record in the database.
A special case is 204, “No Content”. This response is used when there is no content to return to the client, and so the response must not have a body.
300 - 399 are for “Redirection”. Responses with these status codes may or may not have a body, except for 304, “Not Modified”, which must not have one.
400 - 499 are for “Client error” responses. These are the second type you would probably use the most.
An example is 404, for a “Not Found” response.
For generic errors from the client, you can just use 400.
500 - 599 are for server errors. You almost never use them directly. When something goes wrong at some part in your application code, or server, it will automatically return one of these status codes.
User Agent
wiki 用户代理(user agent)在计算机科学中指的是代表用户行为的程序(软件代理程序)。例如,网页浏览器就是一个“帮助用户获取、渲染网页内容并与之交互”的用户代理
简单来说,user agent是http header里的客户端标识,告诉目标服务器自己是通过哪个浏览器进行访问的
- 爬虫总是需要伪装自己是通过某个代理访问服务器的,否则容易被拦截
一般格式
| |
web浏览器的通用格式
| |
具体示例
| |
cookie
MDN 服务器收到 HTTP 请求后,服务器可以在响应标头里面添加一个或多个 Set-Cookie 选项。浏览器收到响应后通常会保存下 Cookie,并将其放在 HTTP Cookie 标头内,向同一服务器发出请求时一起发送。你可以指定一个过期日期或者时间段之后,不能发送 cookie。你也可以对指定的域和路径设置额外的限制,以限制 cookie 发送的位置
Web cache
Web缓存是用于临时存储(缓存)Web文档(如HTML页面和图像),以减少服务器延迟的一种信息技术。Web缓存系统会保存下通过这套系统的文档的副本;如果满足某些条件,则可以由缓存满足后续请求
流程如下:
- 浏览器建立 TCP 连接 到 Web Cache,发送 HTTP 请求获取某个对象。
- Web Cache 查询本地缓存。
- 若存在对象副本(cache hit),直接返回 HTTP 响应给浏览器。
- 若本地没有该对象(cache miss),Web Cache 建立 TCP 连接 到 Origin Server。
- Web Cache 通过该 TCP 连接向 Origin Server 发送 HTTP 请求。
- Origin Server 返回包含对象的 HTTP 响应。
- Web Cache 接收响应后:
- 在本地缓存该对象副本
- 通过已有的 浏览器 ↔ Web Cache TCP 连接 将 HTTP 响应返回给浏览器。
从HTTP/1到HTTP/3
HTTP1采用非持续连接,每个HTTP请求都使用独立的TCP连接,可想而知慢的吓人 因此,HTTP1.1采用了并行的TCP持续连接,共享带宽,但这会增加连接占用的带宽,容易引发网络阻塞 这也是HTTP2推出的原因,只使用一个TCP持续连接来处理多个并行请求,将每个HTTP报文划分为帧单位,在第一个请求发送第一帧后,发送第二个请求的第一帧,以此类推,不断循环 至于HTTP3,改进的程度比较有限,且基于UDP而非TCP连接,在22年已经标准化
SMTP协议(3/4)
SMTP,一种广泛使用,历史悠久的邮件传输协议,与HTTP一样使用的是持续的TCP连接 流程如下:
- Alice 在 用户代理(Mail User Agent) 中输入 Bob 的邮箱地址(如
bob@someschool.edu),编写邮件并发送。 - 用户代理将邮件发送到 Alice 的邮件服务器(Mail Server),邮件进入服务器的 邮件队列(message queue)。
- Alice 邮件服务器上的 SMTP 客户端 从队列中发现该邮件,并建立 TCP 连接 到 Bob 的邮件服务器上的 SMTP 服务器。
- 完成 SMTP 握手 后,SMTP 客户端通过该 TCP 连接发送邮件内容。
- Bob 的邮件服务器上的 SMTP 服务器 接收邮件,并将邮件存入 Bob 的邮箱(mailbox)。
- Bob 在需要时启动 用户代理,从邮箱中读取邮件。
DNS
识别主机有两种方式———主机名(hostname)和 IP 地址。人们喜欢便于记忆的主机名标识方式,而路由器则喜欢定长的、有着层次结构的 IP 地址,因为hostname(如www.baidu.com)不能给路由器任何有关这个主机所在位置的信息
因此,我们需要一种能够将主机名转换成IP地址的服务,也就是 域名系统( Domain Name System , DNS ),由DNS服务器和DNS协议构成,运行在UDP之上,故也是应用层协议
常用查询方法
- A 记录查询 (Address Record)
- 物理定义:将域名直接映射到一个具体的 IPv4 地址。
- 工作机制:当发起 A 记录查询时,DNS 服务器会返回一个由 4 组数字组成的物理地址(如
192.168.1.1)。 - 特性:它是最基础、速度最快的解析方式。浏览器拿到 A 记录后,可以直接根据该 IP 地址物理寻找目标服务器并建立 TCP 连接。
- CNAME 记录查询 (Canonical Name Record)
- 物理定义:将一个域名指向另一个域名,而不是具体的 IP 地址。
- 工作机制:
- 客户端查询
www.example.com。 - DNS 返回一个 CNAME 记录(如
example.cdn.com)。 - 客户端必须针对这个新域名再次发起 DNS 查询,直到最终获得一个 A 记录(IP 地址)。
- 客户端查询
- 特性:
- 别名逻辑:常用于 CDN 加速或云服务。当后端物理服务器 IP 变动时,只需更改最终域名的 A 记录,所有指向它的 CNAME 无需修改。
- 性能成本:相比 A 记录,CNAME 至少会增加一轮 DNS 查询的物理往返时间。
为什么DNS用UDP 我们可以简单总结一下 DNS 的发展史,1987 年的 RFC1034 和 RFC1035 定义了最初版本的 DNS 协议,刚被设计出来的 DNS 就会同时使用 UDP 和 TCP 协议,对于绝大多数的 DNS 查询来说都会使用 UDP 数据报进行传输,TCP 协议只会在区域传输的场景中使用,其中 UDP 数据包只会传输最大 512 字节的数据,多余的会被截断;两年后发布的 RFC1123 预测了 DNS 记录中存储的数据会越来越多,同时也第一次显式的指出了发现 UDP 包被截断时应该通过 TCP 协议重试
实际应用举例
来看这样一个图,这是我在服务器上部署好了网站后,并在dynadot购买域名进入后台时将服务器的IP地址与对应域名绑定的过程.
使用A记录时,只要将服务器的ip地址填入就可以生效,但是别人访问这个服务器的时候只能在地址栏输入类似qin******.com的内容来访问.
但用户可能会输入www.qin******.com来访问这个服务器,但DNS并不会自动帮我将www前缀删除,所以我需要增加一条CNAME记录,将www.qin******.com指向qin******.com.
- www前缀代表着这个网站使用的是http协议,是一个web网站,但由于现在基本都是web网站,少有类似
ftp.qin*****.com这样的网站名了
P2P协议
BitTorrent是里面最为著名的代表,简单来说是一种多人之间互相传数据分包的协议,从而避免多人仅通过连接一台服务器导致的下载速度延缓.
磁力链接,torrent等资源链接都采用这一协议进行传输
DASH和CDN
DASH(Dynamic Adaptive Streaming over HTTP),将视频编码为不同清晰度的版本,根据用户的可用带宽来动态选择对应画质版本的视频
CDN(Content Distribution Network),由名字可以看出来,CDN相当于一个存储视频,文档等数据的分布式服务器,避免只用一个服务器来接受http请求导致的各种问题
Port(端口)
可以理解为通信接口,也就是说,应用层的进程通过特定的端口实现与运输层TCP/UDP的连接.
- 一个端口号使用16位无符号整数(unsigned integer)来表示,其范围介于0与65535之间
- 在TCP协议中,端口号0是被保留的,不可使用。1–1023 系统保留,只能由root用户使用。1024–4999 由客户端程序自由分配。5000–65535 由服务器端程序自由分配。在UDP协议中,来源端口号可选择是否填上,如果设为0,则代表无来源端口号。
运输层
Reliable Data Transfer Protocol (RDT)
- 显然书上这部分的引入太长了,而且并没有作者自以为的讲得很详细很清晰,还是让AI来总结一下吧 可靠数据传输协议(Reliable Data Transfer Protocol,RDT)是计算机网络中用来保证发送方的数据能够完整、正确、按顺序送达接收方的一类协议。即使底层信道可能存在丢包、乱序或传输错误,RDT 也能通过设计机制让数据安全传输
1. RDT 的核心问题
在现实网络中,直接发送比特流存在很多潜在问题:
- 丢包:数据包在传输中可能完全丢失。
- 数据错误:信道噪声或硬件故障可能导致比特翻转,接收方收到的数据与发送方发送的数据不同。
- 重复数据:网络重传机制或路由问题可能导致同一个数据包被接收多次。
- 乱序:数据包可能通过不同路径传输,先发送的包晚到达。
可靠数据传输协议需要解决这些问题,保证端到端的可靠性。
2. 核心机制概览
RDT 的核心机制可以概括为五个部分:
分包(Segmentation)
- 将大数据拆分成较小的数据包,每个包称为 segment。
- 优点:小包更容易重传,减少重发的代价,同时便于序列号管理。
- 每个包通常包含以下内容:
- 数据内容(payload)
- 序列号(Sequence Number)
- 校验和(Checksum)
错误检测(Error Detection)
利用 Checksum 或 CRC(Cyclic Redundancy Check) 检测数据在传输中是否被破坏。
发送方:计算数据包的校验和并附加在包头。
接收方:收到包后重新计算校验值,如果与包头的值相同,则认为数据正确,否则认为数据出错。
示例:
1 2数据内容: 10110011 校验和: 0110接收方校验,如果不匹配,就触发重传。
序列号(Sequence Number)
- 每个数据包被赋予唯一的序列号(Sequence Number),用于:
- 防止重复包处理
- 保证接收顺序
- 序列号通常为 0、1 或更大的整数,循环使用。
- 接收方通过序列号判断是否收到新的包还是重复包。
- 每个数据包被赋予唯一的序列号(Sequence Number),用于:
确认机制(Acknowledgment, ACK / Negative Acknowledgment, NAK)
ACK(确认):接收方收到正确的数据包后发送 ACK 给发送方。
NAK(否定确认):接收方收到错误数据包时发送 NAK,要求发送方重发。
作用:
- 让发送方知道哪些数据包成功到达。
- 在丢包或错误情况下触发重传。
示例流程:
1 2发送方 -> 数据包 1 -> 接收方 接收方 -> ACK 1 -> 发送方
重传机制(Timeout & Retransmission)
- 发送方设置 超时时间(Timeout)。
- 如果在超时时间内没有收到 ACK,发送方会自动 重发数据包。
- 与 ACK/NAK 配合,可以保证即使网络丢包,最终数据仍然完整送达。
- 关键点:
- 超时必须合理,否则可能导致过早重发或等待过久。
- 与序列号结合,保证重发的数据仍能正确排序,不被重复处理。
3. 可靠数据传输模型示例
3.1 Stop-and-Wait RDT(最基础模型)
- 发送端:
- 发送一个数据包,附带序列号。
- 等待接收方发送 ACK。
- 如果超时未收到 ACK,重发数据包。
- 收到 ACK 后发送下一个包。
- 接收端:
- 收到数据包,检查校验和。
- 如果正确,处理数据并发送 ACK。
- 如果错误或重复,丢弃数据或发送 NAK。
- 优点:简单易实现,理解方便。
- 缺点:效率低,因为发送方在等待 ACK 期间 无法发送下一个数据包。
3.2 Sliding Window RDT(滑动窗口机制,流水线机制)
- 改进 Stop-and-Wait,允许 发送方在等待 ACK 的同时发送多个包。
- 核心概念:
- 发送窗口:发送方未确认的数据包集合。
- 接收窗口:接收方能够接收的序列号范围。
- 优点:提高链路利用率,尤其是高延迟链路。
- 实现机制:
- 发送方维护一个窗口,窗口内的包可以连续发送。
- 接收方按序号接收,并发送 ACK。
- 窗口滑动:收到 ACK 后,发送方窗口向前滑动,可以发送新的包。
- 常见变种:
- Go-Back-N:出错时从错误包开始重发之后所有包。
- Selective Repeat:只重发出错的包,更高效。
4. RDT 的工作流程总结
以最简单的 Stop-and-Wait 为例,端到端流程如下:
| |
异常情况:
- 数据包丢失:
- 发送方超时重发。
- 数据包出错:
- 接收方丢弃包并发送 NAK 或不发送 ACK。
- ACK 丢失:
- 发送方超时重发数据包,接收方根据序列号判断重复,避免重复处理。
核心思想:发送方持续重发,接收方持续确认,直到每个包安全到达。
UDP(User Datagram Protocol)
UDP的原理非常简单,就是将src post传输的数据 打包进UDP报文,并传递给网络层,再分发给dst post
d
- 使用 UDP 时,在发送报文段之前,发送方和接收方的运输层实体之间没有握手.正因为如此,UDP 被称为无连接的.
为什么要用UDP
- 无连接状态。TCP 需要在端系统中维护连接状态。此连接状态包括接收和发送缓存、拥塞控制参数以及序号与确认号的参数。另一方面, UDP 不维护连接状态 , 也不跟踪这些参数。 因此, 当应用程序运行在 UDP 之上而不是运行在 TCP 上时,某些专门用于某种特定应用的服务器一般都能支持更多的活跃客户。
- 分组首部开销小 。每个 TCP 报文段都有 20 字节的首部开销 , 而 UDP 仅有 8 字节的开销。
- TCP 的拥塞控制会导致如因特网电话、视频会议之类的实时应用性能变得很差 。由于这些原因,多媒体应用开发人员通常将这些应用运行在 UDP 之上而不是 TCP 之上
UDP包分析
一个完整的 UDP 包由 UDP 头部 + 数据负载(Payload)组成
UDP头部(固定8字节)
| 字段 | 字节数 | 说明 |
|---|---|---|
| Source Port | 2 | 源端口 |
| Destination Port | 2 | 目标端口 |
| Length | 2 | UDP 头 + 数据总长度 |
| Checksum | 2 | 校验和,验证头部和数据是否损坏 |
| |
UDP 数据负载(Payload)
- 长度 = UDP Length – 8(头部大小)
- 完全由应用程序生成
UDP检验和 检验和用于确定当 UDP 报文段从源到达目的地移动时,其中的比特是否发生了改变 ( 例如,由于链路中的噪声干扰或者存储在路由器中时引入问题 )。发送方的 UDP 对报文段中的所有 16 比特字的和进行反码运算,求和时遇到的任何溢出都被回卷(把最高位进位送入最低位相加) 。 得到的结果被放在 UDP 报文段中的检验和字段.
显然接收方可以再进行一次求和与反码相加,如果出现了0就说明数据有地方出错了.
TCP(Transmission Control Protocol)
TCP 被称为是面向连接的 ( connection-oriented),这是因为在一个应用进程可以开始向另一个应用进程发送数据之前 , 这两个进程必须先相互 “ 握手 ”,即它们必须相互发送某些预备报文段,以建立确保数据传输的参数
TCP报文段分析
一个完整的 TCP 报文段由 **TCP头部(Header)+ 选项(Options,可选)+ 数据负载(Payload)**组成,其中最小 TCP 头部固定 20 字节。
TCP头部(最小20字节)
| 字段 | 字节数 | 说明 |
|---|---|---|
| Source Port | 2 | 源端口,标识发送应用进程 |
| Destination Port | 2 | 目标端口,标识接收应用进程 |
| Sequence Number | 4 | 序列号,标识第一个数据字节编号 |
| Acknowledgment Number | 4 | 确认号,期望收到的下一个字节编号(ACK置1有效) |
| Data Offset | 4位 | TCP头部长度(单位:32位字/4字节) |
| Reserved | 3位 | 保留,必须置0 |
| Flags(控制位) | 9位 | URG, ACK, PSH, RST, SYN, FIN 等 |
| Window Size | 2 | 接收端可接收缓冲区大小(流量控制) |
| Checksum | 2 | TCP头+数据+伪首部校验和 |
| Urgent Pointer | 2 | 紧急指针,URG置1时有效 |
TCP头部字段示意图
| |
- Flags(控制位):
- URG:紧急指针有效
- ACK:确认号有效
- PSH:接收端应用立即读取数据
- RST:重置连接
- SYN:同步序列号,用于建立连接
- FIN:关闭连接
- 数据偏移(Data Offset):
- 表示 TCP 头部长度,单位4字节
- 最小值 5(20字节),最大 15(60字节,包括选项)
- 窗口大小用于流量控制,控制发送端发送未确认的数据量。
- 校验和覆盖 TCP 头部、数据以及伪首部(IP源/目的地址、协议号、TCP长度)。
序号和确认号
报文段的序号 ( sequence number for a segment ) 是该报文段首字节的字节流编号
举例来说 ,假设主机 A 上的一个进程想通过一条 TCP 连接向主机 B 上的一个进程发送一个数据流 。主机 A 中的 TCP 将隐式地对数据流中的每一个字节编号 。假定数据流由一个包含 500 000 字节的文件组成,其 MSS 为 1000 字节,数据流的首字节编号是 0。则该 TCP 将为该数据流构建 500 个报文段。给第一个报文段分配序号 0 ,第二个报文段分配序号 1000 ,第三个报文段分配序号 2000,以此类推。每一个序号被填入到相应TCP报文段首部的序号字段中。
至于确认号,首先我们需要明确为什么需要确认号这样一个东西,由于TCP连接是双向的,故发送方也需要收到接收方传来的信息,故需要在确认号字段里填写缺失的来自接收方传来的包序号
假设主机 A 已收到一个来自主机 B 的包含字节 0 ~ 535 的报文段,以及另一个包含字节 900 ~ 1000 的报文段。 由于某种原因, 主机 A 还没有收到字节 536 ~ 899 的报文段。 在这个例子中, 主机 A 为了重新构建主机 B 的数据流,仍在等待字节 536 ( 和其后的字节)。 因此 , A 到 B 的下一个报文段将在确认号字段中包含 536
TCP连接的建立(三次握手)
- 第一步:SYN 报文段 客户端向服务器发送一个首部 SYN 比特置为 1 的特殊报文段。该报文不含应用层数据,但包含客户端随机选择的初始序号 client_isn。该报文段被封装在 IP 数据报中发送。
- 第二步:SYNACK 报文段 服务器接收到 SYN 后,为连接分配 TCP 缓存和变量,并回送允许连接的报文段。此时 SYN 比特置为 1,确认号字段设为 client_isn + 1,同时服务器选择自己的初始序号 server_isn。此报文段表明服务器同意建立连接。
- 第三步:ACK 报文段 客户端收到 SYNACK 后,也为连接分配缓存和变量,并向服务器发送最后的确认报文。此时 SYN 比特置为 0,确认号字段设为 server_isn + 1。该阶段的报文段负载可以开始携带实际的客户数据。
- 注意,第三步的时候客户端可以主动选择终止连接
拓展:为什么要三次握手 想象一下这个场景,如果通信双方的通信次数只有两次,那么发送方一旦发出建立连接的请求之后它就没有办法撤回这一次请求,如果在网络状况复杂或者较差的网络中,发送方连续发送多次建立连接的请求,如果 TCP 建立连接只能通信两次,那么接收方只能选择接受或者拒绝发送方发起的请求,它并不清楚这一次请求是不是由于网络拥堵而早早过期的连接。
使用三次握手和 RST 控制消息将是否建立连接的最终控制权交给了发送方,因为只有发送方有足够的上下文来判断当前连接是否是错误的或者过期的,这也是 TCP 使用三次握手建立连接的最主要原因。
TCP连接的终止(四次挥手)
TCP 协议是对称的全双工协议,连接的任何一方(无论最初是客户端还是服务器)都可以主动调用 close() 发送 FIN 报文段来开启连接终止流程。在RFC 793中,通常将发起关闭的一方称为 Active Closer(主动关闭方),将接收关闭请求的一方称为 Passive Closer(被动关闭方)。
- 全双工:双方都可以同时发送和接收消息 主流程
- 主动方 (Active Closer) 发送 FIN 该方应用进程决定不再发送数据。TCP 实体构造首部 FIN 位为 1 的报文段。发送后,主动方进入 FIN-WAIT-1 状态。
- 被动方 (Passive Closer) 确认 ACK 被动方收到 FIN 后,由 TCP 协议栈自动回送 ACK。此时被动方进入 CLOSE-WAIT 状态,并通知上层应用进程对端已关闭。主动方收到 ACK 后进入 FIN-WAIT-2。
- 被动方 (Passive Closer) 发送 FIN 当被动方的应用进程处理完所有剩余数据后,显式关闭套接字。TCP 发送 FIN 位为 1 的报文段,被动方进入 LAST-ACK 状态。
- 主动方 (Active Closer) 发送最终 ACK 主动方收到对端的 FIN 后,发送最后一个 ACK,进入 TIME-WAIT 状态。被动方收到此 ACK 后直接进入 CLOSED 状态,释放所有资源。
- 主动方的资源释放延迟 主动方必须在 TIME-WAIT 状态维持 2MSL 时长,以确保最后一个 ACK 到达被动方,并清空网络中残存的旧报文段。倒计时结束后,主动方进入 CLOSED 并释放资源。
TCP中的可靠数据传输
为了实现可靠数据传输,TCP有以下三个机制: 超时间隔,冗余ACK和快速重传
首先,TCP设置一个初始超时间隔,发出某个包时开始计时,如果接收方未能在超时间隔内将ACK确认包传来,则标记为超时.
每当超时事件发生时,TCP重传具有最小序号的还未被确认的报文段。只是每次 TCP 重传时都会将下一次的超时间隔设为先前值的两倍.
接收方保存一个连续接收到的包末端序号,比如说,“已经收到了 100-200 和 300-400,但中间缺了 201-299”,那么末端序号就是201,尽管接收到了300-400的包,接收方仍会返回ACK=201,如果这次仍未收到201-299的包,则继续发送ACK=201,直到收到该部分的包为止,这被称为冗余ACK,之后,接收方立刻将序号调整为ACK=401.
如果发送方接收到对相同数据的3个ACK时,这说明之后的报文段已经丢失,那么发送方就执行快速重传,即重新发送之后的报文段.
- 换句话说,只收到两个ACK时不进行重传,原因如下:
- 如果包 A 比包 B 稍微晚了一点点到达(仅仅是走错了路或者在路由器队列里被插了队),接收方就会因为先收到 B 而发回一个重复 ACK。如果此时发送方立即重传,会导致网络中充斥着大量无谓的重传包,极大地浪费带宽。
因此,重传只在以下两种情况中发生:
- 超出超时间隔未收到该包对应的ACK时重传,这被称为超时重传
- 收到该包的三个重复ACK则立刻重传,这被称为快速重传
TCP流量控制
TCP 为它的应用程序提供了流量控制服务 ( flow-control service ) 以消除发送方使接收方缓存溢出的可能性.
为了实现流量控制,发送方维护一个接收窗口(receive window,rwnd),接收方为该TCP连接分配了一个接收缓存,并维护以下三个变量:
- LastByteRead:应用进程从缓存读出的最后一个字节编号。
- LastByteRcvd:放入接收缓存中的最后一个字节编号。
- RcvBuffer:接收缓存的总大小。
为防止缓存溢出,必须满足: LastByteRcvd - LastByteRead ≤ RcvBuffer
那么接收窗口就需要根据缓存可用的空间来设置: rwnd = RcvBuffer - [ LastByteRcvd - LastByteRead ]
具体实现
- 通知机制:主机 B 将当前的 rwnd 值放入发给主机 A 的报文段“接收窗口”字段中。
- 发送方限制:主机 A 跟踪 LastByteSent(已发送编号)和 LastByteAcked(已确认编号)。
- 发送准则:主机 A 必须保证在连接生命周期内: LastByteSent - LastByteAcked ≤ rwnd
如果B的接收缓存已经存满,即 rwnd = 0 ,主机 B 随后清空缓存但没有数据回传,主机 A 将因无法获知新空间而被阻塞,因此当 rwnd = 0 时,主机 A 持续发送仅含一个字节数据的探测报文段,这些报文段会被确认,最终主机 B 的确认报文将包含非 0 的 rwnd 值,从而恢复传输。
拥塞控制原理(3/11)
由于实际应用中网络层总是不能实现具有无限容量的,无数据丢失的信道,故当数据传输量很大时信道很容易发生拥塞,故需要运输层使用拥塞控制方法来尽可能减小拥塞的可能.
在最为宽泛的级别上,我们可根据网络层是否为运输层拥塞控制提供了显式帮助,来区分拥塞控制方法。
端到端拥塞控制
在端到端拥塞控制方法中,网络层没有为运输层拥塞控制提供显式支持。即使网络中存在拥塞,端系统也必须通过对网络行为的观察 ( 如分组丢失与时延) 来推断之
网络辅助的拥塞控制
路由器会向发送方提供关于网络中拥塞状态的显式反馈信息
TCP拥塞控制
TCP 所采用的方法是让每一个发送方根据所感知到的网络拥塞程度来限制其能向 连接发送流量的速率 。
如果一个 TCP 发送方感知从它到目的地之间的路径上没什么拥塞 , 则 TCP 发送方增加其发送速率 ; 如果发送方感知沿着该路径有拥塞 , 则发送方就会降低其发送速率 。
但是,这种方法提出了三个问题:
- TCP 发送方如何限制它向其连接发送流量的速率呢 ?
- TCP 发送方如何感知从它到目的地之间的路径上存在拥塞呢 ?
- 当发送方感知到端到端的拥塞时 , 采用何种算法来改变发送速率呢 ?
TCP发送方如何限制发送速率
如之前的TCP流量控制所说,TCP 连接的每一端都是由一个接收缓存,一个发送缓存和几个变量 ( LastByteRead 、rwnd 等) 组成。 运行在发送方的 TCP 拥塞控制机制跟踪一个额外的变量,即拥塞窗口(congestion window,cwnd),它对一个 TCP 发送方能向网络中发送流量的速率进行了限制,即在一个发送方中未被确认的数据量不会超过 cwnd 与 rwnd 中的最小值.
LastByteSent -LastByteAcked≤ min{cwnd,rwnd}
因此,在接收窗口比较大的时候,通过调节cwnd的值,发送方可以调整发送数据的速率.
TCP发送方如何感知拥塞以及如何调整速率
至于如何感知发生了拥塞,TCP使用下列指导性原则:
- 丢失报文段意味着拥塞:当丢失报文段时,应当降低 TCP 发送方的速率。一个超时事件或四个确认(一个初始 ACK 和其后的三个冗余 ACK)被解释为“丢包事件”的隐含指示。TCP 发送方应当减小它的拥塞窗口长度,以应对这种推测的丢包事件。
- 确认报文段指示网络交付正常:当对先前未确认报文段的确认到达时,能够增加发送方的速率。确认的到达被认为是一切顺利的隐含指示,即报文段正成功交付,网络不拥塞。拥塞窗口长度因此能够增加。
- 带宽探测:TCP 调节其传输速率的策略是增加其速率以响应到达的 ACK,除非出现丢包事件,此时才减小传输速率。为探测拥塞开始出现的速率,TCP 发送方增加它的传输速率,从该速率后退,进而再次开始探测。网络中没有明确的拥塞状态信令,ACK 和丢包事件充当了隐式信号,每个 TCP 发送方根据异步于其他发送方的本地信息而行动。
完整的论述: TCP拥塞控制算法
该算法由三个阶段组成:
- 慢启动(Slow Start)
- 拥塞避免(Congestion Avoidance)
- 快速恢复(Fast Recovery) - 非必需
慢启动
cwnd的初始值通常都设置的很小,对于发送方而言,希望能够迅速找到可用带宽的大小.因此,cwnd的值以一个**MSS(最大报文长度)**开始,每当传输的报文段被确认就增加一个MSS,这样一来,每经过一个RTT(往返时间),发送速率就翻倍,以指数级别增长,如图所示:
如果丢包事件发生,发送方将会把cwnd值重新置为1,并设置一个新的变量ssthresh (slow start threshold)为cwnd/2-这里的cwnd值检测到丢包时的拥塞窗口大小,然后继续发送包.
当cwnd值增长到等于ssthresh时,发送方结束慢启动阶段,进入拥塞避免阶段
拥塞避免
该阶段中,每次传输后(即经过一个RTT后)将cwnd的值加一.
当再次触发丢包事件时,cwnd的值被再次置为1,ssthresh的值再次置为当前cwnd值的一半.
然而丢包事件有两个可能的触发机制:超时和收到3个冗余ACK.
对于后一种情况,既然能够收到接收方传来的ACK,这说明信道不是那么拥塞,因此,发送方只会将cwnd的值减半,并进入快速恢复阶段.
快速恢复
该阶段中,每当收到针对丢失报文冗余的ACK时,cwnd值加1 最终发送方收到对于丢失报文的ACK时,TCP降低cwnd后进入拥塞避免阶段;如果出现超时事件,则迁移到慢启动状态.
总览
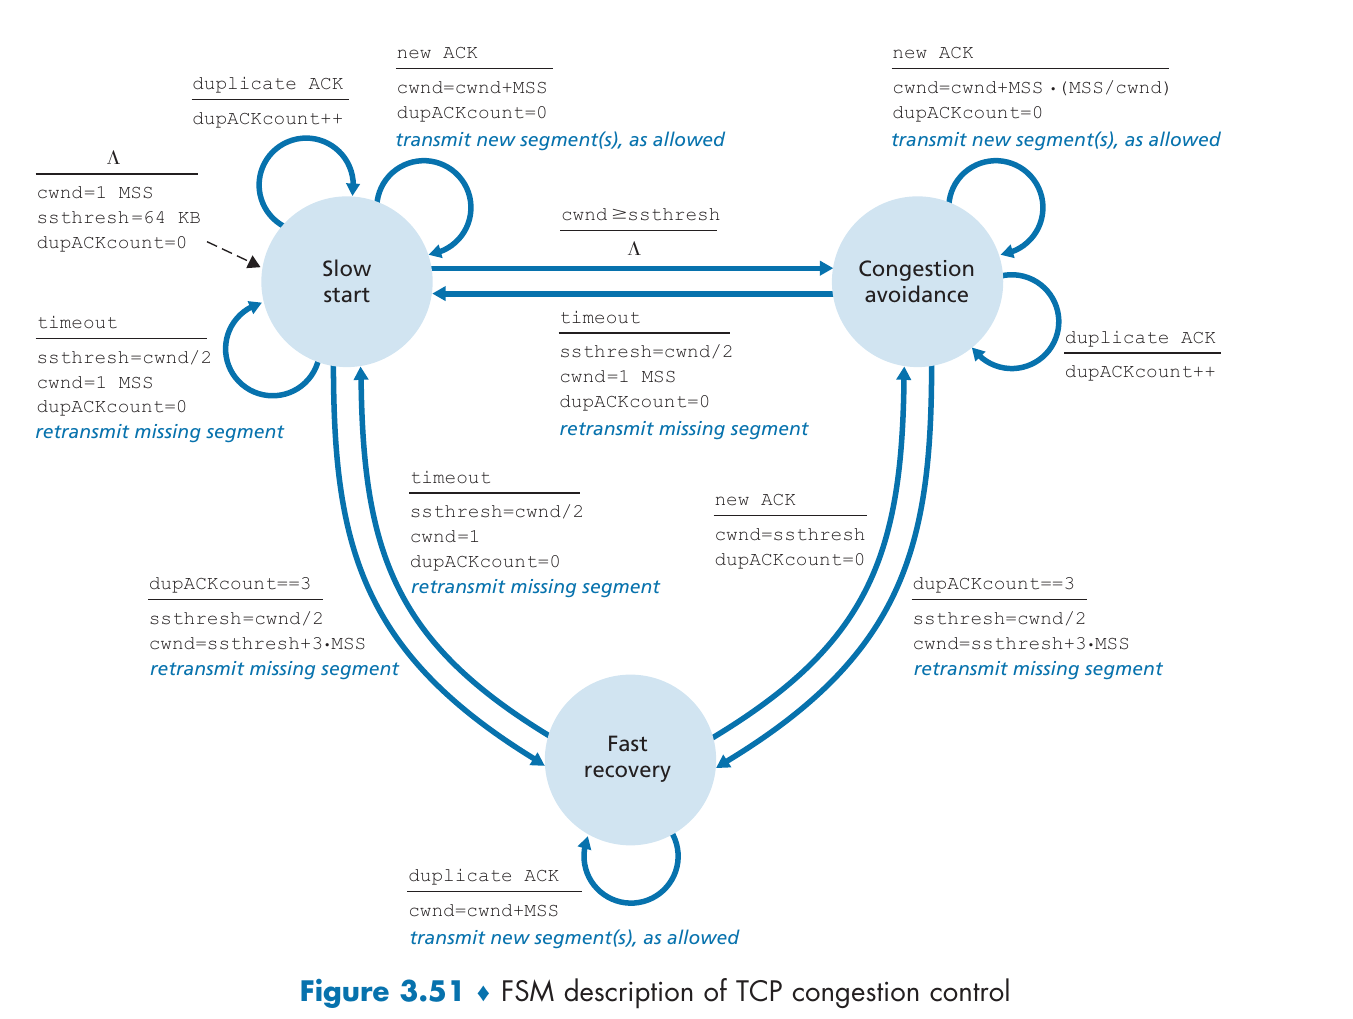
TCP连接的公平性
如果在某一条有限带宽的链路上,不同的TCP连接的传输速率基本相同,则认为该拥塞控制算法是公平的.
在实践中,具有较小RTT的TCP连接能够在链路空闲时更快的占据带宽,从而享用更高的吞吐量;而由于UDP没有拥塞控制,所以需要专门抑制UDP的无限制增长来防止UDP占用所有带宽.
不管怎样,这个问题至今都没有很好的得到解决.
QUIC
QUIC,Quick UDP Internet Connections,与HTTPS同为应用层协议,但它使用UDP作为运输层协议,主要特征如下:
- 数据流: 允许不同的应用程序使用同一个QUIC连接
- 可靠传输: 尽管UDP是不可靠的,但我们可以让QUIC的应用层可靠,即加上数据检验和重传机制
网络层(3/12)
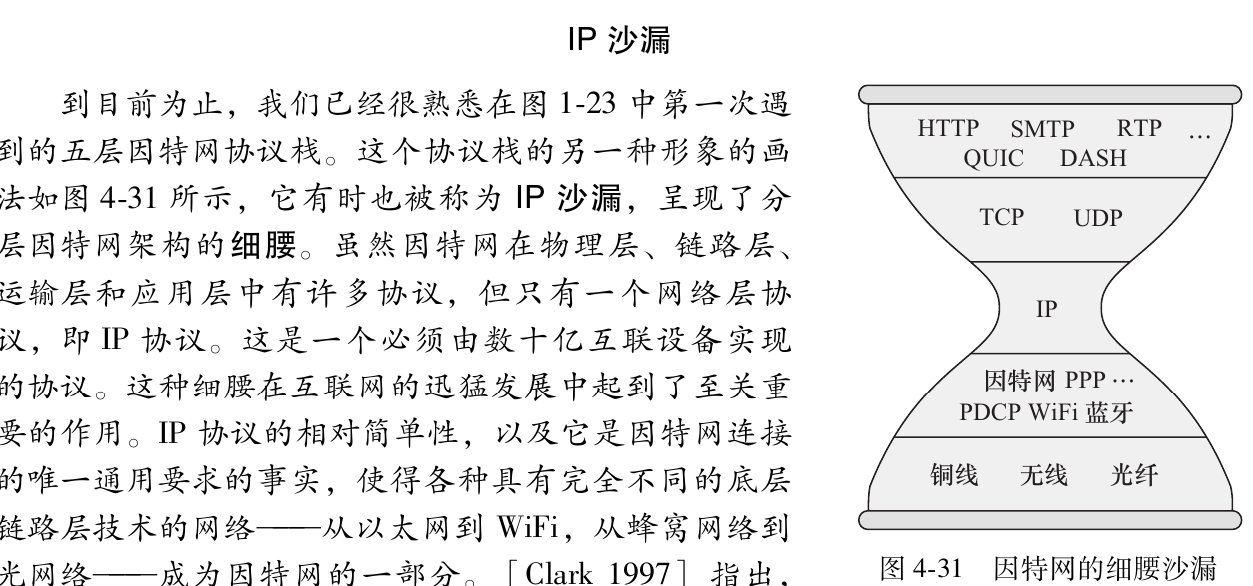
网络层用一句话来表示就是: 通过多个路由器将数据从服务端移动到客户端.为此,网络层需要具备以下两种功能:
- 转发: 当数据输入时,路由器需要将数据移动到适当的输出端口
- 路由选择: 网络层需要解决数据从服务端传输到客户端所采用的路径,相当于规划好了具体要用到的转发路由器
- 注意这里的端口是指物理的输入输出接口,与虚拟的软件端口不是一个概念.
- 网络层不具有重传机制,而是由上层协议来决定是否重传
这样来看的话,网络层便可以分为负责转发功能的数据平面和负责路由选择功能的控制平面.
数据平面
路由器工作原理
路由器有四个组件:
- 输入端口
- 交换结构: 将路由器的输入端口连接到输出端口
- 输出端口
- 路由选择处理器: 主要作用于交换结构
输入端口处理和基于目的地转发
输入端口可以通过转发表和嵌入式的搜索算法来查找传入的ip地址对应的输出端口,故可以在本地实现转发决策,而无需调用路由选择处理器.
交换方法
经内存交换 早期的路由器是传统的计算机,端口之间的交换.一个分组到达一个输入端口时,该端口会先通过中断方式向路由选择处理器发出信号。于是 ,该分组从输入端口处被复制到处理器内存中。路由选择处理器则从其首部提取目的地址,在转发表中查找适当的输出端口,并将该分组复制到输出端口的缓存中.
经总线交换 输入端口经一根共享总线将分组直接传送到输出端口,不需要路由选择处理器的干预.由于总线单一时间只能通过一个数据分组,故交换速率受到总线速率的限制.
经互联网络交换 克服单一、共享式总线带宽限制的一种方法是,使用一个更复杂的互联网络.如纵横式交换机使用由2N条总线构成的互联网络,能够并发转发多个分组,因此是非阻塞的
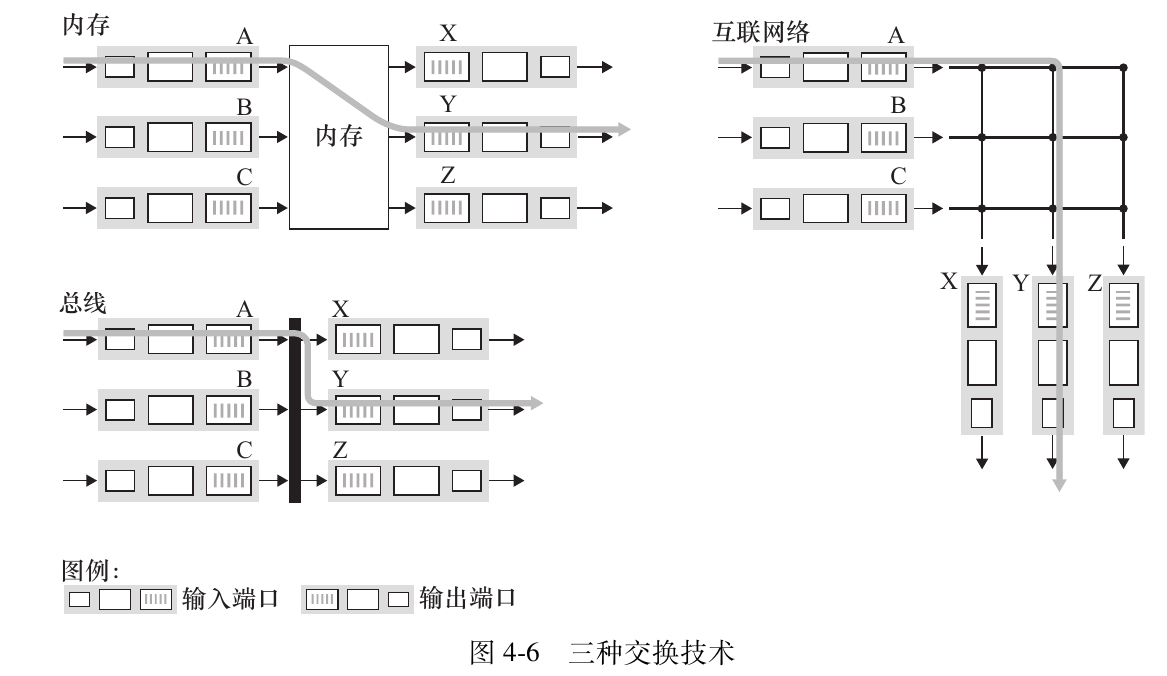
输出端口处理
输出端口处理取出已经存放在输出端口内存中的分组并将其发送到输出链路上
- 分组(packet):从传输层传入的打包好的数据帧
排队问题分析
在输入端口和输出端口处都可以形成分组队列,就像在环状交叉路的类比中我们讨论过的情况,即汽车可能等待在流量交叉点的入口和出口。排队的位置和程度(或者在输入端口排队,或者在输出端口排队)将取决于流量负载、交换结构的相对速率和线路速率。
我们现在更为详细地考虑这些队列,因为随着这些队列的增长,路由器的缓存空间最终将会耗尽,并且当无内存可用于存储到达的分组时将会出现丢包(packet loss)。回想前面的讨论,我们说过分组“在网络中丢失”或“被路由器丢弃”。正是在一台路由器的这些队列中,分组被实际丢弃或丢失。
为什么不加缓存空间? 我们很容易这样想:更多的缓存必定更好,因为更大的缓冲区能承受更大的分组到达率波动,从而降低路由器的丢包率。
但更大的缓冲区也意味着潜在的更长的排队时延。
对于游戏玩家和交互式电话会议用户,几十毫秒的时延就很关键。
如果为了减少丢包而把每跳路由器的缓冲区大小增加10倍,端到端时延可能随之增加10倍。
增加的RTT会使TCP发送方对拥塞或分组丢失的响应变慢:
- TCP依赖RTT来估计超时重传定时器(RTO)。
- RTT增大 → RTO变大 → 检测到丢包后等待更久才重传。
- 拥塞控制窗口增长更慢(慢启动、拥塞避免阶段受RTT影响)。
- 整体吞吐响应性下降,尤其在突发拥塞或间歇性丢包场景。
如何决定分组转发的优先权?
有以下几种调度方法 先进先出( First-In-First-Out,FIFO,也称为First-Come-First-Serve,FCFS) 调度规则按照分组到达输出链路队列的相同次序来选择分组在链路上传输 优先权排队(priority queuing) 针对不同分组或者IP地址配置不同优先级别的权限,每次转发分组时均从当前最高优先级别的队列中选择分组来传输,同一级别则采用FIFO方式 循环排队(round robin queuing discipline)和加权公平排队(Weighted Fair Queuing) 循环排队像优先权排队规则一样给不同分组分类,但是会轮流处理不同类,从而避免低优先级类难以被转发的情况.
加权公平排队会为不同类分配权重,保证在某一时刻下在排队队列中的某一类能够得到对应权重的转发量.
IPv4,IPv6,寻址(3/13)
IPv4数据报格式
网络层中的分组被称为数据报,IPv4数据报的格式如下:
- 版本:使用的IP协议版本,帮助路由器决定如何解释数据报的剩余部分
- 首部长度:用来确定载荷(运输层报文)实际开始的字节
- 服务类型: 可以将不同服务类型的数据报区别开来
- 数据报长度: 首部加上数据的总字节长度,为16bit,故理论最大长度为65535字节,但实际上很少超过1500字节
- 标识,标志,片偏移: 将一个大数据报分片为几个小数据报所需的字段
- 寿命: 确保数据报不会一直在网络中循环
- 协议: 指示数据部分是由哪个协议处理的,例如值为17表示要交给UDP处理
- 首部检验和: 检验是否有数据错误或丢失
- 源IP地址和目的IP地址
- 可选字段: 很少用
- 数据(有效载荷): 来自运输层
IPv4编址
一台主机通常只有一条链路连接到网络 ,当主机中的 IP 想发送一个数据报时,它就在该链路上发送。主机与物理链路之间的边界叫作接口(interface)
路由器与它的任意一条链路之间的边界也叫作接口,因此每台主机与路由器都能发送和接收IP数据报,为了明确源地址和目标地址,故每台主机和路由器接口都有自己的IP地址.
在IPv4协议中,一个IP地址长度为32字节,书写方法为点分十进制记法(dotted-decimal notation),即每个字节都用它的十进制形式书写,因此会有3个点,4个部分,每个部分占8字节,如:
193. 32. 216. 9:11000001 00100000 11011000 00001001
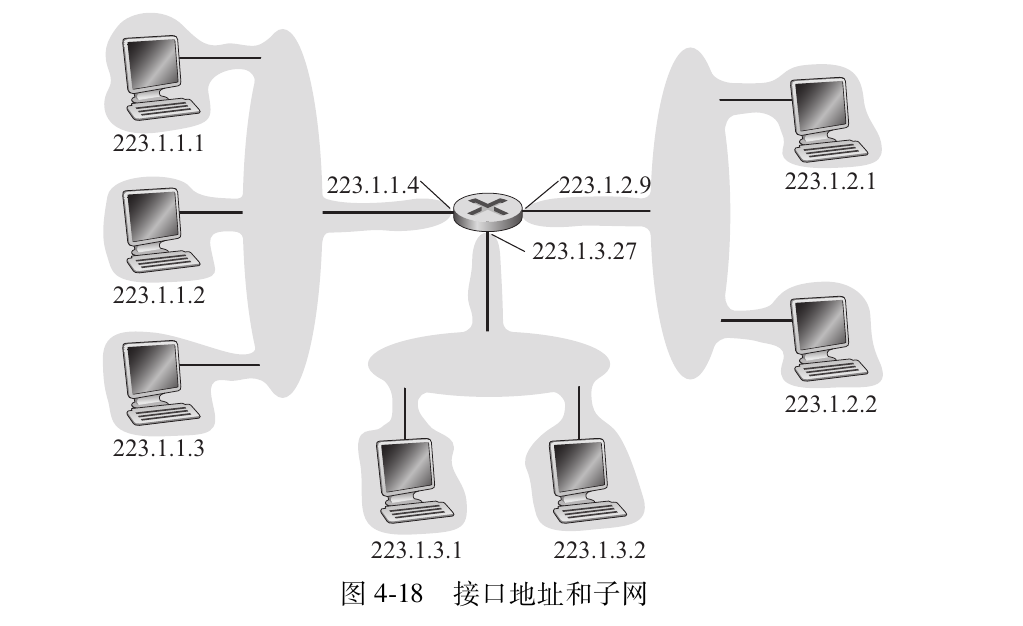
互联这 3 个主机接口与 1 个路由器接口的网络形成一个子网(subnet),IP编址为这个子网分配一个地址223. 1. 1. 0 / 24,其中, /24被称为子网掩码,将地址的前24位设定为该子网的IP地址
表示为255.255.255.0.需要时可以通过将子网掩码与ip地址取和得到子网地址;换句话说,只有前24位等于223.1.1的地址才属于这个子网.
- 可以在cmd输入ipconfig查看自己所属的子网.
IP地址是如何分配的(3/15) IP 地址由因特网名字和编号分配机构(Internet Corporation for Assigned Names and Numbers,ICANN)管理,是非盈利的.
当某个组织获得了被分配的地址块后,可以为本组织内的主机与路由器接口逐个分配 IP 地址,这主要由动态主机配置协议 (Dynamic Host Configuration Protocol , DHCP)完成.
某给定主机每次与网络连接时能得到一个相同的 IP 地址,或者被分配一个临时的 IP 地址. 除了主机 IP 地址分配外,DHCP 还允许一台主机得知它的子网掩码、它的第一跳路由器地址(也就是直连路由器,常称为默认网关)与它的本地 DNS 服务器的地址等其他信息.
网络地址转换(Network Address Translation,NAT)
NAT(网络地址转换) 是工作在路由器等网关设备上的物理逻辑,它允许整个局域网(LAN)内的成百上千台设备,通过同一个公网 IP 地址(WAN 端)访问互联网。
A. 出站请求 (SNAT - Source NAT)
当你的手机(192.168.1.5)访问网站时:
- 原始数据包:源 IP 是
192.168.1.5,源端口是10001。 - 物理改写:路由器将源 IP 修改为自己的 公网 IP(如
1.2.3.4),并将源端口修改为一个新分配的端口(如5000)。 - 记录映射:路由器在 NAT 表中记下一笔:
5000 端口 <-> 192.168.1.5:10001。
B. 入站响应 (DNAT - Destination NAT)
当网站服务器回传数据时:
- 到达数据包:目标地址是
1.2.3.4:5000。 - 物理查询:路由器查找 NAT 表,发现
5000端口对应的是内网的192.168.1.5:10001。 - 物理还原:路由器将目标 IP 和端口还原,数据包准确送达手机。
IPv6
IPv6将地址长度从32bit增加到128bit,确保了IP地址不会被用完,具体结构如下:
- 版本: 4bit长,字段值为6
- 流量类型: 与IPv4的服务类型类似
- 流标签: 对数据流中的某些数据报给出优先权
- 有效载荷长度: 载荷的字节数量
- 下一个首部: 与IPv4中的协议字段含义一样,表示要交付给哪个运输层协议
- 跳限制: 类似于IPv4中的寿命字段,当跳限制计数变为0时,包被丢弃
- 源地址和目的地址
- 数据: 载荷
事实上,IPv6不再使用子网掩码,而是直接用一个整数表示网络部分的位数,写在地址后的斜线后,如:
fe80::49e0/128
如何兼容IPv4
通过将IPv6数据报整个放入IPv4数据报的载荷部分中,并通过协议字段指示接收方这是一个装入了IPv6的IPv4数据报,从而实现了对网络层中使用IPv4路由器的兼容
补充: 泛化转发(4/22)
之所以叫泛化转发(Generalized Forwarding),是因为这里的转发除了网络层之外,还可能会涉及链路层,这与之前路由器的转发并不相同,因此加上泛化两个字来表示这个转发是宽泛而言的.
- 因此,泛化转发使用的设备也不是简单的使用链路层的交换机或者网络层的路由器,而是称为分组交换机
- wiki 泛化转发主要基于OpenFlow标准来执行:
流表(Flow Table)
这是泛化转发的逻辑核心。每个分组交换机内部维护一个或多个流表。每个流表项(Flow Table Entry)由三个核心部分组成:
- 首部字段匹配值(Match):这是“泛化”的具体体现。匹配字段可以涵盖 入端口、源/目的 MAC 地址、以太网类型、VLAN 标签、源/目的 IP 地址、协议号(TCP/UDP)以及源/目的端口号。这种跨 1-4 层的匹配能力,使得分组交换机既可以充当路由器,也可以充当交换机、防火墙或 NAT 设备。
- 计数器(Counter):用于实时统计匹配该规则的分组数量、字节数等。这是流量监控与计费的物理基础。
- 操作(Actions):当分组匹配成功后执行的动作,包括:
- 转发:发送到指定端口。
- 丢弃:执行安全过滤逻辑。
- 修改字段:例如修改 IP 头部(NAT 功能)或重写 MAC 地址(路由功能)。
- 入栈/出栈:针对 MPLS 或 VLAN 标签的封装处理。
匹配-动作(Match-plus-Action)抽象
与传统路由器“查找最长前缀-转发”的单一模式不同,泛化转发将其抽象为通用的“匹配-动作”范式。
- 机制本质:只要分组匹配首部字段(Match),就执行相应操作(Action)。这意味着网络管理员可以自定义非标准的处理流程。
- 流的概念:被相同规则处理的一系列分组被视为一个“流(Flow)”。网络管理的粒度从单纯的“路径选择”细化到了“流控制”。
控制与数据平面分离
OpenFlow 实现了物理上的解耦:
- 数据平面(Data Plane):分组交换机只负责执行流表中的匹配逻辑,逻辑简单且支持硬件加速(通常基于 TCAM 内存)。
- 控制平面(Control Plane):由远程控制器(Controller)统一管理。当交换机遇到无法识别的未知流时,会将其通过 OpenFlow 协议发送给控制器。控制器计算出处理规则后,再下发回交换机的流表中。
换句话说,数据在网络层中转发的时候,不再是简单的通过路由器后再经过交换机,而是直接通过分组交换机转发,从而大幅度减小了传播过程中出差错的概率.因此,泛化转发才是真正的转发,取代了我们之前所说的路由器转发.
中间盒(middlebox)
中间盒: 在源主机和目的主机之间的数据路径上,执行除了 IP 路由器的正常标准功能之外的其他功能的任何中间的盒子,可以提供以下三种功能服务:
- NAT转换
- 安全服务: 如防火墙和电子邮件过滤器等
- 性能增强: 提供内容缓存等功能
控制平面
路由选择算法
按照集中式的还是分散式的来给算法分类:
- 集中式路由选择算法(centralized routing algorithm):也被称为链路状态(Link State,LS)算法,需要提前得知网络中每条链路的开销,从而计算出当前节点的最低开销路径
- 分散式路由选择算法(decentrlized routing algorithm): 每个节点仅有与其直接相连的节点链路开销,通过迭代和通信逐渐计算出最低开销路径,距离向量(Distance Vector)算法是一个代表.
链路状态(LS)算法 通过链路状态广播(link state broadcast)算法来获取整体的节点信息,并根据Dijkstra算法找到最佳路径.
但是,实际应用中会产生振荡(Oscillation)问题,也就是当路由恰巧都沿着最短路径转发时,这条路径的开销由于流量增大而不再是最优路径,因此路由都转向原本开销比较高但现在相对是开销最低的那条线路,又导致这条线路开销变高,路由又都回到原来的路由转发路径上,这样来回切换路径显然不利于网络减小时延.
距离向量(DV)算法 使用Bellman-Ford算法
因特网中自治系统内部的路由选择: OSPF
如果将网络看作一个大规模的路由器互联网络会遇到以下两个问题:
- 规模瓶颈(Scalability):数亿台设备若运行单一路由算法,将导致内存耗尽、广播风暴以及算法(如距离向量)无法收敛。
- 管理自治(Administrative Autonomy):不同 ISP 需要独立控制内部协议、隐藏拓扑结构,并按自身策略进行管理。 因此,设计者将路由器规划成一个自治系统( Autonomous System,AS):
- 构成:处于相同管理控制下的路由器和链路集合。
- 标识:每个 AS 拥有全局唯一的 AS 号 (ASN),由 ICANN 授权机构分配。
- 划分:ISP 可作为一个 AS,也可拆分为多个 AS。
光这样说还不够,看下面这个表格:
| 运营商 | 网络名称 | AS 号 (ASN) | 角色 |
|---|---|---|---|
| 中国电信 | ChinaNet (163 骨干网) | AS4134 | 全球最大的 AS 之一,承载绝大多数宽带流量。 |
| 中国电信 | CN2 (下一代承载网) | AS4809 | 独立的 AS,专注于高质量、低延迟的精品业务。 |
| 中国联通 | 中国联通骨干网 | AS4837 | 原中国网通与联通合并后的核心 AS。 |
| 中国移动 | 中国移动骨干网 | AS9808 | 移动宽带及移动端流量的核心承载 AS。 |
- 这样就很好理解了,当我们接入网络的时候,实际上是进入了某一个运营商的AS,而不是直接接入整个互联网.
在一个AS内部运行的路由选择算法称为(intra-autonomous system routing protocol).
开放最短路优先 ( OSPF )
该算法使用Dijkstra和周期性的路由广播,也就是说:
路由器向自治系统内所有其他路由器广播路由选择信息,而非只向相邻路由器广播. 每当一条链路的状态发生变化时(如开销的变化或连接 / 中断状态的变化), 路由器就会广播链路状态信息 。即使链路状态未发生变化,它也要周期性地(至少每隔 30min一次)广播链路状态.从而能够运用Dijkstra得到正确的结果.
ISP之间的路由选择:BGP
前面讨论的是AS内部的路由选择,现在我们来考虑AS之间的路由选择,在internet中,所有AS运行相同的路由选择协议: 边界网关协议(Border Gateway Protocol,BGP).
BGP的作用
作为一种 AS 间的路由选择协议,BGP 为每台路由器提供了一种完成以下任务的手段:
- 从邻居 AS 获得前缀的可达性信息: 特别是,BGP 允许每个子网向因特网的其余部分通告它的存在。一个子网高声宣布 “我存在,我在这里”,而 BGP 确保在因特网中的所有 AS 知道该子网。如果没有 BGP 的话,每个子网将是隔离的孤岛,即它们孤独地存在,不为因特网其余部分所知和所达。
- 确定到该前缀的 “最好的” 路由: 一台路由器可能知道两条或更多条到特定前缀的不同路由。为了确定最好的路由,该路由器将本地运行一个 BGP 路由选择过程 (使用它经过相邻的路由器获得的前缀可达性信息)。该最好的路由将基于策略以及可达性信息来确定。
- 前缀指的是例如138.16.68/22这样的AS子网
通告BGP路由信息
一个AS中有两种类型的路由器:网关路由器(gateway router)和内部路由器(internal router),网关路由器直接与其他AS中的路由器相连接,内部路由器仅连接AS内部的主机和路由器
与先前AS内部的路由广播类似,网关路由器也会将对应的转发信息传递给相邻的网关路由和内部路由,从而找到不同AS之间的转发路由路径
- IP任播(anycast)
- 路由选择策略
SDN控制平面
ICMP: 因特网控制报文协议
wiki 互联网控制消息协议(英语:Internet Control Message Protocol,缩写:ICMP)是互联网协议族的核心协议之一。它用于网际协议(IP)中发送控制消息,提供可能发生在通信环境中的各种问题反馈。通过这些信息,使管理者可以对所发生的问题作出诊断,然后采取适当的措施解决。
ICMP与传输协议(如TCP和UDP)显著不同:它一般不用于在两点间传输数据。它通常不由网络程序直接使用,除了 ping 和 traceroute 这两个特别的例子.
事实上,ICMP位于IPv4和IPv6报文里面,用于提供网络发生问题时返回报错信息
链路层
OVERVIEW
- 节点: 运行链路层协议的任何设备,包括主机,路由器,交换机,WiFi接入点
- 链路: 连接相邻节点的通信信道
链路层需要提供的服务
- 成帧(framing): 将网络层的数据报封装成链路层帧
- 协调多个节点之间的通信: MAC协议
- 可靠交付: 通过确认和重传确保数据不出错和丢失
- 差错检测
链路层是如何实现的
链路层控制器的大部分功能是在硬件中实现的,但也有部分链路层是在运行与主机CPU上的软件实现的.
差错检测和纠正
奇偶校验
假设要发送的信息D有d比特,在偶校验方案中,发送方附加一个校验比特,使得者d+1个比特中1的总数是偶数;在奇校验方案中则保证是奇数.
接收方只需要检测接收的d+1个比特中1的个数即可以验证是否出现差错,比如在偶校验方案中发现了奇数个1比特,则说明至少出现了1个比特差错.
但如果出现了偶数个比特的差错,那就无法检测出差错了.因此,可以采用二维的奇偶校验方案,通过行和列来检验从而减小没有检测到差错的概率
检验和方法
与TCP/UDP协议中采用的检验和类似.
循环冗余检测(Cyclic Redundancy Check,CRC)(待补充)
双方协商取一个最高位为1的r+1位多项式G,发送方在d位数据段D的后端附加r个附加比特R,使得这个d+r位数据在模2算术下可以被G整除,接收方只需要用G去除这个收到的数据就可以知道是否出现差错.
多路访问协议(multiple access protocol)
该协议的目标是实现多个发送和接收节点对同一个共享信道的访问.
因为所有的节点都能够传输帧,所以多个节点可能会同时传输帧,那么其他节点就会同时接收到多个帧,发生碰撞(collide),这时没有一个节点能够有效获得传输的帧.
在理想情况下,对于速率为 R bps 的广播信道,多路访问协议应该具有以下所希望的特性:
- 当仅有一个节点发送数据时,该节点具有 R bps 的吞吐量;
- 当有 M 个节点发送数据时,每个节点吞吐量为 R / M bps. 这不必要求 M 个节点中的每一个节点总是有 R / M 的瞬间速率,而是每个节点在一些适当定义的时间间隔内应该有 R / M 的平均传输速率;
- 协议是去中心化的; 这就是说不会因某主节点故障而使整个系统崩溃;
- 协议是简单的,使实现不昂贵.
信道划分协议(过)
随机接入协议
在随机接入协议中,一个传输节点总是以信道的全部速率(即 R bps)进行发送. 当有碰撞时,涉及碰撞的每个节点反复地重发它的帧(也就是分组),到该帧无碰撞地通过为止. 但是当一个节点经历一次碰撞时,它不必立刻重发该帧. 相反,它在重发该帧之前等待一个随机时延. 涉及碰撞的每个节点独立地选择随机时延. 因为该随机时延是独立地选择的,所以下述现象是有可能的:这些节点之一所选择的时延充分小于其他碰撞节点的时延,并因此能够无碰撞地将它的帧在信道中发出.
Switched Local Area Networks
Link-Layer Addressing and Address Resolution Protocol(ARP)
MAC地址
A link-layer address is variously called a LAN address, a physical address, or a MAC address.
事实上,并不是主机或路由器具有链路层地址,而是它们的适配器(即网络接口)具有链路层地址
The MAC address is 6 bytes long, giving 2^48 possible MAC addresses. 尽管MAC地址是一个固定值并且是唯一的,但现在有可能用软件改变某个接口的MAC地址.
- 需要注意的是,一般来说一个设备的MAC地址总是不变的,而对应的IP地址总是根据连接到的网络而改变
一般来说,当源适配器要向向一个目的适配器发送帧时,它会讲目的适配器的MAC地址插入帧中,并将该帧发送到局域网中;有时候源适配器或者中途经过的交换机会将帧广播到所有的适配器. 当目的适配器接收到帧时,如果帧中的目的MAC地址与自己的MAC地址匹配,则会提取出封装的数据报并沿着协议栈向上传输;如果不匹配,则直接丢弃这个帧.
- 有时候源适配器需要让局域网的所有适配器接收并处理自己的帧,这个时候,可以在目的地址字段插入一个特殊的MAC广播地址,对于6字节MAC地址的局域网来说,广播地址是48个连续的1组成的字符串
Address Resolution Protocol,ARP(地址解析协议)
为了在发送链路层帧的时候指明接收该帧的适配器,需要提前知道适配器的MAC地址,从而实现包的正确发送,因此我们采用ARP协议来根据适配器对应路由器或主机的IP地址,找到其MAC地址
- ARP: 将网络层地址与链路层地址相互转换的协议.它和DNS的作用基本类似,但一个重大区别是: DNS可以解析因特网上任意主机或者域名为IP地址,但ARP只为同一个子网的主机和路由器接口解析IP地址为MAC地址 ARP原理
每台主机或者路由器在内存中有一个ARP表(ARP table),包含了IP地址与MAC地址的映射关系,还有保存时限值,指示了从表中删除该映射的时间.
主机要发送帧前,先要发送一个ARP packet给自己的适配器,这个ARP分组包括发送和接收方的IP地址以及自己的MAC地址,指示适配器使用MAC广播地址发送这个分组并发送该链路层帧,从而让子网的所有适配器接收这个分组,IP地址与该ARP packet中包含的目的IP地址匹配的适配器会向发送方传回一个响应ARP packet,让发送方可以更新它的ARP表.
- 从这个角度来看,ARP与IP处于同一级别,都位于网络层 如何跨越子网传输数据 通过上面的论述,我们可以发现,ARP只适用于子网内部的转发,当我们要跨越子网转发数据时,应该先将数据转发给网关路由,再由网关路由来根据链路层帧包含的IP地址跳到下一个路由器,直到转发到目标主机的网关路由,再将数据交给目标主机
以太网(Ethernet)
- 以太网(Ethernet)几乎完全占据了有线局域网市场
以太网的帧结构
- Data field (46 to 1,500 bytes): This field carries the IP datagram. The minimum size of the data field is 46 bytes.This means that if the IP datagram is less than 46 bytes, the data field has to be “stuffed” to fill it out to 46 bytes.
- Destination address (6 bytes): This field contains the MAC address of the destination adapter.
- Source address (6 bytes): This field contains the MAC address of the adapter that transmits the frame onto the LAN
- Type field (2 bytes): 指示数据字段所用网络层协议的类型
- Cyclic redundancy check (CRC) (4 bytes): 检测帧差错
- Preamble (8 bytes): 用于唤醒适配器,告诉它现在有一个以太网帧来了
以太网的无连接传输
以太网技术向网络层提供不可靠服务. 具体来说, 当适配器 B 收到一个来自适配器 A 的帧, 它对该帧执行 CRC 校验, 但是当该帧通过 CRC 校验时它既不发送确认帧; 而当该帧没有通过 CRC 校验时它也不发送否定确认帧. 当某帧没有通过 CRC 校验, 适配器 B 只是丢弃该帧. 因此, 适配器 A 根本不知道它传输的帧是否到达了 B 并通过了 CRC 校验.
在链路层缺乏可靠传输有助于使以太网变得简单且便宜. 但是这也意味着传递到网络层的数据报流可能存在间隙.
如果由于丢弃了以太网帧而存在间隙, 主机 B 上的应用也会看见这个间隙吗? 正如我们在第 3 章中所学到的, 这完全取决于该应用是使用 UDP 还是 TCP.
- 如果应用使用的是 UDP, 则主机 B 中的应用确实会看到数据中的间隙.
- 另一方面, 如果应用使用的是 TCP, 则主机 B 中的 TCP 将不会确认包含在丢弃帧中的数据, 从而引起主机 A 的 TCP 重传.
注意到当 TCP 重传数据时, 数据最终将回到曾经丢弃它的以太网适配器. 因此, 从这种意义上来说, 以太网确实重传了数据, 尽管以太网本身并不知道它正在传输的是一个包含全新数据的全新数据报, 还是一个包含已经被传输过至少一次的数据的数据报.
链路层交换机(Link-Layer Switches)
转发和过滤
Filtering is the switch function that determines whether a frame should be forwarded to some interface or should just be dropped. Forwarding is the switch function that determines the interfaces to which a frame should be directed, and then moves the frame to those interfaces.
假定目的地址为 DD-DD-DD-DD-DD-DD 的帧从交换机接口 x 到达,那么会有以下三种情况:
- 交换表中没有对应 DD-DD-DD-DD-DD-DD 的表项,则将这个帧广播到所有接口(除了接口x,因为帧是从接口x来的)
- 交换表中有对应 DD-DD-DD-DD-DD-DD 的表项,但是对应接口为x,那么显然你不可能把从接口x收到的帧再送回接口x,只能就地丢弃这个帧
- 交换表中有对应 DD-DD-DD-DD-DD-DD 的表项,对应接口不是x而是y,那么交换机就需要把这个帧送入接口y
疑问:第二种可能中,如果是局域网通信的话,那不就有可能用的是同一个接口吗?
在局域网(LAN)中,如果两个主机 A 和 B 都在“同一个接口”下,通常只有两种物理物理场景:
- 场景 A:接了集线器(Hub) 你将 A 和 B 都接在一个外接 Hub 上,再把 Hub 连到交换机的接口 $x$。
- 场景 B:共享介质(旧式同轴电缆) 所有主机物理上连在同一根线上。
交换机(Switch)的核心作用是隔离冲突域并跨端口转发。
当主机 A 发送一个目的 MAC 为 B 的帧进入接口 $x$ 时:
- 查表:交换机查找 MAC 地址表,发现 B 的 MAC 对应接口也是 $x$。
- 判断:交换机意识到,“目的地”和“来源地”都在同一个物理方向上。
- 结论:如果 A 和 B 都在接口 $x$ 下方,那么当 A 发出信号时,信号在到达交换机之前,物理上已经流经了 B(如果是 Hub 或共享总线)。
底层逻辑:交换机认为,既然目标 MAC 就在接收端口所在的网段内,那么目标主机 B 应该已经通过物理介质直接收到了这个帧。如果交换机再把它从接口 $x$ “弹回”去,不仅是浪费带宽,更会导致 B 收到两份重复的数据帧。
交换表的建立与交换机的自学习
- 交换表初始为空
- 对于在每个接口接收的帧,交换机会在表中记录以下信息:
- 该帧的源MAC地址
- 该帧是从哪个接口进来的
- 当前时间
- 如果一段时间后,交换机没有接收到过与记录的源MAC地址相同的帧,那么就会在表中删除这个地址
那么,让我们来详细分析一个新产生的帧被目的MAC地址对应的交换机接收的过程:
- 当这个帧进入第一个交换机时,由于交换机不认识这个帧,故会在所有接口转发该帧并记录该帧信息
- 经过很多次转发,在传播路径上的交换机都记录了该帧的三种信息
- 当目的MAC地址对应的交换机接收到该帧时,由于目的MAC地址对应的服务器一定已经将自己的信息存在了该交换机中(思考一下是为什么),那么只需要将该帧送入服务器的适配器即可完成整个流程.
虚拟局域网(VLAN)
- wiki
- 由于书上讲的不明不白,所以去额外找资料了
VLAN的工作原理是在广播域内转发的网络帧上添加标签,从而使网络流量看起来如同被分割在不同的网络中。这样即使在同一个物理网络,VLAN也能将网络隔离开来,而无需部署多套电缆和网络设备。
无线网络概览
前面谈的都是有线网络,现在来谈谈WiFi,4G等无线网络,它由以下三个要素组成:
- 无线主机: 可以是手机,电脑,家用电器,可以是移动的,也可以是位置固定不动的
- 无线链路: 主机通过无线链路连接到一个基站或者另一个主机
- 基站: 负责收发无线链路数据
我们可以把无线网络分为四类:
- 具有基站的单跳: 基站和主机之间可以直接通信,不需要经过中继节点,日常见到的无线网络如WiFi和4G都属于这一类型
- 无基站的单跳: 由一个主机进行收发无线数据,其他设备与该主机通信,而不通过基站,蓝牙协议便是典型的例子
- 具有基站的多跳: 主机与基站通信需要经过中继节点
- 无基站的多跳: 通过多个主机节点进行通信,这显然是最难设计的一类网络
无线链路的特征
与有线链路相比,无线链路有以下三个特点:
- 信号强度递减: 电磁波穿过物体时强度将减弱,也就是路径损耗
- 来自其他通信源的干扰: 同一频段的电磁波会相互干扰
- 多路径传播: 电磁波会经过地面或者物体反射,导致出现多径传播的问题 显然,无线网络更容易出现差错,因此我们需要使用更为可靠的传输方法.
- 信噪比( Signal-to-Noise Ratio,SNR):单位为dB,是接收到的信号振幅与噪声幅度比值的以10为底的对数的20倍,显然,信噪比越大,信号就越干净.
- 比特差错率(BER): 接收方收到的一个比特为错误的概率
物理层的通信有以下特点:
- 使用同一个调制方法,SNR越高,BER越低: 因此发送方可以通过增加传输功率提高SNR来降低BER,但是这样会消耗更多的能量,并且当功率超过阈值时不再有实际增益
- 对于给定的SNR,调制方法的传输速度越高BER越高,这很容易理解,速度越快越容易出差错
- 对于给定的信道我们可以采用不同的调制技术
WiFi
尽管无线局域网(WLAN)的通信有很多技术可以选用,但是WiFi占据着统治地位.
WiFi的正式名称为IEEE 802. 11 无线局域网
基本服务集 (BSS) 是WiFi的基本构件,有两个部分:
- 无线站点 (Station):手机、笔记本等终端设备。
- 接入点 (Access Point,AP):起中央基站作用的节点。
信道与关联
当管理员安装AP时,需要为AP分配一个服务集标识(Service Set Identifier,SSID)和一个信道号.
802.11运行在 2. 4GHz ~ 2. 485GHz的频段中,由11个部分重叠的信道组成, 当且仅当两个信道由 4 个或更多信道隔开时它们才无重叠,因此管理员需要指示AP的信道号避免影响到其他AP.
显然,当你进入咖啡馆时,你可以收到很多个AP传来的信号,那么我们是符合与一个特定AP连接的呢? 802.11协议要求每个AP周期性的发送信标帧,该帧包括该AP的SSID和MAC地址,供无线站点接收并处理;当然,主机也可以自己发送广播帧来主动扫描附近的AP,选定关联AP,具体过程如图所示:
选定与之关联的 AP 后,无线主机向该 AP 发送一个关联请求帧,并且该 AP 以一个关联响应帧进行响应。注意,对于主动扫描需要第二个请求 / 响应握手 ,因为一个对初始探测请求的帧进行响应的 AP 并不知道主机选择哪个 ( 可能多个 ) 响应的 AP 进行关联 , 这与 DHCP 客户能够从多个 DHCP 服务器中进行选择有诸多相同之处
与AP连接之后,主机便会发送DHCP报文获取自己的IP地址,从而与互联网连接.
802. 11采用的传输协议: CSMA/CA
802.11采用的MAC协议类型为随机接入协议,称为带碰撞避免的CSMA(CSMA with collision avoidance), 简称为CSMA/CA.
之所以802.11采用碰撞避免而非和以太网相同的碰撞检测,有以下两个原因:
- 检测碰撞需要主机同时具有发送信号和接收其他站点信号的能力,而802.11适配器接收到的信号强度往往远小于发送出去的信号强度
- 无线信号存在衰减,多路传播,隐藏终端等问题,无法检测到所有的碰撞
802.11的链路层确认方案
由于无线链路中的帧不能无损的到达目的地,因此802.11采用链路层确认方案来实现重传机制.
目的站点收到一个通过CRC校验的帧后,等待一小段时间-这被称为短帧间间隔(short inter-frame spacing),然后发回一个确认帧,如果发送站点在给定时间内没有收到确认帧,它就假定出现了错误并进行重传,如果若干次重传后仍未收到确认帧,则放弃发送并丢弃该帧.
为什么现代以太网不重传而802.11重传
因为802.11的环境极易丢包,如果依靠上层协议如TCP的重传机制,由于跨越了多层硬件,传输速率将会大幅度下降;而以太网线路的环境非常稳定,发生丢包的概率几乎为零,将少量的丢包问题交给上层协议处理可以减少不必要的设计复杂度.
CSMA/CA协议的详细原理
- 如果有一个帧要发送,发送站监听到信道空闲时,它等待一小段时间后发送该帧-这被称为分布式帧间间隔(distributed inter-frame space)
- 如果信道被占据,则站点选取一个随机回退值,在侦听到信道空闲时减小该值,信道繁忙时则保持该值不变
- 计数值减到零时,该站点发送帧并等待确认
- 如果收到确认,则帧被正确接收.如果要传输另一个帧,站点将从第二步重新开始;如果没收到确认,则站点进入第二步并在一个更大的范围内选取随机值 满格信号网速仍然很慢的原理 当大量主机使用同一个AP时,为了避免碰撞,单一主机的等待时间大量延长,从而导致了网速的降低;同时,AP的上行光纤容量有限,不允许所有设备以最大功率同时传输.
处理隐藏终端问题
- 尽管每个无线站点对AP都不隐藏,但两者彼此是隐藏的
当H1和H2要发送帧时,由于它们彼此是看不见的,因此都以为信道是空闲的,就会同时发送并导致碰撞.
为了避免碰撞,802.11通过让站点使用请求发送(Request to Send,RTS)控制帧和允许发送(Clear to Send,CTS)控制帧来预约何时访问信道.
发送方在发送帧之前,首先向AP发送一个RTS帧,指示自己传输帧和收到确认帧所需的总时间,AP收到该帧后广播一个CTS帧,指示发送方明确的发送许可并告知其他站点在这段时间内不要发送,从而避免碰撞.
- 这两个控制帧都很短,所以在这个过程中发生碰撞的可能性很小
尽管 RTS / CTS 交换有助于减少碰撞 , 但它同样引入了时延并消耗了信道资源。因此 ,RTS / CTS 交换仅仅用于为长数据帧预约信道 。 在实际中,每个无线站点可以设置一个 RTS门限值,仅当帧长超过门限值时,才使用 RTS / CTS 序列。对许多无线站点而言 ,默认的RTS 门限值大于最大帧长值 , 因此对所有发送的 DATA 帧,RTS / CTS 序列都被跳过。
802.11的帧结构
接下来对其中的重要组成部分做一点分析:
- 有效载荷与CRC字段
- 地址字段: 地址4仅在AP相互转发时使用,前三个字段的定义如下:
- 地址1是要接收该帧的站点MAC地址
- 地址2是传输该帧的站点MAC地址
- 地址3是子网默认网关的MAC地址
- 序号,持续期,帧控制字段
无线站点在同一子网中的不同BSS之间移动
随着 H1 逐步远离 AP1 ,H1 检测到来自 AP1 的信号逐渐减弱并开始扫描一个更强的信号.H1 收到来自 AP2 的信标帧. H1然后与 AP1 解除关联,并与AP2 关联起来,同时保持其 IP 地址和维持正在进行的 TCP 会话.新AP2 会发送以太网广播,强制沿途交换机更新路径.
蓝牙
蓝牙网络运行在 2.4 GHz ISM(工业、科学、医学) 免授权频段。由于该频段同时被微波炉、车库门遥控器和无绳电话等多种设备占用,蓝牙在设计之初就将抗噪与抗干扰作为核心目标。
蓝牙的物理原理
- 时分复用(TDM):蓝牙无线信道被划分为时长为 625 微秒 的时间隙。
- 频分跳频扩展频谱(FHSS):在每个时间隙中,发送端在 79 个信道中的某一个进行传输。信道(频率)在每个时隙间按照已知但伪随机的规律切换。
- 抗干扰逻辑:通过跳频技术,即使 ISM 频段内存在其他设备的干扰,也只会影响到极少数特定时隙的蓝牙通信,从而保证了整体链路的稳健性。目前蓝牙数据速率最高可达 3 Mbps。
蓝牙网络的结构
在蓝牙网络(Piconet)中,设备角色分为以下三类:
- 主节点 (Master Device):核心控制单元,负责管理连接数量、调度时隙以及控制所有连接设备的传输功率。
- 客户设备 (Client/Slave Device):受控单元,遵循主节点的跳频序列进行通信。
- 存放设备 (Parked Device):低功耗睡眠模式设备。它们保持与主节点的同步,但不参与数据传输,仅在需要时由主节点唤醒进入活跃状态。
主节点如何与其他设备连接
连接过程本质上是一个从“频率盲区”到“时间与频率双重同步”的过程,分为 查询(Inquiry) 和 寻呼(Paging) 两个阶段:
- 第一阶段:设备发现(查询)
- 广播探测:主节点在 32 个不同的信道上轮流发送询问消息,并将该序列重复传输多达 128 次,以确保覆盖所有可能的监听频率。
- 被动监听:潜在的客户设备在自己随机选择的频率上进行监听。
- 随机回退机制:一旦客户设备接收到查询,它会在 0 ~ 0.3 秒 之间选择一个随机时间量进行回退。这种“随机退避”设计是为了防止多个客户设备同时响应主节点而引发信号冲突。
- 身份响应:回退结束后,客户设备发送包含其唯一设备 ID 的报文响应主节点。
- 第二阶段:建立连接(寻呼)
- 定向寻呼:主节点在发现范围内所有潜在设备后,开始针对特定设备发送 32 条寻呼邀请报文。由于此时客户设备尚未获得跳频序列,主节点仍需在多个频率上重复发送。
- 确认握手:客户设备接收到寻呼报文后,返回 ACK(确认) 报文。
- 参数交付:主节点随后向客户设备发送关键配置信息,包括:
- 跳频序列模式(告知未来的频率路径)。
- 时钟同步信息(校准通信时间基准)。
- 活跃成员地址(分配逻辑地址)。
- 轮询激活:最后,主节点使用已同步的跳频模式对该客户设备进行轮询(polling)。一旦回复成功,双方正式进入连接状态,实现网络层面的握手。
更上层发生了什么
我们可以发现,蓝牙的链路层连接逻辑与其他的协议完全不同,这从而说明蓝牙的上层逻辑也与其他的协议不同,这里就不介绍了.
Cellular Networks: 4G and 5G
无线网络分为无线局域网和无线广域网,我们前面所说的WiFi和蓝牙就属于局域网,而这里的4G/5G就属于广域网了.
The term cellular(蜂窝) refers to the fact that the region covered by a cellular network is partitioned into a number of geographic coverage areas, known as cells. Each cell contains a base station that transmits signals to, and receives signals from, the mobile devices currently in its cell.
4G LTE Cellular Networks: Architecture and Elements
The 4G networks that are pervasive as of this writing in 2020 implement the 4G Long-Term Evolution standard, or more succinctly 4G LTE.
4G网络由以下几个部件构成:
- Mobile device: 连接到蜂窝运营商网络的智能手机 、 平板电脑、笔记本电脑或物联网设备
- 该移动设备还具有全球唯一的 64 位标识符,称为国际移动用户身份 ( IMSI),存储在其 SIM ( 用户身份模块) 卡上。IMSI 在全球蜂窝网络系统中识别用户,包括用户所属的国家和归属蜂窝网络 。
- Base Station: The base station is responsible for managing the wireless radio resources and the mobile devices with its coverage area.
- 这类似于WiFi中的AP,但还有很多额外的功能
- Home Subscriber Server (HSS): The HSS is a database, storing information about the mobile devices for which the HSS’s network is their home network.
- Serving Gateway (S-GW), Packet Data Network Gateway (P-GW), and other network routers: 用于实现NAT,路由转发等功能
- Mobility Management Entity (MME): 控制平面部件,用于验证设备,设置路径,追踪设备位置
无线链路对高层协议的影响
鉴于无线链路传播的比特差错率远高于有线链路,因此需要对上层协议如TCP连接做出针对性的处理
在所有情况下,TCP 的接收方到发送方的 ACK 都仅仅表明未能收到一个完整的报文段,发送方并不知道报文段是由于拥塞或切换 , 还是由于检测到比特错误而被丢弃的。在所有情况下 ,发送方的反应都一样 , 即重传该报文段 。 TCP 的拥塞控制响应在所有场合也是相同的 ,即 TCP 减小其拥塞窗口,这会导致带宽利用率骤降.
链路层重传 (LL-ARQ)
这是解决无线丢包的最前线。LTE、5G 或 Wi-Fi 协议在数据链路层(MAC/RLC 层)实现了快速重传。
- 机制: 基站与终端之间发现包序列不连续时,直接在二层进行重传,不向网络层汇报。
- 代价: 引入了抖动 (Jitter),因为链路层重传会导致部分包延迟到达。
拥塞控制算法的进化 (BBR)
Google 提出的 BBR (Bottleneck Bandwidth and RTT) 算法改变了判断逻辑。
- 原理: BBR 不再将“丢包”作为减速信号。它通过周期性探测带宽极大值和延迟极小值来构建网络模型。
- 实战表现: 在一定比例(如 5% ~ 15%)的随机丢包环境下,BBR 能维持几乎满带宽的传输速率,而 CUBIC 则会因为不断减半窗口而彻底卡死。
选择性确认 (SACK)
原生 TCP 采用累积确认,丢一个包可能导致后续一连串包被重传。
- 机制: 启用
TCP_SACK选项。接收端在 ACK 中告知发送端具体哪些数据块(Ranges)已收到。 - 效果: 发送端可以精确补齐缺失的数据,而不是盲目重传所有未确认的包。
拆分连接协议 (Split-TCP / Proxy)
在移动通信核心网中,常使用 PEP (Performance Enhancing Proxy)。
- 拓扑:
终端 <——无线链路——> 基站/边缘网关 <——有线主干——> 服务器。 - 机制: 将一个 TCP 连接拆分为两段。无线段使用针对高丢包优化的协议(如调整过初始窗口、禁用慢启动退避的私有协议),有线段保持标准 TCP。
- 逻辑: 避免了无线端的局部丢包反馈到远端服务器,缩短了重传的往返时间 (RTT)。
网络安全
网络通信中的安全需要满足以下要求:
- 机密性(confidentiality): 仅有发送方和希望的接收方能够理解传输报文的内容,这需要报文能够被加密和解密
- 完整性(message integrity): 通信内容在传输过程中不应该被篡改,这需要我们实现数据检验和可靠的传输通道
- 通信认证(end-point authentication): 发送方和接收方都需要能够证明另一方的身份是真实的
- 防御恶意攻击(operational security): 通过防火墙和入侵检测系统来防御网络攻击
密码学
我们现在假设A要向B发送一个报文,最初的文本被称为明文(plaintext),A使用密钥(key)m来加密明文,从而得到密文(ciphertext),并将其发送出去.
B为了解密这个密文,需要使用密钥n来处理这个密文,从而得到明文.
显然,加密过程中最关键的就是密钥了,根据密钥是否对称(相同)可以将加密方式分为两种:
- 对称密钥系统: A和B所用的密钥是相同而且保密的,否则就没有任何意义了
- 非对称密钥系统(也称为公开密钥系统): 有两个密钥,一个是公开的密钥,称为公钥,所有人都可以获取;另一个是只有A或者B才知道的密钥
攻击手段
根据攻击者掌握的信息,大致有三种攻击手段:
- 密文攻击: 入侵者只截取到了密文,破解难度最高
- 已知明文攻击: 攻击者事先知道部分明文对应的密文
- 选择明文攻击: 攻击者能够选择任意一段明文并获取对应的密文,破解难度最低
对称密钥
Caesar Cipher(凯撒密码)
密钥为字母表偏移量,很容易被破解
Block Cipher(块密码)
- TLS采用的就是这个加密方式 将明文划分为固定长度k的块,通过一一对应的映射函数将其转换为相同长度的密文块.如果我们让k=3,就需要让000到111这8个输入转换到对应的三比特输出.
尽管当增大k值时转换表的破解难度大幅度上升,但交流的双方都需要维护一张2^k大小的转换表,这不太现实.
因此,块密码使用函数来模拟转换表,例如:当k=64时,我们可以把64比特块划成8个子块,每个8比特块按照一张独特的k=8的转换表处理,然后将转换后的64比特按照一定规则打乱后再分为8个子块进行处理,进行多次循环.这种算法的密钥是8张k-8的转换表.
- 如果用 1 秒破解 56 比特 DES 的计算机 ( 就是说,每秒尝试所有 2^56个密钥 ) 来破解一个 128 比特的 AES 密钥 ,要用大约 149 万亿年的时间才有可能成功
Cipher-Block Chaining: 引入随机性
前面的块密码有一个缺陷: 如果有多个块中的明文内容相同,如"HTTP/1.1"这类常见的前缀词,那么将会得到相同的密文,从而被攻击者探测到并进行破解.
因此,我们可以在加密时引入随机数,如下图所示:
这样一来,即使明文相同,得到的密文也会不同,而密文相同时,得到的明文可能相同,破解难度大幅上升.
同时,实际应用中不太可能一个个传输随机数,故块密码使用密码块链接(Cipher-Block Chaining,CBC)来高效传输接收方所需的随机数,基本方法如下:
- 在发送数据之前,发送方生成一个随机的k比特串(对应k比特块加密),称为初始向量(Initialization Vector,IV).表示为c(0),并以明文方式发给接收方
- 对第一个块,发送方计算 c(1) = Ks(m(1) ⊕ c(0))后发送密文
- 对于第 i 个块,发送方根据 c(i) = Ks(m(i) ⊕ c(i-1)) 生成第 i 个密文块
非对称密钥
该类型的密钥有三个关键要素:
- 一个公开的加密算法和一个公开的解密算法
- 一个公开的密钥,称为公钥
- 只有通信中的某一方才知道的密钥,称为私钥
使用非对称密钥的通信过程如下: 发送者用加密算法和公钥来加密报文,接收者使用解密算法和私钥来解密报文.
但是,这种加密方式有不少问题:
- 如何保证加密后的报文不会被破解?
- 由于任何人都可以通过公钥加密报文后发送给接收方,如何确定发送者是可靠的?
尽管有很多算法可以解决上述问题,但RSA算法已经成为了非对称密钥的代名词.
RSA算法
为了生成RSA的公钥和私钥,接收方需要执行以下步骤:
- 选择两个大素数p和q,值越大就越难破解.
- 计算
n=pq和z=(p-1)(q-1) - 选择小于n的一个数e,使得e和z互质.
- 选择一个数d,满足
ed mod z = 1 - 那么接收方的公钥由(n,e)组成,私钥由(n,d)组成
通信过程如下:
- 发送方发送的报文以二进制形式表示为一个整数m,由于报文的位数有限,故m一般不会很大,在RSA算法中要求m < n,然后计算
c = m^e mod n,从而得到密文c,并交给接收方. - 为了解密c,接收方计算
m = c^d mod n,得到报文m.
举一个简单的例子:
- 接收方选择p=5和q=7,得到n=35和z=24,在5,7,11等与24互质的数中选择一个数,比如说5,那么由于
(5x29)-1可以被24整除(尽管5x5-1等取值也可以被24整除,但假设我们是随机取值取到了29),则d=29. - 发送方使用(35,5)加密报文,接收方使用(35,29)报文.
会话密钥
由于大数据的指数运算非常耗时,所以实际应用中我们可以把对称密钥和RSA结合在一起,用RSA来加密对称密钥算法中所需的密钥.这个被加密的密钥称为会话密钥(session key)
RSA原理
RSA运用了两个数论中的结论,这里不做说明,我们只需要知道通过(n,e)和(n,d)就足够进行加密和解密,攻击者如果想暴力破解,唯一的方法是:
- 试图从公开的 n 中分解出两个原始质数 p 和 q。
- 只有得到 p 和 q,才能计算出
z = (p-1)(q-1)。 - 通过
ed ≡ 1 mod z解出私钥 d。
RSA 的安全性依赖于这样的事实:目前没有已知的算法可以快速进行一个数的因数分解 ,这种情况下公开值 n 无法快速分解成素数 p 和 q。如果已知 p 和 q ,则给定公开值 e, 就很容易计算出秘密密钥 d 。 另一方面,不确定是否 存在 因数分解一个数的快速算法 , 从这种意义上来说,RSA 的安全性也不是确保的 。
报文完整性的鉴别和数字签名
接收方验证某条消息是否可靠,需要检测以下两个因素:
- 该报文来自可靠的发送方
- 该报文在途中没有被篡改
加密哈希函数(cryptographic hash function)
- hash function: 任意输入都会得到相同长度的输出
- cryptographic hash function: 在哈希函数的基础上,需要额外保证: 找到一个不同的输入得到相同的输出是基本不可能的.
从加密哈希函数的定义就可以看出来,攻击者一般来说是无法用其他报文伪造原报文的,从而保证该报文不会被篡改.
常用的加密哈希函数有以下几种:
| 算法 | 哈希长度 | 基本逻辑 | 安全性现状与建议 |
|---|---|---|---|
| MD5 | 128 位 | 将输入信息按 512 位分组,通过复杂的压缩函数进行多轮迭代处理,生成 128 位哈希值。 | ❌ 已破解,可人为制造碰撞。任何安全场景下都不应使用。 |
| SHA-1 | 160 位 | 逻辑与 MD5 类似,哈希值更长(160 位),处理步骤更复杂,安全性有所提升。 | ⚠️ 已不足够安全,存在理论碰撞攻击,Google 等已在 2017 年实现碰撞。应避免使用。 |
| SHA-2 | 224 / 256 / 384 / 512 位 | 采用 Merkle-Damgård 结构,更多轮次和更复杂的逻辑(如更多常量)。其中 SHA-256 和 SHA-512 最常用。 | ✅ 广泛认为安全,是替代 MD5 和 SHA-1 的首选标准。 |
| SHA-3 | 224 / 256 / 384 / 512 位 | 采用全新的 Keccak 海绵函数结构,与 SHA-2 设计思路完全不同,提供更高的安全冗余。 | ✅ 安全性高,可作为 SHA-2 的备选方案。 |
报文鉴别: 使用哈希函数和鉴别密钥
使用哈希函数,我们可以这样验证报文的完整性:
- Alice生成报文m并计算散列H(m).
- 然后Alice将H(m)附到报文m上,生成一个扩展报文(m, H(m)),并将该扩展报文发给Bob.
- Bob接到一个扩展报文(m, h)并计算H(m). 如果H(m) = h,Bob得出结论:一切正常.
但这种方法有一个问题: 攻击者可以声称他就是Alice,并将报文发送给Bob,这显然可以通过报文完整性的验证.
因此,我们还需要加入鉴别密钥(authentication key),即一个被双方共享的秘密比特串,在下述过程中我们将其称为s.
- Alice生成报文m,加入s生成m+s,并计算H(m+s),这被称为报文鉴别码(Message Authentication Code,MAC).
- 然后Alice将MAC附加到报文m上,生成扩展报文(m, H(m+s)),并将该扩展报文发送给Bob.
- Bob接收到一个扩展报文(m,h),由于知道s,计算出报文鉴别码H(m+s).如果H(m+s)=h,Bob得出结论:一切正常.
数字签名
有时候,我们会需要用一个数字签名(digital signature)来标识某个文件,这个数字签名一定是独一无二,不可篡改的,这样才可以保证能够分辨出该文件的所有者.
一种方法是发送方使用某一加密哈希函数取得报文的hash值,并用私钥加密该hash值;而在验证这个签名时,接收方只需要用公钥去解密这个hash值,如果计算结果与该文件的hash值一致,则证明报文的来源可靠
公钥认证
要让公钥密码生效,必须要证明你使用的公钥来源可靠,比如A和B通信时,A需要证明报文中的公钥确实来自B.
因此,我们需要通过CA(certification authority)来将公钥与特定实体(一个人,一台路由器,一个网站等)绑定.
CA有以下两个作用:
- 证实一个实体的身份.这需要该CA能够执行严格的身份验证,具有权威性,常见的CA有"Let’s Encrypt",“DigiCert"等
- 将某个实体的身份与其公钥绑定为证书,由CA对这个证书进行数字签名
end-point authentication(端点鉴别)
前面的数字签名和公钥认证更像是被动被检测的,而这里提到的端点鉴别则是通信的某一方主动向另一方证明自己的身份.
应用层的安全服务: 安全电子邮件(过)
运输层的安全服务: TLS
TLS(Transport Layer Security)协议是由Netscape设计的安全协议-SSL(Secure Sockets Layer)协议-的升级版,所有的浏览器和服务器都支持该协议(看一下某个网站的URL,如果以https开始,就是启用了TLS),它有以下几个功能:
- 机密性: 攻击者可能截获购买者的订单并得到银行卡信息
- 完整性: 攻击者可能会修改购买者的订单地址或者购买数量
- 服务器鉴别: 证明这个网站是官方的,安全的
可以看到,TLS只在应用层进行了加密而已,并没有深入运输层
TLS Intro
先大致描述一下TLS的简化版本(称为类TLS),它具有三个阶段: 握手,密钥生成和传输数据
现在以客户B与服务器A之间的通信来举例说明
握手
在建立TCP连接后,B向服务器A发送一个hello报文,A在响应报文中返回该服务器的证书,里面包含了它的公钥.
由于该证书被某个CA证实过,B知道了这个公钥真的来自A,然后B生成一个主密钥(MS)用于此次TLS会话,使用A的公钥加密MS生成加密的主密钥(EMS),再发给服务器A,A再用私钥解密该EMS得到MS.
如此依赖,双方都知道了这次会话的主密钥MS.
密钥生成
事实上,出于安全性的考量,通信双方都会使用MS生成4个密钥:
- E_B: 从B发送到A时所用的加密密钥
- M_B: 从B发送到A时所用的HMAC密钥(用于验证报文完整性)
- E_A: 从A发送到B时所用的加密密钥
- M_A: 从A发送到B时所用的HMAC密钥
传输数据
TLS breaks the data stream into records, appends an HMAC to each record for integrity checking, and then encrypts the record + HMAC. 比如说B要发送数据,它需要将数据流分割为一个个record,为每个record附上HMAC,然后使用M_B加密这个record+HMAC包后发送出去.
事实上,这个HMAC中还含有这次发送的record所属的序号,从而保证攻击者不会打乱record的顺序.
record的结构
- Type字段: 判断这是握手报文还是传输数据的报文,也用于关闭TLS连接
对于TLS更为精确的描述
握手阶段
TLS不强制通信双方使用特定的加密算法,而是允许双方在TLS会话开始时就统一决定加密算法,真实的步骤如下:
- 客户发送它支持的密码算法的列表和它选取的不重数(在本次会话中不会第二次出现的数字)
- 服务器从列表中选择一个对称密钥算法,一种非对称密钥算法和一种HMAC算法,它把这些选择连同证书和另一个不重数发给服务器
- 客户验证证书后提取服务器的公钥,生成PMS(Pre-Master Secret),用公钥加密该PMS后发送给服务器.
- 客户和服务器根据PMS和各自的不重数得到上述的四种密钥.
- 双方发送一段用新生成的密钥加密过的握手信息摘要,用于验证双方计算出的密钥是否一致,以及握手过程是否被篡改
你可能想知道在步骤 1 和步骤 2 中存在**不重数(Nonce)**的原因。序号不足以防止报文段重放攻击吗?答案是肯定的,但它们并不只是防止“连接重放攻击”
假设 Trudy 嗅探了 Alice 和 Bob 之间的所有报文。第二天,Trudy 冒充 Bob 并向 Alice 发送正好是前一天 Bob 向 Alice 发送的相同的报文序列。
- 若未使用不重数:Alice 将以前一天发送的完全相同的序列报文进行响应。由于接收到的每个报文都能通过完整性检查,Alice 不会怀疑任何异常。如果 Alice 是一个电子商务服务器,她将认为 Bob 正在进行第二次相同的订购。
- 若使用不重数:Alice 将对每个 TCP 会话发送不同的不重数,使得两天的加密密钥完全不同。当 Alice 接收到 Trudy 重放的 TLS 记录时,由于密钥不匹配,该记录将无法通过完整性检查,假冒的事务便不会成功。
连接终止
如果仅通过TCP连接来终止TLS会话的话,攻击者可以通过截断攻击(truncation attack)来提前结束会话,也就是说他可以在会话中发送一个TCP FIN报文,从而让用户不能获取完整的信息.
因此,我们可以用最后一个record指示终止会话.
网络层的安全服务: IPsec(过)
补充: 有线网络的安全服务
有线网络不提供安全服务,因为链路通信是很难被攻击和篡改的,只需依靠上层的安全服务即可.
总结
显然,有这么多的防护措施,普通的cracker是很难通过截获IP数据报的形式来进行攻击的,相反,通过恶意软件(病毒,木马等)可以很轻易的跨越多层封锁,进入最薄弱的环节-主机-中,但这部分就不是网络通信所能负责的范畴了.
ppt概念补充
Intro
OSI七层协议
事实上,OSI协议的前三层对应了本书中的应用层,后面的都是一一对应的
Modem v.s. Router
Modem (调制解调器) 的本质是信号转换器。由于计算机内部处理的是二进制数字信号(Binary stream),而广域网传输介质(如电话线、光纤)传输的是模拟信号(Sinusoidal waves),Modem 负责将数字信号调制为模拟信号发出,并将接收到的模拟信号解调回数字信号。如果家中只有一个上网设备且不需要防火墙等功能,理论上仅需 Modem 即可拨号上网。
Circuit Switching and Packet Switching
Circuit Switching (电路交换)
核心流程:
- 建立电路 (Establishment):在发送数据前,必须先预留一条端到端的物理路径。
- 信息传输 (Transfer):数据(模拟或数字)沿专用路径实时流动。
- 电路拆除 (Termination):释放沿途占用的所有资源。
关键特性:
- 优势:由于资源独占,数据传输速率恒定、带宽有保障,且数据严格按序到达,对用户而言网络是“透明”的。
- 劣势:存在明显的拨号/建立延迟。资源利用率低,即便不传输数据,信道依然被占用,无法分配给其他用户。
- 复用方式:通常通过多路复用 (Multiplexing) 将物理链路划分为多个子信道
Packet Switching (分组交换)
核心流程:
- 分组化 (Packetization):将长报文拆分为带有首部(源地址、目的地址、校验码)的小数据包。
- 存储转发 (Store-and-forward):路由器必须接收完一个分组的所有比特后,才能开始向下一跳转发。
关键特性:
- 优势:
- 带宽利用率高:单个分组可以使用链路的全带宽,资源按需分配,支持更多用户接入。
- 应对突发流量 (Bursty Data):互联网流量通常是爆发式的,分组交换通过路由器内的缓冲区 (Buffer) 吸收临时流量峰值。
- 劣势:资源竞争可能导致拥塞和丢包;路由算法复杂;分组可能乱序到达目的地。
核心对比总结
| 特性 | 电路交换 (Circuit) | 分组交换 (Packet) |
|---|---|---|
| 资源分配 | 预先静态分配(独占) | 动态按需分配(共享) |
| 延迟来源 | 建立连接延迟 | 存储转发延迟、排队延迟 |
| 性能表现 | 稳定、无抖动、带宽保证 | 可能拥塞、有抖动、高并发 |
| 典型应用 | 传统电话网 (PSTN) | 现代计算机网络 (Internet) |
物理层
outline
- Bandwidth (带宽) and Data Rate
- Modulation (调制) of a Signal (ASK, PSK, QPSK, QAM)
- Medium and Transmission (传输)
- Multiplexing (复用) (FDMA, TDMA, CDMA)
Bandwidth (带宽) and Data Rate
- Bandwidth: 单位时间内从一个节点传送到另一个节点的数据量
奈奎斯特采样定理 (Nyquist Sampling Theorem)
核心物理含义 在进行模数转换(将连续信号变为数字点)时,如果模拟信号包含的最高频率为 $H$ Hz,那么每秒钟至少需要进行 $2H$ 次采样(即采样频率 $f_s \ge 2H$),才能通过这些采样点无失真地重建原始信号。这个最小值 $2H$ 被称为奈奎斯特速率。
采样频率与波形还原 为了识别一个周期的波形,数学上至少需要记录其一个波峰和一个波谷。如果采样率低于 $2H$,采样点分布太稀疏,捕捉到的数据点在还原时会连成一个错误的低频波形,这种现象称为混叠 (Aliasing)。
混叠 (Aliasing) 的直观理解 当采样频率不足时,高频信号会“伪装”成低频信号。
- 视觉现象:在电影(每秒 24 帧采样)中看到快速转动的车轮时,车轮似乎在缓慢倒转,这就是典型的视觉混叠。
- 音频后果:若采样率过低,录入的高音会变成诡异的低频杂音,且这种失真是永久性的,无法通过软件修复。
工程应用实例
- CD 音质:人耳听觉上限约为 $20\text{kHz}$。根据定理,采样率必须大于 $40\text{kHz}$。CD 标准采用 $44.1\text{kHz}$,正是为了确保完全覆盖人耳带宽并留出滤过缓冲带。
- 通信带宽:在带通信号传输中,该定理限制了在给定频率范围内可以传输的最大符号速率,是数字通信设计的底层物理约束。
信道容量与编码定理 (Channel Capacity & Coding Theorems)
奈奎斯特准则 (Nyquist Theorem) —— 无噪声信道 在理想的、没有噪声的信道中,由于信号在传输时存在码间串扰(带宽限制了信号的变化速率),最大数据传输速率由带宽和信号电平数(量化等级)决定。
- 公式: $$R_{max} = 2 \times BW \times \log_2 V \text{ bps}$$
- 参数含义:
- $BW$:信道带宽(Hz)。
- $V$:信号的离散电平数(量化等级)。
- 物理本质:在无噪声情况下,理论上可以通过无限增加量化电平数 $V$ 来提升速率,但受限于实际硬件对电平分辨的精确度。
香农定理 (Shannon’s Theorem) —— 有噪声信道 在存在随机热噪声的实际信道中,由于噪声会掩盖信号的电平细节,最大可靠传输速率(信道容量)存在一个物理极限。
- 公式: $$C = BW \times \log_2 (1 + \frac{S}{N}) \text{ bps}$$
- 参数含义:
- $C$:信道容量,即该信道能实现的理论最大信息传输速率。
- $S/N$:信噪比(SNR),信号功率与噪声功率的比值。
- 物理本质:噪声决定了我们能区分的最小信号电平差。即使无限增加发送电平 $V$,如果电平差小于噪声强度 $N$,接收方也无法识别。因此,带宽和信噪比共同限定了信息交换的上限。
信噪比与分贝 (SNR in Decibels) 在工程实践中,信噪比通常跨越多个数量级,因此常使用对数单位分贝 (dB) 来表示。
- 分贝换算公式: $$SNR(dB) = 10 \times \log_{10} (\frac{S}{N})$$
- 典型值参考:
- 如果 $S/N = 10$,则 $SNR = 10\text{ dB}$。
- 如果 $S/N = 100$,则 $SNR = 20\text{ dB}$。
- 如果 $S/N = 2$(信号是噪声的两倍),则 $SNR \approx 3\text{ dB}$。
核心逻辑总结
- 奈奎斯特告诉我们:由于带宽限制,采样率有上限(不能跑太快,否则波形会糊)。
- 香农告诉我们:由于噪声存在,信息的精细度有上限(不能分太细,否则分不清信号和噪声)。
- 实际应用:在设计网络系统(如 5G 或 Wi-Fi)时,通常会同时计算这两个值,取其中的较小者作为实际物理层的理论瓶颈。
Modulation
专业名词(即使前面提过也会放在这里)
- RTT: Round-Trip Time(往返时延)
- MSS: Maximum Segment Size,TCP 报文段中负载的最大长度限制
- adapter: 适配器,主机与特定网络连接的硬件接口,俗称网卡.
- Internet: 是由无数个使用 TCP/IP 协议族 相互连接的计算机网络,物理上通过路由器和交换机在全球范围内实现数据交换与资源共享的网际网路。
- packet(分组): 在特定层传输的数据包,从应用层,运输层,网络层,到链路层,每经过一层增加一个头部修饰
- MAC: Medium Access Control,介质访问控制协议
- ISP: Internet Service Provider
- NAT: Network Address Translation
- WAN: Wide Area Network - 广域网
- LAN: Local Area Network - 局域网
- SDN: Software Defined Networking,通过软件管理路由转发
- CIDR: Classless Inter-Domain Routing,无类别域间路由,是一个用于给用户分配IP地址的方法
- CSMA: Carrier Sense Multiple Access,发送信号前先监听,从而判断是否要在这个时候发送信号
- 全双工(full-duplex): 可以同时接收和发送数据
- 半双工(half-duplex): 同一时刻要么接收,要么发送,不能同时进行
实战
备案流程
wiki 个人网站备案需要准备:1份网站负责人的身份证件彩色扫描件或复印件;负责人的半身彩色照片(带接入商名称背景);网站所使用的独立域名注册证书复印件(加盖公章);主办单位所在地的详细联系方式;填写《信息安全管理协议》;填写《真实性核验单》。
根据相关行政法规,所有在中国境内的互联网信息服务提供者都应完成备案登记手续方可开办,未按规定备案的不得开展服务。
2005年2月8日,原中华人民共和国信息产业部部长王绪东签发《非经营性互联网信息服务备案管理办法》,并于3月20日正式实施。该办法要求从事非经营性互联网信息服务的网站进行备案登记,否则将予以关站、罚款等处理。
根据《互联网信息服务管理办法》,提供非经营性互联网信息服务需办理备案,而办理备案的前提是使用中国境内服务商提供的内地机房IP
事实上,在中国内地,合规运行网站需要两个核心要素:域名实名认证和ICP备案。
- 后缀限制:并非所有域名后缀都能备案。只有在工信部正式批复的顶级域名列表中的后缀(如 .com, .cn, .net 等)才允许备案。如果你使用 .io, .ai 等部分未批复后缀,即便服务器在国内也无法通过备案。
- 注册商要求:办理 ICP 备案的域名,其注册商必须在中国内地经过许可。如果你的域名是在 Namecheap、GoDaddy 或 Google Domains 注册的,必须先将域名转入国内注册商(如万网、新网),才能提交备案申请。
(补充): 事实上,所有的备案都是通过第三方的,小程序上线需要通过微信开发者平台备案;网站上线需要通过阿里云,腾讯云备案…
平台初审(一般需要1-2个工作日)通过后,再由平台提交给工信部审核(时间范围不确定,但一般不短),审核通过后会发短信提醒你.
这还没完,当你通过备案后,需要再进行公安联网备案,并提交审核,一般为2-3个工作日.
瑟瑟发抖…
计算机体系结构: 量化研究方法
- 如上一本书所说明的,这本书属于进阶版本的教材,但因为是相同的作者写的,所以编排风格十分相似.
量化设计与分析基础
前置概念
应用程序中主要有两种并行:
- 数据级并行(DLP): 同时操作多个数据项
- 任务级并行(TLP): 同时执行多个工作任务
计算机硬件为了实现上述的两种架构,有以下四种并行方法:
- 指令级并行: 利用流水线实现数据级并行
- 使用向量处理机和GPU: 将单条指令并行应用于一个数据集,实现数据级并行
- 线程级并行: 在并行线程间进行交互,实现数据级/任务级并行
- 请求级并行
我们还可以根据指令流与数据流的关系将计算机架构分成4类:
- 单指令流,单数据流(SISD): 使用单处理器,顺序执行指令,但可以实现指令级并行
- 单指令流,多数据流(SIMD): 使用多处理器,不同的处理器可以装载不同的数据流,但只能由一个处理器来装载指令,是现代GPU的主要架构
- 多指令流,单数据流(MISD): 不太有开发的必要,指令容易冲突,还不能并行处理多个数据.
- 多指令流,多数据流(MIMD): 每个处理器都使用自己的指令操控自己的数据,是现代CPU的主要架构.
指令集体系结构(ISA)
几乎所有的ISA都属于通用寄存器体系结构,80x86有16个通用寄存器和16个存储浮点数据的寄存器;MIPS有32个通用寄存器和32个浮点寄存器.
所有的计算机都使用字节寻址来访问存储器操作数,MIPS有三种寻址方式: 寄存器寻址,立即数寻址,位移量寻址.
MIPS的操作指令比较简单,大致可分为以下几种:
- 数据传输指令
- 算术逻辑指令
- 控制指令
- 浮点指令
| 指令类型/操作码 | 指令含义 |
|---|---|
| 数据传输 | 在寄存器和存储器之间,或者在整数和FP或特殊寄存器之间移动数据;唯一的存储器寻址模式是16位位移量加上GPR的内容 |
| LB, LBU, SB | 载入字节、载入无符号字节、存储字节(至/自整数寄存器) |
| LH, LHU, SH | 载入半字、载入无符号半字、存储半字(至/自整数寄存器) |
| LW, LWU, SW | 载入字、载入无符号字、存储字(至/自整数寄存器) |
| LD, SD | 载入双字、存储双字(至/自整数寄存器) |
| L.S, L.D, S.S, S.D | 载入SP浮点、载入DP浮点、存储SP浮点、存储DP浮点 |
| MFC0, MTC0 | 在GPR与特殊寄存器之间复制数据 |
| MOV.S, MOV.D | 将一个SP或DP FP寄存器复制到另一个FP寄存器 |
| MFC1, MTC1 | 在FP寄存器与整数寄存器之间复制32位 |
| 算术/逻辑 | 对GPR中的整数或逻辑数据进行操作;带有符号算术运算溢出时进行陷阱捕获 |
| DADD, DADDI, DADDU, DADDIU | 加,加立即数(所有立即数为16位),有符号和无符号 |
| DSUB, DSUBU | 减,有符号和无符号 |
| DMUL, DMULU, DDIV, DDIVU, MADD | 乘和除,有符号和无符号,乘-加;所有运算的操作数和结果都是64位数值 |
| AND, ANDI | 与,和立即数相与 |
| OR, ORI, XOR, XORI | 或,和立即数求或,异或,和立即数求异或 |
| LUI | 载入高位立即数;将立即数载入到寄存器的32~47位,然后进行符号扩展 |
| DSLL, DSRL, DSRA, DSLLV, DSRLV, DSRAV | 移位:立即数形式(DS__)和变量形式(DS__V),移位为左逻辑移位、右逻辑移位、右算术移位 |
| SLT, SLTI, SLTU, SLTIU | 若小于操作数则置位、若小于立即数则置位、有符号和无符号 |
| 控制 | 控制分支和跳转,相对于PC寄存器或通过寄存器控制 |
| BEQZ, BNEZ | GPR等于/不等于0时转移,相对于PC+4偏移16位偏移量 |
| BEQ, BNE | GPR相等/不等时转移、相对于PC+4偏移16位偏移量 |
| BC1T, BC1F | 测试FP状态寄存器中的对比位,并转移;相对于PC+4偏移16位偏移量 |
| MOVN, MOVZ | 如果第三个GPR为负数/零,则将第一个GPR复制到第二个GPR |
| J, JR | 跳转至与PC+4偏移26位偏移量的位置(J)、跳转至寄存器中的目标位置(JR) |
| JAL, JALR | 跳转和链接:将PC+4保存在R31中,目标为相对于PC(JAL)或寄存器(JALR) |
| TRAP | 转移到操作系统的一个向量地址 |
| ERET | 从异常中返回用户代码,恢复用户模式 |
| 浮点 | 对DP和SP格式执行FP操作 |
| ADD.D, ADD.S, ADD.PS | DP、SP相加,一对SP数相加 |
| SUB.D, SUB.S, SUB.PS | DP、SP相减,一对SP数相减 |
| MUL.D, MUL.S, MUL.PS | DP、SP浮点数相乘,一对SP数相乘 |
| MADD.D, MADD.S, MADD.PS | DP、SP浮点数相乘加,一对SP数相乘加 |
| DIV.D, DIV.S, DIV.PS | DP、SP浮点数相除,一对SP数相除 |
| CVT.. | 转换指令:CVT.x.y从类型x转换为类型y,其中x和y为L(64位整数)、W(32位整数)、D(DP)或S(SP)。两个操作数都是FRP |
| C..D, C..S | DP和SP对比:“_”=LT, GT, LE, GE, EQ, NE;在FP状态寄存器中置位 |
MIPS中所有指令的长度都是32位,从而简化了指令译码:
Amdahl定律: 计算加速比
Amdahl定律用于计算升级某个部件/功能时获得的加速比,即采用升级前所用的时间与升级后所用时间的比值,从而衡量出某个部件/功能的贡献大小:
$$S_{\text{latency}} = \frac{1}{(1 - p) + \frac{p}{s}}$$- $S_{\text{latency}}$:整个任务执行速度的理论加速比。
- $p$:任务中受益于资源改进的部分所占的时间比例($0 \le p \le 1$)。
- $s$:受改进部分原本的性能提升倍数。
CPI: 衡量处理器的性能
所有计算机都有一个时钟周期,那么CPU执行某个任务的时间就等于经过的周期数乘以一个时钟周期的时间.
我们使用每条指令的周期数(Cycle Per Instruction,CPI)来衡量某条指令所花的时间长度:
$$\text{CPI} = \frac{\text{程序的CPU时钟周期数}}{\text{指令数}}$$那么处理器的性能就取决于三个变量: 时钟周期,CPI,指令数.
存储器层次结构设计
鉴于快速存储器非常昂贵,现代计算机都使用分层的存储器结构,从而实现以下效果:
- 每字节的成本几乎与最便宜的存储器级别相同,速度几乎与最快速的级别相同

- 下一级存储器通常会保留上一级存储器的所有信息,才能保证信息不会丢失
优化缓存性能
- 使用小而简单的第一级缓存,缩短命中时间
- 采用路预测,缩短命中时间
- 缓存中留出一部分空间用于预测下一次要访问的数据
- 缓存访问流水化(Cache Access Pipelining),即将缓存访问拆成多个步骤,提高缓存带宽:
| |
- 采用无阻塞缓存,提高缓存带宽
- 出现缓存不命中(miss)时,不中断缓存访问,这是通过在缓存内部引入了一组特殊的硬件寄存器实现的,它被称为未命中状态保持寄存器(MSHR,Miss Status Holding Registers).
- 采用多种缓存,提高缓存带宽.
- 将缓存划分成多个相互独立的,支持同时访问的缓存组
- 关键字优先和提前重启动,降低缓存不命中的代价
- 缓存与主存交换数据的最小单位是块(Block),一个块包含多个字(word),当CPU只需要某一块其中的一个字时,缓存控制器直接跳转到对应的地址获取那个缺失的字,让CPU恢复执行后再发送该块的剩余部分
- 另一种实现方法,缓存保持顺序读取,实时检查当前块中是否出现了CPU需要的字,一旦出现就直接发送给CPU,再接着发送剩余部分.
- 合并写缓冲区,降低缓存不命中的代价
- 为了不让CPU每次执行缓存的写入操作时都等待新数据从缓存慢慢传回内存,我们会设计一个写缓冲区,CPU将数据写入该缓冲区后继续执行,缓冲区负责将数据异步写入下级存储.
- 如果新写入的数据与缓冲区中某个数据属于一个块(这是非常常见的情况,因为代码和数据通常都保存在一块连续内存上),则直接将这两部分数据合并,节省写缓冲区空间

- 采用编译器优化,降低缓存不命中的概率
- 编译器会对代码进行优化处理,帮助处理器以更高的效率执行代码
上面的这些做法都在现代计算机体系结构中得到了广泛的应用.
存储器种类
- Static Random Access Memory(SRAM): 通常用作缓存,集成在处理器的芯片上,响应速度远超DRAM
- Dynamic Random Access Memory(DRAM): 用作内存条,在每次读取信息后会破坏该信息,所以要进行刷新后写回数据,速度比较慢,适合放在硬盘和缓存中间作为缓冲存储器.
- SDRAM: 同步DRAM,DRAM的优化版本,现代的内存条都是SDRAM.
- NAND flash(闪存): 最常见的闪存就是SSD(固态硬盘),通常为最后一级存储器,速度很慢,但比起HDD(机械硬盘)又快得多.
附录B: 存储器层次结构
前置概念
- 根据主存块在cache中的放置位置,可以讲cache的组织方式分成三种:
- 直接映射:
(块地址)MOD(缓存行数) - 全相联: 块可以放在缓存中的任意位置
- 组相联: 块可以放在缓存中的有限个位置组成的组(set)中.块首先通过
(块地址)MOD(缓存组数)映射到组,可以放在组中的任意位置.- 如果组中有n个块,就被称为n路组相联
- 有m块的全相联实际上就是只有一组的m路组相联
- 直接映射:
- 处理器在寻找一个主存块时,会提供给cache两个信息: 块地址和块偏移,块地址可以拆分成tag字段和索引字段,索引字段可以定位cache的某一行/某几行,tag字段可以与cache中的tag位进行比较,从而判断cache中该行是否存储了要寻找的主存块,如果不匹配,则说明发生了cache miss,需要从主存中加载数据到cache中,并重置cache中对应的tag位.
- 发生cache miss时,由于直接映射时只需替换被映射的那一行,所以不用多操心;但对于组相联的cache,我们主要有三种算法来决定替换该组中的哪一行:
- RAND: 随机选择该组中的任意一行
- LRU(最近最少使用): 替换掉最近最少使用的一行,这应用了局部性原理.
- FIFO(先入先出): 替换掉最早被使用的哪一行.
- 将数据写入缓存时,有两种方法:
- 直写: 写入缓存和主存中
- 实现起来比较简单,而且发生cache miss时也不需要再对主存进行写入,主存中存有数据的最新副本
- 写回: 写入缓存,缓存中的数据如果被修改了,那么在被替换时才会被写入主存中.
- 写入时占用的时钟周期短,节省功耗
- 直写: 写入缓存和主存中
缓存优化
- 增加相联度: 主存块可以放进cache的候选位置变多,被替换的概率下降
- 增大存取的主存块大小: 根据空间局部性,如果程序访问了某个地址,它很可能马上访问附近的地址;但主存块太大的话,cache容纳的主存块个数过少,反而会降低性能
- 增大cache容量: 装的主存块个数变多
- 使用多级缓存,多级缓存的存储器平均访问时间计算方法如下:
虚拟存储器
如果由程序员亲自负责物理内存的分配,拆分过于庞大的内存,确保程序不会越界访问,这显然很累人,尽管早期计算机确实是这么做的.
为了解决这个问题,虚拟存储器诞生了,处理器负责计算得到要处理的虚拟地址,由MMU单元按照操作系统提供的页表完成从虚拟地址到物理地址的映射(通过偏移量实现),再访问cache/主存中的实际物理地址.
指令级并行
前置概念
- 指令级并行: 有两种实现方式,一种是依靠硬件来动态实现并行,一种是依靠编译器来静态发现并实现并行.
为了确定能否开展指令级并行,我们需要判断指令间是否相关,总共有三种类型的相关:
- 数据相关: 指令i的结果可能会被指令j使用,或者指令i的结果会被指令k使用,而指令k的结果会被指令j使用,这两种情况都被称为数据相关.
- 如果两条指令数据相关,那么他们必须顺序执行,无法真正的并行.
- 名称相关: 指令i需要用到指令j需要的寄存器/存储器位置
- 名称相关非常好解决,既可以让编译器对涉及冲突的寄存器进行重命名(即更换寄存器),也可以让硬件更改冲突的存储器位置.
- 控制相关: 条件语句中的条件指令与执行语句只能顺序执行.
编译器优化
编译器可以智能地帮助我们合并指令,减少流水线停顿:

硬件优化
硬件优化的代表性算法是Tomasulo算法,它能够通过寄存器重命名降低数据相关和名称相关的指令数量,实现流水线的乱序执行(在指令可用时立刻执行而无需等待).
例如,上面这个指令序列可以通过两个临时寄存器被改写成这样,让指令间互不相关:
数据级并行
SIMD通过使用单条指令启动多次数据运算,比起MIMD更为高效.
SIMD有以下三种实际应用:
- 向量处理机: 将处理器硬件全部替换成适配向量操作的结构,当需要大规模的数据运算时,可以直接使用矩阵来快速简化运算,而无需如同普通处理器一样通过多次循环来迭代处理.
- 很明显,向量处理机不是那么好实现的,效果也未必有多好,不然不会在推出几十年后也没成功商业化
- 多媒体SIMD扩展: 简单来说就是对MIMD进行扩展,例如允许64位寄存器同时操作8个8位操作数,这适用于诸如图形处理,色彩渲染等功能.本质上来说是延续了向量处理机的实现方法.
- GPU(Graphic Process Unit): 与CPU的架构差别很大

线程级并行
为了实现线程级并行,我们需要同时运行多个处理器,按照存储器的组织方式,多处理器方案可以分成两种:
- SMP(对称多处理器): 处理器数量少,有各自的独立缓存,但同时共享一个下一级缓存:
- DSM(分布式共享存储器): 处理器数量多,处理器之间不共享存储器,缩短了存储器存取延迟,但也让处理器之间传送数据变得更加复杂
Kubernetes Up and Running
- 不如in action详细,不推荐阅读
Linkers and Loaders
- 出版于1999年,作者:John R. Levine。
本来以为这么有名的书内容一定很充实吧,结果发现完全比不上修养那本书,白期待一场.
Linux内核设计与实现
- 尽管源码分析很多,好在都有一些比较概括性的介绍,只看介绍就行了,谁愿意看你那些破碎的代码分析呢.再说Linux的0.01版只有一万行代码,真要研究的话看那个也足够了.
进程管理
前置概念
- 进程: 处于执行期的程序
- 线程: 进程中活动的对象,在Linux中,线程是一种特殊的进程.
- 进程创建: Linux调用
fork复制一个现有进程(父进程),创建一个新进程(子进程),执行完毕后,父进程恢复执行,子进程开始执行. - 进程执行: Linjx调用
exec创建新进程的地址空间,并通过exit终结进程.
进程有以下五种状态:
- TASK_RUNNING: 进程是可执行的,要么正在执行,要么在运行队列中等待执行
- TASK_INTERRUPTIBLE: 进程正在睡眠,等待某些条件被满足,一旦满足这些条件,进程就会进入TASK_RUNNING状态
- TASK_UNINTERRUPTIBLE: 进程正在睡眠,但外界信号不会影响它,由进程主动进入其他状态
- TASK_TRACED: 被其他进程跟踪的进程
- TASK_STOPPRD: 进程没有运行也无法运行
进程描述符与任务结构
Linux内核用一个叫做任务队列的双向循环链表来保存进程,链表中的每一项都是类型为
task_struct,称为进程描述符(process descriptor)的结构,包含一个具体进程的所有信息.
内核通过一个唯一的进程标识值(process identification,PID)来标识每个进程.
Linux中所有的进程都是PID为1的init进程的后代.
进程创建
其他的操作提供都提供了产生(spawn)进程的机制: 在新的地址空间里创建进程,并读入可执行文件后开始执行;而Unix类操作系统将上述的两个步骤分解为两个函数: fork和exec.
首先,fork通过拷贝当前进程创建一个子进程,子进程的大部分数据与父进程相同,除了PID和PPID(父进程的进程号).
然后,exec负责读取可执行文件并将其载入地址空间开始运行.
写时拷贝
由于整个复制父进程的数据非常浪费空间,如果在进程创建后马上运行一个可执行文件,在运行时与父进程共享同一份数据,那么就可以大大减小开销,这被称为写时拷贝.
线程
在其他操作系统中,线程被称为"轻量级进程”,可以消耗更少的资源迅速执行任务;而在Linux中,线程就像是一个普通的进程,只是会与其他的进程共享某些资源
进程调度
当运行状态的进程数量多于处理器个数时,就必须要调度程序来决定哪些进程优先执行,哪些进程稍后执行.
补充: Linux调度程序的历史
- 由于这本书太老了,所以让AI介绍一下完整的调度程序历史
从 Linux 2.5 至今,调度器经历了四次重大的架构级跃迁:
1. O(1) 调度器 (Linux 2.5 - 2.6.22)
引入背景:早期的 O(N) 调度器在每次挑选进程时,都要遍历链表中的所有进程,耗时与进程总数 $N$ 成正比。在多核、多进程环境下,CPU 时间全部浪费在了遍历链表上。
核心特性与机制
- 常数级时间复杂度:引入了
runqueue(运行队列)结构,每个 CPU 拥有独立的队列,挑选进程的时间复杂度变成了 $O(1)$,与系统内运行的进程数量无关。 - 双阵营设计(Active/Expired):每个队列包含两个位图(Bitmap)加链表的组合:
- Active 阵营:存放还有时间片的进程。
- Expired 阵营:存放时间片耗尽的进程。
- 切换方式:CPU 总是通过汇编指令(如
bsfl寻找位图第一个非 0 位)在 Active 阵营中极速查找优先级最高的进程。当 Active 清空,直接交换 Active 和 Expired 指针,周而复始。 - 启发式交互评估:为了给桌面交互进程(如鼠标、键盘响应)提供低延迟,内核通过一套复杂的“启发式算法”,根据进程的睡眠时间来猜测它是不是交互进程。如果是,就给它更高的优先级,甚至在其时间片用完后继续留在 Active 阵营。
淘汰原因
这套“猜测”算法很快成为了灾难。随着应用变复杂,内核无法通过简单的公式准确区分哪些是真正的交互进程。这导致大名鼎鼎的 3D 射击游戏《Doom 3》在当时的 Linux 上运行时,由于被误判为非交互进程,掉帧极其严重,引起了社区的强烈不满。
2. RSDL 与 CFS (Linux 2.6.23 - 6.5)
引入背景:为了彻底废除 O(1) 调度器中恶心的“启发式猜测”,澳大利亚医生兼内核天才 Con Kolivas 提出了 RSDL(反转台阶截止日期调度器),证明了无需猜测、仅靠纯粹的公平数学模型就能完美搞定交互体验。受此启发,Ingo Molnar 在 2007 年的 Linux 2.6.23 中引入了 CFS(Completely Fair Scheduler,完全公平调度器)。
核心特性与机制
- 红黑树取代链表:CFS 废除了时间片的概念,改用红黑树(Red-Black Tree)来管理进程。
- 虚拟运行时间 ($vruntime$):这是 CFS 的灵魂。每个进程都有一个 $vruntime$,代表它在 CPU 上实际运行的“虚拟时间”。
- 优先级低(Nice 值大)的进程,其 $vruntime$ 增加得快;
- 优先级高(Nice 值小)的进程,其 $vruntime$ 增加得慢。
- 绝对公平调度:CFS 的逻辑非常纯粹:永远选择红黑树最左侧(即 $vruntime$ 最小值)的节点运行。
淘汰原因
CFS 运行了 16 年,但它有一个致命的结构性缺陷:它把“公平(Fairness)”和“延迟(Latency)”这两个维度绑定在了同一个 Nice 值(权重)上。
当一个高优先级的音频进程长期睡眠后突然醒来,它的 $vruntime$ 虽然落后,但由于红黑树的机制,它必须按照既定的步长去追赶,CFS 无法在“不破坏全局公平性”的前提下,强制让它立即抢占 CPU,这在高吞吐量的服务器或混合负载下会导致无法忍受的毛刺延迟。
3. EEVDF 调度器 (Linux 6.6 - 至今)
引入背景:为了彻底解决 CFS 的延迟毛刺,Linux 核心调度器维护者 Peter Zijlstra 在 2023 年(Linux 6.6)移除了 CFS,换上了基于 1995 年学术理论实现的 EEVDF(Earliest Eligible Virtual Deadline First)。
核心特性与机制
- 解耦“公平”与“延迟”:EEVDF 引入了两个全新维度来衡量进程:
- Eligible(可行性):通过计算 $Lag$(进程“应得的 CPU 时间”与“实际得到的 CPU 时间”之差)。如果 $Lag \ge 0$,说明进程被亏欠了,属于 Eligible 状态;如果 $Lag < 0$,说明它透支了,不合格。
- Virtual Deadline(虚拟截止日期):进程被允许运行的最终期限。对延迟极其敏感的任务,其 Deadline 会被设得非常近。
- 双阶筛选算法:
- 第一步:剔除所有透支的(非 Eligible)进程,只在合格 of 进程里挑。
- 第二步:在合格进程中,直接挑选 Virtual Deadline 最早的那一个运行。
通过这种设计,一个短时间醒来的音频或 UI 进程,不仅合格,而且其截止日期极短,可以在不破坏长线公平的前提下,瞬间切入 CPU 执行,完美解决了延迟毛刺。
前置概念
多任务
多任务操作系统支持并发执行多个进程,在单处理器计算机中,这会产生多个进程在同时运行的幻觉,而在多处理器计算机上,多个进程会在不同的处理器上真正地同时运行.
多任务系统有两种:
- 非抢占式多任务: 除非进程主动停止运行,否则将会一直运行下去,现在的操作系统都不再采用这种方案
- 抢占式多任务: 由系统调度程序来决定什么时候停止一个进程运行,以供其他进程在处理器上运行,这被称为抢占.这是绝大部分操作系统采用的方案.
进程类型
进程大致可分为两种类型:
- I/O消耗型: 大部分时间用来提交I/O请求或者等待I/O请求,经常处于可运行状态,但实际的运行时间很短
- 处理器消耗型: 大部分时间用来执行,代表性的例子有那些大量执行数学计算的程序如MATLAB
Linux为了优化交互体验和提升性能,更倾向于优先调度I/O消耗型的进程.
时间片
- 时间片: 进程被抢占前能持续运行的时间,默认情况下很短,比如10ms,从而保证系统与用户交互的延迟较低.
进程优先级
进程调度的一个简单想法是: 优先级高的进程优先运行,相同优先级的进程轮流运行.
Linux采用两种不同的优先级算法:
- 使用nice值: 它的范围从-20到+19,默认值为0,nice值越大优先级越低(你对系统中的其他进程太好了,让它们比你先运行).在Linux中,nice值越低,进程占用的时间片比例越高.
- 对应调度管理器算法
- 使用实时优先级: 它的范围从0到99,数值越高进程优先级越高,可以手动配置,使用该类优先级算法的进程比默认使用nice值的进程优先级都高.
- 对应实时的调度策略,不受调度管理器管辖
Linux调度算法
如果直接按照nice值映射到进程占用的时间片大小,会产生以下问题:
- nice值越高的进程占用的时间片越短,需要经过频繁的上下文切换,但这种进程往往是不应该被打断的计算密集型的后台进程,导致运行效率显著下降
Linux2.6版本引入了CFS(完全公平调度)机制:
- 将nice值作为进程获得的处理器运行比的权重,而不是分得的时间片大小
- 设定一个目标延迟值(如20ms),每个进程严格按照延迟值来运行,如果有4个进程,每个进程只能运行5ms;如果有20个进程,则只能运行1ms;
- 设定一个最小时间片大小(如1ms),每个进程获得的时间片大小不得小于该长度
- CFS通过红黑树来调度进程.
显然,如果进程数量过多,必须让一些进程终止运行,否则进程的运行时间会小于最小时间片大小.
系统调用
- 系统调用: 用户进程与内核进行交互的一组接口,可以让应用程序在一定的限制下访问硬件设备
- 实际使用方法和调用库函数没有任何的区别,所以就直接略过了
中断
- 中断: 由硬件向内核发出的常规通知,内核针对中断值来区分不同的中断信号
- 异常: 由处理器向内核发出的错误通知,实际处理方式与处理中断类似
二者的差异就在于中断是由硬件引发而非由软件引发
内核同步
- 临界区: 存放共享数据的代码段
- 同步: 避免两个进程在同一个临界区中同时执行,因为进程调度中发生进程抢占的情况经常出现,例如中断,内核抢占和多处理器
- 加锁: 在进程执行时给临界区加锁可以让其他进程无法进入临界区,从而实现进程同步
- 死锁: 每个进程都在等待被加锁的资源才能继续执行,而这个资源被解锁的条件恰恰是该进程执行完毕
- 自死锁: 一个进程在执行中申请获得自己持有的锁,那么该进程只能永远等待下去
- 自旋锁(spin lock): 最多只能被一个可执行进程持有的锁,其他进程在等待该进程执行完毕时必须不停地反复询问,原地旋转(spin).
- 读/写自旋锁: 多个读任务可以同时持有读者锁,但只能由一个写任务持有写者锁,且写者代码执行时不可以有读者代码同时执行.该类锁显然是针对读写任务设计的
- 信号量: 信号量是一种睡眠锁,如果一个进程试图获取被占用的信号量时,将会被推进一个等待队列并睡眠,只有当信号量被释放时才能被唤醒.该类锁是针对需要长时间执行的进程设定的.
时间管理
- 处理器的时钟频率是可调的,操作系统可以根据自己的需要动态调节时钟频率,这也是为什么在低功耗模式下打游戏会卡顿,时钟频率下降后,单位时间内操作系统能够处理的任务数就变少了.
- 更高的时钟频率可以提高内核定时器的精度,细化每个任务的分配时间,从而提高整体的运行速度.
虚拟文件系统(virtual file system,VFS)
之所以我们能够直接对外接硬盘进行操作,就是虚拟文件系统的功劳
VFS定义了所有文件系统都支持的接口,通过把文件视为文件对象来做统一的处理.
VFS 中有四个主要的对象类型,它们分别是:
- 超级块对象,它代表一个具体的已安装文件系统。
- 索引节点对象,它代表一个具体文件。
- 目录项对象,它代表一个目录项,是路径的一个组成部分。
- 文件对象,它代表由进程打开的文件。
块I/O层
- 块设备: 能够随机访问固定大小的数据片的硬件设备,如硬盘和闪存
- 字符设备: 可以按照字符流的方式有序访问,如键盘和音箱
- 块: 文件系统的最小寻址单元,为固定大小的数据片,需要是扇区的整数倍大小,通常为4KB
- 扇区: 设备的最小寻址单元,为512B/4KB大小
- 缓冲区: 块被调入内存时的存储区,每个缓冲区对应一个块
I/O调度程序
Linux2.6中同时存在四种I/O调度程序:
| 调度器 | 主要目标 | 特点 |
|---|---|---|
noop | 尽量少做事 | 简单 FIFO,适合硬件自己已经会调度的场景 |
deadline | 避免请求饿死 | 给请求设置期限,尤其保护读请求延迟 |
anticipatory / as | 预测后续读请求 | 服务完一次读请求后短暂等待,避免马上切去远处写请求 |
cfq | 公平性 | 按进程/队列分配 I/O 时间,强调公平和桌面体验 |
进程地址空间
用户空间中的进程内存被称为进程地址空间,由虚拟内存(VMA)映射而成.
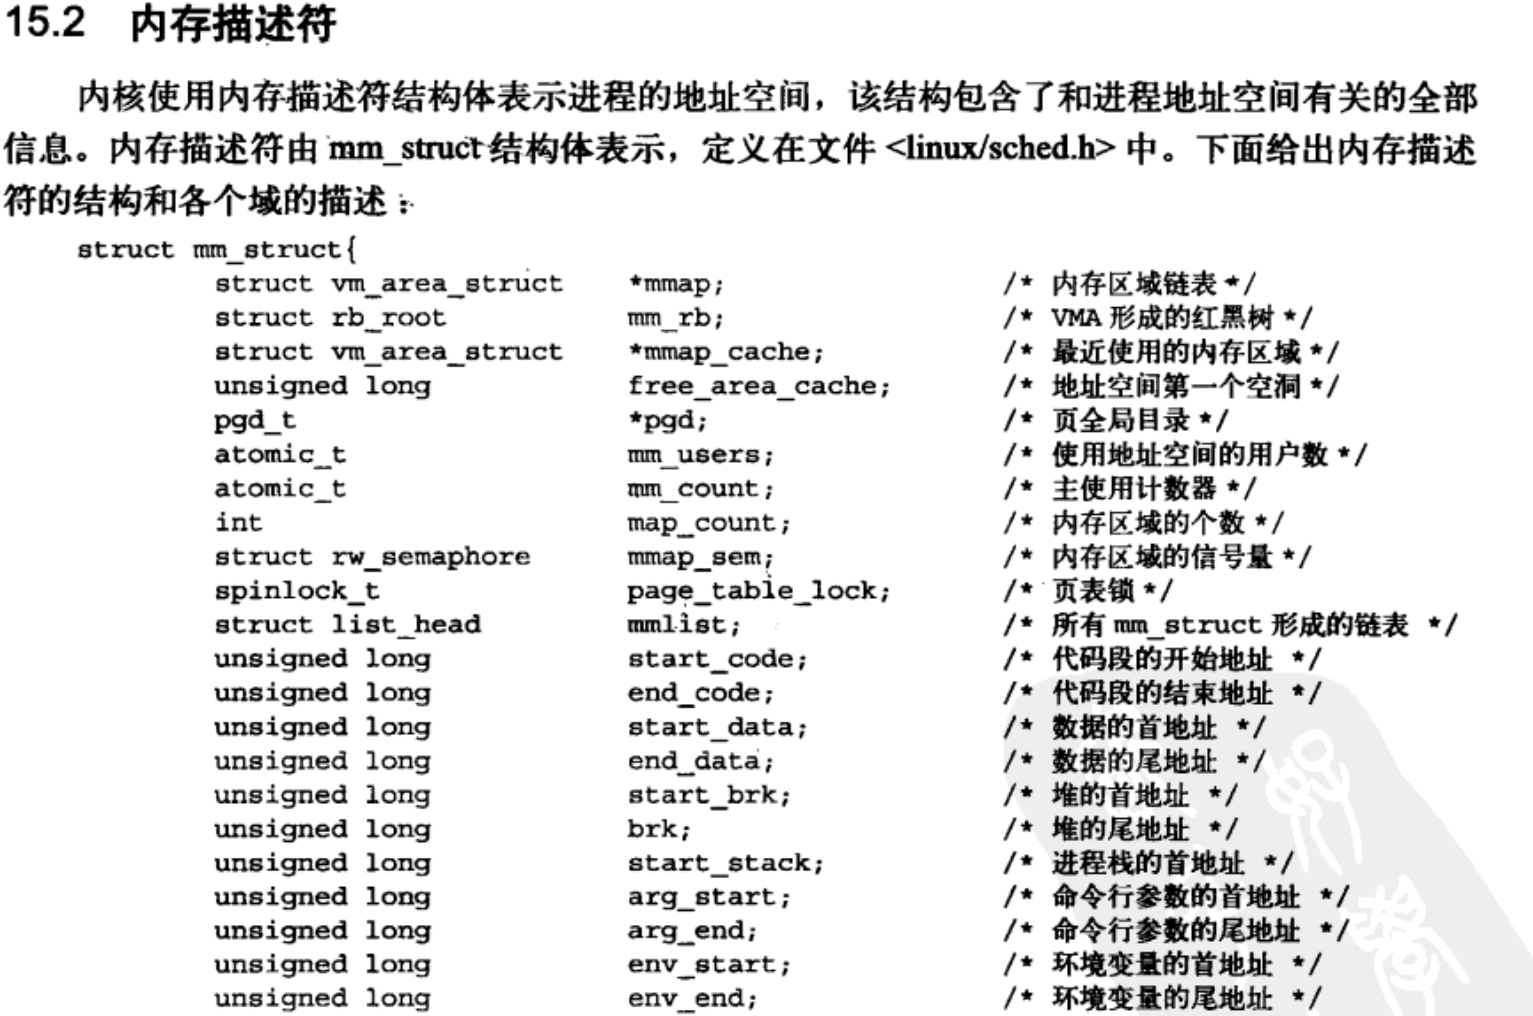
将虚拟内存映射到物理内存是通过页表实现的:
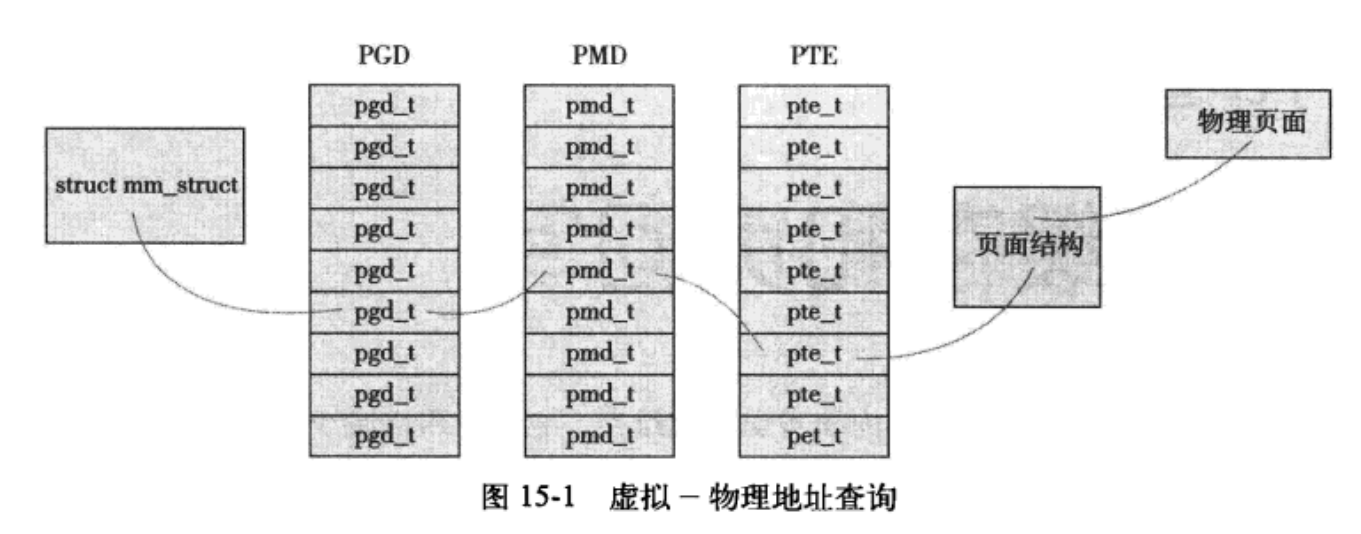
Metasploit
讲Metasploit渗透测试框架的,写的挺烂.
MongoDB权威指南(第三版)
- 出版于2019年(英文第3版),出版商:O’Reilly,作者:Shannon Bradshaw。
简介
MongoDB 不是关系数据库,而是面向文档(document-oriented)的数据库
随着所需存储数据量的增长,开发人员面临一个艰难的决定:应该如何扩展数据库?这可以归结为两种选择:纵向扩展(提高配置)和横向扩展(将数据分布到更多机器上)。纵向扩展通常是阻力最小的途径,但它也有缺点:大型机器一般非常昂贵,而且在最终达到物理极限时,就无法再升级到更高的配置了。另一种方式是横向扩展:如果想增加存储空间或增加读写操作的吞吐量,那么可以购买额外的服务器,并将它们添加到集群中。这既便宜又便于扩展,但管理 1000 台机器比管理 1 台机器困难得多。
MongoDB 的设计采用了横向扩展。面向文档的数据模型使跨多台服务器拆分数据更加容易。MongoDB 会自动平衡跨集群的数据和负载,自动重新分配文档,并将读写操作路由到正确的机器上
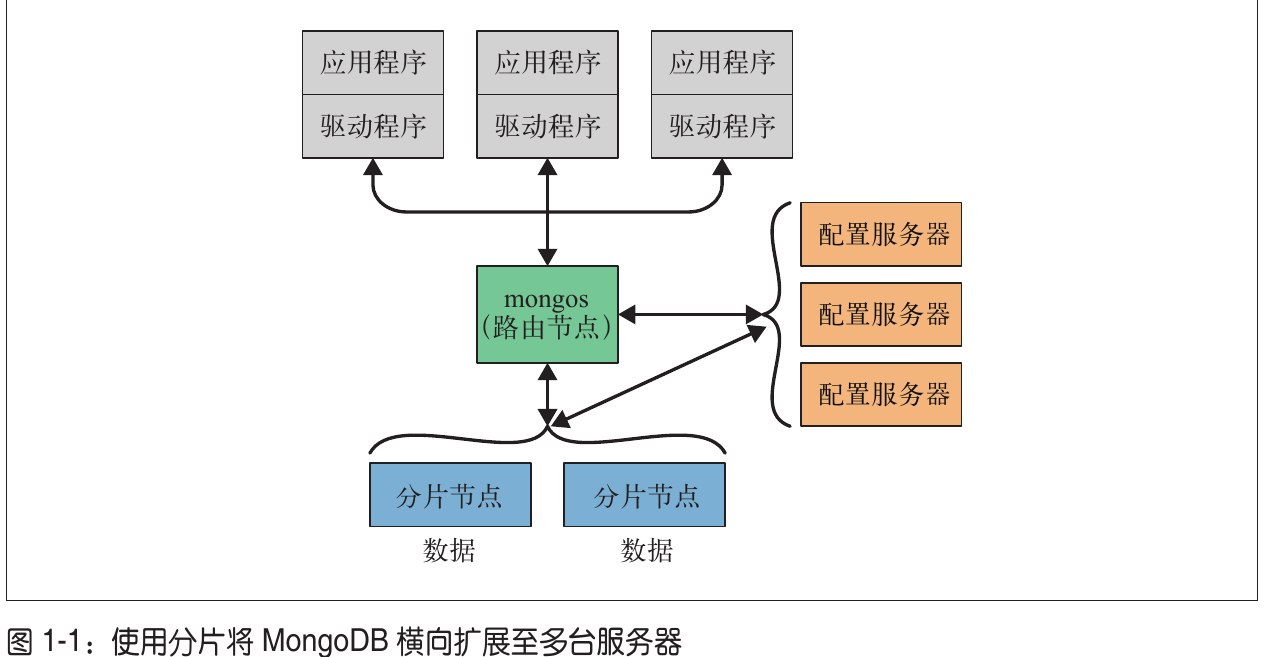
文档
文档是 MongoDB 的核心概念:它是一组有序键值的集合。文档的表示形式因编程语言而异,但大多数语言具有自然匹配的数据结构,比如映射、哈希表或字典.
MongoDB 会区分类型和大小写。例如,下面这两个文档是不同的:
| |
集合
集合就是一组文档。如果将文档比作关系数据库中的行,那么一个集合就相当于一张表。
任何文档都可以放入集合中,但为了管理方便,通常都会进行一定的分类.
数据库
MongoDB 使用集合对文档进行分组,使用数据库对集合进行分组。一个 MongoDB 实例可以承载多个数据库
有一些数据库名称是保留的。这些数据库可以被访问,但它们具有特殊的语义:
- admin: admin 数据库会在身份验证和授权时被使用。
- local: 特定于单个服务器的数据会存储在此数据库中。
- config: MongoDB 的分片集群会使用 config 数据库存储关于每个分片的信息
通过将数据库名称与该库中的集合名称连接起来,可以获得一个完全限定的集合名称,称为命名空间。如果你要使用 cms 数据库中的 blog.posts 集合,则该集合的命名空间为 cms.blog.posts。
补充: 安装和启动MongoDB
官网下载对应平台的社区版server,勾选下载图形化界面的MongoDB Compass,就可以以可视化的界面方便的管理MongoDB了.
MongoDB Compass中自带了一个mongosh终端,它是一个JavaScript解释器,可以执行任意的JS程序,这也很合理,毕竟MongoDB操作的就是json.
MongoDB数据类型
MongoDB 在保留了 JSON 基本键 – 值对特性的基础上,增加了对许多额外数据类型的支持:
- null: null 类型用于表示空值或不存在的字段。
- bool: 布尔类型的值可以为 true 或者 false。
- 数值: shell 默认使用 64 位的浮点数来表示数值类型,如
{"x" : 3.14}- 如果要强调该数值为整数,可以用NumberInt 或 NumberLong 类,它们分别表示 4 字节和 8 字节的有符号整数,如
{"x" : NumberInt("3")}
- 如果要强调该数值为整数,可以用NumberInt 或 NumberLong 类,它们分别表示 4 字节和 8 字节的有符号整数,如
- 字符串:
{"x" : "foobar"} - 日期: MongoDB 会将日期存储为 64 位整数,表示自 Unix 纪元(1970 年 1 月 1 日)以来的毫秒数.
- 数组类型,内嵌json等组合类型,如
{"x" : {"foo" : "bar"}} - Object ID: 一个 12 字节的 ID,是文档的唯一标识。
MongoDB中存储的每个文档都必须有一个"_id" 键,在单个集合中每个文档的id值都是唯一的.可以用{"x" : ObjectId()}显式设置,如果没写则会自动生成.
ObjectId 的 12 字节是按照如下方式生成的:

因为时间戳在前,所以 ObjectId 将大致按照插入的顺序进行排列。这并不是一个很强的保证,但是确实在某些方面很有用,比如可以使 ObjectId 的索引效率更高
总结
后面都是一些终端操作和不痛不痒的通用数据库常识了,不过我们肯定是用Python或者Java来操作MongoDB,所以也没必要去学这些终端操作了
Multiplayer Game Programming
- 出版于2015年,作者:Joshua Glazer。
- 不推荐阅读
OVERVIEW OF NETWORKED GAMES
- 简单讲了讲联网游戏的历史,可以直接略过不看.
BERKELEY SOCKETS
Sockets概览
Originally released as part of BSD 4.2, the Berkeley Sockets API provides a standardized way for processes to interface with various levels of the TCP/IP stack. Since its release, the API has been ported to every major operating system and most popular programming languages, so it is the veritable standard in network programming.
- 换句话说socket其实是Berkey研究组对网络协议和硬件交互的封装API,并在之后普及到了所有的主流操作系统和编程语言中.
创建一个socket对象可以这么写:
| |
- af: address family,表示socket底层使用的是什么网络层协议,最常用的两个值是
AF_INET:IPV4和AF_INET6:IPV6. - type: 表示通过socket传输的包的类型,最常用的有
SOCK_STREAM,表示Packets represent segments of an ordered, reliable stream of data,对应的传输层协议为TCP;另一个常用的是SOCK_DGRAM,表示Packets represent discrete datagrams,对应的传输层协议为UDP - protocol: 表示使用的具体传输层协议,常用值如下:
| Macro | Required Type | Meaning |
|---|---|---|
IPPROTO_UDP | SOCK_DGRAM | Packets wrap UDP datagrams |
IPPROTO_TCP | SOCK_STREAM | Packets wrap TCP segments |
IPPROTO_IP / 0 | Any | Use the default protocol for the given type |
- 如果protocol填0就表示选择type字段对应的传输层协议
- To close a socket, regardless of type, use the closesocket function:
| |
- To cease transmitting or receiving before closing, use the shutdown function:
| |
ch4&&ch5&&ch6
- 这几章书上讲的很烂,沉浸在自己的代码里了,但这部分的内容却是这本书的核心,我只好重新自己梳理一下
我们需要考虑一个问题,游戏联机与普通的网站开发不同,网站开发可以在前后端内传递json文件,将数据有组织的接收和传送,并存放在数据库中;
但是游戏联机要求我们玩家能够与服务器间进行低延迟通信,而且需要实际地更改玩家的游戏数据,有一个非常严重的问题就是,尽管玩家的账户数据是可以用数据库存储的,但游戏中的实时数据(比如玩家的位置,剩余血量等)是不能存放在数据库中的,这些实时数据彼此之间以指针相互引用,很有可能在不同玩家的主机上使用不同的内存地址:
因此,我们不能简单的把在玩家的本地数据映射到服务器数据上,实际的解决方法有两种:
- 状态同步 (State Synchronization): 服务端计算所有游戏逻辑、碰撞和数值,将结果(如怪物坐标、玩家血量)广播给客户端。客户端只负责渲染。防作弊能力强,适合 MMORPG。
- 帧同步 (Lockstep / Frame Sync): 服务端只负责收集转发玩家的操作输入(如:按了向左键),不计算逻辑。各个客户端在相同的帧执行相同的输入,计算出相同的结果。对网络延迟要求极高,流量小,适合 MOBA、格斗、局域网联机。
但谁来作为服务器呢?我们有两种解决方案:
- Client-Server (C/S):必须有一个中心节点(服务器)。所有客户端都只和服务器连,客户端之间不直接通信。
- Peer-to-Peer (P2P):没有固定的中心服务器,或者服务器只负责牵线。每个客户端(玩家)同时也是服务器,客户端之间直接互发数据。
不同的通信方案
帧同步 + P2P(早期经典)
- 代表作:《魔兽争霸 3》、《星际争霸》、早期的局域网格斗游戏。
- 机制:玩家 A 按了下技能,直接通过网络把“A 释放技能”的指令发给玩家 B,玩家 B 也把自己的操作发给 A。没有中央服务器算逻辑,大家各算各的。
帧同步 + C/S(现代主流)
- 代表作:《王者荣耀》、《乱斗西游》。
- 机制:玩家 A 按了向左走,这个输入先发给中央服务器。服务器收集齐这一帧所有玩家的输入后,打包成一个“帧包”,统一广播给所有玩家。客户端收到服务器的统一帧包后才开始执行。这样操作是为了解决 P2P 架构下某一个玩家断线导致全员卡死(Lockstep 严格同步)的问题。
状态同步 + C/S(绝对统治)
- 代表作:《魔兽世界》、《反恐精英 (CS)》、《PUBG》。
- 机制:这是最标准的组合。服务器在云端运行完整的游戏世界,算好一切,再把状态压进网络包发给客户端。客户端如果作弊改了本地坐标,服务器下一次状态刷新会直接强制把你拉回原位。
状态同步 + P2P(极少见/主机常用)
- 代表作:« 幻兽帕鲁 » 。
- 机制:为了省服务器成本,不架设中央高性能服务器。由系统自动选出一个玩家的电脑作为“主机(Host)”,它承担状态同步中“服务器”的角色,负责计算逻辑并广播给其他 P2P 连接的玩家。缺点是一旦该玩家退出,游戏就必须中断并“迁移主机”。
总结
不推荐阅读,前面两三章还可以,后面完全变成毫无意义的代码分析了.
OBJECT REPLICATION
MySQL是怎样运行的(待补充)
- 出版于2020年,作者:小孩子4919。
基本
架构
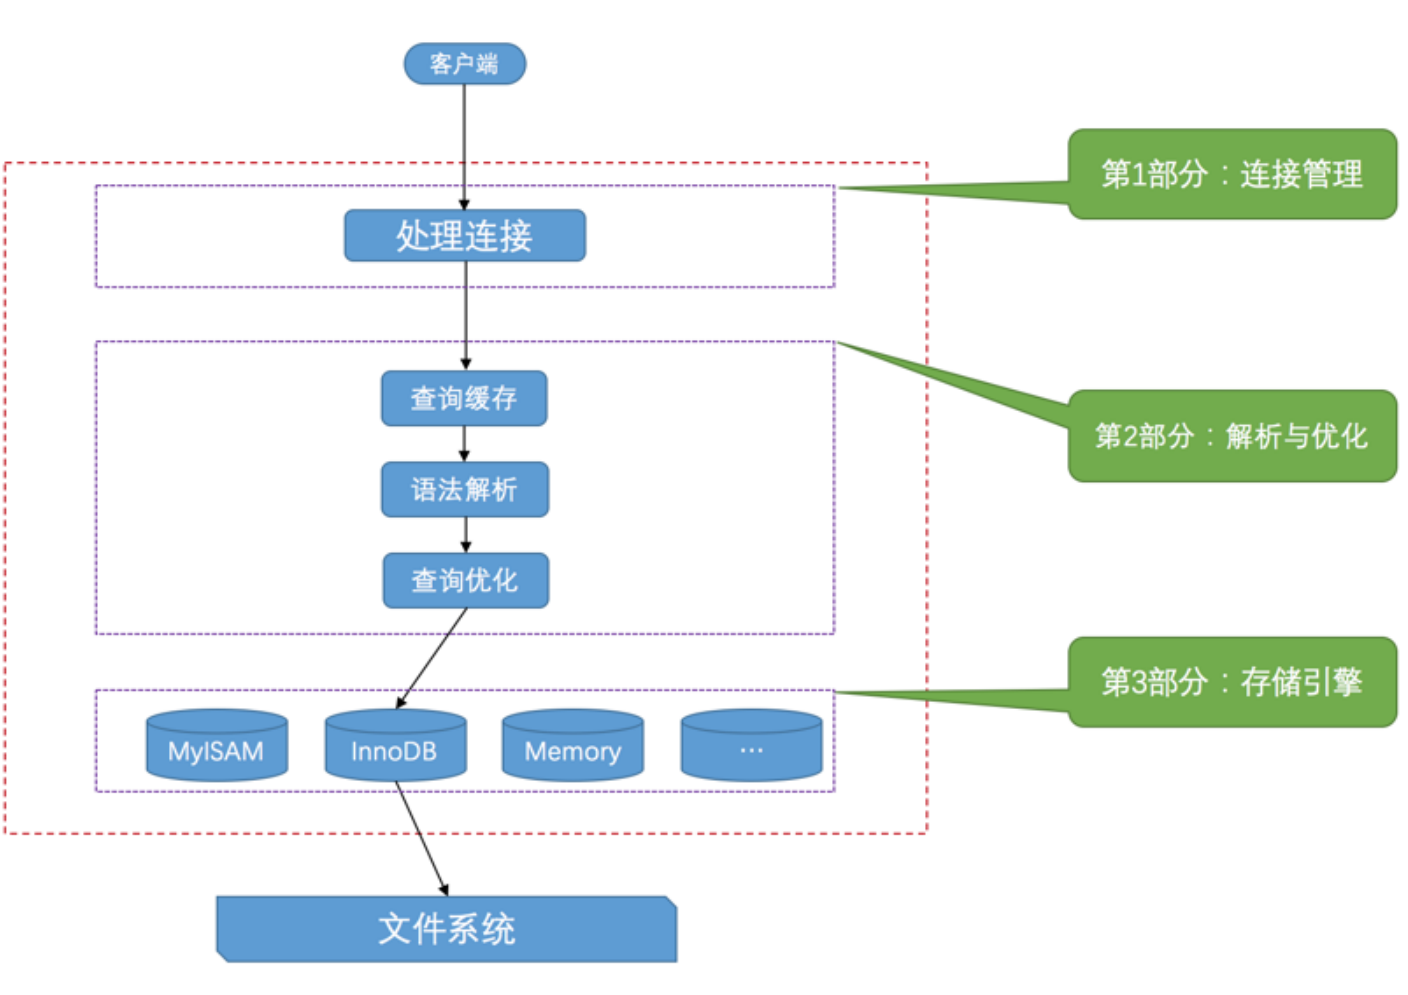
- MySQL的查询缓存过于低效,需要查询语句完全相同才可以生效,所以在8.0版本后被彻底废除
在客户端程序发起连接的时候,需要携带主机信息、用户名、密码,服务器程序会对客户端程序提供的这些信息进行认证,如果认证失败,服务器程序会拒绝连接
MySQL中的存储引擎列举:
| 存储引擎 | 描述 |
|---|---|
| ARCHIVE | 用于数据存档(行被插入后不能再修改) |
| BLACKHOLE | 丢弃写操作,读操作会返回空内容 |
| CSV | 在存储数据时,以逗号分隔各个数据项 |
| FEDERATED | 用来访问远程表 |
| InnoDB | 具备外键支持功能的事务存储引擎 |
| MEMORY | 置于内存的表 |
| MERGE | 用来管理多个MyISAM表构成的表集合 |
| MyISAM | 主要的非事务处理存储引擎 |
| NDB | MySQL集群专用存储引擎 |
我们最常用的就是InnoDB(默认引擎)和MyISAM(旧系统),有时候会用Memory(临时数据),用法如下:
| |
这被称为“可插拔存储引擎架构”
记录
真实数据在不同存储引擎中存放的格式一般是不同的,甚至有的存储引擎比如 Memory 都不用磁盘来存储数据,也就是说关闭服务器后表中的数据就消失了。
设计 InnoDB 存储引擎的大叔们到现在为止设计了4种不同类型的 行格式 ,分别是 Compact 、 Redundant 、Dynamic 和 Compressed 行格式
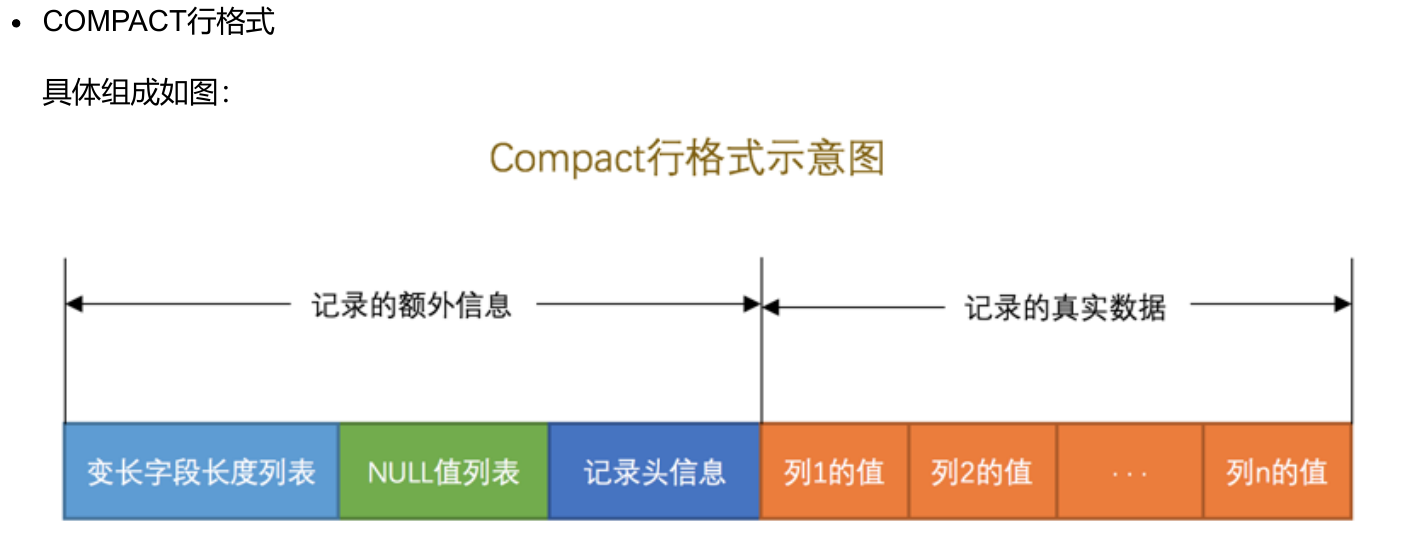
索引
MySQL采用B+树索引,叶子节点中存储了页号,行号等定位信息,InnoDB中一个B+树节点就是一个Page.
InnoDB 内节点记录存“索引键 + 子页号”;聚簇索引叶子存完整行;二级索引叶子存“二级键 + 主键”,不存聚簇数据页号。
数据存储
因为 MySQL 的数据都是存在文件系统中的,就不得不受到文件系统的一些制约,这在数据库和表的命名、表的大小和性能方面体现的比较明显,比如下边这些方面:
- 数据库名称和表名称不得超过文件系统所允许的最大长度。
- 每个数据库都对应 数据目录 的一个子目录,数据库名称就是这个子目录的名称
- 文件长度受文件系统最大长度限制
总的来说,MySQL使用frm格式(frame)的文件来描述表结构,使用ibd文件来标记表的具体数据存放位置,这被称为表空间(table space),一个表空间可以对应多个区(extent),每个区由连续的64页组成(默认为1MB大小),我们的数据就存储在页中.
具体的文件结构就没必要去看了,看了也看不懂…
进阶
等工作了再来看吧,目前这些知识也够用了.
Nginx应用与运维实战
- 出版于2020年,作者:王小东。
- 不推荐,抓不住重点
NGINX HTTP Server
- 不推荐
入门
include关键字
该关键字是递归处理的,会将对应文件的内容全部插入调用处.
http模块
http是顶层模块,其中可以声明多个server块
变量
NGINX中的变量始终以$开头:
| |
字符串则有两种写法:
- 不带引号的普通值:
| |
- 带引号的含有空格/花括号/分号的特殊值,单双引号效果相同:
| |
总结
我服了,找了这么多nginx方面的书,没有一本能够清晰的讲清楚nginx配置的,总要弯弯绕绕很久,而官网的文档也不甚清晰,还给F5打广告,受不了了.
Node.js Cookbook
介绍
Node.js 创建于2009年,是一个跨平台的开源JavaScript运行时,允许你在浏览器环境之外执行JavaScript。它封装了谷歌浏览器的JavaScript引擎——V8引擎,使JavaScript能够在脱离浏览器的情况下运行
Node的执行环境为单线程,通过异步I/O来实现高并发,这与Python的GIL极为相似,不过也正是因为这样,后端通常不会让Node来负责,否则就会受到性能上的限制.
总结
忽然想到,我不太需要知道node.js的api用法,毕竟框架都帮我做好了,而且我即便学习好了,或许日后也会被其他框架取代,只是现在还看不出这个趋势而已.
Node.js in Action, Second Edition
- 出版于2017年(第2版),出版商:Manning,作者:Alex Young。
- 十年前写的,用的还是CommonJS的写法 不推荐,太老了,涉及的技术栈也都非常老旧,基本都死透了.
Powerful Python
- 出版于2024年,出版商:O’Reilly,作者:Aaron Maxwell。
尽管是24年出版的书,但内容都很老套,也都讲的很简单.
Powershell Cookbook
- 出版于2021年(第4版),出版商:O’Reilly,作者:Lee Holmes。
- 这本书是21年出版的,所以用的还是PowerShell Core,不推荐,不过拿来学习基本命令还可以
前言
Windows早期的shell用的是cmd.exe,于93年发布,到了02年,微软设立了一个内部项目Monad,是06年发布的Windows Powershell的前身,在16年,随着.NET Framework变成.NET Core,微软发布了开源跨平台的Powershell Core来取代原先的Windows Powershell,再后来,随着.NET Core更名为.NET,Powershell Core于20年也变成了Powershell,在这几年一直停留在7.x版本.
- 这也可以看得出来,微软的底层架构到了现在也没有完全成熟.
而操作系统默认安装的甚至不是Powershell Core,而是Windows Powershell:
| |
而更为古老的cmd也一直留在Windows中,没有被删除.
语法
基本语法
要在包含空格的命令名称中运行命令,请将其文件名用单引号(’)括起来,并在命令前加上和号(&):
| |
要在当前目录下运行一个命令,请在文件名前加上.:
| |
- 如果PowerShell能在系统路径中找到某个脚本或工具,则无需显式指定其位置
cmdlet命令
Cmdlet 是PowerShell中使用的轻量型单一功能命令,采用“动词-名词”(Verb-Noun)的结构命名,中间以短划线分隔(例如 Get-Process).
管道
- ps中最强的命令
在 PowerShell 中,我们使用管道符(|)来分隔管线的每个阶段:
| |
- Where-Object是一个非常方便的从列表/终端输出中筛选符合要求的变量的工具,更为简短的别名为
where和?
&& and ||同样也属于管道运算符,可用于输出调试信息:
| |
脚本
cmd时代的脚本名字为.bat,对应的英文为batch,通常称为批处理文件,而powershell的脚本名字为.ps1
总结
都说是Cookbook了,自然没有一丁点的可读性,真要学的时候再来翻吧.
PROFESSIONAL C++(待补充)
Pro git
- 官网
- 非常好的教程,比所有的二手资料都齐全.
起步
Git 和其它版本控制系统(包括 Subversion 和近似工具)的主要差别在于 Git 对待数据的方式。 从概念上来说,其它大部分系统以文件变更列表的方式存储信息,这类系统(CVS、Subversion、Perforce 等等) 将它们存储的信息看作是一组基本文件和每个文件随时间逐步累积的差异 (它们通常称作 基于差异(delta-based) 的版本控制)。
Git 不按照以上方式对待或保存数据。反之,Git 更像是把数据看作是对小型文件系统的一系列快照。 在 Git 中,每当你提交更新或保存项目状态时,它基本上就会对当时的全部文件创建一个快照并保存这个快照的索引。 为了效率,如果文件没有修改,Git 不再重新存储该文件,而是只保留一个链接指向之前存储的文件。 Git 对待数据更像是一个 快照流。
在 Git 中的绝大多数操作都只需要访问本地文件和资源,一般不需要来自网络上其它计算机的信息。 如果你习惯于所有操作都有网络延时开销的集中式版本控制系统,Git 在这方面会让你感到速度之神赐给了 Git 超凡的能量。 因为你在本地磁盘上就有项目的完整历史,所以大部分操作看起来瞬间完成。
Git 中所有的数据在存储前都计算校验和,然后以校验和来引用。 这意味着不可能在 Git 不知情时更改任何文件内容或目录内容。 这个功能建构在 Git 底层,是构成 Git 哲学不可或缺的部分。 若你在传送过程中丢失信息或损坏文件,Git 就能发现。
你执行的 Git 操作,几乎只往 Git 数据库中 添加 数据。 你很难使用 Git 从数据库中删除数据,也就是说 Git 几乎不会执行任何可能导致文件不可恢复的操作。 同别的 VCS 一样,未提交更新时有可能丢失或弄乱修改的内容。但是一旦你提交快照到 Git 中, 就难以再丢失数据,特别是如果你定期的推送数据库到其它仓库的话。
现在请注意,如果你希望后面的学习更顺利,请记住下面这些关于 Git 的概念。 Git 有三种状态,你的文件可能处于其中之一: 已提交(committed)、已修改(modified) 和 已暂存(staged)。
- 已修改表示修改了文件,但还没保存到数据库中。
- 已暂存表示对一个已修改文件的当前版本做了标记,使之包含在下次提交的快照中。
- 已提交表示数据已经安全地保存在本地数据库中。
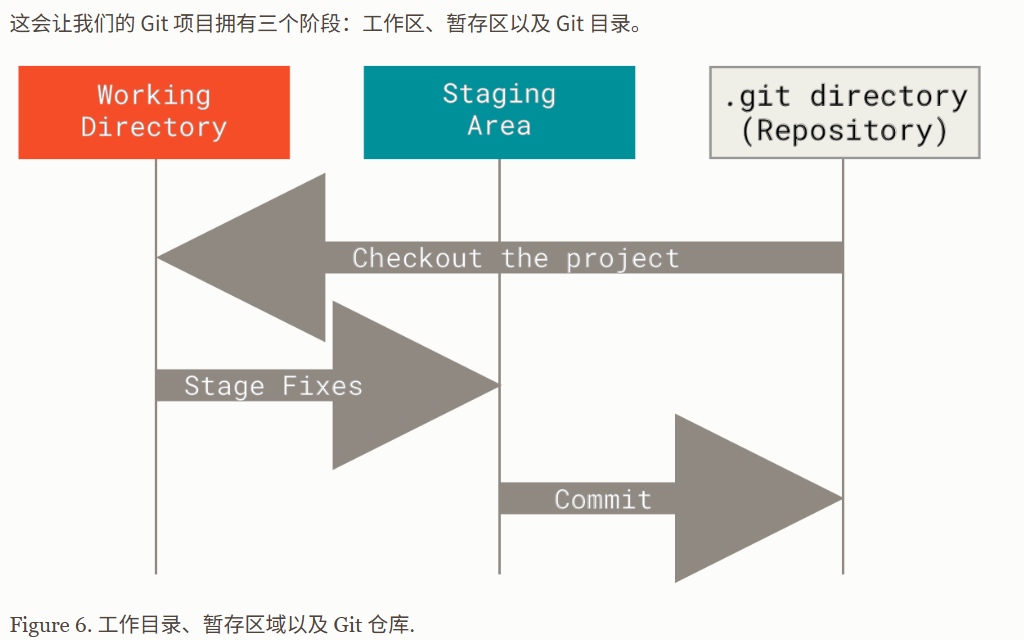
也就是说,直接改系统目录下的.gitconfig文件也可以更新全局代理.
Git基础
git init: 初始化git仓库git add: 追踪新文件git commmit: 提交新文件git clone url: 从远程的仓库拉取文件和git记录
文件 .gitignore 的格式规范如下:
- 所有空行或者以
#开头的行都会被 Git 忽略。 - 可以使用标准的 glob 模式匹配,它会递归地应用在整个工作区中。
- 匹配模式可以以(
/)开头防止递归。 - 匹配模式可以以(
/)结尾指定目录。 - 要忽略指定模式以外的文件或目录,可以在模式前加上叹号(
!)取反。
尽管使用暂存区域的方式可以精心准备要提交的细节,但有时候这么做略显繁琐。 Git 提供了一个跳过使用暂存区域的方式, 只要在提交的时候,给 git commit 加上 -a 选项,Git 就会自动把所有已经跟踪过的文件暂存起来一并提交,从而跳过 git add 步骤:
| |
| |
- 这种写法确实不错,又能偷点懒了
例如,你提交后发现忘记了暂存某些需要的修改,可以像下面这样操作:
| |
最终你只会有一个提交——第二次提交将代替第一次提交的结果。
修补提交最明显的价值是可以稍微改进你最后的提交,而不会让“啊,忘了添加一个文件”或者 “小修补,修正笔误”这种提交信息弄乱你的仓库历史。
git checkout 用于撤销之前所做的修改.
请务必记得
git checkout — <file>是一个危险的命令。 你对那个文件在本地的任何修改都会消失——Git 会用最近提交的版本覆盖掉它。 除非你确实清楚不想要对那个文件的本地修改了,否则请不要使用这个命令。
远程仓库
| |
git别名
Git 并不会在你输入部分命令时自动推断出你想要的命令。 如果不想每次都输入完整的 Git 命令,可以通过 git config 文件来轻松地为每一个命令设置一个别名。 这里有一些例子你可以试试:
| |
这意味着,当要输入 git commit 时,只需要输入 git ci
Git分支
git branch用于确认有哪些分支,git branch 分支名用于创建分支,这只不过是创建了一个新的git指针,并不需要复制文件的内容.git checkout用于切换分支,这是通过git指针的移动实现的.
在19年,Git引入了git switch和git restore命令,将功能过于繁杂的git checkout拆分成了两个命令.
git checkout -b 分支名是两条命令的结合,可以快速创建一个新分支.等价命令就是git switch -c <branch>
git merge 分支名用于将某个分支合并到当前分支上, 如果顺着一个分支走下去能够到达另一个分支,那么合并时只需要简单地将旧分支的指针往前面移动就可以了,这被称为快进(fast-forward).
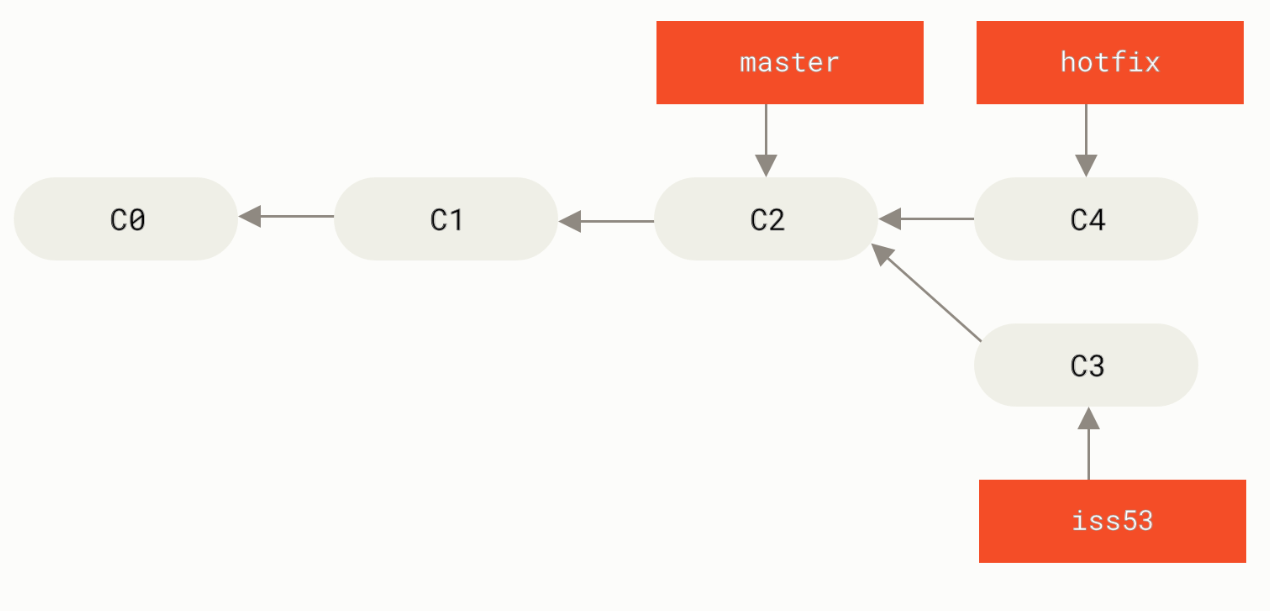
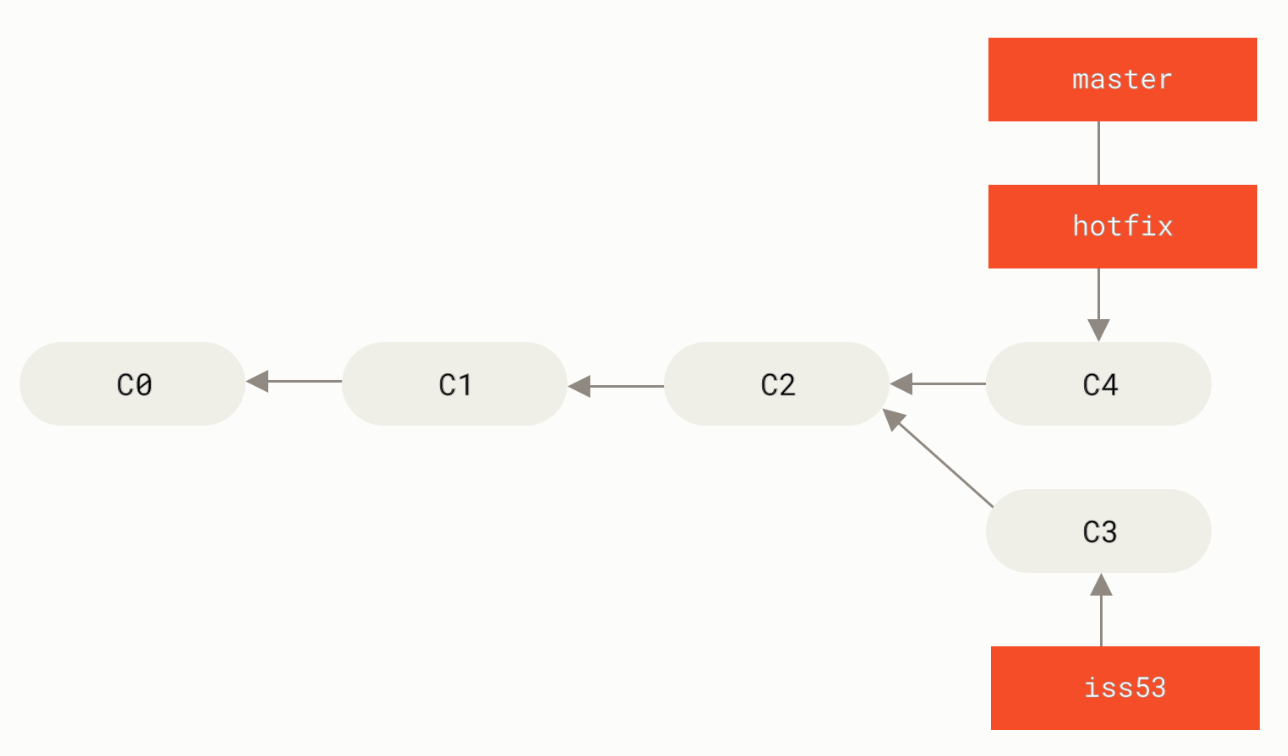
git branch -d 分支名用于删除不需要的分支
| |
假设你已经修正了 #53 问题,并且打算将你的工作合并入 master 分支。 为此,你需要合并 iss53 分支到 master 分支,这和之前你合并 hotfix 分支所做的工作差不多。 你只需要检出到你想合并入的分支,然后运行 git merge 命令:
| |
这和你之前合并 hotfix 分支的时候看起来有一点不一样。 在这种情况下,你的开发历史从一个更早的地方开始分叉开来(diverged)。 因为,master 分支所在提交并不是 iss53 分支所在提交的直接祖先,Git 不得不做一些额外的工作。 出现这种情况的时候,Git 会使用两个分支的末端所指的快照(C4 和 C5)以及这两个分支的公共祖先(C2),做一个简单的三方合并。
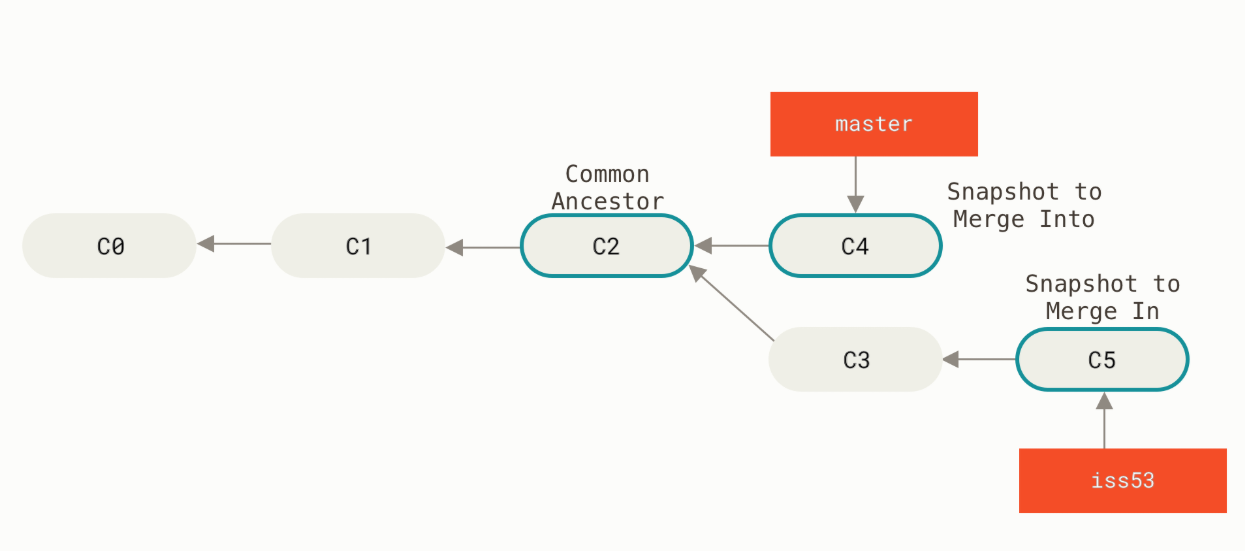
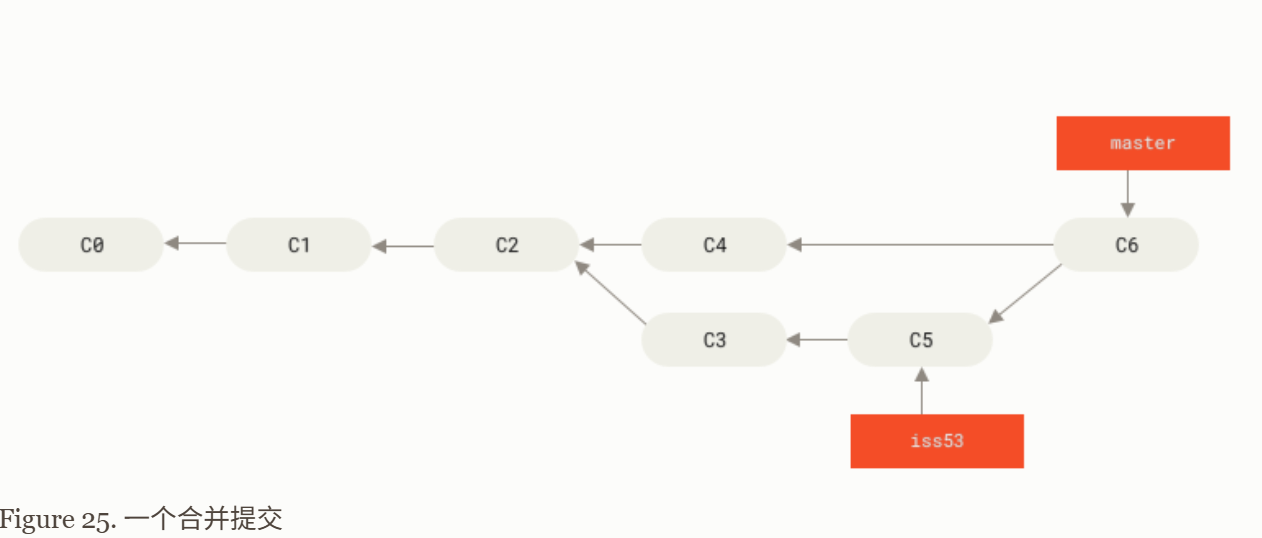
如果你在两个不同的分支中,对同一个文件的同一个部分进行了不同的修改,Git 就没法干净的合并它们。 如果你对 #53 问题的修改和有关 hotfix 分支的修改都涉及到同一个文件的同一处,在合并它们的时候就会产生合并冲突:
| |
| |
服务器上的git(过)
Git 可以使用四种不同的协议来传输资料:本地协议(Local),HTTP 协议,SSH(Secure Shell)协议及 Git 协议。
Github
现在,你完全可以使用 https:// 协议,通过你刚刚创建的用户名和密码访问 Git 版本库。 但是,如果仅仅克隆公有项目,你甚至不需要注册——刚刚我们创建的账户是为了以后 fork 其它项目,以及推送我们自己的修改。
我现在才知道原来用http协议甚至不需要注册ssh公钥,那么这样来看那些教新手入门Git的教程全都在扯淡了,直接让新人用http协议clone不就可以了,也就没有那么劝退了.
如果你想要参与某个项目,但是并没有推送权限,这时可以对这个项目进行“派生(Fork)”。 当你“派生”一个项目时,GitHub 会在你的空间中创建一个完全属于你的项目副本,且你对其具有推送权限。
Git内部原理
当在一个新目录或已有目录执行 git init 时,Git 会创建一个 .git 目录。 这个目录包含了几乎所有 Git 存储和操作的东西。 如若想备份或复制一个版本库,只需把这个目录拷贝至另一处即可。 本章探讨的所有内容,均位于这个目录内。 新初始化的 .git 目录的典型结构如下:
| |
config 文件包含项目特有的配置选项。 info 目录包含一个全局性排除(global exclude)文件, 用以放置那些不希望被记录在 .gitignore 文件中的忽略模式(ignored patterns)。
剩下的四个条目很重要:HEAD 文件、(尚待创建的)index 文件,和 objects 目录、refs 目录。 它们都是 Git 的核心组成部分。 objects 目录存储所有数据内容;refs 目录存储指向数据(分支、远程仓库和标签等)的提交对象的指针; HEAD 文件指向目前被检出的分支;index 文件保存暂存区信息。
由于这部分讲的不是很详细,只好另外找方法来学习git的内部原理了.
Python源码剖析
- 出版于2008年,作者:陈儒。
概览
Python的整体架构如下:
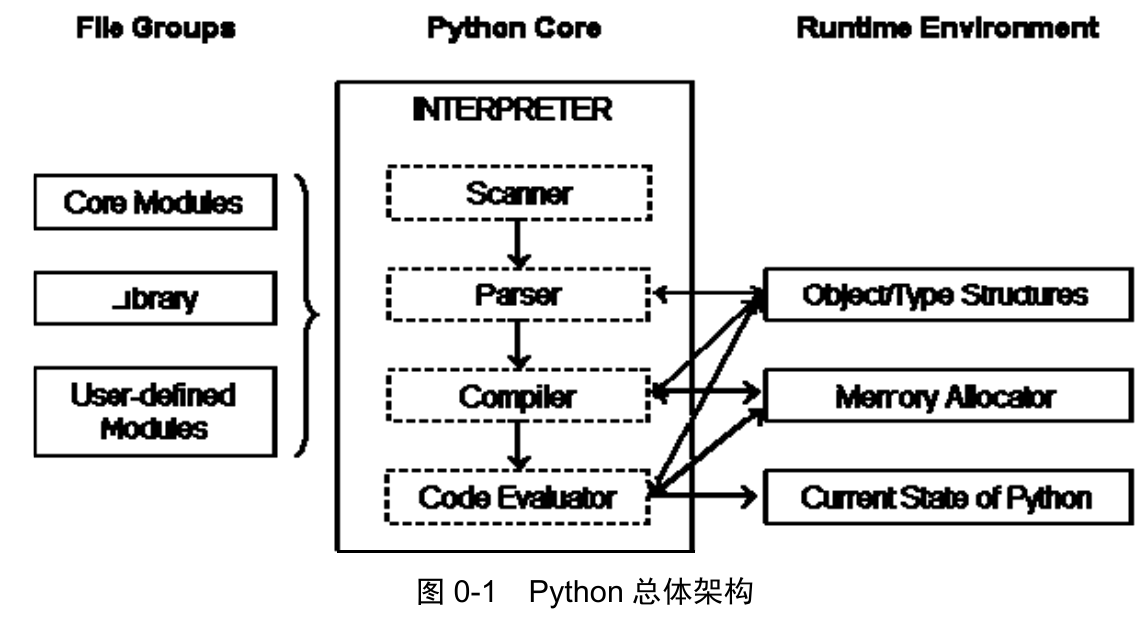
分为三个部分:
- 模块: 系统模块(如os)和用户自定义模块(如fastapi)
- python运行时: python程序运行时的所有上下文,包括类型系统,内存分配器和运行时的状态信息.
- python解释器/虚拟机: 将python代码转换成字节码,并执行该字节码.
这本书分析的python版本为06年发布的2.5,距今已经有整整二十年,而我们都知道python3对python2做了很多大规模的修改,看一下两者的架构图对比:
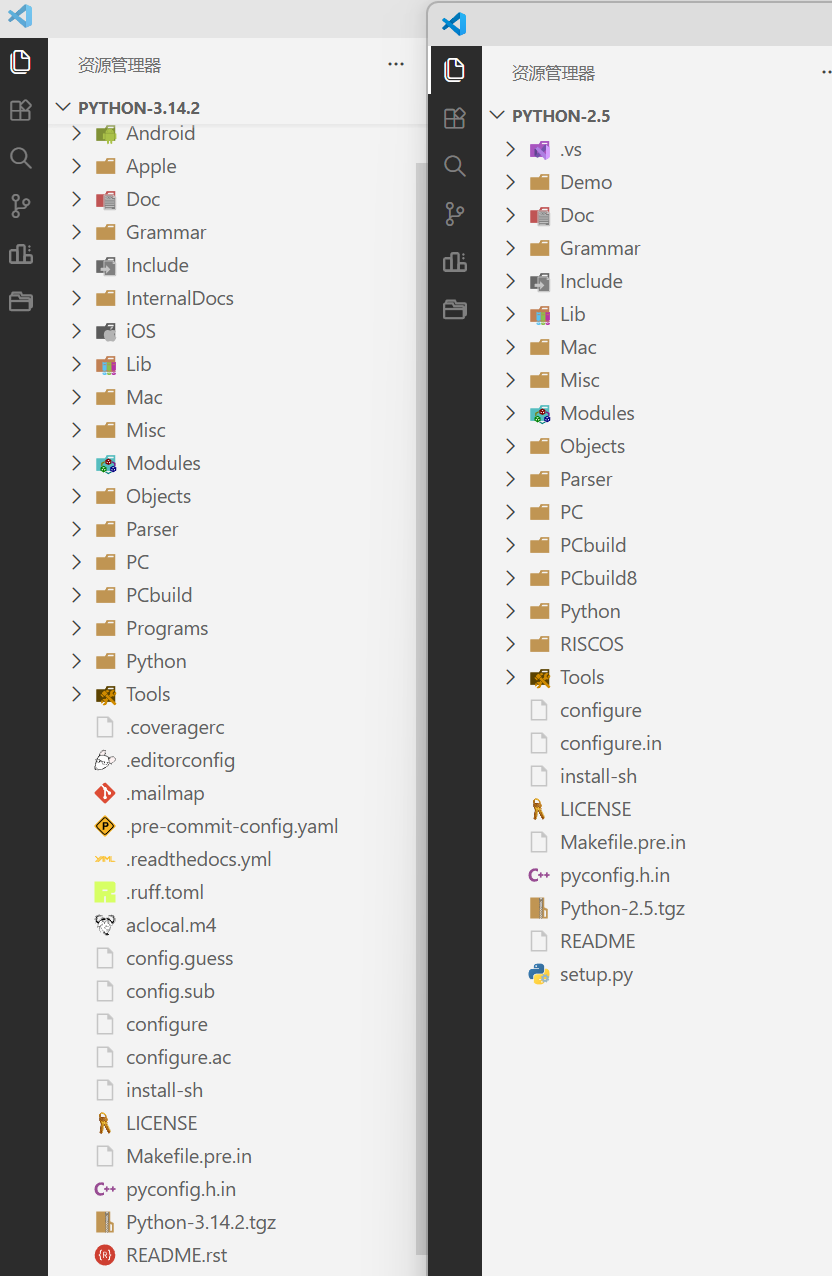
python2.5
| |
- 852 828行代码
python3.14
| |
- 1 840 232行代码
两倍多的增量注定了这本书太老了,不过话又说回来,也正是因为分析的python版本老,我们才能看得清楚python的核心架构,所以更有必要看这本书了.
Python2.5的核心文件夹如下:
- Include:包含了 Python 提供的所有头文件。用户若使用 C 或 C++ 编写自定义扩展模块,需调用此处的头文件。
- Lib:包含了 Python 自带的所有标准库,均使用 Python 语言编写。
- Modules:包含了用 C 语言编写的模块(如 random、cStringIO)。主要存放对执行速度要求极高的模块。
- Parser:包含了 Python 解释器中的 Scanner(词法分析)和 Parser(语法分析)部分,以及可根据语法自动生成词法/语法分析器的工具。
- Objects:包含了所有 Python 的内建对象(如整数、list、dict)以及运行时所需的内部对象的具体实现。
- Python:包含了 Python 解释器中的 Compiler(编译器)和执行引擎部分,是 Python 运行的核心。
- PCBuild:包含了 Visual Studio 2003 的工程文件,用于在 VS2003 环境下编译 Python 源码。
- PCBuild8:包含了 Visual Studio 2005 使用的工程文件。
Python内部对象
概览
在Python中,一切都是对象,甚至类型(如int,string)也是一个对象.
Python的实现语言一直都是ANSI C(C的简单改版),它并不是一个面向对象的语言,那么Python是如何实现面向对象的呢?
在Python中,对象为C中的结构体在堆上申请的一块内存,我们都知道堆的申请每次都要指定内存大小(malloc),那么一个对象一旦被创建,它的内存大小就是不变的了.
这样一来,诸如列表,字典等可变长度的对象就需要维护一个指针了,随时指向一个新的内存区域以便扩展或者收缩容量.
PyObject
PyObject是所有python对象的基本内容,不同的类型是在PyObject上进行扩展来实现的:
| |
为了存储变长的对象,python设计了一个PyVarObject,本质上也还是对PyObject的简单扩展:
| |
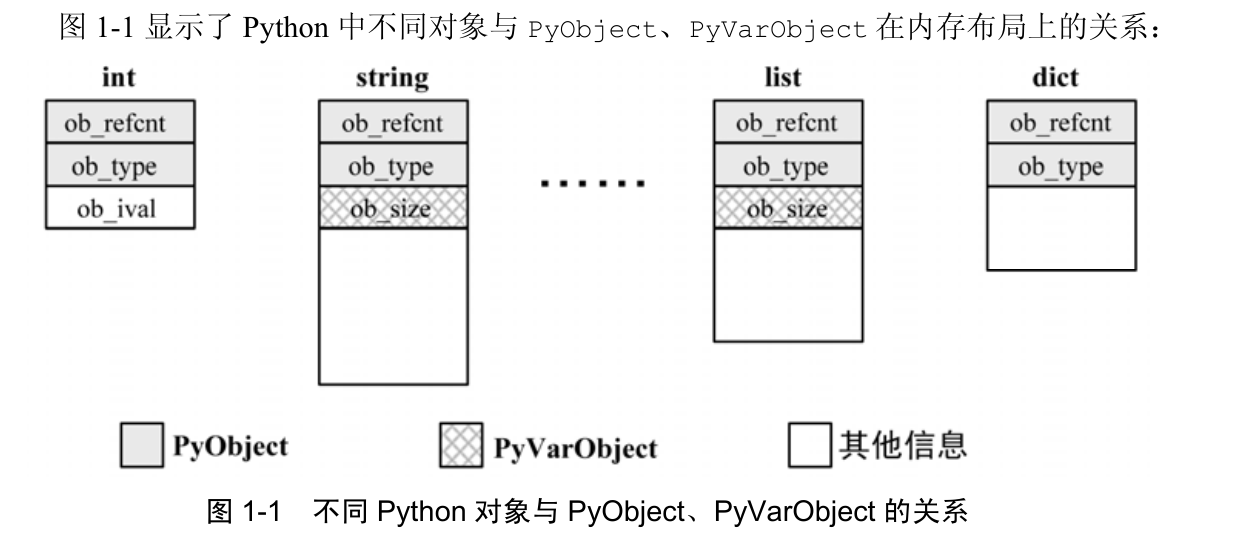
在 Python 内部,每一个对象都拥有相同的对象头部。这就使得在 Python 中,对对象的引用变得非常的统一, 我们只需要用一个 PyObject* 指针就可以引用任意的一个对象。而不论该对象实际是一个什么对象。
引用计数
Python的垃圾回收使用的是引用计数,初始计数为1,被引用对象增加或删除时对应增减,当一个对象的引用计数减少到 0 之后,Python将调用该对象的析构函数(实际为C中的free)来释放该对象所占有的内存和系统资源
整数对象
Python中的整数对象PyIntObject会根据整数的大小来进行适配管理,小整数会被放入一个驻留在内存的对象池中,永远不会被销毁,无论创建多少次都会指向同一个内存地址;
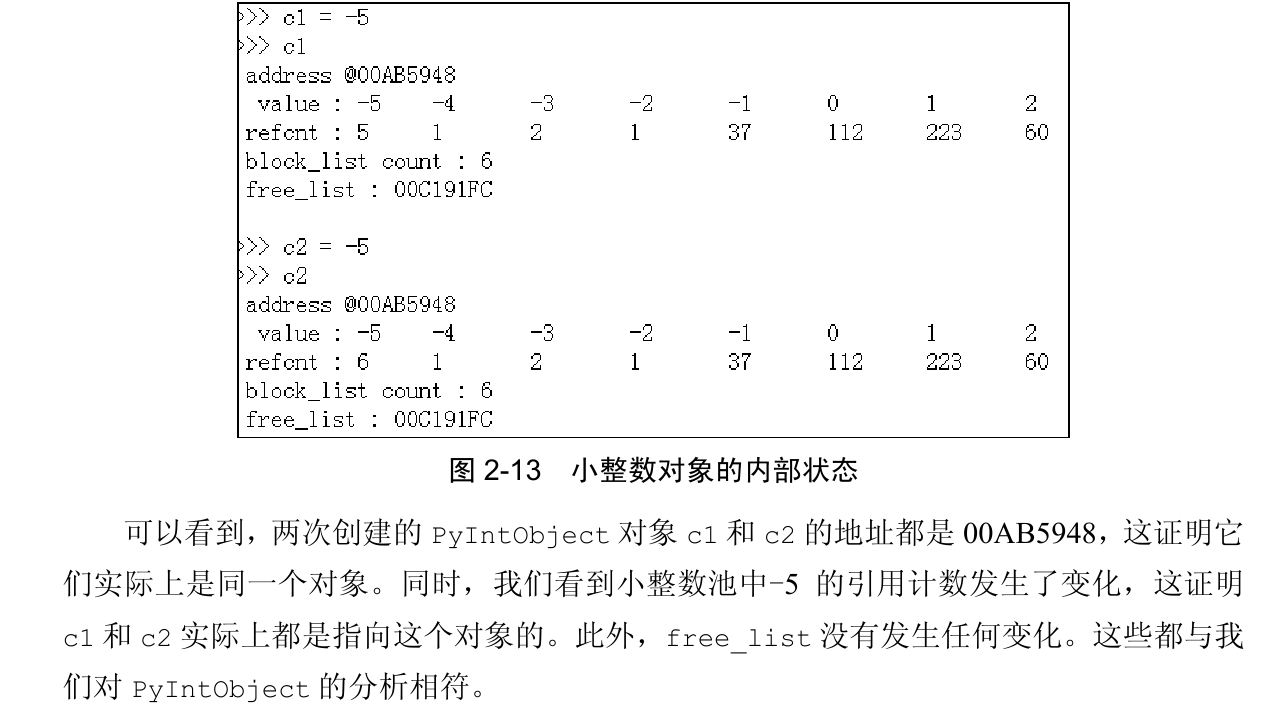
而大整数会放入一块共享的内存空间,通过一个单向链表来管理其中所有的空闲内存
字符串对象
PyStringObject是一个有着可变长度内存的对象,定义如下:
| |
同 C 中的字符串一样,PyStringObject 内部维护的字符串在末尾必须以’\0’结尾,
与对待小整数的方式一样,Python为一个字节的字符也设置了一个对象缓冲池.
由于PyStringObject是一个不可变对象,所以每次用+进行字符串拼接时都要创建一个新对象,这会极大地降低python运行效率,官方的做法是在需要在一个循环中进行多次拼接时,就统一获取后再进行唯一的一次拼接.这样就可以提高运行的效率.
List对象
类似于cpp中的vector机制,不多赘述.
Dict对象
PyDictObject对搜索的效率要求极其苛刻,这是因为 PyDictObject 对象在Python 本身的实现中被大量地采用。比如 Python 会通过 PyDictObject 来建立执行 Python字节码的运行环境,其中会存放变量名和变量值的元素对,通过查找变量名获得变量值。
因此,PyDictObject 没有如cpp STL中的 map 一样采用红黑树,而是采用了散列表(hash table),因为理论上,在最优情况下,散列表能提供 O(1)复杂度的搜索效率。
| |
而实际的字典PyDictObject就是管理PyDictEntry节点的结构体容器,通过数组来实现随机存取:
| |
当产生散列冲突时,Python 会通过一个二次探测函数 f ,计算下一个候选位置 addr, 如果位置 addr 可用,则可将待插入元素放到位置 addr;如果位置 addr 不可用,则 Python 会再次使用探测函数 f,获得下一个候选位置,如此不断探测,总会找到一个可用的位置。
这个f的递推公式如下:
| |
Python虚拟机
Python编译
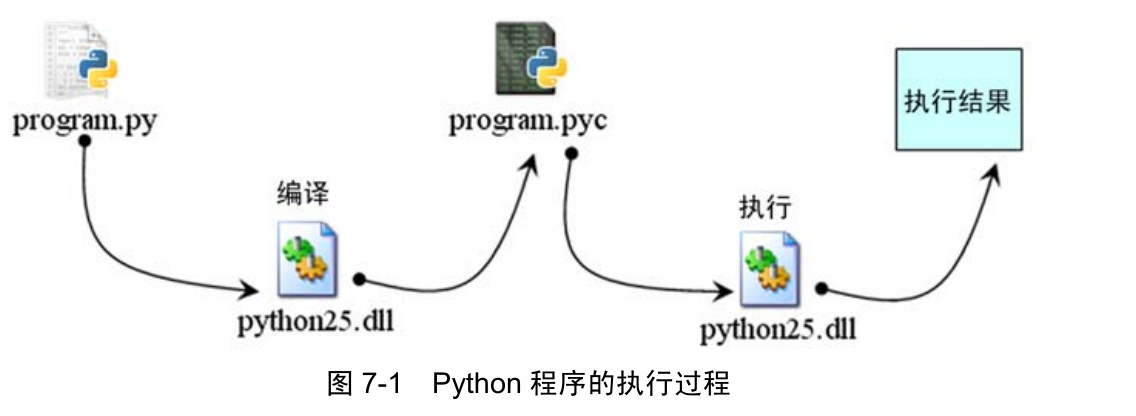
虽然 Python 程序执行的机理与 Java 程序和 C# 程序的执行机理是一样的,但是 Python 的虚拟机与 Java 和 .NET 虚拟机还有不同之处。一个最大的不同是,Python 的虚拟机是一种更高级的虚拟机。这里的高级不是说 Python 的虚拟机的功能比 Java 和 .NET 虚拟机的功能更强大、更拽,而是说与 Java 或 .NET 相比,Python 的虚拟机距离真实机器更远。或者可以这么说,Python 虚拟机是一种抽象层次更高的虚拟机。
在程序运行期间,编译结果存在于内存的 PyCodeObject 对象中;而 Python 结束运行后,编译结果又被保存到了 pyc 文件中。当下一次运行相同的程序时,Python 会根据 pyc文件中记录的编译结果直接建立内存中的 PyCodeObject 对象,而不用再次对源文件进行编译了。
Python 编译器在对 Python 源代码进行编译的时候,对于代码中的一个 Code Block,会创建一个 PyCodeObject 对象与这段代码对应。那么如何确定多少代码算是一个 Code Block 呢?事实上,Python 有一个简单而清晰的规则:当进入一个新的名字空间,或者说作用域时,我们就算是进入了一个新的 Code Block 了。
也就是说,每个python文件,每个函数,每个类都会被分配一个PyCodeObject,
每一个 PyCodeObject 对象中都包含了每一个 Code Block 中所有 Python 源代码经过编译后得到的 byte code 序列。前面我们提到,Python 会将这些字节码序列和 PyCodeObject 对象一起存储在 pyc 文件中。但不幸的是,事实并不总是这样。试着在命令行下执行一下 python demo.py,你会发现 Python 并没有产生一个对应的 pyc 文件。为什么呢?真实的原因不得而知,不过我们可以做出一个合理的猜测:有一些 Python 程序只是临时完成一些琐碎的工作,比如统计某个特定文件中的词频信息,这样的程序可能仅仅运行一次,然后就再也没用了,所以也就没有保存其对应的 pyc 文件的必要,因此,对于直接用 python demo.py 这样的形式执行的程序,Python 就不会存储编译结果了。
但是假如说 demo.py 中实现的是一个需要被重用的类时,我们就希望能存储其对应的 PyCodeObject 对象,这样下次 Python 就不会再次进行编译了。当在另外一个程序,比如说在 demo.py 中对 demo.py 进行一个 import demo 的动态加载动作之后,你就会发现,Python 会为其产生 pyc 文件了。
也就是说,import机制才会触发pyc文件的生成,这也解释了为什么我们一般没见过main.pyc这个文件.
PyCodeObject中记录了各种各样的Code Block信息:
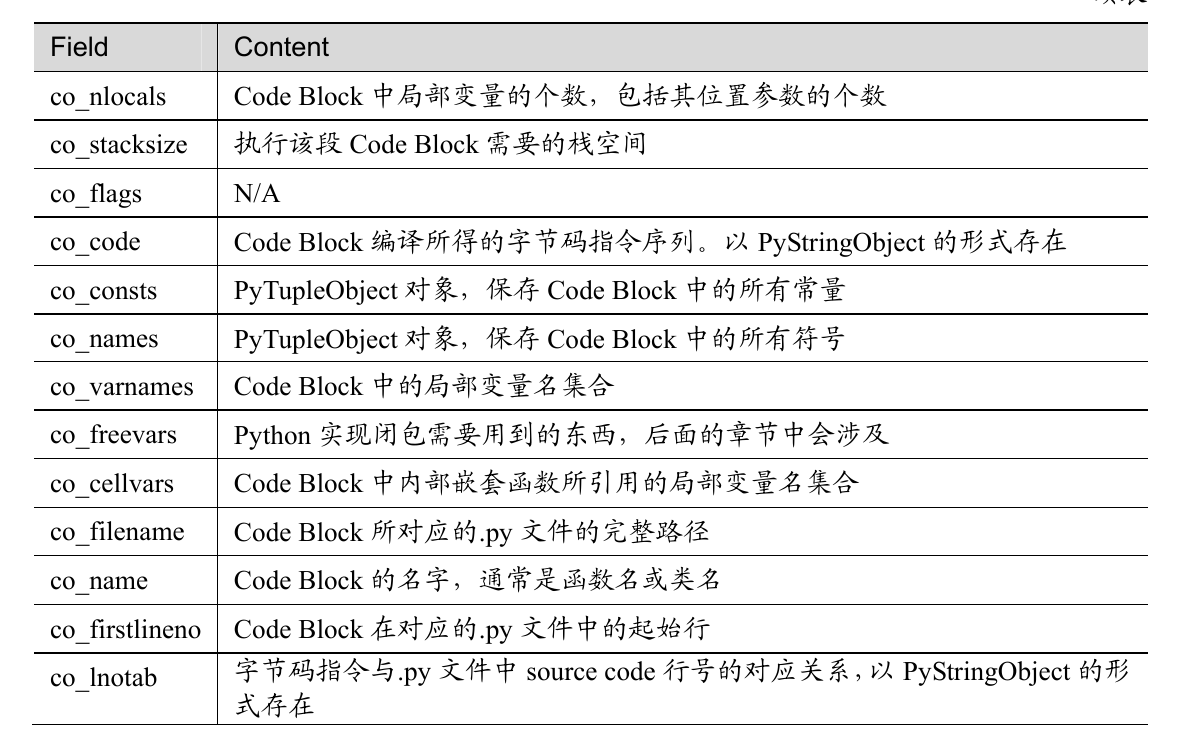
| |
从 write_compiled_module 中可以发现,一个 pyc 文件中实际上包含了三部分独立的信息:Python 的 magic number、pyc 文件创建的时间信息,以及 PyCodeObject 对象。
不同版本的Python会定义不同的魔数,如果编译器发现某个文件的魔数对不上,则会因为不兼容而报错.
Python虚拟机框架
PyCodeObject 对象中包含了最关键的字节码指令,以及关于程序的所有静态信息。 然而有一点,是 PyCodeObject 对象没有包含,也不可能包含的。
这就是关于程序运行的动态信息——执行环境。
执行环境就是命名空间,栈帧的位置等信息.
Python使用PyFrameObject来记录执行环境,每个PyFrameObject和一个Code Block一一对应:
| |
名字、作用域和名字空间
每一个.py 文件被称 Python 视为一个 module。这些 module 中,有一个主 module,不管一个 module 是如何被加载的,在加载的过程中都会进行一个动作——执行 module 中的表达式。
一个对象(模块对象,class对象,dict对象,函数对象)的名字空间中的所有名字都称为对象的属性,要使用别的module中的名字,就要通过属性引用.来实现.
在一个 module 内部,可能存在多个名字空间,每一个名字空间都与一个作用域对应。位于一个作用域中的代码可以直接访问作用域中出现的名字,所谓“直接访问”,就是指不用加上属性引用方式的访问修饰符“.”:比如在 B.py 中访问 A.py 中的名字 a,需要使用“print A.a”的方式;而在 B.py 中访问自己这个 module 中的名字 a,则直接使 用“print a”这样的方式就可以了。
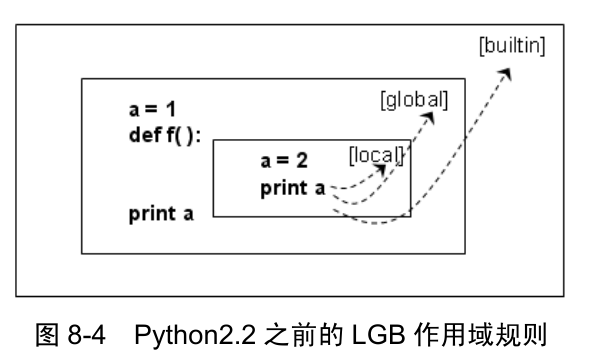
因此,一旦local作用域中定义了某个变量a,那么变量a的作用域就锁定在了local,一旦试图在未定义前访问,就会报错,如下述代码:
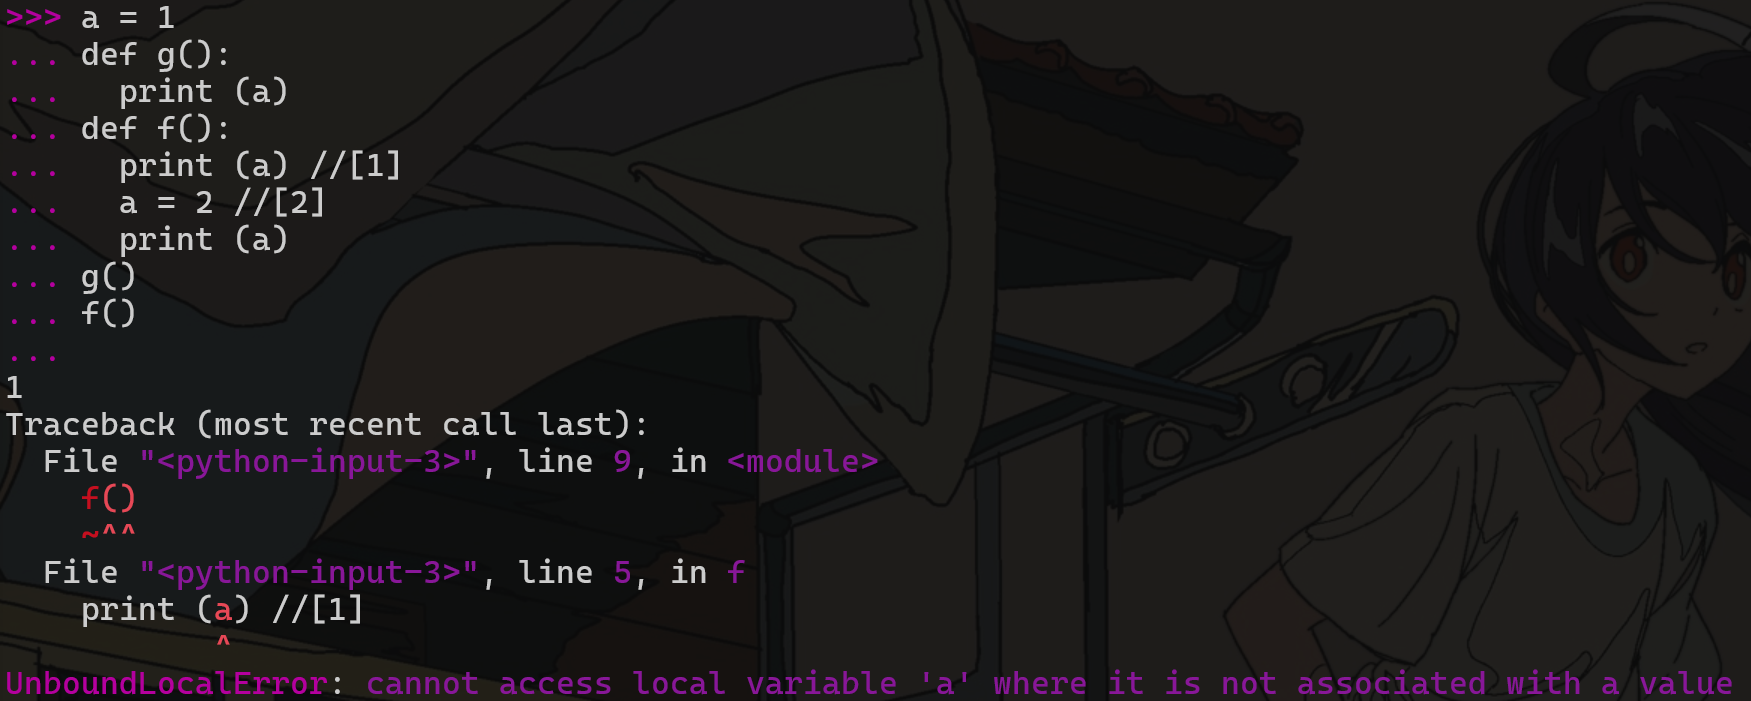
- 不过正常的程序员不会写出这种代码的…
线程机制
Python虚拟机中的线程仍然使用操作系统的原生线程。用PyThreadState 作为线程状态的抽象.而进程则用 PyInterpreterState 对象来实现。
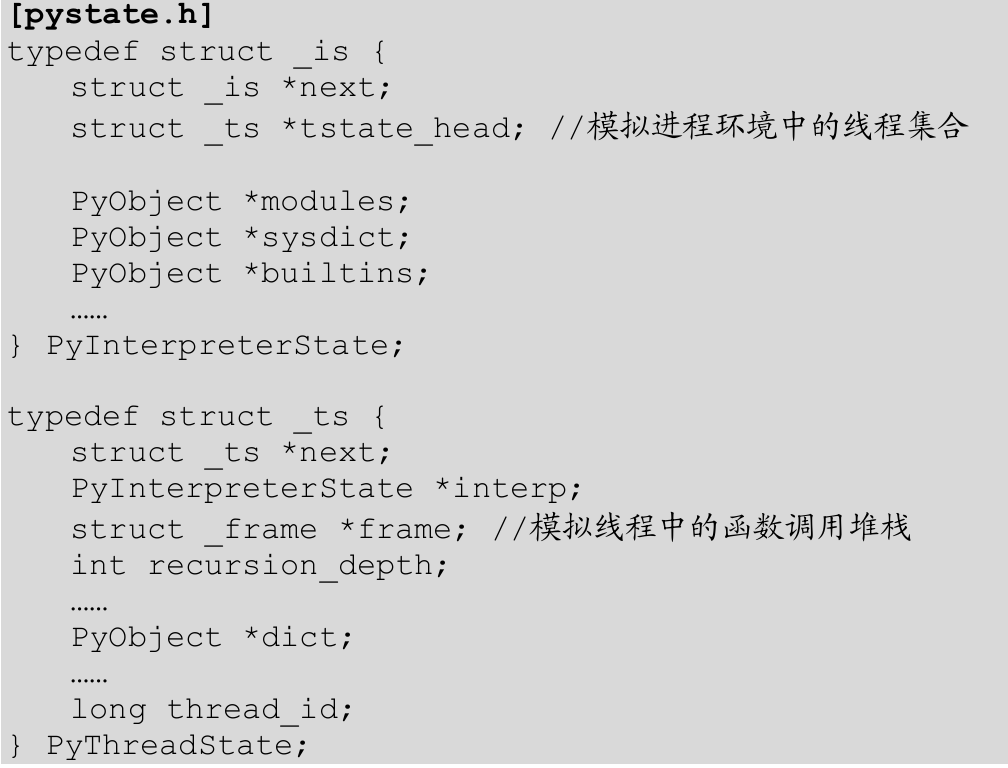
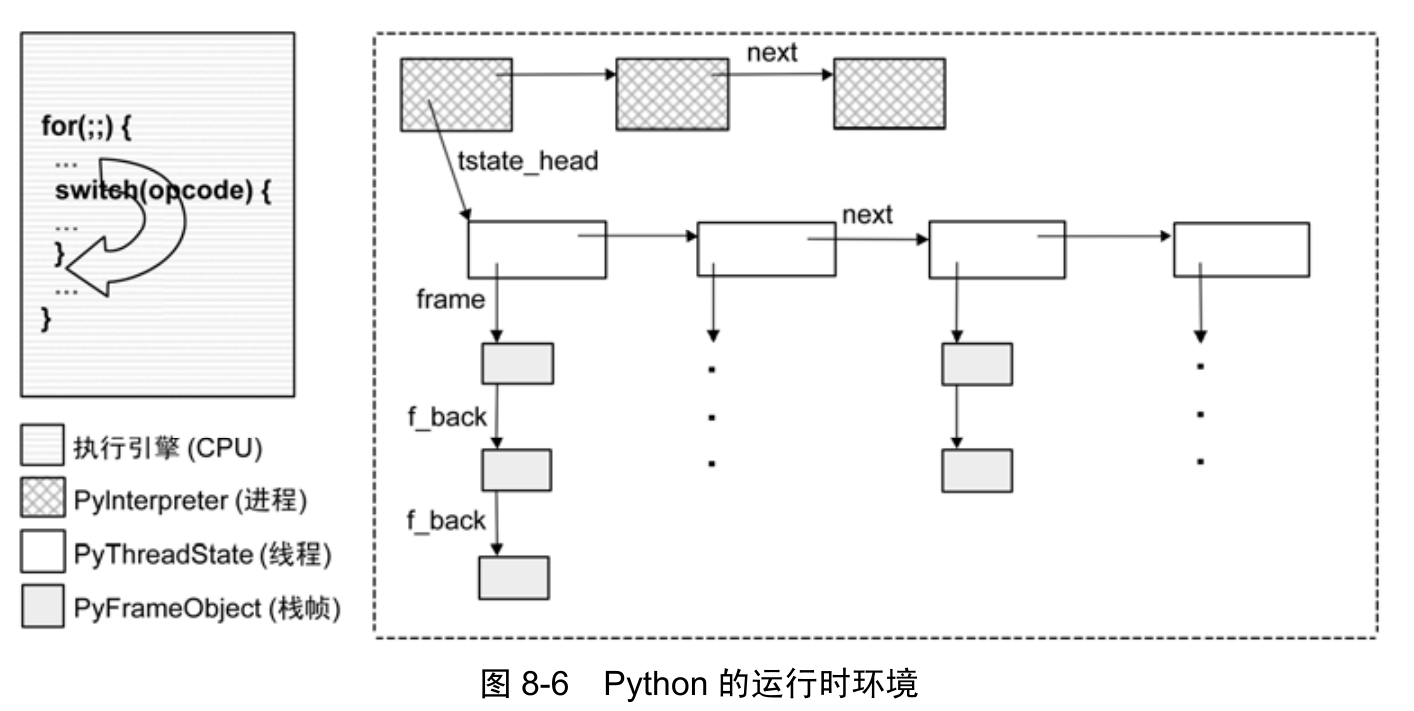
具体实现
所有的python代码都会被编译成类似汇编代码的字节码,然后虚拟机就使用C语言来执行这些指令,从而完成整个编译过程.
Python高级
Python多线程
为了支持多线程机制,一个基本的要求就是需要实现不同线程对共享资源访问的互斥,Python 也不例外,这正是引入 GIL 的根源所在。Python 中的 GIL 是一个非常霸道的互斥实现,正如它的名字所暗示的,GIL 是一个解释器(Interpreter)级的互斥机制,也就是说,在一个线程拥有了解释器的访问权之后,其他的所有线程都必须等待它释放解释器的访问权,即使这些线程的下一条指令并不会互相影响。初看上去,这样的保护机制粒度太大了,我们似乎只需要将可能被多个线程共享的资源保护起来即可,对于不会被多个线程共享的资源,完全可以不用保护。实际上,在 Python 的发展历史中,确实出现过这样的解决方案,但是令人惊奇的,这样的方案在单处理器上的多线程实现的效率上却没有 GIL 的方案好。所以现在 Python 中的多线程机制是在 GIL 的基础上实现的。
单处理器的本质是不可能并行的,但是对于多处理器,情形就完全不同了,同一时间,确实可以有多个线程独立运行,然而 Python 的 GIL 限制了这样的情形,使得多处理器最终退化为单处理器,性能大打折扣
与操作系统一样,Python虚拟机也需要进行多线程的调度,根据线程执行的指令数量和内置时钟来决定是否要切换线程,但对于切换后将解释器交给哪个进程,Python并没有插手,而是交给了操作系统的线程调度机制来解决.
总结
书读的越多,越能发现自己的无知,这本书对Python2.5源码的分析确实非常不错,或许有朝一日我能对现在的Python源码也做一点分析呢.
Python3网络爬虫开发实战
爬虫基础
讲的还不错,基本涉及了爬虫所需的所有知识,尤其是关于session,cookie的地方讲的很好,帮我扫清了一点疑惑
数据的存储
Elasticsearch
- 这部分的简短介绍比官网讲的好得多
Elasticsearch是使用Lucene作为底层引擎的开源搜索引擎.
- Es本质上是一个分布式数据库,每台服务器可以运行多个Es实例,一个实例被称为一个节点(Node),一组节点构成一个集群
- Es会索引所有的字段,根据索引来查找数据,所以Es管理的顶层单位就是索引,对应MySQL中数据库的概念,索引的名字必须小写
- 索引中的单条记录称为文档(document)
文档可以进行分组,这种分组被称为类型(type),用于过滤文档,,已在8.x版本后被废除- 每个文档都类似一个Json结构,与MongoDB中的结构非常相似.
这么来看,Es展现出来的确实就是一个数据库而已.
RabbitMQ
爬取数据时,我们需要用到一些进程间的通信机制,例如一个进程负责构造爬取请求,另一个负责执行爬取请求,或者一个进程爬取完毕后通知另一个进程来处理数据,尽管yield,async,await等关键字能够解决部分的问题,但用起来还是不太顺手
这就是我们要用到消息队列的地方了,RabbitMQ则是其中的代表框架.
异步爬虫
- 前面的概念辨析很有看头
总结
尽管确实很全面,奈何讲解都简单的过分了,不够深入,基本都是依靠框架来实现爬虫的.但还是为数不多的爬虫好书.
Python for Algorithmic Trading
- 出版于2020年,出版商:O’Reilly,作者:Yves Hilpisch。
前置知识
- Beta trading: 通过投资于例如复制标普500指数表现的交易所交易基金(ETFs)来赚取市场风险溢价
- Alpha generation: 以独立于市场的方式获取风险溢价,例如做空标普500指数成分股或标普500指数ETF即可实现。
- Static hedging: ,通过买入标准普尔500指数价外看跌期权来对冲市场风险
- Dynamic hedging: 通过对标普500指数期权产生影响的市场风险进行对冲,例如动态交易标普500指数期货以及相应的现金、货币市场或利率工具
本书聚焦于Alpha generation策略.
总结
基本是代码的罗列,原理讲的一点都不清晰,所以看的很迷糊
Python for DevOps by Chacko
- 出版于2025年,作者:Varghese Chacko。
与同名书的收获相同.
Python for DevOps by Noah Gift
- 出版于2019年,出版商:O’Reilly,作者:Noah Gift。
唯一的收获是告诉我第一章讲python语法的都不是好书.
React in Depth
- 出版于2024年,出版商:Manning,作者:Morten Barklund。
介绍
前端的技术栈比起后端要可怕的多,这也是为什么资深前端这么少的原因.
总结
不推荐,看来前端还是要以文档和实战为主,因为技术栈的变化太快了,几年前的经验到现在就根本不适用了.
Advanced component patterns
The Provider pattern
Redis in action
- 出版于2013年,出版商:Manning,作者:Josiah L. Carlson。
介绍
Redis有5种基础数据类型:
- string: 支持字符串,整数和浮点数
- list: 链表,每个节点包含一个元素,元素可重复
- set: 无序的字符串集合,元素不可重复
- hash: 哈希表,存储键值对
- zset: 有序字典,存储键值对
string类型支持get,set,del三种方法:
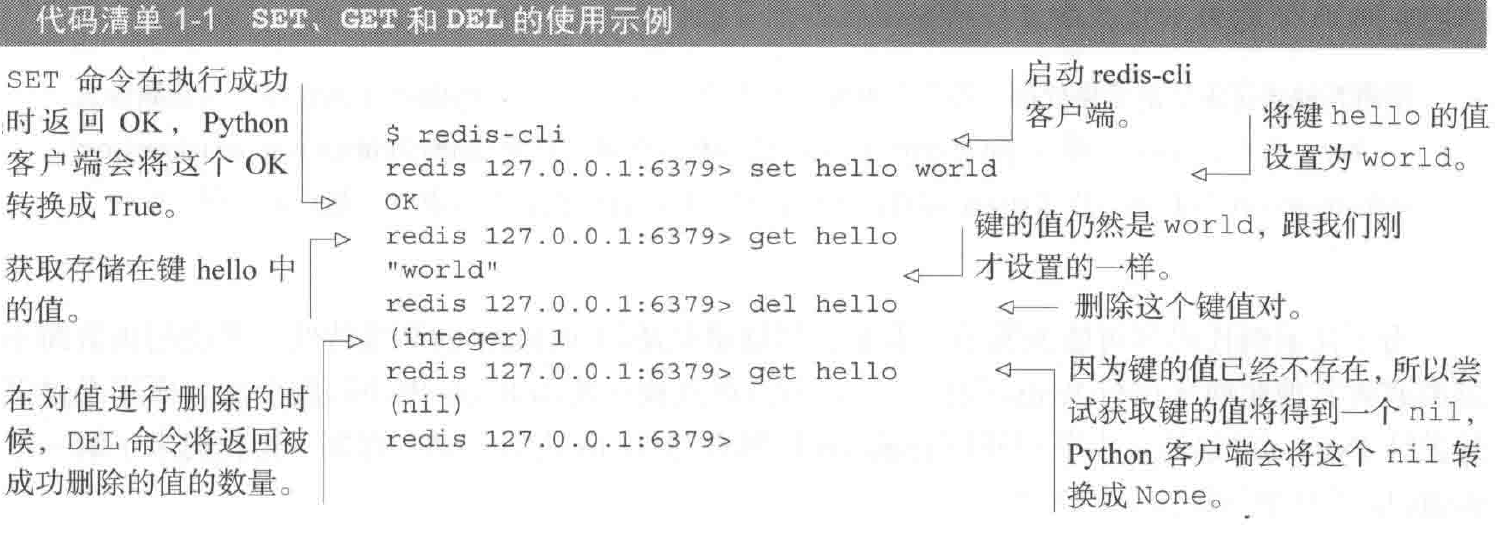
list类型支持以下命令:
| 命令 | 行为 |
|---|---|
RPUSH | 将给定值推入列表的右端 |
LRANGE | 获取列表在给定范围上的所有值 |
LINDEX | 获取列表在给定位置上的单个元素 |
LPOP | 从列表的左端弹出一个值,并返回被弹出的值 |
- 左右端都可以进行操作,前缀分别是
L,R.
set类型支持sadd,srem等命令
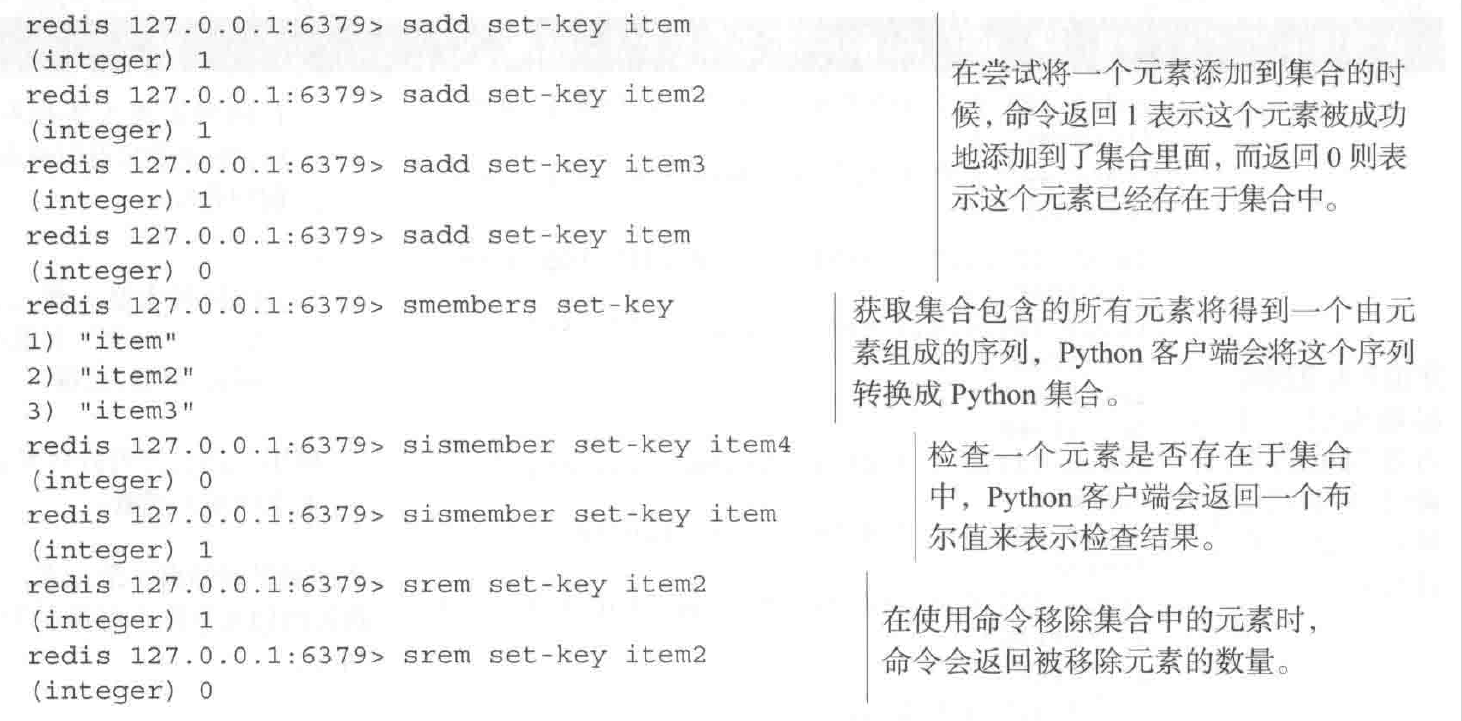
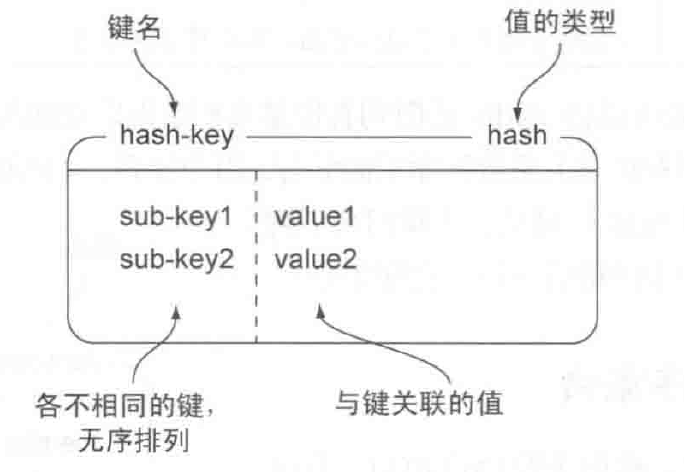
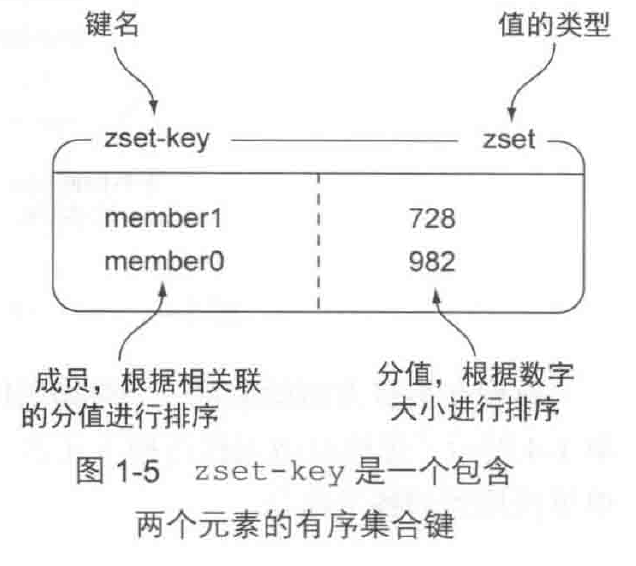
数据存储
Redis有两种数据存储方式:
- snapshot(快照): 将某一时刻内存中保存的所有数据写入硬盘
- append-only file(AOF): 执行某条写入命令时,将指令复制到硬盘里.
复制(replication)
单个Redis节点无法应对高并发,所以我们需要用到主从服务器的配置,从服务器在连接主服务器的时候会发生以下过程:
| 步骤 | 主服务器操作 | 从服务器操作 |
|---|---|---|
| 1 | (等待命令进入) | 连接(或者重连接)主服务器,发送 SYNC 命令 |
| 2 | 开始执行 BGSAVE,并使用缓冲区记录 BGSAVE 之后执行的所有写命令 | 根据配置选项来决定是继续使用现有的数据(如果有的话)来处理客户端的命令请求,还是向发送请求的客户端返回错误 |
| 3 | BGSAVE 执行完毕,向从服务器发送快照文件,并在发送期间继续使用缓冲区记录被执行的写命令 | 丢弃所有旧数据(如果有的话),开始载入主服务器发来的快照文件 |
| 4 | 快照文件发送完毕,开始向从服务器发送存储在缓冲区里面的写命令 | 完成对快照文件的解释操作,像往常一样开始接受命令请求 |
| 5 | 缓冲区存储的写命令发送完毕;从现在开始,每执行一个写命令,就向从服务器发送相同的写命令 | 执行主服务器发来的所有存储在缓冲区里面的写命令;并从现在开始,接收并执行主服务器传来的每个写命令 |
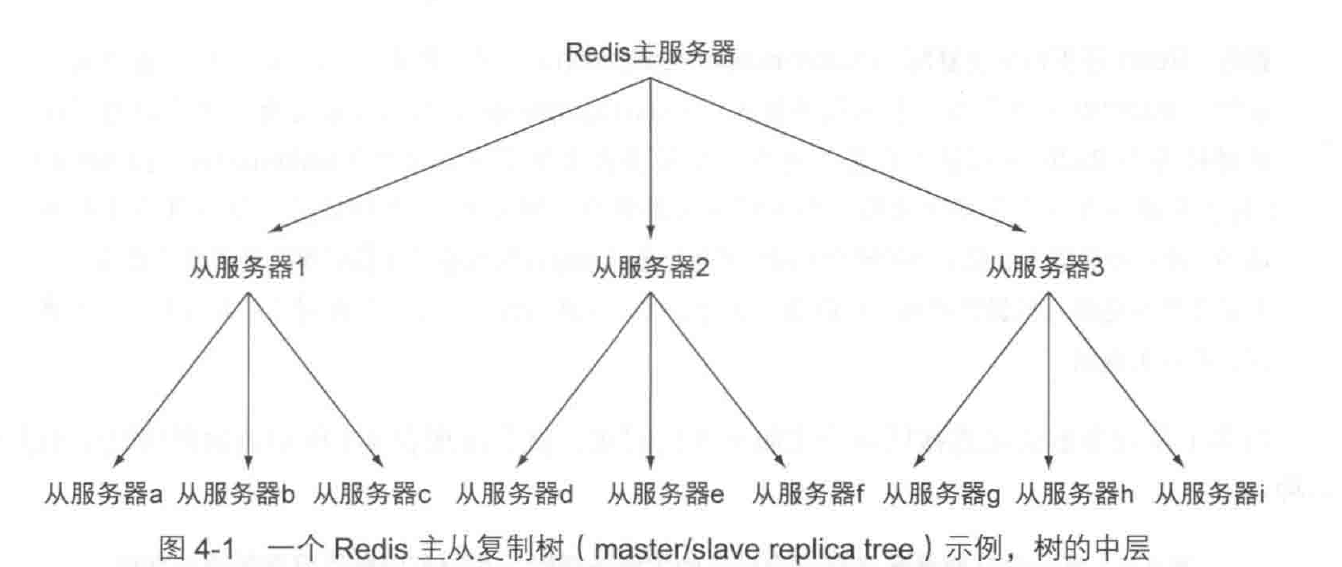
主从复制只有复制和冗余,并没有实现扩容,要想扩容就必须用到多个主服务器.
总结
剩下的内容就都是一些不太实用的扯淡了,可以直接跳过
RESTful Web APIs
- 出版于2013年,出版商:O’Reilly,作者:Leonard Richardson。
一本比较优秀的书,如果你不知道如何写API请求,不知道前后端如何通信,不知道如何规范API格式,就可以来看这本书.
- 这本书的作者之一就是著名爬虫库bs4的开创者,还是有一定分量的
- zlib中文版链接,可惜没有书签
补充: 什么是RESTful Web API
非常令人震惊的是,这本书并没有详细谈这一名词的具体概念和历史背景…因此需要在这里做一点补充
只看上面的文章就够了,我再加上一点历史背景解析
历史背景
- 根据« RESTful Web APIs Patterns and Practices Cookbook »总结
在www(万维网)的概念于1993年左右开始盛行时,并没有一个合适的规范来约束用户端和服务器之间的通信.
于是,web技术大牛Roy T. Fielding在1998年的微软演讲提出了Representational State Transfer(REST)的初步构想,并在两年后的论文(“Architectural Styles and the Design of Network-based Software Architectures”)中完整的介绍了REST,总结一下大致意思就是:
REST provides a set of architectural constraints that, when applied as a whole, emphasizes scalability of component interactions, generality of interfaces, independent deployment of components, and intermediary components to reduce interaction latency, enforce security, and encapsulate legacy systems.
看不懂没关系,我们只需要知道Rest的主要准则如下:
| 约束名称 | 核心要求 | 违背后的后果 |
|---|---|---|
| 客户机-服务器 (Client-Server) | 前后端分离,职责解耦。 | 无法独立演进,扩展性受阻。 |
| 无状态 (Stateless) | 每个请求必须包含处理所需的全部信息,服务器不保存会话上下文。 | 导致服务器无法水平扩展,容错性降低。 |
| 可缓存 (Cacheable) | 响应必须定义自身是否可缓存。 | 增加网络延迟,浪费带宽和服务器资源。 |
| 统一接口 (Uniform Interface) | 包含资源标识、通过表述操纵资源、自描述消息、HATEOAS。 | 最常被忽视的一项。不满足此项的通常只是“带 HTTP 的 RPC”。 |
| 分层系统 (Layered System) | 客户端无法感知直接连接的是服务器还是中间件(代理、缓存)。 | 破坏安全性与负载均衡的透明度。 |
| 按需代码 (Code on Demand) | (可选) 允许服务器向客户端发送可执行代码(如 JS)。 | 增加客户端复杂度和安全风险。 |
如果你的Web架构设计和API请求符合这些原则,则可以被称为Restful Web和Restful Web API.(rest-ful,意思大致为rest风格)
ch1: Surfing the Web
- 非常详尽的介绍了点击URL过程中客户端与服务器之间的交互
在REST中我们将你所停留的页面等窗口信息称为应用状态(application state),当你上网的时候,客户端从一个应用状态切换到另一个应用状态.
同样,服务器端根据客户端的状态转换(发送GET/POST等HTTP请求)来响应对应的表述(representation),并将改变的信息保存在服务器端.
为什么要在你可以搭建一个每个人都可以使用的网站的时候,开发一种只有计算机专业人员才能理解的工具呢?所有成功的后 Web 协议(post-Web protocols)都是在做一些 Web 做不了的事情:P2P 协议比如 BitTorrent,实时协议比如 SSH。对于大部分的目的,HTTP 已经足够使用了。
ch2: 一个简单的API
HTTP响应
每个由服务器发出的HTTP响应可分成三个部分:
- 状态码(status code): 简要说明了请求目前的进展
- 消息体(entity body): 采用某种数据格式写成的文档,可以被客户端理解和提取
- 响应头(response head): 夹在状态码和消息体之间,描述消息体性质和服务器状态
Content-Type: 最重要的报头,告诉HTTP客户端如何理解消息体,最常见的内容类型有text/html和image/webp等
令人头疼的API
遗憾的是,大多数企业或者网站都使用的是自定义的json格式,导致不同网站之间的api完全不能兼容,至今为止,api格式仍然没有一个统一的标准,但JSON:API 有可能成为一个实际标准来挽回这个糟糕的局面.
ch3: Resources and Representations
前置概念
- resource(资源): 一个URL链接对应的事物
- representation(表述): 包含资源(resource)相关信息的文档
那么HTTP的常用方法可以这样定义:
- GET: 获取资源的某个表述
- DELETE: 销毁一个资源
- POST: 基于给定的表述,在当前资源的下一级创建新的资源
- PUT: 用给定的表述替换资源的当前状态
- HEAD: 获取服务器发送过来的报头信息
- OPTIONS: 获取该URL所能响应的HTTP方法列表
- PATCH: 根据提供的表述修改资源的部分状态,但若有些资源未在表述中提及,则保持不变.
- 相当于一个强化版的PUT
HTTP请求概览
| |
这是使用了HTTP POST方法的请求,尽管看上去很复杂,但不同的请求方法对应的请求格式也不一样,比如GET请求就可以没有任何HTTP报头和请求体.
HTTP GET
HTTP规范中表示: GET请求是为了获取网页内容而作的请求,主观上没有改变服务器资源状态的意图.也就是说,当我们得到了一个URL但没有更多信息可供参考时,我们一般都会发送GET请求,而不会产生任何负面作用.
- 所以GET请求是幂等的,即多次请求和一次请求返回的结果相同
HTTP DELETE
当客户端想要一个资源消失的时候,它可以发送一个DELETE请求,可能会收到以下状态码:
- 204:
No Content,删除成功,我没有其他关于这个资源的表述了 - 200:
OK,删除成功,这里是关于它的一条消息 - 202:
Accepted,我等下就删除它
- 同样,DELETE请求是幂等的,因为你不可能反复删除同一个资源
HTTP POST
HTTP规范中对POST的功能定义如下:
- 对现有资源的注解
- 发布新消息
- 提交表单等用户输入
- 向数据库追加数据
POST方法既不安全也不幂等,因为它没有指定要生成的资源对应的URL,服务器就只能创建一个新的URL来存放新的数据,如果发送了多个POST请求,服务器也会生成多个新的URL.
| |
HTTP PUT
由于PUT指定了唯一的用于替换的表述信息和对应的URL,因此发送多次PUT请求的结果和发送一次的结果相同,也就是说PUT是幂等的.
| |
HTTP PATCH
PATCH与POST一样是非幂等的,因为它同样不会指定存放资源的URL路径,而是直接发送一个只有部分信息被修改的表述(representation),并让服务器根据这个表述来做出对应的更改,它可能会产生新的数据.
HTTP HEAD
对HEAD最好的理解就是轻量级版本的GET,服务器应该和处理GET方法一样处理HEAD方法,但只需要发送状态码和报头,不需要发送消息体.
- 由于服务器发送该消息还是要经历一个完整的RTT(往返时间),只是不用发送报文而已,所以用处不是很大
HTTP OPTIONS
获取该URL支持的所有请求方法,很少会被用到.
| |
ch4: Hypermedia(超媒体)
- hypermedia(超媒体): 超文本(hypertext)的对应概念,是对HTML链接,表单,图像等事物的通称,可以实现用户交互
超媒体有以下作用:
- 引导请求,引导用户点击链接跳转到其他URL
- 对响应做出承诺,比如在html中展示外部图像
ch11: HTTP for APIs
- 第五章到第十章的内容都过于古老陈旧了,故直接跳过
我们可以将www(万维网)分成三层技术栈,自上而下分别是:
- Hypermedia: 下一步要做什么
- HTTP: 如何与这些资源通信
- URL: 资源在哪里
这一章主要围绕HTTP协议展开
HTTP/1.1(RFC 2616)
响应码
HTTP1.1定义了41个响应码,按照百位数字可以进行分类:
- 1xx: Informational
- 仅在HTTP客户端与服务器之间进行协商时使用
- 2xx: Successful
- 客户端要求的状态转换已经发生
- 3xx: Redirection
- 客户端要求的状态转换没有发生,但如果客户端愿意发起一个稍有不同的HTTP请求,服务器就会完成对应的行为
- 4xx: Client Error
- 由于HTTP请求的问题,客户端要求的状态转换没有发生,该请求可能有缺陷,不和逻辑或者无法被服务器接收
- 5xx: Server Error
- 由于服务器的问题,客户端要求的状态转换没有发生.
报头
HTTP1.1定义了47种HTTP请求和响应报头
表述(representation)选择
当服务器为一个资源提供了多种可用的表述时,客户端想要获取特定的表述时(如选择中文版本,选择XML文本,选择详细版本),可以通过内容协商来实现
内容协商
- 内容协商(content negotiation): 客户端使用特定的HTTP请求报头来告诉服务器它想要哪些表述.
HTTP1.1定义了5个与之相关的请求报头,统称为*Accept-报头.最重要的两个报头是Accept和Accept_Language.
如果服务器因为某个Accept限制而不能处理某个请求,它可以发送响应码406(Not Acceptable)
HTTP优化
HTTP1.1定义了一些优化方案用于帮助服务器拦截一些可能没有意义的请求,降低一般请求的开销.
- 缓存(Caching): 服务器通过Cache-Control报头让客户端调整缓存
- 条件GET(Conditional GET):
- Last-Modified报头告诉客户端该资源状态上次改变的时间,若该资源状态没有变化,服务器会在客户端再次访问时发送状态码304(Not Modified),并且不再附带实体消息体
- ETag报头包含一些随机字符串,只要对应的表述发生了变化,该字符串就会改变,与Last-Modified的作用基本相同,但不需要关注具体的更改日期,可以节省带宽,更为可靠
- 压缩,通过Accept-Encoding和Content-Encoding来设置服务器和客户端能够接受和发送的文档压缩格式,可以大量节省带宽
API认证
API认证有两个步骤:
- 用户设置自己的证书(如创建网站的账号或者将现有的账号绑定到此次会话中)
- 用户每次发送API请求时自动提交用户证书
之所以每次请求都要提交证书,是因为HTTP的无状态约束要求服务器不保留客户端的任何信息.
接下来会介绍3种常见的认证技术:
- Basic认证
- OAuth1.0
- OAuth2.0
这三种技术都通过WWW-Authenticate和Authorization报头来进行证书确认,一个完整的流程如下:
| |
Basic认证
Basic认证是一种简单的用户名/密码方法.用户通过附属网站或者电子邮件注册一个账户,获得自己的用户名和密码,并加入Authorization请求报头来申请访问服务器,服务器则会正常返回信息:
| |
这种方法确实很简单,但不够安全可靠
OAuth 1.0
OAuth(short for open authorization)中,用户针对每个客户端都单独提供一套独特的证书,如果它决定不再使用某个客户端,则会撤销该客户端的证书,而其他客户端不受任何影响.
例如,当用户未被授权时,服务器会返回以下响应:
| |
很多时候我们都是通过OAuth进行第三方授权的(如Google登录,QQ登录,微信登录),这类请求的本质如下:
- 用户点击当前网页
www.fun.cn里面的第三方注册/登录按钮 - 客户端发送该请求到该网页所在服务器,服务器向用户的浏览器发送了一个HTTP重定向响应,让用户前往第三方网站(如Google弹窗).
- 用户同意是否使用第三方网站的令牌证书来授权当前网站.
- 用户做出决定后,浏览器重定向回网站
www.fun.cn - 如果用户选择不同意,则网站不会得到任何信息,若选择同意,则该网站被允许通过第三方网站的api获得第三方网站的用户证书,样式如下:
| |
缺点
当用户的所有活动都发生在浏览器中的时候,Oauth1.0就足够了.但当用户使用的是桌面或者手机应用时,就需要弹出一个浏览器窗口来进行认证,这显然有点突兀了(尽管很多APP/桌面端使用这一方式来进行认证).
补充: OAuth 2.0
- 阮一峰教程
- OAuth2.0是为了解决1.0版本的缺陷而推出的,但这本书并没有深入谈及它的原理和应用
简单说,OAuth 就是一种授权机制。数据的所有者告诉系统,同意授权第三方应用进入系统,获取这些数据。系统从而产生一个短期的进入令牌(token),用来代替密码,供第三方应用使用。
令牌(token)与密码(password)的作用是一样的,都可以进入系统,但是有三点差异。
(1)令牌是短期的,到期会自动失效,用户自己无法修改。密码一般长期有效,用户不修改,就不会发生变化。
(2)令牌可以被数据所有者撤销,会立即失效。以上例而言,屋主可以随时取消快递员的令牌。密码一般不允许被他人撤销。
(3)令牌有权限范围(scope),比如只能进小区的二号门。对于网络服务来说,只读令牌就比读写令牌更安全。密码一般是完整权限。
总结
本书涉及了很多种古老或者新颖(本书出版于2013年,HTTP2.0都尚未制定完成)的通信文本框架,从一个比较高的维度讲述了一个符合Rest规范的通信框架应该是怎么样的.实战代码相对较少,理念比较多,但读完还算有一点收获,对于前后端的通信规范理解的更深入了.
- 对于有一定基础的人来说,最有价值的也许是附录A和附录B.
Rust程序设计语言
基础
补充: 前瞻体验
不得不承认,rust的代码非常丑陋,导致开发效率很低下:
| |
变量与常量
- rust中变量用
let声明,可以隐式推导类型,但默认为不可变的,即初始化后就不可改变,如果想要让它可变,则要加上mut修饰符,如:
| |
Rust 编译器保证,如果声明一个值不会变,它就真的不会变,所以你不必自己跟踪它。这意味着你的代码更易于推导。
rust中有一个神奇的语法叫做遮蔽(shadowing),当你第二次用let声明同一个变量时,就可以覆盖该变量,这可以在同一个作用域中进行,因此与cpp的规则不太一样.
- 常量用
const声明,不可加上mut修饰,永远不可变,声明时必须要有类型注释(这比隐式推导的Go要好上不少).
| |
复合类型
- 元组(tuple): 大致与python中tuple没有什么区别,一旦声明,它的大小就不能增长或缩小:
| |
- 数组(array): rust的数组长度是固定的,每个元素必须有相同类型.另一个支持的数组类型则是vector,可变长度,与cpp的vector相似.
| |
函数
Rust 代码中的函数名和变量名通常使用 snake case 风格。在 snake case 中,所有字母都使用小写,并用下划线分隔单词
rust中语句是一类没有分号的表达式.
函数可以把值返回给调用它的代码。我们不会给返回值命名,但必须在箭头(->)后面声明它的类型。在 Rust 中,函数的返回值等同于函数体中最后一个表达式的值。你也可以使用 return 关键字并指定一个值,从函数中提前返回;不过大多数函数都会隐式返回最后一个表达式的值。下面是一个带有返回值的函数示例:
| |
控制流
与Go一样,rust中的if表达式中的条件必须是bool值,不允许隐式的类型转换,否则会报错,使用的仍然是C系的
else if写法.
Rust 有三种循环:loop、while 和 for:
- loop 关键字告诉 Rust 反复执行一段代码,要么永远执行下去,要么直到你明确要求它停止。
rust一个比较神奇的地方是可以把控制流赋值给变量:
| |
loop还可以带有标签,这类似于c中的label关键字:
| |
- 与label的待遇一样,正常的代码里是不应该有loop出现的
- while关键字则为正常的写法:
| |
- for用于遍历容器:
| |
所有权(ownership)
所有程序都必须管理其运行时使用计算机内存的方式。一些语言中具有垃圾回收机制,在程序运行时有规律地寻找不再使用的内存;在另一些语言中,程序员必须亲自分配和释放内存。Rust 则选择了第三种方式:通过所有权系统管理内存,编译器在编译时会根据一系列的规则进行检查。
首先,让我们看一下所有权的规则:
- Rust 中的每一个值都有一个 所有者(owner)。
- 值在任一时刻有且只有一个所有者。
- 当所有者离开作用域,这个值将被丢弃。
| |
当 s 离开作用域的时候。当变量离开作用域,Rust 为我们调用一个特殊的函数。这个函数叫做 drop,在这里 String 的作者可以放置释放内存的代码。Rust 在结尾的 } 处自动调用 drop。
当你给一个已有的变量赋一个全新的值时,Rust 将会立即调用 drop 并释放原始值的内存
| |
当 s2 和 s1 离开作用域,它们都会尝试释放相同的内存。这是一个叫做 二次释放(double free)的错误,也是之前提到过的内存安全性 bug 之一。两次释放(相同)内存会导致内存污染,它可能会导致潜在的安全漏洞。
为了确保内存安全,在 let s2 = s1; 之后,Rust 认为 s1 不再有效,因此 Rust 不需要在 s1 离开作用域后清理任何东西
- 这种语法相当独特,不过确实很合理,正常情况下不应该在同一个作用域中出现两个相同的指针变量.
| |
调用一次无返回值的函数takes_ownership后,s就被置为无效了,这确实是我闻所未闻的语法,不过另一方面,这确实很合理,正常编写代码的时候不会这样写的.
| |
如果不显式返回所有权,那么就说明这个变量不再有用,那么直接收回确实很合理.
s
reference and borrow
| |
& 符号表示 引用;它们让你引用某个值而不取得它的所有权,我们将创建一个引用的行为称为 借用(borrowing)。正如现实生活中,如果一个人拥有某样东西,你可以从他那里借来。当你使用完后,必须还回去。因为我们并不拥有它的所有权。
既然是借用,那么我们自然不能损坏它,所以引用变量均无法修改:
| |
如果要想修改借用的值,就要加上mut关键字,这被称为可变引用:
| |
可变引用有一个很大的限制:在同一个作用域内,如果你有一个对该变量的可变引用,你就不能再创建对该变量的引用。这些尝试创建两个 s 的可变引用的代码会失败:
| |
我们也不能在拥有不可变引用的同时拥有可变引用,因为不可变引用的借用者可不希望在借用时值会突然发生改变!
| |
在带有指针的语言中,如果释放了一块内存,却保留了指向它的指针,就很容易错误地制造出一个悬垂指针(dangling pointer):这个指针指向的内存位置可能已经被分配作其他用途。相比之下,在 Rust 中,编译器保证引用永远不会变成悬垂引用:如果你持有某些数据的引用,编译器会确保这些数据不会在它们的引用之前离开作用域。
Slice
| |
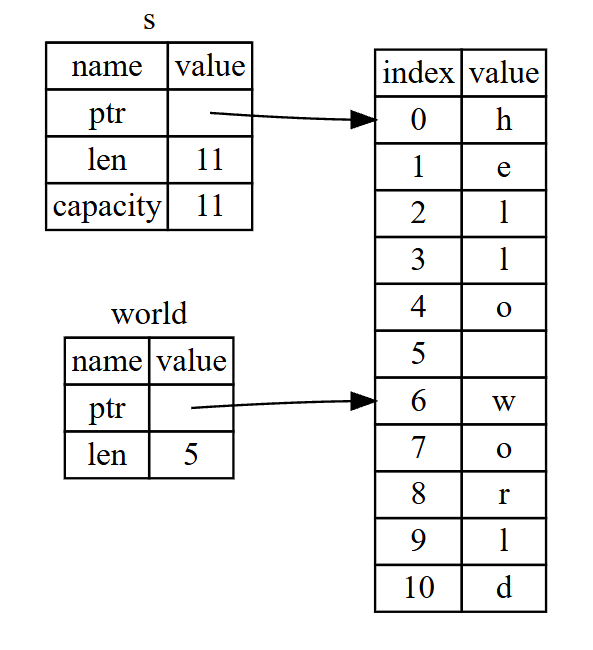
下面这段函数会编译错误,因为 clear 需要清空 String,它尝试获取一个可变引用,但在调用 clear 之后的 println! 使用了 word 中的引用,所以这个不可变的引用在此时必须仍然有效:
| |
| |
结构体
| |
不得不说,这种结构体的写法真的是赏心悦目,非常适合我这种对Ts和Python都比较熟悉的人.
实例化的写法不太正常:
| |
照理说这里弄成等号显然更为合理一点,弄成:就不知所云了.
简写构造函数:
| |
这一语法糖与CS中的比较相似.
| |
这与js中的解包语法和pydantic中的解包极其相似,也确实很方便.
你也可以定义没有任何字段的结构体!它们被称为 类单元结构体(unit-like structs),因为它们的行为类似于 (),也就是我们在“元组类型”一节中提到的 unit 类型
| |
方法
| |
&self 实际上是 self: &Self 的缩写。在一个 impl 块中,Self 类型是 impl 块的类型的别名。方法的第一个参数必须有一个名为 self 的Self 类型的参数,所以 Rust 让你在第一个参数位置上只用 self 这个名字来简化
这与python的语法高度相似呢.
Enum
| |
任何类型都可以放入enum中,例如元组,结构体,甚至是另一个枚举.
| |
结构体和枚举还有另一个相似点:就像可以使用 impl 来为结构体定义方法那样,也可以在枚举上定义方法
| |
我称之为我十亿美元的错误。当时,我在为一个面向对象语言设计第一个综合性的面向引用的类型系统。我的目标是通过编译器的自动检查来保证所有引用的使用都应该是绝对安全的。不过我未能抵抗住引入一个空引用的诱惑,仅仅是因为它是这么的容易实现。这引发了无数错误、漏洞和系统崩溃,在过去四十年里可能造成了价值十亿美元的痛苦和损失。
问题不在于概念而在于具体的实现。为此,Rust 并没有空值,不过它确实拥有一个可以编码存在或不存在概念的枚举。这个枚举是 Option
| |
实际应用:
| |
简而言之,因为 Option
| |
除了错误地假设一个非空值的风险,会让你对代码更加有信心。为了拥有一个可能为空的值,你必须要显式的将其放入对应类型的 Option
中。接着,当使用这个值时,必须明确的处理值为空的情况。只要一个值不是 Option 类型,你就可以安全的认定它的值不为空。这是 Rust 的一个经过深思熟虑的设计决策,来限制空值的泛滥以增加 Rust 代码的安全性。
这一考量确实很不错.
模式匹配: match
| |
当 match 表达式执行时,它将结果值按顺序与每一个分支的模式相比较。如果模式匹配了这个值,这个模式相关联的代码将被执行。如果模式并不匹配这个值,将继续执行下一个分支,非常类似一个硬币分类器
match 还有另一方面需要讨论:这些分支必须覆盖了所有的可能性。考虑一下 plus_one 函数的这个版本,它有一个 bug 并不能编译:
| |
rust还支持通过变量来实现通配:
| |
如果我们不想使用通配变量来处理所有的边缘情况,而是打算直接忽略它或者做其他处理,就可以用到_这一特殊模式:
| |
简洁控制流
| |
可以认为 if let 是 match 的一个语法糖,它当值匹配某一模式时执行代码而忽略所有其他值。
不过这个语法糖确实很抽象,让人看的很迷糊:
| |
包、Crates 与模块
- 包(Packages):Cargo 的一个功能,它允许你构建、测试和分享 crate。
- Crates:一个模块树,可以产生一个库或可执行文件。
- 模块(Modules)和 use:允许你控制作用域和路径的私有性。
- 路径(path):一个为例如结构体、函数或模块等项命名的方式。
crate 是 Rust 编译器每次处理的最小代码单位。即使你用 rustc 而不是 cargo 来编译单个源代码文件,编译器也会把那个文件视为一个 crate.
crate 有两种形式:二进制 crate 和库 crate。二进制 crate(Binary crates)可以被编译为可执行程序,比如命令行程序或者服务端。它们必须有一个名为 main 函数来定义当程序被执行的时候所需要做的事情。目前我们所创建的 crate 都是二进制 crate。
库 crate(Library crates)并没有 main 函数,它们也不会编译为可执行程序。相反它们定义了可供多个项目复用的功能模块
块让我们可以将一个 crate 中的代码进行分组,以提高可读性与重用性。因为一个模块中的代码默认是私有的,所以还可以利用模块控制项的私有性(privacy)。
总结
暂时弃坑,写的不如我想象中的好.
Rust 中文学习教程
由于另一本书太难啃了,所以换这本书来试试咸淡.
- 即便这个文档已经相当有耐心了,但看着依然很累,由此可见Rust是真的很难
基础
语句
| |
语句会执行一些操作但是不会返回一个值,而表达式会在求值后返回一个值,因此在上述函数体的三行代码中,前两行是语句,最后一行是表达式。
函数
单元类型 (),是一个零长度的元组。它没啥作用,但是可以用来表达一个函数没有返回值:
| |
所有权和引用
Rust引入了所有权之后,我们写函数时就要尽量地通过引用来处理数据,不然一不小心就会发生所有权转移问题.
- 正如变量默认不可变一样,引用指向的值默认也是不可变的,如果变量没写mut,自然无法修改引用的值,如果引用没写mut,也无法修改引用的值.
复合类型
字符串
Rust 在语言级别,只有一种字符串类型: str,它通常是以引用类型出现 &str,也就是上文提到的字符串切片。虽然语言级别只有上述的 str 类型,但是在标准库里,还有多种不同用途的字符串类型,其中使用最广的即是 String 类型。
str 类型是硬编码进可执行文件,也无法被修改,但是 String 则是一个可增长、可改变且具有所有权的 UTF-8 编码字符串
- 这一段话太关键了,之前那本rust书都没有清楚的指出这一点,导致我之前都懵懵懂懂的
简单来说,String可以自动被编译器转换成&str:
| |
而&str想要转换成&String,则需要用到转换函数,并发生新的内存分配:
| |
切片
切片的写法如下:
| |
由于切片是引用,所以必须通过&来标明借用
索引
Rust不允许字符串索引,因为要避免其他语言中常见的UTF-8字符报错(中文常常要占用3个或者4个字节),所以我们只能用切片来分割字符串,但如果分割不当,rust也会报错:
| |
- 这管的也太宽了…
元组
| |
结构体
| |
如果要修改结构体,就必须将结构体实例声明为可变的:
| |
| |
如上所示,当函数参数和结构体字段同名时,可以直接使用缩略的方式进行初始化,跟 TypeScript 中一模一样。
| |
可能是为了表示这并非对象展开,而是原样继承,才用的两个点吧.
把结构体中具有所有权的字段转移出去后,将无法再访问该字段,但是可以正常访问其它的字段。
| |
Enum
| |
可以看到rust使用::来访问枚举成员,这一点是继承了Cpp的写法的.
枚举自然可以赋值:
| |
数组
在 Rust 中,最常用的数组有两种,第一种是速度很快但是长度固定的 array,第二种是可动态增长的但是有性能损耗的 Vector,在本书中,我们称 array 为数组,Vector 为动态数组。
| |
与Go一样,[u8; 3]和[u8; 4]是不同的类型,数组的长度也是类型的一部分.
流程控制
| |
Rust中的流程控制可以返回语句,但也可以普通的执行:
| |
for-in循环:
| |
普通循环while:
| |
无条件循环loop:
| |
模式匹配
match
| |
- match 的匹配必须要穷举出所有可能,因此这里用 _ 来代表未列出的所有可能性
- match 的每一个分支都必须是一个表达式,且所有分支的表达式最终返回值的类型必须相同
- 这种简单的
=>标记过于粗暴了
复杂一些的模式匹配:
| |
if let
有时会遇到只有一个模式的值需要被处理,其它值直接忽略的场景,如果用 match 来处理就要写成下面这样:
| |
简单的写法如下:
| |
不管怎么看都很难看懂这个写法,不过这种情况使用if判断就足够了,不过可能之后有更高级的用法,所以就先放着.
Option
rust使用Option枚举来解决空指针问题
| |
匹配:
| |
方法
Rust 使用 impl 来定义方法,例如以下代码:
| |
因为是函数,所以不能用 . 的方式来调用,我们需要用 :: 来调用,例如 let sq = Rectangle::new(3, 3);。
Rust中的self是需要显式声明的,如果用不到self,就说明这个函数与该结构体的内部没有关系,而是与结构体的构造有关系,这被称为关联函数.
&self参数表示不获取所有权的指针,而self参数则会转移该结构体的所有权.所以一般都用&self的形式.
泛型Generics
| |
Rust中的泛型在很多情况下都要加上特征的限制才可以正常运行,因为Rust不主动猜测,只有你的泛型可以在所有约束下都成立时才能编译成功:
| |
特征Trait
如文中所说,Trait和其他语言中的Interface其实很相似,它定义了一组可以被共享的行为,只要实现了特征,你就能使用这组行为。
一个自定义特征Summary的实现方式如下:
| |
当然,我们可以直接给特征定义一个默认实现的方法,这样其他的类型只要象征性地实现一下就可以了:
| |
使用特征作为函数参数
| |
impl Summary表示实现了该特征的任何数据类型,然后就可以在函数中调用该特征的任何方法
上述写法只是语法糖,它的完整版本如下:
| |
形如 T: Summary 被称为特征约束。
当特征约束很多时,函数的签名就会非常复杂,这时候可以用where关键字来改进:
| |
派生特征
在本书中,形如 #[derive(Debug)] 的代码已经出现了很多次,这种是一种特征派生语法,被 derive 标记的对象会自动实现对应的默认特征代码,继承相应的功能。
特征对象
特征的进阶
动态数组Vector
Vector只支持存放相同类型的元素.
创建方法
- new方法创建:
| |
vec!宏创建,可以指定初始化值,如此就不用标注类型:
| |
更新
| |
访问Vector
| |
和其它语言一样,集合类型的索引下标都是从 0 开始,&v[2] 表示借用 v 中的第三个元素,最终会获得该元素的引用。而 v.get(2) 也是访问第三个元素,但是有所不同的是,它返回了 Option<&T>,因此还需要额外的 match 来匹配解构出具体的值。
| |
运行以上代码,&v[100] 的访问方式会导致程序无情报错退出,因为发生了数组越界访问。 但是 v.get 就不会,它在内部做了处理,有值的时候返回 Some(T),无值的时候返回 None,因此 v.get 的使用方式非常安全。
KV存储HashMap
- HashMap没有包含在Rust的Prelude中
创建方法
- new方法
| |
- Vector转换:
| |
获取元素
| |
查询到的是一个枚举类型,要想直接获得值,我们需要这么写:
| |
其中,copied函数把枚举中的&去掉,即&i32变成了i32,然后unwrap_or负责从枚举中获得值
如果想要简单的获取,只能通过遍历来处理:
| |
认识生命周期
| |
上述的'a和'b表示生命周期,即变量的存活时间.为了使得程序正常运行,生命周期更长的变量不能借用生命周期更短的变量,否则容易引发悬垂指针等问题.
| |
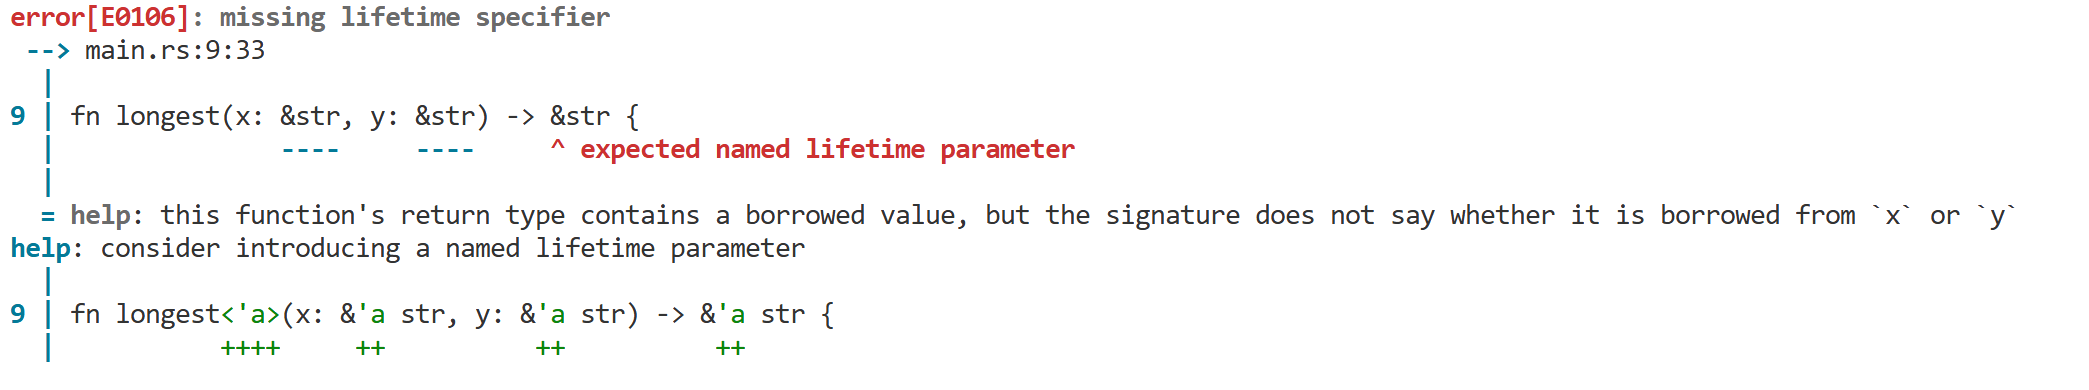
尽管确实无法提前得知这个返回值是引用的哪个变量,但直接报错也太过分了吧.
为了让编译器听话,我们需要加上生命周期的注释,跟Java中的注解作用类似,只不过我们的目的是为了不报错而已.
生命周期的语法也颇为与众不同,以 ’ 开头,名称往往是一个单独的小写字母,大多数人都用 ‘a 来作为生命周期的名称。 如果是引用类型的参数,那么生命周期会位于引用符号 & 之后,并用一个空格来将生命周期和引用参数分隔开:
| |
上述的代码我们可以这么改:
| |
此处生命周期标注仅仅说明,这两个参数至少活得和’a 一样久,至于到底活多久或者哪个活得更久,抱歉我们都无法得知.
实际上,在 Rust 1.0 版本之前, Rust 要求必须显式的为所有引用标注生命周期:
| |
在写了大量的类似代码后,Rust 社区抱怨声四起,包括开发者自己都忍不了了,最终揭锅而起,这才有了我们今日的幸福。
编译规则
编译器使用三条消除规则来确定哪些场景不需要显式地去标注生命周期。其中第一条规则应用在输入生命周期上,第二、三条应用在输出生命周期上。若编译器发现三条规则都不适用时,就会报错,提示你需要手动标注生命周期。
- 每一个引用参数都会获得独自的生命周期
例如一个引用参数的函数就有一个生命周期标注:
| |
两个引用参数的有两个生命周期标注:
| |
依此类推。
- 若只有一个输入生命周期(函数参数中只有一个引用类型),那么该生命周期会被赋给所有的输出生命周期
也就是所有返回值的生命周期都等于该输入生命周期。
例如函数:
| |
x 参数的生命周期会被自动赋给返回值 &i32,因此该函数等同于:
| |
- 若存在多个输入生命周期,且其中一个是
&self或&mut self,则&self的生命周期被赋给所有的输出生命周期
拥有 &self 形式的参数,说明该函数是一个方法,该规则让方法的使用便利度大幅提升。
方法中的生命周期
| |
生命周期的语法和泛型相同:
| |
- impl 中必须使用结构体的完整名称,包括 <‘a>,因为生命周期标注也是结构体类型的一部分!
- 方法签名中,往往不需要标注生命周期,得益于生命周期消除的第一和第三规则
静态生命周期
在 Rust 中有一个非常特殊的生命周期,那就是 ‘static,拥有该生命周期的引用可以和整个程序活得一样久。
这时候,有些聪明的小脑瓜就开始开动了:当生命周期不知道怎么标时,对类型施加一个静态生命周期的约束 T: ‘static 是不是很爽?这样我和编译器再也不用操心它到底活多久了。
返回值和错误处理
panic 深入剖析
在某些特殊场景中,开发者想要主动抛出一个异常,例如开头提到的在系统启动阶段读取文件失败。
对此,Rust 为我们提供了 panic! 宏,当调用执行该宏时,程序会打印出一个错误信息,展开报错点往前的函数调用堆栈,最后退出程序。
| |
长话短说,如果是 main 线程,则程序会终止,如果是其它子线程,该线程会终止,但是不会影响 main 线程。因此,尽量不要在 main 线程中做太多任务,将这些任务交由子线程去做,就算子线程 panic 也不会导致整个程序的结束。
显然,panic是一个大杀器,只适合于抛出那些一定有严重影响的异常,如果仅仅是用户的输入错误,那用普通的异常处理就够了.
异常枚举Result
Result的定义如下:
| |
用法如下:
| |
直接panic有点过了,还可以这样写:
| |
失败就 panic: unwrap 和 expect
expect 跟 unwrap 很像,也是遇到错误直接 panic, 但是会带上自定义的错误提示信息,相当于重载了错误打印的函数:
| |
大杀器?
| |
其实 ? 就是一个宏,它的作用跟 match 几乎一模一样:
| |
甚至还有调用链:
| |
看着很吓人,但联想一下Ts中的?.可选链,其实还是挺好看懂的.
包和模块
Package与Crate
Package可以视作一个完整的Rust项目,通过cargo.toml管理,分为可直接执行的二进制Package和只能作为第三方库被其他项目引用的库类型Package.
而Crate则被包含在Package之中,是一个编译单元,编译后会得到一个可执行文件或者一个库.
- 这种不清不白的边界迟早会改掉吧.
Module(待补充)
一个Crate对应一个或者多个Module,可以是由多个文件组成,也可以只有一个文件.
模块的声明方式如下:
| |
Rust 出于安全的考虑,默认情况下,所有的类型都是私有化的,包括函数、方法、结构体、枚举、常量,是的,就连模块本身也是私有化的
注释和文档
Rust的代码注释和Cpp完全相同,但它额外有一个文档注释的神奇功能
当查看一个 crates.io 上的包时,往往需要通过它提供的文档来浏览相关的功能特性、使用方式,这种文档就是通过文档注释实现的。
Rust 提供了 cargo doc 的命令,可以用于把这些文档注释转换成 HTML 网页文件,最终展示给用户浏览,这样用户就知道这个包是做什么的以及该如何使用。
格式如下:
| |
使用单行的///或者多行的/** ... */标明文档注释,并可以使用md语法
除了给函数加注释,还可以给包和模块加注释,包级别的注释也分为两种:行注释 //! 和块注释 /*! ... */。只要放在文件内部的最上方就可以:
| |
格式化输出
| |
rust别具一格的使用{}作为占位符,并通过"?这样的简洁语法实现不同的格式化输出.
高级
生命周期
看力竭了,速度跳过
函数式编程
闭包
闭包是一种匿名函数,它可以赋值给变量也可以作为参数传递给其它函数,不同于函数的是,它允许捕获调用者作用域中的值,例如:
| |
如果不用闭包,我们需要这么写代码:
| |
但如果用闭包,就可以省略掉参数的传递:
| |
闭包可以由编译器自己进行类型推导,但是必须在声明后使用,否则编译器是无从下手的.
| |
在rust中,即使是两个签名一摸一样的闭包的,它们的类型也是不同的:
| |
- 这太反直觉了
因此,要在结构体中声明闭包就必须要通过泛型来解决,并用特征来说明闭包:
| |
异步
| |
总结
弃坑了弃坑了,尽管看得出来教程已经很想教会我了,奈何Rust的特性实在太超出常规了.只好靠项目来一点点学Rust了
深度探索C++对象模型
- 出版于1996年(英文原版),作者:Stanley B. Lippman。
不推荐阅读,内容太老了,讲的也不清晰
深入理解计算机系统(第三版)
- 出版于2015年(英文第3版;中文版2016年),作者:Randal E. Bryant。
- 在读了各个层面的专业书籍后再回来看这本汇总书确实是一种享受,有一种把所有东西都串联起来的感觉.
概览
一场酣畅淋漓的概览,从处理器架构向上谈起,穿过操作系统,最终实现程序的I/O交互.
信息处理
我一直都很好奇各种入门书籍为何都如此看重诸如补码,反码,浮点数之类的知识,这本书也没能逃过这个俗套.
事实上来说,它们一点都不重要,在软件领域,我们根本没有机会用到这个知识,只要知道某个数据类型支持的最大范围和最大精度就可以了,即便是在相当冷门的硬件领域,只有在处理器和操作系统接口这一小小的范围内,你才需要考虑这些问题,然而这起码要在计算机领域钻研了好几年才有实力去接触,这不就是脱裤子放屁的事情吗.
大小端问题
不同处理器/操作系统中的有效字节顺序不同.最低有效字节在低地址的方式称为小端法(little endian),最高有效字节在低地址的方式称为大端法(big endian).
这两种字节顺序在如今看来并没有什么高下之分,但也正是因为没有高下之分,也就无法达成一致的共识.
程序的机器级表示
这部分讲的是x86架构下的C语言汇编代码,说实话,讲的比较一般,通篇都是汇编代码的分析,入门程序员我想需要翻来覆去看很多遍才能看明白.
处理器体系结构
- 前半部分可以去看The Elements of Computing Systems,讲的比这可清楚多了;后半部分可以看计算机组成与设计
优化程序性能&&存储器层次结构
- 这两个部分对应了计算机体系结构那本书
链接
- 这一章的缺点是压缩了重要的链接具体过程,而拓展了一些不是很有用的知识.
为了从目标文件中构造可执行文件,链接器需要完成两个任务:
- 符号解析: 将符号在各个文件中的引用与它在某个文件中的定义关联起来
- 重定位: 将每个符号定义与一个内存位置关联起来,修改对这个符号的所有引用,使它们都指向这个内存位置.
这本书把目标文件分成三种:
- 可重定位目标文件。包含二进制代码和数据,其形式可以在编译时与其他可重定位目标文件合并起来,创建一个可执行目标文件。
- 可执行目标文件。包含二进制代码和数据,其形式可以被直接复制到内存并执行。
- 共享目标文件。一种特殊类型的可重定位目标文件,可以在加载或者运行时被动态地加载进内存并链接。
ELF格式的可重定位目标文件格式如下:
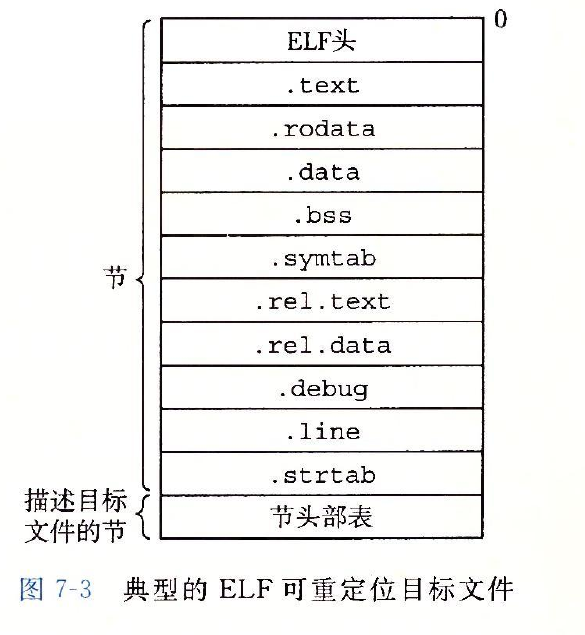
- ELF头记录了该文件的类型和节头部表的位置(偏移)
- 节头部表描述了不同节的位置和大小.
- text: 程序代码的机器语言表示
- rodata: 只读数据,比如printf语句中的格式串
- data: 已初始化的全局和静态C变量.至于局部C变量,它们只在运行时出现在栈中
- bss: 未初始化的全局和静态C变量,以及所有被初始化为0的全局或静态变量.这个段不占据实际的空间,仅仅是一个占位符,直到运行时才实际地分配这些变量的初始值为0.
- symtab: 符号表,存放在程序中定义和引用的函数和全局变量的信息,这是由汇编器构造的
- rel.text: 当链接器将该目标文件和其他文件组合时,需要修改这个段,用于重定位
- rel.data: 被模块引用或定义的所有全局变量的重定位信息
- debug: 用于调试的段,只有用-g选项调用gcc时才会生成
- line: 原始C源程序中的行号与.text中机器代码之间的映射,只有用-g选项调用gcc时才会生成
- strlab: 内容包括symtab和debug中的符号表
bss的全名为Block Storage Start,始于IBM 704的汇编语言,这确实不知所云,一个简单方法是记成Better Save Space.
符号解析
链接器的输入是一组可重定位目标模块。每个模块定义一组符号,有些是局部的(只对定义该符号的模块可见),有些是全局的(对其他模块可见)。如果多个模块定义同名的全局符号,会发生什么呢?下面是 Linux 编译系统采用的方法。
在编译时,编译器向汇编器输出每个全局符号,或者是强(strong)或者是弱(weak),而汇编器把这个信息隐含地编码在可重定位目标文件的符号表里。函数和已初始化的全局变量是强符号,未初始化的全局变量是弱符号。
根据强弱符号的定义,Linux 链接器使用下面的规则来处理多重定义的符号名:
- 规则 1:不允许有多个同名的强符号。
- 规则 2:如果有一个强符号和多个弱符号同名,那么选择强符号。
- 规则 3:如果有多个弱符号同名,那么从这些弱符号中任意选择一个。
重定位
重定位可以细分为两步:
- 重定位节和符号定义: 将相同类型的节合并成一个新的节,并将符号定义对应特定的内存地址
- 重定位符号引用: 修改代码节和数据节中的符号引用,指向第一步中的内存地址
异常控制&&虚拟内存
这两个部分完全就是操作系统导论的劣化版了.
程序部分
这一部分真想看的话可以翻一下Unix环境高级编程,不过想看的人一定很少吧.
总结
尽管写一本底层的汇总书并命名为"深入理解计算机系统"非常有魄力,但奈何这本书所说的深入都不是那么的深入,很多地方都拘泥于不太重要的层面.如果没有读过各个角度的专业书籍的话,是很容易被这本书迷惑的,从而花费大量时间去揣摩文中经过压缩和扭曲的知识点,这些时间完全可以用来去读专门的书籍,来获得更好一些的理解.
- 整体来说的话,只有链接一章值得一看,因为这方面的专业书籍实在太少了.
深入浅出密码学
- 出版于2010年(英文原版),作者:Christof Paar。
- (6/6): 强烈推荐,如果早点看到这本书就可以少走很多弯路了
概述
本书不会涉及令人害怕的数学公式。本书的目的是揭开密码学的 神秘面纱,介绍当今常用的密码学技术,并给出这些技术在我们身边 的应用案例。本书适合那些对密码学怀有好奇心的人、有强烈求知欲 的工程师、富有冒险精神的软件开发人员和兴趣广泛的研究人员。
哈希函数
哈希函数有以下特性:
- 任意长度的输入都会得到相同的输出长度
- 同一个输入可以得到相同的输出
- 实践中无法根据输出得到输入,这被称为Pre-image Resistance
- 根据一个输入无法找到另一个输入得到相同的输出,这被称为Second Pre-image Resistance
- 实践中无法找到两个不同的输入能够产生相同的输出,这被称为Collision Resistance
绝对安全的哈希函数: SHA系列
SHA-2算法族于2001年标准化,有4个子类,分别是SHA-224、SHA-256、SHA-384 和 SHA-512,它们分别产生 224、256、384 和 512 比特的输出.
SHA-3算法族于2015年标准化,同样有4个子类,分别是SHA-3-224、SHA-3-256、SHA-3-384 和 SHA-3-512.
消息认证码(Message Authentication Code,MAC)
- 讲的确实很好,无论有无这方面的基础都能大有收获,一本密码书竟然能够比专门讲网站设计的书还能谈的更深,不过大部分知识我都已经了解了,就不摘抄了.
- HMAC: 将密钥与SHA-2系列哈希函数结合使用,这是网站验证中最常用的加密方法
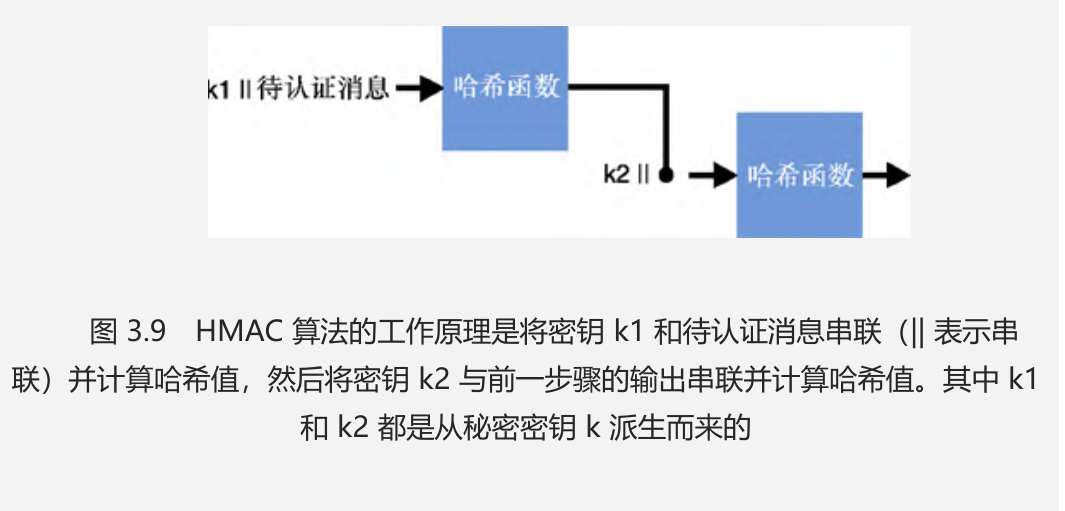
- KMAC: 单纯使用SHA-3系列哈希函数,而不依靠HMAC辅助:
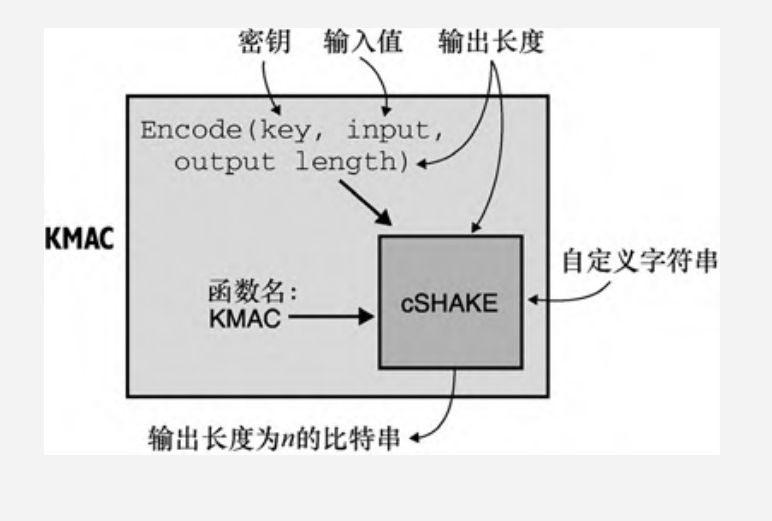
长度扩展攻击
之所以不能单纯使用SHA-2系列的哈希函数,就是因为这类哈希函数有可能遭受长度扩展攻击,不过书上这部分讲的不是很好,好在有Gemini帮助我:
| |
对称加密
前置概念
对称加密算法的输入为密钥(secret key)和明文(plaintext),输出为密文(Ciphertext).
解密算法的输入为密文和同一个密钥,输出为明文.
AES算法
AES是应用最为广泛的加密算法,因此主流处理器都内置了对AES的支持,能够以相当快的速度完成加密和解密.
AES算法加密的输入为一个变长密钥(由用户选择)和一个长度固定为128比特(16字节)的明文,输出一个128比特的密文,解密时输入同一个密钥和密文即可得到明文.
加密时,AES将明文转换成4x4的状态矩阵:
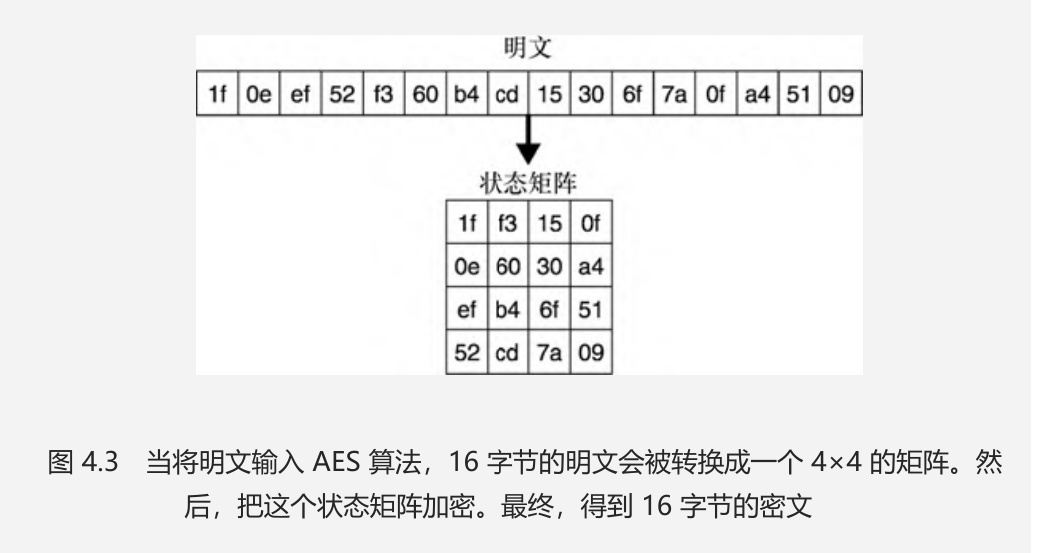
然后,对该矩阵进行多轮加密,每次加密使用的密钥都是由用户设定的密钥随机生成的.
如果要加密一个非常长(远超过超过128比特)的消息,一个简单的方法就是把消息分成多个16字节的块,如果最后一块小于16字节,则追加字节填充到16字节,然后再逐块加密,这被称为电码本(Electronic Codebook,ECB)模式.
很显然,如果明文中有多个相同的16字节块,会得到多个完全相同的密文,这有很大的安全隐患.因此,我们可以采用密码块链接(Cipher Block Chaining,CBC)模式,该模式会根据明文(或者随机指定)生成一个额外的初始向量IV,用于和明文进行迭代的异或操作,从而将明文随机化,相同的明文也会得到完全不同的密文:
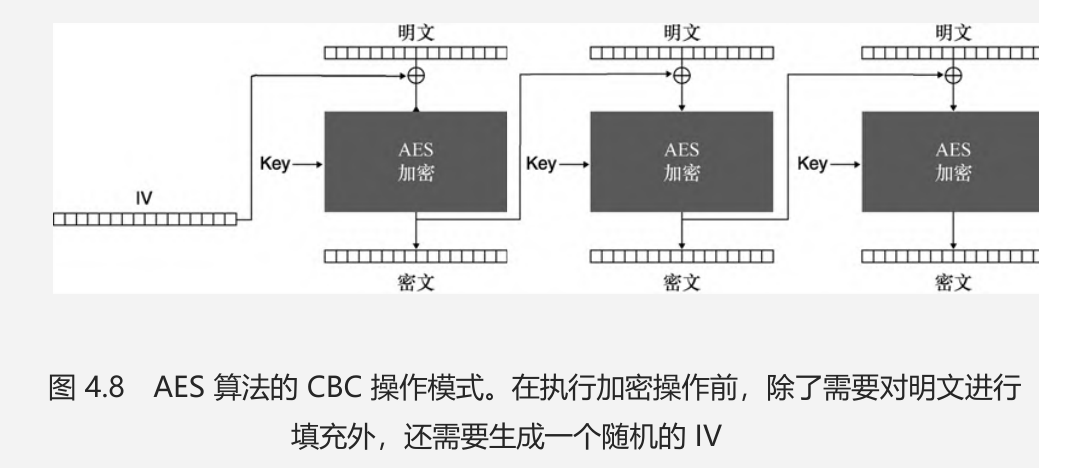
解密时,我们需要加密方以明文方式提供IV:
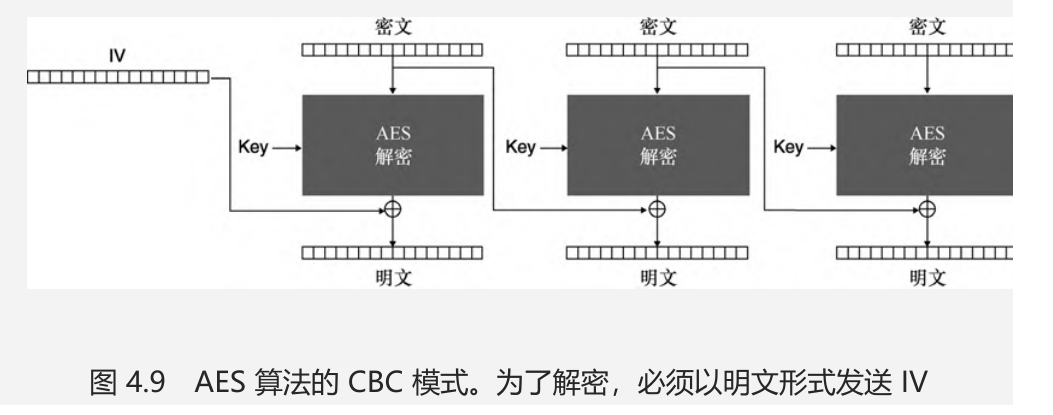 .
- 上述加密算法被称为AES-CBC
很显然,我们需要对密文和IV进行校验,防止被攻击者篡改,所以我们可以用HMAC算法来给它们加上一个认证标签,这就是AES-CBC-HMAC算法.
新型加密算法(过)
非对称加密
密钥交换
尽管对称加密可以说是万无一失的,但是它需要我们在一开始就告知对方自己的密钥,而这个密钥如果不经过加密传输的话,那么攻击者就极易窃取到这个密钥,从而让对称加密失效.
因此,密钥交换类算法诞生了,基本原理如下: 通信双方各自持有一对公钥和私钥,并使用对方的公钥来组合自己的私钥生成共享密钥,只要私钥得到了保护,那么攻击者就无法获知最终的密钥.
DH密钥交换
- 该算法由Whitfield Diffie 和 Martin E.Hellman 于1976年提出
- 所有参与者协商使用一个大素数p和一个生成元g作为公共参数。
- 每个参与者随机产生一个数x作为私钥。
- 每个参与者通过计算g^x = h mod p生成自身的公钥h。
如何将上述的所有数学知识应用在 DH 密钥交换算法中呢?可以想象下面的场景:
- Alice 有一个私钥 $a$ 及其对应的公钥 $A = g^a \bmod p$;
- Bob 有一个私钥 $b$ 及其对应的公钥 $B = g^b \bmod p$。
Alice 可以根据 Bob 的公钥和自身的私钥计算双方的共享密钥 $B^a \bmod p$,Bob 也可以进行类似的操作,计算 $A^b \bmod p$。显而易见,双方最终会得到相同的结果:
$$B^a = g^{ba} = g^{ab} = A^b \bmod p$$该算法需要选择的素数足够大,实践中为2048位,由于实在是太长了,所以不久之后,基于椭圆曲线的 DH 密钥交换算法(Elliptic Curve Cryptography,ECC)诞生了
ECDH密钥交换
现在我们构造一个椭圆曲线群,就可以在这个群上实现 DH 密钥交换算法。产生 ECDH 算法密钥对的方法如下。
- 所有参与者协商一个椭圆曲线方程、一个有限域(最有可能是一个素数)和一个群生成元G(在椭圆曲线密码中通常称为基点)。
- 每个参与者生成一个随机数x作为自身的私钥。
- 参与者各自生成自己的公钥[ x ]G。
- [ x ]G表示x个G相加
● Alice 拥有私钥a以及公钥[a]G。
● Bob 拥有私钥b以及公钥[b]G。
Alice 可以根据 Bob 的公钥以及自身的私钥a计算共享密钥[a]B。Bob也可以使用类似的计算得到[b]A。很明显,双方最终计算出相同的最终密码:
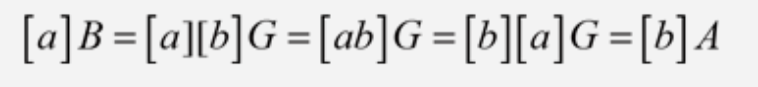
因为有着如此可怕的参数,即便攻击者知道了使用的是哪条椭圆曲线,用的是哪个生成元,同时还知道了双方的公钥,这也无济于事,只要双方的私钥足够随机,就无法暴力破解得到最终的密码
如今,ECDH算法取代了DH算法,因为它的密钥更短,更为安全,更好实现.
混合加密
实际应用中,我们通常是先用非对称加密来进行沟通得到共享密钥,转换后得到共同的对称密钥,之后再使用对称密钥来加密通信.这一过程被称为混合加密.
RSA算法
如文中所说,标准的RSA算法是不够安全的,所以可以直接忽略掉.
ECIES算法
基于椭圆曲线的混合加密标准(Elliptic Curve Integrated Encryption Scheme,ECIES)是应用最为广泛的混合加密算法,过程如下:
- 双方使用ECDH生成临时共享密钥
- 将共享密钥作为对称密钥,加密消息后发送给对方.
但如之前所说,我们最好对共享密钥做一些处理,而不要直接拿来作为对称密钥,这本书在后面会谈到这个问题.
数字签名
签名用于将特定网站/实体与它所提供的公钥绑定,这一过程是由权威的签名机构实现的,当用户访问网站时,浏览器会自动用公钥验证该网站对应的签名,从而确认该网站是否合法.
- 具体的签名算法由于原理过于复杂,就不深入了
随机性和秘密性
我们在计算机中实际使用的随机数都是伪随机的,有的是使用内置的随机化种子,有的是使用操作系统提供的随机数生成接口(内部是通过计算诸如启动顺序,环境噪声等极度随机的变量实现的)
**密钥派生函数(Key Derivation Function,KDF)**用于从输入中得到一个均匀的随机输出密钥,刚好可以用来处理我们之前的ECDH密钥,用来作为新的对称密钥.
安全传输
SSL与TLS协议
1990年代,SSL(Secure Socket Layer)协议诞生,与HTTP协议结合使用,扩展为HTTPS协议,在3.0版本后,SSL更名为TLS(Transport Layer Security)协议,并于1999年正式发布.
TLS协议可以分成以下两个阶段:
- 握手阶段: 通信双方协商并创建一个安全通信连接
- 安全通信阶段: 加密通信
握手阶段
握手阶段有四项内容:
- 协商: TLS 协议是高度可配置的,客户端和服务器都使用协商好的 SSL 和 TLS 版本以及加密算法作为通信过程的配置参数。握手的协商阶段旨在找到客户端和服务器之间可选配置参数的共同点,以确保连接的双方是对等的。
- 密钥交换: 握手阶段的核心是两个参与者之间的密钥交换。使用何种密钥交换算法是客户端与服务器协商过程中要确定的事项之一。
- 认证: 正如我们在第 5 章密钥交换了解到的那样,中间人攻击者可以轻易模拟密钥交换过程中的任何一方,因此,密钥交换必须经过认证。例如,浏览器必须能够确保自身是在与 google.com 通信,而非与互联网服务提供商(Internet Service Provider, ISP)通信。
- 会话恢复: 由于浏览器经常重复连接到同一个网站,如果每次都进行密钥交换可能产生高昂的计算代价,并且会降低用户体验,因此,TLS 协议中集成了无须重复密钥交换即可快速跟踪安全会话的机制。
- 该阶段不是必需的
协商
客户端向服务器发送第一个请求(称为ClientHello),包含客户端支持的TLS协议版本,支持的密码算法和更多的信息,密码算法包括以下部分:
- 一种或多种密钥交换算法: ECDH算法的各种变体,最新版本的TLS中移除了对RSA算法的支持
- 两种(握手双方都需要选择一种签名算法)或多种数字签名算法
- HMAC和HKDF所需的哈希函数
- 一个或多个对称加密算法
密钥交换
TLS 1.3中的密钥交换是这样的:
- 客户端使用 TLS 1.3 的协议,向服务器发送 ClientHello 消息以说明自己支持 X25519 和 X448 密钥交换算法,并附加客户端自身的 X25519 算法公钥。
- 服务器并不支持 X25519 算法,只能支持 X448 算法。因此,服务器向客户端发送 HelloRetryRequest 消息,告诉客户端自己只能支持 X448 密钥交换算法。
- 客户端重新发送 ClientHello 消息,将自己的 X448 算法公钥告知服务器。
- 服务器发送ServerHello消息,并告知自己选定的密码套件,并附上自己的X448公钥
后续的对话都会使用选定的密码套件进行加密.
对于每次会话,双方都会生成新的密钥对,并在交换密钥后立即将其删除
认证
在 Web 系统上,TLS 协议中的认证通常是单向的。例如,只有浏览器才能验证 google.com 是否确实是 google.com,但 google.com 不会验证浏览器的身份(或者说至少这个步骤不会作为 TLS 协议的一部分)。
首先,浏览器必须信任一组证书认证机构(Certification Authority,CA)的根公钥。通常,浏览器会使用一组硬编码的公钥或由操作系统提供的可信公钥。
其次,想要使用 HTTPS 的网站必须要从上述可信的 CA 中获取证书(即对用于验证签名的公钥本身进行签名)。为此,网站拥有者(或者网站管理员)必须向 CA 证明他们拥有一个特定的域。
服务器为了向浏览器证明自己确实是 google.com,需要在 TLS 协议握手阶段向浏览器发送一个证书链。这个证书链包括如下内容。
- 服务器自己的叶子证书,其中包含网站的域名(例如 google.com)、网站的长期公钥以及 CA 对这些内容的签名。
- 一条 CA 证书链,该 CA 证书链包含的 CA 证书从为 google.com 签名的 CA 证书开始,到最后一个由根 CA 证书签名的 CA 证书结束。
其他安全传输协议
- SSH(Secure Shell): 为不同主机上的远程终端提供安全连接
- Wi-Fi 保护接入(Wi-Fi Protected Access,WPA)协议
所有这些协议都实现了类似 TLS 协议的握手和安全通信的流程,并在 TLS 协议的基础之上加入个性化的设计
端到端加密
总结
第一部分的每一章都非常有看头,讲的非常透彻,第二部分的安全传输讲的最好,其他的随便看看就行.
事务处理: 概念与技术
- 出版于1993年(英文原版),作者:Jim Gray。
- 图灵奖得主的书,年代很久远,也比较冷门,匆匆一览下来,发现这么冷门是有理由的,首先内容太老了,其次是比较学究气,不太推荐阅读
数据库系统实现
- 出版于2000年(英文原版),作者:Hector Garcia-Molina。
- 不推荐,内容太老了,讲的也比较宽泛
Spring实战 && Spring Boot实战
- 不推荐,到底哪里有正常一点的框架书啊😢
Spring Start Here
- 出版于2021年,出版商:Manning,作者:Laurentiu Spilca。
前言
The reality is that despite being so popular, it’s pretty hard to find quality introductory material. The reference documentation is thousands of pages long, describing all the subtleties and details that could be helpful in very specific scenarios, so it’s not an option for a newcomer. While online videos and tutorials typically fail to engage the student, very few books capture the essence of Spring framework, often spending long pages debating topics that prove to be irrelevant to the problems faced in modern application development. With this book, however, it’s very hard to find anything to remove; all the concepts covered are recurring topics in the development of any Spring application.
This book is for developers who understand basic object-oriented programming and Java concepts and want to learn Spring or refresh their Spring fundamentals knowledge.
如果对 Spring 完全没有(或仅有极少)了解,最佳读法是从第一章开始,按顺序通读全书。
- (6/23): 希望这本书能够如前言所说的那样好.
介绍
Spring框架由以下部分组成:
- Spring Core: 包含Spring context,The Spring Expression Language等核心功能.
- Spring model-view-controller (MVC): 用于开发Web应用程序
- Spring Data Access: 用于连接数据库
- Spring testing: 用于测试
Spring Boot引入了convention over configuration这一概念,也就是说,开发者无需自行完成框架的全套配置,Spring Boot会提供一套默认配置方案,用户可根据需求进行个性化调整.
- 暂时弃坑
算法导论
理论部分
算法复杂度计算
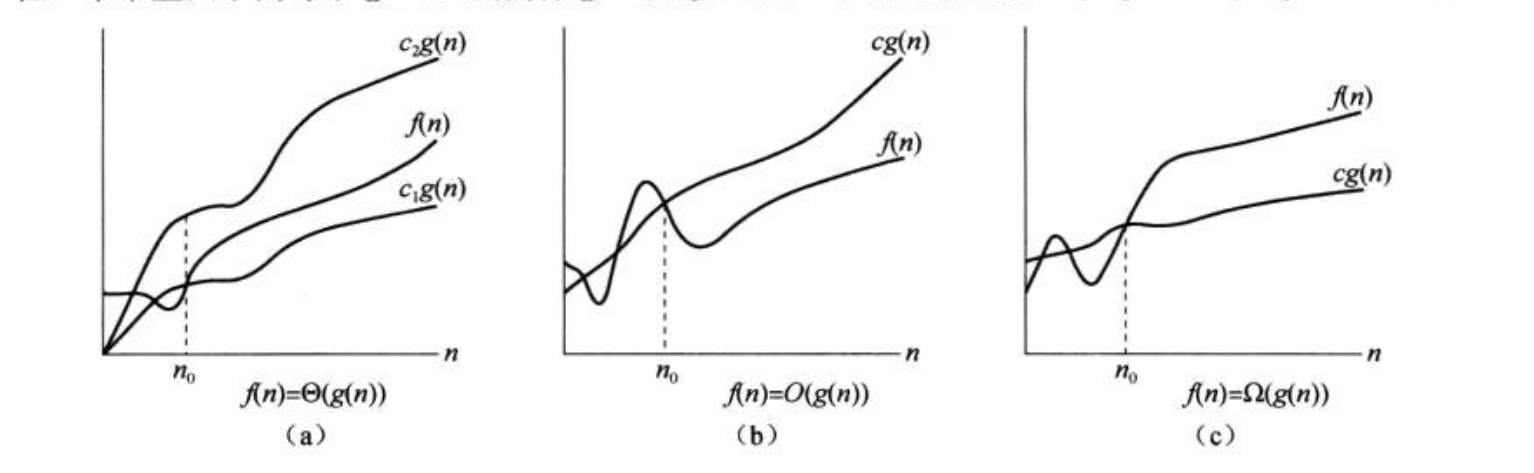
- Θ表示确界,f(n)主要项的次数必须与g(n)相同
- O表示上界,f(n)主要项的次数小于或等于g(n)
- Ω表示下界,f(n)主要项的次数大于或等于g(n)
主定理计算分治递归式
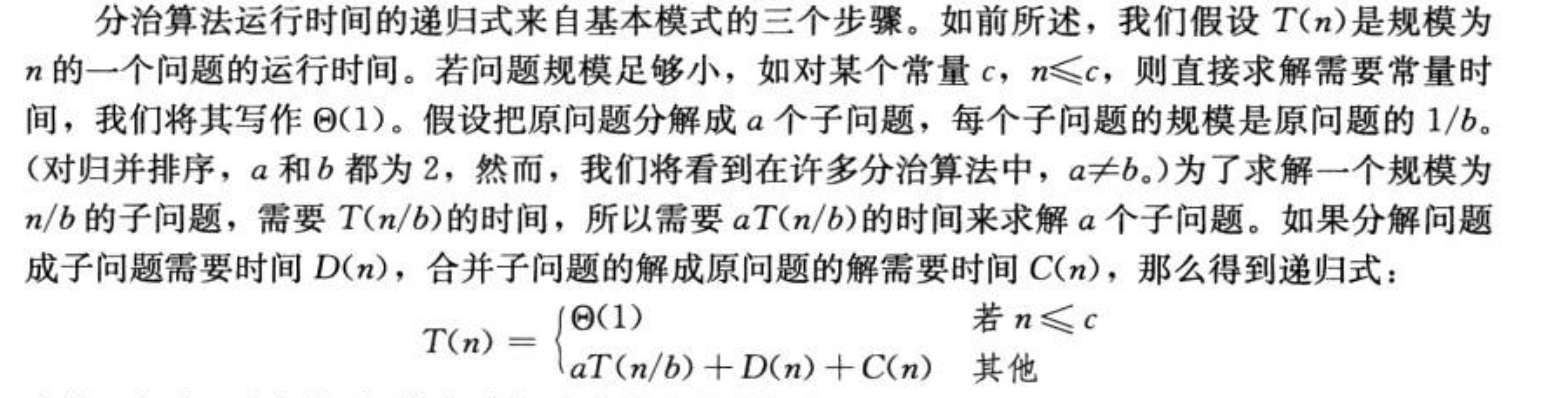
定理 4.1(主定理) 令 $a \ge 1$ 和 $b > 1$ 是常数,$f(n)$ 是一个函数,$T(n)$ 是定义在非负整数上的递归式:
$$T(n) = aT(n/b) + f(n)$$其中我们将 $n/b$ 解释为 $\lfloor n/b \rfloor$ 或 $\lceil n/b \rceil$。那么 $T(n)$ 有如下渐近界:
- 若对某个常数 $\epsilon > 0$ 有 $f(n) = O(n^{\log_b a - \epsilon})$,则 $T(n) = \Theta(n^{\log_b a})$。
- 若 $f(n) = \Theta(n^{\log_b a})$,则 $T(n) = \Theta(n^{\log_b a} \lg n)$。
- 若对某个常数 $\epsilon > 0$ 有 $f(n) = \Omega(n^{\log_b a + \epsilon})$,且对某个常数 $c < 1$ 和所有足够大的 $n$ 有 $a f(n/b) \le c f(n)$,则 $T(n) = \Theta(f(n))$。
算法部分
分治
- 4.1的论述非常不错,浅显易懂的说明了最大子数组的写法
对于最大子数组和问题,我们可以用两种分治想法来看:
- 维护一个前缀和数组,遍历所有的前缀和来找到最大和,时间复杂度是O(n^2)
- 当前最大和只有两种情况,前面的所有元素加上当前的元素和只使用当前元素,从下标1开始遍历到最后一个元素即可,时间复杂度为O(n).
普通的矩阵乘法计算的时间复杂度是O(n^3):
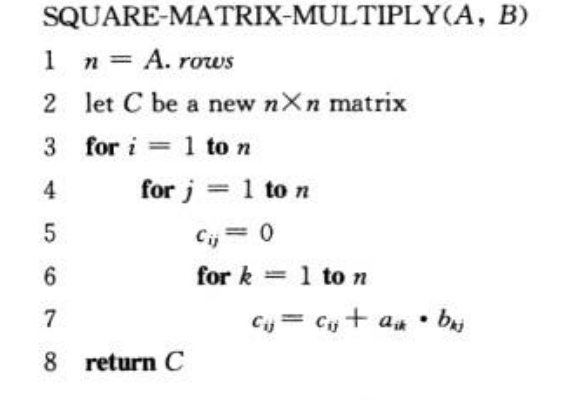
而Strassen算法能够把时间复杂度压缩到O(n^lg7):
$$T(n) = \begin{cases} \Theta(1) & \text{若 } n = 1 \\ 7T(n/2) + \Theta(n^2) & \text{若 } n > 1 \end{cases}$$排序算法(过)
这本书关于排序的几章都比较宽泛,没什么看头
动态规划
LCS问题
- 最长公共子序列问题(longest common subsequence): 给定两个序列X和Y,找到X和Y中长度最长的公共子序列(可以不连续).
定理: (LCS 的最优子结构) 令 $X = \langle x_1, x_2, \cdots, x_m \rangle$ 和 $Y = \langle y_1, y_2, \cdots, y_n \rangle$ 为两个序列, $Z = \langle z_1, z_2, \cdots, z_k \rangle$ 为 $X$ 和 $Y$ 的任意 LCS。
- 如果 $x_m = y_n$, 则 $z_k = x_m = y_n$ 且 $Z_{k-1}$ 是 $X_{m-1}$ 和 $Y_{n-1}$ 的一个 LCS。
- 如果 $x_m \neq y_n$, 那么 $z_k \neq x_m$ 意味着 $Z$ 是 $X_{m-1}$ 和 $Y$ 的一个 LCS。
- 如果 $x_m \neq y_n$, 那么 $z_k \neq y_n$ 意味着 $Z$ 是 $X$ 和 $Y_{n-1}$ 的一个 LCS。
上述定理意味着,在求 $X = \langle x_1, x_2, \cdots, x_m \rangle$ 和 $Y = \langle y_1, y_2, \cdots, y_n \rangle$ 的一个 LCS 时,我们需要求解一个或两个子问题。如果 $x_m = y_n$,我们应该求解 $X_{m-1}$ 和 $Y_{n-1}$ 的一个 LCS。将 $x_m = y_n$ 追加到这个 LCS 的末尾,就得到 $X$ 和 $Y$ 的一个 LCS。如果 $x_m \neq y_n$,我们必须求解两个子问题:求 $X_{m-1}$ 和 $Y$ 的一个 LCS 与 $X$ 和 $Y_{n-1}$ 的一个 LCS。两个 LCS 较长者即为 $X$ 和 $Y$ 的一个 LCS。由于这些情况覆盖了所有可能性,因此我们知道必然有一个子问题的最优解出现在 $X$ 和 $Y$ 的 LCS 中。
贪心
自顶向下,反复选择当前最优的选择,然后得出答案,这与动态规划很类似,实际上,每个贪心算法都可以用更繁琐的动态规划算法来表示.
图算法
最小生成树
- Kruskal: 将边按权重从低到高排序,只要不形成环路就按顺序将边加入
- Prim: 从任意节点开始,每次选择当前可见范围内的最短边,只要不形成环路即可
单源最短路径
Bellman-Ford与Dijkstra.
所有节点对的最短路径
Warshall算法
数论
欧几里得算法
- 最大公约数(greatest common divisor,gcd): 能够整除多个非零整数的最大正整数
欧几里得算法(辗转相除法)可以用来递归计算两个非零整数的最大公约数:
| |
实战来说的话只要这么写就行了:
| |
写成while循环:
| |
np完全问题
- P问题(Polynomial): 可以在多项式时间内解决的问题
- NP问题(Nondeterministic Polynomial time): 可以在多项式时间内验证解答的问题
- NP完全问题(NP-Complete,NPC): 所有NP类问题都可以在多项式时间内转换成NPC问题,如果能够求解NPC,那么就可以求解所有的NP问题.
至今为止没有人能够发现任何一个NPC问题的解决方案
数据结构
二叉搜索树
- 书上讲的非常学术化,同样没什么看头
二叉搜索树中,所有子树的左节点都小于根节点,右节点都大于根节点.
红黑树
红黑树是一种平衡的二叉搜索树,每个节点有五个属性,color,key,left,right,p,满足以下性质:
- 每个节点要么是红色要么是黑色
- 根节点是黑色的
- 每个空节点是黑色的
- 如果一个节点是红色的,那么两个子节点都是黑色的
- 每个节点到达所有后代空节点的路径上,都有相同数量的黑色节点
B树(过)
讲的不是很详细,不如看B站视频
总结
这本书的内容很丰富,奈何没有几个地方讲的比较深入,整体来说,更适合作为一本参考书,看看有哪些知识点是自己不会的,再专门找资料去学习就行了.
Tailwind CSS
- 出版于2022年,作者:Ivaylo Gerchev。
ch1
| |
- container作为容器,限制页面与网页边框的间距
- mx-auto作用于div,section,或者设置了flex的元素,使得这些元素在父容器中水平居中,
m=margin,x=横向,若为my-auto则表示纵向 - justify-between (justify-content: space-between):将子元素沿水平方向向两端推开
- items-center (align-items: center):让不同高度的子元素在垂直方向居中对齐。
- sticky: 固定该元素,会随着页面滚动
z-10,z轴优先级,设置高优先级保证始终位于页面最上层.py-4: padding-y为4*4pxbg-blue-900: 背景为蓝色,强度为900,色调的默认范围为50到950
| |
fas fa-wind: 风图标,属于Font Awesome库fa-2x: 放大为2倍.ml-6: margin-left,6*4pxcursor-pointer: 悬停时光标变成pointer(手),自然还有cursor-wait等其他的光标形状text-2xl: 2倍字号大小font-semibold: 半粗体flex-shrink-0: 控制当 Flex 容器空间不足时,元素是否以及如何按比例缩小,若为0则表示不缩小.
| |
text-white hover:text-blue-300:很好看懂
补充学习
遗憾的是,这篇教程剩下的内容用的是vue,而且还是tailwind v3版本,不具备任何的实用性,所以只好做点个人的补充了.
在某个文件夹运行下述命令:
| |
如果用pnpm的话则这样写:
| |
之所以不要额外干什么活儿,是因为nextjs已经将tailwindcss全部内置统一安装了,还是非常不错的.
好在ch1学的东西已经够用了,现在再来看page.tsx就不觉得是鬼画符了:
| |
flex-1,等价于下述代码:
| |
max-w-md: 最大宽度为medium尺寸dark:bg-black: 当主题被设置为dark时,背景变成blackleading-8: line-height为8*4px大小
必须承认,tailwind确实很好记,怪不得这么火.
Test-Driven React
- 出版于2024年,作者:Trevor Burnham。
- 明明是24年的书,用的库却是Jest呢,那就不看了吧
The Elements of Computing Systems
概览
- www.nand2tetris.org: 配套官网
- 该书被尊称为Nand to Tetris,至于为什么,看完这本书就会知道了
- 第二版于2021年发行,距离第一版已经过了将近二十年,内容上做了相当大的革新
We wrote this book because we felt that many computer science students are missing the forest for the trees. The typical learner is marshaled through a series of courses in programming, theory, and engineering, without pausing to appreciate the beauty of the picture at large. And the picture at large is such that hardware, software, and application systems are tightly interrelated through a hidden web of abstractions, interfaces, and contract-based implementations.
We believe that the best way to understand how computers work is to build one from scratch.
涵盖的内容如下:
基本逻辑器件
所有的布尔运算都可以由And,Or,Not三个布尔运算来表示,而由于Nand可以表示这三个布尔运算,所以所有的布尔运算都可以被Nand(Not and,与非)一个运算表示出来,不过实际工程中这么做就太不值当了,还是要用到其他的布尔运算器件的,毕竟简单的取反比与非门好实现得多.
- 门(gate): 实现简单布尔运算的物理器件,通常用蚀刻在硅基板上的晶体管实现,并被封装成芯片(chips)
好在我们不要担心门的底层是怎么实现的,这是物理学家和电气工程师的事情.
基于三种基本逻辑门,我们可以实现各种各样的复合逻辑门:
硬件设计
如今,硬件工程师不需要自己来手动制作任何部件,而是通过硬件描述语言(Hardware Description Language,HDL)来设计芯片架构,并通过计算机进行模拟的运行和测试,得到最终蓝图之后再通过自动化流水线批量生产芯片即可
抛开简单的门电路不谈,我们来看几个高级一点的芯片设计.
多路选择器的实现:
分路器的实现:
由于处理器架构通常为16位,32位甚至是64位的,所以我们需要将之前那些只能执行单位计算的门电路改装为多路电路:
进阶逻辑器件
半加器:
全加器:
16位加法器:
算术逻辑单元(Arithmetic Logic Unit,ALU),将一系列通用运算包含在一起,至于包含哪些运算,要看具体的CPU设计了:
上图中的ALU对两个16位二进制补码数和6个1位输入(控制位)进行计算:
于此之外,该ALU还计算了两个输出位zr和ng,分别表示zero和negative,标记输出是否为零或者为负.
存储器件
之前构建的芯片都是与时间无关的,被称为组合逻辑芯片,本章将介绍时序逻辑芯片,芯片的输出与时间有关,这种芯片可以用于存储信息.
- oscillator(振荡器): 最重要的时序逻辑部件,在高低电平间反复变化,用于产生时钟周期信号,电路负责将时钟周期信号广播道所有的时序逻辑芯片上
- data flip-flop(DFF,数据触发器,也被称为D触发器,尽管这个名字实在是不知所云,但却能常常在国内教材中看到): 接受一个时钟输入和单比特数据输入,输出一个单比特数据
- 每个时钟周期会输出上一个时钟周期的输入,如果时钟周期信号的输入线路被暂时锁定,那么DFF就会一直保留上次的输入,直到被时钟周期信号激活
- 由于实现起来是相当复杂的,所以这本书并没有介绍.
- Bit(单比特寄存器): 基于DFF实现,包含一个输入端口in,空值端口load,输出端口out,只要load位未被置1,那么寄存器就会保持锁存状态,保持状态不变.
- Register(寄存器): 基于Bit组合实现
- Random Access Memory(RAM,随机存取存储器): 基于寄存器实现,读取地址m对应的寄存器时,将load置为0即可在不改变内容的情况下输出上一个状态值;写入地址m对应的新值时,将load置为1即可覆盖原内容.
- 之所以称为随机存取,是因为RAM可以在O(1)时间内访问任意一个寄存器,这是通过诸如3-8译码器或者2-4译码器实现的
- Program Counter(程序计数器): 每次被时间信号激活时就将存储的值加一,基于寄存器实现,增加了两个控制位inc和reset,inc用于判断是否要递增PC,reset用于重置PC为0.
构建计算机
前置概念
- Memory: 存储设备,与CPU有一段距离,故存取速度不是很快
- Processor: 处理器,通常被称为Central Processing Unit(CPU),能够执行所有的指令集指令
- Register: 与CPU紧密连接的寄存器,用于实现高速存取
- 汇编语言: 使用符号(例如add,r1,r2)表示的机器语言,将汇编语言翻译成二进制代码的程序被称为汇编器.
- 不同处理器硬件架构使用的汇编语言不同,但理论上都是等价的,能够执行基本相同的一组任务
Hack处理器架构
这本书自创了一个用于教学的处理器架构:
- 三个16位寄存器: 数据寄存器(D),地址寄存器(A),可选寄存器(M),汇编代码如下.
- Hack处理器支持两类16位指令:
- 地址指令(A类指令): 使用符号
@标识,对应的操作码为0,将A寄存器设定为某个值.也就是说是1位操作码+15位地址值 - 运算指令(C类指令): 没有符号标识,对应的操作码为1,基本格式为1位操作码+2位不使用的位(设定为1)+7位comp指令(compute,表示ALU操作)+3位dest指令(存储到哪个位置)+3位jump指令(跳转到哪里)
- 地址指令(A类指令): 使用符号
非常令人震惊的就是,只用这两种指令就可以实现键盘交互,屏幕显示,数值运算等所有的基本计算机功能了.
汇编器
汇编器用来将汇编语言转换成二进制机器码,针对每条汇编指令,汇编器会按照翻译规则进行翻译,至于具体怎么翻译,这本书讲的不是很清晰,就直接跳过了.
虚拟机
Hack计算机使用了双层编译器,即将高级语言先转换成中间语言,再将中间语言转换成汇编语言,分别由编译器的前端和后端实现,这里的虚拟机就对应了编译器的后端.
由于书中的实现方法相当简化,所以不太具备学习的价值.
编译器与操作系统
这部分由于过于宽泛,也不推荐阅读
总结
这本书的前半部分是最有价值的,对于软件工程师来说,物理器件与处理器的关系是最让人迷惑的,而这本书能够让我们看到处理器架构实际上并没有那么难实现.
而后半部分关于编译器和操作系统的讲述,由于过于宽泛和简化,不太有必要去读,不如去专门看操作系统和编译原理相关的书.
THE MISSING README
- 出版于2021年,作者:Dmitriy Ryaboy。
很一般…
图数据库(第二版)
- 出版于2015年(第2版),出版商:O’Reilly,作者:Ian Robinson。
介绍
在数据集增大的时候,图数据库的性能保持不变,因为查询总是只与图的一部分有关,只需要遍历符合查询条件的那部分图即可.
建模
- Cypher是图数据库的标准查询语言,而不少图数据库还支持RDF的查询语言SPARQL.
很遗憾的是,书中对Cypher的介绍非常浅显,所以需要专门找其他的书来看了.至于剩下的内容就都是扯淡了,这也看得出来图数据库本身还没有那么成熟.
Understanding The Linux Kernel(深入理解Linux内核)
不推荐阅读
- 总结的太到位了,这本书确实写的很烂.
绪论
本书描述的是Linux2.6.11版的内核,而现在的Linux内核版本号都到7.1了,甚至还有不少代码是由rust写的:
操作系统基本概念
任何计算机系统都包含一个名为操作系统的基本程序集合,在这个集合里,最重要的程序称为内核(kernel).当操作系统启动时,内核被映射到内存中运行,是其他程序运行的基底
操作系统需要完成两个目标:
- 与硬件部分交互
- 为用户程序提供执行环境
某些系统如MS-DOS允许用户程序与硬件部分交互,但类Unix操作系统如Linux,MaCOS等将硬件部分隐藏起来,需要程序向操作系统发出请求才能通过内核与硬件部分交互.
用户与组
在多用户系统(支持多个用户使用)的系统中,每个用户在机器上都有自己专用的私有空间,所有用户由一个唯一的数字来标识,叫做用户标识符(User ID,UID),用户通过ID和口令来登录自己的账号.
类Unix操作系统都有一个特殊的用户,叫做root,即超级用户(superuser),他可以访问系统中的所有文件并干涉所有的用户程序.
Unix文件系统
Unix文件被组织在一个树结构的命名空间中:
- 与树根对应的目录被称为根目录(root directory),名字是"/".
Unix的每个进程都有一个当前的工作目录,我们通过相对路径或者绝对路径来标识目录文件的位置.
.和..分别标识当前工作目录和父目录.
内存寻址
地址
80x86微处理器架构下,存在以下三种地址:
- 逻辑地址(logical address): 由一个段和偏移量组成,指定一个操作数或者一条指令的地址.
- 虚拟地址(也称线性地址): 将指令映射到虚拟空间时的地址,在32位Linux系统中可寻址的空间为4GB
- 物理地址: 虚拟地址实际映射的内存地址
逻辑地址
具体来说,一个逻辑地址实际上是由16位长的段选择符和32位长的偏移量组成的.
处理器中提供了6个段寄存器用来存放段选择符:
- cs: 代码段寄存器
- 含有一个两位的字段,用于指明CPU的当前级别,0级为最高优先级,3级为最低优先级,Linux只用0和3级,称为内核态与用户态.
- ss: 栈段寄存器
- ds: 数据段寄存器
- es,fs,gs: 通用型寄存器,可以指向任意的数据段.
Cache
由于从内存(DRAM)中读取指令还是太慢了,我们设计了cache(高速缓存),它基于局部性原理设计: 最近最常用的相邻地址在将来又被用到的可能性极大.
80x86体系引入了一个叫做行(line)的单位,它由几十个连续的字节组成.cache就由多个行组成.
Cache 单元位于分页单元与主内存之间。它由硬件 Cache 存储器(Hardware Cache Memory)和 Cache 控制器(Cache Controller)组成。Cache 存储器负责存放内存数据行。Cache 控制器则维护一个入口数组,每个入口对应的是Cache 存储器中的一行.
Each entry includes a tag and a few flags that describe the status of the cache line. The tag consists of some bits that allow the cache controller to recognize the memory location currently mapped by the line. The bits of the memory’s physical address are usually split into three groups: the most significant ones correspond to the tag, the middle ones to the cache controller subset index, and the least significant ones to the offset within the line.
When accessing a RAM memory cell, the CPU extracts the subset index from the physical address and compares the tags of all lines in the subset with the high-order bits of the physical address. If a line with the same tag as the high-order bits of the address is found, the CPU has a cache hit; otherwise, it has a cache miss.
- 也就是说缓存是否命中只需比对缓存控制器中的标签是否与RAM中的高位物理地址对应即可,还是很快的.
进程
- 进程: 程序执行时的一个实例,进程之间有共享的程序代码,但每个进程都有独立的数据存储空间
- 线程: 一个进程可以由一个或者多个线程组成
- 轻量级进程: 轻量级进程间可以共享资源,一个轻量级进程对应一个线程.
进程描述符
进程描述符(process descriptor)存放了一个进程所有信息的结构体,它的主要结构如下:
进程的状态
进程可能处于以下状态中,状态之间是互斥的:
- 可运行状态: 进程要么正在执行,要么准备执行
- 中断状态: 进程被挂起,等待所需的信号或者资源,由进程主动执行.
- 不可中断的等待状态: 进程被挂起,无法被信号唤醒,直到某个必要进程执行完毕
- 例如Windows突然死机,用户无法执行任何操作
- 暂停状态: 进程接收到信号后被强制暂停运行,进程是被动暂停的,这也是与2的不同点所在.
- 跟踪状态: 当一个进程被另一个进程(通常是调试器如 GDB)监控时,它会进入 TASK_TRACED 状态。此时,被跟踪进程的执行权被完全移交给跟踪者。
- 僵尸状态: 进程执行完毕后,父进程尚未开始处理关于该子进程的终止信息
- 复活状态: 父进程开始处理子进程的终止信息
进程的标识
类Unix操作系统中都有一个叫做进程标识符(process ID,PID)的数来标识进程,它同样位于进程描述符中.
- 同一个进程的多个线程使用相同的PID
进程的组织
Linux使用双向链表来存储进程队列,并根据PID的不同将不同类型的PID分成了4个hash表:
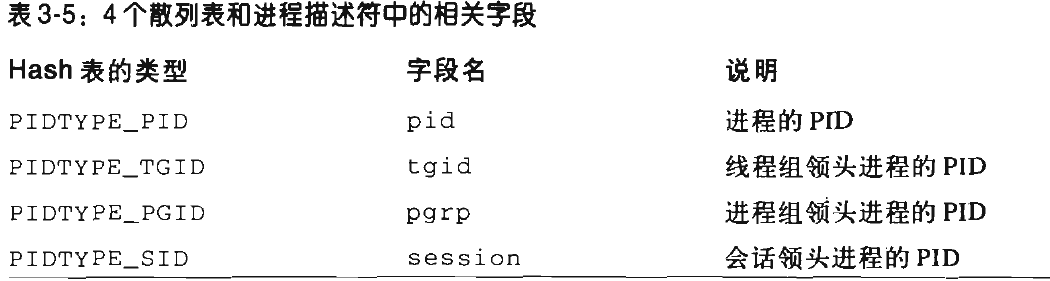
当需要分配新进程时,会根据进程的PID字段进行hash映射到对应的空间中.
运行和等待状态的进程是最重要的,Linux内核为这两种进程设定了专门的队列用于调度进程.
- 运行队列: 将可运行状态的进程用链表组织在一起
- 等待队列: 将等待状态的进程用链表组织在一起
创建进程
传统的Unix操作系统使用唯一一种方式创建所有的进程: 子进程复制父进程所有的资源,这种方法的效率相当低下,现代Unix内核使用以下三种机制来优化进程创建:
- 写时复制: 允许父进程和子进程读取相同的存储空间
- 轻量级进程: 通过
clone()函数创建,父子进程间共享各类数据 - vfork()系统调用: 使用vfork()函数创建的进程可以与父进程共享相同的内存地址空间.
看着迷糊吗,但这并非翻译的锅,原文同样也很迷糊,很好奇这本书为什么这么有名
中断和异常
- 中断: 由I/O设备,硬件设备发出
- 异常: 由CPU发出,有三种类型的异常
- 故障(fault): 通常可以被纠正,之后会重新执行引起故障的指令
- 陷阱(trap): 一般用于调试,之后不再执行故障指令,而是执行下一条指令
- 中止(abort): 发生了严重错误,需要专门处理
总结
及时止损,看不下去了,显然作者沉浸在自己的代码分析世界里了,完全没能从一个更高的维度来对Linux的运作机制做一个概括
网络游戏核心技术与实战
- 出版于2014年(中文版),作者:中嶋谦互。
- 讲的挺全面的,要想搞懂联机游戏是什么看这本书就对了.尽管如此,很多地方都讲的很啰嗦,实战代码部分也不够清晰,中规中矩吧.
要点总结
为什么不能用数据库存储游戏信息
假如要在搭载了 6502 芯片的家用游戏机上使用 RDBMS 会怎么样呢?当然首先必须通过 SQL 语句,但是像 SELECT * from FlyingObjects 这样的语句,单单判断语法是否正确就要消耗几百个 CPU 周期,显然不现实。
游戏编程必须在 1 帧内完成坐标的判断和保存。为此,必须只通过组合 CPU 所具有的一些最原始的命令来实现这些处理,只是读取数据就要花费几百个周期是相当不合理的。因此,在家用游戏机中,基本不考虑使用 RDBMS 这种方式。
Web Automation Testing Using Playwright
- 出版于2024年,作者:Kailash Pathak。
介绍
人工编写测试用例并逐一运行过于繁琐,这也是测试工具不断演进不断发展的原因,而在其中名气处于第一梯队的就是Playwright了,而它这么火爆的另一个原因是还可以被用于爬虫.谁能想到,Playwright的正式发布时间也才在2020年呢,至于老牌的Selenium由于更差性能和更复杂的调用方式则逐渐落伍.有力的竞争者之一则是Cypress,由于它运行在浏览器内部,不需要额外安装驱动,所以也占有了一席之地.
安装Playwright
- 每次安装都麻烦的过头了好不好
| |
locators
playwright中的定位器都很朴素,调用方法如下:
| |
如果用于css的话,则是这样写:
| |
显然,对于爬虫来说,这一功能确实很不错,至少能够保证
总结
必须承认,这本书写的很烂,也没什么系统性,不过基本能够了解playwright是什么,而且它远远没有达到所谓的自动化的程度.
x86汇编语言:从实模式到保护模式(第二版)
- 出版于2023年(第2版),作者:李忠。
这本书的前半部分围绕8086处理器,后半部分围绕80386处理器.
基础知识
ROM
8086 有 20 根地址线,但并非全都用来访问 DRAM,也就是内存条。事实上,这些地址线经过分配,大部分用于访问 DRAM,剩余的部分给了只读存储器(Read Only Memory,ROM)和外围的板卡,如图所示。
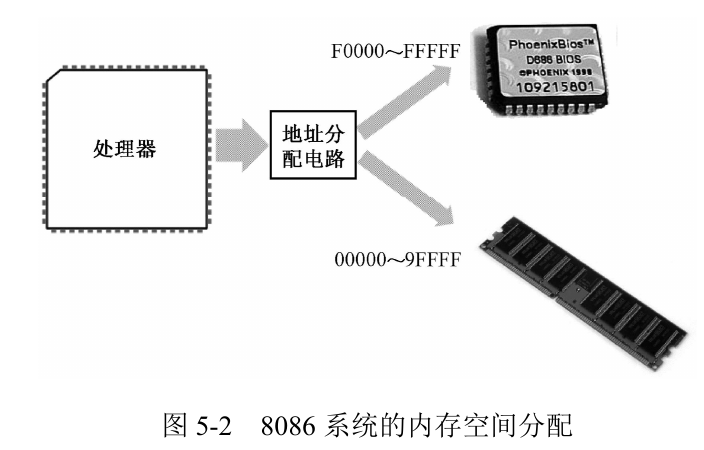
与 DRAM 不同,ROM 不需要刷新,它的内容是预先写入的,即使掉电也不会消失,但也很难改变.
因此,我们可以在ROM中存入初始化指令,在电脑开机时载入最基本的硬件(如硬盘和内存),这块ROM芯片又被称为基本输入输出系统((Base Input & Output System,BIOS))ROM,即ROM-BIOS.
这是很显然的,因为操作系统都装在硬盘里呢,所以我们需要BIOS来激活操作系统.
硬盘
谁能想到这本书对磁盘的讲解远远超过了我至今见过的所有底层技术书籍呢
硬盘由一个或者多个盘片组成,都串联在一个转轴上,由电动机带动着不断高速旋转,每个盘片都有两个磁头(Head),上面一个下面一个,磁头通过磁头臂固定在磁头支架上,由另一个电动机带动着在盘片的中心和边缘之间来回移动,速度略慢.
盘片高速旋转过程中会画出一个圆圈,由内而外半径主键变大,这就是磁道(Track),所有的磁头和垂直对应的磁道形成了一个虚拟的圆柱,称为柱面.
磁道和柱面也要编号,从0开始.磁道进一步可以划分成扇区(sector),是读写数据的最小单元,每个扇区也有编号,从1开始.
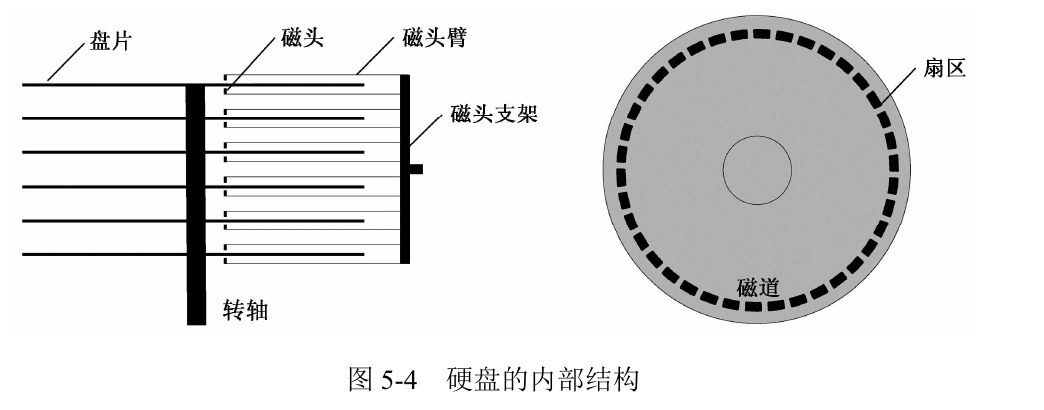
主引导扇区
硬盘的第一个扇区是 0 面 0 道 1 扇区,或者说是 0 头 0 柱 1 扇区,这个扇区称为主引导扇区(Main Boot Sector,MBR)。如果计算机的设置是从硬盘启动的,那么,ROM-BIOS 将读取硬盘主引导扇区的内容,将它加载到内存地址 0x0000:0x7c00(也就是物理地址 0x07C00),然后用一个 jmp 指令跳到那里接着执行.
为什么偏偏是 0x7c00 这个地方?还不太清楚。反正当初定下这个方案的家伙已经被人说了很多坏话,我也就不准备再多说什么了。
一般来说,主引导扇区是由操作系统负责的。正常情况下,一段精心编写的主引导扇区代码将检测用来启动计算机的操作系统,并计算出它所在的硬盘位置。然后,它把操作系统的自举代码加载到内存,也用 jmp 指令跳转到那里继续执行,直到操作系统完全启动
,我们知道,8086 可以访问 1MB 内存。其中,0x00000~9FFFF 属于常规内存,由内存条提供;0xF0000~0xFFFFF 由主板上的一个芯片提供,即 ROM-BIOS。
这样一来,中间还有一个 320KB 的空洞,即 0xA0000~0xEFFFF。传统上,这段地址空间由特定的外围设备来提供,其中就包括显卡。
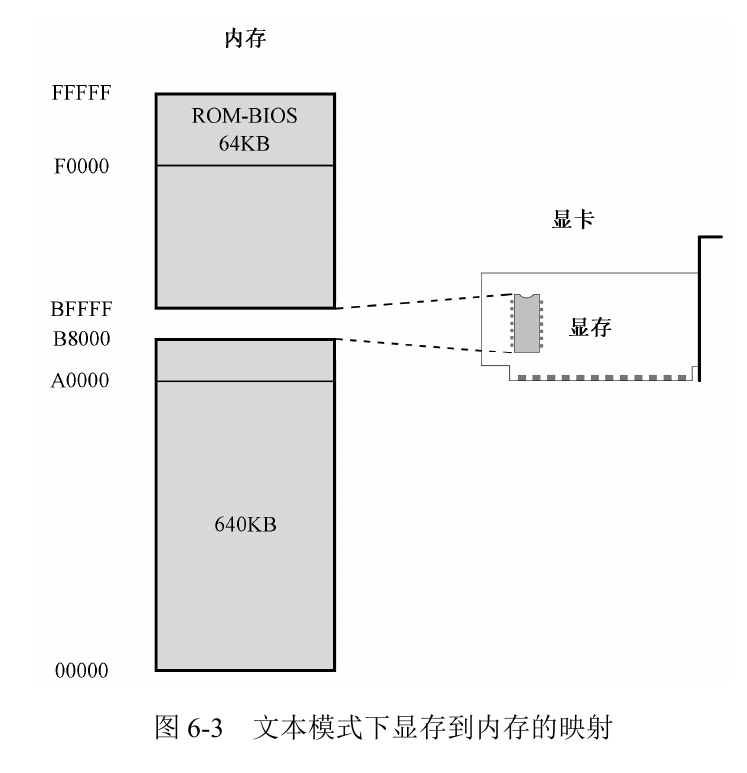
实模式
8086处理器架构
- 8086处理器是INTEL的第一款16位处理器,诞生于1978年
8086中有8个16位(两个字节)的通用寄存器,结构如下:
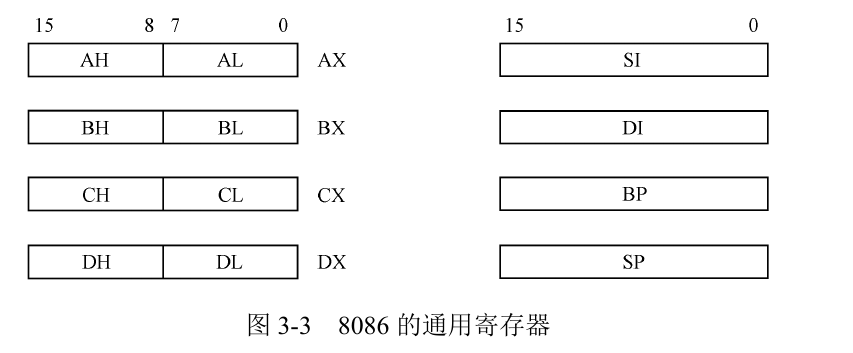
由于x86中指令的长度不定,短的只有1字节,长的有15字节,所以需要将指令和数据分开存放在内存中.
内存的结构如下:
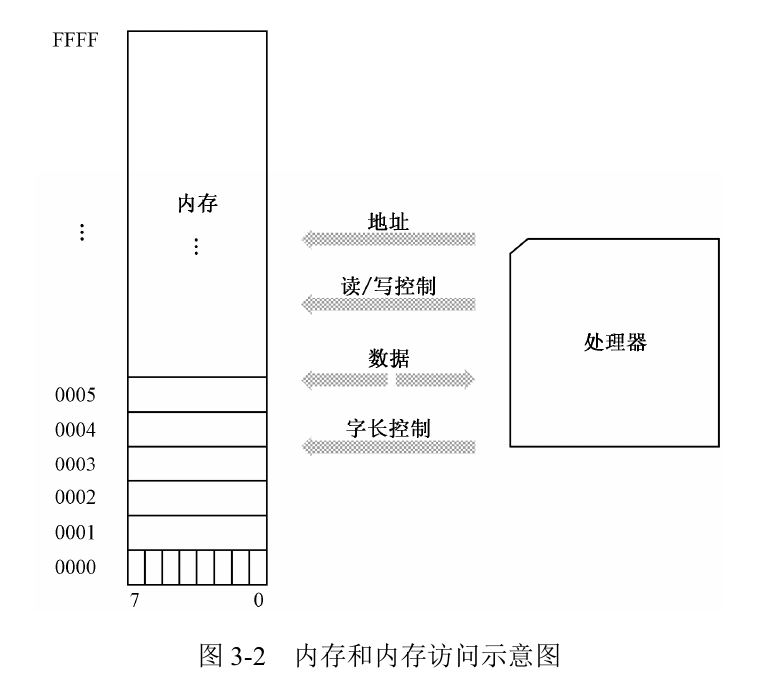
内存的最小访问单元是1字节,每一位地址对应1个字节.
关于8086架构的一个详细示意图如下:
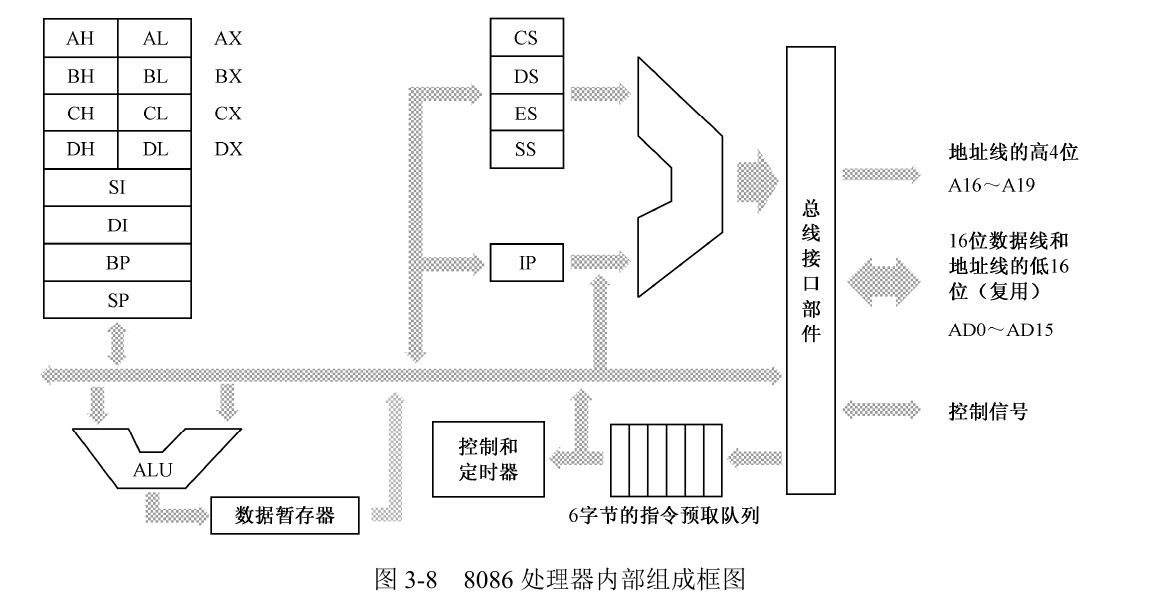
8086 内部有 4 个段寄存器。其中,CS 是代码段寄存器,DS 是数据段寄存器,ES 是附加段(Extra Segment)寄存器,SS 是栈段(Stack Segment)寄存器
IP是指令指针(Instruction Pointer)寄存器,只和CS一起使用,当一段代码开始执行时,CS 保存代码段的段地址,IP 则指向段内偏移。这样,由 CS 和 IP 共同形成逻辑地址.
汇编语言
16进制的英文是Hexadecimal,比如125H后面的“H”用于表明这是一个十六进制数,但在很多高级语言中,如果要指示一个数是十六进制数,通常不采用在后面加“H”的做法,而是为它添加一个“0x”前缀,如:
| |
你可能想问一下,为什么会是这样,为什么会是“0x”?答案是不知道,不知道在什么时候,为什么就这样用了。这不得不让人怀疑,它肯定是一个非常随意的决定,并在以后形成了惯例
运算指令
- neg: 将寄存器/内存中的数据变成负数,如
neg al - :cbw:(Convert Byte to Word),将8位(Byte)的有符号数扩展为16位(Word),即补上全0或者全1.
- cwd: (Convert Word to Double-word),把16位有符号数扩展到32位,这是借助了DX寄存器来实现的
inc ah: 将ah中的数据加1add ah, al: 相加并将数据送入ah.sub ah, al: 相减并将数据送入ahidiv/div bx: 有符号/无符号除法
大多数时候,无符号数和有符号数是可以同等处理的,如下列指令:
| |
在这里,0xf0 的二进制形式是 11110000,它既可以解释为无符号数 240(十进制),也可以解释为有符号数-16,毕竟它的符号位是 1。无论如何,inc 是加一指令,这条指令执行后,寄存器 AH 中的内容是二进制数 11110001,既是无符号数 241,也是有符号数-15。
所以在设计的时候我们并不需要花心思去判别这到底是不是负数,而是让使用者自己决定.
为了给运算提供方便,x86中有一个专门的FLAGS标志寄存器,存储各种运算结果的标志:
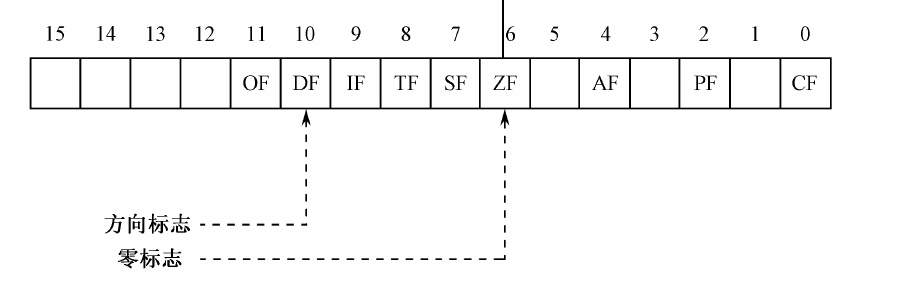
但对于除法和乘法,无符号数和有符号数是有区别的,所以需要单独增加几个扩展指令.
栈
8086中有一个栈段(Stack Segment),由段寄存器SS存储初始地址,并依靠栈指针SP指示当前的栈顶,由处理器自动维护,我们只要使用push/pop指令就可以方便的进行栈操作了.
- or/xor/and: 逐位进行或/异或/与运算,如
or al, 0xaa - push/pop: 将某个寄存器/内存单元的内容压入/推出栈顶,如
push ax
寻址
有三种寻址方式:
- 寄存器寻址: 要操作的数在寄存器中,如
mov ax, cx - 立即数寻址: 要操作的数直接给出了,如
add bx, 0xf000 - 内存寻址: 访问内存来获取数据,分为4种;
- 直接寻址:
mov ax, [0x5c0f] - 基址寻址: 将要寻址的内存地址放在寄存器中,如
mov [bx], dx - 变址寻址: 使用变址寄存器来存储内存地址,如
mov [si + 0x100], al - 基址变址寻址: 如
mov ax, [bx + si]
- 直接寻址:
中断
Intel处理器使用两根信号线来处理中断:
- NMI: 对应电池耗尽,内存读取错误等严重事件,需要立即处理,称为不可屏蔽中断
- INTR: 对应键盘输入等不着急处理的中断信号,称为可屏蔽中断
我们使用中断号来区分不同类型的中断信号,对于不可屏蔽中断,我们使用固定的中断号2,然后再由特定的软件来进行分别的处理;对于可屏蔽中断,由于可能会同时发生多个,所以需要用多个中断号来区分,Intel处理器中用8259芯片来处理(或者说缓存)这些中断.
时钟
ICH(I/O Controller Hub)芯片用于处理所有的I/O,内置了实时时钟电路(Real Time Clock,RTC)和两 小块由互补金属氧化物(CMOS)材料组成的静态存储器(CMOS RAM).
RTS的频率为1秒,用于显示电脑的时间,而日期和时间信息保存在 CMOS RAM 中,通常有 128 字节,而日期和时间信息只占了一小部分容量,其他空间则用于保存整机的配置信息,比如各种硬件的类型和工作参数、开机密码和辅助存储设备的启动顺序等
保护模式
32位x86处理器架构
32位处理器扩展了8086中8个通用寄存器的长度,用一个前缀E来表示,如eax,ebx等:
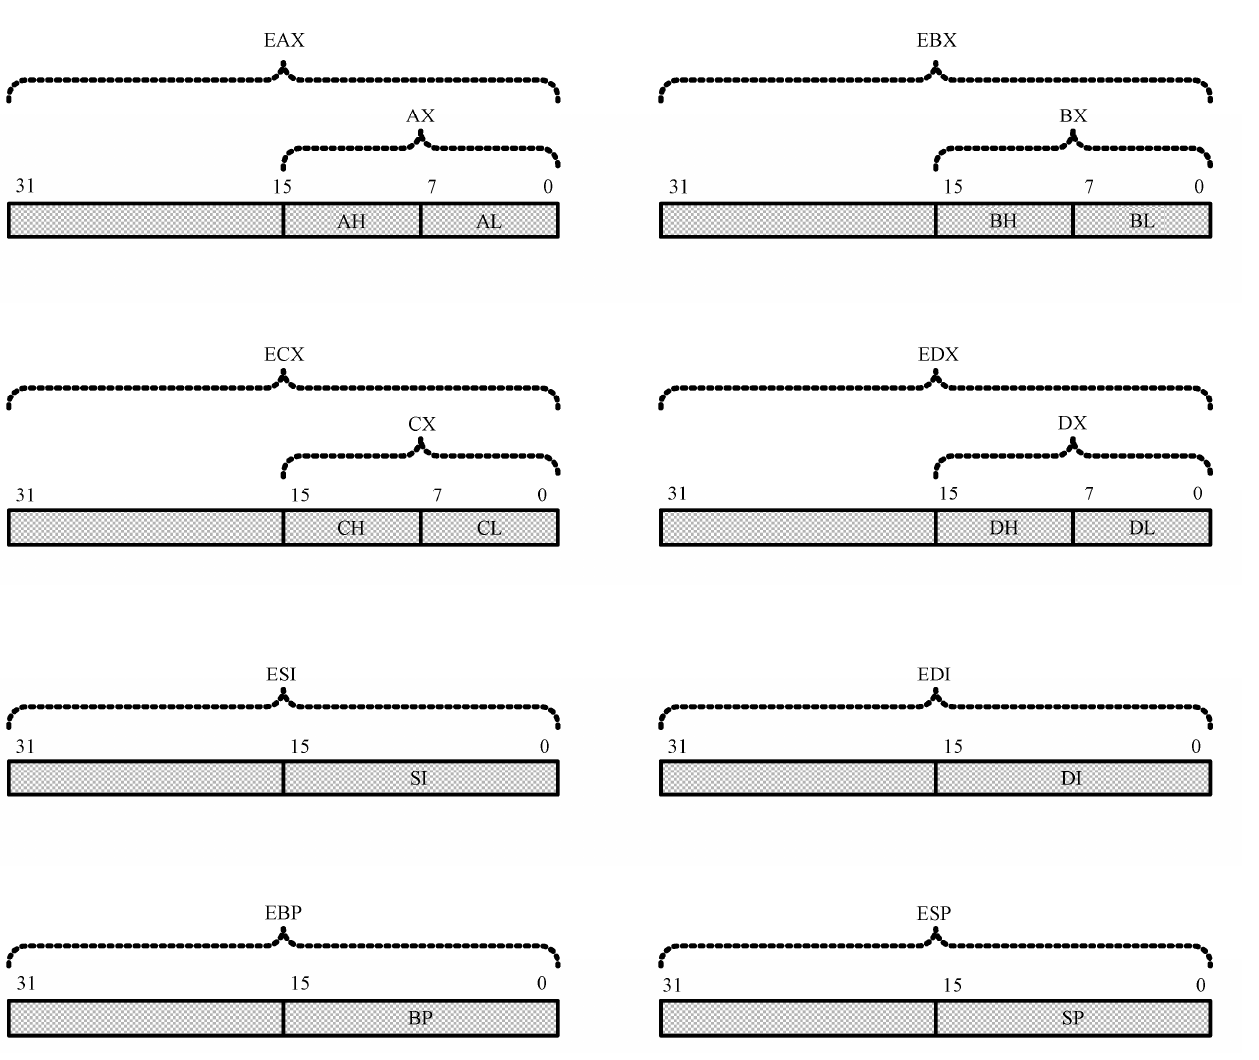
低16位可以兼容16位处理器上的软件,而高16位则作为32位模式下的扩展.
- 其余的部件也都进行了从16位到32位的扩展
保护模式介绍
一般来说,操作系统负责整个计算机软、硬件的管理,它做任何事情都是可以的。但是,用户程序却应当有所限制,只允许它访问属于自己的数据,即使是转移,也只允许在自己的各个代码段之间进行。
- 实模式: Real Mode,用户程序可以绕过操作系统,随意访问内存并进行修改
- 保护模式: Protected Mode,用户程序无法访问不属于自己的内存
全局描述符表(GDT)
全局描述符表用于存储所有要用到的段的描述符,应用程序运行时,由操作系统在GDT中分配,任何试图访问其他不属于自己的段的行为都会被处理器阻止.
每个段描述符为8字节,对应64位:
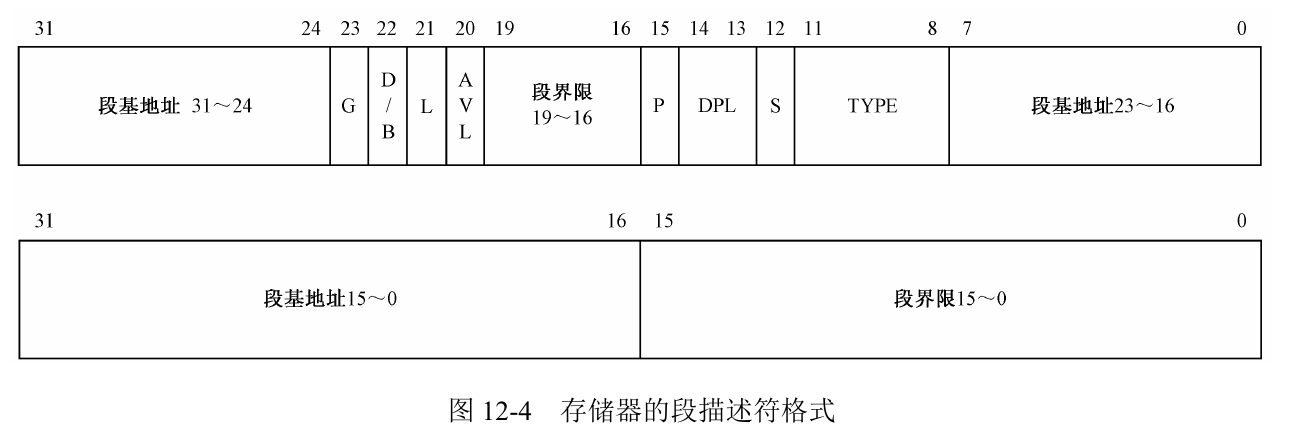
DPL 表示描述符的特权级(Descriptor Privilege Level,DPL)。共有 4 种处理器支持的特权 级别,分别是 0、1、2、3,其中 0 是最高特权级别,3 是最低特权级别。
在这里,描述符的特权级用于指定要访问该段所必须具有的最低特权级。 如果这里的数值是 2,那么,只有特权级别为 0、1 和 2 的程序才能访问该段, 而特权级为 3 的程序访问该段时,处理器会予以阻止。
x86指令集
x86 处理器的机器指令大体上可由五大部分组成:
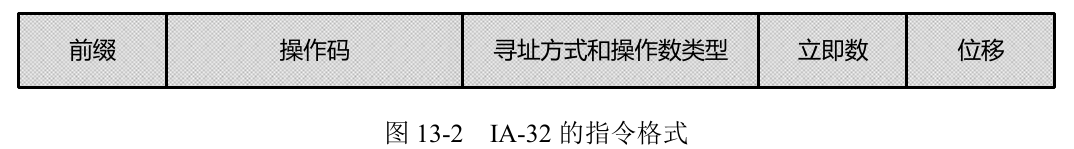
分页机制
从80386处理器开始,引入了分页机制,用长度固定的页来代替长度不一的段,从而更好地管理内存空间
处理器处理的都是段,编译时分配的也都是段表,并没有页的概念,需要由操作系统建立从段到页的映射,再由处理器来执行转换和取页操作.
由于早期内存容量不足的问题,内存中没办法一下子装入所有的映射,80386采用了使用多个页表来进行映射:
每个进程都有自己的页目录和页表,所以当进程切换时,页目录和页表也会进行切换,所以,这就是进程切换开销最大的地方吧.
总结
非常不错的书呢,不过实战的部分由于不太可能复刻,所以都直接跳过了,但收获是很大的,姑且能看懂一点汇编代码了吧.
On Java 8(待补充)
- 出版于2017年(在线原版),作者:Bruce Eckel。
- 中文翻译版链接
Agent
AI Engineering Building Applications with Foundation Models
- 出版于2025年,出版商:O’Reilly,作者:Chip Huyen。
不推荐阅读,读起来有一种受骗上当的感觉…
Build AI-Enhanced Web Apps
- 出版于2026年,出版商:Manning,作者:Theo Despoudis。
- 拉完了
Deep Learning from Scratch
- 出版于2016年(日文原版;中文版2018年),出版商:O’Reilly,作者:斋藤康毅。
- pdf链接 如前所说,阅读« Transformers快速入门 »的前提是要搞懂神经网络是什么,于是我辗转找到了这本享有盛名的书,希望能够彻底理解神经网络的概念
感知机(perceptron)
感知机是一个类似于电路节点的模型,它接收多个输入信号,输出一个信号,该信号只有两个值: 0和1,0对应不传递信号,1对应传递信号.
如图:x1和x2是输入信号,被送往y节点时会分别乘以权重(weight),w1和w2,y节点会计算w1x1+w2x2的结果,当总和超过某个界限值时,才会输出1,这也被称为神经元激活.我们将这个界限值称为阈值,用θ表示.
数学公式表示:
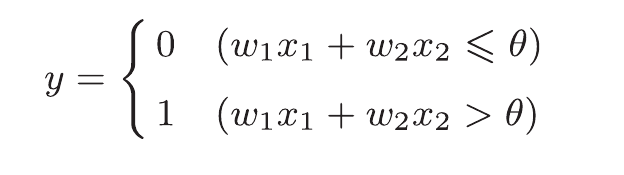
但我们可以把阈值与总和移到同一侧:
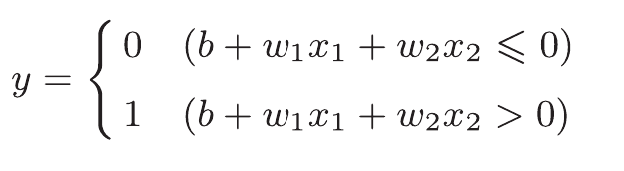
这里的b就是-θ,被称为偏置(bias),决定了神经元被激活的容易程度.
显然,单层感知机是一个线性数学模型,它无法处理非线性空间:
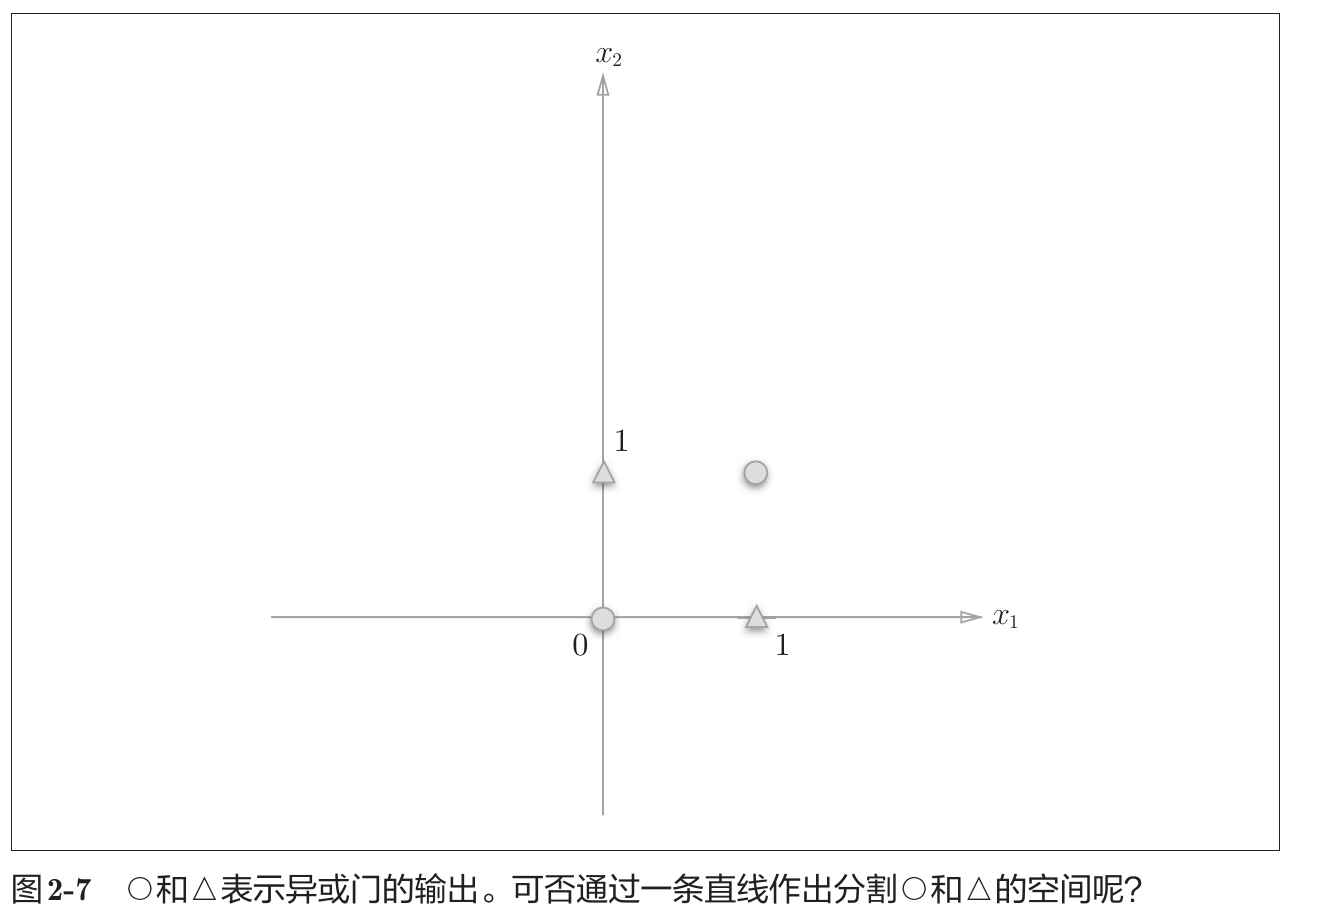
因此,我们可以使用多层感知机的叠加来实现非线性模型
多层感知机
为了实现异或电路,我们可以这样写:
| |
对应的图像为:
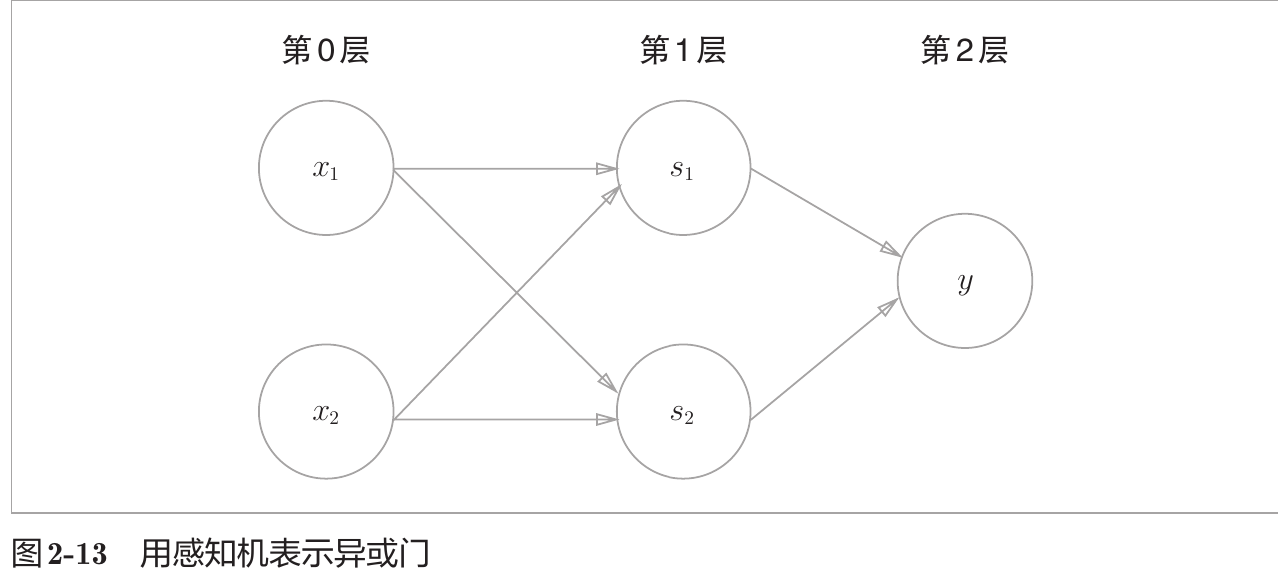
我们将最左边的一列称为第0层,中间一列称为第1层,最右边一列称为第2层,这也就是多层感知机(multi-layered perceptron).
神经网络
从感知机到神经网络
我们之前的多层感知机结构可以再优化一下,将偏置b也作为输入参数:
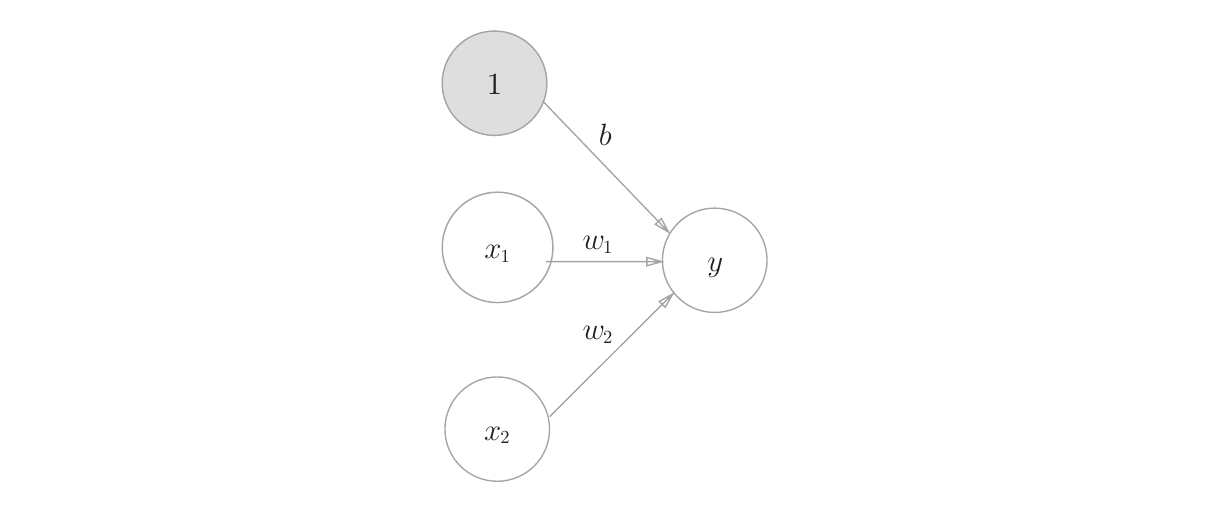
并且,由于分段函数不太好看,我们可以将上述式子,改写成下面的两个式子:
$$y = h(b + w_1x_1 + w_2x_2)$$$$h(x) = \begin{cases} 0 & (x \le 0) \\ 1 & (x > 0) \end{cases}$$这个h(x)函数会将输入信号的总和转换成输出信号,它被称为激活函数(activation function).
如果我们把总和(add)称为a的话,就可以这样画图:
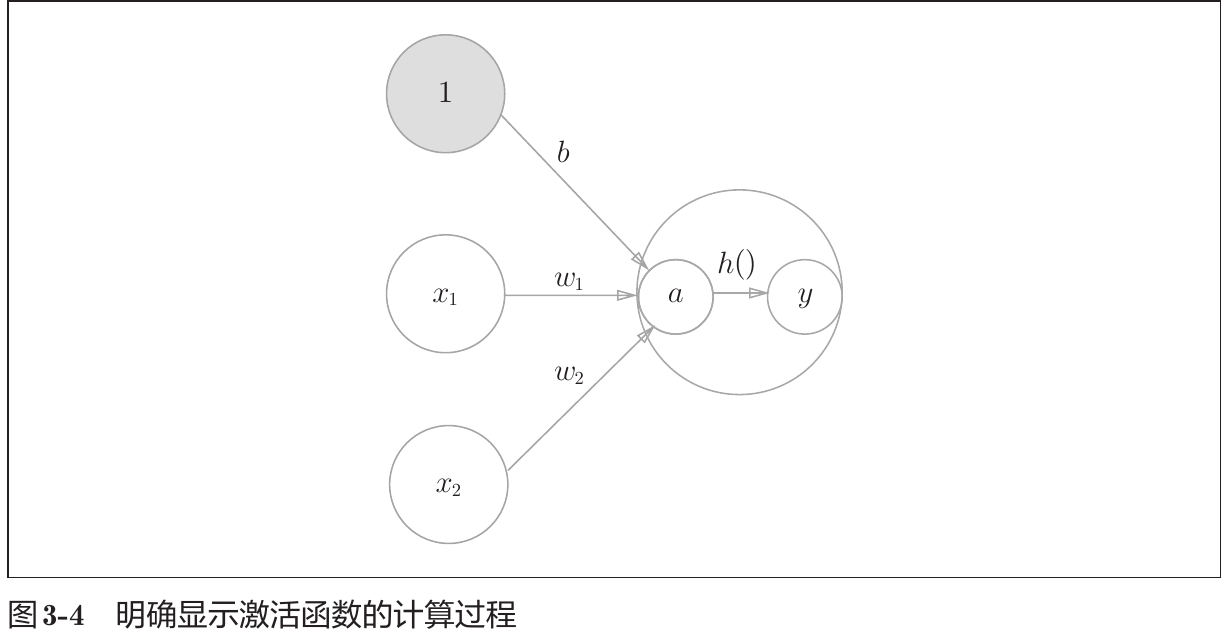
这就得到了我们的神经网络,我们把最左边的一列称为 输入层,最右边的一列称为输出层,中间列全部称为中间层:
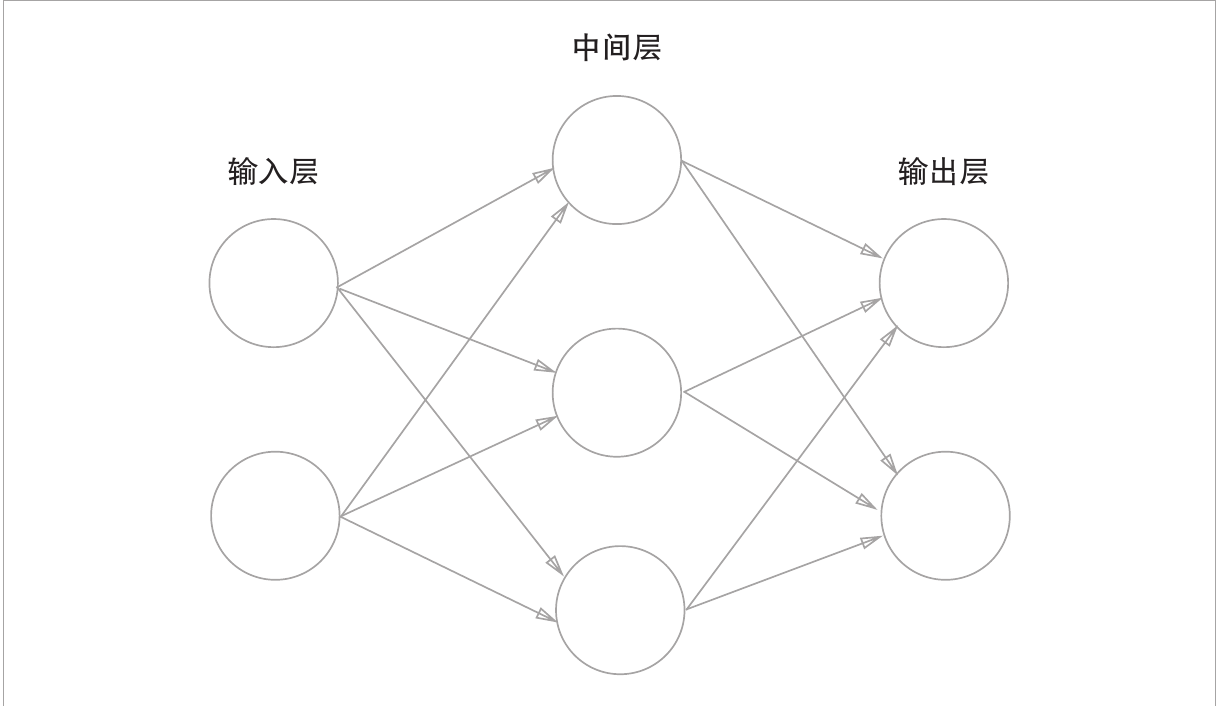
激活函数
$$h(x) = \begin{cases} 0 & (x \le 0) \\ 1 & (x > 0) \end{cases}$$由于上述的阶跃函数太过单调,不具有可操控性,在神经网络中我们通常采用一些非线性的,更复杂的激活函数.
- 之所以不用线性的,是因为多层的线性函数叠加总可以被单层的线性函数所替代.(例如a^3=a * a * a)
sigmoid函数
该函数是神经网络的常用激活函数:
$$h(x) = \frac{1}{1 + e^{-x}}$$效果如下,非常平滑:
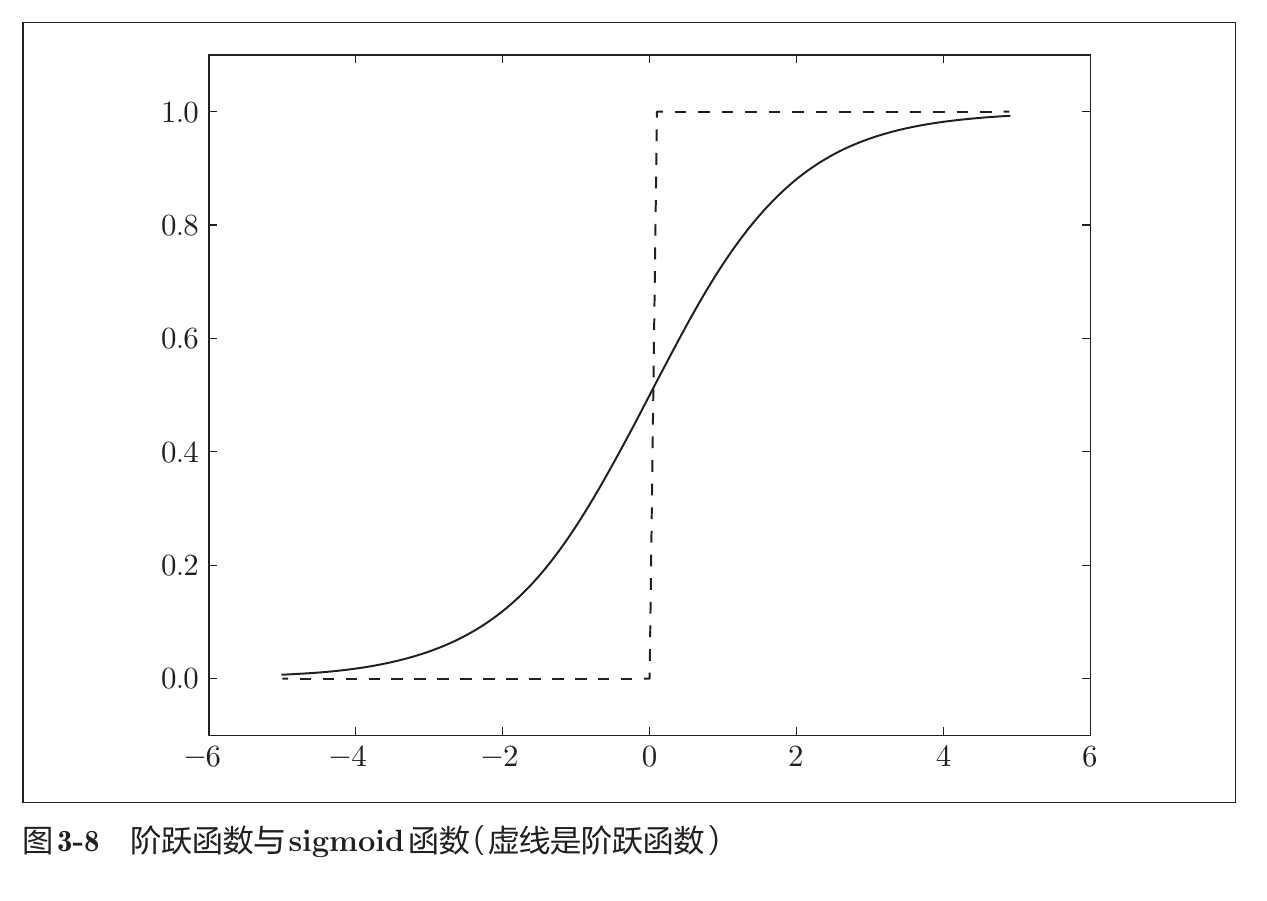
ReLU函数
ReLU,全称为Rectified Linear Unit,比起sigmoid函数更为简单:
$$h(x) = \max(0, x)$$写成分段函数形式更为清晰一点:
$$h(x) = \begin{cases} x & (x > 0) \\ 0 & (x \le 0) \end{cases}$$它有以下特性:
- 线性增长:当输入 $x$ 大于 0 时,直接输出 $x$,没有任何梯度消失问题。
- 单侧抑制:当输入 $x$ 小于等于 0 时,输出硬性截断为 0,使神经元进入“休眠”状态
用矩阵来表示神经网络
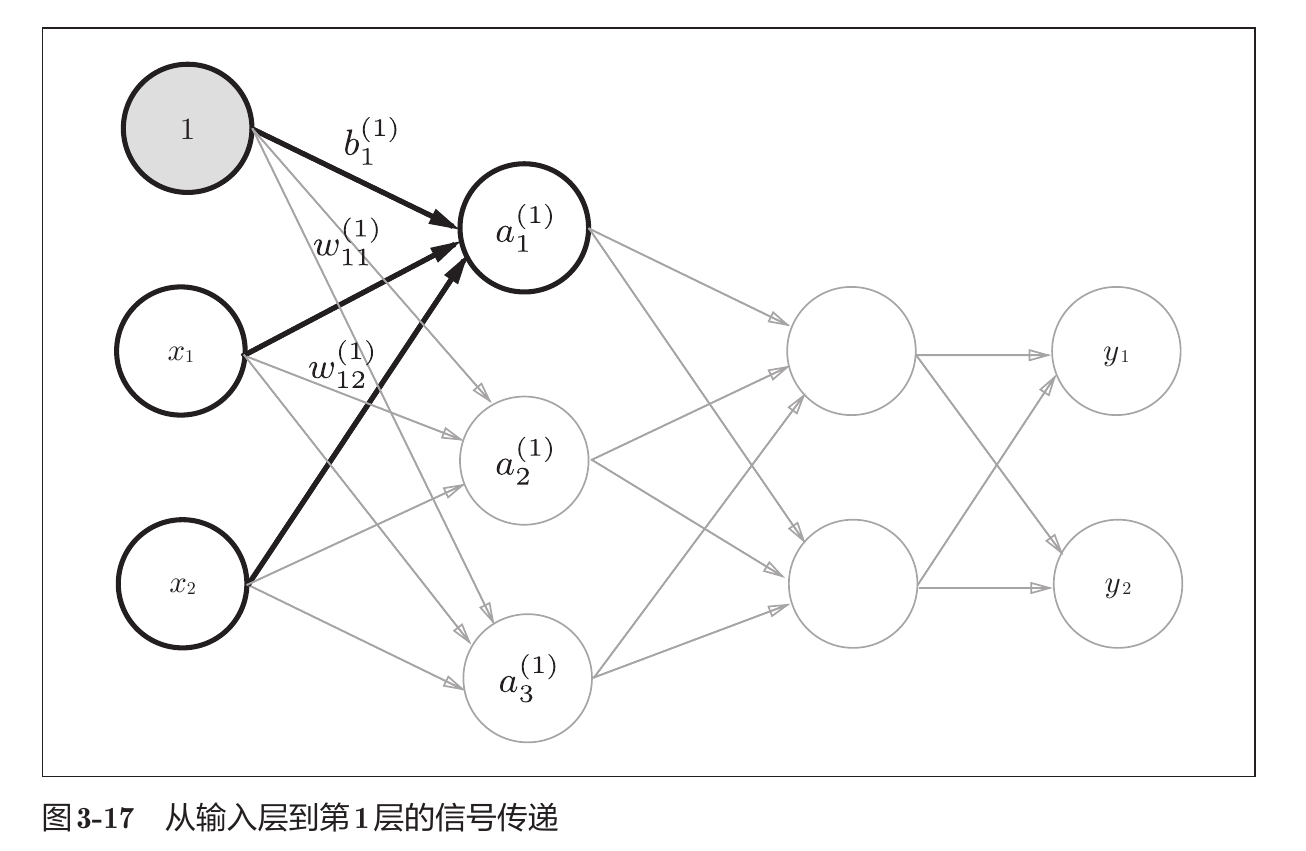
由于用普通的乘法运算来表示神经网络过于麻烦,所以我们引入了矩阵运算:
$$\boldsymbol{A}^{(1)} = \boldsymbol{X}\boldsymbol{W}^{(1)} + \boldsymbol{B}^{(1)}$$其中的几个符号定义如下:
$$\boldsymbol{A}^{(1)} = \begin{pmatrix} a_1^{(1)} & a_2^{(1)} & a_3^{(1)} \end{pmatrix}$$$$\boldsymbol{X} = \begin{pmatrix} x_1 & x_2 \end{pmatrix}$$$$\boldsymbol{B}^{(1)} = \begin{pmatrix} b_1^{(1)} & b_2^{(1)} & b_3^{(1)} \end{pmatrix}$$$$\boldsymbol{W}^{(1)} = \begin{pmatrix} w_{11}^{(1)} & w_{21}^{(1)} & w_{31}^{(1)} \\ w_{12}^{(1)} & w_{22}^{(1)} & w_{32}^{(1)} \end{pmatrix}$$输出层的处理
对于输出层,我们单独把它的激活函数用σ()来表示,用于重点标明它的特殊性.因为根据不同的应用场景我们需要采用不同的输出层激活函数,而中间层的激活函数通常是不用变的.一般来说,回归问题用恒等函数,分类问题用softmax函数.
- 在学习过程中和实际部署时,我们可以随时替换输出层,从而实现不同的任务目标.
恒等函数很好理解,将所有输入原样输出,不做任何处理,重点需要理解的是softmax函数
softmax函数
其公式如下:
$$y_k = \frac{\exp(a_k)}{\sum_{i=1}^{n} \exp(a_i)}$$- 可以看到,对于每一个输出信号,softmax函数都考虑了所有的输入信号,并通过指数函数进行平滑化处理
- softmax函数的输出值总和为1,所以我们可以将softmax函数的输出解释为概率
由于当输入信号过大时会导致指数爆炸,使用计算机程序计算softmax函数的结果时会发生数据溢出,所以我们需要对上式做一些加工:
$$y_k = \frac{\exp(a_k)}{\sum_{i=1}^{n} \exp(a_i)} = \frac{C \exp(a_k)}{C \sum_{i=1}^{n} \exp(a_i)}$$$$= \frac{\exp(a_k + \log C)}{\sum_{i=1}^{n} \exp(a_i + \log C)}$$$$= \frac{\exp(a_k + C')}{\sum_{i=1}^{n} \exp(a_i + C')}$$上述的推导有一个奇怪的地方,本来应该是lnC,却被写成了logC,我四处搜寻答案找到一条比较合理的解答:
上述的式子说明,在进行softmax计算时,加上或者减去某个常数并不会改变运算的结果,所以我们可以通过减去输入信号中的最大值来防止溢出.
神经网络的学习
实际的神经网络中有成千上万甚至几千亿的权重参数,想要人工一个个处理标注这些参数是不可能的,因此我们需要让神经网络自己学习如何设置这些参数.
机器学习中,我们将数据分成训练数据和测试数据两部分,才可以正确评价模型的泛化能力(即处理新数据的能力),并确保不出现过拟合(over fitting),训练数据也被称为监督数据.
损失函数(loss function)
神经网络以某个指标为线索寻找最优的权重参数,该指标被称为损失函数,一般使用均方误差和交叉熵误差来计算.
我们通常将正确解的参数表示为1,其他解的参数表示为0,这被称为 one-hot 表示,例如:
| |
这里的t只给正确解标注了1,其他解都标注为0.
均方误差
均方误差公式如下所示:
$$E = \frac{1}{2} \sum_{k} (y_k - t_k)^2$$- $y_k$: 神经网络的输出
- $t_k$: 监督数据
- $k$: 数据的维数
均方误差会计算神经网络的输出和监督数据的各个元素之差的平方和
交叉熵误差(cross entropy error)
交叉熵误差公式如下:
$$E = -\sum_{k} t_k \log y_k$$这里,$\log$ 表示以 $\text{e}$ 为底数的自然对数 ($\log_{\text{e}}$)。$y_k$ 是神经网络的输出,$t_k$ 是正确解标签。并且,$t_k$ 中只有正确解标签的索引为 1,其他均为 0(one-hot 表示)。
因此,上式实际上只计算正确解标签的输出的自然对数而已.
由于输出值$y_k$的取值范围为0-1,那么当它越接近1时,神经网络的交叉熵就越接近0,代表误差越小;当它越接近0时,神经网络的交叉熵就越接近正无穷,代表误差越大.
mini-batch(小批量)学习
计算损失函数时,我们需要把所有的训练数据都考虑进去,如果训练数据有一百组,就要计算这一百组损失函数的总和,尽量让他变小:
$$E = -\frac{1}{N} \sum_{n} \sum_{k} t_{nk} \log y_{nk}$$这里,假设数据有 $N$ 个,$t_{nk}$ 表示第 $n$ 个数据的第 $k$ 个元素的值($y_{nk}$ 是神经网络的输出,$t_{nk}$ 是监督数据)。
当数据过多时,直接选取所有数据计算总和是不太合理的,比如说有60000个数据,我们从中随机选取100个,再用这100个数据来学习,这被称为mini-batch学习.
梯度法
这里需要注意的是,梯度表示的是各点处的函数值减小最多的方向。因此, 无法保证梯度所指的方向就是函数的最小值或者真正应该前进的方向。实际 上,在复杂的函数中,梯度指示的方向基本上都不是函数值最小处。
梯度法的定义
- 梯度法: 不断沿着梯度方向前进,逐渐减小函数值.
- 该方法经常被用在神经网络的学习中.
数学表示如下:
$$ \begin{aligned} x_0 &= x_0 - \eta \frac{\partial f}{\partial x_0} \\ x_1 &= x_1 - \eta \frac{\partial f}{\partial x_1} \end{aligned} $$式子中的η表示更新量,在神经网络中被称为学习率(learning rate),决定了在一次学习中应该学习多少,以及在多大程度上更新参数.
学习率需要通过试验得到一个合理的值,如果学习率过大,则容易错过最优解;学习率过小的话,更新幅度会很小,需要经过更久的循环运算.
在神经网络中运用梯度法
对于一个形状为2X3的权重W的神经网络,损失函数用L表示,那么梯度可以表示成L对W中各个参数的偏导数:
$$ \begin{aligned} \boldsymbol{W} &= \begin{pmatrix} w_{11} & w_{12} & w_{13} \\ w_{21} & w_{22} & w_{23} \end{pmatrix} \\ \frac{\partial L}{\partial \boldsymbol{W}} &= \begin{pmatrix} \frac{\partial L}{\partial w_{11}} & \frac{\partial L}{\partial w_{12}} & \frac{\partial L}{\partial w_{13}} \\ \frac{\partial L}{\partial w_{21}} & \frac{\partial L}{\partial w_{22}} & \frac{\partial L}{\partial w_{23}} \end{pmatrix} \end{aligned} $$误差反向传播法
- 我们可以通过数学公式和计算图两种方式来理解反向传播
在看前面的文章时我就想到了,单纯的梯度下降法只能够处理一层参数,再加上输出层的σ()函数,怎么说也只可以实现一个简单的2层神经网络.但实际上的神经网络都是成千上万层的,那这些参数又是如何调试的呢?这就用到了反向传播
计算图
计算图的引入
上图即为计算图: 通过节点和箭头表示计算过程,节点用⚪表示,⚪中是计算的内容,计算的中间结果写在箭头上方.
我们可以只把运算符写在⚪中,将具体的变量数提出来放在外面:
一个更为复杂的问题求解,但还是很好理解:
链式法则与反向传播
反向传播的通俗理解:
将对损失函数的贡献度通过输出层一步步回传至输入层,计算出各层的权重参数对该次训练结果误差的贡献,并让权重参数针对自身的贡献进行大小上的调整.
- 具体原理则是通过导数的乘积和加减实现.
加法原样传递参数
乘法交叉传递导数
实战
| |
优化神经网络的学习
参数的更新
在前面几章,为了找到最优参数,我们不断沿着梯度方向更新参数,并重复多次,从而逐渐靠近最优参数,这被称为随机梯度下降法(stochastic gradient descent,SGD),公式如下:
$$\boldsymbol{W} \leftarrow \boldsymbol{W}-\eta \frac{\partial L}{\partial \boldsymbol{W}}$$
由于梯度的方向未必是最小值的方向,所以SGD很多时候的效率比较低,因此我们又有Momentum,AdaGrad,Adam三种方法来代替SGD.
Momentum(动量法)
$$\begin{aligned} \boldsymbol{v} & \leftarrow \alpha \boldsymbol{v}-\eta \frac{\partial L}{\partial \boldsymbol{W}} \\ \boldsymbol{W} & \leftarrow \boldsymbol{W}+\boldsymbol{v} \end{aligned}$$通过α我们能够更精细的调整增量的大小,效果如下:
如果不好理解的话,我们可以结合物理学知识来看:
- $\alpha \boldsymbol{v}$: 惯性项,保留一部分上次的速度,通常取0.9等小于1的值
- $\eta \frac{\partial L}{\partial \boldsymbol{W}}$: 冲量,当前的梯度更新方向
通过保留之前的一部分动量,动量法能够让函数更加平稳地前进,而不至于忽上忽下.
AdaGrad
在神经网络学习中有一种技巧:
随着学习进行,不断减小学习率,即一开始多学,后面逐渐少学,从而降低了整体参数的学习率.
AdaGrad(Adaptive Grad)进一步发展了该想法,针对每个参数都适当地调整学习率,公式如下:
$$\begin{aligned} \boldsymbol{h} & \leftarrow \boldsymbol{h}+\frac{\partial L}{\partial \boldsymbol{W}} \odot \frac{\partial L}{\partial \boldsymbol{W}} \\ \boldsymbol{W} & \leftarrow \boldsymbol{W}-\eta \frac{1}{\sqrt{\boldsymbol{h}}} \frac{\partial L}{\partial \boldsymbol{W}} \end{aligned}$$- $\odot$ 表示Hadamard积,也被称为逐元素乘法,即对于两个维度相同的矩阵或者向量,对应位置的元素直接相乘,而不需要进行行列求和,换句话说这里其实在计算每一个参数各自梯度的平方.
这里新引入了变量h,如果元素的梯度越大,学习率就会越小,反过来则是会大幅度增加学习率,效果如下:
- 变量h实际上会记录过去所有梯度的平方和,所以会一直增大,学习越深入,更新幅度就会越小.
补充: Adam
2017年提出的Transformer即采用了2015年提出的Adam方法进行训练,所以需要重点了解,书上几乎没怎么介绍它,因此要在这里补充一下.
Adam结合了Momentum和AdaGrad两种方法,具体原理如下:
1. 计算梯度 在当前时间步 $t$,计算损失函数对参数 $\boldsymbol{W}$ 的随机梯度:
$$\boldsymbol{g}_t \leftarrow \nabla_{\boldsymbol{W}} L(\boldsymbol{W}_{t-1})$$- 之前的偏导数写法不够正式,故这里从整体上写成梯度了,原理是一样的 2. 更新一阶矩估计(动量项) 利用指数移动平均(EMA)计算梯度的平均值: $$\boldsymbol{m}_t \leftarrow \beta_1 \boldsymbol{m}_{t-1} + (1 - \beta_1) \boldsymbol{g}_t$$
- 物理意义:代表梯度的“方向”和“惯性”。
- 超参数:$\beta_1$ 通常设为 0.9。
这里的β就是动量法中的α,m实质上就是动量法中的速度,但这次我们对冲量的修饰不再使用学习率η,而是用
1-β.
3. 更新二阶矩估计(环境自适应项) 计算梯度平方的指数移动平均:
$$\boldsymbol{v}_t \leftarrow \beta_2 \boldsymbol{v}_{t-1} + (1 - \beta_2) (\boldsymbol{g}_t \odot \boldsymbol{g}_t)$$- 物理意义:代表梯度的“波动剧烈程度”。若 $\boldsymbol{v}_t$ 很大,说明该参数更新频繁且震荡剧烈。
- 超参数:$\beta_2$ 通常设为 0.999。
这里实际上就是对AdaGrad的参数修正,梯度的作用被大幅度削弱了:
$$\boldsymbol{h} \leftarrow \boldsymbol{h}+\frac{\partial L}{\partial \boldsymbol{W}} \odot \frac{\partial L}{\partial \boldsymbol{W}}$$4. 偏差修正(Bias Correction) 由于 $\boldsymbol{m}$ 和 $\boldsymbol{v}$ 初始化为零向量,在训练初期其估计值会严重偏向零。通过以下公式消除偏差:
$$\hat{\boldsymbol{m}}_t \leftarrow \frac{\boldsymbol{m}_t}{1 - \beta_1^t}$$$$\hat{\boldsymbol{v}}_t \leftarrow \frac{\boldsymbol{v}_t}{1 - \beta_2^t}$$这里的t即为t次方,故随着训练次数增多,削弱幅度会逐渐增大,从而保证参数不会剧烈震荡. 5. 参数更新 利用修正后的矩估计调整参数:
$$\boldsymbol{W}_t \leftarrow \boldsymbol{W}_{t-1} - \eta \frac{\hat{\boldsymbol{m}}_t}{\sqrt{\hat{\boldsymbol{v}}_t} + \epsilon}$$
- $\eta$:学习率。
- $\epsilon$:数值稳定项。
这里实际上就是把魔改后的参数缝合到了AdaGrad公式中:
$$\boldsymbol{W} \leftarrow \boldsymbol{W}-\eta \frac{1}{\sqrt{\boldsymbol{h}}} \frac{\partial L}{\partial \boldsymbol{W}}$$Adam有以下机制:
- 自适应步长:当某个参数的梯度很大时,分母中的 $\sqrt{\hat{\boldsymbol{v}}_t}$ 也会变大,从而调小步长;反之,梯度极小的参数会获得更大的步长。
- 消除震荡:分子中的 $\hat{\boldsymbol{m}}_t$ 保留了历史方向,抵消了随机噪声。
- 显然,这种丑陋且复杂的调参是研究者经过了多次实验才发明出来的,意外的极其有效,所以才一战成名.但具体原理是什么,谁也说不清楚.
2019年又提出了改进的AdamW算法,是BERT,GPT,Llama等Transformer模型的核心算法,就不具体分析了.
- 可以看到这些算法的本质并不多么高深,但总有些营销号喜欢把简单的事情复杂化…
权重的初始值
可以设定为0吗
在误差方向传播法中,如果将所有权重的初始值设定为0,那么所有的权重都会被更新成相同的值,这显然是不理想的,所以我们需要随机生成初始值.
标准初始值
对于sigmoid/tanh激活函数,推荐的各层权重的初始参数符合标准差为$\frac{1}{\sqrt{n}}$的正态分布,这被称为Xavier 初始值,公式如下:
$$w \sim \mathcal{N}\left(0, \frac{1}{n}\right)$$n为前一层的节点数,那么如果前一层的节点数越多,当前的初始权重分布就会越靠近0,即绝对值会越小.
对于ReLU等非线性激活函数来说,推荐使用He 初始值,它同样也是正态分布,但标准差是Xavier 初始值的根号二倍:
$$w \sim \mathcal{N}\left(0, \frac{2}{n}\right)$$- 之所以用2倍的系数,是因为ReLU的负值区域的值为0,需要让它更有广度一点.
batch normalization
batch normalization于2015年提出,由于可以加速学习和抑制过拟合,被广泛使用在机器学习中.
该方法实质上是在隐藏层前加了一个数据处理层,使用四步将mini batch(小批量样本)中的输入数据正规化成标准正态分布:
$$\mu_{B} \leftarrow \frac{1}{m} \sum_{i=1}^{m} x_{i}$$$$\sigma_{B}^{2} \leftarrow \frac{1}{m} \sum_{i=1}^{m}\left(x_{i}-\mu_{B}\right)^{2}$$$$\hat{x}_{i} \leftarrow \frac{x_{i}-\mu_{B}}{\sqrt{\sigma_{B}^{2}+\varepsilon}}$$最后一步则是用两个参数来修饰正规化后的数据:
$$y_{i} \leftarrow \gamma \hat{x}_{i} + \beta$$- 一开始,γ=1,β=0,后续再通过学习调整到合适的值.
正则化
过拟合
两种情况下会发生过拟合:
- 模型参数过多,表现力强
- 训练数据少
我们有两种方法来抑制过拟合: 权值衰减和Dropout
权值衰减
由于很多过拟合是在权重参数取值过大时才出现的,该方法通过在学习的过程中对大权重进行惩罚,来抑制过拟合.
复习一下,神经网络的学习目的是减小损失函数的值。这时,例如为损失函数加上权重的平方范数(L2 范数)。这样一来,就可以抑制权重变大。用符号表示的话,如果将权重记为 $W$,L2 范数的权值衰减就是 $\frac{1}{2}\lambda W^2$,然后将这个 $\frac{1}{2}\lambda W^2$ 加到损失函数上。这里,$\lambda$ 是控制正则化强度的超参数。$\lambda$ 设置得越大,对大的权重施加的惩罚就越重。此外,$\frac{1}{2}\lambda W^2$ 开头的 $\frac{1}{2}$ 是用于将 $\frac{1}{2}\lambda W^2$ 的求导结果变成 $\lambda W$ 的调整用常量。
自然,我们在反向传播的时候在损失函数中加上$\lambda W$即可实现权值衰减,但在求梯度偏导的时候,对于某一层而言,只有该层的参数会被计入计算,而其他层的参数都被视为常数,因此异常的权重参数不会将影响扩大至其他层.
Dropout
如果神经网络的复杂度比较高,只用权值衰减是不够的,还需要使用Dropout方法.
Dropout会在学习的过程中随机删除神经元,具体原理是:
- 训练时,每传递一次数据,就随机选择要删除的神经元
- 测试时,虽然会传递所有的神经元信号,但对于各个神经元的输出,要乘上训练时的删除比例.
代码如下:
| |
实验效果如下:
- 成功地抑制了过拟合,并且减小了训练数据和测试数据的识别精度差距
超参数的调整
- 超参数(hyper-parameter): 各层的神经元数量,batch大小,学习率和权值衰减率等参数.权重和偏置等则是普通参数.
调整和评估超参数时,我们不能使用测试数据,因为这样一来超参数就会对测试数据发生过拟合,从而严重影响测试效果.
所以我们要再拿一批数据作为验证数据(validation data).
超参数的最优化
我们可以这么做:
- 先大致设定一个范围,从这个范围中随机选出一个超参数,用它来评估识别精度
- 多次重复步骤1,逐渐缩小超参数的范围
- 缩小到一定程度时,从中选出一个超参数的值.
卷积神经网络
- 久闻卷积神经网络的大名,终于见到本人了
整体结构
之前的神经网络中,相邻层的所有神经元之间都有连接,这被称为全连接:
而卷积神经网络(CNN)中新增了Convolution层(卷积层)和Pooling层(池化层):
卷积层
全连接层的问题
全连接层存在一个问题: 忽视了数据的形状.例如,输入数据是图像时,图像通常是长,宽,通道方向上的三维形状.但是全连接层输入时,需要将3维数据拉平为1维数据,否则根本无法进行输入.
- 比如前面的MNIST数据集,输入的图像是1通道,长28像素,宽28像素的形状,却被排成了1列,以784个数据的形式进入了初始层.
而卷积层可以保持输入数据的形状不变,我们将卷积层的输入输出数据称为特征图(feature map).
卷积运算
卷积运算即对输入的数据使用滤波器,对应元素两两直接相乘后相加,将和放到对应坐标位置:
加上偏置时是对输出数据的每一位都加上偏置:
填充
为了调整输出的大小,我们可以在输入数据的周围填充固定数据(如0或者1),从而扩充输出数据的维度:
- 如果我们不进行填充,那么输出数据的维度将越变越小,直到变成一维,那就失去卷积运算的意义了.
步幅
应用滤波器的位置间隔称为步幅(stride),先前的例子中步幅为1,如果将步幅设置为2,则是这样的:
3维数据的卷积运算
先前的例子中的数据都是二维的,如果输入一个三维的图像数据,就需要针对每一个输入的二维图形设置单独的滤波器,将多个二维图形的结果加起来作为输出数据:
池化层
池化(pooling)是缩小长宽方向上空间的运算,常用的max池化会取输入数据中的最大值:
但是池化运算是针对每个通道单独进行处理的,所以不会缩小维度:
补充: 卷积神经网络的反向传播
非常离谱的是,文章没有提到卷积层和池化层是怎么进行反向传播的,但这却是非常重要的一个环节.
池化层的反向传播比较好处理,如果是max池化的话,直接将梯度传回最大值所在的位置即可,其他位置的梯度填充为0;如果是平均池化,那么就要对梯度进行均摊,例如: $2 \times 2$ 的平均池化,梯度值为 $g$,则回传给前层该区域的 4 个点每个点都是 $g/4$.
卷积层的反向传播就很复杂了,需要对当前层的梯度矩阵进行填充后,与卷积核(即前文所说的滤波器)再次进行卷积,与乘法的反向传播是交换导数类似,卷积核需要旋转180度再与梯度相乘,然后将误差传递给卷积层.
CNN的种类
本书主要介绍1998年提出的元祖LeNet和2012年提出的新秀AlexNet.
LeNet
Lenet使用子采样(subsampling)来缩小中间数据的大小,而不像现在使用Max池化,但其他的结构与现在的CNN差别不大.
AlexNet
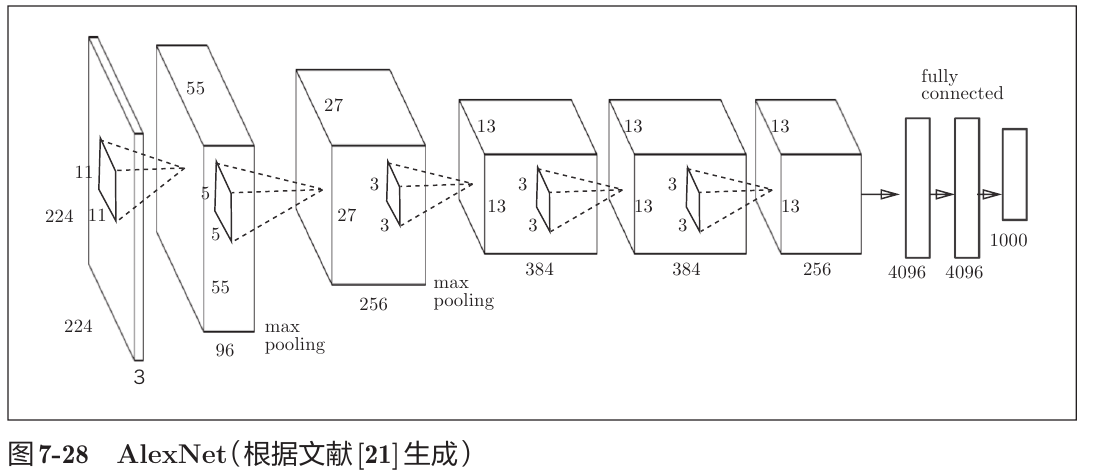
大致结构与LeNet没有什么差别,只是引入了ReLU作为激活函数,使用Dropout用来正则化参数.
深度学习
深度学习本质上就是加深了网络层数的神经网络学习.
加深网络
加深网络的好处如下:
- 通过多层卷积层运算,可以使用更少的参数实现同样甚至更优的效果
- 减少学习数据,实现更高效的学习
深度学习的高速化
深度学习中的大部分时间到耗费在卷积层上:
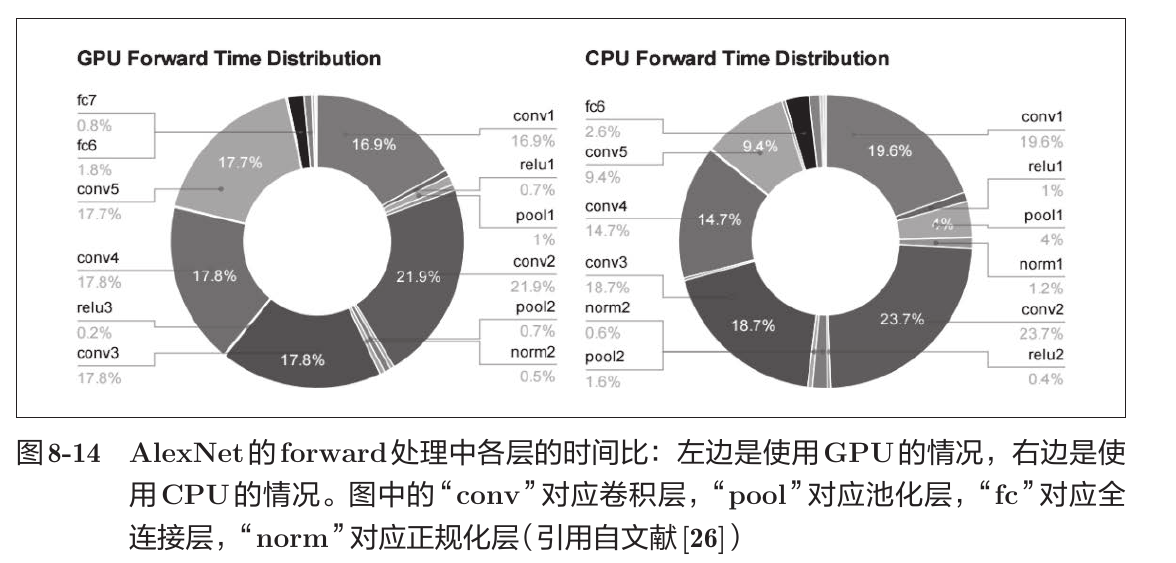
如前所说,卷积计算需要将卷积核与输入数据逐个相乘,完全可以拆分成并行计算后再将结果相加,这恰恰是GPU最擅长的地方.
如果要进一步加速的话,可以使用多个GPU或者多个机器进行学习,这被称为分布式学习:
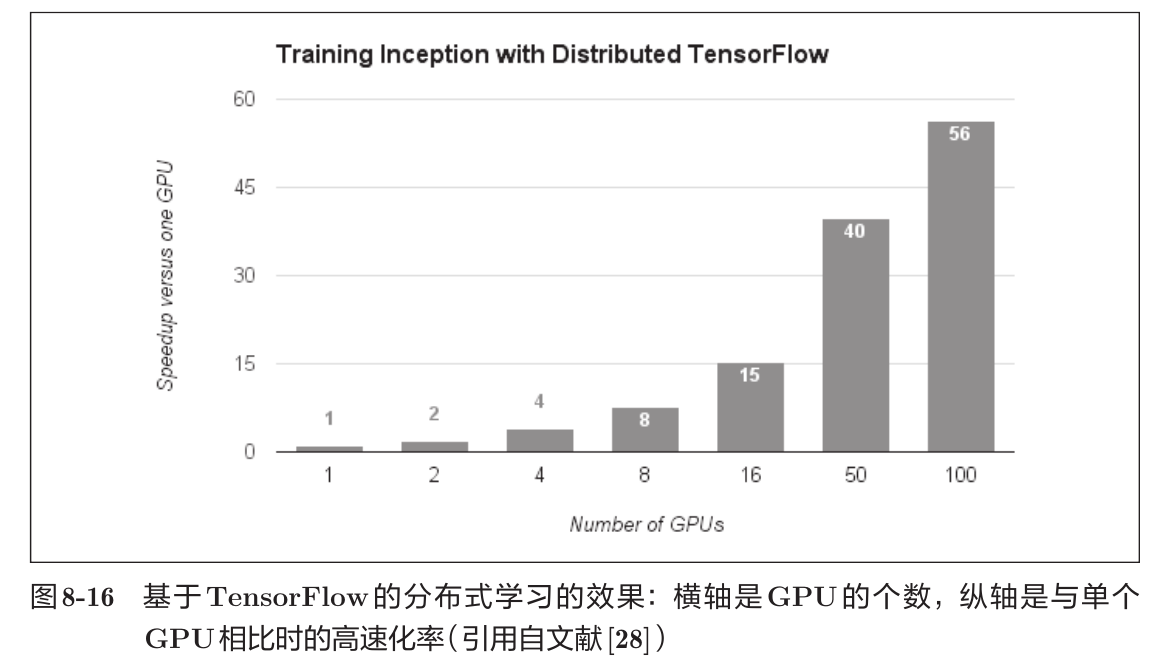
显然这就是为什么如今的AI模型回答速度这么快的原因,这背后需要大量的GPU进行算力支持.
由于双精度浮点数和单精度浮点数的位数过多,而根据实验结果,即使是16位的半精度浮点数(half float)也足够支持深度学习了,所以现在的AI芯片全面转向支持16位甚至是8位的浮点运算,直接将运算速度翻倍了.
总结
这本书之所以这么有名是有理由的,讲的确实很好,足够深入浅出,让我这个小白也有幸懂得了神经网络和深度学习是什么.
我没怎么附上算法的具体实现代码,因为书中的示例代码过于简陋和破碎了,需要额外去阅读其他书籍来学习真正的神经网络代码编写.
Essential GraphRAG Knowledge Graph-Enhanced RAG
- 出版于2025年,出版商:Manning,作者:Tomaž Bratanič。
总结
很高兴能够看到这本书,尽管只有薄薄的一百多页,但它成功帮我拨开了关于RAG的迷雾,让我真正地明白了一件事:
- 在部署端使用RAG的效果是微乎其微的.
我们可以将RAG拆成一个比较完整的几步:
- 将本地文件拆分成向量并存入向量数据库中
- 调用第三方的embedding API或者使用本地部署的小模型来将用户的提示词转变成embedding层的向量
- 根据提示词向量在数据库中查询得到关联度最大的文档向量(通常是计算两个向量的余弦相似度)
- 将文档向量对应的文本块附加在提示词之后交给API
- API返回经过了RAG的回答.
尽管如此,RAG的原型论文是说的用这一回答来微调大模型本身,而非用在API上的微调.如果我们需要让大模型来处理隐私文档和数据,那就不应该走API,而应该使用本地训练的模型,那么就无所谓RAG了,直接把内部文件作为初始训练语料就可以了;但话又说回来,不具备本地训练模型条件的公司和个人又不太需要保护所谓的内部知识库,大方交给API就行了.
而在如今,主流大模型的知识库储备都是相当恐怖的,完全不需要我们来给API额外提供公开的文档知识,如果你希望了解最近发生的事情,现在的AI甚至还可以主动去联网搜索,在大模型端进行RAG处理,而不需要我们这边提供任何的信息.
总体来看,要不要在部署端用RAG是相当矛盾的一件事,粗暴一点说的话,这事我看成不了.
但话又说回来,在大模型端使用RAG确实很有必要,所以自2021年RAG被正式提出后,这方面的论文层出不穷
Generative AI with Python
- 出版于2025年,作者:Bert Gollnick。
- 不推荐阅读
Hugging Face in Action
- 出版于2025年,出版商:Manning,作者:Wei-Meng Lee。
- 有了一定数量的论文打底之后看起来终于不像是天书了
简介
HuggingFace有Transformers库和各种pipeline,大量的预训练模型(通过huggingface_hub下载),构建网页UI的Gradio库(21年被Hugging Face收购).
使用Transformer和pipeline
很遗憾,我不太用得到,所以也不想去背API了
数据集介绍
从hugging face上下载数据集后即可直接调用,数据集的内部结构一般如下:
| |
- 训练集:用于训练模型的训练数据集。
- 测试集:用于评估模型性能的测试数据集。
- 无监督数据集:通常包含未标记数据的子集,可用于无监督或半监督学习任务。 *
使用方法也很简单:
| |
Hugging Face Datasets服务会自动将所有公开数据集转换为Parquet格式,这能显著提升性能
分词(tokenization)介绍
分词方法有以下几种类型:
- 词级(Word-level)——将文本拆分为单个词语
- 子词级别(Subword-level)——将单词切分为更小的有意义单元或子词
- 字符级(Character-level)——将文本拆分为单个字符;通常用于中文和日语等语言,这些语言中词边界不那么明显。
词级分词虽然简单直接,但在处理词汇表外的单词时会遇到困难,因此对于多样化语言需要很大的词汇量。此外,它无法捕捉单词的内部结构,这限制了模型的泛化能力。使用此方法的一些模型包括Word2Vec和GloVe。
大多数新型模型,特别是基于Transformer的模型(如BERT和GPT),倾向于采用子词或字节对编码(BPE)的分词方式,以克服这些问题,从而在跨语言和词形变化方面提供更好的灵活性和泛化能力
字符级分词通常用于汉语和日语等语言,俗称CJK,基本都是一个token对应一个汉字.
对数据集进行分词时,会有以下三个结果: input_ids、token_type_ids和attention_mask
input_ids的结构如下,每个数字代表一个token的ID,末尾的0则是填充的token,用于维持所有训练集批次中的序列长度保持一致,方便统一处理
| |
根据token的ID我们能找到原来的Token:
| |
第一个token是
[CLS],它标志着字符串的开始。某些token前面的##符号表示该token是一个子词单元,它是较大词的延续或后缀。简而言之,它表示该token不是一个独立词,而是一个片段,与前一个token结合形成完整的词。[PAD]token表示token化序列中的填充。它用于通过向较短的序列填充填充token,确保模型的所有输入序列长度相同。这种填充过程是必要的,因为许多基于变换器的模型(如BERT)期望输入张量具有统一大小,以便在训练或推理期间进行高效的批量处理。
第二个属性,token_type_ids,用于区分单个输入中的多个段,也就是说,帮助Bert确定对话的顺序.但对于GPT等LLM来说,用assitant,user来标注就足够了.
第三个属性,attention_mask,用于告知模型哪些标记应当被关注(处理),哪些不应当。当输入中存在填充标记时,这一点尤为重要,因为模型在计算过程中应忽略这些填充:
| |
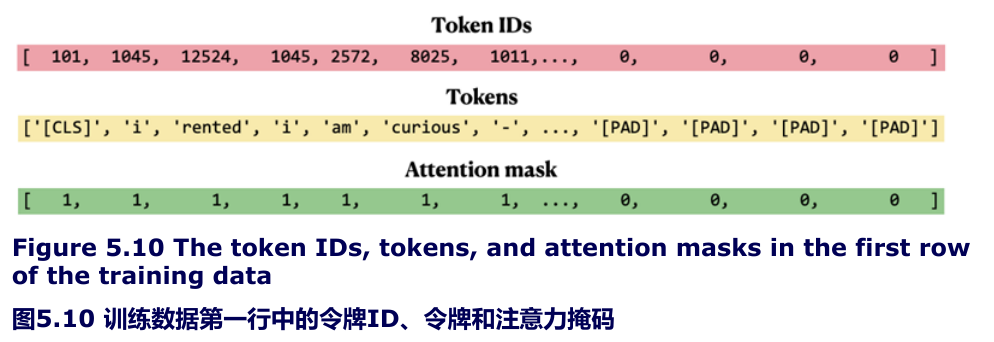
搜索集成
文中推荐的是smolagent,但我觉得差了点意思,然后AI推荐的是ddgs:
| |
效果如下:
| |
比我想的要好很多呢.
总结
干货有不少,但废话也很多.
计算机视觉: 算法与应用(第一版)
- 出版于2010年(英文第一版;中文版2011年),作者:Richard Szeliski。
- 跟我想象中的不太一样,基本全是数学,真心看不下去
基于大模型的RAG应用开发与优化
- 出版于2025年,作者:严灿平。
- 值得一看,尽管很多地方都是不太重要的接口调用和代码分析,但讲的还算不错,能有不少收获
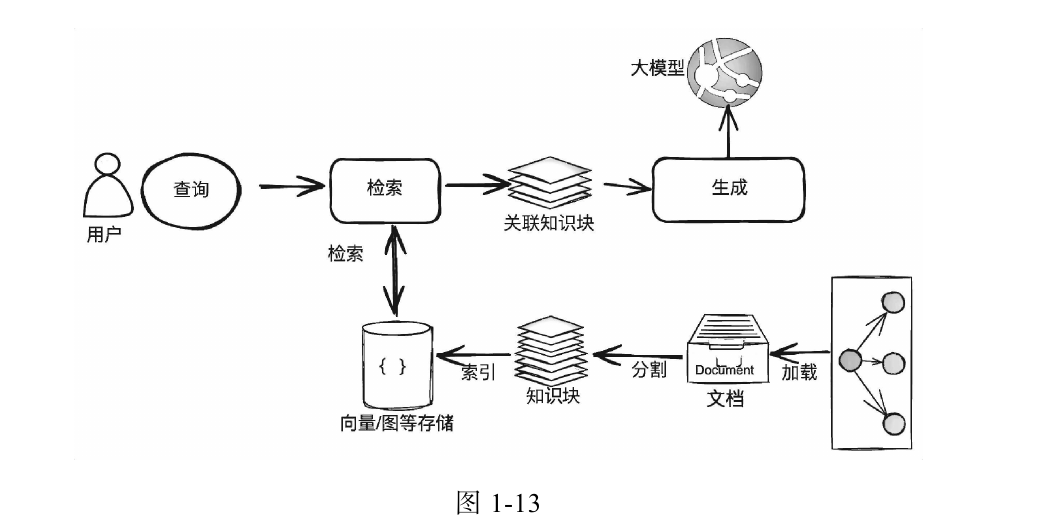
深度学习理论与实战:提高篇
- 这本书我是偶然发现的,知名度并不高,但是里面的不少内容都讲的很好,比起某些深度依赖框架的深度学习书好很多,希望能有更多人看到这种优秀的中文文章.
深度学习理论与实战:基础篇
- 出版于2019年,作者:李理。
- 写的不是很好,也不够通俗,看的出来很多论述都是戛然而止的,非常浅显,我只能认为是被编辑砍掉了,不然和姊妹书的差别还是太大了
Transformers快速入门
标题很具有迷惑性,事实上,这篇文章的前面几章深入浅出的讲述了大语言模型(LLM)的前世今生,让人受益匪浅
自然语言处理
- 这一章的介绍相当精彩,通俗易懂
要让计算机处理自然语言,首先需要为自然语言建立数学模型,这种模型被称为语言模型(Language Model,LM),其核心思想是判断一个文字序列是否构成人类能理解并且有意义的句子,即建模文本序列的生成概率。
统计语言模型
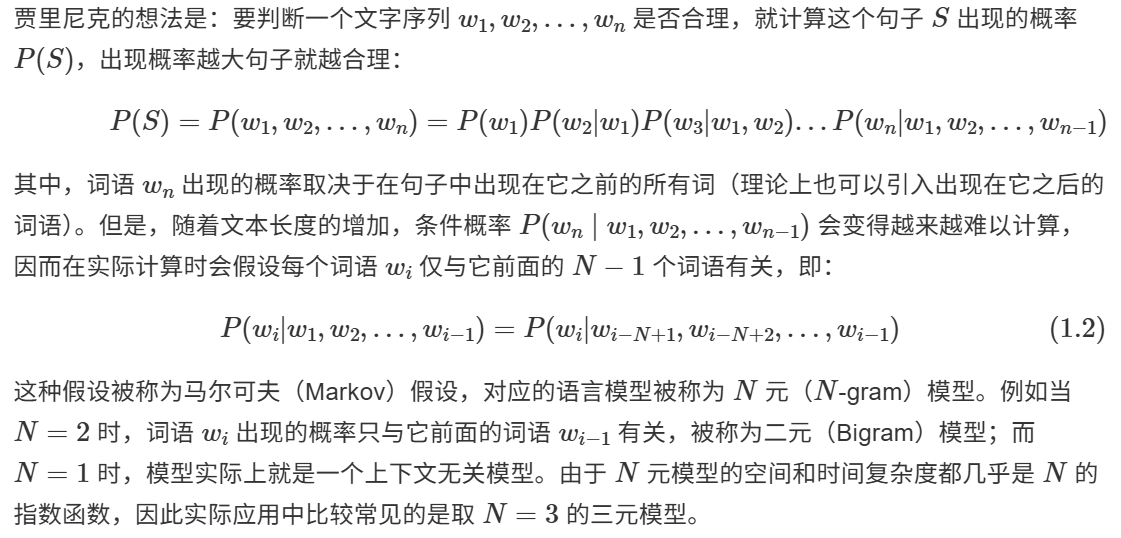
- 可以看到,这里的数学原理是非常简单的,并不怎么难懂
即使是使用三元、四元甚至是更高阶的语言模型,依然无法覆盖所有的语言现象。在自然语言中,上下文之间的关联性可能跨度非常大,例如从一个段落跨到另一个段落,这是马尔可夫假设解决不了的。此时就需要使用 LSTM、Transformer 等模型来捕获词语之间的远距离依赖(Long Distance Dependency)了。
神经语言模型
NNLM模型
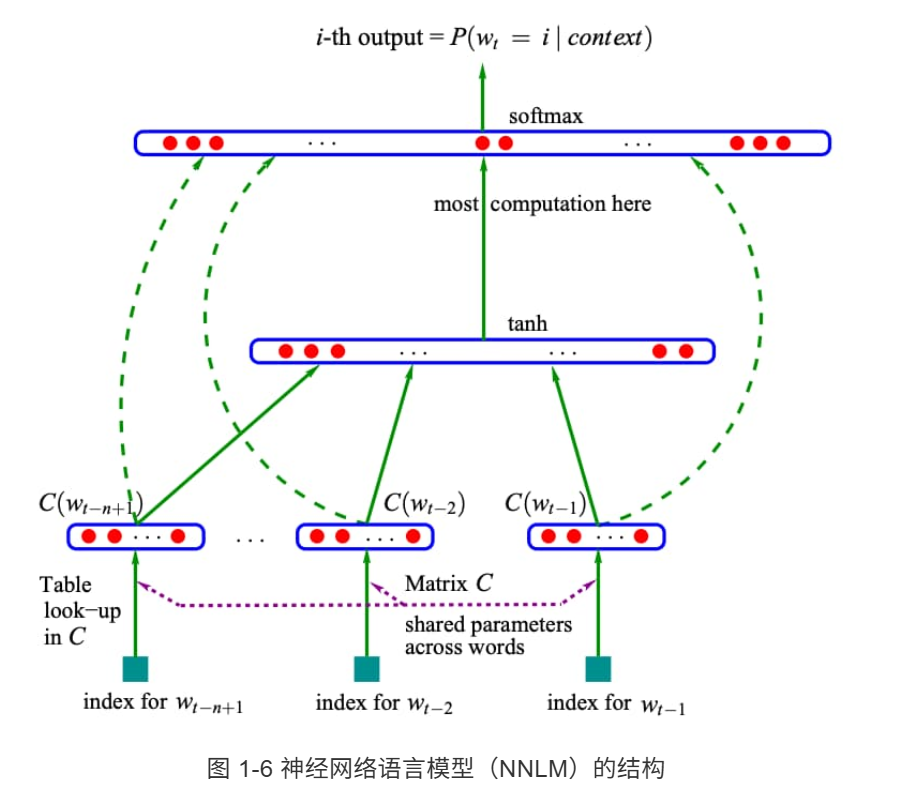
具体来说,NNLM 模型首先从词表C中查询得到前面N个词语对应的词向量,然后将这些词向量拼接后输入到带有激活函数的隐藏层中,通过Softmax函数预测当前词语的概率,它不仅能够能够根据上文预测当前词语,同时还能够给出所有词语的词向量
Word2Vec模型
Word2Vec 的模型结构和 NNLM 基本一致,只是训练方法有所不同,分为 CBOW (Continuous Bag-of-Words) 和 Skip-gram 两种:
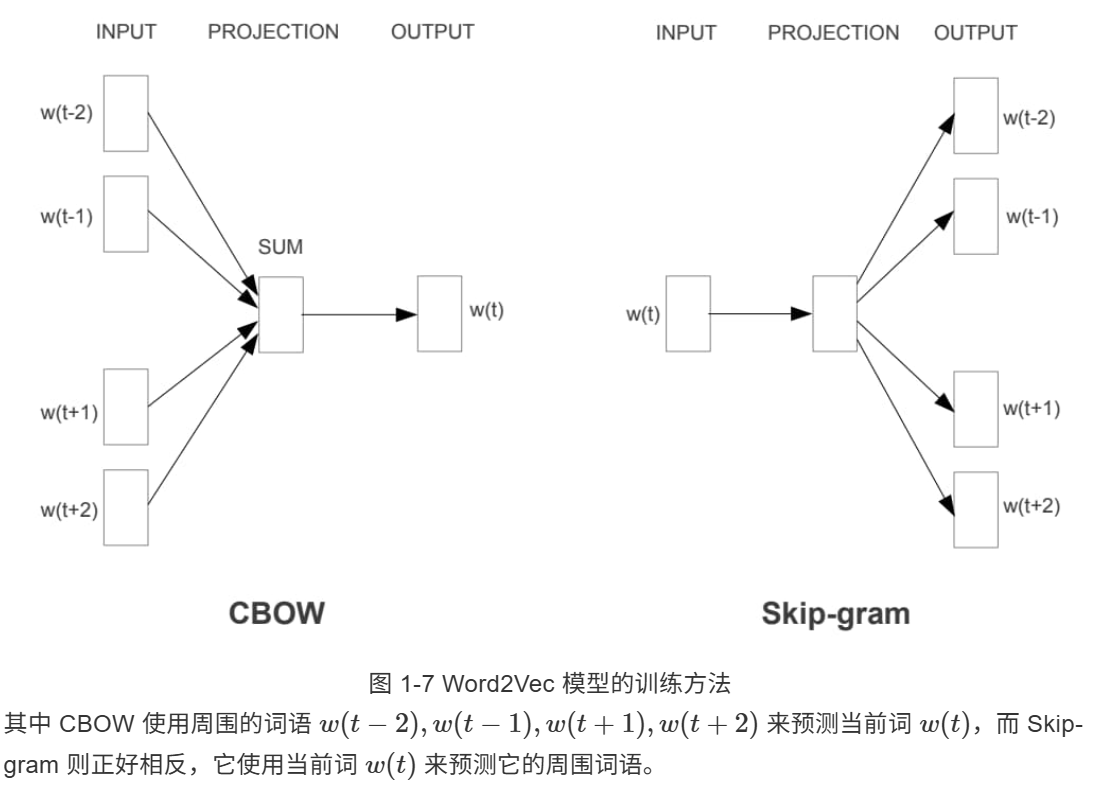
可以看到,与严格按照统计语言模型结构设计的 NNLM 模型不同,Word2Vec 模型在结构设计上更加自由,训练目标也更多是为获得词向量服务。特别是 CBOW 训练方法同时通过上文和下文来预测当前词语,打破了语言模型“只通过上文来预测当前词”的固定思维,为后续一系列神经网络语言模型的发展奠定了基础
预训练语言模型
然而,有一片乌云始终笼罩在 Word2Vec 模型的上空——多义词问题。一词多义是语言灵活性和高效性的体现,但是 Word2Vec 模型却无法处理多义词,一个词语无论表达何种语义,Word2Vec 模型都只能提供相同的词向量,即将多义词编码到完全相同的参数空间。
实际上在 20 世纪 90 年代初,雅让斯基(Yarowsky)就给出了一个简洁有效的解决方案——运用词语之间的互信息(Mutual Information) 具体来说,对于多义词,可以使用文本中与其同时出现的互信息最大的词语集合来表示不同的语义。例如对于“苹果”,当表示水果时,周围出现的一般就是“超市”、“香蕉”等词语;而表示“苹果公司”时,周围出现的一般就是“手机”、“平板”等词语
ELMo 模型
为了更好地解决多义词问题,2018 年研究者提出了 ELMo 模型(Embeddings from Language Models)。与 Word2Vec 模型只能提供静态词向量不同,ELMo 模型会根据上下文动态地调整词语的词向量。
但是 ELMo 模型存在两个缺陷:首先它使用 LSTM 模型作为编码器,而不是当时已经提出的编码能力更强的 Transformer 模型;其次 ELMo 模型直接通过拼接来融合双向抽取特征的做法也略显粗糙
GPT 模型
不久之后,OpenAI 将 ELMo 模型中的 LSTM 更换为 Transformer 提出了 GPT 模型(Generative Pre-trained Transformer)。并且 GPT 模型继续追随 NNLM 的脚步,采用仅有解码器的 Transformer 架构,只通过词语的上文进行预测。
虽然解码器架构适合于完成自然语言生成任务(如文本摘要),但是在一定程度上也限制了模型的应用场景,例如对于文本分类、阅读理解等任务,如果不把词语的下文信息也嵌入到词向量中就会白白丢掉很多信息。
BERT 模型
2018 年底,Google 基于 Transformer 模型进一步提出了 BERT 模型(Bidirectional Encoder Representations from Transformers),这一阶段神经网络语言模型的发展终于出现了一位集大成者,BERT 模型在发布时在 11 个任务上都取得了最好性能.
BERT 模型采用和 GPT 模型类似的两阶段框架,首先对语言模型进行预训练,然后通过微调来完成下游任务。但是,BERT 不仅像 GPT 模型一样采用 Transformer 作为编码器,而且采用了类似 ELMo 模型的双向语言模型结构,如图 1-11 所示。因此 BERT 模型不仅编码能力强大,而且对各种下游任务,BERT 模型都可以通过简单地改造输出部分来完成。
大语言模型
除了优化模型结构,研究者发现扩大模型规模也可以提高性能。在保持模型结构以及预训练任务基本不变的情况下,仅仅通过扩大模型规模就可以显著增强模型能力,尤其当规模达到一定程度时,模型甚至展现出了能够解决未见过复杂问题的涌现(Emergent Abilities)能力。例如 175B 规模的 GPT-3 模型只需要在输入中给出几个示例,就能通过上下文学习(In-context Learning)完成各种小样本(Few-Shot)任务,而这是 1.5B 规模的 GPT-2 模型无法做到的。为了区分这两代模型之间的差异,业界将大型预训练语言模型命名为“大语言模型”(Large Language Model,LLM)。
在规模扩展定律(Scaling Laws)被证明对语言模型有效之后,研究者基于 Transformer 结构不断加深模型深度,构建出了许多大语言模型 可以说,大语言模型的出现改变了自然语言处理的范式,从为特定 NLP 任务构建专用模型转变为使用单一的大型模型,通过提示或微调来处理各种语言任务,这使得复杂的语言处理更容易实现。相比早期的语言模型主要面向自然语言的建模与生成,最新的语言模型则侧重于复杂任务的求解。从语言建模到任务求解,这是人工智能科学思维的一次重要跃升。
- (26/4/15): 尽管直到现在都没人彻底搞明白为什么扩大模型规模就能实现性能的跃升,但还是有很多人都信誓旦旦的认为AI将会取代一切.
Transformer模型
正如第一章所述,自从 BERT 和 GPT 模型取得重大成功之后, Transformer 模型已经替代循环神经网络(RNN)、卷积神经网络(CNN)等传统神经网络结构,成为各种 NLP 模型的标配。
- 换句话说,出于工程应用的角度,不太有必要去学传统神经网络架构了
Transformer的架构
标准 Transformer 模型主要由**编码器(Encoder)和解码器(Decoder)**两个模块组成 其中编码器负责接收输入并构建输入的语义表示(语义特征),从而理解输入内容,而解码器则利用编码器输出的语义表示(语义特征)以及前序输出来生成目标序列。
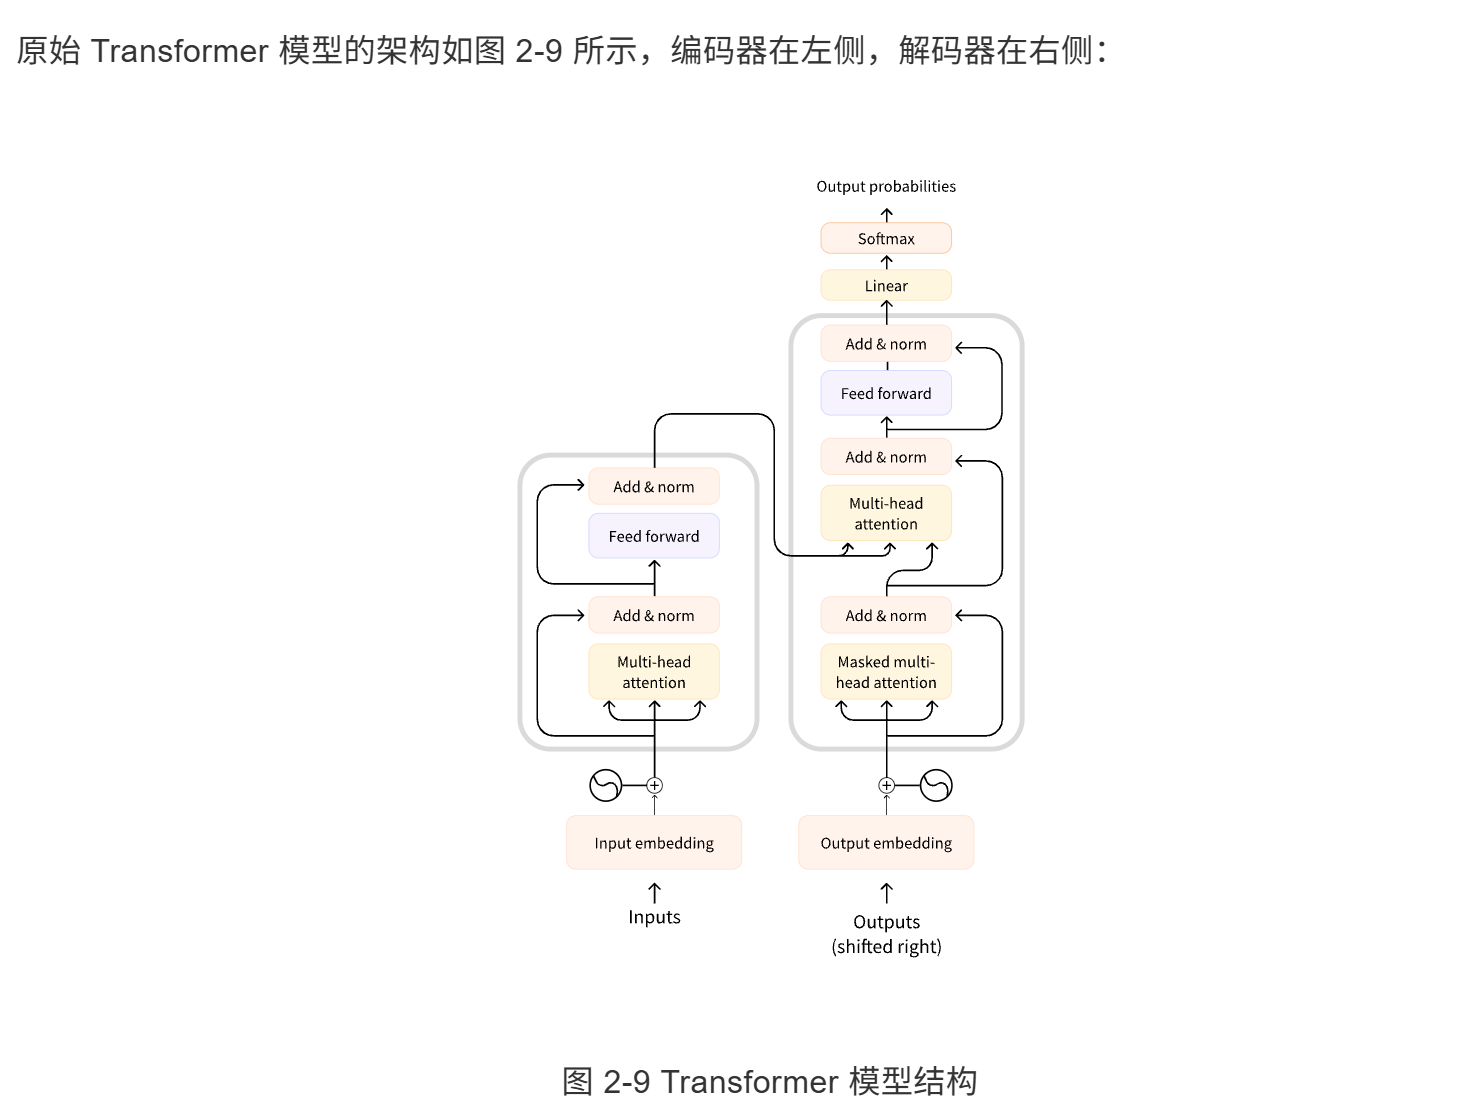
Transformer模型分类
- 纯编码器模型(Encoder-Only) 只包含编码器部分,采用双向语言建模,从两个方向理解上下文。适合需要深度理解文本的任务,例如文本分类、命名实体识别等,典型代表如 BERT。
- 纯解码器模型(Decoder-Only)
只包含解码器部分,从左到右处理文本。尤其擅长文本生成任务,可以根据提示完成句子、撰写文章,甚至生成代码,典型代表如 GPT、Llama。
- 大多数大语言模型(LLM)都采用纯解码器架构,这些模型在过去的几年中规模和功能都得到了显著提升,一些最大的模型包含数千亿个参数。
- 编码器-解码器模型(Encoder-Decoder) 结合了编码器和解码器,使用编码器理解输入,解码器生成输出。擅长序列到序列任务,例如翻译、摘要、问答等,典型代表如 T5、BART。
大语言模型的工作原理
推理是指大语言模型利用训练中积累的知识,根据给定的输入提示逐字逐句地生成生成类似人类语言文本的过程。具体来说,大语言模型会按照顺序生成的方式,利用从数十亿个参数中学习到的概率来预测和生成序列中的下一个词元(Token),从而生成连贯且与上下文相关的文本。
注意力的作用
注意力机制赋予大语言模型理解上下文并生成连贯响应的能力,在预测下一个词时,句子中的每个词并非都具有相同的权重。
例如,在句子“法国的首都是……”中,“法国”和“首都”这两个词对于确定下一个词是“巴黎”至关重要.
这种识别最相关词以预测下一个词元的方法已被证明非常有效。简而言之,注意力机制是语言模型能够生成既连贯又具有上下文感知能力的文本的关键,它也是使现代语言模型区别于前几代语言模型的关键
想要了解大语言模型实际能够处理多少上下文信息,就需要引出上下文长度,或者说模型的“注意力跨度”。上下文长度是指大语言模型一次可以处理的最大词元数量,这会受到模型的架构和尺寸、可用计算资源以及输入和期望输出的复杂性等多个因素的限制。
当我们向大语言模型传递信息时,会以某种方式组织输入以引导模型生成所需的输出,这被称为提示词工程(Prompting)。由于模型的主要任务就是通过注意力机制分析每个输入词元的重要性来预测下一个词元,因此输入序列的措辞至关重要。相比口语化的简单任务描述,精心设计的提示(Prompt)可以更容易地引导大语言模型生成符合预期的输出。
两阶段推理过程
大语言模型生成文本的过程主要分为两个阶段:预填充(Prefill)和解码.
预填充阶段就像烹饪中的准备阶段,所有初始食材都在此阶段进行加工和准备,该阶段包含三个关键步骤:
- 分词(Tokenization):将输入文本转换为模型可以理解的基本语言单元——词元(token)。
- 嵌入转换(Embedding Conversion):将词元转换为能够表示其语义的密集嵌入表示。
- 初始处理:将这些嵌入向量输入模型的神经网络,以深入了解上下文。
这个阶段计算量很大,因为模型需要一次性处理完所有输入的词元,就像人类在回复消息之前,先需要阅读并理解消息中的所有文字。
预填充阶段处理完输入后,就进入实际生成文本的解码阶段。在这个阶段,模型会逐个生成词元以构建完整的输出,称之为自回归过程(每个新词元都依赖于所有先前的词元)。这一阶段包含了针对每个新词元执行的多个关键步骤:
- 注意力计算:回顾所有先前的词元以理解上下文;
- 概率计算:确定下一个可能出现的词元的概率;
- 词元选择:根据这些概率选择下一个词元;
- 持续性检查:决定是否继续或停止生成。
此阶段会占用大量内存,因为模型需要跟踪所有先前已经生成的词元以及它们之间的关系。
采样策略
在模型生成过程中,就像作家可以选择更具创意还是更精确一样,我们也可以调整模型选择词元的方式。当模型生成下一个词元时,它首先会得到词汇表中每个词的原始概率(称为logits),然后基于这些概率来选择下一个词元,这个过程包含以下几个步骤:
- 原始概率:可以将其视为模型对每个可能的下一个词的初始直觉。
- 温度控制(Temperature Control):就像控制创造力的旋钮,设置较高的值(>1.0)会使选择更随机、更具创造性,而较低的值(<1.0)则会使选择更集中、更具确定性。
- Top-p 采样(核采样):不考虑所有可能的词语,而是只关注那些概率总和达到选定阈值的最可能词语(例如前 90%)。
- Top-k 过滤:一种替代方法,只考虑最有可能的 k 个下一个词。
此外,大语言模型面临的一个常见挑战是重复性问题,即生成重复的内容。为了解决这个问题,通常可以采用两种惩罚机制:
- 出现惩罚(Presence Penalty):对任何已出现过的词元,无论其出现频率如何都施加固定惩罚,从而防止模型重复使用相同的词;
- 频度惩罚(Frequency Penalty):根据词元使用频率递增的惩罚机制,一个词出现得越多,再次被选中的可能性就越小。
这些惩罚项会在词元选择的早期阶段就被应用,从而在其他采样策略实施之前就调整原始概率。可以被视为一种温和的引导,鼓励模型探索新的词汇。
最后,考虑到局部最优解未必是全局最优解,如果每次只是简单地选择当前最合适的词元,未必能获得全局质量最好的生成结果,因此还可以使用束搜索(Beam search),同时生成多个词元序列,最后选择总体概率最高的作为最终输出:
- 在每个步骤中,维护多个候选序列(通常为 5-10 个)。
- 对于每个候选词,计算其成为下一个词元的概率;
- 只保留最可能的序列和后续词元组合;
- 重复此过程,直至达到所需长度或停止;
- 选择总体概率最高的序列作为输出。
束搜索通常能生成更连贯、语法更正确的文本,但需要更多的计算资源。
- 但它其实也是局部最优解,要想输出更合理的答案就可以根据之前所说的调整温度和引入惩罚机制
实际挑战与优化
在实际部署大模型时,通常需要考虑以下几个关键指标:
- 首次响应时间(Time to First Token,TTFT):获得首次响应的时间,这主要受预填充阶段的影响,对于用户体验非常重要。
- 输出每词元所需时间(Time Per Output Token,TPOT):用户衡量生成后续词元的速度,这决定了整体生成速度。
- 吞吐量(Throughput):可以同时处理的请求数量。
- 显存使用情况:GPU 显存的消耗量,这通常会成为实际应用中的主要瓶颈。
此外,有效管理上下文长度是大语言模型推理中最具挑战性的问题之一。虽然更长的上下文可以提供更多信息,但也会带来巨大的成本:内存使用量通常随上下文长度呈二次方增长,而处理速度则通常随上下文长度呈线性下降。例如像 Qwen2.5-1M 这样的新模型支持数百万个 token 的上下文窗口,但这也导致推理速度显著降低,因此关键在于找到适合实际场景的最佳平衡点。
为了应对这些挑战,最有效的优化方法之一是 KV 缓存(Key-Value Caching),通过存储和重用中间计算结果来提高推理速度。这项优化可以减少重复计算,从而提升生成速度,使长上下文生成成为可能。虽然代价是会占用更多内存,但性能提升通常远远超过这一成本。
Transformer详解
- 都是latex公式,就不摘抄了 由于太过专业,因此我自己找AI通俗化了一下:
注意力是什么
注意力机制(Attention Mechanism)的本质是资源的最优分配。它让模型学会从大量信息中,筛选出对当前任务最关键的少数核心信息。
1. 核心逻辑:图书馆借书
要理解注意力,最经典的模型是 Query(查询)、Key(键)、Value(值)。你可以将其想象成在图书馆找书:
- Query (Q):你想找的东西。比如你脑子里的搜索词:“人工智能的历史”。
- Key (K):书架上每本书的标签/书名。模型会计算你的 Query 和每一个 Key 的匹配程度(相关性)。
- Value (V):书里的具体内容。
操作流程:
- 你拿着 Q 去跟所有的 K 比对,发现《AI简史》匹配度 0.9,《高等数学》匹配度 0.1。
- 这个匹配度就是权重(Attention Weight)。
- 最后你带走的知识,就是根据权重加权后的结果:0.9 x
《AI简史》的内容+ 0.1 x《高数》的内容。
2. 为什么需要它?(对比传统方法)
在注意力机制出现之前,机器处理信息像吞枣:
- 传统模型(如 RNN):像一个记性不太好的翻译官。读完一个长句后,他试图把所有信息压缩成一个固定长度的向量。结果就是:读到句尾,句头的信息就模糊了。
- 注意力模型:像一个带着荧光笔的读者。在处理每个词时,它会瞬间扫描全句,把相关的重点划出来。
3. 不同的注意力类型
- 自注意力(Self-Attention):自己跟自己找关系。
- 例子:句子“它在马路上跑,因为它累了”。当处理第二个“它”时,注意力机制会高亮“跑”和“马路”,从而让模型明白这个“它”是指那个运动的物体。
- 交叉注意力(Cross-Attention):在两个不同序列间找关系。
- 例子:翻译时。当准备输出英文单词 “Apple” 时,解码器会去中文原句里寻找权重最高的词——“苹果”。
深入理解注意力机制
Transformer 能够“一眼读完全文”且不丢失信息,主要靠的是位置编码和全连接的并行架构。
1. 为什么它能“一眼读完”?
传统的 RNN 像排队进场,信息必须一个接一个传递,前面的信息在传递过程中会像“传声筒游戏”一样逐渐失真。
Transformer 像航拍全景。它利用矩阵运算,在计算的第一步就让序列中所有的词同时进入模型。
- 物理机制:在自注意力层,每个词都会和全场所有词建立连接。从第 1 个词到第 1000 个词的距离,在矩阵里永远是 $1$。
- 无损传输:因为不存在“中间商”传递,信息是直接从 A 点点对点触达到 B 点的。
2. 既然是一眼读完,怎么知道谁先谁后?
如果只是把词丢进去,模型会觉得“我吃鱼”和“鱼吃我”是一样的。为了解决这个问题,它引入了位置编码(Positional Encoding)。
- 硬性叠加:在词向量进入模型之前,会加上一个代表位置的“指纹”。这个指纹是用余弦和正弦函数生成的独特数值序列。
- 坐标系化:这就好比给每个进场的词发了一个带编号的座位号。
- “我”带上了一个“我是第1位”的属性;
- “鱼”带上了一个“我是第3位”的属性。
- 特征融合:模型在处理时,不仅能看到“鱼”的含义,还能感知到它携带的“第3位”这个特征。
3. 为什么信息不会丢失?
信息丢失通常发生在“压缩”阶段。Transformer 采用以下手段锁定信息:
- 全连接注意力(All-to-All):每一个词在每一层都有机会重新审视全句。即使在第 10 层,它依然可以直接调用第 1 层输入的原始位置信息和语义信息。
- 残差连接(Residual Connection):这是最关键的**“保底机制”**。
- 每一层加工完后,都会把“加工前的原始数据”直接加到“加工后的数据”上。
- 这相当于给信息铺设了多条高速公路。如果某一层加工坏了,原始信息可以直接跳过加工层往后传。
Transformer概览
Transformer 的核心逻辑是放弃了“排队处理数据”,改用全连接矩阵并行运算。它将语言处理变成了一个空间几何问题:通过计算词与词之间的距离和权重,捕捉语义。
1. 输入层:数据数字化
计算机不认识文字,第一步是向量化(Embedding)。
- 词嵌入(Embedding):将每个词映射到一个高维空间的坐标(向量)。意思相近的词,坐标距离更近。
- 位置编码(Positional Encoding):由于 Transformer 是同时读入所有词,它无法区分语序。我们必须给每个词的向量叠加上一个“位置指纹”(通常使用正弦/余弦函数生成),让模型知道谁在谁前面。
2. 核心机制:自注意力(Self-Attention)
这是 Transformer 的“灵魂”。它解决了**“联系”**的问题。
- 计算逻辑:每个词都生成三个身份:Q(查询)、K(键)、V(值)。
- 物理过程:
- 每个词拿自己的 Q 去跟全场所有词的 K 做点积,算出匹配度。
- 匹配度经过 Softmax 变成权重(比如 0.8、0.1…)。
- 根据权重去提取对应的 V(值)。
- 本质:它让每个词在处理时,都能根据上下文自动聚焦到相关的词上。比如在“他过马路”中,“他”会通过注意力强力连接到语境中的具体人物。
3. 编码器(Encoder):特征提取
编码器由 $N$ 个相同的块堆叠而成。
- 多头机制(Multi-Head):并行运行多组自注意力,一组看语法,一组看逻辑,类似于多个人从不同角度审题。
- 残差连接(Residual)与归一化(Norm):每一层加工完都会把原始输入加回来,防止深层网络信息丢失或梯度消失。
- 前馈网络(FFN):对注意力提取的信息进行非线性转换,进一步强化特征。
4. 解码器(Decoder):序列生成
解码器负责预测下一个词,它比编码器多了两样东西:
- 掩码注意力(Masked Attention):训练时把后面的词遮住,强制模型只能根据已有的上文预测未来。
- 交叉注意力(Cross-Attention):解码器会去“盯着”编码器输出的特征矩阵。就像写作文时,一边写(解码),一边看题目要求(编码器的输出)。
5. 输出层:概率映射
- 线性层:将解码器的输出映射回词表大小。
- Softmax:将数值转换为概率。概率最高的那个词,就是模型认为的“下一个词”。
总结:Transformer 为什么强大?
- 并行性:不再像 RNN 那样一个字一个字读,大大缩短了训练时间。
- 长程依赖:因为是全连接,句子开头和结尾的词距离永远是 $1$,不会遗忘。
- 可扩展性:支持模型做大(Scaling Law),参数越多,学到的世界知识就越深邃。
现在的 LLM(如 GPT 系列)多采用 Decoder-Only 架构,即去掉了显式的编码器,让解码器自己处理输入并直接续写。
编码器是什么
将编码器(Encoder)想象成一个**“深度阅读理解器”**。它的任务是将一串单词,通过层层理解,翻译成机器能懂的“思想地图”。
1. 零件拆解:它由什么组成?
如果把编码器比作一个加工车间,它主要有三个工位:
- 特种雷达(自注意力机制):每个词都在扫描全场。比如读到“苹果”这个词,雷达会看周围有没有“好吃”或者“乔布斯”。如果有“乔布斯”,它就把“苹果”理解为科技公司;如果有“好吃”,它就理解为水果。
- 多角度摄像头(多头机制):不只用一个雷达,而是用 8 个或更多。有的看语法,有的看语气,有的看逻辑,最后汇总。
- 深加工机床(前馈网络):雷达看清关系后,机床会对每个词的特征进行非线性强化,把零散的信号固定成深刻的记忆。
2. 运作流程:数据是怎么走的?
- 打标签(位置编码):Transformer 是一眼看完一整行字的,为了不让它分不清词序,进门前先给每个词贴个“我是第1个”、“我是第2个”的编号。
- 找关系(注意力计算):每个词伸出无数条线连接其他词,根据关联程度分配权重。
- 加总与校准(残差与归一化):算完之后,把原始信息和加工后的信息加在一起(怕算丢了),然后把数值拉回到一个标准范围,防止网络“走火入魔”。
3. 本质区别:为什么它更强?
- RNN(老方法):像一个学生背课文,读了后面忘前面,且必须一个字一个字读。
- Encoder(新方法):像摄影师拍全景。一眼望去,所有的词同时入画,所有的联系瞬间建立。
4. 结论
编码器的最终输出不是词,而是一组有“灵魂”的向量。这些向量已经不再是孤立的符号,而是吸收了整句话上下文精华的特征集合。
解码器是什么
1. 结构本质:一个“定向生成器”
如果说编码器是理解全文,解码器(Decoder)则是根据理解,逐字产出。它在编码器的基础上多了一个关键组件:交叉注意力(Cross-Attention)。
2. 核心工作机制
- 带掩码的自注意力(Masked Self-Attention):
- 物理约束:生成时,模型不能“偷看”未来的词。
- 实现:通过掩码(Mask)屏蔽掉当前时刻之后的词,确保预测第 $n$ 个词时,只参考前 $n-1$ 个词。
- 交叉注意力(Cross-Attention):
- 桥梁作用:这是解码器最核心的工位。它一边看着已经生成的词,一边盯着编码器传过来的“思想地图”(特征向量)。
- 逻辑:它在问编码器:“根据你刚才理解的原文,我现在写到这一步了,下一步最该接哪个信息?”
- 线性层与 Softmax:
- 将高维向量映射到词表大小的维度,通过概率分布选出得分最高的词。
3. 数据流向:从“过去”和“原文”中找答案
- 输入:输入的是已经生成出来的词(起始符或前文)。
- 自我对齐:通过 Masked Attention 整理已生成内容的逻辑。
- 吸取原文:通过 Cross-Attention 强行去对齐原文的重点。
- 预测输出:产出一个概率,选出一个词,然后把这个词再丢回输入端,循环往复。
4. 通俗比喻:像是在写“命题作文”
- 编码器(出题人):把复杂的背景资料读完,提炼出一张写满考点的纸。
- 解码器(考生):
- 他右手拿着已经写好的半篇作文(已生成的词);
- 左手按着出题人的考点纸(编码器输出);
- 他一边看左手确认别跑题,一边看右手确认逻辑连贯,最后写出下一个字。
新型模型架构
- 混合专家架构(Mixture-of-Experts,MoE): 将Transformer模块中的特定前馈层替换成MoE层,即换成具有不同权重参数的独立网络(称为专家),对于每次输入,选取概率最高的k个专家进行激活,然后加权输出
- 状态空间模型(State Space Model,SSM): 试图取代Transformer模型,性能依然有差距,代表模型有RetNet,Mamba等.
Transformer库使用
Transformers 库将目前的 NLP 任务归纳为几下几类:
- 文本分类:例如情感分析、句子对关系判断等;
- 对文本中的词语进行分类:例如词性标注 (POS)、命名实体识别 (NER) 等;
- 文本生成:例如填充预设的模板 (prompt)、预测文本中被遮掩掉 (masked) 的词语;
- 从文本中抽取答案:例如根据给定的问题从一段文本中抽取出对应的答案;
- 根据输入文本生成新的句子:例如文本翻译、自动摘要等。
Transformers 库最基础的对象就是 pipeline() 函数,它封装了预训练模型和对应的前处理和后处理环节。我们只需输入文本,就能得到预期的答案。目前常用的 pipelines 有:
- feature-extraction:获得文本的向量化表示
- fill-mask:填充被遮盖的词、片段
- ner:命名实体识别
- question-answering:自动问答
- sentiment-analysis:情感分析
- summarization:自动摘要
- text-generation:文本生成
- translation:机器翻译
- zero-shot-classification:零训练样本分类
情感分析
断更原因
后面的论述和代码过于专业了,不是我现在能看得懂的,显然这并不是真正的快速入门.
推荐系统实践
- 出版于2012年,作者:项亮。
推荐系统概述
在这个时代,无论是信息消费者还是信息生产者都遇到了很大的挑战:作为信息消费者,如何从大量信息中找到自己感兴趣的信息是一件非常困难的事情;作为信息生产者,如何让自己生产的信息脱颖而出,受到广大用户的关注,也是一件非常困难的事情
推荐系统就是解决这一矛盾的重要工具。推荐系统的任务就是联系用户和信息,一方面帮助用户发现对自己有价值的信息,另一方面让信息能够展现在对它感兴趣的用户面前,从而实现信息消费者和信息生产者的双赢
总结
还算值得一看,看完之后基本了解了两件事:
- 早期的推荐算法背后的数学原理是相当简单的,不太需要费脑子去设计,市面上有相当多的成熟算法可以选用;而现在的推荐算法都是基于机器学习实现的,需要相当大的计算量,而效果我看并没有多好,不如老老实实地用以前的方法为好.
- 推荐算法最重要的地方反而是数据集,无论是给新用户推荐,还是给老用户推荐,都需要事先有一个相当大规模的测试集,才能够大致划出一个恰当的范围,不会轻易让用户流失.
RAG with Python Cookbook
- 出版于2026年,作者:Deepak Dhyani。
- 原来学不会RAG不是我的问题,只是其他的教材太烂了
RAG介绍
| RAG 拟合度 | 用例 | 适配理由 |
|---|---|---|
| 1 | 我想和我的季度报告聊聊 | 只有单份文档,数据量较小。直接阅读或使用 ChatGPT、Claude 等通用大模型即可完成,自建 RAG 的收益很低。 |
| 2 | 请帮我总结这一份文档 | 通用大模型已经能够较好地完成单文档总结任务,引入 RAG 通常不会带来明显额外价值。 |
| 2 | 自动执行需要作出高风险决策的任务 | 技术上可以实现,但大模型仍可能出错。若缺少人工审核、审计机制和故障保护等措施,风险较高,因此不适合单纯依赖 RAG 自动完成。 |
| 4 | 大量会议录音不断积累,但其中的信息无法进入知识库 | RAG 可以将音频、视频、长篇非结构化笔记等难以检索的信息转化为可搜索、可查询的知识,具有持续价值;最终效果会受到语音转录质量影响。 |
| 4 | 将技术图纸与规格文档进行核对 | 适合利用多模态模型结合 RAG 进行跨材料比对,可以减少大量人工核查工作;但需要完善的评估机制和异常处理流程。 |
| 5 | 有 1 万份合同,需要找出其中包含自动续约条款的合同 | 文档规模很大,人工逐份检查成本过高;任务目标明确,可以通过检索和信息提取定位相关合同,结果也容易人工验证。 |
| 5 | 客户支持工单中包含大量产品问题,但无法有效汇总 | RAG 适合跨大量文档检索、聚合和发现重复模式,可以从大量工单中识别共同问题及趋势,这是人工难以大规模完成的任务。 |
| 5 | 每天收到数百条客户咨询,需要自动分配给合适的团队 | 属于高频、重复的分类与路由任务,任务标准清晰,结果容易评估,并且可以通过自动化显著降低人工成本。 |
核心判断原则:RAG 的价值通常随着数据量、跨文档检索需求、信息更新频率和人工处理成本的增加而提高。对于单份、短小且可以直接放入大模型上下文的文档,通常没有必要专门构建 RAG 系统。
当数据结构不规则且变化多端时,这种能力尤为重要。当每个输入略有不同但处理方式类似时,例如客户电子邮件、合同条款或事件报告,可以使用 RAG。不要将 RAG 用于简单的查找、固定格式的数据提取或基于不变规则的任务。如果您可以编写正则表达式(regex)或 SQL 查询来处理 95% 的情况,那么 RAG 只会增加不必要的复杂性和成本。
RAG常用的库和框架如下:
| 类别 | 示例库 | 主要作用 |
|---|---|---|
| RAG 与代理式 RAG 编排 | LangChain、LangGraph、LlamaIndex | 将检索器、生成器、提示词、记忆等常见 RAG 组件封装为统一抽象,并负责连接向量数据库、LLM 和传统数据库,使开发者更专注于业务逻辑。 |
| 大语言模型与嵌入模型 | OpenAI、Anthropic、Transformers、Sentence Transformers | 为 RAG 系统提供核心智能能力,用于理解用户查询、生成向量嵌入以及生成最终回答。 |
| 向量存储 | Chroma、FAISS、Pinecone、Milvus、Weaviate | 存储和检索向量嵌入,通过相似度搜索快速找到与用户查询相关的内容。 |
| 数据处理 | pandas、NumPy、PyPDF2、pypdf、python-docx、Unstructured、openpyxl、scikit-learn | 用于数据处理、文件读取、清洗和预处理,在文档进入 RAG 系统之前将原始数据转换为可处理的形式。 |
| 多模态与媒体处理 | Pillow、Pytesseract、MoviePy、pdf2image、OpenCV | 用于加载和处理图片、视频、播客、PDF、Word、PowerPoint 等不同媒体和文件格式。 |
| 文本处理与自然语言处理(NLP) | NLTK、Transformers、Rank-BM25、Beautiful Soup 4 | 用于文本清洗、分词、关键词检索、传统 NLP 分析等任务,避免所有文本处理步骤都依赖大语言模型。 |
| 评估与监控 | Ragas、Phoenix、LangSmith、Prometheus-Eval | 提供预定义的评估指标,用于衡量检索器、生成器以及整个 RAG 应用的准确性、质量和运行表现。 |
| Web 框架与部署 | Streamlit、Gradio、Flask、Django | 用于构建 RAG 应用的用户界面和 Web 服务。其中 Streamlit、Gradio 更适合快速原型,Flask、Django 更适合完整应用开发。 |
| 数据库与存储 | SQLAlchemy、Psycopg 2、SQLite3 | 用于连接传统 SQL 数据库,并通过数据库连接器或 ORM 将关系型数据作为 RAG 系统的数据来源。 |
基础模型
Ollama
Ollama 在http://localhost:11434/v1 公开了一个与 OpenAI 兼容的端点,因此您现有的代码几乎无需更改。
| |
还可以试试选用多个模型:
| |
将公开排行榜视为筛选工具,而非最终决策标准。常见的局限性包括以下几点:
基准泄漏或数据污染 一些基准测试题及答案是公开的,可能已被直接或间接包含在训练数据中,从而抬高模型分数。
古德哈特定律或过度优化 一旦某个基准成为目标,模型开发者可能会专门针对该基准进行调整,从而提高分数,但并不会相应提高模型的通用能力。
与实际使用情况不符 生产环境中的具体配置——包括提示模板、检索质量、工具使用、长上下文、多语言内容、量化方式以及延迟限制——都会显著影响最终结果。 因此,即使某个模型在公开排行榜上“胜出”,在你自己的 RAG 查询或真实业务场景中,也可能表现得更差。
图片解析
| |
第一次知道API还可以定制返回模型,不过对话中是不需要的,工具调用时却很有必要
加载数据
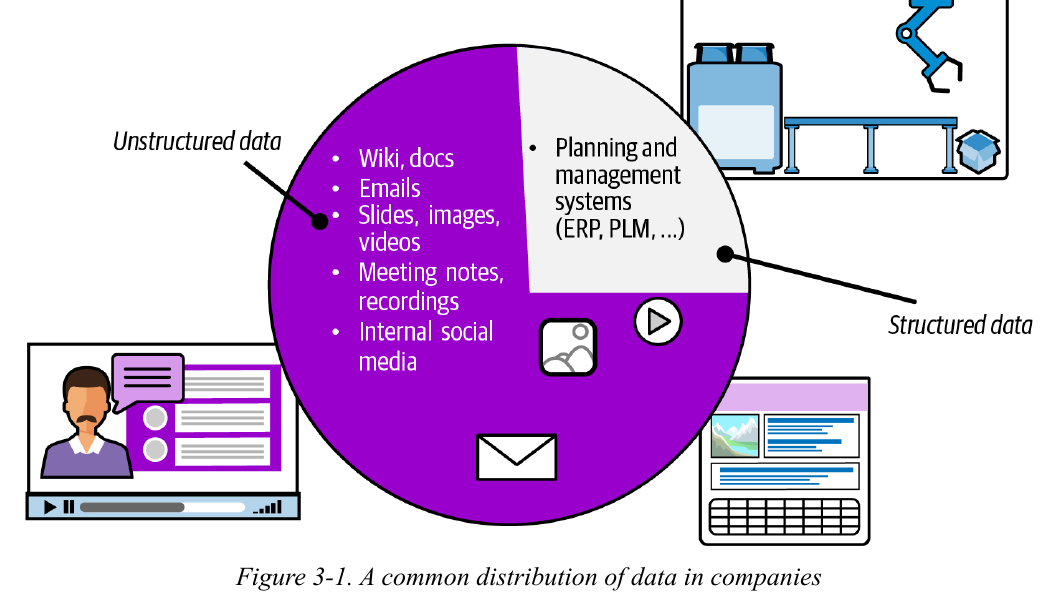
大多数RAG 检索器都使用文本嵌入,因此,一个切实可行的第一步是将不同的格式转换为一致的文本表示形式
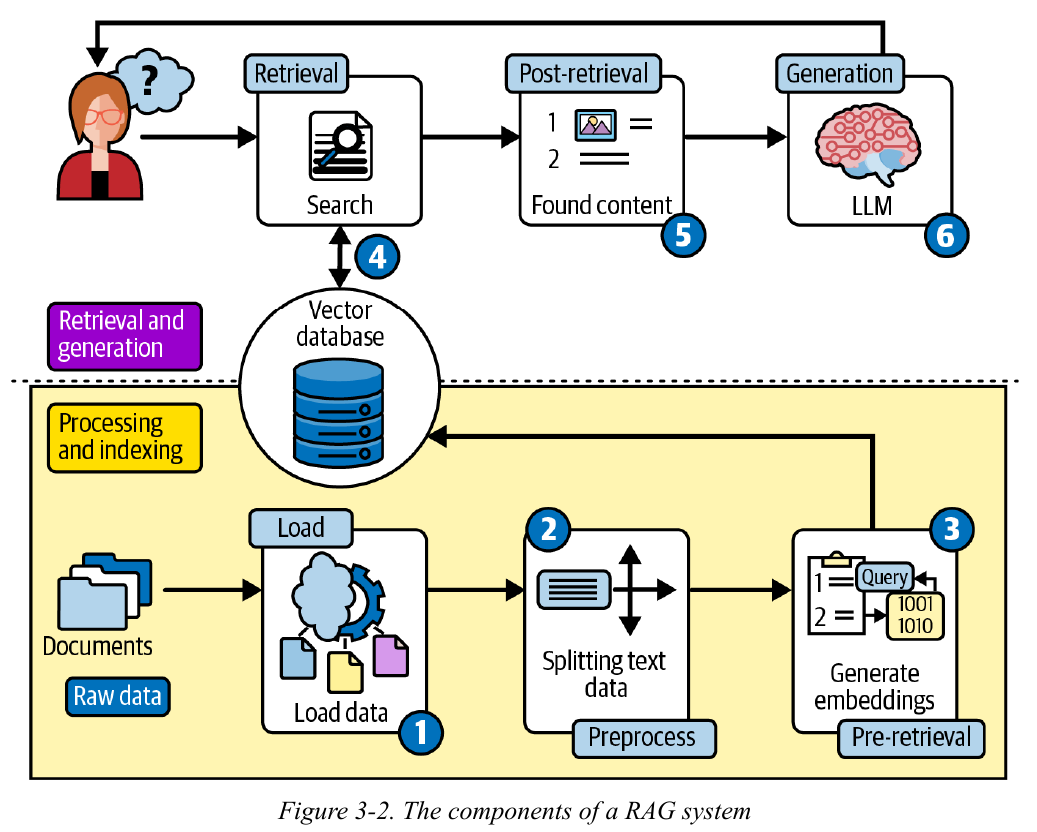
本书从零开始构建核心组件,以阐明其基本概念。在生产环境中,诸如 LangChain 或LlamaIndex 之类的编排框架可以加速开发,但它们也引入了频繁的破坏性变更、快速演进的 API 和额外的抽象等问题。
- 找了这么多书终于有个愿意认真做RAG的了.
加载Word
当您不需要区分元素类型时,可以使用 python-docx 进行简单的文本提取。当您需要保留文档结构(标题、段落、列表、图像)以便对元素进行针对性处理时,请使用 Unstructured。
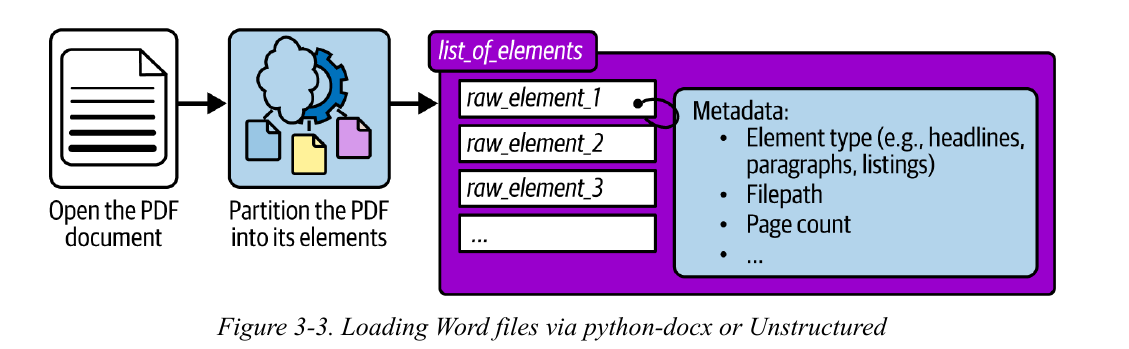
首先安装所需的库:
| |
python-docx
示例代码
| |
运行代码,效果确实可以:
尽管代码中将所有的结构信息都被除去,只剩下了文本信息,但是原本的python-docx库肯定不止这点功能.
看一下官网,发现这个库反而主要是用来生成和加工docx的,单纯提取docx反而是一个比较边角料的功能.
.docx不是一个二进制 Word 文件,而本质上是一个 ZIP 压缩包,内部包含大量 XML、图片和关系文件。
如:
| |
不过对于做RAG来说,确实文本信息就已经足够了…
unstructured
unstructured库更多的像是一个集成库,可以支持多种文档,先看看示例代码:
| |
简单来说就是python-docx库的粒度太细了,毕竟RAG完全不需要docx的样式信息,像这样就刚刚好.
加载PDF
| |
PyPDF2 可以从包含可选择字符的文本的数字生成的 PDF 文件中提取文本。该库无法处理扫描的 PDF 文件或基于图像的文档,因为这些文档中的文本以像素而非字符的形式存在,那就只能用OCR了.
加载csv和excel
我们有三种方案:
- 用openpyxl 库打开和加载 Excel 文件
- 将表格转换成md并直接粘贴给AI,适用于数据量小的表格
- 将表格转换成数据库存储,并使用SQL查询来实现RAG
加载音频
有了Whisper模型后,我们可以直接将音频转写为文本,如果需要质量更高的转写,就要用到一些API了.
OCR
本教程使用的是开源OCR引擎Tesseract,不过也有其他替代品:
| 文档类型 | 体积 | 推荐方法 |
|---|---|---|
| 纯文本 PDF 普通文档、合同、书籍、文章 | < 1,000 份/月 | OCR (Tesseract) 快速、免费、本地运行 |
| 纯文本 PDF 普通文档、合同、书籍、文章 | > 10,000 份/月 | OCR (Tesseract 或 EasyOCR) 大规模应用时具有成本效益 |
| 混合内容 文本 + 表格 + 图像 | < 500 份/月 | 多模态模型 (GPT-5 mini, Claude Haiku, Gemini Flash) 单次处理,结果稳健 |
| 混合内容 文本 + 表格 + 图像 | > 5,000 份/月 | 混合方法 首先对文档进行分类,对简单页面使用 OCR,对复杂页面使用多模态方法 |
| 复杂的版面设计 技术图表、手写笔记、混合字体 | 任何体积 | 多模态模型 (GPT-5.2, Claude Sonnet, Gemini Pro) 在复杂文档上具有更高的准确率 |
| 敏感数据 不能离开基础设施 | 任何体积 | OCR (开源) Tesseract, PaddleOCR, EasyOCR:完全控制,本地部署 |
直接用API
调用多模态模型的API来直接处理图片和文档
嵌入(Embeddings)
相似度计算
余弦相似度衡量的是两个向量之间的角度,而不是它们的绝对距离。对于 RAG 系统而言,余弦相似度是首选的距离度量方法,因为它侧重于语义方向而非向量的大小.
这种对长度差异的鲁棒性至关重要,因为用户查询通常比检索到的文档短得多。如果没有进行归一化处理,较长的文档会因为篇幅较长而非相关性较高而主导排名。
嵌入模型选择
近年来,嵌入模型的发展速度不如语言学习模型(LLM)那么快。许多多年前构建的随机抽取(RAG)系统仍然使用 OpenAI 的 text-embedding-ada-002 模型,因为其精度对于检索任务来说仍然足够。这种稳定性意味着模型选择只需一次决策,很少需要重新调整
向量数据库
FAISS was released in 2017, followed by Milvus and Weaviate in 2019, Vald in 2020, Pinecone in 2021, and Chroma in 2023.
与此同时,PostgreSQL 和 Elasticsearch等传统数据库也已在其现有平台中添加了矢量搜索功能
选择数据库
如果embedding需要和用户数据放在一起,那么就需要使用传统数据库+插件的形式,如果只用于离线分析,那么就可以用FAISS或者本地的Chroma,如果系统规模很大,那么就用Pinecone或者Milvus.
| 决策问题 | 如果答案为“是”,优先考虑 |
|---|---|
| 是否允许将数据发送到第三方托管的云服务? | Pinecone 或 云托管 PostgreSQL |
| 目前是否已经在使用 PostgreSQL 或 MongoDB? | pgvector 或 MongoDB Vector Search |
| 是否需要将关键词检索与向量检索结合使用? | Elasticsearch、OpenSearch 或 Weaviate |
| 小型团队是否希望尽量降低部署和运维成本? | Chroma 或 托管版 Pinecone |
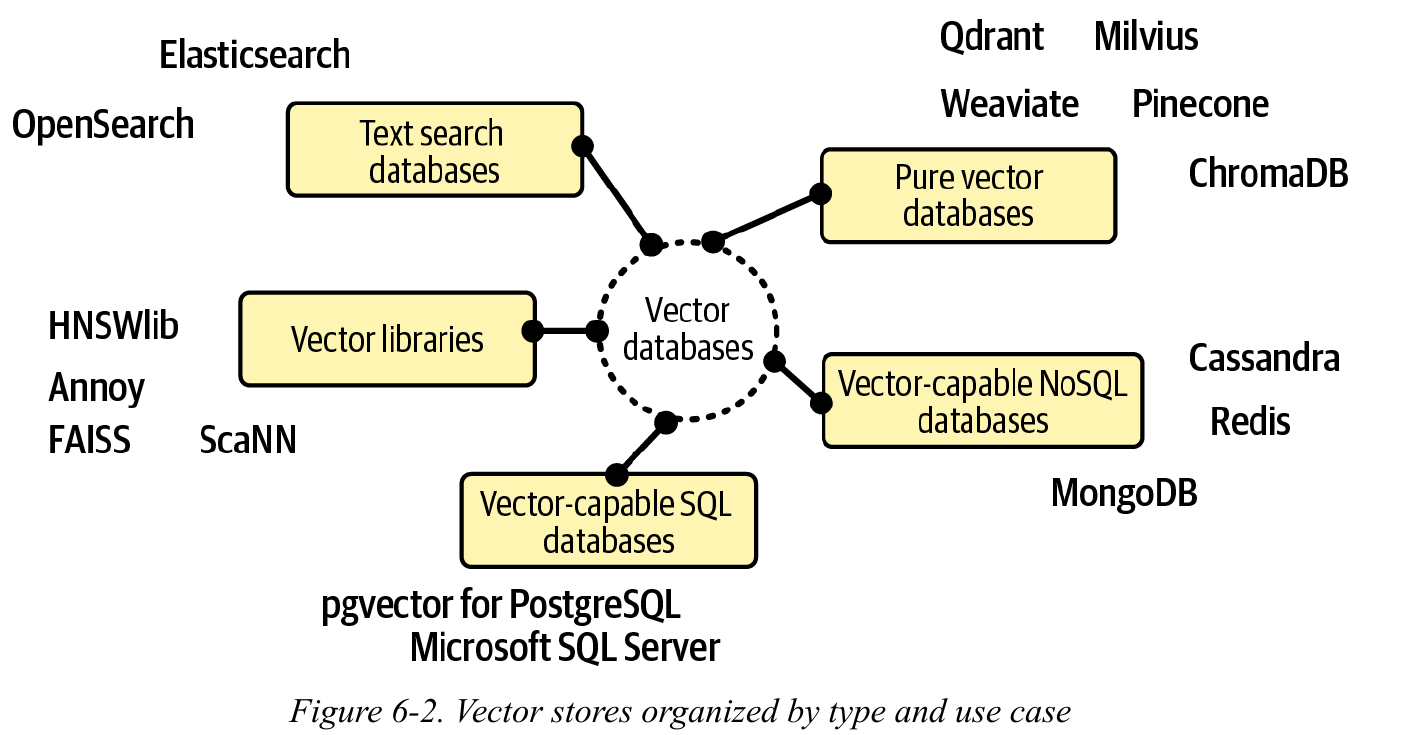
FAISS使用
| |
非常明显,FAISS是一个临时性的内存数据库,不能持久化存储数据,但用起来确实很简单.
Chroma使用
其实都大差不差,创建embedding,比较相似度,访问相似度最高的几个结果,除了API上不太一样外,原理是一样的.
pgvector
先创建容器:
| |
然后连接数据库并插入
| |
可以发现这和普通的事务没有任何区别,这也就意味着当数据规模增大时,就不能用pgvector来处理了,因为关系型数据库无法在大数据量下做到低延迟.
pgvector索引使用
值得注意的是,pgvector支持给向量加上索引,有IVFFlat 和 HNSW两种方式
| |
当查询速度至关重要且内存充足时,请选择 HNSW(HNSW 会在 RAM 中存储更多数据)。当内存受限或需要更快的索引构建速度(即使查询速度略慢)时,请选择 IVF。对于大多数拥有数百万个向量的生产级 RAG 系统,HNSW 可提供最佳的查询性能。
检索(待补充)
有以下七种检索的优化方法:
| 技术 | 描述 |
|---|---|
| 元数据过滤 | 利用元数据,根据对用户的了解来筛选搜索结果。 |
| 多查询检索 | 为同一提示创建多个版本,以便查找更多相关文档。 |
| 查询路由系统 | 使用查询路由系统来确定回答该问题的最佳数据源或工具。 |
| 自动合并检索器 | 通过对相关数据进行分组,检索更大、更有意义的文本块。 |
| 句子窗口检索 | 包含附近的句子,以便为检索到的文本添加上下文。 |
| 假设文档嵌入(HyDE) | 生成假设文档以改进搜索结果。 |
| 查询分解 | 将复杂查询拆分成更简单的子查询。 |
| 重新排名 | 通过 LLM 审查和评估检索到的文档的相关性。 |
Agentic RAG
自定义工具
| |
使用自定义工具来实现特定领域的功能,例如内部数据库、专有 API或业务计算。确保每个工具只专注于一项职责
Workflow Patterns
- Prompt chaining: 如从PDF中提取文本并进行翻译,每一个调用都依赖于前一个调用的输出,所以必须顺序执行
| |
- Routing: 由LLM选择合适的工具或者子工作流程
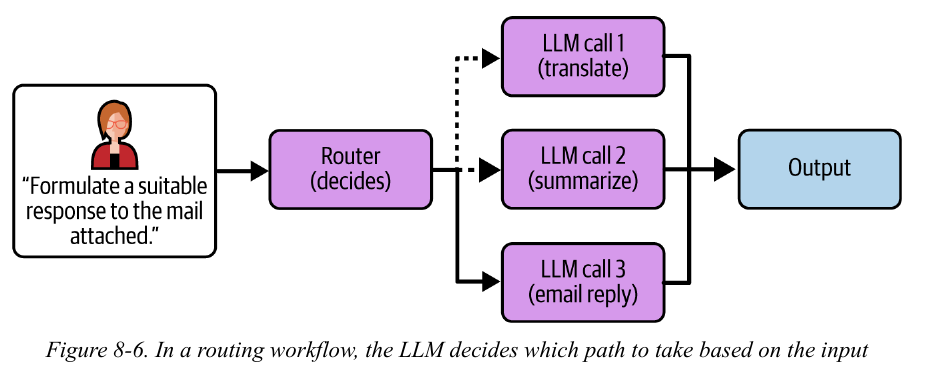
| |
- Parallel tasks: 并行调用多个工具或者API,从而缩短处理时间
| |
- Orchestrator-workers: 根据用户的问题,orchestrator可以调用一个或多个worker,并综合所有内容生成响应
| |
- Evaluator-optimizer: 一个LLM创建初始草稿,另一个LLM对其进行审核。系统在草稿创建和评估之间反复迭代,直到评估者满意或达到最大迭代次数为止
| |
Agentic Frameworks
| 等级 | 示例工具 / 框架 | 这一层级的核心特征 | 适用场景与说明 |
|---|---|---|---|
| 1. 低代码 / 无代码平台 | Microsoft Copilot Studio 等 | 通过可视化界面和预置能力快速搭建 Agent / 工作流,尽量减少底层代码与基础设施开发。 | 适合希望快速落地、开发资源有限的团队。若企业已经使用微软生态,Copilot Studio 往往更容易接入现有系统。优点是上手快、工程负担低;代价是定制能力和底层控制力较弱。截图中该行前半部分缺失,此处根据可见内容整理。 |
| 2. Agent 框架:代码优先(Agentic Frameworks, Code-first) | OpenAI Agents SDK、LangGraph | 提供构建 Agent 所需的基础组件,例如工具调用(Tools)、状态 / 记忆与持久化(State / Memory / Persistence)、运行追踪(Tracing),以及常见的 Agent 设计模式。 | 适合希望比完全从零开发更快,同时又想保留代码级控制权的场景。较轻量的框架(如 OpenAI Agents SDK)通常能减少框架绑定,使以后切换框架或迁移到自研架构更容易。 |
| 3. 从零构建:最大控制(From Scratch, Maximum Control) | 直接调用模型 API + 自研编排层 | 直接调用 LLM 提供商的 API,并自行实现**编排(Orchestration)、工具系统、状态管理、记忆、可观测性(Observability)**等完整基础设施。 | 适合需要最高灵活性、可控性或系统健壮性,且团队有能力维护完整技术栈的场景,包括**日志(Logging)、链路追踪(Tracing)、安全护栏(Guardrails)**等。工程投入最大,但拥有最高程度的架构自主权。 |
| 典型场景 | 从零构建 | 轻量级框架 | 高抽象框架 | 优化后的说明 |
|---|---|---|---|---|
| 需要在几周内完成 Agentic RAG 应用,并快速投入生产 | △ | ✓ | ✓ | 框架更适合快速交付。 LangChain 等高抽象框架已经封装了大量 RAG、工具调用和 Agent 能力,可以显著缩短开发周期;轻量级框架也能减少样板代码。完全从零构建通常需要自行处理编排、状态、错误恢复等基础设施,达到稳定生产状态所需时间更长。 |
| 应用由大量初、中级开发人员共同维护 | △ | ✓ | ✓ | 框架有利于团队协作和代码规范化。 从零构建通常要求开发人员较深入地理解 Agent Loop、状态管理、工具调用等机制;框架则提供统一的接口、项目结构和常见设计模式,使不同经验水平的开发者更容易遵循一致的开发规范。 |
| 系统需要服务数千乃至数百万用户,强调稳定性与可扩展性 | ✓ | ✓ | ○ | 越接近底层,通常越容易精细控制性能和依赖。 从零构建或采用轻量级框架,可以减少不必要的中间层与第三方依赖,从而更容易进行性能优化、水平扩展和故障定位。高抽象框架同样可以扩展,但复杂抽象和额外依赖可能增加性能调优与故障排查成本。 |
| 需要针对特定业务需求构建高度灵活、深度定制的 Agent | ✓ | ✓ | △ | 从零构建拥有最高控制力。 开发者可以完全决定 Agent Loop、工具系统、提示词、状态结构、记忆机制以及各组件之间的交互方式。轻量级框架通常也能保留较大的定制空间;高抽象框架虽然开发方便,但当需求偏离其预设模式时,可能受到框架抽象的限制。 |
| 需要实时调试、可观测性、执行透明度以及审计 / 合规日志 | ○ | ✓ | ✓ | 框架通常能够减少可观测性基础设施的建设成本。 许多 Agent 框架已经提供 tracing、运行轨迹、工具调用记录和调试能力,可以观察 Agent 每一步的执行过程。从零构建也能够实现完整的日志、链路追踪和审计系统,但这些能力通常需要自行设计和维护。 |
符号说明: ✓ = 较适合;○ = 可以采用,但存在一定额外成本;△ = 通常不是该场景下的优先方案。
asyncio加速
| |
调用工具时,我们自然希望越快处理完越好,比如对pdf进行分页拆分,最好的方法就是开多个线程同时进行处理,并使用异步调用.
OpenAI Agents SDK介绍
OpenAI Agents SDK是OpenAI推出的智能体构建轻量框架,待我日后试试效果
LangGraph
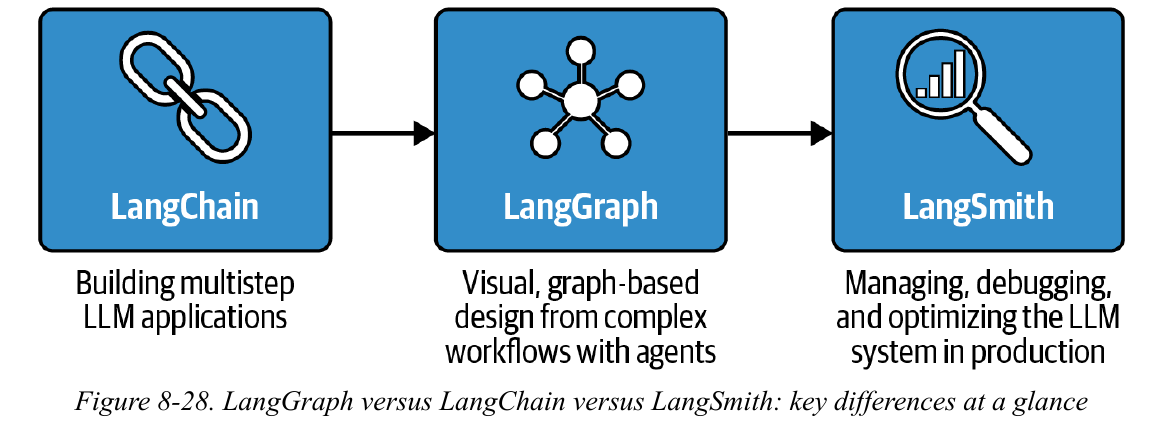
对于简单的线性工作流程,请避免使用 LangGraph。如果您的代理执行的是固定序列,没有分支逻辑或共享状态,那么图抽象只会增加复杂性而没有带来任何好处。
当协调多个共享上下文的代理时,状态管理尤为重要。LangGraph 会自动维护共享状态。
Graph RAG
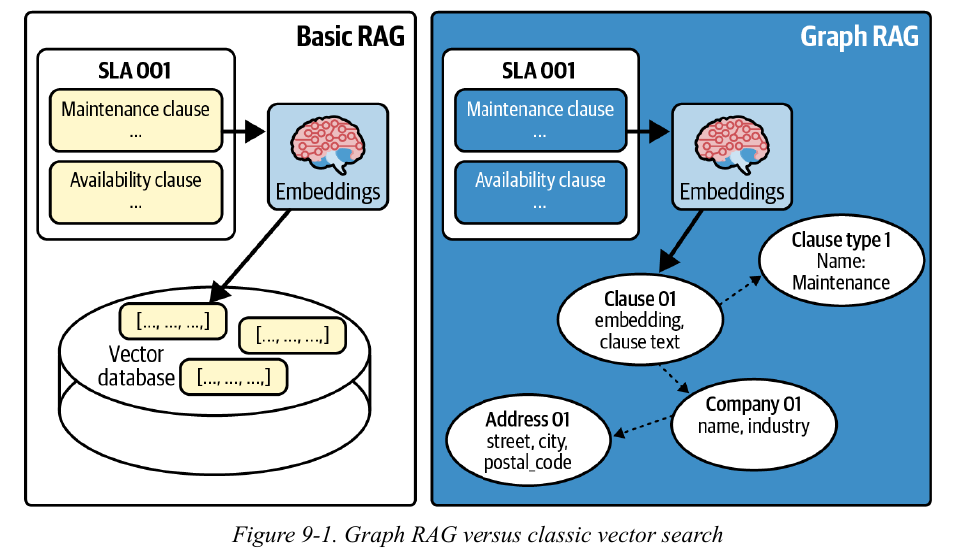
最常用的图数据库自然是Neo4j
补充: docker启动neo4j
| |
NEO4J_AUTH: neo4j/your_password字段分别对应账户名和密码
非常遗憾的是,这部分的叙述非常草率,所以只好我自己去看文档学习了
评估RAG系统
给了一些比较实用的判断RAG效果的方案
总结
干货确实很多,尤其是前几章,读起来很有收获.
Vector Databases(待补充)
- 出版于2026年,出版商:O’Reilly,作者:Nitin Borwankar。
- 非常适合作为工具书,入门某个新框架
介绍
相似性搜索
想象一下,你正在搜索一家公司的知识库,然后你输入“如何才能拿回我的钱?”接下来会发生什么?
- keyword search: 系统对你的查询进行分词后直接搜索文档,但如果文档使用诸如
Refund policy等相近的词则找不到答案 - Semantic search: 系统会尝试理解用户输入,并匹配多种语义相近的结果
传统的关系型数据库和NoSQL数据库都无法很好的适应向量处理,而单纯的向量数据库(只存储向量)又丢失了查询的灵活性和存储效率,也不再具备索引功能,所以一个折衷的方式就是混合架构,将向量功能作为扩展插入到关系型数据库和NoSQL数据库中
嵌入
两种嵌入思想
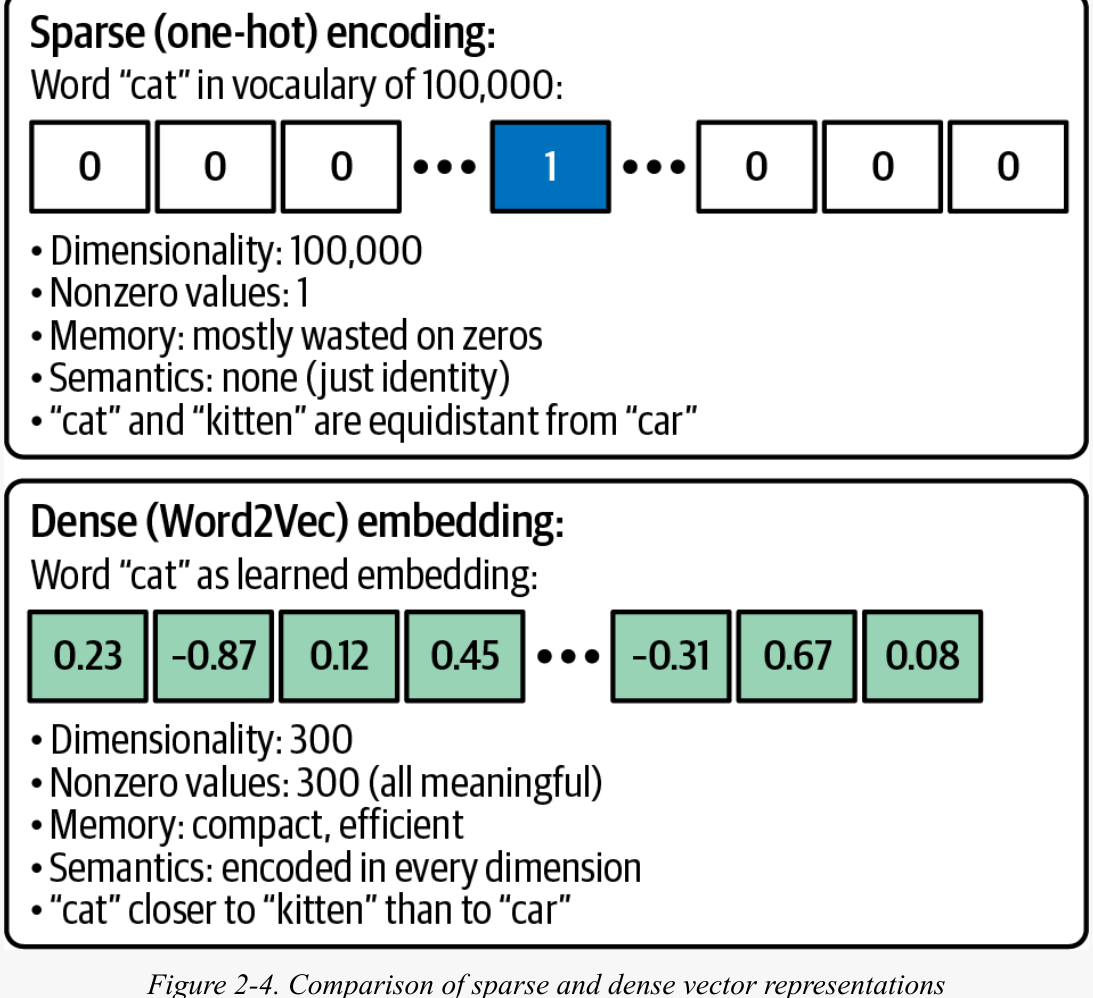
实践指南
- 批处理: 加快处理速度
| |
- 控制长度: 不要嵌入一整个段落,而是分成固定大小的片段
| |
- 归一化: 所有向量都要弄成统一的长度,不然无法比较
| |
- 使用GPU:
| |
- 控制内存使用: GPU太贵了
| |
FAISS使用
SQLite3使用
pgvector使用
AI Agents in Action,Second Edition
- 出版于2026年(第2版),出版商:Manning,作者:Micheal Lanham。
介绍
背景
| 模式 | 审批机制 | 自主程度 | 典型用途 | 示例平台 |
|---|---|---|---|---|
| 直接式 LLM 对话(Direct LLM Chat) | 无需工具调用。 模型仅根据用户输入直接生成文本回复。 | 无 | 问答、文本起草、头脑风暴、知识学习 | 原版 ChatGPT(2022);早期 Claude(2023) |
| 工具增强型 LLM(Tool-Augmented LLM) | 单次调用级的隐式授权。 用户的一次提示可触发模型调用一个工具,通常无需逐步确认。 | 低 | 图像生成、联网搜索、简单信息查询 | 集成 DALL·E 的 ChatGPT;集成 Google Search 的 Gemini |
| AI 助手(Assistant) | 任务级审批。 系统执行具体操作时,通常需要用户对关键步骤或每项操作进行确认。 | 中 | 结对编程、带引用的资料研究、文档编辑 | GitHub Copilot Chat、Cursor、Excel 中的 Claude |
| AI 智能体(Agent) | 目标级授权 + 高风险操作审批。 用户设定总体目标,智能体自主规划并执行多个步骤;涉及高风险或敏感操作时再请求用户确认。 | 高 | 多步骤研究、代码仓库级重构、浏览器自动化、复杂任务执行 | Claude Code、OpenAI Operator、Devin |
实现一个目标很有可能需要调用多个工具:
| 目标(Goals) | 任务(Tasks) | 工具(Tools) |
|---|---|---|
| 创建图像 | 创建图像 | create_image |
| 前往卡尔加里(YYC) | 搜索航班 | search_flights |
| 前往卡尔加里(YYC) | 预订航班 | book_flights |
| 前往卡尔加里(YYC) | 预订酒店 | book_hotels |
| 前往卡尔加里(YYC) | 预订交通 | book_transportation |
| 购买一台电脑 | 搜索符合需求的电脑 | web_search |
| 购买一台电脑 | 比较配置、功能与价格 | web_search |
| 购买一台电脑 | 下单购买电脑 | order |
MCP
传统上,智能体和生命周期管理(LLM)只能使用代码库中现有的工具。这种限制很快就成了问题,因为智能体开发者往往花费更多时间构建工具,而不是开发智能体本身。试想一下,一个智能体需要读取你的日历、发送 Slack 消息、查询 Postgres 数据库并创建 Jira 工单。如果没有共享协议,开发者就必须编写和维护四个独立的工具封装器,跟进四套不同的 API 变更,并且每次都要重新实现相同的身份验证、重试和模式处理逻辑。如果一个团队要开发多个智能体,那么大部分工程时间都将耗费在工具底层架构上,而不是智能体的行为本身。
这种情况如今已有所改变。诸如Model Context Protocol (MCP) 之类的协议允许智能体与自身代码库之外的工具进行交互。智能体无需在内部重新构建每个集成,而是可以调用由服务提供商或社区维护的专用工具服务器。MCP 的出现标志着智能体构建方式的转变,从嵌入在每个智能体代码库中的定制工具库,转向标准化的、可发现的外部工具服务器生态系统。
- 这确实是我现在做Agent项目的痛点,想要将联网搜索接入Agent里,没有经验的话根本无从下手
MCP 由 Anthropic 开发,将于 2024 年 11 月发布,它是一种基于JSON-RPC 2.0 的开放标准。其设计目标是使人工智能系统能够以一致、安全且高效的方式连接到外部服务.
MCP
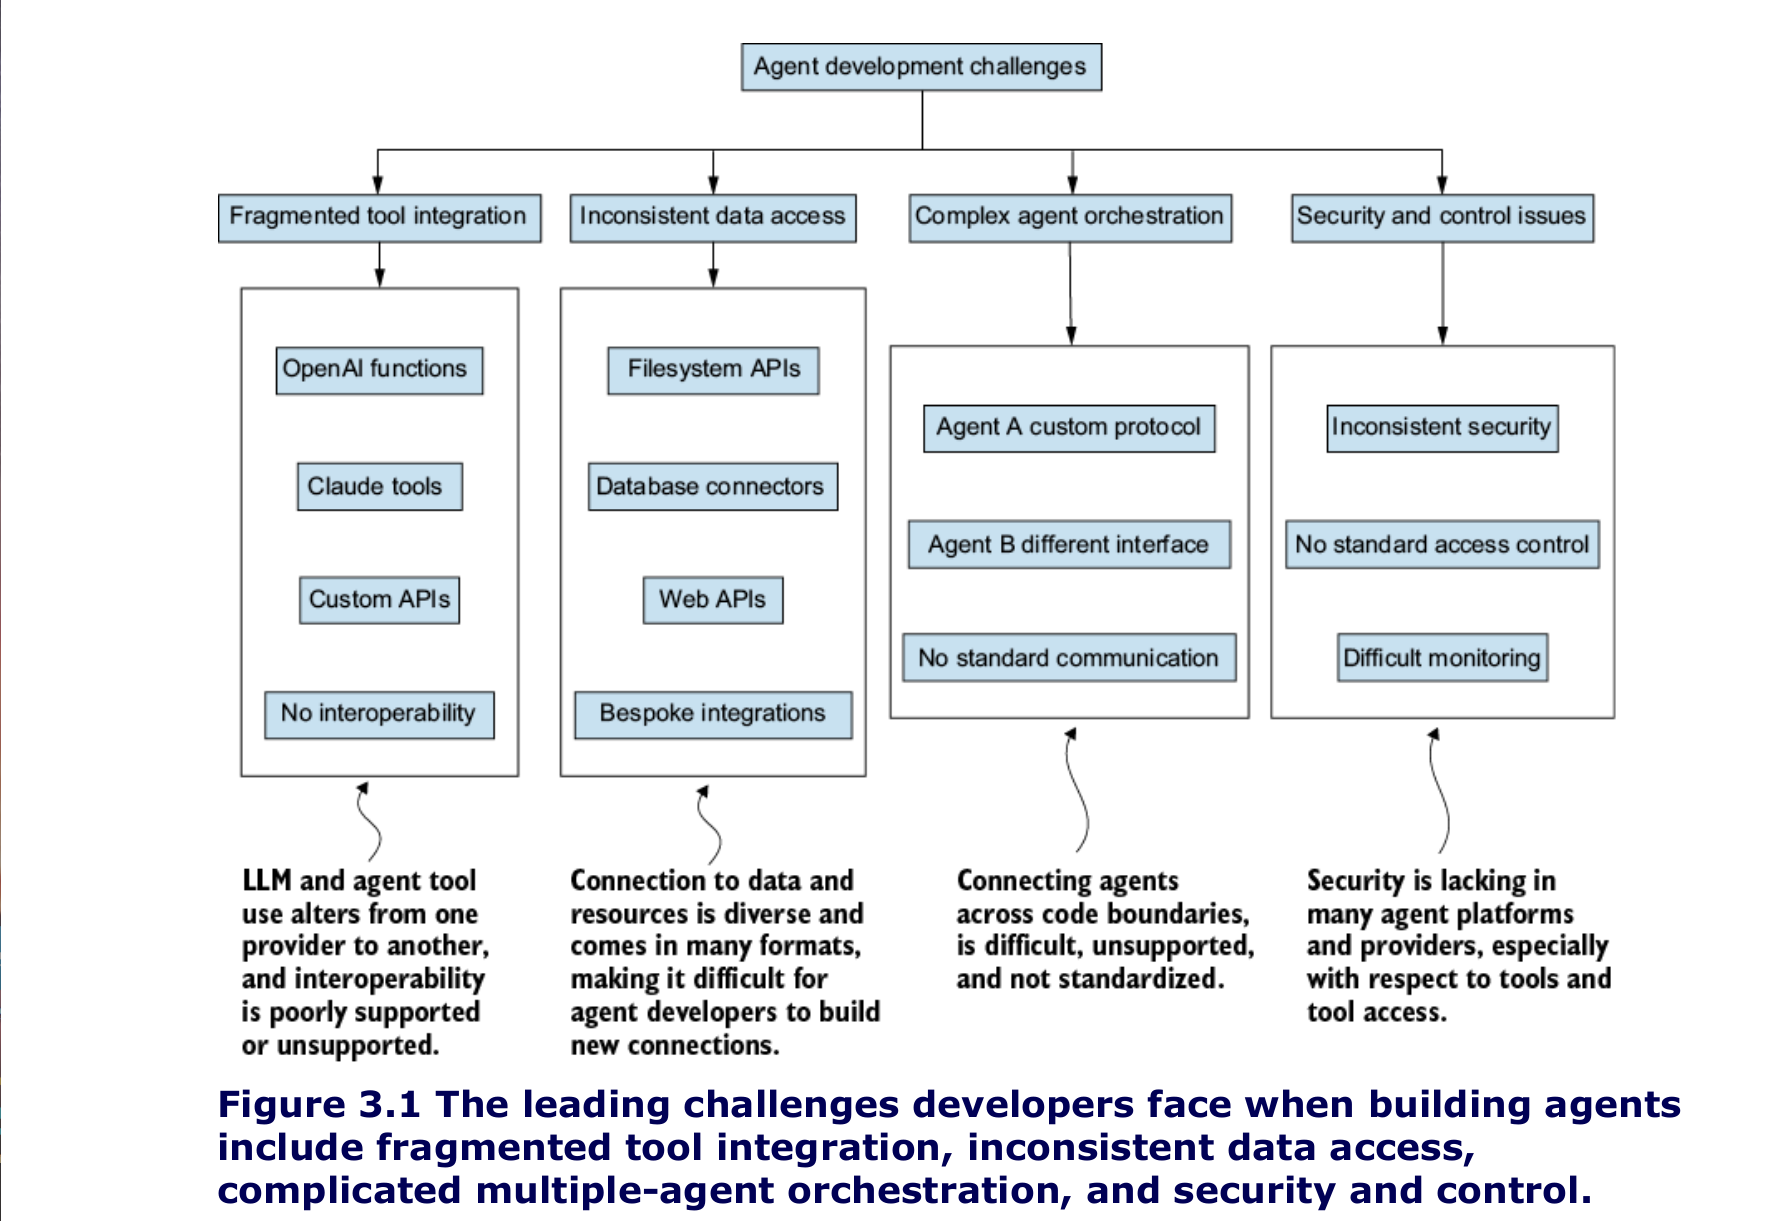
部署方式
- 本地部署(STDIO 传输)
- 低延迟通信
- 无网络开销
- 进程管理简单
- 非常适合开发与单机部署
- 远程部署(SSE 传输)
- 分布式代理架构
- 跨多个代理共享工具服务器
- 可扩展的云原生部署
- 多租户与负载均衡
- 混合部署
- 本地服务器:用于处理敏感操作(如文件访问、本地数据库)
- 远程服务器:用于提供共享服务(如网络搜索、外部 API)
- 代理间通信:通过远程 MCP 服务器进行代理与代理之间的通信
| 名称 | 工作原理 | 何时应该使用它 |
|---|---|---|
| STDIO 标准 | 客户端在同一主机上以子进程的形式启动 MCP 服务器,并通过该进程的标准输入/输出管道交换 JSON-RPC 2.0 消息。 由于不涉及任何网络协议栈,因此该链路延迟很低,但严格来说是一对一的:只有启动服务器的父进程才能与其通信。 | • 本地开发或快速 CLI 实验,希望将所有操作都保留在单个 shell 会话中。 • 命令行工具或脚本,用于启动一个专门用于当前任务的辅助 MCP 服务器(例如, mcp dev my_server.py)。• 以交互方式运行的容器( docker run -it ...),并通过 stdio 进行通信,以避免打开端口。• 简单的流程间集成,不需要远程访问、反向代理或多客户端支持。 |
| SSE 服务器发送事件 | MCP 服务器以 HTTP 服务的形式运行。 客户端向 /messages 发送 JSON-RPC 请求,而服务器则通过长连接(例如 /sse)以流式方式发送响应和通知。这使得该通道为半双工模式(客户端到服务器通过 HTTP POST,服务器到客户端通过 SSE),但完全可网络寻址,并能够同时服务多个客户端。 | • 远程或云端部署,其中工具必须可通过网络或反向代理/负载均衡器访问。 • 基于浏览器或前端的应用程序,需要实时流式传输(逐令牌的 LLM 输出)而不需要 WebSocket 复杂性;SSE 可以穿透大多数防火墙和代理。 |
Multi Agent
背景
单智能体系统出现后不久,开发者和研究人员便开始增加智能体的数量。其理念很简单:智能体越多,就能处理和解决更复杂的目标。
2023 年的浪潮(AutoGPT 和 BabyAGI)率先风靡一时,但都在几周内暴露出同样的缺陷。在演示中,一个智能体不断生成子目标的无约束循环令人印象深刻,但在实践中却十分脆弱。下一波浪潮则着眼于结构化:
- MetaGPT 引入了基于角色的团队,模拟软件公司(CEO、产品经理、工程师、QA)。
- CrewAI 和 AutoGen 则规范了协作团队模式,明确了智能体的职责和沟通渠道。
到 2024 年,实验的重点已经从 “增加智能体数量就能解决问题” 转向 “合适的智能体结构就能解决问题”,并涌现出几种关键架构。
也是在这一时期,**日益复杂的单智能体系统(increasingly complex single-agent systems)**开始涌现。其概念很简单:单个智能体无需复杂的多智能体协调与通信策略(a lone agent eliminated the need for complex multi-agent coordination and communication strategies)。然而,在实践中,单智能体在以下方面都存在局限性:
- 工具使用(tool use)
- 推理与规划详细任务(reasoning and planning for detailed tasks)
- 切换关注点(the ability to switch focus)
三种架构
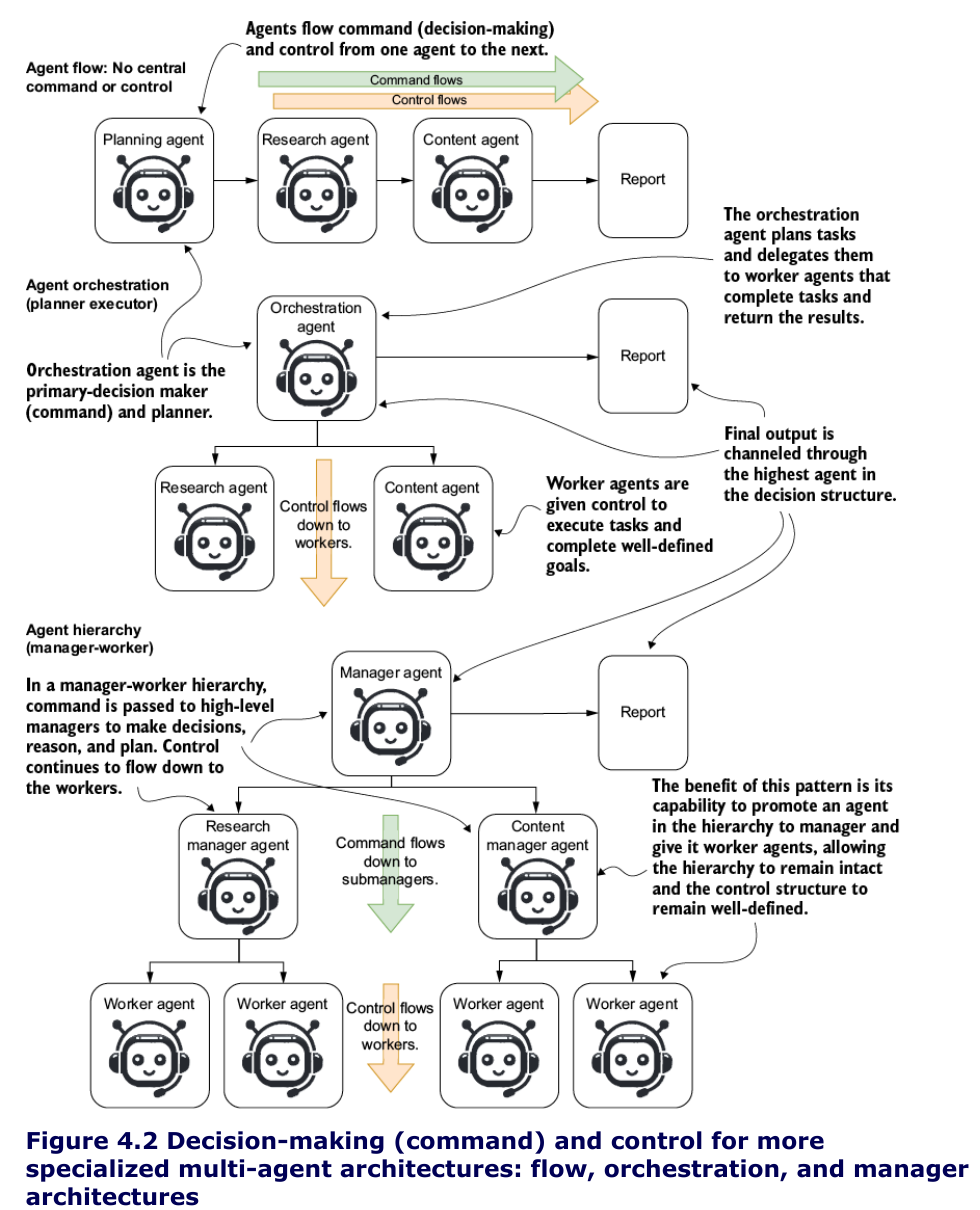
优缺点:
| Pattern | Pros | Cons |
|---|---|---|
| Flow | • Breaks down a complex single agent • One large goal can be easily decomposed • No need for complex decision-making • Easy to evaluate and debug | • Lacks the ability to partially execute all agents; generally all or nothing • Poor decision-making ability • Fragile: if a single agent fails, the whole flow fails |
| Orchestrator | • Handles complex decision-making • Executes some or all agents as needed • Well-suited for direct user interaction • Robust; worker agent failures can be easily recovered | • Complex to build, debug, and evaluate • Orchestrators need strong evaluation, guardrails, and feedback mechanisms |
| Collaboration | • Ambiguous, complex goals and tasks with multiple possible outcomes | • Costly, with high token usage and high latency • Difficult to build evaluations and feedback mechanisms |
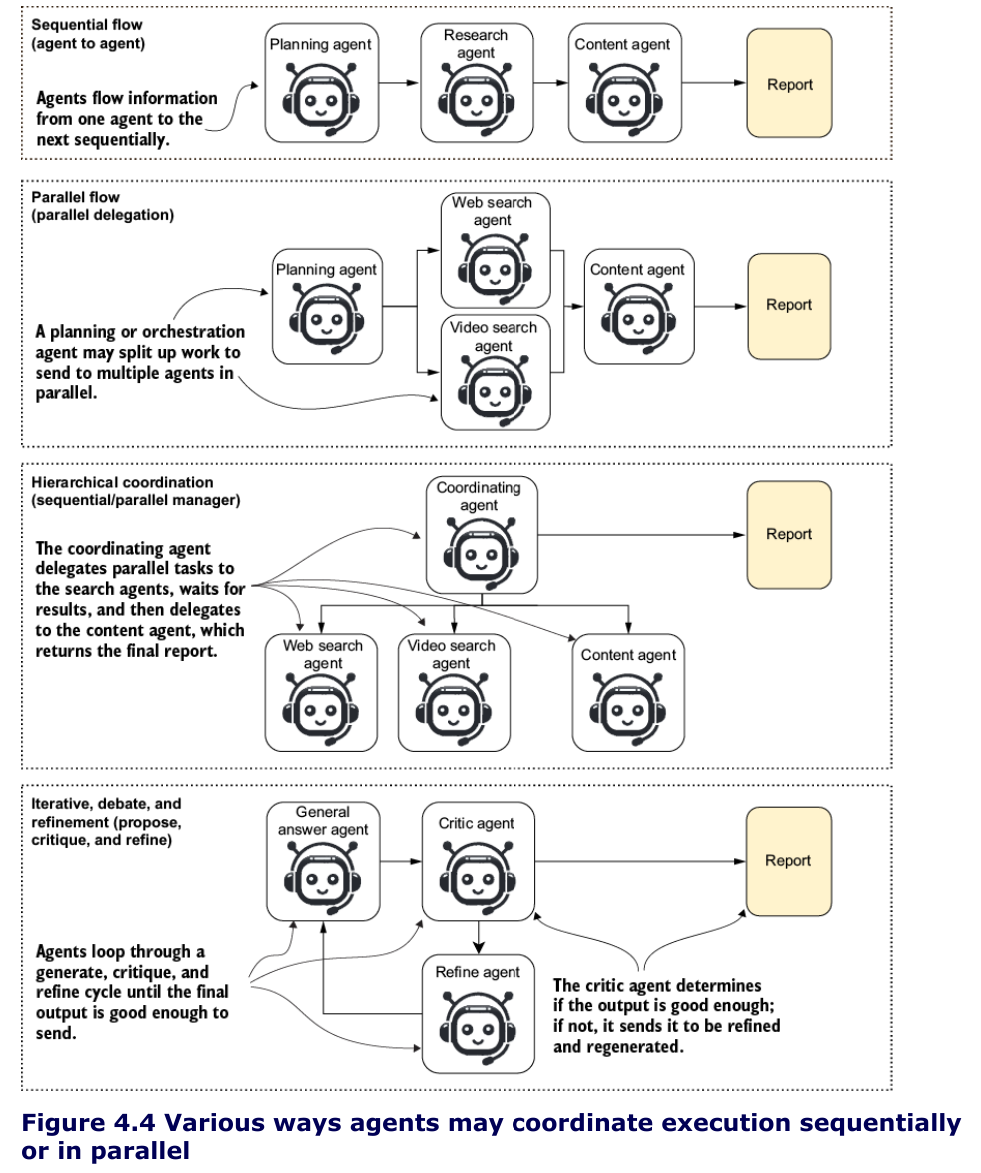
- 想法固然是好的,但这需要在API足够强大的基础上才可以实施,一个顶级API足够碾压一堆弱智AI了
具体设计(待补充)
以后再来读
Agent reasoning and planning
- 选用CoT模型和对非CoT模型使用CoT提示词
- ToT和Reflextion则是两个比较高级的框架技巧:
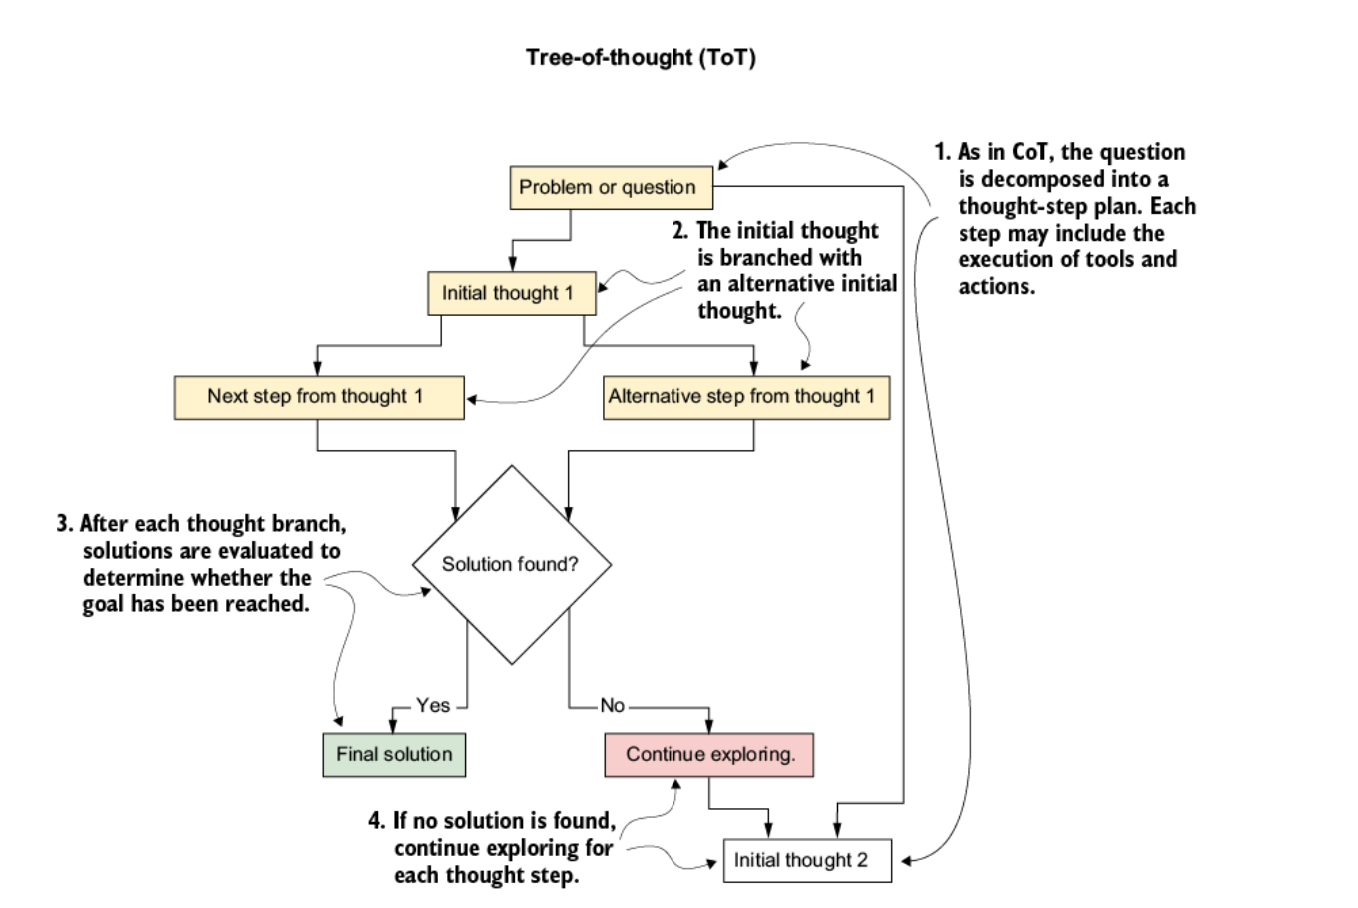
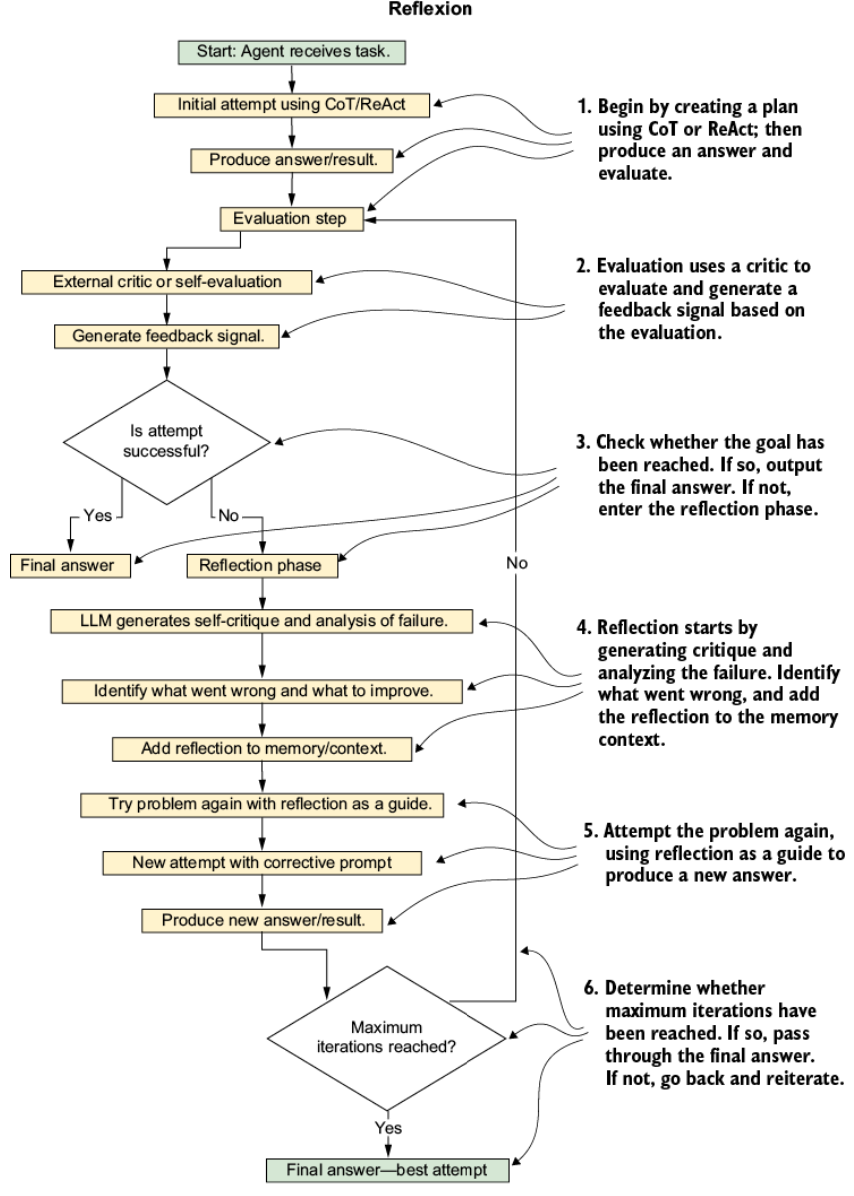
RAG
自然不如专门的书来得详细,可以直接跳过
设计循环
| |
想法上很简单,设置一定量的循环次数,每次检查当前任务目标,并将其分配给子Agent.但真要做成一个完备的Agent还是有难度的.
总结
剩余内容就没必要看了
Agentic Design Patterns
- 出版于2025年,作者:Antonio Gullí。
ch1: Prompt Chaining
简单来说就是将复杂问题拆分成链式的递进式子任务,从而显著提高可靠性.
从我的亲身经历来看是很有用的,让Agent分阶段构建的效果远超过一次构建的成果.
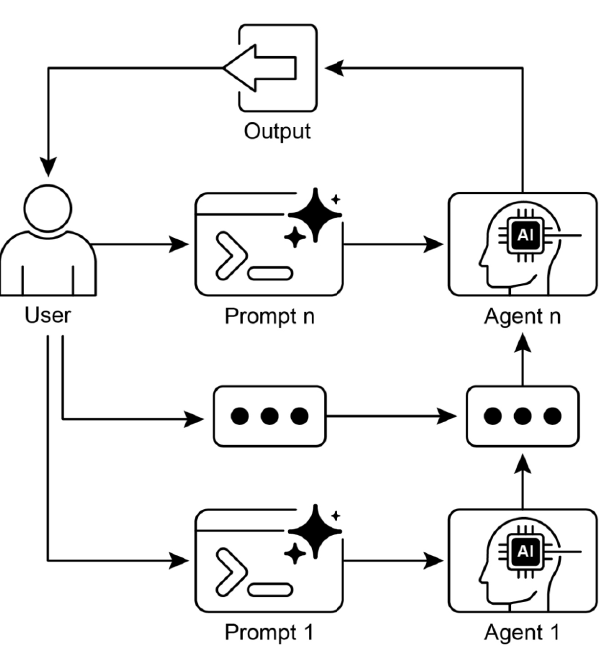
ch2: 路由
路由机制将条件逻辑引入到智能体的操作框架中,使其执行路径从固定不变转变为动态评估特定标准,并从一系列可能的后续动作中进行选择。这使得系统行为更加灵活,并能更好地感知上下文
自然,自己手搓是根本无从下手的,还是得用langchain或者langgraph等框架
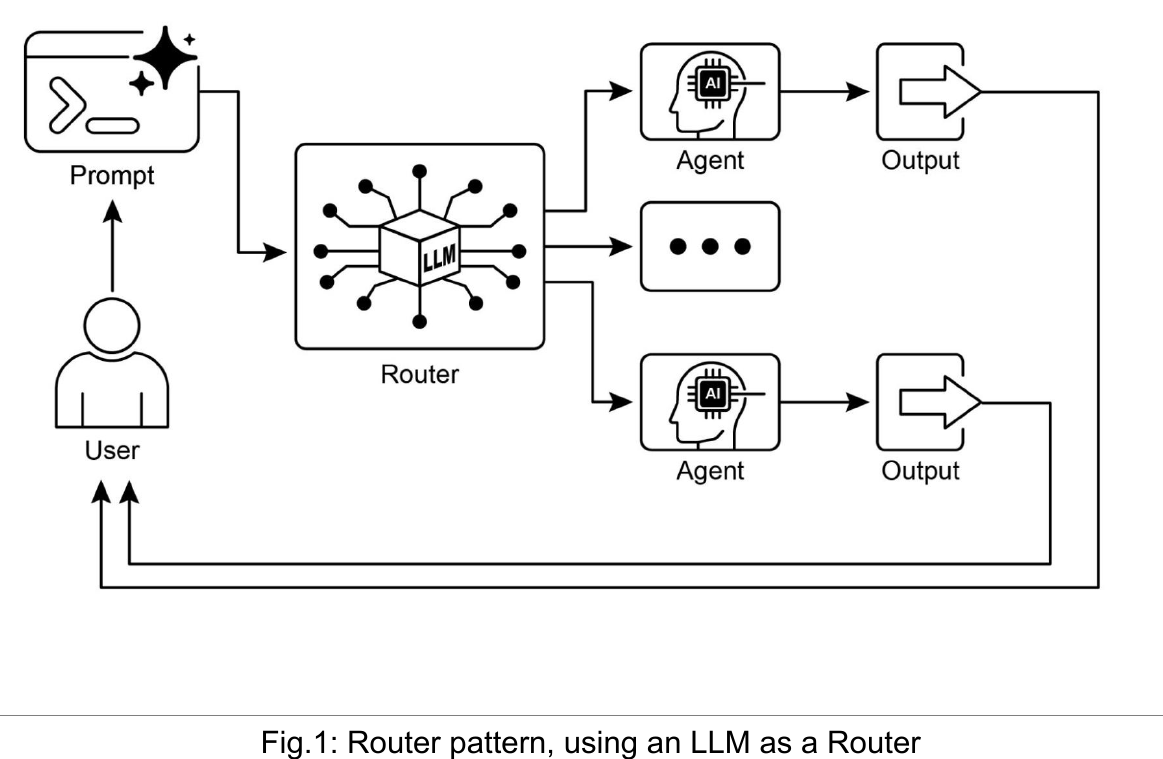
其实目前的LLM平台都是路由机制的,根据当前任务的要求调用某个子智能体实现,处理完毕后返回结果供Supervisor处理,因此还是线性的,无法做到parallelization
ch3: 并行
LangChain、LangGraph 和 Google ADK 等框架提供了并行执行机制
有如下两个案例:
- 一个Agent正在调查一家公司。为尽快形成全面判断,他会同步开展多项工作:一边搜索相关新闻报道,一边提取股票数据,查看社交媒体上的相关提及与舆情动态,同时查询企业数据库中的背景信息。通过这种并行处理方式,他能够比按顺序逐项检索更高效地整合信息,更快获得对公司的整体认识。
- 一个Agent正在分析客户反馈。面对一批反馈数据,他会同时进行情感分析、提取关键词、对反馈内容进行分类,并识别其中需要优先处理的紧急问题。借助这种并行分析方式,客服人员可以在更短时间内从多个维度把握客户意见,从而快速形成更全面、更有针对性的分析结果。
| |
上述编排方式的缺点是相当明显的: 僵化,每换一个需求就要重新写一次代码,如果能够结合ch2中的路由方法,由Agent决定何时并行,调用哪些Agent,具体工作是什么,那么才是真的有用.
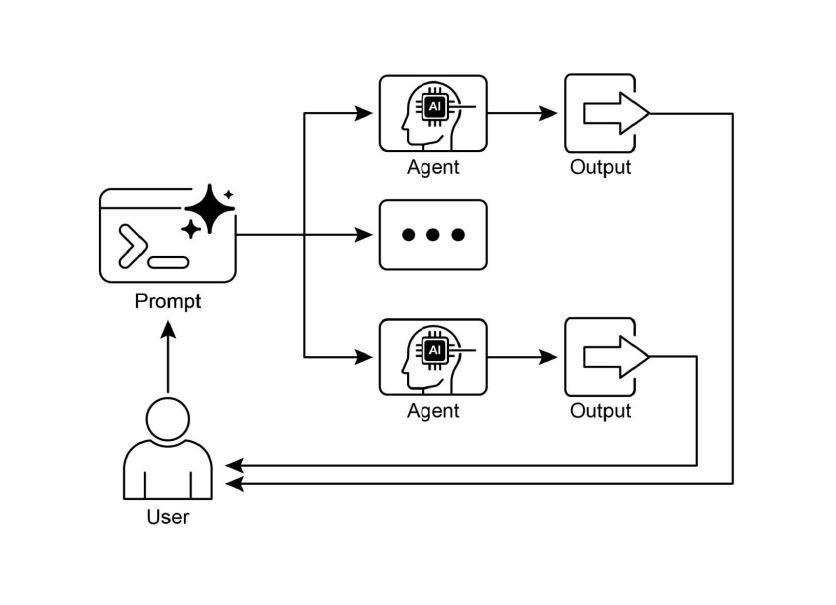
ch4: Reflection
反思模式是指智能体评估自身的工作、输出或内部状态,并利用评估结果来改进自身表现或优化响应。这是一种自我纠正或自我改进的方式,使智能体能够根据反馈、内部评价或与预期标准的比较,迭代地优化输出或调整方法
虽然单个代理可以进行自我反思,但使用两个专门的代理(或使用不同的系统提示进行两次独立的LLM调用)通常能产生更稳健、更客观的结果
This is also often called the “Generator-Critic” or “Producer-Reviewer” model.
| |
这种模式同样有问题,你不可能说每遇到一个新问题都整一个你是一名专业的XXX...吧,所以只能在单个Agent内部使用,自己核查自己,而且不需要额外的指令,除非用更高级的API来做Critic,但又话说回来,为什么不让更高级的API来干活呢.
ch5: tool use
使用工具是LLM进化为Agent的必经之路
ch6: Planning
简单来说就是让LLM先生成规划,再实际做事,这是非常合理也很有用的一招.
ch7: 多智能体合作
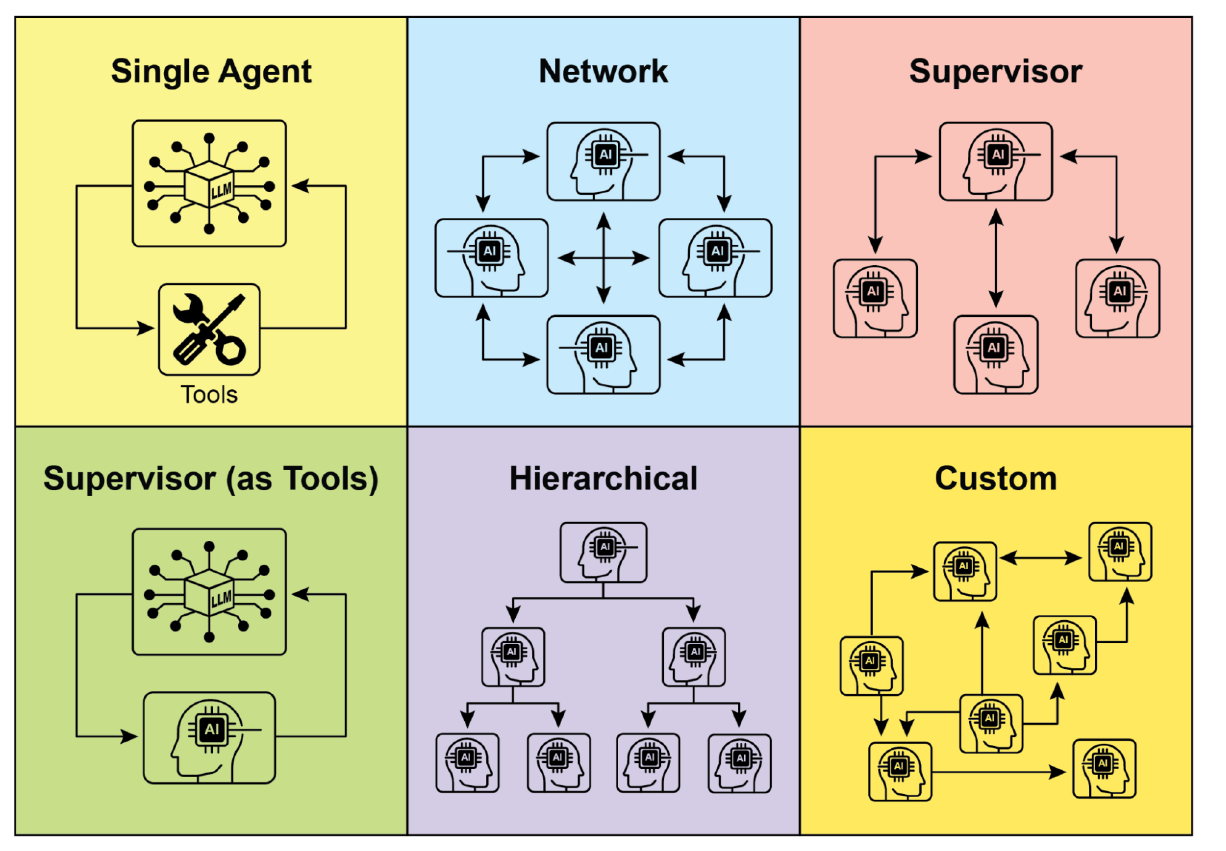
监督者模式肯定是有用的,但是层级Agent是很难处理的,除非你能实现动态负载和扩展,并且保证消息传递中的误差比较小,否则即便只给每个底层Agent一个很简单的要求,实现的效果也是差强人意的.
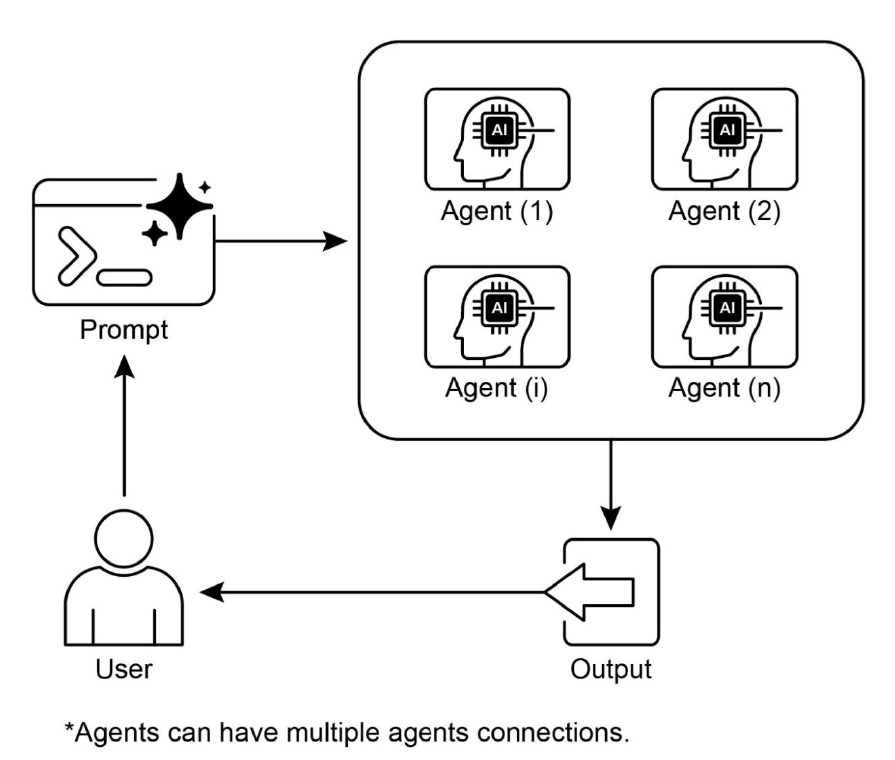
ch8: Memory Management
本章将深入探讨内存管理,重点关注智能体的即时(短期)记忆和持久(长期)记忆需求
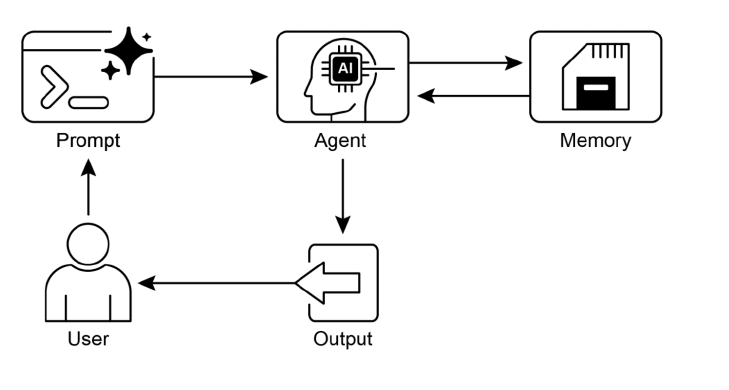
其实就是上下文窗口和RAG嘛
ch9: 学习和适应
道理很简单,只要还是调API,就不可能真正学习好不好…
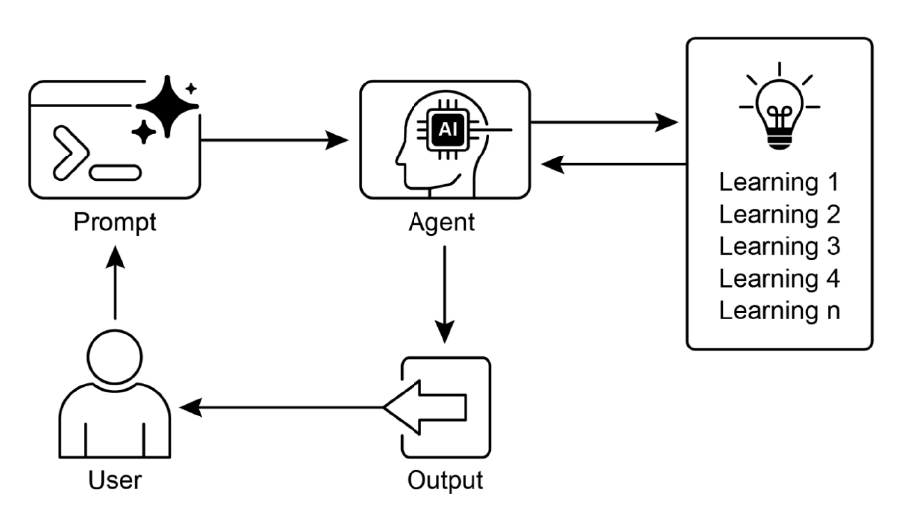
ch10: MCP
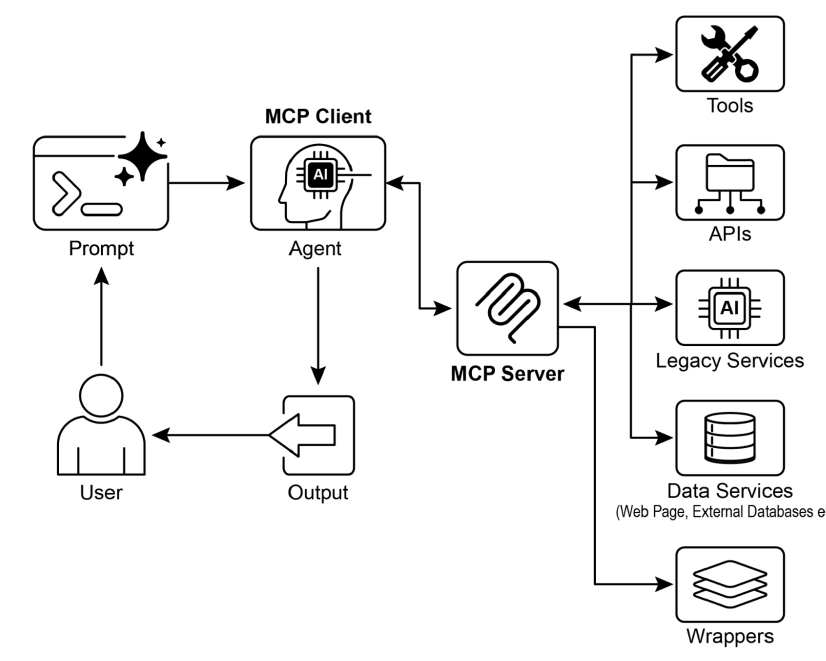
ch11: Goal Setting and Monitoring
其实就是Planning+Reflection(先制定目标,然后迭代检查是否达成当前目标),不过GPT6已经开始使用这个模式了,效果还是很不错的.
ch12: 异常处理
- 错误检测: 如特定的 API 错误(例如 404(未找到)或 500(内部服务器错误)代码);无效或格式错误的工具输出
- 错误处理: 如日志记录,重试参数,采用替代策略.
- 恢复: 撤销数据库更改,状态回滚等
这个实际上是Agent的必备模式,如果工具调用失败或者用户参数有误,不能清晰返回异常信息的话很容易就流式用户,或者难以调试.
ch13: Human-in-the-Loop(HITL)
简单来说就是引入人类输入和监管,但道理很简单,如果都要人类来操作了,那我引入AI干嘛.
ch14: RAG
ch15: Inter-Agent Communication(A2A)
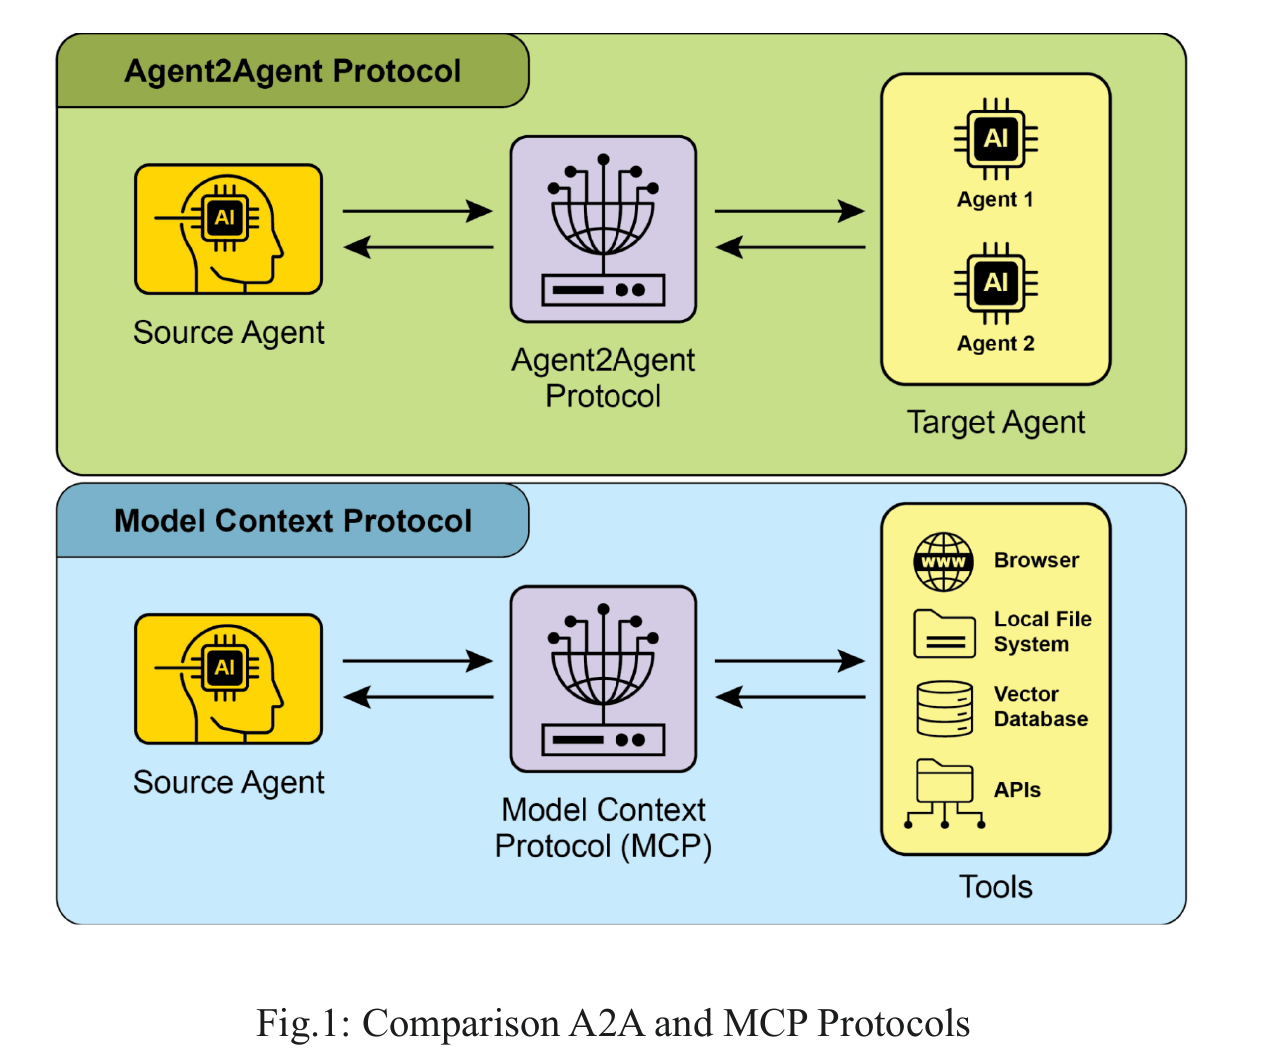
其实如果你觉得另一个AI很牛,那不就换到这个AI就行了,要什么沟通,这就是单纯的零和博弈.而简单的任务交给杂碎AI就行了,双方的地位是不可能对等的,因此用MCP就足够解决了.
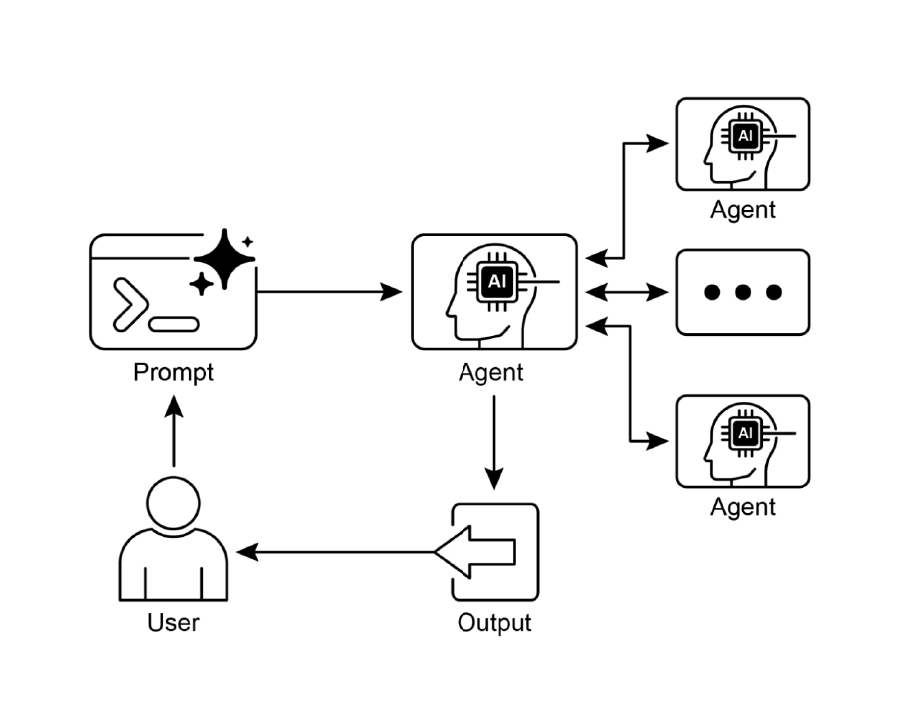
ch16: Resource-Aware Optimization
简单来说就是自己换API,其实还是路由的问题,先判断一次任务强度/种类,然后逐级切换即可.
ch17: Reasoning
有几个路子: CoT,ToT,ReAct.
ch18: Guardrails
实际上只能通过模型内部训练来避免,毕竟不能每次都加上一长串的系统提示词来告诉AI不要输出有害内容吧.
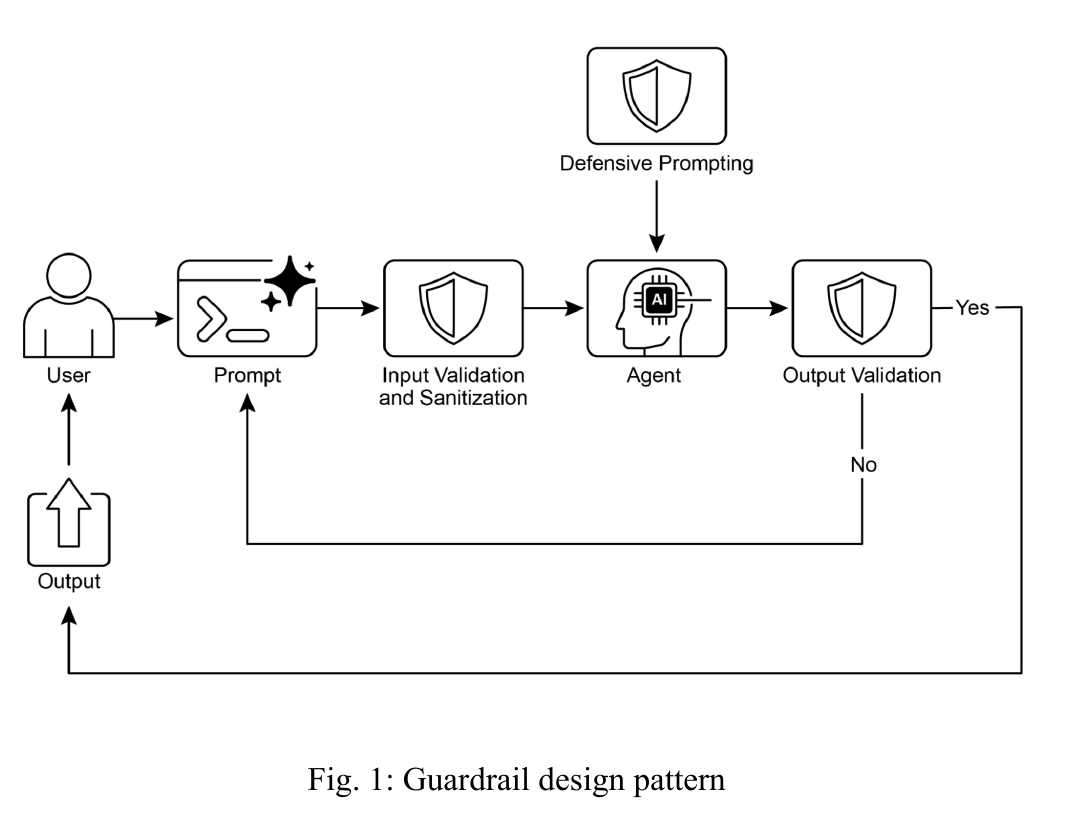
ch19: 评估与监测
这个自然是要引入Agent测试框架了,从而做到精准测评.
ch20: Prioritization
多任务时对任务排序,优先执行最重要的,其实还是路由问题
ch21: Exploration
很复杂的设计,想必很难用.
总结
还是很不错的,把所有Agent的常见Pattern都讲了一遍.
The Agentic Enterprise
引言
鉴于多智能体系统的强大功能,我们可以预见未来组织的架构将由相互关联的智能体构成;然而,在可预见的未来,除非文化和社会发生根本性变革,智能体被赋予某种程度的人格,否则人类仍将是责任的唯一承担者。这意味着,多智能体系统的控制和设计将以人类为最终仲裁者和高风险行为审批者。
ch1: Agent引入企业
一些作者的沉思,还是有点看头的
ch2: 商业案例
现在采取行动拥抱代理式AI(Agentic AI)的论据并非建立在炒作之上,而是建立在证据之上。在接下来的篇幅中,我们将探讨促成这一绝佳战略时机的三大汇聚力量:已跨越成熟门槛的技术、正在重塑竞争格局的经济压力,以及已经开始奠定基础的组织机构。
一旦竞争对手利用智能体在几分钟内完成决策,无论是重新规划供应链、调整报价还是集中营销最有潜力的客户,任何仍然需要耗费数天时间进行人工协调才能完成同样工作的组织都将面临日益严峻的竞争劣势。
ch3: 实际应用
本章提到的许多多智能体系统实际上是使用名为 NeuroSAN 的开源多智能体平台创建和部署的。该平台易于构建智能体系统,因此推荐给技术水平较低的读者使用。
其实就是在我之前的Agent思考上扩展探究了,找到了更多的Agent应用层面.
ch4: 评估风险
分析了三个公司实际使用Agent带来的提升,要我说,这些指标未必有那么有用,但用了Agent就肯定是有提升的,无论在文档操作还是代码编写上,或多或少能帮到一点.
ch5: 如何引入Agent
简单介绍如何接入Agent
ch7: 信任Agent
在商业环境中,责任通常指的是谁负责执行某项任务,而问责指的是谁最终对结果负责并必须对此负责(向管理层、监管机构或客户)。正是基于这种区别,大型组织会使用诸如 RACI 矩阵之类的治理工具来正式明确“谁负责什么/谁拥有什么”。RACI 分别代表负责(Responsibility)、问责(Accountable)、咨询(Consulted)和知情(Informed)。这类框架迫使团队明确哪个角色/个人负责具体工作,如果出现问题谁要承担责任,关键决策前必须咨询谁,以及谁只需要了解情况即可。
因此,诸如“是人工智能干的”之类的解释是行不通的。相反,组织需要明确的角色分工、类似RACI矩阵的职责映射以及升级路径,以便当智能体采取行动时,始终有人和团队(或委员会)对这些行动及其后果负责。
使用Agent的人群可以分为以下几类:
- Enthusiastic early adopters (often younger or tech-centric roles): 这些人已经大量使用人工智能工具,往往对人工智能工具非常熟悉,且信任度较高,但在极端情况下或进入高风险领域时,可能会低估风险,对于智能体人工智能,他们需要清晰了解其局限性、明确的不确定性信号以及可见的安全机制,以避免智能体超出其安全运行范围。
- Skeptical experts in high-stakes domains (e.g., clinicians, risk, legal): 这些用户通常乐于接受人工智能作为决策支持工具,但不愿将最终的高风险判断委托给不透明的系统。他们担忧问责制、罕见的极端情况以及公平性,并且往往在职业环境中养成保守的习惯,不愿做出可能损害患者、客户或公司利益的改变——无论是否涉及正式的法规。对于这类用户,应将智能人工智能明确定位为副驾驶或第二位审阅者:提供基于案例的解释、不确定性评估,并使其能够轻松地升级、推翻或请求人工审核。
- Cautious pragmatists (mid-career managers, operations leaders): 许多管理者和运营领导者属于中间立场:他们既非早期拥护者,也非彻底反对者,但他们最关心的是运营风险、可靠性和声誉。他们希望看到智能体人工智能在他们的实际环境中切实有效,并且在出现问题时能够得到有效控制。他们最能接受具体的商业案例、可见的控制措施(审批流程、审计跟踪、事件处理手册)以及能够显示错误率、升级情况和改进情况的简洁性能仪表盘。对他们而言,信任是通过与管理良好的试点项目进行实践经验逐步建立起来的,而不是通过抽象的承诺。
- Low-familiarity or change-fatigued staff: 这个群体对人工智能的了解甚少,却非常担心人工智能会对他们的工作造成影响,而且常常难以理解人工智能如何与他们的日常工作联系起来。他们可能被晦涩难懂的专业术语所困扰,或者将人工智能视为“又一项自上而下强加的变革实验”。对于智能体系统而言,要想成功地让这个群体接受人工智能,首先需要用通俗易懂的语言进行基础教育,让他们亲身体验安全、低风险的应用案例,明确他们的角色和责任,并提供简洁易用、符合角色需求的界面,让人工智能支持感觉像是现有工具的自然延伸。早期体验至关重要:如果最初的互动令人困惑、带有惩罚性或解释不清,这些用户很快就会变成根深蒂固的怀疑者。
总结
一场酣畅淋漓的思考,停下来看看路在何方.
Prompt Engineering for LLMs
ch1: 介绍提示词工程
简单介绍,可惜当时是24年.
ch2: 介绍LLM
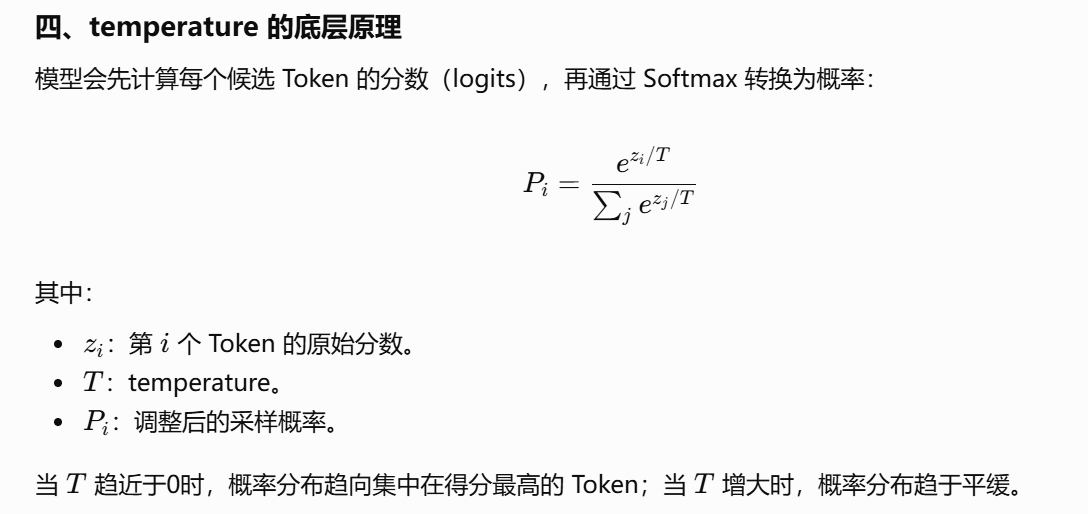
当T趋近于0时,概率最大项会趋近于正无穷,而如果T=0,则是直接选择概率最大项,因为此时它的概率为1.
如果温度大于1,则会让模型的输出偏离典型的输出,而小于1,则会逐渐靠近典型的输出.
值得注意的是,主流的API中,如果开启了reasoning即CoT,那么就无法调节温度,至于为什么,有可能是LLM公司发现如果调了温度会让LLM的输出惨不忍睹,但又不知道具体的原因是什么,所以才遮遮掩掩的.
Transformer只能向过去的输出看,而永远无法向未来看,所以这些LLM都被称为单向Transformer
ch3: chat
比较详细的叙述了从文本补全模型到对话模型的改进,以GPT为中心.
ch4: 设计LLM应用程序
不值得看,因为这两年的Agent变化确实太大了
ch5: Prompt Content
向LLM(机器学习模型)明确提出的问题比大多数人想象的更重要,也更难。原因之一是,人际沟通中误解非常普遍——只不过,当人们彼此交流时,任何误解往往都能迅速得到解决。但当你的应用与LLM通信时(例如,在ChatGPT上以程序化方式而非实时方式查询模型),误解往往会导致彻底失败。向LLM明确问题之所以重要,另一个原因是,更清晰的描述有助于模型每次遇到相同问题时都以相同的方式处理。明确描述能够带来一致性。
讲了RAG和提示词撰写
总结
很遗憾,这本书刚好卡在两波潮流中间,不推荐阅读.
Agentic Coding with OpenAI Codex CLI
ch1: 介绍CodeX CLI
介绍了CLI的历史和基本原理
ch2: 使用CodeX CLI
几乎每个人在第一周都会犯同样的几个错误:
- 将其视为聊天,并且任务描述不够具体。“清理授权码”这样的任务没有给代理提供任何验证依据,因此它会自行定义“清理”的含义,并以此运行数分钟。解决方法是设置完成标准:指定文件名、所需的更改以及必须通过的测试。
- 打断你第一次不同意的修改。正如演示所示,第一次修改通常是一种试探。如果在智能体做出你不会做的事情时立即停止它,就会破坏使其发挥作用的测试和纠正循环。
- 在没有测试和 AGENTS.md 的情况下运行。没有测试,代理无法判断是否成功;没有 AGENTS.md,它无法确定要运行哪个测试命令或遵循哪些约定,因此只能靠猜测。
Codex命令会激活交互式对话页面,但带上参数可以支持各种各样的功能,如codex exec
ch3: Prompting Codex CLI Effectively
Four elements appear reliably in prompts that produce good results:
- Goal: what ‘done’ looks like in one concrete sentence. Use outcome verbs: ‘add’, ‘fix’, ‘migrate’, ‘replace’.
- Context: language version, framework and an analogous piece of code: ‘follow the pattern in
src/api/users.ts’. - Constraints: what Codex CLI should not do. No new dependencies. Don’t modify the database schema. Don’t touch files in
src/legacy/. - Completion criteria: a concrete, runnable check: ‘
GET /api/posts?page=2&limit=20returns the correct JSON, andnpm testexits with code 0’.
包含四个要素的提示也暗示了任务的范围。理想的任务规模是同事可以在一个下午完成的,并且任务完成前后的状态清晰可见。较小的任务会浪费结构化提示的额外工作;较大的任务应该分解成若干里程碑,或者进入计划模式。
一个技巧是渐进式披露Skill,Codex CLI 最初只显示名称和描述,仅在激活时加载完整指令,示例如下:
I have a skill at ~/.agents/skills/api-scaffold/SKILL.md. It should activate when I ask to create a new REST endpoint but NOT when I’m debugging an existing endpoint.
ch4: AGENTS.md
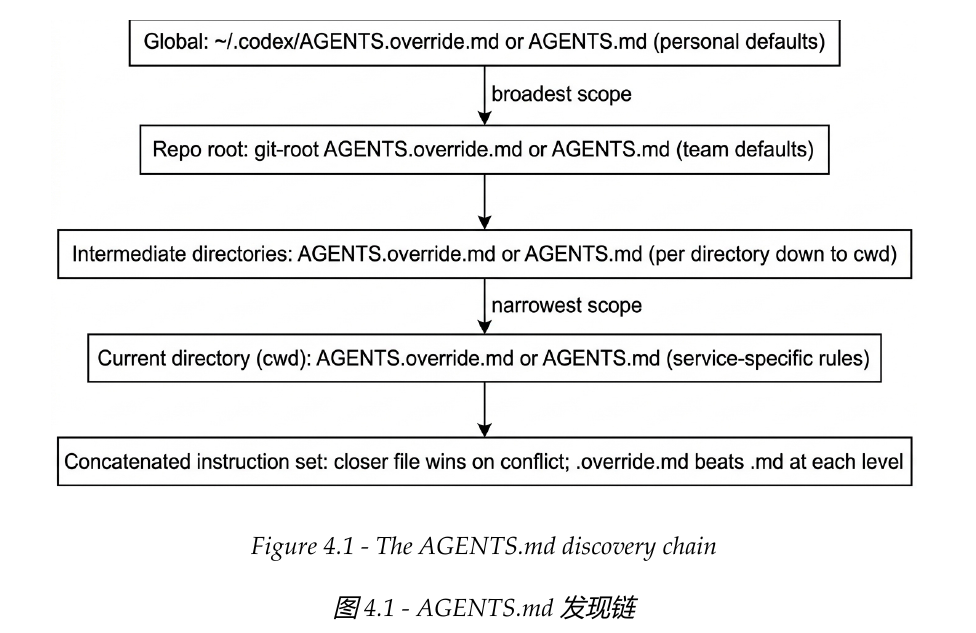
一些值得一开始就了解的操作细节:
- Codex CLI 每次运行时都会重新构建此链;编辑文件时无需清除缓存。
- 空文件会被静默跳过;它们不会重置或中断链。
- 所有已加载文件的总大小受 project_doc_max_bytes 设置的限制,默认值为 32 KiB。超过此限制的文件将被静默截断
- 任何级别的 .override.md 变体都优先于同一级别的普通 .md 变体。
AGENTS.md 文件一开始并不大,通常只有三四行。问题在于其增长曲线。每次智能体出错时,本能反应就是添加一条指令。每次添加指令本身都是合理的,但累积起来却会造成新的问题。
请对 AGENTS.md 实施以下检查:
- 是否涉及仓库结构、架构或布局?如果是,请移除。智能体通过阅读代码来了解仓库结构。
- 是否为通用最佳实践?如果是,请移除。这些知识已内置于模型中。
- 是否描述了框架约定?如果是,请移除。模型已知晓这些内容。
- 是否与你的 README 内容重叠?如果是,请移除。以免重复消耗资源(Token)。
- 能否移至嵌套的 AGENTS.md 中?如果仅与特定子目录相关,请将其下移。
- 能否移至 Skill(技能)中?如果仅在特定工作流中相关,应将其放入按需加载的 Skill 文件中。
指令只是建议。它们决定了 Codex CLI 的运行方式,但并不能阻止它执行你意料之外的操作。信任模型的硬性规定在于审批策略和沙箱模式:这些配置选项决定了代理程序可以执行哪些操作,以及操作系统会阻止哪些操作(即使代理程序尝试执行)。
ch5: Approval Modes and Trust Boundaries
如今,AI编程智能体生成代码的速度已比人类编写或审查的速度快出许多倍,随之而来的是一个结构性问题:下达提示词的开发者已经无法对生成的代码进行有意义的审查了。面对这一现象,一些组织并没有将其视为需要加强代码审查的信号,反而开始把拉取请求(Pull Request)当作拖慢AI生成产出的瓶颈。
目前行业的应对方式是叠加更多的智能体:由智能体审查员来审查智能体生成的代码,由智能体测试员来进行测试。正如一位前 GitHub 高级工程师所言:“建立在缺陷系统之上的缺陷系统,并不会趋于完美。”对于没有机密信息的模块进行格式化处理,自动批准是没问题的。但当任务涉及医疗系统、金融平台或数以百万计的人所依赖的基础设施时,审批环节就不是瓶颈:它是最后一道防线。
大多数会话都使用显式组合 -a on-request -s workspace-write分别对应执行敏感操作时请求Approval(全称为–ask-for-approval)和允许更改工作区文件的Sandbox(全称为–sandbox).
推荐通过权限阶梯来控制Agent的权限:
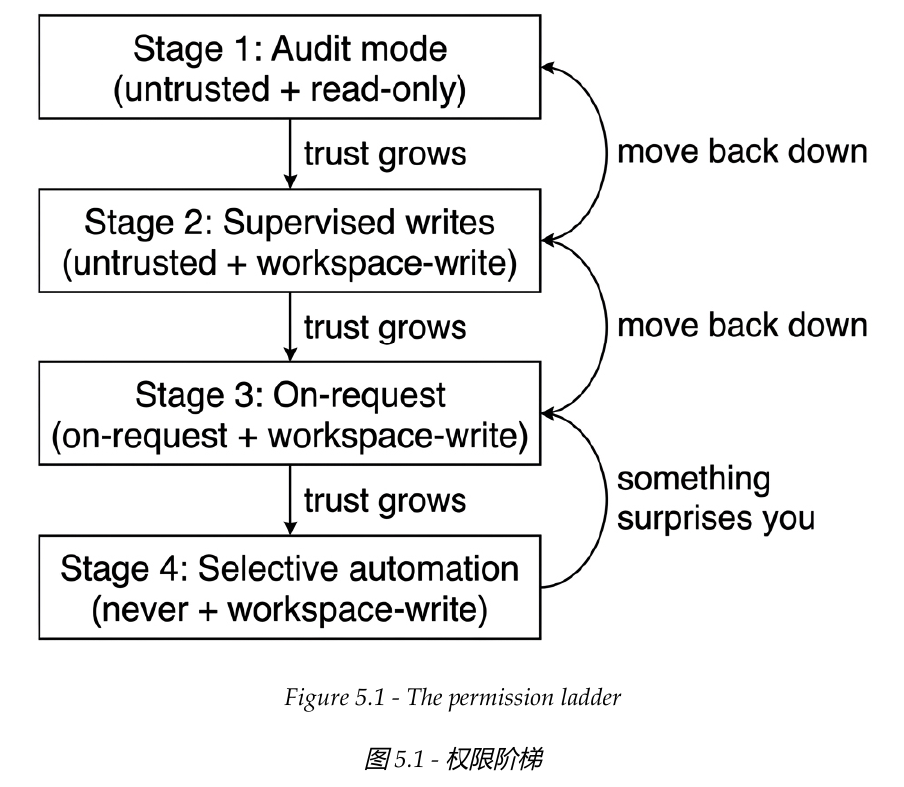
ch6: Model Selection and Reasoning Effort
针对具体任务设置模型强度从而节省费用
ch7: Context Window Management
多轮对话中,每次对话都需要传输之前所有的对话,会让消耗的token数成指数级增长.
Codex会在窗口容量到达一定程度时激活compact命令,生成对话的结构化摘要,并替换累计的历史记录,尽管是有损的,但这一操作相当重要,毕竟Tool Use非常容易引入一大堆调试信息,我们实际上只需要知道某个操作是否正常完成即可,从而可以极大地精简对话历史.
compact不保留以下内容:
- 已读取文件的完整内容(摘要仅按文件名引用文件,但不再保留其具体内容)
- 确切的错误信息或编译器输出(这些内容会被转化为文字概括)
- 工具调用和中间状态的确切顺序
- 任何通过对话语气或隐性假设所建立的隐含上下文
因此,必须在上下文压缩后仍然有效的指令应该放在系统提示符或 AGENTS.md 中,而不是放在会被上下文压缩概括得面目全非的对话中。
何时派生子智能体
委托操作本身也存在开销:每次调用都需要提供指令(100 到 400 个 token),且返回的摘要会消耗父级上下文。一个粗略的衡量标准是:当子任务需要读取三四个以上的重要文件、执行多个 Shell 命令,或经历超过两次错误修复循环时,才建议进行委托。低于此阈值时,委托的开销将与直接内联执行的成本不相上下。
ch8: MCP
MCP 赋予代理程序访问外部系统的权限
ch9: Hooks
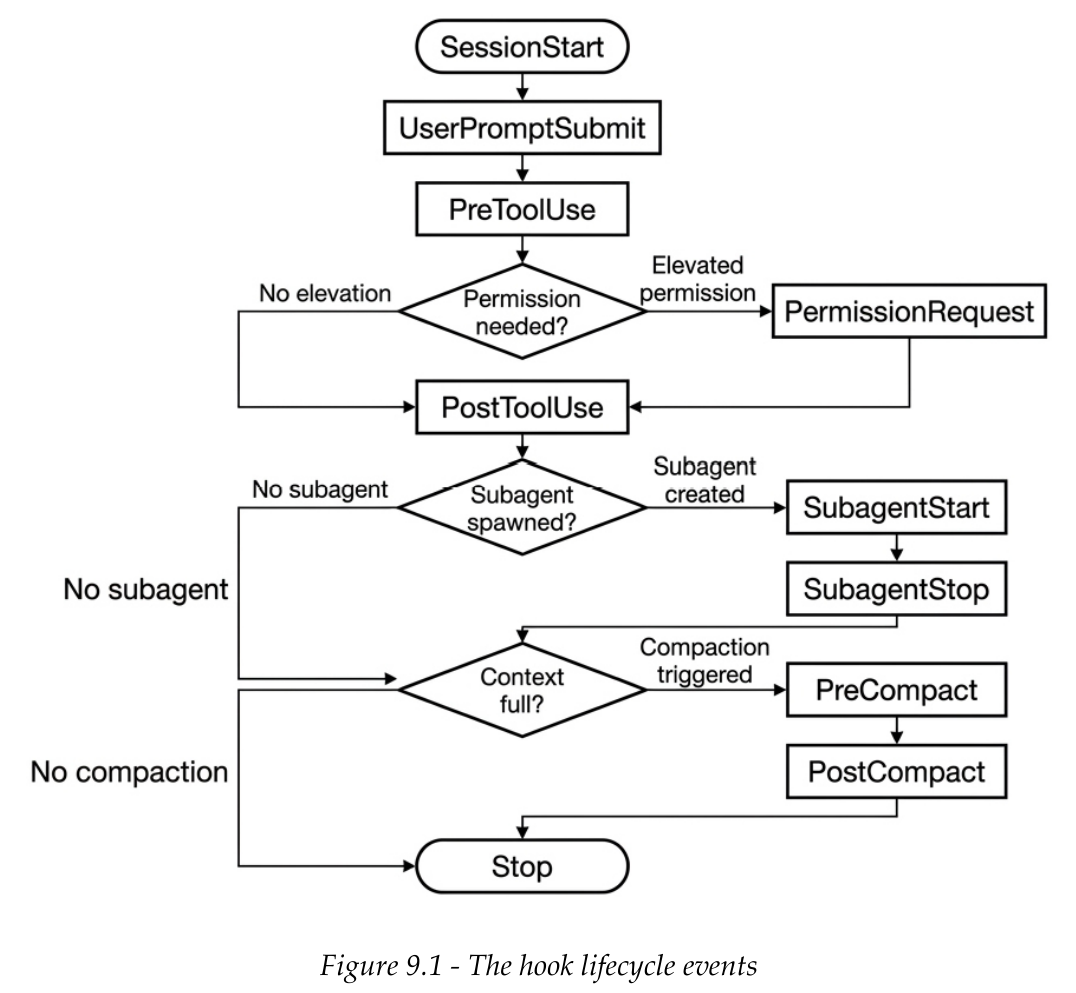
Hook类似于回调函数,当某个事件触发时(如开始对话,subagent执行完毕,上下文窗口达到预设大小),自动执行该命令(可能是你配置的脚本,也可以是MCP工具).
目前Codex支持12种Hook时机:
| Hook 名称 | 触发时机 | 典型用途 |
|---|---|---|
| SessionStart | 会话启动或恢复时 | 加载项目上下文 |
| SessionEnd | 主会话结束时 | 保存日志、清理临时文件 |
| UserPromptSubmit | 用户提交提示词时 | 检查提示词中的敏感信息 |
| PreToolUse | 工具执行前 | 检查或拦截危险命令 |
| PermissionRequest | Codex 准备请求权限时 | 自定义权限检查 |
| PostToolUse | 工具执行完成后 | 检查执行结果 |
| PreCompact | 上下文压缩前 | 保存重要上下文 |
| PostCompact | 上下文压缩后 | 恢复必要信息 |
| SubagentStart | 子智能体启动时 | 注入专属任务信息 |
| SubagentStop | 子智能体准备结束时 | 检查子任务是否完成 |
| Stop | Codex 准备结束当前轮任务时 | 验证任务结果 |
| Interrupt | 用户中断正在进行的任务时 | 记录中断状态 |
我们可以在hooks.json中配置相关的hook:
| |
Hooks对于调试信息,追踪异常耗费,提示任务完成等情景非常有用.
ch10: Skills Ecosystem
Codex搜寻Skills的优先级顺序如下:
| |
如果你想阻止某个技能加载而不删除其目录,请在 ~/.codex/config.toml 中添加一个条目:
| |
修改 config.toml 后,请重启 Codex CLI。当某个技能导致意外的隐式激活时,此方法非常有效:禁用该技能,查看其描述,并在调整后重新启用它.
SKILL.md 包含两个部分,由 YAML frontmatter 分隔符分隔。开头 — 和结尾 — 之间的所有内容都是结构化的metadata。之后的所有内容都是 Markdown 文本,技能激活后,代理会将其作为指令读取。
| |
metadata中,以下字段是必需的:
- name: 长度为 1 至 64 个字符。仅限小写字母、数字和连字符。必须与父目录名称完全匹配。不能有前导/尾随连字符,也不能有连续的连字符。
- description: 长度为 1 至 1024 个字符。每次会话开始时加载。用作路由规则:描述技能的功能以及何时使用,包括帮助代理识别相关任务的关键词。
- 正文不宜太长,控制在500行以内,大约5000个token即可.如果指令超出该限制,最好进行拆分
会话启动时,Codex会扫描每个Skill.md的metadata,
编写描述字段
metadata中的description字段写法相当重要:
| |
Plugin
Codex将Skill和MCP集成为了Plugin.
插件是一个包含.codex-plugin/plugin.json 的清单文件和可选组件包的目录,清单文件内支持三种组件:
- Skills: 在
./.skills文件夹中声明 - Apps: 外部服务连接器(GitHub、Slack、Gmail、Google Drive),通过 OAuth 或 API 令牌提供经过身份验证的数据访问。
- MCP servers: 在
./.mcp.json声明
ch11: SubAgent
Codex自带default(默认主agent),worker(执行全新上下文的任务)和explorer(侧重于读取和探索代码库)三个Agent.
Codex只会在用户明确发出请求时才会生成Subagent,例如spawn an **explorer** to map every reference to payment_service across the repo
Agent可以在.codex/agents/<name>.toml中定义,有三个必填字段: name,description(何时调用),developer_instuctions(系统指令),还有一些可选字段如model(指定模型名字),sandbox_mode(指定agent权限).一个示例如下:
| |
当两个或多个任务可并行运行时,派生Subagent才有奇效.当您不确定两个任务是否真正独立时,请问自己:“如果员工 A 和员工 B 完成任务的顺序不同,最终结果会改变吗?” 如果会,则说明它们之间存在依赖关系。请在父任务的流程编排逻辑中明确定义这种依赖关系。
ch12: Multi-Agent(待补充)
非常高端的操作,在Goal模式内部,针对Subagent的派生设置门控和审查.但这样一来每个任务都需要单独设置门控和审查代码,非常的麻烦.
ch13: 隔离与WorkTree
对于多Agent合作环境,不可能给每个Agent都单独clone整个代码仓库,而用git worktree的话则可以轻松实现文件系统的隔离.
ch14: 成本管理
计算费用
ch15: CI/CD集成
我们可以在GitHub Actions中用Codex:
| |
ch22: Backend Engineering
示例项目:
| |
正确配置 AGENTS.md 是 Python 项目中最重要的配置决策。否则,Codex CLI 会做出看似合理但却错误的选择:例如,使用 pip install 而不是 uv add,使用 python -m pytest 而不是 uv run pytest,以及在项目使用 pyproject.toml 时,使用 setup.cfg 或 .flake8。虽然每个错误单独来看都可以修复,但累积起来会导致环境偏差。
文中的示例:
| |
Run all checks before marking a task done: lint → format → type check这句话相当关键.
如果采用嵌套AGENTS.md,那么需要保证嵌套md专注于偏差,而不用重复完整的工具链.
测试指令:
| |
给fastapi的指令:
| |
这一章相当重要,指挥Agent写代码的前提是自己会写代码
ch23: Frontend Engineering
AGENTS.md
| |
ch24: Infrastructure as Code
关键在于,基础设施并非应用程序代码,这种差异会改变你与智能体的协作方式。核心问题在于影响范围。一行糟糕的应用程序代码只会导致测试失败;而一行糟糕的基础设施代码则可能导致生产环境瘫痪,甚至删除它原本应该承载的内容。因此,智能体的角色范围缩小了:它负责规划、起草和提出方案,而由人类负责审核和实施。本章的其余部分将重点讨论如何确保智能体始终停留在“提出方案”这一侧,以及随之而来的挑战:虚构资源、未经审核的变更成本,以及维持这条边界的安全配置。
- 主要讲的Terraform.
ch27: 长时间运行Agent
Harness 是指封装智能体的所有组件:描述项目的 AGENTS.md 文件、提供确定性反馈的测试套件、限制影响范围的沙箱、验证输出的持续集成 (CI) 流水线、决定何时需要人工干预的审批策略,以及确保耗时数小时的任务在短暂故障后仍能正常运行的检查点逻辑。如果 Harness 设计良好,即使是适中的模型也能自主且高置信度地完成任务。反之,如果 Harness 设计不佳,即使是最好的模型也会束手无策。
- 推荐阅读:
Code as Agent Harness
论文的核心论点是: 建立一个用于coding agent的三层框架:
- Interface layer: 代理如何接收指令并呈现结果,包括AGENTS.md,系统提示词,对话框和TUI
- Mechanism layer: 约束并赋予Agent执行操作的能力,包括sandbox,执行限制,约束模型能够执行哪些操作
- Multi-agent scaling layer: MCP,subagent,A2A协议都属于这个范畴
文中主要是在介绍symphony这个编排框架,让Agent来领取任务,并验证代码.
而我们在日常开发中也可以这么做,要求Agent强制验证CI是否通过,并解释自己的成果是否覆盖了所有要求,事实证明,确实很有用.
如果要从本章中汲取一条操作原则,那就记住:当智能体性能不佳时,应先更换系统组件,再考虑更换模型。
总结
酣畅淋漓的阅读,读之前我真不知道Codex竟然还有这么多功能.
Vibe Coding Architecture at Scale
ch1: The Entropy of the Prompt
AI 代码助手并不关心你的长期架构。它只关心如何让当前的提示信息生效。这就是它的目标函数。当你让它“在结账流程中添加折扣”时,它会找到从当前代码状态到折扣生效状态的最短路径。如果这条最短路径直接穿过你花了一周时间设计的三个架构边界,助手会毫不犹豫地直接穿过这三个边界,而且不会通知你。
AI编码助手就像一个熵引擎,直接指向你的代码库。每一个提示都像一股微弱的力量,在没有约束的情况下,这股力量会将系统推向能量最低的状态:最少的抽象、最少的间接层、最少的刻意连接。而这种状态往往并非架构完善的状态。
这有三个原因:
- 模型的训练目标在于局部优化而非整体架构
- 最短路径偏好,模型会尽可能地少用抽象
- 无感知,AI不会对功能耦合的复杂代码皱眉
1865年,威廉·斯坦利·杰文斯发表了《煤炭问题》一书,对英国的燃料储备进行了系统研究。他的核心发现令人不安:蒸汽机燃烧煤炭的效率越高,英国的煤炭总消耗量反而越大。效率的提升本应减少需求,结果却截然相反。单位产出成本的降低意味着生产规模的扩大,燃料总支出随之逐年攀升。杰文斯将其视为一个悖论。经济学家后来认识到,这其实是技术进步的一种结构性规律。
同样的规律也作用于你的代码库。
在任何大规模部署人工智能编码工具的组织中,积压工作量都没有随着速度提升而成比例减少。相反,最终会达到一种平衡状态。一旦吞吐量提高,产品发现和竞争压力就会填补这一缺口。以前人工开发成本过高的功能,在人工智能时代变得轻而易举。产品路线图也随之扩展。以前需要在三个功能中做出选择的利益相关者,现在会提出七个功能的需求。团队比以前更忙,工作范围更广,面临的问题也更棘手,因为组织已经正确地调整了目标,使其与团队的新能力相匹配。
ch2: Shift Left, Guide Right
我们需要将约束提前,以便提前发现缺陷,并引导Agent不断演进代码.
对于人工智能领域的工程师来说,最重要的思维转变在于:流畅性不再是正确性的保证。你不能像审查人类代码那样审查人工智能代码,寻找那些看起来不稳固的部分,因为人工智能代码看起来完全没有问题。欺骗性代码和正确代码在风格上完全相同。
总结
例子太少,教条太多,不推荐
Build a Large Language Model
ch1: 理解LLM
对LLM的基本介绍
ch2: 文本处理
如果采用一个词对应一个id的方式的话,映射方法如下:
- 根据语料库建立映射表
- 处理新文本时,已经遇到的词可以被映射为向量,未知词则被映射为
<|unk|>,并增加一个标记文本结束的<|endoftext|>,类似于EOS标记.- 根据LLM的不同,我们还会按需添加:
BOS(beginning of sentence),EOS(end of sentence),PAD(padding)等特殊标记
- 根据LLM的不同,我们还会按需添加:
文中还介绍了tiktoken库,其应用了GPT-2,GPT-3所用的BPE(Byte Pair Encoding)分词器,词汇量总计为50257,可以处理任何未知词,关键在于在不在词汇表里的词分解为更小的子词,甚至是单个字符:
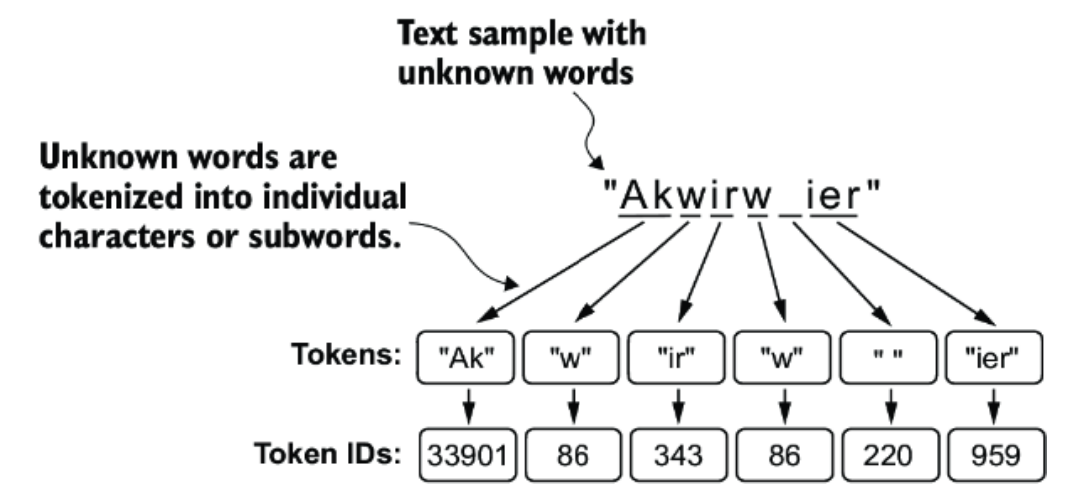
滑动窗口构建训练数据
鉴于GPT模型是逐词预测的,所以我们可以构造一个差额为1的双数组,通过滑动窗口构建训练数据:
| |
转成embedding
假设我们的embedding维度是三维,那么我们先根据id来一个随机映射:
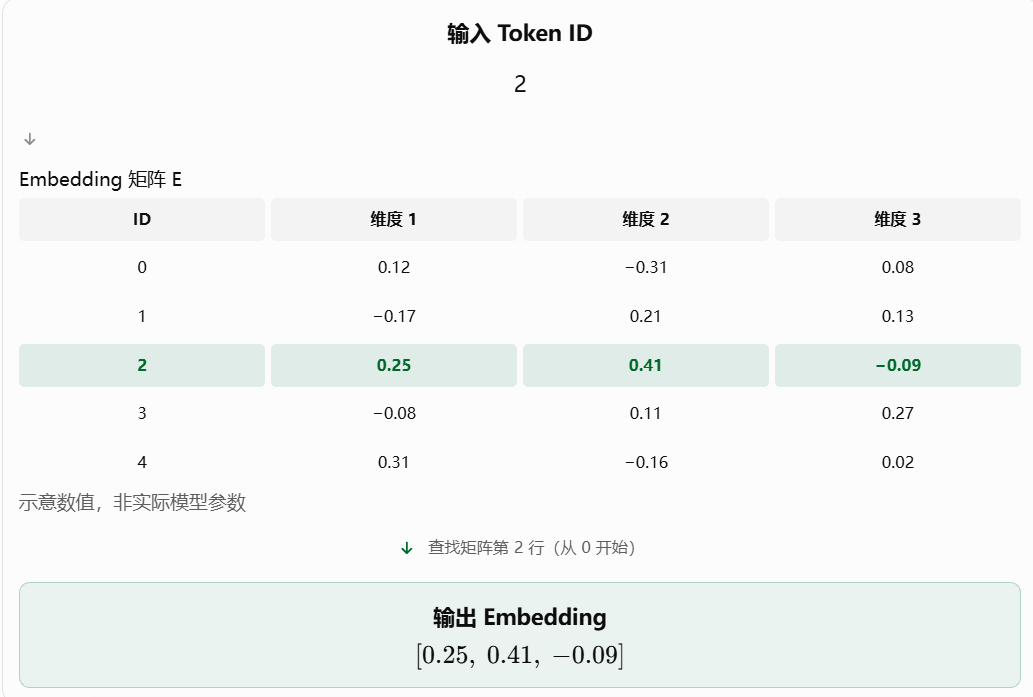
至于为什么随机映射,是因为后面还要通过训练来修改embedding的值.
理论上,我们可以把ID看成是多为的one-hot编码,然后再与embedding矩阵相乘.
问题在于,如果单纯做ID映射,对于相同的单词,无论在什么位置出现,得到的embedding数组都是相同的,这显然不符合我们做NLP的要求,所以需要注入额外的位置信息.
实现的方法就是给每个映射的embedding再加上一个相对位置嵌入(根据前面token的相对位置设置的向量)或者绝对位置嵌入(根据自己的绝对位置设置的向量),二者合成得到输给LLM的Input Embeddings.
原始的Transformer模型采用的是绝对位置编码,而现代LLM采用RoPE方法,即相对位置编码.
绝对位置嵌入有两种设置方式:
- 随机初始化,再通过训练学习
- 固定为正弦位置编码,Transformer用的就是这个.
ch3: Attention
简化表示
输入token中的一个token对其他每个token分配的注意力分数,是通过将两个token的embedding矩阵相乘得到的.
得到的注意力分数既有可能是负数,也有可能相当巨大,所以我们要进行归一化处理,简单一点的话,就是直接算一个分数占所有分数的比例了,这就是注意力权重:
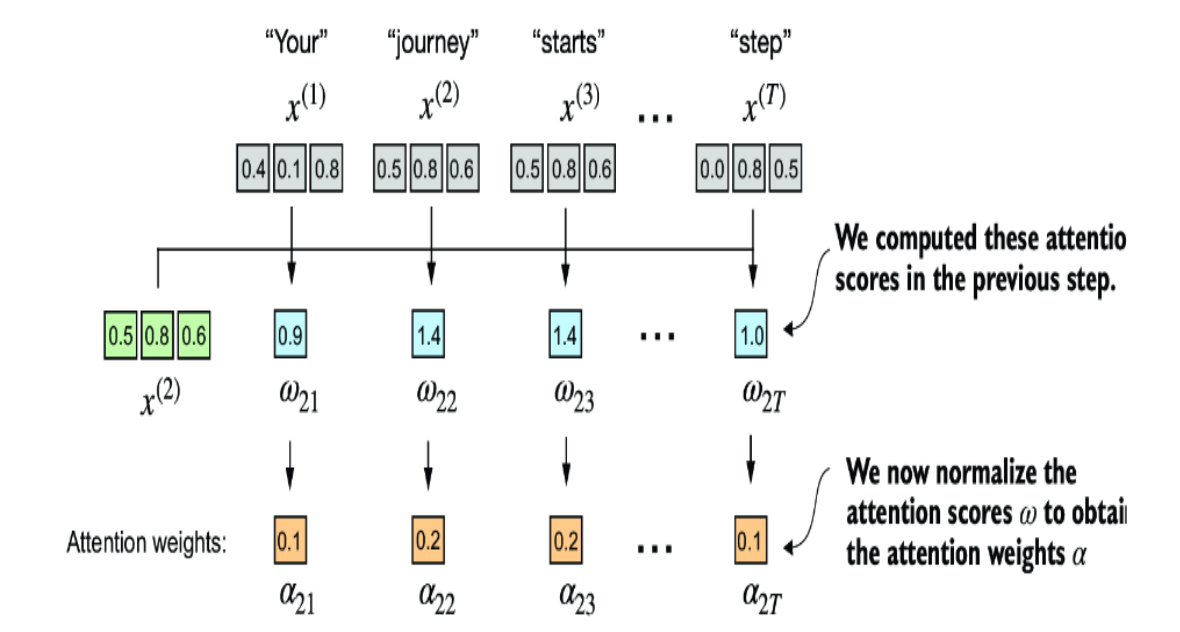
- 实践中用的则是softmax函数
最终,与单个token相关的上下文向量(context vector)即为所有的embedding与相应的注意力权重相乘,并将所有向量相加后的结果.
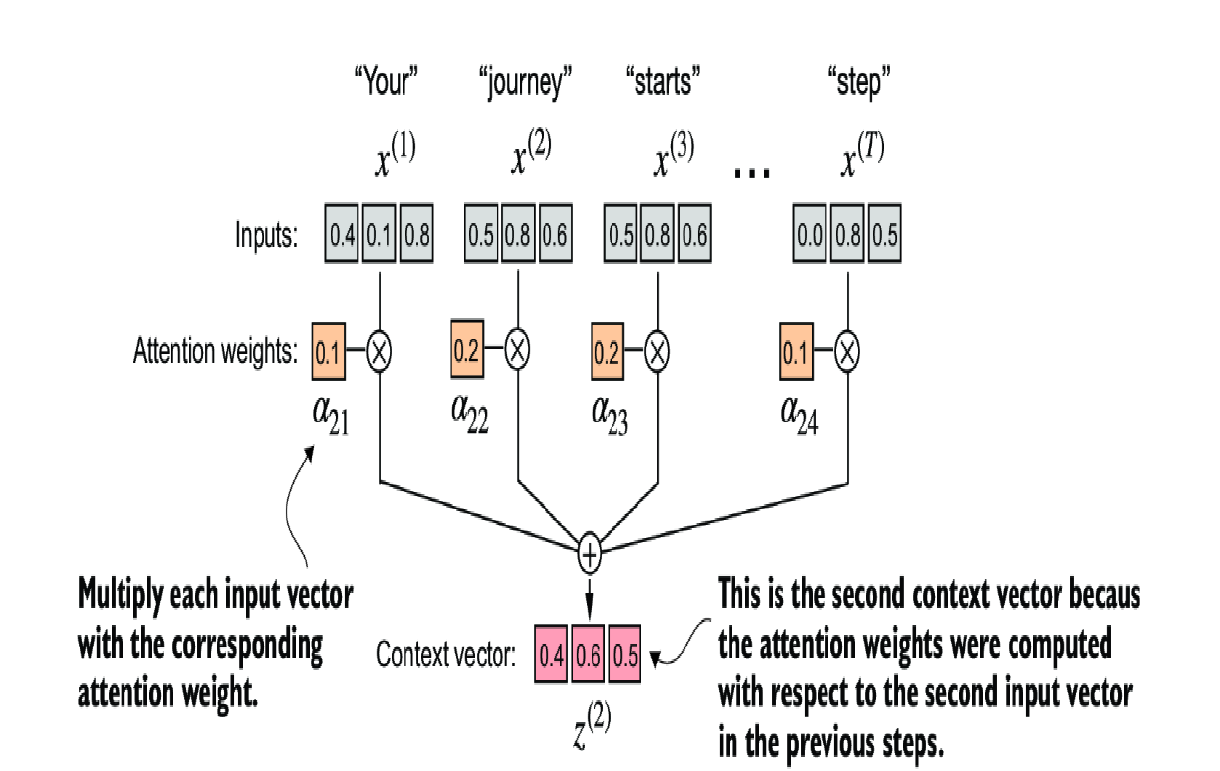
如此一来,我们可以先将所有的注意力权重计算出来:
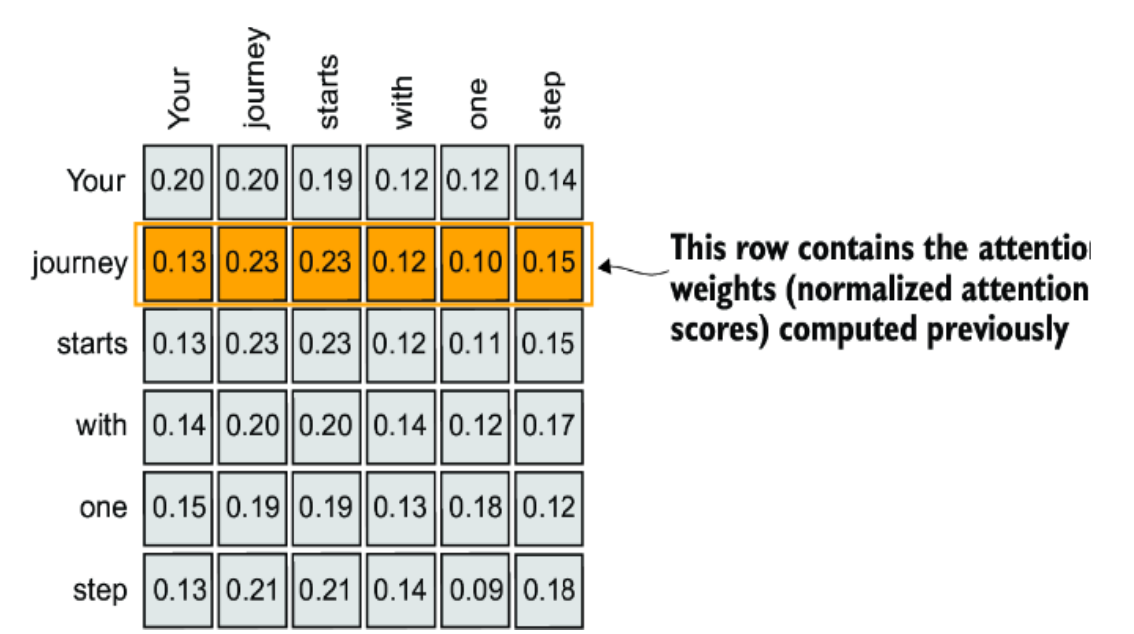
然后计算出所有的上下文向量即可,这就是self-attention的简化版本
复杂表示
原始Transformer采用的机制为缩放点积注意力,与简化表示的区别并没有那么大.
该注意力机制引入了三个可训练的维度相同的权重矩阵:Q,K,V,分别用于将embedding的token映射到查询,键和值向量上,记为query,key,value向量.
首先是随机初始化三个权重矩阵,并将对应token的embedding与这三个矩阵相乘得到Q,K,V对应的向量.
我们先计算第二个token的query与所有token的key向量的点积结果,得到query对key的注意力分数:
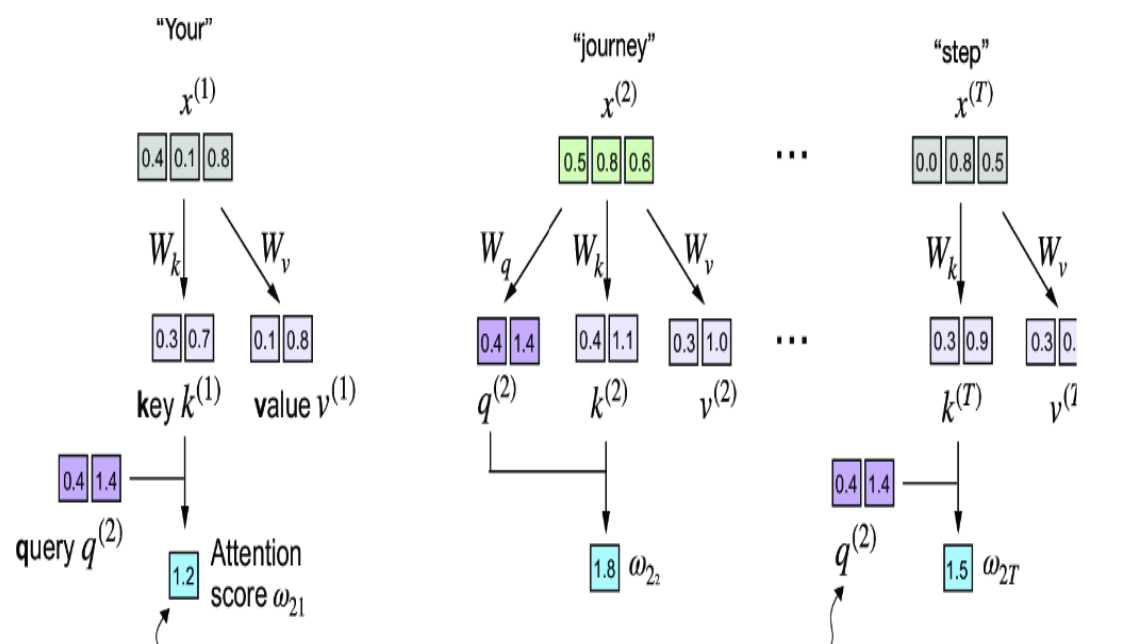
归一化处理时,我们将分数除以key向量维度的平方根(如10000维对应除以100)来进行缩放,再通过softmax得到注意力权重.
原因如下:
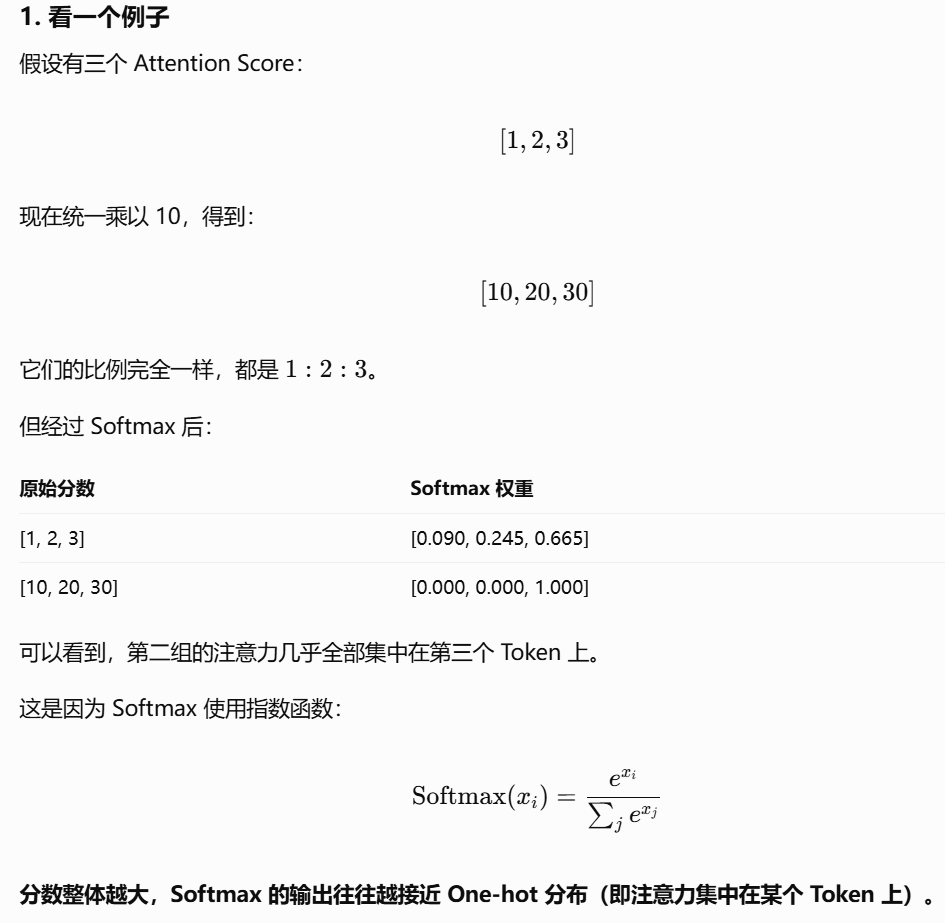
最终,我们将所有的value向量和注意力权重相乘后相加,就得到了上下文向量.
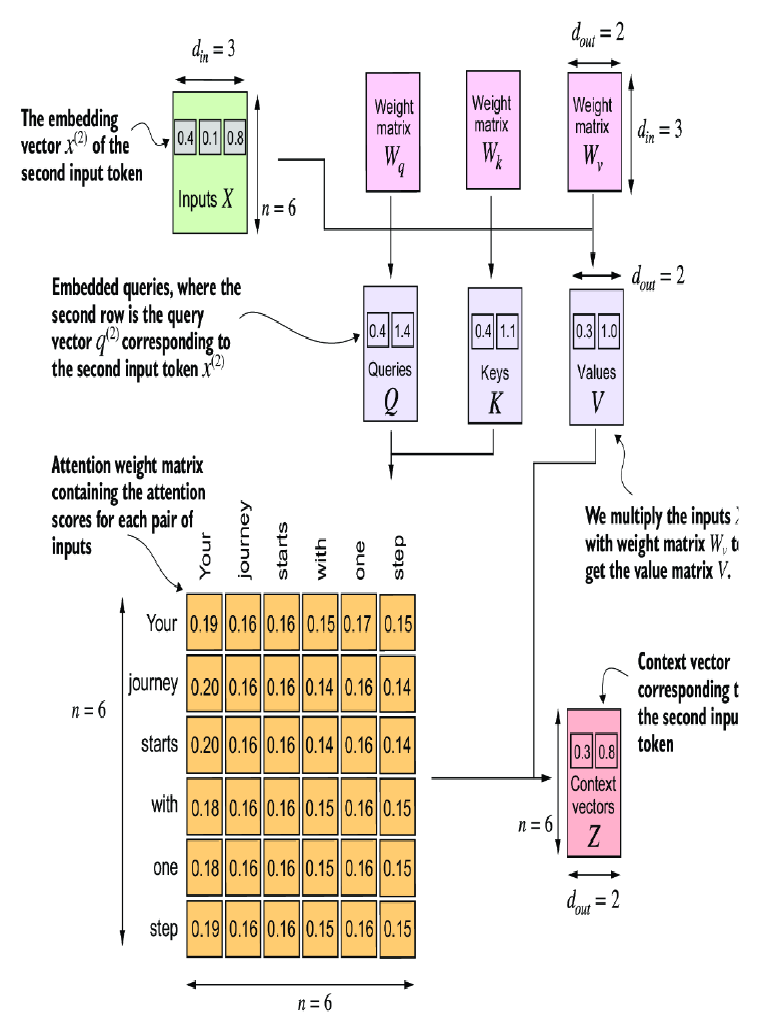
masked attention
鉴于LLM的输出不需要考虑未来的token,所以我们需要屏蔽在当前词之后的token,将原来的矩阵变成下三角形状:
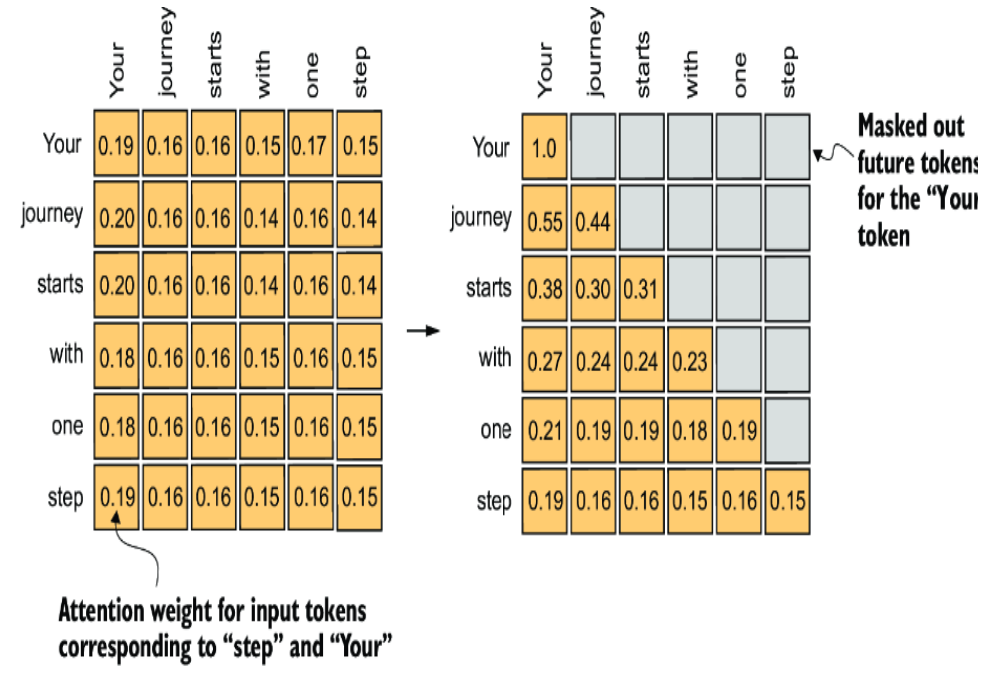
方法很简单,将注意力分数矩阵的上三角清零后,重新计算下三角部分的注意力权重并归一化即可.这就得到了masked attention.
另一个方法则是将上三角置为负无穷,然后应用softmax,效果是一样的.
对于得到的注意力权重矩阵,我们可以先用dropout方法对部分注意力权重置零,减少训练期间的过拟合,这被称为causal attention.
multi-head attention
Multi-head Attention由多个Single-head Attention组成,换句话说,每个子Attention模块都有自己的权重,只在输出时对多个子Attention的结果进行汇总:
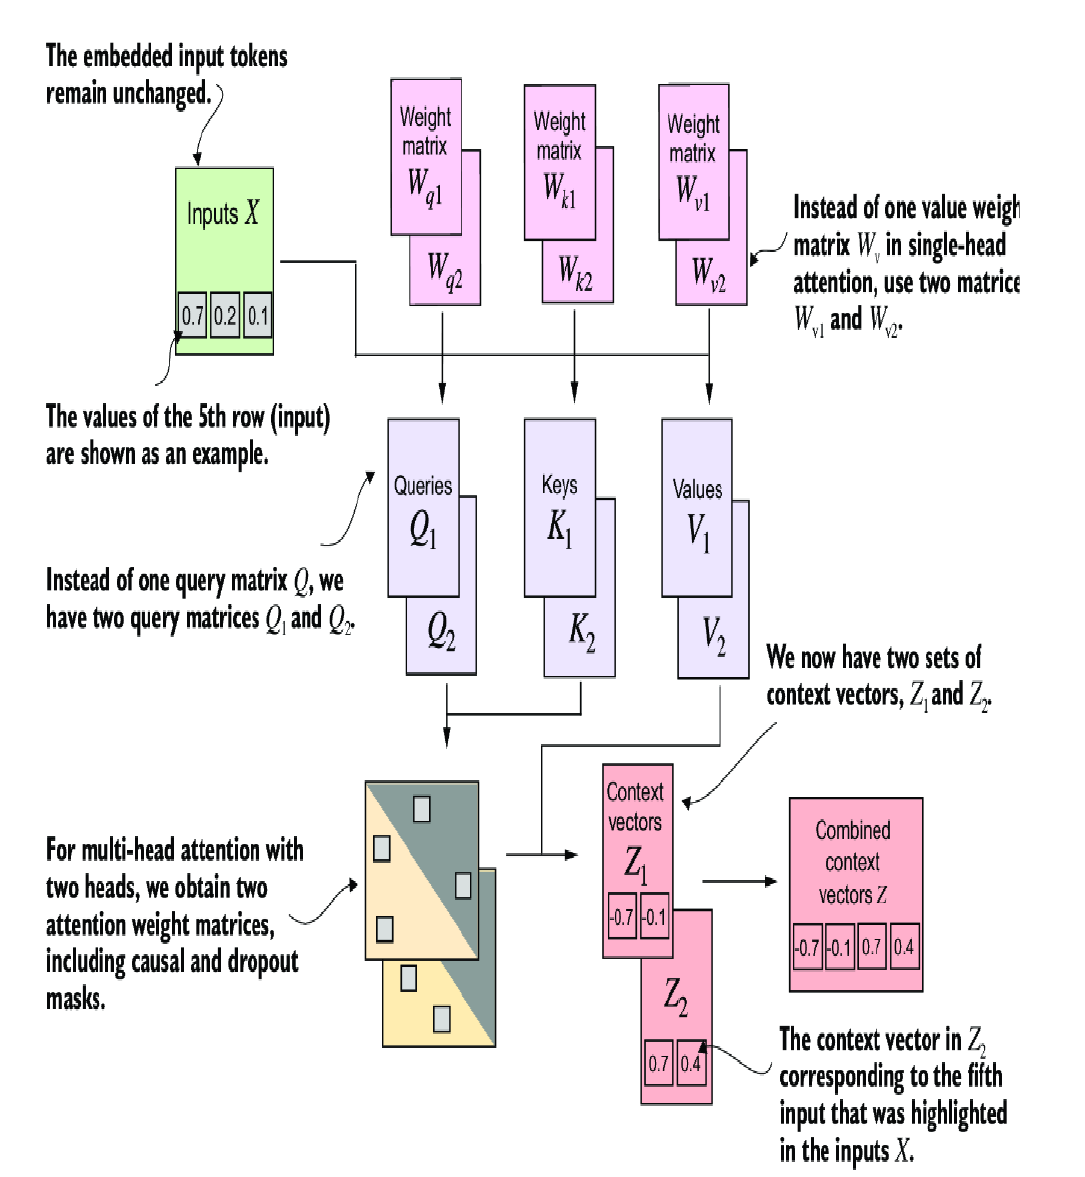
这在直观上表现为多组平行的Q,K,V向量和多组上下文向量.
ch4: 实现GPT模型
架构设计
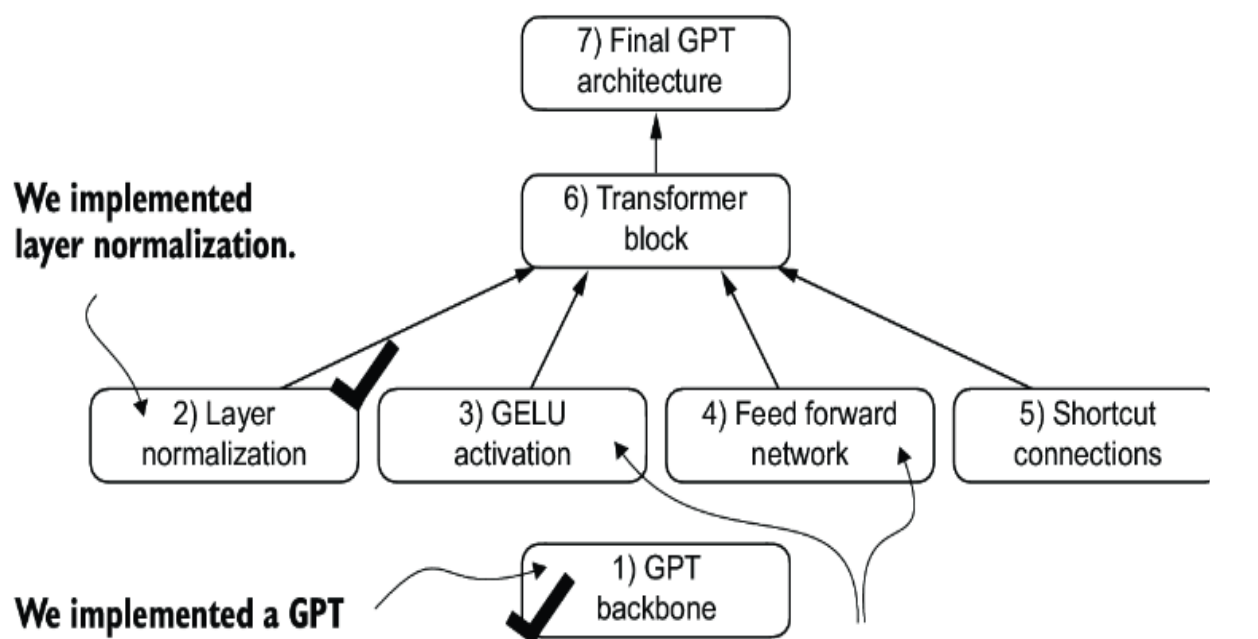
Normalization层
对每个token的embedding进行归一化处理,将均值统一为0,方差统一为1,从而避免参数过大给训练带来影响.
GELU激活的前馈网络
GELU是ReLU的进阶版,能够提供更优的训练效果:
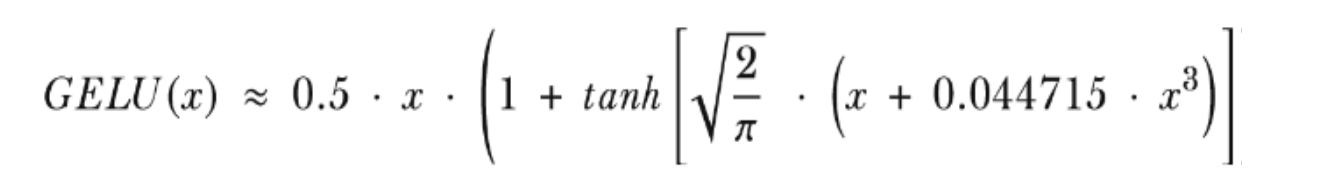
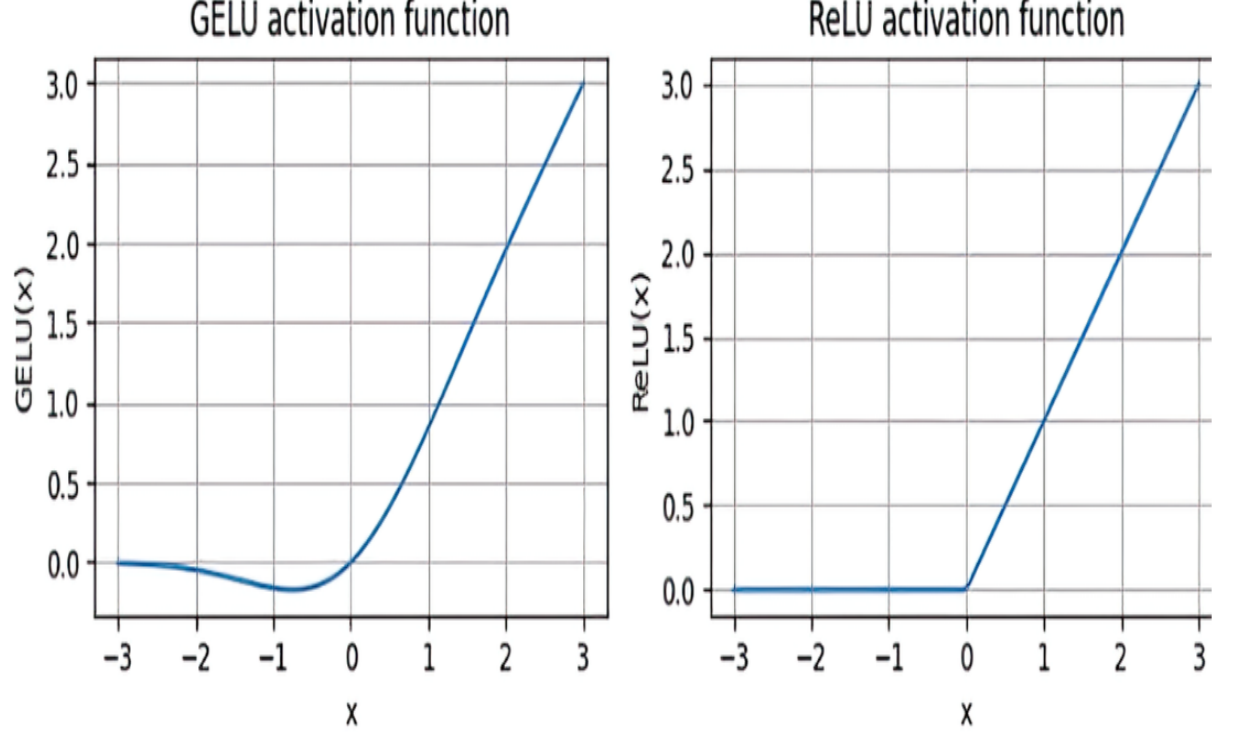
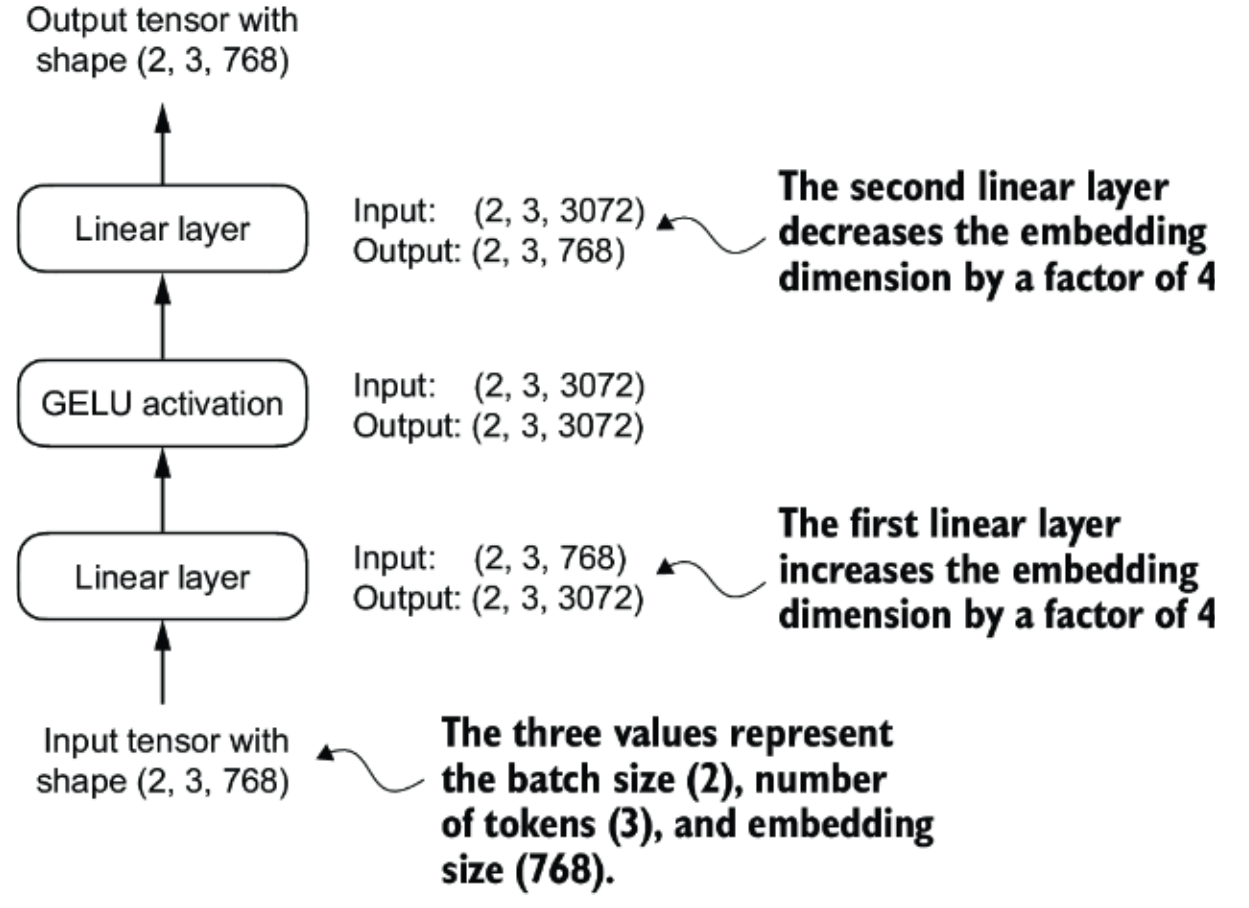
Adding shortcut connections
shortcut用于在反向传播中缓解梯度消失的问题,这也被称为残差连接:
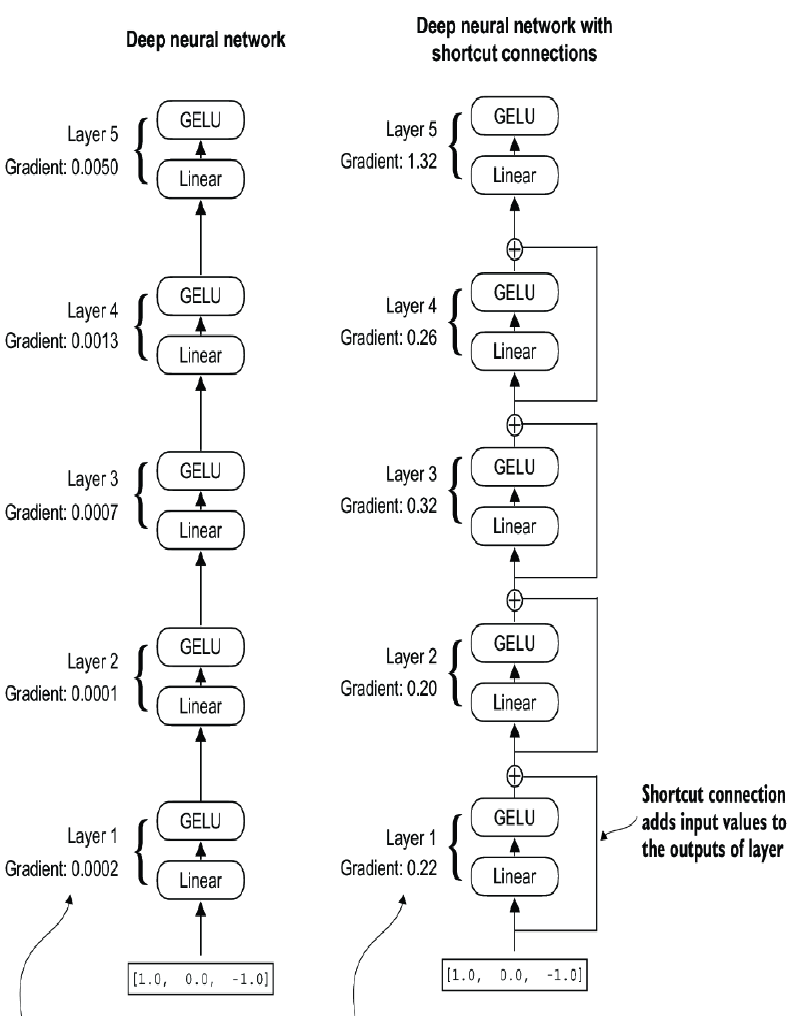
| |
实现Transformer模块
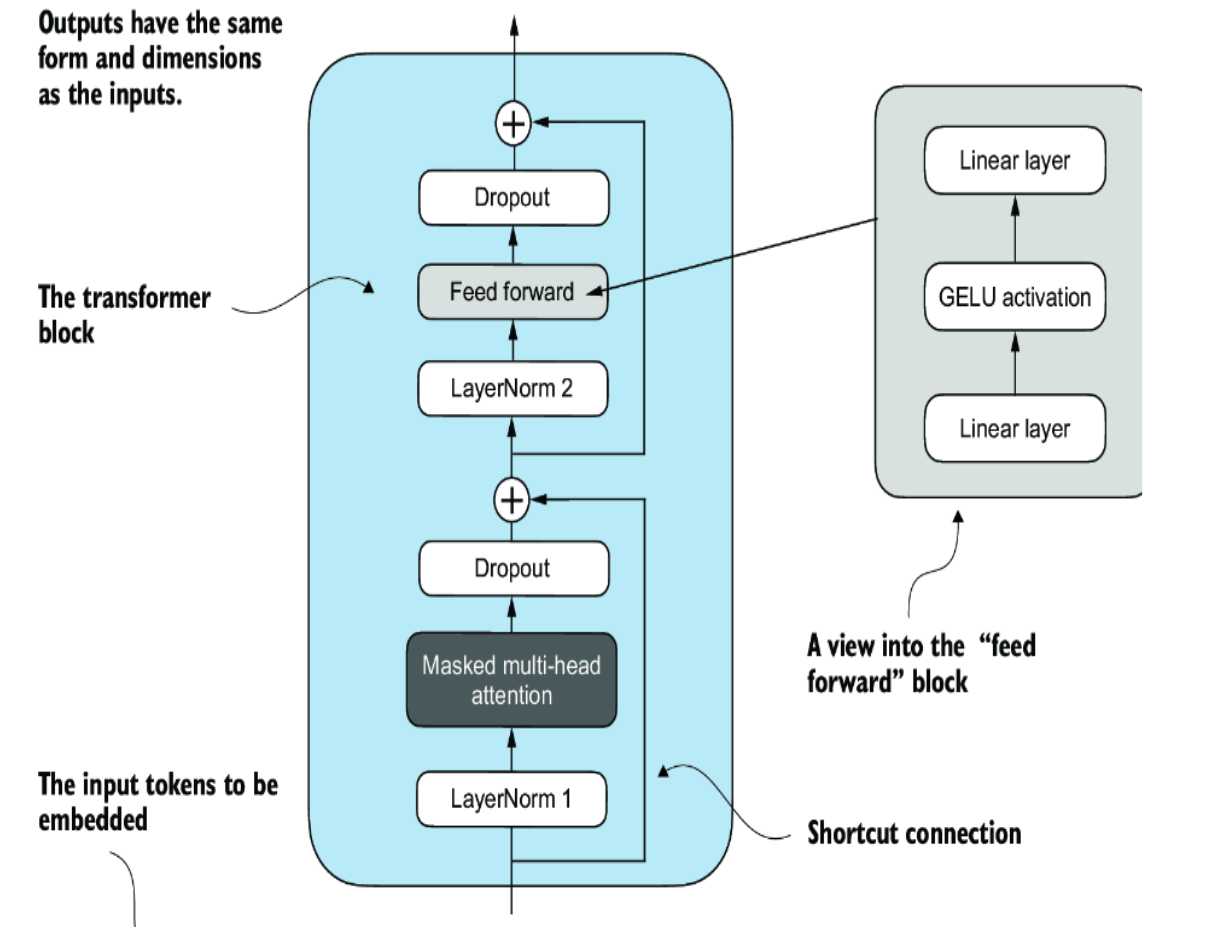
GPT模型实现
GPT采用了权重绑定(weight tying),即输入token的映射矩阵和输出logits的映射矩阵为同一个权重矩阵,均为(50257x768)维,从而可以降低模型的整体内存占用.
不过,现代LLM倾向于使用独立的权重矩阵,从而可以获得更好的训练效果.
通过计算 GPTModel 对象中 1.63 亿个参数的内存需求,并假设每个参数都是一个 32 位浮点数,占用 4 个字节,我们发现模型的总大小为 621.83 MB,这表明即使是相对较小的 LLM 也需要相对较大的存储容量。
输出文本
GPT会对每一个输入的token都生成对下一个token的预测,那么我们只需要提取输入文本的最后一行对应的50257x1维向量,用softmax处理后即可得到最终的token概率,选取概率最大的token即可,并将其作为下一轮的输入.
- 我们还可以设置一个上下文窗口大小,确保LLM的输出不会超出这些token数量.
ch5: Pretraining on unlabeled data
评估
为了让LLM输出可读文本,我们需要定义一个输出目标,从而能够评估模型的质量:
| |
很显然,我们应该让target仅仅针对输入值向前移动一位,否则的话LLM是无法根据上下文来学习的.
模型的训练目标为: 尽可能让target对应token_id的概率最大化.
但对于一句话来说,如果我们要依次预测多个token,那么就需要计算概率乘积以判断输出文本的质量,但这样一来会让数值变得过小,影响训练,所以可以转换成对数后相加得到多个token的概率和.
对于概率和,显然句子越长,那么概率和就会相对越大,直接拿来计算loss的话,就会对训练产生显著的影响,但我们更希望是提升单个token的预测质量,所以需要对概率和取均值,即除以待预测的token数量.
对于log来说,如果真数趋近于1,那么对数值就趋近于0,因此,我们需要让算出来的平均对数概率(average log probability score)尽可能接近0.
但在深度学习中,惯例是要对平均对数概率取反的,即让负平均对数概率趋近于0.
所以,我们最终的loss函数就是这个负平均对数概率,一个简易方法就是用torch的cross_entropy一键算出负平均对数概率.
为了加快训练速度,我们通常会将一批数据(epoch)同时输入进去训练,计算总的loss函数.
另外,我们需要将训练的数据集分成彼此不相关的两部分:
- train数据: 用于实际训练
- value数据: 用于评估模型效果
训练
我们设置一个循环次数,并在循环中不断计算训练数据的损失函数,用损失函数来进行反向传播更新参数矩阵.
- 在训练时启动dropout,但在评估和实际推理时都应该关闭dropout
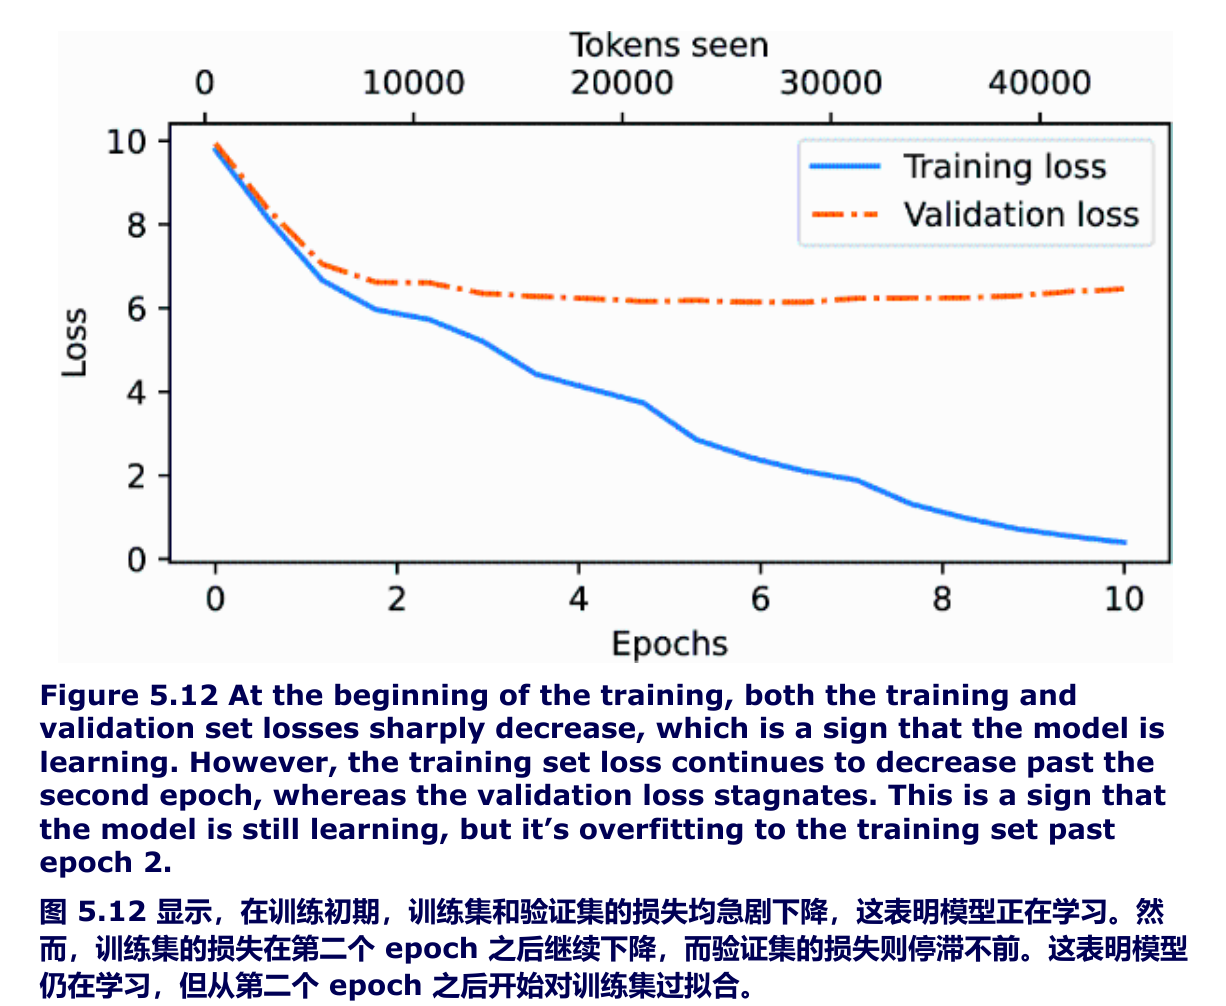
文本生成策略
如果我们每次输出token都是选取概率最高的,那么对于相同的输入token,多次运行都会得到相同的输出token序列.
有两种策略可以改变生成文本的单调性:
- Temperature scaling(温度缩放): 我们通常使用argmax函数直接获取概率最大的token,但也可以用multinomial函数按照logits的概率实际选取token(也就是等概率采样)
- 如果将得到的logits除以一个大于0的数,这被成为温度(temperature),就可以对token的概率进行缩放
- 因为最终归一化logits是用的softmax,要做指数运算,当温度大于1时,token的概率分布会更加分散,当温度小于1时,token的概率分布则会更加集中.
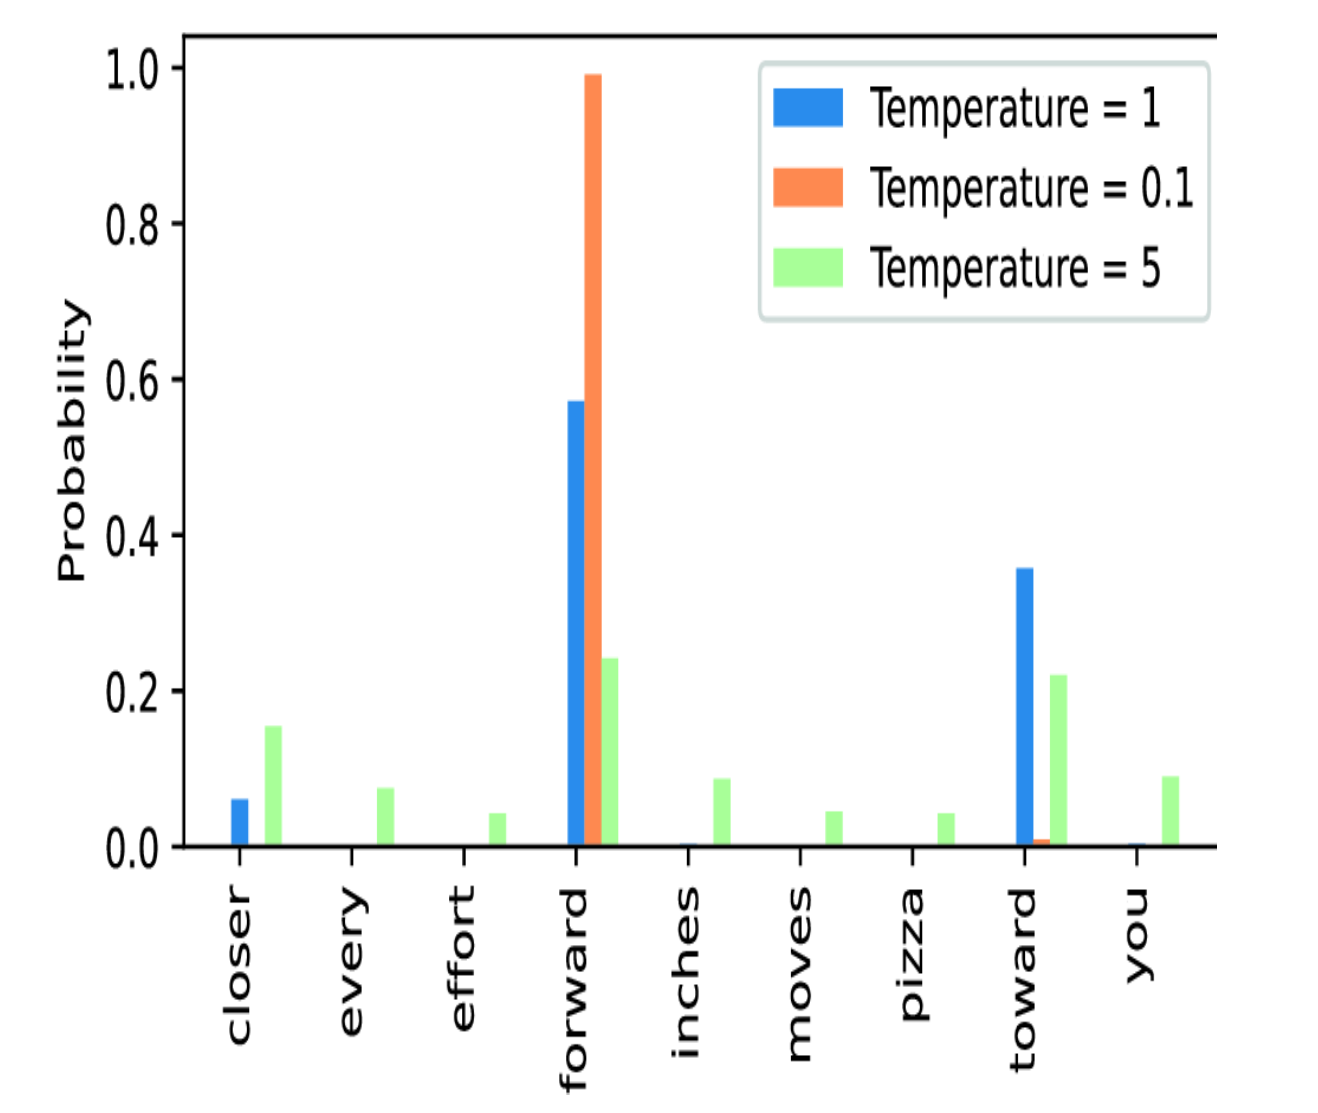
- Top-k sampling(Top-k采样): 简单使用multinomial的话有极低概率会出现错误或者毫无意义的输出,所以更好的方法是只在概率最高的前k个token中进行采样,将所有未被选中的logits替换为-inf即可.
ch6: Fine-tuning for classification
- 到这里,其实我们的模型已经基本完成了预训练,剩下的则属于后训练了.
指令微调虽然用途更广泛,但需要更大的数据集和更强大的计算资源才能开发出能够胜任各种任务的模型。相比之下,分类微调所需的数据和计算能力较少,但其应用范围仅限于模型训练时所针对的特定类别。
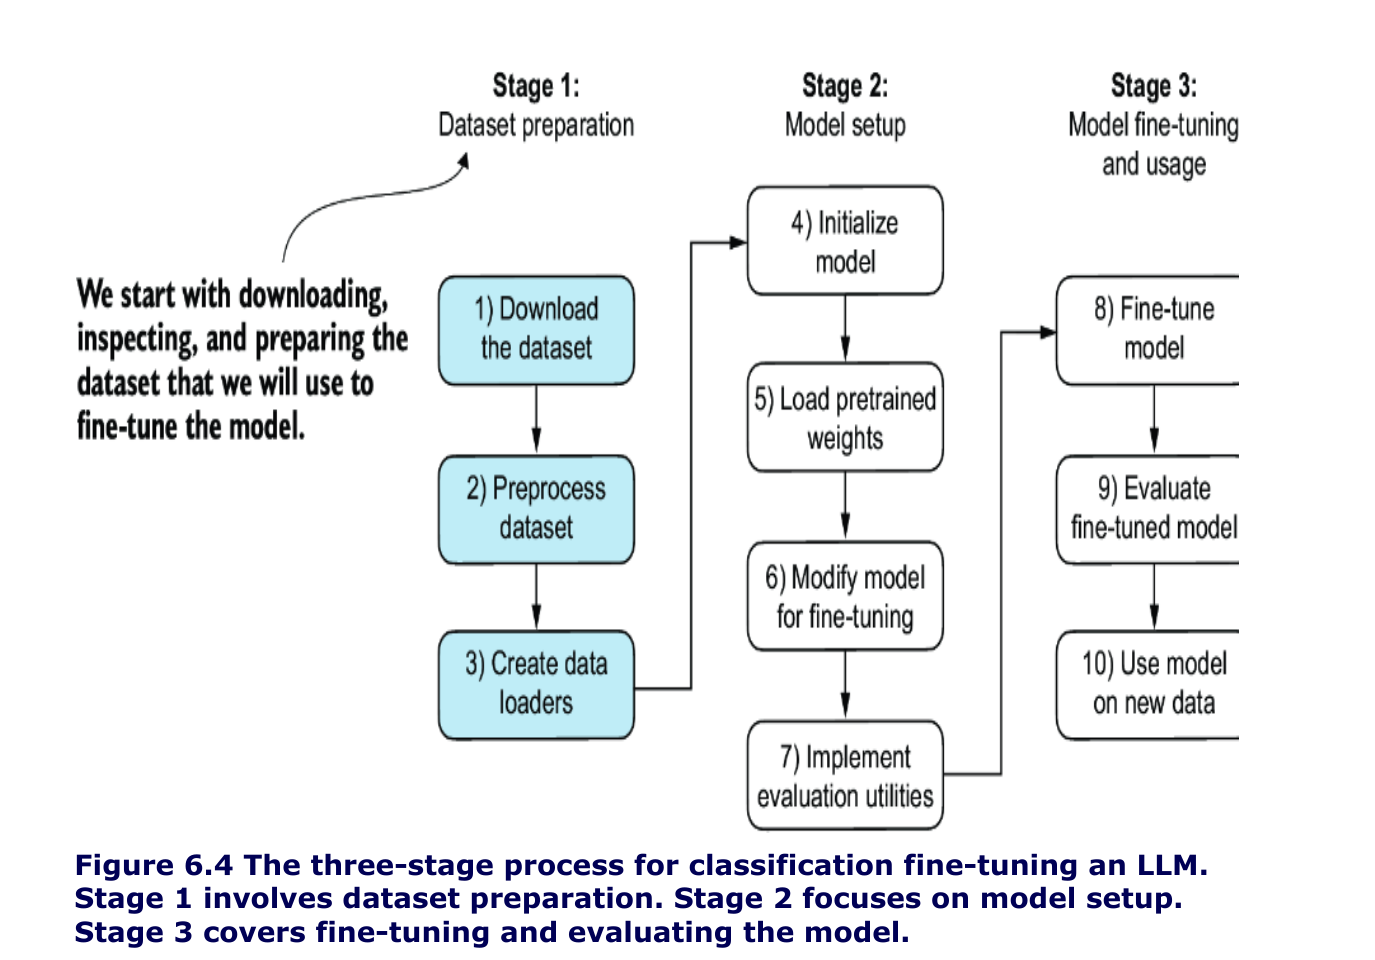
数据集处理
本章采用一个垃圾邮件识别的分类微调,只有ham和spam两种类别,所以词表只需要两个token_id: 0和1.
接着我们将数据集分成三部分,70%用于训练,10%用于验证,20%用于测试.验证在训练过程中进行,而测试则在训练结束后进行,这是二者的区别.
鉴于数据集中每条数据的长度不一,如果不统一就不能进行批量训练,而只能逐条数据训练,对此,我们有两种选择:
- 将所有消息截断为数据集或批次中最短消息的长度。
- 将所有消息填充到数据集或批次中最长消息的长度。
问题在于第一种方法会丢失信息,极有可能影响模型性能,所以还是采用第二种方法.
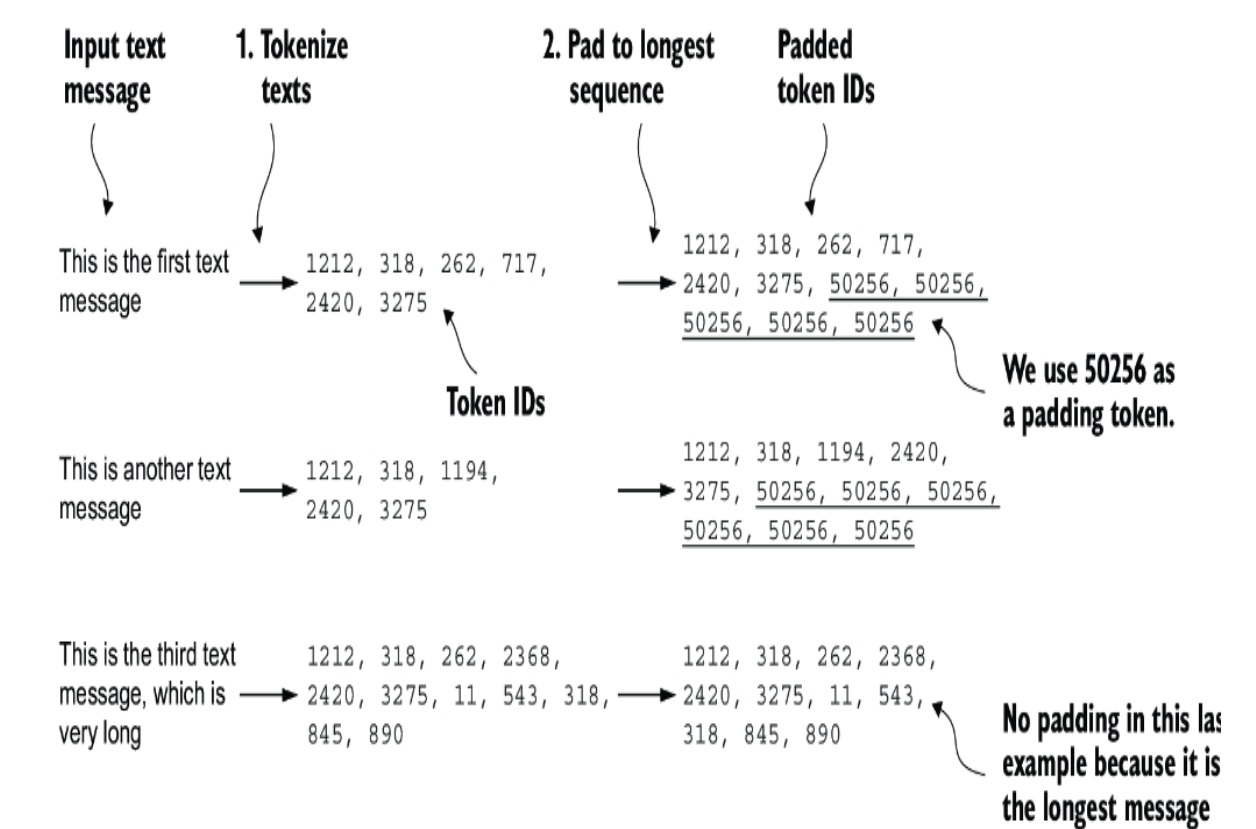
替换输出层为classification head
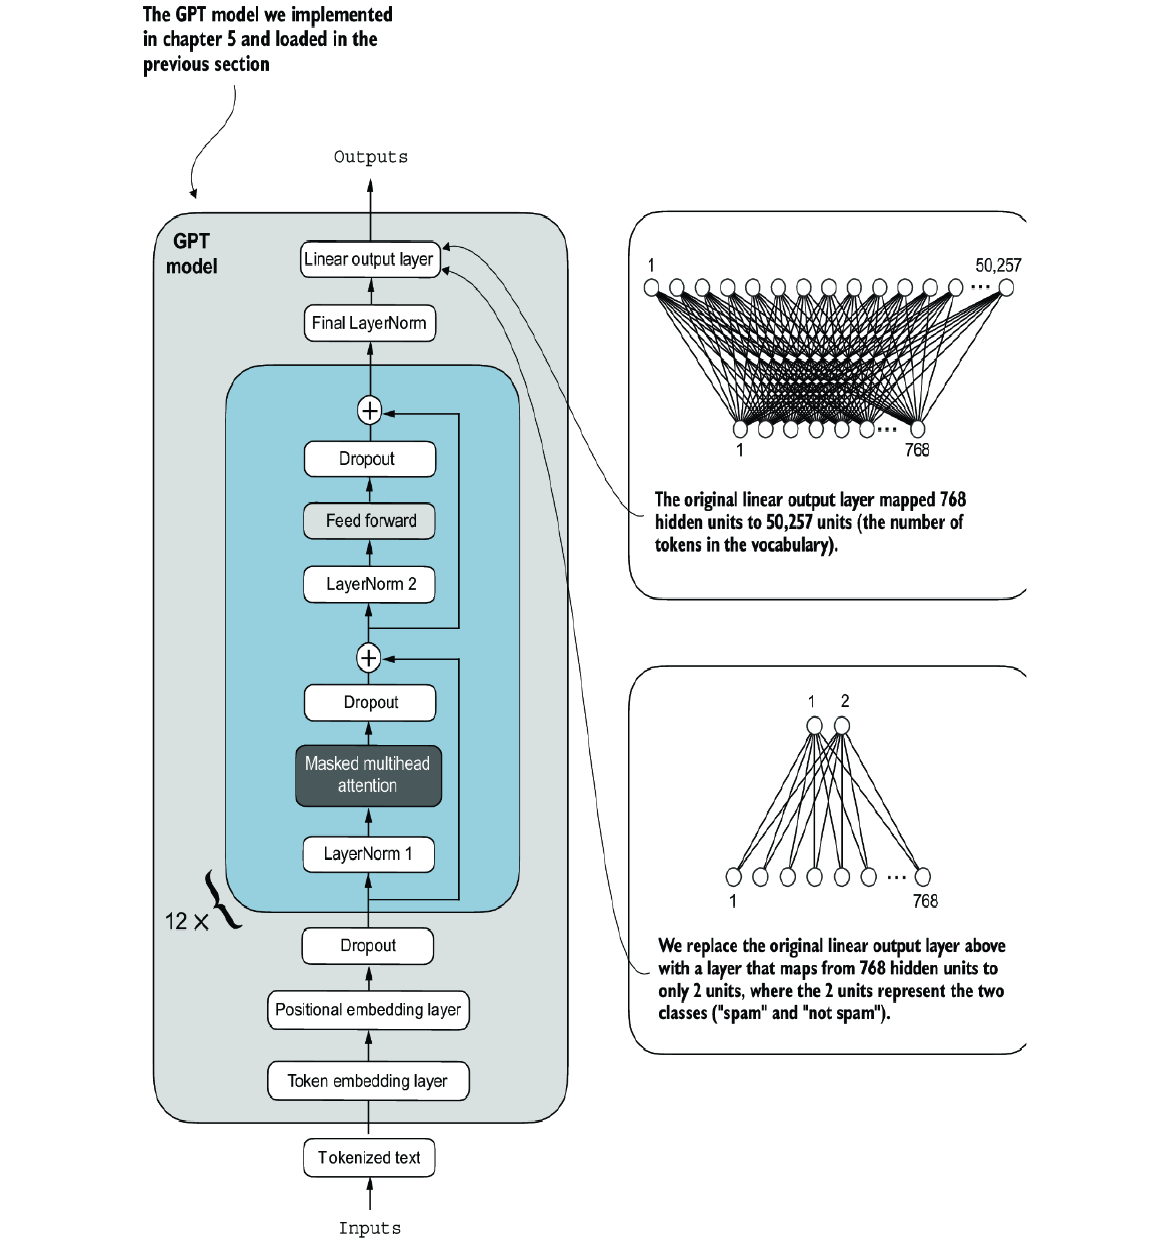
由于我们使用的是预训练模型,因此无需对所有模型层进行微调。在基于神经网络的语言模型中,底层通常捕捉适用于各种任务和数据集的基本语言结构和语义。因此,只需微调最后几层(即靠近输出层的层),这些层更侧重于细微的语言模式和特定任务的特征,通常就足以使模型适应新的任务。
对于我们这个任务,需要解释一下为什么只需要获取最后一个输入token的输出即可,原因在于我们是用casual attention训练的,只有最后一个token能够获取文本的所有信息.
损失函数
对于我们这个分类任务,最终只会输出一个二维向量,我们同样可以用softmax归一化处理后获取id0和id1的概率,但由于输出值越大概率就越高,所以用argmax即可得到最终的输出.
我们依旧采用交叉熵损失作为损失函数,但只需要激活最后一层的Transformer块即可.
Supervised Fine-tuning
ch7: Instruction Fine-tuning
数据集
首先构造一个指令-输出对数据集,内容如下:
| |
常见的两种提示风格如下:
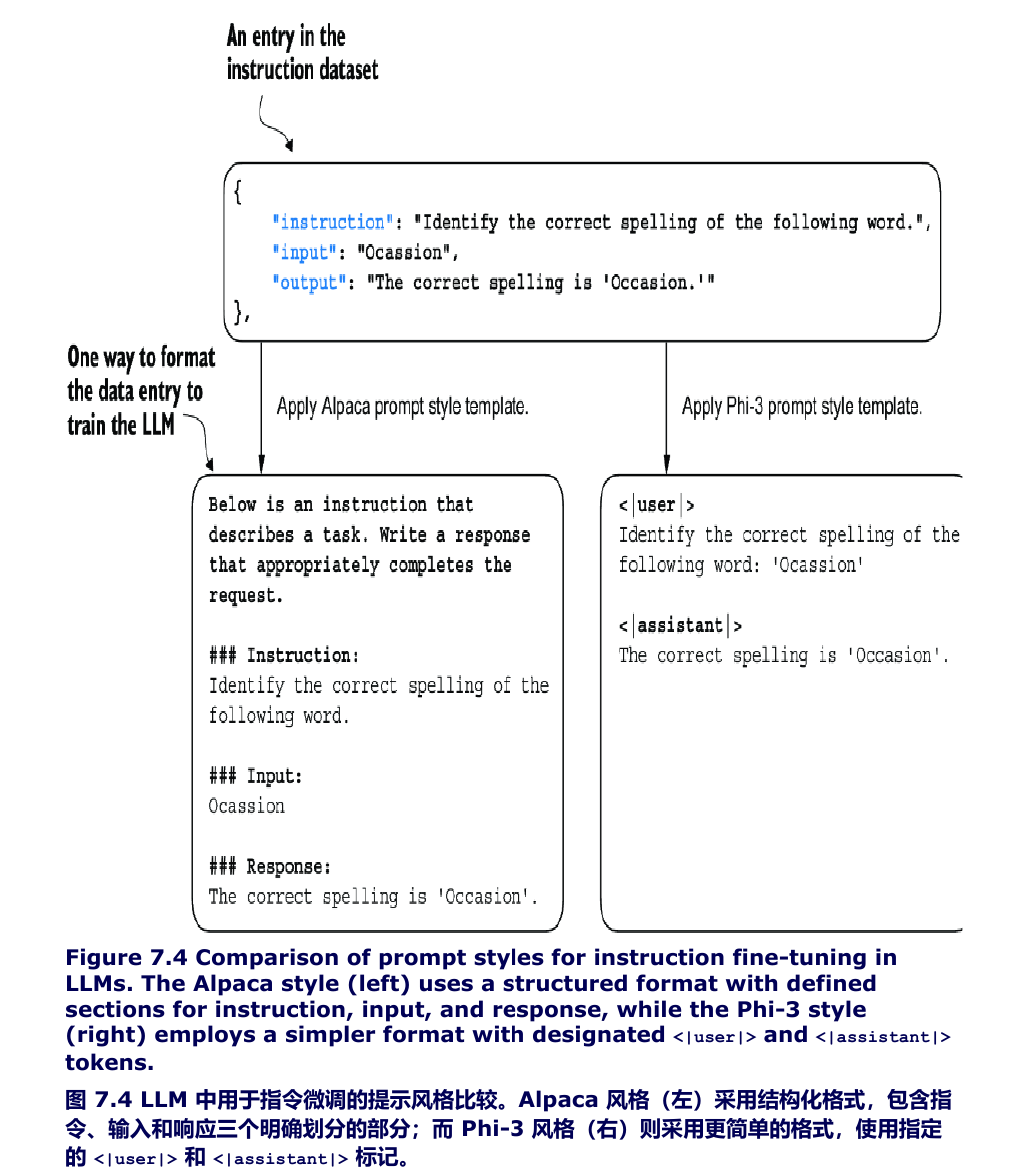
本章将使用Alpaca风格,因为它最流行.
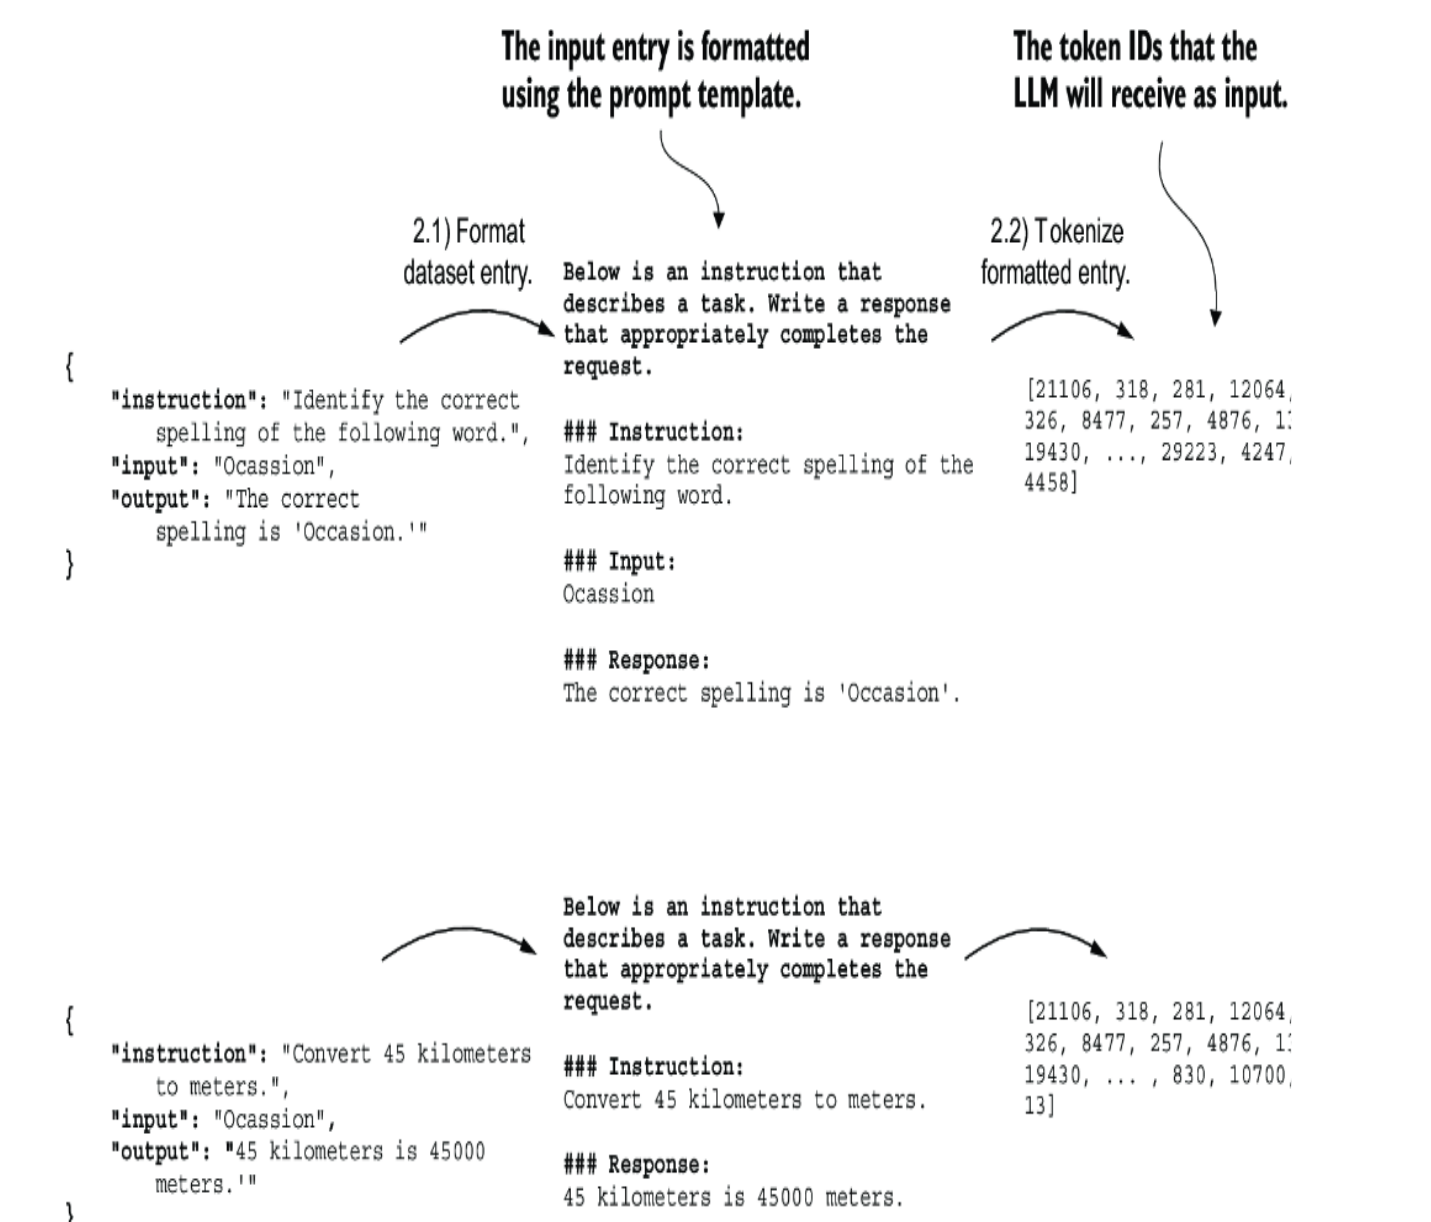
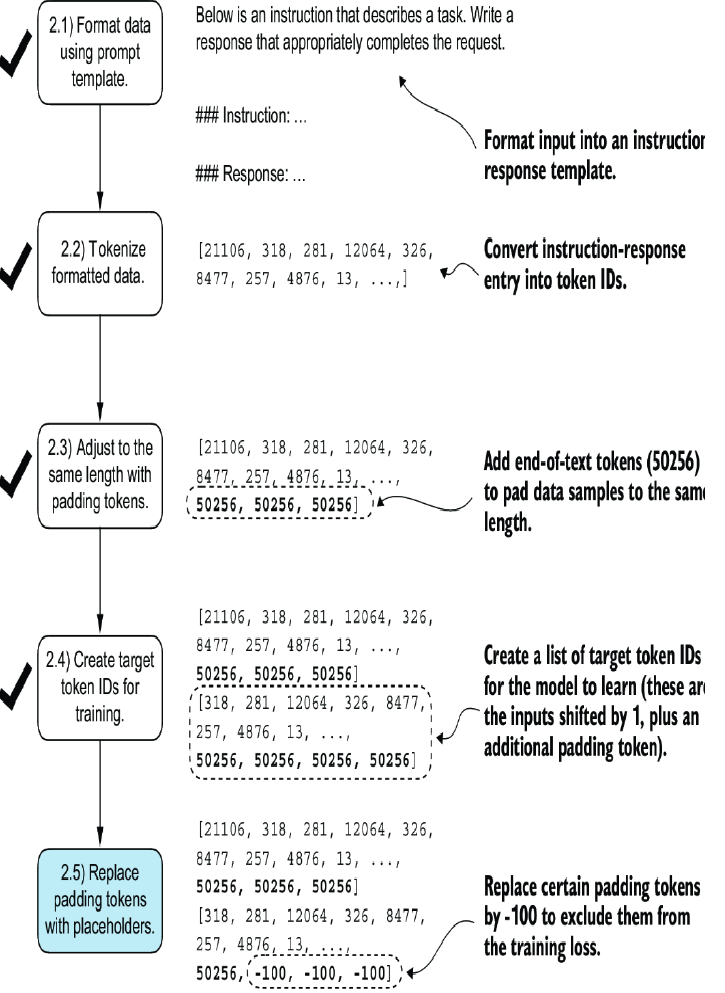
- 50256被换成ID
-100后,会在计算交叉熵损失时被pytorch默认忽略,从而确保padding不会影响模型训练 - 之所以保留一个50256是为了让LLM学习什么时候要生成文本结束符,从而判断响应是否完整
在训练时,我们可以对指令部分也换成-100,但又有研究表明,不用掩码的效果反而会更好.
评估LLM
对于IFT来说,输出质量并不是那么好判断的,人工一个个看太累了,一个方法是使用一个训练好的LLM来评估训练模型的输出,我们可以给出以下指令:
| |
总结
相见恨晚
Build an AI Agent
前言
当我们开始构建代理时,框架简直是天赐之物。LangGraph、CrewAI、AutoGen 等框架使得只需几行代码就能搭建一个可运行的智能体。但每当我们试图深入探究,无论是为了理解智能体的行为原因,还是为了修复生产环境中出现的故障,最终都会不得不阅读框架的源代码。当我们深入研究时,会发现同样的问题:每个框架的底层都蕴含着相同的核心理念:消息循环、工具调用、执行上下文、内存、规划和协作。名称和默认值各不相同,但模式却是共通的。
ch1: What is an AI agent?
在着手开发代理之前,我们必须按正确的顺序提出正确的问题。有两个关键决策决定了代理是否是合适的解决方案:
- Does this task require an LLM?
- If an LLM is needed, does it require an agent, or will aworkflow suffice?
在任何一个阶段回答“否”都意味着选择更简单、更经济高效的方法。
ch2: LLM介绍
从Hugging Face下载GAIA数据集
| |
每个GAIA数据的格式如下:
| |
Question 字段包含用户向我们的智能体提出的问题。Final answer 是我们要与之比较的真实值——在本例中为 17。file_name 字段指示问题是否包含附件;空字段表示问题没有附件。Annotator Metadata 字段揭示了问题创建者解决该问题所需的工具,包括网络浏览器、搜索引擎和计算器。
为了格式化模型的输出,我们引入Pydantic:
| |
模型比较:
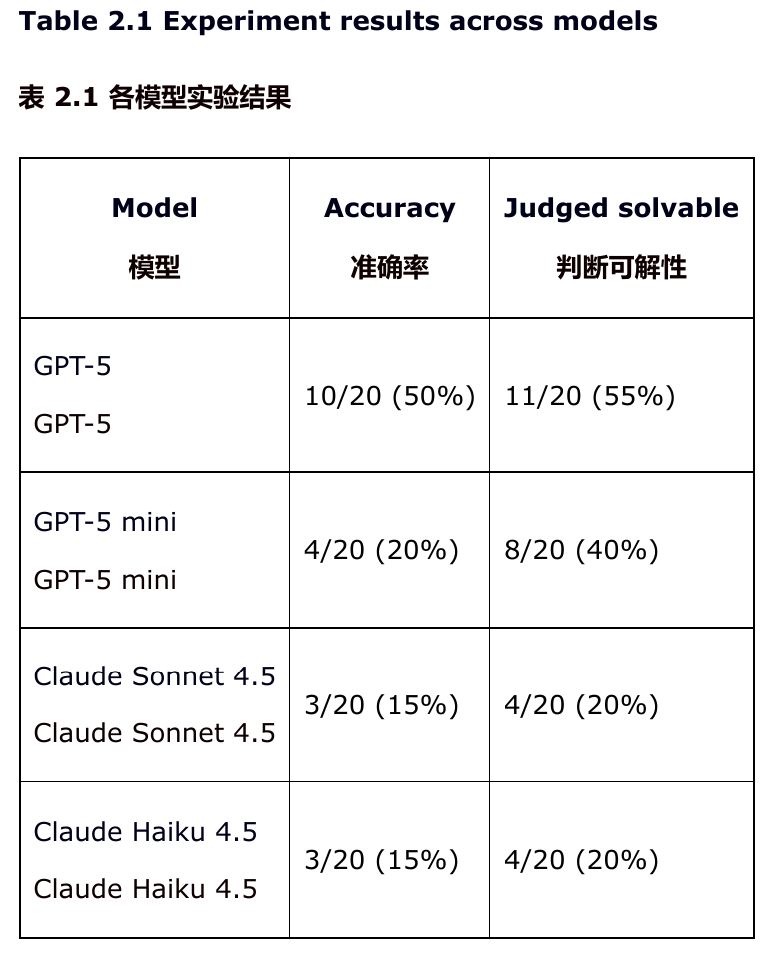
在20个问题中,只有5个问题是不用工具也能解决的,意味着理论准确率最大也只有25%,但由于LLM在训练时已有内置的互联网知识,所以它们往往能够成功解决那些看似需要外部信息的问题
现在我们有了一个基准:即使功能强大的低级逻辑模型 (LLM) 在没有工具的情况下,也只能解决一小部分一级问题。在第三章中,我们将赋予智能体使用工具的能力,首先从网络搜索开始。然后,我们将回到这些相同的 GAIA 问题,并衡量智能体的性能提升。
ch3: Tool use
工具定义
| |
上述为Chat Completions API的格式,如果是Responses API的话,则是这样的:
| |
循环
文中的设计如下:
| |
MCP
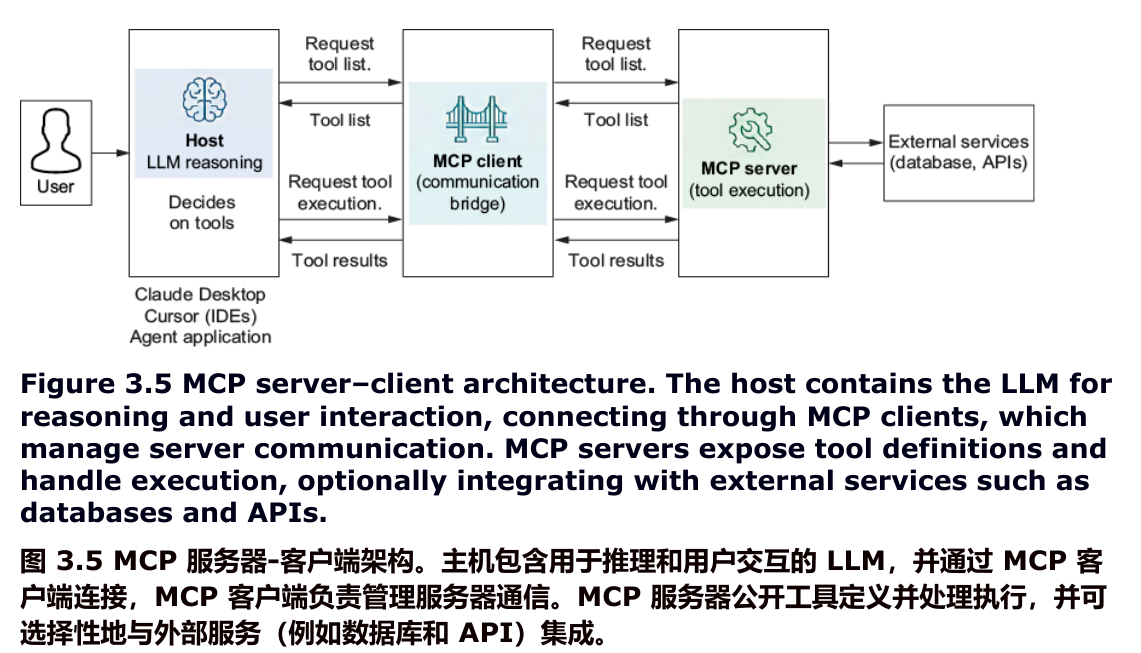
ch4: 实现ReAct(待补充)
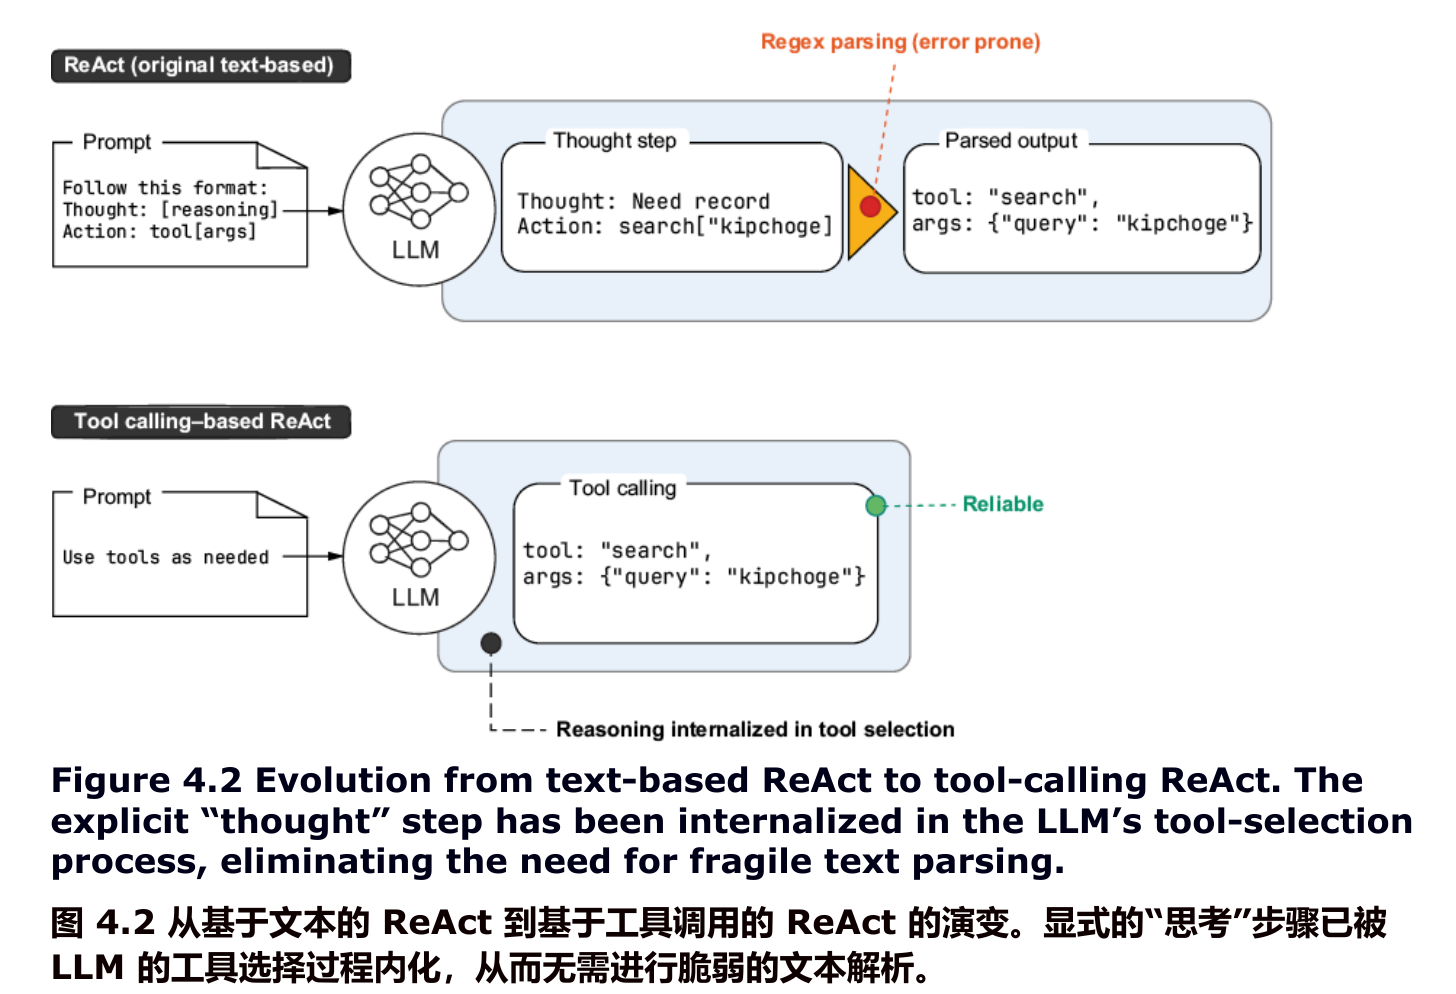
如果现在没有显式的“思考”步骤,它还能算是 ReAct 吗?是的。推理过程并没有消失;它只是转移到了 LLM 内部。现代 LLM 经过大量工具调用示例的训练,学习识别哪种工具适用于每种情况。当 LLM 选择工具并指定其参数时,它已经在内部完成了推理。
Context设计
消息,工具调用,工具结果的pydantic模型:
| |
ch5: 知识库建立
概览
| 场景 | 推荐方法 | 原因 |
|---|---|---|
| 精确词/代码搜索 | 关键词搜索 | 需要精确匹配 get_user_by_id、错误代码 404 等 |
| 自然语言问题 | 向量搜索 | 需要语义搜索,例如“如何存储数据”之类的查询 |
| 基于关系的问题 | 图搜索 | 需要关系遍历,例如“调用此函数的代码” |
| 文件夹/文件结构探索 | 基于结构的搜索 | 当结构本身就是信息时,例如 zip 文件或代码库 |
| 生产环境 | 混合搜索 | 结合多种方法的优势 |
callback部分的设计很值得学习.
总结
最后两章可以跳过,但前面都是必读的,只不过鉴于文字的表达有限,还是直接看源代码来的更有效果.
高级
Becoming SRE
- 出版于2024年,出版商:O’Reilly,作者:David N. Blank-Edelman。
介绍
Site reliability engineering is an engineering discipline devoted to helping organizations sustainably achieve the appropriate level of reliability in their systems, services, and products.
每当我与那些努力理解网站可靠性工程的人交谈时,几乎可以保证讨论迟早会涉及类似这样的问题:DevOps与SRE相比有何异同?它们之间有何关系?在同一个公司同时拥有这两种角色是否合理?
- SRE Implements Class DevOps
- SRE Is to Reliability as DevOps Is to Delivery
- It’s All About the Direction of Attention
总的来说,SRE的职责更大,所以可以说是高级运维.
SRE思维
It was suggested that both the work was well suited to people with ADHD and that people with ADHD were some of the best at this work.
- 说的确实很对,如果你愿意每天折腾各种各样的故障,甚至有在大半夜被叫起来去恢复系统的癖好,那你绝对有ADHD.
SREs can be prone to yak shaving.,意思是为了解决一个问题你要解决一连串的连带问题,永远都搞不定.
总结
前三章看看就得了,后面还翻来覆去的讲这些经验就没看头了.
Building Evolutionary Architectures,2nd edition
- 出版于2022年(第2版),出版商:O’Reilly,作者:Neal Ford。
介绍
当我们于2017年撰写《构建演进式架构》第一版时,软件架构可演进的想法仍显得有些激进。在一次关于该主题的早期演讲中,丽贝卡在结束后被某人指责,称她提出软件架构能随时间演进是职业上不负责任的表现——毕竟,架构是永远不变的东西。然而,正如现实所教导我们的,系统必须不断演变以满足用户的新需求,并反映不断变化的软件开发生态系统的变化。
为什么我们在2000年没有微服务 考虑一位拥有时间机器的架构师,乘时光机回到2000年,向运营负责人提出一个新想法。 “我有一个很棒的新架构概念,它可以让各项能力之间实现极佳的隔离——这叫做微服务;我们将围绕业务能力设计每个服务,并保持高度解耦。” “太好了,”运营负责人说道,“你需要什么?” “嗯,我需要大约50台新电脑,当然还有50个新的操作系统许可证,另外还需要20台电脑用作独立数据库,并为它们配备许可证。你认为我什么时候能全部拿到这些?” “请离开我的办公室。”
尽管微服务在当时看起来可能是个好主意,但生态系统还无法支持它。
无论软件开发涉及的具体方面如何——编程平台、语言、运行环境、持久化技术、云服务等——我们都预期不断变化。尽管无法预测技术或领域环境中的变化何时发生,或哪些变化会持续,但我们知道变化是不可避免的。因此,我们应该在架构系统时认识到技术环境将会改变。
总结
尽管标题是这个,而第一章也的确很雄心壮志,可惜的是后面的内容都是毫无意义的扯淡了.
从零开始学架构(待补充)
- 出版于2018年,作者:李运华。
- 确实很详细,待日后有需求再来学.
Designing Data-Intensive Applications, Second Edition(待补充)
- 出版于2026年(第2版),出版商:O’Reilly,作者:Martin Kleppmann。
前言
- 第一版于2017年出版,第二版于2026年出版,中间间隔了十年,所以章节内容上有了大幅度的改动.
- 第一版出版后就被很多人奉为神书,那么再版后想必更厉害了吧.
There are hundreds of databases to choose from. Which one should you use for your application? The short answer is, “It depends.” The long answer is…this book.
这才是软件工程最美丽的地方,技术的变迁和环境的动荡迫使着程序员们殚精竭虑,设计出符合当前情况的最好架构.
背景
先看看两位作者的title: Martin Kleppmann and Chris Riccomini
Martin Kleppmann(马丁·克莱普曼)目前是英国剑桥大学计算机科学与技术系副教授(Associate Professor),主要研究去中心化系统、Local-first 协作软件和安全协议,并教授分布式系统和密码协议相关课程。此前曾在慕尼黑工业大学从事研究,并在剑桥大学获得博士学位。
Kleppmann 在进入学术界以前做过多年互联网工程和创业。他曾共同创办并出售两家创业公司,也曾在 LinkedIn 等互联网公司从事大规模数据基础设施工作;其中还包括创业公司 Rapportive。
第一版的作者只有他一个人,还是很厉害的,他甚至还有一个博客
Chris Riccomini,O’Reilly 对他的介绍是:拥有 15年以上软件工程经验,先后在 PayPal、LinkedIn、WePay 工作,目前经营 Materialized View Capital,投资基础设施类创业公司
基本
如果一个应用程序开发过程中的主要挑战之一是数据管理,我们便称之为数据密集型应用. 在计算密集型系统中,挑战在于将极其庞大的计算任务并行化;而在数据密集型应用中,我们通常更关注存储和处理海量数据、管理数据变更、在面临故障和并发时确保一致性,以及保证服务的高可用性等问题。
前两章基本都是经验之谈,可看的地方不多.
数据模型
对常见数据库的一个总结,稍微有一点看头
存储
实际上,哈希表在数据库索引中的使用并不普遍。更常见的做法是按照键的顺序来组织数据
本章目前为止讨论的数据结构都是为了解决磁盘的限制问题。与主存相比,磁盘操作起来更为不便。无论是机械硬盘还是固态硬盘,若要实现良好的读写性能,都需要精心安排数据布局。我们容忍这种不便,是因为磁盘拥有两大显著优势:持久性(断电时内容不会丢失)以及每吉字节成本低于RAM。
编码
介绍了Avro,Protobuf,Json Schema等主流编码方式
Json Schema
不看不知道,原来Json Schema这么出名,MCP,OpenAPI,OAuth都用的是它,格式如下:
| |
RPC介绍
本地函数调用是可预测的,其成功与否仅取决于你控制的参数。而网络请求则不可预测,原因完全不受你控制。例如,请求或响应可能因网络问题丢失,远程机器可能响应缓慢或不可用。网络问题很常见,因此应用程序必须预见这些问题(例如,通过重试失败的请求)。
一个本地函数调用要么返回结果、抛出异常,要么永不返回(例如进入无限循环或进程崩溃)。而网络请求则有另一种可能的结果:可能因超时而无结果返回
- 这也是网络游戏制作的一个难点之一
Replication
如果你复制的数据不随时间变化,复制操作就很简单:只需将数据一次性复制到所有节点即可完成任务。复制的所有难点在于处理被复制数据的变更
复制最大的难点在于如何保持同步,即便通过发送日志的方式来保持主从一致性,但如果SQL指令中有Now,Rand等结果未知的语句,或者具有无法预知的副作用如trigger,就会破坏这个一致性.
更为特殊的地方是,由于我们不可避免地要使用异步复制,那么很容易就出现读写不一致的问题,为了保证用户体验,我们需要通过单调读(Monotonic reads)来解决用户读取到更老版本的问题.
复制一共有三种方式: Single-leader,Multi-leader,Leaderless,各有千秋,只好看情况使用了.
Full Stack Testing,2nd edition
- 出版于2026年(第2版),出版商:O’Reilly,作者:Gayathri Mohan。
- July/9 2026: Second Edition
- 我读这本书的日期为7/19,而zlib上就已经有资源了,确实离谱
ch1
Starting testing early in the delivery cycle to provide faster feedback is referred to as shift-left testing, and it’s a key principle of full stack testing.
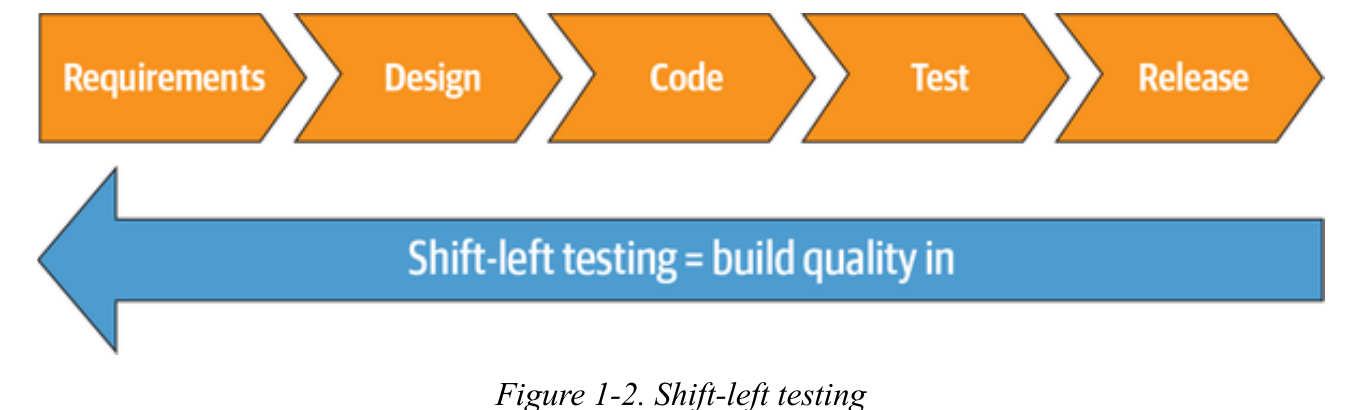
总结
基本都是概念,没多少实战,还教我用AI写测试,跟我原来想的差距有点大.
Security Chaos Engineering
- 出版于2020年,出版商:O’Reilly,作者:Aaron Rinehart。
很好奇这种丝毫不涉及现实,而是空泛提及理论的书是如何出版的.
SQL Antipatterns: Avoiding the Pitfalls of Database Programming
- 原版出版于2010年,中文版是2011年的,不过后来在22年出了一个重制版,并在今年3月出了第二卷,叫做
More SQL Antipatterns(很惊人的是在网上找不到资源),不过既然有中文版就先看中文版吧.
引言
- 什么是“反模式”?反模式是一种试图解决问题的方法,但通常会同时引发别的问题。
换句话说,这本书通过不当使用SQL的例子来告诉读者如何正确使用SQL,每一章都有一个具体的例子,所以只看有需要的几章就可以了.
乱穿马路
程序员通常使用逗号分隔的列表来避免在多对多的关系中创建交叉表,我将这种设计方式定义为一种反模式,称为乱穿马路(Jaywalking),因为乱穿马路也是避免过十字路口的一种方式。
也就是说,本来是这样的:
| product_id | product_name | account_id |
|---|---|---|
| 1 | iPhone | 101 |
| 2 | MacBook | 102 |
结果魔改成这样了:
| product_id | product_name | account_id |
|---|---|---|
| 1 | iPhone | 101,102,108 |
| 2 | MacBook | 102,205 |
| 3 | iPad | 101 |
本来加一个关联表就能解决的事情被折腾的一塌糊涂
单纯的树
| |
如果评论允许多级嵌套(如Reddit中所做的那样),那么就可能出现一个深度过高的评论树,大幅度降低查询性能.
容易想到的嵌套查询方法如下:
| |
如果对树高有一定限制的话(这是大多数网站的做法,到了2级评论就结束了),这个做法还是可行的.
之所以使用左外连接,是因为无论 c1 有没有子评论,都必须保留 c1。
解决方案
- 使用动态数组来存储路径:
| comment_id | path | author | comment |
|---|---|---|---|
| 1 | 1/ | Fran | 这个Bug的成因是什么 |
| 2 | 1/2/ | Ollie | 我觉得是一个空指针 |
| 3 | 1/2/3/ | Fran | 不,我查过了 |
| 4 | 1/4/ | Kukla | 我们需要查无效输入 |
| 5 | 1/4/5/ | Ollie | 是的,那是个问题 |
| 6 | 1/4/6/ | Fran | 好,查一下吧 |
| 7 | 1/4/6/7/ | Kukla | 解决了 |
- 使用嵌套集,即反过来,存储子节点的id,而不是存储父节点的id
- 闭包表(Closure Table),将任何具有祖先-后代关系的节点都记录在一张表中,如图所示:
补充说明
不过,如果是社交平台的话,我们可以通过好友找到好友的好友,再通过好友的好友,找到好友的好友的好友,不断迭代下去,永远不会有一个尽头.这就是图数据库大展神威的地方了,这本书出版的时候显然还没有这个概念吧.
需要ID
这章的目标就是要确认那些使用了主键,却混淆了主键的本质而造成的一种反模式。
很多的书、文章以及程序框架都会告诉你,每个数据库的表都需要一个主键,且具有如下三个特性:
- 主键的列名叫做 id ;
- 数据类型是 32 位或者 64 位整型;
- 主键的值是自动生成来确保唯一的。
但为了让数据库更加清晰,简洁,我们应该做到如下几点:
- 尽量详细说明id的类型,如Bugs表的主键叫做bug_id
- 通过关联关系定位主键,这样就可以不用给关联表加上id了.
不用钥匙的入口
说明外键约束是很有必要的.
实体-属性-值(Entity-Attribute-Value,EAV)
EAV或许看着很美观,插入起来也更简单,但却让查询操作变得痛苦无比,所以不要轻易把列变成行,而是老老实实写关系型数据库.
幽灵文件
当一个理论看上去像是唯一可能的理论时,那意味着你既不理解这个理论,也不理解它所要解决的问题。
理论上来说,图片是一张表中的一个字段,在 Accounts 表中可能会有一个 portrait_image 列。
| |
我们可以选择BLOB类型存储,也可以选择存在文件系统中,并通过VARCHAR记录对应的文件系统路径.
但对于后一种方法,有以下缺点:
- 删除路径属性并不能自动删除路径所在的文件,然后图片就会堆积在那里,除非自己再写一个后端处理函数
- 不支持事务隔离,其他客户端也可以找到图片文件
- 不支持数据库备份和访问权限设置
如果我们简单直接一点,可以把图片直接存储在数据库之外,与数据库管理分离,显然也是一个不错的选择.
System Design Interview: An Insider’s Guide
- 出版于2020年(第1卷),作者:Alex Xu。
你就读吧,很久没见过这么干净利落的技术书籍了,对我的感触远比DDIA要震撼的多.
ch1: 网络扩展
一个非常好的网络服务进阶流程概览
ch10: 通知系统设计
尽管TCP的重传机制保证了我们的消息一定能够发送到用户设备里,但是这只是到了传输层为止,而在应用层,完全可能出现断连(如手机突然关机)等情况,这个时候由于我们收不到用户的通知反馈,只能选择重传,并通过通知ID来去重.
ch12: 聊天系统
聊天系统中,尽管发送端发送消息是实时的,但接收端接收消息却不可能是这样的,一个简单的方法是通过长时的轮询(polling),每过一段时间就重新连接消息系统,查看有没有新消息.
而官方的解决方案是WebSocket,这是一个由客户端发起的双向且持续的HTTP连接,从而保证用户能够实时地接收到消息.
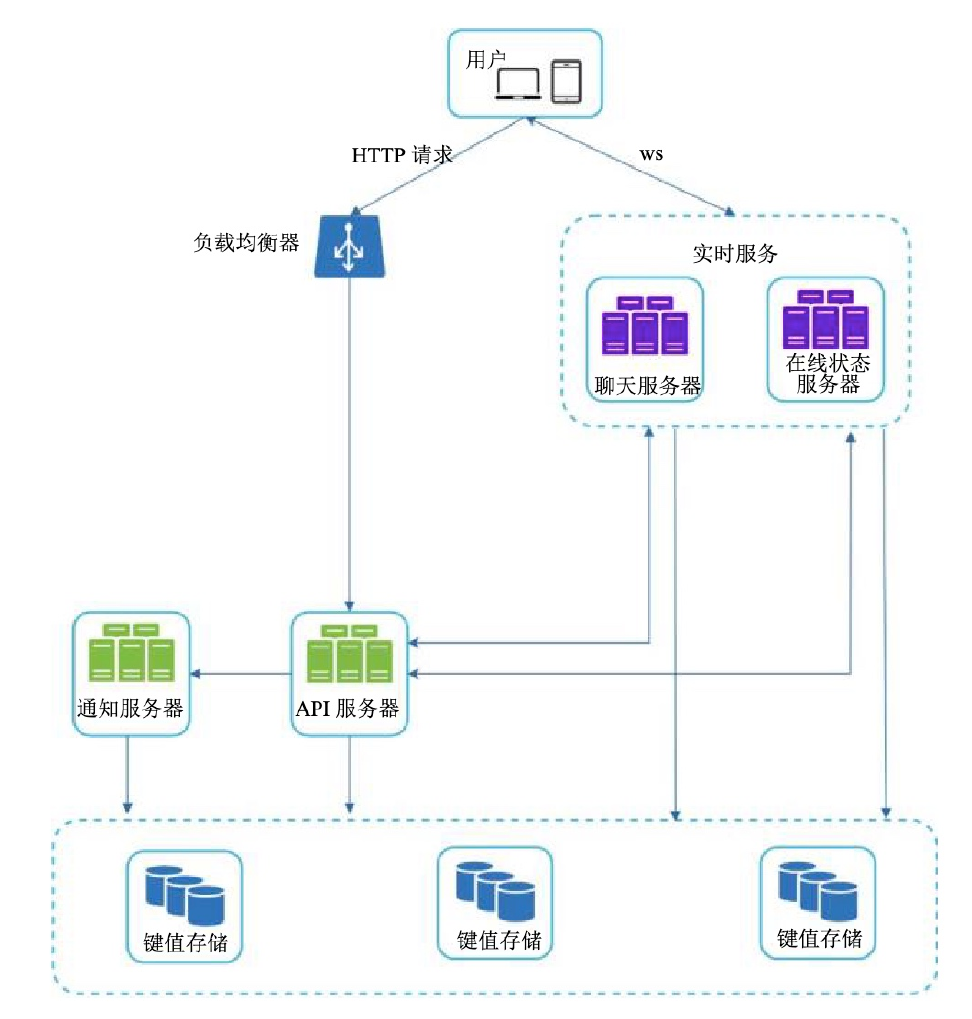
用户连接断开
我们都希望互联网连接是稳定可靠的,但实际上并非总是如此,因此我们在设计中必须为这个问题给出应对方法。当用户与互联网断开连接时,客户端和服务器之间的持久连接就丢失了。处理用户断开连接的一个简单方法是,把用户状态标记为离线,然后当连接被重新建立时再将用户状态改为在线。但是,这个方法有个大缺陷。用户在短时间内频繁地断开连接和重新连接互联网是很常见的。举个例子,当用户正在穿越隧道时,网络连接会时有时无。在每次断开连接/重新连接时都更新在线状态,会让在线状态指示器变化太频繁,导致用户体验很差。
这个问题可以通过心跳机制解决,客户端定期向服务器发送一次心跳,如果服务器在x秒内收到了信号,那么就认为用户是在线的.
ch13: Google补全
一般的字典树每个节点存储一个前缀符或者单词,但这样一来在自动补全时就要经过大量的查询,一个非常合理的方法是在每个节点保留最高频的几个查询词,结构如下:
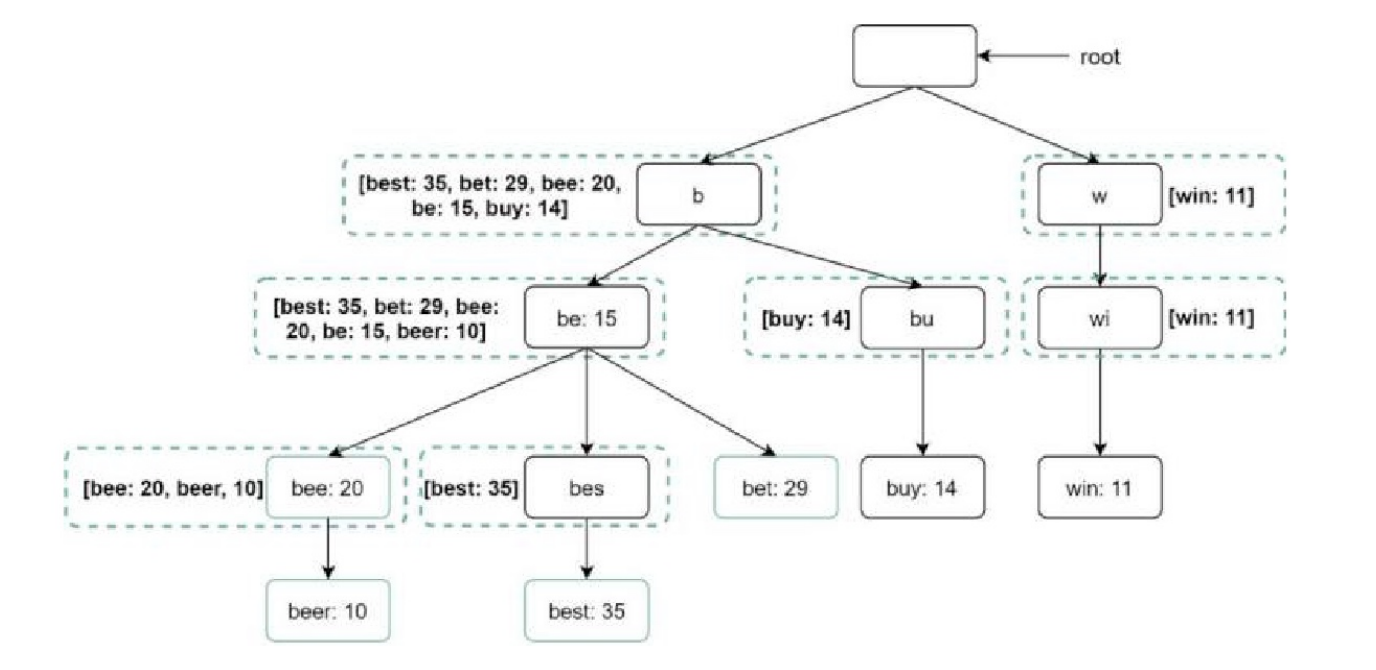
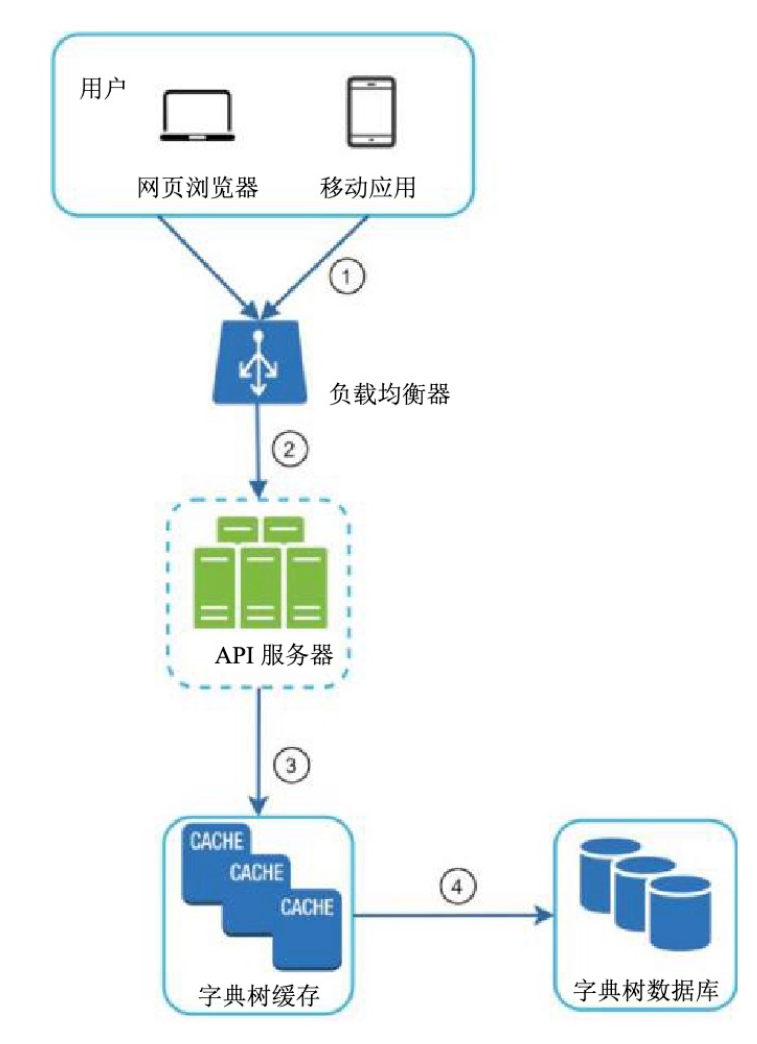
微服务设计
- 出版于2015年(英文原版),出版商:O’Reilly,作者:Sam Newman。
不推荐阅读
微服务
补充: 什么是微服务
- 这本书说了很多,但还是没说清楚
- wiki
In software engineering, a microservice architecture is an architectural pattern that organizes an application into a collection of loosely coupled, fine-grained services that communicate through lightweight protocols.
在具有不同功能的代码之间划清界限,将代码库分割到一个足够小的程度(有多小则看个人的考量),通过API和网络通信相互连接,每一部分都可以独立地运行,这就是微服务,每一部分的独立代码被称为服务(service).
- 也就是说微服务相当于是对良好架构设计的一个狂霸酷炫拽的称呼.
微服务的好处
- 可以轻松的升级/替换某一个服务而不影响其他的服务
- 可以轻松的扩展服务,而不需要重构整个项目
- 由于各个服务的部署是独立的,在出问题时可以专精于出错的特定服务,容易定位和筛查
演化式架构师
架构师并不是建筑师,互联网行业也不是建筑行业,鉴于软件开发的多变性,我们需要灵活调整软件的架构.
架构师应该专注在大方向上,在有限的情况下才会参与到具体的细节实现上.
部署
- 持续集成(Continuous Integration): 将新提交的代码与原代码进行集成,从而让所有人保持同步
- 持续交付(Continuous Delivery): 检查每次提交是否达到了部署到生产环境的要求
总结
前几章看看就可以了,收获并不大,不如直接看维基百科还来的快一些.
The Design of Web APIs, Second Edition
- 出版于2025年(第2版),出版商:Manning,作者:Arnaud Lauret。
前言
- “I can’t list friends of friends!”
- “What contains the
stsproperty?” - “Why don’t
createdAtandfromDateuse the same date-time format?”
API设计确实非常重要,否则不但是开发起来麻烦,用户的体验也会大打折扣
不是每个人都能有幸从白纸一张开始设计API。现有的API可能存在并且设计得不够理想。我们的目的并非指责过去的设计,而是要防止API设计的技术债务继续增加
总结
没能和实战相互结合,也没能具体深入讨论API与应用其他部分的结合,因此就是在建空中楼阁,完全不推荐.
Mastering API Architecture(待补充)
- 出版于2022年,出版商:O’Reilly,作者:James Gough。
前言
One of the hardest things to track during the life of a project is the motivation behind certain decisions. A new person coming on to a project may be perplexed, baffled, delighted, or infuriated by some past decision.
因此,我们需要通过ADR(Architecture Decision Record,架构决策记录)来保存架构设计时的各种考量
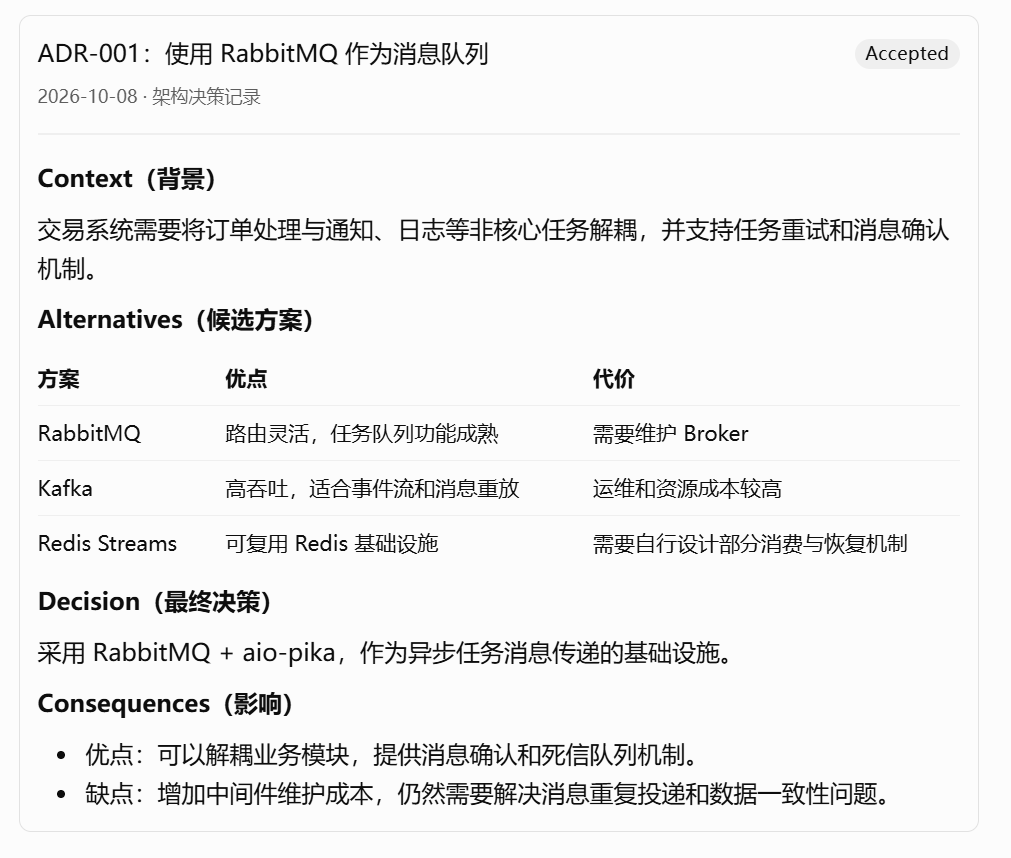
API Gateways
正如您将在本章所学,API网关并非唯一能提供这些需求的技术。例如,您可以使用简单的代理或负载均衡器实现。但我们认为,API网关是最常用的解决方案,尤其是在企业环境下,随着服务消费者和提供者数量的增加,它往往是可扩展性最强、最易于维护且最安全的选择。
- 说真的,没人受得了写
nginx.conf文件的
反向代理、负载均衡器与API网关对比
| 特征 Feature | 反向代理 Reverse proxy | 负载均衡器 Load balancer | API 网关 API gateway |
|---|---|---|---|
| 单后端 Single Backend | * | * | * |
| TLS/SSL TLS/SSL | * | * | * |
| 多种后端 Multiple Backends | * | * | |
| 服务发现 Service Discovery | * | * | |
| API 组合 API Composition | * | ||
| 授权 Authorization | * | ||
| 重试逻辑 Retry Logic | * | ||
| 速率限制 Rate Limiting | * | ||
| 日志记录与跟踪 Logging and Tracing | * | ||
| 熔断 Circuit Breaking | * |
API网关是一种管理工具,位于系统的边缘,介于前端与一组后端服务之间,作为特定API群的单一入口点.
它由两个高层核心组件实现:控制平面和数据平面。这两个组件通常可以打包部署,也可独立部署。控制平面供运维人员与网关交互,定义路由、策略及所需遥测;数据平面则承载控制平面指定的所有工作,包括网络数据包路由、策略执行及遥测数据输出。
在网络层面,API网关通常充当反向代理,用于接收来自消费者的所有API请求,调用并整合满足这些请求所需的各种应用层后端服务,并返回处理结果.
API 网关提供了用户认证、请求速率限制和超时/重试等横向需求功能,并能通过提供指标、日志和追踪数据来支持系统内的可观测性实施
Service Mesh
领域驱动设计精简版
介绍
我们可以以汽车制造来做类比。参与汽车制造的工人会专门负责汽车的某个部件,但这样做的后果是工人们通常对整体的汽车制造流程缺乏了解。他们可能将汽车视为一大堆需要固定在一起的零件的集合体,但一辆汽车的意义远不只于此。一辆好车起源于一个好的创意,开始于认真制定的规格说明,然后再交付给设计。经历若干道设计工序,花费上几个月甚至几年时间去设计、修改、精化,直至达到完美、能够完全反映出最初的愿景。设计的过程也不全然是在纸上进行的。设计工作的很大一部分包括了建造汽车的模型(doing models of the car),并且在特定条件下对它进行测试,以验证该模型是否能工作。设计会根据测试的结果做出修改。汽车最终被交付到生产线上,在那里,所有的部件已经就绪,然后被组装到一起。
- 为了创建一个好软件,你必须知道这个软件究竟是什么。在你充分了解金融业务是什么之前,你是做不出一个好的银行业软件系统的,你必须理解银行业的领域。
总结
确实看不得这种书,全是正确的废话,真要领悟还是得靠实战.
Continuous API Management,2nd edtion
ch1: API管理的挑战
简单介绍API和API管理
ch2: API Governance
如何设计某个API接口,如何确定API的统一风格,API冲突时如何解决,这些都属于API Governance的范围.
对于决策者/架构师来说,我们需要决定如何下放API Governance,哪些决策可以由小组成员独立解决,哪些决策又必须由本人决定.
总结
实际上就是面向管理岗的,也没什么看头其实,没有一点实战环节
Learning Domain-Driven Design(待补充)
- 出版于2021年,出版商:O’Reilly,作者:Vlad Khononov。
ch1: Analyzing Business Domains
讲了一些关于Domain的基本知识
ch2: 发现领域知识
和专业领域人员探讨,找到通用语言.
假设我们正在开发一个广告活动管理系统。请考虑以下陈述:
- 广告宣传活动可以展示不同的创意素材。
- 只有当广告系列中至少有一个广告位处于激活状态时,该广告系列才能发布。
- 销售佣金在交易获得批准后进行结算。
另一方面,以下陈述严格来说是技术性的,因此不符合通用语言的概念:
- 广告 iframe 会显示一个 HTML 文件。
- 只有当活动广告位表中至少有一条关联记录时,该广告活动才能发布。
- 销售佣金是根据交易记录和已批准销售表中的相关记录计算的。
可以看到,专业领域人员是看不懂技术名词的,我们需要精确实行二者间的转换.
这一点值得重申:一个有用的模型并非现实世界的复制品。相反,模型的目的是为了解决问题,它只需提供足以实现该目的的信息。或者,正如统计学家乔治·博克斯所说:
“所有模型都是错误的,但有些是有用的。”
ch3&&ch4: 管理领域复杂性
为了确保项目成功,至关重要的是开发一种所有利益相关者(从软件工程师到领域专家)都能使用的通用语言进行沟通。这种语言应该反映领域专家对业务领域内部运作和基本原理的理解。但如果领域专家对某个技术名词的定义也要通过上下文才能精准判断时,我们就要引入Bounded Context
ch5: 实现简单业务逻辑
当我在领域驱动设计课程中介绍事务脚本模式时,学生们常常会皱起眉头,甚至有人会问:“这值得我们花时间吗?我们来这里难道不是为了学习更高级的模式和技术吗?”
关键在于,事务脚本模式是你后续将要学习的更高级业务逻辑实现模式的基础。此外,尽管它看似简单,却也是最容易出错的模式。我曾参与排查和修复的大量生产环境问题,最终或多或少都归结为系统业务逻辑的事务行为实现有误。
对于本地事务,我们写一个commit+rollback模式即可:
| |
但如果是分布式事务,就需要将消息发布到消息总线:
| |
就算执行时出错,由于没能将消息发送到消息总线,所以也就无法恢复数据
事务脚本模式的主要优势在于其简洁性。它引入的抽象层级极少,从而最大限度地降低了运行时性能和业务逻辑理解方面的开销。然而,这种简洁性也是该模式的缺点。业务逻辑越复杂,就越容易在事务之间出现重复,进而导致行为不一致——当重复的代码失去同步时。因此,事务脚本模式绝不应用于核心子域,因为它无法应对核心子域业务逻辑的高度复杂性。
另一种方法则是使用Active Record,用于实现简单的CRUD,即模型自己负责持久化和业务逻辑:
| |
ch6: 处理复杂业务逻辑
额这一章真的没看明白在讲什么
ch7: 时间建模
加入事件溯源模型,即追踪某个人物各个状态的演变过程(如普通用户申请成为管理员,不代表普通用户时期的数据就不重要了)
ch8: 架构模式
讲了几个常用的架构
ch9: 通信模式
总结
一旦你发现一本书无论如何都看不懂的时候,就应该过段时间再来看.