每日阅读
25
2025-11-15
很多人意识不到运气的重要性,而错把成功归功于自己的才能和努力, 却没有意识到好运在其中的重要性。忽视了这一点就难以保持谦虚,难以不断学习。 明白了运气的重要性,就知道不是人人生而能得到平等的机会的, 在遇到处境不如自己的人,不能假设这种差别是聪明或努力程度的不同造成的,应该知道善待弱者。
此后不久,王先生得了脑血栓。我很有些感慨:敢于直面自己一丁点儿小错的性情中人,活在一个是非不分,且明知错了却死不认账的世道里,能不得脑血 栓?
我从 D 道开始,接受了大量的指导。周围的人都对我很好,我慢慢进步,终于进入了 C 道。那组的人也热情欢迎我。 但是,我注意到,旁边 B 道的人并不像 C 道那样友善。A 道选手都非常友善,慷慨给予鼓励、表扬和提示。 我怀疑这是普遍现象:A 道、C 道和 D 道的人都很友善,大家几乎都乐于助人;B 道的人则是对 A 道和其他 B 道选手友善,但对 C 道和 D 道则不然。 因为我后来发现,其他运动领域也是如此。那些仅次于顶级选手的运动员,往往对不如自己的选手很苛刻,害怕别人超过自己。 学术界也有这种现象。真正伟大的研究者慷慨而热于助人,许多普通水平的研究者也是这样。然而,那些有一定知名度、但又没有做出顶尖成果的研究者,对不如自己的人就不友善了。 当你是最好的 A 组时,很容易表现得宽宏大量,你确信自己会有成果,这让你安心无忧。 当你处于平均水平或低于平均水平(C 组或 D 组)时,表现得友善也很容易。远离顶尖水平,意味着竞争压力不大,所需要付出的努力可能也不大,你会有一种“放轻松”的心态(反正我到不了顶峰,就当作玩呗)。 那些仅次于优秀水平的人,感受到最大的竞争压力。你离顶峰如此之近,追赶却又艰难无比,放弃又不甘心。最令人沮丧的是,没有人记得第二名。同时,后面的人还可能超过你。所有这些因素,都可能导致一种不友善的态度。
我从来不想辩论,但如果必须辩论,我希望自己会输。 我宁愿对方的观点是正确的,他来说服我,因为这样会比我的观点是正确的,我来说服他,对我更有趣。
有些是周刊上的,有些是杂志里的,很后悔我以前不会用博客把这些记录下来,想要找到来源都是难上加难.
2025-11-17
最近上wiki看了杨靖宇的词条杨靖宇wiki,缘由是看了周海婴写的回忆录,里面提到了民主元老马叙伦,马叙伦界面里提到了白朗,白朗界面里提到了杨靖宇,才发现自己的杨靖宇的了解确实贫乏.(或许我可以不断的跳转下去看一整天吧,wiki确实是一个知识宝库,五湖四海的人们四处搜集信息再将他们合并,方便后人来看,这也是开源精神触动我的核心)
纵览杨将军的生平,确实是一个典型的共产主义战士,为了人民的解放先后与地主,军阀,日寇斗争,抱持着自己的信念和理想战斗到了最后一刻,即便只剩自己一人.这与古巴的切.格瓦拉又是何其相似.他们用自己的生命彰显了信念的力量,让其他或多或少抱有私心的灵魂都黯然退下,战栗不已.
要抱有一个纯粹的理想,做一个纯粹的人多难啊,在当下更是如此.
2025-11-19
现在的孩子们比以前更容易接触到成年人的世界,因此他们更早成人化。 从很小的年龄起,他们就在视频网站观看暴力和战争,在社交网络上看到性感和暴露的照片和视频。 然而,当孩子们成年以后,他们往往无法实现经济独立,也没有机会承担足够的责任。 结果,整个社会的文化就变得很幼稚,成年人感到无法做出承诺,即使承诺了也缺乏信心,对以后的生活感到难以把握。 他们的行事方式和处事态度,就像还在青少年时期。 周刊263期
最近在看周海婴写的回忆录«我与鲁迅七十年»,最令人惊奇的地方在于他能记得许许多多零碎的小事情,以当时他七十岁的高龄来看,记忆力已经算很不错了,但另一方面,他的回忆基本是由这些琐事构成的,因此整篇传记的时间线有点散乱,主线不明晰,没什么重要的叙述点,经常在叙述一个人的时候联想到当下的事情,看得很累.
正当我想就此放下这本书不再看的时候,突然想到,这个传记不就是我们一般人的生平吗,除了顶着鲁迅儿子的光环之外,他的日常生活与我们并没有什么不同, 都是由一件件琐事构成的,并没什么值得写入历史大书特书的事情,只是在随着时代的潮流艰难的生存着,没有大起大落,但确实有悲欢离合,这才是我们的生活.想到这里,我把这本书又拿起来了.
2025-11-28
生命太短暂,不能花在那些不值得阅读的内容上面。 就算你是一个很爱读书的人,活到70岁最多大概能阅读15000本书,这只占世界最大图书馆美国国会图书馆3800万册藏书的0.04%。 我们一生中能够阅读的书籍其实很少。因此,关键技能不是多读,而是跳过那些不值得读的内容。 – Hacker News 读者
有些领域变化非常快,在有人写书之前,博客有时是唯一的信息来源。Stable diffusion 模型出现后的第二天,人们就已经在写博客了,书籍永远不会那么快。 而且,博客往往是免费的,而书籍和论文则被锁定在付费墙之后。因此,你可以这么认为,博客获取灵感,书籍获取知识 – Hacker News 读者
2025-12-09
每当有人给我的开源项目,提出这样或那样的要求,我就给他三个 F,让他自己选一个。 Fix it, Fork it, F**k off. 来源
每当我看到一个比较小众的实用开源项目,通常都是只有一个contributer或者一个branch,而issue却有好几个或者几十个,这些issue很少是提修改建议的,更多的是要求增加各种各样的自己想要的需求.
如果每个人都这样做,从不想到自己加入到这个项目中帮助创建者完善功能,那么开发者的热情将会急速冷却,开源社区也将不复存在,幸好现在还不是这样.
人生有没有意义?人类又有什么意义? 我说,人生是有意义的,而人类则是没有意义的。 询问人类的存在有没有意义,就等于询问地球或宇宙的存在有没有意义一样,是得不到答案的。 人生的意义是什么呢?它的意义就在于为没有意义的人类工作、服务等等,其目的不外乎是使人类生活得更好并得以延续。 反正人类是现实的存在,你又是其中一员,你有义务使它发展延续。你只要这样做了,你的人生就具有了意义,或者说价值,并不一定要去理会人类存在的意义。 来源
要我说这段话只是消极中的乐观而已,人类没有意义,人生也没有意义.
人类只是感觉的动物,我们当前的体验决定了我们的感受,也正是一次次体验塑造了我们.所以尽管人生没有意义,我还是想去多体验目前所没能看到和听到的一切.
因此我不愿意沿着别人的老路走,因为这终究是别人的体验,重走一次未免太乏味;但我也不愿意去走一条全新的,险峻的道路,因为我不想让自己遭罪.
2025-12-14
今天翻wiki时通过多次跳转转到了克伦斯基的界面,之前对他的印象只有布尔什维克对他主政政府时期的控诉,以为他只是一个常见的反对派角色.
 看完wiki之后才发现他与陈独秀,托洛茨基并无区别,同样是内心向往着一个更加美好,自由的社会,同样是怀有或多或少的高士情怀,但是每况愈下的社会形势迫使他们站出来,担任自己本不想担任的领袖角色,在时代的浪潮下起起落落,最终被推上风口浪尖,只是因为不愿意参与尔虞我诈的政治斗争,狠不下心去为自己谋求应有的利益,怀着革命为人民的期望,最后却成为被革命的对象,从先驱者变成背叛者,不为敌我双方所认同,无路可走,跌下本就不属于自己的神坛,摔得粉碎.
被尘封在历史的角落,所有的功绩都被后来者掠夺殆尽.
他们宛若一颗流星,照亮了整个世界,而后轰然坠落,再无人记得他们.
这也是我厌恶英雄光环和领袖情结的原因,很多人之所以能够从渺渺众生中脱颖而出,原因便是对自己狠得下心,愿意去做那些旁人坚持不下去或者难以接受的事情,可是如果一个人对自己都能如此狠心,那对待别人又怎么可能会不狠心,不使用一些肮脏的手段,又怎么能让不甘居于人下的自己摘取桂冠,不通过残酷的斗争,又怎么可能胜过同样是英雄俊杰的对手甚至是同志.
可惜我对自己也狠不下心,又何从说对别人狠心,只好默默地给英雄们让道了.
之后会出一系列文章分析俄国革命的全流程,之所以写在这,是提醒自己别忘了.
2025-12-18
我对 Quora 上瘾,情不自禁使用这个网站。那里有一些很棒的问题和讨论,激发了我的灵感和想法。
但是当我重新阅读自己写的答案,一方面欣赏我的修辞和洞察力,另一方面也看到了很多想法可以成长为更大的成果。它们本可能进一步发展为软件、文章、论文、创业公司、书籍或社会运动,但任何事都没有发生。
不仅如此,还有许多篇我写的长篇大论已经无关紧要,沦为了废文。还有很多我花了好几个小时写的评论,试图说服对于这些问题永远不可能改变观点的那些读者。
我花了数千(也许是数万)小时在 Quora 上写作。我写的远不止11000个答案,还有5000多个草稿答案,其中很多已经写得很长了,只是因为来不及最终润色而没有发表。
这篇文章说出了我想说的,我见过很多极其优秀的故事或者技术讲解,可作者发布的网站恰恰是贴吧,天涯或者知乎这样的问答网站或者论坛,作者的观点被一篇篇孤立的文章或者一条条回复分割开来,很难形成一个完整的体系.
而天涯的倒闭也说明了在这些自己不能掌控的平台上并不能保证自己的思想可以永久保留下来,那些优秀的文章随着服务器的关闭直接成为了无法触及的历史,即便是作者本人也无法找回.
因此,我拒绝在论坛里写长篇大论,而是作为读者去发掘优秀的文章,可惜的是现在优秀的文章也越来越少了,而AI生成的无意义内容充斥着论坛的每个角落,很难找到真正有意义的东西,这也是我悲哀的一点.
一方面,论坛不能让作者的文字体系化,另一方面,博客不能保证作者的文章能广泛传播,比如我这个博客就不是所有国人都能访问到的,很难找到一个折衷点.
如果我有那个能力,我可能会去开发一个跨平台的博客论坛吧,侧重点在于分享生活和技术,每个人都能像写博客一样把文章从自己本地上传,改进一下SEO算法,保证最好的文章优先显示,集成了评论系统和follow功能,最大幅度减少作者需要折腾的东西,只写md就行了,呈现的页面也由作者自己在前端设置.重点是这个网站能长久保存,不会让作者的心血白费.
2025-12-21
周刊210期 诺拉·劳森还说了一个观点。大家通常认为,复杂系统往往会在经济繁荣的时候崩溃,因为业务太多,支撑不过来,但他认为不是这样的,系统崩溃往往发生在经济收缩期。 经济繁荣时期,软件公司会大量雇佣新员工,投入更多的财力和人力,支撑复杂系统。等到经济收缩期,公司开始减少投入、冻结招聘或裁员,复杂系统可能就会在这个时候出问题,变得难以维护。 现在就是经济收缩期,那么接下来,会不会就是软件故障的高发期,我们将看到很多复杂系统的崩溃?
IT 行业与传统制造业有一个重要区别,就是 IT 行业有着严重的垄断。 全世界的智能手机有70亿部,比汽车多出5倍(14亿辆)。但是,智能手机制造商比汽车制造商少了好几个数量级。搜索引擎、社交网络、操作系统都是这样,几个巨头就垄断了整个市场。
3.来源 各个互联网公司都试图把自己的网站做成一个完全封闭的APP,你没法在搜索引擎上搜索到微信公众号的文章、小红书的内容、淘宝的商品描述……这就导致bing只能从非常有限的地方获得中文语料,最后就导致他的回答特别池沼……而且比别的AI都池沼十倍甚至九倍……
2025-12-24
来源 我是一个习惯于早做规划与反复思索的人。 而坚持写博客最大的好处就是,可以时不时翻看之前写的文章,宛若跨越时间的荆棘,与曾经的自己促膝长谈。
现在想来,十九岁时,我的迷惘归结下来,即是对将来自己的出路无所适从:出国留学,国内升学,抑或是早日进入职场。这几条路上,都有前人留下的无数足迹与丰碑,但也无可避免地悬着前人用泪水濯洗的种种失败警示牌。我曾尝试从中选出最优解,然而反复的纠结过后,我所意识到的,是这种比较的注定无结果:每当我觉得某个选择优于其他选择时,总会有某些信息刷新我的认知,让我匆忙撤回自己的决定。一如盲人同时摸象与鲸鱼,用片面的认知去比较复杂的事物,注定失败。
先是出国。关于这个选项,我曾仔细考虑,然而最终出于经济上的原因(赴美读硕开销实在过于昂贵)和人生规划的原因(我对学术无甚兴趣,不愿耗费多年去追求博士学位),出国成为了三者中第一个被排除的选项。而站在当下(2020 年)来看,全球疫情的扩散与民族主义情绪的对立,出国虽然依旧有着不可抗拒的诱惑力(比如优渥的学术环境与工作环境),但是更显得充满了极度未知的不确定性。
「选择比努力更重要。」这句话近年来已经广为人知,不少人以此自我调侃,感叹自己当初选择的失误(比如选错学校、选错专业),但当下一次选择到来时,却又不假思索地下意识地站到了主流的人群中,甚至拼尽全力挤出一条道路以加入主流人群。
诚然,作为一个才识普通的人,我或许不具备选择最合适的道路的能力,但我所希望的,是不盲从、不追随,依靠自身的观察与思考,尽量选出一条相对合适的道路。 人类的悲欢并不相通,但是相似。
关于读研与工作,面临同样困扰的也并非只有我一个人。
在做出决定的过程中,我阅读了不少人的博客与帖子,从中获得了一些宝贵的信息与经验,或多或少地影响了我最终的决定。
由于之前并未刻意保存浏览过的网页,在此,仅仅列出其中的一小部分:
- 所以,到底要不要读研? - laike9m’s blog
- 研究生复盘 | 高策
- iPotato | 在读研 & 工作中选择后者
- 已有名校 CS 本科学历,读研对于计算机行业的职业发展有多大的意义? - V2EX
这恰恰是我当下迷惘而又感到无路可走的心境,专业课程的枯燥与无用让我感到厌烦,愈加激烈的保研争夺战让我望而却步,而那些学术论文里面的水分都可以让海平面再升高一米了.
可日愈恶化的工作环境阻断了我得过且过的想法,作为雏鸟在第一家公司所学习的架构未必对我的技术提升有任何的助益,而我的学历劣势也将在很长一段时间内保持下去.
这种左右为难的状况让我一边痛苦一边踟蹰,只好到处翻阅博客,搜寻资源,希望能够对当前的我有些微的救赎.
这篇博客可惜的地方在于没有考虑到提前工作的坏处,但看了看他最近的文章,过得还算不错,可我现在还没有那个胆量去直接放弃保研,因为我讨厌唯一的选择,希望能多几条路可以走,而现在我仅仅是在本专业保研排名的边缘上(笑).这解释为是对我自己负责,但更可能只是我胆小罢了.
题外话:
博客是我最喜欢的信息传播方式,我永远都可以在某个博客里找到一些用一般手段怎么搜都搜不到的棘手问题的解决方案,永远都可以找到一个处境和你相似的人,永远都可以找到能够为你指引道路的人.
这半年来我搜集了差不多一百多个博客,我打算之后整理一下把里面的精华部分传到GitHub上,
2025-12-26
来源 说实话大三上就开始找实习其实是一个有些冒险,但相应收益会比较高的做法。风险点在于学校的课程安排趋近于收尾,一些比较难的专业课也会集中在这个学期,如何平衡好学习和工作是一个首先要考虑的因素,这一点上我的做法比较粗暴:直接翘课。一是因为成绩也够不着保研的尾巴,无需那么在意绩点,二是因为除了体育课这种比较难逃的课,其他一律统统全翘,只是为了挤出了一周 4 天的实习时长,至于课业,只能安排到工作日下班,周末以及考试临近时的请假进行学习。但即便是翘课,对于一些专业课程还是要用心,比如 OS 以及编译原理等课程,可以说是专业的重中之重,不光学习会接触,在面试以及工作中也是非常核心的内容。好在一个学期下来课虽然都翘了,但最后的结果也不坏,没有顾此失彼而整出来个挂科。
- 其实如果没打算读研的话就可以这么做,既然是本科毕业就工作,那绩点的意义就消失了.
这几天用rawweb不知道看了多少博客,足够大的体量保证了我搜任何一个关键词基本都能找到答案,每一个博客对我来说都是一个全新的领域,仿佛博主的生活就是我的生活,他们的迷惘和彷徨就是我的迷惘和彷徨.就比如我搜索关键词保研,一下就得到了一千多条结果,里面的很多文章对我来说都是对读研和工作这一抉择的重新认识.
26上
Ramírez(2026-02-01)

阅读fastapi和sqlmodel的教程就觉得作者是一个风趣,谦虚,对于疑问要穷追不舍,对于新手非常友好的hacker
潦草搜了搜,互联网上关于他的信息还是比较少的,也没有什么比较亮眼的镜头表现,他的英语口音我也比较难接受.只大概知道他没有读大学,从哥伦比亚到了德国工作.
看得出来,他将几乎所有的心血都投入到了开源项目中,所以才不会有时间去包装,宣传自己.
这是一位真正令人尊重的hacker.
迷茫时就多看看博客(02-04)
大学也已经过了一年半了,但我还是没能看清之后要怎么做,保研已经非常够呛了,除非之后一年半我能保持几乎满绩,但厌恶填鸭教育的我看来是很难做到了.所以,工作or保研?
来源 本科前两年半时,我拿定主意直接工作,却在最后时刻,抱着想看看有没有新的机会的想法,极限转弯踏入了研究生的大门。而研究生的前两年的体验让我认识到高校做工程不靠谱,回去看业界的机会时,发现实验室做的工作不能让我踏入一个所谓更“高阶”的工作,我能投向的业界工作和读本科时基本没有区别。后来,当我意识到,当前国内大环境下体制内的技术工作也并非一无是处,想把握北大应届毕业生这个机会了解一下体制内的机会,但却错过了这个时间窗口,最后仍然投向了微软,和三年前的唯一的区别也就是大组(C+AI vs STCA)和工作地点(苏州 vs 上海)的区别了。
来源 这次在各种因素的推动下终于做出改变,总共就简单面试了 3 家公司,最后拿到的机会是深圳的国企和武汉的互联网公司。之前加了一个武汉的交流群,了解到武汉更为恶劣的就业环境,如果回武汉工作几年被裁或者一定要跳槽换工作,那将是很困难的事情,也打消了最近几年有机会就考虑回武汉的念头。 最近几年经历了互联网的动荡,在互联网跟大家一起卷已经卷不动了,最终选择了深圳相对稳定的工作。参加工作后,自己对互联网的热情完全消磨殆尽了,我虽然不够上进,执行力也很弱,但是在学校比较闲就会捣鼓东西,写博客分享很开心。
当前的经济形势下,今年的情况明显比去年前年更加严峻,各家互联网公司都十分默契地通过裁员来降本。几个月前,上周还在一起吃饭朋友某天午休过后,被叫去谈话沟通裁员。几乎没有交接流程,当天就收拾东西滚蛋,十分残酷。
来源 整体来说今年就业环境在部分岗位还是有所回暖。最卷的赛道应该是后端,据我了解三月初各大厂开始面人,四月初就基本没有 hc 了,完全是地狱难度。前端和客户端今年有所扩招,有时候你投的是后端岗 HR 也会打电话来问你有没有面前端的意向。
来源 此文我是想写给应届生的,1-3 年的工作经验没那么恐怖,大多数情况下,你的能力够了,公司不会跟你较真,用年限压你,所以看到自己技术水平能够达到,资历却不符合的岗位,也可以尝试着投一投。 这类公司其实已经算是对技术有了要求了,而且技术细节都明确了出来,但是,看到只对 jsp,servlet 这些技术有所要求,明眼人都知道,这是在招初级开发,了解一点框架,懂计算机基础,这样的新手,公司还是可以接受的,上海这边针对可以独立开发的应届生,或者培训班出来可以直接上手的非科班生:软件公司,实习开价大概在 4-5k,转正开价大概在 7-8k;互联网公司实习大概在 5-6k,转正开价 9-10k 起步。985/211 或者能力不错能够入职的高校生,在互联网名企的开价,就以阿里为例,我了解到的情况大概是 12k14 or 1216。这里都是说一个上海地区价格,不适用与全国。北京的情况是 IT 非常发达,很多互联网公司都在北京,而上海,深圳,广州其次,注意,上海是金融之都,并非 IT 之都。 … 很多学生没有实习计划,或者出于对工作的恐惧,或者出于对自身能力的不自信,又或者是对实习工资的不屑…也有一大部分同学,觉得春招太早了,希望留着机会等到秋招。我这里有一份据阿里巴巴某部门的公开数据:2020 年转正入职的校招生中 80% 来自于春招,20% 来自于秋招。「好书一本,明日在读」,我不推荐大家错过现在这个最好的时机。
来源 这些幻想要批判起来说一年也说不完。不过相信大家也发现了一些共性,就是这种盲目推崇读研的人,往往对很多问题都缺乏基本了解,看问题也非常片面。我暗自揣测,他们中大部分可能并没有真正读过研究生,却又把自己目前的不如意归咎于没有读研,并幻想出了所谓读研之后的美好生活。我在计算所的时候,周围很多同学都觉得读研浪费时间,也包括我在内。有个哥们实在受不了实验室安排的无聊工作直接退学然后面试进了头条,人家也没嫌他学历不够。总之呢,读研这件事好不好,各人有各人的情况。对想进互联网行业的同学,可能确实是浪费时间,但若是想去考公务员或者拿户口,可能又很必要。关键还是要清楚自己的目标,分析自身情况,再来判断读研到底是不是一个好的选择。
来源 整个找实习过程确实挺不容易,毕竟直接和研二学生对线,但最后结果还算不错,去了自己最想去的,对于AI整个行业来说,个人认为在现阶段显然是能实际落地的工程大于算法本身,数据质量大于算法。
博客阅读(4/2)
很久没看博客了,今天来看一下:
链接 详细到可怕的CS硕士申请指南,尽管博客没有再更新过,但祝愿博主在美国能过得很好吧.
同一位博主身为过来人给初学者的建议. 博主认为年轻的时候就要选定一个专精的方向,进入工作岗位后再去随兴趣学习.
这个观念我不敢苟同,因为如果不是运气特别好,能够进入一家允许你去尝试不同技术栈的公司的话,你是很容易在一个技术栈上把牢底坐穿的,枯燥的CRUD也会逐渐的消磨你的学习兴趣,对于其他的技术栈也会逐渐生疏,想要换方向就会非常非常的困难.
然而,应届招聘的时候又确实要求你的技术深度过关,这就真没办法了,我们只能在短短的三年内(但一般人意识到紧迫性的时候就已经是大二,甚至大三了)去尽可能的探索多的技术栈,找到自己最感兴趣并且真的有市场需求的技术后,做到一定程度的精通.
大厂面试看的终归是你的成长潜力和基本功,而对于记忆力过关的年轻人来说,熟悉一个技术的基础特性和常用框架只需要一个月就够了,并且可以同时学习多个技术而不至于感到吃力,但还是建议越早开始学越好.
开曼群岛(4/23)
之前看到某些头部公司的注册地在开曼群岛,就试着搜了一下,结果发现这个地方确实不得了.
开曼群岛位于加勒比海地区,是英国的自治领地,以宽松的税收政策闻名,公司除了年度牌照费外不需申报和缴纳任何税项,所以无论是对个人、公司还是信托行业,开曼群岛都不征收任何直接税.吸引了无数公司在此注册以逃避本国的税收政策.
- 到1997年6月,世界50家大银行中有47家在岛上设有分支机构。到1999年6月,在岛上注册的公司有4.1万多家,银行和信托机构590家,保险公司475家。
- 内地的主要互联网公司都在此处注册
博客阅读(5/6)
- 博客链接 很久没有看博客了,这次再来翻一下,碰巧看到了一位绩点前10%,有大型比赛金奖的学长分享自己在大三放弃保研,前往字节工作的经历,下面是一些摘抄:
至于开发岗,除非研究生学历能带来显著的竞争优势(比如清北复交),否则读研的价值确实有限。在求职面试的过程中,很多面试官问我:“以你的成绩完全可以保研,为什么选择直接就业?”在交流过后他们的反馈也都几乎一致:读研对工程能力的提升确实有限,甚至毫无帮助。面试官最看重的不是你在课程考试中拿了多少 A,而是你是否有扎实的工程实践能力和解决问题的思维。当然,也有人选择“曲线救国”——寻找不怎么限制个人时间、允许长期实习并且不怎么 push 的导师,通过三年实习积累经验,毕业拿到大厂 offer 是理所当然的一件事。
- 我也打算之后问问面试官,哈哈
3 月 31 日投出我的第一份简历,之后陆续向江浙沪地区投递了共 40 个岗位。经过 7 次一轮技术面、3 次二轮技术面、2 次三轮技术面和 2 次 HR 面,历时两个多月,最终收获了字节跳动抖音电商部门的暑期实习 offer。整个求职过程中面试只挂过两次:一次是美团核心本地商业基础业务研发部门的岗位,因为 base 地在北京太远了,当晚就返回人才库了;另一次是腾讯 WXG 事业群微信搜索团队,面试强度特别大(一面 90 分钟,上来手撕三道 C++ 算法题,两道 medium 难度,一道 hard 难度,之后对操作系统、计算机网络、MySQL、Redis、分布式、并发、Linux 进行了高强度提问,感觉自己把 JavaGuide 全都给面试官讲了一遍。二面60分钟,上来手撕两道 C++ 算法题,一道 medium 难度,一道 hard 难度,之后对项目及其业务逻辑进行了深入追问),第二天一早二面挂,毕竟是全国互联网行业 T0 级别的部门,被刷也在情理之中。
- 技术已经强到40个岗位只挂了两个的程度…
如果能动手实现 WebServer 或者手写 TCP/UDP 协议栈,不比死记硬背报文格式更有价值吗?你说实践,是指计算机网络实验吗?上过的同学都知道这门课在干什么。
- 已经开始笑了
我认为只有在小组中承担大部分工作甚至是全部工作的人才能真正获得能力上的提升。大学三年里,我几乎担任了所有课程项目的组长,在技术选型、系统架构、编程能力等方面得到了十足的进步。真心希望大家在团队合作中不要遇到那些无比自信却贡献为负的“神人”(哪怕你贡献为零但能提供情绪价值我也不会说什么了)
- 小组作业赶紧毁灭吧
在数据结构课程设计中我实现了 C++ STL 的常见数据结构;在程序设计范式课程中我用 Cocos2d-x(一个老旧的游戏开发引擎)开发了一个类似金铲铲之战的游戏,这个项目让我首次接触网络编程并与开源社区产生交集;在用户交互技术课程中我学习了 Dart 语言和 Flutter 框架;在操作系统课程设计中我用 Rust 语言编写了一个简单的 OS 内核,实现了基础的进程管理、内存管理、文件系统和一个可交互的简单 Shell;在数据库课程设计中我学习了 C# 语言、Web 开发基础、ASP.NET 框架和 Vue.js 框架,并熟悉了 Linux 开发环境及配套工具链;在区块链导论课程中我学习了 Go 语言和 Gin 框架;在软件工程课程设计中我学习了 Java 语言和 Spring Boot 框架;在移动应用开发课程中我学习了 Swift 语言和 SwiftUI 框架
- 尽管学长开智比我早,但这依旧是让我望尘莫及的学习速度…
说到数据库课程设计,不得不提袁时金。作为同济大学最厉害的老师,没有之一,她所有的成就都是靠自己的努力得来。她是我见过最自信的老师,我真的非常羡慕她从不内耗的性格。我什么时候也能做到从不内耗?字节跳动的面试一贯是压力面,感谢袁时金在数据库课程设计项目答辩上的尖锐质疑和莫名其妙毫无逻辑的指责,让我即使是面对全国互联网行业最压力的面试,也能三轮技术面全部顺利通过。我真的很感谢袁时金打碎了我对大学老师的滤镜,让我知道原来大学老师的水平也就如此,称之为老师属实侮辱共和国的教师团队。
- 太有活了
看得出来学长在前三年的课程历练中把自己的基础打的极其扎实,把面试需要用到的知识点基本都掌握了,从这个角度来看,学校的课程安排是合理的,只是执行上出了一点"小"问题而已.
- 另一个博客链接
- 这篇文章非常优秀,可以这么形容,你这辈子只能看到几篇这样的文章.
2010 年,我跳槽到了一家总部位于北京五道口的大型互联网公司。
加入这家公司前,我只在十人规模的小公司待过,因此,我对新公司在各方面都有着很高的期待,尤其是软件质量方面。当时,我心里想的大概是这样:“这可是支撑了有着千万用户量的产品的‘大’项目,代码质量跟之前那些比,肯定有质的飞跃吧!”
等到在新公司工作了一周后,我才发现自己实在是错得离谱。所谓“大”项目的代码质量同我的预期相去甚远。打开 IDE,数百行的函数和神秘的数字字面量比比皆是,开发任何一个小需求都难如登天。
后来,在待过更多公司,接触了更多软件项目后,我总结出一个道理:不论公司多大、项目多牛,在实际工作中遇见好代码,仍然是小概率事件。
我曾参与开发过一个互联网产品,它设计精美,功能丰富,每天都有大量用户使用。
但就是这么一个从市场角度看颇为成功的产品,工程质量却非常糟糕。如果你打开它的后端项目,把所有目录翻个底朝天,都找不到任何一行单元测试代码,其他自动化测试流程也是无从谈起。而业务逻辑偏偏又十分复杂,最后,项目代码间的意料耦合多如牛毛,开发一个新特性,很容易把旧功能给搞挂。
因此,项目每次发布时,开发和产品同学全都得严阵以待,氛围十分紧张。整个发布过程也很刺激,紧急回滚时有发生。一个人在这样的环境中工作,技术成长抛开不谈,心理素质肯定能得到极大锻炼。
在 LeetCode 刷题很像在玩游戏,富有挑战性,同时也很有趣。整个做题过程,实际完美展现了一种理想化的编程体验:
关注点分离:每道题目都是一个独立个体,同一时间内,开发者可以完全沉浸在一道题目中;
快速获得精准反馈:开发者每次调整代码后,能通过自动化测试快速获得结果反馈;
零成本试错:写出的代码语法有错误、逻辑有问题,没有任何不良后果,心理负担小。
这也是我想的,如果你能够有一个良好的架构观,能够清晰的划分出不同代码文件对应的职责,能够写出优美完整的测试代码,那么就可以很容易的去一个个实现它,而无需在多个文件之间反复跳跃.
我建议你在学习任何一项新事物时,先在脑海中想清楚一个问题:“我应该在上图中的哪个位置停下来?”,而不是闷头猛学。
- 这也正是我所想的,很多知识点到为止就行了,太过琐碎的真没必要强迫自己去理解
从这次失败中,我总结出了一点经验。那就是学习某项新东西时,我们最好挑选那些更易读,更适合“门外汉”的学习资料,不要“眼睛大,嘴巴小”,只知道奔着最经典、最权威的资料而去。
《写给大家看的设计书》:设计相关
《点石成金》:Web 用户体验相关
《鸟哥的Linux私房菜》:Linux 系统相关
并不需要最权威,最经典,但也不能太过简单粗暴,我认为最好选择那种经典的入门读物而非厚重的参考书为佳.
如果到目前为止,你从未试过写单元测试,或从没重视过测试,我建议你从明天就开始写起来。
- 我认为测试代码永远是程序的主要组成部分,当然小项目就没必要用测试代码了…
编程永远是进行时,总会有新的需求不断涌现,也总有AI bug等我们去修复…
- 待我去拜读一下作者编写的« Python工匠 »一书
X再阅(6/11)
大概在我高二的时候,我第一次知道了X,忘了是通过什么途径获取他的博客合集的,不过当时的匆匆一览给我的心灵带来了极大的震撼.由于学业的关系,再加上里面的技术文章我也看不懂,就这样搁置了很多年.
如今,我在整理书库的时候又看到了这本合集,于是就大致的纵览了一遍.
X大学读的是化学工程专业,但由于他非常喜欢计算机,所以辍学之后投身IT行业,在08年的时候,他已经是妥妥的技术大佬,没有必要再以身涉险了.
X在09年的时候发布了第一条博客,内容如下:
| |
但几个月之后,由于众所周知的问题,X坐不住了,除了技术以外,他还试图去谈点别的东西,语调上越来越激烈,内容上也越来越黑暗,再后来,技术博客的占比已经微不足道了,最终也是以悲剧收场.
整体来看的话,他的技术教程比较零散,讲的也不是很深(不过这才是博客的原本样子,像我这种近乎强迫症的博客反而非常少见),反而是关于历史的分析比较有趣,尽管有不够真实和过分夸张的地方,但确实可以冲击到那些不了解历史的人,不说幡然醒悟,起码能够有所思考.
也正是因为X的下场比较凄惨,我也不打算走他的老路,还是希望以生活和技术为主,最多谈点更实际的历史问题,至于那些黑暗的部分,在我看来,不过如同浅色衣服上的霉菌一般,虽然确实很瞩目,但如果你对自己有信心,对未来有信心,大大方方地穿出门就行了.
博客整理(6/17)
刚好空下来一段时间,就想着整理一下以前收藏的博客,意外发现了几篇不错的文章:
和我同时代写技术博客的,现在几乎都已经停更了,即便现在还在更新的我也是很久一篇,而且渐渐的不怎么写技术性内容了。原来在我订阅列表里的绝大部分觉得写的很好、内容很有价值的国内外技术博客都停更甚至不再可以访问,其实挺可惜的。
那么为什么大家不再写或者不愿意写了?
文中介绍几个主要的原因:
- 有更重要的事情.当我真正走入职场后,我想能够用来写博客的时间就很少了吧,毕竟在工位上敲了一天的代码后,再回来敲代码的话是真的有点苦逼了
- 没有能力持续产出. 如文中所说,你学的越多,越发现自己的知识面过于狭窄,计算机领域的整个历史不过才一百年,但他的体量早就已经超过积累了几百上千年的其他理工科了.
职场一开始有非常多技术和非技术的技能要学习和理解,但是融入之后自己不求上进的话很容易温水煮青蛙。其实我们每个人只是公司产品线上的一颗螺丝钉罢了,在业务里我们并没有那么重要,对很多人来说只是负责其中一小部分,这部分可能你是专家,但是其他的部分基本上都只能算熟悉,写不了什么高质量文章:这也是很多人不写书或者写不了书的原因。就拿我说,知乎上我可能花半个小时就能写一篇上百赞的回答,但是写技术文章,别说日更,我都不敢说持续的每周能写 1-2 篇。
- 收不到正反馈.
写技术博客是其中最孤独、最不容易获得反馈的方式。其他的如微信公众号、知乎专栏和 Github 等等,无论那种都比自建博客开发和资源成本低,现在大部分人都喜欢快餐式的获得知识收获关注,不愿意从折腾中获得乐趣,看后就走,就好像点个赞、加个收藏就已经学会了。我能理解一个新人花了很长时间写完一篇自我感觉不错的文章充满期待的发出去,结果只有个位数的阅读量,无人点赞无人评论,这样很容易放弃掉。
不知道翻了多少篇博客,我突然有了一点新的感悟:
- 博客终归是个人的花园,访客可以随时驻足,但能不能留得住客人就要看主人的园艺技术了
- 无论博主本人的技术造诣有多深,用语言完整表达出来是不太可能的,所以优质的技术文章特别少,即便是生活感悟类这类不需要什么技术的文章,值得一读的也不算多.
- 博客最大的用处就是解决问题了,AI永远不能包办一切,但你的某个无法下手的问题可能正是前人所经历过的,在如此广大的博客中总能找到一两篇能够帮你解决燃眉之急的文章.
- 理论上来讲,只要你写的文章够多,总有一两篇文章能够帮助别人解决问题,吸引别人停留片刻.
或许也是因为这样,我把大多数收藏的博客链接都删除了,只留下几篇我最喜欢的博客,至于其他那些从未见过的博客,有缘自然就能见到.
26下
求职调研(8/3)
很久没看博客了,现在再来翻一下求职主题的博客.
1
这类公司其实已经算是对技术有了要求了,而且技术细节都明确了出来,但是,看到只对 jsp,servlet 这些技术有所要求,明眼人都知道,这是在招初级开发,了解一点框架,懂计算机基础,这样的新手,公司还是可以接受的,上海这边针对可以独立开发的应届生,或者培训班出来可以直接上手的非科班生:软件公司,实习开价大概在 4-5k,转正开价大概在 7-8k;互联网公司实习大概在 5-6k,转正开价 9-10k 起步。985/211 或者能力不错能够入职的高校生,在互联网名企的开价,就以阿里为例,我了解到的情况大概是 12k14 or 1216。这里都是说一个上海地区价格,不适用与全国。北京的情况是 IT 非常发达,很多互联网公司都在北京,而上海,深圳,广州其次,注意,上海是金融之都,并非 IT 之都。
我这里有一份据阿里巴巴某部门的公开数据:2020 年转正入职的校招生中 80% 来自于春招,20% 来自于秋招。「好书一本,明日在读」,我不推荐大家错过现在这个最好的时机。
- 这也是我讨厌阿里的原因之一呢…
Java 更偏向于业务研发和中间件研发,C/C++ 更偏向于数据库研发,Go 更偏向于云原生研发,Python 更偏向于机器学习; 北上杭有阿里;深圳有腾讯;广州有微信;北京有一大波互联网…
如何准备实习简历?我交流下来发现很多学生是很优秀的,但缺少表达技巧,准备的简历却过于简单。前面我介绍了公司筛选候选学生的流程,学生需要做的是:
突出项目经历:参加学校/公司 xx 项目,采用了 xx 技术,解决了 xx 难题 突出学习经历:xx 专业课成绩 xx,专业排名 top xx;获得 xx 奖学金 突出竞赛经历:参与了 xx 举办的 xx 竞赛,竞赛主要考验了学生 xx 的能力,取得了 xx/xx 的名次,收获了 xx 的技能;xx 网站解题量 xx。 突出开源经历:参与 xx 开源项目,该项目是 xx。我参与贡献了 xx 模块的代码,附带 issue/pr 突出优秀论文:攻克了 xx 领域的难题,并且在 xx 发表,突出影响力 突出博客积累:文章主要体现了我在 xx 领域的思考,以及学习、编码经验的积累,附上博客链接,uv 或阅读量
- 很惭愧,我只敢说最后一点我做到了一部分,而剩下的确实都不值一提
2
- 写入耗时容忍度
- 问:这种(短链接服务)场景里面写入(创建短链)耗时长可否容忍?
- 答:一定程度上是 OK 的因为创建短链的请求比访问短链的请求少很多,容忍度更高;
- KV / Redis 选型
- 问:在这个大量 KV 数据读写的场景,为什么不考虑直接使用 KV 存储或者 Redis 来支撑?
- 答:考虑过,但是短链服务本质上更需要背后收集到的访问数据来体现业务价值,而访问数据的聚合分析需要数仓,公司内没有很好的 KV 存储到数仓的支持,不想当小白鼠;
- HBase 选型
- 问:为何不考虑数据仓库提供 HBase 来支持读写,节约掉 MySQL / KV 存储同步到数仓的过程?
- 答:嗯,好像是个可考虑的想法,但是不太了解 HBase;
- LevelDB 存储结构
- 问:能说一下 LevelDB 的存储结构吗?
- 内心:完了写上简历了但又没复习,啥都不记得了;
- 跳表算法
- 算法:定义 Redis 跳跃表的结构,再实现一版它的插入方法。
- 内心:orz。
- Golang map 底层数据结构
- 问题:Golang 标准库中 map 的底层数据结构是什么样子的?
- Map 时间复杂度
- 问题:Map 的查询时间复杂度如何分析?
- 最坏时间复杂度规避
- 问题:极端情况下有很多哈希冲突,Golang 标准库如何去避免最坏的查询时间复杂度?
- Rehash 策略与时机
- 问题:Golang map Rehash 的策略是怎样的?什么时机会发生 Rehash?
- Rehash 的影响
- 问题:Rehash 具体会影响什么?哈希结果会受到什么影响?
- Rehash 数据迁移
- 问题:Rehash 过程中存放在旧桶的元素如何迁移?
- 并发安全性
- 问题:并发环境共享同一个 map 是安全的吗?
- 后果:panic
- 并发替代方案
- 问题:如果并发环境想要用这种哈希容器有什么方案?
- 方案:sync.Mutex / sync.RWMutex、sync.Map
- 加锁方案局限
- 问题:加锁存在什么问题呢?
- sync.Map 结构与优势
- 问题:sync.Map 比加锁的方案好在哪里,它的底层数据结构是怎样的?
- 回答:缓存 + map 组成的结构。底层 map 的操作依然是加锁的,但是读的时候使用上缓存可以增加并发性能。
- sync.Map Load 流程
- 问题:sync.Map 的 Load() 方法流程?
- sync.Map Store 流程与一致性
- 问题:sync.Map Store() 如何保持缓存层和底层 Map 数据是相同的? 是不是每次执行修改都需要去加锁?或许是通过加锁和 CAS 保证的?
- 面试官:它下面还有一些 tricky 的思路,面试结束可以再去看看。
- 已关闭 Channel 的操作
- 问题:channel 被 close 操作之后进行读和写会有什么问题?
- 未初始化 Channel 的操作
- 问题:未被初始化的 channel 进行读写会有什么问题?
- Channel 底层数据结构
- 问题:channel 底层数据结构是怎样的,尝试用结构体来表述一下?
这一堆问题搞得我一愣一愣的,不过由于Golang我还没深入学,所以不太清楚上面这些问题的难度,待日后再看.
3
其实本来投递pdd也是抱着随便面一面的目的为后面积攒一点经验,没想到pdd的面试居然是最迟的一批。考虑到之前在学校论坛看到过许多pdd的腌臜事,所以就算pdd给我发offer我也不会去。或许只有一种人比较适合去pdd,那就是命的条数比较多的人。
3.24参加了笔试,本来以为是考编程能力的算法题,点进去之后才发现这笔试除了代码能力什么都考。先后遇到了如下题目:英语完形填空和阅读理解,行测的各种杂七杂八的题目(含数字找规律、图形推理、基本的逻辑判断、中文语法),性格测试,还有反应力和记忆力测试。
字节的面试是所有公司的面试里最令我汗流浃背的不仅有挖祖坟式的拷打基础知识,而且会抓住论文里的细节上的设计追问,并且每一面都有手撕代码题,每次面完字节我都精疲力尽。相比之下很多其他厂的面试其实都是随便聊聊洒洒水啦。
4
实习期间,我在字节内网学习了 golang。不得不说,字节企业内部的文档非常全面,而且对实习生开放。我甚至能看各个部门写给面试官的打分指引、能看面试题库。内网的技术论坛也有一些好文章。与之相反,华为实习生甚至没权限看 W3 中的任正非讲话全文,十分荒唐。 总体来说,字节跳动是很优秀的互联网企业,杭州八方城的工作体验也良好。如果要去互联网,杭州字节可能是最好的选择之一。
5
- 首先最重要的是,早投,一定要早投,投晚了根本约不到面试,今年真不是金9银10了,不少人说金7银8铜9铁10,虽然略显夸张,但是早投是真理。准备的差不多的情况下,建议大家大厂一开就投!具体时间的话,差不多在7月底8月初的时候,各大厂都会开了。
- 实习越来越重要了,如果没实习,哪怕是双9也只能确保你面试机会会多一点,面试没啥聊的,那只能被疯狂拷打八股或场景题,很难顶的,像快手这样注重实习经历的公司,双9没实习还筛不过单9有实习的。实习越早越好,越多越好,越接触核心业务越好。
- 学历厂也越来越不好使了,典型的就是今年的华为,比亚迪,在往年是出了名的学历厂,用来保底的。但是身边有不少朋友双9被华为挂了,比亚迪更是面试都不给。未来或许也只会有过之而无不及,所以大家提前做好准备吧。
- 一定要有相关的信息交流群,不然别人都开始面了某家公司,你都不知道这家公司开了,帮助大家抱团取暖。
- 秋招如果base地没要求的话,选北京你会多很多面试机会。
- 秋招很看运气的,有的时候都答出来了结果反手被挂,有的时候答得自己都没脸看,结果却是秒过。所以没拿到很满意的offer的朋友也不用内耗和焦虑,自己尽力没有遗憾就好。其实你会发现大部分人到最后都拿不到让自己很满意的offer,知足才能常乐。
虽然第二点有点说的太离谱了,但一两段实习确实是需要的
看了马shi兵的关于职业的讲解,和某抖程序员yang哥对未来程序员的看法,我个人感觉秋招的难度是算法>后端»前端>客户端 ≈ 测开,一般的学历配置如下:算法至少要2个9,后端至少要1个9或者中强2,前端至少要1个2,客户端和测开至少要双非一本及以上,并不是说没9就搞不了后端或者算法,只是过来人的经验告诉你这样的选择相对来说自己上岸的机会会大一点。因为你会发现很多9爷其实也会去卷大厂的客户端和测开。
6
这几个月,我沟通了800+公司,80%直接未读或者已读未回,剩下的公司,大概三分之一会要你简历,其余的直接说不合适,这三分之一里要你简历的,最终能约到的面试大概又是3分之一左右,这一层层漏斗筛下来,差不多有十家多一点给了面试机会。这个体感你们可以自己掂量下,有一个非常残酷的事实是,所有给我面试机会的公司,几乎全部和AI有关,如果你简历里一点都没提到AI,上述的漏斗的口子还会更大。
7
遗憾的是,offer至今还在路上——可能迷路了,也可能压根没出发。现在的招聘市场就像一场‘饥饿游戏’:50份简历投出去,5个回复算赢,2个面试算大奖,1个offer……那是奇迹
8
对口经验很重要。虽然校招看经验听起来是很离谱的事情,但是没有办法,每一个岗位投递的人数都太多了,我了解到的某个还算偏小众的岗位,暑期实习有100+投递,筛选了好学校+2篇论文以上后面了30+左右,最后暑期实习收了5个。秋招投递超过500+,基本没有面(因为坑都被暑期实习生占满了)。在这种竞争下,一方面企业只能通过一些硬性条件去筛选一波再面试,如学历是否为双九、是否有论文等等。另一方面我们也要思考一下我们的核心竞争力在哪里,如何让自己的简历在海量的候选者中脱颖而出。
算法题不太重要。本人大大小小实习+秋招面了五六十场,感觉上没有任何一场面试是因为算法题没有做出来而挂掉的。面试的表现(包括简历和岗位的匹配程度)与算法题的难度是基本正相关的。如果面试表现的好,即使算法题没做出来也可以换一个更简单的做;面试表现不好,算法题就算秒杀了也会出一个更难的或面试后也会挂掉。大家都是做技术的,都知道Leetcode那些东西平常也用不上,算法题基本就是走个过场。准备算法题的时候Leetcode HOT 100完全够用了,90%以上的算法题都是从这里来的。
网上有一种说法“暑期实习转正都是白菜价”。这个说法我认为是有偏的。因为暑期实习一般就是按照秋招的HC来招的,站在部门的角度想,如果这个人在我们这里干的很好我为什么要把他放走换另一个不熟悉的再赌一把呢?大多数的人实习的时候应该是没有达到面试时候的预期的,所以可能部门感觉秋招重新招一个损失也不大,因此就开了白菜价劝退了。
9
wxg 的面试是我所接触过的强度最大、最专业的面试。平均每场时长 2h。面试官对项目问的非常细致,扩展出来的开放性问题也很有意义,并且当时面试我的时候没有问任何 iOS 开发方面的八股!wxg 明确地更加看重候选人的综合素质和潜力,这跟其他公司的套路是完全不一样的。每一场面试都是一次愉快的交流,多数面试官也很尊重候选人。但同时竞争也非常大,每一轮面试都有排序,只为筛选出最优秀的候选人
10
招聘的岗位有成百上千,每段时间放出来的 hc 也都是变动的。“刚好”你最近找工作,“刚好”有个岗位适合你,“刚好”你和几个面试官都看对眼了,“刚好”你和 hr 能谈到满意的薪资,“刚好”你也喜欢这个岗位… 😆 在几波“刚好”的筛选下来之后,能成功的情况也不多了 hhhhh
AI调研
| 公司 | 普通档月薪 | SP档月薪 | SSP及高档月薪 | 薪资月数 | 比较合理的首年总包 |
|---|---|---|---|---|---|
| 字节跳动 | 26k | 28–30k | 32–40k | 15薪 | 39–70万 |
| 腾讯 | 27k | 29–32k | 33–38k | 15薪 | 修正后约43.5–70万 |
| 阿里淘天 | 25–26k | 29–30k | 32–35k | 16薪 | 含房补、签字费约43.4–66.4万 |
| 京东零售 | 22.4k | 26–28k | 30–32k | 20薪 | 44.8–64万 |
| 快手 | 25.5k | 27–30k | 32–35k | 16薪 | 含房补约43.2–58.4万,签字费另计 |
| 美团 | 23k | 25k | 30k | 15.5薪 | 35.7–54.5万以上 |
| 百度 | 22–24k | 25–28k | 30–32k | 16薪 | 按签字费分两年修正后约35.2–55.7万 |
| 滴滴 | 21–23k | 25–27k | 30–33k | 15薪 | 31.5–54.5万左右 |
| 拼多多 | 约28k起 | 30–35k | 39–40k | 18薪 | 50.4–72万 |
| 小红书 | 暂无稳定分档 | 约33–35k | 38–39k及以上 | 16薪 | 52.8–62.4万,部分另有股权或签字费 |
| 哔哩哔哩 | 27–29k | 样本不足 | 样本不足 | 15薪 | 加补贴约42.3–45.3万 |
- SP(Special Offer):特批待遇 / 极优录取。代表薪酬高于标准级别(Offer),通常对应能力突出、面试表现优秀、具备较强竞争力的候选人。薪资增幅一般在标准 Offer 的 15%~30% 左右。
- SSP(Super Special Offer):超级特批待遇 / 顶级录取。代表该岗位或该批次招聘中的最高薪酬梯队,针对极少数顶级人才(如核心论文作者、顶级竞赛获奖者或关键技术突破者)。通常包含额外的股票/期权(RSU)、高额签字费(Sign-on Bonus),且薪资标准由高管或薪酬委员会独立特批。
分布式文章与求职再读(8/5)
强一致性:别再用BASE做借口,来看看什么是真正的事务一致性
最早、最正式的对隔离级别的定义,是 ANSI SQL-92(简称 SQL-92),它定义的隔离级别和异常现象如下所示:
| 隔离级别 (Isolation Level) | 脏读 (Dirty Read) | 不可重复读 (Non-Repeatable Read) | 幻读 (Phantom Read) |
|---|---|---|---|
| 未提交读 (Read Uncommitted) | 可能 | 可能 | 可能 |
| 已提交读 (Read Committed) | 不可能 | 可能 | 可能 |
| 可重复读 (Repeatable Read) | 不可能 | 不可能 | 可能 |
| 可串行化 (Serializable) | 不可能 | 不可能 | 不可能 |
还有一个问题也许你一直想问,为什么不支持最高级别的可串行化呢?
答案可能会让你有点沮丧,那就是在很长一段时间内,学术界都没有找到足够高效的并发控制技术。可能你熟悉的很多数据库声称提供了“可串行化”级别,但这往往只是一种形象工程,因为它们都采用的是两阶段封锁协议,导致性能无法满足生产环境的要求。不过,有些消息让人振奋,虽然不是普适的方案,但少数产品的尝试已经取得进展。
隔离性是事务的核心。降低隔离级别,其实就是在正确性上做妥协,将一些异常现象交给应用系统的开发人员去解决,从而获得更好的性能。所以,除“可串行化”以外的隔离级别,都有无法处理的异常现象。
求职文章
西安华为校招根据面试评分给应届生进行评级,本科生和硕士生的评级在 13 级 和 15 级 之间,每一级又分为 A、B、C 三个档。根据评级进行工资的评定,13 级 和 14 级 的税前工资在每月 13-19k 之间,每年 14 薪。15 级 需要特别优秀的硕士才能拿到,工资年包基本在税前 30 万 - 40 万之间。华为在西安的校招薪资水平还是很高的,几乎和北京持平了。
春招实习,有时也称为暑期实习,一般在 2-5 月,有金三银四之说。每年的情况会因为过年时间和公司情况而有所不同,基本上在正月十五之后开始。比如在 18 年的时候开始比较早,我记得牛客网大概在大年初十就已经有春招内推的帖子,今年 2020 年大概在正月十五之后牛客网就有春招内推帖子。
不得不说,没调查之前,我真不知道大厂的薪资现在有这么高,不过也确实很合理,毕竟要求有那么高,这反而更增添了我的不少信心.
O’Reilly/Manning系列书籍(8/10)
不搜不知道,一搜吓一跳,O’Reilly出版的技术书籍可谓是浩如烟海,如果能够把其中的精华全都读一读,立马就能成为一个很有见识的优秀程序员了.另一方面,这也让人不由得感叹O’Reilly对互联网生态的贡献之大.
综合算上自 20 世纪 80 年代至今出版的所有纸质书、电子书、更新版次(Editions)以及动物系列(Animal Books)和 Nutshell 系列,O’Reilly 自身累计出版的图书品种数量在 5,000 至 7,000 册 之间
不过这也给了我不少的动力,争取在下半年把我AI翻译出来的将近一百本O’Reilly的经典书籍全部搞定.这样一来面试的时候说不定我能比面试官还更懂某门技术
数据库架构问题(8/18)
DBMS的诞生是程序员的福音,但也是各类生产事故的来源,从早期的关系数据库,迈步到MongoDB等文档数据库,再到焕发新生的NoSQL数据库,数据库的架构一直在演进,但我们却始终找不到一个可靠的方案去一次性解决所有的问题,我们只有一个万无一失的口诀: It depends.
不过,我们还是要思考一下,为什么数据库架构会这么难处理:
- 对于初创公司来说,光是配置一个云服务器就够了,毕竟几千几万的用户量也不太需要有什么额外的考量.至于选什么数据库倒是无所谓,看你主要存储的数据类型就行了.

- 当用户增长到百万级之后,一个服务器就不够用了,这时候你可能说,那我们可以把数据拆分后放到多个数据库中,这时候就有个非常关键的问题了,如果还用的是关系型数据库,一般来说用SQL的话只能对单个数据库起作用,一个容易想到的方法是在后端中通过条件判断来分流,将1-100万的用户id分配到第一个数据库里,依次类推,当然,更好的方法是将不同类型的数据分到各个数据库中,这样操作起来也更有针对性
- 显然,这种硬编码维护起来非常麻烦,用起来也有问题,当我想要一次性获取所有用户的信息用于数据统计时,这又该怎么办?只能单独写一个函数去逐个遍历所有数据库了吧.
- 但是这又有一个问题,数据库分流后不可避免地会拖慢查询速度,毕竟大多数流量都来自于读请求而非写请求,这样一来,我们必须在数据库前面套一层Redis缓存,存储先前传来的完全相同的请求结果.
- 如此一来又引入了缓存一致性问题,当你更新数据库的时候如果没能更新缓存的话,用户获取的就仍然是旧的数据,这在很多时候都会有灾难性的影响,特别是转账等常见的交易环节.
这一过程可以不断递推下去,每次的扩展都会引入新的问题,可以说永远不会完结,这不像房地产行业,交付了新房后直接走人即可,将维护问题丢给物业,而是需要持续不断地调整架构,软件工程永远都是进行时
看看大佬(9/3)
这个暑假属实是有点颓废了,只好看看大佬们的成果来鞭策一下自己
- Ruanyf
阮一峰(Ruanyf)是中国技术圈与技术写作领域最具影响力的作者之一。他拥有上海财经大学经济学博士背景,后跨界进入前端与软件工程领域,以“将复杂技术用极其浅显易懂的语言讲透”而著称。
其他不说什么,就凭他从03年写博客写到现在就已经很不容易了,坚持二十年写博客的人并不多,但都是各个行业中数一数二的大佬(仔细一看sinya要算的话也写了二十年…)
我最喜欢的就是他每周五发布的周刊了,曾经十天内一口气看了两百章,不过现在就只看看最新章了,毕竟还是打基础要紧.
- 左耳朵耗子
尽管他的文章我看的不多,但人气绝对是全中国里扛把子的,每篇文章下都能找到不少的评论,他的技术水平也是绝对在线的.不过天妒英才,还想看的抓紧吧,今天我发现网站已经不太稳定了.
- 李博杰
李博杰(Li Bojie)是中国年轻一代计算科学与分布式系统领域的尖端学者与创业者。在大学期间是极其顶尖的程序设计竞赛选手,曾代表中科大斩获 ACM-ICPC 国际大学生程序设计竞赛世界总决赛金牌(第 2 名),创造了中科大在该项赛事上的历史最好成绩。他以极其亮眼的学术履历、系统底层的突破性成果以及从顶级科研向硬核创业的跨越而在技术圈闻名。
只要点进他的博客主页,边上的那些相关链接没有一个是无名之辈,各个都是有头有脸的人物,反过来也能知道这个博客的主人也相当不简单.
- 李理
在中文技术圈(尤其是人工智能、深度学习与自然语言处理领域),名为“李理”的代表人物主要指知名 AI 技术博主、前联想集团 AI 资深研究员、《深度学习与MindSpore实践》等技术书作者李理。
博客以“源码级剖析”与“数学原理硬核推导”著称,详细撰写过 BERT、Transformer、GPT 系列、Word2vec、CRF(随机条件场)以及 TensorFlow / PyTorch 源码解析等系列文章,影响了大量转行 AI 与 NLP 领域的工程师。
可惜真正看他博客的人好像不多?可能是不喜欢推销吧.
- yeasy
yeasy 是国内开源社区与技术出版领域极具知名度的清华博士杨保华(Baohua Yang)的网名,他是国内云原生(Docker / Kubernetes)、区块链(Hyperledger Fabric)以及云计算/SDN 网络领域的早期推动者与权威作者之一。
只要点进他的GitHub主页,就能知道他的成果有多少了,每本书写的都挺不错,值得一读.
- 苏剑林
这更是一位不得了的人物,第一次进他博客的人一定都会吓一跳,这么全才的人还是很少见的,可惜我一看公式就头痛,看不了多久时间.
不管怎么说,有这些大佬在前面,我还能怎么办,一个劲的努力吧.
极客时间(9/15)
最近找到一个关于极客时间栏目的电子书仓库,总共有200本书,我本以为是一个根本翻阅不完的知识宝库,后来发现每本书的基调完全相同: 将一个知识点拆分成几十个小知识点,每个知识点用简短的一两千字阐述.
额,尽管作者都是技术圈子里的大牛,但是很遗憾,不少书都没有一读的价值,远不如专业的技术书籍来得全面深入,不过,优秀的书也有很多,尤其是那种涉及实战和高级工程师的栏目,到现在也不过时.
捕蛇者说(9/18)
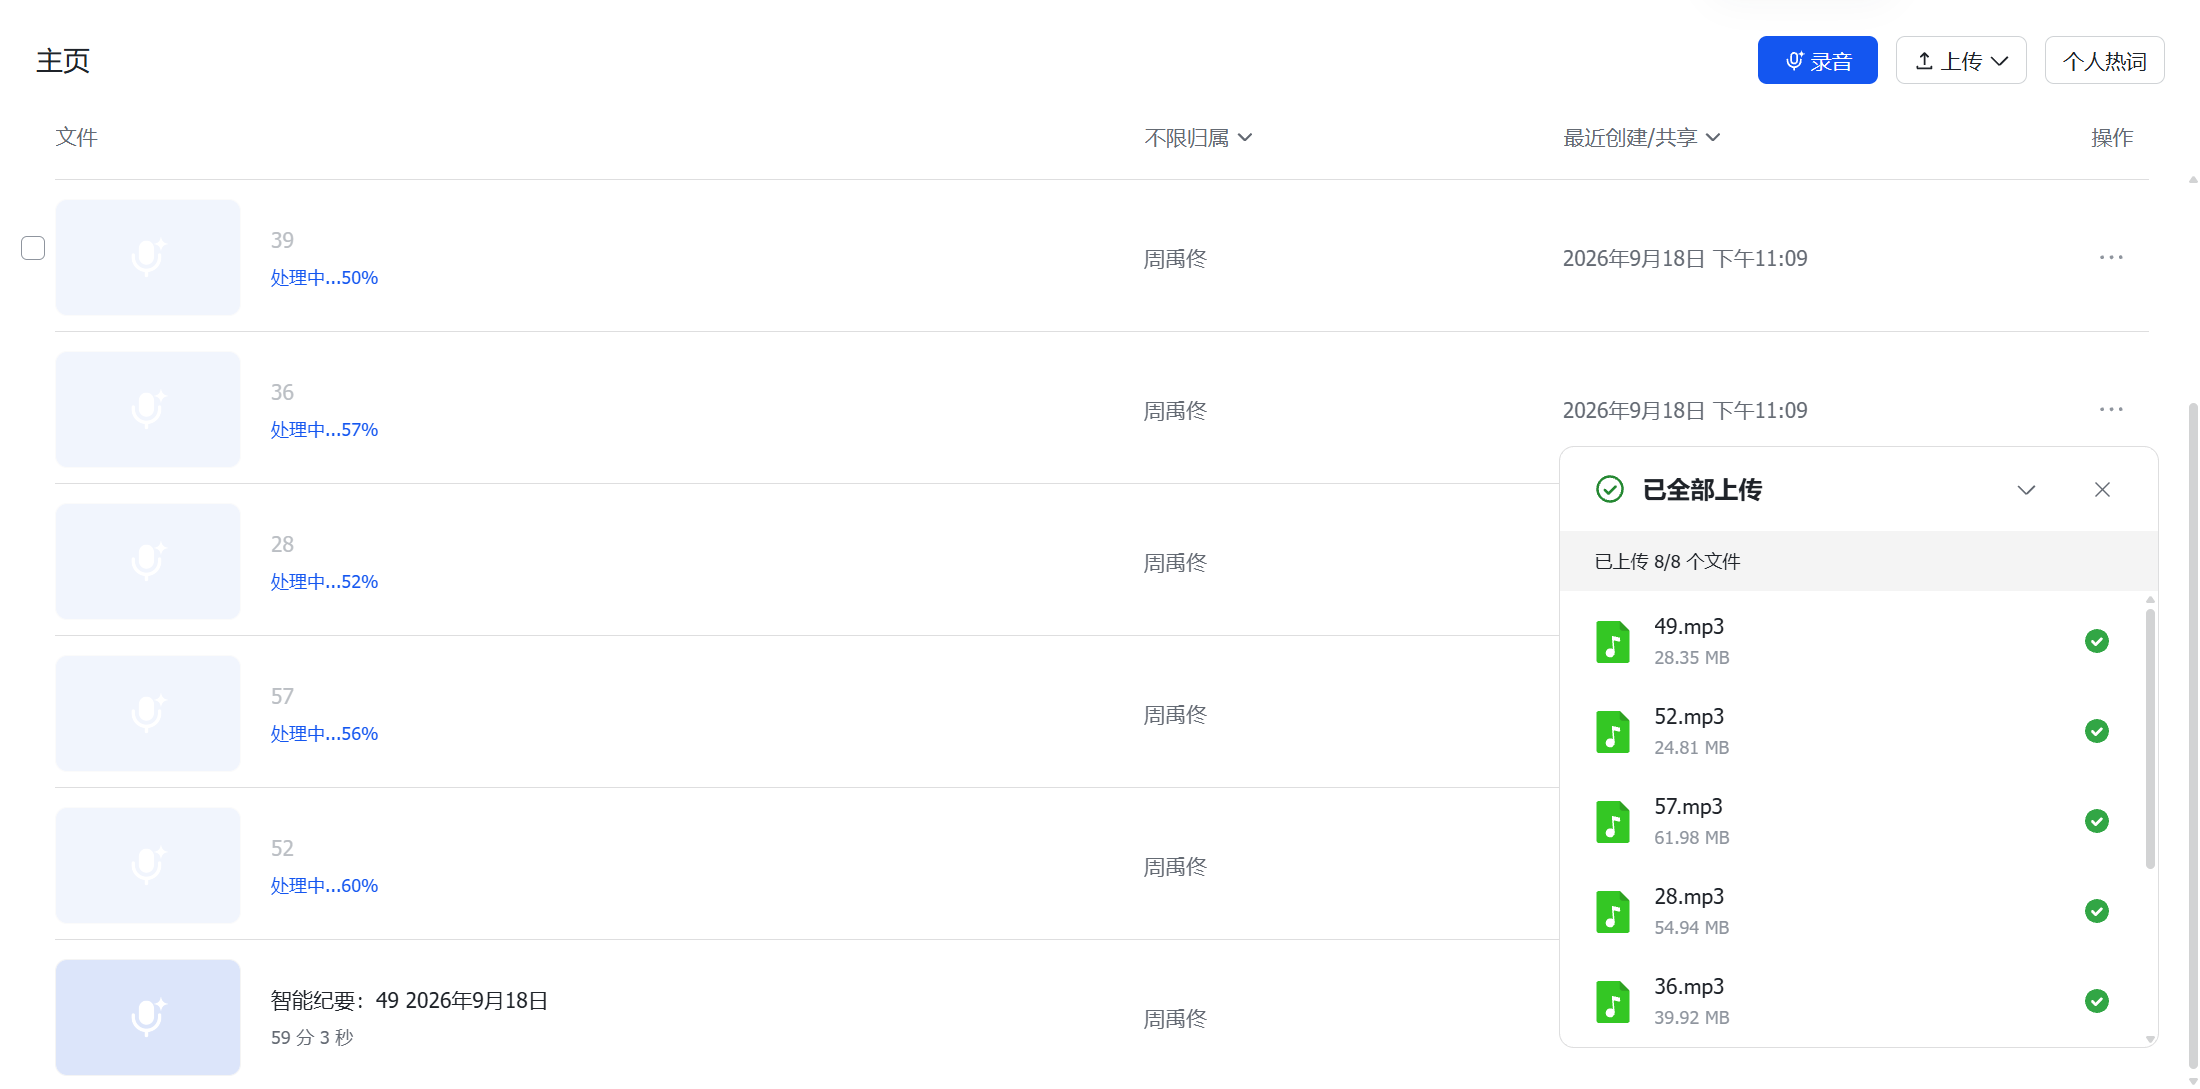
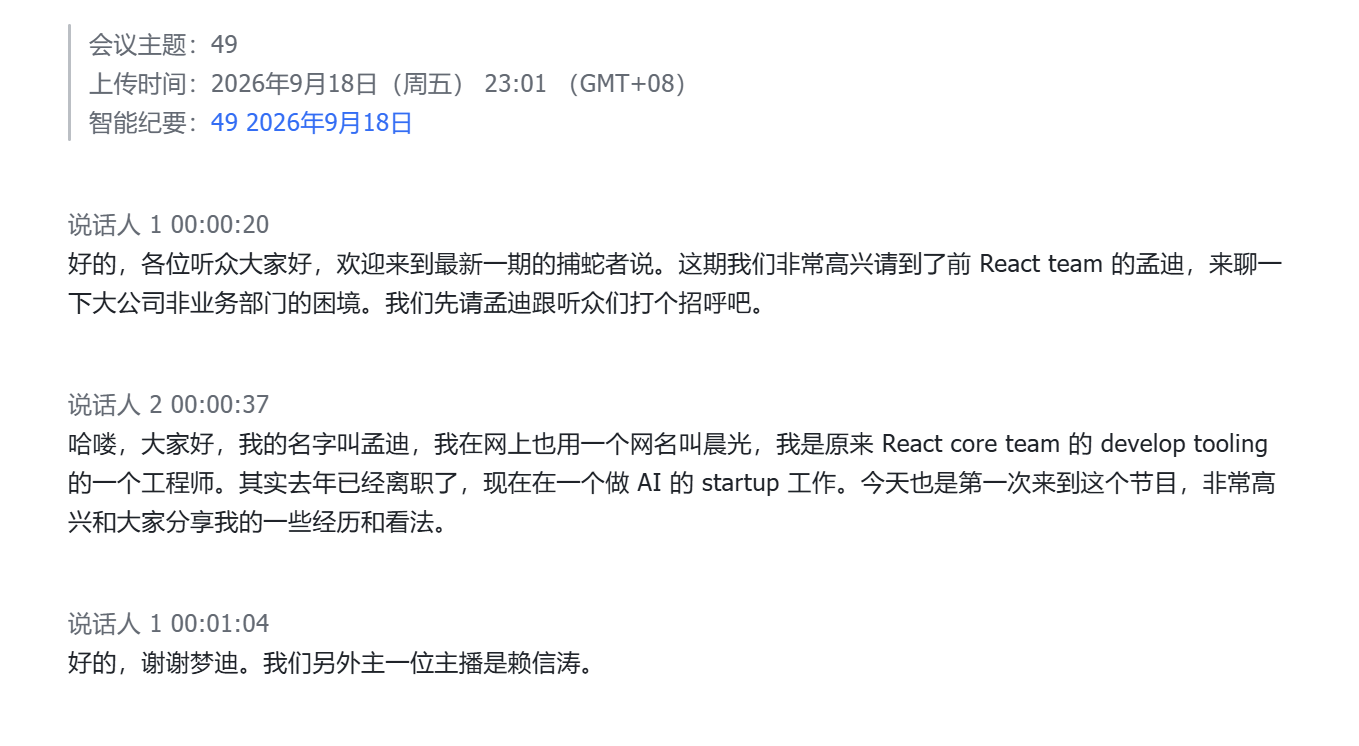
最近在看捕蛇者说,奈何一个播客动辄一个小时多,要是快进的话又怕漏掉内容,更何况我也没那么多时间,调研了几个在线网站,都是要花钱的,好在找到了飞书上的这个神器,不仅能直接转写,还能生成总结,可惜的是试用次数有限,再用就要充值了.
面试经验一览1(9/19)
看完之后发现基本所有博客在上岸之后都不更新了,看来上班是真的很要命.
另一个感受就是自己的准备还远远不够,先不提算法,光是项目上就不够拷打的
面试经验一览2(9/20)
- 经验之谈
- 比较散,但也值得一看
- 研究生秋招
正式开始之前还是先介绍下个人情况,211 CS 科班本硕,研究生期间做过一段时间计算机视觉,后跑路转向系统方向。在系统方向属于无论文、无竞赛、无开源的三无产品,纯靠 CMU 15-445 等国外课程学习和秋招。总结来说就是跟不上 AI 潮流并跑路的纯混子选手。主攻语言 C/C++,略懂 Python,其他 Java、Go 等基本属于看得懂,但是没大量写过代码。因此秋招期间投递的岗位主要是数据库内核,外加一些后端大类岗位。秋招投递了 20 个公司左右,BAT、TMD 等互联网大厂全军覆没,收到的 offer 主要是一些非一线企业和创业公司的数据库内核开发 offer,以及部分公司的后端 offer
- 华为AI实习岗
- 比较简单
- 前端秋招
- 简单的经验总结
- 可怕的巨佬
- 一看就碾压我了好不好
- 腾讯面试合集
- 不少问题我都没自信呢,看来是八股不太熟
- 23届实习
- 25届秋招
- 以Cpp/Go选手为例, 很多人的项目都是下面四大名著之一: MIT 6.5840(原6.824); MIT 6.S081; CMU 15445; Tinykv
- 字节后端
- 都是些比较基础的问题,感觉对面试者就没什么要求,换句话说,就是没什么期望…
- 讨饭历程
- 很散
面试经验一览3(9/21)
- 这博客页面也太帅了吧
面试经验一览4(9/22)
面试经验一览5(9/23)
除了上面几个之外,本来是想每个博客就看看面经就结束的,奈何其中很多都是非常有水平的高手,有很多值得我学习的地方,只好先收藏下来,就不在这里草率一读了.
面试经验一览6-重要(9/29)
- WXG拷打
- 已知 rand16() 是 0-65535 范围的随机数生成器,要求写一个函数能随机从编号 0-30w-1 的员工中均匀抽出 1w 人
- 根本想不到好不好
- 已知 rand16() 是 0-65535 范围的随机数生成器,要求写一个函数能随机从编号 0-30w-1 的员工中均匀抽出 1w 人
- 字节三面拷打
- 相当优秀的数据工程秋招心得
- 26秋招合集
- 看简历就知道是大佬了,但就是这样,在Tencent面前也被拷打到了可怕的程度.
- 19年的反思
对于一个毕业两年多的人,我最希望他有什么特质? 这个阶段的人其实还是“空杯”,我希望他有很强的学习能力和进取心,给自己部门培养出一个超级生产力。
什么样的行为会让我“讨厌一份简历”? 把每个项目都大写特写,尤其是陈述细节没有重点;罗列框架当能力,用过了一类场景的框架就觉得能解决一类业务,诸如此类。
面试的时候我会偏向于问哪些问题? 一是简历上写了“理解”或“精通”的语言与中间件;二是简历上写得比较有趣、又没有完全交代清楚的项目。
这三个问题是相当深刻的,对于我个人来说简直是如逢甘霖,光会框架没有任何作用,换个平台你又要重新熟悉API,但如果你真的能够精研底层技术,自然能够比较自然地迁移框架,并找到不同项目之间的共同点.
左耳朵耗子纪录片,真比片难找不少吧.
面试经验总览-重要(10/3)
本以为很少人会做那种全面的面经或者八股总结,结果发现不仅有,还有不少做的很好,列举如下:
- Agent岗面经总结
- 另有姊妹文章写题解的
- 24年面试经验总结
- 对大厂的分析值得一看
- RAG知识库项目笔记
- 20年的C++岗总结
- 个人八股合集
- 经验技巧合集
- 个人秋招合集
- 个人合集
- 游戏客户端面经
- Agent求职总结
- 个人秋招合集
其实道理也很简单,愿意折腾时间在这个世代写博客的,本就是少数,写了博客还能持续维护个四五年的,更是少数中的少数,那么这些人中自然有愿意去总结和思考的,他们做的比我预想中的还要好的多,帮我节约了一个个去看面经的时间,从而能够专注在面试本身上.
AI Agent 小白教程(10/7)
1
确实是语出惊人,但和我第一次见到RAG的想法一样,如果AI的上下文长度足够大,那么不需要RAG也可以塞下足够的信息,从而做到精确度更加高的检索.
2
大模型技术的研发最早可以追溯到 2015 年,各项基础技术与理论验证储备的完善是在 2020 年,第一个爆款的商业大模型 ChatGPT 则出现在 2022 年,基础模型的预训练能力在 2025 年被验证基本收敛(这一点目前学界与业界仍然有争议。但是基于目前已有的算力登记和公开高质量数据而言,事实上的通用文本大模型能力在 2025 年年中的时候被验证基本收敛),而能力基本收敛,你可以简单理解成在基础训练范式不变的情况下,未来出现的大模型和现在最厉害的大模型相比,再也不会出现质的上的能力飞跃了。
这里不得不插一句题外话了,相信大家经常会把PDF这种特殊的格式扔进大模型里面,让它帮你总结内容或者是做一些概括。相信大家在读论文的时候,这一个操作应该是经常做的。很多人可能会下意识的认为大模型处理PDF的做法就是将PDF里面的文本读取出来,然后把它作为正常的文本信息进行后续的计算和处理。但实际上对于某些特殊的大模型。比如说 gemini 来说,它会先将PDF转换成对应的图片,然后将每一页的图片作为上下文再去处理得到最终你要的结果。而为什么要这么做呢?这是因为如果你将这一页的PDF当成文本来处理,它所消耗的token是大于把PDF看成图片所消耗的token的。而如果你学习完了本章节的内容,对于图片在编码之后占据的token量有了一个大概的了解,你就应该能够理解为什么这句话是对的了。
| 窗口大小 | 对应纸媒形态 |
|---|---|
| 1K | 一张便签纸 |
| 10K | 一本轻薄杂志 |
| 100K | 一本《现代汉语词典》(标准版) |
| 512K | 全本《水浒传》或《西游记》 |
| 1M | 一本《现代汉语词典》(厚重工具书) |
3
论述相当通俗完整,干货很多
4
对Agent Loop的分析相当不错,而这个subagent原来还要明确说才开启,我还以为是内置派生子智能体的:
| |
5
Agent 一路以来的设计哲学一直都是在不断消灭重复劳动,而很多朋友在拿 Agent 干活的时候其实不经意间也存在一定的重复劳动。比如当我们让 Agent 帮我们写一个关于植树节的网站,要求可以登录注册,并且设计稿中的 7 个路由都能正常访问并将访客数据落盘。于是我们编织了一段还算不赖的 PRD 扔给了 Agent,并开启了规划模式,于是就开始喝起了咖啡。
过了一段时间,你发现你的 Agent 告诉你,你的网站已经做完了,于是你打开 localhost:8080 查看效果,你发现页面确实都写完了,但是注册登录怎么有 bug 呀?然后指定的几个路由也只是实现了一个大概,如果说你设想中的满分是 100 分的话,那么除了主页面外的这几个页面只能打 50 分。
一个解决方案是用Skill去规划Agent在每次完成工作后去检查完成情况,如果有问题就继续执行任务.
但现在的Agent已经很智能了,只要设定了目标(Codex几个月前就引入了Goal命令),就会在ReAct外再套一层循环,检查工作是否正常完成.
6
对SKILL.md和AGENTS.md的解析非常不错
7: Agent Harness
接入工具的时候有一个问题,如果接入太多的tool,会导致system prompt变得过长,挤压context的窗口大小:
| |
PTC(Programmatic Tool Calling)是解决这个问题的一个好方法,大意就是由Agent在需要时自己编写工具函数并运行代码即可
在 agent loop 中,Agent 实现完成的一条轨迹对应的编码成的token,最终总是会撑破上下文的,为了避免这个问题,我们还需要实现一个上下文压缩的工具 compact,但是需要注意的是,这个工具不应该被 Agent 主动调用,因为我们必须 100% 保证,当上下文即将撑满时,必须采用 compact 进行压缩。因此,在绝大部分 harness 中,compact 会被设计为一次系统事件。每次大模型调用结束后,harness 系统都会检查一次当前上下文的占用情况,当上下文达到 80% 时(举个例子,也可以是75%,但是 80% 用得比较多),自动压缩上下文并替换下一次开始时发送给LLM的轨迹。
在很多的 agent 产品中,compact 也会成为和 create-skill 一样的系统内置 skill 方便用户直接手动触发上下文压缩。比如在 codex 中,输入 /compact 就会主动触发上下文压缩。
Agent的边界(10/21)
看了这篇文章,对agent的认识又有所改观,文中认为由于LLM在RL阶段对编写代码能力的度量只在于能否通过单元测试,而不在乎具体的软件架构,因此AI目前是不可能写出架构优美符合要求的大规模软件的.
不过说架构训练的问题在于成本,就不太对了,应该说,软件所在的领域决定了它的架构,而我们只需要针对对应的领域训练Agent即可,目前来说在数学/生物/物理等领域,Agent的表现就已经很惊艳了,不过对编写代码这个领域,Agent的表现欠缺,因为它不能很好的把握全文,就算划定了界限,它也会因为看不清全局,不断加上补丁,不断跑偏.
这本质上是由于软件工程本身具有动态性和复杂性,需求总是在变,即便是Agent也不能完美实现Boss每日的奇思妙想.而对于基础科学领域,比如数学定理,你证明出来了就是证明出来了,不存在说让你去改引理或者改问题吧.
所以,一个是研究领域,一个是应用领域,Agent真正的未来在于前者(因为它能够无休止的思考和迭代),而后者由于其本身的复杂性,无法根除所有问题,但作为辅助工具,是绝对有成效的,能够减轻工程领域的繁重劳动.
看看新闻(10/22)
停下来,看一看,想一想,或许有新的出路吧.
- AI岗位
- 虽然AI岗位需求旺盛,但多份人才报告印证赛道扩张的同时,传统技术岗出现收缩。大厂并非整体扩招,而是上演结构性“换血”:压缩后端、NLP等传统技术岗位,将招聘预算重点投向AI业务。即使同为AI领域岗位,部分求职机会也在向顶尖院校少数人才倾斜。字节跳动TopSeed、腾讯青云计划以及各类大厂奖学金,成为锁定顶尖人才的定向通道。
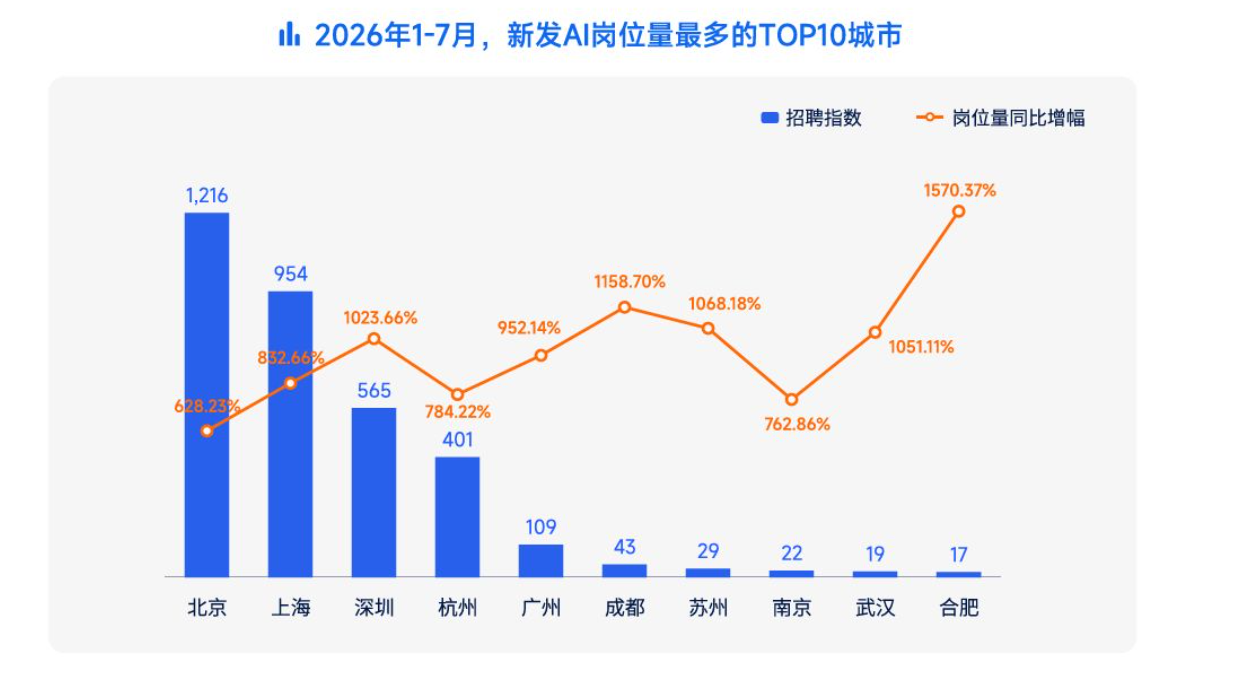
- 此外,脉脉高聘人才智库《Agent重置职场——AI人才流动报告》还显示,2026年1月-7月,AI应用开发岗位在整体AI招聘中的占比达到60.97%,AI技术底座岗位占比24.55%,AI业务效能岗位占比14.48%。AI招聘的重心正在从训练和研发扩展到应用建设、现场交付和业务提效。
- AI浪潮
- 我们和五位2026届、2027届毕业生聊了聊:有人投了四五十份简历,只拿到一次大厂面试机会;有人手握头部大厂实习,却因为不够垂直而被算法岗拒之门外;有人早早转向AI应用层,勉强接住了这波浪潮;也有人去年尝试投AI岗位,简历全挂,最后靠一段非AI的暑期实习转正留在了大厂
- 过去,我们要联系几十名小体量KOC拍产品图,再反复修改。后来只要把产品放进AI工具,就能自动生成展示图。旁边负责优衣库的团队更直接:KOC提供正面、背面和侧面等九张照片,AI就能生成像真人拍摄的试衣镜自拍。主管在会上问:“以后是不是只买账号的发布权就够了,连真人拍摄都不需要?”
- AI改革
- 8月5日,阿里巴巴集团及淘天集团、阿里云、阿里国际、Token Foundry(2026年6月8日成立的AI事业部)、千问办公、千问事业部、平头哥、高德等16个业务集团和公司同时开启2027届应届生招聘。记者了解到,阿里本届招聘涵盖算法、研发、芯片、产品等八大职类,AI相关岗位占比达到了80%。
- 本周,字节跳动同样在“公司不同业务场景都有AI相关岗位需求”的背景下早早启动了2027年校园招聘,本次的招聘中,技术和产品岗位需求占比超过70%,字节表示,产品类岗位需求增加20%,其中超一半为AI产品,同时,算法类岗位需求也较去年再增加,首次上新AI全栈工程师、AI agent开发等岗位。
- 抢人大战
- “大厂都在使用各种方式争夺应届生,这导致校招生的薪资水平和社招的差距大幅缩减,一些顶尖院校的应届生薪资已经接近社招的水平。”
- 虽然各家互联网大厂都在争夺AI人才,但不可否认的是,这些岗位对求职者的学历和技术能力要求较高,市场上能够符合要求的应届生求职者数量本身就不多。
- 对于大多数应届生来说,他们通过校招进入大厂的难度并没有变得更低,而且这种竞争激烈的态势已经持续几年时间。脉脉高聘人才智库在2023年春招期间进行的一项调研显示,从当年1-4月成功签约的应届生中,超过85%感觉求职有难度,其中近32%觉得“非常难”。从求职时间来看,43.91%已签约应届生从求职到接到offer用了3个月以上。
- 校招规模普涨,AI岗占比最高超九成
- 从各家放出的校招计划看,“总量扩张、AI集中”特征鲜明。阿里2027届秋招计划发放7000余个offer,覆盖15个业务集团,AI相关岗位占比超六成,其中阿里云、阿里国际、钉钉占比高达80%,高德占比75%;淘天预计发出约1000个岗位,技术类占比超九成,AI相关岗位占比近五成。
- 字节跳动计划在中国地区招聘超5000人,研发类岗位同比增长23%,算法、前端、客户端增幅最大,非研发类岗位增幅超100%,产品岗offer较去年翻一倍。腾讯校招覆盖70余种岗位,技术类扩招36%、产品类扩招39%,AI相关岗位需求提升30%,并在简历中新增“AI应用技能模块”。百度校招提供超4000个职位,较去年增长35%,AI相关职位占比超九成,新增90个职位聚焦多模态、跨模态等前沿方向。
- 此外,美团补招6000人,新增AI产品经理、AI Agent开发工程师等岗位;蚂蚁集团技术岗占比85%,超70%与AI直接相关,聚焦大模型算法、多模态生成及具身智能等领域。
- 与校招扩张形成强烈反差的是,有数据统计,2026年上半年全球科技行业出现约400起裁员事件,影响员工超15.3万人,平均每天约900名科技从业者失业。
- 国内大厂同样动作密集。阿里员工总数从2024年底的约19.4万人降至2025年底的12.8万人,一年减少6.6万人,减员比例达34%;百度核心移动生态事业群部分团队裁员比例达30%至40%,个别非核心业务线高达90%,但AI及云计算相关职位基本被保留。由此可见,“一边裁人一边招人”正在成为行业常态。
- 一开始被吓了一条,但阿里2025年5月的官方财报明确说明,人数下降主要由于高鑫零售出售并不再纳入集团合并报表,同时被新增招聘部分抵消。而到2026年3月,员工总数反而比上年增加了7,142人.
- 所以这种三流新闻的报道只信一半就行了,不添油加醋是吸引不了读者的
- 值得关注的是,顶尖人才争夺已趋白热化。从腾讯“青云计划”到阿里“阿里星”,从科大讯飞“飞星计划”到B站“B—UP”,各大厂纷纷推出顶尖技术人才专项招聘计划,今年4月更有AI科学家被曝以亿级年薪加入字节跳动。
- AI的破坏
- 目前,AI收缩效应主要集中在月薪5000—8000元,有1至3年工作经验的入门中端劳动者。过去,企业依靠入门新人完成文档、录入、标准化沟通等基础训练任务,如今这些环节被大模型承接,不再设置低薪练手岗。
- 虽然大众期待生成式AI能催生全新职业赛道,但报告数据给出反向结论:2023年至2026年间,新增职业名称体量极小,仅大模型算法、机器人工程师等少数岗位小幅扩张。
- 春招报告
- 字节招聘
- 在AI人才争夺战中,字节跳动持续领跑。《报告》显示,从岗位需求看,2026年1—7月,字节跳动位居新发AI岗位量榜首,小红书、蚂蚁集团、腾讯分列第二至四位。深度求索(DeepSeek)同期新发AI岗位量同比增长601.40%,云计算、智能硬件与新锐AI企业也在持续扩大招聘。
- 实习转正问题
- 柯卡的期待也落空了。全部门转正成功的实习生只有一个,是那个当时和他一起被叫来加班的实习生。柯卡挺失落的,试着后知后觉地寻找一些端倪,“是不是因为自己的带教不够嫡系?”
- 没绷住哈
- 柯卡的期待也落空了。全部门转正成功的实习生只有一个,是那个当时和他一起被叫来加班的实习生。柯卡挺失落的,试着后知后觉地寻找一些端倪,“是不是因为自己的带教不够嫡系?”
- 前端转正失败
- 自驱力,用产出说话: 不能当个闷头干活的“工具人”,要主动去想、去做,去推动事情发生,能够提升团队。
- 我服了哈,就一个实习,难不成还要我自己来提效不成,怎么不让正式员工提效
- 自驱力,用产出说话: 不能当个闷头干活的“工具人”,要主动去想、去做,去推动事情发生,能够提升团队。
| 企业 | 2026年公布的实习招聘计划 | 主要变化 |
|---|---|---|
| 腾讯 | 10000名以上 | 技术类扩招36%,产品类扩招39%,重点关注AI |
| 字节跳动 | 7000个以上实习录用名额 | 公司称是史上最大规模转正实习招聘 |
| 京东 | 10000个实习岗位 | 软件开发、物流、供应链、产品、数据算法等 |
| 美团 | 超过3000个转正实习岗位 | AI产品、软件开发、大模型、具身智能等 |
虽然新闻总有渲染或者夸张的地方,但看完了只有一种无力感,局势比起以往还要严峻,那些在Agent浪潮之前进去的初级工程师该怎么办呢,我们这两年的应届生又该怎么办呢.
不过道理很明显,现在是热点,那么过几年就不是热点了,所谓树大招风,当供过于求的时候,竞争就会额外残酷.所以,当所有人都回过神来的时候,才是真正的地狱难度,由此来看,目前甚至还不是低谷.但未来究竟如何,我不知道,怎么会真有能料事如神的人呢.
11/3
由此重启每日阅读,如果当天有什么特别值得读的文章或者有一个大致的主题,则会重新起标题,否则就直接写发布日期了
面经
看着吓人,其实就是围绕着两个项目来拷打的,而且都比较专业,问的到点子上.
技术文章
AI Agent的代码生成速度是在太可怕了,每天需要做的Merge数是成千上万的:
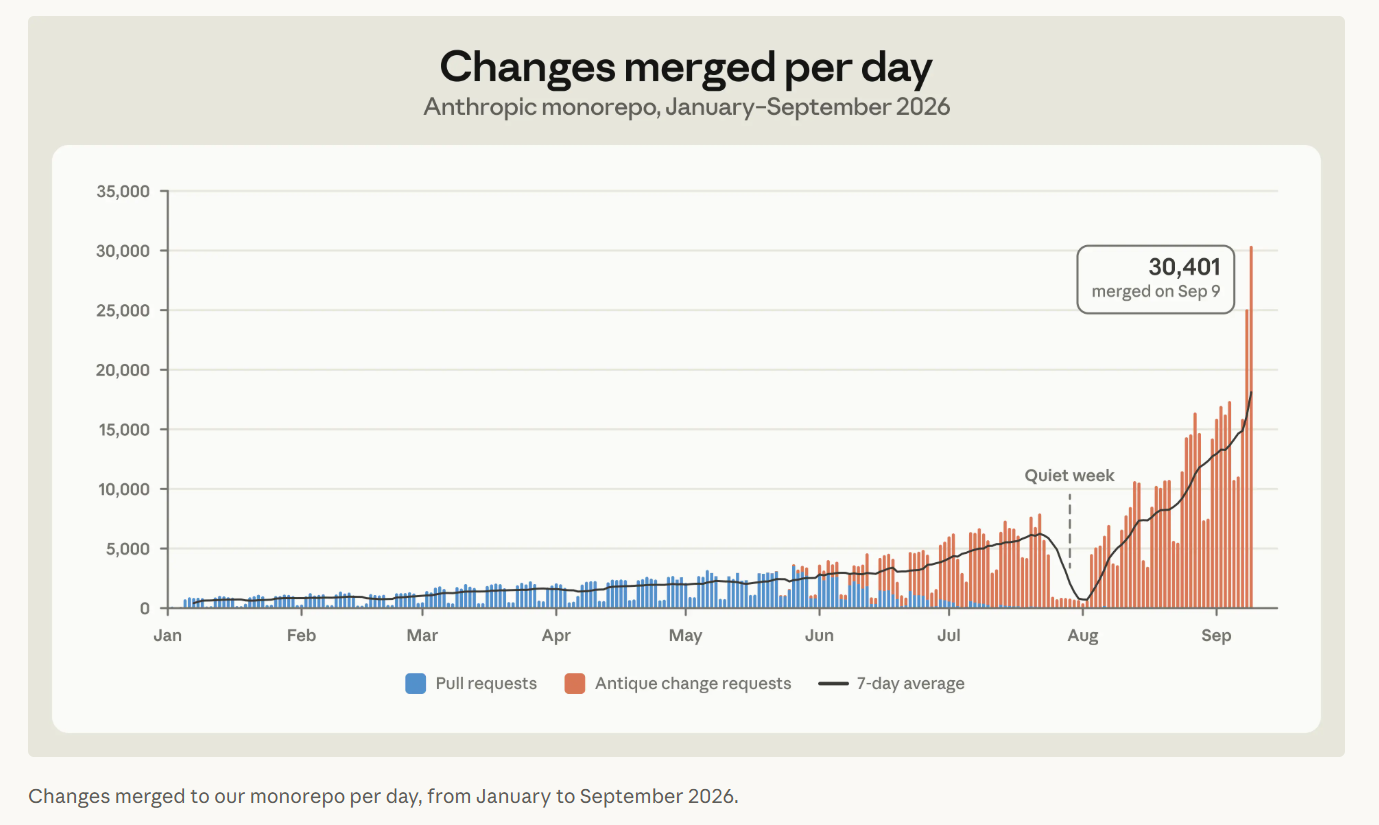
Git适合离线本地操作,但Agent适合在线快速工作,而且,大多数情况下,Agent只需要读取代码库中的一个小文件夹甚至是一个文件(就算想全部读下来,有那么大上下文嘛).
A公司尽可能地让Git完成这些复杂的工作(如shallow clones, sparse checkouts, and promisor remotes),但Merge的频率太高,Git的负载也跟不上了.
因此,A公司研发了Scion这个在线的中心化仓库,从而能够支持大量Agent的高速Merge.
新技术
Monorepo(Monolithic Repository,单体代码仓库)是一种代码管理方式:将多个项目、服务或软件包的代码统一存放在同一个 Git 仓库中。常见Python包和中型项目的开发都是这种架构
与之相对的是Multi-repo,即每个项目使用单独的Git仓库,如Spotify就使用了数千个Git仓库.
11/5
面经
盲点:
- 语言
- 装饰器的实现方式
- 如何打包和发布Python
- 数据库
- MySQL 数据库隔离级别,分别解决哪些问题
- 中间件/容器/API
- RabbitMQ有几种模式
- 什么是云原生,有哪些内容
- Nginx 反向代理,正向代理,如何实现高并发
技术文章
其实我觉得,不存在长时间运行任务的必要吧,如果你将任务目标切的够精准,每次只做必要的修改,给出明确的边界,就可以极大缩短完成单个目标的时间,这样逐个阶段完成是最不容易出错的,除非你非要许愿编程,幻想一步到位,也不想想自己给的要求合不合理.
举个例子,我让模型为一家荷兰艺术博物馆设计网站。到了第九次迭代,它生成了一个简洁的深色主题首页,页面内容是虚构的博物馆。页面视觉效果不错,但基本符合我的预期。然而,到了第十次迭代,它彻底放弃了之前的设计思路,将网站重新构想成一个空间体验:一个3D房间,房间内铺设着用CSS透视渲染的方格地板,艺术品以自由形式悬挂在墙上,展厅之间的导航不再是滚动或点击,而是通过门来切换。这种创造性的飞跃,是我之前从未在单次迭代的模型中见过的。
- 尽管如此,这种设计也是早就有的,所以还是照抄,并没有原创性.
作者要求 Planner 侧重:
- 产品背景和目标。
- 功能范围与用户故事。
- 高层技术设计。
- 产品需要具备的能力。
但是刻意避免让 Planner 提前决定每一个实现细节。
原因在于:如果 Planner 在早期制定了错误的底层方案,后续 Generator 可能机械地遵循这些错误决策。
新技术
我们在vscode开发时经常能看到.devcontainer这个文件夹,它的全名是Development Containers,并不是指开发了一种新的容器格式,而就是和Docker一样的普通容器,但多了对开发环境的一些支持,可以加入一些开发工具相关的依赖.
换句话说,Docker容器用于部署,DevContainer容器用于开发.
例如,Python官方的相关配置如下:
| |
不仅声明了开发环境镜像,重点在于特地说明和统一了Vscode配置,从而保证到了一台新的机器上无需重新配置就能着手开发.
11/6
面经
盲点:
- 数据库与架构:
- 索引下推和索引失效的场景
- 定义 Redis 跳跃表的结构,再实现一版它的插入方法
- 能说一下 LevelDB 的存储结构吗?
- 在主从模式和 Redis Cluster 中分布式锁会有什么问题?
- 迁移过程中双读双写具体是什么样的方案?
- 短链接唯一 ID 设计这块挑战是什么?
- LSM-Tree 有很多实现,能不能用 B+ Tree 作为其中的一种方案呢?用 B+ Tree 代替原来的 SSTable 有什么好处呢?
- Metrics 的数据模型有了解吗?
- LSM-Tree 和 B+ Tree 的本质区别是什么呢?
- 语言
- Go 里面使用 Map 时应注意问题和数据结构?
- Map 扩容是怎么做的?Map 的 panic 能被 recover 掉吗?了解 panic 和 recover 的机制吗?
- Map 怎么知道自己处于竞争状态?是 Go 编码实现的还是底层硬件实现的?
- 并发使用 Map 除了加锁还有什么其他方案吗?
- Golang 标准库中 map 的底层数据结构是什么样子的?
- channel 被 close 操作之后进行读和写会有什么问题?
- Golang map Rehash 的策略是怎样的?什么时机会发生 Rehash?Rehash 具体会影响什么?哈希结果会受到什么影响?
- sync.Map Store() 如何保持缓存层和底层 Map 数据是相同的? 是不是每次执行修改都需要去加锁?
- channel 底层数据结构是怎样的,尝试用结构体来表述一下?
代码题:
| |
问输出结果.
技术文章
Get more out of Claude Code: tell Claude what it can’t see, give it a check to run, and enforce the rules that can’t have exceptions.
如果你对一次对话不满意,一般是这几种情况:
- Claude做了一些与你预期不符的事情,主要原因是你没提供足够的背景信息
- Claude表示自己做完了,但实际没有昨晚,那是因为你没有给他提供检查完成工作的步骤
- Claude做了一些绝对禁止的事情,那是因为你没有在指令中强调该禁令
- Claude花了太多时间/对话轮次做出一个项目,这需要你更改一下模型强度
| 不要这么说 | 试着这么说 |
|---|---|
| “修复登录 bug” | “用户反馈会话超时后登录失败。检查 src/auth/ 中的 token 刷新逻辑,编写一个能复现该问题的失败测试,然后再进行修复” |
| “添加一个日历组件” | “参照 HotDogWidget.php 中的模式,构建一个日历组件,允许用户选择月份并在年份之间翻页。不要引入新的库” |
文章中所有谈到的操作都比较基础,但都很有效.
这篇文章一个最大的槽点就是,认为Claude是全知全能的,如果有问题,那就是你自己的问题😅
新技术
USENIX Association 是成立于 1975 年的非营利计算机技术协会,以推动计算机系统研究、工程实践和技术交流为目标。是计算机系统领域最重要的学术会议入口之一,尤其适合学习操作系统、分布式系统、数据库与存储、计算机网络、网络安全和系统工程。
| 会议 | 研究方向 | 典型研究内容 |
|---|---|---|
| OSDI | 操作系统与系统软件 | 操作系统、分布式存储、资源调度、云计算、系统可靠性 |
| NSDI | 网络与分布式系统 | 分布式一致性、RPC、网络协议、集群调度、数据中心 |
| FAST | 文件系统与存储 | LSM-Tree、SSD、KV 存储、持久化、缓存、文件系统 |
| USENIX Security | 计算机安全 | 系统安全、漏洞挖掘、隐私保护、软件安全、AI 安全 |
| SREcon | 站点可靠性工程 | 可观测性、故障排查、服务稳定性、生产运维 |
| SOUPS | 可用安全与隐私 | 人机交互、用户安全行为、隐私体验 |
| SAIS | 安全的 Agentic AI 系统 | AI Agent 的安全、可信性与系统设计 |
USENIX 最值得关注的特点是开放获取(Open Access):
- 论文 PDF 和会议论文集免费阅读。
- 已发布的演讲视频、Slides 通常也可免费查看
现在看对我来说还是太早了
11/7
面经
- 虽然字节没笔试,但是每次面试都像是在笔试,并且不喜欢出热100里面的,虽然有些题并不是很难,但是要你尽可能时间空间复杂度都最低来解决,二面的时候有个题,本来想着用两个栈解决的,后面改成了一个栈解决,但是他还不满意,说不用栈能不能解决,我说了一下整体思路,但没时间手撕了,后面就挂了。
- 阿里,这位更是重量级,hc少,bar高。整个暑期+秋招,根本约不到面试,要么笔试完没消息,大多都是简历挂,听说是要双9,或者本硕有一个是23所里面的,尤其淘天,阿里云,这俩简直就是只招超人。
- 学历厂也越来越不好使了,典型的就是今年的华为,比亚迪,在往年是出了名的学历厂,用来保底的。但是身边有不少朋友双9被华为挂了,比亚迪更是面试都不给。未来或许也只会有过之而无不及,所以大家提前做好准备吧。
- 秋招如果base地没要求的话,选北京你会多很多面试机会。
- 实习你拿很多offer未必意味着你秋招也能拿很多offer,因为暑期和秋招难度不是一个量级的,有可能你暑期拿到offer的公司,秋招你连简历都筛不过去。
- 每天的流程大概如下:10:10 出发去公司吃早饭。我住在八方城 6 栋,公司在 9 栋,直线距离 200m,五分钟通勤。吃完早饭之后坐到工位,大约是 10:30。工作到 12:00 吃午饭,14:00 上班。正式员工一般晚上工作到 21:30(我则是 18:00 吃完晚饭就走),也就是说,正式员工每天上班时间是 10:30 - 21:30,共计 11h
- 其实这个下班时间非常不正常,但好像大家都习以为常了😅
技术文章
- Harness Engineering
- 这可能是今年最值得读的一篇Agent工程论文了,分量也非常重,适合静心下来读.
An agent is a model plus a harness: the runtime that couples an LLM to the world through a loop, tools, context management, safety controls, orchestration, and extension surfaces
- Harness engineering, named as a discipline in early 2026, is the design and evolution of that runtime.
该论文剖析了Claude Code,Codex,Gemini CLI,Aider,Hermes,Pi,OpenCode等11个Harness框架,总结出了29种反复出现的设计模式.
值得一提的是,这些Harness没有一个用到了通用的Agent框架(如Langchain,AutoGen),也没有Harness使用embedding,而是通过grep,glob等工具来检索.
在如今,上下文管理成为了核心的基础设施,而工具调用和文件编辑的工程细节也十分重要,安全策略也必须在Harness层强制实施.
具体内容
这11个Harness都实现了ReAct的变体模式,但复杂性和状态管理都有极大的不同,不过都可以抽象为这个循环:
| |
这种Loop有三种模式:
| 类型 | 原理 | 代表 |
|---|---|---|
| Iterative Action–Observation | 模型与工具交替运行 | Codex、Claude Code、Gemini CLI 等 |
| Reflection-Augmented | 在执行循环中增加检查与修正 | Aider |
| Coordinator–Worker | 父 Agent 协调多个子 Agent | Claude Code、Codex 等 |
Harness按照模型适配接口可以分为以下两种:
- Provider-Native Harness,例如 Codex、Claude Code:深度适配特定模型,能够使用厂商专属能力。
- Multi-Provider Harness,例如 Pi、OpenCode:通过自己维护的协议适配层兼容多个模型供应商。
作者的重要发现是:多模型架构并非注定失去所有底层优化。只要开发者愿意承担额外的适配代码,也可以支持精细的缓存、推理和流处理功能
不同Harness对工具的设计差别很大,如最重要的文件编辑工具,Claude Code用的是唯一文本匹配策略,而Codex用的是结构化补丁.
不同Harness的工具系统更是截然不同,看一下这个图谱:
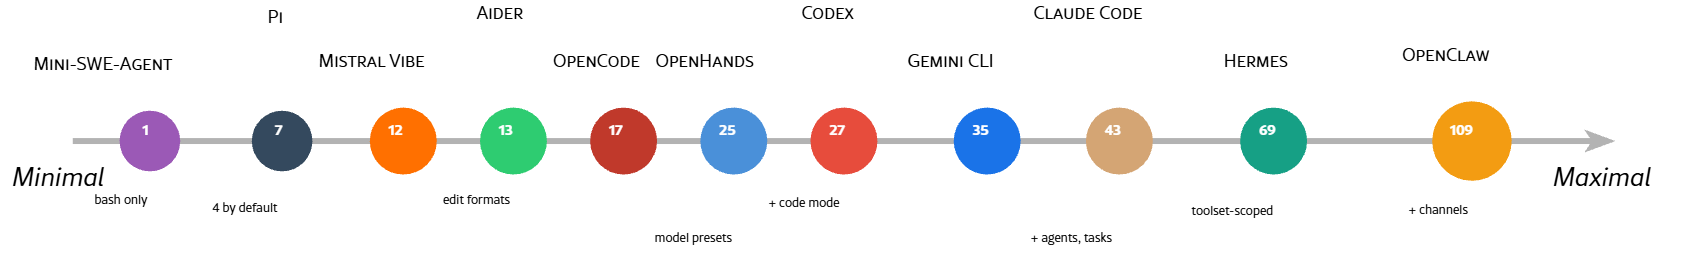
Hermes集成了69个内置工具,而Pi则只有7个工具,其余全部作为扩展.
论文将多 Agent 实现归纳为六种模式:
| 模式 | 含义 | 代表系统 |
|---|---|---|
| Single Agent | 单个 Agent 执行任务 | Aider、Mini-SWE-Agent |
| Sequential Delegation | 串行委派子任务 | Mistral Vibe |
| Parallel Child Sessions | 多个子会话并行 | OpenHands、OpenCode |
| Hierarchical Thread Tree | 父子线程树与任务管理 | Codex |
| Recursive Composition | 子 Agent 可以递归生成子 Agent | Claude Code |
| Registry + Protocol | 注册中心与跨进程接口 | Gemini CLI、OpenClaw 等 |
事实上,Framework和Harness的边界正在模糊:
| 方向 | 例子 | 本质 |
|---|---|---|
| Harness → Framework | Claude Agent SDK、Codex SDK、OpenHands SDK | 将成熟 Agent Runtime 封装为可调用的库 |
| Framework → Harness | LangChain Deep Agents、Pydantic AI Harness | 由通用框架提供开箱即用的 Agent 运行时 |
新技术
- CNCF
CNCF(Cloud Native Computing Foundation,云原生计算基金会)是全球云原生生态中的扛把子开源组织,于2015年在Linux Foundation下成立,内有国歌委员会,最重要的是TOC(Technical Oversight Committee,技术监督委员会),负责批准项目进入 CNCF、评估项目成熟度、协调项目之间的关系,以及维护整体技术方向,但具体实现还是由项目维护者自己实现的.
CNCF旗下的项目有三个等级: Sandbox、Incubating、Graduated,目前,CNCF有152个Sandbox项目,38个孵化项目,41个毕业项目.
| 等级 | 主要特点 | 对企业使用者意味着什么 |
|---|---|---|
| Sandbox(沙箱) | 早期探索,接口和架构可能快速变化 | 适合实验、验证新技术 |
| Incubating(孵化) | 有真实用户和一定社区基础,逐步完善稳定性 | 可以评估生产使用,但需要严格审查 |
| Graduated(毕业) | 成熟治理、广泛采用、生产实践与安全能力得到较充分验证 | 通常是更稳健的技术选择 |
| Archived(归档) | 活跃度下降、维护不足或不再受到基金会支持 | 应检查维护情况与替代方案 |
旗下最具代表性的项目有:
| 技术领域 | 代表项目 | 主要解决什么问题 |
|---|---|---|
| 容器编排 | Kubernetes | 部署、调度、扩容和管理容器工作负载 |
| 容器运行时 | containerd | 管理容器生命周期 |
| 分布式协调 | etcd | 使用 Raft 提供一致性的键值存储 |
| 服务发现 | CoreDNS | DNS 解析和服务发现 |
| 网络 | Cilium | 基于 eBPF 的容器网络、安全与可观测性 |
| 服务代理 | Envoy Proxy | L4/L7 流量代理、负载均衡 |
| 服务网格 | Istio | 微服务流量、安全策略与通信治理 |
| 监控 | Prometheus | 时间序列指标、查询和告警 |
| 可观测性 | OpenTelemetry | 标准化采集 Metrics、Logs、Traces |
| 包管理 | Helm | 管理 Kubernetes 应用部署包 |
| GitOps | Argo CD、Flux | 让集群状态持续与 Git 声明保持一致 |
| 自动扩缩容 | KEDA | 根据事件、消息队列等指标调整实例数量 |
| 容器镜像仓库 | Harbor | 存储、扫描和管理容器镜像 |
CNCF下还有一个旗舰的技术会议KubeCon + CloudNativeCon,可以购买门票现场参加.
美国顶尖课程(11/8)
尽管我一向认为项目和书籍搭配是最好的学习方式,但不可否认国外的部分课程是相当优秀的,是真的在传授工程经验,而且,大多数课程都有专门的配套网站,并无私地向全世界分享学习资料,相比之下,国内能做到这种程度的教师寥寥无几,不超过一手之数,做的好不好还另说.
完整列举
Stanford University:LLM、Agent、AI Infra、分布式系统
- CS 111:Operating Systems Principles【本科】
- 进程、线程、文件系统、同步、虚拟内存
- CS 144:Introduction to Computer Networking【本科】
- TCP/IP、网络协议、传输控制、网络实现
- CS 149:Parallel Computing【本科】
- 并行编程、GPU、性能优化
- CS 221:Artificial Intelligence: Principles and Techniques【研究生】
- 搜索算法、规划、逻辑推理、概率模型
- CS 224N:Natural Language Processing with Deep Learning【研究生】
- Transformer、语言模型、NLP、LLM
- CS 224V:Agentic AI【研究生】
- RAG、Agent 规划、知识推理、长期任务
- CS 229:Machine Learning【研究生】
- 机器学习算法、优化、概率建模
- CS 234:Reinforcement Learning【研究生】
- MDP、Bellman Equation、Q-Learning、策略梯度
- CS 244B:Distributed Systems【研究生】
- 分布式一致性、复制、容错、系统设计
- CS 329A:Self Improving AI Agents【研究生】
- Agent 自我改进、测试时计算、搜索、验证
- CS 329Z:Engineering AI Agents【研究生】
- Agent Loop、Tool Use、RAG、Memory、Agent Evaluation
- CS 336:Language Modeling from Scratch【研究生】
- Tokenizer、Transformer、预训练、GPU 优化、推理
- CS 349D:AI Inference Infrastructure【研究生】
- vLLM、SGLang、KV Cache、Speculative Decoding、PD 分离
- CS 229S:Systems for Machine Learning【研究生】
- ML 系统、计算优化、分布式训练、模型服务
- CS 111:Operating Systems Principles【本科】
MIT:操作系统、分布式系统、软件设计、系统性能
- 6.1020:Software Construction【本科】
- TDD、软件测试、抽象数据类型、设计模式、并发
- 6.1040:Software Design【本科】
- 系统设计、Web 应用、模块化、LLM 辅助开发
- 6.1060:Software Performance Engineering【本科】
- Cache、性能分析、向量化、并行优化
- 6.1100:Computer Language Engineering【本科】
- 编程语言实现、编译器、语言运行时
- 6.1220:Design and Analysis of Algorithms【本科】
- 算法设计、复杂度、图算法
- 6.1800:Computer Systems Engineering【本科】
- 系统抽象、容错、可靠性、性能、安全
- 6.1810:Operating System Engineering【本科】
- xv6、内核、虚拟内存、线程、文件系统
- 6.3900:Introduction to Machine Learning【本科】
- 回归、分类、神经网络、机器学习基础
- 6.5830:Database Systems【研究生】
- 数据库引擎、事务、索引、查询优化、恢复
- 6.5840:Distributed Computer Systems Engineering【研究生】
- Raft、RPC、容错、分布式 KV Store
- 6.5850:Principles of Computer Systems【研究生】
- 分布式协议、并发算法、系统验证
- 6.5860:Datacenter Computing【研究生】
- 数据中心、资源调度、云基础设施
- 6.5250:Distributed Algorithms【研究生】
- 分布式算法、通信复杂度、故障模型
- 6.7920:Reinforcement Learning: Foundations and Methods【研究生】
- MDP、动态规划、强化学习算法
- 6.1020:Software Construction【本科】
Carnegie Mellon University(CMU):软件工程、计算机系统、AI 编程、LLM Infra
- 15-213:Introduction to Computer Systems【本科】
- CS:APP、内存、汇编、缓存、并发、系统性能
- 15-410:Operating System Design and Implementation【本科】
- 操作系统内核、线程、虚拟内存、文件系统
- 15-411:Compiler Design【本科】
- 编译器、优化、寄存器分配、代码生成
- 15-418:Parallel Computer Architecture and Programming【本科】
- GPU、并行算法、计算架构
- 15-440:Distributed Systems【本科】
- RPC、分布式存储、一致性、容错
- 15-445:Database Systems【本科】
- BusTub、索引、缓冲池、执行引擎、事务
- 17-214:Principles of Software Construction【本科】
- 软件设计、抽象、测试、模块化
- 17-313:Foundations of Software Engineering【本科】
- 软件架构、需求、质量保证、团队开发
- 17-316:AI Tools for Software Development【本科】
- Coding Agents、AI 代码审查、测试、生产力评估
- 17-335:Software Architectures【本科】
- 架构风格、模块设计、质量属性
- 17-437:Web Application Development with AI【本科】
- AI 辅助全栈开发、Web、测试、部署
- 17-445:Machine Learning in Production【本科】
- MLOps、模型部署、监控、生产系统
- 17-446:DevOps and Continuous Integration【本科】
- CI/CD、自动化构建、持续集成
- 11-868:Large Language Model Systems【研究生】
- LLM 系统、推理优化、大规模模型基础设施
- 15-213:Introduction to Computer Systems【本科】
UC Berkeley:分布式系统、强化学习、LLM Agent、系统基础设施
- CS 61A:Structure and Interpretation of Computer Programs【本科】
- 编程抽象、递归、解释器
- CS 61B:Data Structures【本科】
- 数据结构、算法、软件组织
- CS 61C:Great Ideas in Computer Architecture【本科】
- 计算机架构、内存、并行计算
- CS 162:Operating Systems and System Programming【本科】
- 线程、进程、调度、内存管理、并发
- CS 164:Programming Languages and Compilers【本科】
- 编译器、语言设计、语义分析
- CS 168:Introduction to the Internet: Architecture and Protocols【本科】
- Internet 架构、路由、TCP/IP
- CS 169A:Introduction to Software Engineering【本科】
- Agile、TDD、BDD、SaaS、重构
- CS 186:Introduction to Database Systems【本科】
- 索引、事务、查询优化、数据库实现
- CS 188:Introduction to Artificial Intelligence【本科】
- A*、MCTS、搜索、概率推理、智能体
- CS 189:Introduction to Machine Learning【本科】
- ML 算法、优化、神经网络
- CS 262A:Advanced Topics in Computer Systems【研究生】
- 高级系统、分布式系统论文研究
- CS 285:Deep Reinforcement Learning【研究生】
- Policy Gradient、Actor-Critic、Model-Based RL
- CS 194/294-196:Large Language Model Agents【本科/研究生】
- LLM Agent、规划、工具调用、Agent Workflow
- CS 194/294-280:Advanced Large Language Model Agents【本科/研究生】
- Agentic Reasoning、搜索、代码生成、Agent 后训练
- CS 61A:Structure and Interpretation of Computer Programs【本科】
Georgia Tech:软件工程、软件架构、云计算、AI、分布式
- CS 1332:Data Structures and Algorithms【本科】
- 数据结构、算法
- CS 2200:Systems and Networks【本科】
- 操作系统基础、计算机组成、网络
- CS 3210:Design of Operating Systems【本科】
- 内核设计、系统调用、并发
- CS 3600:Introduction to Artificial Intelligence【本科】
- 搜索、规划、概率推理
- CS 6200:Graduate Introduction to Operating Systems【研究生】
- 进程、线程、同步、操作系统实现
- CS 6210:Advanced Operating Systems【研究生】
- 分布式 OS、并行系统、性能
- CS 6211:System Design for Cloud Computing【研究生】
- 云计算系统、服务架构、分布式基础设施
- CS 6300:Software Development Process【研究生】
- 软件工程流程、Agile、测试、质量控制
- CS 6310:Software Architecture and Design【研究生】
- 软件架构、模块设计、架构模式
- CS 6340:Software Analysis and Testing【研究生】
- 静态分析、动态分析、自动测试
- CS 6400:Database Systems Concepts and Design【研究生】
- SQL、数据库设计、事务、查询处理
- CS 6601:Artificial Intelligence【研究生】
- 搜索、规划、概率推理、AI 算法
- CS 7210:Distributed Computing【研究生】
- 分布式算法、逻辑时钟、故障模型
- CS 7642:Reinforcement Learning and Decision Making【研究生】
- MDP、RL、多智能体决策
- CS 7652:Large Language Models【研究生】
- LLM 预训练、后训练、微调、模型效率
- CS 1332:Data Structures and Algorithms【本科】
Cornell University:分布式计算、软件工程、数据库、LLM Systems
- CS 3110:Functional Programming and Data Structures【本科】
- 函数式编程、类型系统、软件设计
- CS 3410:Computer System Organization and Programming【本科】
- 计算机组成、内存、系统编程
- CS 3780:Introduction to Machine Learning【本科】
- ML 基础、训练、泛化
- CS 4410:Operating Systems【本科】
- 进程、同步、虚拟内存、文件系统
- CS 4450:Introduction to Computer Networks【本科】
- TCP/IP、网络协议、网络架构
- CS 4740:Natural Language Processing【本科】
- NLP、语言建模、文本处理
- CS 4787:Principles of Large-Scale Machine Learning Systems【本科】
- 分布式训练、SGD、量化、模型压缩
- CS 4789:Introduction to Reinforcement Learning【本科层级课程】
- MDP、价值函数、强化学习
- CS 5150:Software Engineering【本科高年级/研究生】
- 软件开发、CI/CD、代码审查、团队项目
- CS 5154:Software Testing【本科高年级/研究生】
- 测试生成、回归测试、程序分析
- CS 5414:Distributed Computing Principles【本科高年级/研究生】
- Consensus、复制、Quorum、分布式算法
- CS 5470:Systems for Large-Scale ML【本科高年级/研究生】
- 大模型分布式训练、推理、多 GPU 系统
- CS 5744:Language Modeling【研究生】
- 语言模型、训练、推理、评估
- CS 6158:Software Engineering in the Era of Machine Learning【研究生】
- AI for SE、LLM 软件工程、测试与程序分析
- CS 3110:Functional Programming and Data Structures【本科】
Princeton University:系统设计、分布式系统、算法、AI
- COS 217:Introduction to Programming Systems【本科】
- C、系统编程、软件工具、内存管理
- COS 226:Algorithms and Data Structures【本科】
- 数据结构、图算法、复杂度
- COS 240:Reasoning and Computation【本科】
- 离散数学、逻辑、计算理论
- COS 316:Principles of Computer System Design【本科】
- 系统架构、抽象、性能、可靠性
- COS 324:Introduction to Machine Learning【本科】
- 机器学习、神经网络、概率模型
- COS 326:Functional Programming and Formal Methods【本科】
- 函数式编程、程序正确性、形式化方法
- COS 333:Advanced Programming Techniques【本科】
- 软件工程、综合编程、大型项目
- COS 417:Operating Systems【本科】
- 操作系统、线程、进程、虚拟内存
- COS 418:Distributed Systems【本科】
- RPC、一致性、容错、分布式存储
- COS 423:Theory of Algorithms【本科】
- 高级算法、数据结构、NP 完全性
- COS 435:Introduction to Reinforcement Learning【本科】
- MDP、强化学习、决策算法
- COS 445:Networks, Economics, and Computing【本科】
- 博弈论、网络、分布式决策
- COS 461:Computer Networks【本科】
- Internet 协议、路由、网络安全
- COS 484:Natural Language Processing【本科】
- NLP、语言模型、自然语言理解
- COS 217:Introduction to Programming Systems【本科】
Harvard University:计算机系统、AI Agent、LLM Infra、机器学习
- CS 50:Introduction to Computer Science【本科】
- C、Python、SQL、Web、计算机基础
- CS 61:Systems Programming and Machine Organization【本科】
- C/C++、内存、并发、系统编程
- CS 1450:Networking at Scale【本科】
- 网络系统、可扩展性、网络协议
- CS 1520:Programming Languages【本科】
- 编程语言、类型系统、语言设计
- CS 1610:Operating Systems【本科】
- OS、进程、同步、资源管理
- CS 1650:Data Systems【本科】
- 数据系统、数据库、存储
- CS 1810:Machine Learning【本科】
- 机器学习算法、优化、统计学习
- CS 1820:Planning and Learning Methods in AI【本科】
- AI 搜索、规划、智能体学习
- CS 2620:Distributed Computing【研究生】
- 分布式协议、一致性、复制、容错
- CS 2640:Modern Computer Storage Systems【研究生】
- SSD、文件系统、分布式存储、缓存
- CS 2680:Modern AI Systems: Agents and System Optimizations【研究生】
- Coding Agent、Harness、KV Cache、SGLang、LLM Serving
- CS 2824:Foundations of Reinforcement Learning【研究生】
- 强化学习理论、策略优化、序列决策
- CS 2850:Deep Learning【研究生】
- 深度学习、神经网络、优化
- CS 2882:AI Agents and Multiagent Systems【研究生】
- 自主智能体、多智能体协作、LLM Agent
- CS 50:Introduction to Computer Science【本科】
推荐课程
怎么说都不可能逐个学完吧,就算不看讲义,十倍速放视频,我想也要看个好几年.所以我让AI筛选了一下,并由我根据喜好敲定了几个值得一学的工程课程.
- 如果想要速通AI相关课程的话,这里有一个AI讲义合集网站
| 优先级 | 学校 / 课程 | 核心价值 | 推荐程度 |
|---|---|---|---|
| 1 | MIT 6.1020 — Software Construction | 测试、抽象、模块设计、可靠代码 | 必读 |
| 2 | Harvard CS 2680 — Modern AI Systems | Coding Agent、Harness、模型服务 | 必读 |
| 3 | Stanford CS 329Z — Engineering AI Agents | Agent Loop、工具调用、RAG、评估 | 必读 |
| 4 | CMU 15-445 — Database Systems | 索引、事务、并发、存储引擎 | 强烈推荐 |
| 5 | MIT 6.5840 — Distributed Systems | Raft、RPC、容错、分布式 KV | 强烈推荐 |
| 6 | CMU 17-316 — AI Tools for Software Development | AI 编码、代码审查、测试 | 强烈推荐 |
| 7 | MIT 6.1040 — Software Design | 大型软件系统设计、模块化、Web 项目 | 推荐 |
其中最令我惊艳的是CS2680,直接开始教Agent Infra和Harness,并且所有作业都需要用Claude Code完成,这真是大开眼界,真正的大学教学不过如此吧.
好文(11/9)
银行卡交易剖析
银行卡交易由四方模型(Four-party Model)组成:
- 持卡人(Cardholder):库克,使用银行卡支付货款。
- 商户(Merchant):沃尔玛,提供商品并接受银行卡付款。
- 发卡机构(Issuer):向库克发行信用卡,管理他的账户和信用额度,决定是否批准这笔消费。
- 收单机构(Acquirer):为沃尔玛提供银行卡受理服务,把交易提交出去,并按约定向商户支付货款。它可以与沃尔玛日常存款账户所在的银行不同。
Card Network(如Visa,万事达,银联)负责将发卡机构和收单机构连接到一起,从而避免了收单机构需要逐个对接发卡机构,开发接口的烦恼.
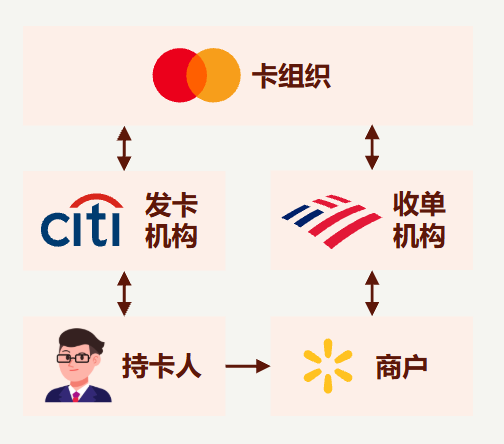
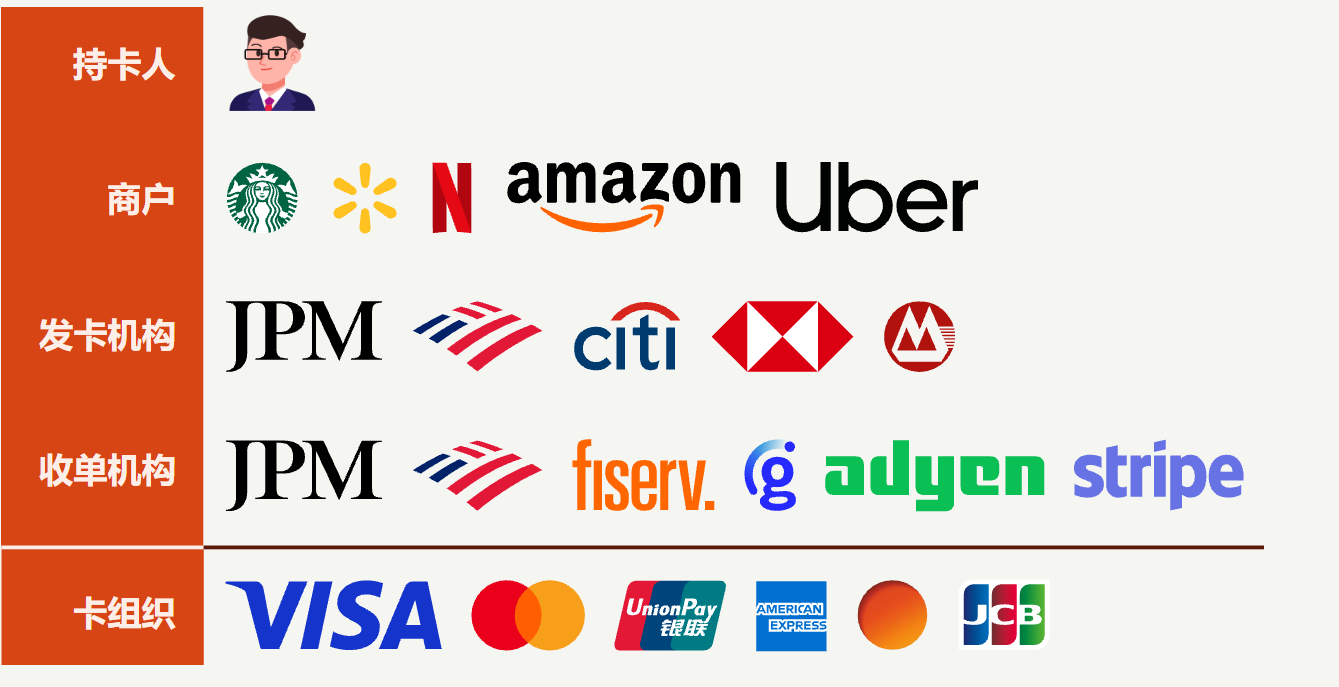
检查流程:
相当相当之复杂.
论文1
简直是瞌睡遇上枕头,我正好奇Computer Use的前沿实践,微软就在10月30号发了这篇论文.
本文提出我们可以通过三种通道来实现Computer Use,简称为HCU,并在OSWorld2.0种取得了目前的最高分:
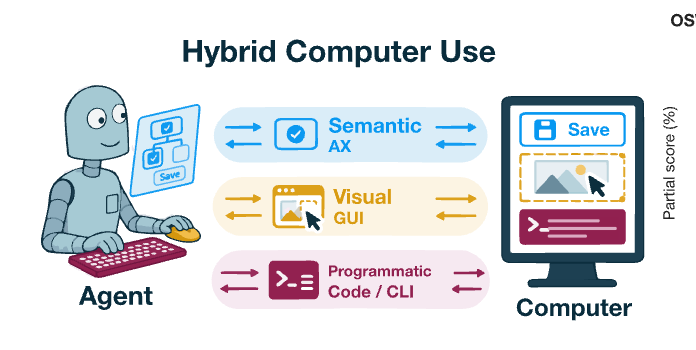
这三个通道是:
- Programmatic(程序化通道):调用 Shell、Python 等工具直接操作文件、数据和程序。
- Semantic(语义通道):通过 Accessibility Tree 读取和操作 UI 控件。
- Visual(视觉通道):通过截图、鼠标和键盘处理无法通过结构化接口完成的任务。
最核心的创新点在于Accessibility Tree(AX),鉴于操作系统本身就知道屏幕上任何一个窗口的组件结构(不然也渲染不了画面),主流操作系统都支持通过辅助功能接口读取这些信息,用于无障碍阅读,HCU可以通过这些接口获取到AX信息,这非常类似于DOM解析:
| |
但具体的操作主要还是通过普通的截图执行的,ux只是帮助辅助理解,类似于LLM对话中RAG的作用.
至于提升嘛,还是很有限的,没有特别的令人震撼,这反过来说明想靠不断截图来实现Computer Use的渠道还是有不少限制的.
新技术
好文(11/10)
蒋老师的博文
劝退确实是劝退,但如果看清了这一点还考虑去读研的人,自然是有自己的考量和苦衷的.
26届薪资(11/11)
用的offershow送的会员,但是26届也就是25年的秋招和26年的春招,所以时效性不是太高.
只看研发岗:
- 腾讯:
- base大幅度提升,白菜25* 15,ssp有(31-39)*15,折算下来就是五十多万,还是很惊人的.
- 百度
- 白菜20* 16,ssp有(31-42)*16,给的确实多哈
- 京东
- 白菜20* 20,ssp(32-43)*20,这薪资确实到bar了
- 美团
- 白菜20* 15.5,ssp(27-36)*15.5,确实没什么大的提升
- 小红书
- (28-32)x16->(37-42)x16,?白菜都能给到50w,太离谱了吧
- 快手
- (23-27)x16->(32-34.5)x16,还行
- 拼多多
- (25-34)x18->(40-43)x18,你敢拿自家时薪跟别的企业比嘛😅
- 字节
- (20-29)x15->(38-45)x15,和tencent基本持平,但算时薪肯定是不值的
尽管薪资上去了,作为对冲的是,岗位数量下去了,要求上去了,换算一下,其实好工作更难找了,转型期向来都是地狱难度.
11/13
面经
盲点:
- 布隆过滤器
- Golang的垃圾回收方案
- TCP的报文格式
- Go Map的底层实现和碰撞方法
- Go的反射是怎么实现的,tag的原理
- 队列和栈对应的应用场景
- 栈死活想不到,原来是浏览器历史记录和Ctrl+Z功能
11/17
面经
遍览下来就能发现,大厂全都会卡学历的,甭管你实力怎么样,92就是比双非要好,硕士就是一般比本科更占优势.
其实这完全不能怪HR,投递的人实在太多了,但HR只能看简历来初步筛选,那肯定挑履历好的给面试机会,就算技术吹的天花乱坠,谁知道你到底是不是有真材实料,而就学历来言却是造不了假的.
新技术
Split-Brain(脑裂)用相当形象的说法描述了集群中出现多个认为自己是主节点的节点,这容易导致数据不一致甚至是数据丢失.
这会出现在原主节点临时宕机后集群重新选取了一个主节点,但原主节点以为自己还拥有权限的情景中.
因此,我们需要控制旧节点的权限,确保只有一个主节点的命令能够生效.
技术文章
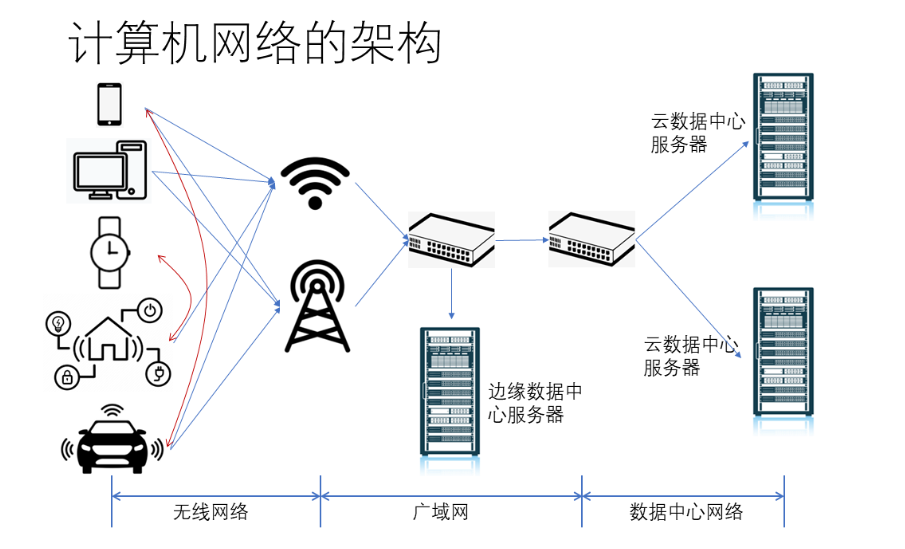
如果仅仅考虑传统的 Web 服务,现有的数据中心网络和内核的 TCP 协议栈已经足够应对需求。那为什么说计算机网络进入了一个新黄金时代呢?不管网络、系统还是体系结构,最大的两个驱动力始终是应用需求和硬件能力。
数据中心网络能够发展得这么快,根本原因是人工智能(AI)、高性能计算(HPC)、大数据、存储等新兴业务对带宽和延迟提出了更高要求。而我们的网络硬件性能还没有触到天花板,可以匹配上应用的需求。新的网络硬件又对上层的软件和系统带来新的需求,这就带领整个行业不断有新的事情可做。
尽管 ChatGPT 目前尚未广泛普及(注:2022 年 12 月 12 日原演讲内容),但未来它必将成为颠覆性的创新。
我们来看一下这些 AI 模型对于计算能力和内存需求的增长趋势。在 2012 年,最早的 AlexNet 问世;到了 2014 年,有了 GoogleNet;之后是 2015 年的 Seq2Seq,2016 年的 ResNet。到了 2018 年出现了 AlphaGo 和 AlphaZero,最后在 2020 年出现了 GPT-3 等。我们可以看到,从 2012 年到 2020 年,这些模型对算力的需求增长速度非常快,翻了 30 万倍。这个增长速度并不像摩尔定律那样每 18 个月翻一倍,而是在 18 个月内翻 40 倍,非常惊人
然而,我们的 AI 算力,即单个 GPU 的算力增长速度,实际上还是相对遵循摩尔定律的,因为它毕竟是硬件。这么巨大的需求差距要求我们必须采用分布式并行计算来满足这些需求。
从另一个角度来看,大模型的内存需求也非常大。我们可以看到,不同的模型对内存的需求也在增长,越大的模型通常意味着越高的内存需求。例如,我们之前提到的 ChatGPT,在单个 GPU 中根本放不下,需要更多的 GPU 资源才能完成推理。
11/18
- 分布式系统百科
- 共计70篇,深度广度兼具
ch1: 分布式系统模型
Raft 依赖的系统模型(system model)对网络时序有假设。具体来说,它假设系统是部分同步(partially synchronous)的——网络延迟可能暂时不可预测,但最终会恢复到一个有界范围。如果你的网络长时间不满足这个假设,Raft 的活性(liveness)保证就失效了。
每个分布式协议都建立在一组假设之上:网络是同步的还是异步的?节点崩溃后能不能恢复?节点可不可能撒谎? 这些假设构成了所谓的”系统模型”。你的模型假设越强(比如假设网络完全同步),能设计出的协议就越简单、性能越好;假设越弱(比如允许拜占庭故障),协议就越复杂、代价越高。
FLP 不可能性定理:在异步系统中,即使只有一个进程可能崩溃(crash-stop),也不存在确定性的共识协议能同时保证 safety 和 liveness。
- 同步模型
- 条件最多: 存在一个已知的上界 Delta,任何消息的传递延迟不超过 Delta;存在一个已知的上界 Phi,任何处理器的一步计算时间不超过 Phi。
- 问题在于现实网络是不同步的,所以不具备适用性
- 异步模型
- 不对消息延迟做任何假设,如果你的协议在异步模型下正确,那在任何网络下都正确
- 问题在于异步系统无法区分"慢"和"死",就算进程长时间没响应,你也不知道到底是崩溃了还只是特别慢,因此不能同时保证safety和liveness
- 部分同步模型
- 有两种形式,第二种更常用也更直观
- 消息延迟存在一个未知的有限上界,协议需要在不知道这个值的情况下保证正确性
- 存在一个未知的时间点GST(Global Stabilization Time),在GST之前,消息延迟可以任意大,在这之后,系统就像同步系统一样,有确定的消息延迟上界.
- 换句话说,协议在网络不稳定时可以”卡住”(不推进),但绝不能”出错”(做出互相矛盾的决定)。一旦网络恢复稳定,协议必须能继续推进。
- 这正是 Paxos、Raft、PBFT 等主流共识协议采用的模型。它们都保证:
- 无论网络状况如何,已提交的值不会被撤销(safety)。
- 只要网络最终稳定,新的提案最终会被提交(liveness)。
- 有两种形式,第二种更常用也更直观
在实践中,协议设计者必须确保 safety 在异步窗口中无条件成立,不依赖任何时序假设。具体来说,即使消息延迟任意大、节点的超时判断全部失效、Leader 选举无法完成,已提交的决定也不能被推翻.
时序假设只被用于 liveness——只有当网络恢复稳定(GST 之后),协议才需要保证能继续推进。这种 safety 与 liveness 的不对称设计,是部分同步模型的核心工程价值所在。
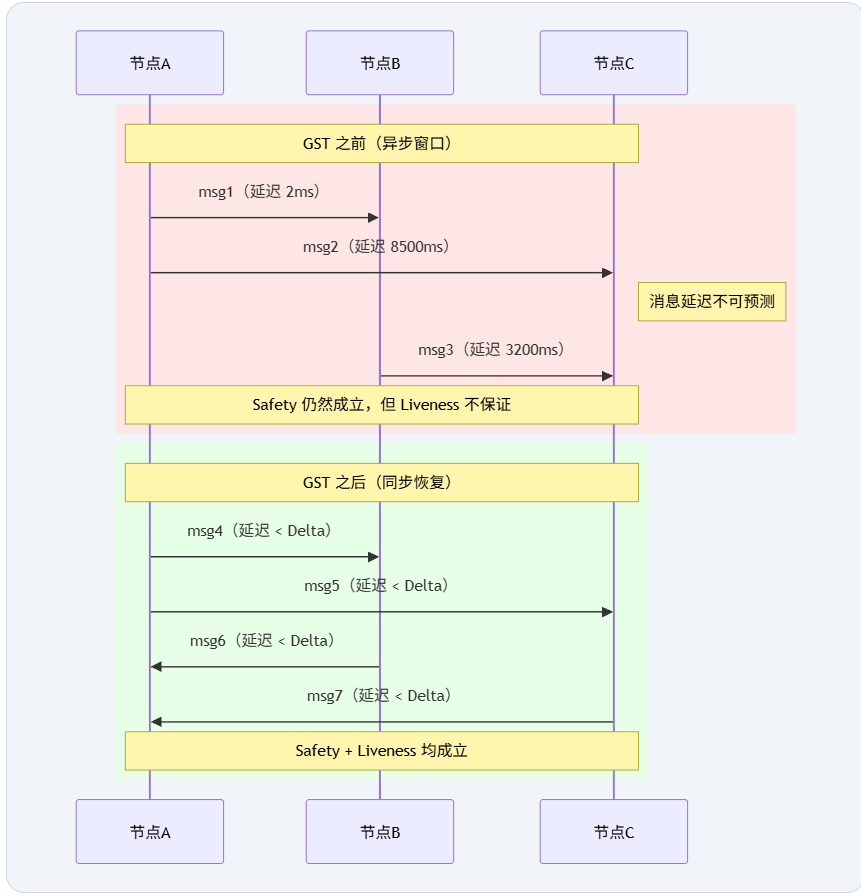
读到这里我就发现不对劲了,写的确实好,结果点进主页一看,这样的系列还有几十个,我的天哪,那我还是放在专门的阅读栏目里吧.
11/19
对于Amazon这种由几百万台设备组成的基础设施,故障是家常便饭;在任何时刻都会有比例小但数量不少(small but significant number)的服务器和网络设备发生故障。因此,Amazon 的软件系统要将故障视为正常的、可预期的行为(treat failure handling as the normal case),不应因设备故障而影响可用性和性能。
对于很多服务,例如畅销排行榜、购物车、客户喜好偏向、session 管理、销售排名、商品目录等等,常见的关系型数据库会非常低效,而且限制了规模的扩展性和可用性。Dynamo 提供了只使用主键(primary key only)的访问接口来满足这类应用的需求。
Dynamo有以下假设:
- 查询模型
- 任何操作都不需要跨表,即不存在关系,通过唯一的key和索引读写数据
- ACID
- 不提供任何隔离保证,可允许牺牲部分一致性.
- SLA
- 将SLA设置到P99.9,头回见这么严格的SLA
Dynamo是一个最终一致的仓库,即最终,所有的更新会应用到所有副本,但不保证能够即时更新.
Dynamo为了提供仓库的永远可写性,因此允许随时写入,只在读取数据的时候解决冲突.
核心系统架构
- Partition: 一致性哈希
- 写高可用: 在读数据时解决冲突的向量时钟
- 短时故障处理: 宽松的选举,在部分副本不可用时仍然提供高可用性
- 故障恢复: 使用Merkle tree
- 成员管理: 使用Gossip
11/13
面经
新技术
技术文章
11/13
面经
新技术
技术文章
思考
- 26/7/29: 忘了是在哪看到的了,最令人的厌烦的无非是装作老成的年轻人对同辈或者后辈发表的不知天高地厚的见解,这句话确实说的不错,曾经我也喜欢这么干,这里面的每个标题我都单独发了一篇博客文章出来,现在看来,确实是浅薄的可怕.不过,总还是得写点什么,这毕竟是几年以后能用来嘲笑自己的唯一根据
25
ai思考(2025-11-24)
随着我在计算机学习方面的逐渐深入,ai对我的作用越来越有限,顶多是在配置环境里帮我减少一点阅读文档的时间了,大多数时候它都不能给我一个正确的解答,而是说些通用的,却不符合我当前情况的解答.
因此,现阶段的ai还是更多的用在文档办公,图像生成等这些日常场景或者娱乐场景中比较好,一旦想要深入的学习一些技术,ai的劣势就一览无遗,就连洛谷的黄题它也很多时候做不出来(虽然我有时候也做不出来~).
因此,我现在更偏爱于技术博客和技术文档,书籍,再也不会去想用ai火速掌握一门技术的可能,而按照当前ai发展的状态来看,所谓的ai编辑器既然底层都是调用的热门大模型的api,那么自然也就不能处理太高端的技术,最多是辅助学生完成基础的代码作业而已.
总结一下,如果ai不能在字面意义上实现自主学习,它永远只会是一个文档翻译器,当成省时间的阅读工具可以,想用来提升自我,学习技术,我看还是算了.一句话,你懂的越多,ai就越傻.
道路与选择(2025-12-16)
这几天有点焦躁和郁闷,总有种无所适从的感觉,浑浑噩噩的,对很多事都不上心了,于是现在静下来认真思考了一下当前的处境.
人生是由一大堆选择构成的,每一个分岔路口都决定了我以后的人生道路,有时候选择多种多样,似乎哪里都是通路,有时候仿佛是山穷水尽,让我别无选择.
人自然是希望选择越多越好,这就是我以前为什么倾向于做事提早做准备的原因,为的就是不让自己在ddl的时候显得无路可走.
但过多的选择,太多的可能,悲观的现实又让我痛苦万分,人生的道路总是要自己走的,但如果有一个引路人就更好了.看不清未来的道路只会使我无所适从,一边厌恶着填鸭式的教育,一边追求绩点的完美,只怕到头来也是一场空.
26上
考研人数的下降(2026-01-03)

 可以看出来,尽管本科毕业人数越来越多,研究生招生人数越来越多,报考研究生的人数却越来越少,接着看下图

 疫情的影响太大了,大家都开始捂住钱包,不会再去做大胆的投资了,因此收入较稳定的餐饮业扶摇直上,而旅游业直到现在也未必恢复了元气.
 越来越多的人选择去找一些稳定的工作如公务员,医护人员,不愿意去创业了.
顺带一提还有战败cg,尽管没有今年的数据,但我相信降幅不会相差太多

这也是普通人的无奈吧,尽管身处这个时代,却连发生了什么都难以把握,只能隐约感觉到大环境不好,却找不到合理的数据来帮自己掌握一点点情况,连知情权也被剥夺,不知道下一步要怎么走,迷茫的在原地打转,只好依着惯例提心吊胆的生活,提不上享受生活,只看得见压抑和悲哀,失去了相信他人的胆量,失去了期盼明天的幸福,只是靠本分承担着责任,不是为了自己,而是为了亲人
很早就想要拿日本跟本国做一个对比了,尽管人口基数差的很离谱,但以前的日本或许就是现在的我们,现在这里预告提醒我自己一下
再战算法(2026-01-11)
昨天考了程序设计范式,一开始觉得三个小时三道题不是有手就行,后来发现我太天真了.
第一道题是leetcode2002,一道关于不相交回文子串的中级题,我硬是没想到用dfs做,可能是一个月没碰算法生疏了吧, 第二道题是设计几个角色的类,考察多态和继承,还真有点难,报错信息我都看不懂,第三道题是求满足给定和的最短子串,尽管我一开始就把双指针写出来了,但却在一些测试数据中一直死循环,还好机房上装了vscode,不然我都不知道要怎么调试,前前后后最少调了半个小时才解决这个问题,只能说是在第一题没做出来的情况下太紧张脑子短路了.
这一顿折腾下来,我才发现我连最基本的dfs都没能很好地掌握,连普通的课程考试都过不了关,啥也不说了,速速去刷题, 之前看了百度之星的题目,彻底断了打acm的念想,但刷点水题娱乐一下也是挺好的,不仅能应付考试,还能应付面试.
渺小的自我(2026-01-25)
今天看到了这篇博客,匆匆看了一遍博主的往年博客,仿佛就看到了一年之后的自己.
我跟博主的经历极其相似,都是在一个不发达地区的小镇经历了懵懵懂懂的少年时光,觉得自己未来有无限可能,进入高中后才发现自己并不是天之骄子,最终考入一个中流985,并发现自己只是一个普通的不能再普通的人,并没有用读书改变命运的可能,也不存在任何奇幻的邂逅,只有一个灰暗的,却又捉摸不定的未来,为了最后一丝甜蜜的幻想而苦痛挣扎.
或许,一年后的今天,我就要像他一样懵懵懂懂的参加实习,之后通过秋招走入职场,陷入都市的牢笼,住在一个窄小的出租屋,每天来回通勤两小时,熬夜加班赶文档,为了晋升和加薪的机会苦苦挣扎,因为被解雇的可能而夜不能寐,一个人蜷缩在屋内度过新年.
可不知为什么,当想到这些的时候,我的内心却无比平静,仿佛认定了这就是我该走的道路一样.也罢,渺小的自我,又怎么能容纳什么宏大的理想呢.
永远不要走极端(1/28)
很少有人能真正意识到互联网对普通人的深远影响,以极其傲慢的无知俯视着那些璀璨的工业成果.
比如不少人用ai写出了一个勉强能看的网站,就在嚷嚷着前端可以被ai取代,却没想到真实工程情景下的前端处理极其复杂,需要面对各种各样的请求并与后端接口交互,并实现高效美观的反馈界面.现在的ai再怎么吹的天花乱坠也做不到这一点.
事实上,绝大多数人在谈及某个人物或是某个事件时,都没有对自己所涉及的话题有着深入的,透彻的了解,而是肆无忌惮地宣扬自己的无知,仿佛自己道听途说的皮毛知识就已经足够应付那些我们本应该怀着敬畏看待的未知.
很少有真正纯粹的恶与真正纯粹的善,既然都是从猿猴进化而来的动物,一个人不可能不具有与生俱来的生存本能,那么自己做出的大多数事都一定是为了自己好,从自己的利益出发,而一旦自己的领域被侵犯,就立马进入戒备状态,朝着入侵者厉声吠叫.这并非是一件羞于启齿的事情,反而应该视为人类的本性,“世上没有圣人"的事实反而愈加衬托着那些真情和壮举的可贵,这些不同寻常的举动是人性的光辉,而非人性的通常表现.
最能凸显这一点的是互联网,历史在以前是被贵族阶级所垄断的,只有高贵的人才能随意涂抹,篡改历史,普通人能作为充实统计数字的材料便已经是万幸,怎么可能在哪个地方留下自己的声音呢.然而互联网做到了这一点,把真正的历史还给了普通人,让普通人也可以留下自己的印记,可以和素不相识的人分享自己的平淡日常,也可以看到千千万万的地球村民的与自己相异的日常.这才是真正的历史,或许未曾打磨,或许太过鸡毛蒜皮,或许太过丑陋不堪,但确比历史书显得真实可靠的多.
然而,正是因为未曾打磨,未经天人过目,副作用便显得格外可怕.请永远牢记一点:或许网上冲浪的人很多,但在网上发言的人永远只占上网冲浪人群的一小部分.不信问问自己这几个问题:你多久才会发一条评论?你是不是大多数时候只是匆匆一览界面便离开?创作者的基数是不是比观众要小的多?
一旦想清楚了这些问题,你才能真正意识到道听途说的可怖与可恨,如果大多数信息都是少数人通过过滤之后告诉你的,如果你从来不能安下心来去亲自了解那些信息,那么便可以很明确的知道,这些消息都只是废料罢了,是被他人咀嚼之后勉为其难的以高姿态施舍给你的,而你却视若珍宝,满怀着发现了事情真相的喜悦,恨不得让所有人都知道自己的无知,顺便还当了一回传教士,向其他人散播这些废料.
这也就回到了我的论题:永远不要走极端,若是互联网上的声音都是少数人发出的,那么走极端那不是必然的吗,你怎么能期待他们会整齐划一的走中间车道而不是来个急转弯撞出护栏呢.所谓的对立,所谓的矛盾,能被摆上互联网就足够说明是个例了,普通人的普通日常也不会有人去大肆声扬.即便有万千的个例,也只是几十亿人口中的少之又少的部分而已,那么,又与真实的社会环境有何关系,这些个例能代表的只有极端而已,绝非是正常情况.
也正是因为有着这些极端作为烟雾弹,真正的历史得以悄无声息的不断进行,直到历史的车轮碾到了身上,才吵嚷着个人的渺小和时代的沧桑,却没想到历史本就是由个人的普通日常组成的,正是因为每个人都有着自己的悲欢离合,都有着自己的大起大落,没有整齐划一的路线选择,才有了无法被预测的未来.
ai幻想(2026-01-31)
- ai幻想:认为ai可以帮自己包揽技术上的难题
我大学这两年经历了不少ai幻想的例子,但也看见过有些同辈依然脚踏实地钻研技术.不得不承认,后者的比例要小的多,而他们的知识水平和成绩都让我不得不低头,承认他们与众不同的技术造诣.
很难想象ai浪潮下的普通大学毕业生在真实的工作场景下会暴露出怎样的一种丑态,而这样一批靠ai吃ai,从来没能真正掌握技术的人攻读研究生,博士生的时候又要去怎样的水出一篇sci.
如果ai真的有他们想象的那么强大,那倒还可以糊弄过去,可惜的是目前ai的水平还远远不到家,近两年业界也并没有突破性的进展,依旧是在倒腾同一个模型,同一种方法,更多的是吃老本而不是真正的开拓创新.
可惜我早就听说在技术好的人未必晋升的快,说不定这些用ai糊弄架构,用心美化ppt的人反而能混的风生水起呢,哈哈,其实现在就是这样了:smile:
2026-02-08 方向选择与信息差
最近仍然是在挣扎,保研已是无望,那么到底是考研还是本科就业好呢.
简单分析一下:
考研之后无非也还是就业,这个学位更多的来自家里人的压力,我自己反而是没什么感觉的,说来也好笑,没有体验过研究生生活和所谓学历优势的人都在劝我读研,他们乐此不疲地阅读那些散播焦虑的,没有实质内容的公众号文章和抖音视频,成功地被同化和洗脑,坚信读研就一定能发达,就能实现阶层突破,读了研还不够,要再去读个博,之后就去参加选调,受尽恩宠后再回老家当个封疆大吏,再在过年时被家里人牵出来,给左邻右舍看看自家有多风光.
不过家里人终归是抱着为了孩子的心劝说着我的,不愿意让我去吃苦,陷入网传的35岁即失业的漩涡.遗憾的是,我并不畏惧这样的未来,反而是不愿意活的太稳定,没有变化,日复一日,“work with unrelated person for unrelated issues”,如果连一点挑战都没有,我又怎么成长呢.
至少,我是不愿意待在小城市的,尽管岁月静好,这也就意味着脱离了最新的潮流,丧失了基本的娱乐,就算能够通过网络去获取必要信息,还是没有自己亲身去体验来的实在.
想明白了这一点,心里的压力就少很多了,正常学习就好,先把"uninteresting lessons taught by uninterested teachers"全翘掉,认真打磨项目,锻炼自己的全方面能力,期末周也认真复习,如果这样也无法保研,那我就无所谓了,谁愿意卷就让他去卷吧,我甘愿被筛选性教育淘汰掉,早早跑去工作.
事实上,我认为迷茫的来源主要是信息差,而不是别的什么,正是因为我不知道自己本科毕业能找到怎样的工作才会迷茫,正是因为我不知道以后会不会真的失业跑去送外卖才会迷茫,正是因为我不知道自己接下来要做什么才会迷茫.
那么,答案也很简单了,磨练技术,收集信息,备战三年难道还拿不下暑期实习和秋招吗.
反思(2026-03-03)
家里人都希望我读研,有的是觉得程序员不稳定,有的是想让我进体制内当官,有的是觉得我可以扩大圈子.
而我一开始以为自己之所以不想读研而是想直接工作,是因为想要干一些有创造力的活,想要挑战自己,但现在我发现,如果在保证有稳定收入的情况下,最理想的条件是事少空闲多,可以有大把的时间干自己喜欢的事情,但事实上并没有这样的工作.
如果我选择进大厂,虽然有可能进一个很push很压抑的组,甚至还需要花力气去打点人际关系,走点向上社交,但这终归是可能,我可以通过各种方式改变自己的工作环境,即便可能在以后被裁员,我也总可以找到一份合适的工作,就算舆论再怎么渲染ai的可怕,我想自动化在取代高级程序员之前一定会先取代公务员和蓝领工人,如果当局不愿意动这个刀子(很大概率不愿意),那就一损俱损,如果经济危机来了,到头来还是要下手.(你要问为什么下手?因为当局总是优先保证高位者的权利,再通过裙带关系来让下位者吃残羹冷炙,如果你威胁到了他的切身利益,那肯定一脚踢开啊,无论在哪都是这样,民族国家之所以维持高军费警费,一方面是逗人的对外防御,更多的是对内防御,怕你不听话呢)
而到了那个时候,若参考1930年代,由于当局的弱势,无法进行像样的改革,又无法向外转移矛盾,再加上绝大部分人口都在农村,可以实现自给自足,城市里的所谓知识分子和公务员基本都受了老罪;而现在由于新兴人口都在城市,当局强势,加上过度依赖当代技术,向内转移矛盾将会导致全面崩坏,故只能向外转移矛盾,而且是非常猛烈的那种,可参考当前美国的外交政策.
所以,我坚决不选择考公,第一是因为流动性小,过于乏味,过多迎合,工资只能保证不饿死,加班也多(假期的值班,重要岗位的加班,什么,你说你的岗位很轻松基本没工作?那肯定是边缘岗位,未来反而更容易被裁),第二是因为太多人来考公,机遇过小难逢贵人,就算限制录取比例,但单位里(尤其是基层单位)的所谓元老都只是80年代生人,离退休还远着呢,导致机关臃肿无比,一定要疯狂的内卷才能吸引领导的注意,当然不卷也行,如果一辈子当个科员(当然博士有正科级待遇,说说而已啦,放首都里你算个屁,处级都没有实权,努力十年不如天降关系,若是像大多数博士公务员一样远离政治中心,晋升机会就小的多),我看你退休金未必会比爸妈高呢.
事实上,现在我也不太愿意去高强度岗位累死累活挣大钱,除非工作内容合我的胃口,挣钱的目的是什么,如果单纯是为了存钱而挣钱,那就有点好笑了;如果是为了脸上有光的虚荣心,那就更好笑了.
我的娱乐活动基本不是很花钱,也没什么旅游的欲望,目前也没有家庭的负担,但如果是为了未来,为了一点飘渺的机缘,为了所谓的经济自由,也可以去打拼打拼吧.
一代人有一代人的路要走,我不想走老一辈的路了.
2026-03-09 你真的会上学吗
很多人在考入大学的时候都已成年,但事实上没有多少大学生是真正的成年人,我认为成年人需要有以下三个表现:
- 能够自己处理日常杂务(衣食住行样样都会),并且有自己的时尚眼光,选择合适的穿搭
- 能够安排好工作,娱乐,家庭三者之间的关系
- 独立思考,对外自信,对己严格
最难的其实就是独立思考了,很多人都在抱怨重点大学里越来越卷的环境,却没有想过一件事,你自己为什么要去卷呢?
自然,要说为了保持高绩点,奖学金倒是其次,重点是有保研机会.
那么你为什么要保研呢? 是真的有自己的目标院校或者目标导师通过保研才能选上吗?是觉得自己能撑过高考却撑不过考研吗? 或者说连自己是不是真的想读研究生都不知道呢?
如果你和我一样觉得本科的课程都已经崩溃了,大多数比赛也都是社交工程,面子工程,豆腐渣工程,那为什么还天天痛苦的去上早八,去花大精力修饰ppt,去思想必修课上卷发言,还要看着大师们用不成文法的语言讲授着过时已久的ppt.
如果反过来想,不考虑保研,而是奔着工作抑或是考研去,是不是本科的前三年就轻松多了,所有课只需要保证最基本的出席率,大多数时候都不必勉强自己去上课,只需要本着糊弄的态度去完成那些没有技术含量的作业,只需要在签到之后从后门悄悄溜出教室,一周满打满算可以剩下六天的自由时间.
如果有了这么多空闲时间,我想只要不是病入膏肓,是不会整天整夜去打游戏的,相反,你轻松摆脱了那些上课的垃圾时间,不再是什么碎片化学习了,而是有了一整块的完整学习时间,可以去以自己的节奏深入学习必修同时也是工作所需要的课程知识,这一定远比跟着老师走的效率高上好几倍,那么期末周的时候你只需要搞懂那些教材上多出来的陈旧的概念就可以了,而基本的大框架你早就学会了,这想必很难挂科吧.
即便这样,你还是能剩下很多时间,深入学习自己感兴趣的知识,去看演唱会,去挑战自己没试过的娱乐,去参加那些真正有技术含量的比赛,去应聘工作日也要出席的日常实习,去体验你应该有的青春生活
实际上,你相当于比同龄人多了好几倍的学习时间和娱乐时间,对于计算机专业来说这是非常可怕的,你可以精通多个前后端技术栈,可以真正从底层了解系统内核和网络通信,可以信手拈来网络安全原理和常见IO算法,可以自己去写几个有技术含量的开源项目或者参与到大型开源项目中.这到了春招暑期实习和秋招入职面试的时候,是远超出其他面试者一大截的,再加上名校的光环加持,很容易收获自己梦寐以求的offer,毕竟面试是不看你绩点的,如果你满绩倒是能坐实做题蛆的身份😅
当然,如果你选择考研的话,那还是老老实实做一年题吧,但考研也是不看绩点的,即便你绩点爆炸又如何呢? 虽然我很难理解不做算法岗还要读研的同辈😃,如果有自己的考量倒是另说,倒是看见过不读研进入算法岗的博客帖子.
这个时候又有人要说了,“大环境不好,你光读个本科以后怎么办”,那我只好把一般的招聘条件贴上来了:
| |
| |
| |
事实上绝大部分工作是不卡硕士学历的,(虽然有些岗位本科要求211,985也比较卡学历了),而要求硕士学历的基本都是算法岗的,而且都是新兴企业. 总体来说,如果不是铁着头要做算法岗,非要冲所谓高薪的话,反而是本科就业更好,因为很多岗位反而有"三年以上工作经历"这样的经验限制而非学历限制.
而更为实际的是,读了研还不能找到满意工作,或者被大厂看不上的人也不少呢,当然这些他们就不会特意去了解了.
当然,又会有人说,“你这只是个例而已,再说程序员又不稳定,还是考研后进体制内好”,自然我举的例子都是个例,你了解的例子都是全面的了.话又说回来,体制内当然好啊,喜欢体制内的一般人自然会自己去不用你说的,但谁让我是二般人呢,不甘愿自己所学的知识就这样被埋没在连低级AI都能处理的CRUD里,就这样把鸡蛋装到一个所谓安全至极的篮子里.
后悔的是我到了大二下才有了上述的这些体会,要是大一入学的时候就能有这些经验的话那我早就起飞了😇,不过走错的路并非是对自己的否定,更多的是教训和经验.
ChatGPT大失败(3/10)
现在GPT开始搞内部wiki,并且大幅度给免费版降智了,就连luogu的黄题都不太能搞得定,还总是输出垃圾文字和不存在的文献,可能是更改战略打算像Claude一样面向高端付费用户吧
即便是最近降智的Gemini也更好用一点,而Grok更是非常擅长查找资料和总结文献,所以,我决定彻底抛弃gpt

- (3/24) Gemini终于把复制选项单独列在下面了…
外文文献并非就比中文好
如果你不是很熟悉英文阅读,那么在读英文文献的时候你一定会逐行逐句的仔细阅读,不然你就看不懂了,而读中文文献的时候由于大多数句子一扫而过就能看懂,正常人不太会对某一个知识点看上太长时间.
所谓的英文教材精炼详细,只是因为你花了更多时间在阅读和思考而已了,未必是教材本身写的有多好,我见过太多看似详细其实是废话太多的外文教材和文档了.
事实上,如果去看中文翻译版的话,即使翻译质量再怎么差,花上与阅读外文同样的时间去扩展阅读,收获一定会大得多.
至于讲座视频更是如此,之所以说看国外讲座学的更好只是因为你花精力去理解英文了而已,同样的时间你花在看教材上我想会有用的多.总不可能米国人人都是至圣先师,随便一句都是金口玉言吧,低质量的讲授才是常态,随便一句话或者一页ppt就让你醍醐灌顶那只能说明你本来就啥也不会,不如好好看文献.
- 补充(3/22): 我错了,遇到垃圾翻译时中英文版本夹杂着看的话,可以实现既能一目十行,也能深刻理解
建议学生只用AI来打杂
我身边有不少人用AI来应付比赛和项目,费尽千辛万苦调试出一个勉强能过关的APP或者网站.但事实上这样啥也没学会.与其让AI去修复一个AI生成的大杂烩,不如靠自己的所学知识去排查异常,只有这样,才能真正的学到东西.
当你想学习一门新技术的时候,最可怕的就是问AI来它来手把手教你,事实上,AI所作的只不过是去查文档,然后把它破碎的理解喂给你而已,得到的知识远不如自己去看文档来的有体系.
英文翻译(3/17)
我认为中文的优点在于句式变换多样,能够以最少的字符表达出最多的意思,通过各种同义词和同音词实现独特的诙谐语感,需要读者从深层次理解句法的内涵,在文学领域是别领风骚的高端语言; 而英文则相反,以尽可能多的字符来表达足够精确的意思,这注定了英文句子大多是枯燥无味的,但是由于英文的表意精确,用语地道,从而在学术研究中占据了统治地位.
那么这样看来,广传的翻译原则"信,达,雅"其实是有道理的,“信"意味着能够真实反映原文的意思,“达"意味着好理解,可以让普通人也能看懂,“雅"意味着足够优美,能够体现出汉语的独特美感.
很可惜的是,在我看过的用中文翻译英文的学术文献中,很少有真正能实践这一点的,大多数译者都是硬着头皮把原文中的分词或者定义对照着词典一个个敲出来.如果自身不是技术专业的话就别来翻译技术类书籍啊(我不了解翻译界,或许有硬性指标之类的吗),但如果自身是技术专业还翻译成这个样子,就有点过分了.
批判用例
这些CPU执行时间已大量测试过。虽然它们随进程和计算机的不同而变化很大,但是它们的频率曲线类似于图5-2所示。该曲线通常为指数或超指数的形式,具有大量短CPU执行和少量长CPU执行。I/O密集型程序通常具有大量短CPU执行。CPU 密集型程序可能只有少量长CPU执行。对于选择合适的CPU调度算法,这种分布是很重要的。
尽管勉强能看懂,但这个名词翻译确实很离谱,看看原文:
The durations of CPU bursts have been measured extensively. Although they vary greatly from process to process and from computer to computer, they tend to have a frequency curve similar to that shown in Figure 6.2. The curve is generally characterized as exponential or hyperexponential, with a large number of short CPU bursts and a small number of long CPU bursts. An I/O -bound program typically has many short CPU bursts. A CPU-bound program might have a few long CPU bursts. This distribution can be important in the selection of an appropriate CPU-scheduling algorithm.
首先这个The durations of CPU bursts翻译成CPU执行时间,是动了一点脑子的,但是完全没有体现出周期的意思,翻译为CPU周期长度应该会好一点.
这个"不同而变化很大"够吐槽了,直接翻译成"随着…不同而不同”,我想才像一个正常的中国人的思维,没必要非要代入副词.
exponential or hyperexponential能翻译成"指数或超指数"也是无敌了好吧,翻译成"指数级或者超过指数级别的增长速度"我想才对,如果原文很难翻译,你倒是加一点副词啊.
short CPU bursts翻译成"短CPU执行"你自己不会笑吗? 我不得不怀疑译者真的系统学过英语不,直接翻译成"短区间"就可以了,在有上下文的环境,读者很容易理解这指的是cpu执行区间.
总结
翻译英文的时候你就应该用中国人的思维来看原文,用中国人的想法去理解原文,在保持大致意思的情况下尽可能的还原中文的语法结构才是最重要的.
AI取代程序员(4/1)
尽管很多人(包括程序员)都在说工作会被AI取代,但鲜有人真正懂得LLM的基本原理,只是看着AI输出一大段代码或者信息后就开始附和媒体的喧嚷,也给了大厂借着AI的名义大幅度裁员的机会.
我的意见是: What the hell?
到底是哪来的自信让你能够轻易的对一个自己一无所知的领域下判断的?如果你自己连LLM的原理都不清楚,那么你又怎么能知道它具有成长为包办一切的神器的潜力?是谁告诉你的?最会见风使舵的媒体吗?
至少,我是没看到有真正在这一领域精通的大牛站出来信誓旦旦的说: 我保证它可以解决所有的代码难题!
我想,在大学实验室里看到的那些大模型炼丹师,未必与闭源大模型的开发者有多大的区别.如果生物领域连大脑的运作机制都没搞明白,那又怎么可能通过普通的数学运算就精确的模拟人脑的认知呢?
LLM目前就只是一个概率模型而已,直到泡沫破裂了,才会有优秀的人才去探索更为实际的研究方向,才会有真正的进步和突破.
某code源码泄露(4/1)
 谁看到这个图能不笑🤣,可惜不是在今天泄露的,不然更有乐子了.
- 不许你们再说小龙虾的star是沽名钓誉了🤢

- 第一次见fork数量比肩star数量的,也是唯一一个fork数量逼近百万的仓库
文档学习法(4/3)
最好的学习方法就是去阅读一手的文档,而不是去看二手甚至三手的博客教程.
毕竟官方文档的撰写者一般都是该领域的大牛甚至是作者本人,他对这个领域的了解程度会远远超过我们这些初学者.
而二手的博客教程一般都是作者在经过了自己的处理之后再片面的告诉你,很难做到十全十美的程度.
官方文档写的好不好,有没有及时更新或者维护,更是判断这个技术的生态是否足够好的硬性指标之一.
数据库小测(4/8)
- (4/7): 明天就要小测了,但还是没有一点底…不过心态还是要放平,我有预感这次小测会带给我一点启发或者冲击.
这次小测确实有点过于逆天了,我以为不会考的procedure和trigger各考了一个11分的大题,关系代数也考了一个10分的大题,而这三个部分我都基本上没怎么学… 看来下次小测和期末要认真一点了,不然真要挂科重修了.
以人文的方式去学习技术(4/14)
现在,我在学习一门新技术之前,总是倾向于先去了解这门技术的演变历史,创作的背景和社区的现状,只有这样我才可以判断这门技术值不值得学,好不好学,需不需要学.
因此,我不再是像以往那样看到一个新名词,直奔AI了解大概意思,看一点二手博客就企图直接上手了
相反,我会通过wiki和官方文档去深入了解这门技术的历史,接着阅读官方的教程说明和社区的最佳实践(Github仓库/教程案例),从而逐渐掌握这门技术的基本操作,最后再去实战和根据AI边问边学.
这恰好对应了人文学科的学习方法:先是了解一门学科的历史,再接着了解这门学科的主要代表人物,然后理解该学科的主要研究内容,最后学习该学科的现代演进和实际案例.
我想,这种学习方法才是最适合技术人员的学习方法.
博客是为了自己写的(4/23)
博客是为了自己写的
大多数博客的大多数文章都只是自我发泄而已,我们装作自己很优秀很清醒,发布各种各样的技术笔记和人生阅历分享.但实际上这些内容没多少经得起推敲的.
你的人生阅历分享终归是个人的问题,很有可能掺杂了大量的私人感情和不可重复的性格印记,是无法复刻的,也不能从中学到什么,只能用垃圾情绪去感染读者而已.
你的技术笔记大多是破碎的,凌乱不堪的,草草了结的,远不如官方文档和书籍有体系,反而是在搜索引擎里增加了垃圾资料的权重.
抛开这些来说,博客仅仅是一个技术人灵魂的呐喊而已,他想要被人发现,被人称赞,被人尊敬;他想要宣泄悲哀,宣泄愤怒,宣泄无奈;他想要升职加薪,事业顺利,生活美满.
真正优质的博客是与你平起平坐,促膝长谈的;是能够让你幡然醒悟的;是能够让你真正学到优质知识的.可惜的是,这样的博客很少很少.
博客是为了自己写的,读懂了这句话,你就很少会去看博客了.
当天晚上的思考
我觉得为了贯彻上述的说法,还是把之前我自己写的劣质文章通通删掉来个整合吧. 本来是想留着警醒我自己技术不够好的,但确实一点都不够看,质量都很低,也没必要留着了.
重构之前:

重构之后

计算机领域没有一条固定的道路(4/29)
尽管标题是这么写的,但实际上很多技术都是有着先后关系的,比如说要想学习Agent搭建和优化,就必须要学会Transformer的具体原理,要想搞懂Transformer,就必须要先学会Pytorch,要想学会Pytorch,不仅要先会Python,还要搞懂神经网络,要想搞懂神经网络,就要先会统计学和线性代数.
再比如说搞全栈开发,如果你采用Next.js+Python fastapi框架,那么光是前端里你就得先学会React的JSX语法,要学会JSX,你得先学好ES6的基本语法,如果想理解好JSX,你就得去学习Html和Css;至于后端,你得掌握fastapi的先驱者flask才能更好地理解fastapi;你得掌握sqlmodel的先驱者SQLAlchemy 和 Pydantic才能更好的使用Sqlmodel中的ORM映射和数据规范;至于数据库,网络通信和安全校验,需要懂的前继知识就更多了,就不列举了.
不管怎样,我举了上面的两个例子只是想说明一点: 大多数计算机领域的技术都不是一蹴而就的,而是吸收了先前技术的精华并加以改进后实现的.
你当然可以直接上手最新的技术,但很容易被各种高级语法和抽象概念搞得晕头转向,这是很自然的事情,因为这些新技术的创始人都对原本的老技术有着非常深刻的理解,所以他们能够取其精华,去其糟粕;但对于二者都不了解的新人来说,由于这门技术是建立在先前的老技术之上的,技术壁垒更高了,所以直接入手新技术反而更不好理解,不如先通过学习旧技术再逐渐接触新技术.
但是,这又回到了这段感想的标题了: 计算机领域没有一条固定的道路,很多时候我们都是误打误撞闯进了一个新的领域的,我们可以去看二手甚至三手的博客教程跟着学,也可以看着最新技术的相关文档跟着学,还可以看着B站和油管上的视频教程跟着学,即使这门新技术再怎么难懂和抽象,总是会学到一些东西的,只有在真正用到这门技术,需要去深究背后原理的时候,我们才会惊觉自身技术储备的不足,回头再去接触它依据的基础技术栈,即使这样也完全来得及.
说了这么多,我想表达的就是,尽管去接触和学习吧,就算你对某一门技术的了解是模糊的甚至是错误的,但总有一天你能找到正确的答案,不管是无心的还是有意的,只要一直在学习,我们总会进步,在计算机领域,从来没有一条固定的道路.
技术学习法2.0(5/7)
最近我发现,除了啃官方文档外,阅读专业书籍通常是一件更为有效的方法,只不过你需要时不时地看点项目或者做点项目来练习,避免纸上谈兵,简单说来可以分成这样的流程:
- 初入该领域时找到该领域最经典的入门读物
- 入门之后再去找能够实现自己需求的框架或者项目
- 发现有自己一无所知或者不太了解的地方时,转向官方文档或者一本更加深入的技术书籍
- 学习吸收完技术书籍的精华和项目精华后,试着自己去实现一个更简单的demo版本
- 如果上一步又出现问题了,说明你还是没有彻底搞懂,需要去看更多的项目和书籍
当然,前提是你有一定的编程经验和基础,如果你对计算机知识一无所知,那这条路径就不太适合了.
这也是让我羞于继续写编程笔记的原因,我本人只是一个小白,对于技术的了解都非常浅显,很少有自己的独到理解,远不如去看一些经典的书籍.或许我可以这么写笔记:
- 该技术的历史和基本作用
- 用经典的书籍推荐来代替我本人的梳理
- 加入我本人的实战环节和重难点分析
似乎这样的效果会比较好一点.
技术文章撰写(6/19)
现在我发现,技术文章的最佳结构是这样的:
- 背景和原理介绍
- 具备完整功能的代码+注释
- 重难点解释
比如我最近正在看的crafting interpreters一书,这本书前面的背景和原理讲的非常好,但奈何在实现解释器和虚拟机的部分将代码拆分的不成样子,尽管作者已经尽力把概念讲的很清晰了,不过读者可没有像作者那样的完整视野,根本无法将所有的知识点一一精确掌握.所以很遗憾的是,我只好放弃看书转而去看源代码了.
- 真看到源代码时我就立刻放弃了,因为确实看不太懂,另一方面也在于我还没必要了解这么深…
大家都喜欢架构规划,逻辑清晰的代码,但当这样的代码被分开成几个逻辑割裂的小段落时,阅读起来就相当难受了.
大多数作者都喜欢摘抄一段代码,附上一点解释和评论,然后继续摘抄代码,这种写法固然是出版书籍的无奈之举,但可读性实在不怎么样.
不过话虽这么说,想要实现我说的这种效果还是很难的,不过对于博客文章来说或许比较简单.这一点我最为钦佩的就是fastapi的教程了,尽管fastapi教程的每一部分都是单独的对一小段代码进行讲解,但它也会在旁边不厌其烦地一次次附上完整代码,从而让读者不会丢失对整个代码全貌的了解.
或许可以弄个分屏的页面,左边是自己的解说,右边是可以随时滚动甚至跳转的代码块,这种设计应该效果会很不错.
是时候做点真东西了(6/22)
在看了几十本经典书籍后,突然发现市面上的绝大部分技术书籍都入不了我的眼了.或许,我可以坦坦荡荡地说,我的理论基础已经够扎实了,无论是底层的处理器架构,操作系统,还是高层的RAG智能体与网站开发,我都有了一个比较清晰的全局视野.
现在需要的并不是看更多的书,而是去实战,做一点真正有用,有趣的真东西出来.
目前我的想法是先完成之前的智能体,然后再重新把爬虫捡起来,之后再试试C#,Java,Kotlin和Golang的开发效果.至于读书,可能只会聚焦于一些更专业的领域和实战类,历史类书籍了.
无缘Spring(6/25)
找了很多本关于Spring框架的参考书和教程,却没有一个能够从基本概念开始讲的,至少告诉我Bean是个什么东西也好,可是不,这些书非要从一大堆注解开始讲,我相信自己也没那么笨,但就是看不懂他们在讲什么,既然你的生态如此糟糕,那我想也没必要再去学了,待有缘再会吧.
26下
还没成熟(7/3)
在阅览计算机历史的时候,我忽然意识到程序员实际上是一个相当年轻的岗位,甚至可以这么说,还远远没有开始成熟.
我们可以仔细想一想,POSIX,Cpp这些我们以为的老古董也不过诞生于40多年前,Linux,Python,Java这些我们习以为常的伙伴诞生于30多年前,而如今席卷全球的AI浪潮所依赖的核心技术Transformer也距今不到十年.
大多数老一代的程序员精英和计算机顶尖科学家都还在世,如设计C语言和GO语言,开发了UNIX的传奇人物Ken Thompson如今也不过80岁,所谓的AI三巨头,和他同时代的还有AI教父Geoffrey Hinton,而他的弟子如Yoshua Bengio也不过60岁,正是大展宏图的年岁.
中文互联网的知名程序员则更为年轻,如扛把子的阮一峰是70年代生人,而23年遗憾逝世的左耳朵耗子当时也才不到50岁.再看看内地的互联网公司,很多企业的老板都还是第一任呢,至今都没变过.
由此看来,唱衰计算机是没有任何道理的,这个行业甚至都还没有成熟,又何谈衰败.甚至可以这么说,计算机是创造力最丰富的岗位,没有之一,人才密度也是最高的,所有传统行业都或多或少地与计算机相关,或者拿计算机来包装自己…
意外的事(7/11)
明明都放弃继续深造的事了,绩点却上升了是怎么一回事啊,以前从来没u过的思政课也拿了优,草草复习的计网和操作系统也都拿了u,尽管万恶的数据库和算法课还是良,但照这个势头下去,难不成有保研的希望吗,还是饶了我吧.
颓废的自我(7/16)
不知道怎么回事,最近两周提不起劲去学习,无论是写智能体,还是读书,都没有以前的那种干劲了.
或许,每天干相同的活儿也是容易疲倦的,多一些任务,多一些挑战,人才有动力去往前冲.
为了实现这个目标,我想目前只需要做到一件事:
- 保证每个星期都能有一个全新的学习目标或者开发任务
如此一来,应该会有多少不同吧.
多读几篇论文(7/19)
读了这么多论文我也发现了,我确实适合当工程师而非科学家,我更感兴趣的是这些论文能不能派上实际用场,如何使用,只要知道技术背后的基本原理就可以了,至于底层的数学逻辑我是不敢去碰的.
所以,想要知道自己适不适合做科研,就多去读几篇论文吧.
被卡脖子了(8/4)
最近的节点特别不稳定,忍痛割爱了使用时长将近两年的Flyingbird,先后转向了赔钱和蜻蜓,遗憾的是效果都很不好:
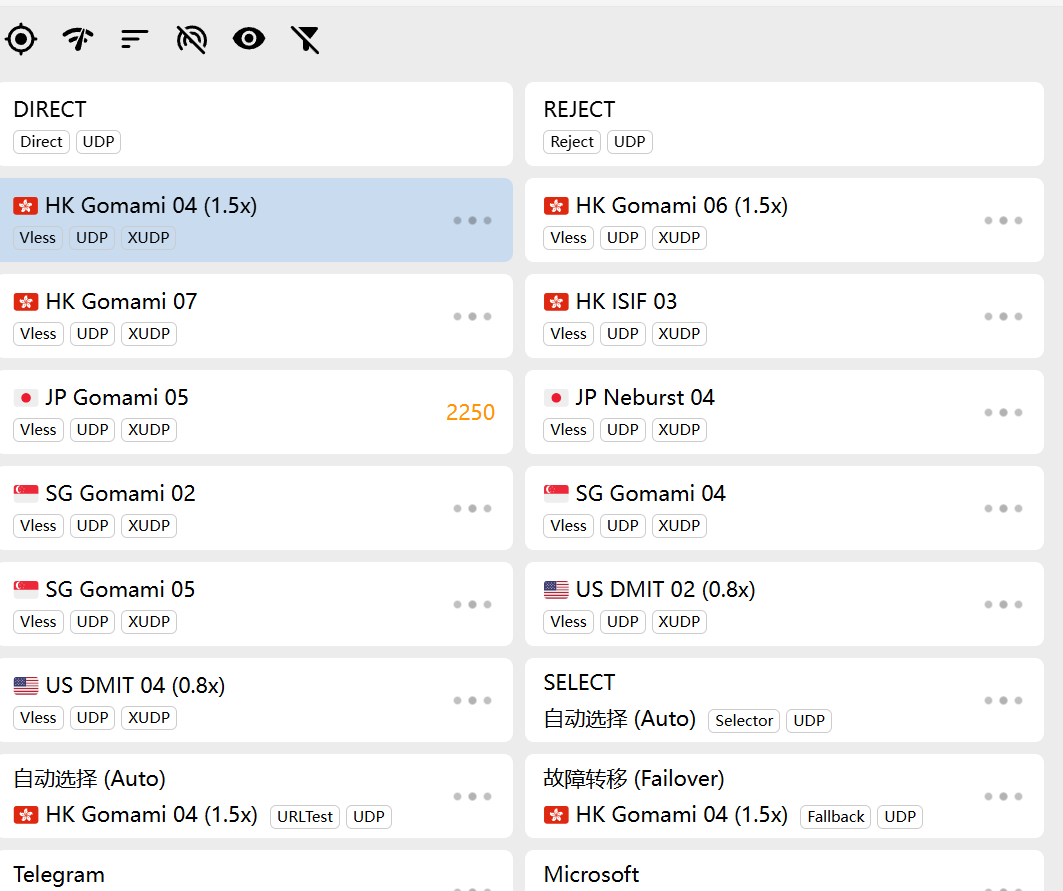
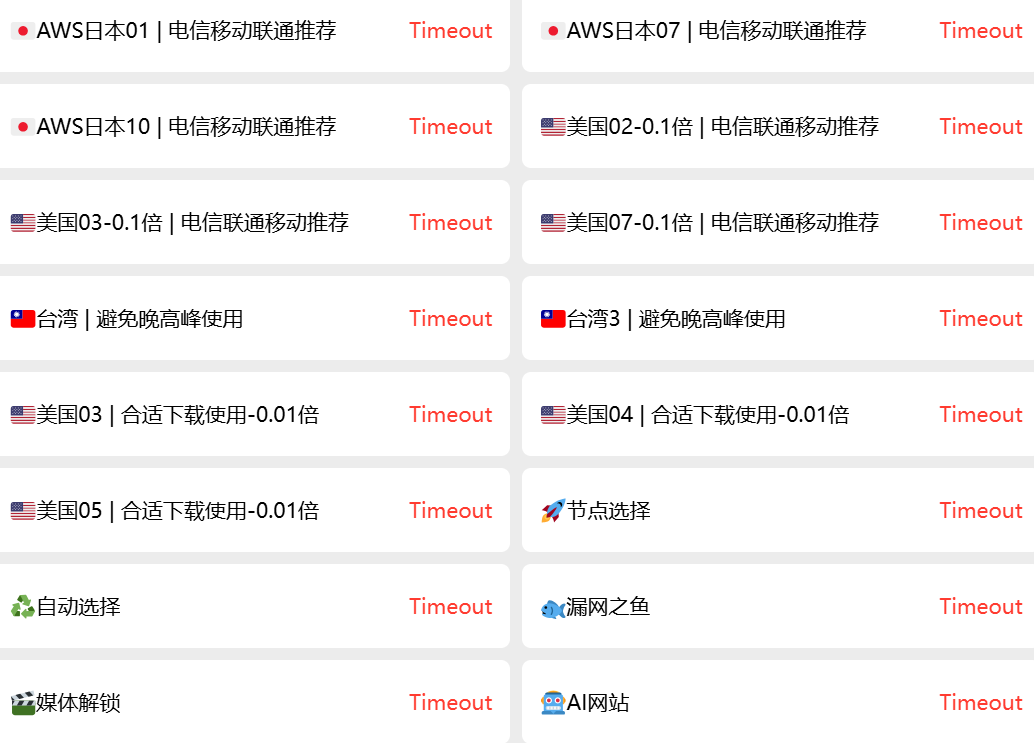
赔钱是真的便宜,而蜻蜓比Flyingbird贵了一倍,但这三家都是时断时续的,大多数时段根本用不了一点,这让我这个时常需要用到AI和Github的普通程序员非常难受,就算不用AI自己搞项目,可是下载依赖项还是需要用到节点,总而言之,基本学不了一点,这可如何是好.
不过,这样也就能体会到多年前那些程序员的悲哀了,在没有可靠消息渠道的环境下,很难说能够紧跟时代潮流,只能靠自己去努力钻研公司内部的老文档,但这种遭遇我可不想再经历了,因此,或许要试试其他的方法了.
我要找什么工作(8/9)
半年前我还对自己希望找怎样的工作感到无比迷茫,但现在我却能够基本下定决心了,基本的目标为APP/Web的后端/架构方向,实际上来说,我对架构和团队管理方面最感兴趣,能够成为一个独当一面的架构师是我这几年的最终目标.但我想怎么也不太可能让一个新人去设计架构吧.
所以我想,只要是后端开发相关的岗位,而且条件很好,要求很高,挑战性很足,那我就会直接跳进去了.至于相关的知识,随便列举一下就知道了:
- 某一门主流语言: Python/Golang/Cpp
- 实话实说,对于Python我是非常有自信的,应届生中敢说比我基础还扎实的不会太常见.
- 基本架构知识: Docker/Kubernetes,OpenAPI规范与gRPC规范,主流消息队列如Kafka和RabbitMQ,主流搜索引擎如Es
- 目前还在努力中…
- 基础知识: 操作系统和计算机网络,基本的数据库数据结构,主流数据库Redis,MySQL,PostgreSQL等
- 这方面的知识我不敢说全部精通,但我有自信能够超过绝大部分人.但真到面试的时候就可能全忘光了😇
- 运维相关: 基本Git,CI/CD,主流监控与日志工具
- 努力中…
- AI相关: 这年头简历上不加点AI是活不下去的,如智能体基本原理,手撕Transformer,RAG和MultiAgent.
- 目前这些知识还在储备中,也是我下半年的努力方向.
AI帮帮忙(8/21)
一没竞赛,二没论文,如何能在面试中脱颖而出?唯一的路子就是靠项目了,只要项目吹的够牛逼,而且面试时能水过去,自然就能找到一份还不错的工作,但至今为止,我连一个能说的过去的项目都还没彻底完成,只好让AI来帮我出主意了:
- 企业级Agent,包括RAG和Tooling
- 高并发交易系统,使用Redis和MQ实现分布式事务
- 对象存储系统,实现文件上传,断点续传,Range下载
看着还说的过去,可惜的是我全都一头雾水,不知道怎么下手,对于新人来说要短时间学会这些还是挺难的,只好乖乖看书了.
走自己的路(8/23)
我发现一旦想要与众不同,走点特殊的道路,就会特别心累,比如说本科就业,固然,和大多数人一样随波逐流,考研读博,最后考公入职,是一条异常清晰的就业道路,可以这么说,几乎不需要动脑子,按部就班的刷题,刷论文,再刷题就结束了.相反,在当今这个时候选择以本科学历进入互联网企业,根本看不出有什么光明的前景,压力很大,路很难走.
但也没办法,走自己的路,就要付出对应的代价,无论前方有什么在等我,我都欣然接受.
原神体验(9/12)
今天作为主讲人,原汁原味的体验了一下原神的冲击,确实名不虚传,说的每组最多二十分钟,但基本上每一组都是三十分钟以上,甚至还有四十多分钟的.
原因当然不是这些组拖沓,光讲个ppt,演示一下功能,能要多少时间,问题在于,原神会提问,问的问题都特别主观和蛮横不说,而且问题多,可以不断追问,直到找到一个漏洞为止,需要让你承认自己的考虑不周全,或者代码有错误.
一旦你觉得她的说法过于武断或者伤自尊了,也千万别顶嘴,不然那些四十多分钟的答辩时间哪来的.
当然,我们组的答辩也非常不顺利,但主要原因或许还是我没考虑到要弄一个数据库在线管理系统,导致用docker部署后看不到远程服务器上的数据.
说真的,部署一个adminer是非常简单的事,遗憾的是,直到答辩当天我才根据前几组的答辩情况得知有这回事,除了我们组之外都不用docker,而是裸机数据库,自然有数据库文件了.
而这也作为她有资格破口大骂的依据了,一个组十个人都要被她一一问候到,用这种伤自尊的方式来抨击学生,很难说是一个老师能干出来的事.即便是所谓的压力面试和群面,实际氛围还是比较温和的,毕竟不会就是不会,日后学习就可以了.
但在原神这里,光认错还不错,必须羞辱你一顿才算了事,很羞愧自己学校能有这么一个老师,还成功当上了教授.
不过,日后来看,顶多作为一个笑料而已,过去的事就算了吧.
变强(9/23)
每次看别人的博客时我都会自惭形秽呢,有的拿到了百度之星金奖,有的几十次面试没有挂过,有的把技术钻研到了一个可怕的境界,远远超出同龄人的平均水平.
而我呢,既没有能够说的过去的竞赛经历,也没有能拿的出手的项目,而现在离实习面试的时间也没有几个月了,任务很繁重啊.
不过仔细一想,我正式开始入门程序员的世界也不到一年呢,还有那么多的经典技术栈和新技术栈没接触过,一点点学习下去不就能变强了吗.
Agent探析(9/30)
这年头要找一个企业官网或者标杆APP里没AI的太难了,这是在AI时代的无奈之举,就算用户不怕麻烦切换页面去跟专门的LLM App对话,但总归是少了一些这个APP内部数据的,对话起来就差点意思,借此总可以留住一点用户.
Agent发展到现在也才两三年,就已经形成了一条比较清晰的发展产业线:
现在的问题很简单,这到底是不是可持续的发展?Agent在可预见的未来又会变成什么样子?
很明显,这对一个普通学生来说,是一个无解的答案,只能尽量去猜测和怀疑.毕竟Agent这个东西太新了,新技术和新架构层出不穷,完全没有稳定下来;又太颠覆了,威胁着明明还没完全成熟的传统互联网岗位.
以我的拙见,至少在未来的二三十年内,是不会有所谓的天翻地覆的改变的.
就算AI再怎么发达,成本再怎么低廉,政府也不可能颁布一个法令说: 废除传统学校,全民改上互联网学校.就算是最激进的政府当职,最多是在初中及高中部加一个AI学科(没错,直接叫AI学科): 先教什么提示词,介绍一下零代码平台,然后用AI造网站,体会AI的伟力;进入高中后,先将线性代数迁移到高中来学,然后介绍一下AI的基本原理,说不定期末考试还要考你写一个卷积神经网络(说真的,略微懂一点线性代数就够用了,不要你做矩阵求导就行).而大学学科里与AI结合的学科只会越来越多,相关的教职和期刊数量也会以可怕的速度上升,开始全民大炼AI的旅程,毕竟学术就是追逐热点而已,什么热门不就研究什么嘛.
而架构有了突破,Token成本下来之后,大多数小型的AI公司一定会倒闭萧条,高端人才被收编,因为大公司有的是钱和人力,不但利润火速上升,而且成本下来后终于可以少花点钱在研发上了,能够迅速扩张市场,而这也不会一家独大,最少是有三四家公司呈现多国鼎立的局面.
而无论国内外,到了最后,肯定会有政府下场来统筹收编,做一个国家支持的算力中心平台,让所有AI公司都通过国家平台来进行算力调度.至于为什么?木秀于林,风必摧之,银行和财团在政府面前是能说得上话,但对于技术公司来说,你不太可能有什么政治背景吧(某家公司除外).最著名的就是80年代盛极一时的AT&T,可以说是世界第一技术公司,依然被拆分的不成样子,给了无数小公司崛起的机会.
而这也很好理解,越是先进高端的东西,越容易被归纳到战略的范畴内,即使我们目前都在讲算力平权,人人都能用AI,但就目前的国际形势来看,以后的Token一定是按照地域来划分的,既可以通过差价来进行打压,也可以通过封锁来实现隔绝.只有通过国家统一的统筹,才能做到地域粒度的限制,说不定还要设定一个什么AI法令,严禁提供API key给其他国家的人员,或者说,直接将个人AI账户与身份证绑定.
所以,未来一二十年,Agent岗位一定是越来越热门的,而除了基座模型研究之外,基础的Agent岗位和学历是没有一点关系的,毕竟调个API还要懂Attention切分就有点过了吧.
分析到现在,未来AI发展的历程已经很明显了,Agent企业和政府一定是不断加强合作的,AI将深入结合到办公和个人生活中,对于传统岗位是会有冲击,但也只是精简人员和缩编而已,不过就算这样也足以形成下岗潮了.
但这一切都是建立在自身相关知识扎实的情况下的,毕竟如果你自己都不懂,如何知道AI做的对不对呢,如果你说我不管,我再怎么学,AI也做的比我好,那你自己滚一边去吧,让AI把你的岗位取代不就行了.
所以,就算是所谓的AI纪元,基础知识仍然无比重要,反过来说,越是依赖AI,越没有真本事,在AI时代就会过的越惨.
不过,上述也只是看到了LLM带来的变化,更为惊心动魄的则是具身智能和机械智能带来的改变,而由于我没有相关的知识积累,所以完全想不到十几年后它们又会带来怎样的惊涛骇浪.所以,这也是我之后希望重点学习了解的目标.
忽然想到(10/6)
不得不说Agent极快的扩充了生产力,照理说给了我们无限的创业机遇,能够帮助牛马们解放双手,但是有一个非常严重的问题:
资源是有限的
Agent能够加快生产是真的,但是却不能增加岗位,反而在削减岗位,而普通人无论如何努力,终归是要和别人竞争越来越少的高端人才位置,那么那些竞争失败的人呢?自然是往低处走,但当这些下游的岗位也被Agent和机器人占据了又要怎么办呢?就连扫地都要让扫地机器人来做,外卖也有外卖机器人了,那么剩下的这些人该何去何从?如果连上一代的遗产也消耗殆尽,连家乡的土地都被严密管控,就算想要回归山林也无处可去,那么到底还剩下什么?
我根本看不到有什么好的解决方案,尽管我们这一代人还不是特别明显,毕竟三线城市之下的缓冲区都还在,就算在大城市打拼失败也能回家考个小岗位,但日后的竞争一定是日益加剧的,那么只会剩下一大批的无业游民,就算生育率下滑,但架不住还有着从00年至10年的这一批积累啊,如果生产力发达到了不需要这么多人力的时候,那么这一次的矛盾又该如何转移?唯一想到的两个法子,比较简单的就是和哪个国家签订条约,弄一个开发移民,和以前的法子一样,但最可怕的可能则是…
30年-40年一定是社会的最低谷,是一个不是天才就会被归类为废才的时代.而我们的解决方案也很简单,拼了命的提升自己,做到行业的前10%,才能勉强生存下去.
一招鲜(10/6)
从网站开发到底层架构,一切都可以用两个模型来解释,Server 和 Client.
Client负责提要求,Server负责完成要求;Client负责发送消息,Server负责接收消息,这可以直接涵盖以下的所有情况:
- 网站/APP开发的前端用户交互和后端API
- 消息队列的Client和Server
- 数据库的客户端负责接收和包装用户操作,执行引擎负责执行该操作
- Nginx的客户端负责接收流量,Server负责反代流量
- Docker的客户端负责接受用户命令如
docker ps,服务端负责管理,值得注意的是,这还是通过REST实现通信的 - Root用户向Linux内核发送请求,内核负责与文件系统和磁盘交互.
再列举下去就没完没了了,不过这个模型建立其实是一个水到渠成的过程,当服务很简单时,我们甚至可以塞到一个文件里面,但等规模增大时,我们就需要拆分,但却必须要在拆分得到的两个或者多个服务之间保持沟通,也就是存在数据的流动,那这就存在一个收发的不对等关系,也就可以划分成Client和Server模型.
如此一来,我们对计算机和网络的认识就瞬间变得清晰了,大多数应用都是通过收发消息实现的,如果你只需要用到这个应用,那就只学Client就行,如果需要深入研究甚至开发,那么就要学习Server部分,我们平常对某个技术抱有模糊的感觉时,那就是因为你没有关注Server部分的实现.
阶级固化的可能(10/13)
我一直认为,阶级固化并非那么复杂的东西,最直观的指标就是选择权的大小.
从历史沿革至近代,是阶级固化最明显的时候,农民/奴隶几乎不可能有任何的上升空间,除非基因突变给了你一个最强大脑,来一个范进中举,否则一辈子只能是务农而已.
而鸦片战争-民国建立,尽管是说变成了半殖民地半封建社会,但实际上底层人民的地位并没有任何改变,能够在历史上留名的无不是传统的贵族/地主阶级,就算是所谓的太平天国,除了杨秀清,萧朝贵是贫农出身外,其他如石达开,韦昌辉等依旧是地主或者富农,而洪秀全好歹是有资源能够长期参加科举的,不是完完全全的农民.
至于民国时期,阶级同样是固化的,有资源/消息渠道进入城市读书的依旧是少数,上个大学还要推荐信,发表文章要走关系,底层其实没有任何改变,农民一辈子就是农民而已.
而建国是对上层的一个大洗牌,毕竟该跑的都跑了,该处决的都处决了,急需大量的新鲜血液来补充管理岗位,即便还是优先找的旧时代知识分子和自己人,但已经是阶层跃升最简单的时期了.之后就不说了.
而在改开和户籍制度变革之前,情景并没有什么改变,跨省的人口流动是NG的,老老实实种地即可,而就算鲤鱼跃龙门,考入XX大学,仍旧会在被分派的工作岗位所在地滞留一生,而想要回家探亲或者旅游?走流程去吧.
上海市民政局刊载的一篇历史回忆就记录了1970年代知青外出看病,需要先提交医疗证明、申请住宿介绍信,获得领导批准后才能成行的经历。
其实改开时期确实是阶层固化被再次打破的黄金时期,出现了人口流动的狂潮,尽管大多数好处流回高处,地位越高收获越大,不可否认的是也有少数工农获得了第一桶金,并能够福泽后代.
而现在的问题是,福利和高等教育普及之后,阶层固化是逐渐严重还是逐渐缓解?
要想看的更清楚,就要拿日本来做个对比,看一下东京大学石田浩对各个历史阶段25—64岁男性的阶层分析:
| 指标 | 1995年 | 2005年 | 2015年 |
|---|---|---|---|
| 子代与父代处于不同阶层 | 68.8% | 68.8% | 68.4% |
| 向上流动 | 41.1% | 38.7% | 35.6% |
| 向下流动 | 11.8% | 14.5% | 17.2% |
尽管样本量不是很大,但也能说明一点点问题.而从基尼系数来看,是保持曲线上升的,所以阶层是在逐渐固化的.
OECD公布的2023年数据中,日本25—34岁青年:至少一名父母接受过高等教育者,72%取得高等教育学历;父母最高学历为高中或高中后非高等教育者,这一比例为43%
所以可以这么说,日本的上升机会有所收缩,既有阶层优势持续存在.
道理也很明显,毕竟穷人的机会成本就是要大很多嘛,不仅要自己积累人脉,还要考虑资金/住房等问题,哪有那么容易就跃升呢.
而直接拿中国和日本对比是不现实的,毕竟人口有个几倍的差距好不好,人口基数大有以下两个优缺点:
- 积重难返,但好听点说就是政策稳定
- 资源丰富,但与人口基数不成比例,所以竞争依旧激烈
总的来说,阶层又开始固化了,毕竟改开的福利已经被吃光了,创业的成本急速上升,各行各业的大公司根基深厚,无可撼动.普通人要闯出一片天更是难上加难,一旦失败,就只有坠落,就连务农这个亘古不变的选择也失去了.
Agent能做什么(10/18)
俗话说打不过就加入,既然不少人都认为AI能够解决低端的代码编写岗位,那么不如就找到那些AI无法自动实现的任务,从而确保自己没那么容易被取代.
从普通人的角度来看,AI的用途分为衣食住行和工作两个维度即可:
衣食住行
其实这部分简单的任务在没有LLM的时候就做的很好了,智慧导航,规划旅游行程,人机交互,智能家居,该有的都有了,但是,这些任务都是单程次的,也就是说不同任务之间无法串联起来.
比如说我让智能灯调节光线强度,直接说请调低室内光照就能解决,但我要是说,渲染一种暧昧的气氛,它就无从下手了,但是如果有一个比较正常的AI(如今的LLM都有这个水平了),我这么一说,它立马能联想到拉上窗帘,打开台灯,播放CD player里的轻柔小提琴曲,调暗顶灯这一连串动作,并指挥这些智能家居行动.要我说,这确实是一个很大的商机,不过目前更多的是硬件跟不上,而不是AI不够强而已.
再比如我们出门旅游,总是要货比三家,先找航空公司里的合适机票,看目的地的天气,决定要去的旅游景点,再货比三家确定合适的酒店,并查看是否有合适的房源,还需要看早中晚的饮食安排,交通方式,最终得到一个大致合理的旅游行程.如果是两三个人出游甚至是独自旅行,这些操作都完全能自动化的,让AI来自己筛选即可,而不需要我们去一个个自己找攻略,直接根据我们的个人喜好去实现即可,然后筛选一下AI制定的计划,就能大功告成.
上述Agent的最大阻力反而是来自传统企业的壁垒,毕竟12306可不会给你一个能够随便查询班次的API,而是要你上网站上一个个查询,携程旅行也不会开放机票的便捷查询API,更别说每个酒店的房型/政策都各不相同了.但是我想,迟早这会被统一的,毕竟只要有人先这么干了,其他人就得被迫与Agent结合,否则就会被迅速淘汰.(垄断软件除外…)
工作
无论是政府工作还是企业工作,百分之九十以上的时间都是浪费在文书和会议上的,真正做事的时间寥寥无几,造成了生产力的极大浪费和颇具特色的冗官冗员,一个流程要走上几天才能批下来.而Agent能够彻底解决这个问题,至于我们放不放心?我觉得大多数草台班子甚至比不上一个强大的Agent吧.毕竟有人就有利益纠葛和鸡毛蒜皮的小事,而Agent可不懂什么人情世故,该处理的一并给你处理了.
这部分是最难用Agent改革的,潜在的收益和风险同样巨大,所以也没听说有哪个国家敢这么干,以Agent结合的名义裁掉公务员,不然社会一定会立马动荡,爆发全国范围的抗议.
而公司由于相对政府来说体量很小,所以受到Agent的影响反而是最轻的,那些裁员都是针对个体和部分工作组的,却没有被整体取代的风险,毕竟专业的事还是要让专业的人来把关,而如果未来几年的Agent没有一个质的飞跃的话,比如我还是不敢放心让它们来写大规模架构的软件,其实光是一个小软件就已经做的一塌糊涂了…
其实所有行业中最好取代的就是那种与书本和文书打交道最多的,无论是律师还是公务员.毕竟个人的能力是不太可能比得过Agent的
总结
可以看到Agent推行的阻力更多的来自于传统行业,所以失业的风险并没有那么大,而一旦AI企业的增长出现疲态,那么就一发不可收拾了,而没人知道那是什么时候,只能祈祷自己不是倒霉鬼之一了.
整体架构思想(10/21)
最近在做Agent的时候突然发现,后端开发不是你想写什么功能就写什么功能的,而是要针对前端所需要的接口来编写,按照供应链来说,前端才是上游,我们后端只要完成需求就可以了.
其实核心就在于用户体验这四个字上面,一切的架构设计都是围绕着用户来的,思考一个架构/接口设计的是否合理,其实就是思考用户会怎么使用它,是否通俗易懂.
只要每次在开发时都想到上面这一点,很多难题就可以轻松解决了,从更高层次来说,这叫做领域驱动设计(Domain-Driven Design,DDD),如此一来,我们就不会成为那种只会CRUD的小白了.
把Agent看作员工(10/23)
实际开发时使用Agent向来是有风险的,如该案例所说,即便在配置中明确设定read-only,Codex也会自动创建Python脚本,获得工作区写入权限.
把Agent看作员工,就可以解释很多事情:
- 领导一拍大腿提出的方案,没有任何具体思路和验收标准,你自然只好去揣摩上意,但往往不尽如人意;和你用Agent却没有给Agents.md和Plan同理
- 新来的实习生不会用git,让他用你的电脑学习一下,结果checkout了你的某个dev分支,并且覆盖了几个关键的源代码;和Agent由于权限不分明,界限不清晰或者没有设定沙箱隔离导致破坏生产环境同理
- 某个同事一时兴起,试图重构一块被尘封了十几年的生产用代码,一开始运行正常,上级本来还打算给表彰,结果没几天后引起了连锁崩溃;和Agent由于没有自主性,无法识别加入/修改某块代码后,尽管能通过单元测试,但可能对整体架构产生灾难性的影响同理
- 某个倒霉的实习生由于忽视了内部文档上的一个要点,导致做出来的产品和现有架构完全不兼容,所有代码都要重写;和Agent由于上下文窗口问题忽略了某条指令,导致破坏性修改同理
并非说把Agent作为一个独立的个体,但我们可以把Agent作为员工来管理,每次给出明确的指令和界限,那么出错的次数自然就会少很多了.
软件运营(10/28)
工程师负责把软件做出来,而管理人员负责把软件运营好,实际上,最重要的是后一部分,就算一个软件写的再好,无人问津那么也无济于事,但就算一个软件做的一般,由于运营出色,那么也有出人头地的可能.
互联网历史中,每次有新的细分领域出现,无不是要经过激烈的角逐和绞杀的,最终结局要么是一家独大,要么是多强鼎立,其他的小角色是没有资格站上舞台的.在行业增长阶段,最重要的是你的产品好不好用;但到了平台期,如果大家的产品基本相同,而你的运营却出现了纰漏,即便只是一个并非特别严重的过失,也极其容易引发用户流式,进而可能导致全面崩盘.
一个非常重要的点在于,产品需要与时俱进,产品经理或者决策者需要敏锐地抓住时代潮流,适时调整软件的架构和功能,必要时可以彻底放弃这个软件并进军新的业务.
所谓大厦将倾,独木难支,如果竞争对手过于强大和热门,又或者行业政策变动带来了毁灭性影响,那么这个产品的衰败也是不可避免的,这时候的运营就真的是苦中作乐了,留住老用户和拉拢新用户都是一个非常棘手的事情.
对于程序员来说,我们要做的就是认清自己即将去做或者正在做的软件到底有没有前途,规模是会扩大还是会收缩,利润会上涨还是会萎缩,从而决定去留和转岗.
先了解全局(11/1)
有句话是这么说的,一切的恐惧都来源于未知,我认为挺有道理,放在互联网领域就很合适,我们对于面试秋招的迷茫,本质上是因为我们不知道企业会开放什么岗位,会不会筛掉你的简历,会不会最终招你入坑.
其实这一点是很好了解的,政策是跟着环境变动的,如果企业蒸蒸日上,生态良好,那没理由你第一天跨进公司大门的时候业绩就突然下滑了,如果企业江河日下,收益一年不如一年,也没有理由说你进去之后就会突然好转,更大的可能是被迅速优化掉,或者由于业绩不达标的+1,+2拼命push后,主动优化自己.
放在岗位招聘这方面也是同理,要想知道哪些岗位热门,或者说会持续热门,就要关注这家企业在近几年的战略目标,开了哪些会,请了哪些人才,经济效益如何,如此一来,你也就知道自己该不该持续投入到相关岗位的准备上了.
再往小了说,对特定领域的学习也是这样,你觉得秋招要学的东西多,那是因为你自己都不知道到底要学些什么,如果你明确了自己的岗位,看了几篇招聘帖子,还有可能不知道要学什么吗?特定领域的知识终归是有限的,日常开发能用到的名词都是在倒腾来倒腾去,能有什么特别艰深或者特别难懂的知识呢.
如果你确定了要进入某个领域,那就问问AI,看看Google,定睛一看,就是那么几个常用的技术名词,最前沿的技术又不需要你去了解,企业内部出于稳定的因素也不太可能采用.
其实拿我自己举例也是一样,我一向是讨厌数学的,一看到数学公式就头疼,但后来查了不少相关文献,发现LLM训练的领域也就未必有那么高的壁垒,学会了微积分和基本的线性代数后,剩下的就是几十个比较常用的数学公式了,只要我一个个耐着性子去研究,按照历史演进把从1990年到2025年的所有重要论文中出现的关键公式搞明白,那个时候也就真正入门了(当然,说是一回事,真去看还是很累的).
成语也说,一叶障目,不见泰山,把内心的疙瘩抛掉后,不就能看到全局了吗,如果看到全局了,那么又为什么不明白下一步要该怎么走呢,至少,泰山不会主动走向你吧.
近期的安排(11/5)
- 考虑了一下,之后的重心还是放在项目上,争取从项目入手,根据项目需求来学习技术,并穿插在学习笔记中,或许可以称之为项目驱动学习(Project-Driven Learning,简称PDL),基本逻辑如下:
- 你有一个要学习的大方向,无论是技术栈(如Fastapi,Gin,Redis),还是新语言(如Go),抑或是开发方式(如TDD),架构模式(如Layer Architecture)
- 利用AI搜索恰好用了这门技术编写的对应优秀项目/优秀书籍(一定不能找AI生成项目,也不能直接让AI生成模板,否则白搭),如果搜不到,不太可能,除非你的技术真有那么小众,那么想必你也已经是对该领域比较熟悉的开发者了,基本知识全都掌握了,也没必要用到这个学习方法了.
- 如果是项目就详细阅读源码,哪里不懂查哪里,并尝试复刻和仿写(当然不能直接抄),最终目标是实现一个基本功能相同,代码架构类似的项目出来;如果是书籍配套项目,那么你就有福了,直接跟着书学习即可.
- 等你真把这个项目做出来了,你会发现,自己也就已经懂了.
- 另一个打算是,大篇幅的思考(如总结,变故),以后还是单立一篇文章出来,毕竟这才是Blog原本的模样,也方便我来写作,而这里就只会放一些碎片的思考了.
Agent的可能(11/7)
这段时间我一直在考量Agent的实际效能和未来,可以从这几个维度来看:
- 推广潜力
- 学术研究可以不断推进,但问题在于,硬件和基础设施跟不上啊,如果还是走大数据中心的路子,那么随着上下文窗口的扩大,所需要的算力规模也会不断扩大,这势必挤压到我们原本的生活空间
- 另一方面,大多数领域是不会那么轻易地就让Agent来接管的,舆论会将Agent的缺陷无限放大,只要你目前还不是全能的许愿机,那么就一定会有纰漏,只要出现一次生产事故,那么整个信任链条就会彻底崩坏
- 发展潜力
- Agent能不能做到能力随着时间线性增长,能不能适应复杂多变的任务环境,能不能真正地适配机器智能领域(如军事和民用),这些都要打个问号
- 只要Agent还需要我们事无巨细地提供上下文,写AGENTS.md,写SKILL,明确禁令和界限,那就意味着它永远不会是一个真正的智能体,不具备自我探索与发现的能力,无法体会隐含信息,那么也就不可能胜任真正的复杂生产任务
- 影响
- 由于软件工程是最贴近Agent前沿的,所以目前受到的影响是最深的,但是还不能说是伤筋动骨的程度
- 初级工程师的招聘位置确实是在减少,固然可以说是Agent提效,但另一方面却是公司的问题,不愿意花时间培养新人,一味索要高级工程师,只不过Agent给了他们一个借口而已.
- Agent最适用的领域就是单流程的科研和繁琐的文书处理,总有一天,我们在填政务表单时能够直接语音输入或者扫描图片输入,自动填补所有待填项,并且没有任何差错.不过真到了那一步,我们还需要自己填写政务表单吗,更有可能是有一个整合的通用平台,能够处理所有的基本政务事项,做到真正的一网通办.
- 再比如科研领域,如果说你的研究流程是下载数据/做数据实验/跑仪器->数据分析->绘图画表格->分析与公式提取->总结->发表论文,那么很疑惑为什么这个活儿不能交给Agent干,人只要负责提出Idea就行了,而Agent跑出来的结果全都归功于你自己即可.
估算(11/11)
假设校招第一年能够拿到高薪的sp或者ssp档次,最终第一年的薪资为35k* 16,那么一年的税前总收入就是56w,扣除掉接近10%的个税(月工资单算+年终奖35k*4单算)+五险一金缴纳,就算不同城市的比例不同,但拿一线城市来说,最终到手的中位数大概在42w左右,震撼吧😅
通常来说,晋升一级,月base涨幅为10%-30%(看自己本事了),一般来说2-3年晋升一次,越往后越难升,就算你特别厉害吧,两三年确实就能升一次,到工作第十年升了四个职级,而且通过不断跳槽涨了五次base(太多次的话写在简历上也不好看是吧),每次涨幅就算它有20%好了(毕竟如果不是特别诱人或者原环境不太好,愿意跳槽的人还是在少数吧),那么最终能够整到大约200多w的年包,对应的就是xx公司的资深专家或者高级工程师,那么平均下来一算的话表格是这样的:
| 年份 | 税前年包 | 税后到手 |
|---|---|---|
| 第1年 | 56.00 | 43.23 |
| 第2年 | 67.20 | 50.13 |
| 第3年 | 77.28 | 57.71 |
| 第4年 | 92.74 | 68.92 |
| 第5年 | 106.65 | 79.00 |
| 第6年 | 127.98 | 92.19 |
| 第7年 | 147.17 | 105.10 |
| 第8年 | 176.61 | 120.73 |
| 第9年 | 203.10 | 136.29 |
| 第10年 | 243.72 | 160.16 |
那么十年你的税前累计有接近1300w,税后为900w上下,尽管看着很多,但对比一下一线城市的房价,还是有点瑟瑟发抖吧,拿上海来说,偏市中心的徐汇黄浦这些地方,比较便宜的小区房价都是在十万上下的,对比下来,连100平都碰不到呢.而只要你的职业生涯有意外中断的风险,应该也不至于愿意整什么30年房贷吧,更有可能的是在郊区比如嘉定闵行浦东这些地方,整个5w一平的八九十平房子就心满意足了,而光这样也要耗去你积累财富的一半以上.
这么来看,至少买房这个选项,对于非本地人来说,还是不太可能的.
放现实点,拿第一年入职举例,之前说了到手的只有42w,其实能有40w就已经很优秀了吧,那么算一下开支:
- 饮食和聚会消费: 大厂一般提供午晚餐,也有提供早餐的,假设工作日都能在公司解决,只算周末的饮食支出和平常的零食消费即可,那么加上平常的应酬和礼金,就算一个月1000好了,那么一年下来也要1w2
- 家居开销: 一年买衣服的开销(假设不是特别爱打扮,但比较爱干净)+床上用品一次性开销+水电费,就算它买衣服花一千,水电费一个月200好了(毕竟上海的夏天是真的热),日常用品纸巾啊什么的肯定也都有,就算你一个月能够控制在200以内好了,那么就是400*12+1000,一年大致有个5k
- 房租: 工资这么高,住所上肯定不能亏待自己,再考虑一下通勤距离,就算它一个月2500了,一年就是3w
- 通勤与旅游: 通勤一般都有补贴或者房补,如果加班的话也有打车报销,但总要出门旅游或者回家吧,假设一年玩个两次好了,一次花上1k,然后每月的话交通费用算他50,一年回两次家,那么一年下来大致就是3k
可以看到,假设你没有任何花钱的娱乐,而且家里没有任何意外事故,大致的花销就是一年5w,但谁不会有点小意外小爱好呢,年轻人也一般花钱大手大脚,所以涨个20%是很合理的,就算一年6w,那么这样一来,第一年的积累就是34w上下了,对于一个学生来说,确实是一个非常理想的积累了.
但假设你就是个普通人,十年下来升了三次,跳槽了两次,那么最终可能也就一百w出头的薪资,就算你最终能有120w了,那么十年下来税后累计其实也就600w,但这就足够算是别人口中的成功人士了.
假设你考虑结婚生子,且不说另一半的薪资水平和消费水平,但光是养育孩子这一块,按照这份报告来看,当孩子长到18岁的时候,平均下来也要100w了,这也是一个分量很重的开销了.
如果不考虑的话,打算自己养老,那么最终假设能干完15年,积累到大概1000w出头的财富,那么这个时候你也有将近40了,伤病什么的早就落下了一大堆,也是时候退休了,但这能不能说是财务自由呢,拿之前的6w开销来算的话是肯定够用的,但要是说出国旅游,到处挥霍,我想还是差点意思,毕竟国外的消费水平有点太离谱了.
这几顿估算下来,确实有种无力感不是嘛,顶天了也就刚刚到A8,还有随时被裁的风险,能够累积的财富也并没有我们想象中的那么多,但这,已经是普通人能够触达的极限了.
谦虚与狂傲(11/14)
以前不明白,不少行业顶端的人才都异常的谦虚,明明有许多值得自傲的成就,却从没有摆出什么大款的架子.
随着我的不断学习,我也渐渐理解了他们,学的越多,是真的能发现自己懂的越少的,能够在一个细分领域做到极致的人本就不超过一手之数,但一走出这个领域,哪怕是与自己所在领域强相关的一些领域,也有很多知识是自己不太明白的.
学海无涯这句话没有任何错,初入新领域时,我们就像一个在沙滩上捡贝壳的孩子,以为视线所及就是大海的一切,却不知自己只在表层之上,一旦将双脚踏入潮水之中,其中的波澜壮阔又岂是言语可以道尽的.
唯有不断学习,从书籍中汲取经验,从错误中获取教训,从实战中锻炼手感,才可以在领域中不断深入,最终小有所成.
但这一切都需要时间,对我来说,时间还远远不够,一边是门槛日益拔高的校招,一边是对自己无知浅陋的鄙夷,即便是日以继夜的学习,我仍畏惧不已,认为自己远远达不到要求.
不说别的,如果让我现在就去写一篇简历或者来一段自我介绍,就能惊悚地发现,我并没有什么好写的,也没有什么好说的.
浅尝辄止的领域是经不起任何严厉拷打的,而所谓比较精通的领域,也终归是没有那么精通.更何况,手头也并没有任何拿的出手的项目,课程项目过于玩具,而拿AI生成项目去糊弄,中小厂或许能蒙混过关,但大厂的面试官是绝对能认出来的,自己有多少投入,又有多少技术底蕴,一眼就能看清.
但我又能如何,真正开始学习软工的日子就在今年的2月份,而最终面试也就是在明年的2月份,时间已经不够用了,只好勤勉,勤勉,再勤勉.若真的撞上南墙,我也无话可说.怨天尤人大可不必,但悲伤沮丧却是免不了的.
渐进式学习(11/18)
如之前的全局学习法所说,要想学习一门技术或者走进一门行业,就要先看清楚它的全局或者概貌,但这只适用于一些比较基础比较简单的场景.
一旦这门技术涉及到的概念太多,太早的接触到全局反而适得其反,因为人最怕的就是未知,当五花八门的概念一起向你涌来,那是相当无力的,与其说会有想去征服的欲望,不如说会感到恐惧,想要放弃.
拿大一点的范畴来说,如果一个高考刚结束的亲戚抓着手找我问,说"我要学计算机!",我不可能说"这很简单的,你先把计算机网络学好了,然后看看操作系统和系统结构,接着学完c++,python,看完设计模式就可以开始写代码了”.
我更有可能是跟他说"你去看一下python就行,然后用pygame敲个贪吃蛇出来玩玩”.
其实道理就是这样的,当一门技术具有一定深度的时候,你要做的就是逐步推进学习,而不要想着什么七天速成,一口气学完什么的.
正常的学习路径就是什么不懂查什么,但直接让AI搭一个完整项目出来的话,效果就差很多了,你以为自己看懂了AI代码就能去做个差不多的了,但真从零开始动手呢,总归是一筹莫展的吧.
文章分享
技术文章
cpp构造与析构
cpp书单
fastapi+react前后端基础教学
zip算法
react框架比较
sqlite背后的故事
手写识别算法
python的问题
Conventions for Command Line Options
职场文章-秋招与实习
校招流程
还是校招
微软实习
18年的前端实习春招
阅历文章
放弃保研前往字节工作
科大非全日制
研究生复盘
在职老程序员考非全211硕士
十年前的实习面试
读这篇文章会让人不由不想去奋发图强,开始学习
疫情求职
已被删除,可惜的是我不记得大致内容了
保研与工作
github-stars-wont-pay-your-rent
git考古
速通日语
加拿大体验
日本游记
My solopreneur story: zero to $45K/mo in 2 years
肮脏的交易
十年学会编程
契诃夫分析
软件开发经验
AI编程
有趣文章和网站
十年之约
gpt成长记录
谷歌街景随机图
ISBN全球书籍可视化
迈登斯的中国摄影集
スタジオジブリ作品一覧
各报纸(含南方周末,人民日报)新年献词
Astronomy Picture of the Day Archive
games and stuff by Neal
The San Francisco FogCam!
手绘极光
催眠曲
编程音乐网站
Funny scientific papers
Review the contributions you have made on GitHub over the years
Starlink Overview
朝天鸣枪的危险性
东京地铁3D
马屁股和航天飞机的关系
马屁股和航天飞机的关系
美国铁路两条铁轨之间的标准距离是四点八五英尺。这是一个很奇怪的标准,究竟从何而来的?
原来这是英国的铁路标准,因为美国的铁路最早是由英国人设计建造的。
那么,为什么英国人用这个标准呢?
原来英国的铁路是由建电车轨道的人设计的,而这个四点八五英尺正是电车所用的标准。电车轨标准又是从哪里来的呢?
原来最先造电车的人以前是造马车的。而他们是用马车的轮宽做标准。好了,那么,马车为什么要用这个一定的轮距离标准呢?
因为如果那时候的马车用任何其它轮距的话,马车的轮子很快会在英国的老路上撞坏的。为什么?
因为这些路上的辙迹的宽度为四点八五英尺。这些辙迹又是从何而来呢?
答案是古罗马人定的,四点八五英尺正是罗马战车的宽度。如果任何人用不同的轮宽在这些路上行车的话,他的轮子的寿命都不会长。我们再问:罗马人为什么用四点八五英尺为战车的轮距宽度呢?
原因很简单,这是两匹拉战车的马的屁股的宽度。故事到此应该完结了,但事实上还没有完。
下次你在电视上看到美国航天飞机立在发射台上的雄姿时,你留意看,在它的燃料箱的两旁有两个火箭推进器,这些推进器是由设在犹他州的工厂所提供的。如果可能的话,这家工厂的工程师希望把这些推进器造得再胖一些,这样容量就会大一些,但是他们不可以,为什么?
因为这些推进器造好后要用火车从工厂运到发射点,路上要通过一些隧道,而这些隧道的宽度只比火车轨道的宽度宽了一点点
故事是颇有趣的。从一定意义上说,今天世界上最先进的运输系统的设计,或许是由两千年前两匹战马的屁股宽度来决定的。历史惯性的力量是多么的强大,要冲破由惯性形成的规则又是多么的艰难。
好习惯将不只影响您的一生,您的后代子子孙孙,皆会因而受益。