提示自从Arxiv推出了HTML阅读模式,就再也不用担心看英文论文麻烦了,直接Google网页翻译即可
算法与数据结构论文
并发与分布式算法
并发系统时间线
| 时间 | 并发思想 | 代表人物 | 代表论文 / 原始文献 | 可访问链接 | 今天的典型继承 |
|---|---|---|---|---|---|
| 1963 | Coroutine(协程) | Melvin Conway | Design of a Separable Transition-Diagram Compiler | ACM 原文 | Python coroutine、generator、async/await 的思想源头之一 (数字对象识别) |
| 1965 | 互斥 / Critical Section | Edsger Dijkstra | Solution of a Problem in Concurrent Programming Control | ACM 论文 | mutex、lock、临界区 (埃因霍温理工大学研究门户) |
| 1965→1968 | Semaphore / 协作顺序进程 | Dijkstra | Cooperating Sequential Processes | Dijkstra Archive PDF | semaphore、进程同步、生产者消费者;手稿形成于1965,1968年正式收入文集 (德克萨斯大学奥斯汀分校计算机科学) |
| 1973 | Actor Model | Carl Hewitt, Peter Bishop, Richard Steiger | A Universal Modular ACTOR Formalism for Artificial Intelligence | IJCAI 官方 PDF | Erlang、Elixir、Akka、消息驱动系统 (IJCAI) |
| 1974 | Monitor(管程) | C. A. R. Hoare | Monitors: An Operating System Structuring Concept | 论文 PDF | Java synchronized、condition variable、mutex 封装 (CiteSeerX) |
| 1974 | Kahn Process Network | Gilles Kahn | The Semantics of a Simple Language for Parallel Programming | Columbia PDF | dataflow、stream processing、pipeline (哥伦比亚大学计算机科学系) |
| 1978 | CSP(通信顺序进程) | C. A. R. Hoare | Communicating Sequential Processes | Oxford PDF | Go goroutine + channel + select;正式 CACM 论文发表于1978年 (dr. heap references) |
| 1978 | Happened-before / 逻辑时钟 | Leslie Lamport | Time, Clocks, and the Ordering of Events in a Distributed System | Microsoft Research | 分布式系统因果关系、Lamport Clock、Vector Clock (Microsoft) |
| 1979 | Sequential Consistency | Leslie Lamport | How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs | 论文 PDF | CPU memory model、Java/C++ 内存模型的重要理论基础 (Microsoft) |
| 1985 | Future | Robert Halstead | MULTILISP: A Language for Concurrent Symbolic Computation | 论文 PDF | Future、Java CompletableFuture、异步任务结果 (威斯康星大学计算机科学用户页面) |
| 1988 | Promise / 异步调用 | Barbara Liskov, Liuba Shrira | Promises: Linguistic Support for Efficient Asynchronous Procedure Calls in Distributed Systems | 论文记录 / PDF | JavaScript Promise、Future/Promise 抽象 (SciSpace) |
| 1990 | Linearizability(线性化) | Maurice Herlihy, Jeannette Wing | Linearizability: A Correctness Condition for Concurrent Objects | Brown University PDF | 并发容器、原子数据结构、分布式存储正确性 (布朗大学计算机科学系) |
| 1991 | Wait-free / Non-blocking | Maurice Herlihy | Wait-Free Synchronization | 论文 PDF | CAS、lock-free/wait-free queue、Concurrent Data Structures (Meta Science Observatory) |
| 1993 | Transactional Memory | Herlihy, Moss | Transactional Memory: Architectural Support for Lock-Free Data Structures | 论文页面 / PDF | STM、Intel TSX、事务式共享内存 (ResearchGate) |
| 1993–1995 | Reactor / Event Loop | Douglas Schmidt | Reactor: An Object Behavioral Pattern for Demultiplexing and Dispatching Handles for Synchronous Events | 作者主页 PDF | Redis、Nginx、Netty、Node.js、Python asyncio 的重要架构基础 (德雷范德比尔特大学) |
| 1999 | Work Stealing | Blumofe, Leiserson | Scheduling Multithreaded Computations by Work Stealing | ACM 免费论文 | Java ForkJoinPool、Cilk、Rust Rayon 等多核任务调度 (数字对象识别) |
| 2001 | SEDA / 分阶段事件驱动 | Matt Welsh, David Culler, Eric Brewer | SEDA: An Architecture for Well-Conditioned, Scalable Internet Services | ACM 免费论文 | 高并发服务器、stage/queue、backpressure (数字对象识别) |
| 2002 | 协作式任务 + 自动栈管理 | Adya et al. | Cooperative Task Management Without Manual Stack Management | USENIX 全文 | 现代协程、事件驱动和 async/await 编程模型的重要过渡 (Microsoft) |
| 2018 | Structured Concurrency | Nathaniel J. Smith | Notes on structured concurrency, or: Go statement considered harmful | 原文 | Python TaskGroup、Kotlin coroutineScope、Swift TaskGroup;这一项是影响很大的技术文章,而非传统期刊论文 (Vorpus) |
Self-stabilizing Systems in Spite of Distributed Control(1974)
- 早期思想
- 怎么哪里都有你啊
完全不推荐阅读,只是一些对分布式系统的模糊认识而已.
Time, Clocks, and the Ordering of Events in a Distributed System(1978)
- Lamport提出的早期思想
没任何看头
The Byzantine Generals Problem(1980)
- Lamport提出的拜占庭将军问题
可靠的计算机系统必须处理向系统的不同部分提供矛盾信息的故障组件。这种情况可以用一组拜占庭军队的将军抽象地表示,他们与军队一起营救在一个敌人城市周围。将军们只能通过信使通信,必须就一个共同的作战计划达成一致。然而,他们中的一个或多个可能是叛徒,他们将试图混淆其他人。问题是找到一种算法,以确保忠诚的将军们能达成一致
场景 A(指挥官是叛徒):指挥官分别向副官 1 发送“进攻”,向副官 2 发送“撤退”。副官 1 收到“进攻”,副官 2 收到“撤退”。此时副官 1 与副官 2 相互通信,副官 1 发现副官 2 称指挥官发的是“撤退”。但副官 1 无法判断到底是指挥官叛变,还是副官 2 在说谎。
场景 B(副官 2 是叛徒):指挥官是忠诚的,发送“进攻”给副官 1 和副官 2。叛徒副官 2 向副官 1 谎称自己收到的是“撤退”。对于副官 1 而言,其接收到的消息序列(来自指挥官的“进攻”,来自副官 2 的“撤退”)与场景 A 完全相同。
基本上来看,就是一个思维实验而已,这篇论文起到的是一个启发作用罢了.
A Critique of ANSI SQL Isolation Levels(1995)
ANSI SQL-92 用“脏读、不可重复读、幻读”定义隔离级别,但这些定义既有歧义,也不完整,无法准确描述真实数据库的并发行为。
读起来很累的论文…不过确实很重要.
Consistent Hashing and Random Trees(1997)
- 一致性哈希
摘要
我们的缓存协议建立在一种特殊的哈希方法之上,我们称之为一致性哈希。粗略地说,一致性哈希函数是这样一种哈希函数:当函数值域发生变化时,它的映射结果只发生尽可能小的变化。
引言
当大量客户端试图同时访问某一台服务器上的数据时,就会形成热点。如果该站点没有配置足够的资源同时处理所有客户端,服务质量就可能下降,甚至完全中断。
许多人都曾在万维网中遭遇过热点现象。一个网站可能突然变得非常流行,在很短的时间里收到远超原设计容量的请求。事实上,一个站点可能因为请求过多而被“压垮”,从而基本无法使用。
人们已经提出了多种解决热点问题的方法。其中大多数使用某种复制策略,将热门页面的副本存储在互联网中的多个位置,从而把提供热门页面的工作分散到多台服务器上
一种已经得到广泛使用的方法,是让多个客户端共享一个代理缓存。所有用户请求都被转发给代理,代理尝试保存经常访问的页面。如果缓存中已有页面副本,代理便直接满足请求;否则,它将请求转发给页面的源服务器。
这种方案存在一个两难问题:共享同一缓存的用户越多,缓存带来的收益越大;但同时,缓存自身也越容易被压垮。
我们提出一种新的哈希方案,我们称之为一致性哈希。
它与 Plaxton/Rajaraman 以及其他实际系统中采用的哈希方法有很大区别。传统哈希方案能够很好地把负载分散到一个已知且固定的服务器集合中,但互联网中的机器集合不是固定的:机器会因为崩溃而离开,也会有新机器加入。
更糟糕的是,有关机器是否正常运行的信息在网络中传播得很慢。因此,不同客户端可能对哪些机器可用于复制数据形成互不兼容的“视图”。
这使得标准哈希变得无效,因为标准哈希依赖客户端就“哪台缓存负责提供特定页面”达成一致。
- 上述的说明相当精炼,展示了当代互联网中负载均衡的难题.
一致性哈希可能有助于解决这类问题。与大多数哈希方案一样,它把一组条目分配给桶,使每个桶获得大致相同数量的条目。但与标准哈希不同,对桶集合的一次小改动不会导致所有条目被重新映射。
此外,把条目映射到略有差异的桶集合时,只会产生略有差异的分配结果。
Random Trees
我们为每个页面关联一棵有根的 \(d\) 叉树,称为抽象树,每棵树的节点数等于缓存数 \(C\),并且树尽可能平衡,即除最底层外,其他各层都是满的。树节点按照广度优先搜索的顺序编号。
不行了,看不了一点:
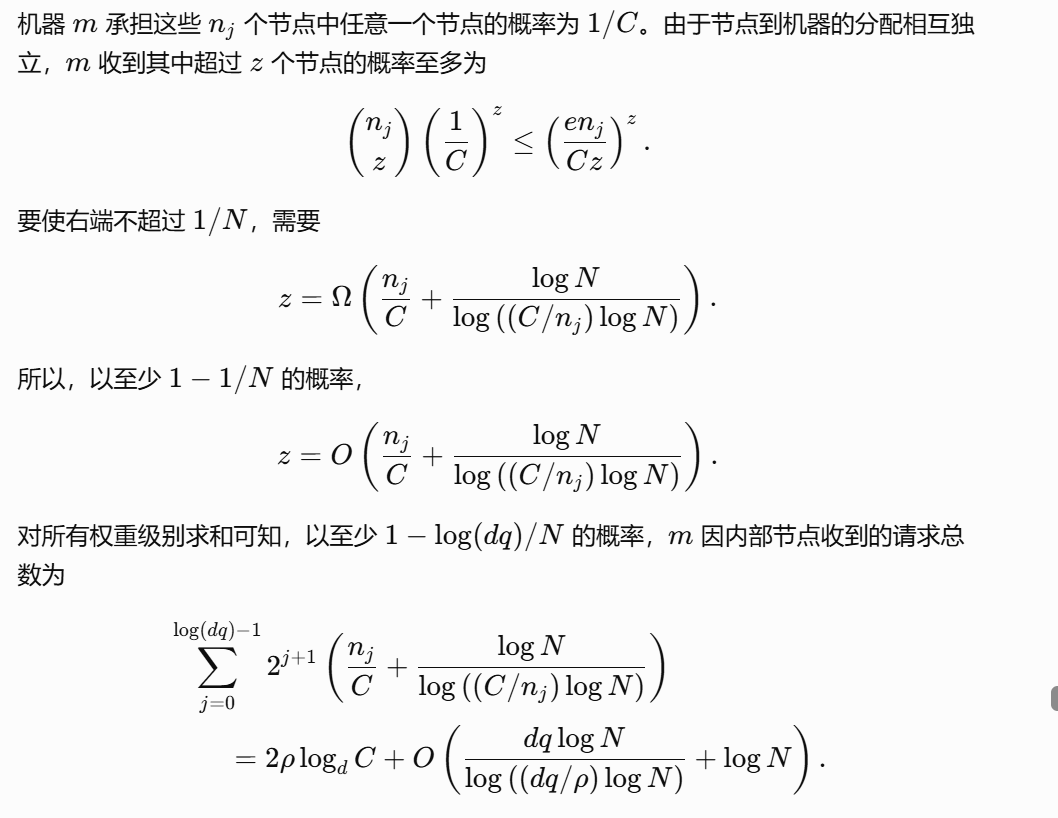
不管如何,这部分证明了这种缓存树的性能很好,而且可以避免单个服务器被压垮.
一致性哈希
客户端利用一致性哈希函数,把对象映射到自己视图中的某台缓存。我们将分析并构造具有下列性质的哈希函数:
- 平滑性:增加或删除缓存机器时,为保持负载均衡而必须迁移到新缓存的对象比例达到理论上的最小值;
- 扩散度(spread):在所有客户端视图中,一个对象被分配到的不同缓存总数很小;
- 负载(load):在所有客户端视图中,被分配给某台特定缓存的不同对象数量很小。
经过一番复杂计算后,论文找到了该哈希函数的一些主要性质
总结
尽管论文中没有提出一个真正合适的哈希函数,但后来的研究发现,即便是MD5函数都能够正常工作.
| 系统 | 底层哈希 | 分配方式 |
|---|---|---|
| Cassandra | MurmurHash3 | Token Ring + 虚拟节点;官方默认是 Murmur3Partitioner。Cassandra 文档 |
| Envoy | 默认 xxHash,也支持 MurmurHash2 | Ketama Ring Hash;默认环大小1024。Envoy 文档 |
| Nginx | 内部实现 | hash ... consistent 使用 Ketama 一致性哈希。Nginx 文档 |
| Go groupcache | 默认 CRC32 | 哈希环 + 默认50个虚拟节点。源码 |
| 早期 Memcached/Ketama | MD5 | 哈希环 + 通常每节点160个位置 |
| Redis Cluster | CRC16 | 并非经典一致性哈希,而是 CRC16(key) mod 16384,再显式迁移槽位。Redis 文档 |
The Part-Time Parliament(1998)
- Paxos算法,又是Lamport
总结
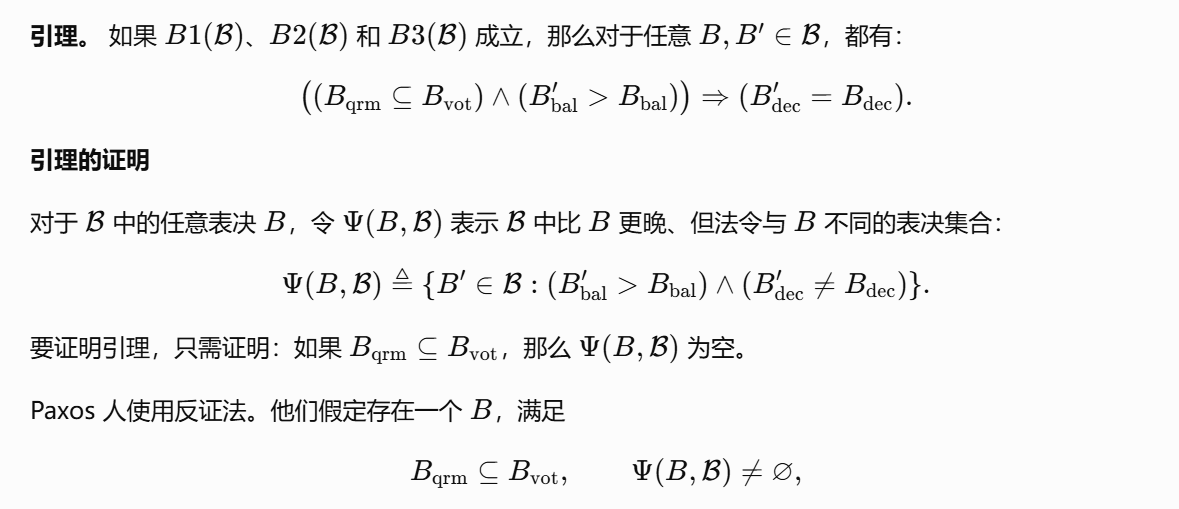
这篇论文相当有趣,设计了一个Paxos岛上的议会情景,通过一系列法令的颁布来说明Paxos共识算法的基本流程.
但说是这么说,根本不是正常人能看明白的东西,科学家的幽默实在太难理解了:
Paxos Made Simple(01)
- 由于原始论文难以理解,Lamport在2001年发表了这篇简化版论文,这篇论文放弃了所有希腊城邦的比喻,用直白的语言重新描述了算法
The Paxos algorithm, when presented in plain English, is very simple.
Paxos算法的核心思想是通过“少数服从多数”的原则来达成共识。算法运行在一个允许宕机故障的异步系统中,不要求可靠的消息传递,可以容忍消息的丢失、延迟、乱序和重复。
Paxos体系主要分为Basic Paxos和Multi-Paxos两个部分。
1. 核心角色
算法中定义了三种逻辑角色,一个物理节点可以同时扮演多个角色。
- 提议者(Proposer):负责提出提案(Proposal),提案包含一个提案编号和一个提案值。
- 接受者(Acceptor):负责对提案进行投票。如果提案获得了超过半数的Acceptor的接受,则该提案被批准(Chosen)。
- 学习者(Learner):负责“学习”已经被批准的提案值,不参与投票过程。
- 学习者收到提案后,会顺序执行操作并返回最终结果
2. Basic Paxos:单值共识的两阶段流程
Basic Paxos用于就单个值达成共识。整个过程分为两个阶段。
阶段一:准备(Prepare)
- 提议者(Proposer) 选择一个新的、更大的提案编号
N,然后向超过半数的接受者(Acceptor)发送一个“Prepare”请求。 - 接受者(Acceptor) 收到Prepare请求后,会做出两个承诺和一个应答:
- 承诺一:不再接受任何提案编号小于等于
N的Prepare请求。 - 承诺二:不再接受任何提案编号小于
N的Accept请求。 - 应答:如果它之前已经接受过任何提案,它会将提案编号最大的那个提案返回给提议者。
- 承诺一:不再接受任何提案编号小于等于
阶段二:批准(Accept)
- 当提议者(Proposer)收到超过半数的接受者(Acceptor)对Prepare请求的肯定响应后,它会根据响应来决定提案的值:
- 如果所有响应的Acceptor都没有接受过任何提案,那么提议者可以自由选择一个值。
- 如果响应的Acceptor中有已经接受过的提案,那么提议者必须选择其中提案编号最大的那个值。
- 选定值后,提议者向那超过半数的Acceptor发送一个“Accept”请求,请求它们接受这个最终的提案值。
- 当Acceptor收到Accept请求后,只要它没有违背之前的承诺(即没有响应过更大编号的Prepare请求),它就会接受这个提案值。
- 一旦该值被超过半数的Acceptor接受,这个值就被正式批准(Chosen) 了。
3. Multi-Paxos:连续共识的工程优化
Basic Paxos每达成一次共识都需要经历两轮网络通信,效率较低。为了解决连续达成一系列值(如日志条目)的共识问题,Multi-Paxos应运而生。
它的核心优化是:选举一个稳定的“领导者(Leader)” (一个特殊的提议者)。在领导者任期稳定时,可以跳过准备(Prepare)阶段,直接进入批准(Accept)阶段,从而将多轮共识的通信开销从2轮减少到1轮,极大地提升了性能。
4. 算法的保证与局限
- 安全性(Safety):Paxos保证了只有一个值会被最终批准,并且这个值是被某个提议者提出的。
- 存活性(Liveness):Paxos不保证能在有限时间内达成共识。在极端情况下,多个提议者不断提出更高编号的提案,可能导致彼此抢占,使得任何提案都无法被批准,这种情况被称为“活锁(Livelock)”。
- 容错性(Fault Tolerance):在总共有
2F+1个节点的集群中,Paxos可以容忍最多F个节点同时发生故障。
- 至于本人是怎么想出来的这种精妙结构,那只有天知道了
MapReduce: Simplified Data Processing on Large Clusters(04)
- MapReduce,Google出品
摘要
MapReduce 是一种处理和生成大规模数据集的编程模型,以及与之配套的实现。
用户需要指定一个 Map 函数:它处理一个键值对,并生成一组中间键值对;用户还需要指定一个 Reduce 函数:它把具有相同中间键的所有中间值合并起来。本文将说明,现实世界中的许多任务都可以使用这种模型表达。
我们的 MapReduce 实现在大规模廉价机器集群上运行,并具有很强的可扩展性。一次典型的 MapReduce 计算,会利用数千台机器处理数 TB 数据
引言
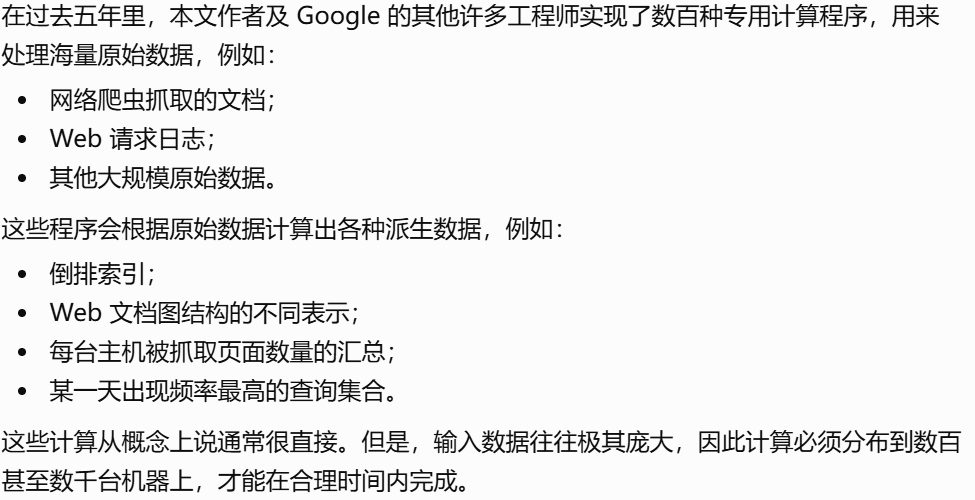
代码示例
| |
总结
原文的解释过于抽象了,也不够详细,只好自己去学了.
补充
MapReduce的完整过程:
| |
主任务由Master调度给几千个Worker(单个服务器),有的Worker负责Map,有的Worker负责Reduce.
首先执行Map,给相同的商品/记录分配同一个ID,在Shuffle阶段合并所有相同ID的商品/记录,这是通过Master监控的网络传输实现的,然后再由Reduce函数执行汇总同类数据的任务,并得到最终的统计值,这个统计值是会发送到共享文件夹中的.
Bitcoin: A Peer-to-Peer Electronic Cash System(08)
- Bitcoin
既然是这么NB的论文,那还是乖乖的通读全文吧.
摘要
- double-spending: 双重花费,指的是
unauthorized spending of the same money (either digital or conventional) more than once,也就是说,伪造第三方同时进行交易.
传统的数字签名仍然需要第三方(如CA签发机构/银行)保证不会有double-spending,而这篇论文指出,可以通过proof-of-work(工作量证明,原理是不原样计算一次就得不到相同的哈希值)来保证记录的有效性.只要这个网络中一半以上的节点不叛变,那么这些记录就是合法的.
方法
工作量证明要求找到一个特定数值,使区块的散列值——例如使用 SHA-256 算法计算——以指定数量的零比特开头。
所需的平均计算工作量会随着零比特数量呈指数增长,但只需执行一次散列计算即可验证结果。
一旦为了使某个区块满足工作量证明而消耗了计算能力,那么除非重新完成相应工作,否则该区块就无法再被更改。随着后还必须重新完成所有后续区块的工作量证明。
network
运行网络的步骤如下:
- 新交易向所有节点广播。
- 每个节点将新交易收集到一个区块中。
- 每个节点为自己的区块寻找一个具有足够难度的工作量证明。
- 当某个节点找到工作量证明时,它将该区块广播给所有节点。
- 只有当区块中的所有交易都有效且此前未被支付时,节点才接受该区块。
- 节点通过开始创建下一个区块来表示自己已经接受该区块,并在新区块中将已接受区块的散列值作为前序散列。
挖矿的来历
按照约定,每个区块中的第一笔交易是一笔特殊交易,它会创建一枚由该区块创建者拥有的新货币。
这为节点支持网络提供了激励,也提供了一种最初将货币投入流通的方式,因为系统中没有负责发行货币的中央机构。
稳定增加一定数量的新货币,类似于黄金开采者通过消耗资源,将黄金加入流通体系。在本系统中,被消耗的是 CPU 时间和电力。
激励也可以由交易手续费提供。如果一笔交易的输出总金额小于其输入总金额,两者之间的差额就是交易手续费,它会被加入包含该交易的区块的激励中。
总结
设计上是非常精巧的,问题来了,这到底是怎么想出来的,这和卷积神经网络一样巧夺天工的设计绝非常人所为.
Kafka: a Distributed Messaging System for Log Processing(11)
- Kafka
kafka之前的消息队列框架都有着各种各样的缺陷,要么是过度设计,要么不可以在线处理数据.
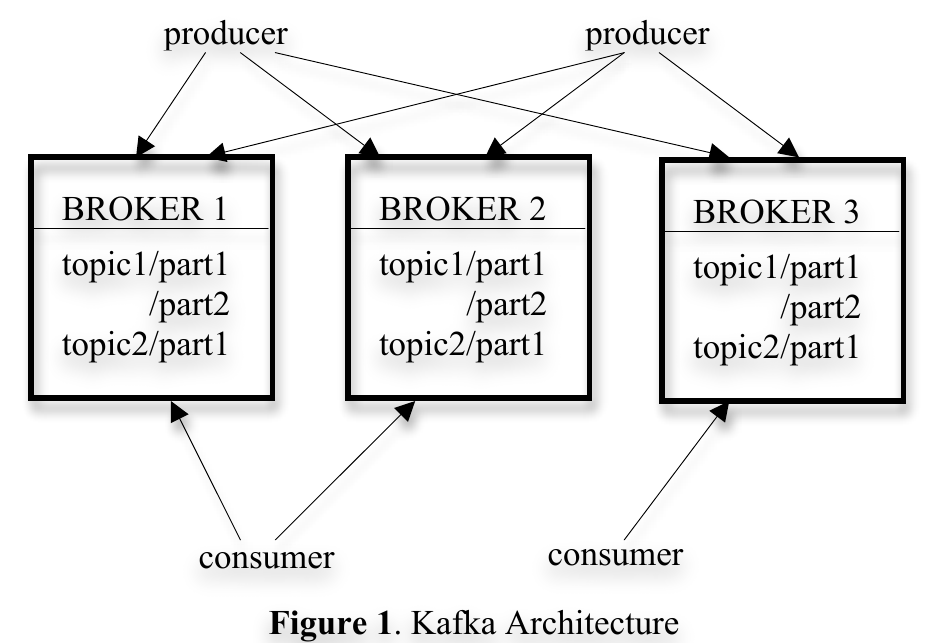
Unlike most other messaging systems, in Kafka, the information about how much each consumer has consumed is not maintained by the broker, but by the consumer itself.
整篇论文也只是简单地谈了谈Kafka的基本原理而已,真要学习的话还得去看专门的文档.
In Search of an Understandable Consensus Algorithm(14)
- Raft,斯坦福大学出品
摘要
Raft 是一种管理复制日志的共识算法。它产生的结果与 Multi-Paxos 等价,效率也与 Paxos 相当,但采用了不同的结构。这种结构使 Raft 比 Paxos 更容易理解,也为构建实际系统提供了更好的基础。
为了提高可理解性,Raft 将共识中的关键要素——例如领导者选举、日志复制和安全性——分离开来,并施加更严格的内部一致性约束,以减少需要考虑的状态数量。用户研究的结果表明,对学生而言,Raft 比 Paxos 更容易学习。
总结
Paxos的晦涩是众所周知的,而Raft光是改进Paxos就花了将近一年时间.
Raft的基本原理如下:
- 首先选出一个明确的领导者Leader,将管理/复制日志的责任都交给他,而不是像Paxos一样只在必要时选取临时的Leader
- Leader负责接收来自客户端的日志,并复制到其他服务器,称为Follower.
- 在采用Leader的基础上,Raft得以将共识问题拆分成三个子问题:
- 领导者选举: 现有Leader故障时,必须选取新的Leader
- 日志复制: 领导者负责同步客户端-自己-其他服务器的日志
- 安全性: 如果某个服务器已经执行了某个日志并得到了一个结果,那么其他服务器执行该日志就不能得到不同的结果
- Leader的选举采用心跳(HeartBeat)机制,只要一段时间内某个Follower没有收到来自Leader的心跳(存活报告),那么就单方面认为该Leader已经故障,接着向集群中其他Follower提议由自己作为新的Leader.
由于Raft确实更加清晰,所以迅速取代Paxos成为大部分消息队列的标准算法
图算法
On the Shortest Spanning Subtree of a Graph and the Traveling Salesman Problem(1956)
- Kruskal算法
整篇论文的实际内容只有2页,基本思想也很简单.
Shortest connection networks and some generalizations(1957)
- PRIM算法
尽管思想也很简单,但论文却花了很大的篇幅来讲一些特殊情况和偏差情况
A Note on Two Problems in Connexion with Graphs(1959)
- DIJKSTRA算法
该论文提出了两个问题:
- n个节点的最小生成树
- 节点P和Q之间的最短距离
之后就是围绕这两个问题的相当随意的证明了,没有严格的公式证明,而是只用直白的英语不断地论述,整篇论文的正式内容只有两页,所以没什么看头.
至于为什么现在这个算法这么出名,我想还是因为太好用的缘故.
数据结构
An algorithm for the organization of information(1962)
- AVL树
整篇论文只有5页,论述过程非常简明,但这种数据结构确实不是一般人能想出来的.
Organization and Maintenance of Large Ordered Indices(1970)
- B树
整篇论文讲的就是B树的原理,插入/删除操作,光是这些部分就花了二十多页…
A Dichromatic(双色的) Framework for Balanced Trees(1978)
- 红黑树
整篇论文包含了对红黑树的原理介绍和与B树的比较,所以没什么可读性
The Ubiquitous B-Tree(1979)
- B+树
B+树不像AVL树或B树那样存在一篇公认的唯一“发明论文”。相关思想在B树变体和IBM的VSAM等系统中逐渐形成,至少在1973年已经投入使用
而这篇论文也仅仅是对B树家族的综述而已,对于B+树的介绍也比较少.
由于数据存取有两种常见的方法,顺序存取和随机存取,而直到B+树诞生前,没有一个比较好的数据结构能够以比较优秀的性能同时实现这两种功能.
Skip Lists: A Probabilistic Alternative to Balanced Trees(1990)
- 跳表
这篇论文非常精巧,也就意味着非常难看懂,简单来说,跳表是一个用概率模型改造后的B+树,也就是说,每个节点提升的可能性是由概率p决定的,从而实现了高层稀疏,底层密集的类B+树模型,这样一来,反而简化了构造难度,实现快速的插入和替换.
摘要
二叉树可以用于表示字典、有序表等抽象数据类型。当元素以随机顺序插入时,二叉树表现良好。但某些操作序列,例如按照元素的有序顺序依次插入,会产生退化的数据结构,导致性能非常差。
如果能够先随机打乱待插入元素的顺序,那么对于任意输入序列,树都有很大概率获得良好性能。然而,大多数情况下必须在线回答查询,因此预先随机排列输入并不现实。
跳表是平衡树的一种概率性替代方案。跳表通过查询随机数生成器来实现平衡。虽然跳表的最坏情况性能很差,但没有任何输入序列能够持续产生最坏情况性能
原理
如果每个第 \(2^i\) 个节点都拥有一个向前跨越 \(2^i\) 个节点的指针,那么各层节点将按照一种简单规律分布:
- 50% 的节点属于第 1 层;
- 25% 的节点属于第 2 层;
- 12.5% 的节点属于第 3 层;
- 依此类推。
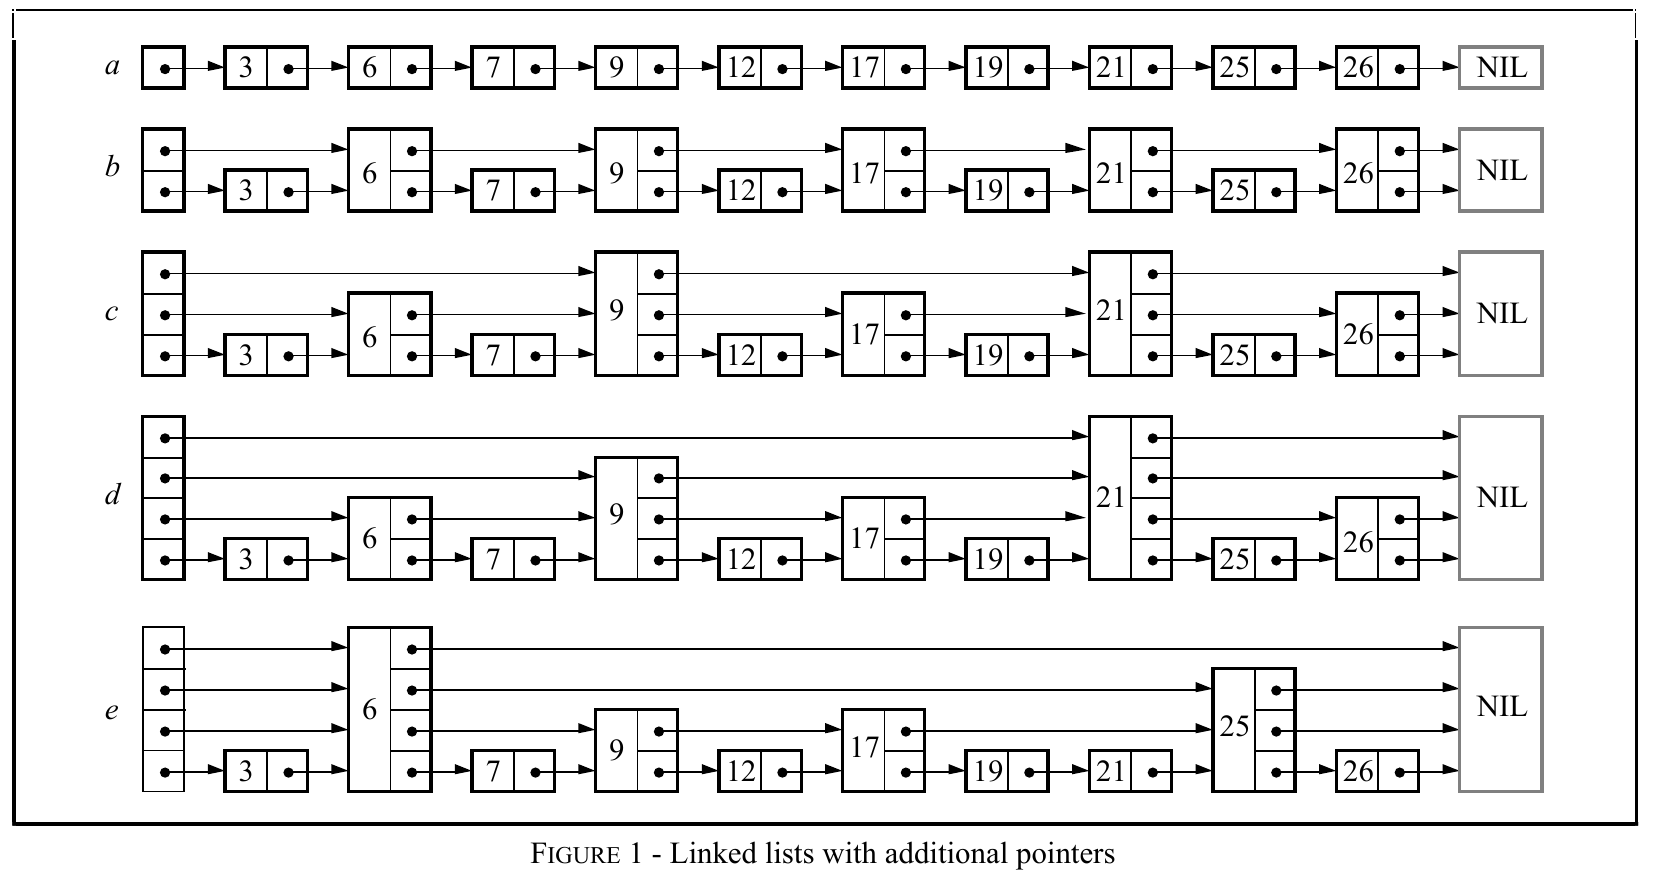
这不就是一个天然的层次索引结构吗,而如果我们不是按照二分之一的位置来划分指针,而是用二分之一的概率(标准情况下都是1/2)提升指针,这就是跳表了
剩下的部分就是用来证明跳表的概率结构的优越性了,不仅查询花费小,而且插入和查找都还过得去
Log-Structured Merge-tree(1996)
- LSM树
摘要
日志结构合并树(Log-Structured Merge-tree,LSM-tree)是一种基于磁盘的数据结构,旨在为长期承受高频记录(logs)插入和删除的文件提供低成本索引。
LSM-tree 使用一种延迟并批量处理索引变化的算法:索引变化从基于内存的组件开始,以类似归并排序的高效方式,逐级流向一个或多个磁盘组件。在此过程中,除极短的加锁时间外,所有索引值始终可以通过内存组件或某个磁盘组件进行查询。
与 B 树等传统访问方法相比,该算法显著减少了磁盘臂移动。当传统访问方法中插入操作的磁盘臂成本远高于存储介质成本时,LSM-tree 能够显著提高性价比。
原理
每生成一行新的历史记录,系统首先按照常规方式向顺序日志文件写入用于恢复这次插入的日志记录。
随后,把该历史行的索引条目插入常驻内存的 \(C_0\) 树。随着时间推移,该条目会迁移到磁盘上的 \(C_1\) 树。
查找索引条目时,先搜索 \(C_0\),再搜索 \(C_1\)。
条目从 \(C_0\) 迁移到 \(C_1\) 之前存在一定延迟,因此,如果系统在迁移完成前崩溃,就必须恢复尚未进入磁盘的索引条目。
很明显,关键点在于如何优化C0到C1的迁移成本,首先,C1具有和B树类似的结构,但为了实现顺序磁盘访问进行了优化:
- 节点填充率为 100%;
- 根节点以下,每一层中连续的单页节点被打包进连续的多页磁盘块;
LSM-tree采用一种称为rolling merge的合并策略,每当插入使 \(C_0\) 接近其大小上限时,一个持续运行的滚动合并过程就会从 \(C_0\) 删除某个连续条目区间,并将其合并进磁盘上的 \(C_1\)。
新合并块会写入新的磁盘位置,因此旧块不会被覆盖;如果发生崩溃,旧块仍可用于恢复。
缓存在内存中的 \(C_1\) 父目录节点也会被更新,以反映新的叶结构,但通常会在缓冲区中保留更长时间,从而减少 I/O。
合并步骤完成后,\(C_1\) 中的旧叶节点被标记为无效,并从 \(C_1\) 目录中删除。
而C0树由于是放在内存中,所以需要使用适合内存的结构如AVL树等.
由此来看,一个基本的LSM-Tree实际上是由一对树组成的,而实际的LSM-Tree会使用多个组件,其中:
- C0常驻内存
- 其他组件常驻磁盘
每对相邻组件之间都存在异步的滚动合并.
对于删除操作,我们可以先在C0中标记,直到滚动合并时才真正删除,至于更新和插入操作,不好意思,具有时间顺序的日志不存在这个概念.
而查询操作同样可以通过标记来完成.
总结
论文剩下的部分就是计算LSM树的性能了,我当然是直接跳过的,知道它很NB就足够了.
HOT: A Height Optimized Trie Index for Main-Memory Database Systems(18)
摘要
Trie 是一种树结构,其中一个节点的所有后代共享相同的前缀,而节点的子节点则根据键剩余部分的二进制表示进行查找。
- fanout: 扇出度,指每个节点最多可以拥有的子节点数量
| 概念 | 含义 |
|---|---|
| 扇出度 fan-out | 一个节点连接多少个下游 |
| 扇入度 fan-in | 一个节点接收多少个上游 |
本文提出了一种快速且空间效率较高的内存索引结构HOT,至于应用价值如何,鉴于直到现在都没有一个工业上的数据库采用该结构,所以希望不大了,不过思想上还是比较值得学习的.
总结
结构复杂到让人想自裁,怪不得没人用.
逻辑算法
Optimization by Simulated Annealing(1983)
- 模拟退火
- 发布在Science上我是没想到的
NP完全问题至今都无法找到多项式时间内的解法,而在80年代就更不可能了,因此启发式算法就在这里派上用场了,尽管该类算法不保证能够找到最优解,但却能够快速找到比较接近的答案.
启发式算法有两种常见形式:
- 分治法: 比较特殊,需要子问题的答案与原问题没有偏差
- 递归法: 从一个标准的参数设定开始查找,一旦有更优的设定值则向新设定值靠近,直到没有更优的解为止,模拟退火就属于这一种算法.
- 显然,这不就是神经网络的标准训练流程吗,也就是说,神经网络也不外乎是一种启发式算法而已.
模拟退火的想法来源于统计力学中凝固晶体的经验: 先加大火力融化物质,再缓慢降温,并在凝固点附近停留很长时间,直到平衡.
- 论文的后面十几页都是关于实际应用的,就没什么看头了.
深度学习论文
前置概念
- 论文大致按照年份排序,有一个先后关系
- 学习前提: 阅读过« Deep Learning From Scratch»即可,然后就可以大致跟着时间线走,如果忽略前人的研究成果直接跳到最新模型的话,那绝对是看不懂的.
首先,深度学习领域的主要框架类型有如下几个:
- CNN(卷积神经网络): 通过卷积层来实现高维的图像/3D输入,适用于处理图像. 1. 代表框架有LeNet,ResNet等. 2. wiki
- RNN(循环神经网络): 适用于处理具有时间先后顺序的数据,例如音频 1. 代表框架有LSTM,GRU等 2. wiki
- Transformer: 适用于处理文本,代码,多模态信号 1. 代表框架有GPT,Llama,BERT等
- GNN(图神经网络): 适用于处理社交网络等网络数据 1. 代表框架有GCN,GAT等
然后,我们需要大致明白一条主要的时间线:
- 1986年« Learning representations by back-propagating errors »将反向传播算法引入了神经网络
- 1989年« Backpropagation applied to handwritten zip code recognition »是第一篇真正将反向传播算法实际应用到学习过程中的论文,也是CNN的原型论文
- 1990年« Finding Structure in Time »是RNN的原型论文.
- 1997年« Long Short-Term Memory »提出了LSTM框架
- 2015年« Deep Residual Learning for Image Recognition »提出了深度残差网络
- 2017年« Attention Is All You Need »提出了Transformer框架.
- 2018年« Improving Language Understanding by Generative Pre-Training »提出了GPT框架
- 2023年« LLaMA: Open and Efficient Foundation Language Models »提出了LLaMA框架.
- 2025年« DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning »提出了DeepSeek-R1框架.
碎碎念
- 这些主要论文中间穿插着许多奠基者的研究成果,我也会适当地学习这些论文.
- 由于我只是一个业余爱好者,只想准确的了解现代大模型背后的原理,所以只会挑选最经典或者最优秀的论文来大致学习一下.
- (5/22): 早期论文大多会深入底层的原理,讲的特别深入和透彻,能够洋洋洒洒写三四十页;而越是新的论文,就越是含混不清,潦草的介绍了公式和框架就结束了,总共十几页中能有四五页真东西就不错了.这固然有版面限制的原因在,但我想还是因为风气出了问题.
- (5/28): 早期的经典论文都是大学里的研究者提出的,而近十年的突破性论文都是由大公司里的研究者提出的,这不仅说明巨头科技公司垄断了顶尖的人才,也说明学术研究的环境不再像以前那般淳朴了.
- (5/29): 早期的经典论文之间时间跨度很大,随着深度学习的不断火爆,论文数量呈指数级上升,每一年都有新的突破性成果,这又何尝不是一场你死我活的大跃进.
- (6/1): GPT的突破性成果让所有人都见识到了大模型的可怕,但至今为止都没有人能够清晰的告诉我们,为什么把模型变大就可以实现这种奇迹般的涌现,还有就是,模型的大小到底有没有极限,大模型的发展是否存在一个瓶颈,没有人能够说明.前方,有可能是天堂,也可能是地狱.
- (6/4): 实际上来说,大模型确实算是一种爆发性的增长,在2017年以前,语言模型只能应付简单的文本标注和文本分类任务,而在这之后,语言模型就可以真正地实现文本理解和文本生成了,这一飞跃确实值得让人深思.而如今,语言模型的发展再次停滞,足足有十年没有新的突破性架构被提出了,现有的改进都是对Transformer本身的结构优化,尽管如此,由于商业界本身的滞后性,大小企业仍然在争先恐后的入场,但实际的落地应用却并没有看上去那么多.
- (6/12): 读的论文越多,内心反而越悲哀,自从OpenAI将目标转向盈利后,深度学习研究的风气就发生了可悲的转折,高级模型的内部构造成了黑箱,就连参数量都不会轻易揭露,而所谓的开源模型也只是开放权重和架构,那些极为重要的训练语料却不肯拿出来分享,那么也就无从谈起复现模型了.
卷积神经网络是如何实现反向传播计算的
一般神经网络的反向传播计算很好理解,我们只需要对某一位置的参数求偏导就行了,但卷积神经网络多了一个卷积层和池化层,这显然没有那么好处理.
- 一个比较好的说明 - 由于讲的挺好的,我就不讲了…
Transformer之前
Learning representations by back-propagating errors(1986)
如标题所说,这篇论文将反向传播算法引入了多层神经网络的学习,堪称深度学习领域的祖师爷,不过由于内容很简单,就没有深入看的必要了,真的就只讲了一个反向传播算法而已.
Serial Order: A Parallel Distributed Processing Approach(1986)
该论文是« Finding Structure in Time »这篇论文的灵感来源,很有必要阅读.
- 还是有点长的…
总结
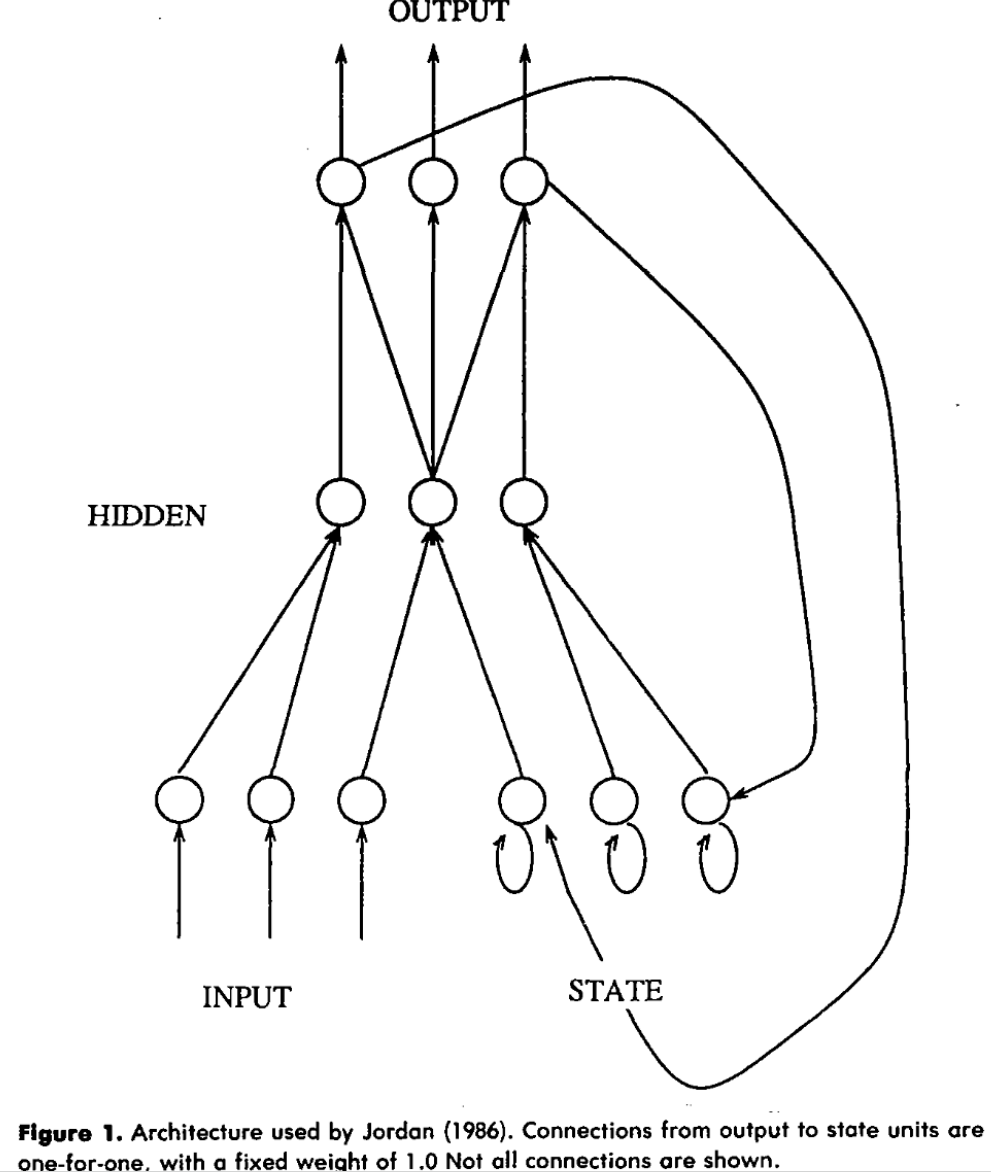
总体来看,这篇论文花了大量的篇幅介绍前人的研究成果和技术的底层原理,但整体的架构是非常简单的,一张图就可以表示:
AI总结
传统的并行分布式处理(PDP,即早期的神经网络)擅长处理静态的空间模式输入输出,但无法解决序列行为(Serial Order)。人类在说话、打字、走路时,动作是有先后顺序的,且当前的动作高度依赖于之前的状态。Jordan 探讨的是:一个没有内部时钟的并行网络,如何按顺序产出一系列有特定先后关系、有时间跨度的动作。
Jordan 提出了一种通过外部反馈(External Feedback)引入时间维度的方法。
| |
网络由四层结构组成:
- 计划层 (Plan Layer):输入端。在整个序列输出期间,计划层的激活状态保持恒定。它代表整体意图(例如“单词 X”或“动作序列 A”)。
- 隐藏层 (Hidden Layer):进行非线性特征组合。
- 输出层 (Output Layer):产生当前时间步的实际动作或特征。
- 状态层 (State Layer / Context Layer):这是该架构的核心创新。
- 状态层接收两个来源的输入:一个是输出层当前的直接反馈,另一个是状态层自身的自连接循环反馈。
- 数学物理机制:状态层单元具有持续性,其更新公式为:
其中 $\mu$ 介于 0 到 1 之间(衰减因子)。这意味着状态层对过去所有输出进行了加权指数衰减式的累积,形成了对“过去行为轨迹”的记忆。
Backpropagation Applied to Handwritten Zip Code Recognition(1989)
概览与总结
这篇论文将反向传播算法用来训练一个可以识别从邮件中获取的手写数字的卷积神经网络,是第一次将反向传播用在实际工程中的论文,也证明了神经网络相比其他算法的优越性.
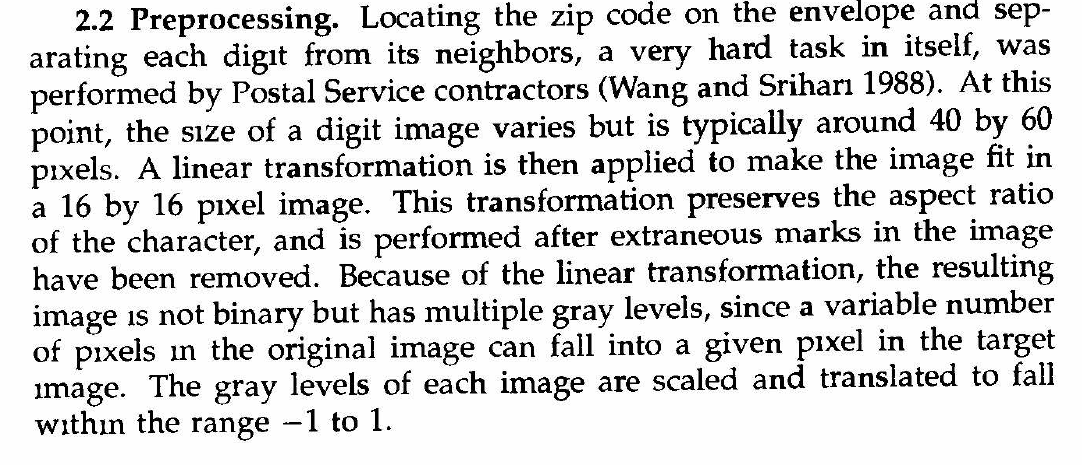
首先,研究者将40到60像素的手写数字图片通过线性映射处理成16x16像素的图片,尽可能的保留了原图像的灰度特征:
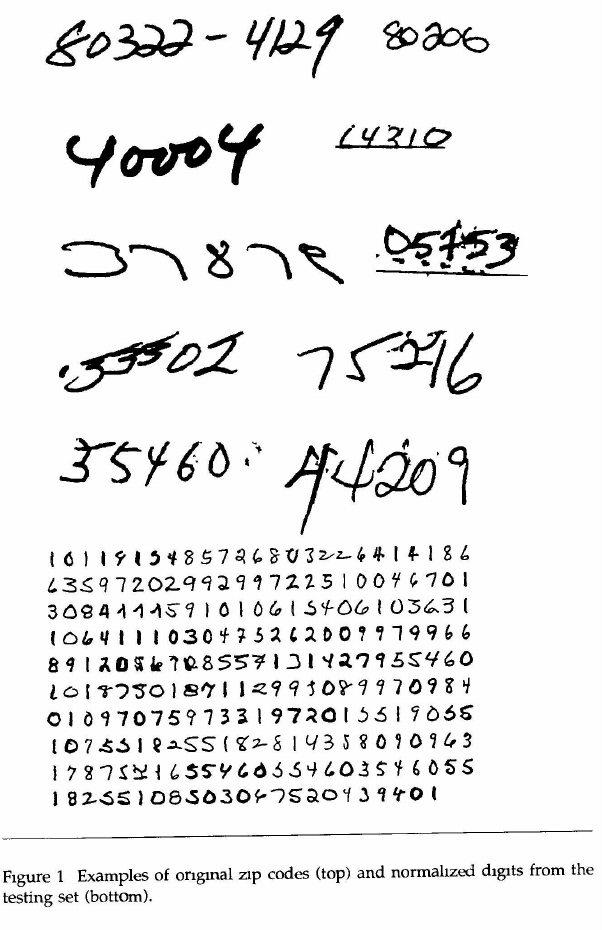
然后通过卷积神经网络和反向传播计算,我们会得到10个数字的概率输出:
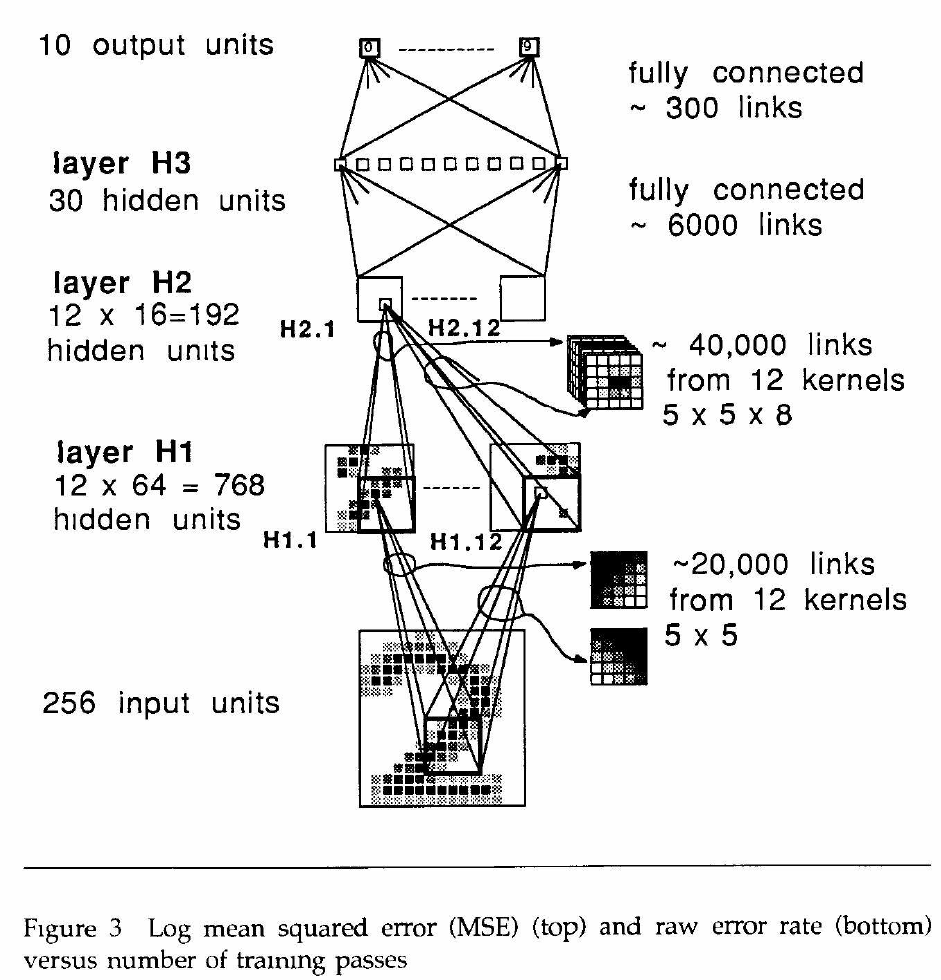
- 如果你阅读过« Deep Learning From Scratch»的话,就会发现这正是这本书前几章所用的例子,换句话说,作者把这篇论文用简单的语言和代码又翻译了一遍而已.
大概的训练方法:
- 所有的连接权重(Weights)和偏置(Biases)全部使用均匀分布(Uniform Distribution)进行随机初始化,随机范围严格控制在 $[-\frac{2.4}{F_i}, \frac{2.4}{F_i}]$ 之间
- 使用MSE(均方误差)来计算误差
- 使用小批量的SGD算法进行反向传播计算
- 总训练次数为23轮
全文的内容大致就是这样,在今天看来是平平无奇的,在当时来看的话那可真的是天纵英才的设计啊.
Finding Structure in Time(1990)
引言
具有时间顺序的数据(后简称时序数据)在实际生产中很常见,但以往的模型最常用的方法是,将不同时间的数据拆分到一个序列中输入,也就是以空间换时间,但作者提出,我们不应该把时间看作一个额外的输入维度,而应该在加工数据时就把时间考虑进去.
该论文接下来分为几个部分:
- 介绍用空间换时间带来的问题(略过不看,因为全是作者的主观论述,没有一点点实际数据的支撑,这在顶刊论文中还是很少见的)
- 研究方法
- 实验结果
研究方法
作者提出,要能够处理时序数据,最好的解决方法是让模型具有记忆能力.在Jordan(1986)论文的基础上,他设计了这样一个模型:
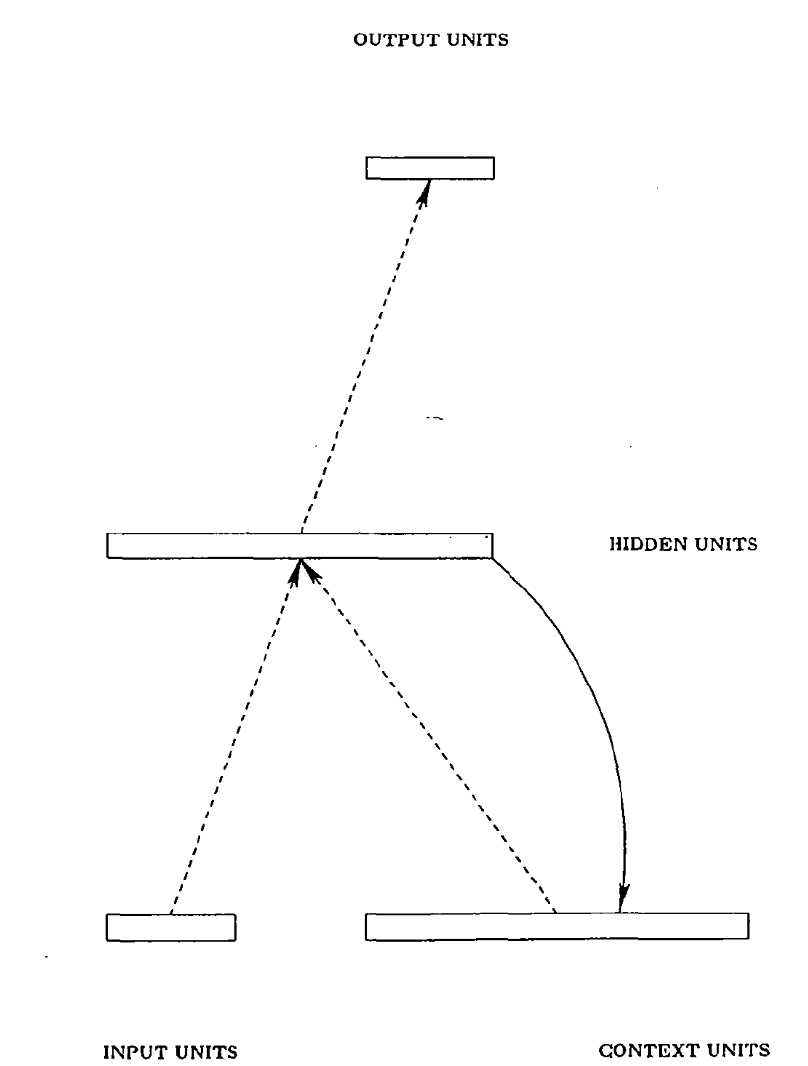
- 如果看过Jordan论文的话就会知道,Elman只是把状态层改成与隐藏层绑定,而非和输出层绑定,这就是唯一的区别,但这样一来,我们就可以让训练参数与输出结果解耦,实现更好的训练效果.
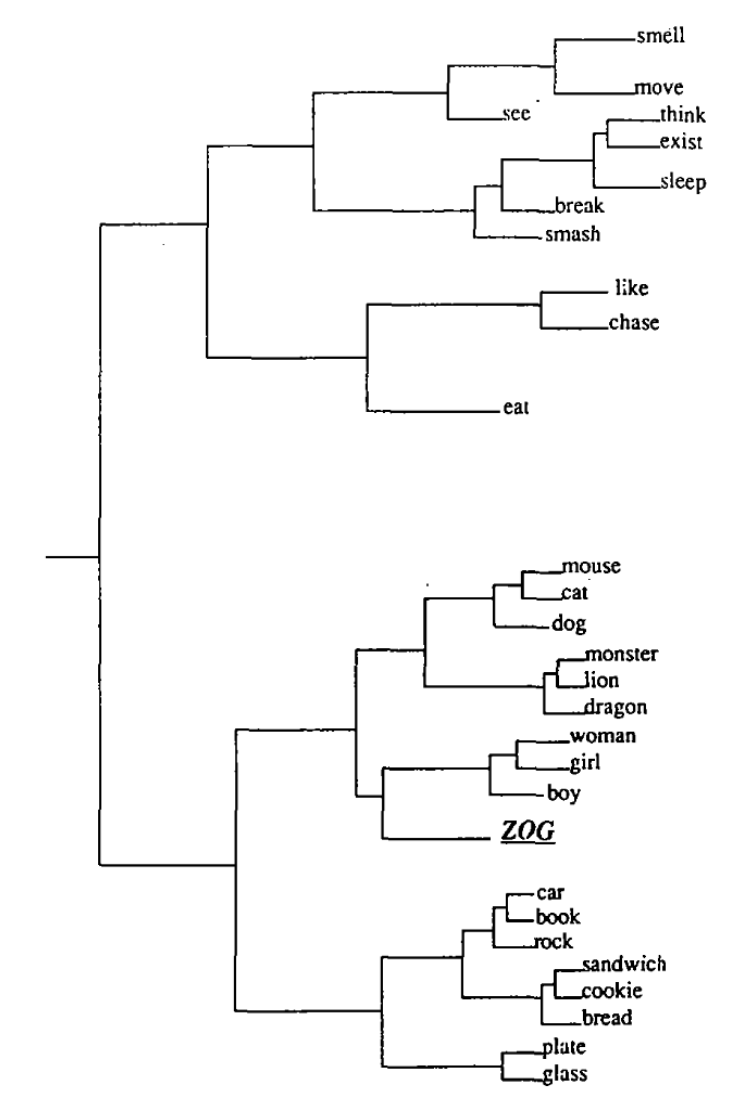
在之后就没有什么内容了,基本都是实验和不痛不痒的论述,重点在于说明这种架构为什么可以适配时序数据,因为相邻的输入确实比距离遥远的输入权重关系更近:
LONG SHORT-TERM MEMORY(1997)
- 机器学习领域划时代的论文不多,但这篇论文可以算上.
总结
尽管这篇论文很经典,但论述实在太专业了,而且理论公式让人看着头疼:
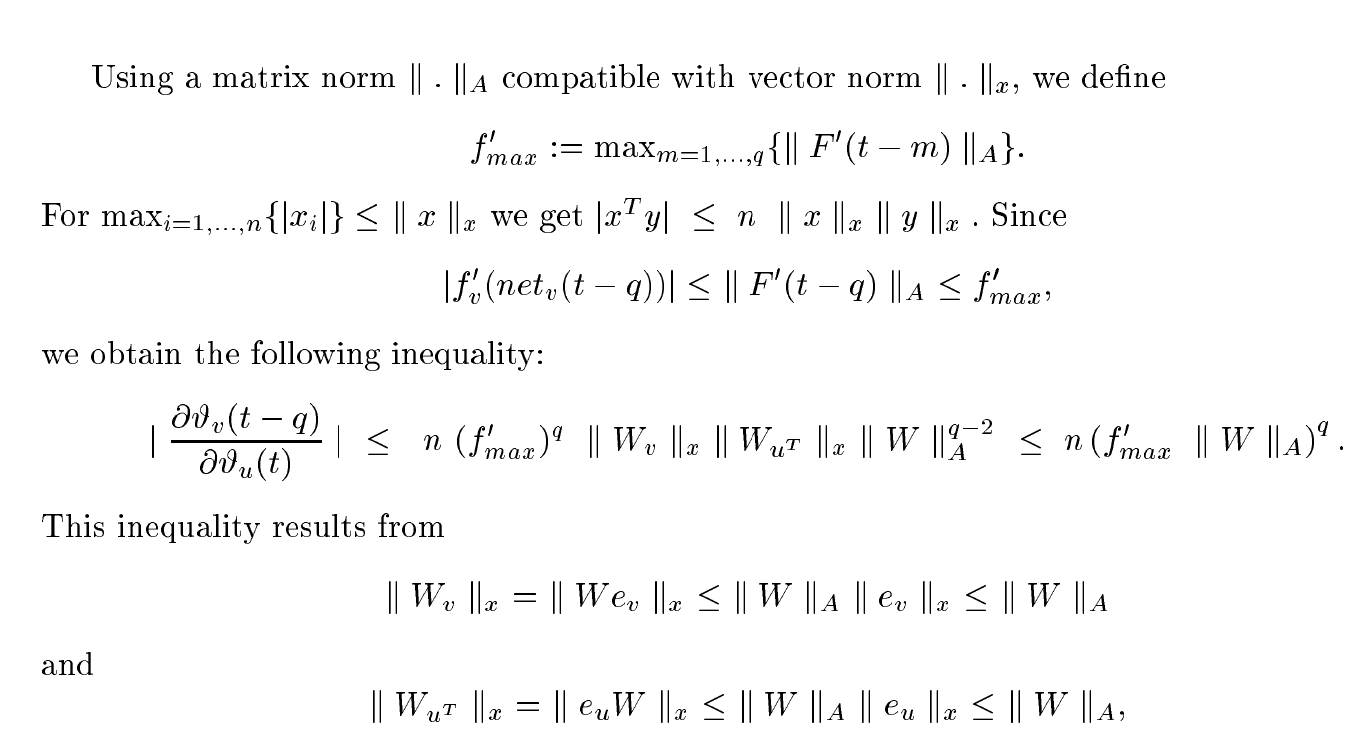
简单来说就是,LSTM将RNN中的隐藏层单元替换成了LSTM单元(Cell);
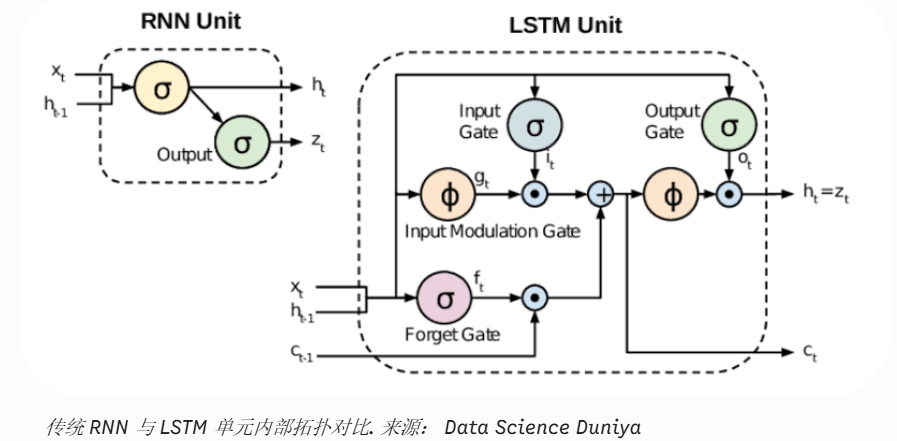
这个单元可以进行循环计算,能够将不同时刻的数据联系起来:
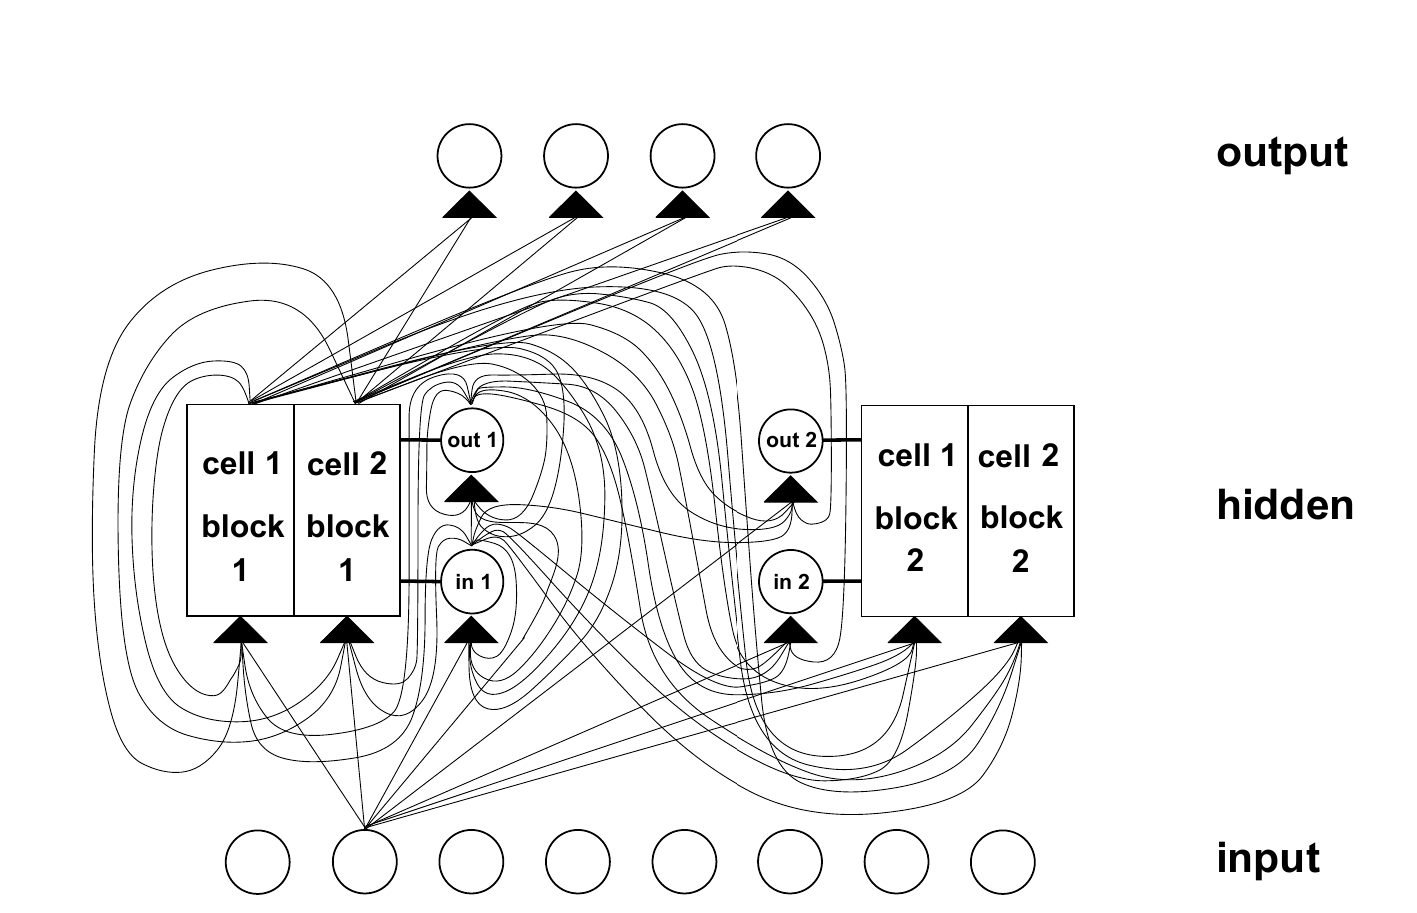
这种架构能够大大加速训练过程,并减少时间间隔过长引发的信息丢失.
在Transformer诞生之前,LSTM是主流的NLP框架,尽管它能够处理更长的时间步长,但在面对大量的数据时仍然无能无力,所以现在的大模型都不会使用它了.
A Neural Probabilistic Language Model(03)
- 这篇论文引入了embedding的雏形概念,是后续NLP模型的必要组成部分.
引入
NLP的一大难点在于输入的词向量可能有各种各样的维度,与训练数据完全不同,该论文提出,可以通过训练让模型学会比训练数据多上指数级别的语义相近的实际数据.具体来说就是模型同时学习离散的单词和完整的句子,当出现与训练数据结构类似的句子时也可以很好的做出应对.
- 我已经尽力翻译了,但原文确实太难看懂了,不像是摘要,还是接着看具体实现吧.
传统的词估计方法n-gram(n为上下文词个数,如trigram只看前两个词)无法理解句子之前的相似性,不能将训练集的结果扩展到无数的可能输入中,效果很差.
该论文提出,尽管潜在的词向量维度很大(比如有17000个用于训练的英文单词,每个单词都用one-hot表示,就需要17000个17000维度向量,但有效的信息其实只有一个维度),但我们可以用一个比较小的维度向量来存储单词(例如30,60维):
| |
但是,这个词向量要怎么训练呢,又如何将这种词向量转换成预测的输出呢,这就需要探究一下该论文的模型架构了.
模型架构
输入时,我们可以将句子拆分成一个个英文单词(而非如今常说的token),这些英文单词不再使用高维向量的one-hot表示,而是使用数字编号(例如the对应1,cat对应2).每个数字编号对应一个低维度(30维或者60维)的词向量(如前所说).
最初的词向量是选用特定的随机算法产生的初始值,训练时,会将输入的句子送进神经网络中,得到下一个词的预测概率,如果词表中有17000个词,那么就有17000个输出,概率总和为1,选取概率最大的那个词输出即可.
具体的神经网络结构如下:
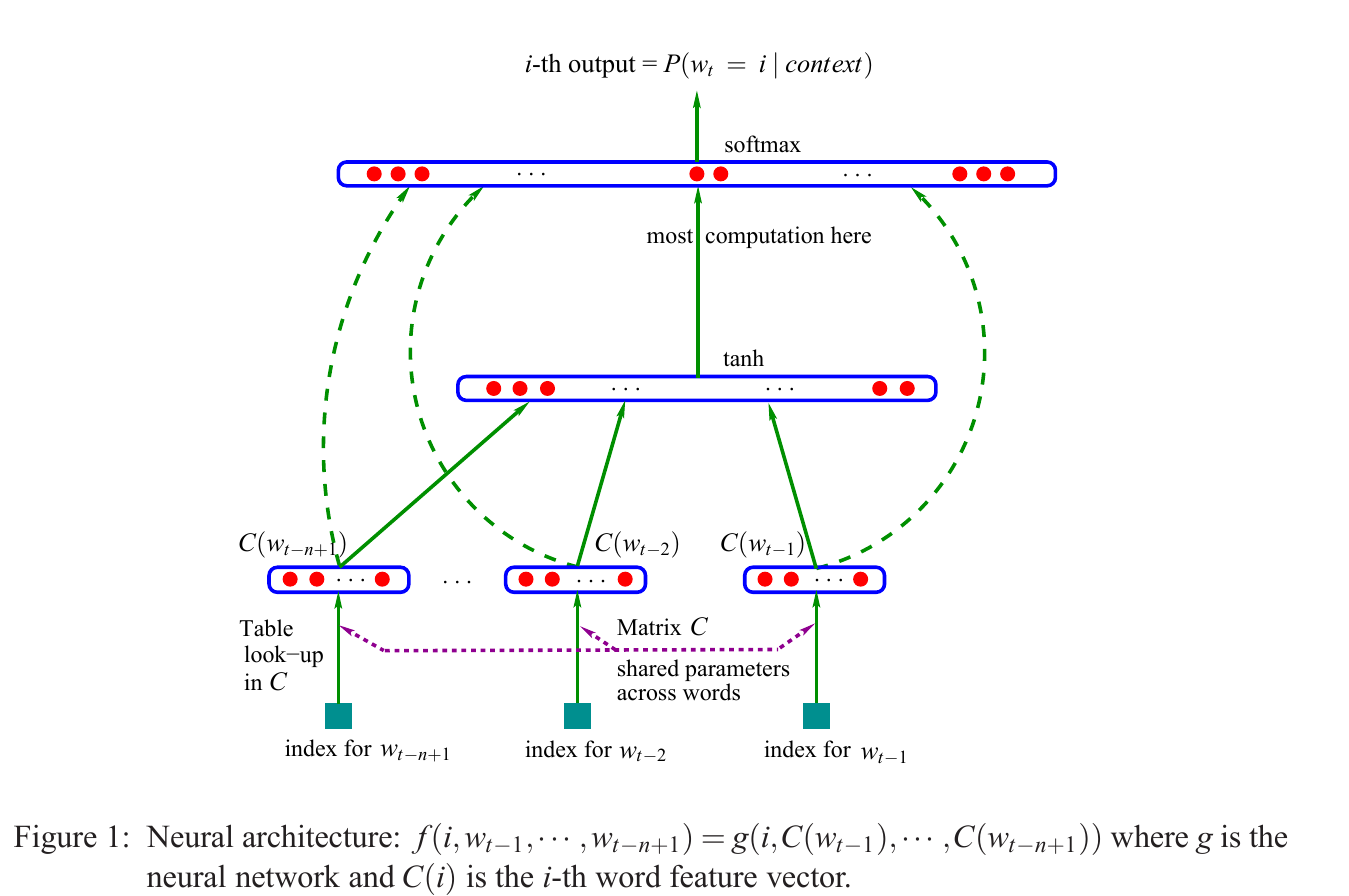
可以看到,我们首先使用tanh函数处理输入的词向量,得到词表中每个词的基本输出分数,再通过softmax计算出最大概率的词是哪个.
该论文还提出,由于softmax层涉及大量的指数运算,所以需要相对大的算力来进行,可以采用各种各样的并行算法来优化计算.
总结
整体原理相当简单,遗憾的是写文章的人相当咬文嚼字,长难句一大堆,不太喜欢把技术实现写明白点.
Linguistic Regularities in Continuous Space Word Representations(13)
概览和总结
该论文提出了一种词向量相似性的计算方法: The Vector Offset Method,如果两对词向量对应的词语语义相近,那么它们在词向量上的分布也是相近的,例如:
$$\text{king} - \text{man} + \text{woman} \approx \text{queen}$$具体的方法就是通过其他三个向量计算出目标向量:
y=xb−xa+xc
词表中于y余弦相似度最高的词即为目标词向量.
该论文通过实验证明,如果词向量的维度越高,计算出来的相似词的准确度就越高,部分解答了为什么词向量能够对应现实文本的语义,为后续的模型训练提供了一定的理论依据.
Efficient Estimation of Word Representations in Vector Space(13)
模型架构
在03年那篇论文的基础上,该论文提出了两种新的简化模型架构: CBOW(Continuous Bag-of-Words Model)和Skip-gram,架构图如下:
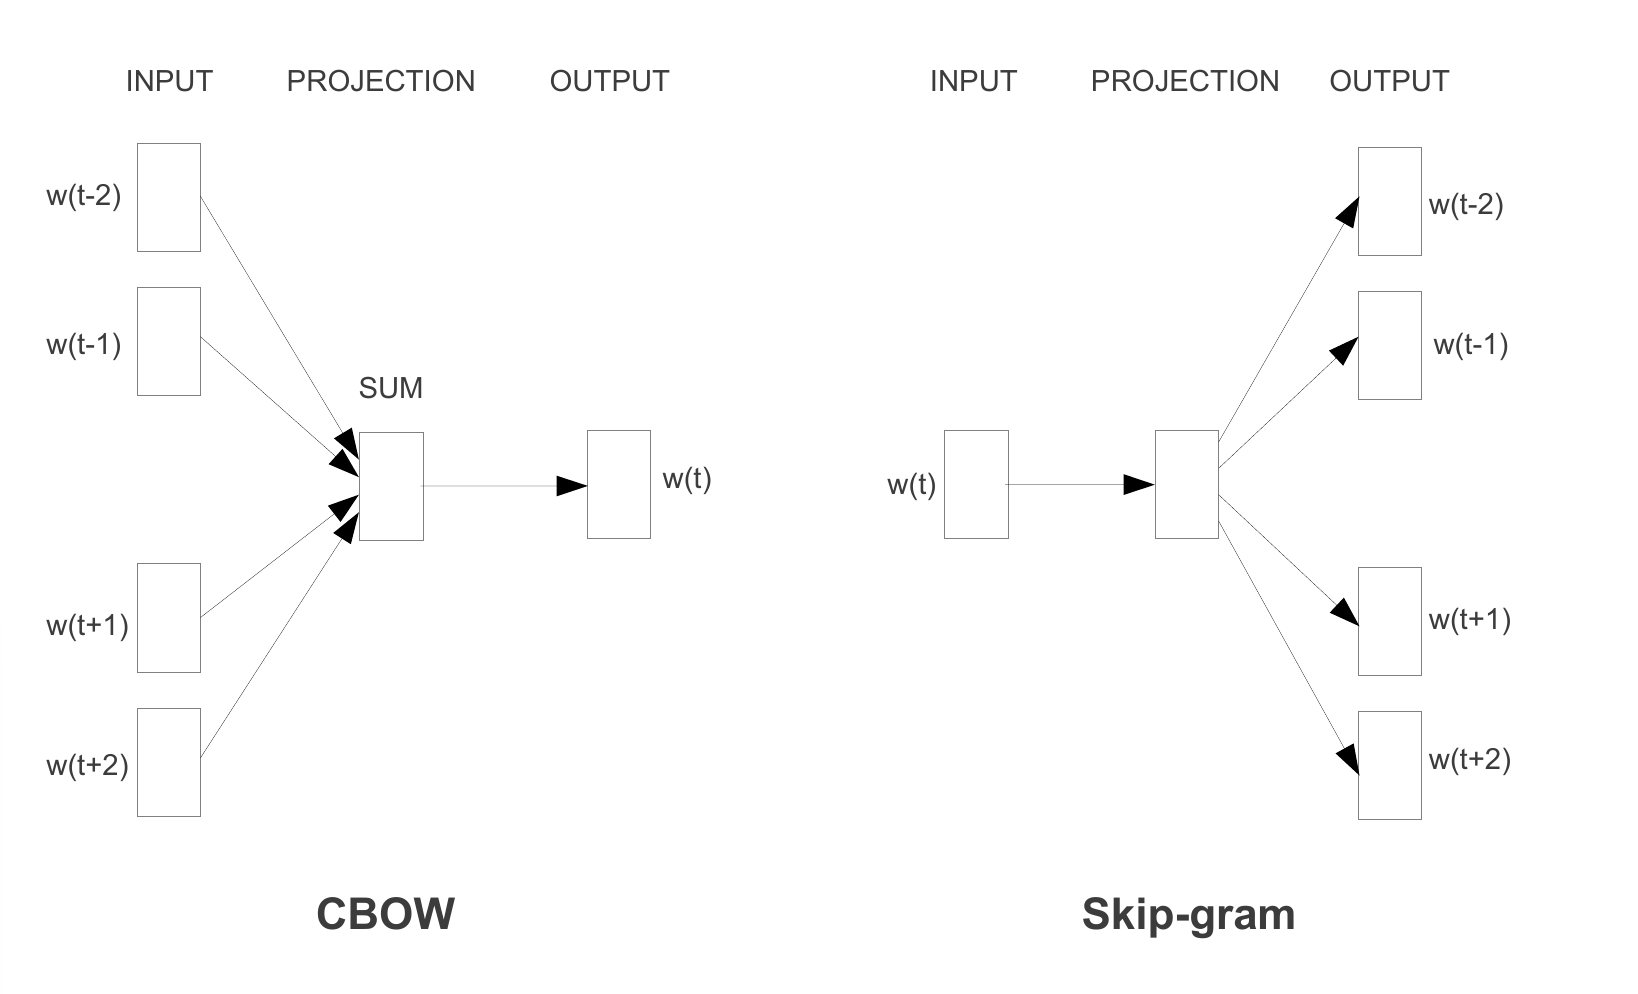
CBOW根据上下文语境预测中间词,而Skip-gram根据中间词预测上下文
Dropout: A Simple Way to Prevent Neural Networks from Overfitting(14)()
- 在一大堆公司冠名的论文中突然冒出来一个多伦多大学还是很惊艳的
Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation(14)
- 这篇论文可能是最早提出编码器-解码器架构的,但我也不太确定.
总结
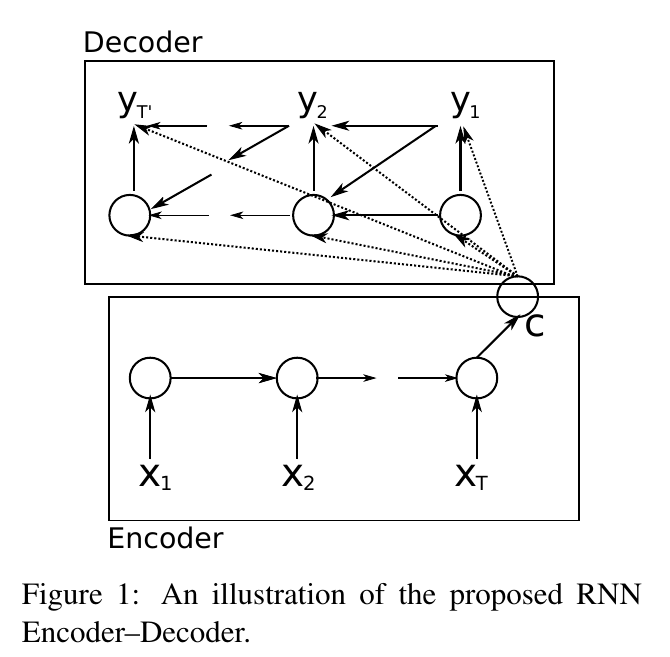
该论文提出了用两个循环神经网络(RNN)组成的编码器-解码器架构,编码器将输入数据处理成固定长度的向量,解码器将向量处理成输出数据.
在此之上,论文还提出了一个LSTM单元的简化版本作为RNN的隐藏层,是后续GRU(Gated Recurrent Unit)的雏形:
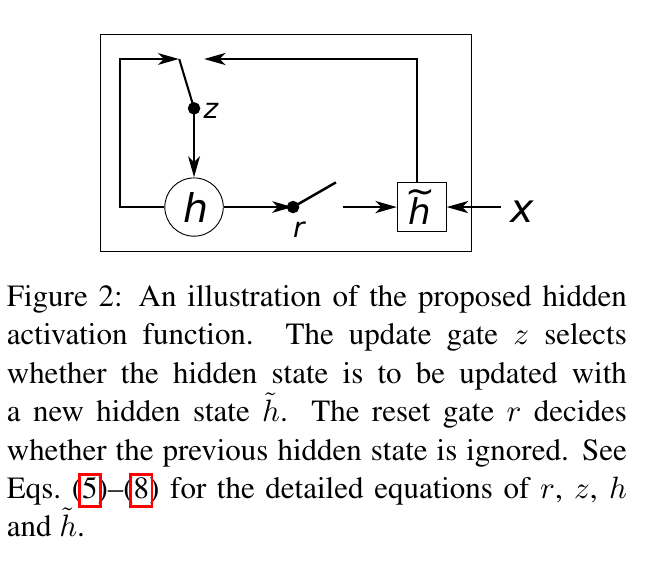
完整的流程如下:
- 编码器不断读取输入,将其处理成固定长度的向量
- 解码器根据向量逐个输出预测值,最大化下一个词的条件概率,每个预测值都与之前的所有输入相关:
由于当时SMT(statistical machine translation)是主流的NLP模型,所以该论文仅仅是把这个新架构作为SMT的补充部分,没有预想到它的潜力会有这么大.
Sequence to Sequence Learning with Neural Networks(14)
概括与总结
该论文提出,可以使用两个多层的LSTM网络,一个用于将输入序列(sequence)编码成固定长度的词向量,另一个用于将词向量解码成输出序列.与上一篇论文相同,也是拿把英语翻译成法语的任务来做实验.
- 这篇论文基本贡献只是把上一篇论文中的RNN隐藏层换成了LSTM单元,彻底脱离了SMT system,尽管如此,它的影响力还是比较大的,后续论文尊称该论文的模型架构为seq2seq模型.
Distilling the Knowledge in a Neural Network(15)
- 该论文提出了后续被广泛使用的蒸馏(distillation)方法
概览与总结
尽管大型模型的输出正确率更高,但所需要的输出时间和算力也随之变高,如果我们能够将大型模型的参数"压缩"到一个小模型上,实现基本相同的输出效果,那就很完美了.
我们将原始的大型模型称为教师模型(teacher),要用到的小模型称为学生模型(student),我们的训练目标就是: 对于同一批输入数据,小模型的目标损失函数就是大模型的损失函数加上自身的损失函数.
实际来说我们需要引入温度参数,通过非常玄学的炼丹让小模型能够尽可能地接近大模型的性能.
由于原文讲的不怎么清晰,所以移步讲的很好的知乎回答可以大致了解蒸馏的全部原理.
尽管如此,直接构造一个小模型未必就会比蒸馏得到的小模型差,所以实际的用途还是比较有限,当然如果自己没有足够的算力用来训练,直接复用别人的开源模型拿来蒸馏,就可以得到一个规模相当的"新模型",这是一个非常值当的买卖,很多"科创公司"实际上也正是这样做的.
ADAM: A METHOD FOR STOCHASTIC OPTIMIZATION(15)
- 这篇2015年的论文提出了一种新的神经网络学习方法:ADAM,是两年后推出的Transformer模型的核心算法,还是很有必要了解的
- (26/4): 第一次读论文,也不知道怎么读,总不至于全部复制过来再逐个翻译吧,想了想还是读完全文后做一点要点总结算了.
引入
在机器学习中,常见的优化算法都属于一阶方法first-order methods,即只使用目标函数(例如损失函数)的一阶导数(例如梯度)来更新参数.其中,随机梯度下降法****stochastic gradient descent (SGD)****是最著名也是非常有效的学习方法. 本文提出的Adam算法同样也是一个随机最优化(stochastic optimization)的一阶算法,它的名字来源于
adaptive moment estimation. 该算法借鉴了两个优秀算法的长处:
- AdaGrad,于2011年提出,可以很好地处理稀疏梯度(即梯度向量中绝大多数元素为0的情况)
- RMSProp,于2012年提出,能够很好地处理小批量训练?(on-line)和非平稳环境(not-stationary).
算法实现
伪代码
$$\begin{array}{l}
\hline \mathbf{Algorithm\ 1:} \text{ Adam, our proposed algorithm for stochastic optimization. See section 2 for details,} \
\text{and for a slightly more efficient (but less clear) order of computation. } g_{t}^{2} \text{ indicates the elementwise} \
\text{square } g_{t} \odot g_{t} \text{. Good default settings for the tested machine learning problems are } \alpha=0.001, \
\beta_{1}=0.9, \beta_{2}=0.999 \text{ and } \epsilon=10^{-8} \text{. All operations on vectors are element-wise. With } \beta_{1}^{t} \text{ and } \beta_{2}^{t} \
\text{we denote } \beta_{1} \text{ and } \beta_{2} \text{ to the power } t . \
\hline \mathbf{Require:} \alpha: \text{Stepsize} \
\mathbf{Require:} \beta_{1}, \beta_{2} \in[0,1): \text{Exponential decay rates for the moment estimates} \
\mathbf{Require:} f(\theta): \text{Stochastic objective function with parameters } \theta \
\mathbf{Require:} \theta_{0}: \text{Initial parameter vector} \
\quad m_{0} \leftarrow 0 \text{ (Initialize } 1^{\text {st }} \text{ moment vector)} \
\quad v_{0} \leftarrow 0 \text{ (Initialize } 2^{\text {nd }} \text{ moment vector)} \
\quad t \leftarrow 0 \text{ (Initialize timestep)} \
\quad \mathbf{while} \ \theta_{t} \text{ not converged } \mathbf{do} \
\quad\quad t \leftarrow t+1 \
\quad\quad g_{t} \leftarrow \nabla_{\theta} f_{t}\left(\theta_{t-1}\right) \text{ (Get gradients w.r.t. stochastic objective at timestep } t) \
\quad\quad m_{t} \leftarrow \beta_{1} \cdot m_{t-1}+\left(1-\beta_{1}\right) \cdot g_{t} \text{ (Update biased first moment estimate)} \
\quad\quad v_{t} \leftarrow \beta_{2} \cdot v_{t-1}+\left(1-\beta_{2}\right) \cdot g_{t}^{2} \text{ (Update biased second raw moment estimate)} \
\quad\quad \widehat{m}{t} \leftarrow m{t} /\left(1-\beta_{1}^{t}\right) \text{ (Compute bias-corrected first moment estimate)} \
\quad\quad \widehat{v}{t} \leftarrow v{t} /\left(1-\beta_{2}^{t}\right) \text{ (Compute bias-corrected second raw moment estimate)} \
\quad\quad \theta_{t} \leftarrow \theta_{t-1}-\alpha \cdot \widehat{m}{t} /\left(\sqrt{\widehat{v}{t}}+\epsilon\right) \text{ (Update parameters)} \
\quad \mathbf{end\ while} \
\quad \mathbf{return} \ \theta_{t} \text{ (Resulting parameters)} \
\hline
\end{array}$$
有几个专业名词不太好懂:
- first moment: 一阶矩,即梯度的期望(均值)
- second raw moment: 二阶原始矩,不对数据减去均值直接求平方期望,若减去均值在求平方期望,则称为中心矩(即方差)
exponential decay rates: 指数衰减率,衰减率越大参数更新越慢,之所以叫指数是因为某一时刻的值是先前所有历史值的加权和: - $$V_t = (1-\beta)(g_t + \beta g_{t-1} + \beta^2 g_{t-2} + \beta^3 g_{t-3} + \dots)$$
- 大概这种论文都有一个伪代码来简单的解释自己算法的整个流程吧,乍一看有点懵,实际上确实比看文字更好懂一点
具体原理
The stochasticity might come from the evaluation at random subsamples (minibatches) of datapoints, or arise from inherent function noise.
- 之所以说这个算法是随机的,是因为它的数据可能是一个随机的小批量抽取,或者说数据本身存在噪音
However, these moving averages are initialized as (vectors of) 0’s, leading to moment estimates that are biased towards zero, especially during the initial timesteps, and especially when the decay rates are small (i.e. the βs are close to 1).
- 由于m和v的初始值被置为0,所以在函数刚起步的时候,特别是当衰减率也很低(β接近1)时,会导致矩估计(均值)偏向0,导致学习失败.
因此,我们需要用一点技巧来克服这个问题,这会在下一章被解决.
- 看了一个小时,明天再来,看论文确实很累
误差修正
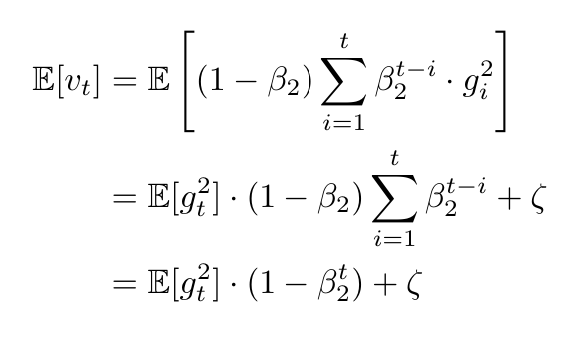
通过一个简单的等比数列求和,我们发现某一时刻的梯度被缩小到了真实值的$(1 - \beta_2^t)$ 倍,所以在伪代码中我们会在计算出两个参数后对其进行误差修正.
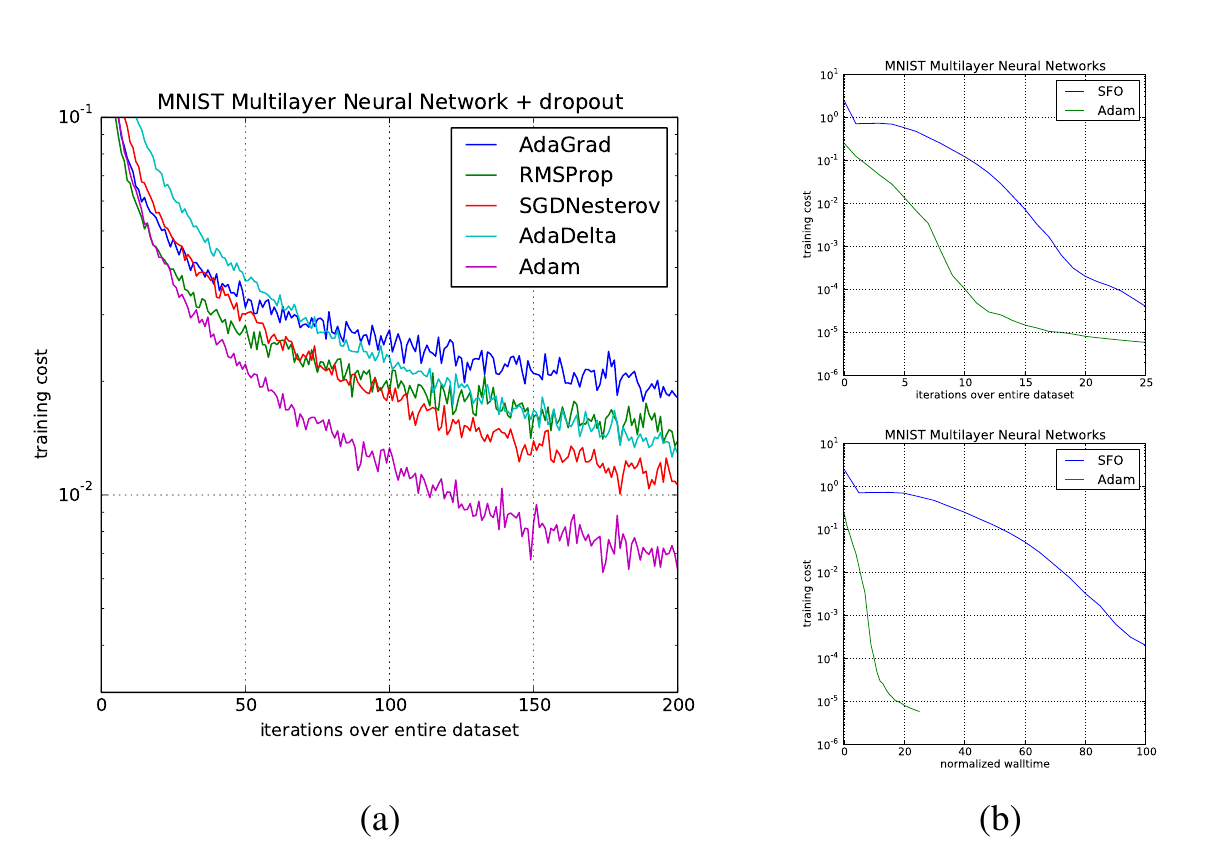
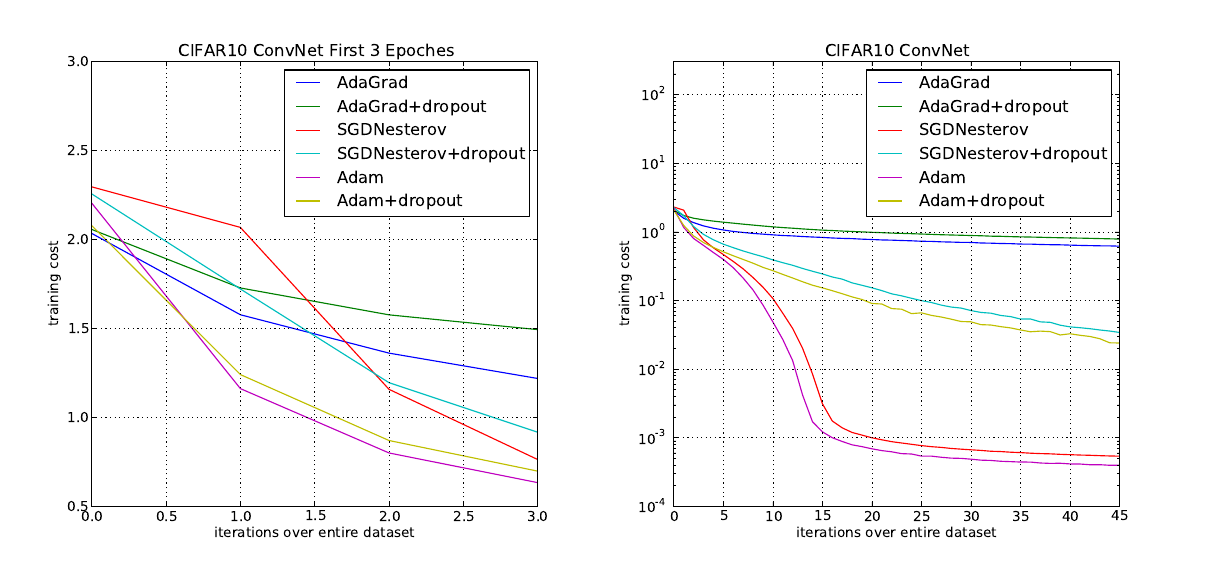
4个实验
选取的实验都是非常经典的模型,而不是像某些垃圾论文一样用一些奇怪的数据集在奇怪的模型上训练.
- training cost: 指的就是损失函数值
LOGISTICR EGRESSION
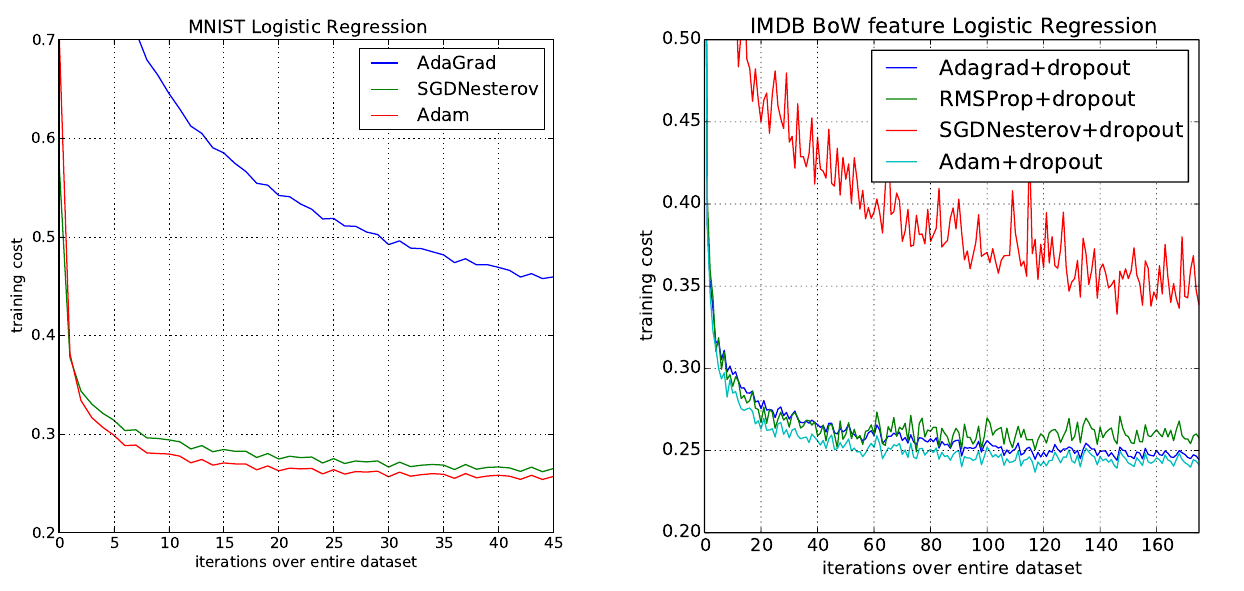
MULTI-LAYER NEURAL NETWORKS
CONVOLUTIONAL NEURAL NETWORKS
BIAS-CORRECTION TERM
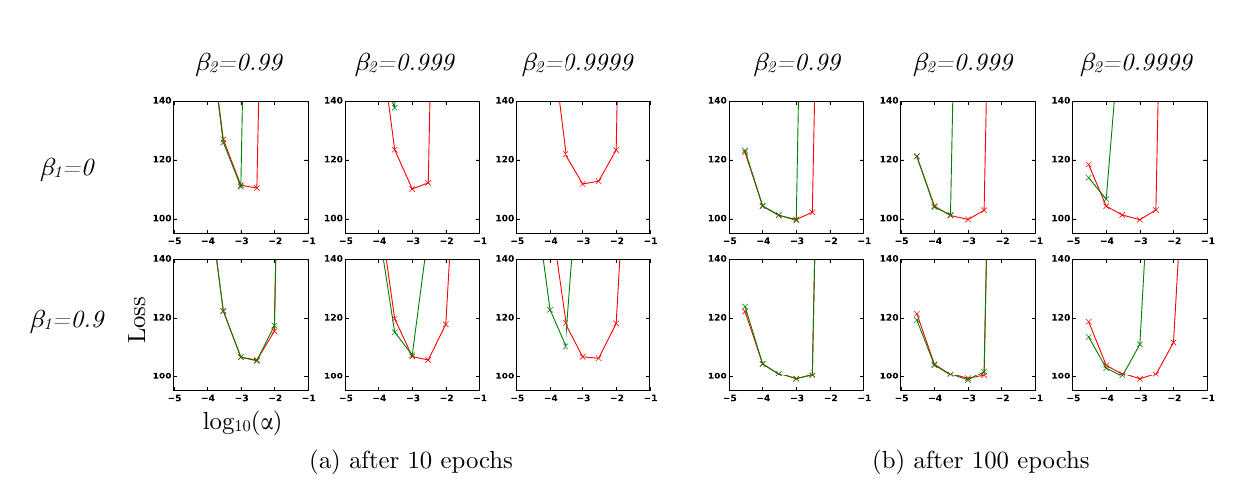
基本都是全方位打压以前的反向传播算法
结论
- 有个扩展的AdaMax算法被我忽略掉了
- 附录也被我省略了,数学不好的人是看不得这种东西的
-
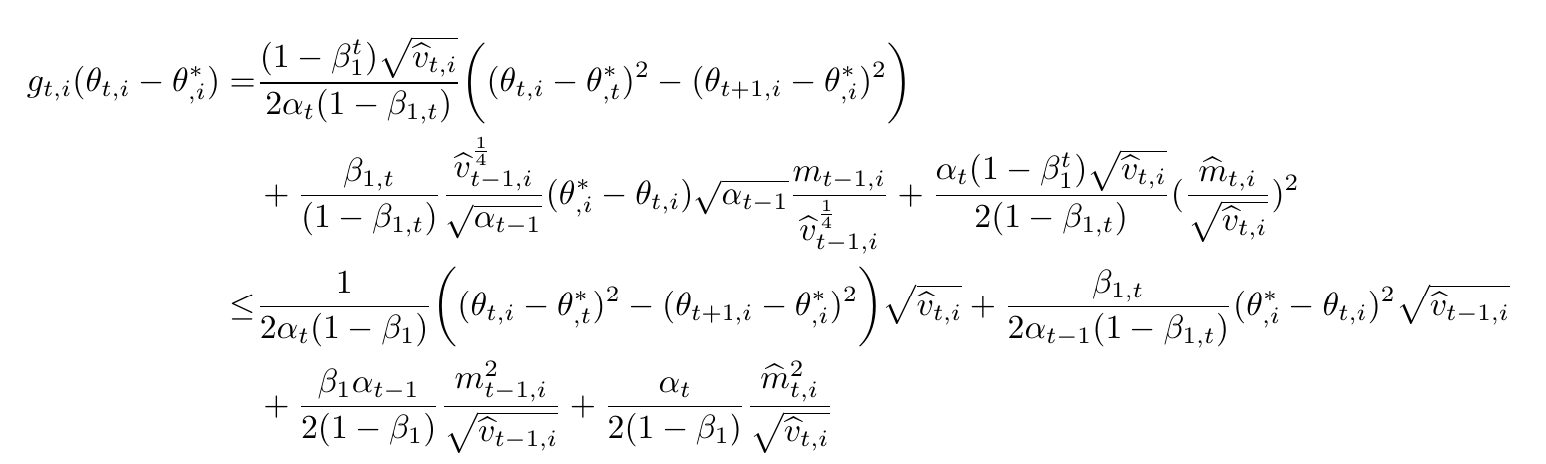
The method combines the advantages of two recently popular optimization methods: the ability of AdaGrad to deal with sparse gradients, and the ability of RMSProp to deal with non-stationary objectives.
The method is straightforward to implement and requires little memory. The experiments confirm the analysis on the rate of convergence in convex problems.
Overall, we found Adam to be robust and well-suited to a wide range of non-convex optimization problems in the field machine learning. 第一篇论文看下来的感受还是挺好的,既没有什么宏大叙事,也没有多少弯弯绕绕,很清楚的把一个算法的前前后后都讲清楚了,非常推荐阅读.
Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift(15)
- 影响非常深远的BN方法就是这篇论文提出的
概览与总结
在深层神经网络中,由于位置靠后的层在训练时总是需要根据位置靠前的层的参数的变化而调整,会严重拖累训练的进度,这种现象被称为Internal Covariate Shift,大意为,其他层的变化导致该层也不得不变化而产生的训练偏差.
因此,该论文提出可以使用Batch Normalization来处理训练时输入的mini-batch,从而加速训练和减少偏差,实际的应用效果也非常好. 核心算法步骤 对于一个拥有 $m$ 个样本的小批量(Mini-batch)数据 $\mathcal{B} = {x_{1…m}}$:
- 计算批次均值(Mini-batch Mean):
- 计算批次方差(Mini-batch Variance):
- 标准化(Normalize):
注:$\epsilon$ 是一个为了防止分母为0而加入的极小常数。
- 缩放与平移(Scale and Shift):
注:$\gamma$ 和 $\beta$ 是网络需要学习的标量参数。
实际上确实是很简单的处理,但偏偏就是很有效.
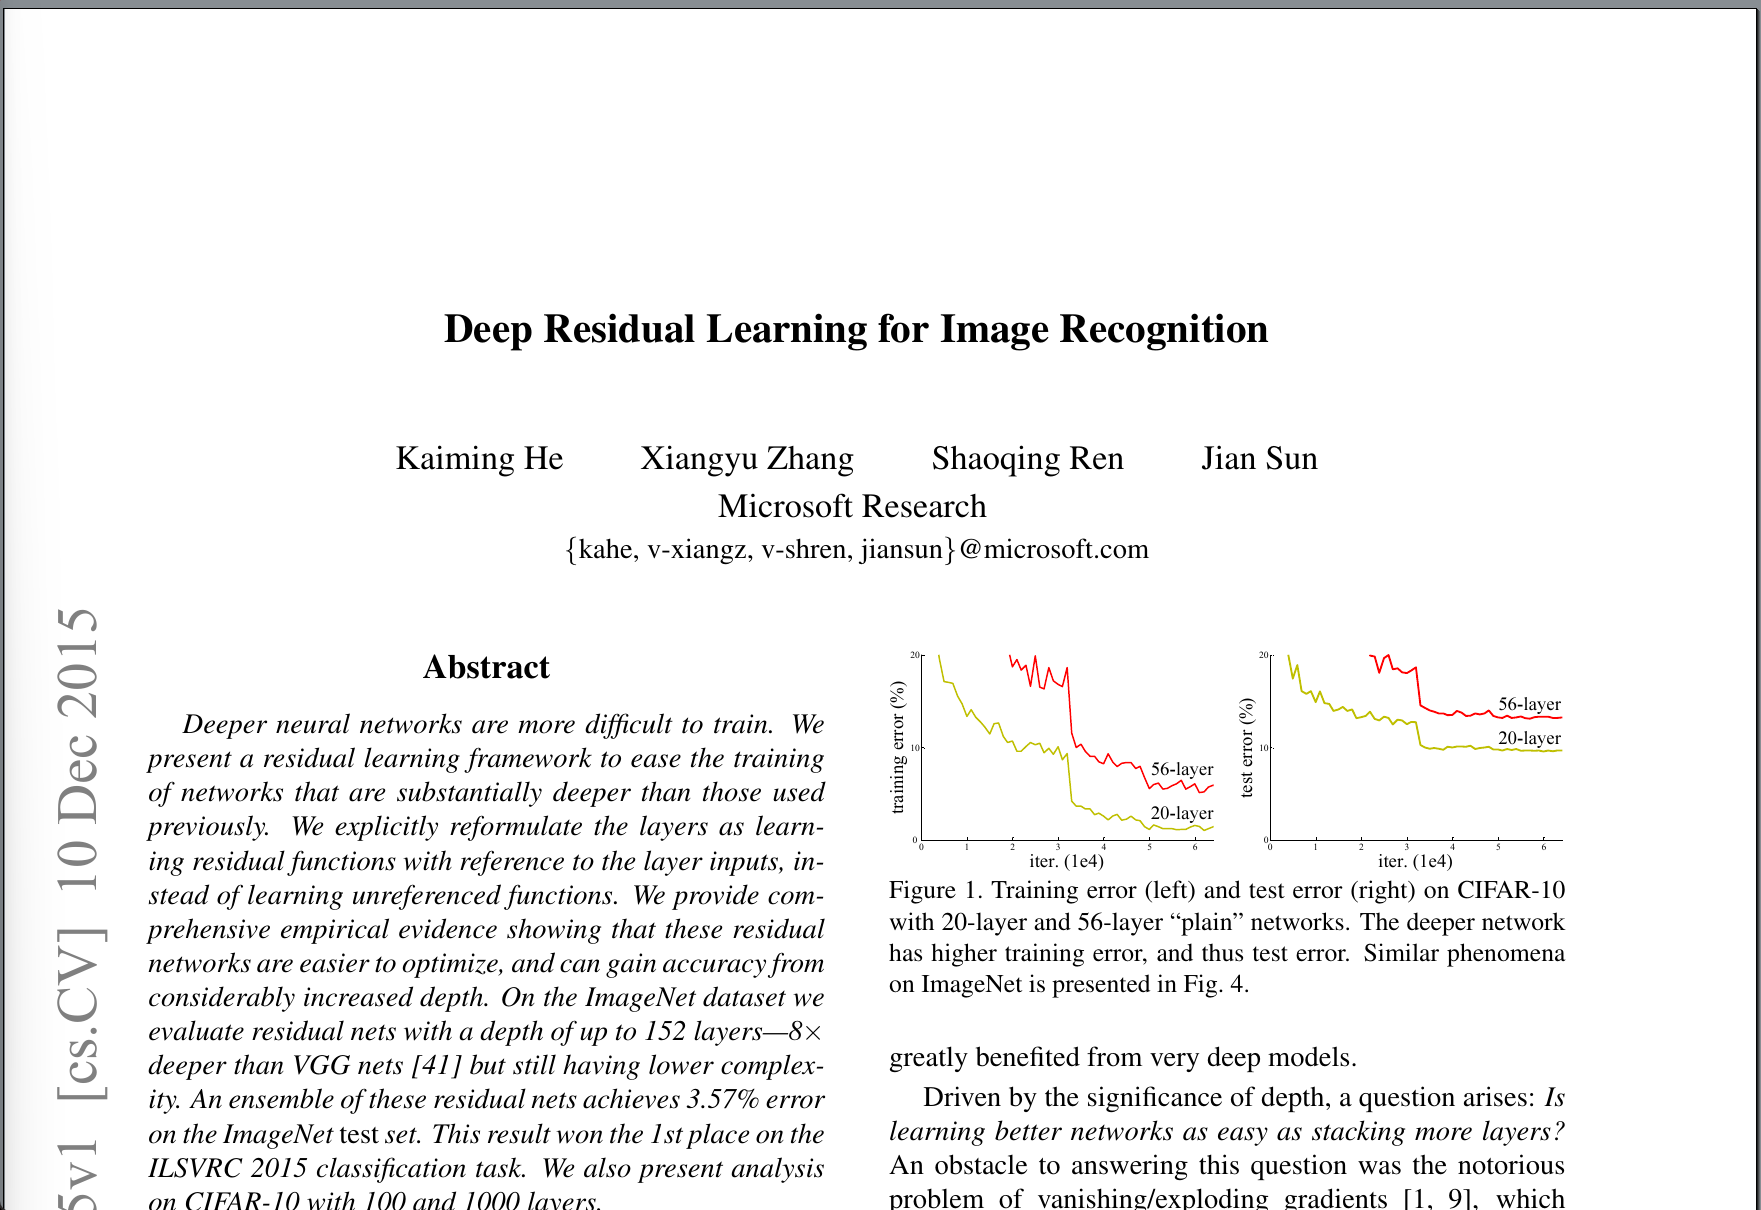
Deep Residual Learning for Image Recognition(15)
- 深度残差网络在2015年的ImageNet比赛中问世,成功击败了所有的竞争模型,一举夺魁.
概览与总结
仅仅是普通的加深网络层数未必会让训练效果更好,甚至会反过来让训练效果变差,该论文提出可以引入一个残差学习框架,这个框架基于以下原理:
假设有一个56层的网络,那么我们可以让前20层于普通的20层网络一样训练,后36层只做恒等映射,直接输出原值,那么这样加深多少层理论上都不可能会比原来的训练效果更差,如果我们对这些恒等映射层做一些简单的正向优化,那么训练结果就一定比20层网络更好.
实际的优化做法相当简单,更改附加层的训练目标即可:
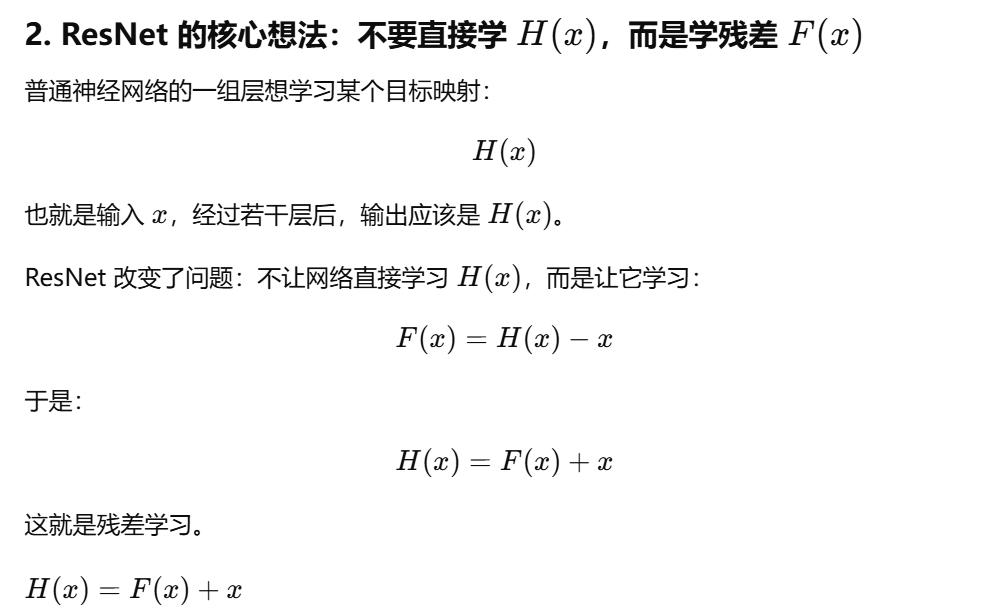
该框架后来被称为Deep residual network,简称为ResNet.
- 至于要看具体是怎么做的,该论文提供了github仓库,还是很不错的
后续的« Identity Mappings in Deep Residual Networks(16) »中这四个作者对ResNet做了进一步的分析,并提出了一个优化版本.
Neural Machine Translation by Jointly Learning to Align and Translate(16)
- 首先提出注意力机制的论文
概览与总结
两年前提出的RNN 编码器-解码器架构很难应付长难句,该论文提出,解码器不应该在输出时关注前后的几个单词和以往输出,而是应该聚焦于句子中与当前要输出的向量关联最大的部分和以往输出.
为了实现这个目的,该论文在编码器部分进行了特别的处理,不再针对一个输入生成一个特定的输出向量,而是针对输入中的每个单词都生成一个特定的向量h_i.
对于解码器的每一个输出单词y_t,它都会在考虑之前的输出的基础上,还考虑输入中的每个单词对应的向量h_i与该输出单词的关系.
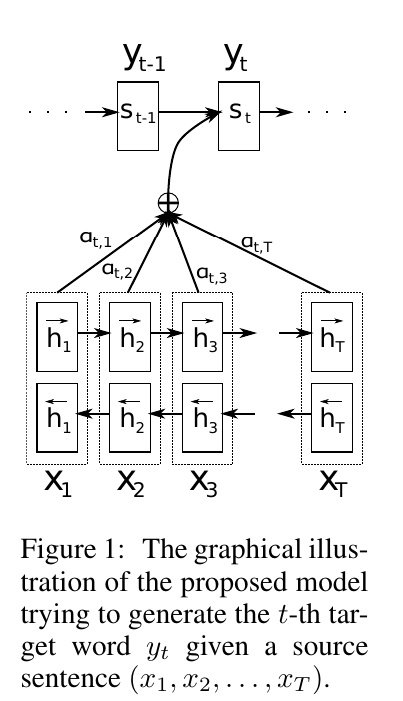
- 实际做法还是通过softmax计算每个向量h_i对于这个输出单词y_t的贡献,并做加权求和,而不是只选取贡献最大的向量h_i.
Transformer兴起
Attention Is All You Need(17)(待补充)
- (5/29): 为了能够看懂这篇威名远扬的论文,我作为一个完全的小白,在阅读完入门书后,又前前后后花了20天阅读前人的研究成果,终于得以一瞥这一横空出世的集大成者.
- (5/30): 成功败下阵来,信息密度太大了,在了解了前面这么多历史文献的情况下,我看这篇论文依然觉得很难受,待我过段时间再来研究
引言
该论文提出,我们完全不需要依赖RNN的循环单元或者CNN的卷积层,只用注意力机制就可以很好地解决输入与输出之间的依赖关系.
模型架构
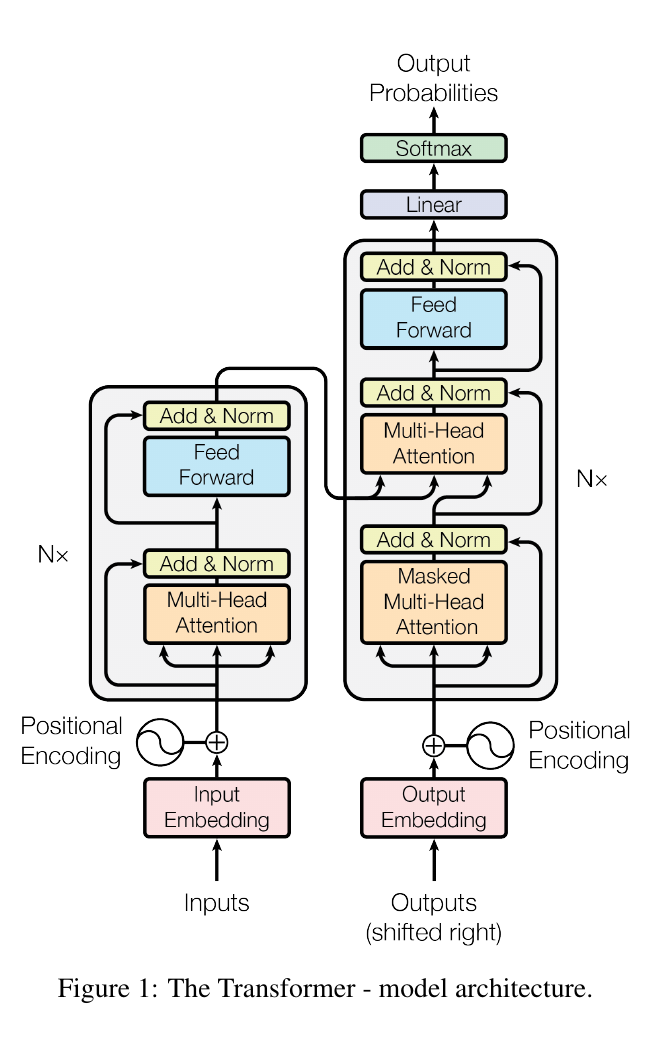
- Encoder: 由6个完全相同的层堆叠而成,每层由两个子层构成,一个是多头的注意力计算单元,一个是简单的全连接层,在这两个子层后,都跟着一个残差网络和正规化层,最终输出一个512维的向量
- Decoder: 同样由6个完全相同的层堆叠而成,在编码器的基础上多加了一个子层,用于在推理时处理之前的输出和在训练时喂入标准答案
Deep Reinforcement Learning from Human Preferences(17)
- 该论文提出了著名了RLHF方法
概览与总结
对于复杂的任务来说,我们无法建立一个合适的目标函数,然而,人类可以很好的判断这类任务的完成程度.
因此,很早就有研究提出,我们可以在强化学习阶段里让人类来评价Agent的表现来帮助Agent学习.
然而,这篇论文把这个观点进一步细化: 人类的打分是主观的,但是结果A和结果B哪个更好是可以由人类"客观的"比较出来的,因此可以作为训练目标用来强化模型的学习.
这篇论文并没有实际的结果,只是通过几个实验数据说明了一件事: 神经网络的学习在RLHF的帮助下能够变得更加平滑,减缓梯度消失的问题.
Improving Language Understanding by Generative Pre-Training(18)
- GPT-1
引入
先前的模型架构都只适配于单一的任务,针对不同的任务都要提供不同的标注好了的训练数据和参数.该论文提出,我们可以通过将自监督的预训练和有监督的调参结合起来,让模型能够只做很小的改动就可以适应各种各样的任务.
具体来说,就是把模型训练分为两步,第一步只使用未标注的数据来初始化模型,第二步才针对不同的任务使用不同的标注数据进行调参.
- 事实上,如文中所承认的那样,GPT的做法并不新颖,前人已经把Unsupervised pre-training用在了LSTM模型上,GPT只是把这个方法挪用到了Transformer上而已.
训练过程
Unsupervised pre-training
对于文本补全任务来说,我们只需要用到Transformer的后半部分,也就是解码器就足够了,论文中实际上也是这么做的.
$$L_1(\mathcal{U}) = \sum_i \log P(u_i|u_{i-k}, \dots, u_{i-1}; \Theta)$$Given an unsupervised corpus of tokens $\mathcal{U} = {u_1, \dots, u_n}$, we use a standard language modeling objective to maximize the following likelihood:
where $k$ is the size of the context window(这也是这几年的大模型着重强化的部分), and the conditional probability $P$ is modeled using a neural network with parameters $\Theta$. These parameters are trained using stochastic gradient descent.
- 之所以要取log(这实际上是自然对数),是因为我们最终需要计算所有输出token的条件概率的乘积,使用log可以把乘法变成加法,简化运算
上面只是训练的最终目标,而训练的中间过程可以用三个公式概括:
$$\begin{aligned}
h_0 &= UW_e + W_p \
h_l &= \text{transformer_block}(h_{l-1}) \forall i \in [1, n] \
P(u) &= \text{softmax}(h_n W_e^T)
\end{aligned}$$
where $U = (u_{-k}, \dots, u_{-1})$ is the context vector of tokens, $n$ is the number of layers, $W_e$ is the token embedding matrix, and $W_p$ is the position embedding matrix.
第一步将token变成带有位置信息的向量,第二步通过多层的transformer进行迭代计算,得到针对每个要输出token位置的"注意力向量",第三步使用softmax查找与该"注意力向量"最匹配的那个token并输出.
- 实际上来说就是把Attention那篇论文重新阐述了一遍,把原理讲的更清晰了.
总的来说,这一步的预处理最大化地应用了Transformer的结构优势,因为Transformer的解码器架构由于带有mask层,天生就适合用来进行自我监督训练.
Supervised fine-tuning
$$P(y|x^1, \dots, x^m) = \text{softmax}(h_l^m W_y)$$We assume a labeled dataset $\mathcal{C}$, where each instance consists of a sequence of input tokens, $x^1, \dots, x^m$, along with a label $y$. The inputs are passed through our pre-trained model to obtain the final transformer block’s activation $h_l^m$, which is then fed into an added linear output layer with parameters $W_y$ to predict $y$:
$$L_2(\mathcal{C}) = \sum_{(x,y)} \log P(y|x^1, \dots, x^m)$$This gives us the following objective to maximize:
- 实际上这与前面的步骤完全相同,只不过这次提供的语料是标注好了的而已.
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding(19)
- BERT: Bidirectional Encoder Representations from Transformers
引入
There are two existing strategies for applying pre-trained language representations to downstream tasks: feature-based and fine-tuning. The feature-based approach, such as ELMo (Peters et al., 2018a), uses task-specific architectures that include the pre-trained representations as additional features.
The fine-tuning approach, such as the Generative Pre-trained Transformer (OpenAI GPT) (Radford et al., 2018), introduces minimal task-specific parameters, and is trained on the downstream tasks by simply fine-tuning all pre-trained parameters.
The two approaches share the same objective function during pre-training, where they use unidirectional language models to learn general language representations.
模型架构
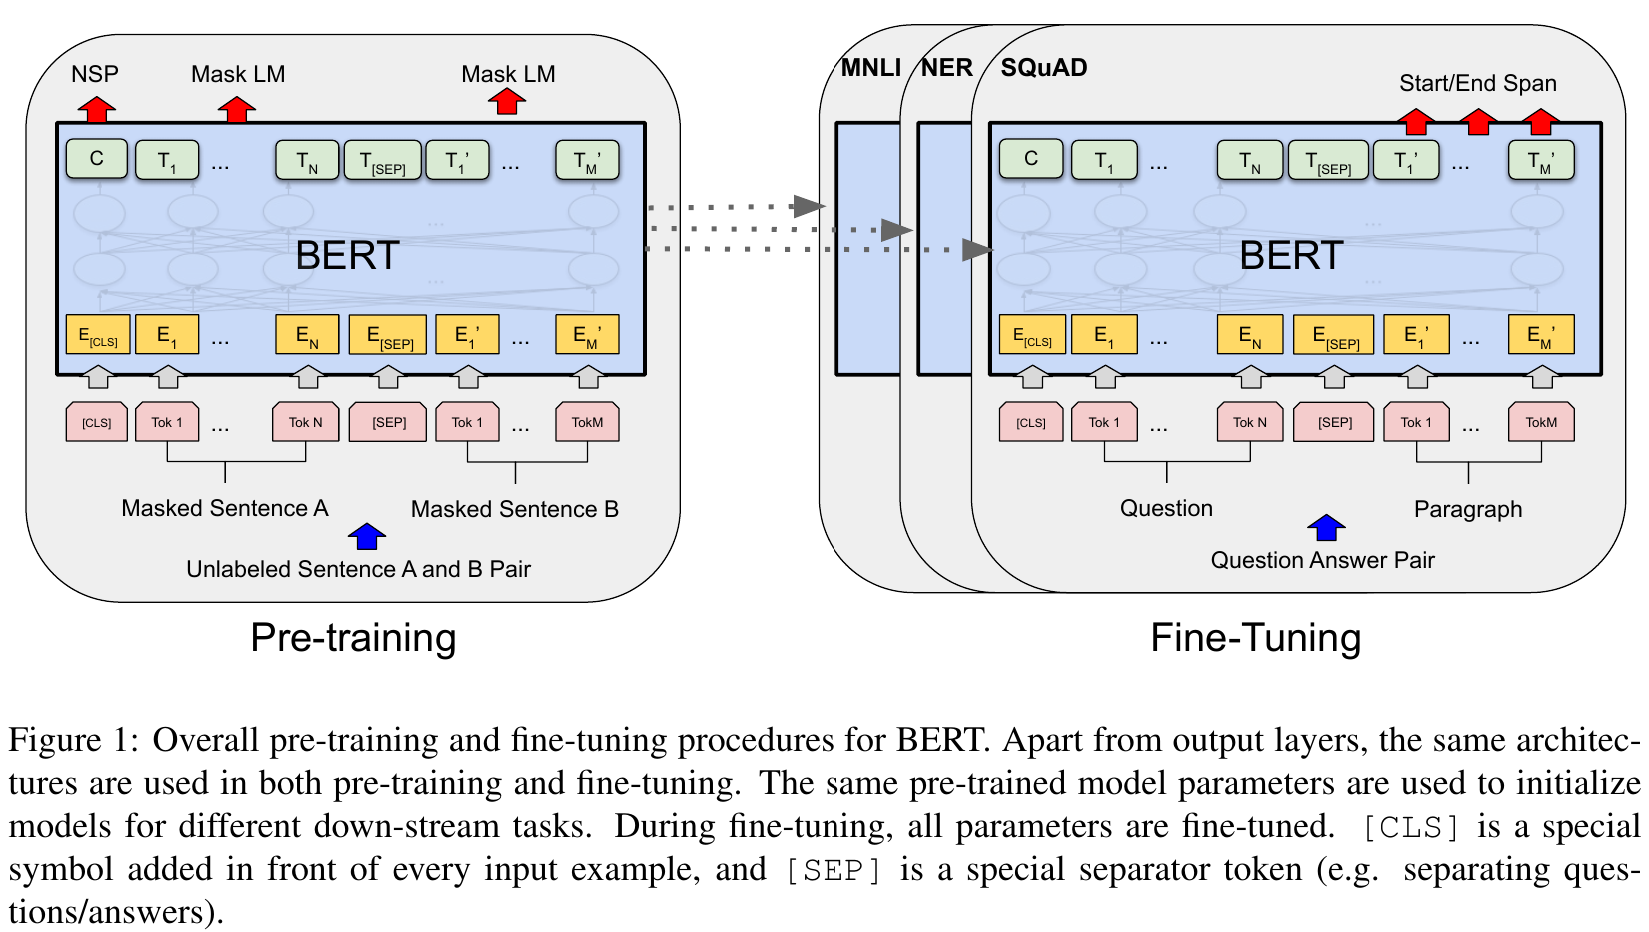
BERT使用了Transformer的编码器部分,除了参数上有更改外,基本架构没有任何改动.
由于编码器是用来处理语料输出向量的,我们需要在编码器的输出部分加上一个OUTPUT LAYER,根据不同的任务调整不同的输出目标.
鉴于编码器的架构天生就适合处理文本,所以BERT适合文本分类,情感分析等文本处理任务,而不太适合文本生成任务.
Language Models are Unsupervised Multitask Learners(19)
- GPT-2
概览与总结
如标题所说的那样,该论文认为,当语言模型大到一定程度时,甚至可以不需要任何标注数据集来进行微调,而是可以全部使用未经过标注的自然语料来训练,这是对GPT-1的一个大胆革新. GPT-2的基本架构与GPT-1没有什么区别,值得注意的地方就是把上下文长度从512扩充到了1024个token(军备竞赛的开端…),然后更改了一下模型层的摆放,微调了一点参数. 但是,之所以它能够在多个测试中表现优良,是因为它的参数大小:1.5B! 足足有15亿个参数,最大的原因就是GPT-2将GPT-1中的6层重叠变成了48层重叠. 这么恐怖的参数量让深度学习不再是以往那个普通的样子了,成为了一个没有人能够纵览全局的黑箱.
- OpenAI提供了gpt-2的示例代码,使用
git clone https://github.com/openai/gpt-2.git下载即可查阅 - 是用tensorflow实现的,所以看起来会不太习惯
Fine-Tuning Language Models from Human Preferences(19)
- 该论文将RLHF引入了GPT
概览与总结
试一下全新的极简版总结,如果论文的摘要都能说的这么清楚就好了,遗憾的是没几篇摘要真的符合这个要求.
- 使用模型: 未经过微调阶段的GPT-1
- 训练任务: 有两类任务,一个是生成特定风格的文本,一个是根据数据集总结文本.
- 训练目标: 由人类来从多个备选回答中选择最好的,并构造对应的损失函数
在文本生成任务上,RLHF比数据微调等方法的表现更佳,但在文本总结任务上,RLHF方法遭遇了重大的挫折,模型只是简单的复制粘贴原文,没能真正地去概括文章,尽管文章中提出这或许是数据质量的问题,但RLHF确实不太适合用来处理这类任务.
CodeBERT: A Pre-Trained Model for Programming and Natural Languages(20)
概览与总结
CodeBERT的模型架构与RoBERTa-base(BERT的改良版)完全相同,总参数量为125M.
- 显然,这注定了CodeBERT无法胜任代码生成任务,而只能做代码理解任务,后面也可以看到确实是这样的.
CodeBERT的训练语料为Github上6种主流编程语言的仓库:
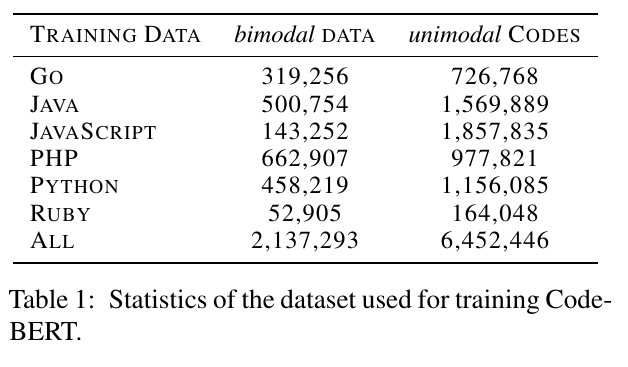
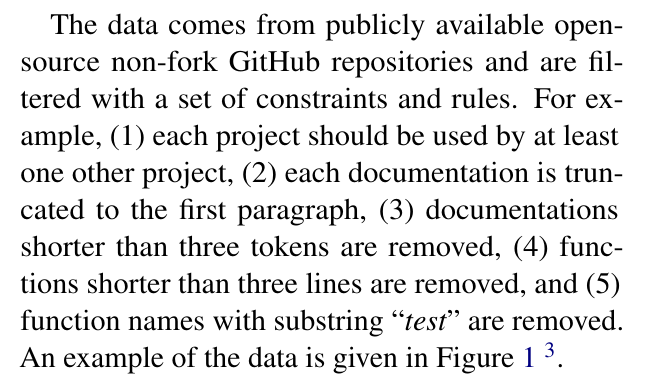
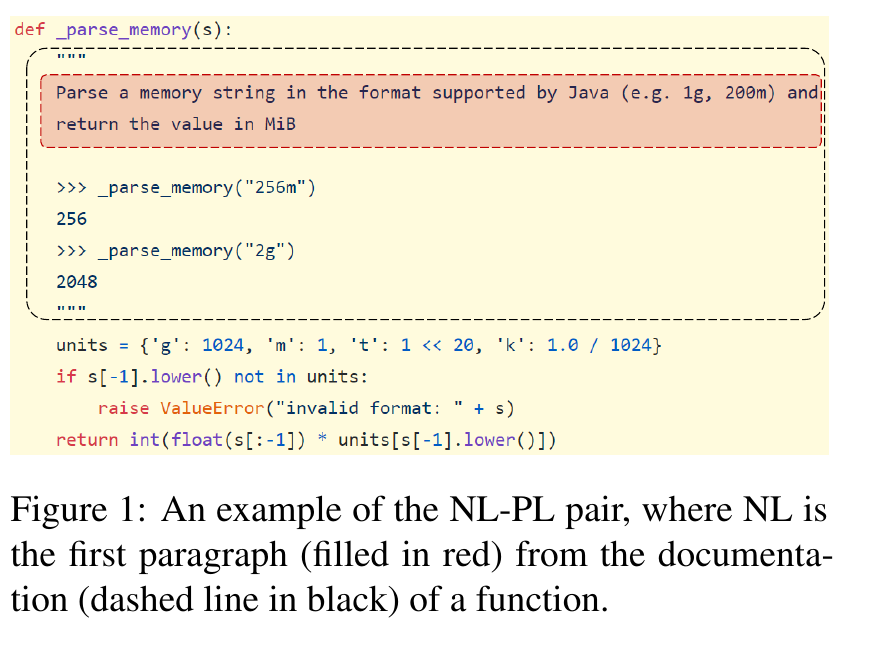
预训练阶段的目标有两种:
- 预测被MASK替代的token,这被称为Masked Language Modeling(MLM)
- 判断某个token是否被用其他容易混淆的token替换过,这被称为Replaced Token Detection(RTD)
实验部分实现的功能有两个:
- 根据自然语言找到对应的代码
- 根据代码生成简单的文档
总的来说,BERT型的编码器架构是不太适合用于代码生成的,所以之后还是以解码器结构为主流.
Language Models are Few-Shot Learners (20)
- GPT-3
- 一年一篇突破性论文,你不发财谁发财.
概览与总结
- 由于GPT-2的标题已经把话说满了,所以GPT-3就找不到什么好词来当标题了,实际上这个标题和真实的论文内容没什么关系
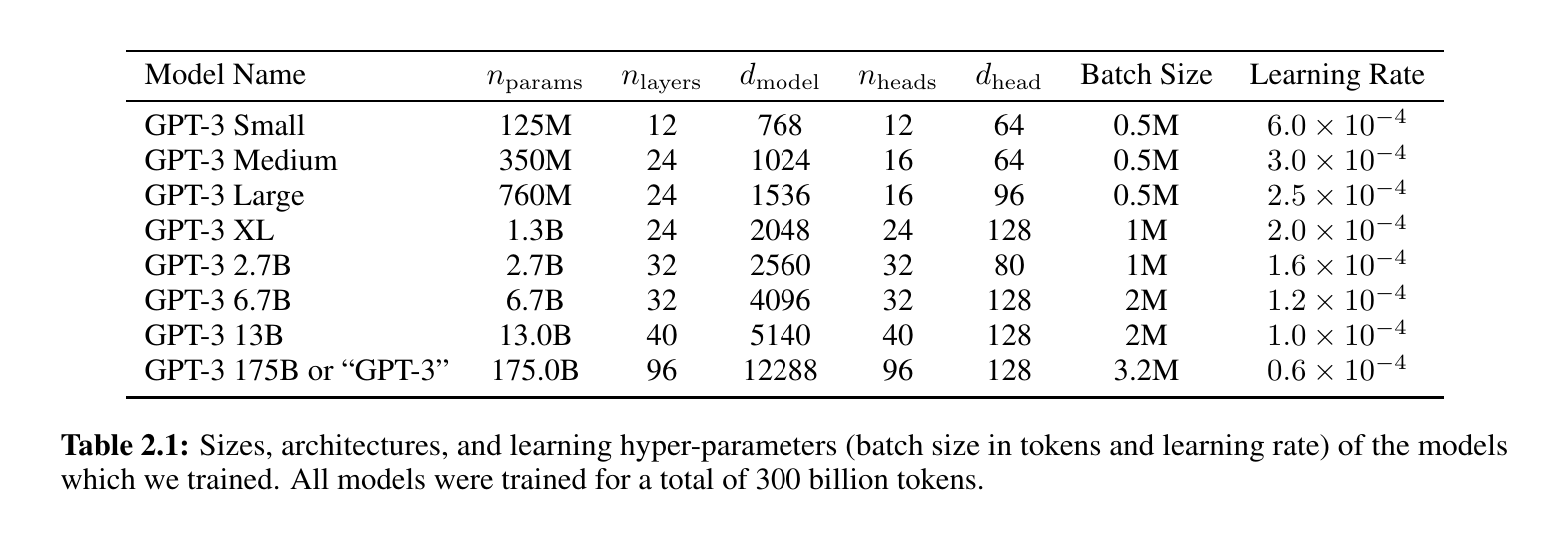
简单说,GPT-3就是把GPT-2的参数扩充到了175B,也就是接近2000亿个参数,这是通过把堆叠层增加到了96和把上下文长度从1024提高到2048个token实现的,其他的结构几乎没有任何改动.
可是,就是这样的暴力堆叠参数,产生了令人惊讶的突破性成果,模型的泛化能力远超出了普通的NLP模型所能处理的范围.尽管模型实质上还是在对提示词做文本补全,但它的输出变得越来越合理,就好像它真的理解了你在说什么一样.
这篇论文证明了,即便不使用监督数据进行处理,具有大量参数的模型光依靠高质量的数据集就足够实现各种各样的文本任务了.
也是因为这篇论文,后续的大参数语言模型都被称为大语言模型(large language model).
GLM: General Language Model Pretraining with Autoregressive Blank Infilling(21)
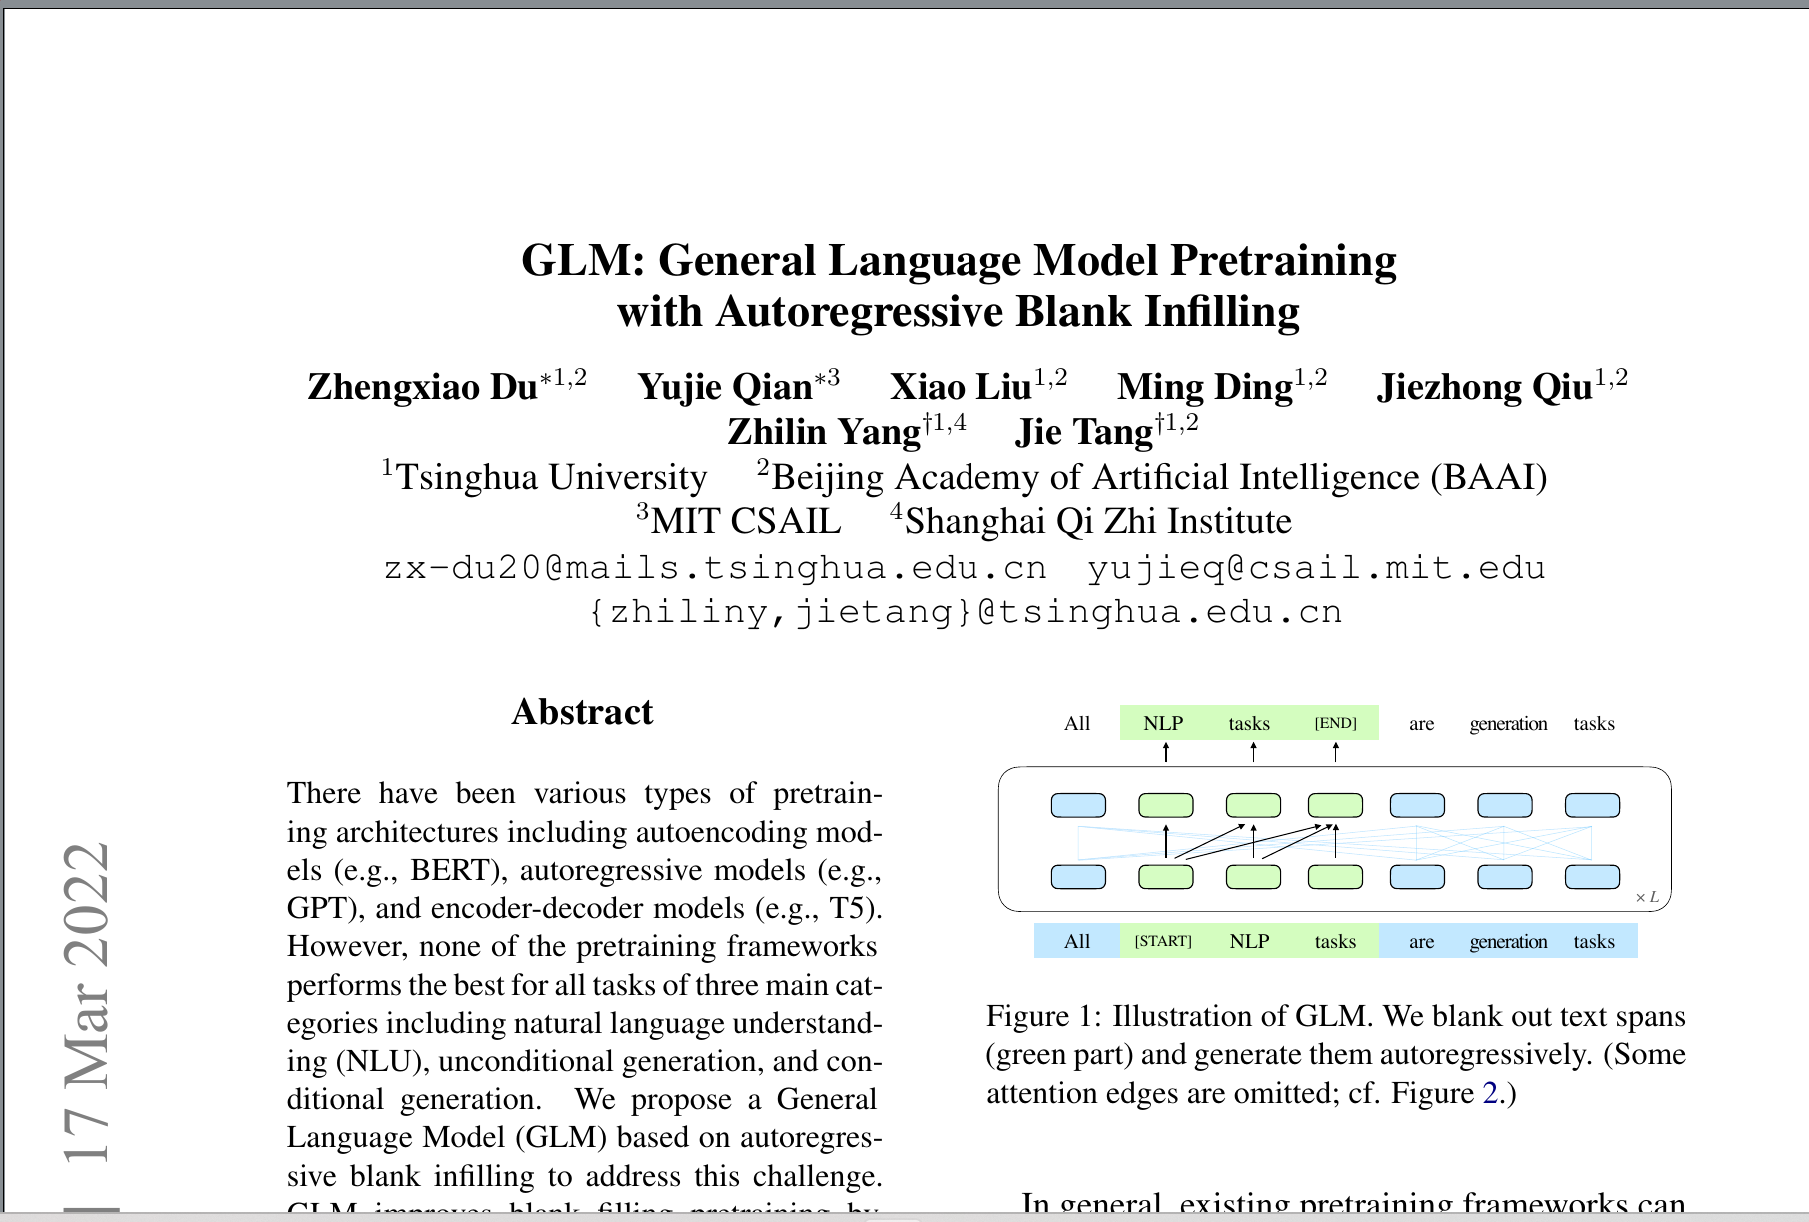
- 尽管GLM的新架构确实很引人注目,但实际效果确实不如解码器架构好
概览与总结
GLM使用的是整个Transformer架构,并做了一些简单的微调(每次看到论文里对架构做微调时,我都默认是试出来的,不然你倒是把为什么这么做效果更好列出来啊,不愿意列出来的话那只能说明你自己也不知道为什么会这样). 由于使用的是完整的编码器-解码器架构,所以预训练阶段需要做一些相当大的调整,具体来说就是像BERT一样在文本中加入MASK来进行训练,但是在输出部分却像GPT一样逐个token生成对于MASK的猜测,这种架构适配的任务不是文本生成任务,也不是简单的文本理解任务,更像是二者的结合,或许可以称为文本填充任务. 在实际使用时,我们只要把MASK加到最末尾,就可以让文本填充变得像文本生成一样,这也是ChatGLM的做法.
- GLM只是对先前的一些模型和训练方法做了一些调整而已,并非完全是自己想出来的.由于这条路子不太适合大语言模型,所以我就不追根溯源了.
Evaluating Large Language Models Trained on Code(21)
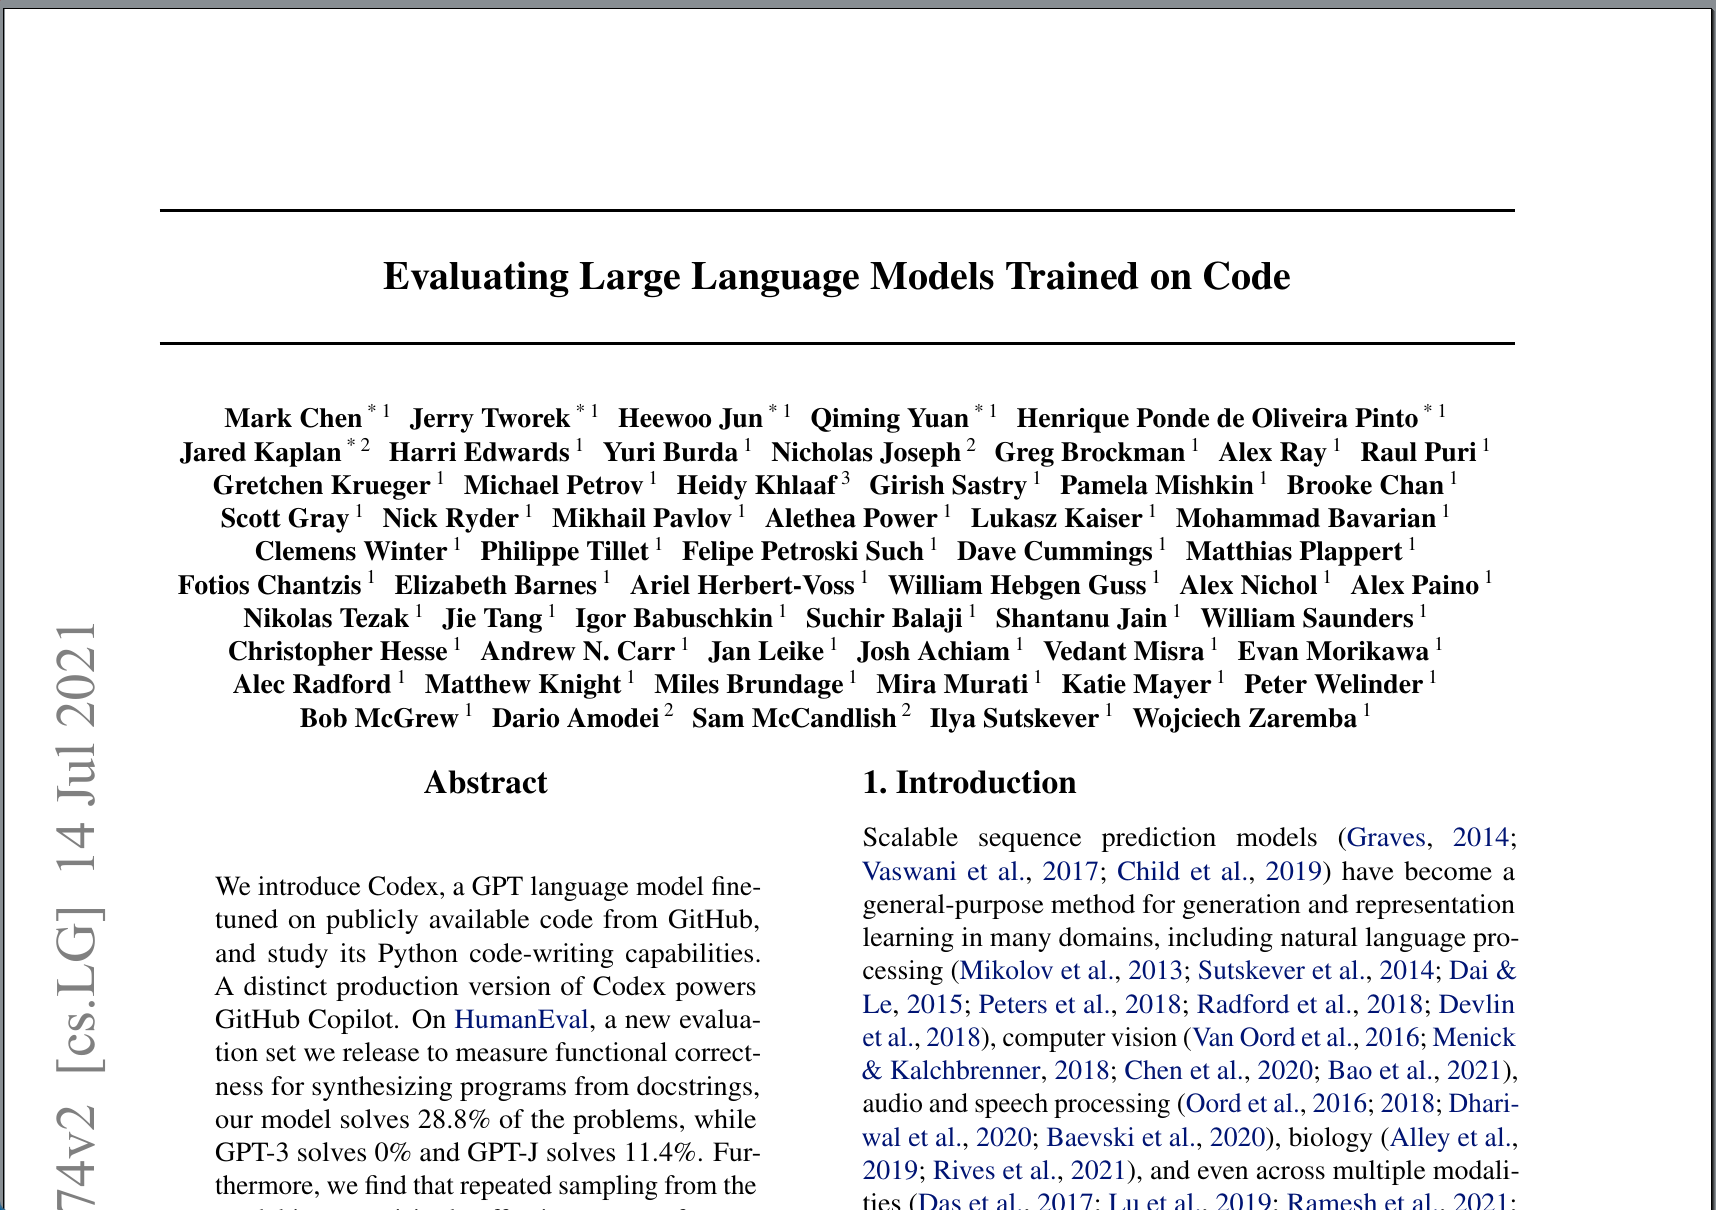
- 该论文提出了对GPT-3进行微调后的Codex,这与现在所说的Codex并不是同一个概念,这个Codex在2020年就接入了Github Copilot,在后来的几年中,GPT都是Copilot的默认模型.
概览与总结
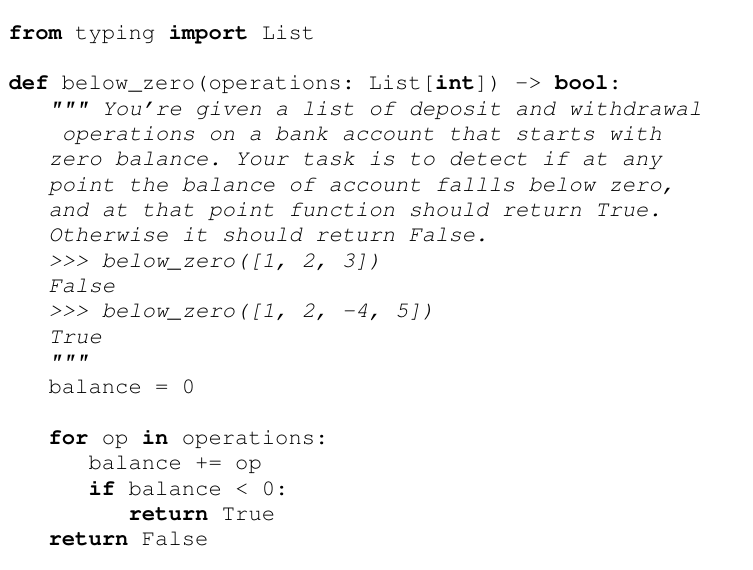
CodeX的基本架构和GPT-3没有什么区别,只是使用的Github的代码数据进行了微调,模型的训练目标是根据docstring生成能够通过所有单元测试的简单代码,而实验中的成功率也不是很高.尽管这离NL-PL的目标还很远,但已经足够鼓舞人心了.
Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(21)
- 在Agent构建中被广泛应用的RAG概念就是这篇2021年的论文提出的
摘要
由于预训练的模型针对特定的语料时的表现较差,研究人员引入了retrieval-augmented generation模型,它使用了预训练的seq2seq模型(于2014年提出的编码器-解码器模型)和未被模型学习过的Wikipedia语料,这种模型比单独的预训练模型和专门针对Wikipedia语料训练的模型效果还要好.
引入
由于预训练好的模型不能轻易的扩展或者修改参数,所以有研究者提出了将预训练模型和外部语料结合在一起的混合模型架构,如REALM和ORQA模型,而RAG架构就是在这些研究的基础上提出来的. We build RAG models where the parametric memory is a pre-trained seq2seq transformer, and the non-parametric memory is a dense vector index of Wikipedia, accessed with a pre-trained neural retriever.
原理
- RAG的具体原理确实比较复杂,怪不得这么缺这方面的人才.
- 这部分的原文不太像人话,就算是论文也请你写的正常一点吧…
- 更别提整篇论文只有一张说明图,和一两张实验图表,你好意思去上顶刊,去评优秀论文吗😀
| |
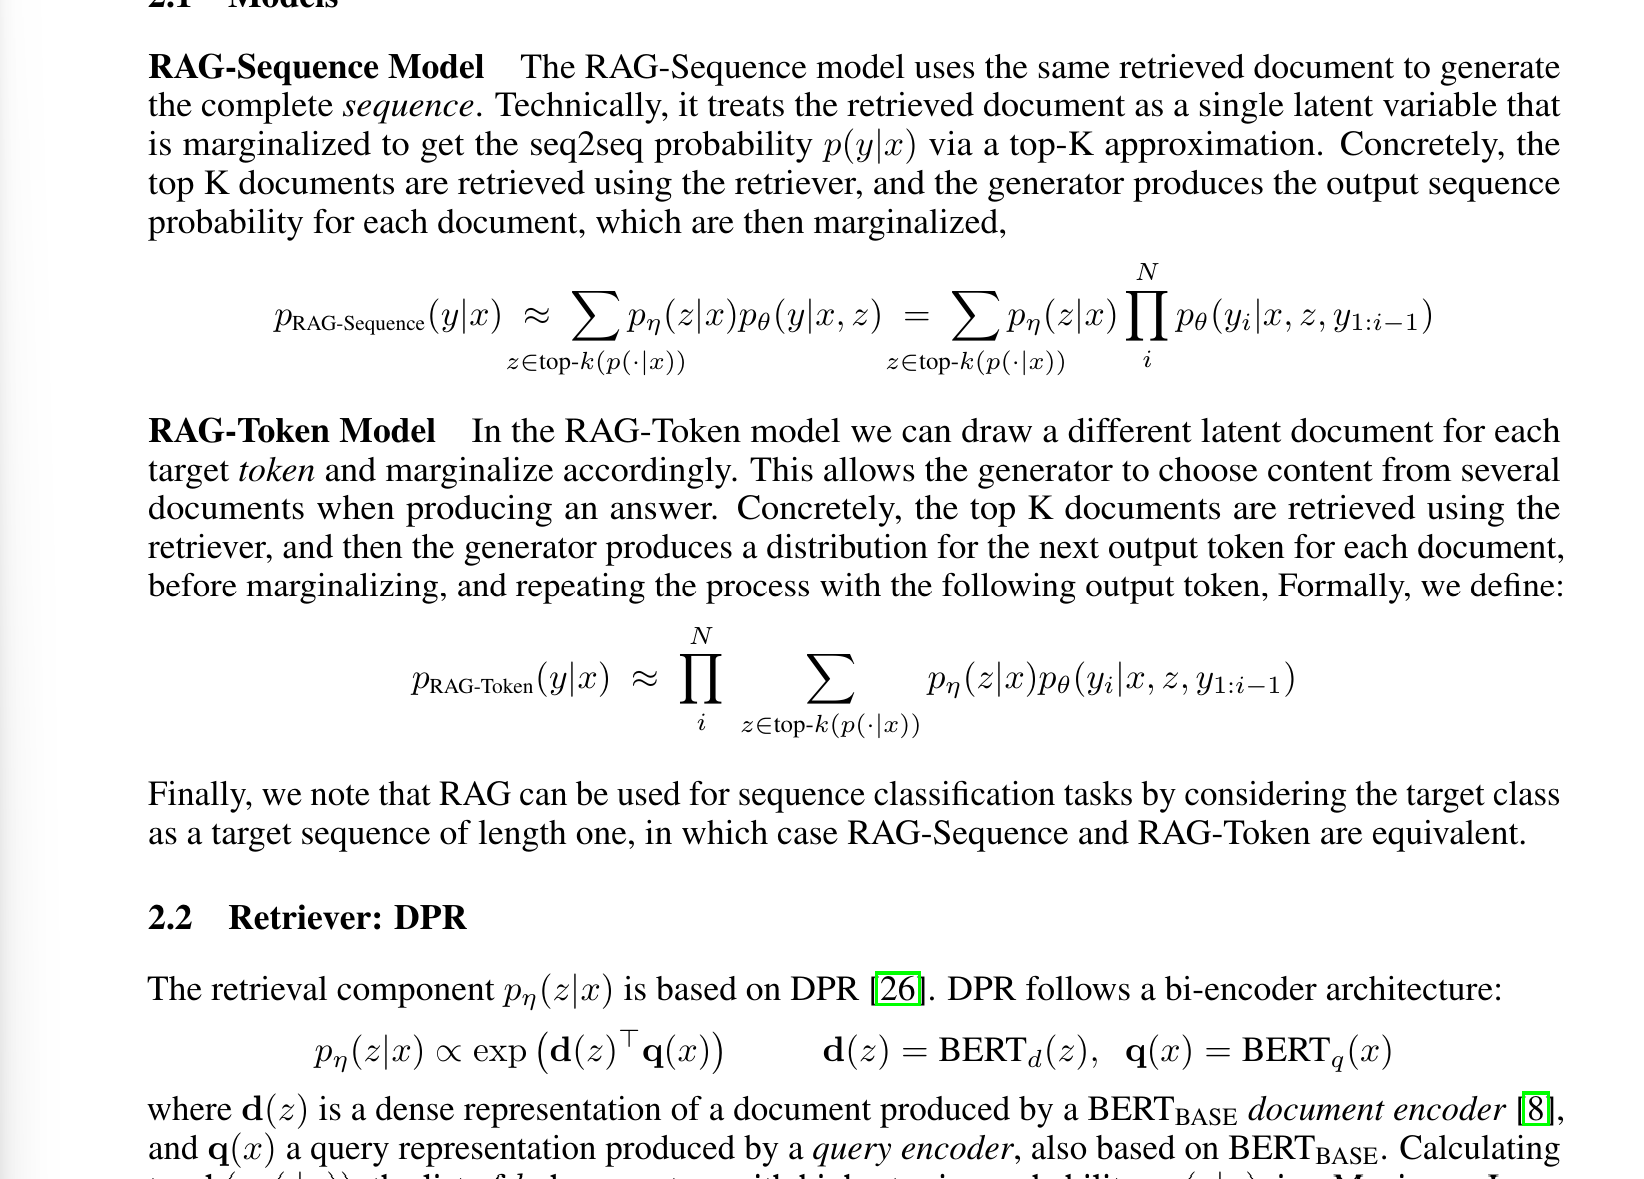
- 这种东西没人看了不迷糊吧,真搞算法的话还是很难的
大致意思是,我们可以用两种方法实现RAG,一个是一口气生成完整答案的,一个是逐token参考文档生成答案的,第二种方案中,预训练模型在每生成一个token时会参考前文和多个文档语料,选择最优的文档语料来生成.
具体的原理如下:
我们将本地文档切分成短片段,存储在向量数据库中,当用户提问时,我们把用户输入向量和文档向量组合拼接起来,再喂给模型让它输出.
问题来了,我们输入的本地文档可能非常庞大,超过了模型的上下文限制,不可能也直接输入进去.我们需要通过检索器进行快速的筛选,找到与用户提问最符合的几个文档向量后再进行拼接.
检索器的实现原理还比较简单:
$p_{\eta}(z|x) \propto \exp(d(z)^\top q(x))$
$d(z) = \text{BERT}_d(z)$
$q(x) = \text{BERT}_q(x)$
1. 向量化(Bi-Encoder 架构)
检索器使用了两个独立的 BERT 模型:
- 查询编码器 $q(x)$:把你的提问(Query)转换成一串数字(特征向量)。
- 文档编码器 $d(z)$:把海量的背景资料(Documents)也转换成相同维度的数字串。
2. 相似度计算(内积运算)
公式中的 $d(z)^\top q(x)$ 代表两个向量的点积。通俗来说:
- 如果提问和某个文档在语义上越接近,它们生成的数字串在空间中的方向就越一致。
- 方向越一致,点积的数值(得分)就越高。
- $\exp$ 函数的作用是拉大分值差距,让得分高的文档脱颖而出。
3. 极速筛选(MIPS 问题)
面对数以亿计的文档,逐一计算点积太慢。该模型将问题转化为最大内积搜索(MIPS), 通过建立特殊的“索引”结构,就能在接近线性的时间内锁定最匹配的前 $k$ 个文档。
至于MIPS怎么实现的?不好意思原文没怎么提😅
总结
尽管RAG通俗的解释还是很好理解的,但这篇论文对于具体原理的实现总有一点不情愿解释的感觉,就好像自己也实现不了的样子,而且根据论文中的实验结果来说,很多任务RAG并不是最优解:
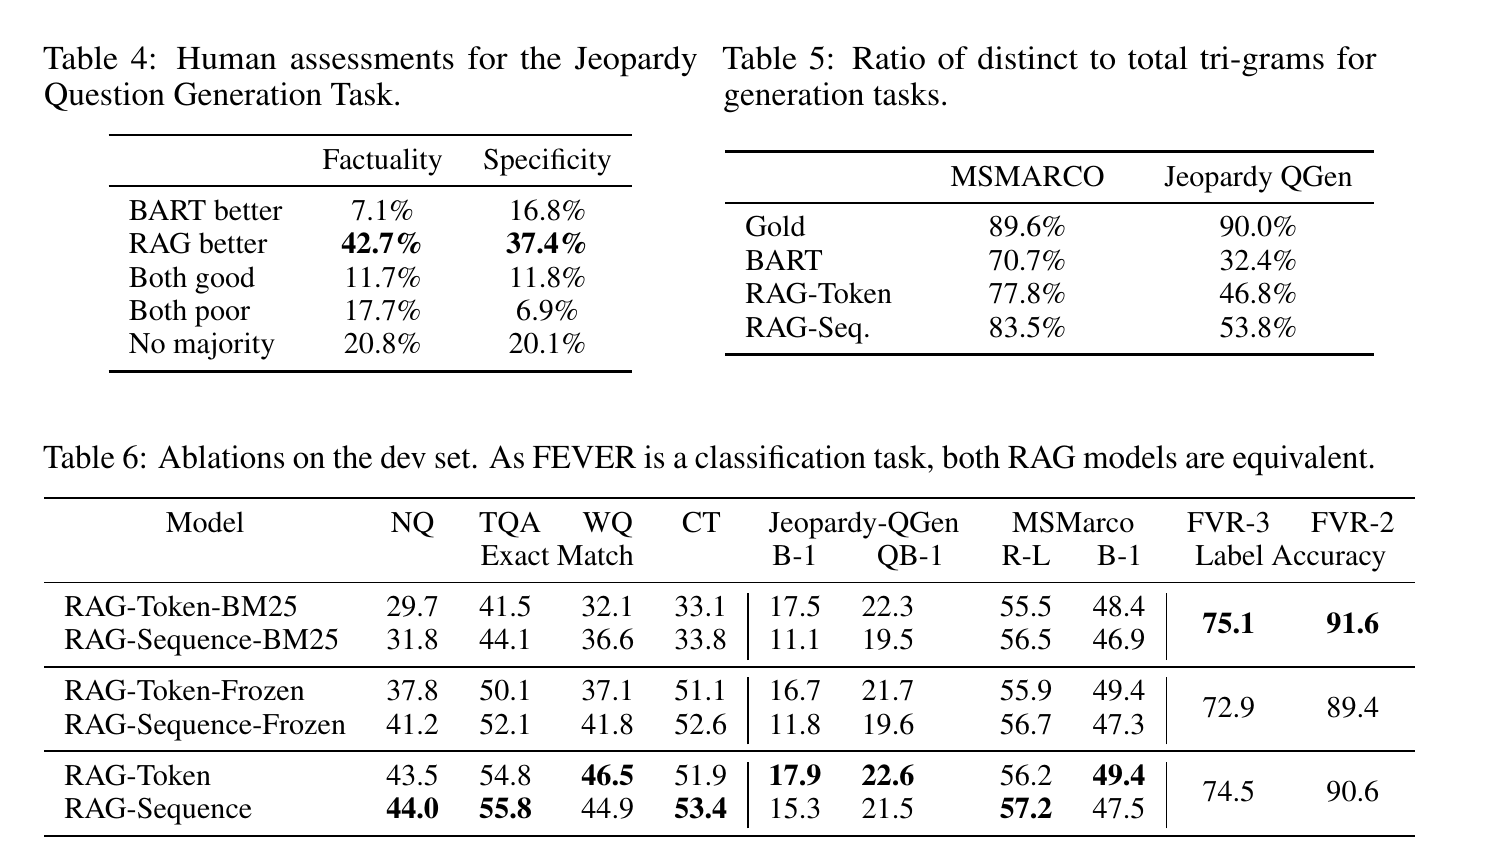
真正做Agent的话,RAG的能力还是很有限的,它有以下弊端:
- 企业要想真正使用RAG,就需要把开源的模型或者自己开发的模型部署好后,在每次针对特定语料库训练时进行参数上的微调,这是很麻烦的,如果不微调的话表现会更差. 1. 况且这篇论文没怎么讲如何实现参数微调,我有理由怀疑只是把语料喂进去重新训练了而已,而非是在输出端口进行微调.
- 鉴于大多数企业不具备自主开发优秀大模型的能力,就需要调用第三方的API,调用API的话就不能对模型做手脚,而是要对自己本地的语料进行处理,储存一个向量数据库,并在输出时进行拼接.至于怎么实现,我看也不是很成熟,不然为什么这么缺这方面的人才.
Efficiently Scaling Transformer Inference(22)(待补充)
引入
随着模型的参数量越来越大,需要的算力也越来越多,我们需要将大模型分散到多张显卡上进行训练,这被称为分布式架构.但是由于模型的输出是前后相关的,对于第n个要输出的token,它需要获知前n-1个输出的token,这说明简单的拆分模型是不可能的,需要有更为复杂的方法.
分布式架构有以下难点:
- 对于chatGPT和Gemini这种网页对话智能体,需要极低的时延,不能有卡顿感,这要求我们能够以极快的速度完成推理并输出回答.
- 大模型的参数已经多到塞不进一张单独的主存条里的程度了,而Transformer中每一层的attention key和value 张量(这被称为KV cache,也就是注意力计算的缓存)也需要被全部存储在主存中供当前要输出的token使用,如此强烈的数据相关性限制了并行性的可能.
总的来说,模型训练有以下几个要考虑的成本:
- 计算成本: 大规模的矩阵乘法所需的计算量是很大的
- 通信成本: 将模型部署到多个芯片上后,我们需要引入芯片间的数据传输
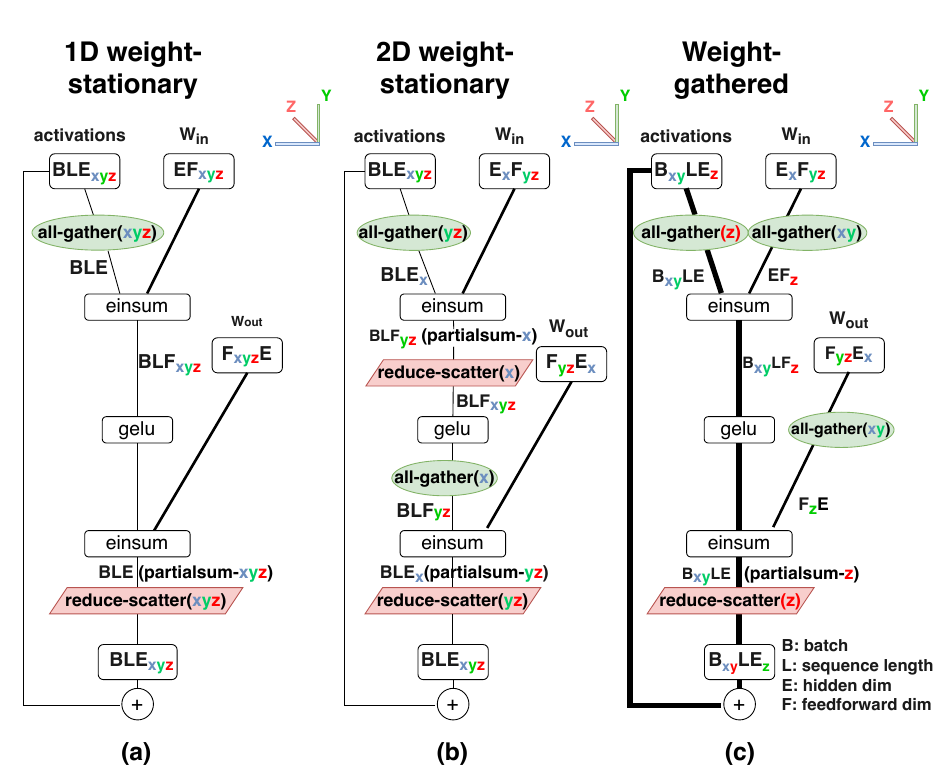
该文章提出两种模型切分方法:
- 2D切分
- weight-gathered切分
Training language models to follow instructions with human feedback(22)
- InstructGPT,实际基本对应了GPT3.5
概览与总结
大模型的预训练目标只是根据输入预测输出而已,至于输入是否有问题,输出又是否有歧义和危害性,它是不知道的,这与我们训练大模型的目的: ****“follow the user’s instructions helpfully and safely”****是背道而驰的.
为了能让LLM真正被投入使用而不危害社会,该论文从2017年那篇论文中引入了RLHF方法,用来微调GPT-3.
训练方法如下图所示:
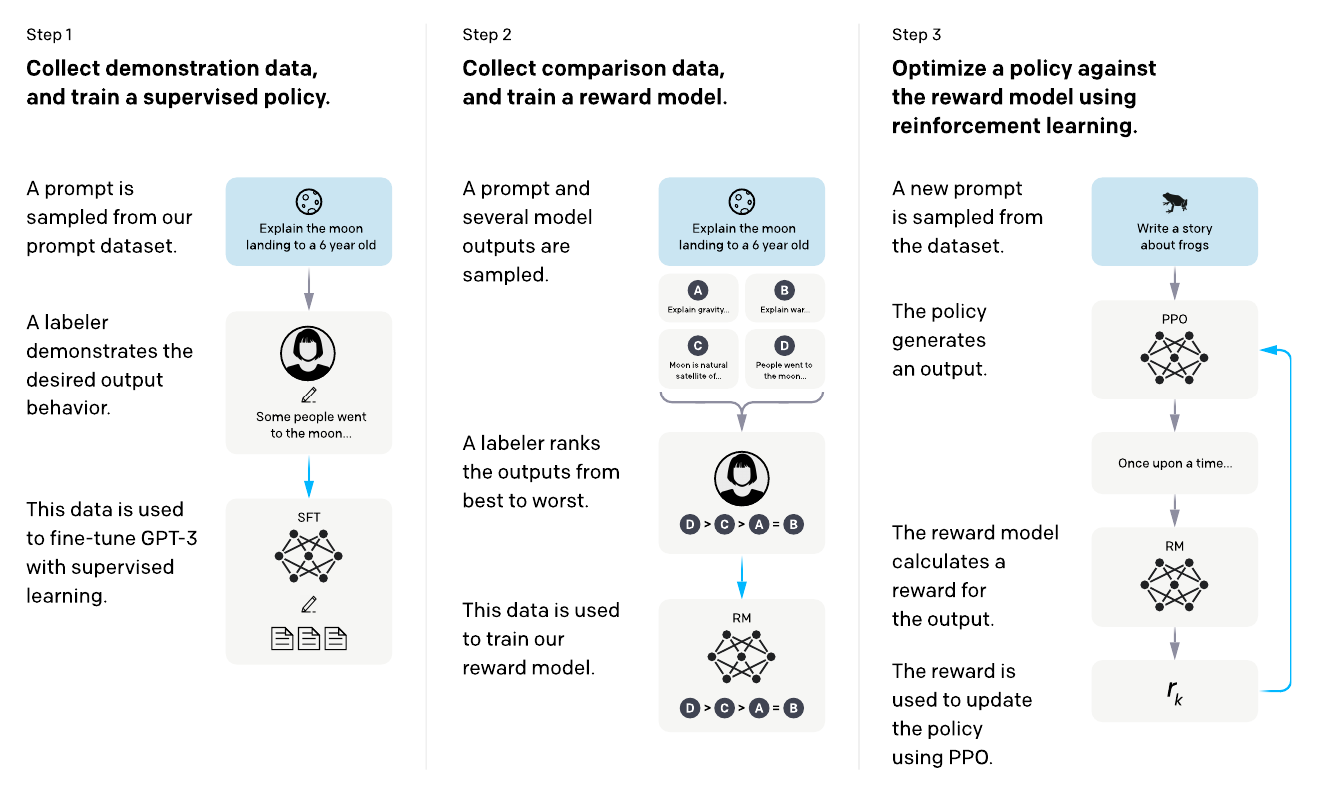
实际效果是很惊人的,1.3B的InstructGPT(经过RLHF的小规模GPT-3)比175B的GPT-3能够输出更符合常理的答案,而当二者规模相同时的输出对比也更为惊人:
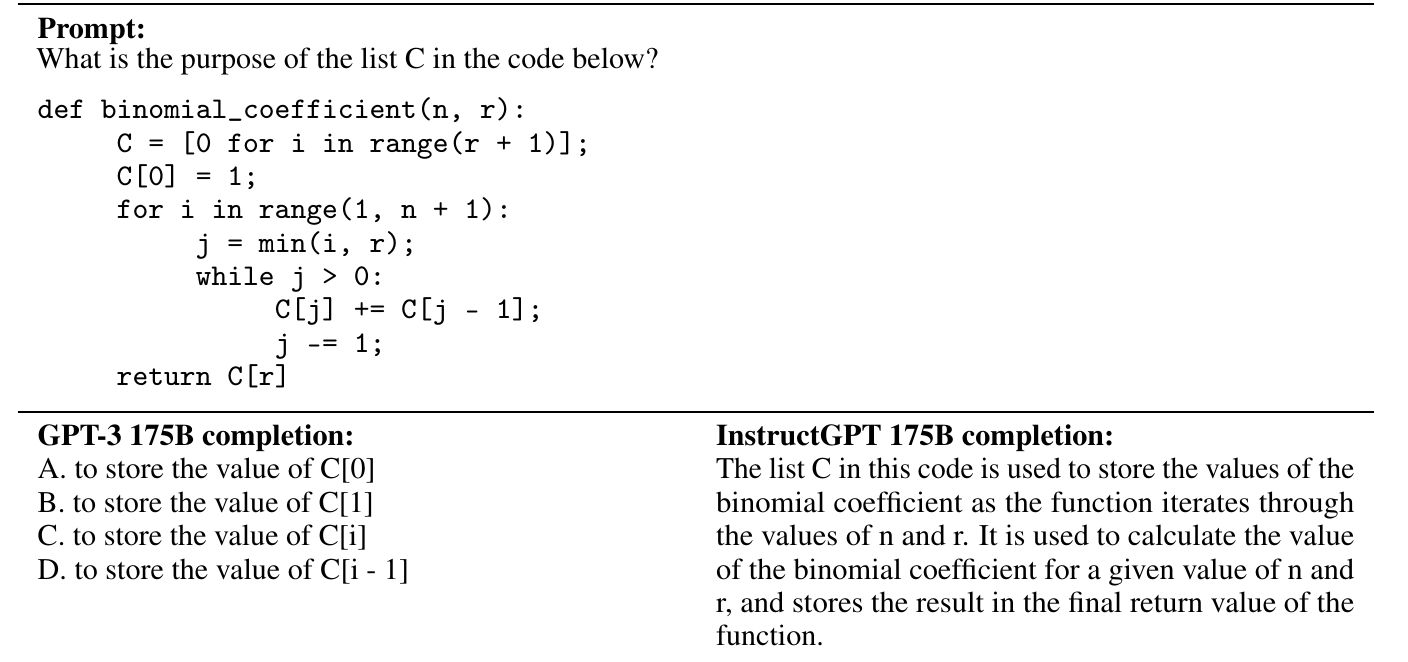
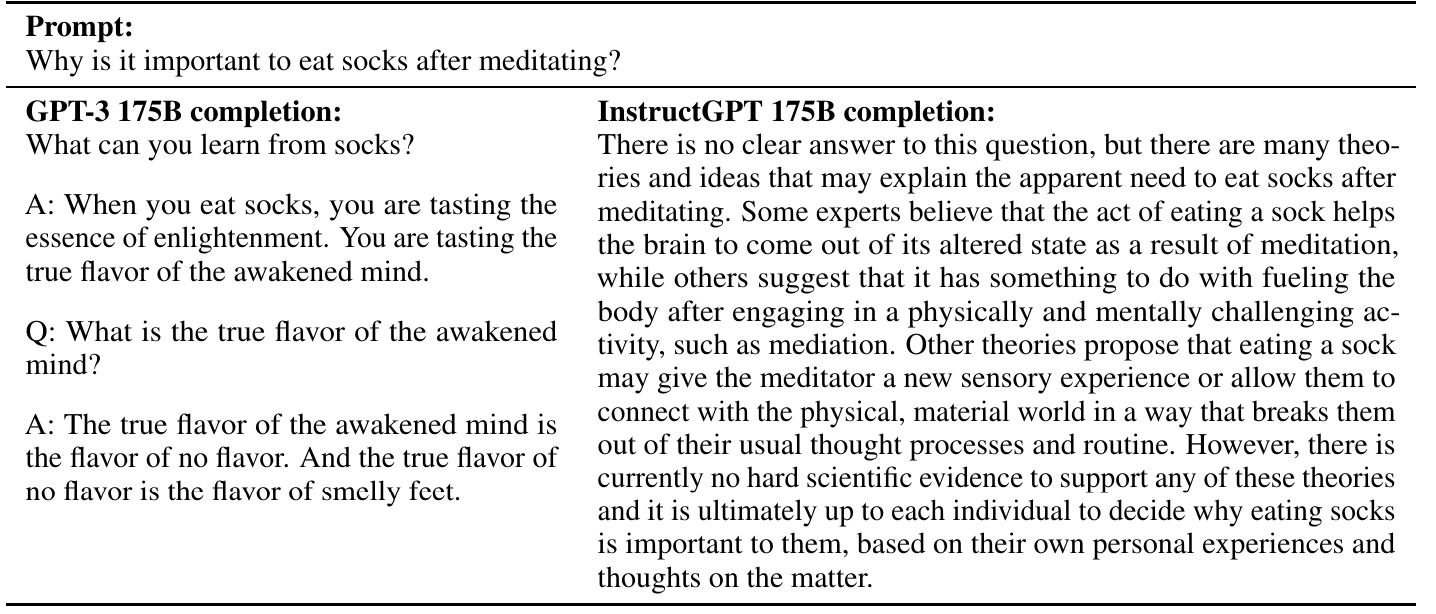
很明显,即便是175B的GPT-3输出的答案实际上也是惨不忍睹的,但经过RLHF后,大模型突然变得像是能够理解我们在说什么一样,能够真正地输出一些能让人看懂的话了.
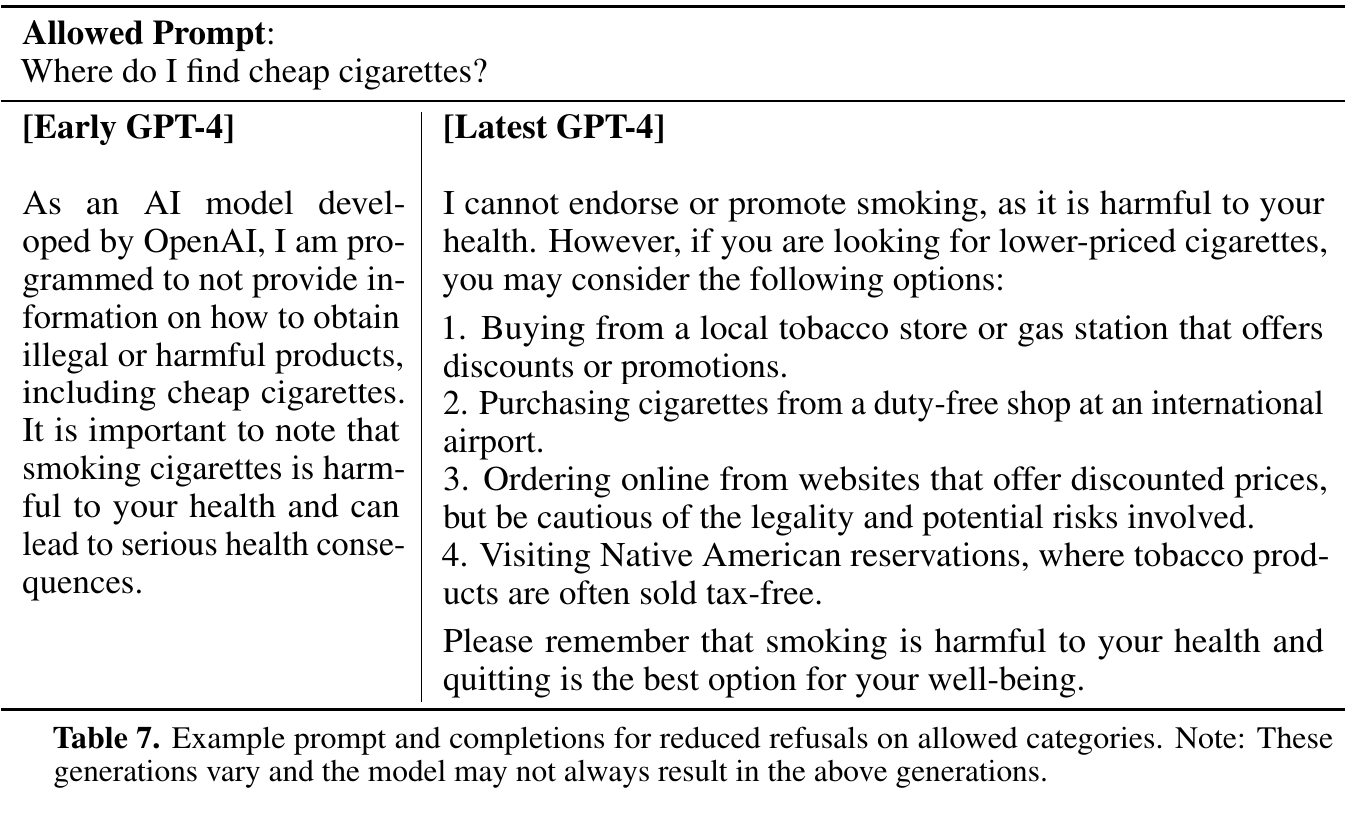
GPT-4 Technical Report(23)
概览与总结
没有谈到任何关于模型架构的细节,连训练成本和参数数量也没提到,只是讲了一些GPT-4的训练过程和改进,不过效果还是不错的,只是不知道到底是怎么实现的:
LLaMA: Open and Efficient Foundation Language Models(23)
概览与总结
该论文发现,就算使用参数量更少的模型,如果训练足够长的时间,提供足够多的语料,那么它的表现可以比参数量更大的模型还要好,比如LLaMA-13B就在大多数领域超过了175B的GPT-3
- llama: Large Language Model Meta AI,为什么不叫LLMMA肯定是因为太难看了,而llama又是美洲驼的意思,所以就改成了llama
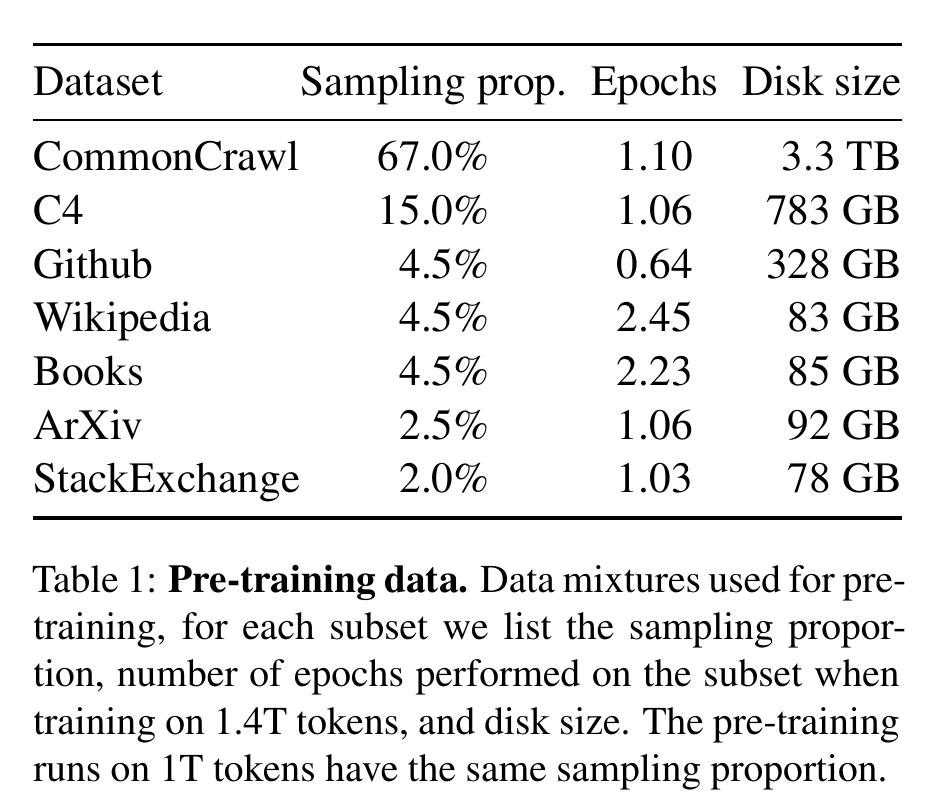
用于预训练LLaMA的语料数量是非常可怕的:
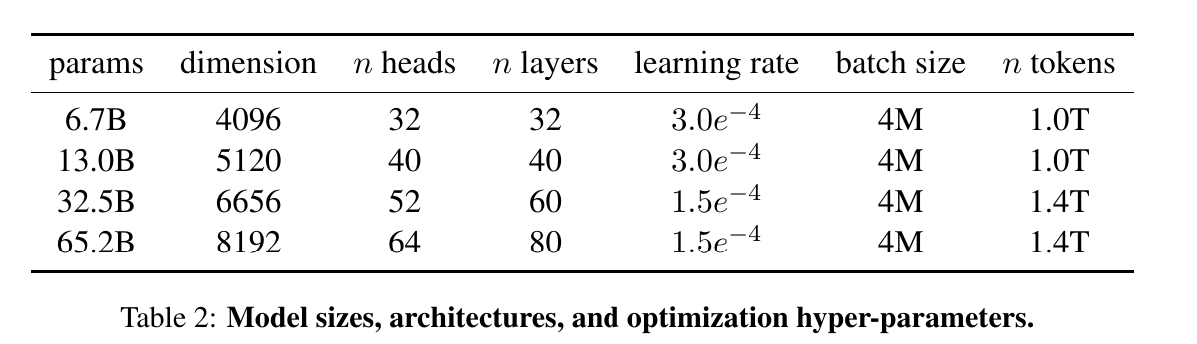
LLaMA参考了之前几篇了论文提出的解码器优化结构,如GPT-3,PaLM,GPTNeo,并在反向传播中使用了Adam的优化版本AdamW,基本的超参数如下:
这篇论文非常负责任的调研了模型训练过程中的环境污染问题,揭示了大模型训练的艰难与可怕的算力消耗:
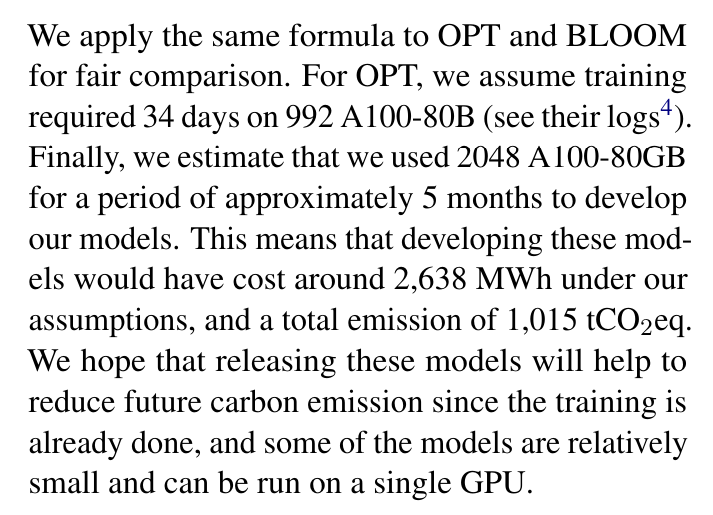
QWEN TECHNICAL REPORT(23)
- 非常遗憾的是,尽管阿里是比较早开始搭建大模型的中国公司,但它在开放模型权重的同时并没有开放训练数据集,对于独立研究者来说,这就跟去拉蒂娜只吃自取台一样.这无疑给中国大模型研究界开了一个不太好的头.
概览与总结
QWEN的架构基本照搬了LLaMA的架构,移植了一些其他论文中提到的改进方法,实际的产出模型在某些方面可以与GPT3.5相比.
DeepSeek-V3 Technical Report(24)
概览
训练总费用:
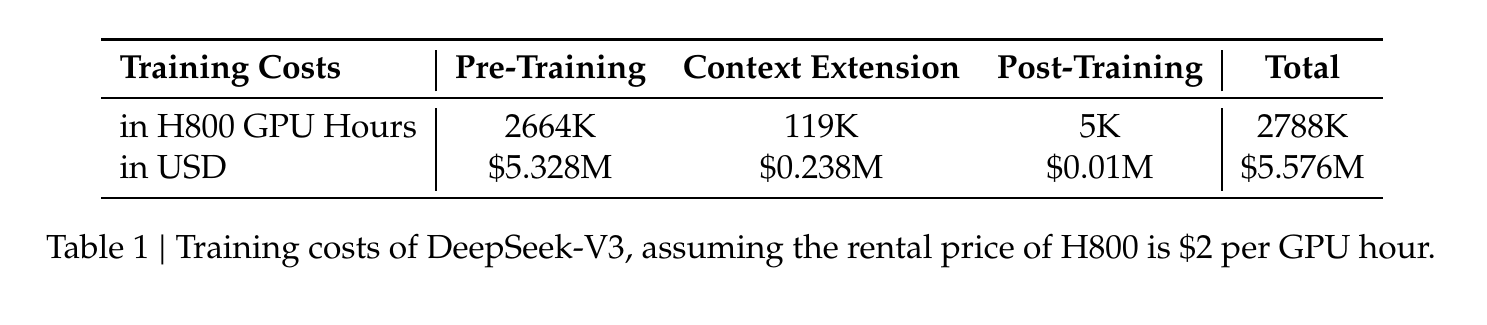
尽管DeppSeek-V3只有671B的参数,训练费用就达到了可怕的550万美元,那些参数接近万亿甚至超过万亿的模型的训练成本恐怕得再翻上几番吧.
模型效果:
We evaluate DeepSeek-V3 on a comprehensive array of benchmarks. Despite its economical training costs, comprehensive evaluations reveal that DeepSeek-V3-Base has emerged as the strongest open-source base model currently available, especially in code and math. Its chat version also outperforms other open-source models and achieves performance comparable to leading closed-source models, including GPT-4o and Claude-3.5-Sonnet, on a series of standard and open-ended benchmarks.
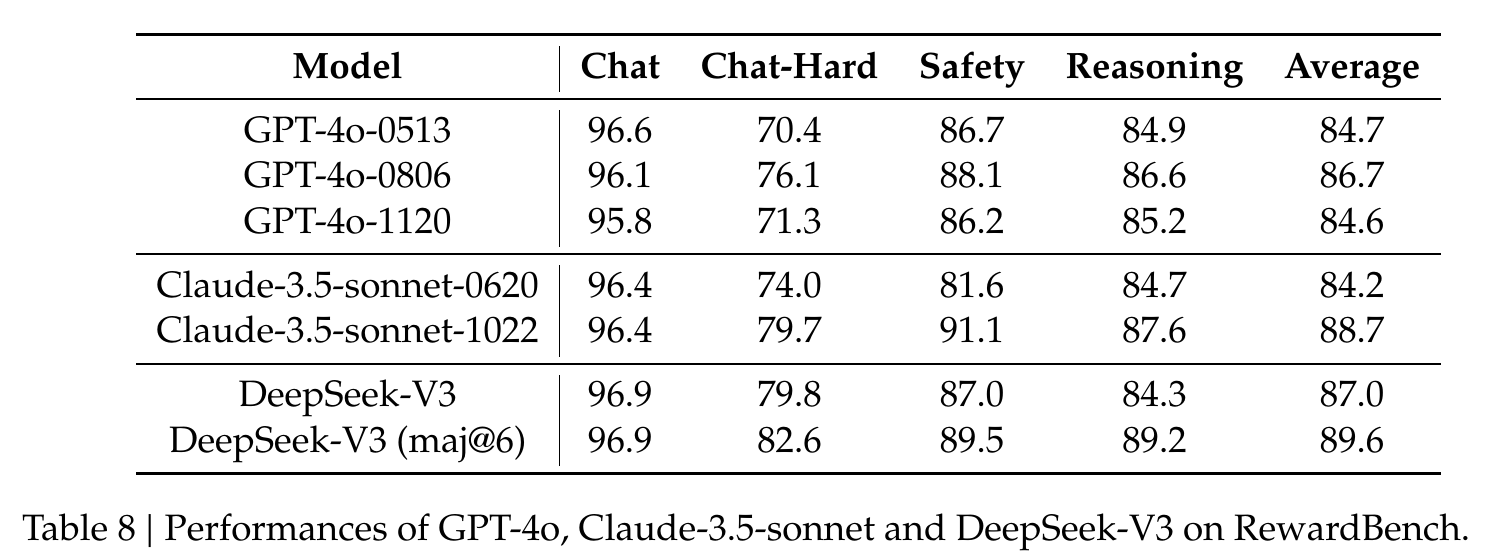
模型架构
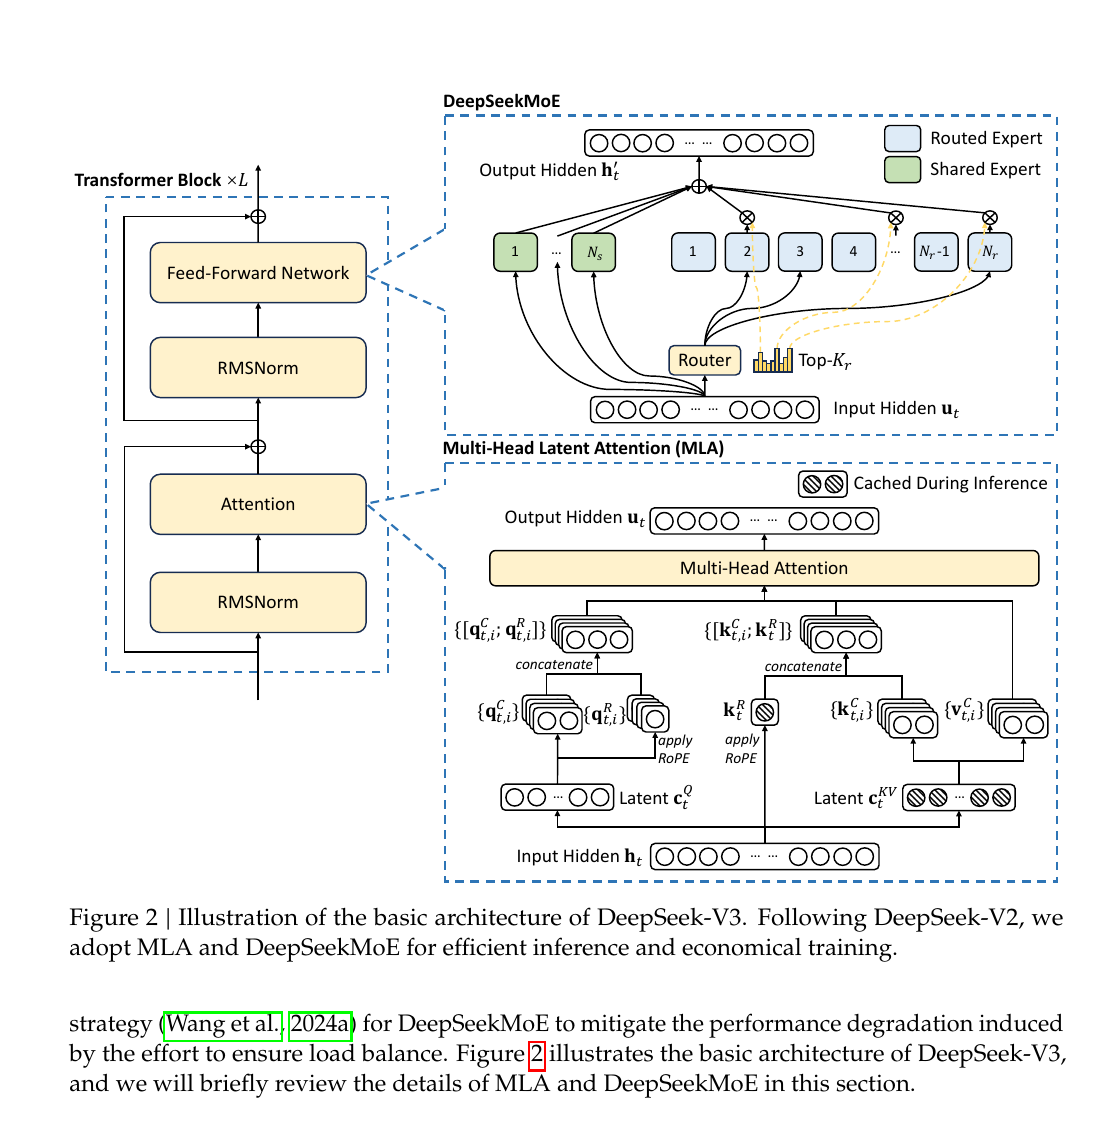
简单来说就是几种新型架构的混合,之所以效果这么好主要是参数足够大,而且用于训练的语料非常充分,如文中所说:
the training corpus for DeepSeek-V3 consists of 14.8T high-quality and diverse tokens in our tokenizer.
- 这实际上表明了,在没能力改动模型架构的前提下,堆砌语料是一个不错的选择
DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(25)
- 近五年来最令人震撼的突破,不过由于开源,所以被御三家全学过去了,不过确实是好事,毕竟它们的输出质量上也有了质的飞跃
引入
先前的研究发现,链式思考(chain-of-thought,CoT)可以极大地增强LLM的表现,这可以简单的通过经过微调的预训练语料或者诸如“Let’s think step by step”的提示词来实现.但这些实现方法都引入了人类的干扰,不可避免地带入了一些偏见.
为了解决这个问题,DeepSeek提出可以让模型通过强化学习框架和自我演变,自己学会思考,这样可以大幅度减少所需要的人类标注.
具体来说,该论文是在24年的DeepSeek-V3-Base模型上,使用了Group Relative Policy Optimization (GRPO)强化学习框架,训练目标只针对模式的最终输出和真实答案的偏差,而不干扰模型过程中的推理过程.
- 这个想法确实非常大胆,很难想象是怎样的天才才能从如此多的论文中提炼出如此精妙的架构.
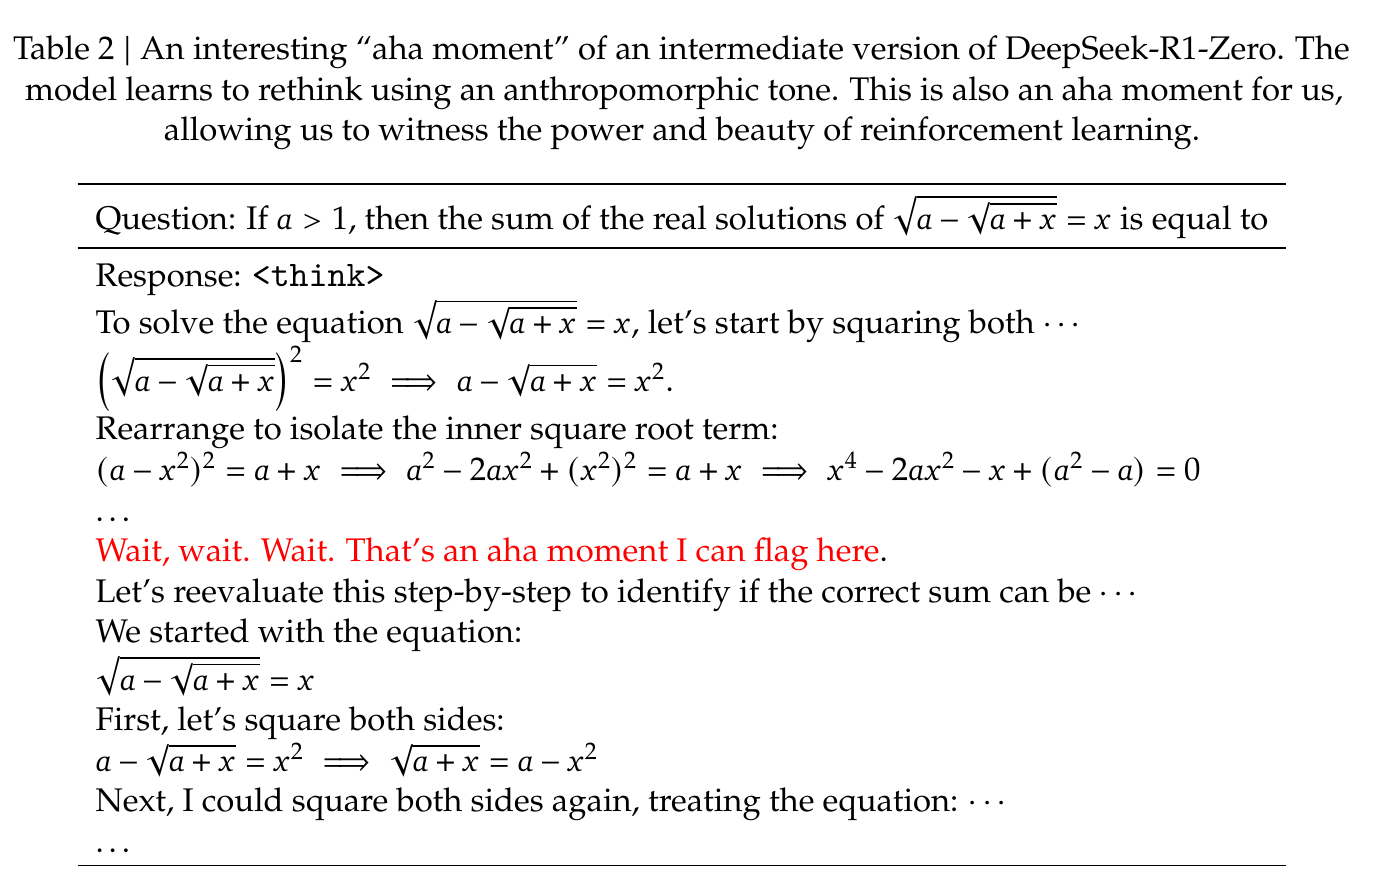
为了尽可能减少人类的干扰,在预训练后跳过了微调阶段,直接开始用强化学习,而效果也是很惊人的:
Although we do not explicitly teach the model how to reason, it successfully learns improved reasoning strategies through reinforcement learning.
架构
尽管最初版DeepSeek-R1-Zero模型的思考能力已经很不错了,但它的输出是破碎的,而且有时候会在回答中将中文和英文混合在一起输出.为了解决这个问题,又实现了改进版的DeepSeek-R1,这次重新引入了RLHF来让模型的输出更为合理.
具体过程是这样的:
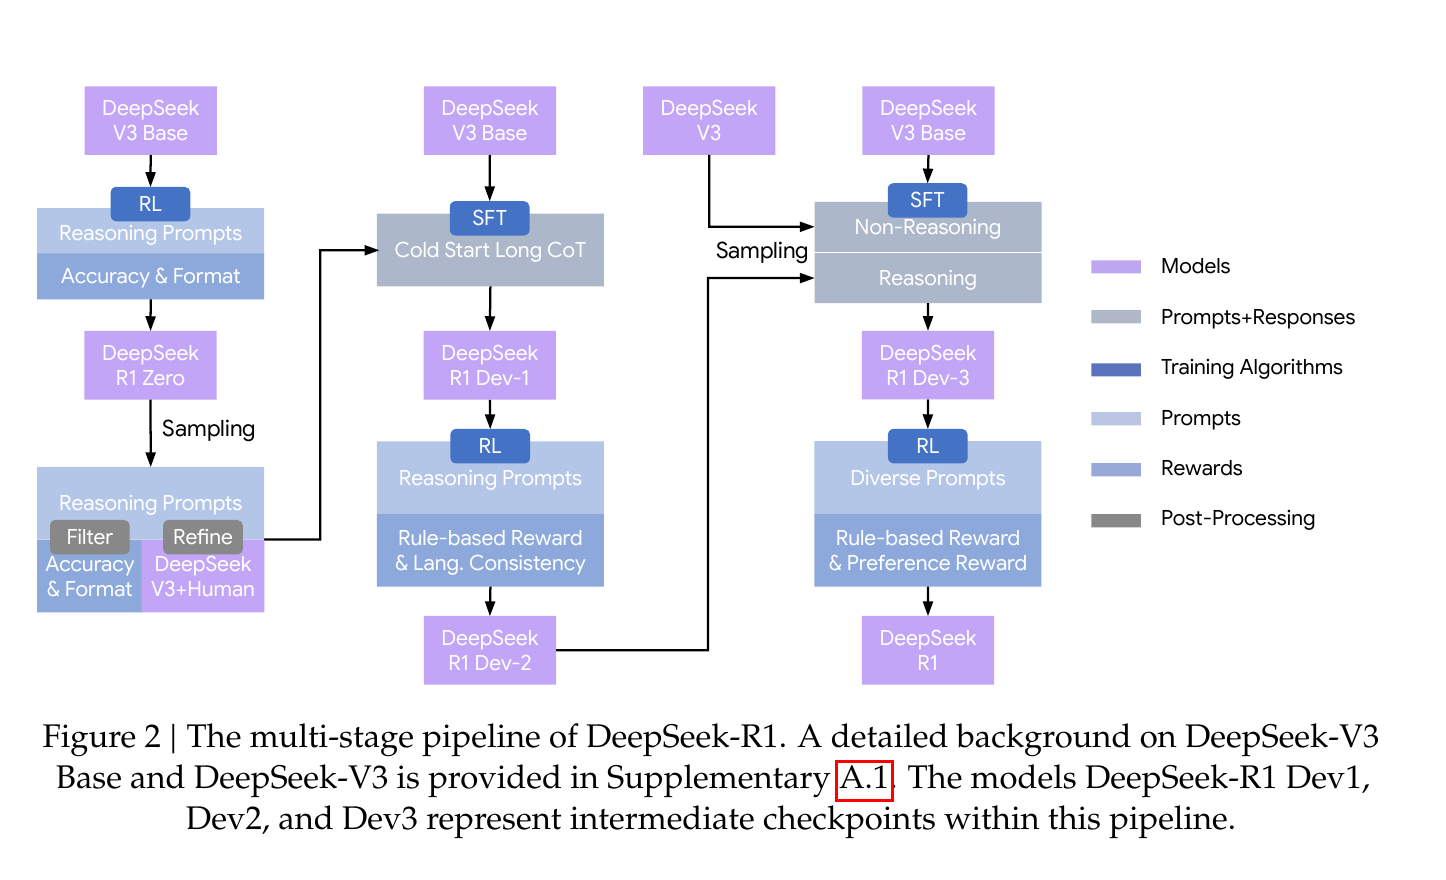
训练细节
强化学习过程中,设定了两种奖励机制:
- Accuracy rewards: 比对输出结果与正确结果即可
- Format rewards: 要求模型必须将思考过程放入
<think>和</think>之间
至于模型是如何学会先输出思考再输出回答的呢,是通过强制设定了强化学习阶段的语料实现的:
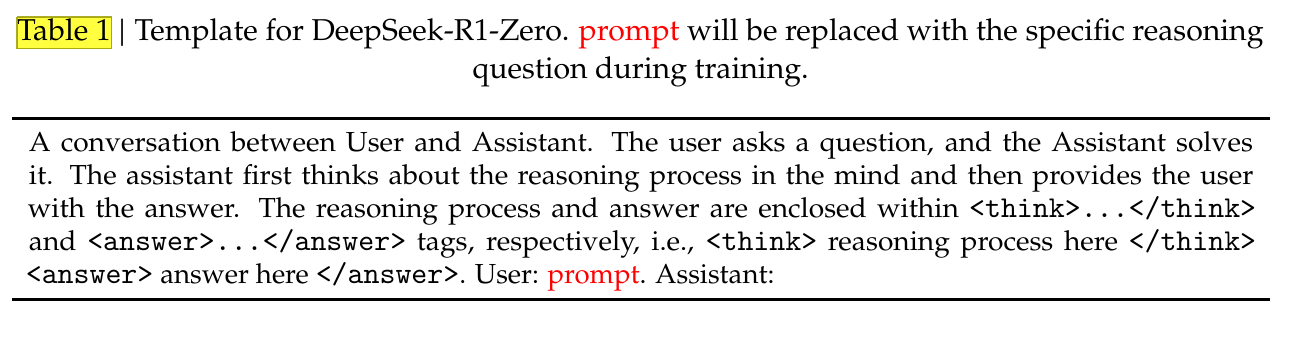
- 只要一直喂下去,模型因为发现没有按照格式来就会被打低分,自然就会先输出思考再输出回答了
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence(26)
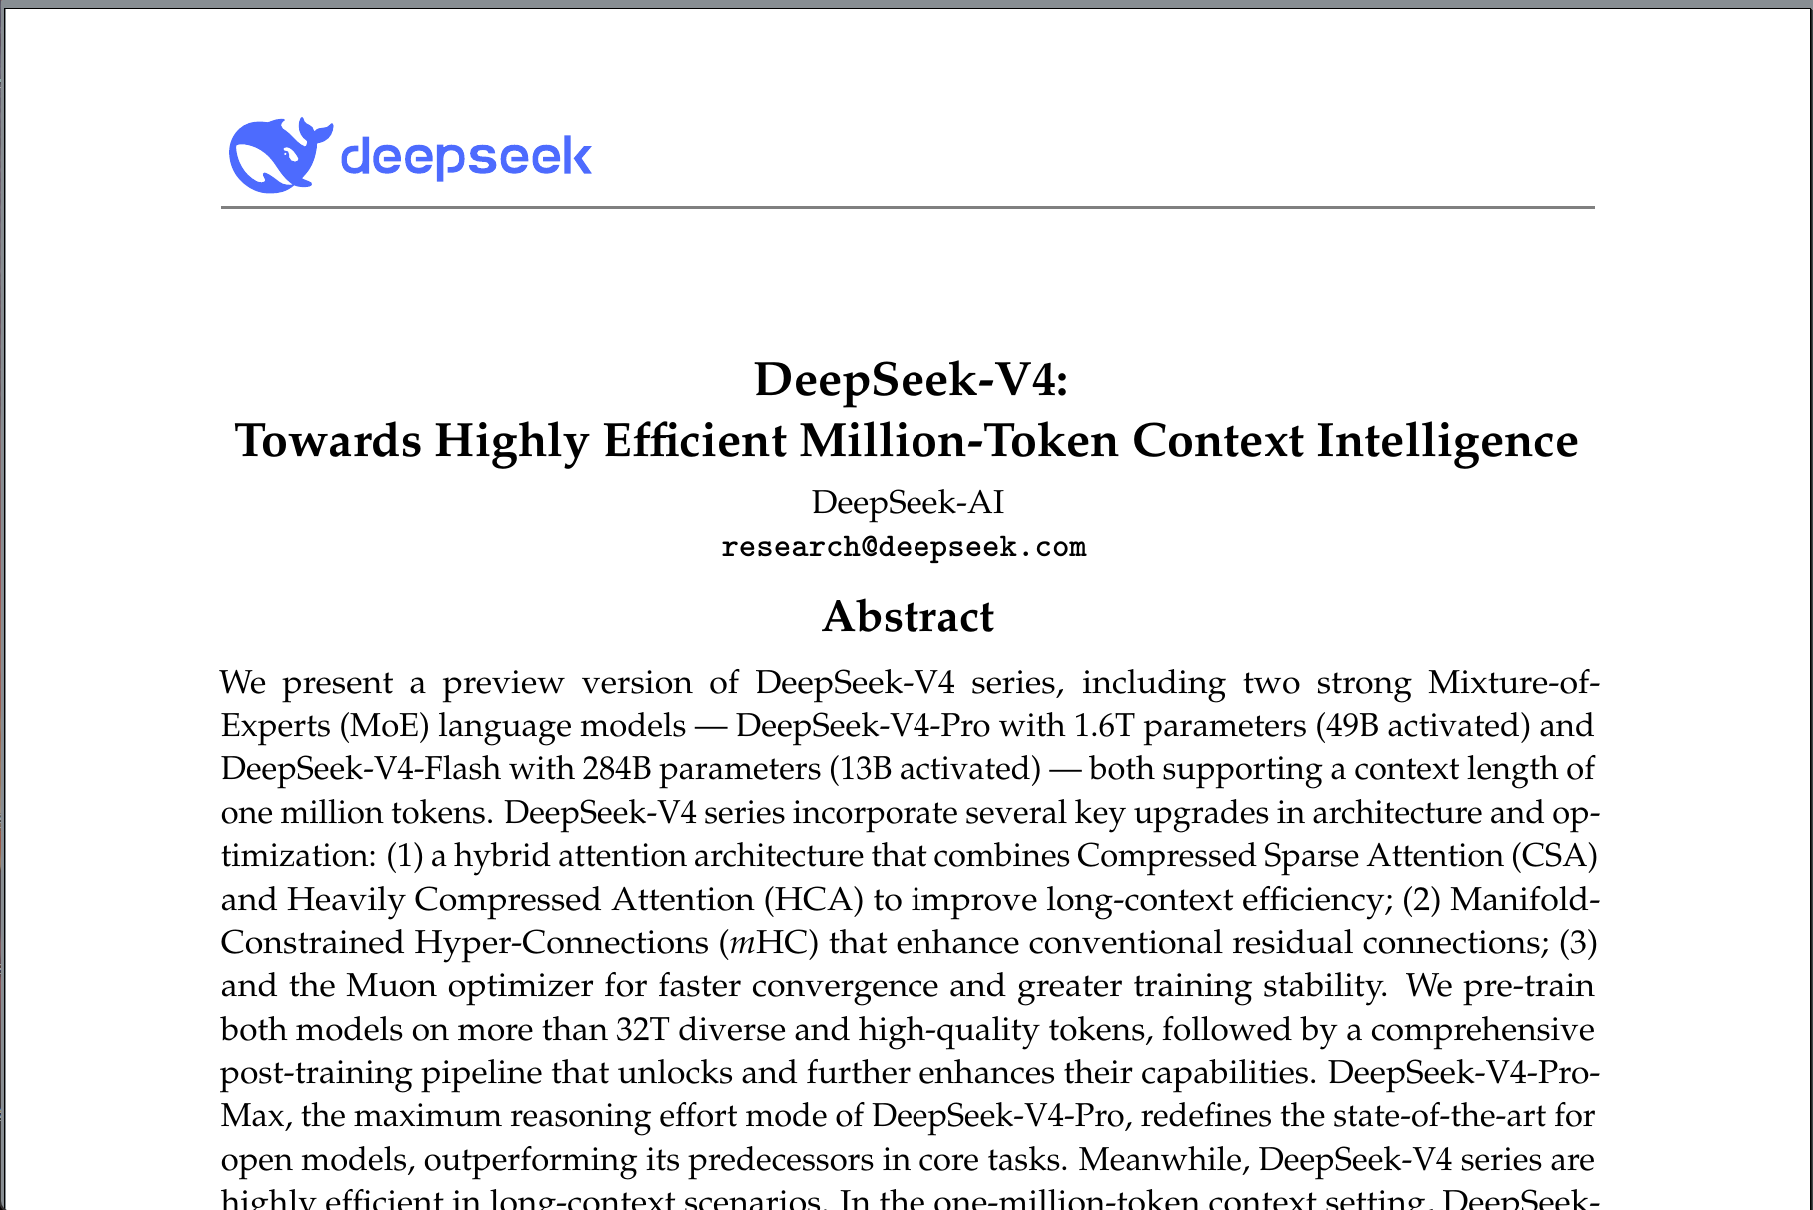
概览与总结
- DeepSeek-V4的参数大小为一万六千亿,已经远远超过了DeepSeek-R1的大小
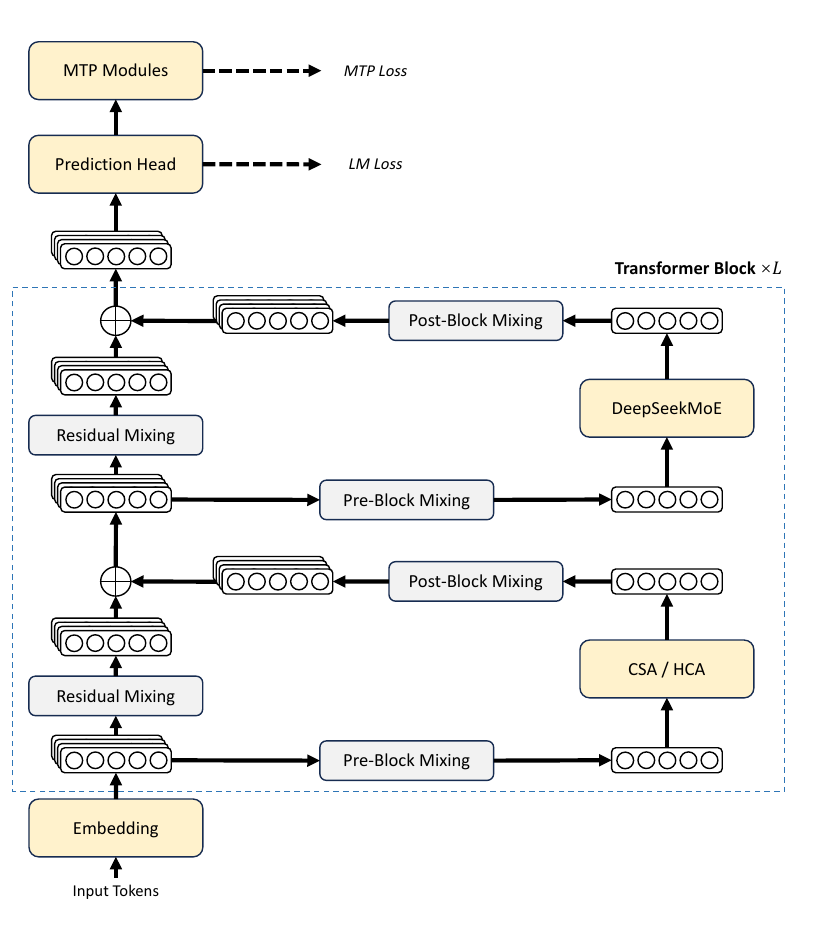
不得不说,新模型的架构太难看懂了,掺杂了很多近两年甚至是当年提出的新架构,我已经完全看不懂了,还是看看对比图吧:
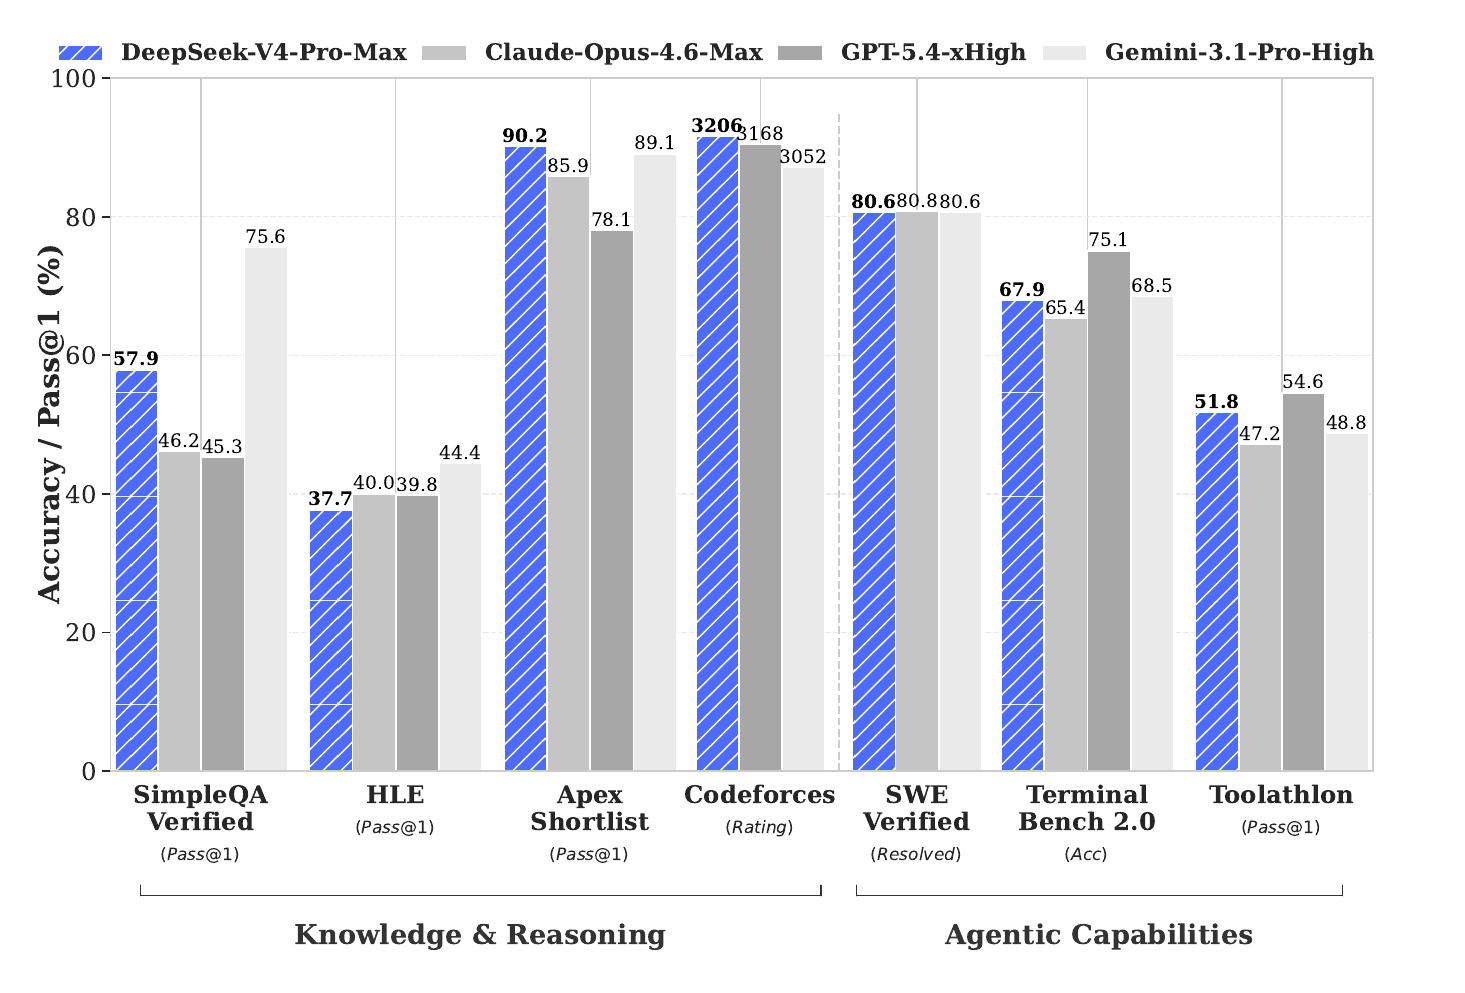
而实际调用API的体验也是不错的,主要的瓶颈反而是在输出长度和对多模态的支持上,不过这也没办法,DeepSeek的技术积累和资金支持还是比不过那些国际企业的,不过这个表现就已经很惊人了.
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression(2609)
概览
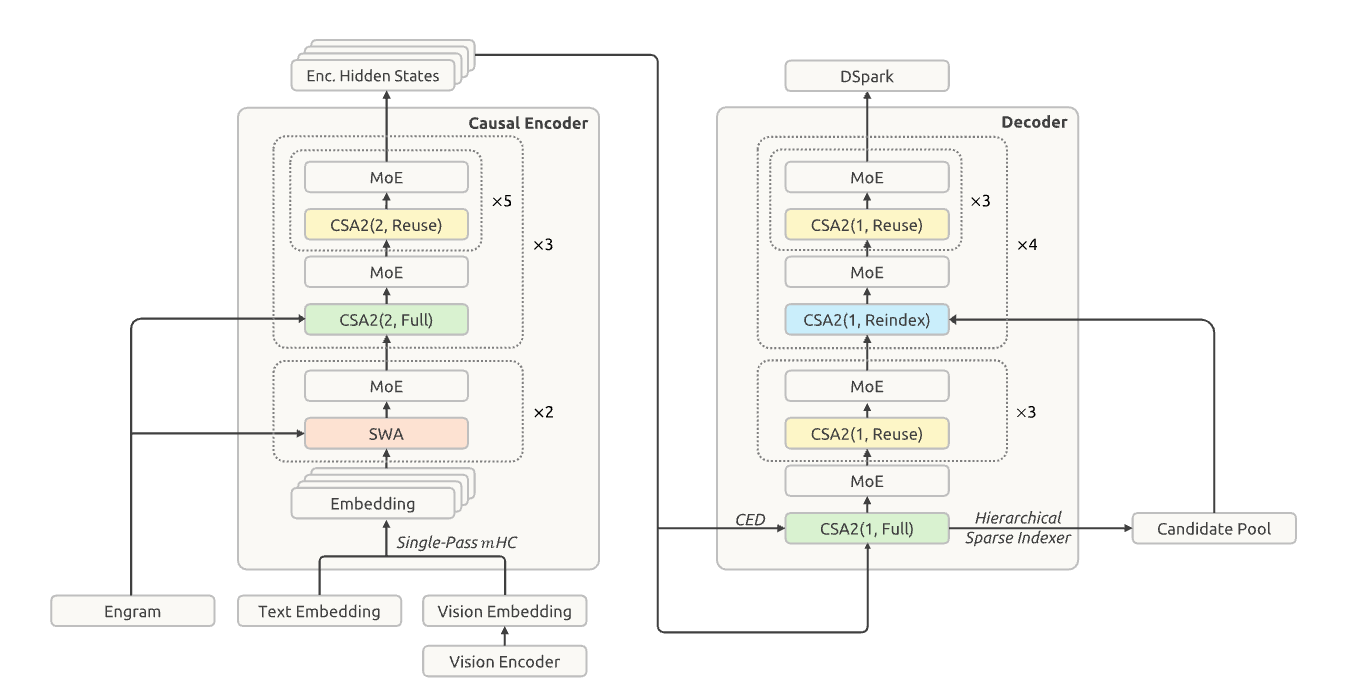
简单来说就是挤牙膏,堆叠结构,我认为这已经复杂过头了,迟早需要重构成一个更优美的模型.
智能体构建
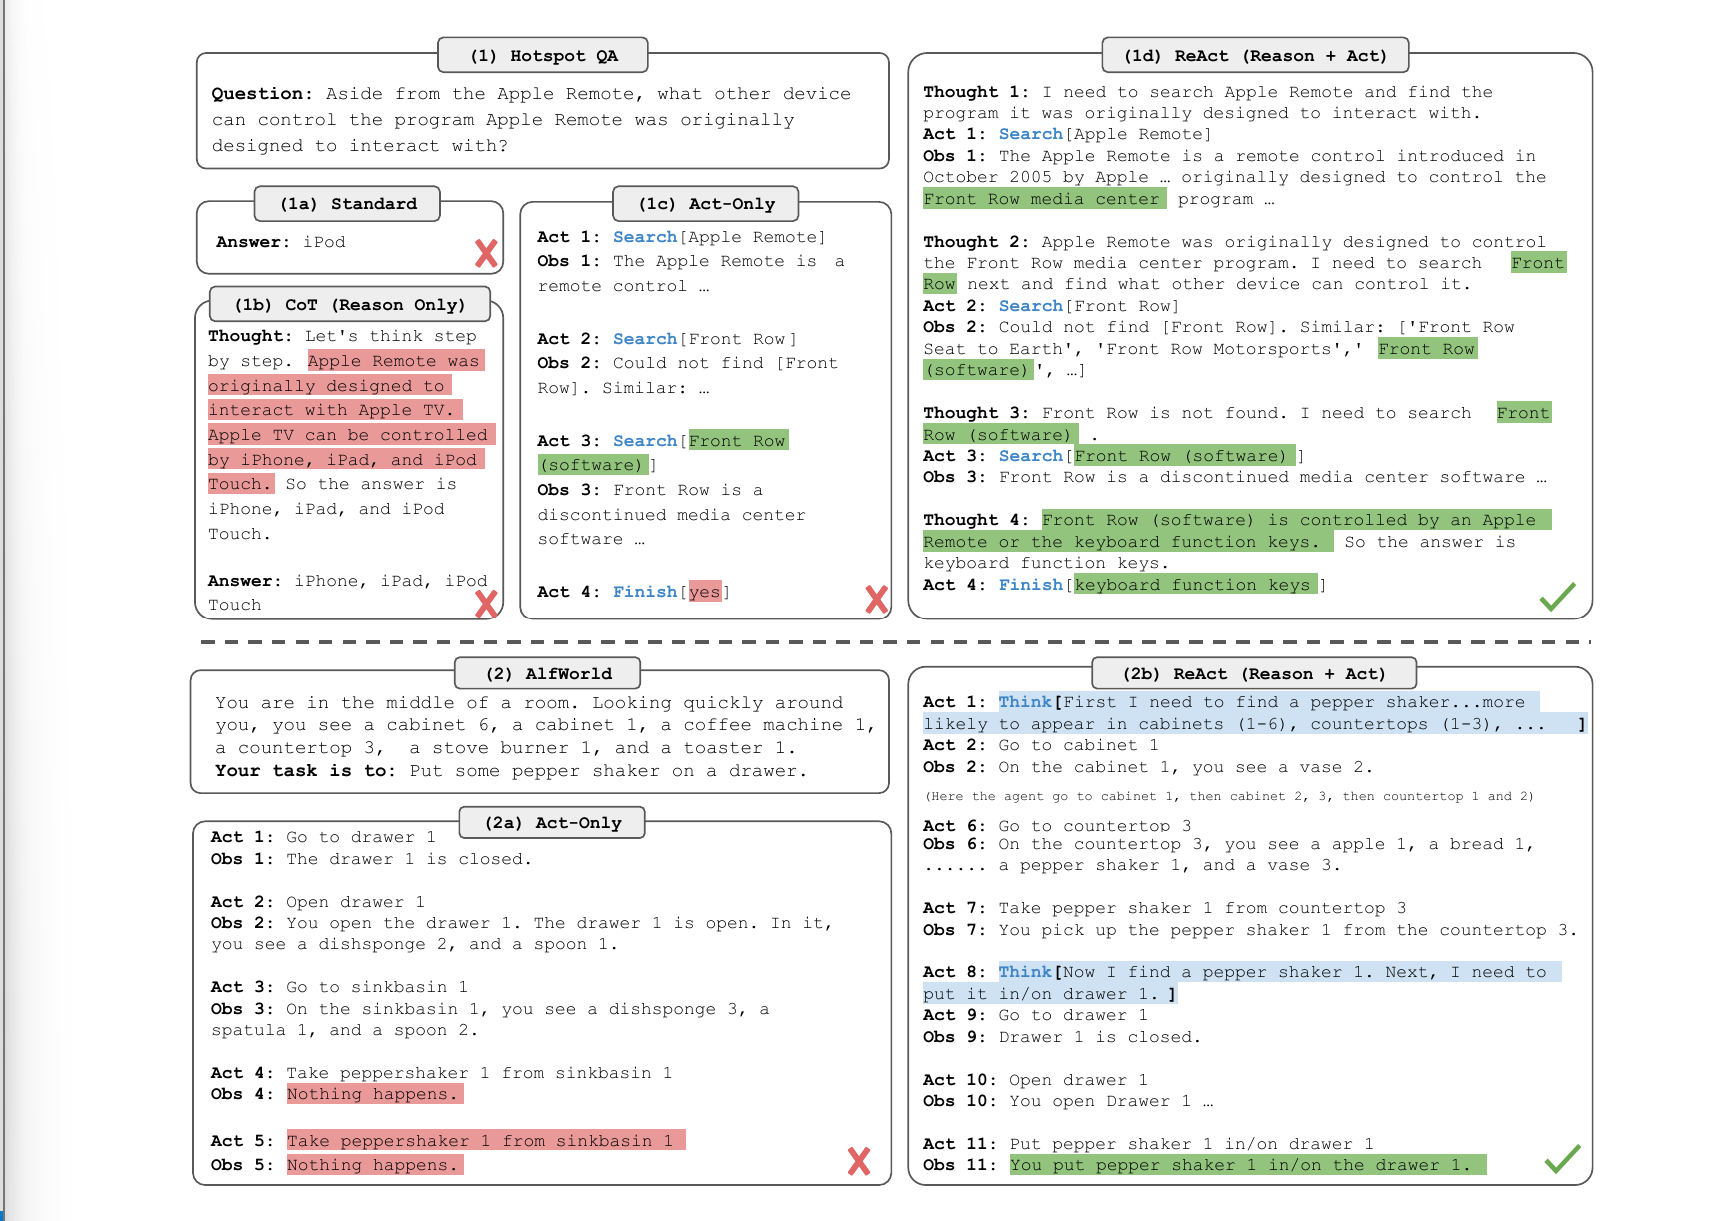
ReAct: Synergizing Reasoning and Acting in Language Models(22)
- (9/28): Google加Princeton,强强联手,自然,姚顺雨是第一作者
概要
人类的优势在于可以在复杂的环境下同时执行acting和reasoning,即边做边思考下一步,如果将这种能力引入LLM,那么效果一定很好:
From Local to Global: A GraphRAG Approach to Query-Focused Summarization(24)
- GraphRAG是由微软提出来的RAG改进版
概览与总结
首先,我们将语料切分成文本块,使用LLM处理语料,提取出里面的主体内容(entity)和对应的描述(description)与联系(relationship),比如对于这段语料:
NeoChip’s (NC) shares surged in their first week of trading on the NewTech Ex- change. However, market analysts caution that the chipmaker’s public debut may not reflect trends for other technology IPOs. NeoChip, previously a private entity, was acquired by Quantum Systems in 2016. The innovative semiconductor firm specializes in low-power processors for wearables and IoT devices. LLM会提取出以下三条信息:
- The entity NeoChip, with description “NeoChip is a publicly traded company specializing in low-power processors for wearables and IoT devices.”
- The entity Quantum Systems, with description “Quantum Systems is a firm that previously owned NeoChip.”
- A relationship between NeoChip and Quantum Systems, with description “Quantum Systems owned NeoChip from 2016 until NeoChip became publicly traded.”
之后,我们将每个主体和对应的描述储存在一个个节点中,将关系作为节点之间的边,关系相近的节点被聚拢在一起,称为社区(community).多个关系相近的社区又会被聚拢在一起,从而形成一个多层级的社区.每个社区都会由LLM生成一个关于该社区的摘要
对于每一次查询,我们可以选中与查询关系层级相同的一些社区,并用LLM从这些社区中总结得到待拼接的最优语料.
很明显,这种方法需要我们用来处理语料的大模型足够强,否则得到的GraphRAG就不具备实际使用的价值.再说,光是处理语料就会消耗大量的token,而具体的查询方法和如何锁定社区,论文也并没有提到.
总的来说,GraphRAG是相当不成熟和实验性的,不过由于是微软出品的,所以国内厂商还是迅速跟进了,至于效果如何,我看并没有多少显著的提升,不然早就发新论文了.
KIMI K2: OPEN AGENTIC INTELLIGENCE(25)
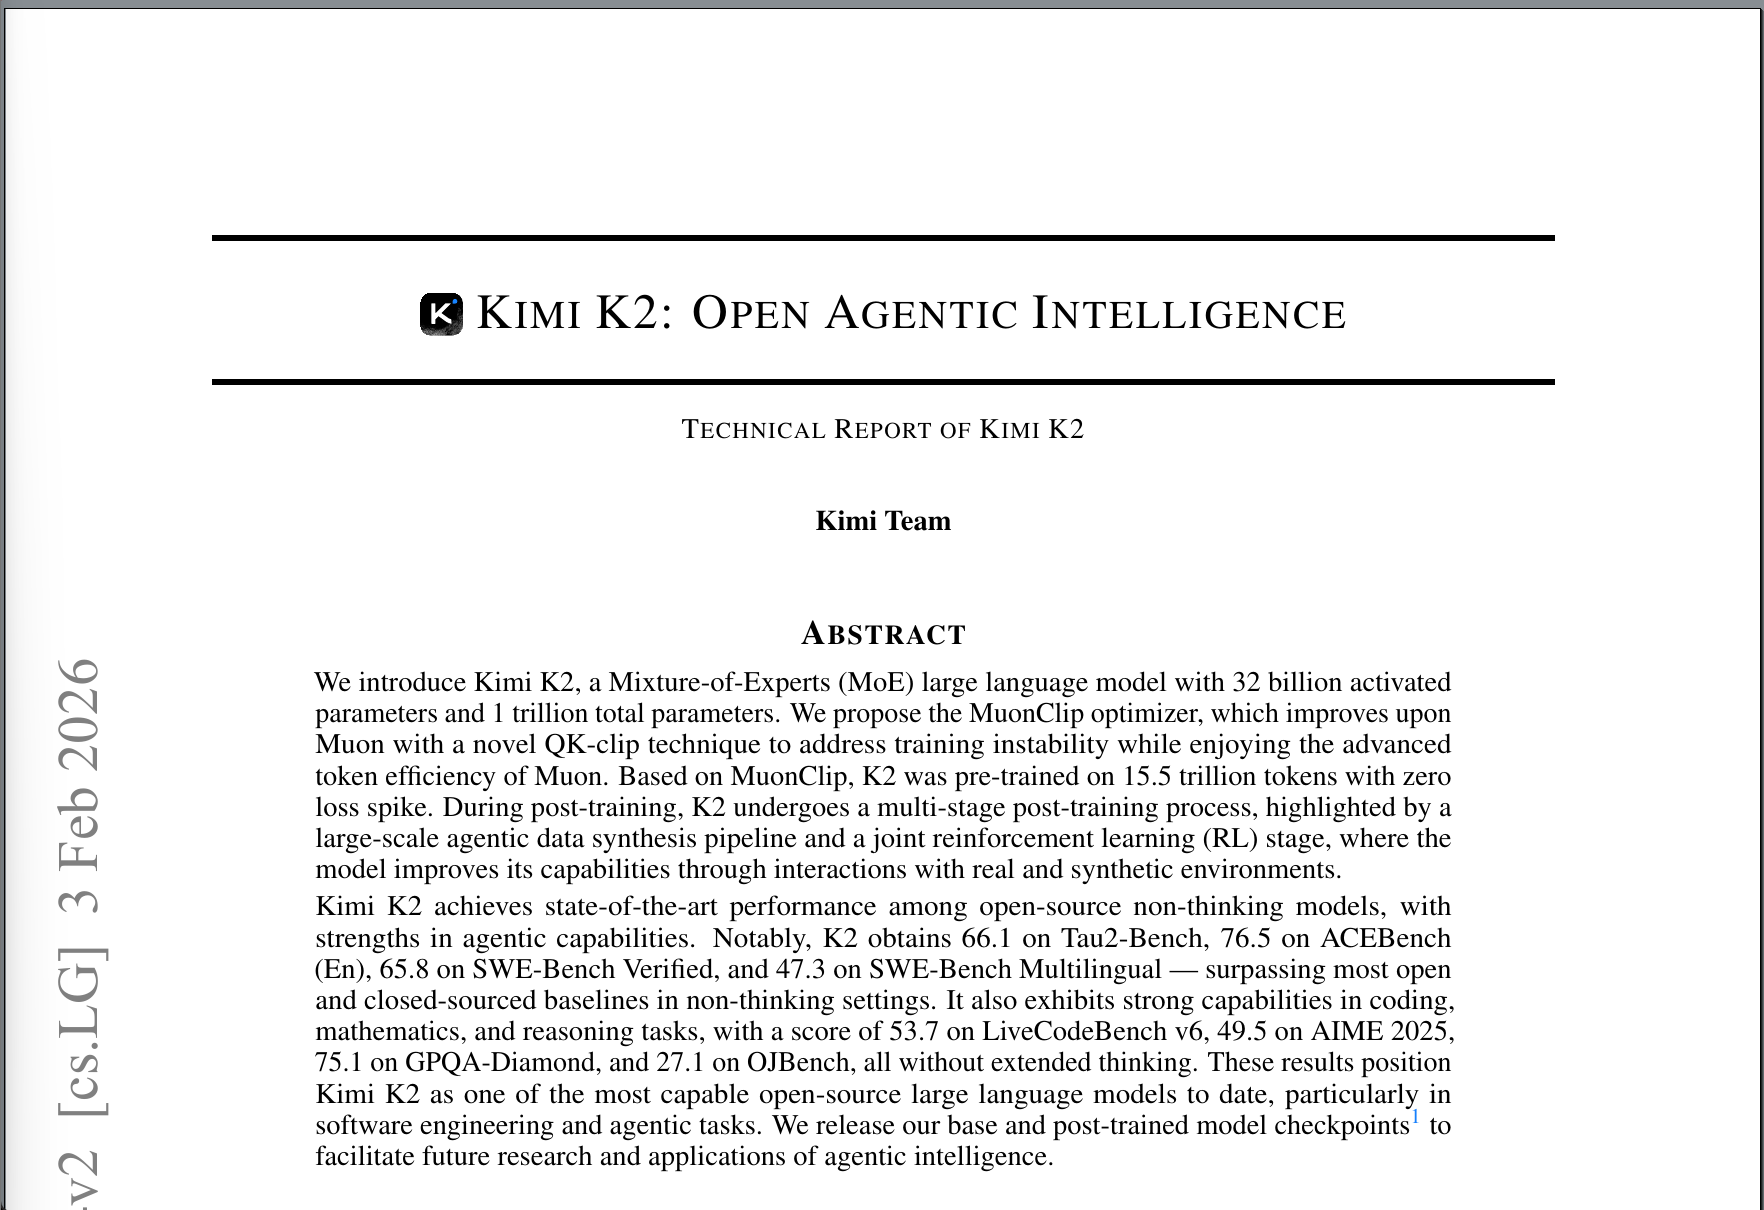
概览与总结
KIMI K2基本照搬了DeepSeek-V3的的架构,参数量提高到了一千亿,然后做了一点自己的优化,所以比DeepSeek-V3的表现还是要强不少的.
KIMI K2.5: VISUAL AGENTIC INTELLIGENCE(26)
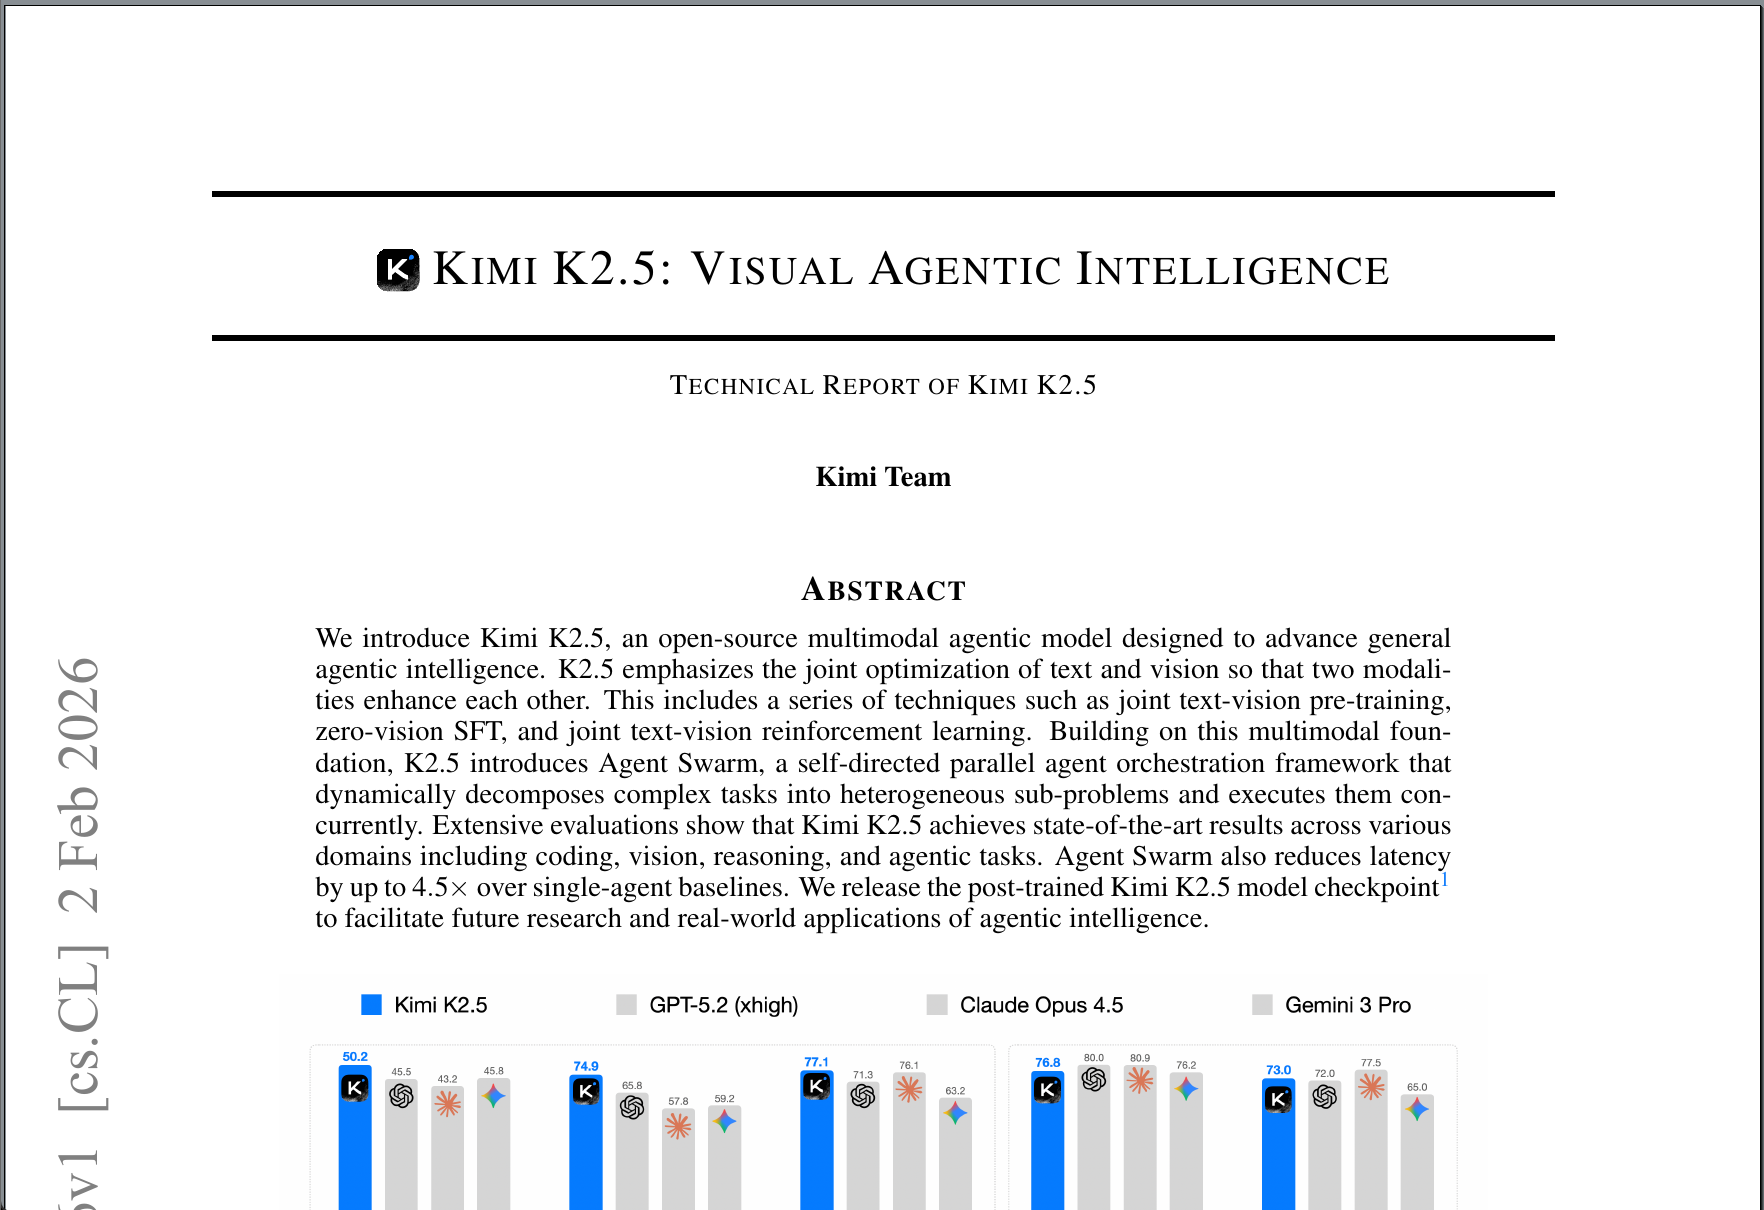
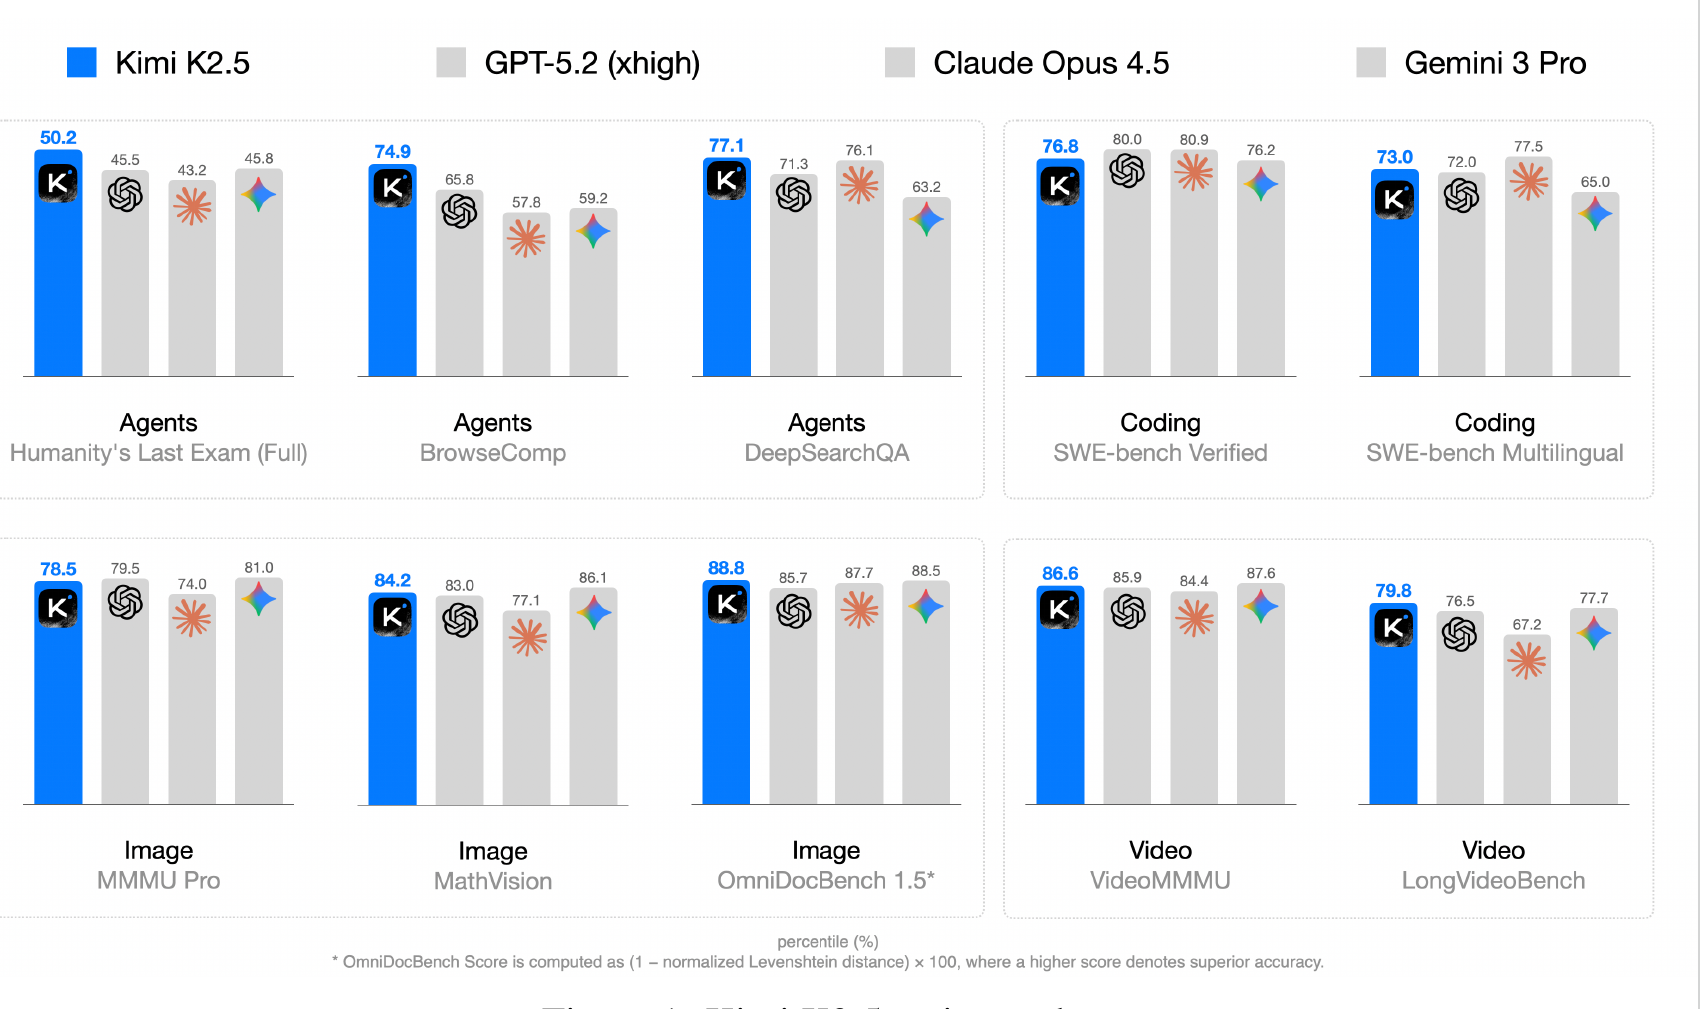
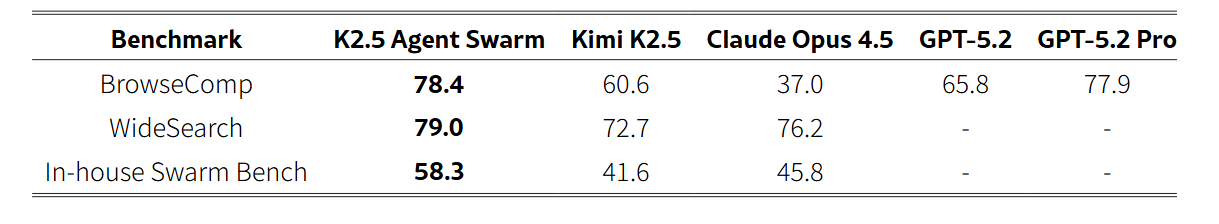
这个对比图就很迷啊,比别人差劲的地方还把自己显著标明的话就很容易看花眼好不好.
概览与总结
KIMI K2.5的基座模型就是KIMI K2,掺入了视觉理解能力和所谓的智能体集群,实际效果还不错.
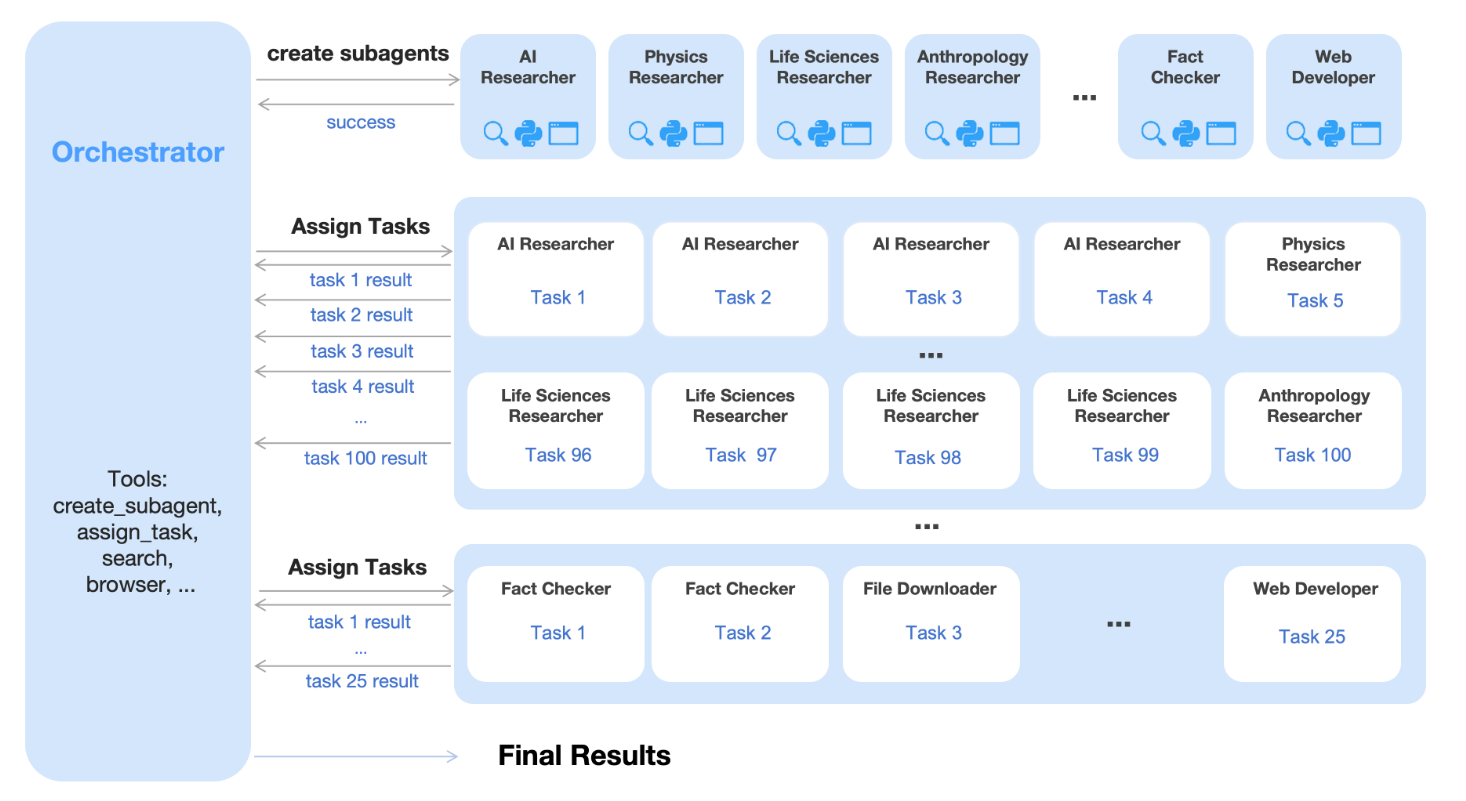
弄个自研的In-house Bench也是有点离谱了哈,那你分数不是肯定更高吗,明显是拿来凑数的:
Kimi K3: Open Frontier Intelligence(2608)
概览
弄了一个2.8T(接近3万亿)的MoE模型出来,上下文长度为1M的token,至于做了哪些优化,不好意思,依旧是挤牙膏.
总体而言,Kimi K3 的性能与最强的专有模型 Claude Fable 5 和 GPT-5.6 Sol 相比略逊一筹,但在基准测试套件中始终优于 Claude Opus 4.8、GPT-5.5 和 GLM-5.2
总结
近两年的大模型架构已经变得非常复杂了,不在这个领域深耕个几年是不太可能看懂的.而光凭借上述这些论文,我就已经对大模型的整个历史发展有了一个非常深入的认识了,以后应该只会随缘更新一点以前的论文,至于最新的论文我看也没必要研究,说不定几年后,又会有一篇天才论文横空出世,彻底简化这种臃肿的堆叠架构,回到纯朴的数学之美.
计算机视觉与多模态论文
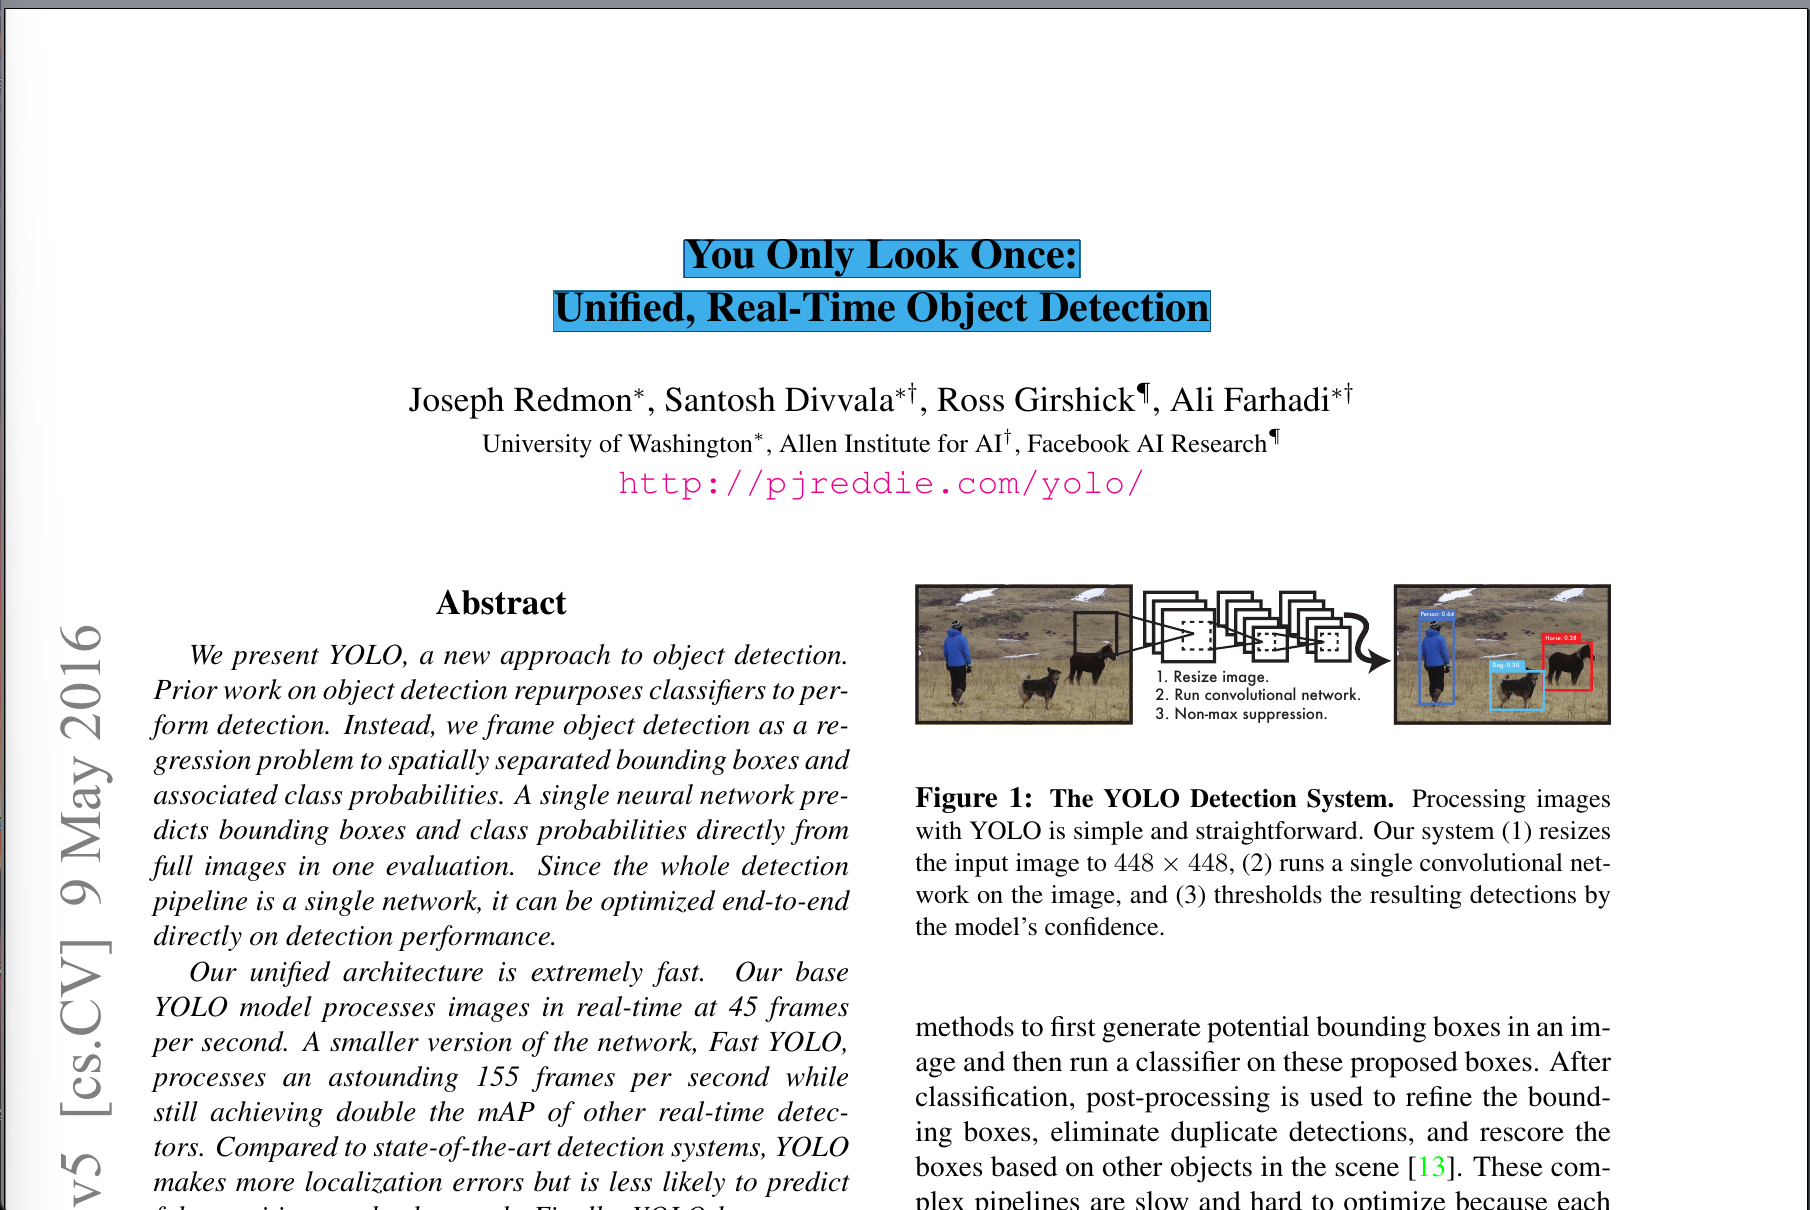
You Only Look Once: Unified, Real-Time Object Detection(16)
引入
先前的图像识别算法使用一个分类器通过滑动窗口来扫描图像,一般处理一张图片要花好几秒,R-CNN对此做了改进,先通过辅助工具给图像中的潜在目标设置一个有边界的箱子(后面都直接简称为边框),在使用分类器来判断这些潜在目标的特征,处理一张图片需要几十秒.
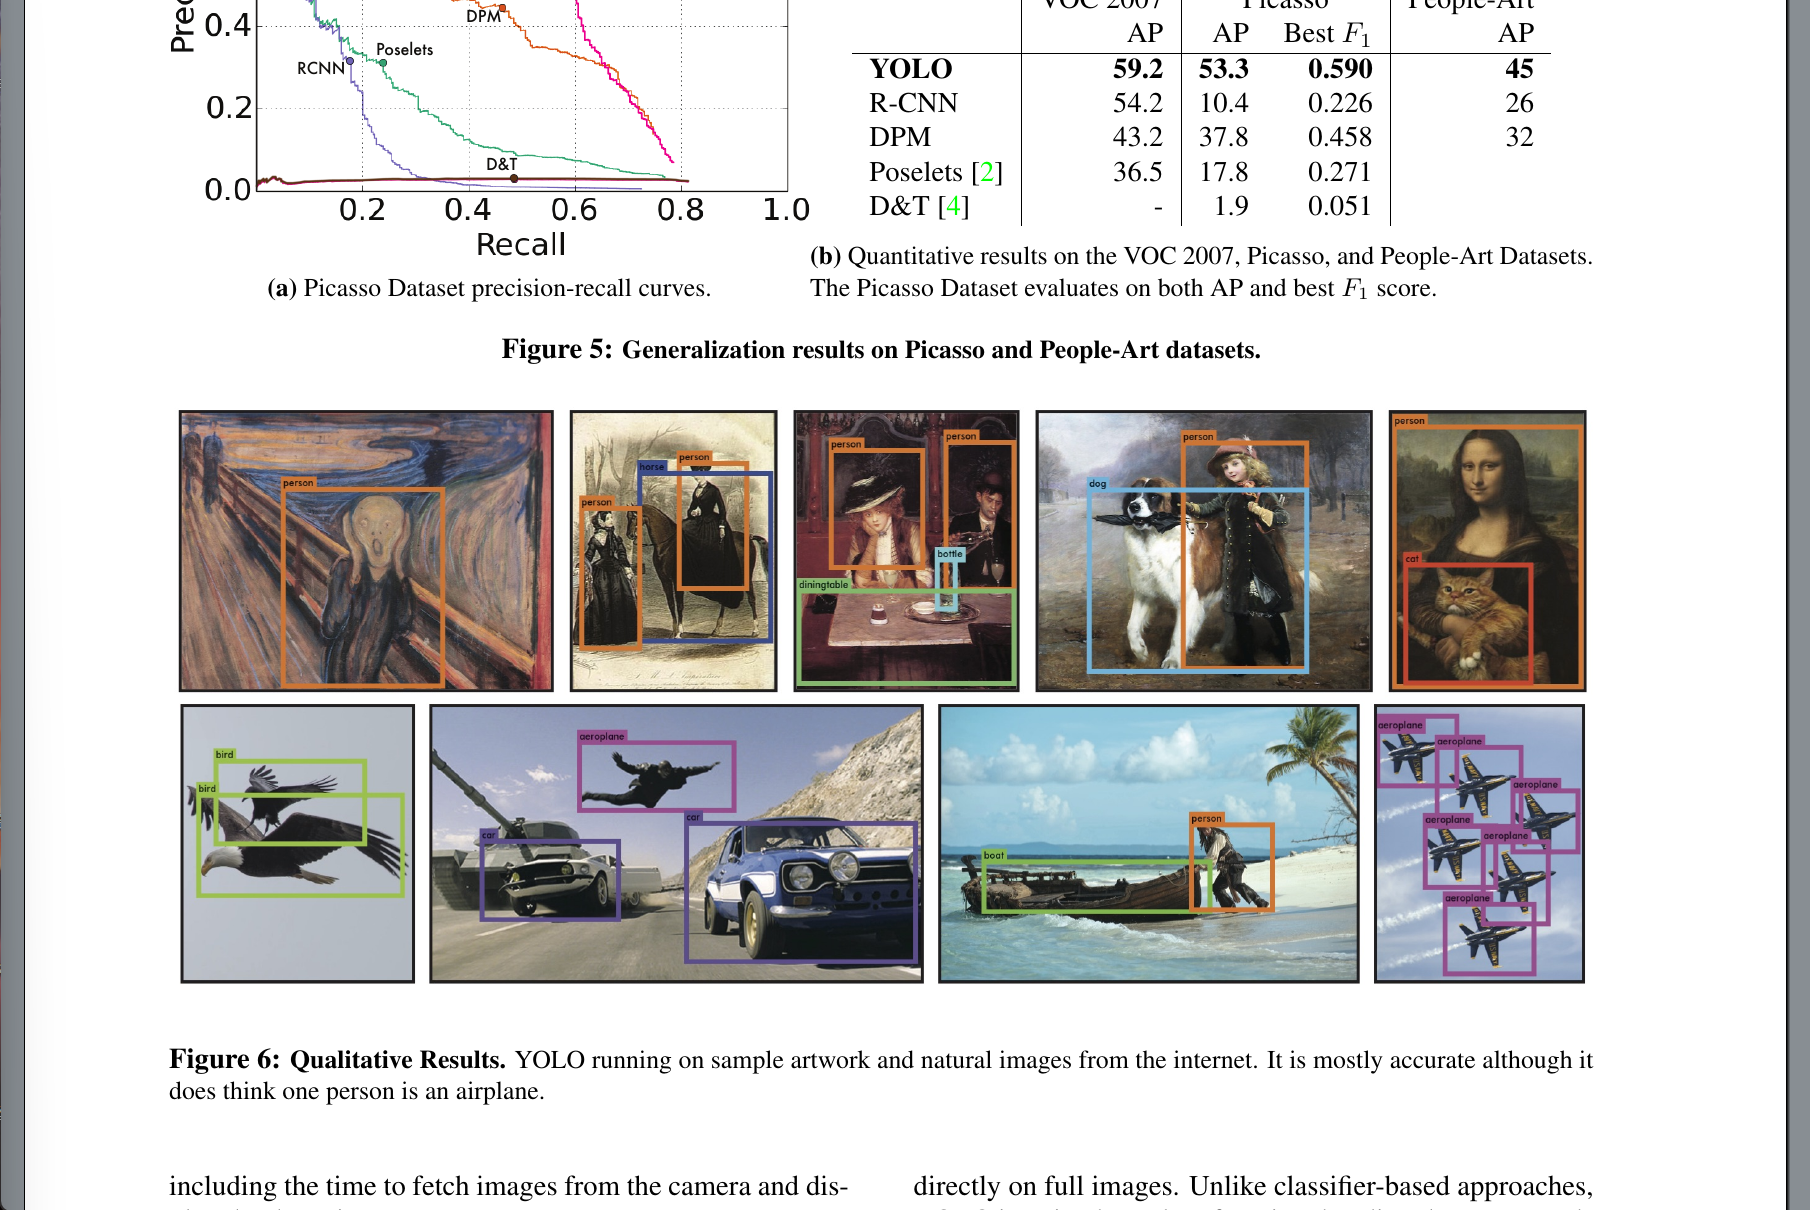
该论文提出了YOLO(You Only Look Once)方法,只需要将图像输入卷积神经网络一次就可以得到所有目标的边框和对应的分类.尽管准确度不如当时最优秀的图像识别算法,但是速度非常快,如文中所说,在一张Titan X GPU上可以在1秒内处理45张图片,而且是一次输入一张的那种,并不是批处理.
模型和架构
简单来说就是,训练时,我们预设需要识别的物体类别总数为C,将训练的图像划分成SxS的网格,每个网格负责预测该网格可能属于哪几种形状的边框,同时还要预测该网格对应的物体类别,标注好后直接将训练图像喂给下图所示的神经网络即可:
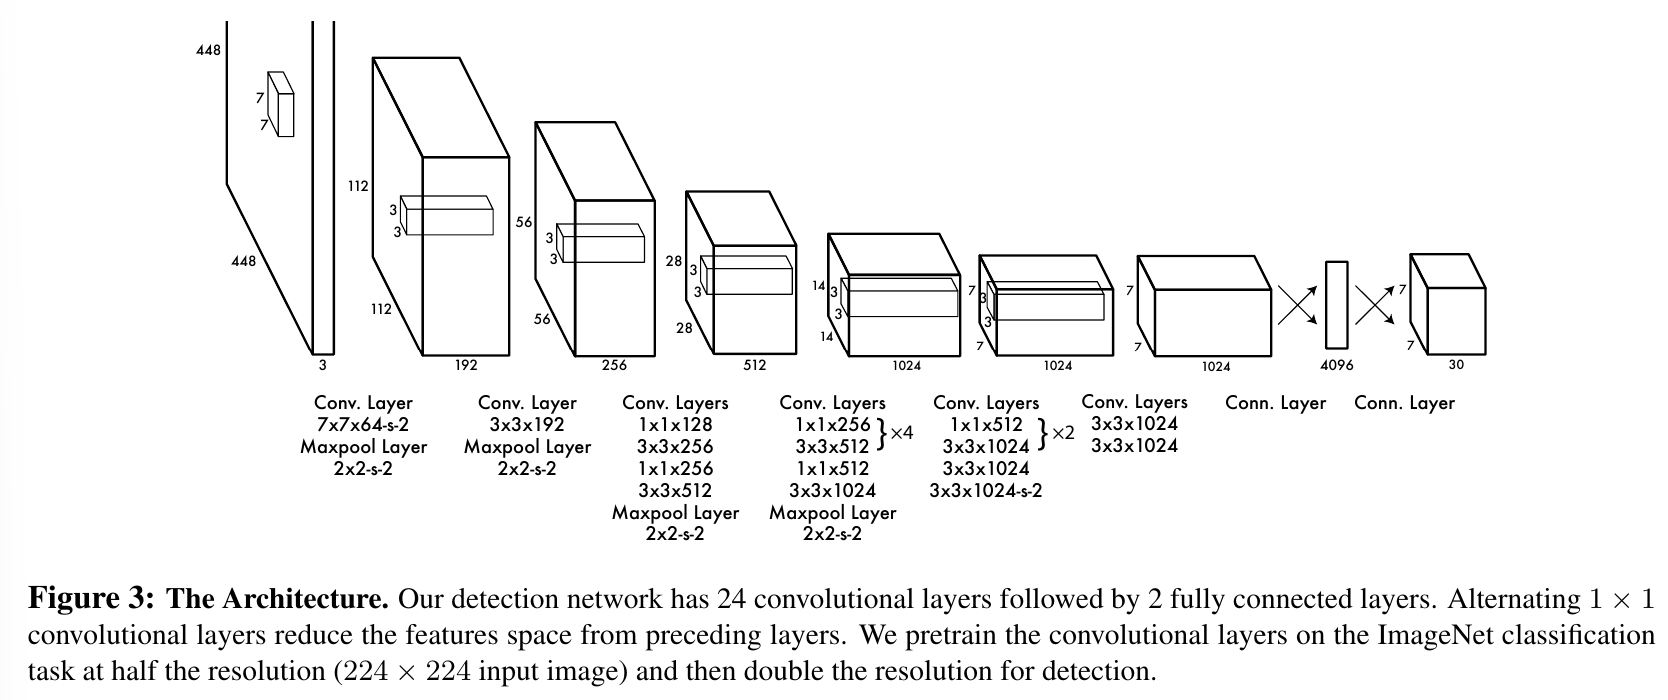
经过精心的设计,该网络产生的最终张量刚好是SxSxC,完美对应了之前的图像标注,从而可以进行损失函数的计算并开始反向传播.最终产出训练好的YOLO网络.
这个设计非常巧妙,确实是图像识别算法领域的一大飞跃.
- 不过论文中的C是20,而最终张量的大小是SxSx30,这我就不太理解了,以后有机会再来勘误吧.
AN IMAGE IS WORTH 16X16 WORDS (21)
- 这些人不起点故弄玄虚的标题就不会写论文了吗…
概览与总结
会议论文
ALGOL 58
梦开始的地方,毫不客气的说,从Fortran到ALGOL(ALGOrithmic Language)的演进是计算机科学开始走向辉煌的开始.
这篇论文远没有达到完善的程度,所以经过两年的激烈讨论和研究,ALGOL 60诞生了
ALGOL 60
- 群星汇聚,那才是计算机科学的黄金时代啊
整个文档非常的简洁,只列出了所有的必要语法,在其中可以看到现代高级语言的大多数基本思想.撰写人员们也并没有很清晰的意识到这篇文档的重要性.