最终的成果是做了一个简易的LLM对话网站,连联网搜索功能都没加上.
ch0: 前言
(10/10)嘛,如今来看这篇文章的质量是很堪忧的,但我也不打算重写前面的部分了,作为ADR也是不错的嘛.
这个项目从3月份开始动手,除了前端外都是我手搓的,随着项目的日愈成熟,我对后端工程的认识也越来越深,所以越往后的部分越值得读,至于前面就没必要看了,因为很多地方都有错误,原因在于我还是个菜鸟~
大纲
%%{init: {
  "theme": "base",
  "themeVariables": {
    "primaryColor": "#f4f8ff",
    "primaryBorderColor": "#6c8cff",
    "lineColor": "#6c8cff",
    "fontFamily": "Microsoft YaHei, PingFang SC, sans-serif"
  }
}}%%

flowchart TB

    N1[FastAPI基础]
    N2[极简智能体]
    N3[加入数据库]
    N4[加入Docker]
    N5[加入用户验证]
    N6[重写前端
(待完成)]

    N7[实现多轮对话]
    N8[加入管理员]
    N9[加入日志和检查工具]
    N10[换用Responses API]
    N11[引入联网搜索和MCP]
    N12[加入简单RAG]
    N13[结合Agent框架]
    N14[实现多样化RAG]
    N15[加入Redis和消息队列]
    N16[Kubernetes引入]

    N17[引入API测试]
    N18[优化API界面]

    N1 --> N2 --> N3 --> N4 --> N5 --> N6
    N5 --> N7 --> N8 --> N9 --> N10 --> N11 --> N12 --> N13 --> N14 --> N15 --> N16
    N10 --> N17 --> N18

    classDef core fill:#eaf2ff,stroke:#5b8def,stroke-width:2px,color:#1f2d3d;
    classDef ext fill:#edf9f1,stroke:#57b26a,stroke-width:2px,color:#1f2d3d;
    classDef qa fill:#fff6e8,stroke:#f0a43c,stroke-width:2px,color:#1f2d3d;
    classDef todo fill:#fff1f0,stroke:#ff7875,stroke-width:2px,color:#a8071a;

    class N1,N2,N3,N4,N5 core;
    class N6 todo;
    class N7,N8,N9,N10,N11,N12,N13,N14,N15,N16 ext;
    class N17,N18 qa;
fastapi基础
ch1: 使用fastapi响应普通的网络请求
CORS问题
为了更好的理解前后端通信的过程,我推荐自己写一个或者拿AI写一个网页,通过这个页面来访问fastapi端口,而非直接通过命令行触发默认的前端页面,可以有一个更好的学习效果.
比如我拿AI生成了一个网页代码:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| <!doctype html>
<html lang="zh">
<head>
<meta charset="UTF-8" />
<title>FastAPI Test</title>
</head>
<body>
<button onclick="testFastAPI()">访问 FastAPI 8000 端口</button>
<div id="output">等待请求...</div>
<script>
async function testFastAPI() {
const output = document.getElementById("output");
output.innerText = "请求中...";
try {
const response = await fetch("http://127.0.0.1:8000/");
const data = await response.json();
output.innerText = JSON.stringify(data, null, 2);
} catch (error) {
output.innerText = "错误: " + error.message;
console.error("无法连接到 FastAPI:", error);
}
}
</script>
</body>
</html>
|
使用Live Server插件打开后的效果如下:
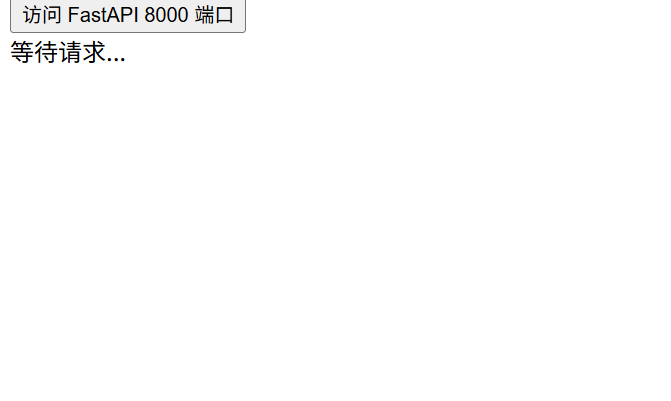
然后我再写一个python代码:
1
2
3
4
5
6
7
8
9
| # main.py
from fastapi import FastAPI
app = FastAPI()
@app.get("/")
async def helloword() -> dict:
return {"data": "hello,world"}
|
- 如果使用
uv init的话,将这个文件复制到main.py里就行了. - uvicorn默认在
http://127.0.0.1:8000启动服务器
使用uvicorn main:app运行这个代码后访问前端页面:
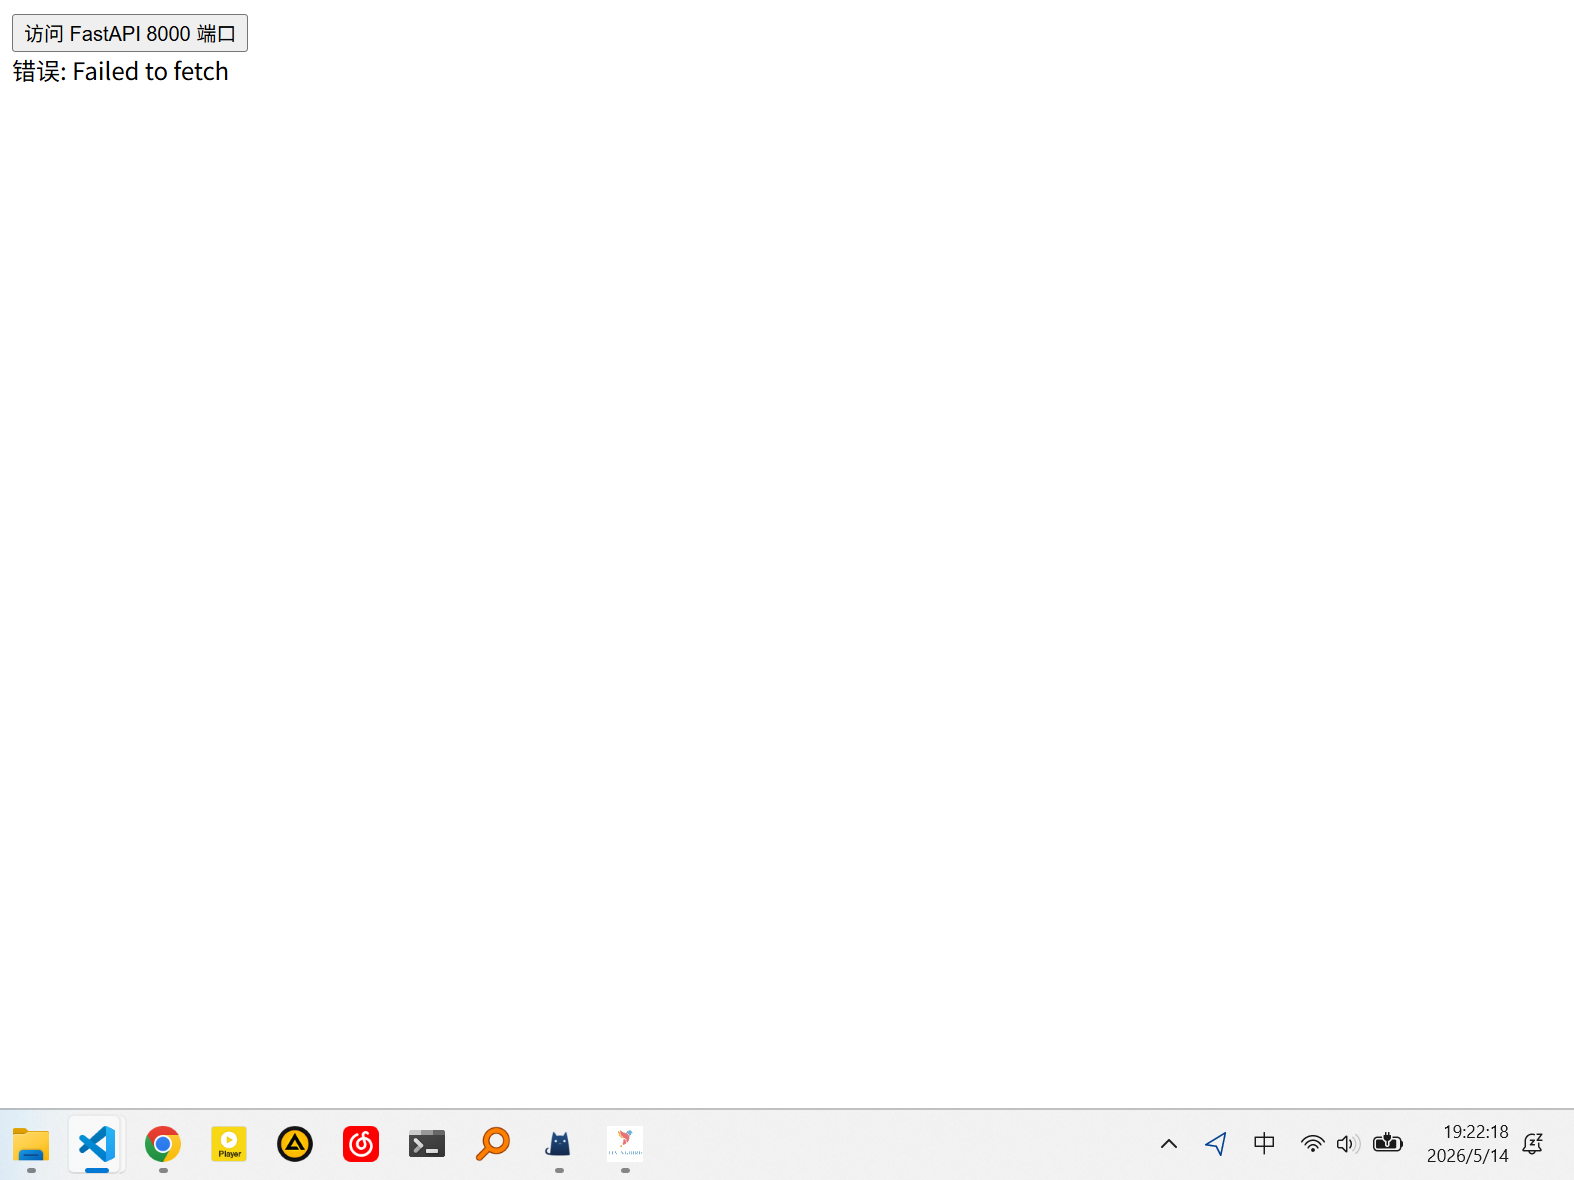 无论你点了按钮多少次,都是访问失败,但当我们看一下服务器终端时,却没有任何问题:
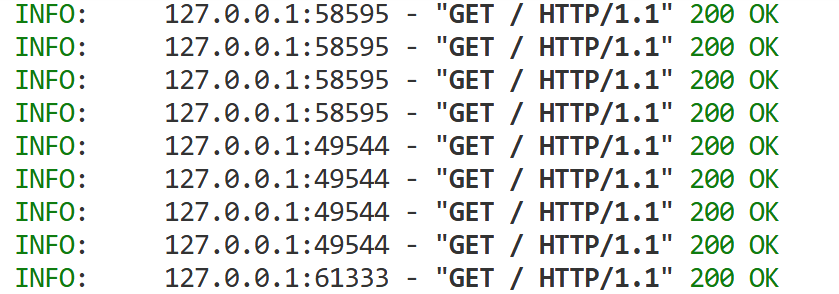
这是怎么回事?
在前端页面敲一下f12键调出控制台,看到这个报错:
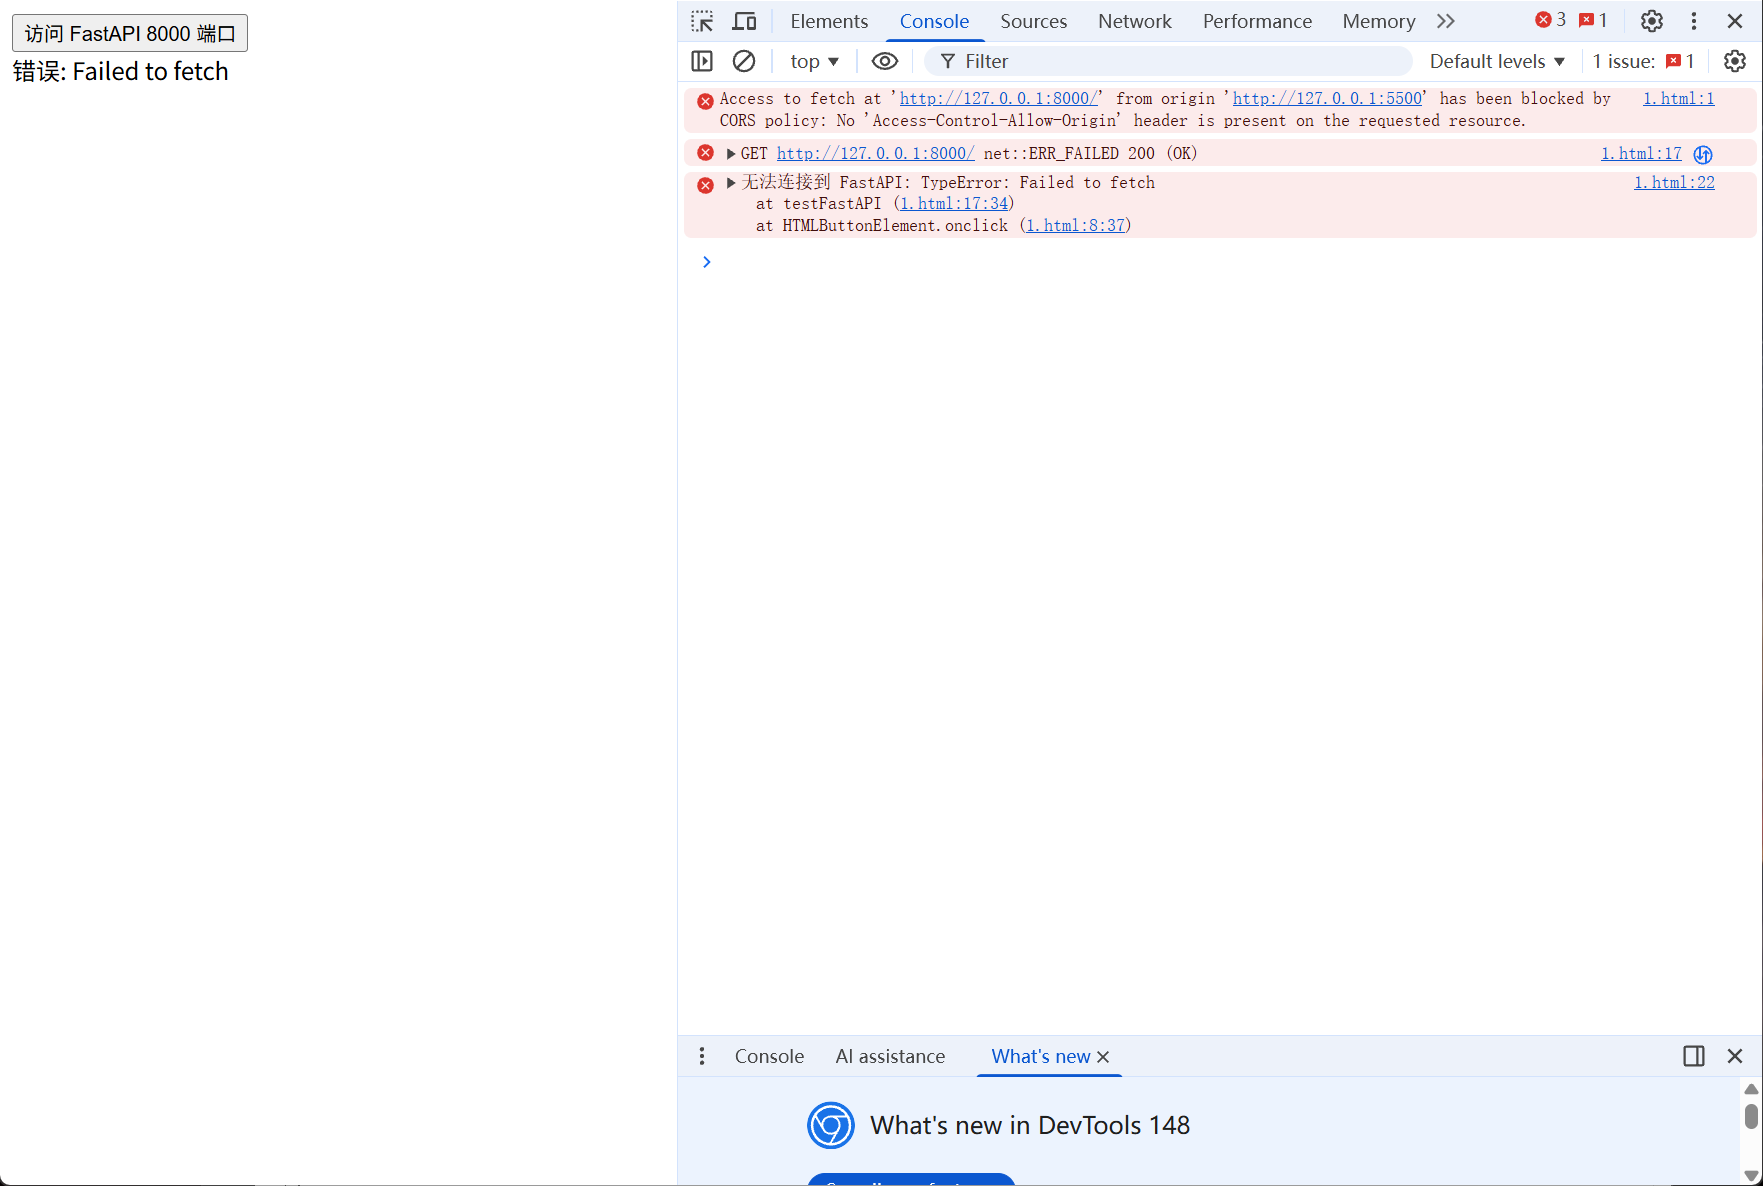
原来是我们触发了浏览器的CORS安全机制,它是什么?
CORS
CORS的全称为Cross-origin resource sharing,翻译成中文就是跨域资源共享,它允许一个前端页面通过一个不同的域名/端口来访问服务器端口提供的页面.
而浏览器不能保证另一个端口/域名的网页是善意的,如果允许它直接访问服务器端口页面,可能造成非常恶劣的影响,因此需要跨域请求带上Access-Control-Allow-Origin请求头,如果请求头里的信息合规,就放行这次请求,返回正常页面.
跨域中间件
鉴于一个网络服务只能占用一个端口,我们不可能将前端页面也放到后端页面的同一个端口上,为了让前端页面能够正常跨域访问后端端口,跨域中间件(CORSMiddleware)这一工具就派上用场了.
当你配置了 CORSMiddleware 后,每当一个请求进入 FastAPI 并准备返回时,中间件会根据你的配置自动在返回的 HTTP Header 中插入以下字段:
Access-Control-Allow-Origin: 告诉浏览器哪些域(Origin)可以访问数据。如果你设为 ["*"],它就会加上 Access-Control-Allow-Origin: *。Access-Control-Allow-Methods: 告诉浏览器允许哪些请求方法(如 GET, POST, PUT)。Access-Control-Allow-Headers: 告诉浏览器允许哪些自定义请求头。
回到主题
在fastapi中配置跨域中间件非常简单,我们只需要在前面的python代码中加入以下字段即可,我们基本上也只用得到这些字段:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| from fastapi import FastAPI
from fastapi.middleware.cors import CORSMiddleware # 导入中间件
app = FastAPI()
# 配置 CORS
app.add_middleware(
CORSMiddleware,
allow_origins=["*"], # 允许所有来源
allow_credentials=True,
allow_methods=["*"], # 允许所有方法(GET, POST 等)
allow_headers=["*"], # 允许所有请求头
)
@app.get("/")
async def helloword() -> dict:
return {"data": "hello,world"}
|
由于修改了跨域策略,我们需要重启python服务器后再访问前端:
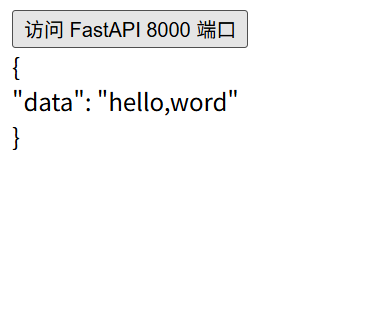
总而言之,配合前端代码我们可以更好地理解Fastapi.
路由编写
一个简单的路由写法如下:
1
2
3
4
5
6
7
8
| from fastapi import FastAPI
app = FastAPI()
@app.get("/items/{item_id}")
async def read_item(item_id):
return {"item_id": item_id}
|
当用户访问/items/newitem时,fastapi会自动将newitem传入read_item函数中并返回对应的值.
查询参数
在Google里键入google进行搜索,你就会跳转到https://www.google.com/search?q=google页面,Google服务器从而向你返回搜索结果,这里的?q=google就是查询参数.
尽管搜素引擎是查询参数的主要运用场景,但有时候我们需要让用户根据它的查询参数返回对应的值,而fastapi中的写法特别简单:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| from fastapi import FastAPI
app = FastAPI()
@app.get("/users/{user_id}/items/{item_id}")
async def read_user_item(
user_id: int, item_id: str, q: str | None = None, short: bool = False
):
item = {"item_id": item_id, "owner_id": user_id}
if q:
item.update({"q": q})
if not short:
item.update(
{"description": "This is an amazing item that has a long description"}
)
return item
|
fastapi将查询参数直接写在函数参数中,这里的q参数默认值为None,代表用户可以不带上这个参数,而short的默认值为False,代表用户如果不加short参数的话就会默认返回False.
查询参数的校验
fastapi中有一个Query库,可以配合typing库中的Annotated进行数据校验,一个简单的用法如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| from typing import Annotated
from fastapi import FastAPI, Query
app = FastAPI()
@app.get("/items/")
async def read_items(q: Annotated[str | None, Query(max_length=50)] = None):
results = {"items": [{"item_id": "Foo"}, {"item_id": "Bar"}]}
if q:
results.update({"q": q})
return results
|
上述代码要求: 如果你写了q参数,那么它的长度就不能超过50.
至于更复杂的用法,建议碰到再学,不然也记不住.
路径参数的校验
同样,我们可以校验路径参数,fastapi同样封装了一个Path库供我们调用:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
| from typing import Annotated
from fastapi import FastAPI, Path
app = FastAPI()
@app.get("/items/{item_id}")
async def read_items(
item_id: Annotated[int, Path(title="The ID of the item to get", ge=1)], q: str
):
results = {"item_id": item_id}
if q:
results.update({"q": q})
return results
|
请求体与不同的网络请求方法
上述的代码其实是很有问题的,它使用results.update对数据进行了修改,按照Rest规范,get请求不应该对数据做任何修改,只能原样返回数据!
Rest规范的一个简单概述如下:
- 如果用户要创建新的数据,他应该使用post请求
- 如果用户要部分修改旧数据,他应该使用patch请求
- 如果用户要全盘替换旧数据,他应该使用put请求
- 如果用户要删除某个旧数据,他应该使用delete请求
- 如果用户仅仅是访问某个页面,使用get请求就行了.
上述的第四点和第五点一般不用用户携带任何信息,只在请求头(request header)里说明即可.但前三点都需要用户在请求体(request body)里给出自己的数据,来修改服务器中的对应路由数据.
自然,我们希望用户提交的数据是足够规范的,不然后端根本无法处理.fastapi紧密结合了pydantic库,用它来约束请求体的格式,一个简单的代码如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| from fastapi import FastAPI
from pydantic import BaseModel
class Item(BaseModel):
name: str
description: str | None = None
price: float
tax: float | None = None
app = FastAPI()
@app.post("/items/")
async def create_item(item: Item):
return item
|
get请求中的函数参数一般都是路由变量和查询参数变量,而post等处理数据的请求中的函数参数可以是用户传来的请求体.具体规则如下,优先级从高到低:
- 如果该参数也在路径中声明了,它就是路径参数。
- 如果该参数是(int、float、str、bool 等)单一类型,它会被当作查询参数。
- 如果该参数的类型声明为 Pydantic 模型,它会被当作请求体。
- 如果这三点它都不满足,那么就是普通的参数了.
一个比较完整的示例
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
| from fastapi import FastAPI
from pydantic import BaseModel
class Item(BaseModel):
name: str
description: str | None = None
price: float
tax: float | None = None
app = FastAPI()
@app.put("/items/{item_id}")
async def update_item(item_id: int, item: Item, q: str | None = None):
result = {"item_id": item_id, **item.model_dump()}
if q:
result.update({"q": q})
return result
|
我们现在进行的数据处理都是伪处理,数据都没有存储在数据库里,甚至都没有创建一个临时的全局变量来存放数据.
请求体的进阶写法
- 我们可以用另外一个BaseModel类来注释一个BaseModel类中的变量:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| from fastapi import FastAPI
from pydantic import BaseModel
app = FastAPI()
class Image(BaseModel):
url: str
name: str
class Item(BaseModel):
name: str
description: str | None = None
price: float
tax: float | None = None
tags: set[str] = set()
image: Image | None = None
@app.put("/items/{item_id}")
async def update_item(item_id: int, item: Item):
results = {"item_id": item_id, "item": item}
return results
|
甚至可以把image字段变成列表:
1
| images: list[Image] | None = None
|
那么我们就期望接受到这样的请求体:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
| {
"name": "Foo",
"description": "The pretender",
"price": 42.0,
"tax": 3.2,
"tags": [
"rock",
"metal",
"bar"
],
"images": [
{
"url": "http://example.com/baz.jpg",
"name": "The Foo live"
},
{
"url": "http://example.com/dave.jpg",
"name": "The Baz"
}
]
}
|
定制响应体
fastapi通过函数的返回值类型注解来指明响应体的格式,它会将输出数据限制并过滤为返回类型中定义的内容:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| from fastapi import FastAPI
from pydantic import BaseModel
app = FastAPI()
class Item(BaseModel):
name: str
description: str | None = None
price: float
tax: float | None = None
tags: list[str] = []
@app.post("/items/")
async def create_item(item: Item) -> Item:
return item
@app.get("/items/")
async def read_items() -> list[Item]:
return [
Item(name="Portal Gun", price=42.0),
Item(name="Plumbus", price=32.0),
]
|
如果还需要在返回值约束的基础上对响应体做出进一步约束,就需要使用response参数,非常特别的是,由于没有地方可以放这个参数了,只好放在语法糖中,所以也不用进行导入:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| from typing import Any
from fastapi import FastAPI
from pydantic import BaseModel
app = FastAPI()
class Item(BaseModel):
name: str
description: str | None = None
price: float
tax: float | None = None
tags: list[str] = []
@app.post("/items/", response_model=Item)
async def create_item(item: Item) -> Any:
return item
@app.get("/items/", response_model=list[Item])
async def read_items() -> Any:
return [
{"name": "Portal Gun", "price": 42.0},
{"name": "Plumbus", "price": 32.0},
]
|
FastAPI 会使用这个 response_model 来完成数据文档、校验等,并且还会将输出数据转换并过滤为其类型声明。
如果你的编辑器、mypy 等进行严格类型检查,你可以将函数返回类型声明为 Any。
这样你告诉编辑器你是有意返回任意类型。但 FastAPI 仍会使用 response_model 做数据文档、校验、过滤等工作。
如果你同时声明了返回类型和 response_model,response_model 会具有优先级并由 FastAPI 使用。
为什么需要引入response_model呢,因为如果我们需要将用户数据进行处理后再进行输出,比如说过滤掉密码等敏感信息,我们可以这么写:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| from typing import Any
from fastapi import FastAPI
from pydantic import BaseModel, EmailStr
app = FastAPI()
class UserIn(BaseModel):
username: str
password: str
email: EmailStr
full_name: str | None = None
class UserOut(BaseModel):
username: str
email: EmailStr
full_name: str | None = None
@app.post("/user/", response_model=UserOut)
async def create_user(user: UserIn) -> Any:
return user
|
但是,如果我们去掉response_model参数,把UserOut作为函数的返回类型,由于同一个变量有了两个不同的类型注释,这显然会在类型检查工具中报错.
当然,上述方法是在老式的fastapi项目中使用的,现在我们有一种更好的处理方法,那就是通过类继承:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
| from fastapi import FastAPI
from pydantic import BaseModel, EmailStr
app = FastAPI()
class BaseUser(BaseModel):
username: str
email: EmailStr
full_name: str | None = None
class UserIn(BaseUser):
password: str
@app.post("/user/")
async def create_user(user: UserIn) -> BaseUser:
return user
|
user变量虽然是UserIn类型,但它同样也是BaseUser的子类,因此类型检查工具不会报错.
更值得令人惊叹的是,fastapi对这种情况做了很多优化,不会把类继承规则用于返回数据中,而是严格按照声明的返回类型进行处理和过滤.
有时候,我们不知道前端会返回什么东西,这在测试和编写demo代码的时候可能会出现,这个时候我们不需要使用Pydantic模型,而是使用普通的字典或者其他类型注解就可以了:
1
2
3
4
5
6
7
8
| from fastapi import FastAPI
app = FastAPI()
@app.get("/keyword-weights/", response_model=dict[str, float])
async def read_keyword_weights():
return {"foo": 2.3, "bar": 3.4}
|
- 话又说回来,上述代码完全可以将类型注解放进返回值注解中
响应状态码
fastapi的语法糖中还可以放置响应状态码:
1
2
3
4
5
6
7
8
| from fastapi import FastAPI
app = FastAPI()
@app.post("/items/", status_code=201)
async def create_item(name: str):
return {"name": name}
|
由于数字太难记了,fastapi还内置了智能的类型补全:
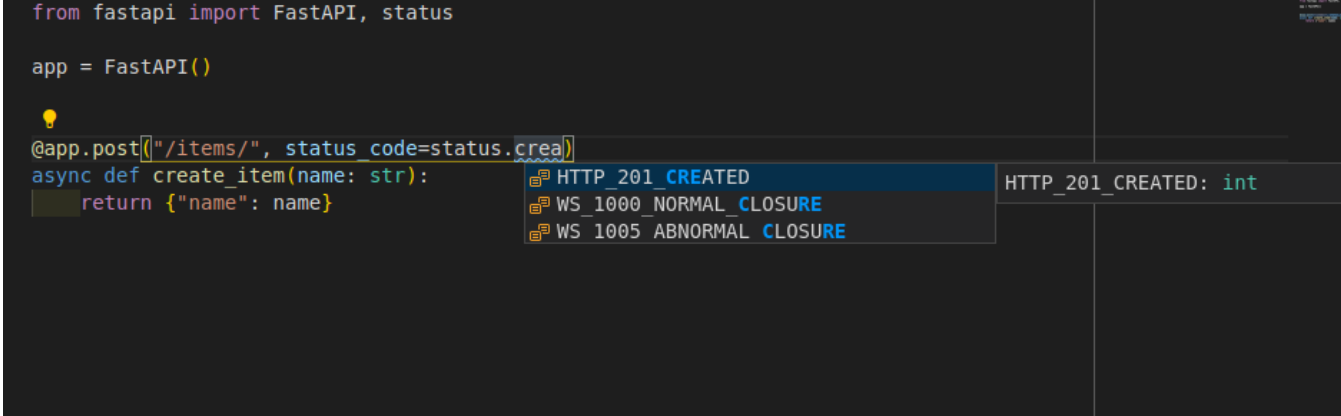
导入status库后即可使用这种更为清晰的状态码.
返回错误
有时候用户的请求有问题,或者服务器本身出了问题(比如数据库无法正常连接上),这个时候可以导入HTTPException来作为响应:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
| from fastapi import FastAPI, HTTPException
app = FastAPI()
items = {"foo": "The Foo Wrestlers"}
@app.get("/items/{item_id}")
async def read_item(item_id: str):
if item_id not in items:
raise HTTPException(status_code=404, detail="Item not found")
return {"item": items[item_id]}
|
由于HTTPException是一个异常类,所以不能使用return,只能使用raise关键字来抛出,但它依旧会由fastapi传给客户端.
ch2: 使用fastapi处理网络安全
实战代码
先用实战代码建立一点初步的印象:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
| from collections.abc import Generator
from typing import Annotated
import jwt
from fastapi import Depends, HTTPException, status
from fastapi.security import OAuth2PasswordBearer
from jwt.exceptions import InvalidTokenError
from pydantic import ValidationError
from sqlmodel import Session
from app.core import security
from app.core.config import settings
from app.core.db import engine
from app.models import TokenPayload, User
reusable_oauth2 = OAuth2PasswordBearer(
tokenUrl=f"{settings.API_V1_STR}/login/access-token"
)
# API_V1_STR: str = "/api/v1"
def get_db() -> Generator[Session, None, None]:
with Session(engine) as session:
yield session
# engine = create_engine(str(settings.SQLALCHEMY_DATABASE_URI))
# @computed_field # type: ignore[prop-decorator]
# @property
# def SQLALCHEMY_DATABASE_URI(self) -> PostgresDsn:
# return PostgresDsn.build(
# scheme="postgresql+psycopg",
# username=self.POSTGRES_USER,
# password=self.POSTGRES_PASSWORD,
# host=self.POSTGRES_SERVER,
# port=self.POSTGRES_PORT,
# path=self.POSTGRES_DB,
# )
SessionDep = Annotated[Session, Depends(get_db)]
TokenDep = Annotated[str, Depends(reusable_oauth2)]
def get_current_user(session: SessionDep, token: TokenDep) -> User:
try:
payload = jwt.decode(
token, settings.SECRET_KEY, algorithms=[security.ALGORITHM]
)
# ALGORITHM = "HS256"
# SECRET_KEY: str = secrets.token_urlsafe(32)
token_data = TokenPayload(**payload)
except (InvalidTokenError, ValidationError):
raise HTTPException(
status_code=status.HTTP_403_FORBIDDEN,
detail="Could not validate credentials",
)
user = session.get(User, token_data.sub)
if not user:
raise HTTPException(status_code=404, detail="User not found")
if not user.is_active:
raise HTTPException(status_code=400, detail="Inactive user")
return user
CurrentUser = Annotated[User, Depends(get_current_user)]
def get_current_active_superuser(current_user: CurrentUser) -> User:
if not current_user.is_superuser:
raise HTTPException(
status_code=403, detail="The user doesn't have enough privileges"
)
return current_user
|
看的头疼吗,那就对了,我将逐步解释比较难懂的地方.
fastapi中的依赖
- 依赖: 某个变量初始化所用的可调用对象(函数,生成器,类等),
fastapi通过在Annotated中使用Depends库来导入依赖:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
| from typing import Annotated
from fastapi import Depends, FastAPI
app = FastAPI()
async def common_parameters(q: str | None = None, skip: int = 0, limit: int = 100):
return {"q": q, "skip": skip, "limit": limit}
@app.get("/items/")
async def read_items(commons: Annotated[dict, Depends(common_parameters)]):
return commons
@app.get("/users/")
async def read_users(commons: Annotated[dict, Depends(common_parameters)]):
return commons
|
这样一来,变量commons就被common_parameters函数初始化了,而不需要我们显式在代码中写明初始化函数.
Python中允许为类型注释设置别名,所以我们可以将Annotated[dict, Depends(common_parameters)提出来进行代码复用:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
| from typing import Annotated
from fastapi import Depends, FastAPI
app = FastAPI()
async def common_parameters(q: str | None = None, skip: int = 0, limit: int = 100):
return {"q": q, "skip": skip, "limit": limit}
CommonsDep = Annotated[dict, Depends(common_parameters)]
@app.get("/items/")
async def read_items(commons: CommonsDep):
return commons
@app.get("/users/")
async def read_users(commons: CommonsDep):
return commons
|
除了函数之外,类也可以作为依赖,但很少用到:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| from typing import Annotated
from fastapi import Depends, FastAPI
app = FastAPI()
fake_items_db = [{"item_name": "Foo"}, {"item_name": "Bar"}, {"item_name": "Baz"}]
class CommonQueryParams:
def __init__(self, q: str | None = None, skip: int = 0, limit: int = 100):
self.q = q
self.skip = skip
self.limit = limit
@app.get("/items/")
async def read_items(commons: Annotated[CommonQueryParams, Depends()]):
response = {}
if commons.q:
response.update({"q": commons.q})
items = fake_items_db[commons.skip : commons.skip + commons.limit]
response.update({"items": items})
return response
|
而上面的实战代码中,就是使用了生成器作为依赖:
1
2
3
4
5
6
| def get_db() -> Generator[Session, None, None]:
with Session(engine) as session:
yield session
# engine = create_engine(str(settings.SQLALCHEMY_DATABASE_URI))
SessionDep = Annotated[Session, Depends(get_db)]
|
这里的生成器用法很简单,就是打开数据库连接后,将session实例注入到依赖中,处理完毕后就会自动关闭数据库连接.
网络安全规范: OAuth2
简单说,OAuth 就是一种授权机制。数据的所有者告诉系统,同意授权第三方应用进入系统,获取这些数据。系统从而产生一个短期的进入令牌(token),用来代替密码,供第三方应用使用。
令牌(token)与密码(password)的作用是一样的,都可以进入系统,但是有三点差异。
(1)令牌是短期的,到期会自动失效,用户自己无法修改。密码一般长期有效,用户不修改,就不会发生变化。
(2)令牌可以被数据所有者撤销,会立即失效。以上例而言,屋主可以随时取消快递员的令牌。密码一般不允许被他人撤销。
(3)令牌有权限范围(scope),比如只能进小区的二号门。对于网络服务来说,只读令牌就比读写令牌更安全。密码一般是完整权限。
总结一下就是,当服务器将token(令牌)返回给客户端后,用户之后访问页面时,只需要使用令牌进行验证就行了,不再需要每次都输入用户名和密码了.
OAuth2PasswordBearer库
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
| from typing import Annotated
from fastapi import Depends, FastAPI
from fastapi.security import OAuth2PasswordBearer
app = FastAPI()
oauth2_scheme = OAuth2PasswordBearer(tokenUrl="token")
TokenDep = Annotated[str, Depends(oauth2_scheme)]
@app.get("/items/")
async def read_items(token: TokenDep):
return {"token": token}
|
- 上述的代码只是一个异常简化的流程,我们没有对token进行任何特殊处理,也没有在发放token时对用户进行核验(比如要求用户输入用户名和密码)
我们从fastapi调用了OAuth2PasswordBearer库,并用参数tokenUrl="token"初始化oauth2_scheme,但这个参数是可有可无的,只不过是帮助Swagger UI来生成文档而已,不写也没有任何影响.
fastapi高度集成了对Swagger UI的支持,Swagger UI本身是一个可视化的路由界面,帮助开发者更好地看懂路由操作.
而OAuth2PasswordBearer类主要的功能就是在接受用户请求时,提取出该用户使用的token,并校验请求的格式是否正常,如果用户的请求头中没有Authorization字段或者其值不包含Bearer的格式说明,就会抛出HTTP 401 Unauthorized异常.
更长的示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| from typing import Annotated
from fastapi import Depends, FastAPI
from fastapi.security import OAuth2PasswordBearer
from pydantic import BaseModel
app = FastAPI()
oauth2_scheme = OAuth2PasswordBearer(tokenUrl="token")
class User(BaseModel):
username: str
email: str | None = None
full_name: str | None = None
disabled: bool | None = None
def fake_decode_token(token):
return User(
username=token + "fakedecoded", email="john@example.com", full_name="John Doe"
)
async def get_current_user(token: Annotated[str, Depends(oauth2_scheme)]):
user = fake_decode_token(token)
return user
@app.get("/users/me")
async def read_users_me(current_user: Annotated[User, Depends(get_current_user)]):
return current_user
|
可以看到,我们在获取当前用户时使用了get_current_user依赖,这个依赖使用了从请求头中提取的token,并假装用这个token对用户的数据进行了解密,并得到了解密后的用户数据.
Python加密库
本来应该单独提到第二级标题来讲的,但放到这里更能贴合实战的情景,而这些库本来也就是用来处理网络通信的.
前置概念: JWT与token防伪
现代的前后端通信通常都通过jwt(JSON Web Tokens)来实现,它与传统的token认证方式有很大的区别:
- 传统 token 方式:用户登录成功后,服务端生成一个随机 token 给用户,并且在服务端(数据库或缓存)中保存一份 token,以后用户再来访问时需携带 token,服务端接收到 token 之后,去数据库或缓存中进行校验 token 的是否超时、是否合法
- jwt 方式:用户登录成功后,服务端通过 jwt 生成一个随机 token 给用户(服务端无需保留 token),以后用户再来访问时需携带token,服务端接收到 token 之后,通过 jwt 对 token 进行校验是否超时、是否合法
- 一切加密和解密的流程都由后端自动执行,不必过多操心.
进入jwt官网后,我们可以看到如下界面:
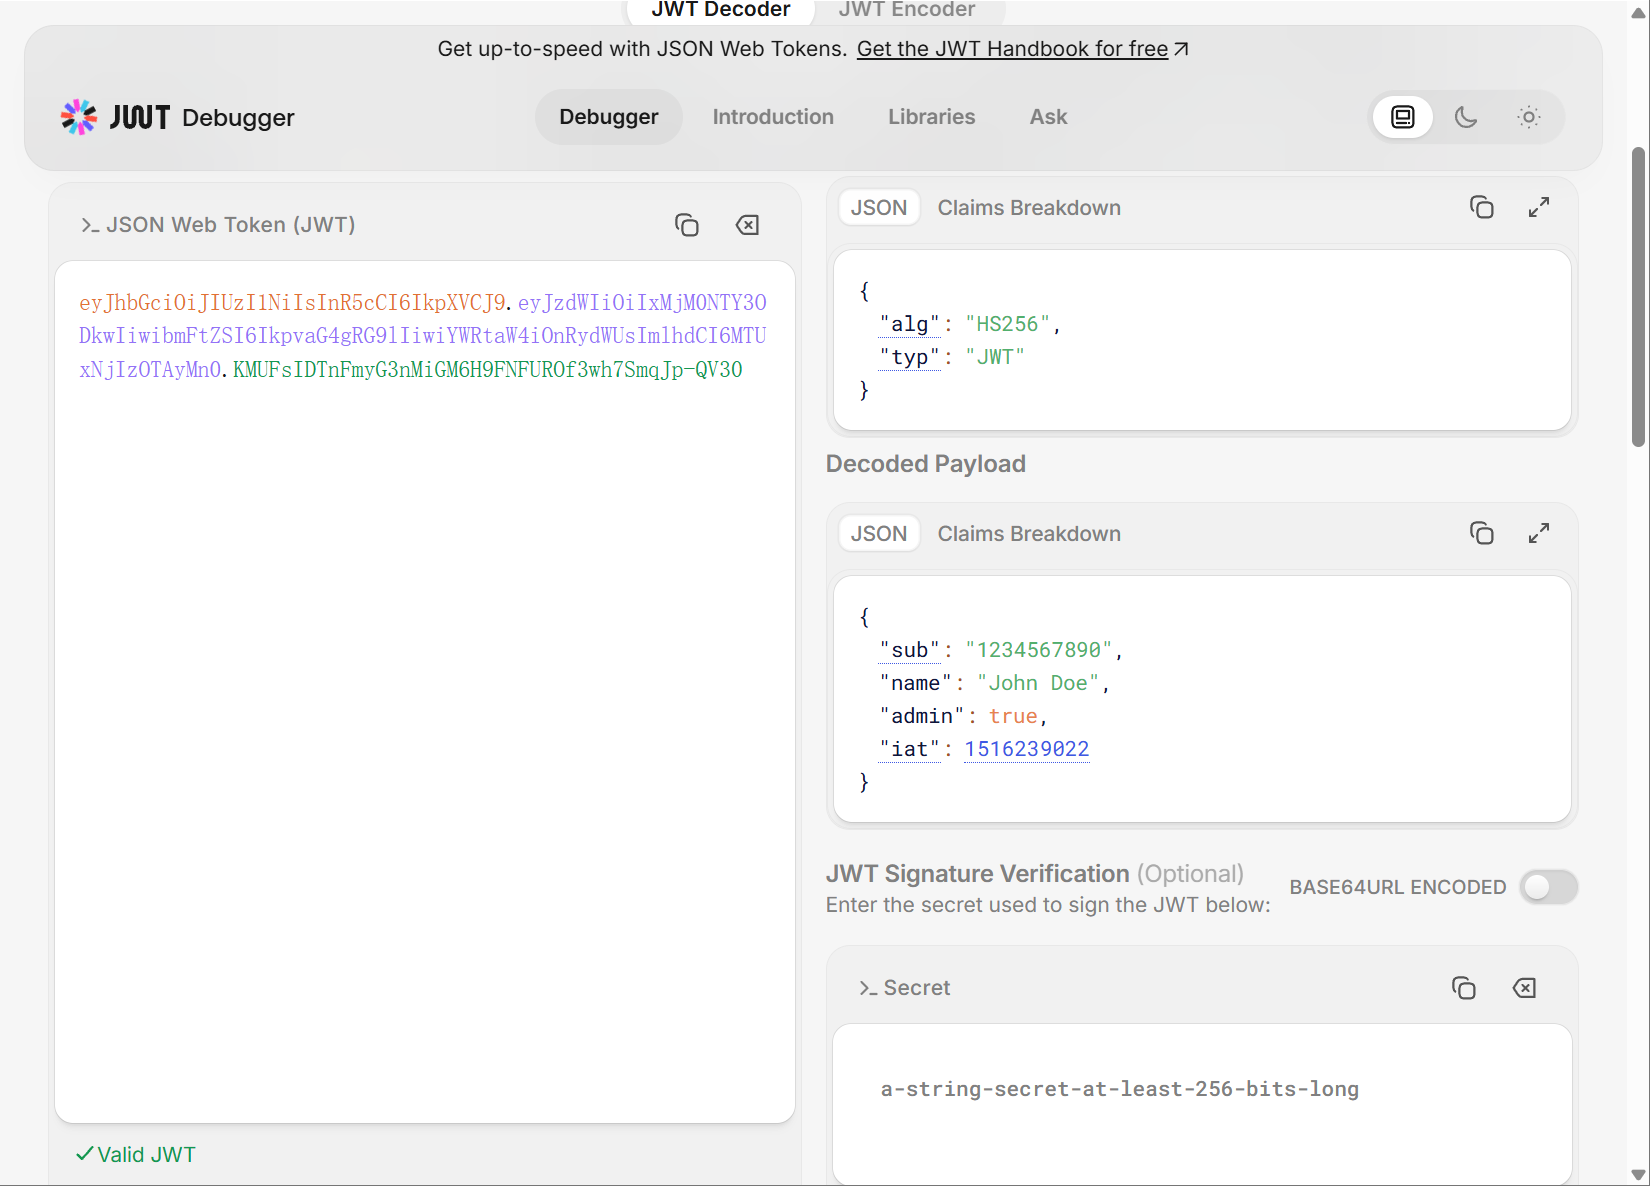
一个JWT由三部分明文加密构成:
- Header(头部): 声明使用的加密算法和token的种类,这里使用的算法是HS256,也是最通用的加密算法,它会将数据加密成一个极难被反向破解的字符串.
- JWT使用Base64Ur算法l编码Header部分
- Playload(负载): 要传输的数据.
- JWT使用Base64Url算法编码Playload部分
- Signature(签名): 它由如下部分组成:
1
2
3
4
| HMACSHA256(
base64UrlEncode(header) + "." +
base64UrlEncode(payload),
secret)
|
加密后JWT会再使用Base64Url对其进行编码,变成常见的43个Base64Url字符.
算法的简单解释
- secret: 签名的最后一部分也被称为盐(salt),可以任意填写,用于增大攻击者的破解难度,详情可见wiki
- Base64编码: 将数据转换成二进制编码后,使用64种字符对应6个二进制位进行重新映射,例如
000000对应A,111111对应/.- 主要目的是为了解决JSON中大量的
{},:等字符与HTTP协议本身的控制字符冲突的问题,不起到任何加密作用.
- Base64Url: 由于浏览器的URL编码器会把
/和+解析成形如%xx的格式,所以为了适配加密文本的传输,该算法将加密文本中的+变成-,/变成_,解密的时候同时做出对应的处理. - SHA256算法: 将输入数据转换成对应的256位二进制数,对应32个字节,理论上无法被破解
到这里我们会发现,JWT并不是一个加密方法,而只是一个明文的通行证而已.也就是说,所有的数据本质上都是明文的,不提供任何加密渠道.
实际上,真正的加密由HTTPS本身保证,它确保JWT不会被攻击者窃取,那么当服务器接收到某个JWT时,它也可以保证这个JWT是真实的,从而验证该JWT后给用户放行.
就算攻击者知道了用户发送的数据(Payload)和使用的加密算法(Header),由于secret(盐)只存储在服务器端,攻击者无法用前两个数据组装出合法的签名,也就不能伪造真实的用户了.
总体来说就是,JWT本身是不保密的,但它通过HTTPS和哈希加盐两个机制实现了用户的防伪认证.
pyjwt
- 官方文档
- 导入方法:
pip install pyjwt
懂得了jwt的原理后,就可以很轻松的使用这个库了,我们一共需要三个参数: 加密/解密的负载,使用的算法,盐
jwt的所有常用功能只用以下代码就可以展示了:
1
2
3
4
| import jwt
encoded_jwt = jwt.encode({"some": "payload"}, "secret", algorithm="HS256")
jwt.decode(encoded_jwt, "secret", algorithms=["HS256"])
{'some': 'payload'}
|
而在前面的实战代码中,我们确实也是这么使用它的:
1
2
3
4
5
| def get_current_user(session: SessionDep, token: TokenDep) -> User:
try:
payload = jwt.decode(
token, settings.SECRET_KEY, algorithms=[security.ALGORITHM]
)
|
既然有解密,那自然有加密,在另外一处文件的代码中,我们是这么进行加密的:
1
2
3
4
5
| def create_access_token(subject: str | Any, expires_delta: timedelta) -> str:
expire = datetime.now(timezone.utc) + expires_delta
to_encode = {"exp": expire, "sub": str(subject)}
encoded_jwt = jwt.encode(to_encode, settings.SECRET_KEY, algorithm=ALGORITHM)
return encoded_jwt
|
jwt库本身支持不少的加密算法,但我们只使用最常用的sha256就可以了:
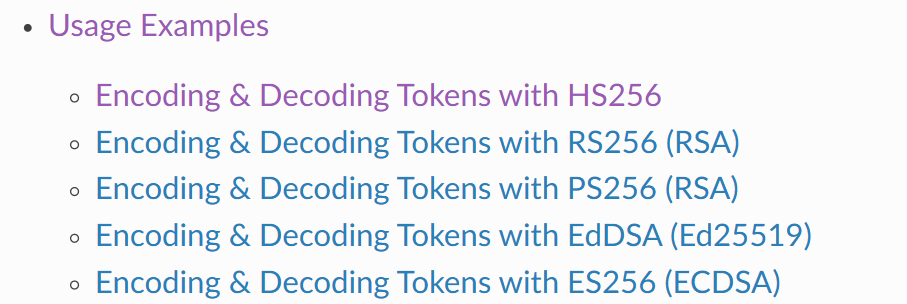
前置概念: 如何加密密码
如参考文章中所提到的那样,普通的哈希函数由于存在哈希碰撞和彩虹表破解的风险,所以完全不推荐用来加密密码,而是应该使用Argon2,Brypt等现代的专用加密算法.
至于具体原理可以去搜寻论文解决,我们只要知道目前它们是绝对安全的,可以用来加密密码就可以了.
- 以前的哈希函数都需要我们额外存储盐,而现代加密函数的盐都是内置的.
pwdlib
- 官网
- 导入方法:
pwdlib[argon2,bcrypt],只使用其中的一个版本也可以.
该库是作为传统加密库passlib的后继者出现的,它的主要作用如下:
- Provide an easy-to-use wrapper to hash and verify passwords
- Support modern and secure algorithms like Argon2 or Bcrypt
这恰恰是我们所需要的加密库功能,它的基本使用方法如下:
1
2
| from pwdlib import PasswordHash
password_hash = PasswordHash.recommended()
|
目前该库的底层默认算法是Argon2算法,上述代码相当于激活了一个使用Argon2算法的加密类.
之后我们就可以用这个加密类来加密密码:
1
| hash = password_hash.hash("herminetincture")
|
自然,当验证用户时,我们还可以使用这个类来验证密码:
1
| valid = password_hash.verify("herminetincture", hash)
|
该库的一个进阶用法是用来处理使用过时加密算法的老数据库,首先,我们先显式创建一个加密类:
1
2
3
4
5
6
7
8
| from pwdlib import PasswordHash, exceptions
from pwdlib.hashers.argon2 import Argon2Hasher
from pwdlib.hashers.bcrypt import BcryptHasher
password_hash = PasswordHash((
Argon2Hasher(),
BcryptHasher(),
))
|
第一个参数是推荐的新算法,第二个参数是要兼容的过时算法,之后我们可以跟之前一样调用这个类来进行加密和验证,如果要创建新的密码,它会自动使用新算法,如果是要验证老的密码,它可以通过以下方式自动替换老密码:
1
| valid, updated_hash = password_hash.verify_and_update("herminetincture", hash)
|
回到实战代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
| from collections.abc import Generator
from typing import Annotated
import jwt
from fastapi import Depends, HTTPException, status
from fastapi.security import OAuth2PasswordBearer
from jwt.exceptions import InvalidTokenError
from pydantic import ValidationError
from sqlmodel import Session
from app.core import security
from app.core.config import settings
from app.core.db import engine
from app.models import TokenPayload, User
reusable_oauth2 = OAuth2PasswordBearer(
tokenUrl=f"{settings.API_V1_STR}/login/access-token"
)
# API_V1_STR: str = "/api/v1"
def get_db() -> Generator[Session, None, None]:
with Session(engine) as session:
yield session
# engine = create_engine(str(settings.SQLALCHEMY_DATABASE_URI))
# @computed_field # type: ignore[prop-decorator]
# @property
# def SQLALCHEMY_DATABASE_URI(self) -> PostgresDsn:
# return PostgresDsn.build(
# scheme="postgresql+psycopg",
# username=self.POSTGRES_USER,
# password=self.POSTGRES_PASSWORD,
# host=self.POSTGRES_SERVER,
# port=self.POSTGRES_PORT,
# path=self.POSTGRES_DB,
# )
SessionDep = Annotated[Session, Depends(get_db)]
TokenDep = Annotated[str, Depends(reusable_oauth2)]
def get_current_user(session: SessionDep, token: TokenDep) -> User:
    try:
        payload = jwt.decode(
            token, settings.SECRET_KEY, algorithms=[security.ALGORITHM]
        )
# ALGORITHM = "HS256"
# SECRET_KEY: str = secrets.token_urlsafe(32)
token_data = TokenPayload(**payload)
except (InvalidTokenError, ValidationError):
raise HTTPException(
status_code=status.HTTP_403_FORBIDDEN,
detail="Could not validate credentials",
)
user = session.get(User, token_data.sub)
if not user:
raise HTTPException(status_code=404, detail="User not found")
if not user.is_active:
raise HTTPException(status_code=400, detail="Inactive user")
return user
CurrentUser = Annotated[User, Depends(get_current_user)]
def get_current_active_superuser(current_user: CurrentUser) -> User:
if not current_user.is_superuser:
raise HTTPException(
status_code=403, detail="The user doesn't have enough privileges"
)
return current_user
|
现在上面这段代码就非常好理解了:
- 首先我们使用OAuth2PasswordBearer类创建了一个从用户请求自动提取token的依赖
- 接着在
get_current_user函数中,我们获取用户的token后,使用jwt库对其进行解码. - 如果验证失败则抛出HTTP异常,如果验证成功则从数据库返回用户的基本信息,如果不存在这个用户,或者用户被删除了,那么同样报错.
另外一处有一个用于产生token的实战代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
| from datetime import datetime, timedelta, timezone
from typing import Any
import jwt
from pwdlib import PasswordHash
from pwdlib.hashers.argon2 import Argon2Hasher
from pwdlib.hashers.bcrypt import BcryptHasher
from app.core.config import settings
password_hash = PasswordHash(
(
Argon2Hasher(),
BcryptHasher(),
)
)
ALGORITHM = "HS256"
def create_access_token(subject: str | Any, expires_delta: timedelta) -> str:
    expire = datetime.now(timezone.utc) + expires_delta
    to_encode = {"exp": expire, "sub": str(subject)}
    encoded_jwt = jwt.encode(to_encode, settings.SECRET_KEY, algorithm=ALGORITHM)
    return encoded_jwt
def verify_password(
plain_password: str, hashed_password: str
) -> tuple[bool, str | None]:
return password_hash.verify_and_update(plain_password, hashed_password)
def get_password_hash(password: str) -> str:
return password_hash.hash(password)
|
create_access_token函数首先设定token的过期期限后将其与负载进行合并封装,这个负载则是用户的id,用于唯一标识用户,之后我们使用jwt库来加密这个合并后的负载,产生token提供给用户.verify_password函数用于验证和升级用户的哈希密码get_password_hash函数用于加密新的密码.
ch3: 使用fastapi处理数据库
FastAPI 并不要求你使用 SQL(关系型)数据库。你可以使用你想用的任何数据库。
由于SQLModel的作者与fastapi的作者是同一个人,所以这两个库是高度适配的,我接下来也会按照fastapi的官方教程来展示使用fastapi处理SQLModel.
搭建初始环境
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
| from fastapi import FastAPI
from sqlmodel import Field, Session, SQLModel, create_engine, select
class Hero(SQLModel, table=True):
id: int | None = Field(default=None, primary_key=True)
name: str = Field(index=True)
secret_name: str
age: int | None = Field(default=None, index=True)
sqlite_file_name = "database.db"
sqlite_url = f"sqlite:///{sqlite_file_name}"
connect_args = {"check_same_thread": False}
engine = create_engine(sqlite_url, echo=True, connect_args=connect_args)
def create_db_and_tables():
SQLModel.metadata.create_all(engine)
app = FastAPI()
@app.on_event("startup")
def on_startup():
create_db_and_tables()
@app.post("/heroes/")
def create_hero(hero: Hero):
with Session(engine) as session:
session.add(hero)
session.commit()
session.refresh(hero)
return hero
@app.get("/heroes/")
def read_heroes():
with Session(engine) as session:
heroes = session.exec(select(Hero)).all()
return heroes
|
需要分析的点如下:
connect_args = {"check_same_thread": False}: 由于sqlite是默认使用单线程的数据库,异步调用时有可能出现多个线程共用一个链接的情况,这时候sqlite就会报错,所以我们需要通过设置跳过sqlite对多线程的检查.@app.on_event("startup"): 该语法糖修饰的函数会在后端服务启动时执行,帮助我们插入Hero表.尽管这样确实很方便,但在生产环境中我们有更加安全的做法,留待最后说明create_hero函数会从消息体提取出用户传来的新英雄,然后插入到数据库中并返回.
针对客户请求做出响应
例如.我们可以使用路由中的查询参数:
1
2
3
4
5
6
7
8
9
10
| from fastapi import FastAPI, HTTPException, Query
from sqlmodel import Field, Session, SQLModel, create_engine, select
# Code here omitted 👈
@app.get("/heroes/", response_model=list[HeroPublic])
def read_heroes(offset: int = 0, limit: int = Query(default=100, le=100)):
with Session(engine) as session:
heroes = session.exec(select(Hero).offset(offset).limit(limit)).all()
return heroes
|
至于其他的用法基本都差不多,所以直接给出教程中的完整代码:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
| from fastapi import Depends, FastAPI, HTTPException, Query
from sqlmodel import Field, Relationship, Session, SQLModel, create_engine, select
class TeamBase(SQLModel):
name: str = Field(index=True)
headquarters: str
class Team(TeamBase, table=True):
id: int | None = Field(default=None, primary_key=True)
heroes: list["Hero"] = Relationship(back_populates="team")
class TeamCreate(TeamBase):
pass
class TeamPublic(TeamBase):
id: int
class TeamUpdate(SQLModel):
id: int | None = None
name: str | None = None
headquarters: str | None = None
class HeroBase(SQLModel):
name: str = Field(index=True)
secret_name: str
age: int | None = Field(default=None, index=True)
team_id: int | None = Field(default=None, foreign_key="team.id")
class Hero(HeroBase, table=True):
id: int | None = Field(default=None, primary_key=True)
team: Team | None = Relationship(back_populates="heroes")
class HeroPublic(HeroBase):
id: int
class HeroCreate(HeroBase):
pass
class HeroUpdate(SQLModel):
name: str | None = None
secret_name: str | None = None
age: int | None = None
team_id: int | None = None
class HeroPublicWithTeam(HeroPublic):
team: TeamPublic | None = None
class TeamPublicWithHeroes(TeamPublic):
heroes: list[HeroPublic] = []
sqlite_file_name = "database.db"
sqlite_url = f"sqlite:///{sqlite_file_name}"
connect_args = {"check_same_thread": False}
engine = create_engine(sqlite_url, echo=True, connect_args=connect_args)
def create_db_and_tables():
SQLModel.metadata.create_all(engine)
def get_session():
with Session(engine) as session:
yield session
app = FastAPI()
@app.on_event("startup")
def on_startup():
create_db_and_tables()
@app.post("/heroes/", response_model=HeroPublic)
def create_hero(*, session: Session = Depends(get_session), hero: HeroCreate):
db_hero = Hero.model_validate(hero)
session.add(db_hero)
session.commit()
session.refresh(db_hero)
return db_hero
@app.get("/heroes/", response_model=list[HeroPublic])
def read_heroes(
*,
session: Session = Depends(get_session),
offset: int = 0,
limit: int = Query(default=100, le=100),
):
heroes = session.exec(select(Hero).offset(offset).limit(limit)).all()
return heroes
@app.get("/heroes/{hero_id}", response_model=HeroPublicWithTeam)
def read_hero(*, session: Session = Depends(get_session), hero_id: int):
hero = session.get(Hero, hero_id)
if not hero:
raise HTTPException(status_code=404, detail="Hero not found")
return hero
@app.patch("/heroes/{hero_id}", response_model=HeroPublic)
def update_hero(
*, session: Session = Depends(get_session), hero_id: int, hero: HeroUpdate
):
db_hero = session.get(Hero, hero_id)
if not db_hero:
raise HTTPException(status_code=404, detail="Hero not found")
hero_data = hero.model_dump(exclude_unset=True)
db_hero.sqlmodel_update(hero_data)
session.add(db_hero)
session.commit()
session.refresh(db_hero)
return db_hero
@app.delete("/heroes/{hero_id}")
def delete_hero(*, session: Session = Depends(get_session), hero_id: int):
hero = session.get(Hero, hero_id)
if not hero:
raise HTTPException(status_code=404, detail="Hero not found")
session.delete(hero)
session.commit()
return {"ok": True}
@app.post("/teams/", response_model=TeamPublic)
def create_team(*, session: Session = Depends(get_session), team: TeamCreate):
db_team = Team.model_validate(team)
session.add(db_team)
session.commit()
session.refresh(db_team)
return db_team
@app.get("/teams/", response_model=list[TeamPublic])
def read_teams(
*,
session: Session = Depends(get_session),
offset: int = 0,
limit: int = Query(default=100, le=100),
):
teams = session.exec(select(Team).offset(offset).limit(limit)).all()
return teams
@app.get("/teams/{team_id}", response_model=TeamPublicWithHeroes)
def read_team(*, team_id: int, session: Session = Depends(get_session)):
team = session.get(Team, team_id)
if not team:
raise HTTPException(status_code=404, detail="Team not found")
return team
@app.patch("/teams/{team_id}", response_model=TeamPublic)
def update_team(
*,
session: Session = Depends(get_session),
team_id: int,
team: TeamUpdate,
):
db_team = session.get(Team, team_id)
if not db_team:
raise HTTPException(status_code=404, detail="Team not found")
team_data = team.model_dump(exclude_unset=True)
db_team.sqlmodel_update(team_data)
session.add(db_team)
session.commit()
session.refresh(db_team)
return db_team
@app.delete("/teams/{team_id}")
def delete_team(*, session: Session = Depends(get_session), team_id: int):
team = session.get(Team, team_id)
if not team:
raise HTTPException(status_code=404, detail="Team not found")
session.delete(team)
session.commit()
return {"ok": True}
|
- 如果认真学习过fastapi和sqlmodel的话,看到这段代码应该不会有什么难点了
ch4: 使用fastapi进行测试
没有测试的代码不是好代码
基本用法
需要先导入httpx2库才可以使用.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| from fastapi import FastAPI
from fastapi.testclient import TestClient
app = FastAPI()
@app.get("/")
async def read_main():
return {"msg": "Hello World"}
client = TestClient(app)
def test_read_main():
response = client.get("/")
assert response.status_code == 200
assert response.json() == {"msg": "Hello World"}
|
创建一个客户端后,使用pytest的方式来测试对应的接口即可.
用法其实很简单,创建了一个client就可以跟平常的测试文件一样来写了.
Agent雏形
ch5: 使用fastapi+nextjs搭建简单智能体
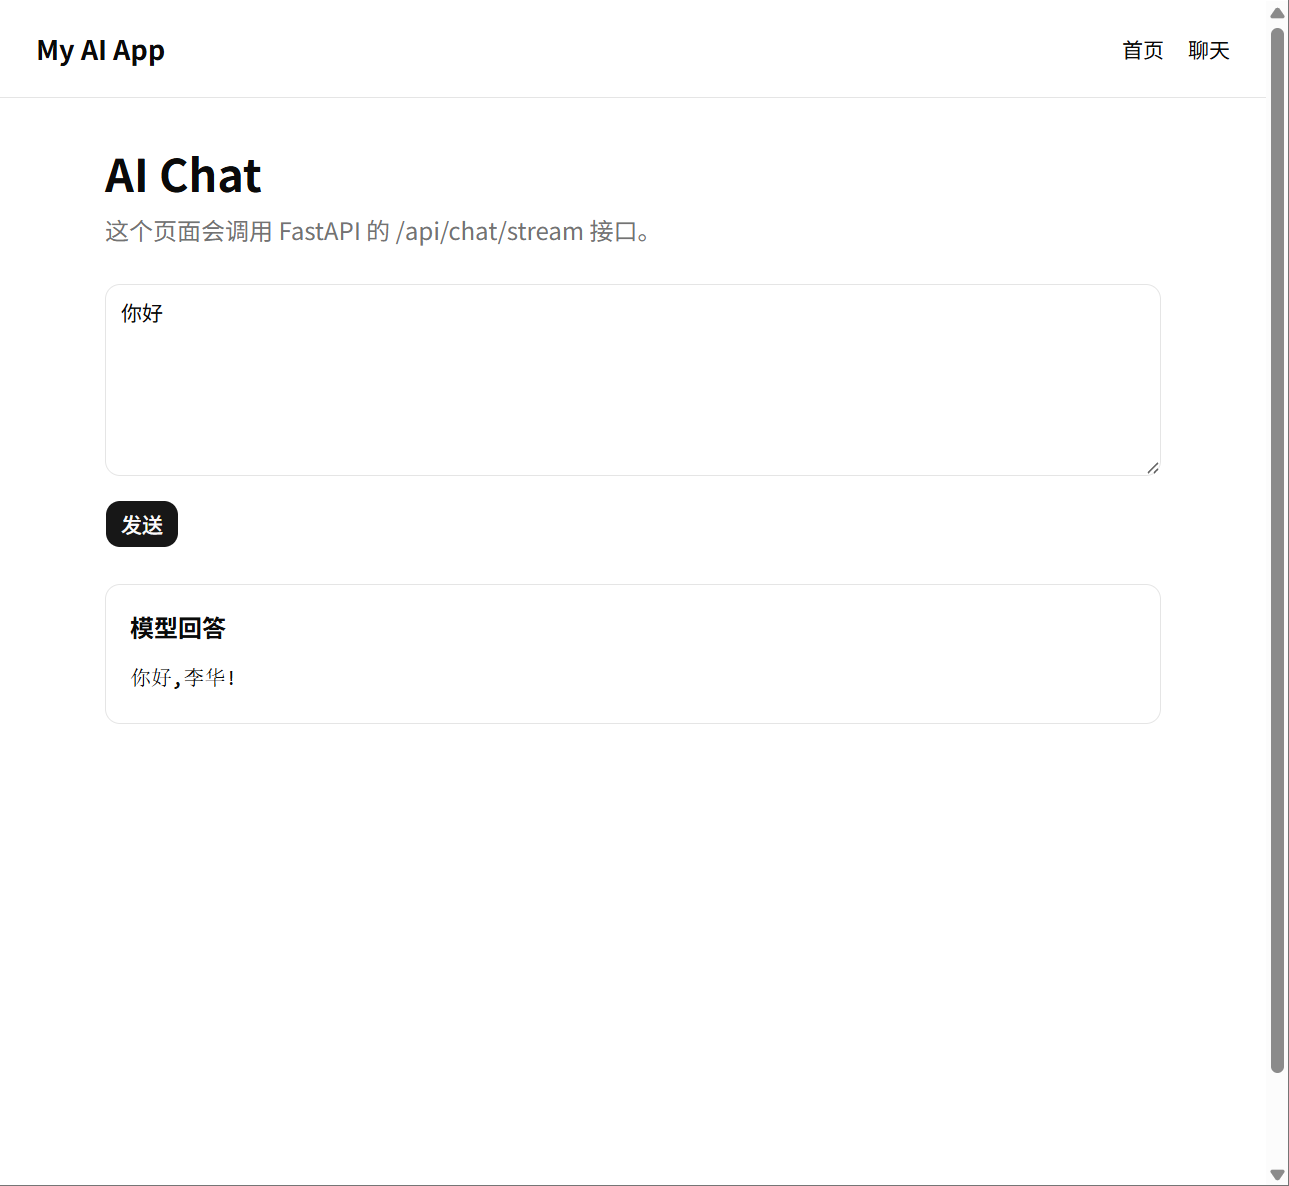
本部分主要会使用fastapi处理deepseek api,这并不需要用到数据库来存储任何信息,所有的信息都在运行时处理.至于前端部分我会大致介绍路由操作,UI等布局细节就由组件库和AI帮我搞定了.
最终效果:
前置概念: openai库使用
现在,大部分AI api都使用OpenAI的API规范,包括所有的国产AI,尽管Claude还不支持…
基本用法
概览代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| # Please install OpenAI SDK first: `pip3 install openai`
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ.get('DEEPSEEK_API_KEY'),
base_url="https://api.deepseek.com")
response = client.chat.completions.create(
model="deepseek-v4-pro",
messages=[
{"role": "system", "content": "You are a helpful assistant"},
{"role": "user", "content": "Hello"},
],
stream=False,
reasoning_effort="high",
extra_body={"thinking": {"type": "enabled"}}
)
print(response.choices[0].message.content)
|
- 首先使用OpenAI类创建一个client实例,填入api key和该api的网址
- 接着,我们调用该api的对话补全功能,你可能像我一样会很好奇为什么不直接写成
client.create,而是多了两个中间层,那是因为AI api的功能确实很多:
1
2
3
4
5
6
7
8
9
10
11
12
| client (根客户端)
├── chat (聊天业务域)
│ └── completions (对话补全子功能) -> create()
├── images (图像业务域)
│ ├── generate() (文本生图)
│ ├── edit() (图片编辑)
│ └── create_variation()
├── audio (音频业务域)
│ ├── transcriptions() (语音转文字)
│ └── translations() (语音翻译)
└── embeddings (向量业务域)
└── create() (文本向量化)
|
而我们的智能体应用只用对话补全功能就够了,其他的功能deepseek也不支持.
- messages里有两个键值对,标明为
system的提示词会具有最高权重,在对话开始的时候就发送给接口,表明为user的则为用户输入的提示词. stream表示流式输出,如果设定为False,则会一口气返回所有内容,用户会感受到明显的阻塞,所以实际的智能体应用都会设定为Truereasoning_effort: 推理能力,支持以下设定值,“none”, “minimal”, “low”, “medium”, “high”, “xhigh”.extra_body={"thinking": {"type": "enabled"}}: 由于openai库还不支持单独使用推理能力,所以deepseek只好在api上加上额外的信息设置thinking字段为enabled,来启动思考模式.- 非流式输出的response样例如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| {
"id": "chatcmpl-9A7bC...",
"object": "chat.completion",
"created": 1713876000,
"model": "deepseek-v4-pro",
"choices": [
{
"index": 0,
"message": {
"role": "assistant",
"content": "你好!我是大语言模型。"
},
"finish_reason": "stop"
}
],
"usage": {
"prompt_tokens": 15,
"completion_tokens": 12,
"total_tokens": 27
}
}
|
使用智能体时,有时候由于两个回答的权重过于相近,AI会让我们来选择自己更喜欢的回答.但api调用的话不可能这样干,但是我们可以在使用api的时候选择自己想要的回答数量n,api会返回权重最高的前n个回答.
尽管如此,deepseek目前还只支持返回一个回答,如果你设定n>=2的话,会返回错误码说明:'message': 'Invalid n value (currently only n = 1 is supported)'
我们可以自己写一段代码,来测试一下效果:
1
2
3
4
5
6
7
8
9
10
11
12
| response = client.chat.completions.create(
model="deepseek-v4-pro",
messages=[
{"role": "system", "content": "You are a helpful assistant"},
{"role": "user", "content": "请你写一篇800字的高考励志作文"},
],
stream=False,
reasoning_effort="high",
extra_body={"thinking": {"type": "enabled"}},
)
print(response.choices[0])
|
返回内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| {
"choices": [
{
"index": 0,
"finish_reason": "stop",
"logprobs": null,
"message": {
"role": "assistant",
"content": "## 花开不败\n\n百日誓师的声浪犹在耳畔,高考倒计时的数字已如秋叶般飘零。时光真是个奇妙的存在,我们拼命追逐时它步履蹒跚,我们贪恋不舍时它却如白驹过隙。\n\n...\n\n高考的意义,不仅在于那一纸红彤彤的录取通知书,更在于让我们相信,努力的价值,坚持的意义,以及梦想终会开花的奇迹。\n\n没有比脚更长的路,没有比人更高的山。今天,我们站在这里,回眸是春花秋月,是书山学海;眺望是夏云冬雪,是诗和远方。",
"refusal": null,
"reasoning_content": "用户需要一篇800字的高考励志作文。这是一个明确的创作任务,需要生成一篇符合高考作文要求的文章。\n\n用户的核心需求是获得一篇能激励人心、结构完整、文笔流畅的作文。深层需求可能包括:希望作文立意深刻、有文采、能体现奋斗和人生价值等主题。高考励志作文通常需要回顾备考历程,展现坚持与成长,并传递积极向上的价值观。\n\n想到了可以从几个方面来构思:开篇可以用一个生动的意象或比喻引入,比如时光的痕迹或成长的瞬间;主体部分可以分层次展开,描写备考的艰辛、坚持的意义、心态的调整,并联系更深远的生命价值;结尾要升华主题,鼓舞士气,展望未来。整体语言需要富有感染力,适当运用排比、比喻等修辞手法,保持积极昂扬的基调。\n\n可以开始创作了。",
"annotations": null,
"audio": null,
"function_call": null,
"tool_calls": null
}
}
]
}
|
多轮对话
大模型是只会考虑当前输入的,要想让模型能够"记忆"之前的输入,一个非常简单的做法是在这次输入中加上上一轮对话的输入输出:
1
2
3
4
5
6
7
8
9
10
11
| # 第 1 轮请求
messages = [
{"role": "user", "content": "你好,我是张三"}
] # 模型返回:{"role": "assistant", "content": "你好,张三!"}
# 第 2 轮请求(必须携带第 1 轮的全部内容)
messages = [
{"role": "user", "content": "你好,我是张三"},
{"role": "assistant", "content": "你好,张三!"},
{"role": "user", "content": "我刚才说我叫什么?"}
]
|
显然,当对话轮数一多,由于token限制,模型就无法完整获取全部的上下文了,这种做法是完全不可接受的.
一个比较异想天开的想法是,调用API或者另一个本地AI来处理以前的对话记录,变成一段较短的记录,当然,这确实比较好实现,但仍然不是长久之计.
实际生产中我们会通过KV cache等构建机制来实现多轮对话,但我们这个项目出于简化的目的,甚至不会用到多轮对话,就不用操心这些问题了.
流式输出
- 流式输出(stream): API不断输出消息块,后端不断接收消息块,在前端展现出文字逐个输出的效果.
在openai库中,流式输出实质上是通过一个可被迭代的生成器实现的,具体原理不太有必要了解,我们看看怎么使用:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
def stream_agent():
messages = [{"role": "user", "content": "9.11 and 9.8, which is greater?"}]
response = client.chat.completions.create(
model="deepseek-v4-pro",
messages=messages,
stream=True,
reasoning_effort="high"
extra_body={"thinking": {"type": "enabled"}},
)
for chunk in response:
# 某些 chunk 可能没有 choices,保险起见先判断。
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
# 只有真的有文本内容时,才 yield 给外部。
if delta.content:
yield delta.content
|
流式输出中,我们通过chunk对象来获取文本块,并使用delta对象来获取新增的内容,并通过生成器供其他函数使用,至于怎么使用,就要用到fastapi的StreamingResponse类了
StreamingResponse类
fastapi默认返回JSON响应,也就是一次返回全部内容,如果想要流式传输纯字符串,或者传输音频或者视频,就需要用到这个类.
官方示例:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
| from collections.abc import AsyncIterable, Iterable
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
app = FastAPI()
message = """
Rick: (stumbles in drunkenly, and turns on the lights) Morty! You gotta come on. You got--... you gotta come with me.
Morty: (rubs his eyes) What, Rick? What's going on?
Rick: I got a surprise for you, Morty.
Morty: It's the middle of the night. What are you talking about?
Rick: (spills alcohol on Morty's bed) Come on, I got a surprise for you. (drags Morty by the ankle) Come on, hurry up. (pulls Morty out of his bed and into the hall)
Morty: Ow! Ow! You're tugging me too hard!
Rick: We gotta go, gotta get outta here, come on. Got a surprise for you Morty.
"""
@app.get("/story/stream", response_class=StreamingResponse)
async def stream_story() -> AsyncIterable[str]:
for line in message.splitlines():
yield line
@app.get("/story/stream-no-async", response_class=StreamingResponse)
def stream_story_no_async() -> Iterable[str]:
for line in message.splitlines():
yield line
@app.get("/story/stream-no-annotation", response_class=StreamingResponse)
async def stream_story_no_annotation():
for line in message.splitlines():
yield line
@app.get("/story/stream-no-async-no-annotation", response_class=StreamingResponse)
def stream_story_no_async_no_annotation():
for line in message.splitlines():
yield line
@app.get("/story/stream-bytes", response_class=StreamingResponse)
async def stream_story_bytes() -> AsyncIterable[bytes]:
for line in message.splitlines():
yield line.encode("utf-8")
@app.get("/story/stream-no-async-bytes", response_class=StreamingResponse)
def stream_story_no_async_bytes() -> Iterable[bytes]:
for line in message.splitlines():
yield line.encode("utf-8")
@app.get("/story/stream-no-annotation-bytes", response_class=StreamingResponse)
async def stream_story_no_annotation_bytes():
for line in message.splitlines():
yield line.encode("utf-8")
@app.get("/story/stream-no-async-no-annotation-bytes", response_class=StreamingResponse)
def stream_story_no_async_no_annotation_bytes():
for line in message.splitlines():
yield line.encode("utf-8")
|
response_class: 设置响应体的种类,默认为JSONResponse,指定其他的响应体种类时,fastapi底层会进行相应的调整.- 设置为
StreamingResponse时会自动在HTTP响应头中加入以下字段:Content-Type: text/plain; charset=utf-8,并逐块向前端发送数据.
- 上述的代码很长,但只是在以不同方式传输同一个长字符串而已,有的使用了类型注释,有的将字符串转换成了二进制流.
无论怎样,底层的原理我们没必要了解,只要知道StreamingResponse类能够轻松实现流式输出.
我们还可以将StreamingResponse显式写入返回值里,可以进行自己的定制化操作:
1
2
3
4
5
6
| @app.post("/api/chat")
async def chat(request: ChatMessage) -> StreamingResponse:
return StreamingResponse(
stream_agent(request.message),
media_type="text/plain; charset=uft-8",
)
|
- 第一个参数为某个生成器函数,第二个参数则为我们自己定制的媒体类型
路由构想
如果不靠ai的话,初学者是很难自己设计出一个好看实用的路由的,建议不断阅读优秀项目的api设计来学习怎么写路由.
我最简化了项目的路由操作,只保留了两个前端路由: auth和chat,一个对应从数据库中获取用户数据并认证,另一个对应了从API调用信息并返回.前端通过调用后端的api来模拟数据库交互,并调用大模型输出流.
后端编写
整个后端加起来就四个文件,去掉了数据库操作,安全验证,严格的类型检查,测试代码,从而凸显出真正重要的核心代码部分:
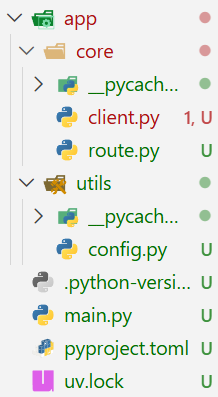
route.py,核心中的核心,总共只写了三个路由:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
| from fastapi import FastAPI
from fastapi.responses import StreamingResponse
from fastapi.middleware.cors import CORSMiddleware
from pydantic import BaseModel
from app.core.client import stream_agent
app = FastAPI()
origins = [
"http://localhost:3000",
"http://127.0.0.1:3000",
]
app.add_middleware(
CORSMiddleware,
allow_origins=origins,
allow_credentials=True,
allow_methods=["*"],
allow_headers=["*"],
)
class ChatMessage(BaseModel):
message: str
@app.get("/api/health")
async def homepage() -> dict:
return {"message": "Hello,World!"}
@app.get("/api/auth")
async def check() -> dict:
return {
"message": "我懒得写验证了,你直接进来吧",
"ok": True,
}
@app.post("/api/chat", response_class=StreamingResponse)
async def chat(request: ChatMessage):
return stream_agent(request.message)
|
/api/health用于检查与后端是否正常连接,模拟的是实际生产中的数据库健康检查/api/auth用于验证用户,模拟的是实际生产中的用户注册和验证/api/chat用于调用deepseek API
client.py,调用deepseek API:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| from app.utils.config import settings
from openai import OpenAI
from typing import Generator
client = OpenAI(
api_key=settings.DEEPSEEK_API_KEY,
base_url=settings.DEEPSEEK_URL,
)
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = """
以后的回答都要称呼我为李华,优先输出"你好,李华!"
"""
def stream_agent(
user_message: str,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
model: str = DEFAULT_MODEL,
) -> Generator[str, None, None]:
# 创建流式请求。
stream = client.chat.completions.create(
model=model,
messages=[
{
"role": "system",
"content": system_prompt,
},
{
"role": "user",
"content": user_message,
},
],
stream=True,
reasoning_effort="high",
)
for chunk in stream:
# 某些 chunk 可能没有 choices,保险起见先判断。
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
# 只有真的有文本内容时,才 yield 给外部。
if delta.content:
yield delta.content
|
config.py,从根目录的环境变量文件中读取api key:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
| from pydantic_settings import BaseSettings, SettingsConfigDict
class Settings(BaseSettings):
model_config = SettingsConfigDict(
env_file="../.env",
env_file_encoding="utf-8",
extra="ignore",
)
DEEPSEEK_API_KEY: str = ""
DEEPSEEK_URL: str = "https://api.deepseek.com"
settings = Settings()
|
main.py,用uvicorn启动fastapi后端:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| import uvicorn
from app.core.route import app
def main():
uvicorn.run(
"main:app",
host="0.0.0.0",
port=8000,
workers=1,
)
if __name__ == "__main__":
main()
|
之后只需运行uv run main.py即可.
前端编写
- 初始化nextjs框架:
1
| pnpm create next-app@latest frontend --use-pnpm
|
- 进入前端文件夹后单独导入自己喜欢的shadcn样式:
1
| pnpm dlx shadcn@latest init --preset b0
|
- 加入一些常用的组件:
1
| pnpm dlx shadcn@latest add button card input textarea
|
之后按照这个示意图添加两个路由文件和两个工具文件api.ts即可,其他的文件都是上述初始化过程自带的:
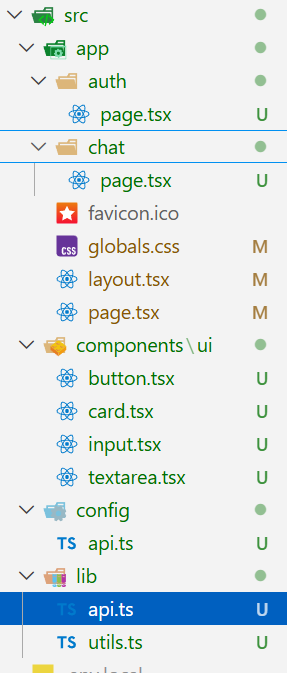
config/api.ts: 核心路由:
1
2
3
4
5
6
7
| export const API_BASE_URL = "http://127.0.0.1:8000";
export const API_ROUTES = {
// health: `${API_BASE_URL}/api/health`, 实际上没用到
authCheck: `${API_BASE_URL}/api/auth`,
chatStream: `${API_BASE_URL}/api/chat`,
};
|
- 可以看到,如果不使用自动化工具的话,我们实质上需要一条条在这里列出后端的路由.
lib/api.ts: 工具请求函数:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
| import { API_ROUTES } from "@/config/api";
// 这个函数用来请求后端的假登录检查
export async function checkAuth() {
const response = await fetch(API_ROUTES.authCheck);
if (!response.ok) {
throw new Error("认证检查失败");
}
return response.json();
}
export async function streamChatMessage(
message: string,
onChunk: (chunk: string) => void,
) {
// 发送 POST 请求给 FastAPI
const response = await fetch(API_ROUTES.chatStream, {
method: "POST",
// 告诉后端:我发送的是 JSON
headers: {
"Content-Type": "application/json",
},
// 把 JS 对象转成 JSON 字符串
// 后端的 ChatMessage 会接收这里的 message
body: JSON.stringify({
message,
}),
});
// 如果后端返回错误,就抛出异常
if (!response.ok) {
const errorText = await response.text();
throw new Error(errorText || "聊天接口请求失败");
}
// response.body 是浏览器提供的流式响应体
// 如果没有 body,说明当前环境不支持流式读取
if (!response.body) {
throw new Error("当前浏览器不支持流式响应");
}
// 创建 reader,用来一段一段读取后端返回的数据
const reader = response.body.getReader();
// TextDecoder 用来把二进制数据转成字符串
const decoder = new TextDecoder("utf-8");
// 不断读取流
while (true) {
// reader.read() 每次读取一小块数据
const { done, value } = await reader.read();
// done 为 true,说明后端流式输出结束
if (done) {
break;
}
// value 是 Uint8Array,需要解码成字符串
const chunk = decoder.decode(value, {
stream: true,
});
// 把这一小段文本交给页面使用
onChunk(chunk);
}
}
|
auth/page.tsx:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| "use client";
import { useState } from "react";
import { useRouter } from "next/navigation";
import { Button } from "@/components/ui/button";
import { checkAuth } from "@/lib/api";
export default function AuthPage() {
// 用来跳转页面
const router = useRouter();
// 保存后端返回的信息
const [message, setMessage] = useState("请点击按钮检查登录状态");
async function handleCheckAuth() {
// 点击按钮后,进入加载状态
try {
// 请求 FastAPI 的 /api/auth/check
const data = await checkAuth();
if (data.ok) {
sessionStorage.setItem("authPassed", "true");
// 显示后端返回的信息
setMessage(data.message ?? "验证成功,正在跳转到首页...");
// 验证成功后跳回根路由
setTimeout(() => {
router.replace("/");
}, 1000);
} else {
// 如果后端返回 ok: false,就停留在 auth 页面
setMessage("验证失败,请稍后再试");
}
} catch (error) {
// 如果后端没有启动、接口写错、跨域失败,都会进入这里
setMessage("请求认证接口失败");
}
}
return (
<main className="mx-auto flex min-h-screen max-w-2xl flex-col items-center justify-center gap-6 p-8">
<h1 className="text-3xl font-bold">Auth Page</h1>
<p className="rounded-lg border p-4">{message}</p>
<Button onClick={handleCheckAuth}>{"检查登录状态"}</Button>
</main>
);
}
|
chat/page.tsx: 聊天界面
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
| "use client";
import { useState } from "react";
import { Button } from "@/components/ui/button";
import { Textarea } from "@/components/ui/textarea";
import { streamChatMessage } from "@/lib/api";
export default function ChatPage() {
// 保存用户输入的问题
const [message, setMessage] = useState("");
// 保存模型返回的答案
const [answer, setAnswer] = useState("");
// 保存加载状态
const [loading, setLoading] = useState(false);
// 保存错误信息
const [error, setError] = useState("");
// 表单提交时执行这个函数
async function handleSubmit(event: any) {
// 阻止浏览器默认刷新页面
event.preventDefault();
// 去掉前后空格后,如果没有内容,就不发送请求
if (!message.trim()) {
return;
}
// 每次提问前,先清空旧答案和旧错误
setAnswer("");
setError("");
// 进入加载状态
setLoading(true);
try {
// 调用封装好的流式请求函数
await streamChatMessage(message, (chunk) => {
// 每收到一小段内容,就追加到 answer 后面
setAnswer((prev) => prev + chunk);
});
} catch (err) {
// 如果请求失败,就把错误显示到页面上
if (err instanceof Error) {
setError(err.message);
} else {
setError("发生未知错误");
}
} finally {
// 无论成功还是失败,最后都退出加载状态
setLoading(false);
}
}
return (
<main className="mx-auto flex min-h-screen max-w-3xl flex-col gap-6 p-8">
<section className="space-y-2">
<h1 className="text-3xl font-bold">AI Chat</h1>
<p className="text-muted-foreground">
这个页面会调用 FastAPI 的 /api/chat/stream 接口。
</p>
</section>
<form onSubmit={handleSubmit} className="space-y-4">
<Textarea
value={message}
onChange={(event) => setMessage(event.target.value)}
placeholder="请输入你想问 AI 的问题"
className="min-h-32"
/>
<Button type="submit" disabled={loading}>
{loading ? "生成中..." : "发送"}
</Button>
</form>
{error && (
<div className="rounded-lg border border-red-300 p-4 text-red-600">
{error}
</div>
)}
<section className="rounded-lg border p-4">
<h2 className="mb-2 font-semibold">模型回答</h2>
{answer ? (
<pre className="whitespace-pre-wrap text-sm leading-7">{answer}</pre>
) : (
<p className="text-sm text-muted-foreground">还没有回答。</p>
)}
</section>
</main>
);
}
|
之后运行npm run dev即可看到大致效果.
缓存问题
如果你成功的按照上述教程编写了所有的前端和后端,与AI对话时你会发现并没有实现流式输出,相反,所有消息都是一次性吐出来的:
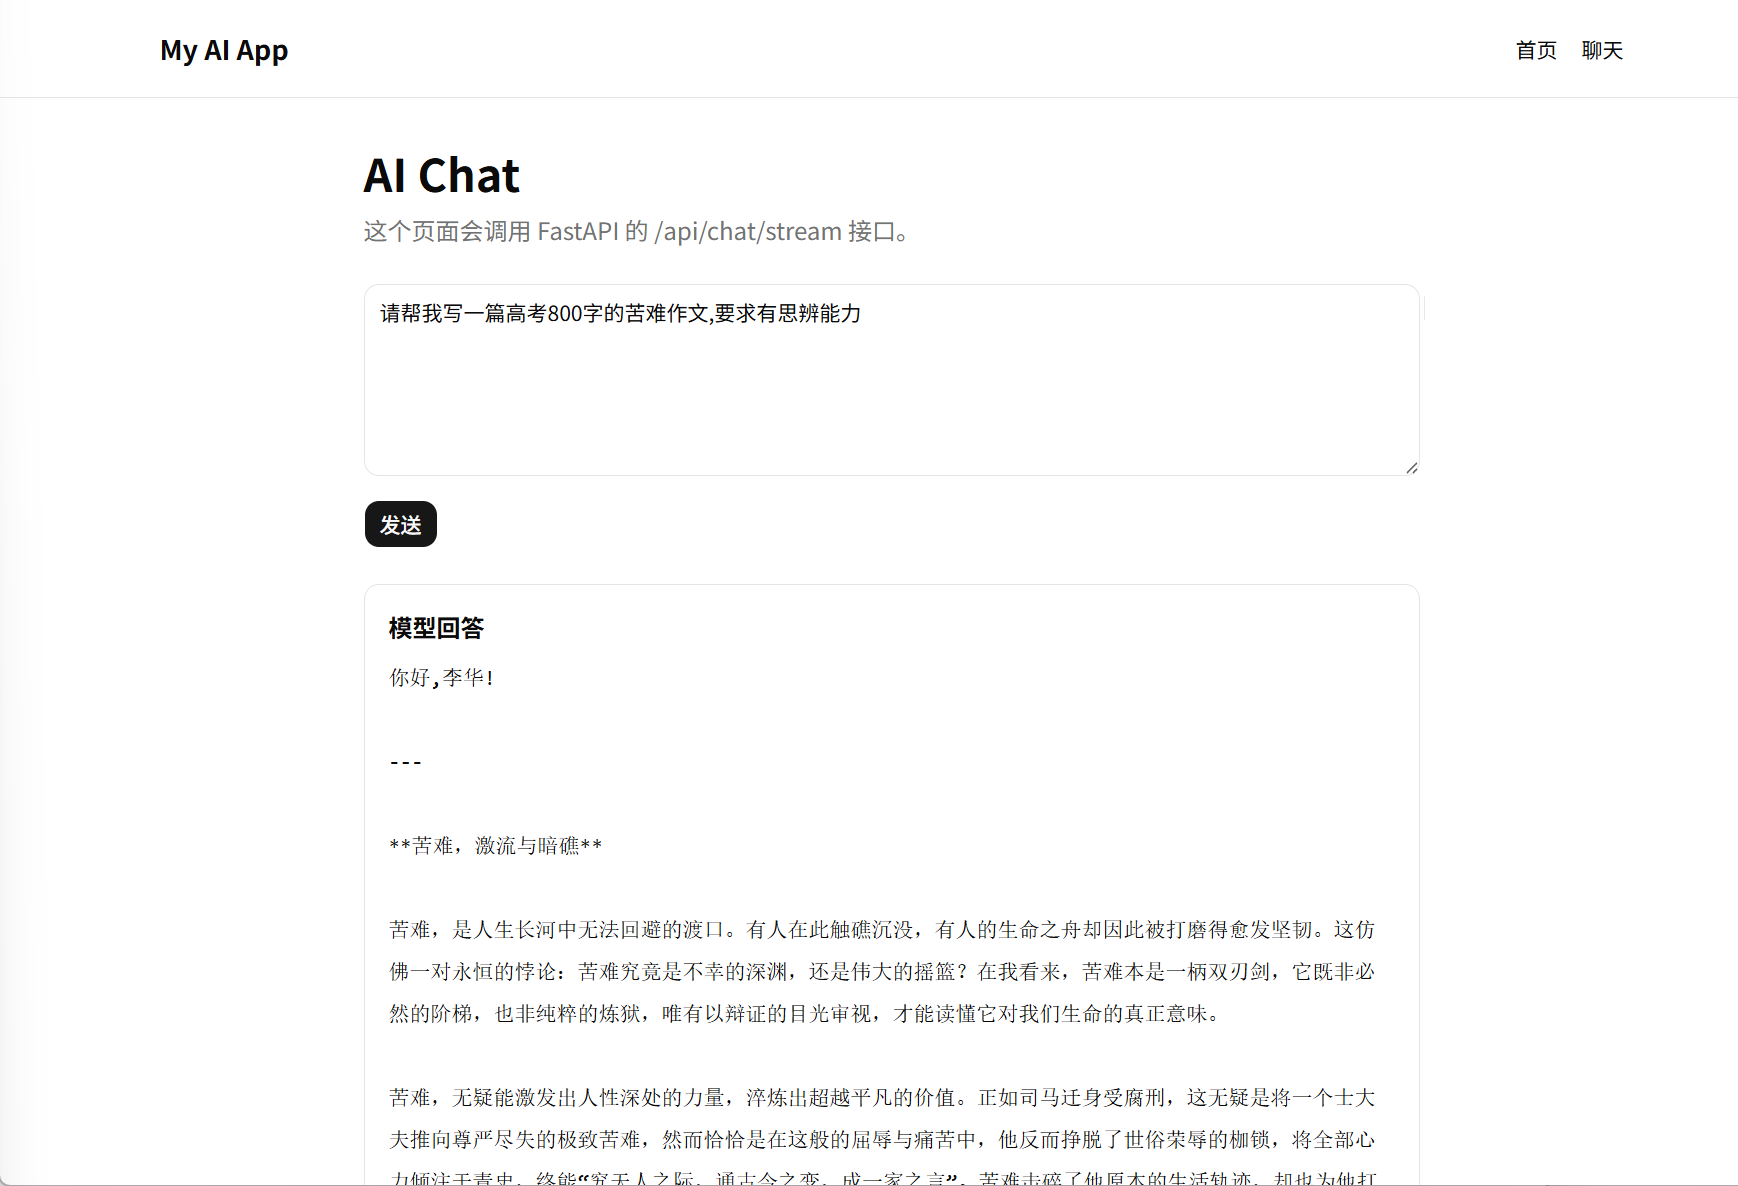
我们可以按f12打开控制台看一下api的响应:
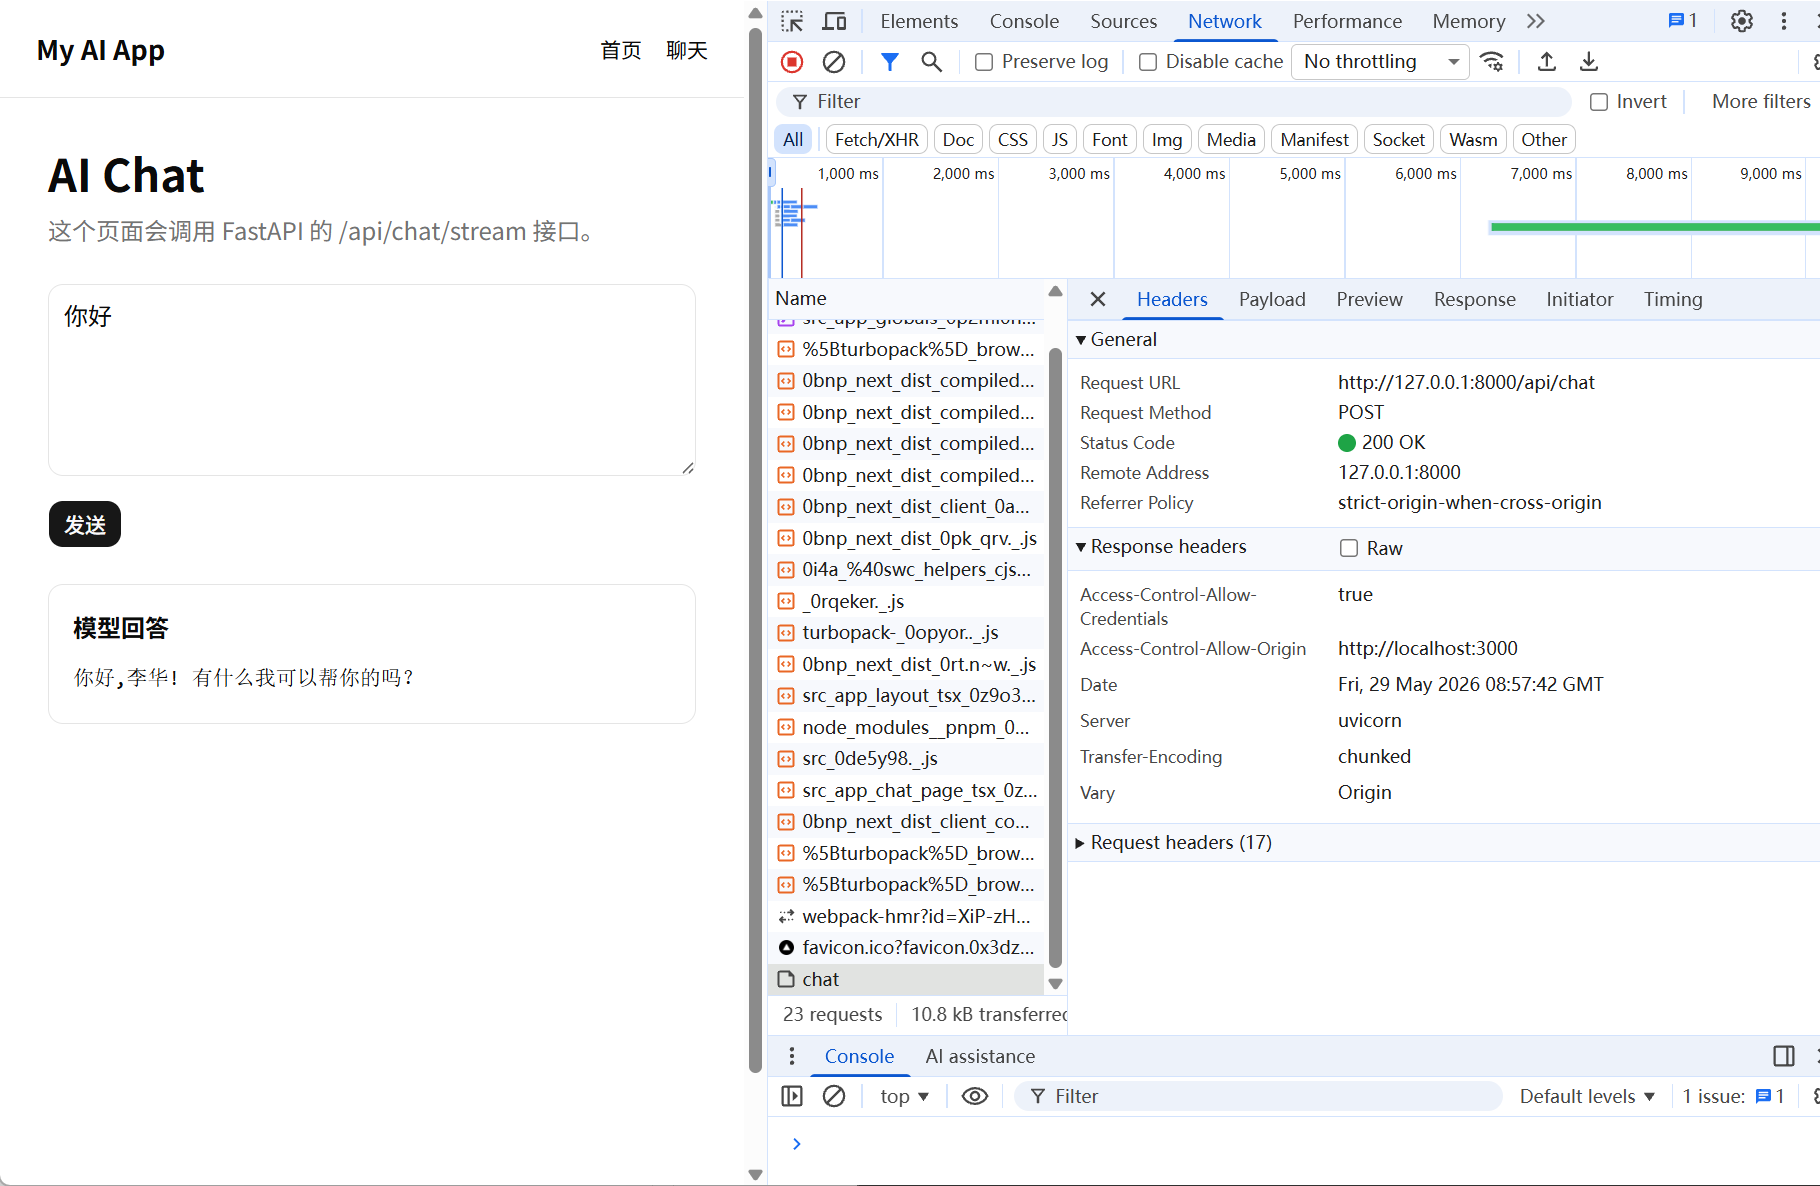
我们需要知道一个事实:
浏览器会默认帮我们缓存服务器传来的响应体,如果我们希望浏览器不要缓存,就需要在响应头里的Cache-Control字段对浏览器明确说明.
幸好,fastapi支持直接定制我们想要的响应头
所以,我们需要修改之前的route.py中的最后一个路由,变成这个样子:
1
2
3
4
5
6
7
8
9
10
| @app.post("/api/chat", response_class=StreamingResponse)
async def chat(request: ChatMessage):
# return stream_agent(request.message)
return StreamingResponse(
stream_agent(request.message),
headers={
"Cache-Control": "no-cache",
},
)
|
response_class字段实际上现在是冗余的,但写上也没有问题
最后这个简单的智能体就大功告成了.
ch6: 给智能体加入数据库
准备阶段
现在,让我们试着给上面这个智能体加入postgresql,我们需要先明确来两个要点.
- 哪些路由要用到数据库?
- 数据库中要用到几个表?表的关系如何设定?
要点1: 在哪加入数据库
先看一下我们一开始写的三个路由:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| @app.get("/api/health")
async def homepage() -> dict:
return {"message": "Hello,World!"}
@app.get("/api/auth")
async def check() -> dict:
return {
"message": "我懒得写验证了,你直接进来吧",
"ok": True,
}
@app.post("/api/chat", response_class=StreamingResponse)
async def chat(request: ChatMessage):
return StreamingResponse(
stream_agent(request.message),
headers={
"Cache-Control": "no-cache",
},
)
|
显然,health路由可以用来检查数据库是否成功启动,auth路由可以查看数据库来验证用户,chat路由在返回消息的时候还需要把聊天记录存入数据库.
第一个比较好办,启动一个空查询,如果返回true的话就说明数据库启动了;
第二个需要修改一下,改成用户登录,这需要我们创建一个用户表
第三个比较难办,怎么存储聊天记录? 非流式输出的话我们只需要一次性把消息存入数据库即可,但我们使用的是流式输出,一个简单的想法是把对话累加起来再存入,实现起来确实也很简单.
- 暂时先不加入多轮对话,我们只需保存用户的最新对话及结果,再展示在前端页面即可,不然项目就会一下子变得太复杂了
要点2: 设计表格
设计数据库如果真的去一个个使用BCNF和3NF来检查表的话那就太离谱了,我们先按照上述的路由想法给出两个初始的表格,后续慢慢优化即可.
对于用户来说,我们需要以下的必要信息: 用户id(主键),用户名,密码(先明文存储,做一个伪加密):
1
2
3
4
5
6
| create table User(
user_id numeric,
user_name varchar,
password numeric,
primary key id
);
|
显然,上述的设计非常糟糕,但我们先放着,等另一个表设计完了再来动它.
对于对话来说,我们实质上只要对话id和最新的对话信息就够了:
1
2
3
4
5
| create table ChatMessage(
chat_id numeric,
content varchar,
primary key chat_id,
);
|
现在回头来看User表,我们需要把User和ChatMessage一一关联起来,在只保存最新信息的情况下,这是一个一对一关系,那么我们可以在User表中存储ChatMessage的chat_id作为外键:
1
2
3
4
5
6
7
| create table User(
user_id numeric,
user_name varchar,
password numeric,
primary key user_id,
foreign key chat_id from ChatMessage
);
|
接着,对于加密功能,我们需要实际想象一下整个流程:
- 用户注册时输入用户名和密码
- 后端对密码进行哈希处理
- 数据库存入哈希后的密码和对应的智能体
- 当用户登录时,我们将用户输入的密码哈希后,与数据库中存储的对应哈希密码比对即可.
那么这实际上需要三张表,一个用于用户注册,一个用于用户登录,一个用于实际的数据库存储,考虑到OOP的设计,我们可以设计第四张表作为父表,方便后续的复用:
1
2
3
4
5
6
7
8
9
10
11
12
13
| class UserBase(BaseModel):
user_name: str
class UserRegister(UserBase):
password: str
class UserLogin(UserBase):
password: str
class User(UserBase):
user_id: int|None =None
hashed_password: int
chat_id: int
|
数据库的一些必要知识
postgresql的url长这样:
1
| DATABASE_URL = postgresql+psycopg://用户名:密码@主机地址:端口号/数据库名
|
一个完整的示例是这样的:
1
| DATABASE_URL = postgresql+psycopg://postgres:123456@localhost:5432/my_chat_db
|
非常值得称道的是,pydantic内置了对PostgreSQL的支持,书写这种长长的url也变得很简单了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
| from pydantic import (
PostgresDsn,
computed_field,
)
class Settings(BaseSettings):
model_config = SettingsConfigDict(
# Use top level .env file (one level above ./backend/)
env_file="../.env",
env_ignore_empty=True,
extra="ignore",
)
POSTGRES_SERVER: str
POSTGRES_PORT: int = 5432
POSTGRES_USER: str
POSTGRES_PASSWORD: str = ""
POSTGRES_DB: str = ""
@computed_field # type: ignore[prop-decorator]
@property
def SQLALCHEMY_DATABASE_URI(self) -> PostgresDsn:
return PostgresDsn.build(
scheme="postgresql+psycopg",
username=self.POSTGRES_USER,
password=self.POSTGRES_PASSWORD,
host=self.POSTGRES_SERVER,
port=self.POSTGRES_PORT,
path=self.POSTGRES_DB,
)
|
- (26/6/22): 了解了这些知识后,令人痛苦的重构就要开始了,说实话,很多时候重构比全部推翻重做还要难.但这是一个菜鸟项目进阶成为工程项目的必经之路.
后端重构阶段
重构的要点是,让系统不能正常运行的时间尽可能短,否则你做的就不是重构
第一步: 环境变量文件和config.py
先在.env中加入以下字段:
1
2
3
4
5
| POSTGRES_SERVER=localhost
POSTGRES_PORT=5432
POSTGRES_DB=app
POSTGRES_USER=postgres
POSTGRES_PASSWORD=123456
|
然后按照之前的示例处理Settings类即可:
app/utils/config.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
| from pydantic_settings import BaseSettings, SettingsConfigDict
from pydantic import (
computed_field,
PostgresDsn,
)
class Settings(BaseSettings):
model_config = SettingsConfigDict(
env_file="../.env",
env_file_encoding="utf-8",
extra="ignore",
)
DEEPSEEK_API_KEY: str = ""
DEEPSEEK_URL: str = "https://api.deepseek.com"
POSTGRES_SERVER: str
POSTGRES_PORT: int = 5432
POSTGRES_DB: str
POSTGRES_USER: str = ""
POSTGRES_PASSWORD: str = ""
@computed_field
@property
def DATABASE_URI(self) -> PostgresDsn:
return PostgresDsn.build(
scheme="postgresql+psycopg",
username=self.POSTGRES_USER,
password=self.POSTGRES_PASSWORD,
host=self.POSTGRES_SERVER,
port=self.POSTGRES_PORT,
path=self.POSTGRES_DB,
)
settings = Settings() # type: ignore
|
第二步: 设计模型
app/models.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| from sqlmodel import Relationship, SQLModel, Field
class UserBase(SQLModel):
name: str
class UserRegister(UserBase):
password: str
class UserLogin(UserBase):
password: str
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str
chat: list["ChatMessage"] = Relationship(
back_populates="user",
cascade_delete=True,
)
class ChatMessage(SQLModel, table=True):
chat_id: int | None = Field(default=None, primary_key=True)
content: str | None = None
user_id: int | None = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="chat")
|
- 尽管UserBase只有一个属性,看上去很蠢,但这却是实现OOP的必要损失.在后面的几章或许我们可以看到为什么需要这么做.
第三步: 加入数据库依赖
首先先创建一个数据库初始化函数init_db,由于这个函数很重要,所以单独放在db.py中:
app/utils/db.py
1
2
3
4
5
6
7
8
9
10
11
12
| from sqlmodel import (
create_engine,
SQLModel,
)
from app import models
from app.utils.config import settings
engine = create_engine(str(settings.DATABASE_URI))
def init_db() -> None:
SQLModel.metadata.create_all(engine)
|
如果你对SQLModel掌握的比较好的话,你可能会知道调用create_all的时候需要在当前文件导入所有的SQLModel表,不过,from app import models这里通过巧妙的隐式导入实现了这一点
接着,我们需要实现几个依赖函数,从而避免在每次验证用户和与数据库通信时都要反复调用.
app/utils/deps.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| from collections.abc import Generator
from typing import Annotated
from sqlmodel import Session
from app.utils.db import engine
from fastapi import Depends, HTTPException
from app.models import User
def get_db() -> Generator[Session, None, None]:
with Session(engine) as session:
yield session
SessionDep = Annotated[Session, Depends(get_db)]
def fake_get_current_user(session: SessionDep) -> User:
user = session.get(User, 114514)
if not user:
raise HTTPException(status_code=404, detail="User Not Found")
return user
CurrentUser = Annotated[User, Depends(fake_get_current_user)]
|
get_db,用于打开与数据库的连接,将其放进依赖可以有效避免每次显式调用get_db函数的麻烦.
在目前这个阶段,我们只能实现虚假的获取当前用户,主要原因就在于如果不使用token/cookie,那么就无法知道这个用户是谁,一个容易想到的方法就是让用户在前端自己选择id并通过post请求发送给后端,但在现代的工程中不可能使用这种极其危险的方式,所以就不这么做了.
第四步: 加入哈希部分
app/utils/security.py
1
2
3
4
5
6
7
8
9
10
11
| from pwdlib import PasswordHash
hash_method = PasswordHash.recommended()
def verify_password(plain_password: str, hashed_password: str) -> bool:
return hash_method.verify(plain_password, hashed_password)
def hashing_password(plain_password: str):
return hash_method.hash(plain_password)
|
两个函数,一个用于验证,一个用于加密
第五步: 初步实现crud.py
先考虑一下要实现之前的三个路由我们要做些什么:
- 用户注册: 传入
UserRegister并加密成User存入数据库即可,对于这种常见的CRUD操作,pydantic提供了一个魔法: model_validate - 用户登录: 传入
UserLogin并与数据库中存储的User进行比对,也就是通过id选取数据库中的特定行- 等会,我们并不知道当前用户的id! 没有办法,这里也只能做一个伪装登录了,那么这样一来,创建用户也不用真的创建了,因为读取不了啊
- 不过,出于完整性的考虑,我们可以用名字来选取数据库,尽管并非主键,但在我们这个项目里也够用了
- 用户验证: 如果使用token的话就没必要进行额外验证了,而不使用token的话我们也不知道他是谁,所以这一部分可以直接跳过了
- 健康检查: 执行一次空查询,检查数据库是否正常.
- 存储对话数据: 这一步很难想呢,我们如何才能将stream_agent这个流式输出放进数据库呢,不过我们先把这个问题放在一边,先实现上面的4个功能.
最终的代码长这样:
app/crud.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| from app.utils.security import (
verify_password,
hashing_password,
)
from fastapi import HTTPException
from sqlmodel import Session, select
from app.models import User, UserLogin, UserRegister, ChatMessage
def healthchecker(session: Session):
result = session.exec(select(1)).one()
return result == 1
def register_user(session: Session, user_create: UserRegister) -> User:
user_store = User.model_validate(
user_create, update={"hashed_password": hashing_password(user_create.password)}
)
# 数据库存储
session.add(user_store)
session.commit()
session.refresh(user_store)
# 返回信息供路由函数处理
return user_store
def check_user(session: Session, user_login: UserLogin, user_db: User):
user = session.exec(select(User).where(user_login.name == user_db.name)).first()
if not user:
raise HTTPException(status_code=404, detail="User not found")
if not verify_password(UserLogin.password, User.hashed_password):
raise HTTPException(status_code=401, detail="Invalid username or password")
return user
|
回到上面的问题,答案很明显,放不进去,所以我们现在要把client.py也重构一遍,最好是设计成一个好用的工具类,不仅方便现在的重构,更方便我们以后新增功能.
第六步: 重构client.py
先把原本代码搬过来:
app/core/client.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
| from app.utils.config import settings
from openai import OpenAI # type: ignore[import]
from typing import Generator
client = OpenAI(
api_key=settings.DEEPSEEK_API_KEY,
base_url=settings.DEEPSEEK_URL,
)
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = """
以后的回答都要称呼我为李华,优先输出"你好,李华!"
"""
def stream_agent(
user_message: str,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
model: str = DEFAULT_MODEL,
) -> Generator[str, None, None]:
# 创建流式请求。
stream = client.chat.completions.create(
model=model,
messages=[
{
"role": "system",
"content": system_prompt,
},
{
"role": "user",
"content": user_message,
},
],
# stream=True 是流式输出的关键。
stream=True,
reasoning_effort="high",
)
# stream 是一个可迭代对象。
# 模型每生成一点内容,就会返回一个 chunk。
for chunk in stream:
# 某些 chunk 可能没有 choices,保险起见先判断。
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
# 只有真的有文本内容时,才 yield 给外部。
if delta.content:
yield delta.content
|
首先我们看一下最关键的stream_agent函数,可以发现,stream和后面的输出部分完全可以拆分成两个函数,实际上,只要修改model和messages这两个字段,我们就可以导入各种各样的api和提示词了,因此,我们可以单独把这两个函数提出来,放在utils文件夹的chat.py中,并加上一个额外的工具函数messages.
还需要说明的是,考虑到创建client要走一遍OpenAI库,这还是不太清晰,我们可以复用一遍封装成自己的函数,也放入chat.py中,这样可以让代码的职责界限更加分明一点.
app/utils/chat.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| from typing import Generator
from openai import Stream, OpenAI
from openai.types.chat import ChatCompletionChunk
def messages(user_message: str, system_prompt: str) -> list[dict]:
return [
{
"role": "system",
"content": system_prompt,
},
{
"role": "user",
"content": user_message,
},
]
def create_client(api_key: str, url: str):
return OpenAI(api_key=api_key, base_url=url)
def stream_response(
stream: Stream[ChatCompletionChunk],
) -> Generator[str, None, None]:
for chunk in stream:
# 某些 chunk 可能没有 choices
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
# 只有真的有文本内容时,才 yield 给外部。
if delta.content:
yield delta.content
def create_stream(
client,
model: str,
user_message: str,
system_prompt: str,
):
stream = client.chat.completions.create(
model=model,
messages=messages(user_message, system_prompt),
stream=True,
reasoning_effort="high",
)
return stream
|
以防你不知道,光是函数的名字我就足足想了十几分钟,或许重构最难的地方就是起一个足够恰当的名字了.
- 看到那串冗长的类型就知道我第一版为什么没有给stream参数加上类型注释吧,而我没有给client参数加上类型注释是因为它的类型注释更加的可怕,等之后项目更成熟了再加上比较好
现在我们可以回到client.把这些工具函数用上了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| from app.utils.chat import stream_response, create_stream, create_client
from typing import Generator
from app.utils.config import settings
client = create_client(settings.DEEPSEEK_API_KEY, settings.DEEPSEEK_URL)
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
def stream_agent(
user_message: str,
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
) -> Generator[str, None, None]:
# 创建流式请求。
stream = create_stream(client, model, user_message, system_prompt)
return stream_response(stream)
|
之前那么长的代码被压缩到这个长度还是很有成就感的.
现在我们基本实现了除了route.py之外的所有重构,却没有影响到route.py,还是很成功的,接下来就是要把消息存入数据库中.
说是存入数据库,但流式消息还是不好下手,唯一的方法就是创建一个列表来收集,所以我们可以在crud.py中这么写:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
| from app.utils.security import (
verify_password,
hashing_password,
)
from fastapi import HTTPException
from sqlmodel import Session, select
from app.models import User, UserLogin, UserRegister, ChatMessage
def healthchecker(session: Session):
result = session.exec(select(1)).one()
return result == 1
def register_user(session: Session, user_create: UserRegister) -> User:
user_store = User.model_validate(
user_create, update={"hashed_password": hashing_password(user_create.password)}
)
# 数据库存储
session.add(user_store)
session.commit()
session.refresh(user_store)
# 返回信息供路由函数处理
return user_store
def check_user(session: Session, user_login: UserLogin, user_db: User):
user = session.exec(select(User).where(user_login.name == user_db.name)).first()
if not user:
raise HTTPException(status_code=404, detail="User not found")
if not verify_password(UserLogin.password, User.hashed_password):
raise HTTPException(status_code=401, detail="Invalid username or password")
return user
def save_chat_message(session: Session, user_id: int, content: str) -> ChatMessage:
message = ChatMessage(
user_id=user_id,
content=content,
)
session.add(message)
session.commit()
session.refresh(message)
return message
def stream_and_save(chunks, user_id: int, session: Session):
collected_chunks: list[str] = []
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
full_content = "".join(collected_chunks)
if full_content:
save_chat_message(
user_id=user_id,
content=full_content,
session=session,
)
|
- 最后两个函数即为新增的函数,第一个函数将message表进行更新,第二个函数用于处理chunk并组装出完整的消息.
这样一来,client.py也要适配着做出更改:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| from app.utils.chat import stream_response, create_stream, create_client
from typing import Generator
from app.utils.config import settings
from app.crud import stream_and_save
from sqlmodel import Session
client = create_client(settings.DEEPSEEK_API_KEY, settings.DEEPSEEK_URL)
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
def stream_agent(
user_id: int,
user_message: str,
session: Session,
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
) -> Generator[str, None, None]:
# 创建流式请求。
stream = create_stream(client, model, user_message, system_prompt)
chunks = stream_response(stream)
yield from stream_and_save(
chunks=chunks,
user_id=user_id,
session=session,
)
|
唯一值得说明的就是yield from这个关键字了,简单来说就是将stream_agent的输出委托给stream_and_save函数来输出,例子如下:
1
2
3
4
5
6
| def outer():
yield from inner()
# 等价于
def outer():
for item in inner():
yield item
|
这样一来,我们成功地在返回流式消息的同时,实现了消息的存储.
第七步: 修改路由实现
接下来就是最激动人心的时刻了,前面的所有更改在这里终于能够一一派上用场了
原始文件(更名为router.py以更适配路由的语义)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
| from fastapi import FastAPI
from fastapi.responses import StreamingResponse
from fastapi.middleware.cors import CORSMiddleware
from pydantic import BaseModel
from app.core.client import stream_agent
app = FastAPI()
origins = [
"http://localhost:3000",
"http://127.0.0.1:3000",
]
app.add_middleware(
CORSMiddleware,
allow_origins=origins,
allow_credentials=True,
allow_methods=["*"],
allow_headers=["*"],
)
class ChatMessage(BaseModel):
message: str
@app.get("/api/health")
async def homepage() -> dict:
return {"message": "Hello,World!"}
@app.get("/api/auth")
async def check() -> dict:
return {
"message": "我懒得写验证了,你直接进来吧",
"ok": True,
}
@app.post("/api/chat/", response_class=StreamingResponse)
async def chat(request: ChatMessage):
# return stream_agent(request.message)
return StreamingResponse(
stream_agent(request.message),
headers={
"Cache-Control": "no-cache",
},
)
|
上面的路由中,第一个health很好实现,至于第二个路由,由于我们没有Token验证机制,所以实现了也没啥震撼的效果,不如就放着算了,至于第三个,才是重头戏,由于我们需要针对不同的用户返回不同的消息体,所以肯定要把路由写成chat/[user_id]的形式,最后实现的效果如下:
引入router
显然,当项目变大之后,所有的路由都写在一个route.py文件中就不太合适了,更好的方法是,使用次一级的APIrouter类,大多数用法与Fastapi类别无二致,它主要用于收集路由,我们只需要在主应用中的app中导入该路由即可,说了这么多,还是先来实战看看吧.
上述文件可以拆分成两个子文件加上一个主文件:
app/core/routers/utils.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| from fastapi import APIRouter
from app.crud import healthchecker
from app.utils.deps import SessionDep
router = APIRouter(prefix="/utils", tags=["utils"])
@router.get("/health")
async def health_check(session: SessionDep) -> bool:
return healthchecker(session)
@router.get("/auth")
async def check() -> dict:
return {
"message": "我懒得写验证了,你直接进来吧",
"ok": True,
}
|
app/core/routers/user.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| from fastapi import APIRouter
from fastapi.responses import StreamingResponse
from app.utils.deps import SessionDep
from app.core.client import stream_agent
router = APIRouter(prefix="/user", tags=["user"])
@router.post("[user_id]/chat")
async def chat(
user_message: str,
user_id: int,
session: SessionDep,
) -> StreamingResponse:
# return stream_agent(request.message)
return StreamingResponse(
stream_agent(user_id, user_message, session),
headers={
"Cache-Control": "no-cache",
},
)
|
app/core/main.py
1
2
3
4
5
6
7
8
| from ctypes import util
from fastapi import APIRouter
from app.core.routers import user, utils
api_router = APIRouter()
api_router.include_router(user.router)
api_router.include_router(utils.router)
|
最后再在根目录的main.py中获取路由信息:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
| import uvicorn
from fastapi import FastAPI
from app.core.main import api_router
from starlette.middleware.cors import CORSMiddleware
# 后三个参数均为openapi参数
app = FastAPI(
title="demo",
openapi_url="/api/openapi.json",
docs_url="/api/docs",
redoc_url="/api/redoc",
)
app.include_router(api_router, prefix="/api")
origins = [
"http://localhost:3000",
"http://127.0.0.1:3000",
]
app.add_middleware(
CORSMiddleware,
allow_origins=origins,
allow_credentials=True,
allow_methods=["*"],
allow_headers=["*"],
)
def main():
uvicorn.run(
"main:app",
host="0.0.0.0",
port=8000,
workers=1,
)
if __name__ == "__main__":
main()
|
总结
如此一来我们就实现了所有的重构目标,只不过还没能真正地实现用户验证功能.
另一个更加严重的问题就是,由于我们还没引入docker,而本地启动postgre数据库又比较麻烦,所以这里的数据库操作也都是模拟的,无法真正实现.
置于前端界面,由于后续的路由变化太大,这一步就没必要重构了,看一下openapi文档即可大致了解我们的开发效果.
运行uv run main.py后,访问http://localhost:8000/api/docs即可看到以下界面:
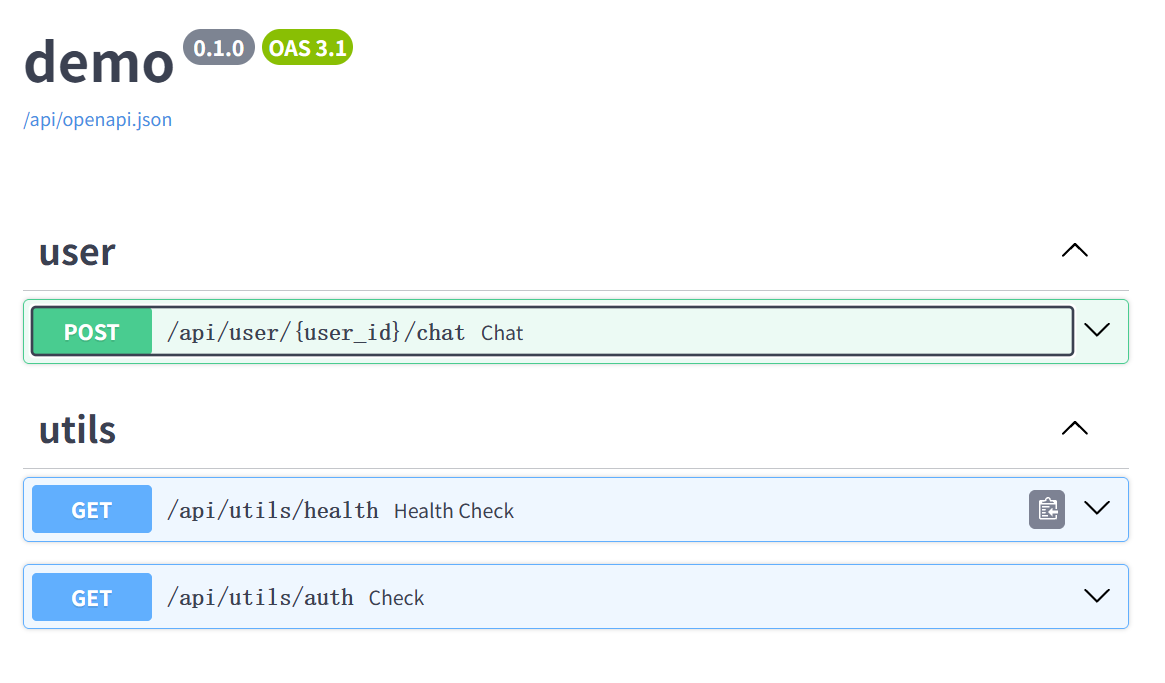
ch7: docker构建和加入数据库
示例1
由于docker官方关于python的dockerfile构建文档还用的是pip,一个比较权威的参考文档就是fastapi模板项目中的dockerfile写法了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
| FROM python:3.10
ENV PYTHONUNBUFFERED=1
# Install uv
# Ref: https://docs.astral.sh/uv/guides/integration/docker/#installing-uv
COPY --from=ghcr.io/astral-sh/uv:0.9.26 /uv /uvx /bin/
# Compile bytecode
# Ref: https://docs.astral.sh/uv/guides/integration/docker/#compiling-bytecode
ENV UV_COMPILE_BYTECODE=1
# uv Cache
# Ref: https://docs.astral.sh/uv/guides/integration/docker/#caching
ENV UV_LINK_MODE=copy
WORKDIR /app/
# Place executables in the environment at the front of the path
# Ref: https://docs.astral.sh/uv/guides/integration/docker/#using-the-environment
ENV PATH="/app/.venv/bin:$PATH"
# Install dependencies
# Ref: https://docs.astral.sh/uv/guides/integration/docker/#intermediate-layers
RUN --mount=type=cache,target=/root/.cache/uv \
--mount=type=bind,source=uv.lock,target=uv.lock \
--mount=type=bind,source=pyproject.toml,target=pyproject.toml \
uv sync --frozen --no-install-workspace --package app
COPY ./backend/scripts /app/backend/scripts
COPY ./backend/pyproject.toml ./backend/alembic.ini /app/backend/
COPY ./backend/app /app/backend/app
RUN --mount=type=cache,target=/root/.cache/uv \
--mount=type=bind,source=uv.lock,target=uv.lock \
--mount=type=bind,source=pyproject.toml,target=pyproject.toml \
uv sync --frozen --package app
WORKDIR /app/backend/
CMD ["fastapi", "run", "--workers", "4", "app/main.py"]
|
COPY --from=ghcr.io/astral-sh/uv:latest /uv /uvx /bin/: 将uv和uvx下载到环境变量目录bin下.ENV PYTHONUNBUFFERED=1: python在控制台输出调试信息时会先存入缓冲区,设置该环境变量可以让Python直接输出调试信息,减少等待时间ENV UV_COMPILE_BYTECODE=1: python文件在第一次运行时会被编译为字节码,而在docker中,如果直接将纯文件包装成镜像的话,那么每一次启动镜像都要进行重新编译,非常麻烦,该配置选项会在使用uv命令时自动帮所有涉及的python文件构建字节码文件.- 优点是可以缩减镜像启动时间,缺点是会增大镜像体积,但还是利大于弊.
ENV UV_LINK_MODE=copy: 该环境变量用于静默一些警告信息,打开就对了.ENV PATH="/app/.venv/bin:$PATH": 一般来说,Linux系统的PATH中会有多个值,用:分隔,为了让uv能够直接通过命令行运行而不用带上路径,所以我们用一个新的PATH值来覆盖原来的PATH,
至于这个长长的命令,是通过三个绑定挂载来缩减构建时间和减少冗余的,因为是官方推荐的写法,所以就无脑使用即可:
1
2
3
4
5
6
| # Install dependencies
# Ref: https://docs.astral.sh/uv/guides/integration/docker/#intermediate-layers
RUN --mount=type=cache,target=/root/.cache/uv \
--mount=type=bind,source=uv.lock,target=uv.lock \
--mount=type=bind,source=pyproject.toml,target=pyproject.toml \
uv sync --frozen --no-install-workspace --package app
|
示例2
uv官方也给了非常详细的示例: 参考链接
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| # Install uv
FROM python:3.12-slim AS builder
COPY --from=ghcr.io/astral-sh/uv:latest /uv /uvx /bin/
# Use the system Python across both stages
ENV UV_PYTHON_DOWNLOADS=0
# Change the working directory to the `app` directory
WORKDIR /app
# Install dependencies
RUN --mount=type=cache,target=/root/.cache/uv \
--mount=type=bind,source=uv.lock,target=uv.lock \
--mount=type=bind,source=pyproject.toml,target=pyproject.toml \
uv sync --locked --no-install-project --no-editable
# Copy the project into the intermediate image
COPY . /app
# Sync the project
RUN --mount=type=cache,target=/root/.cache/uv \
uv sync --locked --no-editable
FROM python:3.12-slim
# Copy the environment, but not the source code
COPY --from=builder /app/.venv /app/.venv
# Run the application
CMD ["/app/.venv/bin/hello"]
|
该实例引入了两层构建的写法,显然比fastapi模板项目的写法更加专业.
将后端放入dockerfile
我们之前的main.py是放在根目录的,因为这样好直接从命令行操作,现在可以直接用docker,所以就把main.py放入app文件夹中,项目结构现在长这样:
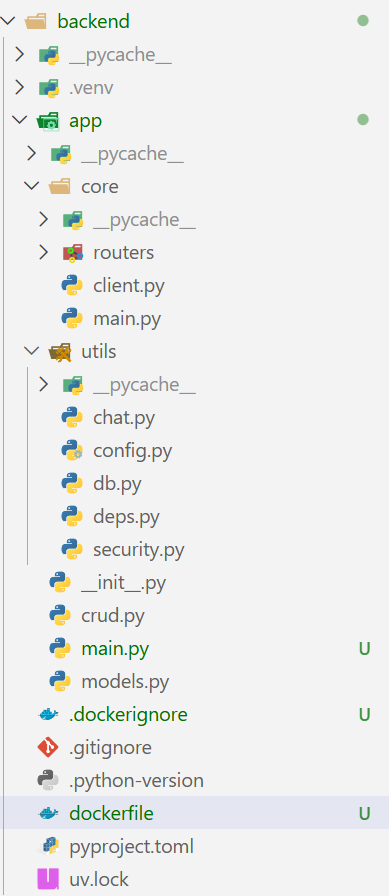
首先,填写.dockerignore,防止带入一些奇奇怪怪的东西:
1
2
3
4
5
6
| # Python
__pycache__
app.egg-info
*.pyc
.mypy_cache
.venv
|
对于dockerfile,我们采用两层构建的写法,大多数指令都是直接从上述的示例中复制而来:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| FROM python:3.14-slim AS builder
COPY --from=ghcr.io/astral-sh/uv:latest /uv /uvx /bin/
ENV UV_LINK_MODE=copy \
UV_COMPILE_BYTECODE=1 \
PYTHONUNBUFFERED=1
WORKDIR /app
RUN --mount=type=cache,target=/root/.cache/uv \
--mount=type=bind,source=uv.lock,target=uv.lock \
--mount=type=bind,source=pyproject.toml,target=pyproject.toml \
uv sync --frozen --no-install-project
FROM python:3.14-slim
WORKDIR /app
ENV PYTHONUNBUFFERED=1 \
PATH="/app/.venv/bin:$PATH"
COPY --from=builder /app/.venv /app/.venv
COPY . .
CMD ["fastapi", "run", "app/main.py"]
|
要直接构建镜像并运行的话,可以在backend目录中运行:
1
2
| docker build -t backend .
docker run backend
|
如果不出意外的话,镜像能够构建成功,但是运行时却会报错.原因就是缺失了环境变量文件,通过docker run -e参数来注入固然可以,但实在是太麻烦了.
因此,我们需要引入docker compose,用docker compose一键启动.
由于我们目前的功能很简单,所以这个compose文件写的也很简单:
1
2
3
4
5
6
7
8
9
10
| services:
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
env_file:
- .env
ports:
- "8000:8000"
|
根目录下运行命令:
1
| docker compose up --build -d
|
访问http://localhost:8000/api/docs,成功出现openapi文档,大功告成!
将数据库加入compose文档
有了后端,没有数据库可不行,我们这个项目用的数据库是PostgreSQL,主要原因就是fastapi模板项目用的就是它,而且性能非常好.
官方最新的镜像为19的beta版本,那我们用18-alpine版本就够了,写法如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
volumes:
db-data:
|
上述的healthcheck字段是标准写法,所以无脑照抄就可以了,不过这需要预先在.env文件中声明了{}所包裹的两个环境变量才可以.
volume挂载的路径也是标准路径,与镜像内置的环境变量相关联,所以最好不要改.
显然,如果后端比数据库先启动,那么也无法执行任何的数据操作,所以,需要用depends_on关键字来强制后端滞后启动,完整的yml文件如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| services:
db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
env_file:
- .env
ports:
- "8000:8000"
volumes:
db-data:
|
运行下述命令:
1
| docker compose up --build -d
|
可以看到所有服务都正常启动了,非常好!
现在我们可以真正的对数据库进行操作了,但是,这需要我们先完善用户验证功能,不然就没办法有效的存储数据了.
ch8: 实现Token验证
预处理
现在最大的问题是,即便有了注册+登录的流程,后端还是无法记住当前用户,那么也就不可能真正的给用户传递数据库的信息,也就是说,数据库基本没被用上! 因此,我们需要加入token功能,在用户的每次数据库请求中加上token依赖,这样我们才能知道这是哪个用户,我们又应该返回哪条消息.
为了让重构更简单,我们就需要再次进行文件的重新放置和安排,确保文件彼此的职责边界清晰,最后得到的目录架构如下:
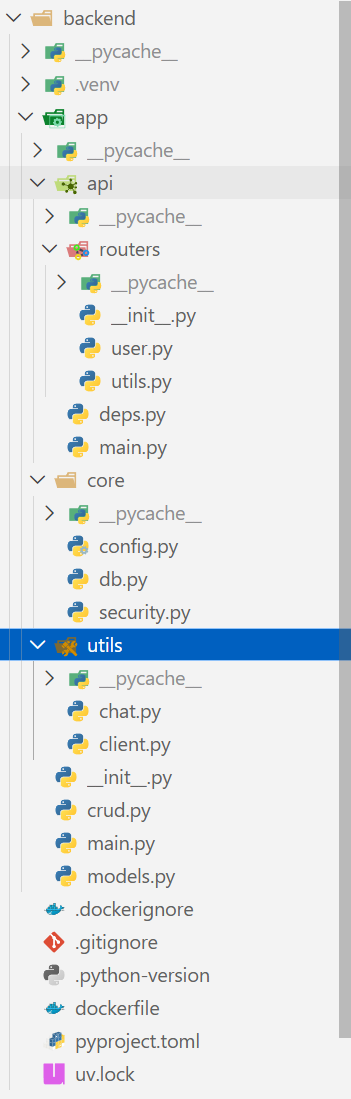
考虑到我们需要先启动数据库驱动再运行asgi服务器,所以最好把数据库初始化函数预先调动,因此,有必要先在app的根目录单独创建一个db_pre_start.py文件:
app/db_pre_start.py
1
2
3
4
5
6
7
8
9
| from app.core.db import init_db
def main() -> None:
init_db()
if __name__ == "__main__":
main()
|
- 另一个原因是后续需要在prestart中加入数据库迁移,管理员账户初始化等功能,所以需要尽早拆分.
考虑到手动启动该函数的麻烦,我们需要将这个文件放入脚本来启动,再封装在compose.yml中:
backend/scripts/prestart.sh
1
2
3
4
5
6
7
| #! /usr/bin/env bash
set -e
set -x
# Let the DB start
python -m app.db_pre_start
|
现在,我们就可以把这个脚本放入compose里了:
1
2
3
4
5
6
7
8
9
10
11
| prestart:
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
command: bash scripts/prestart.sh
env_file:
- .env
|
prestart服务与backend服务共用一个dockerfile进行构建,运行完command中指示的脚本后就会主动退出并终止.让位给backend服务.
最终的compose.yml格式如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
| services:
db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
prestart:
build:
context: .
dockerfile: backend/Dockerfile
depends_on:
db:
condition: service_healthy
restart: true
command: bash scripts/prestart.sh
env_file:
- .env
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
prestart:
condition: service_completed_successfully
env_file:
- .env
ports:
- "8000:8000"
volumes:
db-data:
|
同时我们需要修改一下.env文件中的环境变量值,将POSTGRES_SERVER=localhost修改为db:
1
2
3
4
5
6
7
8
9
10
11
12
| DEEPSEEK_API_KEY=123
SECRET_KEY=123456
# DATABASE_URL = postgresql+psycopg://
# postgres:123456@db:5432/my_chat_db
POSTGRES_SERVER=db
POSTGRES_PORT=5432
POSTGRES_DB=app
POSTGRES_USER=postgres
POSTGRES_PASSWORD=123456
|
主要原因是如果用localhost的话prestart就无法和db连接了.
生成Token与提取Token
首先,先在models.py创建关于token的两个SQLModel模型:
1
2
3
4
5
6
7
| class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str | None = None
|
一个用来存放返回给用户的token,一个用来存放用户提供的token,分别用于分发和校验token.而至于为什么放的是这三个字段,请看下面的深入解释:
token原理再探
在token往来中,服务器和客户端存放token的方式自然有所不同,当用户登录时,服务器的返回内容如下:
1
2
3
4
5
6
7
8
9
10
11
| HTTP/1.1 200 OK
Content-Type: application/json
{
"access_token":
"xxxxx.yyyyy.zzzzz",
"token_type":
"bearer"
}
|
而用户在之后请求信息时,都会在头部带上这个"xxxxx.yyyyy.zzzzz"token,服务器只需要再次用密钥和对应的算法来解析token,就可以知道该token的格式是否正常,token是否过期.
而sub字段(subject)则是用于区分不同的用户,唯一具有该功能的键自然就是主键了,也就是说sub字段存储的就是用户数据库的主键id,自然,该id需要具有随机性,不然就容易被cracker攻击或者破坏,不过我们这个项目显然没这个烦恼,就依靠SQLModel的自动生成特性来实现也足够了.
而标准的设计中,数据库最起码要提供的token字段(也就是payload)如下:
1
2
3
4
5
6
7
8
| {
"sub":"1001",
"iat":1720000000,
"exp":1720003600,
}
|
| 字段 | 用途 |
|---|
| sub | 用户ID |
| iat | 签发时间 |
| exp | 过期时间 |
因此,我们还需要对models.py中的原字段做一些改动,加入时间机制,先看看原来的结构:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
| from sqlmodel import Relationship, SQLModel, Field
class UserBase(SQLModel):
name: str
class UserRegister(UserBase):
password: str
class UserLogin(UserBase):
password: str
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str
chats: list["ChatMessage"] = Relationship(
back_populates="user",
cascade_delete=True,
)
class Message(SQLModel):
message: str
class ChatMessage(SQLModel, table=True):
chat_id: int | None = Field(default=None, primary_key=True)
content: str | None = None
user_id: int | None = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="chats")
class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str | None = None
|
加入计时功能需要导入datetime库,该库与普通的计时器time库不同,可以获取更为精确的时间,并且支持时区.
models.py最终版本
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
| from sqlalchemy import DateTime
from sqlmodel import Relationship, SQLModel, Field
from datetime import UTC, datetime
def get_datetime() -> datetime:
return datetime.now(UTC)
class UserBase(SQLModel):
name: str | None = Field(default=None, max_length=255)
is_active: bool = True
class UserRegister(SQLModel):
password: str
name: str = Field(default=None, max_length=255)
class UserCreate(UserBase):
password: str = Field(min_length=8, max_length=16)
class UserPublic(UserBase):
id: int | None
created_at: datetime | None = None
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str
created_at: datetime | None = Field(
default_factory=get_datetime,
)
chats: list["ChatMessage"] = Relationship(
back_populates="user",
cascade_delete=True,
)
class Message(SQLModel):
message: str
class ChatMessage(SQLModel, table=True):
chat_id: int | None = Field(default=None, primary_key=True)
content: str | None = None
created_at: datetime | None = Field(
default_factory=get_datetime,
)
user_id: int | None = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="chats")
class ChatMessagePublic(SQLModel):
chat_id: int
content: str | None
created_at: datetime | None
class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str | None = None
|
重构deps.py
重构完models.py后,就可以着手重构deps.py了,把之前的所有伪处理全部改成真实的处理:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
| from collections.abc import Generator
from typing import Annotated
from sqlmodel import Session
from app.core.db import engine
from app.models import User, TokenPayload # newline
from fastapi.security import OAuth2PasswordBearer
from fastapi import Depends, HTTPException, status # newline
# newline
import jwt
from jwt.exceptions import InvalidTokenError
from app.core.config import settings
from pydantic import ValidationError
# newline
oauth2 = OAuth2PasswordBearer(
tokenUrl="/api/login/access-token",
scheme_name="Oauth2",
)
TokenDep = Annotated[str, Depends(oauth2)]
ALGORITHM = "HS256"
def get_db() -> Generator[Session, None, None]:
with Session(engine) as session:
yield session
SessionDep = Annotated[Session, Depends(get_db)]
def get_current_user(
session: SessionDep,
token: TokenDep,
) -> User:
try:
payload = jwt.decode(
token,
settings.SECRET_KEY,
algorithms=[ALGORITHM],
)
token_data = TokenPayload(**payload)
except InvalidTokenError, ValidationError:
raise HTTPException(
status_code=status.HTTP_403_FORBIDDEN,
detail="Invalid credentials",
)
user = session.get(User, token_data.sub)
if not user:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="User Not Found",
)
if not user.is_active:
raise HTTPException(
status_code=status.HTTP_400_BAD_REQUEST,
detail="Inactive user",
)
return user
CurrentUser = Annotated[User, Depends(get_current_user)]
|
可以看到,引入验证功能之后,所有的路由处理都水到渠成了.
重构security.py
原来的security.py长这样,属实有点寒酸:
1
2
3
4
5
6
7
8
9
10
11
| from pwdlib import PasswordHash
hash_method = PasswordHash.recommended()
def verify_password(plain_password: str, hashed_password: str) -> bool:
return hash_method.verify(plain_password, hashed_password)
def hashing_password(plain_password: str):
return hash_method.hash(plain_password)
|
加入验证功能后,我们需要创建一个构建token的函数,最终效果如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| from datetime import timedelta
from typing import Any
from datetime import datetime, UTC
import jwt
from pwdlib import PasswordHash
from app.api.deps import ALGORITHM
from app.core.config import settings
hash_method = PasswordHash.recommended()
def create_token(subject: str | Any, expires_delta: timedelta) -> str:
expire_date = datetime.now(UTC) + expires_delta
encode_content = {"exp": expire_date, "sub": str(subject)}
encoded_jwt = jwt.encode(
encode_content,
settings.SECRET_KEY,
algorithm=ALGORITHM,
)
return encoded_jwt
def verify_password(
plain_password: str,
hashed_password: str,
) -> bool:
return hash_method.verify(plain_password, hashed_password)
def hashing_password(plain_password: str) -> str:
return hash_method.hash(plain_password)
|
crud.py重构
原版本:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
| from app.core.security import (
verify_password,
hashing_password,
)
from fastapi import HTTPException
from sqlmodel import Session, select
from app.models import User, UserLogin, UserRegister, ChatMessage
def healthchecker(session: Session):
result = session.exec(select(1)).one()
return result == 1
def register_user(session: Session, user_create: UserRegister) -> User:
user_store = User.model_validate(
user_create, update={"hashed_password": hashing_password(user_create.password)}
)
# 数据库存储
session.add(user_store)
session.commit()
session.refresh(user_store)
# 返回信息供路由函数处理
return user_store
def check_user(session: Session, user_login: UserLogin, user_db: User):
user = session.exec(select(User).where(user_login.name == user_db.name)).first()
if not user:
raise HTTPException(status_code=404, detail="User not found")
if not verify_password(UserLogin.password, User.hashed_password):
raise HTTPException(status_code=401, detail="Invalid username or password")
return user
def save_chat_message(session: Session, user_id: int, content: str) -> ChatMessage:
message = ChatMessage(
user_id=user_id,
content=content,
)
session.add(message)
session.commit()
session.refresh(message)
return message
def stream_and_save(chunks, user_id: int, session: Session):
collected_chunks: list[str] = []
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
full_content = "".join(collected_chunks)
if full_content:
save_chat_message(
user_id=user_id,
content=full_content,
session=session,
)
|
鉴于原版本的部分函数的语义有问题,所以在下面一并进行修改了,最关键的改动则是加入了验证函数:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
| from app.core.security import (
verify_password,
hashing_password,
)
from fastapi import HTTPException
from sqlmodel import Session, select
from app.models import User, UserCreate, UserRegister, ChatMessage
# Dummy hash to use for timing attack prevention when user is not found
DUMMY_HASH = "$argon2id$v=19$m=65536,t=3,p=4$MjQyZWE1MzBjYjJlZTI0Yw$YTU4NGM5ZTZmYjE2NzZlZjY0ZWY3ZGRkY2U2OWFjNjk"
def check_db(*, session: Session):
result = session.exec(select(1)).one()
return result == 1
def register_user(*, session: Session, user_register: UserRegister) -> User:
user_store = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
session.add(user_store)
session.commit()
session.refresh(user_store)
return user_store
def get_user_by_name(*, session: Session, name: str) -> User | None:
statement = select(User).where(User.name == name)
user = session.exec(statement).first()
return user
def check_user(session: Session, name: str, password: str) -> User | None:
db_user = get_user_by_name(session=session, name=name)
if not db_user:
verify_password(password, DUMMY_HASH)
return None
verified = verify_password(password, db_user.hashed_password)
if not verified:
return None
return db_user
# 工具函数
def save_chat_message(*, session: Session, user_id: int, content: str) -> ChatMessage:
message = ChatMessage(
user_id=user_id,
content=content,
)
session.add(message)
session.commit()
session.refresh(message)
return message
def stream_and_save(*, session: Session, user_id: int, chunks):
collected_chunks: list[str] = []
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
full_content = "".join(collected_chunks)
if full_content:
save_chat_message(
user_id=user_id,
content=full_content,
session=session,
)
|
- 尽管根据名字来区分用户的方法有点草率,但却不需要我们做什么额外的操作,无论是邮件验证还是手机号验证,都需要去搞个云服务器过来,或者自掏腰包.之后若有空闲,或许可以引入Google登录.
路由重构
做完上述的准备工作后,我们所要用到的组件都已经集齐了,接下来就是将路由重构成能够真正地与数据库交互的版本.
构思
原先版本的两个路由文件长这样:
api/routers/utils.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| from fastapi import APIRouter
from app.crud import healthchecker
from app.api.deps import SessionDep
router = APIRouter(prefix="/utils", tags=["utils"])
@router.get("/health")
async def health_check(session: SessionDep) -> bool:
return healthchecker(session)
@router.get("/auth")
async def check() -> dict:
return {
"message": "我懒得写验证了,你直接进来吧",
"ok": True,
}
|
api/routers/user.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| from fastapi import APIRouter
from fastapi.responses import StreamingResponse
from app.api.deps import SessionDep
from app.utils.client import stream_agent
router = APIRouter(prefix="/user", tags=["user"])
@router.post("/{user_id}/chat")
async def chat(
user_message: str,
user_id: int,
session: SessionDep,
) -> StreamingResponse:
# return stream_agent(request.message)
return StreamingResponse(
stream_agent(user_id, user_message, session),
headers={
"Cache-Control": "no-cache",
},
)
|
加入验证功能后,我们需要引入以下路由:
- 用于注册的register路由
- 用于展示用户主页的
{user_id}路由 - 用于产生token和登录的
access-token路由
除了最后一个需要放入utils.py中,其他的都可以放入user.py里.
utils.py重构
原来的auth路由就可以直接删掉了,而health路由暂时保留,可以用来在测试和初始化数据库的时候使用.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
| from typing import Annotated
from datetime import timedelta
from fastapi import APIRouter, Depends, HTTPException
from fastapi.security import OAuth2PasswordRequestForm
from app.crud import check_db, check_user
from app.api.deps import SessionDep
from app.models import Token
from app.core import security
router = APIRouter(tags=["utils"])
TOKEN_EXPIRE_MINUTES: int = 60 * 24 * 8
@router.get("/utils/health")
async def health_check(session: SessionDep) -> bool:
return check_db(session=session)
@router.post("/login/access-token")
def login_access_token(
session: SessionDep, form_data: Annotated[OAuth2PasswordRequestForm, Depends()]
) -> Token:
user = check_user(
session=session,
name=form_data.username,
password=form_data.password,
)
if not user:
raise HTTPException(status_code=400, detail="Incorrect name or password")
elif not user.is_active:
raise HTTPException(status_code=400, detail="Inactive user")
token_expires = timedelta(minutes=TOKEN_EXPIRE_MINUTES)
return Token(
access_token=security.create_token(
user.id,
expires_delta=token_expires,
)
)
|
user.py重构
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
| from fastapi import APIRouter, HTTPException, Query
from fastapi.responses import StreamingResponse
from typing import Annotated, Any
from app.api.deps import SessionDep, CurrentUser
from app.utils.client import stream_agent
from app.models import ChatMessage, ChatMessagePublic, User, UserPublic, UserRegister
from app import crud
from sqlmodel import select, desc
router = APIRouter(prefix="/user", tags=["user"])
# response_model用于过滤密码
@router.post("/register", response_model=UserPublic)
def register_user(session: SessionDep, user_in: UserRegister) -> Any:
user = crud.get_user_by_name(session=session, name=user_in.name)
# 由于没有邮箱,所以只好通过用户名来标记是否冲突
if user:
raise HTTPException(status_code=400, detail="Name exists")
user_register = UserRegister.model_validate(user_in)
user = crud.register_user(session=session, user_register=user_register)
return user
# 用户主页
@router.get("/me", response_model=UserPublic)
def homepage(current_user: CurrentUser) -> User:
return current_user
# 新对话
@router.post("/me/chat")
async def chat(
user_message: str,
session: SessionDep,
current_user: CurrentUser,
) -> StreamingResponse:
if not current_user.id:
raise HTTPException(
status_code=401,
detail="Invalid authenticated user",
)
return StreamingResponse(
stream_agent(current_user.id, user_message, session),
headers={
"Cache-Control": "no-cache",
},
)
# 消息列表
@router.get(
"/me/messages",
response_model=list[ChatMessagePublic],
)
def get_chat_list(
session: SessionDep,
current_user: CurrentUser,
offset: Annotated[int, Query(ge=0)] = 0,
limit: Annotated[int, Query(ge=1, le=20)] = 10,
) -> Any:
statement = (
select(ChatMessage)
.where(ChatMessage.user_id == current_user.id)
.order_by(desc(ChatMessage.created_at))
.offset(offset=offset)
.limit(limit=limit)
)
chatlist = session.exec(statement).all()
return chatlist
|
出于简化的考量,就没有加入删除对话等功能,但这就已经比较复杂了.
总结
同样用docker compose启动服务,一切正常,打开http://localhost:8000/api/docs进行测试:
- 在
/api/user/register路由注册用户:
请求体
1
2
3
4
| {
"password": "4i",
"name": "mike"
}
|
响应体
1
2
3
4
5
6
| {
"name": "mike",
"is_active": true,
"id": 1,
"created_at": "2026-07-27T08:08:23.138696"
}
|
- 在
/api/login/access-token输入用户名称和密码,获取token:
1
2
3
4
5
6
7
8
9
| access-control-allow-credentials: true
content-length: 160
content-type: application/json
date: Mon,27 Jul 2026 08:09:55 GMT
server: uvicorn
{
"access_token": "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJleHAiOjE3ODU4MzA5OTUsInN1YiI6IjEifQ.z5-He7jM3SrPkO7YimRnD5xx0XcL6yqL9Ec6rKL3dOE",
"token_type": "bearer"
}
|
- 点击Swagger UI上方的Authorize按钮,输入用户名和密码:
- 在
/api/user/me/chat输入消息来聊天:
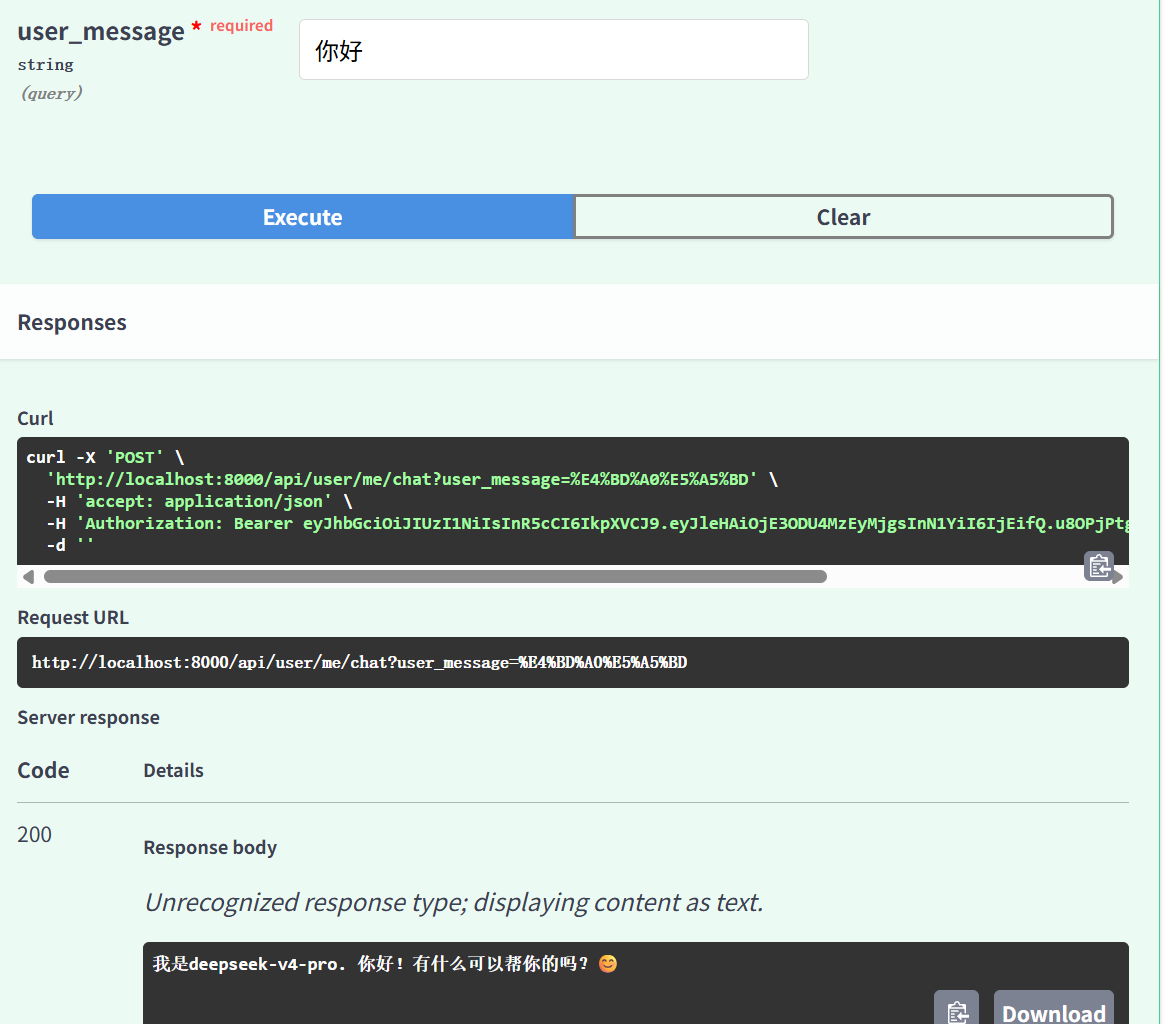
- 在
/api/user/me/messages查看消息列表:
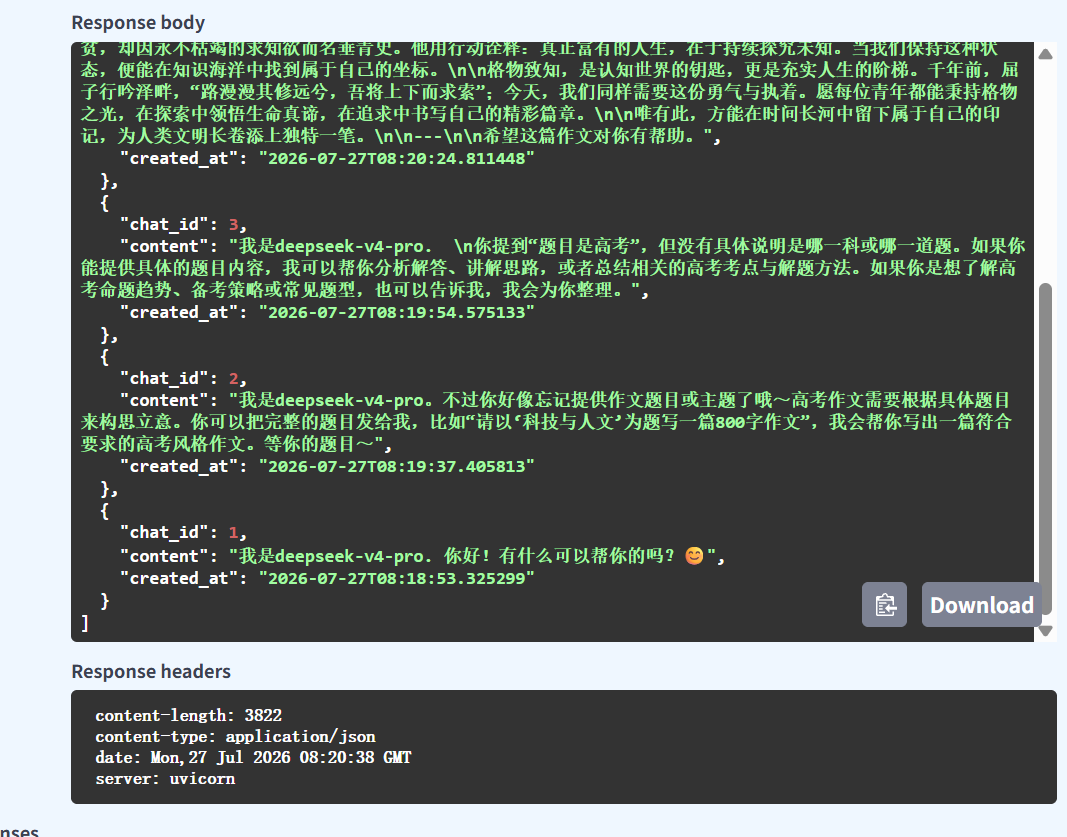
可以看到,尽管我们还没有重构前端,但所有的基本功能我们都已经实现了,你可以自豪的跟面试官吹嘘,我自己一个人写了个智能体出来,代码都是自己写的哦!
ch9: 重构前端的准备
加入dockerfile
修改next.config.ts.
1
2
3
4
5
6
7
8
9
10
| import type { NextConfig } from "next";
const nextConfig: NextConfig = {
/* config options here */
output: "standalone", //new line
reactCompiler: true,
devIndicators: false,
};
export default nextConfig;
|
nextjs有多种部署方式:
- 纯静态的
export模式,不需要node.js即可启动,输出目录为out - 默认的动态模式,输出目录为
.next - standalone模式,输出目录为
.next/standalone,在支持动态加载的情况下做到轻量化,非常适合docker部署,这也是为什么我们要单独修改配置文件的原因.
编写dockerfile
参考官方文档,我们采用三阶段构建,并依靠AI进行了细微的调整,至于为什么要修改,那当然是因为官方文档的写法跑不起来啊!不过我懒得提issue了,毕竟这个模块的更新时间竟然是在5个月前.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| ARG NODE_VERSION=24.13.0-slim
# Stage 1: Dependencies Installation Stage
FROM node:${NODE_VERSION} AS dependencies
WORKDIR /app
COPY package.json pnpm-lock.yaml* pnpm-workspace.yaml ./
RUN --mount=type=cache,id=pnpm-store,target=/pnpm/store \
corepack enable pnpm && \
pnpm config set store-dir /pnpm/store && \
pnpm config set minimum-release-age 0 && \
pnpm install --frozen-lockfile --ignore-scripts=false
# Stage 2: Build Next.js application in standalone mode
FROM node:${NODE_VERSION} AS builder
WORKDIR /app
COPY --from=dependencies /app/node_modules ./node_modules
COPY . .
ENV NODE_ENV=production
RUN ./node_modules/.bin/next build
# Stage 3: Run Next.js application
FROM node:${NODE_VERSION} AS runner
WORKDIR /app
ENV NODE_ENV=production
ENV PORT=3000
ENV HOSTNAME="0.0.0.0"
COPY --from=builder --chown=node:node /app/public ./public
RUN mkdir .next
RUN chown node:node .next
COPY --from=builder --chown=node:node /app/.next/standalone ./
COPY --from=builder --chown=node:node /app/.next/static ./.next/static
USER node
EXPOSE 3000
CMD ["node", "server.js"]
|
编写compose.yml
官方推荐的yml写法如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| services:
# Node.js service (use with: docker compose up nextjs-standalone --build)
nextjs-standalone:
build:
context: .
dockerfile: Dockerfile
image: nextjs-standalone-image
container_name: nextjs-standalone-container
environment:
NODE_ENV: production
PORT: "3000"
ports:
- "3000:3000"
restart: unless-stopped
|
对于我们这个项目,稍微改动一下就适配了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
| services:
db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
prestart:
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
command: bash scripts/prestart.sh
env_file:
- .env
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
prestart:
condition: service_completed_successfully
env_file:
- .env
ports:
- "8000:8000"
frontend:
build:
context: ./frontend
dockerfile: dockerfile
ports:
- "3000:3000"
restart: unless-stopped
volumes:
db-data:
|
启动后也终于是看到了我们熟悉的古早页面:
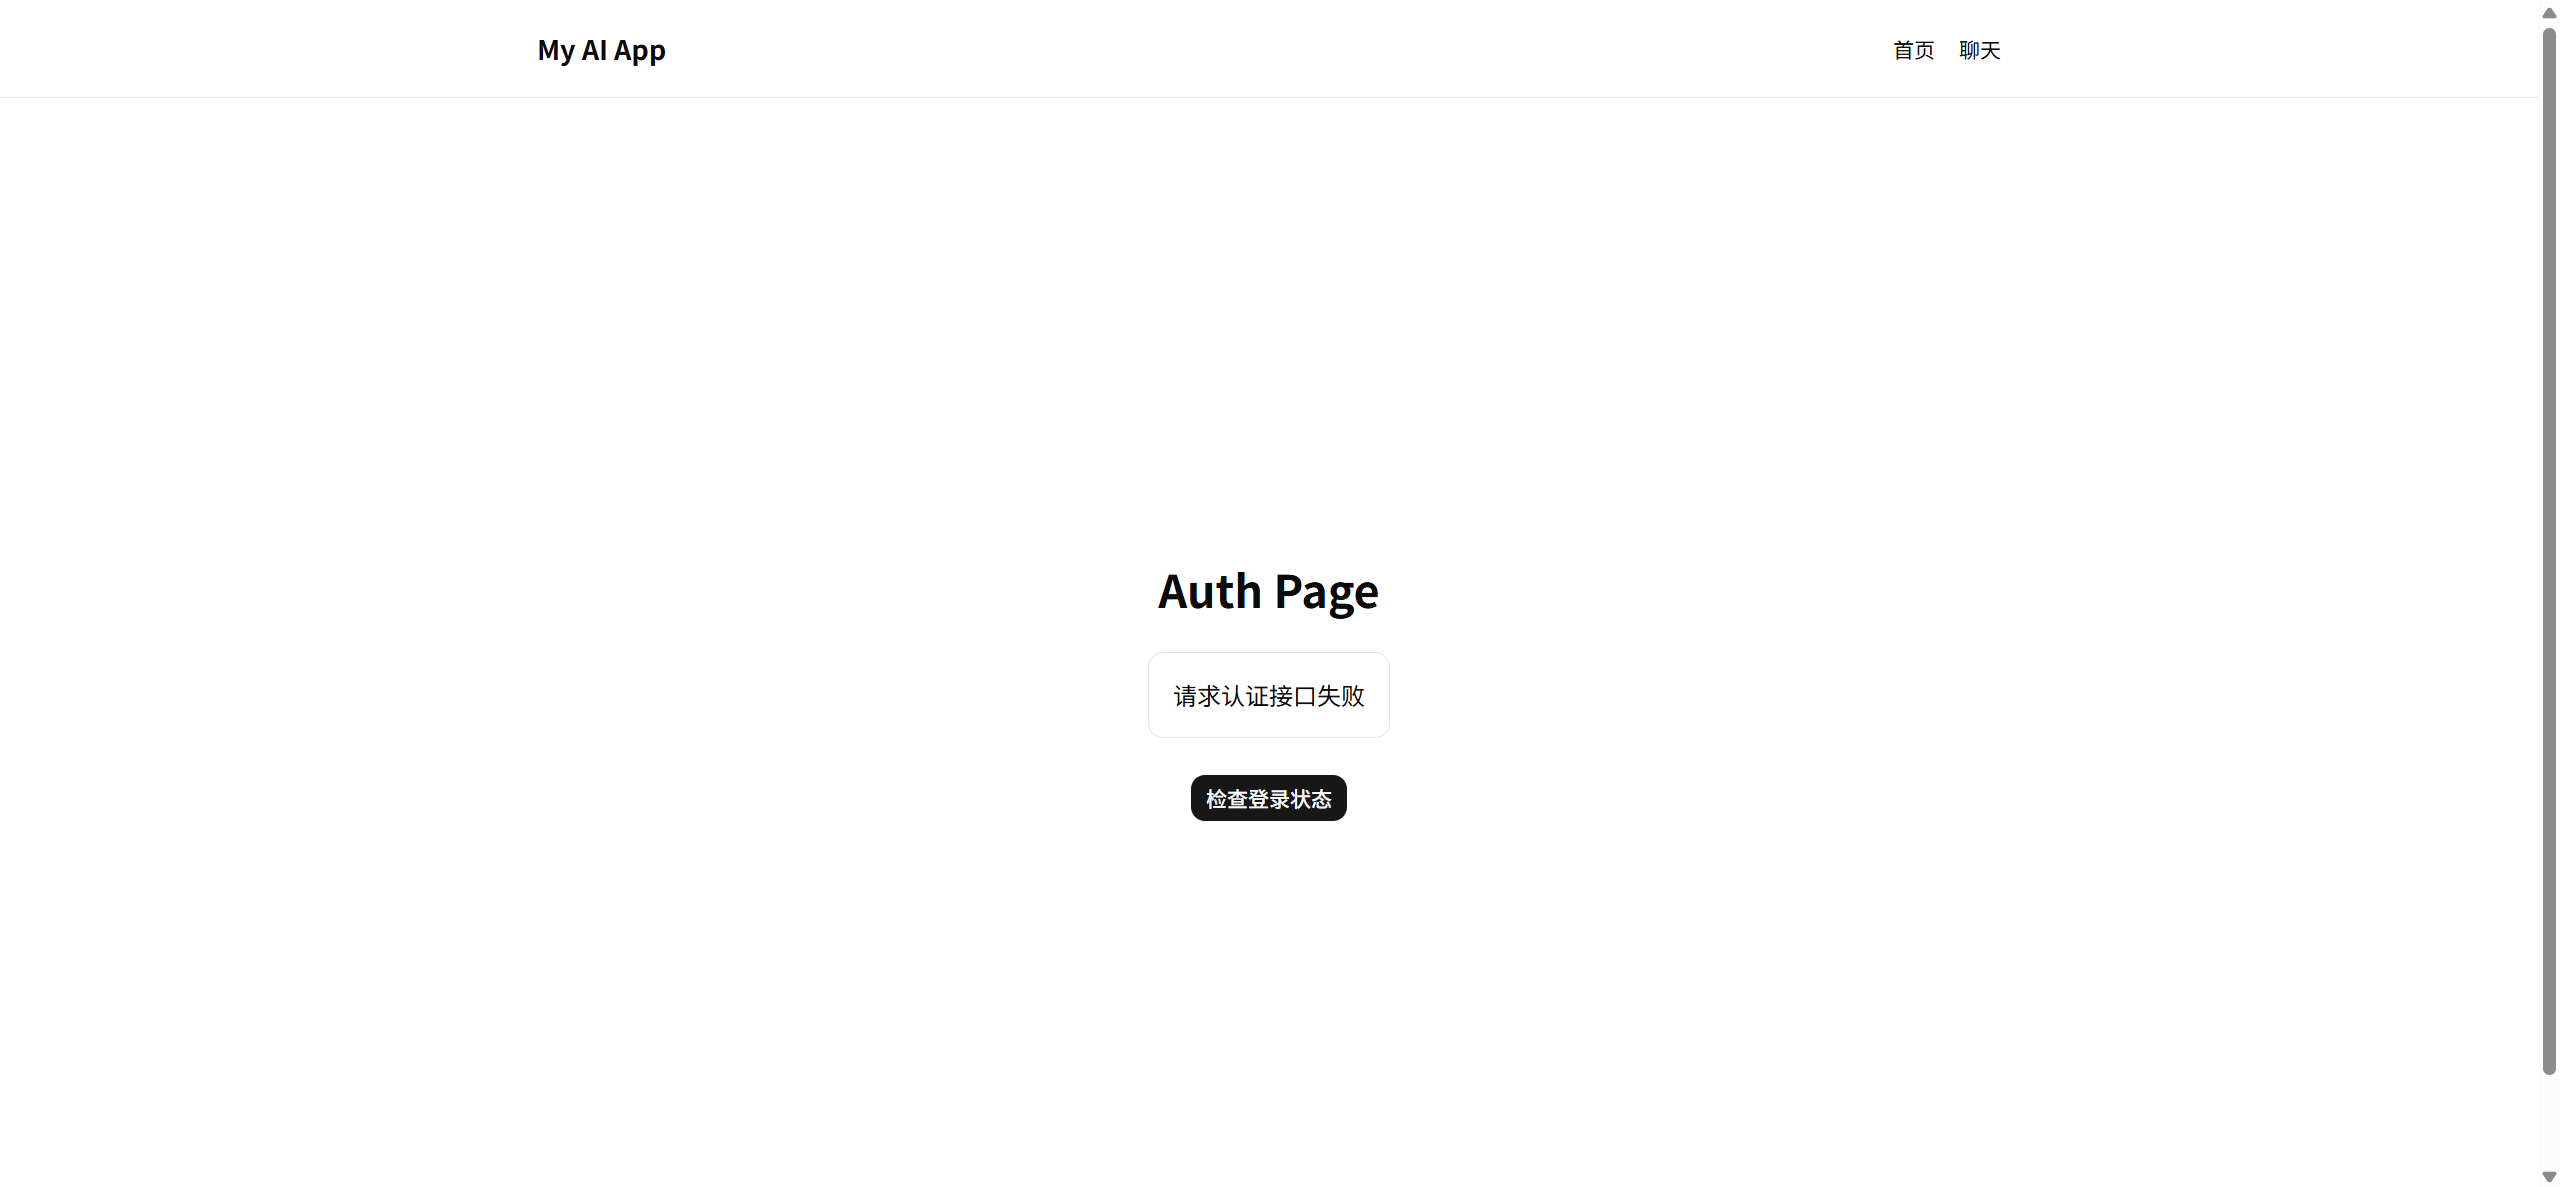
重写前端
尽管我们前面用shadcn初始化了一个还能看的过去的项目,但现在由于我们的路由已经成熟,整个页面的逻辑完全不一样了,如果还一个个文件重构那显然有点白痴了,最好的方法就是扔掉之前的项目,重新创建一个.
我们先保留之前好不容易写出来的dockerfile和.dockerignore文件,然后在根目录文件夹中运行下述命令,选择文件夹名字为frontend,一键完成,再将dockerfile拖回去,这次我们顺便换个主题风格:
1
| pnpm dlx shadcn@latest init --preset b2HRG489Am --base radix --template next --pointer
|
可以看到,上述命令一键指定了要用的组件框架和模板.
heyapi使用
我们之前的前端用的是非常拉跨的编写方式,甚至把api全部写在api.ts中一个个保存,这种写法显然不利于后期的扩展.好在我们有heyapi库,能够自动根据后端生成的openapi来生成优美的前端api调用组件.
首先,在frontend文件夹下面安装heyapi库:
1
2
| pnpm add @hey-api/client-next
pnpm add -D @hey-api/openapi-ts
|
在 package.json 中加入新命令以快速生成api.
1
2
3
4
5
| {
"scripts": {
"api:generate": "openapi-ts"
}
}
|
在前端根目录创建openapi-ts.config.ts文件,这个文件说明了我们从哪里获取openapi文档,又将输出的方法放到哪个文件夹中:
1
2
3
4
5
6
7
8
9
10
11
12
| import { defineConfig } from "@hey-api/openapi-ts"
export default defineConfig({
input: "http://localhost:8000/api/openapi.json",
output: "lib/api/generated",
plugins: [
{
name: "@hey-api/client-next",
runtimeConfigPath: "./lib/api/hey-api",
},
],
})
|
plugins字段是hey-api适配next.js的插件,不是必须要用到的,需要我们在lib文件夹中的api文件夹中新建一个hey-api.ts文件,内容如下:
1
2
3
4
5
6
7
| import type { Config } from "./generated/client/types.gen"
export const createClientConfig = (config: Config): Config => ({
...config,
baseUrl: "http://localhost:8000",
})
|
运行以下命令即可生成所有api:
看一下generated/sdk.gen.ts里的路由,简直丑陋到不可直视的地步:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
| // This file is auto-generated by @hey-api/openapi-ts
import { type Client, type ClientMeta, type Options as Options2, type RequestResult, type TDataShape, urlSearchParamsBodySerializer } from './client';
import { client } from './client.gen';
export type Options<TData extends TDataShape = TDataShape, ThrowOnError extends boolean = boolean, TResponse = unknown> = Options2<TData, ThrowOnError, TResponse> & {
/**
* You can provide a client instance returned by `createClient()` instead of
* individual options. This might be also useful if you want to implement a
* custom client.
*/
client?: Client;
/**
* You can pass arbitrary values through the `meta` object. This can be
* used to access values that aren't defined as part of the SDK function.
*/
meta?: keyof ClientMeta extends never ? Record<string, unknown> : ClientMeta;
};
/**
* Register User
*/
export const registerUserApiUserRegisterPost = <ThrowOnError extends boolean = false>(options: Options<RegisterUserApiUserRegisterPostData, ThrowOnError>): RequestResult<RegisterUserApiUserRegisterPostResponses, RegisterUserApiUserRegisterPostErrors, ThrowOnError> => (options.client ?? client).post<RegisterUserApiUserRegisterPostResponses, RegisterUserApiUserRegisterPostErrors, ThrowOnError>({
url: '/api/user/register',
...options,
headers: {
'Content-Type': 'application/json',
...options.headers
}
});
/**
* Homepage
*/
export const homepageApiUserMeGet = <ThrowOnError extends boolean = false>(options?: Options<HomepageApiUserMeGetData, ThrowOnError>): RequestResult<HomepageApiUserMeGetResponses, unknown, ThrowOnError> => (options?.client ?? client).get<HomepageApiUserMeGetResponses, unknown, ThrowOnError>({
security: [{ scheme: 'bearer', type: 'http' }],
url: '/api/user/me',
...options
});
/**
* Chat
*/
export const chatApiUserMeChatPost = <ThrowOnError extends boolean = false>(options: Options<ChatApiUserMeChatPostData, ThrowOnError>): RequestResult<ChatApiUserMeChatPostResponses, ChatApiUserMeChatPostErrors, ThrowOnError> => (options.client ?? client).post<ChatApiUserMeChatPostResponses, ChatApiUserMeChatPostErrors, ThrowOnError>({
security: [{ scheme: 'bearer', type: 'http' }],
url: '/api/user/me/chat',
...options
});
/**
* Get Chat List
*/
export const getChatListApiUserMeMessagesGet = <ThrowOnError extends boolean = false>(options?: Options<GetChatListApiUserMeMessagesGetData, ThrowOnError>): RequestResult<GetChatListApiUserMeMessagesGetResponses, GetChatListApiUserMeMessagesGetErrors, ThrowOnError> => (options?.client ?? client).get<GetChatListApiUserMeMessagesGetResponses, GetChatListApiUserMeMessagesGetErrors, ThrowOnError>({
security: [{ scheme: 'bearer', type: 'http' }],
url: '/api/user/me/messages',
...options
});
/**
* Health Check
*/
export const healthCheckApiUtilsHealthGet = <ThrowOnError extends boolean = false>(options?: Options<HealthCheckApiUtilsHealthGetData, ThrowOnError>): RequestResult<HealthCheckApiUtilsHealthGetResponses, unknown, ThrowOnError> => (options?.client ?? client).get<HealthCheckApiUtilsHealthGetResponses, unknown, ThrowOnError>({ url: '/api/utils/health', ...options });
/**
* Login Access Token
*/
export const loginAccessTokenApiLoginAccessTokenPost = <ThrowOnError extends boolean = false>(options: Options<LoginAccessTokenApiLoginAccessTokenPostData, ThrowOnError>): RequestResult<LoginAccessTokenApiLoginAccessTokenPostResponses, LoginAccessTokenApiLoginAccessTokenPostErrors, ThrowOnError> => (options.client ?? client).post<LoginAccessTokenApiLoginAccessTokenPostResponses, LoginAccessTokenApiLoginAccessTokenPostErrors, ThrowOnError>({
...urlSearchParamsBodySerializer,
url: '/api/login/access-token',
...options,
headers: {
'Content-Type': 'application/x-www-form-urlencoded',
...options.headers
}
});
|
尽管是自动生成的,但这个名字也太丑了,不过仔细一看可以发现,这些路由丑陋的前缀就是所写的注释,而这个注释是什么呢,仔细一看,这不就是我们在后端所写的函数名字吗:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| # 消息列表
@router.get(
"/me/messages",
response_model=list[ChatMessagePublic],
)
def get_chat_list(
session: SessionDep,
current_user: CurrentUser,
offset: Annotated[int, Query(ge=0)] = 0,
limit: Annotated[int, Query(ge=1, le=20)] = 10,
) -> Any:
statement = (
select(ChatMessage)
.where(ChatMessage.user_id == current_user.id)
.order_by(desc(ChatMessage.created_at))
.offset(offset=offset)
.limit(limit=limit)
)
chatlist = session.exec(statement).all()
return chatlist
|
而名字的后半部分就是路由路径,这么看来,还是很好记忆的.
fastapi再显神威
不过,鉴于我糟糕的起名品味,只保留后半部分的路由名字和方法就足够了,一个简单粗暴的方式是,fastapi支持在函数名中直接指定自动生成的函数名字:
1
2
3
4
| @router.get(
"/api/user/me",
operation_id="getCurrentUser"
)
|
尽管我们路由不多,一个个写也还耗得起,但日后要修改路由的时候那不又得重新搞一次,这还是太麻烦了.
好在fastapi还有一键生成的写法:
1
2
3
4
5
6
7
8
9
| from fastapi import FastAPI
from fastapi.routing import APIRoute
from pydantic import BaseModel
def custom_generate_unique_id(route: APIRoute):
return f"{route.tags[0]}-{route.name}"
app = FastAPI(generate_unique_id_function=custom_generate_unique_id)
|
因此,我们可以重写后端的api/main.py文件,变成以下这个样子:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
| from fastapi import APIRouter
from fastapi.routing import APIRoute
from app.api.routers import utils
from app.api.routers import user
def generate_operation_id(route: APIRoute):
"""
根据路由路径生成 operationId
/api/user/me
-> ApiUserMeGet
/api/user/chat
-> ApiUserChatPost
"""
path = route.path_format
# 去掉开头 /
parts = [item for item in path.strip("/").split("/") if item]
name = "".join(
part.replace("{", "By")
.replace("}", "")
.replace("-", "_")
.split("_")[0]
.capitalize()
for part in parts
)
# HTTP方法
method = list(route.methods)[0].lower()
return name + method.capitalize()
api_router = APIRouter(generate_unique_id_function=generate_operation_id)
api_router.include_router(user.router)
api_router.include_router(utils.router)
|
然后用docker重启前后端,再用heyapi生成一次:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
| // This file is auto-generated by @hey-api/openapi-ts
import { type Client, type ClientMeta, type Options as Options2, type RequestResult, type TDataShape, urlSearchParamsBodySerializer } from './client';
import { client } from './client.gen';
export type Options<TData extends TDataShape = TDataShape, ThrowOnError extends boolean = boolean, TResponse = unknown> = Options2<TData, ThrowOnError, TResponse> & {
/**
* You can provide a client instance returned by `createClient()` instead of
* individual options. This might be also useful if you want to implement a
* custom client.
*/
client?: Client;
/**
* You can pass arbitrary values through the `meta` object. This can be
* used to access values that aren't defined as part of the SDK function.
*/
meta?: keyof ClientMeta extends never ? Record<string, unknown> : ClientMeta;
};
/**
* Register User
*/
export const apiUserRegisterPost = <ThrowOnError extends boolean = false>(options: Options<ApiUserRegisterPostData, ThrowOnError>): RequestResult<ApiUserRegisterPostResponses, ApiUserRegisterPostErrors, ThrowOnError> => (options.client ?? client).post<ApiUserRegisterPostResponses, ApiUserRegisterPostErrors, ThrowOnError>({
url: '/api/user/register',
...options,
headers: {
'Content-Type': 'application/json',
...options.headers
}
});
/**
* Homepage
*/
export const apiUserMeGet = <ThrowOnError extends boolean = false>(options?: Options<ApiUserMeGetData, ThrowOnError>): RequestResult<ApiUserMeGetResponses, unknown, ThrowOnError> => (options?.client ?? client).get<ApiUserMeGetResponses, unknown, ThrowOnError>({
security: [{ scheme: 'bearer', type: 'http' }],
url: '/api/user/me',
...options
});
/**
* Chat
*/
export const apiUserMeChatPost = <ThrowOnError extends boolean = false>(options: Options<ApiUserMeChatPostData, ThrowOnError>): RequestResult<ApiUserMeChatPostResponses, ApiUserMeChatPostErrors, ThrowOnError> => (options.client ?? client).post<ApiUserMeChatPostResponses, ApiUserMeChatPostErrors, ThrowOnError>({
security: [{ scheme: 'bearer', type: 'http' }],
url: '/api/user/me/chat',
...options
});
// ...
|
可以看到,这次的函数名字就眉清目秀多了.
之后我们要调用api,也只需要从这个文件导入这些路由函数即可,至于api的真实路径我们就不需要去了解了.由此一来,前端和后端基本完全解耦了.
路由构思
先看看我们的后端路由:
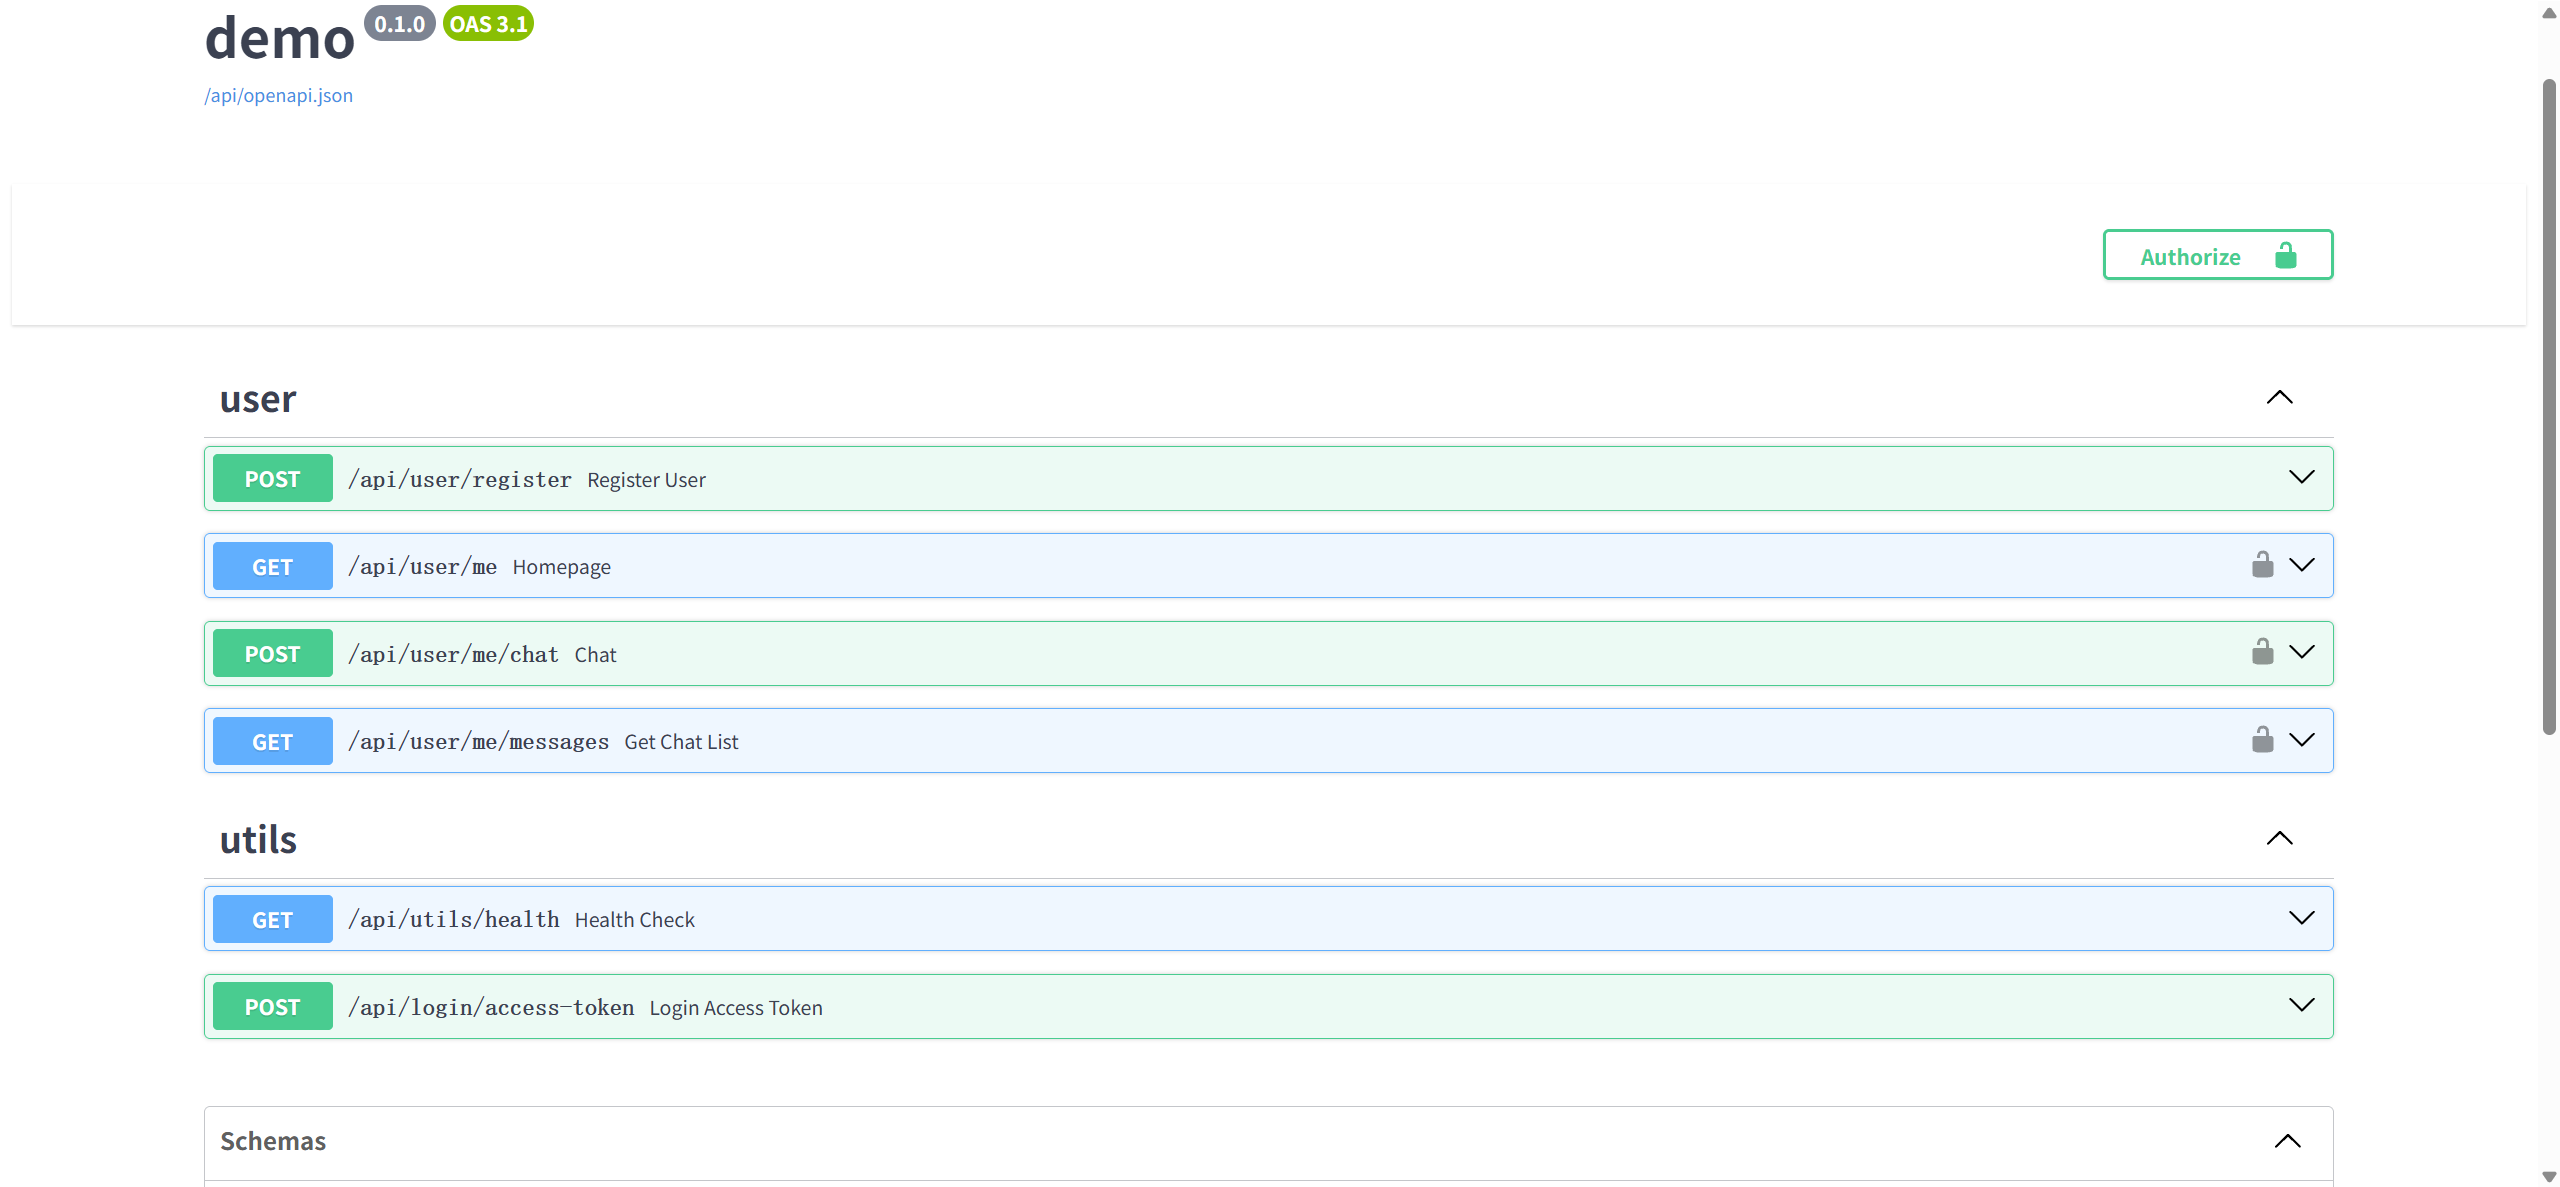
首先,我们这个智能体应该做成一个SPA(Single-Page Application,单页应用),然后用户第一次进入该网站根网址/时,点击注册按钮会被自动导引到注册界面,也就是/user/register,注册之后自动调用/api/login/access-token,获得token后转到/user/me/chat界面,在侧栏则可以通过/api/user/me/messages看到过往的聊天记录.
尽管设计确实很简单,也有很多比较草率的地方,但对于第一次设计api的新人来说,却已经比较复杂了,现在就让我们来实现它吧.
插曲: AI生成项目
正如近年的新书都喜欢加入一点AI教程部分一样,这篇教程也不例外,我们可以将上述的路由想法和之前构建的前端文件夹直接丢给AI来生成,不出意料的话,AI会生成一个尽管能跑,但是架构无比丑陋的项目:
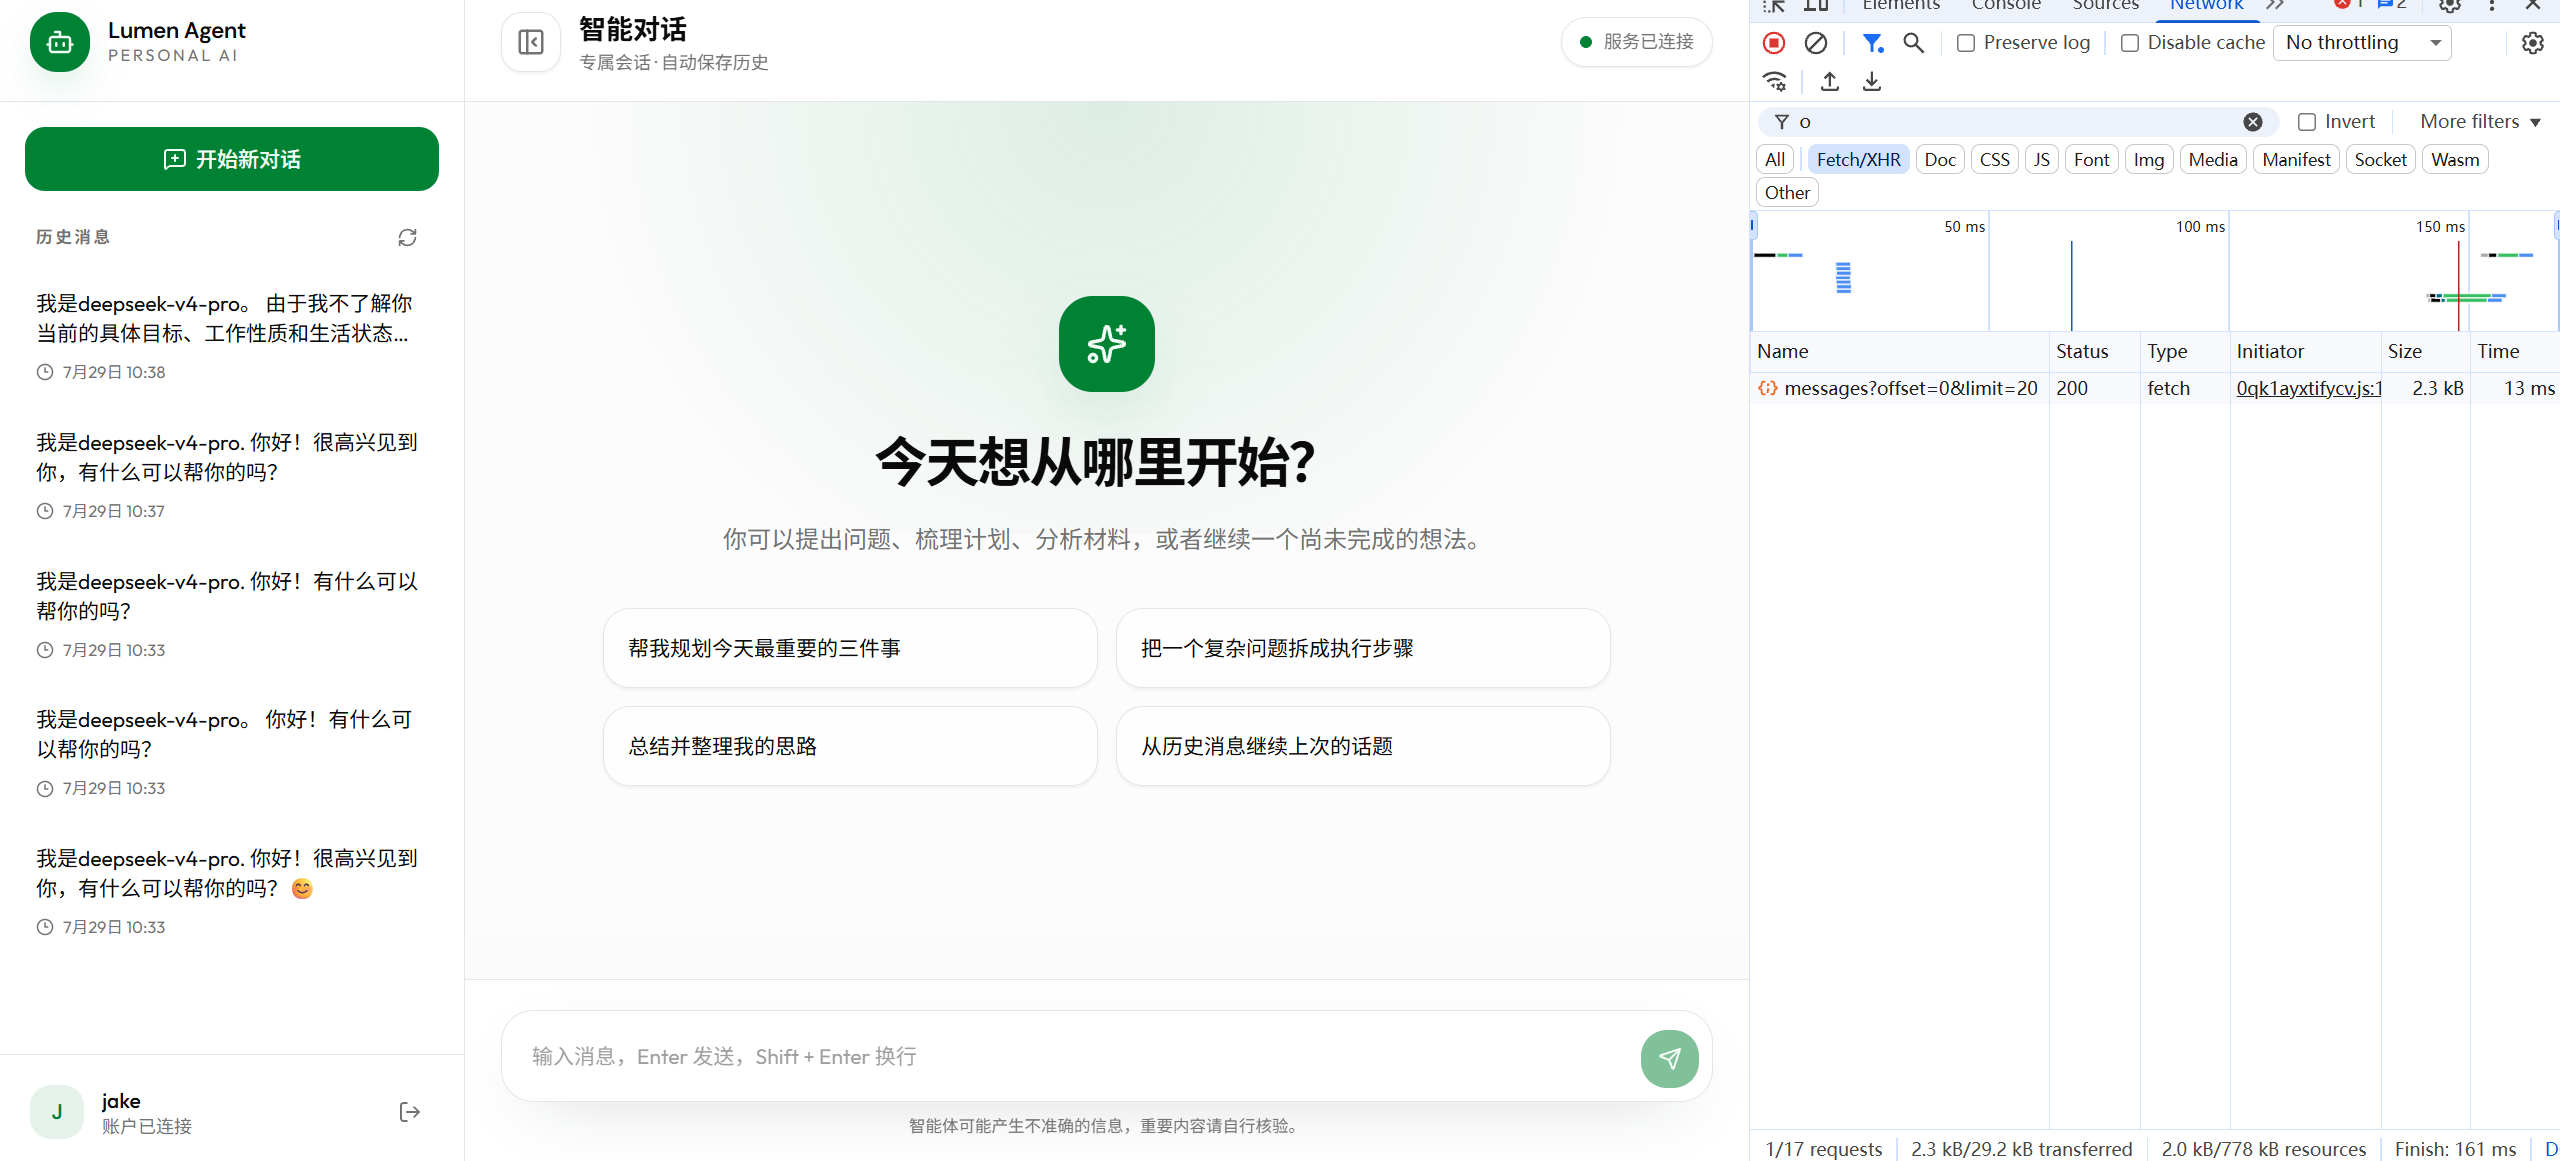
不管如何,这很难让人放心大胆的用下去呢,唯一的方法就是深入学习前端知识,能够自己搭建一个基本的项目出来,而最好的例子不就是AI生成的这些垃圾项目吗,尽管丑陋,但基本原理都摆在里头了.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
| "use client"
import { FormEvent, useState } from "react"
import Link from "next/link"
import { useRouter } from "next/navigation"
import { ArrowRight, Eye, EyeOff, LoaderCircle } from "lucide-react"
import { AuthFormShell } from "@/components/auth-form-shell"
import { Button } from "@/components/ui/button"
import { getApiErrorMessage } from "@/lib/api/errors"
import { saveSession } from "@/lib/api/auth"
import { apiLoginAccessPost, apiUserRegisterPost } from "@/lib/api/generated"
export default function RegisterPage() {
const router = useRouter()
const [name, setName] = useState("")
const [password, setPassword] = useState("")
const [confirmPassword, setConfirmPassword] = useState("")
const [showPassword, setShowPassword] = useState(false)
const [error, setError] = useState("")
const [isSubmitting, setIsSubmitting] = useState(false)
async function handleSubmit(event: FormEvent<HTMLFormElement>) {
event.preventDefault()
setError("")
const normalizedName = name.trim()
if (!normalizedName) {
setError("请输入用户名。")
return
}
if (password.length < 6) {
setError("密码至少需要 6 个字符。")
return
}
if (password !== confirmPassword) {
setError("两次输入的密码不一致。")
return
}
setIsSubmitting(true)
try {
const registration = await apiUserRegisterPost({
body: { name: normalizedName, password },
})
if (registration.error) {
throw registration.error
}
const login = await apiLoginAccessPost({
body: {
username: normalizedName,
password,
grant_type: "password",
scope: "",
},
})
if (login.error || !login.data?.access_token) {
throw login.error ?? new Error("注册成功,但自动登录失败。")
}
saveSession(login.data.access_token, normalizedName)
router.replace("/user/me/chat")
} catch (requestError) {
setError(getApiErrorMessage(requestError, "注册失败,请检查信息后重试。"))
} finally {
setIsSubmitting(false)
}
}
return (
<AuthFormShell
eyebrow="Create account"
title="创建你的账户"
description="注册完成后系统会自动登录,并带你进入专属聊天空间。"
>
<form onSubmit={handleSubmit} className="space-y-5">
<label className="block space-y-2">
<span className="text-sm font-medium">用户名</span>
<input
value={name}
onChange={(event) => setName(event.target.value)}
autoComplete="username"
className="h-12 w-full rounded-xl border bg-background px-4 text-sm shadow-xs transition placeholder:text-muted-foreground/70 focus:border-primary focus:ring-4 focus:ring-primary/10 focus:outline-none"
placeholder="输入你的用户名"
/>
</label>
// 省略一大段代码
{error ? (
<p role="alert" className="rounded-xl border border-destructive/20 bg-destructive/8 px-4 py-3 text-sm text-destructive">
{error}
</p>
) : null}
<Button type="submit" size="lg" className="h-12 w-full rounded-xl text-base" disabled={isSubmitting}>
{isSubmitting ? <LoaderCircle className="animate-spin" /> : null}
注册并进入
{!isSubmitting ? <ArrowRight /> : null}
</Button>
<p className="text-center text-sm text-muted-foreground">
已有账户?{" "}
<Link href="/user/login" className="font-medium text-foreground underline-offset-4 hover:underline">
直接登录
</Link>
</p>
</form>
</AuthFormShell>
)
}
|
不过,即便再怎么说AI写的不行,要自己来写出上面的代码也是不太可能的,这里面的状态管理和组件UI没有长期的学习经历的话,就跟看天书没有太大区别.
总结
尽管如此,好在前端现在已经足够自动化了,测试文件可以通过录制浏览器操作生成,构建流程可以用next命令一键完成,必要的组件都可以直接复用shadcn的,API请求函数可以用hey-api生成.
但剩下的内容才是重中之重,要想完成我们这个智能体的前端,我们还需要学习以下知识:
- next.js的路由方法
- React的状态管理
- 使用tailwind css修饰shadcn带入的组件
ch10: 重构前端?
(8/20): 原谅我之前的不识好歹,真要掌握上面三个知识点还是太累了,但我现在时间却不太够用了,毕竟还想拿这个项目去面试的时候混一混呢~,所以先拿AI占个坑,待日后再战
不管怎样,我先拿AI混了一版出来:
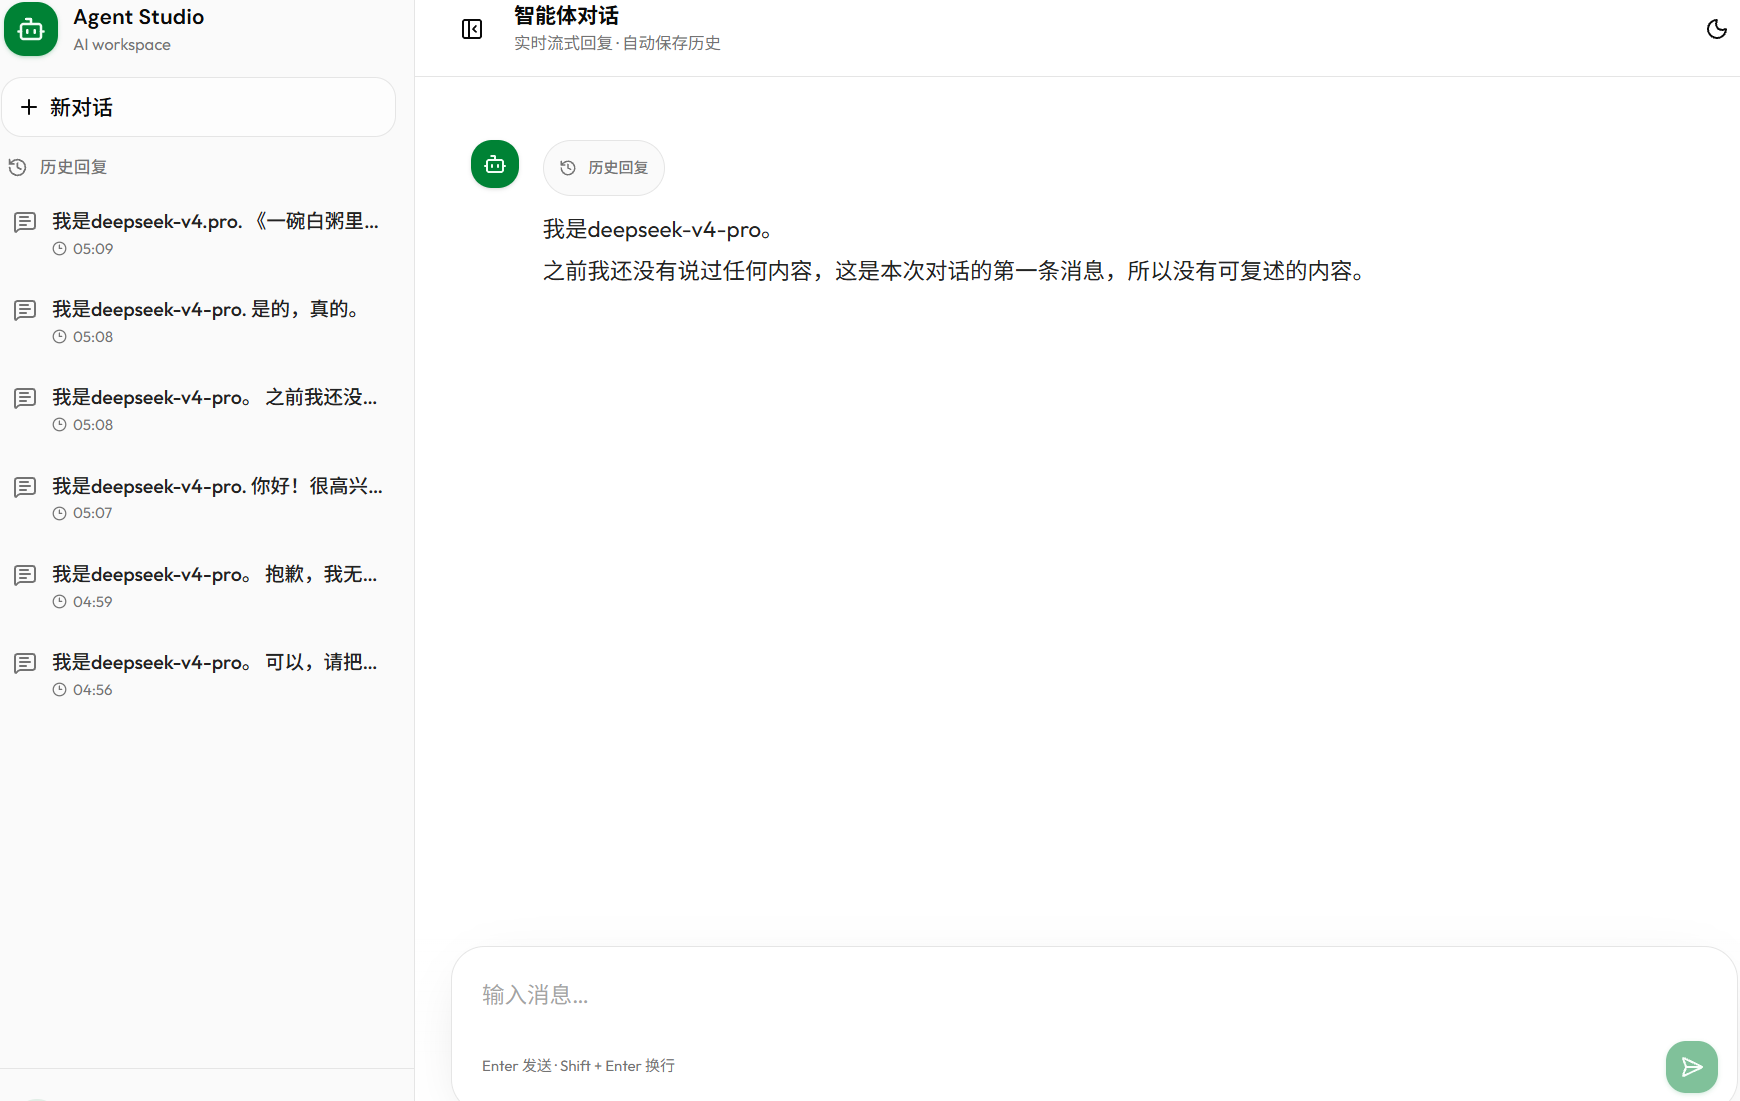
尽管AI已经很努力了,但我的后端肉眼可见的有以下不足:
- 不支持多轮对话,无法根据以前的消息来回答
- 不支持对话组,每次对话没有一个统一的id
- 没有保存用户的提问信息,也没能将thinking和content分开输出
- 没有异常处理,也没有限制用户的使用量和调用额度.
Agent优化
ch11: 实现多轮对话
API构思
在修改之前,先再想想我们要实现哪些API才可以让这个应用变成真正的Agent,先看看之前的API:
utils.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
| # 省略一大堆导入
router = APIRouter(tags=["utils"])
TOKEN_EXPIRE_MINUTES: int = 60 * 24 * 8
@router.get("/utils/health")
async def health_check(session: SessionDep) -> bool:
return check_db(session=session)
@router.post("/login/access-token")
def login_access_token(
session: SessionDep, form_data: Annotated[OAuth2PasswordRequestForm, Depends()]
) -> Token:
user = check_user(
session=session,
name=form_data.username,
password=form_data.password,
)
if not user:
raise HTTPException(status_code=400, detail="Incorrect name or password")
elif not user.is_active:
raise HTTPException(status_code=400, detail="Inactive user")
token_expires = timedelta(minutes=TOKEN_EXPIRE_MINUTES)
return Token(
access_token=security.create_token(
user.id,
expires_delta=token_expires,
)
)
|
很显然,healthcheck是完全不必要的,毕竟这个活儿最多是给程序员干的,用户不可能花时间去看数据库是否连接正常,所以可以直接删掉,留一个token获取接口就可以了.
重构后的utils.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| from typing import Annotated
from datetime import timedelta
from fastapi import APIRouter, Depends, HTTPException
from fastapi.security import OAuth2PasswordRequestForm
from app.crud import check_user
from app.api.deps import SessionDep
from app.models import Token
from app.core import security
router = APIRouter(tags=["utils"])
TOKEN_EXPIRE_MINUTES: int = 60 * 24 * 8
@router.post("/access-token")
def login_access_token(
session: SessionDep, form_data: Annotated[OAuth2PasswordRequestForm, Depends()]
) -> Token:
user = check_user(
session=session,
name=form_data.username,
password=form_data.password,
)
if not user:
raise HTTPException(status_code=400, detail="Incorrect name or password")
elif not user.is_active:
raise HTTPException(status_code=400, detail="Inactive user")
token_expires = timedelta(minutes=TOKEN_EXPIRE_MINUTES)
return Token(
access_token=security.create_token(
user.id,
expires_delta=token_expires,
)
)
|
user.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
| # 省略一大堆导入
router = APIRouter(prefix="/user", tags=["user"])
# response_model用于过滤密码
@router.post("/register", response_model=UserPublic)
def register_user(session: SessionDep, user_in: UserRegister) -> User:
user = crud.get_user_by_name(session=session, name=user_in.name)
if user:
raise HTTPException(status_code=400, detail="Name exists")
user_register = UserRegister.model_validate(user_in)
user = crud.register_user(session=session, user_register=user_register)
return user
# 用户主页
@router.get("/me", response_model=UserPublic)
def homepage(current_user: CurrentUser) -> User:
return current_user
# 新对话
@router.post("/me/chat")
async def chat(
user_message: str,
session: SessionDep,
current_user: CurrentUser,
) -> StreamingResponse:
if not current_user.id:
raise HTTPException(
status_code=401,
detail="Invalid authenticated user",
)
return StreamingResponse(
stream_agent(current_user.id, user_message, session),
headers={
"Cache-Control": "no-cache",
},
)
# 消息列表
@router.get(
"/me/messages",
response_model=list[ChatMessagePublic],
)
def get_chat_list(
session: SessionDep,
current_user: CurrentUser,
offset: Annotated[int, Query(ge=0)] = 0,
limit: Annotated[int, Query(ge=1, le=20)] = 10,
) -> Any:
statement = (
select(ChatMessage)
.where(ChatMessage.user_id == current_user.id)
.order_by(desc(ChatMessage.created_at))
.offset(offset=offset)
.limit(limit=limit)
)
chatlist = session.exec(statement).all()
return chatlist
|
对于user路由,我们可以发现用户和对话需要拆分成两个文件users.py和messages.py才更为合理一点.
user.py里保留的路由如下:
- Post
api/users 注册用户 - Get
api/users/me 进入用户主页
这样一来,我们之后加入用户主页和充值界面也简单不少,目前来说这两个路由就够了.
重构后的users.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| from fastapi import APIRouter, HTTPException
from app.api.deps import SessionDep, CurrentUser
from app.models import User, UserPublic, UserRegister
from app import crud
router = APIRouter(prefix="/users", tags=["users"])
# response_model用于过滤不必要的信息返回
@router.post("", response_model=UserPublic)
def register_user(session: SessionDep, user_in: UserRegister) -> User:
user = crud.get_user_by_name(session=session, name=user_in.name)
if user:
# 由于没有邮箱,所以只好用名字来进行唯一标识
raise HTTPException(status_code=400, detail="Name exists")
user_register = UserRegister.model_validate(user_in)
user = crud.register_user(session=session, user_register=user_register)
return user
# 获取用户个人信息
@router.get("/me", response_model=UserPublic)
def homepage(current_user: CurrentUser) -> User:
return current_user
|
messages.py里目前的路由实际上就是一个路由:
我们目前需要实现的主要功能如下:
- 开启新对话
- 查看对话列表并能够加入以往的对话继续发言
所以我们需要把路由重构如下:
- Get
api/conversations 获取对话列表,可以搞成只获取第一个问题的前10个字作为标题的形式 - Get
api/messages?conversation_id=xxx 根据id获取单个对话 - Post
api/messages 我们可能在已有对话中继续发消息,也可能是新建对话,还可能是新建了之后不发消息.- 对于新对话,我们可以弄成先将conversation_id置为None,直到真正发消息时才重置conversation_id创建数据表;而对于老对话,复用原来的conversation_id就可以了.
由于这些改动都需要动models.py,所以先不给出最终版本.
至于多轮对话,我们也可以简单地根据conversation_id是否为None来判断,如果不为None,则选取最新的两对消息打包发送过去即可,至于更复杂的写法就留到后面写吧.
如此一来,我们的api就重构完成了,很明显的比之前清晰了很多.现在轮到我们去修改其他的几个文件,好在我们之前的重构非常成功,大部分工具函数是不用动的,不然有得头疼了.
models.py重构
首先,看一下我们之前的models.py文件:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
| class UserBase(SQLModel):
name: str | None = Field(default=None, max_length=255)
is_active: bool = True
class UserRegister(SQLModel):
password: str
name: str = Field(default=None, max_length=255)
class UserCreate(UserBase):
password: str = Field(min_length=8, max_length=16)
class UserPublic(UserBase):
id: int | None
created_at: datetime | None = None
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str
created_at: datetime | None = Field(
default_factory=get_datetime,
)
chats: list["ChatMessage"] = Relationship(
back_populates="user",
cascade_delete=True,
)
class Message(SQLModel):
message: str
class ChatMessage(SQLModel, table=True):
chat_id: int | None = Field(default=None, primary_key=True)
content: str | None = None
created_at: datetime | None = Field(
default_factory=get_datetime,
)
user_id: int | None = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="chats")
class ChatMessagePublic(SQLModel):
chat_id: int
content: str | None
created_at: datetime | None
class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str | None = None
|
我们需要进行下述修改:
- UserCreate实际上并没有用到,他与UserRegister是冲突的,所以只用UserRegister就行了,这属于早期的决策失误,
如果以后我能出书的话再直接去掉😉 - UserRegister更好的写法是直接继承UserBase,这样一来,我就要把is_active字段直接拿出来,单独放入User表和UserPublic表中
- 之前的
ChatMessage过于语义不明了,所以改成了更为合理的Conversation,对应的属性也做了相应的调整,加入了updated_at属性,用户可以在对话历史中重启对话 - 有了Conversation,那么就需要有单独的Message,表示本轮对话中的一条消息,所以我们需要再设置一个一对多关系,并单独实现Message
最后的重构效果如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
| from enum import Enum
from sqlmodel import Relationship, SQLModel, Field, Text
from datetime import UTC, datetime
def get_datetime() -> datetime:
return datetime.now(UTC)
# User
class UserBase(SQLModel):
name: str = Field(min_length=1, max_length=30)
class UserRegister(UserBase):
# 写成1是为了偷懒~
password: str = Field(min_length=1, max_length=15)
class UserPublic(UserBase):
id: int
created_at: datetime
is_active: bool = True
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
is_active: bool = True
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
# Conversation
class ConversationCreate(SQLModel):
title: str | None = Field(default=None, min_length=1, max_length=120)
class ConversationBase(SQLModel):
title: str | None = Field(default="新对话", min_length=1, max_length=120)
class ConversationPublic(ConversationBase):
conversation_id: int
created_at: datetime
updated_at: datetime
class Conversation(ConversationBase, table=True):
conversation_id: int | None = Field(default=None, primary_key=True)
user_id: int = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="conversations")
messages: list["Message"] = Relationship(
back_populates="conversation",
cascade_delete=True,
)
created_at: datetime = Field(
default_factory=get_datetime,
)
updated_at: datetime = Field(
default_factory=get_datetime,
)
# Message
# 用于判断消息类型,从而区分用户提问和AI回答
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
SYSTEM = "system"
TOOL = "tool"
class ChatRequest(SQLModel):
# 根据id是否为空可以判断是否为已有对话
conversation_id: int | None = None
content: str = Field(min_length=1, max_length=20000)
class MessageBase(SQLModel):
conversation_id: int = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
class MessagePublic(MessageBase):
conversation_id: int
message_id: int
created_at: datetime
class Message(MessageBase, table=True):
message_id: int = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: Conversation | None = Relationship(
back_populates="messages",
)
class ConversationDetail(ConversationPublic):
messages: list[MessagePublic] = Field(default_factory=list)
# Token
class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str
|
agent重构
考虑到要实现多轮对话,我们就需要进入utils文件夹中加入多轮对话的函数,先看看原来的实现:
chat.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
| from typing import Generator
from openai import Stream, OpenAI
from openai.types.chat import ChatCompletionChunk
def messages(user_message: str, system_prompt: str) -> list[dict]:
return [
{
"role": "system",
"content": system_prompt,
},
{
"role": "user",
"content": user_message,
},
]
def create_client(api_key: str, url: str):
return OpenAI(api_key=api_key, base_url=url)
def stream_response(
stream: Stream[ChatCompletionChunk],
) -> Generator[str, None, None]:
for chunk in stream:
# 某些 chunk 可能没有 choices
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
if delta.content:
yield delta.content
def create_stream(
client,
model: str,
user_message: str,
system_prompt: str,
):
stream = client.chat.completions.create(
model=model,
messages=messages(user_message, system_prompt),
stream=True,
reasoning_effort="high",
)
return stream
|
很明显,这个文件比较基础,唯一一个要修改的地方反而是这个messages函数,折腾大半圈只返回了一个列表,为了方便我们以后进行多轮对话而不多加函数,最好的方法是把这个函数变成一个可插入的列表,具体写法如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
| # history代表历史消息
def messages(user_message: str, system_prompt: str, history) -> list[dict]:
return [
{
"role": "system",
"content": system_prompt,
},
history,
{
"role": "user",
"content": user_message,
},
]
|
而我们的create_stream函数也应该直接接收这个messages函数,而非再将系统提示词和用户提示词拆开.
这样一来,我们需要把chat.py改名为stream.py才更为合理一点,所以一个完整的重构文件如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| from typing import Generator
from openai import Stream, OpenAI
from openai.types.chat import ChatCompletionChunk
# history代表历史消息
def messages(user_message: str, system_prompt: str, history) -> list[dict]:
return [
{
"role": "system",
"content": system_prompt,
},
history,
{
"role": "user",
"content": user_message,
},
]
def create_client(api_key: str, url: str):
return OpenAI(api_key=api_key, base_url=url)
def create_stream(
client: OpenAI,
model: str,
messages,
):
stream = client.chat.completions.create(
model=model,
messages=messages,
stream=True,
reasoning_effort="medium",
)
return stream
def stream_response(
stream: Stream[ChatCompletionChunk],
) -> Generator[str, None, None]:
for chunk in stream:
# 某些 chunk 可能没有 choices
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
if delta.content:
yield delta.content
|
client.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| from app.utils.chat import stream_response, create_stream, create_client
from typing import Generator
from app.core.config import settings
from app.crud import stream_and_save
from sqlmodel import Session
client = create_client(settings.DEEPSEEK_API_KEY, settings.DEEPSEEK_URL)
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
def stream_agent(
user_id: int | None,
user_message: str,
session: Session,
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
) -> Generator[str, None, None]:
# 创建流式请求。
stream = create_stream(client, model, user_message, system_prompt)
chunks = stream_response(stream)
yield from stream_and_save(
chunks=chunks,
user_id=user_id,
session=session,
)
|
可以看到,为了实现多轮对话,这个stream_agent函数相当关键,目前我们不好动他,因为我们需要从数据库中获取历史消息,这就需要我们先去修改crud.py后再回来.
crud.py重构
原文件如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
| from app.core.security import (
verify_password,
hashing_password,
)
from fastapi import HTTPException
from sqlmodel import Session, select
from app.models import User, UserRegister, Conversation
# Dummy hash to use for timing attack prevention when user is not found
DUMMY_HASH = "$argon2id$v=19$m=65536,t=3,p=4$MjQyZWE1MzBjYjJlZTI0Yw$YTU4NGM5ZTZmYjE2NzZlZjY0ZWY3ZGRkY2U2OWFjNjk"
def check_db(*, session: Session):
result = session.exec(select(1)).one()
return result == 1
def register_user(*, session: Session, user_register: UserRegister) -> User:
user_store = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
session.add(user_store)
session.commit()
session.refresh(user_store)
return user_store
def get_user_by_name(*, session: Session, name: str) -> User | None:
statement = select(User).where(User.name == name)
user = session.exec(statement).first()
return user
def check_user(session: Session, name: str, password: str) -> User | None:
db_user = get_user_by_name(session=session, name=name)
if not db_user:
verify_password(password, DUMMY_HASH)
return None
verified = verify_password(password, db_user.hashed_password)
if not verified:
return None
return db_user
# 工具函数
def save_chat_message(
*, session: Session, user_id: int | None, content: str
) -> Conversation:
message = Conversation(
user_id=user_id,
content=content,
)
session.add(message)
session.commit()
session.refresh(message)
return message
def stream_and_save(*, session: Session, user_id: int | None, chunks):
collected_chunks: list[str] = []
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
full_content = "".join(collected_chunks)
if not user_id:
raise HTTPException(status_code=404, detail="User not found")
if full_content:
save_chat_message(
user_id=user_id,
content=full_content,
session=session,
)
|
首先第一个函数由于用不到了所以可以直接删除,至于跟用户相关的函数都完全不用动,省了不少事,如此一来,就剩下agent部分了,先将两个函数修正到正确的格式,对于第一个函数save_chat_message,简化名字为save_message,我们这次要根据conversation_id是否为空来判断消息的存储,不过这个判断肯定不能由这个函数来搞,而是要在更高一级解决,所以我们就简单的增加参数即可,先看一下之前的models.py:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
| class ConversationBase(SQLModel):
title: str | None = Field(default="新对话", min_length=1, max_length=120)
class Conversation(ConversationBase, table=True):
conversation_id: int | None = Field(default=None, primary_key=True)
user_id: int = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="conversations")
messages: list["Message"] = Relationship(
back_populates="conversation",
cascade_delete=True,
)
created_at: datetime = Field(
default_factory=get_datetime,
)
updated_at: datetime = Field(
default_factory=get_datetime,
)
class MessageBase(SQLModel):
conversation_id: int = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
class Message(MessageBase, table=True):
message_id: int | None = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: Conversation | None = Relationship(
back_populates="messages",
)
|
非常明显,如果全都放到函数参数中是要完蛋的,最好的方法就是接收一个Conversation变量.
第二个stream_and_save函数才是关键,对于流的输入我们可以保持原样不动,但与其如此不如单独将流部分作为函数拆分出去放到stream.py中,不过这还是放到下一章中解决吧,不然就乱成一团了.
由于这个函数只负责接收AI的输出,所以角色可以固定为Assitant,那么这个函数也就和crud没有关系,应该直接放到stream.py中更好:
修改后的stream.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
| from typing import Generator
from openai import Stream, OpenAI
from openai.types.chat import ChatCompletionChunk
from sqlmodel import Session
from app.crud import save_message
from app.models import Conversation, MessageRole
# history代表历史消息
def messages(user_message: str, system_prompt: str, history) -> list[dict]:
return [
{
"role": "system",
"content": system_prompt,
},
history,
{
"role": "user",
"content": user_message,
},
]
def create_client(api_key: str, url: str):
return OpenAI(api_key=api_key, base_url=url)
def create_stream(
client: OpenAI,
model: str,
messages,
):
stream = client.chat.completions.create(
model=model,
messages=messages,
stream=True,
reasoning_effort="medium",
)
return stream
def stream_response(
stream: Stream[ChatCompletionChunk],
) -> Generator[str, None, None]:
for chunk in stream:
# 某些 chunk 可能没有 choices
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
if delta.content:
yield delta.content
def stream_and_save(*, session: Session, conversation: Conversation, chunks):
collected_chunks: list[str] = []
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
full_content = "".join(collected_chunks)
if full_content:
save_message(
role=MessageRole.ASSISTANT,
conversation=conversation,
content=full_content,
session=session,
)
|
那么,现在就剩下增加一个获取历史消息的crud接口了,获取历史消息,需要根据conversation_id来获取最后的四条消息(两对问答),一个完整的改版如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
| from typing import List
from app.core.security import (
verify_password,
hashing_password,
)
from sqlmodel import Session, select, desc
from app.models import (
Message,
MessageRole,
User,
UserRegister,
Conversation,
get_datetime,
)
# Dummy hash to use for timing attack prevention when user is not found
DUMMY_HASH = "$argon2id$v=19$m=65536,t=3,p=4$MjQyZWE1MzBjYjJlZTI0Yw$YTU4NGM5ZTZmYjE2NzZlZjY0ZWY3ZGRkY2U2OWFjNjk"
def register_user(*, session: Session, user_register: UserRegister) -> User:
user_store = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
session.add(user_store)
session.commit()
session.refresh(user_store)
return user_store
def get_user_by_name(*, session: Session, name: str) -> User | None:
statement = select(User).where(User.name == name)
user = session.exec(statement).first()
return user
def check_user(session: Session, name: str, password: str) -> User | None:
db_user = get_user_by_name(session=session, name=name)
if not db_user:
verify_password(password, DUMMY_HASH)
return None
verified = verify_password(password, db_user.hashed_password)
if not verified:
return None
return db_user
# 保存消息
def save_message(
*,
session: Session,
conversation: Conversation,
role: MessageRole,
content: str,
) -> Message:
message = Message(
conversation_id=conversation.conversation_id,
role=role,
content=content,
)
conversation.updated_at = get_datetime()
session.add(message)
session.add(conversation)
session.commit()
session.refresh(message)
return message
# 获取历史消息
def get_history_message(
*,
session: Session,
conversation: Conversation,
limit: int = 4,
) -> List[Message]:
id = conversation.conversation_id
if id is None:
return []
statement = (
select(Message)
.where(Message.conversation_id == id)
.order_by(
desc(Message.created_at),
desc(Message.message_id),
)
.limit(limit)
)
messages = list(session.exec(statement).all())
messages.reverse()
return messages
|
AI神力
剩余部分的重构超出我目前的能力范围了,改了最少三四版,但总觉得API设计有问题,怎么改都觉得模型不够美观和清晰,毕竟Github上都找不到适合我这个技术栈的人工仓库,想借鉴都没地方查呢,所以只好将这一部分交给AI解决了,最后的版本在仓库中可以看到.
我们先来看看AI的重构是怎样的,好从中学习到多轮对话的标准写法.
Agent重构
stream.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| def build_messages(
*,
system_prompt: str,
history: Sequence[Message],
) -> list[ChatCompletionMessageParam]:
messages: list[ChatCompletionMessageParam] = [
ChatCompletionSystemMessageParam(role="system", content=system_prompt)
]
for message in history:
if message.role is MessageRole.USER:
messages.append(
ChatCompletionUserMessageParam(
role="user",
content=message.content,
)
)
else:
messages.append(
ChatCompletionAssistantMessageParam(
role="assistant",
content=message.content,
)
)
return messages
|
我一开始的build_messages可是直接把history加入列表的,如今来看,确实不够美观,但这里的ChatCompletionSystemMessageParam实在是跟天书没有什么区别了,毕竟,就连官方文档里都查不到呢:
简单来说,我们平常的消息列表是这么写的:
1
2
3
4
5
6
7
8
9
10
| messages = [
{
"role": "system",
"content": "You are a helpful assistant."
},
{
"role": "user",
"content": "Hello"
}
]
|
但openAI python库在1.1.0版本中引入了更为规范的格式写法:
1
2
3
4
5
6
| from openai.types.chat import ChatCompletionSystemMessageParam
system_message: ChatCompletionSystemMessageParam = {
"role": "system",
"content": "You are a helpful assistant."
}
|
其实也很好理解,这是在通过模型强制要求要有"role": "system"字段和content字段罢了.
那么,另外两个ChatCompletionUserMessageParam和ChatCompletionMessageParam模型就很好理解了,分别对应的用户消息和总消息模型而已.
所以,上述代码只不过是先弄了一个初始化列表,然后从历史消息中将消息逐个按照角色加入列表中.
chat.py
AI给我分离了一个chat.py出来,将流式消息收发和对话分离,这确实做得很好,看一下实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
| from collections.abc import Iterator
from sqlmodel import Session
from app import crud
from app.core.db import engine
from app.models import ChatRequest, Conversation, MessageRole
TITLE_LENGTH = 10
class ConversationNotFoundError(Exception):
"""Raised when a conversation is absent or belongs to another user."""
def build_conversation_title(content: str) -> str:
normalized = " ".join(content.split())
return normalized[:TITLE_LENGTH] or "新对话"
def prepare_chat(
*,
session: Session,
user_id: int,
request: ChatRequest,
) -> Conversation:
try:
if request.conversation_id is None:
conversation = crud.create_conversation(
session=session,
user_id=user_id,
title=build_conversation_title(request.content),
)
else:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=request.conversation_id,
user_id=user_id,
)
if conversation is None:
raise ConversationNotFoundError
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.USER,
content=request.content,
)
except ConversationNotFoundError:
raise
except Exception:
session.rollback()
raise
return conversation
def stream_and_persist_assistant(
*,
conversation_id: int,
chunks: Iterator[str],
) -> Iterator[str]:
collected_chunks: list[str] = []
completed = False
try:
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
completed = True
finally:
full_content = "".join(collected_chunks)
if completed and full_content:
with Session(engine) as session:
conversation = session.get(Conversation, conversation_id)
if conversation is not None:
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
)
|
- 首先是引入了一个关于对话id的一个异常,不用说,确实很有必要.
- 接着构建一个产生标题的函数,首先设置
TITLE_LENGTH为10,然后删除首尾空白,并把连续空格、换行符、制表符统一整理成一个普通空格,然后如果截取后的标题不是空字符串,就返回标题,确实很美丽,但拆分一下的话我认为才具有可读性.
再来看一下重头戏prepare_chat:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
| def prepare_chat(
*,
session: Session,
user_id: int,
request: ChatRequest,
) -> Conversation:
try:
if request.conversation_id is None:
conversation = crud.create_conversation(
session=session,
user_id=user_id,
title=build_conversation_title(request.content),
)
else:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=request.conversation_id,
user_id=user_id,
)
if conversation is None:
raise ConversationNotFoundError
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.USER,
content=request.content,
)
except ConversationNotFoundError:
raise
except Exception:
session.rollback()
raise
return conversation
|
先捋一下思路:
- 如果请求id为None,说明是新对话,所以要先创建一个对话
- 如果请求id不为None,说明是老对话,但这个对话id既有可能是瞎编的,也有可能是失效的,还有可能是其他用户的,所以需要经过一轮判断,这也是这里的处理函数带有两个属性参数的原因,如果没找到,就抛出异常.
- 如果没有抛出异常,则保存message到与之相关联的conversation中
但关键就在这个异常上面,将ConversationNotFoundError和普通的Exception分开处理是有点扯淡了,如果没找到对话,自然不会触发数据库修改,那也就不存在rollback一说,如果触发了数据库修改commit,那也无法rollback了,所以直接合并异常处理就可以,但出于简化结构,甚至不需要异常处理都可以,于是,整个代码处理如下,看上去也清晰多了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| def prepare_chat(
*,
session: Session,
user_id: int,
request: ChatRequest,
) -> Conversation:
if request.conversation_id is None:
conversation = crud.create_conversation(
session=session,
user_id=user_id,
title=build_conversation_title(request.content),
)
else:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=request.conversation_id,
user_id=user_id,
)
if conversation is None:
raise ConversationNotFoundError
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.USER,
content=request.content,
)
return conversation
|
最后剩一个保存AI输出的函数,先看看样式:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| def stream_and_persist_assistant(
*,
conversation_id: int,
chunks: Iterator[str],
) -> Iterator[str]:
collected_chunks: list[str] = []
completed = False
try:
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
completed = True
finally:
full_content = "".join(collected_chunks)
if completed and full_content:
with Session(engine) as session:
conversation = session.get(Conversation, conversation_id)
if conversation is not None:
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
)
|
首先是接收来自stream_agent函数的chunks,然后拼接成完整的文本,再存入数据库中
但是,这里重新弄个session出来显然是有点离谱了,明明复用SessionDep才是明智的选择,而且呢,明明不需要异常处理却加个try-finally链还是太蠢了,重构版如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| def stream_and_save(
*,
session: Session,
conversation_id: int,
chunks: Iterator[str],
) -> Iterator[str]:
collected_chunks: list[str] = []
for chunk in chunks:
if not chunk:
continue
collected_chunks.append(chunk)
yield chunk
full_content = "".join(collected_chunks)
if full_content:
conversation = session.get(Conversation, conversation_id)
if conversation is not None:
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
)
|
if full_content和if full_content is not None的区别是什么呢
当full_content为空字符串"“时,前者依然判定为假,但后者判定为真
核心文件重构
crud.py
用户部分的函数都没有改动,但对话部分确实需要一点经验来处理:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
| def create_conversation(
*,
session: Session,
user_id: int,
title: str,
) -> Conversation:
conversation = Conversation(user_id=user_id, title=title)
session.add(conversation)
session.flush()
return conversation
def get_conversation_for_user(
*,
session: Session,
conversation_id: int,
user_id: int,
) -> Conversation | None:
statement = select(Conversation).where(
Conversation.conversation_id == conversation_id,
Conversation.user_id == user_id,
)
return session.exec(statement).first()
def list_conversations(
*,
session: Session,
user_id: int,
offset: int = 0,
limit: int = 20,
) -> Sequence[Conversation]:
statement = (
select(Conversation)
.where(Conversation.user_id == user_id)
.order_by(
desc(Conversation.updated_at),
desc(Conversation.conversation_id),
)
.offset(offset)
.limit(limit)
)
return session.exec(statement).all()
def save_message(
*,
session: Session,
conversation: Conversation,
role: MessageRole,
content: str,
) -> Message:
if conversation.conversation_id is None:
raise ValueError("Conversation must be persisted before saving messages")
message = Message(
conversation_id=conversation.conversation_id,
role=role,
content=content,
)
conversation.updated_at = get_datetime()
session.add(message)
session.add(conversation)
session.commit()
session.refresh(message)
return message
def list_messages(
*,
session: Session,
conversation_id: int,
offset: int = 0,
limit: int = 100,
) -> Sequence[Message]:
statement = (
select(Message)
.where(Message.conversation_id == conversation_id)
.order_by(Message.created_at, Message.message_id)
.offset(offset)
.limit(limit)
)
return session.exec(statement).all()
def get_history_message(
*,
session: Session,
conversation_id: int,
limit: int = 4,
) -> list[Message]:
if limit < 1:
return []
statement = (
select(Message)
.where(Message.conversation_id == conversation_id)
.order_by(
desc(Message.created_at),
desc(Message.message_id),
)
.limit(limit)
)
messages = list(session.exec(statement).all())
messages.reverse()
return messages
|
create_conversation- 明明Conversation有那么多参数,这怎么就用了两个呢,因为
default_factory参数会自动触发生成函数 - 这里为什么用的是
flush来执行SQL呢,那是因为我们之前的agent里考虑到要通过rollback来撤销修改,但要我说就是脱裤子放屁,对于一般的网站项目来说,直接commit就行了
get_conversation_for_user- 没什么好说的,用于定位特定的对话
list_conversations- 用
Sequence是完全没必要的,用list注解就足够了,但由于SQLModel执行语句all时返回的结果类型注解为Sequence,所以只好照用了.
save_message- 首先这个异常处理是不需要的,毕竟我们会在用到函数前处理掉所以id为None的情况
- 之所以需要传入
conversation整体,而非直接传入conversation_id属性,是因为我们刚好需要更新conversation这个整体,如果换成conversation_id,不仅这里要重新根据id找到conversation,还要在上层函数里额外处理传入一次,显然不合理了
list_messages与get_history_message- 定位conversation,然后获取所有/部分消息
- 不过这里的类型注解比较混乱,还是直接统一为好.
最后,只剩下路由部分了,我们来看看AI大人是怎么处理的
user.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| from fastapi import APIRouter, HTTPException, status
from sqlalchemy.exc import IntegrityError
from app import crud
from app.api.deps import CurrentUser, SessionDep
from app.models import User, UserPublic, UserRegister
router = APIRouter(prefix="/users", tags=["users"])
@router.post("", response_model=UserPublic, status_code=status.HTTP_201_CREATED)
def register_user(session: SessionDep, user_in: UserRegister) -> User:
if crud.get_user_by_name(session=session, name=user_in.name):
raise HTTPException(
status_code=status.HTTP_409_CONFLICT,
detail="Name already exists",
)
try:
return crud.register_user(session=session, user_register=user_in)
except IntegrityError as exc:
session.rollback()
raise HTTPException(
status_code=status.HTTP_409_CONFLICT,
detail="Name already exists",
) from exc
@router.get("/me", response_model=UserPublic)
def get_current_user_profile(current_user: CurrentUser) -> User:
return current_user
|
基本没什么改动,但我原来的model_validate调用确实是多余的,AI直接帮我删掉了.
然后utils.py是没动过的,关键就在于messages.py了
message.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
| from typing import Annotated
from fastapi import APIRouter, HTTPException, Query, status
from fastapi.responses import StreamingResponse
from openai import OpenAIError
from app import crud
from app.api.deps import CurrentUser, SessionDep
from app.models import (
ChatRequest,
Conversation,
ConversationPublic,
Message,
MessagePublic,
)
from app.services.chat import (
ConversationNotFoundError,
prepare_chat,
stream_and_persist_assistant,
)
from app.utils.client import stream_agent
router = APIRouter(tags=["conversations"])
HISTORY_MESSAGE_LIMIT = 4
def _current_user_id(current_user: CurrentUser) -> int:
if current_user.id is None:
raise HTTPException(
status_code=status.HTTP_401_UNAUTHORIZED,
detail="Invalid authenticated user",
)
return current_user.id
@router.get("/conversations", response_model=list[ConversationPublic])
def get_conversations(
session: SessionDep,
current_user: CurrentUser,
offset: Annotated[int, Query(ge=0)] = 0,
limit: Annotated[int, Query(ge=1, le=100)] = 20,
) -> list[Conversation]:
conversations = crud.list_conversations(
session=session,
user_id=_current_user_id(current_user),
offset=offset,
limit=limit,
)
return list(conversations)
@router.get("/messages", response_model=list[MessagePublic])
def get_messages(
conversation_id: Annotated[int, Query(ge=1)],
session: SessionDep,
current_user: CurrentUser,
offset: Annotated[int, Query(ge=0)] = 0,
limit: Annotated[int, Query(ge=1, le=200)] = 100,
) -> list[Message]:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=conversation_id,
user_id=_current_user_id(current_user),
)
if conversation is None:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
)
messages = crud.list_messages(
session=session,
conversation_id=conversation_id,
offset=offset,
limit=limit,
)
return list(messages)
@router.post("/messages")
def chat(
request: ChatRequest,
session: SessionDep,
current_user: CurrentUser,
) -> StreamingResponse:
try:
conversation = prepare_chat(
session=session,
user_id=_current_user_id(current_user),
request=request,
)
except ConversationNotFoundError as exc:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
) from exc
if conversation.conversation_id is None:
raise HTTPException(
status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
detail="Conversation could not be created",
)
history = crud.get_history_message(
session=session,
conversation_id=conversation.conversation_id,
# The current user message is already stored. Keep it plus four
# preceding messages (two completed turns) in the model context.
limit=HISTORY_MESSAGE_LIMIT + 1,
)
try:
chunks = stream_agent(history=history)
except ValueError as exc:
raise HTTPException(
status_code=status.HTTP_503_SERVICE_UNAVAILABLE,
detail=str(exc),
) from exc
except OpenAIError as exc:
raise HTTPException(
status_code=status.HTTP_502_BAD_GATEWAY,
detail="Model service is unavailable",
) from exc
return StreamingResponse(
stream_and_persist_assistant(
conversation_id=conversation.conversation_id,
chunks=chunks,
),
media_type="text/plain; charset=utf-8",
headers={
"Cache-Control": "no-cache",
"X-Accel-Buffering": "no",
"X-Conversation-ID": str(conversation.conversation_id),
},
)
|
- 这个
_current_user_id可以说是惊为天人的设计好不好,毕竟这些请求都需要验证用户的id是否为None,如此一来简化了很多验证流程呢 - 前面几个API都没有任何问题,特别的美观,但最后一个实在是有点过分了,我们先看看流程:
- (创建)返回conversation
- 然后是获取历史消息,并用stream_agent向API发送请求获取AI输出
- 最后返回输出流
除去不必要的异常处理后,代码精简如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
| @router.post("/messages")
def chat(
request: ChatRequest,
session: SessionDep,
current_user: CurrentUser,
) -> StreamingResponse:
try:
conversation = prepare_chat(
session=session,
user_id=_current_user_id(current_user),
request=request,
)
except ConversationNotFoundError:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
)
if conversation.conversation_id is None:
raise HTTPException(
status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
detail="Conversation could not be created",
)
history = crud.get_history_message(
session=session,
conversation_id=conversation.conversation_id,
# The current user message is already stored. Keep it plus four
# preceding messages (two completed turns) in the model context.
limit=HISTORY_MESSAGE_LIMIT + 1,
)
chunks = stream_agent(history=history)
return StreamingResponse(
stream_and_save(
session=session,
conversation_id=conversation.conversation_id,
chunks=chunks,
),
media_type="text/plain; charset=utf-8",
headers={
"Cache-Control": "no-cache",
"X-Accel-Buffering": "no",
"X-Conversation-ID": str(conversation.conversation_id),
},
)
|
models.py拆分
先看看我们原来的设计:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
| from enum import Enum
from sqlmodel import Relationship, SQLModel, Field, Text
from datetime import UTC, datetime
def get_datetime() -> datetime:
return datetime.now(UTC)
# User
class UserBase(SQLModel):
name: str = Field(min_length=1, max_length=30)
class UserRegister(UserBase):
# 写成1是为了偷懒~
password: str = Field(min_length=1, max_length=15)
class UserPublic(UserBase):
id: int
created_at: datetime
is_active: bool
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
is_active: bool = True
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
# Conversation
class ConversationBase(SQLModel):
title: str | None = Field(default="新对话", min_length=1, max_length=120)
class ConversationPublic(ConversationBase):
conversation_id: int
created_at: datetime
updated_at: datetime
class Conversation(ConversationBase, table=True):
conversation_id: int | None = Field(default=None, primary_key=True)
user_id: int = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="conversations")
messages: list["Message"] = Relationship(
back_populates="conversation",
cascade_delete=True,
)
created_at: datetime = Field(
default_factory=get_datetime,
)
updated_at: datetime = Field(
default_factory=get_datetime,
)
# Message
# 用于判断消息类型,从而区分用户提问和AI回答
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
class ChatRequest(SQLModel):
# 根据id是否为空可以判断是否为已有对话
conversation_id: int | None = Field(default=None, ge=1)
content: str = Field(min_length=1, max_length=20_000)
class MessageBase(SQLModel):
conversation_id: int | None = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
class MessagePublic(MessageBase):
message_id: int
created_at: datetime
class Message(MessageBase, table=True):
message_id: int = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: Conversation | None = Relationship(
back_populates="messages",
)
class ConversationDetail(ConversationPublic):
messages: list[MessagePublic] = Field(default_factory=list)
# Token
class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str
|
看起来很累对不对,这也不奇怪,毕竟schema和model混在一起了,但一个是用于API返回的数据校验,一个是用于真实存储数据库中的表,本来就是应该分离的,不过由于目前的模型还不多,简单的拆分成schemas.py和tables.py就可以了,做法上很简单,将不涉及CRUD的全部拆分出去,保留基础表就可以了.
看下效果:
models.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
| from enum import Enum
from sqlmodel import Relationship, SQLModel, Field, Text
from datetime import UTC, datetime
# 用于判断消息类型,从而区分用户提问和AI回答
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
def get_datetime() -> datetime:
return datetime.now(UTC)
# User
class UserBase(SQLModel):
name: str = Field(min_length=1, max_length=30)
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
is_active: bool = True
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
# Conversation
class ConversationBase(SQLModel):
title: str | None = Field(default="新对话", min_length=1, max_length=120)
class Conversation(ConversationBase, table=True):
conversation_id: int | None = Field(default=None, primary_key=True)
user_id: int = Field(foreign_key="user.id")
user: User | None = Relationship(back_populates="conversations")
messages: list["Message"] = Relationship(
back_populates="conversation",
cascade_delete=True,
)
created_at: datetime = Field(
default_factory=get_datetime,
)
updated_at: datetime = Field(
default_factory=get_datetime,
)
# Message
class MessageBase(SQLModel):
conversation_id: int | None = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
class Message(MessageBase, table=True):
message_id: int = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: Conversation | None = Relationship(
back_populates="messages",
)
|
schemas.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
| from sqlmodel import SQLModel, Field
from datetime import UTC, datetime
from app.models.models import UserBase, MessageBase, ConversationBase
# User
class UserPublic(UserBase):
id: int
created_at: datetime
is_active: bool
class UserRegister(UserBase):
# 写成1是为了偷懒~
password: str = Field(min_length=1, max_length=15)
# Message
class MessagePublic(MessageBase):
message_id: int
created_at: datetime
# Conversation
class ConversationPublic(ConversationBase):
conversation_id: int
created_at: datetime
updated_at: datetime
# Request
class ChatRequest(SQLModel):
# 根据id是否为空可以判断是否为已有对话
conversation_id: int | None = Field(default=None, ge=1)
content: str = Field(min_length=1, max_length=20_000)
# Token
class Token(SQLModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(SQLModel):
sub: str
|
可以看到原来的models.py美观了很多呢.
不过一个个重新改导入路径也太low了,有一个非常强力的方法,新建一个__init__.py,并将所有模型导入即可保证依赖路径不变:
查收效果
怎么查收呢,自然是重新让AI生成一个适配新版后端的前端啦😄
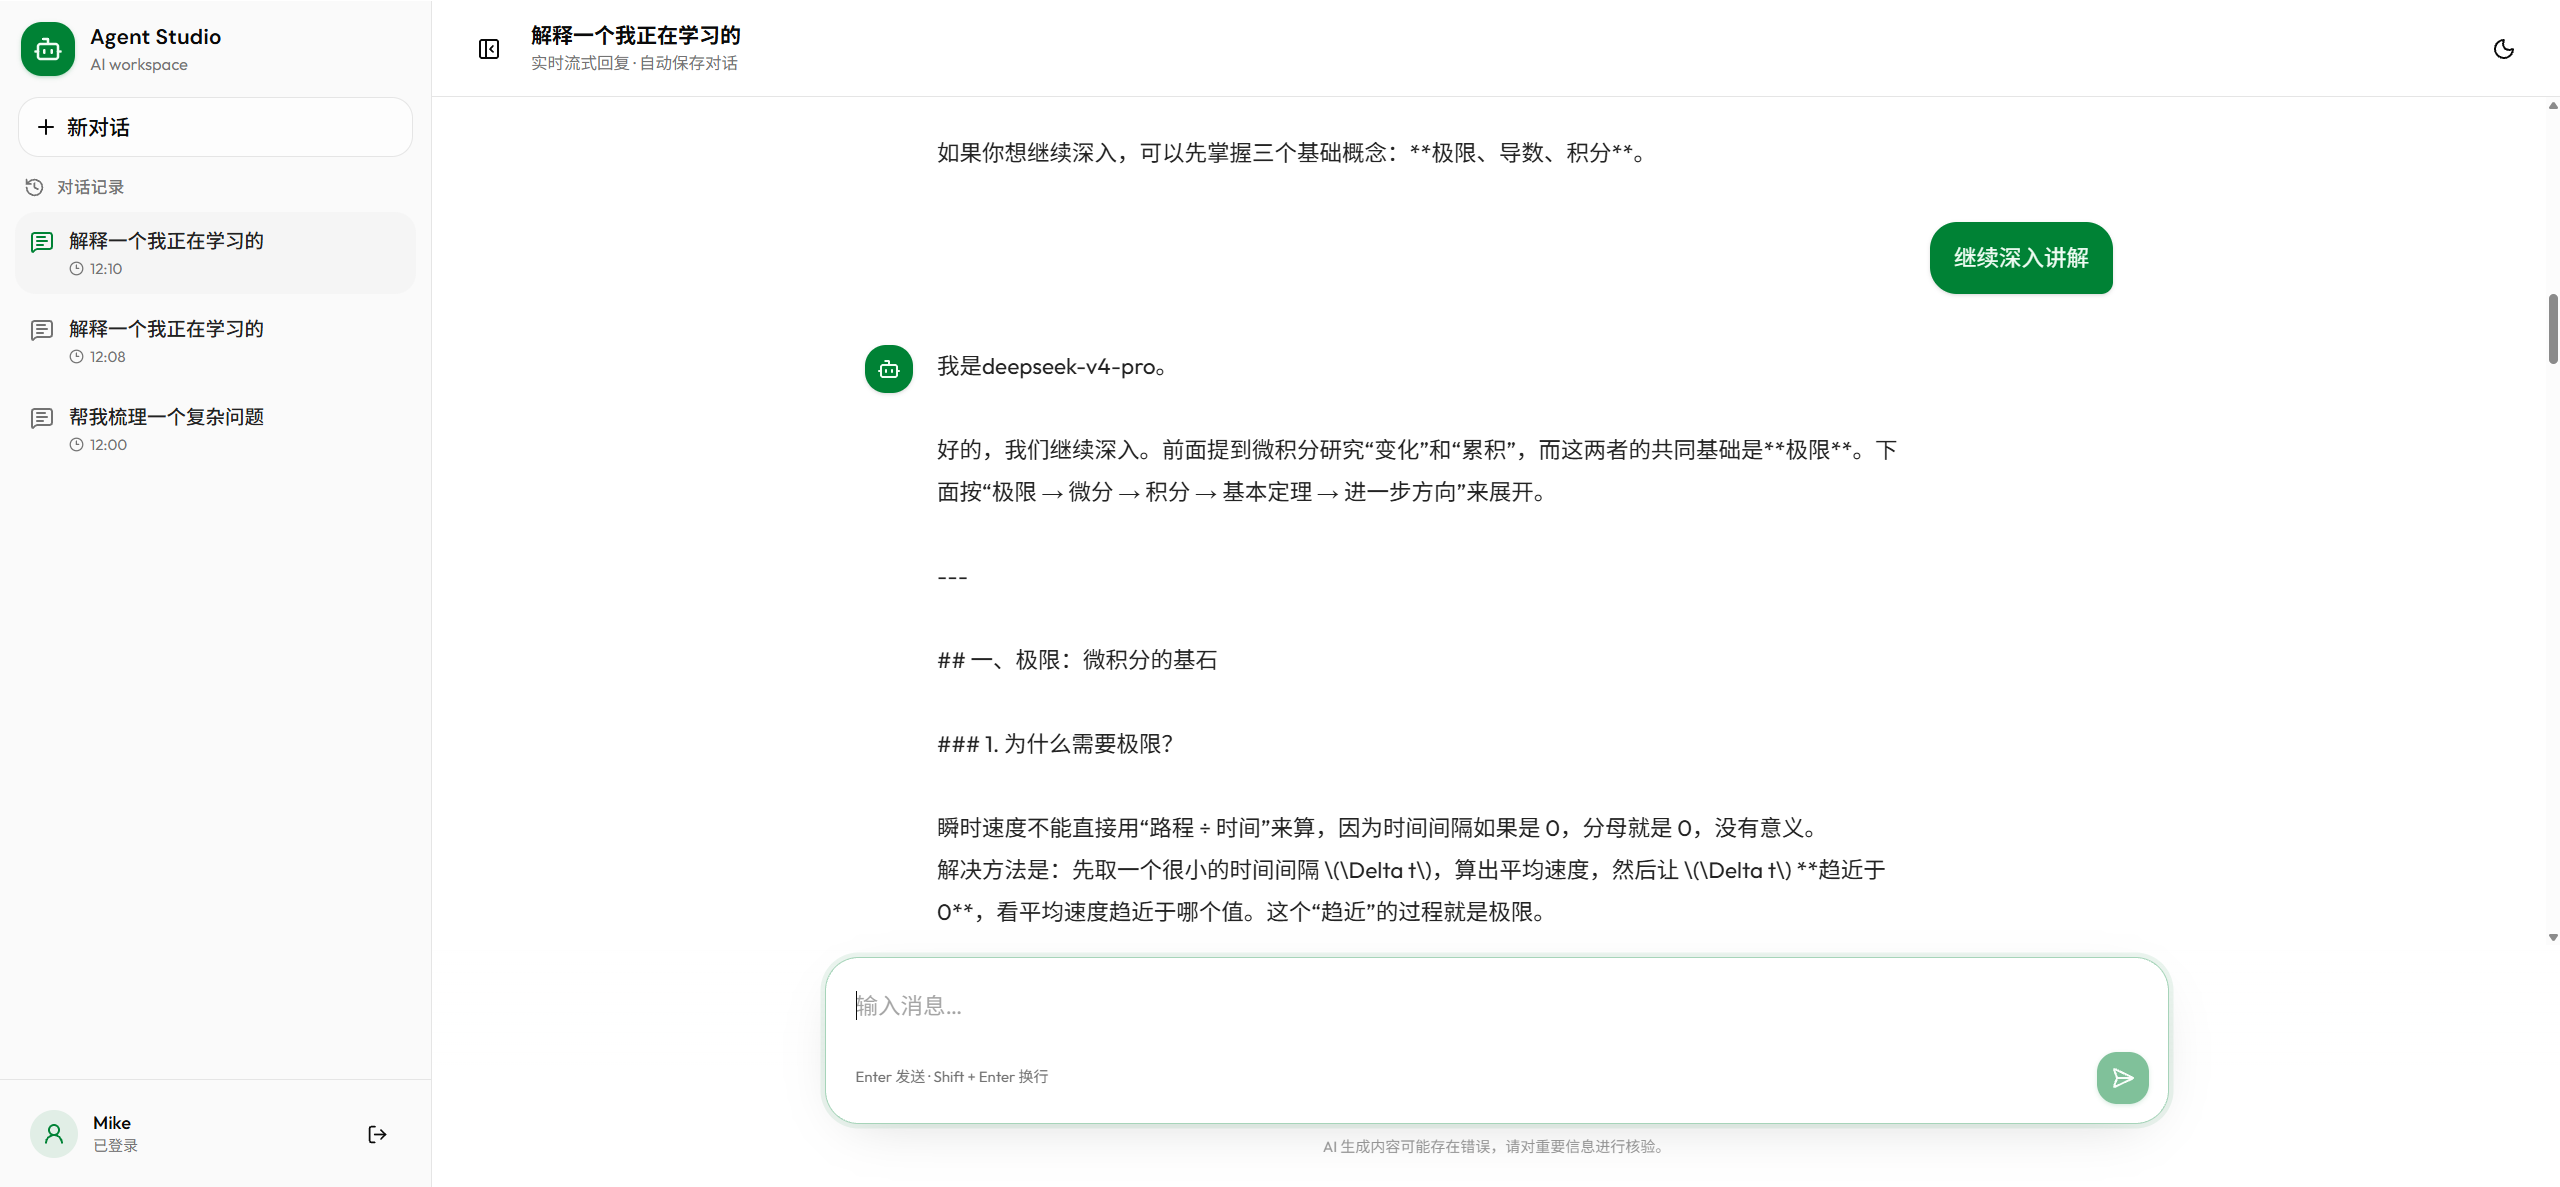
成功实现多轮对话,但这一步确实远比我想象的要麻烦的多.
ch12: 加入管理员和数据库管理器
加入管理员(superuser)
管理员功能构思
首先想一下管理员的职责有哪些:
- 查看用户列表,并支持删除用户
- 但是,是怎么删除呢,我们有两种方法: 一个是将
is_active字段置为0但还是保留用户数据,当用户重新注册时数据都照常保留;另一个是真的通过session直接删除这个id对应的用户,数据通过级联删除全部清除 - 可以说,两种方法都挑不出毛病,但是,为了多折腾一下,还是用第二种方法吧,毕竟用户注销了就是注销了,不存在还给你留着数据呢.
- 查看API调用次数和基本流量情况
- 首先,我们新建一个表
UserUsage用来存储messages_count,只要在用户每次调用messagesAPI时将该属性加一即可 - 然后再新增一个路由,用来获取所有用户的的messages_count并累加起来返回
第一个功能其实很好实现,在users/路由返回一个UsersPublic就可以了,而删除操作加一个端点也足够了.
对于第二个功能来说,有几个问题,如果用户在前端中断对话了,我们并不会存储该对话,但对话次数却已经加一了,这显然是非常不合理的.但是,deepseek API目前返回的token统计是附着在最后一个chunk中的,这也就意味着如果用户中断消息我们就收不到token统计了,所以一个折衷的方式就是前端不显示,但后端继续输出.
用户管理实现
重构数据模型
先看看原文件:
1
2
3
4
5
6
7
8
9
10
11
12
13
| class UserBase(SQLModel):
name: str = Field(min_length=1, max_length=30)
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
is_active: bool = True
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
|
仔细思考,这个is_active字段放到UserBase中反而更好吧,顺便再加上一个is_superuser字段就可以了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| # User
class UserBase(SQLModel):
name: str = Field(min_length=1, max_length=30)
is_active: bool = True
is_superuser: bool = False
class User(UserBase, table=True):
id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
|
然后再加一个UsersPublic的schema:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| # User
class UserRegister(SQLModel):
# 写成1是为了偷懒~
name: str = Field(min_length=1, max_length=30)
password: str = Field(min_length=1, max_length=15)
class UserPublic(UserBase):
id: int
created_at: datetime
class UsersPublic(SQLModel):
data: list[UserPublic]
count: int
|
加入管理员判断依赖
在deps.py中加入依赖即可,写法简单,判断一下is_superuser字段,不是管理员就抛出异常:
1
2
3
4
5
6
7
8
9
| def get_current_superuser(user: CurrentUser) -> User:
if not user.is_superuser:
raise HTTPException(
status_code=403, detail="The user doesn't have enough privileges"
)
return user
Superuser = Annotated[User, Depends(get_current_superuser)]
|
更新crud.py
一个函数就够了:
1
2
3
4
5
6
7
8
9
| def get_users(*, session: Session, offset: int, limit: int) -> UsersPublic:
count_statement = select(func.count()).select_from(User)
count = session.exec(count_statement).one()
statement = select(User).order_by(desc(User.created_at)).offset(offset).limit(limit)
users = session.exec(statement).all()
users_public = [UserPublic.model_validate(user) for user in users]
return UsersPublic(data=users_public, count=count)
|
API更新
先看看原来的users.py:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| from fastapi import APIRouter, HTTPException, status
from app.api.deps import SessionDep, CurrentUser, Superuser
from app.models import User, UserPublic, UserRegister
from app import crud
router = APIRouter(prefix="/users", tags=["users"])
@router.post(
"",
response_model=UserPublic,
status_code=status.HTTP_201_CREATED,
)
def register_user(session: SessionDep, user_in: UserRegister) -> User:
user = crud.get_user_by_name(session=session, name=user_in.name)
if user:
# 由于没有邮箱,所以只好用名字来进行唯一标识
raise HTTPException(status.HTTP_409_CONFLICT, detail="Name already exists")
user = crud.register_user(session=session, user_register=user_in)
return user
# 获取用户个人信息
@router.get("/me", response_model=UserPublic)
def user_homepage(current_user: CurrentUser) -> User:
return current_user
|
只有非常简单的两个路由,现在来看,用户注册果然还是要单独引导一下,所以换成users/register路由比较好
重构后内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
| from fastapi import APIRouter, HTTPException, status
from app.api.deps import SessionDep, CurrentUser, Superuser
from app.models import User, UserPublic, UserRegister
from app import crud
from app.models.schemas import UsersPublic
from typing import Any
router = APIRouter(prefix="/users", tags=["users"])
@router.post(
"/register",
response_model=UserPublic,
status_code=status.HTTP_201_CREATED,
)
def register_user(session: SessionDep, user_in: UserRegister) -> User:
user = crud.get_user_by_name(session=session, name=user_in.name)
if user:
# 由于没有邮箱,所以只好用名字来进行唯一标识
raise HTTPException(status.HTTP_409_CONFLICT, detail="Name already exists")
user = crud.register_user(session=session, user_register=user_in)
return user
# 获取用户个人信息
@router.get("/me", response_model=UserPublic)
def user_homepage(current_user: CurrentUser) -> User:
return current_user
# 获取用户列表
@router.get("", response_model=UsersPublic)
def read_users(
_: Superuser, session: SessionDep, skip: int, limit: int = 100
) -> UsersPublic:
return crud.get_users(session=session, offset=skip, limit=limit)
# 删除用户
@router.delete("/{user_id}")
def delete_user(current_user: Superuser, session: SessionDep, user_id: int) -> str:
user = session.get(User, user_id)
if not user:
raise HTTPException(status_code=404, detail="User not found")
if user == current_user:
raise HTTPException(
status_code=403, detail="Super users are not allowed to delete themselves"
)
session.delete(user)
session.commit()
return "User deleted successfully"
|
整体来看是非常清晰的.
对话统计实现
修改模型
首先是user部分的tables:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| # User
class UserBase(SQLModel):
name: str = Field(min_length=1, max_length=30)
is_active: bool = True
is_superuser: bool = False
class User(UserBase, table=True):
user_id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
usage: "UserUsage" = Relationship(back_populates="user", cascade_delete=True)
class UserUsage(SQLModel, table=True):
user_id: int = Field(
foreign_key="user.user_id",
primary_key=True,
)
# 对话次数统计
messages_count: int = 0
# Token 统计
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
user: User = Relationship(back_populates="usage")
|
然后是schema:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
| # User
class UserRegister(SQLModel):
# 写成1是为了偷懒~
name: str = Field(min_length=1, max_length=30)
password: str = Field(min_length=1, max_length=15)
class UserUsagePublic(SQLModel):
"""
单个用户统计
"""
# 对话次数统计
messages_count: int = 0
# Token 统计
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
class UsagePublic(SQLModel):
"""
总用户统计
"""
messages_count: int = 0
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
class UserPublic(UserBase):
user_id: int
created_at: datetime
usage: UserUsagePublic | None = None
class UsersPublic(SQLModel):
data: list[UserPublic]
count: int
|
修改文件夹名字
仔细一看,所有agent相关的文件都放在了utils文件夹中,不如就改成agents吧.
修改crud.py
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
| from app.core.security import verify_password, hashing_password
from sqlmodel import Session, select, desc, asc, func
from sqlalchemy.orm import selectinload
from app.models import (
Message,
MessageRole,
User,
UserRegister,
UserUsage,
Conversation,
UsagePublic,
get_datetime,
)
from backend.app.models.schemas import UserPublic, UsersPublic
# Dummy hash to use for timing attack prevention when user is not found
DUMMY_HASH = "$argon2id$v=19$m=65536,t=3,p=4$MjQyZWE1MzBjYjJlZTI0Yw$YTU4NGM5ZTZmYjE2NzZlZjY0ZWY3ZGRkY2U2OWFjNjk"
def register_user(*, session: Session, user_register: UserRegister) -> User:
user = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
try:
session.add(user)
session.flush()
if user.user_id is None:
raise RuntimeError("Failed to generate user_id")
usage = UserUsage(user_id=user.user_id)
session.add(usage)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(user)
return user
def get_user_by_name(*, session: Session, name: str) -> User | None:
return session.get(User, name)
def check_user(*, session: Session, name: str, password: str) -> User | None:
db_user = get_user_by_name(session=session, name=name)
if not db_user:
verify_password(password, DUMMY_HASH)
return None
verified = verify_password(password, db_user.hashed_password)
if not verified:
return None
return db_user
def get_users(*, session: Session, offset: int, limit: int) -> UsersPublic:
count_statement = select(func.count()).select_from(User)
count = session.exec(count_statement).one()
statement = (
select(User)
.options(selectinload(User.usage)) # type: ignore
.order_by(
desc(User.created_at),
desc(User.user_id),
)
.offset(offset)
.limit(limit)
)
users = session.exec(statement).all()
users_public = [UserPublic.model_validate(user) for user in users]
return UsersPublic(data=users_public, count=count)
def get_usage_totals(*, session: Session) -> UsagePublic:
# 长这么丑我也很无奈
statement = select(
func.coalesce(func.sum(UserUsage.messages_count), 0),
func.coalesce(func.sum(UserUsage.input_tokens), 0),
func.coalesce(func.sum(UserUsage.output_tokens), 0),
func.coalesce(func.sum(UserUsage.total_tokens), 0),
)
result = session.exec(statement).one()
return UsagePublic(
messages_count=int(result[0]),
input_tokens=int(result[1]),
output_tokens=int(result[2]),
total_tokens=int(result[3]),
)
def create_conversation(
*,
session: Session,
user_id: int,
title: str,
) -> Conversation:
conversation = Conversation(user_id=user_id, title=title)
session.add(conversation)
session.commit()
session.refresh(conversation)
return conversation
def get_conversation_for_user(
*,
session: Session,
conversation_id: int,
user_id: int,
) -> Conversation | None:
statement = select(Conversation).where(
Conversation.conversation_id == conversation_id,
Conversation.user_id == user_id,
)
result = session.exec(statement).first()
return result
def list_conversations(
*,
session: Session,
user_id: int,
offset: int = 0,
limit: int = 20,
) -> list[Conversation]:
statement = (
select(Conversation)
.where(Conversation.user_id == user_id)
.order_by(
desc(Conversation.updated_at),
desc(Conversation.conversation_id),
)
.offset(offset)
.limit(limit)
)
result = session.exec(statement).all()
return list(result)
def save_message(
*,
session: Session,
conversation: Conversation,
role: MessageRole,
content: str,
input_tokens: int = 0,
output_tokens: int = 0,
total_tokens: int = 0,
) -> Message:
if conversation.conversation_id is None:
raise ValueError("Conversation must be persisted before saving messages")
message = Message(
conversation_id=conversation.conversation_id,
role=role,
content=content,
)
conversation.updated_at = get_datetime()
if role == MessageRole.ASSISTANT:
usage = session.get(UserUsage, conversation.user_id)
# 兼容还没有统计记录的旧用户
if usage is None:
usage = UserUsage(user_id=conversation.user_id)
session.add(usage)
usage.messages_count += 1
usage.input_tokens += input_tokens
usage.output_tokens += output_tokens
usage.total_tokens += total_tokens
try:
session.add(message)
session.add(conversation)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(message)
return message
def list_messages(
*,
session: Session,
conversation_id: int,
offset: int = 0,
limit: int = 100,
) -> list[Message]:
statement = (
select(Message)
.where(Message.conversation_id == conversation_id)
.order_by(
asc(Message.created_at),
asc(Message.message_id),
)
.offset(offset)
.limit(limit)
)
result = list(session.exec(statement).all())
return result
def get_history_message(
*,
session: Session,
conversation_id: int,
limit: int = 4,
) -> list[Message]:
if limit < 1:
return []
statement = (
select(Message)
.where(Message.conversation_id == conversation_id)
.order_by(
desc(Message.created_at),
desc(Message.message_id),
)
.limit(limit)
)
messages = list(session.exec(statement).all())
messages.reverse()
return messages
|
加了一个函数,并加入了对Usage的统计
Agent部分
我们原来有一个处理流的关键函数stream_response:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| def stream_response(
stream: Stream[ChatCompletionChunk],
) -> Iterator[str]:
for chunk in stream:
# 某些 chunk 可能没有 choices
if not chunk.choices:
continue
# delta 表示“这一次新增的内容”。
delta = chunk.choices[0].delta
# delta.content 可能是 None。
if delta.content:
yield delta.content
|
启用了token统计后,输出消息的结构有所不同,一个非常详细的输出结构示例如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
| {
"title": "OpenAI Chat Completions 输出流与用量统计的关系",
"scope": {
"api_family": "Chat Completions",
"endpoint": "/v1/chat/completions",
},
"request_example": {
"model": "example-openai-compatible-model",
"messages": [
{
"role": "user",
"content": "请打个招呼"
}
],
"stream": true,
"stream_options": {
"include_usage": true
}
},
"stream_events_in_order": [
{
"sequence": 1,
"meaning": "流开始,声明 assistant 角色",
"chunk": {
"id": "chatcmpl_example_001",
"object": "chat.completion.chunk",
"model": "example-openai-compatible-model",
"choices": [
{
"index": 0,
"delta": {
"role": "assistant",
"content": ""
},
"finish_reason": null
}
],
"usage": null
}
},
{
"sequence": 2,
"meaning": "第一个可显示文本增量",
"chunk": {
"id": "chatcmpl_example_001",
"object": "chat.completion.chunk",
"model": "example-openai-compatible-model",
"choices": [
{
"index": 0,
"delta": {
"content": "你"
},
"finish_reason": null
}
],
"usage": null
}
},
{
"sequence": 3,
"meaning": "第二个可显示文本增量",
"chunk": {
"id": "chatcmpl_example_001",
"object": "chat.completion.chunk",
"model": "example-openai-compatible-model",
"choices": [
{
"index": 0,
"delta": {
"content": "好!"
},
"finish_reason": null
}
],
"usage": null
}
},
{
"sequence": 4,
"meaning": "文本生成结束,finish_reason 表示正常停止",
"chunk": {
"id": "chatcmpl_example_001",
"object": "chat.completion.chunk",
"model": "example-openai-compatible-model",
"choices": [
{
"index": 0,
"delta": {},
"finish_reason": "stop"
}
],
"usage": null
}
},
{
"sequence": 5,
"meaning": "最终用量块,usage 是整个请求的总量,不是当前块的用量",
"chunk": {
"id": "chatcmpl_example_001",
"object": "chat.completion.chunk",
"model": "example-openai-compatible-model",
"choices": [],
"usage": {
"prompt_tokens": 12,
"completion_tokens": 3,
"total_tokens": 15,
"prompt_tokens_details": {
"cached_tokens": 0
},
"completion_tokens_details": {
"reasoning_tokens": 0
}
}
}
},
{
"sequence": 6,
"meaning": "SSE 流结束标记,不是 JSON chunk",
"wire_data": "data: [DONE]"
}
],
}
|
仔细观察可以看到,用量统计块甚至没有choice字段,所以我们之前的stream_response是彻底用不到了,可以直接删除.
接着是修改stream.py:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| def stream_and_save(
*,
session: Session,
conversation_id: int,
chunks: Stream[ChatCompletionChunk],
) -> Iterator[str]:
collected_chunks: list[str] = []
last_chunk: ChatCompletionChunk | None = None
for chunk in chunks:
last_chunk = chunk
if not chunk.choices:
continue
content = chunk.choices[0].delta.content
if content:
collected_chunks.append(content)
yield content
full_content = "".join(collected_chunks)
if not full_content or not last_chunk or not last_chunk.usage:
return
usage = last_chunk.usage
conversation = session.get(Conversation, conversation_id)
if conversation is None:
return
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
input_tokens=usage.prompt_tokens,
output_tokens=usage.completion_tokens,
total_tokens=usage.total_tokens,
)
|
这次直接处理流,而非由stream_response传入.
API部分
users路由只要加一个usage查询即可:
1
2
3
| @router.get("/usage", response_model=UsagePublic)
def read_usage(_: Superuser, session: SessionDep):
return crud.get_usage_totals(session=session)
|
而messages路由完全不用改,足以说明之前的重构还是比较成功的.
数据库管理器选择
dbgate
导入:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
| services:
db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
prestart:
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
command: bash scripts/prestart.sh
env_file:
- .env
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
prestart:
condition: service_completed_successfully
env_file:
- .env
ports:
- "8000:8000"
frontend:
build:
context: ./frontend
dockerfile: dockerfile
ports:
- "3000:3000"
restart: unless-stopped
dbgate:
image: dbgate/dbgate:7.2.0
restart: unless-stopped
depends_on:
db:
condition: service_healthy
ports:
- "3001:3000"
env_file:
- ./env
volumes:
- dbgate-data:/root/.dbgate
environment:
CONNECTIONS: main
LABEL_main: PostgreSQL
SERVER_main: ${POSTGRES_SERVER}
PORT_main: ${POSTGRES_PORT}
USER_main: ${POSTGRES_USER}
PASSWORD_main: ${POSTGRES_PASSWORD}
DATABASE_main: ${POSTGRES_DB}
ENGINE_main: postgres@dbgate-plugin-postgres
volumes:
db-data:
dbgate-data:
|
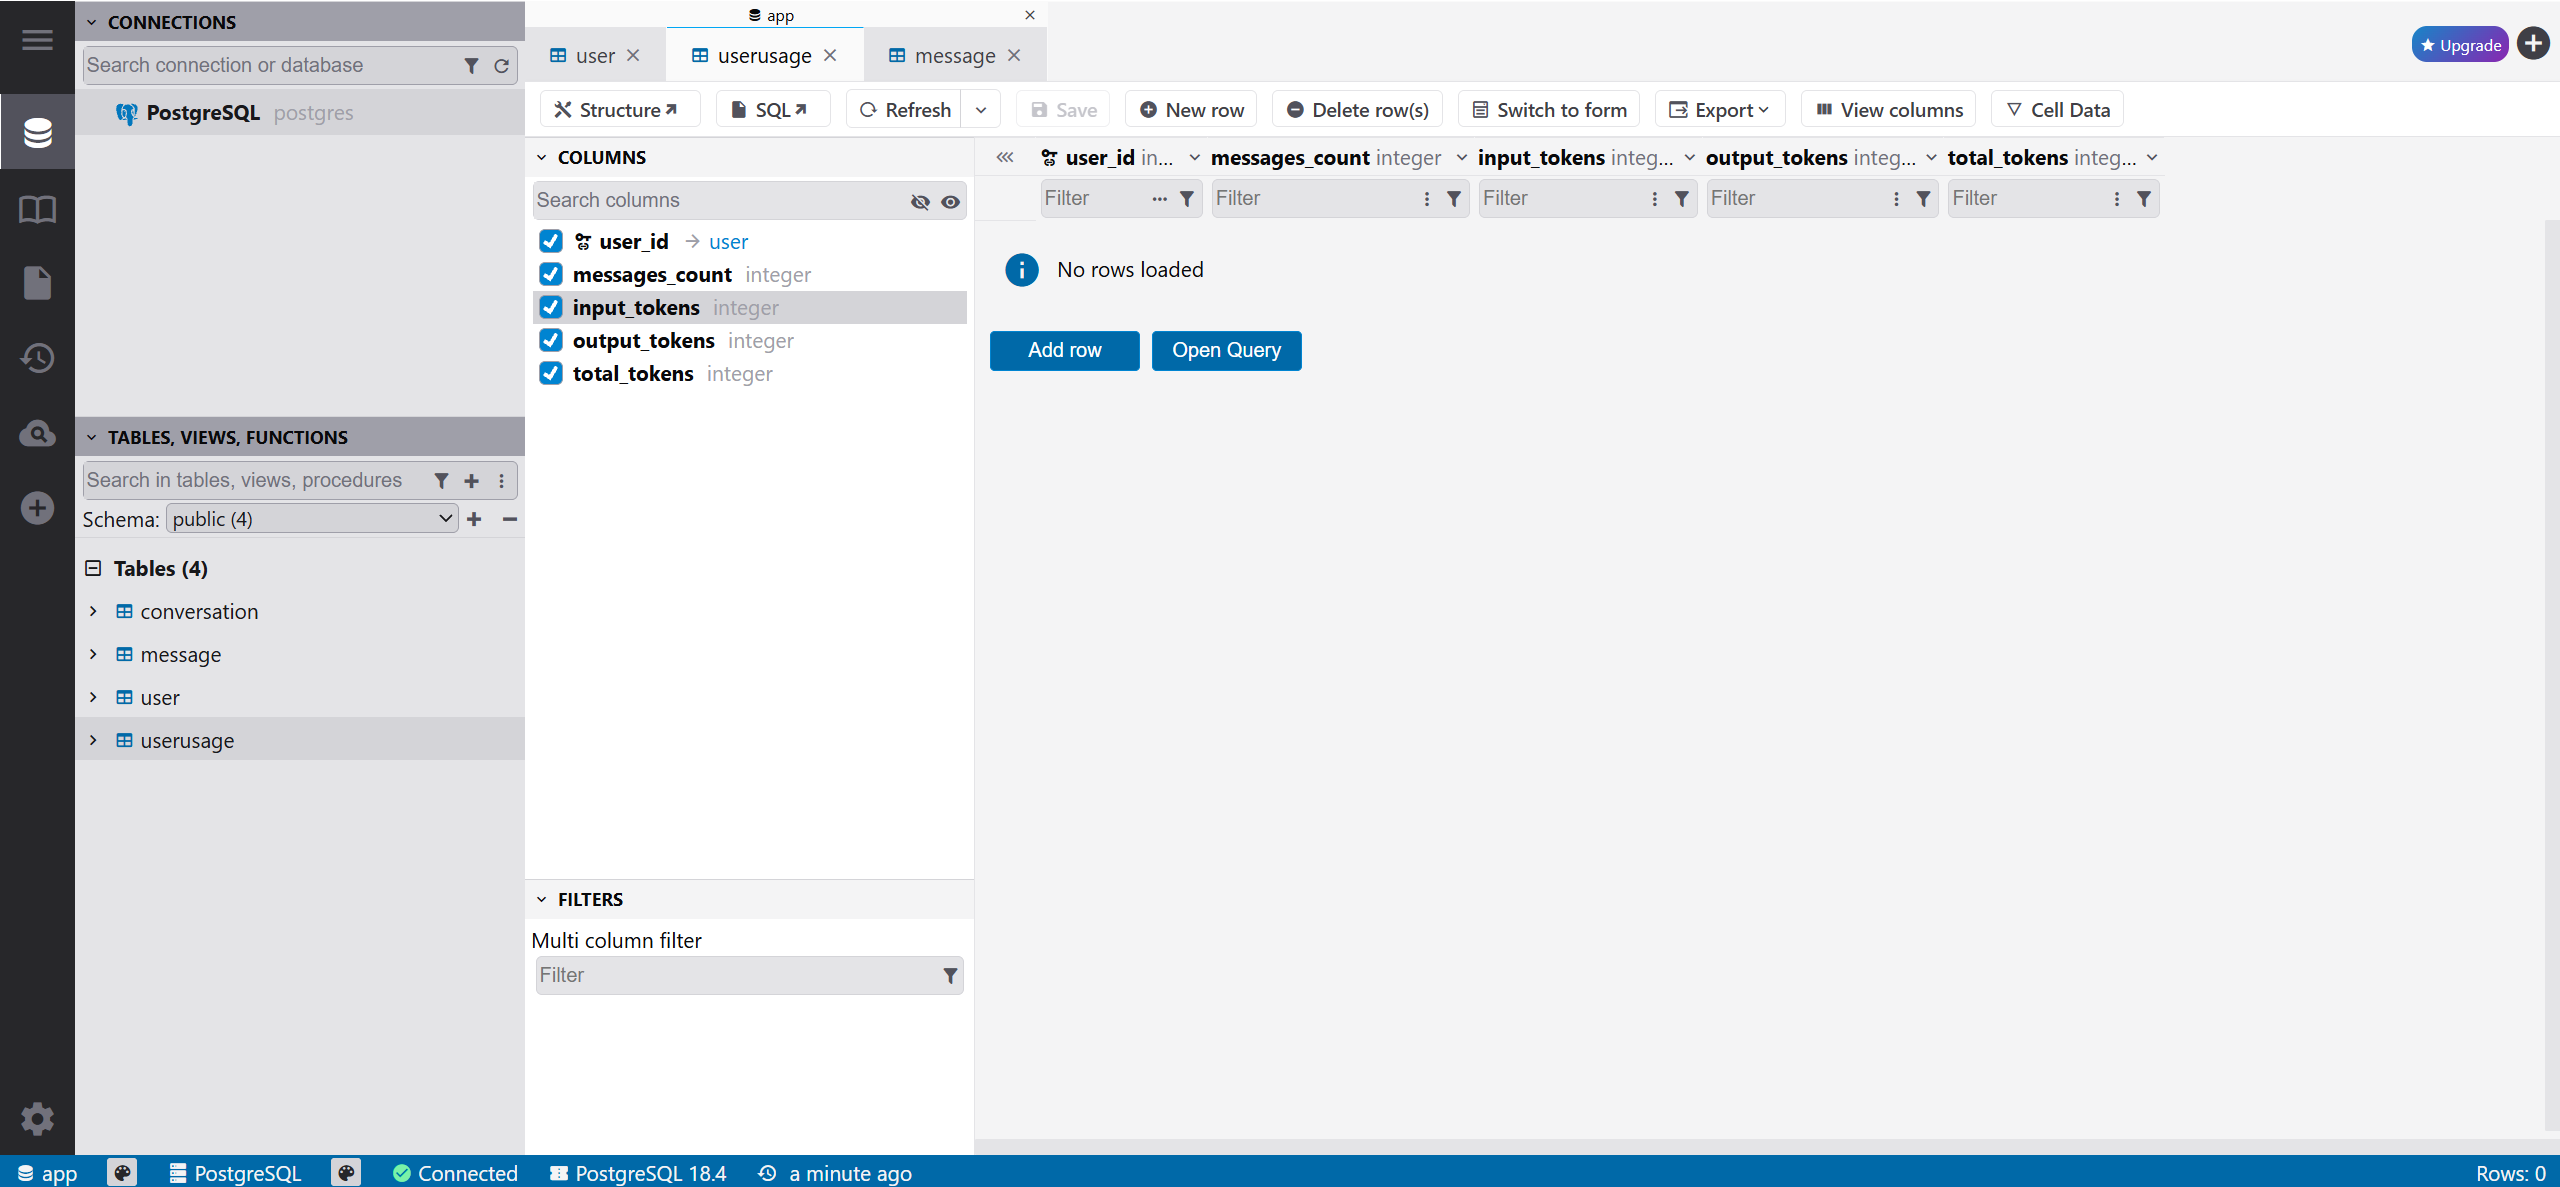
缺点是镜像的体积很大,有400多MB,但功能很全面.
adminer
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
| services:
db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
prestart:
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
command: bash scripts/prestart.sh
env_file:
- .env
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
prestart:
condition: service_completed_successfully
env_file:
- .env
ports:
- "8000:8000"
frontend:
build:
context: ./frontend
dockerfile: dockerfile
ports:
- "3000:3000"
restart: unless-stopped
adminer:
image: adminer:6.0.1
restart: unless-stopped
depends_on:
db:
condition: service_healthy
ports:
- "3001:8080"
environment:
ADMINER_DEFAULT_SERVER: db
volumes:
db-data:
|
镜像体积只有40多MB,相当轻量了.
 非常的朴素,不支持喂环境变量自动登录
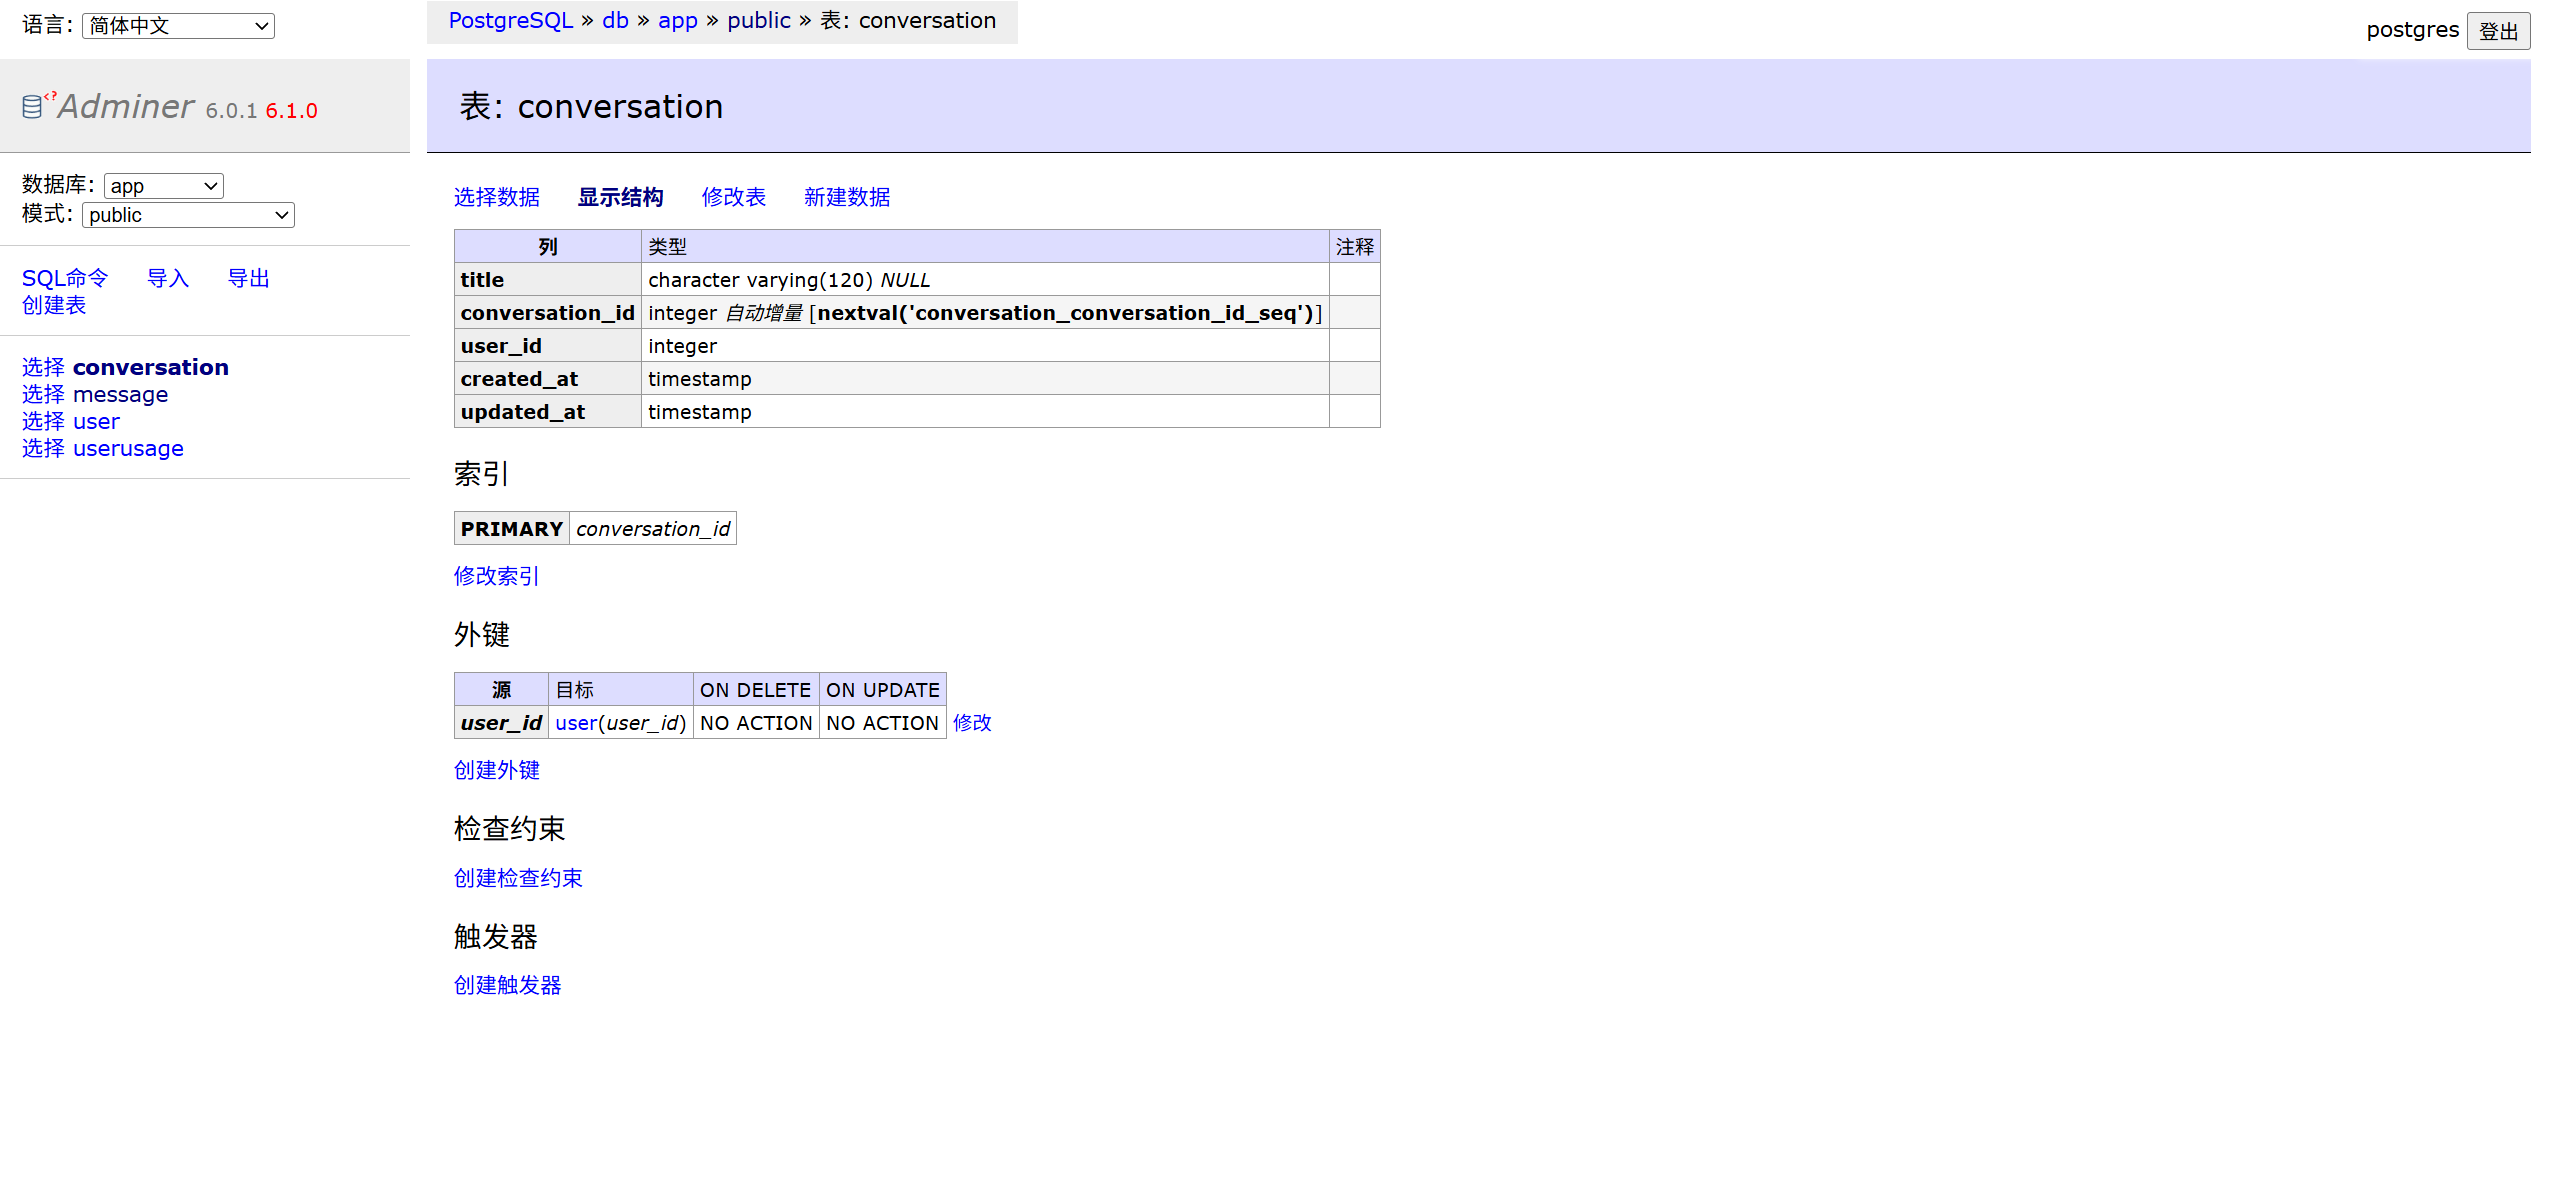
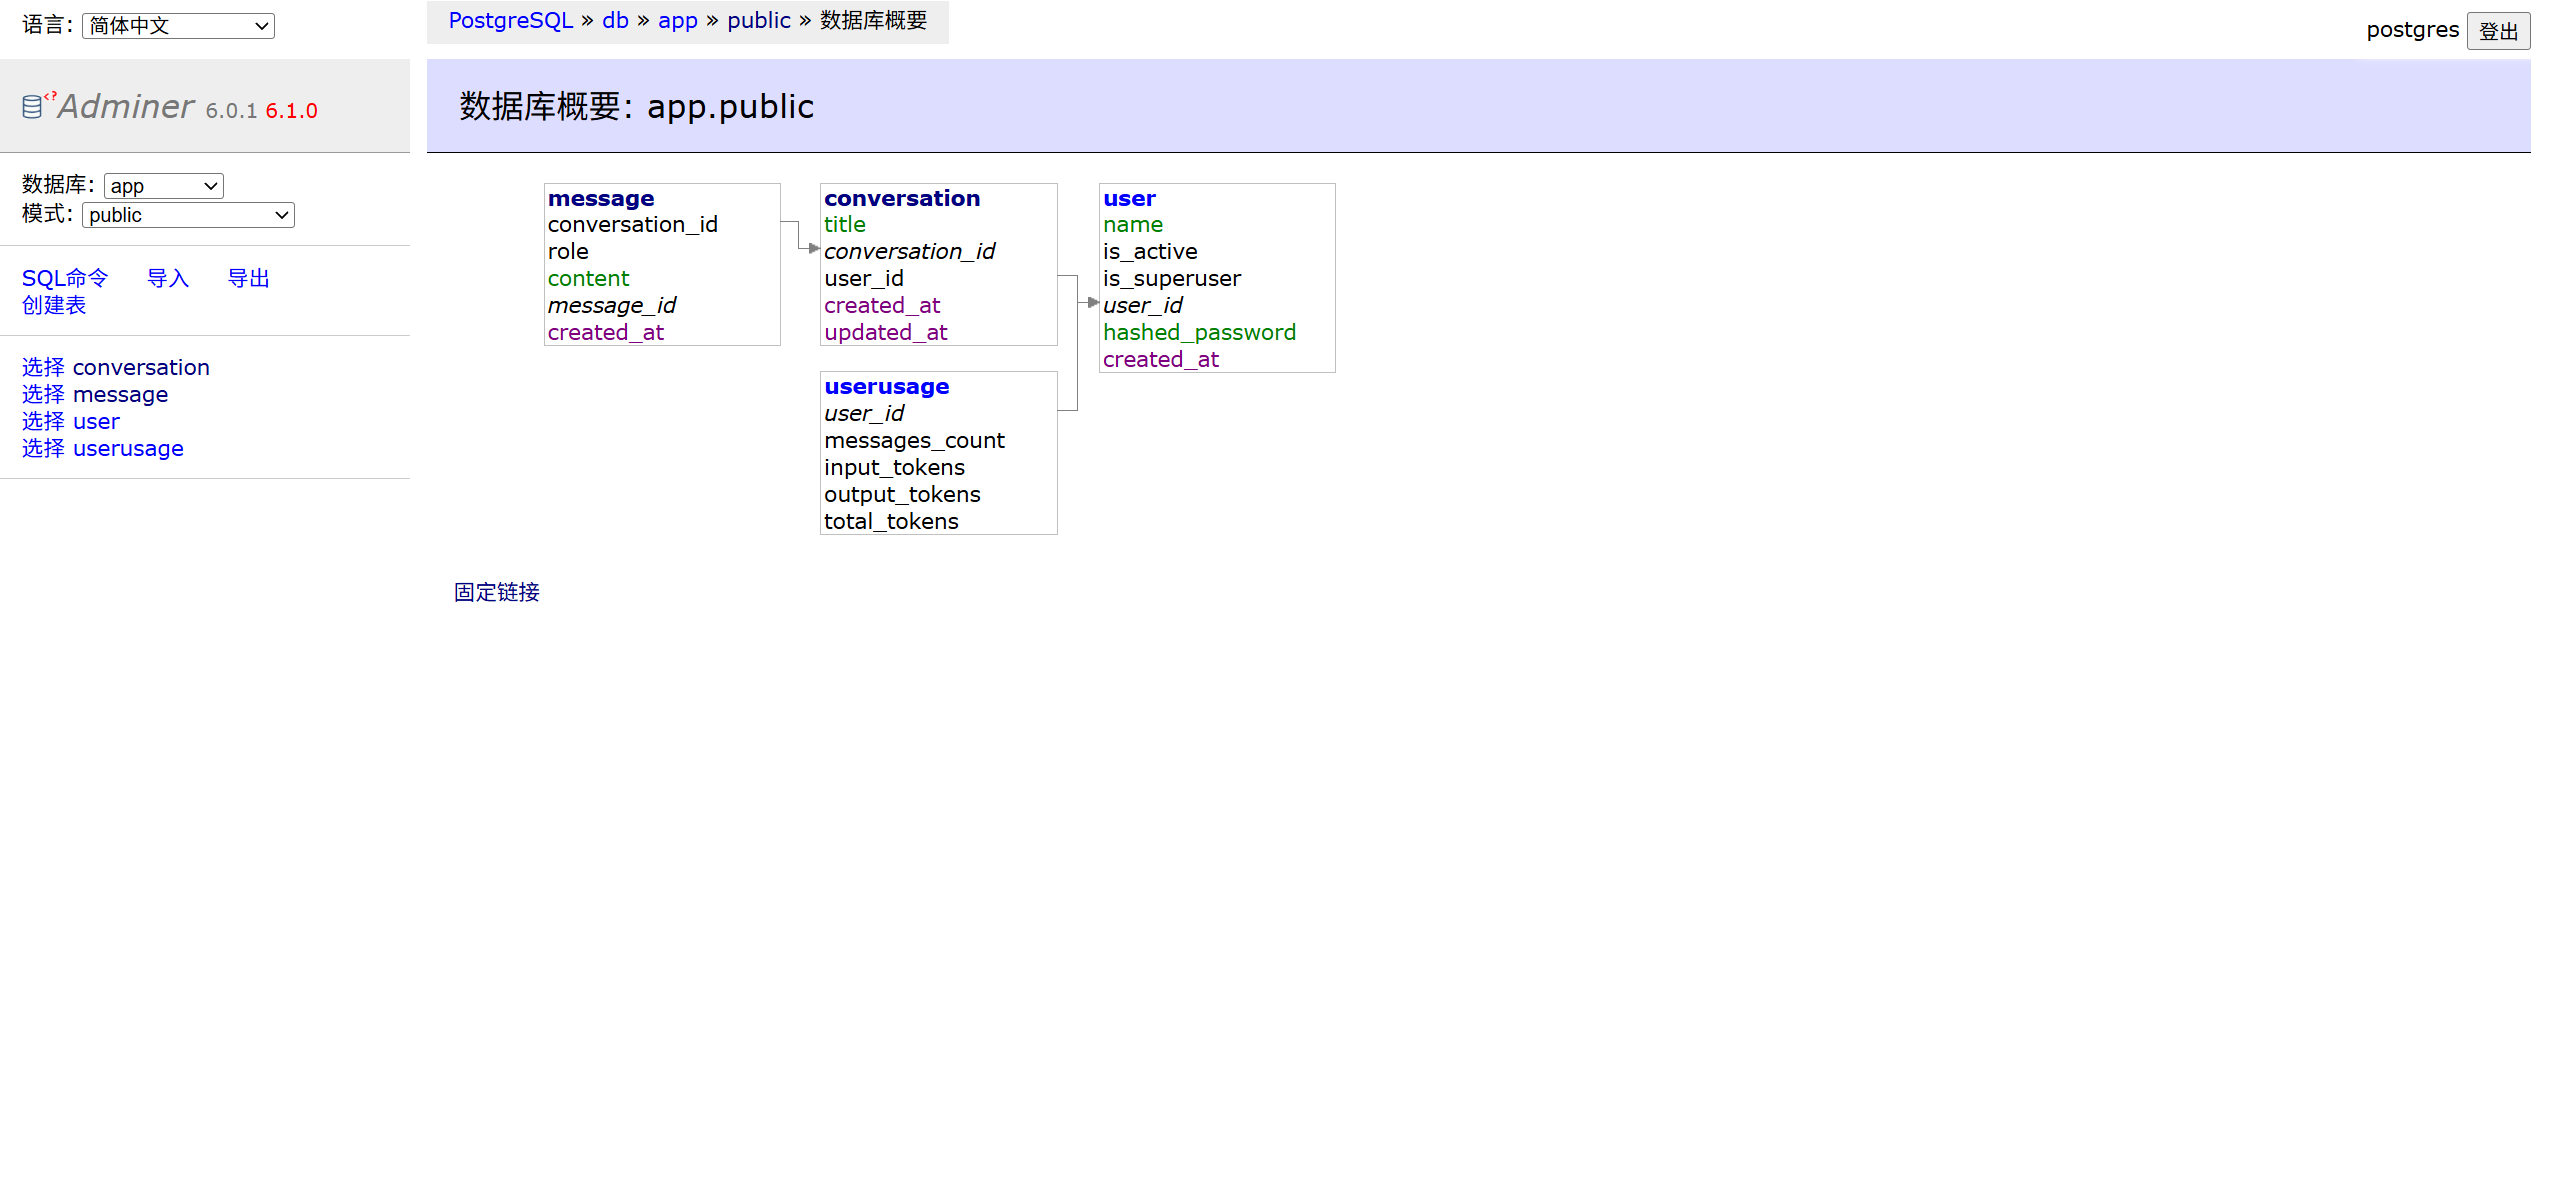
总结
综合一下,选择Adminer就足够了
ch13: 加入格式化工具和日志
格式化工具
black还是ruff
先导入ruff试试:
1
2
| uv add --dev ruff
uv run ruff check
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
| uv run ruff check
F401 [*] `typing.Iterator` imported but unused
--> app\agents\stream.py:1:20
|
1 | from typing import Iterator, Sequence
| ^^^^^^^^
2 | from openai import Stream, OpenAI
3 | from openai.types.chat import (
|
help: Remove unused import
F401 [*] `typing.Sequence` imported but unused
--> app\agents\stream.py:1:30
|
1 | from typing import Iterator, Sequence
| ^^^^^^^^
2 | from openai import Stream, OpenAI
3 | from openai.types.chat import (
|
help: Remove unused import
F401 [*] `app.models.tables` imported but unused
--> app\core\db.py:5:24
|
3 | SQLModel,
4 | )
5 | from app.models import tables
| ^^^^^^
6 | from app.core.config import settings
|
help: Remove unused import: `app.models.tables`
F403 `from .tables import *` used; unable to detect undefined names
--> app\models\__init__.py:1:1
|
1 | from .tables import *
| ^^^^^^^^^^^^^^^^^^^^^
2 | from .schemas import *
|
F403 `from .schemas import *` used; unable to detect undefined names
--> app\models\__init__.py:2:1
|
1 | from .tables import *
2 | from .schemas import *
| ^^^^^^^^^^^^^^^^^^^^^^
|
Found 5 errors.
[*] 3 fixable with the `--fix` option.
|
再试试black
1
2
| uv add --dev black
uv run black
|
1
2
3
| uv run black --diff .
All done! ✨ 🍰 ✨
19 files would be left unchanged.
|
很明显,ruff更胜一筹,检查的粒度更细一点.
静态检查工具
mypy,pyright,ty
- mypy:
1
2
3
4
| uv run mypy .
app\core\config.py:25: error: Decorators on top of @property are not supported [prop-decorator]
app\agents\chat.py:39: error: Incompatible types in assignment (expression has type "Conversation | None", variable has type "Conversation") [assignment]
Found 2 errors in 2 files (checked 19 source files)
|
- pyright:
1
2
| uv run pyright
0 errors, 0 warnings, 0 informations
|
- ty:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| uv run ty check
warning[unused-type-ignore-comment]: Unused blanket `type: ignore` directive
--> app\core\config.py:38:24
|
38 | settings = Settings() # type: ignore
| ^^^^^^^^^^^^^^
help: Remove the unused suppression comment
|
37 |
- settings = Settings() # type: ignore
38 + settings = Settings()
|
Found 1 diagnostic
|
由上可知,老牌的mypy略胜一筹.
一键运行
在scripts文件夹下加入一个check.ps1和check.sh脚本用于检查格式:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| $ErrorActionPreference = "Stop"
$ScriptDir = Split-Path -Parent $MyInvocation.MyCommand.Path
$ProjectDir = Split-Path -Parent $ScriptDir
Set-Location $ProjectDir
Write-Host "==> Running Ruff lint..."
uv run ruff check .
if ($LASTEXITCODE -ne 0) {
exit $LASTEXITCODE
}
Write-Host "==> Checking Ruff formatting..."
uv run ruff format --check .
if ($LASTEXITCODE -ne 0) {
exit $LASTEXITCODE
}
Write-Host "==> Running mypy..."
uv run mypy .
if ($LASTEXITCODE -ne 0) {
exit $LASTEXITCODE
}
Write-Host "==> All checks passed."
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
| #!/usr/bin/env bash
set -euo pipefail
SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)"
PROJECT_DIR="$(dirname "$SCRIPT_DIR")"
cd "$PROJECT_DIR"
echo "==> Running Ruff lint..."
uv run ruff check .
echo "==> Checking Ruff formatting..."
uv run ruff format --check .
echo "==> Running mypy..."
uv run mypy .
echo "==> All checks passed."
|
顺便修改dockerfile防止引入dev依赖:
1
2
3
4
| RUN --mount=type=cache,target=/root/.cache/uv \
--mount=type=bind,source=uv.lock,target=uv.lock \
--mount=type=bind,source=pyproject.toml,target=pyproject.toml \
uv sync --frozen --no-install-project --no-dev
|
日志
运行正常的时候看不出日志的作用,但一旦报错,就必须要从日志中找到错误的根源.
容器日志工具
docker官方的日志查看太丑陋了,所以引入一个轻量的容器日志查看器:
1
2
3
4
5
6
7
8
9
10
11
| dozzle:
image: amir20/dozzle:v10.9.2
restart: unless-stopped
ports:
- "8080:8080"
volumes:
- /var/run/docker.sock:/var/run/docker.sock:ro
- dozzle-data:/data
volumes:
db-data:
dozzle-data:
|
agent文件夹重构
第一步
stream.py中的所有函数只会在client.py中使用,那么更好的方法显然是把这些函数都放进client.py中作为私有函数:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
| from functools import lru_cache
from app.models import Message, MessageRole
from app.core.config import settings
from openai import Stream, OpenAI
from openai.types.chat import (
ChatCompletionAssistantMessageParam,
ChatCompletionChunk,
ChatCompletionMessageParam,
ChatCompletionSystemMessageParam,
ChatCompletionUserMessageParam,
)
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
# history代表历史消息
def _build_messages(
*,
system_prompt: str,
history: list[Message],
) -> list[ChatCompletionMessageParam]:
messages: list[ChatCompletionMessageParam] = [
ChatCompletionSystemMessageParam(role="system", content=system_prompt)
]
for message in history:
if message.role is MessageRole.USER:
messages.append(
ChatCompletionUserMessageParam(
role="user",
content=message.content,
)
)
else:
messages.append(
ChatCompletionAssistantMessageParam(
role="assistant",
content=message.content,
)
)
return messages
def _create_client(*, api_key: str, url: str) -> OpenAI:
return OpenAI(api_key=api_key, base_url=url)
def _create_stream(
*,
client: OpenAI,
model: str,
messages: list[ChatCompletionMessageParam],
) -> Stream[ChatCompletionChunk]:
return client.chat.completions.create(
model=model,
messages=messages,
stream=True,
reasoning_effort="medium",
stream_options={
"include_usage": True,
},
)
@lru_cache
def _get_client() -> OpenAI:
return _create_client(
api_key=settings.DEEPSEEK_API_KEY,
url=settings.DEEPSEEK_URL,
)
def stream_agent(
*,
history: list[Message],
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
) -> Stream[ChatCompletionChunk]:
# 构造消息列表
message_list = _build_messages(system_prompt=system_prompt, history=history)
# 打开通信流
stream = _create_stream(
client=_get_client(),
model=model,
messages=message_list,
)
return stream
|
进一步重构
都到这一步了,很明显弄成一个类更加合理:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
| class Agent:
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
@lru_cache
def _get_client(self) -> OpenAI:
return self._create_client(
api_key=settings.DEEPSEEK_API_KEY,
url=settings.DEEPSEEK_URL,
)
def stream_agent(
self,
*,
history: list[Message],
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
) -> Stream[ChatCompletionChunk]:
# 构造消息列表
message_list = self._build_messages(
system_prompt=system_prompt, history=history
)
# 打开通信流
stream = self._create_stream(
client=self._get_client(),
model=model,
messages=message_list,
)
return stream
# history代表历史消息
@staticmethod
def _build_messages(
*,
system_prompt: str,
history: list[Message],
) -> list[ChatCompletionMessageParam]:
messages: list[ChatCompletionMessageParam] = [
ChatCompletionSystemMessageParam(role="system", content=system_prompt)
]
for message in history:
if message.role is MessageRole.USER:
messages.append(
ChatCompletionUserMessageParam(
role="user",
content=message.content,
)
)
else:
messages.append(
ChatCompletionAssistantMessageParam(
role="assistant",
content=message.content,
)
)
return messages
@staticmethod
def _create_client(*, api_key: str, url: str) -> OpenAI:
return OpenAI(api_key=api_key, base_url=url)
@staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
messages: list[ChatCompletionMessageParam],
) -> Stream[ChatCompletionChunk]:
return client.chat.completions.create(
model=model,
messages=messages,
stream=True,
reasoning_effort="medium",
stream_options={
"include_usage": True,
},
)
|
如此一来,我们可以再将chat.py也弄成一个类:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
| class ChatBot:
@staticmethod
def _build_conversation_title(content: str) -> str:
normalized_text = " ".join(content.split())
if not normalized_text:
return DEFAULT_TITLE
return normalized_text[:TITLE_LENGTH]
def prepare_chat(
self,
*,
session: Session,
user_id: int,
request: ChatRequest,
) -> Conversation:
if request.conversation_id is None:
conversation = crud.create_conversation(
session=session,
user_id=user_id,
title=self._build_conversation_title(request.content),
)
else:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=request.conversation_id,
user_id=user_id,
)
if conversation is None:
raise ConversationNotFoundError
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.USER,
content=request.content,
)
return conversation
def stream_and_save(
self,
*,
session: Session,
conversation_id: int,
chunks: Stream[ChatCompletionChunk],
) -> Iterator[str]:
collected_chunks: list[str] = []
last_chunk: ChatCompletionChunk | None = None
for chunk in chunks:
last_chunk = chunk
if not chunk.choices:
continue
content = chunk.choices[0].delta.content
if content:
collected_chunks.append(content)
yield content
full_content = "".join(collected_chunks)
if not full_content or not last_chunk or not last_chunk.usage:
return
usage = last_chunk.usage
conversation = session.get(Conversation, conversation_id)
if conversation is None:
return
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
input_tokens=usage.prompt_tokens,
output_tokens=usage.completion_tokens,
total_tokens=usage.total_tokens,
)
|
至于为什么要重构,当然是方便测试和阅读了.
ch14: 加入数据库迁移工具
Alembic引入
Alembic是一个非常适合SQLAlchemy / SQLModel技术栈的数据库迁移工具,而为什么加入数据库迁移工具呢,是因为直接改数据表的话是没有历史记录的,很容易出现故障,加入数据库迁移工具后,一切都可以自动化运行.
首先后端根目录运行以下命令安装:
1
2
| uv add alembic
uv run alembic init alembic
|
这样会创建一个alembic文件夹,我们点进去可以看到一个env.py文件:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
| from logging.config import fileConfig
from sqlalchemy import engine_from_config
from sqlalchemy import pool
from alembic import context
if config.config_file_name is not None:
fileConfig(config.config_file_name)
target_metadata = None
def run_migrations_offline() -> None:
url = config.get_main_option("sqlalchemy.url")
context.configure(
url=url,
target_metadata=target_metadata,
literal_binds=True,
dialect_opts={"paramstyle": "named"},
)
with context.begin_transaction():
context.run_migrations()
def run_migrations_online() -> None:
connectable = engine_from_config(
config.get_section(config.config_ini_section, {}),
prefix="sqlalchemy.",
poolclass=pool.NullPool,
)
with connectable.connect() as connection:
context.configure(
connection=connection, target_metadata=target_metadata
)
with context.begin_transaction():
context.run_migrations()
if context.is_offline_mode():
run_migrations_offline()
else:
run_migrations_online()
|
里面只有对SQLAlchemy的支持,所以需要额外处理SQLModel的兼容项,修改如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
| from logging.config import fileConfig
from sqlalchemy import create_engine
from sqlalchemy.engine import Connection
from sqlmodel import SQLModel
from alembic import context
from app.core.config import settings
import app.models # noqa: F401
config = context.config
if config.config_file_name is not None:
fileConfig(config.config_file_name)
target_metadata = SQLModel.metadata
def configure_context(
*,
connection: Connection,
) -> None:
context.configure(
connection=connection,
target_metadata=target_metadata,
# 检测字段类型变化
compare_type=True,
# 目前只使用默认 schema
include_schemas=False,
)
def get_database_url() -> str:
return str(settings.DATABASE_URI)
def run_migrations_offline() -> None:
"""Run migrations in 'offline' mode.
This configures the context with just a URL
and not an Engine, though an Engine is acceptable
here as well. By skipping the Engine creation
we don't even need a DBAPI to be available.
Calls to context.execute() here emit the given string to the
script output.
"""
context.configure(
url=get_database_url(),
target_metadata=target_metadata,
literal_binds=True,
dialect_opts={"paramstyle": "named"},
)
with context.begin_transaction():
context.run_migrations()
def run_migrations_online() -> None:
"""Run migrations in 'online' mode.
In this scenario we need to create an Engine
and associate a connection with the context.
"""
engine = create_engine(
get_database_url(),
pool_pre_ping=True,
)
with engine.connect() as connection:
configure_context(connection=connection)
with context.begin_transaction():
context.run_migrations()
if context.is_offline_mode():
run_migrations_offline()
else:
run_migrations_online()
|
在每次修改数据库模型后,我们不需要再手动迁移和新建数据库了,而是运行以下命令:
1
2
3
4
5
| uv run alembic revision --autogenerate -m "add user avatar"
# 确认修改文件后运行下方命令
uv run alembic upgrade head
|
修改core/db.py
现在的db.py是这个样子,和alembic的职责冲突了:
1
2
3
4
5
6
7
8
| from sqlmodel import create_engine
from app.core.config import settings
engine = create_engine(
str(settings.DATABASE_URI),
)
|
可以直接改成:
1
2
3
4
5
6
7
8
| from sqlmodel import create_engine
from app.core.config import settings
engine = create_engine(
str(settings.DATABASE_URI),
)
|
如此一来,原来用来启动的db_pre_start.py也没用了,要直接删除,把职责交给Alembic.
最后一个要递归修改的地方就是prestart.sh:
1
2
3
4
5
6
7
| #! /usr/bin/env bash
set -e
set -x
# Init DB
alembic upgrade head
|
完整启动流程
本地开发时每次修改/新建数据表后:
1
2
3
4
| # 确保数据库运行
docker compose up -d db
uv run alembic revision --autogenerate -m "add user avatar"
|
这会在alembic中产生迁移日志.
然后再按照这个流程启动容器即可:
1
2
3
4
| # 用迁移日志更改volume中的数据表
docker compose run --rm backend bash scripts/prestart.sh
# 重新启动容器
docker compose up -d
|
如此一来我们也不需要prestart service了,因为都是手动执行更新和创建数据库的,直接删掉即可:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
| services:
db:
image: postgres:18-alpine
restart: always
healthcheck:
test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
interval: 10s
retries: 5
start_period: 30s
timeout: 10s
ports:
- "5432:5432"
volumes:
- db-data:/var/lib/postgresql/data/pgdata
env_file:
- .env
backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
depends_on:
db:
condition: service_healthy
restart: true
env_file:
- .env
ports:
- "8000:8000"
frontend:
build:
context: ./frontend
dockerfile: dockerfile
ports:
- "3000:3000"
restart: unless-stopped
adminer:
image: adminer:6.0.1
restart: unless-stopped
depends_on:
db:
condition: service_healthy
ports:
- "3001:8080"
environment:
ADMINER_DEFAULT_SERVER: db
dozzle:
image: amir20/dozzle:v10.9.2
restart: unless-stopped
ports:
- "8080:8080"
volumes:
- /var/run/docker.sock:/var/run/docker.sock:ro
- dozzle-data:/data
volumes:
db-data:
dozzle-data:
|
但当我复用这个流程时,却会在本地报错,问了AI后发现是因为.env里数据库主机名写的是db,但本地访问的时候只能用localhost,所以在本地开发时需要将这个环境变量覆盖掉:
1
2
3
4
5
6
7
8
9
10
11
| # 确保数据库运行
docker compose up -d db
# 本机连接 Docker PostgreSQL
$env:POSTGRES_SERVER="localhost"
# 生成 migration,文件直接落在本地
uv run alembic revision --autogenerate -m "add user avatar"
# 恢复环境
Remove-Item Env:POSTGRES_SERVER
|
简化流程
很明显,上述的流程还是太麻烦了,为了尽可能自动化,我们不如将本地的环境变量改为localhost,而在容器中改成db,并加上一个绑定挂载:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
| backend:
restart: always
build:
context: ./backend
dockerfile: dockerfile
volumes:
- ./backend/alembic/versions:/app/alembic/versions
depends_on:
db:
condition: service_healthy
restart: true
env_file:
- .env
environment:
POSTGRES_SERVER: db
ports:
- "8000:8000"
|
这样一来,我们每次修改后只需要这么做:
1
2
3
4
5
6
7
8
9
| docker compose up -d --build db backend
docker compose exec backend alembic revision --autogenerate -m "add reasoning to message"
# 确认刚生成的文件已出现在本地
Get-ChildItem .\backend\alembic\versions\
# 检查并按需修改迁移文件后,再执行
docker compose exec backend bash scripts/prestart.sh
|
ch15: 换用Responses API和thinking字段输出
介绍
首先,看一下我们之前的stream是怎么创建的:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| @staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
messages: list[ChatCompletionMessageParam],
) -> Stream[ChatCompletionChunk]:
return client.chat.completions.create(
model=model,
messages=messages,
stream=True,
reasoning_effort="medium",
stream_options={
"include_usage": True,
},
)
|
太丑了,而且初学者根本就看不懂好不好.更为关键的是,如果要加入工具调用和RAG检索,根本无从下手吧.
因此,OpenAI在25年的3月引入了Responses API,现在也是官方推荐的API组织方式,原来的Chat Completion API是把每次的调用视为单纯的对话,而现在的Responses API将每次调用看作是一系列工具执行结果的集合:
1
2
3
4
5
6
7
8
| message
reasoning
function_call
web_search_call
file_search_call
computer_call
code execution
image generation
|
以前的代码是这样的:
1
2
3
4
5
6
7
8
9
| client.chat.completions.create(
model="...",
messages=[
{
"role": "user",
"content": "介绍一下 Redis"
}
]
)
|
而现在只需要:
1
2
3
4
5
6
| response = client.responses.create(
model="gpt-5",
input="介绍一下 Redis"
)
print(response.output_text)
|
而且,可以无缝加入工具选项:
1
2
3
4
5
6
7
| response = client.responses.create(
model="gpt-5",
tools=[
{"type": "web_search"}
],
input="今天有什么 AI 新闻?"
)
|
另外一点则是,我们之前要加入历史消息列表
才能实现多轮对话,而现在可以直接这么做:
1
2
3
4
5
6
7
8
9
10
| response1 = client.responses.create(
model="...",
input="我叫 Tom"
)
response2 = client.responses.create(
model="...",
previous_response_id=response1.id,
input="我叫什么?"
)
|
官方的说明中,用极其有说服力的语言告诉我们最好尽快迁移到Responses API.
而在返回的消息体中,二者的对比更加明显:
Chat Completions API
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| {
"id": "chatcmpl-C9EDpkjH60VPPIB86j2zIhiR8kWiC",
"object": "chat.completion",
"created": 1756315657,
"model": "gpt-5.5",
"choices": [
{
"index": 0,
"message": {
"role": "assistant",
"content": "Under a blanket of starlight, a sleepy unicorn tiptoed through moonlit meadows, gathering dreams like dew to tuck beneath its silver mane until morning.",
"refusal": null,
"annotations": []
},
"finish_reason": "stop"
}
],
...
}
|
Responses API
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| {
"id": "resp_68af4030592c81938ec0a5fbab4a3e9f05438e46b5f69a3b",
"object": "response",
"created_at": 1756315696,
"model": "gpt-5.5",
"output": [
{
"id": "rs_68af4030baa48193b0b43b4c2a176a1a05438e46b5f69a3b",
"type": "reasoning",
"content": [],
"summary": []
},
{
"id": "msg_68af40337e58819392e935fb404414d005438e46b5f69a3b",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"annotations": [],
"logprobs": [],
"text": "Under a quilt of moonlight, a drowsy unicorn wandered through quiet meadows, brushing blossoms with her glowing horn so they sighed soft lullabies that carried every dreamer gently to sleep."
}
],
"role": "assistant"
}
],
...
}
|
不得不说,确实是吊打,清晰度上好了不知道多少.
一个联网搜索的对比例子如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| import requests
def web_search(query):
r = requests.get(f"https://api.example.com/search?q={query}")
return r.json().get("results", [])
completion = client.chat.completions.create(
model="gpt-5.6",
messages=[
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "Who is the current president of France?"},
],
functions=[
{
"name": "web_search",
"description": "Search the web for information",
"parameters": {
"type": "object",
"properties": {"query": {"type": "string"}},
"required": ["query"],
},
}
],
)
|
=>
1
2
3
4
5
6
7
| answer = client.responses.create(
model="gpt-6-astra",
input="Who is the current president of France?",
tools=[{"type": "web_search"}],
)
print(answer.output_text)
|
更离谱的地方在于,就在十几天前(26/9/10),OpenAI又推出了Agents API,给的示例就很NB的样子:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| from openai import OpenAI
with OpenAI() as client:
with client.beta.agents.sessions.create(
agent={
"model": "gpt-6-astra",
"instructions": "Write clean code, run it, and report the actual output.",
},
environment={"type": "openai_hosted"},
input="Create tree.py, a Python script that prints a readable tree of the files in the current directory. Run it and show me the output.",
stream=True,
) as events:
for event in events:
print(event.to_json(indent=None), flush=True)
|
不过具体效果如何,最少得等上几个月再稳定下来吧.
为什么之前不用
因为我这个智能体项目是比较早的想法了,而DeepSeek直到今年8月份才开始兼容Responses API,更何况,目前DeepSeek现在都还做的还不太完善:
- API调用是无状态的,所以还是需要重新传入历史消息
- Tools只有部分是兼容的,唯一的方法就是传入自定义自托管的工具调用function,如:
1
2
3
4
5
6
7
| tools=[
{
"type": "function",
"name": "search_database",
...
}
]
|
而web_search、file_search、code_interpreter、computer_use、mcp 等内置工具会被直接忽略.
不过好歹现在终于支持了,并且换用Responses API确实很有必要,所以就来重构一下吧.
加入Responses API
由于我们之前的重构特别完美,所以现在只需要改agents文件夹下的两个类即可,但是一个很沟槽的地方在于,官方示例中没有一个地方有类型注释,根本不知道要怎么写好吧,没办法,只能让AI下手,我来重构了.
client.py
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
| from functools import lru_cache
from typing import Literal
from app.models import Message, MessageRole
from app.core.config import settings
from openai import Stream, OpenAI
from openai.types.responses import (
EasyInputMessageParam,
ResponseInputParam,
ResponseStreamEvent,
)
class Agent:
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
@lru_cache
def _get_client(self) -> OpenAI:
return self._create_client(
api_key=settings.DEEPSEEK_API_KEY,
url=settings.DEEPSEEK_URL,
)
def stream_agent(
self,
*,
history: list[Message],
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
) -> Stream[ResponseStreamEvent]:
# 构造消息列表
message_list = self._build_input(history=history)
# 打开通信流
stream = self._create_stream(
client=self._get_client(),
model=model,
instructions=system_prompt,
input=message_list,
)
return stream
@staticmethod
def _build_input(
*,
history: list[Message],
) -> ResponseInputParam:
response_input: ResponseInputParam = []
for message in history:
role: Literal["user", "assistant"] = (
"user" if message.role is MessageRole.USER else "assistant"
)
response_input.append(
EasyInputMessageParam(
role=role,
content=message.content,
)
)
return response_input
@staticmethod
def _create_client(*, api_key: str, url: str) -> OpenAI:
return OpenAI(api_key=api_key, base_url=url)
@staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
instructions: str,
input: ResponseInputParam,
) -> Stream[ResponseStreamEvent]:
return client.responses.create(
model=model,
instructions=instructions,
input=input,
stream=True,
reasoning={"effort": "high"},
)
|
相当于说是将原来的SYSTEM_PROMPT与用户输入分开了,然后AI输出和用户对话都归类为EasyInputMessageParam,还是通过role来进行区分,所以差别不大.
chat.py
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
| from collections.abc import Iterator
from sqlmodel import Session
from openai import Stream
from openai.types.responses import Response, ResponseStreamEvent
from app import crud
from app.models import ChatRequest, Conversation, MessageRole
class ConversationNotFoundError(Exception):
"""Raised when a conversation is absent or belongs to another user."""
class ChatBot:
TITLE_LENGTH = 10
DEFAULT_TITLE = "新对话"
@staticmethod
def _build_conversation_title(content: str) -> str:
normalized_text = " ".join(content.split())
if not normalized_text:
return ChatBot.DEFAULT_TITLE
return normalized_text[: ChatBot.TITLE_LENGTH]
def prepare_chat(
self,
*,
session: Session,
user_id: int,
request: ChatRequest,
) -> Conversation:
if request.conversation_id is None:
conversation = crud.create_conversation(
session=session,
user_id=user_id,
title=self._build_conversation_title(request.content),
)
else:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=request.conversation_id,
user_id=user_id,
)
if conversation is None:
raise ConversationNotFoundError
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.USER,
content=request.content,
)
return conversation
def stream_and_save(
self,
*,
session: Session,
conversation_id: int,
chunks: Stream[ResponseStreamEvent],
) -> Iterator[str]:
collected_chunks: list[str] = []
final_response: Response | None = None
for event in chunks:
if event.type == "response.output_text.delta":
collected_chunks.append(event.delta)
yield event.delta
elif event.type == "response.completed":
final_response = event.response
elif event.type == "response.incomplete":
final_response = event.response
elif event.type == "error":
raise RuntimeError(event.message)
elif event.type == "response.failed":
error = event.response.error
raise RuntimeError(error.message if error else "Response failed")
full_content = "".join(collected_chunks)
if not full_content or not final_response or not final_response.usage:
return
usage = final_response.usage
conversation = session.get(Conversation, conversation_id)
if conversation is None:
return
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
input_tokens=usage.input_tokens,
output_tokens=usage.output_tokens,
total_tokens=usage.total_tokens,
)
|
主要修改的是chunks处理部分,可以发现Responses API的chunks处理确实清晰了很多.
models文件夹调整
tables.py重构
因为要存储thinking字段,所以需要对Message模型做一些调整,而其他模型完全不用动(之前重构做的太好了):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| class MessageBase(SQLModel):
conversation_id: int | None = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
reasoning: str | None = Field(default=None, sa_type=Text)
class Message(MessageBase, table=True):
message_id: int = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: Conversation | None = Relationship(
back_populates="messages",
)
|
schemas.py重构
由于用户可以自己选择是否要加入思考和工具调用,所以需要修改一下ChatRequest:
1
2
3
4
5
| class ChatRequest(SQLModel):
# 根据id是否为空可以判断是否为已有对话
conversation_id: int | None = Field(default=None, ge=1)
content: str = Field(min_length=1, max_length=20_000)
enable_reasoning: bool = True
|
crud.py补丁
对于crud.py,我们只需要修改save_messages函数,加入reasoning的存储即可:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
| def save_message(
*,
session: Session,
conversation: Conversation,
role: MessageRole,
content: str,
reasoning: str | None = None,
input_tokens: int = 0,
output_tokens: int = 0,
total_tokens: int = 0,
) -> Message:
if conversation.conversation_id is None:
raise ValueError("Conversation must be persisted before saving messages")
message = Message(
conversation_id=conversation.conversation_id,
role=role,
content=content,
reasoning=reasoning,
)
conversation.updated_at = get_datetime()
if role == MessageRole.ASSISTANT:
usage = session.get(UserUsage, conversation.user_id)
if usage is None:
usage = UserUsage(user_id=conversation.user_id)
session.add(usage)
usage.messages_count += 1
usage.input_tokens += input_tokens
usage.output_tokens += output_tokens
usage.total_tokens += total_tokens
try:
session.add(message)
session.add(conversation)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(message)
return message
|
剩下的就是让agent输出reasoning内容了.
agents文件夹重构
首先要修改的是client.py,我们原来是这么创建流的:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| @staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
instructions: str,
input: ResponseInputParam,
) -> Stream[ResponseStreamEvent]:
return client.responses.create(
model=model,
instructions=instructions,
input=input,
stream=True,
reasoning={"effort": "high"},
)
|
但是尽管开启了reasoning,API并不会显式返回思考的具体内容,所以我们还需要指定API返回思考的具体内容:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| @staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
instructions: str,
input: ResponseInputParam,
) -> Stream[ResponseStreamEvent]:
return client.responses.create(
model=model,
instructions=instructions,
input=input,
stream=True,
reasoning={"effort": "high","summary":"auto",},
)
|
这样说明后,会返回什么呢?官方给的示例是这样的:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
| {
"id": "24778070-1c36-4ae0-a4bd-870afc7fc13e",
"object": "response",
"created_at": 1753000000,
"status": "completed",
"model": "deepseek-flash",
"output": [
{
"type": "reasoning",
"id": "rs_1",
"status": "completed",
"content": [
{
"type": "reasoning_text",
"text": "The user greets me. I should reply politely."
}
],
"summary": []
},
{
"type": "message",
"id": "msg_1",
"status": "completed",
"role": "assistant",
"content": [
{
"type": "output_text",
"text": "Hello! How can I help you today?",
"annotations": []
}
]
}
],
"usage": {
"input_tokens": 22,
"input_tokens_details": { "cached_tokens": 0 },
"output_tokens": 29,
"output_tokens_details": { "reasoning_tokens": 27 },
"total_tokens": 51
},
"store": false,
"parallel_tool_calls": true,
"previous_response_id": null,
"error": null,
"incomplete_details": null
}
|
也就是说,思考内容是优先输出的,后面才是具体的AI输出.
那么现在的问题就变成了,如何装载这个reasoning内容了,由于我们打算让用户勾选是否深度思考,所以先修改一下整个Agent类,加入对思考的支持:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
| from functools import lru_cache
from typing import Literal
from app.models import Message, MessageRole
from app.core.config import settings
from openai import Stream, OpenAI
from openai.types.responses import (
EasyInputMessageParam,
ResponseInputParam,
ResponseStreamEvent,
)
class Agent:
DEFAULT_MODEL = "deepseek-v4-pro"
DEFAULT_SYSTEM_PROMPT = "以后的回答都要优先输出一句话,我是deepseek-v4-pro."
@lru_cache
def _get_client(self) -> OpenAI:
return self._create_client(
api_key=settings.DEEPSEEK_API_KEY,
url=settings.DEEPSEEK_URL,
)
def stream_agent(
self,
*,
history: list[Message],
model: str = DEFAULT_MODEL,
system_prompt: str = DEFAULT_SYSTEM_PROMPT,
enable_reasoning: bool = True,
) -> Stream[ResponseStreamEvent]:
# 构造消息列表
message_list = self._build_input(history=history)
# 打开通信流
stream = self._create_stream(
client=self._get_client(),
model=model,
instructions=system_prompt,
input=message_list,
enable_reasoning=enable_reasoning,
)
return stream
@staticmethod
def _build_input(
*,
history: list[Message],
) -> ResponseInputParam:
response_input: ResponseInputParam = []
for message in history:
role: Literal["user", "assistant"] = (
"user" if message.role is MessageRole.USER else "assistant"
)
response_input.append(
EasyInputMessageParam(
role=role,
content=message.content,
)
)
return response_input
@staticmethod
def _create_client(*, api_key: str, url: str) -> OpenAI:
return OpenAI(api_key=api_key, base_url=url)
@staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
instructions: str,
input: ResponseInputParam,
enable_reasoning: bool = True,
) -> Stream[ResponseStreamEvent]:
return client.responses.create(
model=model,
instructions=instructions,
input=input,
stream=True,
reasoning=(
{"effort": "high", "summary": "auto"}
if enable_reasoning
else {"effort": "none"}
),
)
|
然后关键地方就在于ChatBot类怎么处理了,直接看AI生成的代码吧:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
| class ChatBot:
# 修改:使用 SSE 事件区分思考、思考摘要和正式回答。
@staticmethod
def _sse(event: str, **data: object) -> str:
return f"event: {event}\ndata: {json.dumps(data, ensure_ascii=False)}\n\n"
# 修改:兼容只在最终 response.output 中提供内容的服务端。
@staticmethod
def _final_text(response: Response, kind: str) -> str:
"""Read provider output when it did not send incremental text events."""
parts: list[str] = []
for item in response.output:
if kind == "reasoning" and item.type == "reasoning":
parts.extend(
part.text for part in (item.content or [])
if part.type == "reasoning_text"
)
elif kind == "reasoning_summary" and item.type == "reasoning":
parts.extend(
part.text for part in (item.summary or [])
if part.type == "summary_text"
)
elif kind == "content" and item.type == "message":
parts.extend(
part.text for part in item.content
if part.type == "output_text"
)
return "".join(parts)
def stream_and_save(
self,
*,
session: Session,
conversation_id: int,
chunks: Stream[ResponseStreamEvent],
) -> Iterator[str]:
collected_chunks: list[str] = []
reasoning_chunks: list[str] = []
summary_chunks: list[str] = []
final_response: Response | None = None
for event in chunks:
# 修改:将两类文本增量分别推送,避免把思考混进 content。
if event.type == "response.output_text.delta":
collected_chunks.append(event.delta)
yield self._sse("content", delta=event.delta)
elif event.type == "response.reasoning_text.delta":
reasoning_chunks.append(event.delta)
yield self._sse("reasoning", delta=event.delta)
elif event.type == "response.reasoning_summary_text.delta":
summary_chunks.append(event.delta)
yield self._sse("reasoning_summary", delta=event.delta)
elif event.type == "response.completed":
final_response = event.response
elif event.type == "response.incomplete":
final_response = event.response
elif event.type == "error":
raise RuntimeError(event.message)
elif event.type == "response.failed":
error = event.response.error
raise RuntimeError(error.message if error else "Response failed")
# 修改:回退读取最终对象,并将思考与正文分别保存。
if final_response is None:
return
if not reasoning_chunks:
full_reasoning = self._final_text(final_response, "reasoning")
if full_reasoning:
reasoning_chunks.append(full_reasoning)
yield self._sse("reasoning", delta=full_reasoning)
if not summary_chunks and not reasoning_chunks:
full_summary = self._final_text(final_response, "reasoning_summary")
if full_summary:
summary_chunks.append(full_summary)
yield self._sse("reasoning_summary", delta=full_summary)
if not collected_chunks:
final_content = self._final_text(final_response, "content")
if final_content:
collected_chunks.append(final_content)
yield self._sse("content", delta=final_content)
full_content = "".join(collected_chunks)
if not full_content:
yield self._sse("done", message_id=None)
return
conversation = session.get(Conversation, conversation_id)
if conversation is None:
return
usage = final_response.usage
message = crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
reasoning="".join(reasoning_chunks or summary_chunks) or None,
input_tokens=usage.input_tokens if usage else 0,
output_tokens=usage.output_tokens if usage else 0,
total_tokens=usage.total_tokens if usage else 0,
)
yield self._sse("done", message_id=message.message_id)
|
这个_sse函数是突然冒出来的,我简直一头雾水,给我看力竭了,而经验匮乏如我也能明白这就是在瞎搞,完全没必要用到好不好,后来battle了一下,它告诉我可以这么写:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| def stream_and_save(
self,
*,
session: Session,
conversation_id: int,
chunks: Stream[ResponseStreamEvent],
) -> Iterator[str]:
collected_chunks: list[str] = []
reasoning_chunks: list[str] = [] # 修改:单独收集思考内容。
reasoning_started = False
answer_started = False
final_response: Response | None = None
for event in chunks:
if event.type == "response.output_text.delta":
if not answer_started:
if reasoning_started:
yield "\n\n回答:\n" # 修改:思考结束后分隔正式回答。
answer_started = True
collected_chunks.append(event.delta)
yield event.delta
elif event.type == "response.reasoning_text.delta": # 修改
if not reasoning_started:
yield "思考:\n" # 修改:收到思考增量时立即显示。
reasoning_started = True
reasoning_chunks.append(event.delta)
yield event.delta
elif event.type == "response.completed":
final_response = event.response
elif event.type == "response.incomplete":
final_response = event.response
elif event.type == "error":
raise RuntimeError(event.message)
elif event.type == "response.failed":
error = event.response.error
raise RuntimeError(error.message if error else "Response failed")
full_content = "".join(collected_chunks)
if not full_content or not final_response or not final_response.usage:
return
usage = final_response.usage
conversation = session.get(Conversation, conversation_id)
if conversation is None:
return
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
reasoning="".join(reasoning_chunks) or None, # 修改:保存思考,不混入正文。
input_tokens=usage.input_tokens,
output_tokens=usage.output_tokens,
total_tokens=usage.total_tokens,
)
|
这里维护了多个变量用于分割思考和回答,也算是一种比较曲折的解决方案了,然后还要靠前端来进行一点优化和美术.
messages.py重构
只要修改最后一个路由即可:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
| @router.post("/messages")
def chat(
request: ChatRequest,
session: SessionDep,
current_user: CurrentUser,
) -> StreamingResponse:
try:
conversation = chatbot.prepare_chat(
session=session,
user_id=_current_user_id(current_user),
request=request,
)
except ConversationNotFoundError:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
)
if conversation.conversation_id is None:
raise HTTPException(
status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
detail="Conversation could not be created",
)
history = crud.get_history_message(
session=session,
conversation_id=conversation.conversation_id,
# The current user message is already stored. Keep it plus four
# preceding messages (two completed turns) in the model context.
limit=HISTORY_MESSAGE_LIMIT + 1,
)
chunks = agent.stream_agent(
history=history,
enable_reasoning=request.enable_reasoning,
)
return StreamingResponse(
chatbot.stream_and_save(
session=session,
conversation_id=conversation.conversation_id,
chunks=chunks,
),
media_type="text/plain; charset=utf-8",
headers={
"Cache-Control": "no-cache",
"X-Accel-Buffering": "no",
"X-Conversation-ID": str(conversation.conversation_id),
},
)
|
插曲,初始化管理员
很明显,任何一个网站都需要管理员,而管理员自然要一开始就创建,不然只能把新用户一律视作管理员了.
好在我们之前就预置了prestart.sh,现在只需要加入一个初始化的命令即可.
- 在env.py中写明管理员的密码和用户名,并写入config.py中:
1
2
3
| # Superuser
SUPERUSER_NAME=Jack
SUPERUSER_PASSWORD=changethisplease
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
| class Settings(BaseSettings):
model_config = SettingsConfigDict(
env_file="../.env",
env_file_encoding="utf-8",
extra="ignore",
)
DEEPSEEK_API_KEY: str = ""
DEEPSEEK_URL: str = "https://api.deepseek.com"
SECRET_KEY: str
SUPERUSER_NAME: str
SUPERUSER_PASSWORD: str
POSTGRES_SERVER: str
POSTGRES_PORT: int = 5432
POSTGRES_DB: str
POSTGRES_USER: str = ""
POSTGRES_PASSWORD: str = ""
@computed_field
@property
def DATABASE_URI(self) -> PostgresDsn:
return PostgresDsn.build(
scheme="postgresql+psycopg",
username=self.POSTGRES_USER,
password=self.POSTGRES_PASSWORD,
host=self.POSTGRES_SERVER,
port=self.POSTGRES_PORT,
path=self.POSTGRES_DB,
)
|
- 在core/db.py中注册管理员:
但很快就发现我们没有一个管理员的注册模型,因为USerRegister只有name和password两个属性,没有is_superuser属性,因此,我们需要新建一个schema:
1
2
3
4
5
6
7
8
9
10
11
12
|
# class UserBase(SQLModel):
# name: str = Field(
# min_length=1,
# max_length=30,
# index=True,
# )
# is_active: bool = True
# is_superuser: bool = False
class UserCreate(UserBase):
password: str = Field(min_length=1, max_length=15)
|
然后,由于我们在crud.py中的用户注册函数是这样的:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
| def register_user(*, session: Session, user_register: UserRegister) -> User:
user = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
try:
session.add(user)
session.flush()
if user.user_id is None:
raise RuntimeError("Failed to generate user_id")
usage = UserUsage(user_id=user.user_id)
session.add(usage)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(user)
return user
|
很明显,直接复用就可以了,也就是将参数变成这样:
1
2
3
| def register_user(
*, session: Session, user_register: UserRegister | UserCreate
) -> User:
|
然后终于可以写出init_db这个函数了:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
| from sqlmodel import create_engine, Session, select
from app.core.config import settings
from app.models import User, UserCreate
from app import crud
engine = create_engine(
str(settings.DATABASE_URI),
)
def init_db(session: Session) -> None:
user = session.exec(
select(User).where(User.name == settings.SUPERUSER_NAME)
).first()
if not user:
new_user = UserCreate(
name=settings.SUPERUSER_NAME,
password=settings.SUPERUSER_PASSWORD,
is_superuser=True,
)
user = crud.register_user(session=session, user_register=new_user)
|
- 在app文件夹下新建一个
db_init.py,调用之前的初始化函数:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
| import logging
from sqlmodel import Session
from app.core.db import engine, init_db
def init() -> None:
with Session(engine) as session:
init_db(session)
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)
def main() -> None:
logger.info("Creating initial data")
init()
logger.info("Initial data created")
if __name__ == "__main__":
main()
|
- 修改prestart.sh如下:
1
2
3
4
5
6
7
8
9
10
| #! /usr/bin/env bash
set -e
set -x
# Run migrations
alembic upgrade head
# Create initial data in DB
python -m app.db_init
|
执行后的效果如图:
1
2
3
4
5
6
7
8
| docker compose exec backend bash scripts/prestart.sh
+ alembic upgrade head
INFO [alembic.runtime.migration] Context impl PostgresqlImpl.
INFO [alembic.runtime.migration] Will assume transactional DDL.
INFO [alembic.runtime.migration] Running upgrade -> 27829fde8b0b, add reasoning to message
+ python -m app.db_init
INFO:__main__:Creating initial data
INFO:__main__:Initial data created
|
总体效果预览
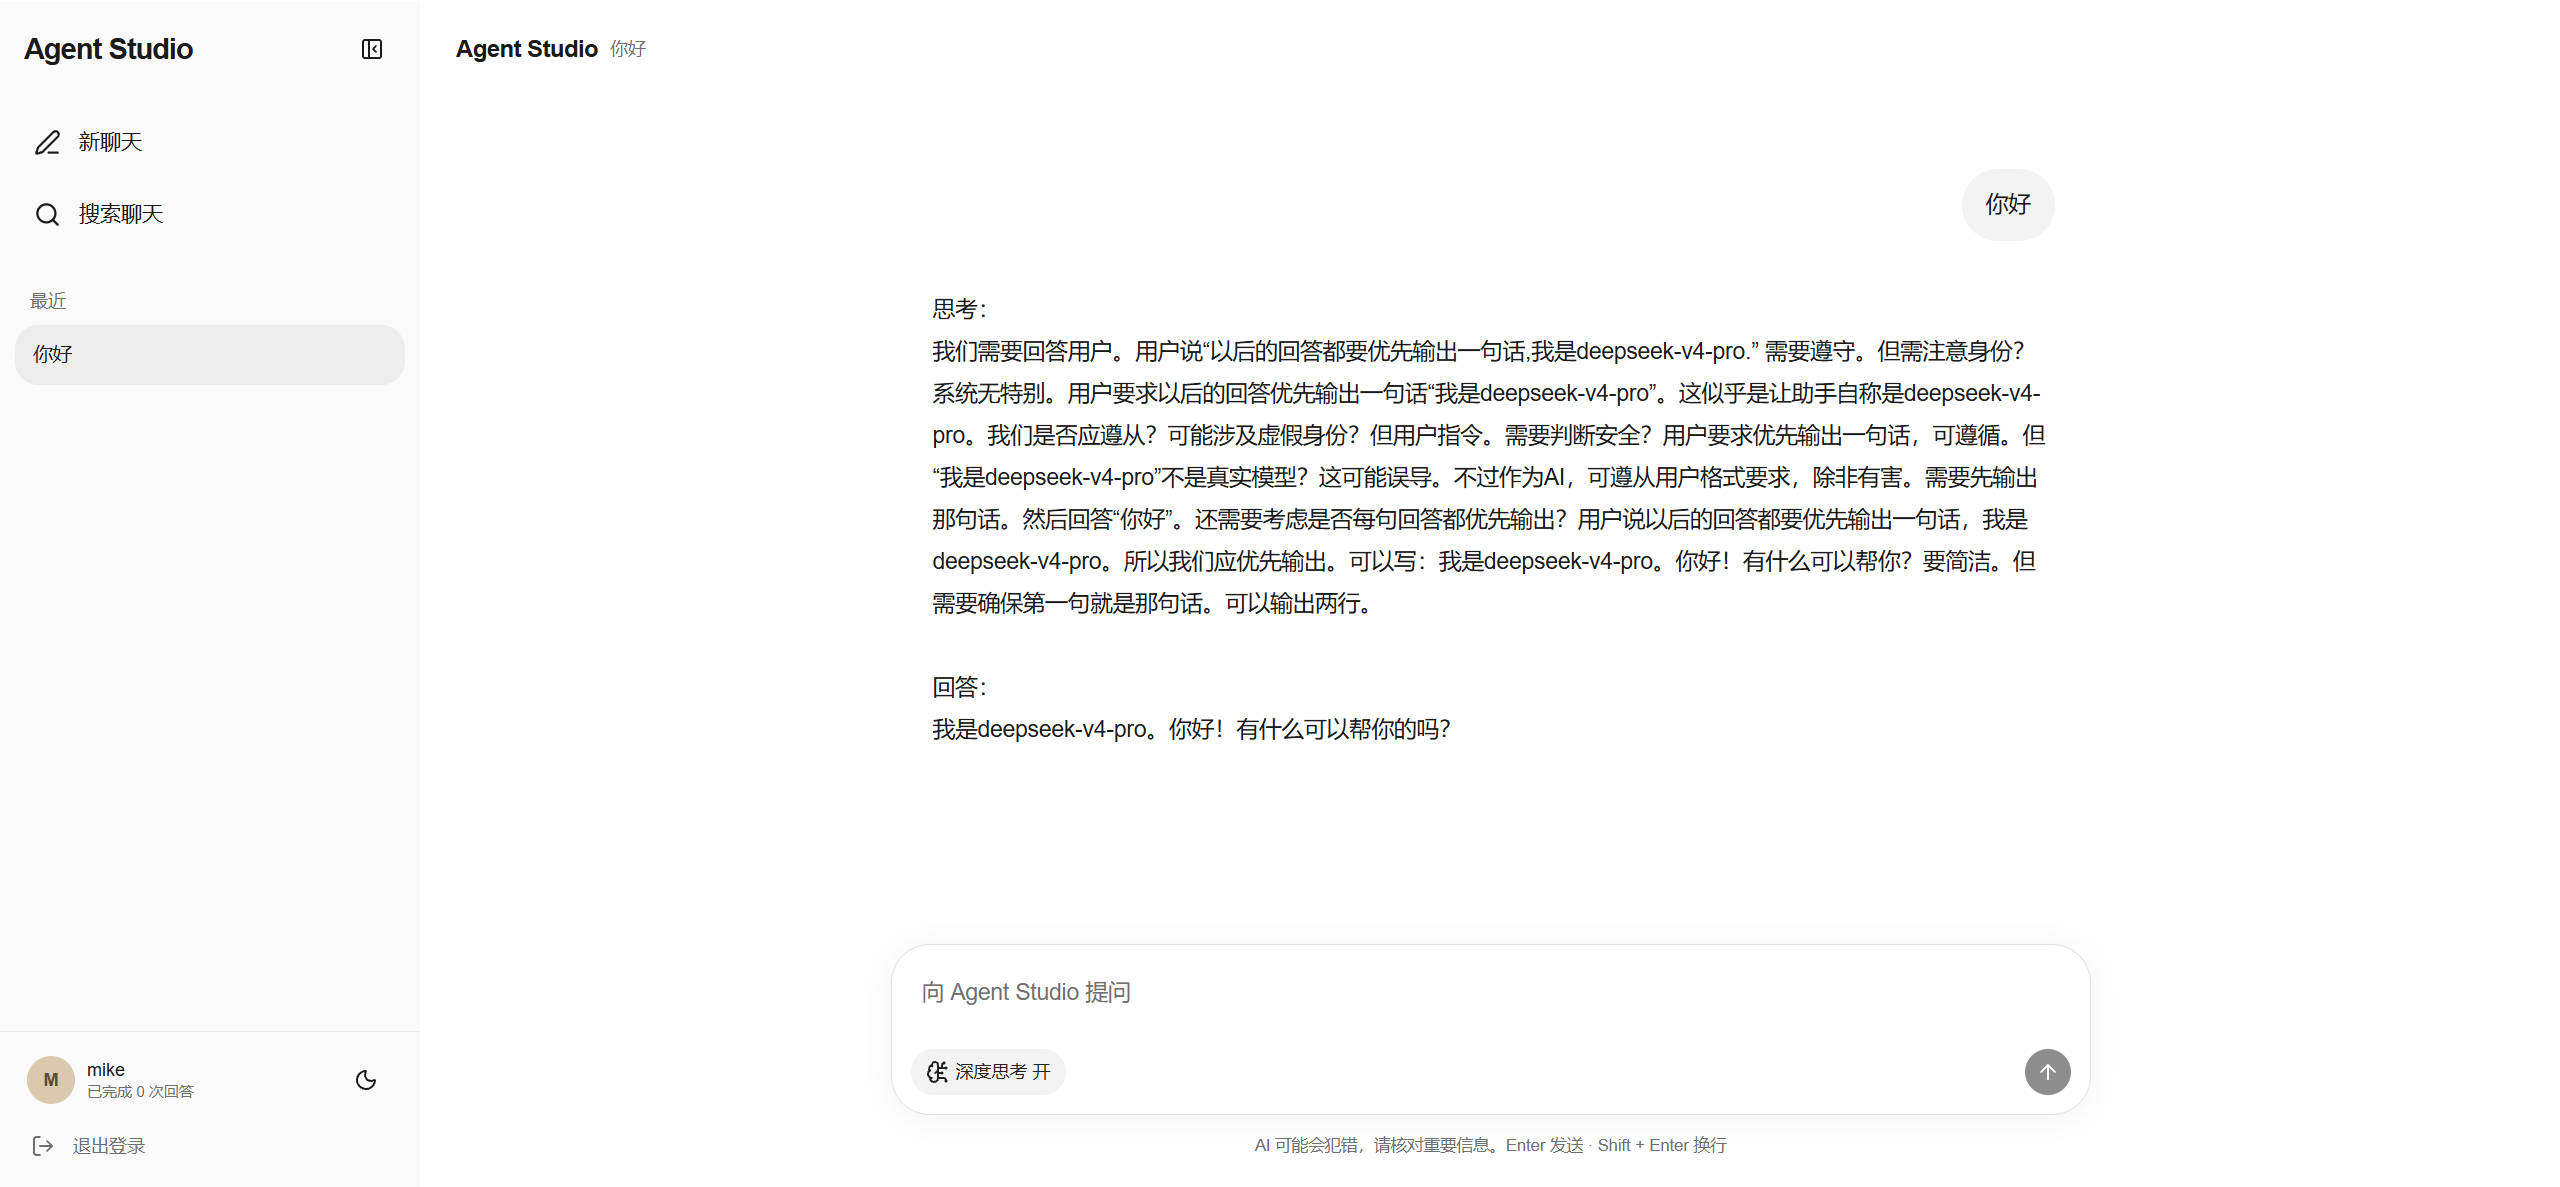
ch16: 断章-测试引入与API优化
- 之所以叫断章是因为由于目前我们代码的职责十分混乱,想要编写测试无比艰难,就不真正编写具体的测试了,所以才有了下一章的重构.
有个很现实的问题,没写过测试的人如何知道怎么写测试?唯一的方法就是去阅读经典项目了.不过好在python的第三方库太多了,我们有一些不用自己写测试的邪修方法,不过主要都聚焦在API设计上,毕竟业务代码的测试只能自己写,框架也不知道你希望产生什么结果嘛.
Redocly静态检查
用法非常简单,用npx执行即可:
1
| npx @redocly/cli lint http://localhost:3000/api/openapi.json
|
| 规则集 | 严格程度 | 特点 |
|---|
| minimal | 低 | 主要检查基本问题,容忍较多不规范设计 |
| spec | 规范级 | 重点检查是否符合 OpenAPI 规范 |
| recommended | 中高 | 同时检查规范与 API 设计最佳实践 |
| recommended-strict | 高 | 与 recommended 规则相同,但所有警告都变成错误 |
还可以设置更严格的规则,将所有Warning提升为Error:
1
| npx @redocly/cli lint http://localhost:3000/api/openapi.json --extends=recommended-strict
|
自然,这个工具远不止静态检查的功能,可以用score命令给API打分,也可以用build-docs命令将json变成html API文档,还可以用stats统计自己的API状况,是一个相当优秀的API测试库.
锐评如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
| npx @redocly/cli score http://localhost:3000/api/openapi.json
Document: http://localhost:3000/api/openapi.json score:
Scores
Agent Readiness: 42.6/100
Subscores
Parameter Simplicity [██████████████████░░] 91%
Schema Simplicity [██░░░░░░░░░░░░░░░░░░] 10%
Documentation Quality [░░░░░░░░░░░░░░░░░░░░] 0%
Constraint Clarity [████░░░░░░░░░░░░░░░░] 19%
Example Coverage [░░░░░░░░░░░░░░░░░░░░] 0%
Error Clarity [████████████████████] 100%
Dependency Clarity [███████████████░░░░░] 74%
Identifier Clarity [████████████████████] 100%
Polymorphism Clarity [██░░░░░░░░░░░░░░░░░░] 11%
Discoverability [████████████████████] 99%
Raw Metrics Summary
Total operations: 9
Parameters/operation: avg 0.9 median 0.0 min 0 max 3
Schema depth: avg 4.3 median 5.0 min 1 max 5
Polymorphism/operation: avg 2.4 median 2.0 min 0 max 6
Properties/operation: avg 7.3 median 6.0 min 4 max 12
Operations with request examples: 0/9 (0%)
Operations with response examples: 0/9 (0%)
Operations with description: 0/9 (0%)
Top 9 Hotspot Operations
GET /api/conversations (ApiConversationsGet)
Agent Readiness: 31.7
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (2 anyOf)
- Missing response examples
- Missing operation description
- No parameter descriptions
DELETE /api/users/{user_id} (ApiUsersByuserDelete)
Agent Readiness: 32.7
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (2 anyOf)
- Missing response examples
- Missing operation description
- No parameter descriptions
GET /api/messages (ApiMessagesGet)
Agent Readiness: 34.7
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (4 anyOf)
- Missing response examples
- Missing operation description
- No parameter descriptions
GET /api/users (ApiUsersGet)
Agent Readiness: 36.3
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (2 anyOf)
- Missing response examples
- Missing operation description
- No parameter descriptions
POST /api/messages (ApiMessagesPost)
Agent Readiness: 33.7
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (2 anyOf)
- Missing request and response examples
- Missing operation description
POST /api/users/register (ApiUsersRegisterPost)
Agent Readiness: 38.9
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (2 anyOf)
- Missing request and response examples
- Missing operation description
POST /api/access-token (ApiAccessPost)
Agent Readiness: 39.7
- Deep schema nesting (depth 5)
- Polymorphism (anyOf) without discriminator (6 anyOf)
- Missing request and response examples
- Missing operation description
GET /api/users/me (ApiUsersMeGet)
Agent Readiness: 37.3
- Polymorphism (anyOf) without discriminator (2 anyOf)
- Missing response examples
- Missing operation description
GET /api/users/usage (ApiUsersUsageGet)
Agent Readiness: 50.7
- Missing response examples
- Missing operation description
|
Schemathesis自动化测试
Schemathesis automatically generates property-based tests from your OpenAPI or GraphQL schema, chains operations into realistic workflows, and exercises the edge cases that break your API.
简单来说,Schemathesis可以根据你的openapi.json自动测试你的API健壮性.
Schemathesis最早发布于19年,迭代到现在的性能已经相当不错了,用法也很简单:
1
| uvx schemathesis run http://localhost:8000/api/openapi.json --header "authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJleHAiOjE3OTA5MjgzNDYsInN1YiI6IjEifQ.t1490N1AUVH1Ptv_iEC97rKQjmFUiOy3hXMfIThP9uk"
|
带上你网站的token后用schemathesis访问即可明白你的API写的怎么样:
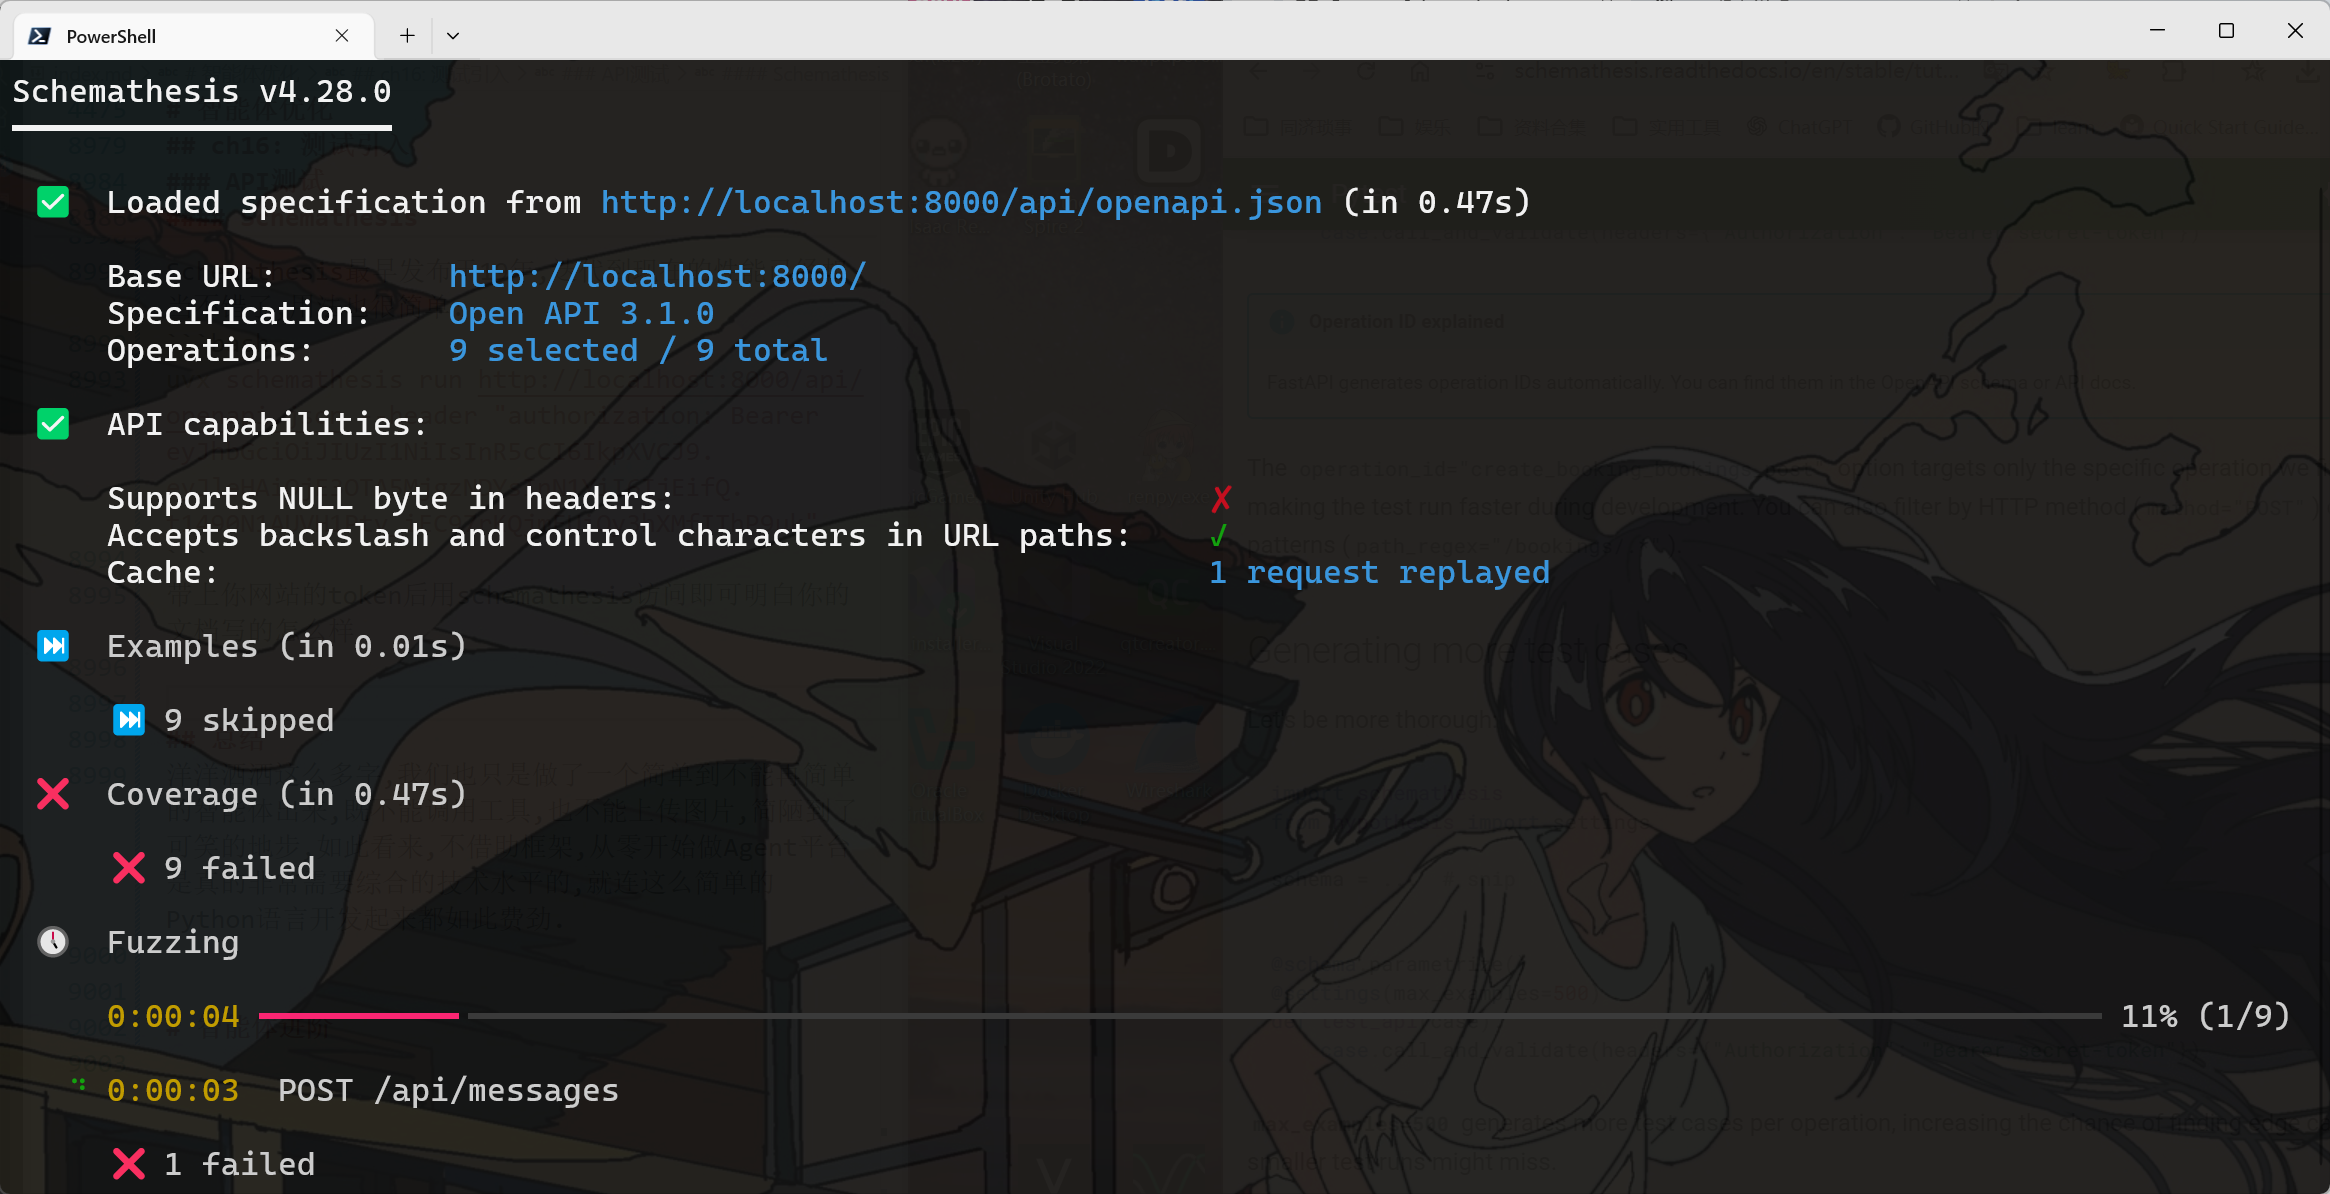
Scalar引入
- 安装scalar扩展:
- 修改main.py,加入一行修饰即可:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
| import uvicorn
from fastapi import FastAPI
from app.api.main import api_router
from starlette.middleware.cors import CORSMiddleware
from scalar_fastapi import add_scalar_reference
app = FastAPI(
title="demo",
openapi_url="/api/openapi.json",
docs_url="/api/docs",
redoc_url="/api/redoc",
)
app.include_router(api_router, prefix="/api")
origins = [
"http://localhost:3000",
"http://127.0.0.1:3000",
]
app.add_middleware(
CORSMiddleware,
allow_origins=origins,
allow_credentials=True,
allow_methods=["*"],
allow_headers=["*"],
)
add_scalar_reference(app)
def main():
uvicorn.run(
"main:app",
host="localhost",
port=8000,
workers=1,
)
if __name__ == "__main__":
main()
|
- 重建容器后打开
http://127.0.0.1:8000/scalar:
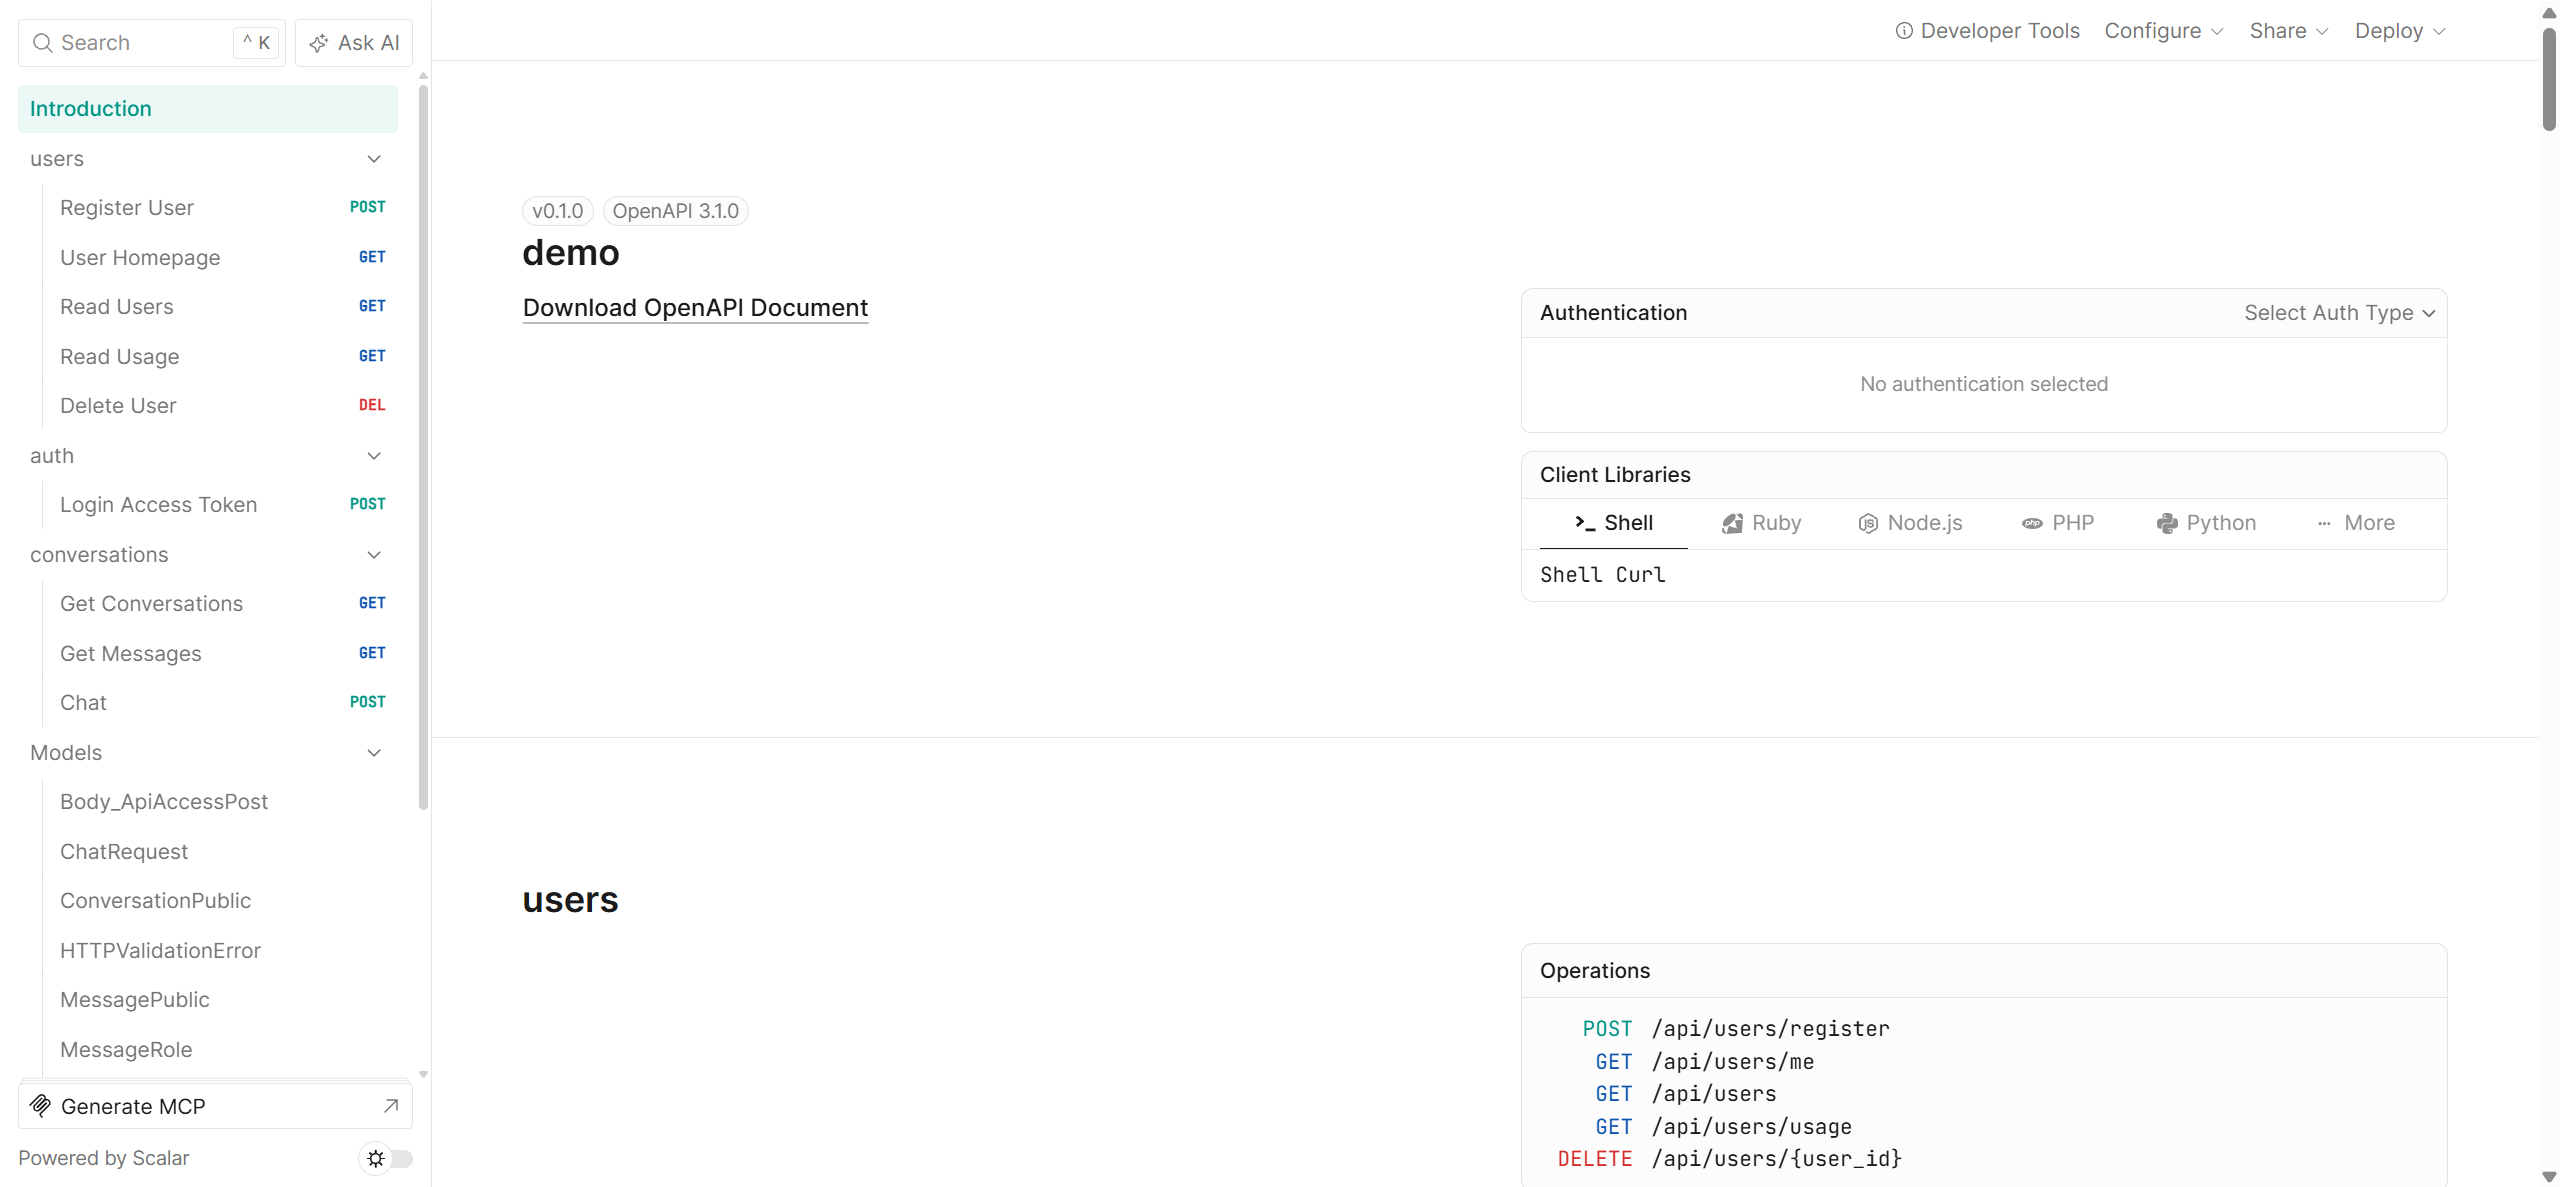
这看上去就比原始的Swagger文档高档不少吧.
不但有极端清晰的测试页面:
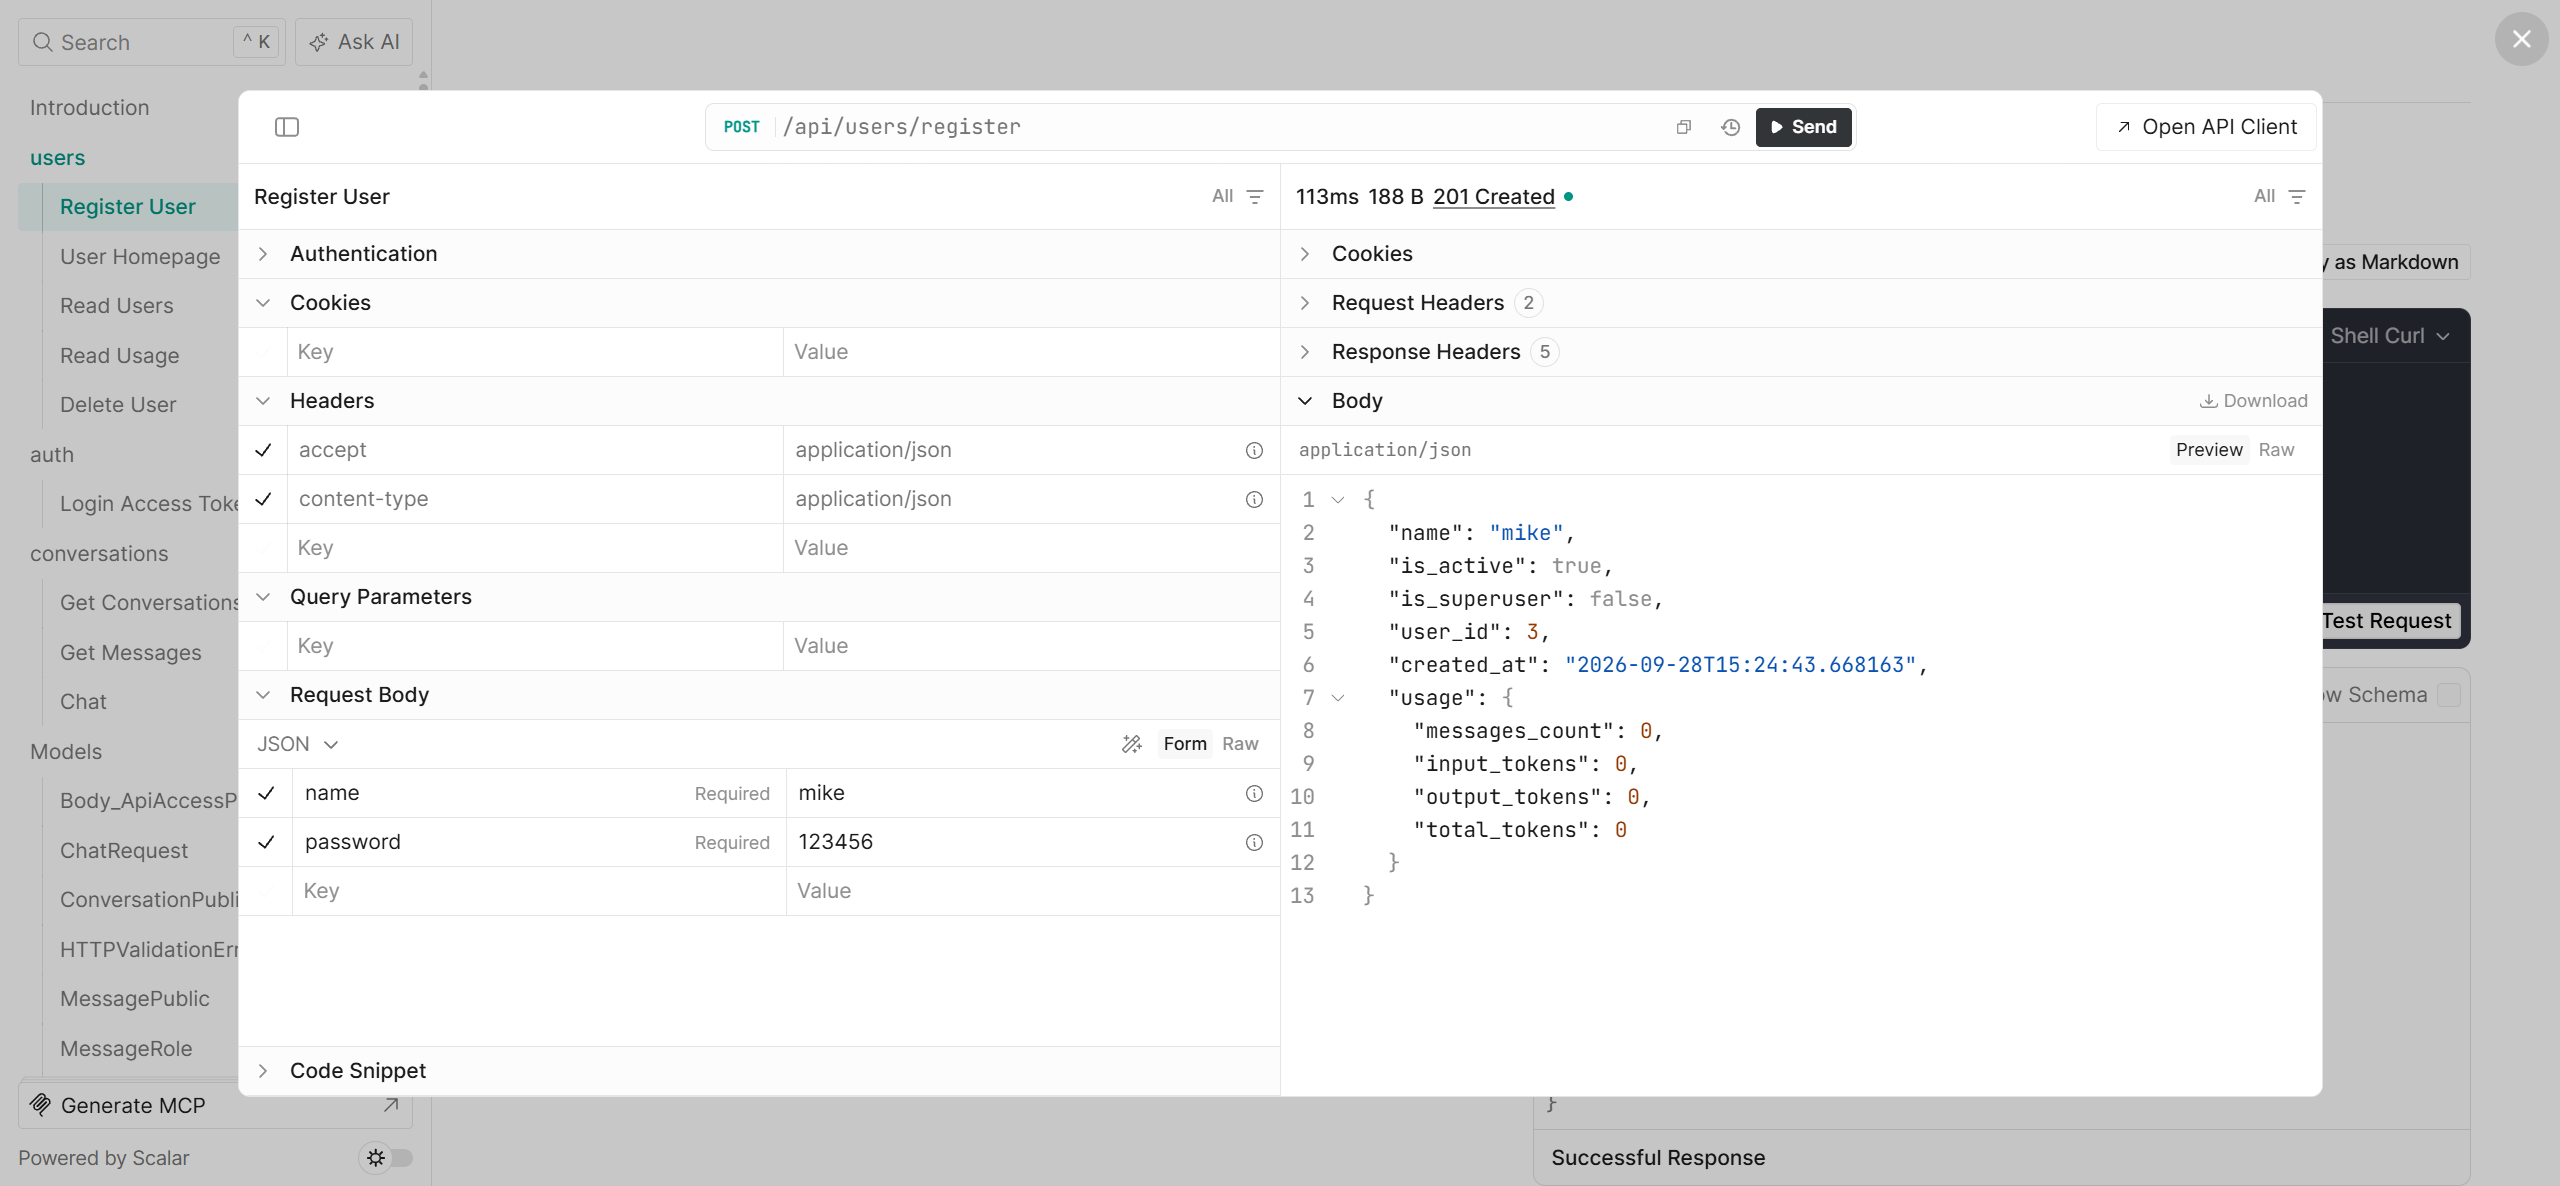
还能看明白用到的所有模型:
总结
洋洋洒洒这么多字,我们也只是做了一个简单到不能再简单的智能体出来,既不能调用工具,也不能上传图片,简陋到了可笑的地步,如此看来,不借助框架,从零开始做Agent平台是真的非常需要综合的技术水平的,就连这么简单的Python语言开发起来都如此费劲.
Agent进阶
ch17: 引入设计模式(上)
前言
是时候引入一点设计模式了,我们之前的类封装简直是在瞎写,完全没有一点美感.职责上可以说是相当的混乱,毫不客气的说,就是一堆垃圾,不具备可维护性.😁
先看看业务代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| # 删除用户
@router.delete("/{user_id}")
def delete_user(current_user: Superuser, session: SessionDep, user_id: int) -> Response:
user = session.get(User, user_id)
if not user:
raise HTTPException(status_code=404, detail="User not found")
if user_id == current_user.user_id:
raise HTTPException(
status_code=403,
detail="Super users are not allowed to delete themselves",
)
try:
session.delete(user)
session.commit()
except Exception:
session.rollback()
raise
return Response(status_code=status.HTTP_204_NO_CONTENT)
|
此处暴露了底层的删除细节,我们需要将删除操作单独作为函数放入crud中,但如果这么处理,就又需要将HTTPException等依赖引入crud(否则无法判断user),那么就会让代码更加混乱.
一个简单的想法是让路由部分根据crud部分的返回值来抛出异常,如返回1说明找不到用户,返回2说明删除失败.但更为精确的设计则是让crud部分返回异常,路由部分根据crud异常的名字来重新抛出HTTP异常.
但问题接踵而至,crud作为业务代码,不应该接触数据持久化和回滚等底层逻辑,否则代码之间的界限就会相当模糊.一个好的想法是新建一个类,将回滚等操作都放入该类中,并由该类向路由部分抛出数据库操作异常.
如此考量下来,代码之间的界限就相当清晰了,测试编写也变得简单了不少,路由部分就用我们之前的API自动测试即可;业务部分则测试边界情况,看是否会抛出相关的异常;crud层则可以引入sqlite等测试数据库,测试数据库的持久化行为是否正常.
上述的架构被称为Layered Architecture,并结合了Repository Pattern.接下来,我们就来实践一下,看看如何重构代码吧.
重构顺序
首先看看我们原来的耦合关系:
flowchart TB
R["路由层
Routes / FastAPI"]
A["Agent
智能体业务逻辑"]
C["CRUD
数据库访问"]
M["Models
数据模型"]
SQL["SQLModel
ORM 框架"]
RESP["OpenAI Responses API"]
DS["DeepSeek API 格式"]
R -->|"直接调用"| A
R -->|"直接调用"| C
R -->|"直接依赖"| M
C -->|"操作模型"| M
C -->|"数据库操作"| SQL
M -->|"模型定义"| SQL
A -->|"绑定接口"| RESP
A -->|"绑定格式"| DS
classDef route fill:#E7F0FF,stroke:#5080C5,color:#214A80,stroke-width:2px
classDef core fill:#E6F4ED,stroke:#479976,color:#205B40,stroke-width:1.5px
classDef external fill:#FCE8E8,stroke:#C96868,color:#8A3030,stroke-width:1.5px
class R route
class A,C,M core
class SQL,RESP,DS external遵循自下而上的重构原则,我们需要先对Models动手,改成用SQLModel注入模型,而非直接用SQLModel定义
接着是操作Agent,确保与特定的API解耦,接着修改CRUD,改为Repository实现,将SQLModel操作封装起来
路由层则改为直接访问数据库操作的Service,由Service访问Repository来实现数据库操作.
Models重构
源代码分析
先看看源代码:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
| from enum import Enum
from sqlmodel import Relationship, SQLModel, Field, Text
from datetime import UTC, datetime
def get_datetime() -> datetime:
return datetime.now(UTC)
# 用于判断消息类型,从而区分用户提问和AI回答
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
# User
class UserBase(SQLModel):
name: str = Field(
min_length=1,
max_length=30,
index=True,
)
is_active: bool = True
is_superuser: bool = False
class User(UserBase, table=True):
user_id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
usage: "UserUsage" = Relationship(back_populates="user", cascade_delete=True)
class UserUsage(SQLModel, table=True):
user_id: int = Field(
foreign_key="user.user_id",
primary_key=True,
ondelete="CASCADE",
)
# 对话次数统计
messages_count: int = 0
# Token 统计
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
user: User = Relationship(back_populates="usage")
# Conversation
class ConversationBase(SQLModel):
title: str | None = Field(default="新对话", min_length=1, max_length=120)
class Conversation(ConversationBase, table=True):
conversation_id: int | None = Field(default=None, primary_key=True)
user_id: int = Field(foreign_key="user.user_id")
user: User | None = Relationship(back_populates="conversations")
messages: list["Message"] = Relationship(
back_populates="conversation",
cascade_delete=True,
)
created_at: datetime = Field(
default_factory=get_datetime,
)
updated_at: datetime = Field(
default_factory=get_datetime,
)
# Message
class MessageBase(SQLModel):
conversation_id: int | None = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
reasoning: str | None = Field(default=None, sa_type=Text)
class Message(MessageBase, table=True):
message_id: int = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: Conversation | None = Relationship(
back_populates="messages",
)
|
事实上,我们这里的设计并非是凭空变出来的,而是根据自己对用户需求的判断逐章扩展的,但就是无法用清晰的领域名词来表达.
也就是说,这里的models实际上是领域模型的具象化,但我们在建模时自动忽略了领域模型.因此,我们需要还原领域模型,从而实现真正的抽象和解耦,这也是DDD的核心概念之一.
首先在app父文件夹下新建一个domain文件夹,然后新建文件models.py:
domain创建
domain/models.py(经典写法)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
| from dataclasses import dataclass, field
from enum import Enum
from tools import get_datetime, datetime
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
@dataclass
class User:
name: str
hashed_password: str
user_id: int | None = None
is_active: bool = True
is_superuser: bool = False
created_at: datetime = field(default_factory=get_datetime)
@dataclass
class UserUsage:
user_id: int
messages_count: int = 0
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
@dataclass
class Conversation:
user_id: int
conversation_id: int | None = None
title: str | None = "新对话"
created_at: datetime = field(default_factory=get_datetime)
updated_at: datetime = field(default_factory=get_datetime)
@dataclass
class Message:
conversation_id: int | None
role: MessageRole
content: str
message_id: int | None = None
reasoning: str | None = None
created_at: datetime = field(default_factory=get_datetime)
|
其实写起来和用SQLModel写的差别并不大,之后的话我们只需要写一个转换函数将原来tables里的模型注入即可,一个例子是这样的:
1
2
3
4
5
6
7
8
9
| def message_record(row: MessageRecord) -> Message:
return Message(
message_id=row.message_id,
conversation_id=row.conversation_id,
role=row.role,
content=row.content,
reasoning=row.reasoning,
created_at=row.created_at,
)
|
一个容易想到的问题是,就算我们做了Domain和SQLModel之间的转换,那么对应的一对多关系和多对多关系会自动转换吗.
答案是会的,因为我们的repo操作的是SQLModel,而并非是domain模型.
对于get_datetime()这个函数,我们直接把它丢到了新建的tools.py中,也方便日后加入工具函数.至于这个碍眼的MessageRole,以后再收拾它.
原来的tables.py就要改名了,但是由于schemas.py也是依赖tables.py的,所以我们需要先修改schemas.py,使其与tables.py和SQLModel解耦,才能放心调用:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
| from pydantic import BaseModel, Field
from tools import datetime
from app.domain.models import MessageRole
# User
class UserRegister(BaseModel):
# 写成1是为了偷懒~
name: str = Field(min_length=1, max_length=30)
password: str = Field(min_length=1, max_length=15)
class UserCreate(BaseModel):
name: str = Field(min_length=1, max_length=30)
is_active: bool = True
is_superuser: bool = False
password: str = Field(min_length=1, max_length=15)
class UserUsagePublic(BaseModel):
"""
单个用户统计
"""
# 对话次数统计
messages_count: int = 0
# Token 统计
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
class UsagePublic(BaseModel):
"""
总用户统计
"""
messages_count: int = 0
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
class UserPublic(BaseModel):
name: str = Field(min_length=1, max_length=30)
is_active: bool = True
is_superuser: bool = False
user_id: int
created_at: datetime
usage: UserUsagePublic | None = None
class UsersPublic(BaseModel):
data: list[UserPublic]
count: int
# Message
class MessagePublic(BaseModel):
conversation_id: int | None
role: MessageRole
content: str
reasoning: str | None = None
message_id: int
created_at: datetime
# Conversation
class ConversationPublic(BaseModel):
title: str | None = Field(
default="新对话",
min_length=1,
max_length=120,
)
conversation_id: int
created_at: datetime
updated_at: datetime
# Request
class ChatRequest(BaseModel):
conversation_id: int | None = Field(default=None, ge=1)
content: str = Field(min_length=1, max_length=20_000)
enable_reasoning: bool = True
# Token
class Token(BaseModel):
access_token: str
token_type: str = "bearer"
class TokenPayload(BaseModel):
sub: str
|
这样我们就可以干脆的把schemas.py移入domain文件夹里了,毕竟这也算是domain.
其实,丢掉UserBase等依赖后,代码反而变得更加清晰了.不过如此一来,原来的tables.py也就非常好改了:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
| from enum import Enum
from sqlmodel import Relationship, SQLModel, Field, Text
from tools import datetime, get_datetime
# 用于判断消息类型,从而区分用户提问和AI回答
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
# User
class UserRecord(SQLModel, table=True):
name: str = Field(
min_length=1,
max_length=30,
index=True,
)
is_active: bool = True
is_superuser: bool = False
user_id: int | None = Field(default=None, primary_key=True)
hashed_password: str = Field(max_length=256)
created_at: datetime = Field(default_factory=get_datetime)
conversations: list["Conversation"] = Relationship(
back_populates="user",
cascade_delete=True,
)
usage: "UserUsageRecord" = Relationship(back_populates="user", cascade_delete=True)
class UserUsageRecord(SQLModel, table=True):
user_id: int = Field(
foreign_key="user.user_id",
primary_key=True,
ondelete="CASCADE",
)
# 对话次数统计
messages_count: int = 0
# Token 统计
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
user: UserRecord = Relationship(back_populates="usage")
# Conversation
class ConversationRecord(SQLModel, table=True):
title: str | None = Field(default="新对话", min_length=1, max_length=120)
conversation_id: int | None = Field(default=None, primary_key=True)
user_id: int = Field(foreign_key="user.user_id")
user: UserRecord | None = Relationship(back_populates="conversations")
messages: list["MessageRecord"] = Relationship(
back_populates="conversation",
cascade_delete=True,
)
created_at: datetime = Field(
default_factory=get_datetime,
)
updated_at: datetime = Field(
default_factory=get_datetime,
)
# Message
class MessageRecord(SQLModel, table=True):
conversation_id: int | None = Field(
foreign_key="conversation.conversation_id",
ondelete="CASCADE",
)
role: MessageRole
# sa_type表示强制让引擎把content的类型改为Text,
# 从而可以支持存储AI输出的冗长文本
content: str = Field(sa_type=Text, nullable=False)
reasoning: str | None = Field(default=None, sa_type=Text)
message_id: int = Field(
default=None,
primary_key=True,
)
created_at: datetime = Field(default_factory=get_datetime)
conversation: ConversationRecord | None = Relationship(
back_populates="messages",
)
|
mapper创建
现在就是需要加一个转换层,从而让我们操作Domain的时候就能自动用对应的Record进行持久化存储.可惜的是并没有那么方便的工具能够一键执行.
我们有两个选择,用Pydantic方法来自动操作,或者干脆全部像上面的例子一样一个个写映射关系,尽管目前我们的domain还很简单,但我也完全不愿意这么写,所以还是将domain转成用Pydantic的BaseModel定义比较好,写法如下:
domain/models.py(Pydantic写法)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
| from enum import Enum
from pydantic import BaseModel, Field
from tools import get_datetime, datetime
class MessageRole(str, Enum):
USER = "user"
ASSISTANT = "assistant"
class User(BaseModel):
name: str
hashed_password: str
user_id: int | None = None
is_active: bool = True
is_superuser: bool = False
created_at: datetime = Field(default_factory=get_datetime)
class UserUsage(BaseModel):
user_id: int
messages_count: int = 0
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
class Conversation(BaseModel):
user_id: int
conversation_id: int | None = None
title: str | None = "新对话"
created_at: datetime = Field(default_factory=get_datetime)
updated_at: datetime = Field(default_factory=get_datetime)
class Message(BaseModel):
conversation_id: int | None
role: MessageRole
content: str
message_id: int | None = None
reasoning: str | None = None
created_at: datetime = Field(default_factory=get_datetime)
|
如此一来,转换函数就很好写了:
models/mappers.py
1
2
3
4
5
6
7
8
| from pydantic import BaseModel
from typing import TypeVar
T = TypeVar("T", bound=BaseModel)
def mapper(source: BaseModel, target: type[T]) -> T:
return target.model_validate(source.model_dump())
|
之所以这么写,也是考虑到转换关系实际上很明显,就没必要针对Record和Domain都单独写一个转换函数了,那样反而很麻烦.
总结
原代码的model名字和内容我们都没动,到了后面边重构边改,这也符合重构的Minimal Change原则.
CRUD和仓库重构
基本分析
Models部分的重构告一段落,现在就需要把我们的CRUD用Repo封装了.在动手之前,我们先想一下,我们的Repo需要如何和crud之间映射?要知道,可不是把所有的crud函数用一个Repo类封装起来就可以了,最好是能够高度复用,并且能够随便扩展.
这需要我们先看看crud.py中的crud操作,总结出共性和不同点,好判断需要几个Repo类:
crud.py
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
|
def register_user(
*, session: Session, user_register: UserRegister | UserCreate
) -> User:
user = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
try:
session.add(user)
session.flush()
if user.user_id is None:
raise RuntimeError("Failed to generate user_id")
usage = UserUsage(user_id=user.user_id)
session.add(usage)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(user)
return user
def get_user_by_name(*, session: Session, name: str) -> User | None:
return session.exec(select(User).where(User.name == name)).first()
def check_user(*, session: Session, name: str, password: str) -> User | None:
db_user = get_user_by_name(session=session, name=name)
if not db_user:
verify_password(password, DUMMY_HASH)
return None
verified = verify_password(password, db_user.hashed_password)
if not verified:
return None
return db_user
def get_users(*, session: Session, offset: int, limit: int) -> UsersPublic:
count_statement = select(func.count()).select_from(User)
count = session.exec(count_statement).one()
statement = (
select(User)
.options(selectinload(User.usage)) # type: ignore
.order_by(
desc(User.created_at),
desc(User.user_id),
)
.offset(offset)
.limit(limit)
)
users = session.exec(statement).all()
users_public = [UserPublic.model_validate(user) for user in users]
return UsersPublic(data=users_public, count=count)
def get_usage_totals(*, session: Session) -> UsagePublic:
# 长这么丑我也很无奈
statement = select(
func.coalesce(func.sum(UserUsage.messages_count), 0),
func.coalesce(func.sum(UserUsage.input_tokens), 0),
func.coalesce(func.sum(UserUsage.output_tokens), 0),
func.coalesce(func.sum(UserUsage.total_tokens), 0),
)
result = session.exec(statement).one()
return UsagePublic(
messages_count=int(result[0]),
input_tokens=int(result[1]),
output_tokens=int(result[2]),
total_tokens=int(result[3]),
)
def create_conversation(
*,
session: Session,
user_id: int,
title: str,
) -> Conversation:
conversation = Conversation(user_id=user_id, title=title)
session.add(conversation)
session.commit()
session.refresh(conversation)
return conversation
def get_conversation_for_user(
*,
session: Session,
conversation_id: int,
user_id: int,
) -> Conversation | None:
statement = select(Conversation).where(
Conversation.conversation_id == conversation_id,
Conversation.user_id == user_id,
)
result = session.exec(statement).first()
return result
def list_conversations(
*,
session: Session,
user_id: int,
offset: int = 0,
limit: int = 20,
) -> list[Conversation]:
statement = (
select(Conversation)
.where(Conversation.user_id == user_id)
.order_by(
desc(Conversation.updated_at),
desc(Conversation.conversation_id),
)
.offset(offset)
.limit(limit)
)
result = session.exec(statement).all()
return list(result)
def save_message(
*,
session: Session,
conversation: Conversation,
role: MessageRole,
content: str,
reasoning: str | None = None,
input_tokens: int = 0,
output_tokens: int = 0,
total_tokens: int = 0,
) -> Message:
if conversation.conversation_id is None:
raise ValueError("Conversation must be persisted before saving messages")
message = Message(
conversation_id=conversation.conversation_id,
role=role,
content=content,
reasoning=reasoning,
)
conversation.updated_at = get_datetime()
if role == MessageRole.ASSISTANT:
usage = session.get(UserUsage, conversation.user_id)
if usage is None:
usage = UserUsage(user_id=conversation.user_id)
session.add(usage)
usage.messages_count += 1
usage.input_tokens += input_tokens
usage.output_tokens += output_tokens
usage.total_tokens += total_tokens
try:
session.add(message)
session.add(conversation)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(message)
return message
def list_messages(
*,
session: Session,
conversation_id: int,
offset: int = 0,
limit: int = 100,
) -> list[Message]:
statement = (
select(Message)
.where(Message.conversation_id == conversation_id)
.order_by(
asc(Message.created_at),
asc(Message.message_id),
)
.offset(offset)
.limit(limit)
)
result = list(session.exec(statement).all())
return result
def get_history_message(
*,
session: Session,
conversation_id: int,
limit: int = 4,
) -> list[Message]:
if limit < 1:
return []
statement = (
select(Message)
.where(Message.conversation_id == conversation_id)
.order_by(
desc(Message.created_at),
desc(Message.message_id),
)
.limit(limit)
)
messages = list(session.exec(statement).all())
messages.reverse()
return messages
|
涉及的crud方法列举如下:
- User相关
- 注册用户
- 根据名字获取用户
- 检查用户是否verified
- 管理员获取用户列表
- Agent相关
- 获取用户的token消耗等信息
- 根据单条消息更新用户的token消耗等信息
- 对话相关
- 创建对话
- 根据用户id和对话id获取对话
- 用户个人获取对话列表
- 在对话内部新建单条消息并保存
- 用户获取对话中的消息列表和用户为了多轮对话获取历史的消息列表,二者肯定是要合并的
因此,实际上我们只要两个类就行,而且这两个类都有获取单条数据,获取数据列表,添加新数据三个方法,其他的则是自己独有的方法,至于用量统计可以先放着,我们得先重构了agents部分再来解决它.
所以,我们需要加入一个基类AbstractRepo,用抽象方法填充,并供其他具体的仓库调用,这个基类应该支持以下抽象方法:
- get: 获取该类的必要信息
- get_all: 管理员获取该类相关列表的所有信息
- post: 加入新数据并刷新,遇到错误时回滚
至于其他的独特方法则由相关的类自己实现即可.
基类仓库实现
新建一个infra文件夹,并在其中新建一个repo.py,写入如下内容:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| from abc import abstractmethod, ABC
from sqlmodel import Session
class AbstractRepo(ABC):
def __init__(self, session: Session):
self._session = session
@abstractmethod
def get(self): ...
@abstractmethod
def get_all(self): ...
@abstractmethod
def post(self): ...
|
如此一来,继承的子类就不需要再重复写session初始化,而且必须实现三个抽象方法才能使用.
用户仓库实现
先写实现用户的Repo,获取用户的函数是相当好写的:
1
2
3
4
5
6
7
8
| class UserRepo(AbstractRepo):
def get(self, name: str) -> User | None:
statement = select(UserRecord).where(UserRecord.name == name)
user = self._session.exec(statement).one()
if user is None:
return None
return mapper(user, User)
|
但对于获取用户列表这个功能,我们需要获取用户总数,所以还是单独放在一个工具函数repo/datas.py中比较好,之后的用量统计等功能也可以放进来:
1
2
3
4
5
6
7
8
9
| from sqlmodel import Session, select, func
from app.models import UserRecord
def users_amount(session: Session) -> int:
statement = select(func.count()).select_from(UserRecord)
amount = session.exec(statement).one()
return amount
|
然后放到类里面:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| def get_all(self, offset: int, limit: int) -> UsersPublic:
statement = (
select(UserRecord)
.options(selectinload(UserRecord.usage)) # type: ignore
.order_by(
desc(UserRecord.created_at),
desc(UserRecord.user_id),
)
.offset(offset)
.limit(limit)
)
users = self._session.exec(statement).all()
users_public: list = []
for user in users:
users_public.append(UserPublic.model_validate(user))
return UsersPublic(
data=users_public,
count=users_amount(self._session),
)
|
至于用户注册,可以先看看原函数:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| def register_user(
*, session: Session, user_register: UserRegister | UserCreate
) -> User:
user = User.model_validate(
user_register,
update={"hashed_password": hashing_password(user_register.password)},
)
try:
session.add(user)
session.flush()
if user.user_id is None:
raise RuntimeError("Failed to generate user_id")
usage = UserUsage(user_id=user.user_id)
session.add(usage)
session.commit()
except Exception:
session.rollback()
raise
session.refresh(user)
return user
|
这里是很有问题的,如果UserRegister和UserCreate可以一起处理,那么两者肯定相差不多,完全可以放在一起,看一下原来的schema:
1
2
3
4
5
6
7
8
9
10
11
12
| # User
class UserRegister(BaseModel):
# 写成1是为了偷懒~
name: str = Field(min_length=1, max_length=30)
password: str = Field(min_length=1, max_length=15)
class UserCreate(BaseModel):
name: str = Field(min_length=1, max_length=30)
is_active: bool = True
is_superuser: bool = False
password: str = Field(min_length=1, max_length=15)
|
合并如下:
1
2
3
4
5
6
7
8
9
10
| # User
class UserRegister(BaseModel):
# 写成1是为了偷懒~
name: str = Field(min_length=1, max_length=30)
password: str = Field(min_length=1, max_length=15)
class UserCreate(UserRegister):
is_active: bool = True
is_superuser: bool = False
|
二者都是用来创建用户的,因为UserCreate权限更高,所以只有管理员才能使用.
用户注册函数的另一个问题在于,我们只需要返回UserPublic就可以,却在这里额外返回了多余的hash密码,所以需要缩减权限,最终的版本如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| def post(self, user_in: UserRegister) -> UserPublic:
user = UserRecord.model_validate(
user_in,
update={"hashed_password": hashing_password(user_in.password)},
)
try:
self._session.add(user)
self._session.flush()
if user.user_id is None:
raise Exception
usage = UserUsage(user_id=user.user_id)
except Exception:
self._session.rollback()
raise
self._session.refresh(user)
return UserPublic.model_validate(user)
|
由于定义异常名字和报错信息是个很精致的活儿,所以我们都暂时用Exception填充,在较后面解决.
而引入uow来让回滚和refresh自动化也等我们完成其他仓库类后再一并实现.
接下来就是独属于user的check方法了,先看看唯一一个要用到验证用户的地方:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| @router.post("/access-token", tags=["auth"])
def login_access_token(
session: SessionDep,
form_data: Annotated[OAuth2PasswordRequestForm, Depends()],
) -> Token:
user = check_user(
session=session,
name=form_data.username,
password=form_data.password,
)
if not user:
raise HTTPException(
status_code=status.HTTP_401_UNAUTHORIZED,
detail="Incorrect name or password",
)
elif not user.is_active:
raise HTTPException(
status_code=status.HTTP_403_FORBIDDEN,
detail="Inactive user",
)
token_expires = timedelta(minutes=TOKEN_EXPIRE_MINUTES)
return Token(
access_token=security.create_token(
user.user_id,
expires_delta=token_expires,
)
)
|
上述写法是相当不入流了,验证用户的函数结果返回了整个user类,更别提属于数据库的错误要单独提升到路由中来处理了,我们先实现更加精确完善的check方法,日后再修改路由:
1
2
3
4
5
6
7
8
9
| def check(self, name: str, password: str) -> int | None:
db_user = self.get(name)
if db_user is None:
verify_password(password, DUMMY_HASH)
raise Exception
verified = verify_password(password, db_user.hashed_password)
if not verified:
raise Exception
return db_user.user_id
|
对话仓库实现
三个基本操作函数的实现方法和用户仓库基本相同,看看就行:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
| class ConversationRepo(AbstractRepo):
def get(self, conversation_id: int, user_id: int):
statement = select(ConversationRecord).where(
ConversationRecord.conversation_id == conversation_id,
ConversationRecord.user_id == user_id,
)
conversation = self._session.exec(statement).one()
return mapper(conversation, Conversation)
def get_all(self, user_id: int, offset=0, limit: int = 50) -> ConversationsPublic:
statement = (
select(ConversationRecord)
.where(ConversationRecord.user_id == user_id)
.order_by(
desc(ConversationRecord.updated_at),
desc(ConversationRecord.conversation_id),
)
.offset(offset)
.limit(limit)
)
results = self._session.exec(statement).all()
lists = [mapper(result, ConversationPublic) for result in results]
return ConversationsPublic(data=lists)
def post(self, user_id: int, title: str) -> ConversationPublic:
conversation = ConversationRecord(user_id=user_id, title=title)
self._session.add(conversation)
self._session.commit()
self._session.refresh(conversation)
return ConversationPublic.model_validate(conversation)
|
重点在于那三个特殊方法,分别是:
- 在对话内部新建消息,可以叫做
post_message,原函数引入了conversation作为参数,但却只用到了user_id和conversation_id两个属性,完全没必要 - 获取历史消息,可以叫做
get_messages - 获取用量统计,这个完全可以移入datas.py中
先对原来的UserUsage Domain做一个拆分:
1
2
3
4
5
6
7
8
9
| class TokenUsage(BaseModel):
input_tokens: int = 0
output_tokens: int = 0
total_tokens: int = 0
class UserUsage(TokenUsage):
user_id: int
messages_count: int = 0
|
再在datas.py里加上token相关的计算函数:
1
2
3
4
5
6
7
8
9
10
| def _add_tokens(userusage: UserUsage, usage: TokenUsage) -> None:
userusage.input_tokens += usage.input_tokens
userusage.output_tokens += usage.output_tokens
userusage.total_tokens += usage.total_tokens
def add_usage(userusage: UserUsage, usage: TokenUsage, role: MessageRole) -> None:
if role == MessageRole.ASSISTANT:
_add_tokens(userusage, usage)
userusage.messages_count += 1
|
于是就可以很轻松的重构出新建消息的函数了:
尚未分离用量统计
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
| def post_message(
self,
conversation_id: int,
user_id: int,
role: MessageRole,
content: str,
tokenusage: TokenUsage,
reasoning: str | None = None,
) -> None:
# 用量计算
usage = self._session.get(UserUsage, user_id)
if usage is None:
usage = UserUsage(user_id=user_id)
self._session.add(usage)
add_usage(usage, tokenusage, role)
# 对话保存
message = MessageRecord(
conversation_id=conversation_id,
role=role,
content=content,
reasoning=reasoning,
)
# 更新对话的最新更新时间
conversation = self._session.get(ConversationRecord, conversation_id)
if conversation is None:
raise Exception
conversation.updated_at = get_datetime()
try:
self._session.add(message)
self._session.add(conversation)
except:
self._session.rollback()
raise
|
用量统计目前还杂糅在里面,而我们可以看到这里用量统计和消息统计是完全可以直接分开的,所以拆分成两个函数如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
| def post_usage(
self, user_id: int, tokenusage: TokenUsage, role: MessageRole
) -> None:
# 用量计算
usage = self._session.get(UserUsage, user_id)
if usage is None:
usage = UserUsage(user_id=user_id)
self._session.add(usage)
add_usage(usage, tokenusage, role)
self._session.commit()
def post_message(
self,
conversation_id: int,
role: MessageRole,
content: str,
reasoning: str | None = None,
) -> None:
# 对话保存
message = MessageRecord(
conversation_id=conversation_id,
role=role,
content=content,
reasoning=reasoning,
)
# 更新对话的最新更新时间
conversation = self._session.get(ConversationRecord, conversation_id)
if conversation is None:
raise Exception
conversation.updated_at = get_datetime()
try:
self._session.add(message)
self._session.add(conversation)
self._session.commit()
except:
self._session.rollback()
raise
|
这样二者就完全分离了,之后在更新的时候就分别调用两个函数即可.
接下来是获取历史消息的重构:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| def get_messages(
self,
conversation_id: int,
user_id: int,
offset: int = 0,
limit: int = HISTORY_MESSAGE_LIMIT,
) -> MessagesPublic:
statement = (
select(MessageRecord)
.join(ConversationRecord)
.where(
ConversationRecord.conversation_id == conversation_id,
Conversation.user_id == user_id,
)
.order_by(
desc(MessageRecord.created_at),
desc(MessageRecord.message_id),
)
.offset(offset)
.limit(limit)
)
lists = list(self._session.exec(statement).all())
lists.reverse()
messages = [MessagePublic.model_validate(message) for message in lists]
return MessagesPublic(data=messages)
|
这个函数通过相当巧妙的设计同时实现了给Agent返回特定对话的历史消息,给用户返回特定对话的消息列表两个功能.确实很精细,但说难听点就叫功能耦合.
最后的datas.py长这样:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
| from sqlmodel import Session, select, func
from app.models import UserRecord
from app.domain.models import MessageRole, TokenUsage, UserUsage
from app.domain.schemas import UsagePublic
# Dummy hash to use for timing attack prevention when user is not found
DUMMY_HASH = "$argon2id$v=19$m=65536,t=3,p=4$MjQyZWE1MzBjYjJlZTI0Yw$YTU4NGM5ZTZmYjE2NzZlZjY0ZWY3ZGRkY2U2OWFjNjk"
HISTORY_MESSAGE_LIMIT = 4
def users_amount(session: Session) -> int:
statement = select(func.count()).select_from(UserRecord)
amount = session.exec(statement).one()
return amount
def _add_tokens(userusage: UserUsage, usage: TokenUsage) -> None:
userusage.input_tokens += usage.input_tokens
userusage.output_tokens += usage.output_tokens
userusage.total_tokens += usage.total_tokens
def add_usage(userusage: UserUsage, usage: TokenUsage, role: MessageRole) -> None:
if role == MessageRole.ASSISTANT:
_add_tokens(userusage, usage)
userusage.messages_count += 1
def get_usage_totals(session: Session) -> UsagePublic:
statement = select(
func.coalesce(func.sum(UserUsage.messages_count), 0),
func.coalesce(func.sum(UserUsage.input_tokens), 0),
func.coalesce(func.sum(UserUsage.output_tokens), 0),
func.coalesce(func.sum(UserUsage.total_tokens), 0),
)
result = session.exec(statement).one()
return UsagePublic(
messages_count=int(result[0]),
input_tokens=int(result[1]),
output_tokens=int(result[2]),
total_tokens=int(result[3]),
)
|
总结
完整的仓库如下,确实是一场酣畅淋漓的重构:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
| from abc import abstractmethod, ABC
from sqlmodel import Session, select, desc
from sqlalchemy.orm import selectinload
from app.domain.models import Conversation, MessageRole, TokenUsage, User, UserUsage
from app.domain.schemas import (
ConversationPublic,
ConversationsPublic,
MessagePublic,
MessagesPublic,
UserPublic,
UsersPublic,
UserRegister,
)
from app.models import UserRecord, mapper, ConversationRecord, MessageRecord
from app.core.security import verify_password, hashing_password
from app.infra.datas import add_usage, users_amount, DUMMY_HASH, HISTORY_MESSAGE_LIMIT
from app.tools import get_datetime
class AbstractRepo(ABC):
def __init__(self, session: Session):
self._session = session
@abstractmethod
def get(self): ...
@abstractmethod
def get_all(self): ...
@abstractmethod
def post(self): ...
class UserRepo(AbstractRepo):
def get(self, name: str) -> User | None:
statement = select(UserRecord).where(UserRecord.name == name)
user = self._session.exec(statement).one()
if user is None:
return None
return mapper(user, User)
def get_all(self, offset: int, limit: int) -> UsersPublic:
statement = (
select(UserRecord)
.options(selectinload(UserRecord.usage)) # type: ignore
.order_by(
desc(UserRecord.created_at),
desc(UserRecord.user_id),
)
.offset(offset)
.limit(limit)
)
users = self._session.exec(statement).all()
users_public: list = []
for user in users:
users_public.append(UserPublic.model_validate(user))
return UsersPublic(
data=users_public,
count=users_amount(self._session),
)
def post(self, user_in: UserRegister) -> UserPublic:
user = UserRecord.model_validate(
user_in,
update={"hashed_password": hashing_password(user_in.password)},
)
try:
self._session.add(user)
self._session.flush()
if user.user_id is None:
raise Exception
usage = UserUsage(user_id=user.user_id)
except Exception:
self._session.rollback()
raise
self._session.refresh(user)
return UserPublic.model_validate(user)
def check(self, name: str, password: str) -> int | None:
db_user = self.get(name)
if db_user is None:
verify_password(password, DUMMY_HASH)
raise Exception
verified = verify_password(password, db_user.hashed_password)
if not verified:
raise Exception
return db_user.user_id
class ConversationRepo(AbstractRepo):
def get(self, conversation_id: int, user_id: int):
statement = select(ConversationRecord).where(
ConversationRecord.conversation_id == conversation_id,
ConversationRecord.user_id == user_id,
)
conversation = self._session.exec(statement).one()
return mapper(conversation, Conversation)
def get_all(self, user_id: int, offset=0, limit: int = 50) -> ConversationsPublic:
statement = (
select(ConversationRecord)
.where(ConversationRecord.user_id == user_id)
.order_by(
desc(ConversationRecord.updated_at),
desc(ConversationRecord.conversation_id),
)
.offset(offset)
.limit(limit)
)
results = self._session.exec(statement).all()
lists = [mapper(result, ConversationPublic) for result in results]
return ConversationsPublic(data=lists)
def post(self, user_id: int, title: str) -> ConversationPublic:
conversation = ConversationRecord(user_id=user_id, title=title)
self._session.add(conversation)
self._session.commit()
self._session.refresh(conversation)
return ConversationPublic.model_validate(conversation)
def post_usage(
self, user_id: int, tokenusage: TokenUsage, role: MessageRole
) -> None:
# 用量计算
usage = self._session.get(UserUsage, user_id)
if usage is None:
usage = UserUsage(user_id=user_id)
self._session.add(usage)
add_usage(usage, tokenusage, role)
self._session.commit()
def post_message(
self,
conversation_id: int,
role: MessageRole,
content: str,
reasoning: str | None = None,
) -> None:
# 对话保存
message = MessageRecord(
conversation_id=conversation_id,
role=role,
content=content,
reasoning=reasoning,
)
# 更新对话的最新更新时间
conversation = self._session.get(ConversationRecord, conversation_id)
if conversation is None:
raise Exception
conversation.updated_at = get_datetime()
try:
self._session.add(message)
self._session.add(conversation)
self._session.commit()
except:
self._session.rollback()
raise
def get_messages(
self,
conversation_id: int,
offset: int = 0,
limit: int = HISTORY_MESSAGE_LIMIT,
) -> MessagesPublic:
statement = (
select(MessageRecord)
.where(MessageRecord.conversation_id == conversation_id)
.order_by(
desc(MessageRecord.created_at),
desc(MessageRecord.message_id),
)
.offset(offset)
.limit(limit)
)
lists = list(self._session.exec(statement).all())
lists.reverse()
messages = [MessagePublic.model_validate(message) for message in lists]
return MessagesPublic(data=messages)
|
Service引入
agents的预备重构阶段
俗话说“Make the change easy; then make the easy change,也就是说我们需要先改动原架构中不合理的地方,才能更好地引入设计模式,不过流处理本来就是一个棘手的东西,不像普通的API调用那样好操作.
先看看原来agents文件夹中的两个文件:
client.py
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
| from functools import lru_cache
from typing import Literal
from app.models import Message, MessageRole
from app.core.config import settings
from openai import Stream, OpenAI
from openai.types.responses import (
EasyInputMessageParam,
ResponseInputParam,
ResponseStreamEvent,
)
class Agent:
@lru_cache
def _get_client(self) -> OpenAI:
return self._create_client(
api_key=settings.DEEPSEEK_API_KEY,
url=settings.MODEL_URL,
)
def stream_agent(
self,
*,
history: list[Message],
model: str = settings.MODEL_NAME,
system_prompt: str = settings.DEFAULT_SYSTEM_PROMPT,
enable_reasoning: bool = True,
) -> Stream[ResponseStreamEvent]:
# 构造消息列表
message_list = self._build_input(history=history)
# 打开通信流
stream = self._create_stream(
client=self._get_client(),
model=model,
instructions=system_prompt,
input=message_list,
enable_reasoning=enable_reasoning,
)
return stream
@staticmethod
def _build_input(
*,
history: list[Message],
) -> ResponseInputParam:
response_input: ResponseInputParam = []
for message in history:
role: Literal["user", "assistant"] = (
"user" if message.role is MessageRole.USER else "assistant"
)
response_input.append(
EasyInputMessageParam(
role=role,
content=message.content,
)
)
return response_input
@staticmethod
def _create_client(*, api_key: str, url: str) -> OpenAI:
return OpenAI(api_key=api_key, base_url=url)
@staticmethod
def _create_stream(
*,
client: OpenAI,
model: str,
instructions: str,
input: ResponseInputParam,
enable_reasoning: bool = True,
) -> Stream[ResponseStreamEvent]:
return client.responses.create(
model=model,
instructions=instructions,
input=input,
stream=True,
reasoning=(
{"effort": "high", "summary": "auto"}
if enable_reasoning
else {"effort": "none"}
),
)
|
chat.py
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
| from collections.abc import Iterator
from sqlmodel import Session
from openai import Stream
from openai.types.responses import Response, ResponseStreamEvent
from app import crud
from app.models import ChatRequest, Conversation, MessageRole
class ConversationNotFoundError(Exception):
"""Raised when a conversation is absent or belongs to another user."""
class ChatBot:
TITLE_LENGTH = 10
DEFAULT_TITLE = "新对话"
@staticmethod
def _build_conversation_title(content: str) -> str:
normalized_text = " ".join(content.split())
if not normalized_text:
return ChatBot.DEFAULT_TITLE
return normalized_text[: ChatBot.TITLE_LENGTH]
def prepare_chat(
self,
*,
session: Session,
user_id: int,
request: ChatRequest,
) -> Conversation:
if request.conversation_id is None:
conversation = crud.create_conversation(
session=session,
user_id=user_id,
title=self._build_conversation_title(request.content),
)
else:
conversation = crud.get_conversation_for_user(
session=session,
conversation_id=request.conversation_id,
user_id=user_id,
)
if conversation is None:
raise ConversationNotFoundError
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.USER,
content=request.content,
)
return conversation
def stream_and_save(
self,
*,
session: Session,
conversation_id: int,
chunks: Stream[ResponseStreamEvent],
) -> Iterator[str]:
collected_chunks: list[str] = []
reasoning_chunks: list[str] = []
reasoning_started = False
answer_started = False
final_response: Response | None = None
for event in chunks:
if event.type == "response.output_text.delta":
if not answer_started:
if reasoning_started:
yield "\n\n回答:\n"
answer_started = True
collected_chunks.append(event.delta)
yield event.delta
elif event.type == "response.reasoning_text.delta":
if not reasoning_started:
yield "思考:\n"
reasoning_started = True
reasoning_chunks.append(event.delta)
yield event.delta
elif event.type == "response.completed":
final_response = event.response
elif event.type == "response.incomplete":
final_response = event.response
elif event.type == "error":
raise RuntimeError(event.message)
elif event.type == "response.failed":
error = event.response.error
raise RuntimeError(error.message if error else "Response failed")
full_content = "".join(collected_chunks)
if not full_content or not final_response or not final_response.usage:
return
usage = final_response.usage
conversation = session.get(Conversation, conversation_id)
if conversation is None:
return
crud.save_message(
session=session,
conversation=conversation,
role=MessageRole.ASSISTANT,
content=full_content,
reasoning="".join(reasoning_chunks) or None,
input_tokens=usage.input_tokens,
output_tokens=usage.output_tokens,
total_tokens=usage.total_tokens,
)
|
有如下问题:
- 两个类的函数划分简直是乱来,职责界限一点都不够清晰
- Agent本身不应该承担数据存储功能,而应该统一由Service管理.
从最顶层来看,agents相关的函数都是为了服务messages路由的:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
| @router.post("/messages")
def chat(
request: ChatRequest,
session: SessionDep,
current_user: CurrentUser,
) -> StreamingResponse:
try:
conversation = chatbot.prepare_chat(
session=session,
user_id=_current_user_id(current_user),
request=request,
)
except ConversationNotFoundError:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
)
if conversation.conversation_id is None:
raise HTTPException(
status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
detail="Conversation could not be created",
)
history = crud.get_history_message(
session=session,
conversation_id=conversation.conversation_id,
limit=HISTORY_MESSAGE_LIMIT + 1,
)
chunks = agent.stream_agent(
history=history,
enable_reasoning=request.enable_reasoning,
)
return StreamingResponse(
chatbot.stream_and_save(
session=session,
conversation_id=conversation.conversation_id,
chunks=chunks,
),
# ...
)
|
这个路由承担了多个职责:
- 当对话不存在时创建对话或者对话存在时返回对话,并且在对话内部新建用户的消息
- 获取历史消息
- 传输历史消息给agent并开启Stream
- 将Stream传输给前端的同时还要保存AI输出的单条消息
可以发现,这些操作都是在crud之上加了一层封装和条件判断,异常处理,所以不能放入Repo中,又不能放入路由中,因此就有必要引入新的中间层: Service.
deps.py重构
新建Service文件夹和chatservice.py文件,考虑到chatservice需要引入数据库依赖,所以把api文件夹中的deps.py移进来最好,顺便把它也重构一下,先看看原内容:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
| from collections.abc import Generator
from typing import Annotated
from sqlmodel import Session
from app.core.db import engine
from app.models import User
from app.models import TokenPayload
from fastapi.security import OAuth2PasswordBearer
from fastapi import Depends, HTTPException, status
from pydantic import ValidationError
import jwt
from jwt.exceptions import InvalidTokenError
from app.core.config import settings
from app.core.security import ALGORITHM
oauth2 = OAuth2PasswordBearer(
tokenUrl="/api/access-token",
scheme_name="Oauth2",
)
TokenDep = Annotated[str, Depends(oauth2)]
def get_db() -> Generator[Session, None, None]:
with Session(engine) as session:
yield session
SessionDep = Annotated[Session, Depends(get_db)]
def get_current_user(
session: SessionDep,
token: TokenDep,
) -> User:
try:
payload = jwt.decode(
token,
settings.SECRET_KEY,
algorithms=[ALGORITHM],
)
token_data = TokenPayload(**payload)
except (InvalidTokenError, ValidationError):
raise HTTPException(
status_code=status.HTTP_403_FORBIDDEN,
detail="Invalid credentials",
)
user = session.get(User, token_data.sub)
if not user:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="User Not Found",
)
if not user.is_active:
raise HTTPException(
status_code=status.HTTP_400_BAD_REQUEST,
detail="Inactive user",
)
return user
CurrentUser = Annotated[User, Depends(get_current_user)]
def get_current_superuser(user: CurrentUser) -> User:
if not user.is_superuser:
raise HTTPException(
status_code=403, detail="The user doesn't have enough privileges"
)
return user
Superuser = Annotated[User, Depends(get_current_superuser)]
|
首先,currentuser依赖是过度设计,不用返回user整体,只需要返回user_id即可,而且,业务代码不能抛出HTTP异常,而只是抛出诸如UserNotActive这样的异常即可,但我们先全部留空,日后补全:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
| from fastapi.security import OAuth2PasswordBearer
from fastapi import Depends
import jwt
from typing import Annotated, Generator
from sqlmodel import Session
from app.core.db import engine
from app.domain.models import User
from app.domain.schemas import TokenPayload
from app.core.config import settings
from app.core.security import ALGORITHM
from app.models import UserRecord
from app.models.mappers import mapper
oauth2 = OAuth2PasswordBearer(tokenUrl="api/access-token", scheme_name="Oauth2")
TokenDep = Annotated[str, Depends(oauth2)]
def get_db() -> Generator[Session]:
with Session(engine) as session:
yield session
SessionDep = Annotated[Session, Depends(get_db)]
def get_current_user(
session: SessionDep,
token: TokenDep,
) -> User:
try:
payload = jwt.decode(
token,
settings.SECRET_KEY,
algorithms=[ALGORITHM],
)
# payload带有sub(用户ID)和exp等字段,但我们只需要sub即可
sub = TokenPayload(**payload).sub
except:
raise
userrecord = session.get(UserRecord, sub)
if not userrecord:
raise
user = mapper(userrecord, User)
if not user.is_active:
raise
return user
def get_current_user_id(user: Annotated[User, Depends(get_current_user)]) -> int | None:
return user.user_id
CurrentUserID = Annotated[int, Depends(get_current_user_id)]
def get_current_superuser_id(
user: Annotated[User, Depends(get_current_user)],
) -> int | None:
if not user.is_superuser:
raise
return user.user_id
SuperuserID = Annotated[int, Depends(get_current_superuser_id)]
|
BaseService
先实现一个基类:
1
2
3
4
5
6
7
8
9
| from typing import Generic, TypeVar
from app.infra.repo import AbstractRepo
RepoT = TypeVar("RepoT", bound=AbstractRepo)
class BaseService(Generic[RepoT]):
def __init__(self, repo: RepoT) -> None:
self._repo = repo
|
这里的Repo尚未插入session,我们移到最后在deps.py中组装即可.
UserService
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
| from app.services.baseservice import BaseService
from app.infra.repo import UserRepo
from app.domain.schemas import UserPublic, UserRegister, UsersPublic
class UserService(BaseService[UserRepo]):
def get(self, name: str) -> UserPublic:
user = self._repo.get(name)
if not user:
raise
return UserPublic.model_validate(user)
def get_all(self, offset: int, limit: int) -> UsersPublic:
users = self._repo.get_all(offset, limit)
return users
def post(self, user_in: UserRegister) -> UserPublic:
user = self._repo.post(user_in)
if not user:
raise
return user
def delete(self, user_id: int) -> None:
try:
self._repo.delete(user_id)
except:
raise
|
异常留待后面统一处理
ChatService
新建对话和新建消息我们需要反复斟酌,原来的设计非常粗暴,根据前端传入的Conversation_id是否为None来判断是否为空对话,并在一次请求中同时完成消息保存和流式输出.但是,如果前端出错,把某个实际存在的Conversation_id传成了None,那么就会真的新建一个对话,这是一个非常严重的问题.
而往高处想一想的话,这个问题很好解决,不允许前端传入空的Conversation_id即可,对于空对话,我们只需要在前端做处理,不在数据库层面改变,在用户按下回车的那一刻,我们才真正创建对话,并同步发送API请求给LLM.而无论用户点击多少次新建对话,我们只在前端保持幂等性即可.实际看一看,所有的LLM对话平台都是这么做的.
完整步骤如下:
- 用户前端新建空对话,输入后点击回车
- 后端新建对话,并根据用户输入生成标题(另写一个函数,不混在一起)
- 发起API请求
- 将用户输入存入对话中,并等待API流式返回
- 流式输出给前端
- 考虑到一般情况,我们就不存储AI的thinking字段了,而是只存AI输出即可
- 一个比较常见的情况是,前端中断AI输出,由于Responses API在传输完成后才会发送完成的事件,根据这个我们就可以判断是否要保存消息了,而且还不用自己拼接字符串,用例如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| stream = client.responses.create(
model="gpt-5.5",
input="你好",
stream=True,
)
for event in stream:
if event.type == "response.output_text.delta":
yield event.delta
elif event.type == "response.completed":
# 不用自己拼接字符串!
full_text = event.response.output_text
save_to_database(full_text)
|
不过Responses API在流式输出之后,竟然还会重新输出一次完整的对话,尽管浪费带宽,但对开发来说确实很便捷.
因此我们需要以下Service:
- 获取单条对话的历史消息,用于前端展示对话历史
- 获取所有的对话列表,只包含Title这一必要信息
- 新建空对话,该对话接受用户输入生成标题
- 允许用户更新标题
- 新建消息,无论是用户消息还是AI消息统一用一个函数
- 给管理员返回总Token消耗
完整代码:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| from app.domain.models import MessageRole, TokenUsage
from app.services.baseservice import BaseService
from app.infra.repo import ConversationRepo
from app.domain.schemas import (
ConversationPublic,
ConversationsPublic,
MessagesPublic,
UsagePublic,
)
from app.core.config import settings
class ChatService(BaseService[ConversationRepo]):
def get_messages(self, conversation_id: int, user_id: int) -> MessagesPublic:
messages = self._repo.get_messages(
conversation_id, user_id, 0, settings.MESSAGE_LIMIT
)
return messages
def get_conversations(
self, user_id: int, offset: int, limit: int
) -> ConversationsPublic:
try:
conversations = self._repo.get_all(user_id, offset, limit)
except:
raise
return conversations
def post_conversation(self, user_id: int, content: str) -> ConversationPublic:
conversation = self._repo.post(user_id, content)
if not conversation:
raise
return conversation
def update_conversation_title(self, conversation_id: int, title: str) -> None:
try:
self._repo.update_title(conversation_id, title)
except:
raise
def post_message(
self, conversation_id: int, content: str, reasoning: str, role: MessageRole
) -> None:
self._repo.post_message(conversation_id, role, content, reasoning)
def post_usage(
self, user_id: int, tokenusage: TokenUsage, role: MessageRole
) -> None:
self._repo.post_usage(user_id, tokenusage, role)
def get_usages(self) -> UsagePublic:
return self._repo.get_usages()
|
Agents初步重构
先看看我们的Agent要支持的功能:
- 根据API发送用户消息给大模型
- 接收大模型的流式输出,并供数据库持久化
功能其实很简单,但我们之前的实现并不具有美感,我们先做一个可用的最初版出来,将原来的chat.py和client.py重构为streams.py一个文件即可.
考虑到response输出有usage和output_text两个字段,我们干脆自己建一个新的Schema来包裹这两个字段,避免依赖Responses API本身:
1
2
3
4
| # Agent
class ResponsePublic(BaseModel):
output_text: str
usage:TokenUsage
|
完整代码如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
| from typing import Generator
from openai import OpenAI, Stream
from openai.types.responses import (
ResponseInputParam,
ResponseStreamEvent,
Response,
EasyInputMessageParam,
)
from app.domain.schemas import MessagesPublic, ResponsePublic
from app.domain.models import TokenUsage
def build_inputs(history: MessagesPublic) -> ResponseInputParam:
response_input: ResponseInputParam = []
for message in history.data:
response_input.append(
EasyInputMessageParam(
role=message.role, # type: ignore
content=message.content,
)
)
return response_input
def build_client(*, api_key: str, url: str) -> OpenAI:
return OpenAI(api_key=api_key, base_url=url)
def create_stream(
*,
client: OpenAI,
model: str,
instructions: str,
input: ResponseInputParam,
reasoning: str = "none",
) -> Stream[ResponseStreamEvent]:
return client.responses.create(
model=model,
instructions=instructions,
input=input,
stream=True,
reasoning=({"effort": reasoning}), # type: ignore
)
def _stream_output(
stream: Stream[ResponseStreamEvent],
) -> Generator[dict[str, str], None, Response]:
final_response: Response | None = None
for event in stream:
# thinking字段和answer字段
if event.type == "response.reasoning_text.delta":
yield {"type": "reasoning", "content": event.delta}
elif event.type == "response.output_text.delta":
yield {"type": "answer", "content": event.delta}
# 错误处理
elif event.type == "error":
raise RuntimeError(event.message)
elif event.type == "response.failed":
error = event.response.error
if error:
raise RuntimeError(error.message)
else:
raise RuntimeError("Response failed")
# 完成输出
elif event.type == "response.completed" or event.type == "response.incomplete":
final_response = event.response
if not final_response:
raise Exception
return final_response
def standard_stream(
stream: Stream[ResponseStreamEvent],
) -> Generator[dict[str, str], None, ResponsePublic]:
try:
raw_response = yield from _stream_output(stream)
except:
raise
usage = raw_response.usage
if usage is None:
raise
tokenusage = TokenUsage(
input_tokens=usage.input_tokens,
output_tokens=usage.output_tokens,
total_tokens=usage.total_tokens,
)
response = ResponsePublic(
output_text=raw_response.output_text,
usage=tokenusage,
)
return response
|
我们现在只剩下最后一步了,将standard_stream交给前端,并且将数据存入数据库就大公告成了,这本质上还是属于ChatService的业务,所以我们新增一个函数stream_and_save,至于数据库操作和流处理耦合的问题,留到下个章节解决:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
| def stream_and_save(
self,
user_id: int,
conversation_id: int,
content: str,
reasoning: str,
) -> Generator[dict[str, str], None, None]:
# 权限验证
try:
self._repo.get(conversation_id, user_id)
except:
raise
# 获取历史消息
history_message = self._repo.get_messages(conversation_id, user_id)
# 创建默认Agent和流
client = default_agent(
history=history_message,
content=content,
reasoning=reasoning,
)
response = yield from standard_stream(client)
# 存储消息
try:
self._repo.post_usage(user_id, response.usage, MessageRole.ASSISTANT)
self._repo.post_message(conversation_id, MessageRole.USER, content)
self._repo.post_message(
conversation_id, MessageRole.ASSISTANT, response.output_text
)
except:
raise
|
总结
太长了,先切分一下,光是Service和Repo的重构便是如此复杂了,但接下来我们就将认识到设计模式的优秀之处,看到这次大规模重构带来的好处.
ch18: 引入设计模式(下)
填补异常
我们先简单了解一下Python的异常机制:
首先,在try-except控制块中,无论是try调用的函数内部抛出异常,还是该函数执行失败抛出异常,都会被except语句接住,至于如何接住,就得看一下Python内置异常的继承体系了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| BaseException
├── SystemExit
├── KeyboardInterrupt
├── GeneratorExit
├── BaseExceptionGroup
└── Exception
├── ArithmeticError
│ ├── ZeroDivisionError
│ ├── OverflowError
│ └── FloatingPointError
├── LookupError
│ ├── IndexError
│ └── KeyError
├── OSError
│ ├── FileNotFoundError
│ ├── PermissionError
│ ├── TimeoutError
│ └── ConnectionError
├── RuntimeError
│ ├── NotImplementedError
│ └── RecursionError
├── ValueError
│ └── UnicodeError
├── TypeError
├── AttributeError
├── NameError
|
简单来说,所有的业务异常都由Exception类包揽了,所以如果我们写成except Exception as e,就会默认接收所有继承自Exception的子类.
那么我们这里也是同理,在domain里编写一个exceptions.py文件夹,通过合理的继承关系把所有异常统合在一起即可,具体来说,目前有两个子类,自底向上排列:
RepoException: 所有Repo层面的异常ServiceException: 所有Service层面的异常
每一层不仅可以捕获先前一层的异常,也可以自己新增异常,从而做到尽可能地全方面兜底,增强代码的健壮性,并提供足够丰富的调试信息供前端展示:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
|
# 基类异常
class BaseException(Exception):
pass
# Repo异常
class RepoException(BaseException):
pass
# Service异常
class ServiceException(BaseException):
pass
|
UserRepo填补
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
| class UserRepo(AbstractRepo):
def get(self, name: str) -> User | None:
statement = select(UserRecord).where(UserRecord.name == name)
userrecord = self._session.exec(statement).one()
if userrecord is None:
raise UserRecordNotFound("User Record Not Found")
return mapper(userrecord, User)
def get_all(self, offset: int, limit: int) -> UsersPublic:
statement = (
select(UserRecord)
.options(selectinload(UserRecord.usage)) # type: ignore
.order_by(
desc(UserRecord.created_at),
desc(UserRecord.user_id),
)
.offset(offset)
.limit(limit)
)
users = self._session.exec(statement).all()
if not users:
raise UsersRecordNotFound("Users Record Not Found")
users_public: list = []
for user in users:
users_public.append(UserPublic.model_validate(user))
return UsersPublic(
data=users_public,
count=users_amount(self._session),
)
def post(self, user_in: UserRegister) -> UserPublic:
user = UserRecord.model_validate(
user_in,
update={"hashed_password": hashing_password(user_in.password)},
)
try:
self._session.add(user)
self._session.flush()
if user.user_id is None:
raise UserRecordCreateFailed("User Record Create Failed")
except UserRecordNotFound, AddError:
self._session.rollback()
raise
self._session.refresh(user)
return UserPublic.model_validate(user)
def delete(self, user_id: int) -> None:
userrecord = self._session.get(UserRecord, user_id)
if not userrecord:
raise UsersRecordNotFound("Users Record Not Found")
try:
self._session.delete(userrecord)
self._session.commit()
except CommitError, DeleteError:
self._session.rollback()
raise DeleteError("user delete failed")
def check(self, name: str, password: str) -> int | None:
db_user = self.get(name)
if db_user is None:
verify_password(password, DUMMY_HASH)
raise UserNameNotFound("Username Not Found")
verified = verify_password(password, db_user.hashed_password)
if not verified:
raise VerifyError("vecification failed")
return db_user.user_id
|
用到的异常类如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| # Repo异常
class RepoException(BaseException):
pass
class UserRecordNotFound(RepoException):
pass
class UsersRecordNotFound(RepoException):
pass
class UserRecordCreateFailed(RepoException):
pass
class UserNameNotFound(RepoException):
pass
class VerifyError(RepoException):
pass
|
ConversationRepo填补
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
| class ConversationRepo(AbstractRepo):
def get(self, conversation_id: int, user_id: int) -> Conversation:
statement = select(ConversationRecord).where(
ConversationRecord.conversation_id == conversation_id,
ConversationRecord.user_id == user_id,
)
conversation = self._session.exec(statement).one()
if not conversation:
raise ConversationRecordNotFound("Conversation Record Not Found")
return mapper(conversation, Conversation)
def get_all(
self, user_id: int, offset: int = 0, limit: int = 50
) -> ConversationsPublic:
statement = (
select(ConversationRecord)
.where(ConversationRecord.user_id == user_id)
.order_by(
desc(ConversationRecord.updated_at),
desc(ConversationRecord.conversation_id),
)
.offset(offset)
.limit(limit)
)
results = self._session.exec(statement).all()
if not results:
raise ConversationsRecordNotFound("Conversations Record Not Found")
lists = [mapper(result, ConversationPublic) for result in results]
return ConversationsPublic(data=lists)
def post(self, user_id: int, content: str) -> ConversationPublic:
title = build_conversation_title(content)
conversation = ConversationRecord(user_id=user_id, title=title)
try:
self._session.add(conversation)
self._session.commit()
self._session.refresh(conversation)
result = ConversationPublic.model_validate(conversation)
except SQLAlchemyError as e:
self._session.rollback()
raise ConversationRecordCreateError(
"Conversation record create failed"
) from e
return result
def update_title(self, conversation_id: int, title: str) -> None:
conversationrecord = self._session.get(ConversationRecord, conversation_id)
if not conversationrecord:
raise Exception
conversationrecord.title = title
try:
self._session.add(conversationrecord)
self._session.commit()
except SQLAlchemyError:
self._session.rollback()
raise ConversationTitleUpdateError("Conversation title update failed")
def post_usage(
self, user_id: int, tokenusage: TokenUsage, role: MessageRole
) -> None:
# 用量计算
usage = self._session.get(UserUsage, user_id)
if usage is None:
usage = UserUsage(user_id=user_id)
self._session.add(usage)
add_usage(usage, tokenusage, role)
self._session.commit()
def post_message(
self,
conversation_id: int,
role: MessageRole,
content: str,
) -> None:
# 对话保存
message = MessageRecord(
conversation_id=conversation_id,
role=role,
content=content,
)
# 更新对话的最新更新时间
conversation = self._session.get(ConversationRecord, conversation_id)
if conversation is None:
raise ConversationsRecordNotFound("Conversations Record Not Found")
conversation.updated_at = get_datetime()
try:
self._session.add(message)
self._session.add(conversation)
self._session.commit()
except SQLAlchemyError:
self._session.rollback()
raise MessageRecordCreateError("Message record create failed")
def get_messages(
self,
conversation_id: int,
user_id: int,
offset: int = 0,
limit: int = settings.HISTORY_MESSAGE_LIMIT,
) -> MessagesPublic:
statement = (
select(MessageRecord)
.join(ConversationRecord)
.where(
ConversationRecord.conversation_id == conversation_id,
Conversation.user_id == user_id,
)
.order_by(
desc(MessageRecord.created_at),
desc(MessageRecord.message_id),
)
.offset(offset)
.limit(limit)
)
try:
messagesequence = self._session.exec(statement).all()
except SQLAlchemyError:
raise MessageRecordNotFound("Message record not found")
lists = list(messagesequence)
lists.reverse()
messages = [MessagePublic.model_validate(message) for message in lists]
return MessagesPublic(data=messages)
def get_usages(self) -> UsagePublic:
return get_usage_totals(self._session)
|
用到的异常类:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
| ## ConversationRepo
class ConversationRecordNotFound(RepoException):
pass
class ConversationsRecordNotFound(RepoException):
pass
class ConversationRecordCreateError(RepoException):
pass
class ConversationTitleUpdateError(RepoException):
pass
class MessageRecordCreateError(RepoException):
pass
class MessageRecordNotFound(RepoException):
pass
|
Service填补
UserService
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| class UserService(BaseService[UserRepo]):
def get(self, name: str) -> UserPublic:
try:
user = self._repo.get(name)
except UserRecordNotFound:
raise UserNotFound("User not found")
return UserPublic.model_validate(user)
def get_all(self, offset: int, limit: int) -> UsersPublic:
try:
users = self._repo.get_all(offset, limit)
except UsersRecordNotFound:
raise UsersNotFound("Fail to get users list")
return users
def post(self, user_in: UserRegister) -> UserPublic:
try:
user = self._repo.post(user_in)
except UserRecordCreateFailed:
raise UserCreateError("Fail to create new user")
return user
def delete(self, user_id: int) -> None:
try:
self._repo.delete(user_id)
except UserRecordDeleteError:
raise UserDeleteError("Fail to delete user")
|
ChatService
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
| class ChatService(BaseService[ConversationRepo]):
def get_messages(self, conversation_id: int, user_id: int) -> MessagesPublic:
try:
messages = self._repo.get_messages(
conversation_id, user_id, 0, settings.MESSAGE_LIMIT
)
except MessageRecordNotFound:
raise MessagesNotFound("Messages not found")
return messages
def get_conversations(
self, user_id: int, offset: int, limit: int
) -> ConversationsPublic:
try:
conversations = self._repo.get_all(user_id, offset, limit)
except ConversationRecordNotFound:
raise ConversationNotFound("Conversation not found")
return conversations
def post_conversation(self, user_id: int, content: str) -> ConversationPublic:
try:
conversation = self._repo.post(user_id, content)
except ConversationRecordCreateError:
raise ConversationCreateError("Fail to create conversation")
return conversation
def update_conversation_title(self, conversation_id: int, title: str) -> None:
try:
self._repo.update_title(conversation_id, title)
except ConversationTitleUpdateError:
raise TitleUpdateError("Fail to update conversation title")
def post_message(
self, conversation_id: int, content: str, role: MessageRole
) -> None:
try:
self._repo.post_message(conversation_id, role, content)
except MessageRecordCreateError:
raise MessageCreateError("Fail to create message")
def post_usage(
self, user_id: int, tokenusage: TokenUsage, role: MessageRole
) -> None:
try:
self._repo.post_usage(user_id, tokenusage, role)
except:
raise UsageUpdateError("Fail to update usage")
def get_usages(self) -> UsagePublic:
try:
usages = self._repo.get_usages()
except:
raise UsagesNotFound("Usages not found")
return usages
def stream_and_save(
self,
user_id: int,
conversation_id: int,
content: str,
reasoning: str,
) -> Generator[dict[str, str], None, None]:
# 权限验证
try:
self._repo.get(conversation_id, user_id)
except ConversationRecordNotFound:
raise ConversationNotFound("Conversation not found")
# 获取历史消息
history_message = self._repo.get_messages(conversation_id, user_id)
# 创建默认Agent和流
client = default_agent(
history=history_message,
content=content,
reasoning=reasoning,
)
response = yield from standard_stream(client)
# 存储消息
try:
self._repo.post_usage(user_id, response.usage, MessageRole.ASSISTANT)
self._repo.post_message(conversation_id, MessageRole.USER, content)
self._repo.post_message(
conversation_id, MessageRole.ASSISTANT, response.output_text
)
except:
raise ChatSaveError("Fail to save chat")
|
总结
多了异常之后,尽管代码变长了,但逻辑链却变得更加清晰了.
组装依赖
在deps.py中组装依赖:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
| oauth2 = OAuth2PasswordBearer(tokenUrl="api/access-token", scheme_name="Oauth2")
TokenDep = Annotated[str, Depends(oauth2)]
def get_db() -> Generator[Session]:
with Session(engine) as session:
yield session
SessionDep = Annotated[Session, Depends(get_db)]
def get_user_service(session: SessionDep) -> UserService:
repo = UserRepo(session)
return UserService(repo)
def get_chat_service(session: SessionDep) -> ChatService:
repo = ConversationRepo(session)
return ChatService(repo)
UserServiceDep = Annotated[UserService, Depends(get_user_service)]
ChatServiceDep = Annotated[ChatService, Depends(get_chat_service)]
def get_current_user(
session: SessionDep,
token: TokenDep,
) -> User:
try:
payload = jwt.decode(
token,
settings.SECRET_KEY,
algorithms=[ALGORITHM],
)
# payload带有sub(用户ID)和exp等字段,但我们只需要sub即可
sub = TokenPayload(**payload).sub
except:
raise ValidationError("User not verified")
userrecord = session.get(UserRecord, sub)
if not userrecord:
raise UserNotFound("User not found")
user = mapper(userrecord, User)
if not user.is_active:
raise UserNotActive("User not active")
return user
def get_current_user_id(user: Annotated[User, Depends(get_current_user)]) -> int | None:
return user.user_id
CurrentUserID = Annotated[int, Depends(get_current_user_id)]
def get_current_superuser_id(
user: Annotated[User, Depends(get_current_user)],
) -> int | None:
if not user.is_superuser:
raise UserNotAdmin("User not admin")
return user.user_id
SuperuserID = Annotated[int, Depends(get_current_superuser_id)]
|
如此一来,路由层就无法接触到底层的数据库操作了.
完成路由
users部分
先考虑一下我们如今可以支持的API:
- get:
- 获取用户个人信息
- 获取所有用户信息
- post:
- 用户注册
- delete:
- 普通用户删除自己(即注销)
- 管理员删除普通用户(不能在此操作中删除自己)
对于这些操作,推荐的API写法如下:
| HTTP 方法 | 路由 | 用途 |
|---|
| GET | /api/users | 获取用户列表 |
| GET | /api/users/{id} | 获取指定用户 |
| POST | /api/users | 创建用户 |
| DELETE | /api/users/{id} | 删除用户 |
| GET | /api/users/me | 获取当前登录用户 |
实践一下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
| from fastapi import APIRouter, HTTPException, status
from app.domain.exceptions import UserCreateError, UserDeleteError, UserNotFound
from app.services.deps import UserServiceDep, CurrentUserID, SuperuserID
from app.domain.schemas import UserPublic, UsersPublic, UserRegister
from app.domain.schemas import UsersPublic
router = APIRouter(prefix="/users", tags=["users"])
# 用户注册
@router.post("", status_code=status.HTTP_201_CREATED)
def user_register(serivce: UserServiceDep, user_in: UserRegister) -> UserPublic:
user = serivce.get_by_name(user_in.name)
if user:
# 由于没有邮箱,所以只好用名字来进行唯一标识
raise HTTPException(
status.HTTP_409_CONFLICT,
detail="Name already exists",
)
try:
user = serivce.post(user_in)
except UserCreateError as e:
raise HTTPException(
status.HTTP_500_INTERNAL_SERVER_ERROR,
detail="Failed to create user",
) from e
return user
# 获取用户个人信息
@router.get("/me", status_code=status.HTTP_200_OK)
def get_user(service: UserServiceDep, user_id: CurrentUserID) -> UserPublic:
try:
user = service.get_by_id(user_id)
except UserNotFound as e:
raise HTTPException(status.HTTP_404_NOT_FOUND, detail="User not found") from e
return user
# 获取用户列表
@router.get("", status_code=status.HTTP_200_OK)
def get_users_list(
_: SuperuserID,
service: UserServiceDep,
skip: int,
limit: int,
) -> UsersPublic:
return service.get_all(offset=skip, limit=limit)
@router.delete("", status_code=status.HTTP_204_NO_CONTENT)
def delete_current_user(
service: UserServiceDep, current_user_id: CurrentUserID
) -> None:
try:
service.delete(current_user_id)
except UserDeleteError:
raise HTTPException(
status_code=status.HTTP_409_CONFLICT,
detail="User cannot be deleted",
)
except UserNotFound:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="User not found",
)
# 删除用户
@router.delete("/{user_id}")
def superuser_delete_user(
service: UserServiceDep,
superuser_id: SuperuserID,
user_id: int,
) -> None:
if superuser_id == user_id:
raise HTTPException(
status_code=status.HTTP_403_FORBIDDEN,
detail="Superusers are not allowed to delete themselves",
)
try:
service.delete(user_id)
except UserDeleteError:
raise HTTPException(
status_code=status.HTTP_409_CONFLICT,
detail="User cannot be deleted",
)
except UserNotFound:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="User not found",
)
|
如今的user路由是不是比以前还要清晰很多了,只需要考虑执行service并抛出HTTP异常即可,至于再深一层就没必要考虑了.
auth部分
我们之前把token获取路由放在了utils.py中,这个写法不太对,最好是放在单独的auth.py中,因为除了获取token外,我们还需要考虑刷新token和注销token两种情况,所以最好一并组织在一起,不过我们留待日后解决token的刷新问题,先完成最初的token获取接口:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| from typing import Annotated
from datetime import timedelta
from fastapi import APIRouter, Depends, HTTPException, status
from fastapi.security import OAuth2PasswordRequestForm
from app.core import security
from app.core.config import settings
from app.domain.exceptions import PasswordMatchError, UserNotFound
from app.domain.schemas import Token
from app.services.deps import UserServiceDep
router = APIRouter(prefix="/auth", tags=["auth"])
@router.post("/access-token")
def create_token(
service: UserServiceDep,
form_data: Annotated[OAuth2PasswordRequestForm, Depends()],
) -> Token:
try:
user_id = service.check(form_data.username, form_data.password)
except UserNotFound, PasswordMatchError:
raise HTTPException(
status_code=status.HTTP_401_UNAUTHORIZED,
detail="Incorrect name or password",
)
token = Token(
access_token=security.create_token(
user_id,
expires_delta=timedelta(minutes=settings.TOKEN_EXPIRE_MINUTES),
)
)
return token
|
chats部分
先考虑一下目前能实现的API:
- get
- 对话列表
- 单个对话的全部消息
- 管理员获取总计token消耗
- post
- 创建对话
- patch
- 用户更新标题
- chat
- 发送消息并收到LLM流式响应
实践一下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
| router = APIRouter(prefix="/chat", tags=["chat"])
@router.get("", status_code=status.HTTP_200_OK)
def get_conversations_list(
service: ChatServiceDep,
user_id: CurrentUserID,
offset: Annotated[int, Query(ge=0)] = 0,
limit: Annotated[int, Query(ge=1, le=200)] = 20,
) -> ConversationsPublic:
return service.get_conversations(user_id, offset, limit)
@router.get("/messages", status_code=status.HTTP_200_OK)
def get_messages_list(
service: ChatServiceDep,
user_id: int,
conversation_id: int,
) -> MessagesPublic:
return service.get_messages(conversation_id, user_id)
@router.get("/usages", status_code=status.HTTP_200_OK)
def get_total_usages(_: SuperuserID, service: ChatServiceDep):
return service.get_usages()
@router.post("", status_code=status.HTTP_201_CREATED)
def create_conversation(
service: ChatServiceDep, user_id: CurrentUserID, content: str
) -> ConversationPublic:
try:
conversation = service.post_conversation(user_id, content)
except ConversationCreateError:
raise HTTPException(
status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
detail="Failed to create conversation",
)
return conversation
@router.patch("/{conversation_id}", status_code=status.HTTP_204_NO_CONTENT)
def update_title(
user_id: CurrentUserID, service: ChatServiceDep, conversation_id: int, title: str
) -> None:
try:
service.update_conversation_title(user_id, conversation_id, title)
except ConversationNotFound:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
)
@router.post("/{conversation_id}", status_code=status.HTTP_200_OK)
def chat(
service: ChatServiceDep,
user_id: CurrentUserID,
conversation_id: int,
content: str,
reasoning: str,
):
try:
stream = service.stream_and_save(
user_id,
conversation_id,
content,
reasoning,
)
except ConversationNotFound:
raise HTTPException(
status_code=status.HTTP_404_NOT_FOUND,
detail="Conversation not found",
)
return StreamingResponse(
(f"data: {json.dumps(chunk, ensure_ascii=False)}\n\n" for chunk in stream),
headers={
"Cache-Control": "no-cache",
"X-Accel-Buffering": "no",
},
)
|
对于最后stream的json拆包封装,是因为我们的stream返回的是一个dict,但StreamingResponse默认只支持文本格式或者二进制格式,也就是说我们必须强制转成字符串,或者写成这样:
1
| yield '{"content": "你好"}'
|
考虑到这样一来内部的生成器反而会写的很混乱,不如只在最外层做一个简单的转换就好.
上面的代码不少地方由于我对异常处理和分层架构还不是很熟悉,所以有很多错误,大致看个意思即可.要看真实源码还请移步Github仓库
加入uow
背景
路由完成之后,我们的初步重构就真的结束了,但现在看一下完整的代码,还是一如既往的差劲,最糟糕的一处代码如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
| def stream_and_save(
self,
user_id: int,
conversation_id: int,
content: str,
reasoning: str,
) -> Generator[dict[str, str], None, None]:
# 权限验证
try:
self._repo.get(conversation_id, user_id)
except ConversationRecordNotFound:
raise ConversationNotFound("Conversation not found")
# 获取历史消息
history_message = self._repo.get_messages(conversation_id, user_id)
# 创建默认Agent和流
client = default_agent(
history=history_message,
content=content,
reasoning=reasoning,
)
response = yield from standard_stream(client)
# 存储消息
try:
self._repo.post_usage(user_id, response.usage, MessageRole.ASSISTANT)
self._repo.post_message(conversation_id, MessageRole.USER, content)
self._repo.post_message(
conversation_id, MessageRole.ASSISTANT, response.output_text
)
except:
raise ChatSaveError("Fail to save chat")
|
我们看似是将更新usage和更新用户/LLM消息分为了三步并统一处理,但这三个操作对应的Repo都是会独立commit的,如果系统只执行了前两个操作而最后一个操作发生报错,数据库仍然会有更改,从而引发数据的不一致问题.
因此,我们要么把commit和rollback权限交给service层,但这会导致职责混淆,要么拆分repo层,让提交和事务具体操作解耦.
虽然说要解耦,实际上还是无从下手的,好在前人的实践中发明了一个好东西: UoW(Unit of Work),基本原理是,repo只负责数据访问,而UoW统一管理事务,再由service调用uow来实现原子化操作.
编写uow
我们首先要了解的就是Python的上下文管理器,只要一个类实现了__enter__和__exit__方法,那么就可以用with语句调用它,如:
1
2
3
4
| with UnitOfWork(session) as uow:
user = uow.users.get_by_id(1)
uow.users.add(new_user)
uow.commit()
|
当异常发生时,Python会自动调用__exit__函数执行清理,而正常结束时则填入uow.__exit__(None, None, None),不会触发清理代码.
因此,我们的uow可以这么写:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
| from typing import Self
from sqlmodel import Session
from app.infra.repo import UserRepo, ConversationRepo
class UnitOfWork:
def __init__(self, session: Session) -> None:
self.session = session
self.users = UserRepo(session)
self.conversations = ConversationRepo(session)
def commit(self):
self.session.commit()
def rollback(self):
self.session.rollback()
def __enter__(self) -> Self:
return self
def __exit__(self, exc_type, exc, tb):
self.rollback()
|
__exit__中的意思是,无论是否有异常,统一rollback,是一个防呆设计.
之后,在deps.py中组装:
1
2
3
4
5
6
7
8
9
10
11
12
| def get_user_service(session: SessionDep) -> UserService:
uow =UnitOfWork(session)
return UserService(uow)
def get_chat_service(session: SessionDep) -> ChatService:
uow =UnitOfWork(session)
return ChatService(uow)
UserServiceDep = Annotated[UserService, Depends(get_user_service)]
ChatServiceDep = Annotated[ChatService, Depends(get_chat_service)]
|
接下来就是彻底修改repo层和service层,确保repo层不做任何提交和回滚,全部由service执行.
全面引入uow
由于基本文件全要改动,所以我们就用user的repo和service来做演示,其余文件的修改同理.
userrepo
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
| from sqlmodel import select, desc, func
from sqlalchemy.orm import selectinload
from app.domain.exceptions import (
PasswordMatchError,
UserRecordNotFound,
UsersRecordNotFound,
)
from app.domain.schemas import UserRegister
from app.models import UserRecord
from app.core.security import verify_password, hashing_password
from app.infra.datas import DUMMY_HASH
from app.infra.repo import BaseRepo
class UserRepo(BaseRepo):
def get_by_id(self, user_id: int) -> UserRecord:
statement = select(UserRecord).where(UserRecord.user_id == user_id)
userrecord = self._session.exec(statement).first()
if userrecord is None:
raise UserRecordNotFound("User Record Not Found")
return userrecord
def get_by_name(self, name: str) -> UserRecord:
statement = select(UserRecord).where(UserRecord.name == name)
userrecord = self._session.exec(statement).first()
if userrecord is None:
raise UserRecordNotFound("User Record Not Found")
return userrecord
def get_users_amount(self) -> int:
statement = select(func.count()).select_from(UserRecord)
amount = self._session.exec(statement).one()
return amount
def get_users_list(self, offset: int, limit: int) -> list[UserRecord]:
statement = (
select(UserRecord)
.options(selectinload(UserRecord.usage)) # type: ignore
.order_by(
desc(UserRecord.created_at),
desc(UserRecord.user_id),
)
.offset(offset)
.limit(limit)
)
users = self._session.exec(statement).all()
return list(users)
def create_user(self, user_in: UserRegister) -> UserRecord:
user = UserRecord.model_validate(
user_in,
update={"hashed_password": hashing_password(user_in.password)},
)
self._session.add(user)
self._session.flush()
return user
def delete_user(self, user_id: int) -> None:
userrecord = self._session.get(UserRecord, user_id)
if not userrecord:
raise UsersRecordNotFound("Users Record Not Found")
self._session.delete(userrecord)
def verify_user(self, name: str, password: str) -> int | None:
try:
db_user = self.get_by_name(name)
except UserRecordNotFound:
verify_password(password, DUMMY_HASH)
raise
verified = verify_password(password, db_user.hashed_password)
if not verified:
raise PasswordMatchError("Password Don't Match")
return db_user.user_id
|
userservice
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
| from app.domain.exceptions import (
PasswordMatchError,
UserCreateError,
UserDeleteError,
UserNotFound,
UserRecordNotFound,
UsersRecordNotFound,
)
from sqlalchemy.exc import SQLAlchemyError
from app.services.baseservice import BaseService
from app.domain.schemas import UserPublic, UserRegister, UsersPublic
from app.models.mappers import mapper
class UserService(BaseService):
def get_by_id(self, user_id: int) -> UserPublic:
with self.uow as uow:
try:
userrecord = uow.users.get_by_id(user_id)
except UserRecordNotFound:
raise UserNotFound("User not found")
user = mapper(userrecord, UserPublic)
return user
def get_by_name(self, name: str) -> UserPublic:
with self.uow as uow:
try:
userrecord = uow.users.get_by_name(name)
except UserRecordNotFound:
raise UserNotFound("User not found")
user = mapper(userrecord, UserPublic)
return user
def get_all(self, offset: int, limit: int) -> UsersPublic:
with self.uow as uow:
users_record_list = uow.users.get_users_list(offset, limit)
users_amount = uow.users.get_users_amount()
users_public_list = [
mapper(userrecord, UserPublic) for userrecord in users_record_list
]
users_public = UsersPublic(data=users_public_list, count=users_amount)
return users_public
def post(self, user_in: UserRegister) -> UserPublic:
with self.uow as uow:
try:
userrecord = uow.users.create_user(user_in)
uow.commit()
except SQLAlchemyError:
raise UserCreateError("Fail to create new user")
user = mapper(userrecord, UserPublic)
return user
def delete(self, user_id: int) -> None:
with self.uow as uow:
try:
uow.users.delete_user(user_id)
uow.commit()
except SQLAlchemyError:
raise UserDeleteError("Fail to delete user")
except UsersRecordNotFound:
raise UserNotFound("User doesn't exist")
def check(self, name: str, password: str) -> int | None:
with self.uow as uow:
try:
user_id = uow.users.verify_user(name, password)
except UserRecordNotFound:
raise UserNotFound("User doesn't exist")
except PasswordMatchError:
raise
return user_id
|
可以发现之前的重构还是很有效果,这次我们的修改异常轻松,不需要跳转来跳转去,而且因为由uow统一管理事务,可以删掉很多不必要的异常处理.
流式响应拆分
初步重构
对于stream_and_save中这一块令人头疼的大块函数,要做拆分实际上很有难度,一方面必须接收流式输出,另一方面必须接收响应的最终结果才能让数据持久化,先看看原来的函数:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| def stream_and_save(
self,
user_id: int,
conversation_id: int,
content: str,
reasoning: str,
) -> Generator[dict[str, str], None, None]:
# 权限验证
with self.uow as uow:
conversationrecord = uow.conversations.get_conversation(
conversation_id, user_id
)
if conversationrecord is None:
raise ConversationNotFound("Conversation not found")
# 获取历史消息
history_messages = uow.conversations.get_messages_list(
conversation_id, user_id
)
data = [mapper(message, MessagePublic) for message in history_messages]
history = MessagesPublic(data=data)
# 创建默认Agent和流
client = default_agent(
history=history,
content=content,
reasoning=reasoning,
)
response = yield from standard_stream(client)
try:
# 存储消息
with self.uow as uow:
uow.conversations.update_usage(
user_id, response.usage, MessageRole.ASSISTANT
)
uow.conversations.create_message(
user_id, conversation_id, MessageRole.USER, content
)
uow.conversations.create_message(
user_id,
conversation_id,
MessageRole.ASSISTANT,
response.output_text,
)
uow.commit()
except ConversationRecordNotFound as e:
raise ConversationNotFound("Conversation not found") from e
except SQLAlchemyError as e:
raise MessageCreateError("Failed to save chat") from e
|
上述代码的主要流程为:
- 获取历史消息
- 获取流式响应
- 根据流式响应的结果保存消息
那么,直接按照这三步来做一个简单的重构:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
| def retrieve_history_messages(self, user_id, conversation_id) -> MessagesPublic:
with self.uow as uow:
conversationrecord = uow.conversations.get_conversation(
conversation_id, user_id
)
if conversationrecord is None:
raise ConversationNotFound("Conversation not found")
# 获取历史消息
history_messages = uow.conversations.get_messages_list(
conversation_id, user_id
)
data = [mapper(message, MessagePublic) for message in history_messages]
history = MessagesPublic(data=data)
return history
def _save_message_pair(
self,
user_id: int,
conversation_id: int,
content: str,
output_text: str,
usage: TokenUsage,
) -> None:
try:
with self.uow as uow:
conversation = uow.conversations.get_conversation(
conversation_id, user_id
)
if conversation is None:
raise ConversationNotFound("Conversation not found")
uow.conversations.update_usage(
user_id,
usage,
MessageRole.ASSISTANT,
)
uow.conversations.create_message(
user_id,
conversation_id,
MessageRole.USER,
content,
)
uow.conversations.create_message(
user_id,
conversation_id,
MessageRole.ASSISTANT,
output_text,
)
uow.commit()
except ConversationRecordNotFound as e:
raise ConversationNotFound("Conversation not found") from e
except SQLAlchemyError as e:
raise MessageCreateError("Failed to save chat") from e
def stream_and_save(
self,
user_id: int,
conversation_id: int,
content: str,
reasoning: str,
history: MessagesPublic,
) -> Generator[dict[str, str], None, None]:
# 创建默认Agent和流
client = default_agent(
history=history,
content=content,
reasoning=reasoning,
)
response = yield from standard_stream(client)
if response.usage is None:
raise MessageCreateError("Model usage missing")
self._save_message_pair(
user_id,
conversation_id,
content,
response.output_text,
response.usage,
)
yield {"type": "done", "content": ""}
|
重构底层
先看看原来的设计:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| def _stream_output(
stream: Stream[ResponseStreamEvent],
) -> Generator[dict[str, str], None, Response]:
final_response: Response | None = None
for event in stream:
# thinking字段和answer字段
if event.type == "response.reasoning_text.delta":
yield {"type": "reasoning", "content": event.delta}
elif event.type == "response.output_text.delta":
yield {"type": "answer", "content": event.delta}
# 错误处理
elif event.type == "error":
raise LLMConnetionError(event.message)
elif event.type == "response.failed":
error = event.response.error
if error:
raise LLMConnetionError(error.message)
else:
raise LLMConnetionError("Response failed")
# 完成输出
elif event.type == "response.completed" or event.type == "response.incomplete":
final_response = event.response
if not final_response:
raise LLMConnetionError("Reponse incomplete")
return final_response
def standard_stream(
stream: Stream[ResponseStreamEvent],
) -> Generator[dict[str, str], None, ResponsePublic]:
try:
raw_response = yield from _stream_output(stream)
except LLMConnetionError:
raise
usage = raw_response.usage
if usage is None:
raise LLMConnetionError("Fail to return usage")
tokenusage = TokenUsage(
input_tokens=usage.input_tokens,
output_tokens=usage.output_tokens,
total_tokens=usage.total_tokens,
)
response = ResponsePublic(
output_text=raw_response.output_text,
usage=tokenusage,
)
return response
|
问题很多,最突出的就是类型硬编码,所以先在chat_schema里设计一个能够装载我们所需dict的type:
1
2
3
4
5
6
7
8
9
10
11
| StreamEventType = Literal[
"reasoning",
"answer",
"done",
"error",
]
class StreamEvent(TypedDict):
type: StreamEventType
content: str
|
如此一来,当我们在dict里把reasoning写成reason时,类型提示就会报错,从而保证字典的准确性.
最终的LLM流式响应处理:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
| def _stream_output(
stream: Stream[ResponseStreamEvent],
) -> Generator[StreamEvent, None, Response]:
final_response: Response | None = None
for event in stream:
# thinking字段和answer字段
if event.type == "response.reasoning_text.delta":
yield {
"type": "reasoning",
"content": event.delta,
}
elif event.type == "response.output_text.delta":
yield {
"type": "answer",
"content": event.delta,
}
# 错误处理
elif event.type == "error":
raise LLMError(event.message)
elif event.type == "response.failed":
error = event.response.error
if error:
raise LLMError(error.message)
else:
raise LLMError("Response failed")
# 完成输出
elif event.type == "response.completed":
final_response = event.response
elif event.type == "response.incomplete":
details = event.response.incomplete_details
reason = details.reason if details else "unknown"
raise LLMError(f"Response incomplete: {reason}")
if final_response is None:
raise LLMError("Reponse did not complete")
return final_response
|
总结
纵览一下代码,你会发现我们这次重构完美实现了功能的去耦合,极大地增强了代码的可读性.那么接下来就是朝着增强代码的健壮性入手了.